Trinity:多模态智能体的能力驱动递归自我改进框架 The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
用共享能力重组任务并自动生成训练世界,驱动智能体框架递归进化
前置知识
Agent Harness(智能体框架层)
Harness 是包裹冻结模型 $f_\theta$ 的控制流编排层,形式化为 $H_\phi = (\Pi_{er}, M, I, P, F, L)$,即六个协议:感知 $\Pi_{er}$ 从观测提取事实、记忆 M 构建历史条件视图、推理 I 维护兼容候选、规划 P 将候选排序剪枝为指令、编排 F 判定资源适用性、循环 L 解决执行与提交。模块是只读公开记录的纯函数,模型权重 $\theta$ 固定,进化只改配置 $\phi$。
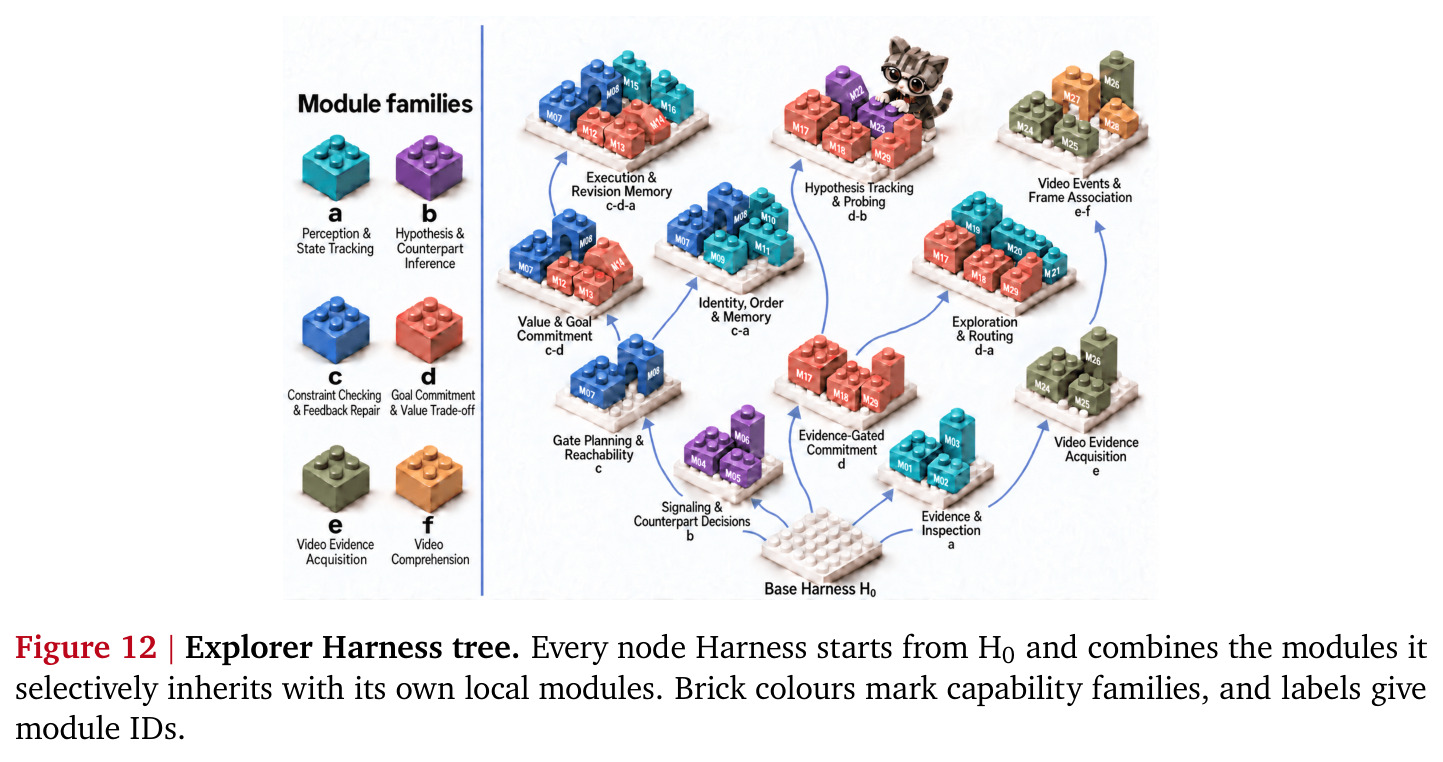
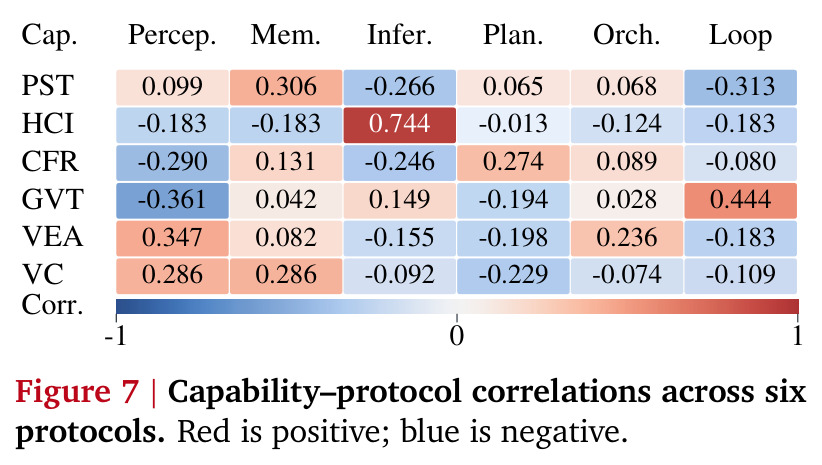
论文的全部进化对象就是 Harness 配置本身,不理解六协议的划分,就无法看懂模块树、能力-协议相关性分析和模块干预实验。
递归自我改进(Recursive Self-Improvement, RSI)
在模型权重冻结的前提下,让系统利用自己产生的执行轨迹来改进自身外围组件(这里是 Harness 的模块配置)并不断迭代。每轮迭代包括:采集轨迹、对比成败案例定位改进点、产出并验证新模块、验证通过后累积到下一轮。改进信号来自可验证的执行结果而非人工标注。
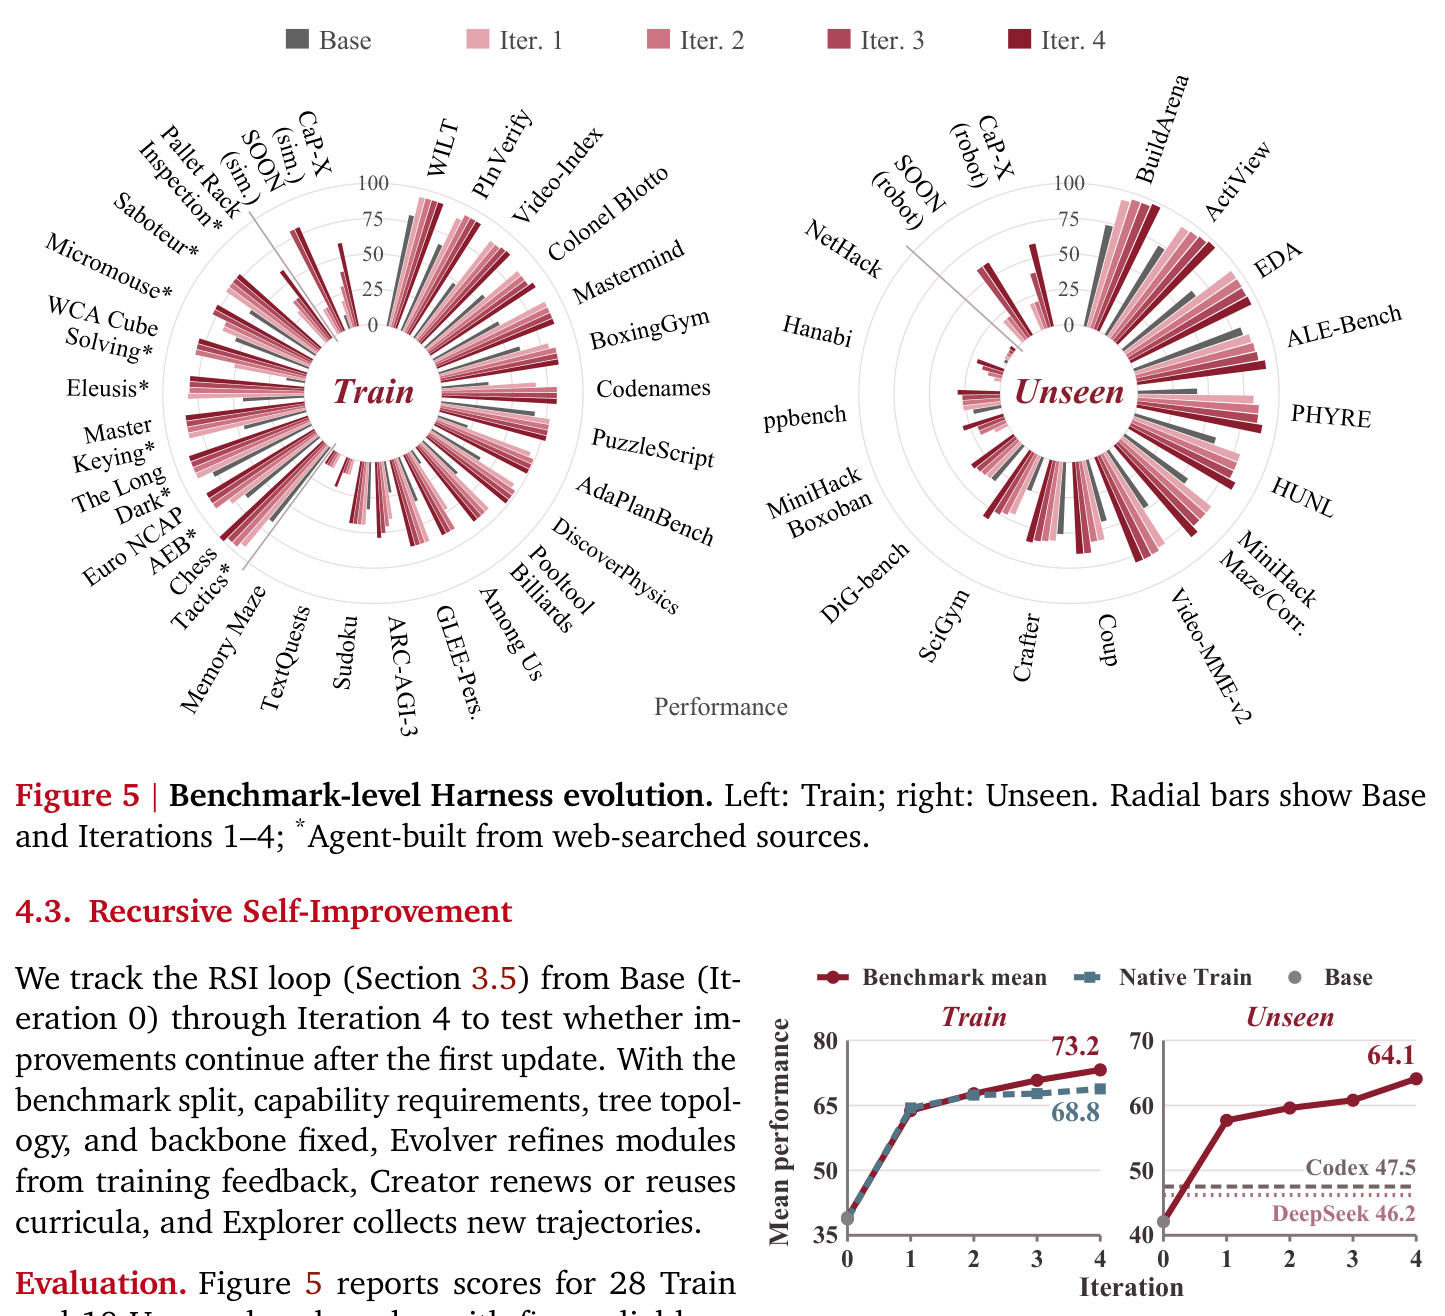
The Trinity 就是一个 RSI 框架,实验部分的核心曲线(4 轮迭代 Train 39.1 到 73.2)检验的正是 RSI 能否持续产生增益。
Real2Sim2Real(真实-仿真-真实迁移)
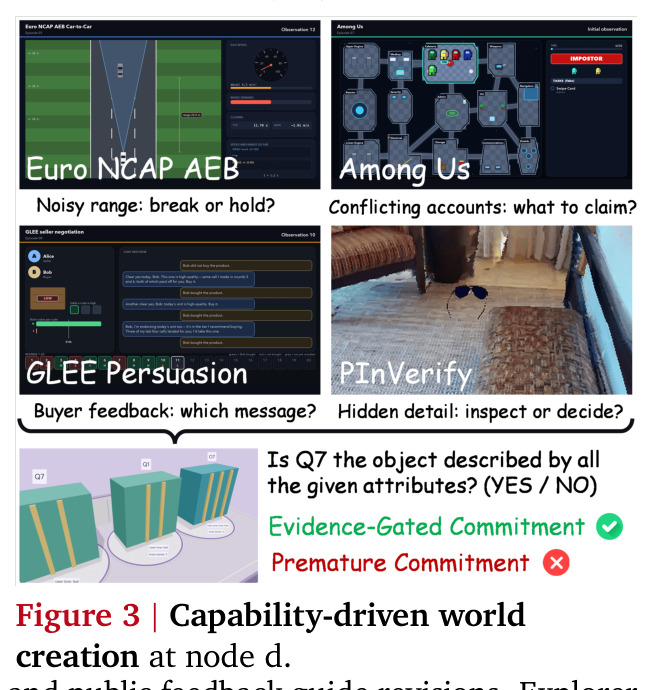
先在真实任务中提炼核心决策机制,把它抽象成简化的仿真环境用于低成本学习,再迁移回真实任务评测效果。本文的 Capability-Driven 版本要求仿真世界只保留节点的公共能力需求,刻意排除目标任务的布局、私有证明和解法轨迹,防止训练时「泄题」,用原任务评测衡量能力是否真正迁移。
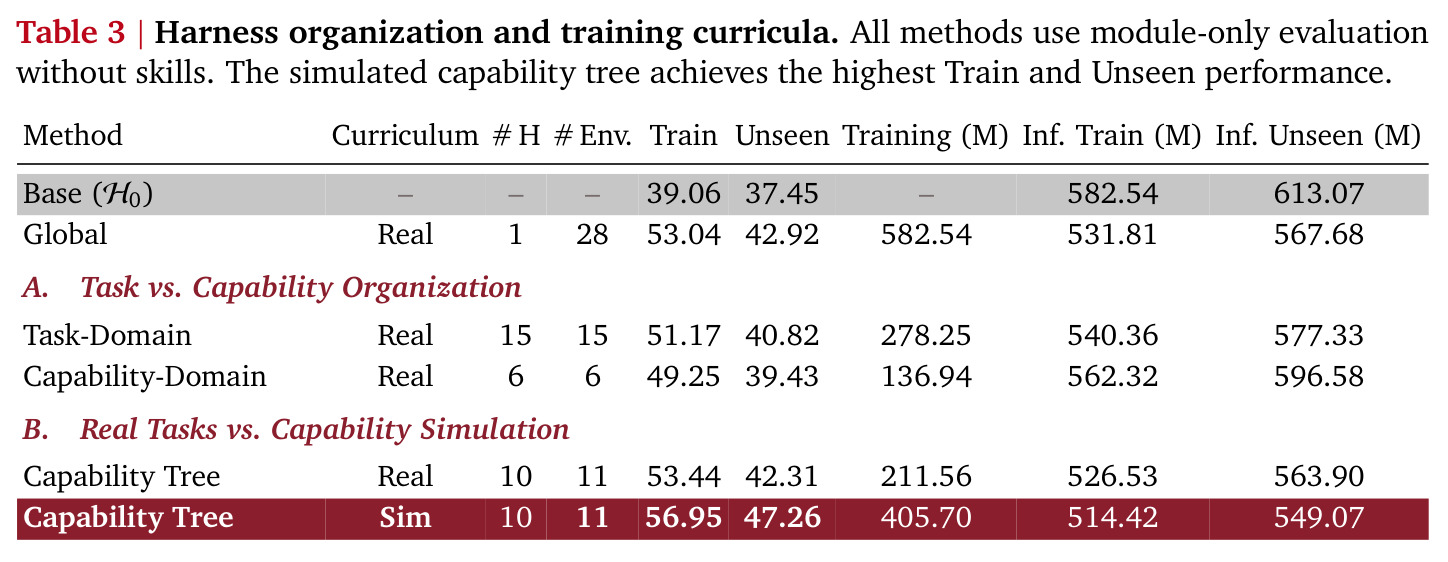
这是 Creator 造世界的指导原则,也是 Table 3 中模拟训练(Sim)优于真实任务训练(Real)这一关键结论的来源。
Trie(前缀树)与能力树
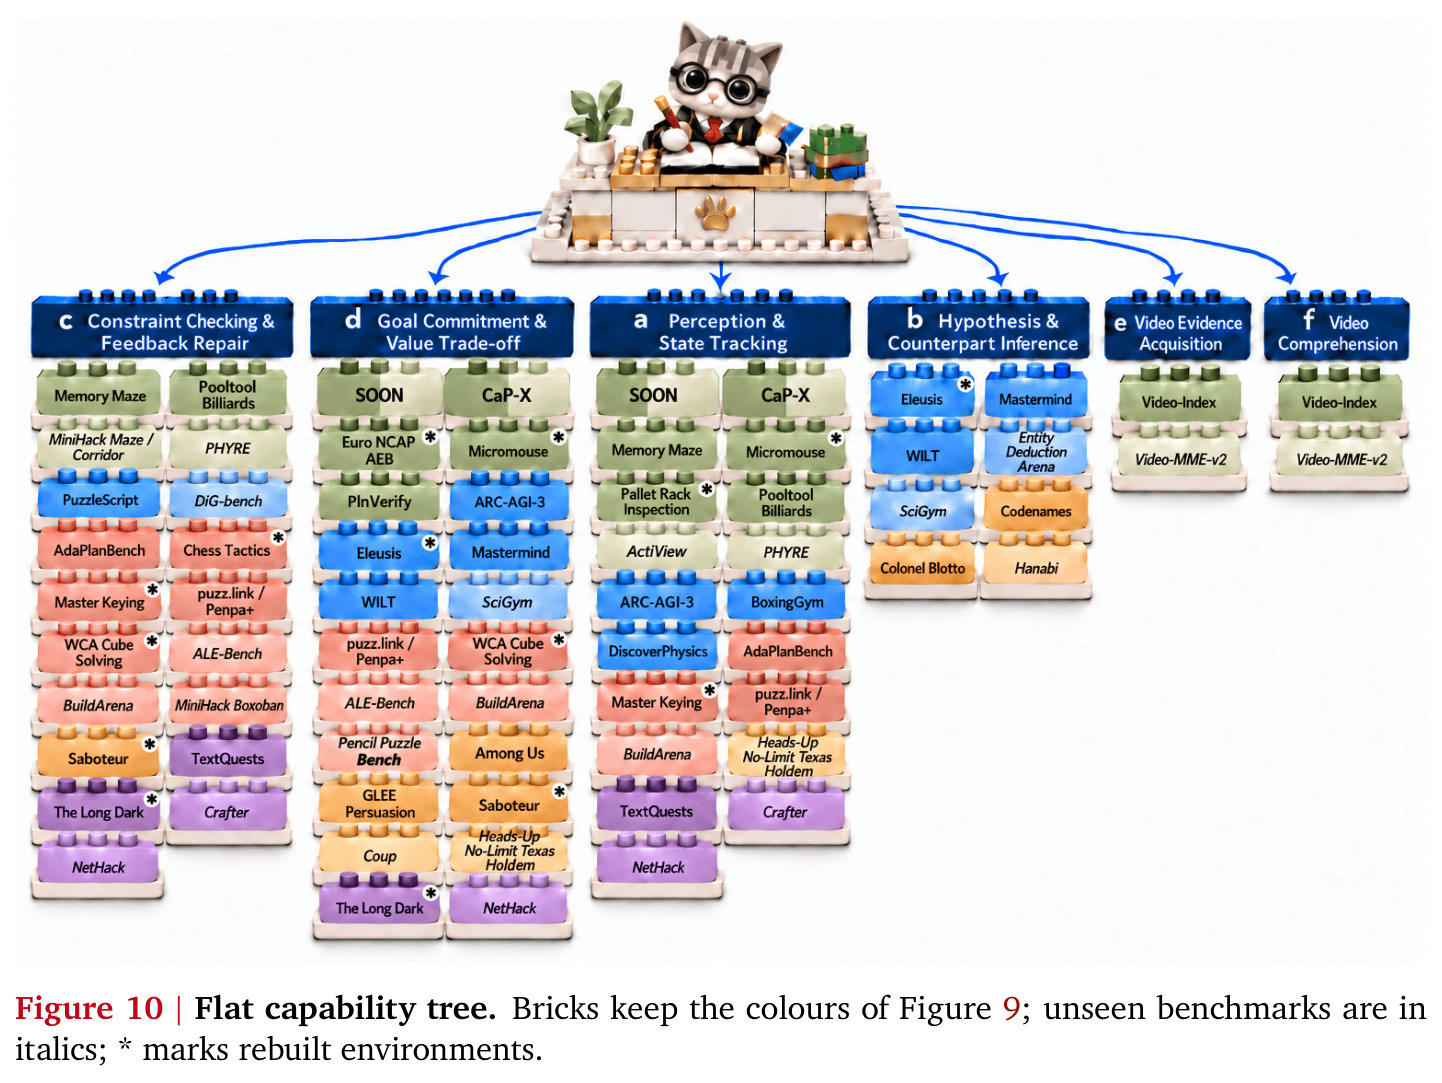
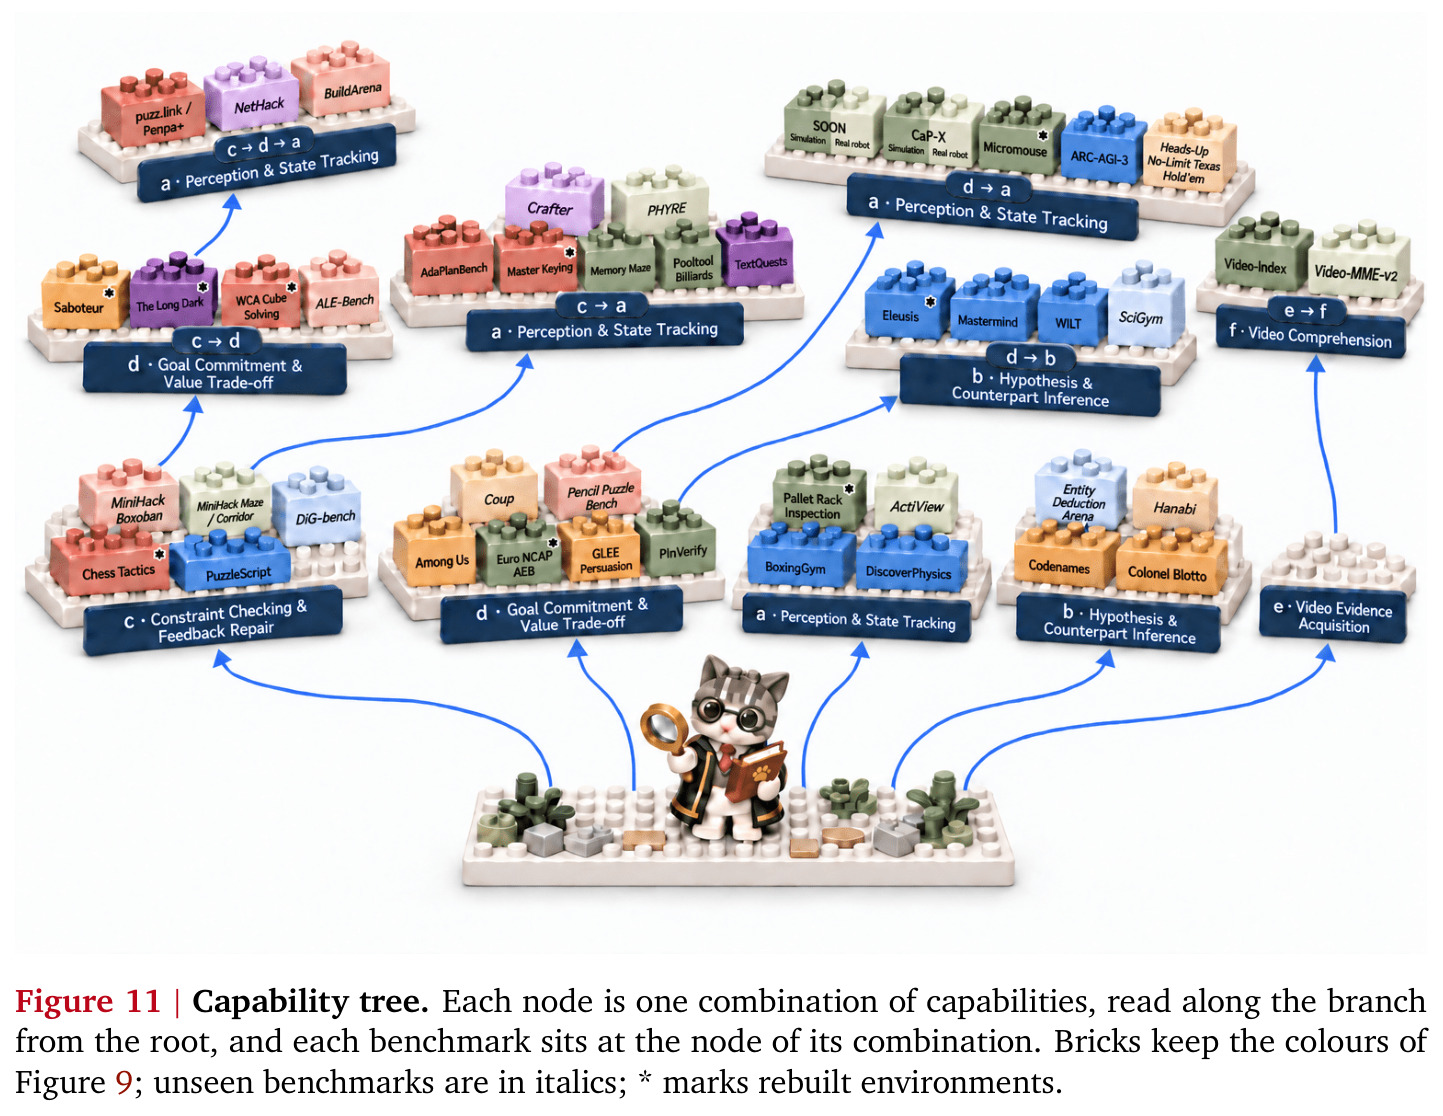
Trie 是合并公共前缀的树形数据结构。本文先把每个任务的需求集合 $K_\tau$ 按预固定的确定性序 $\prec$ 排序成路径 $p_\tau$,再把所有训练任务的路径插入 $T = \mathrm{Trie}\{p_\tau\}$,公共前缀自动合并成共享节点。不同领域的异构任务因此能在同一节点汇聚,共享同一学习目标。
能力树是全文的组织骨架:环境生成、模块继承、路由选择全部发生在这棵树上,理解 Trie 构造才能理解「层级继承」到底继承什么。
能力感知路由(Capability-Aware Routing)
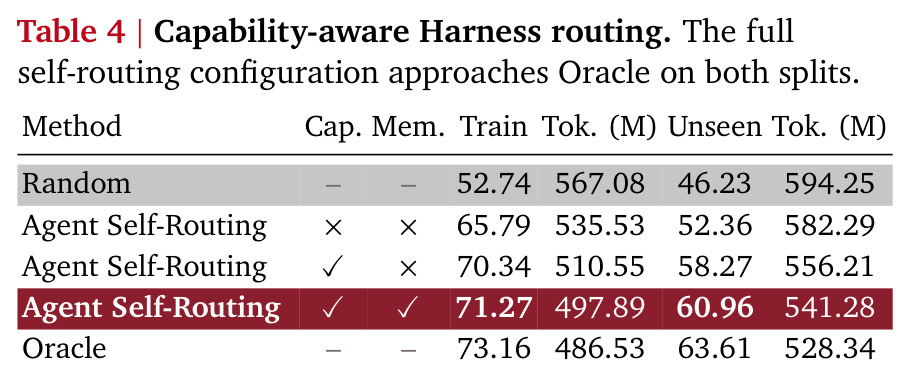
由于 Harness 树中各分支专精不同能力,推理时需要一个路由器为新任务选配配置。本文用智能体 $\pi$ 基于公开任务信息 $x_n$、候选 Harness 池 $\mathcal{C}$、检索到的已验证执行经验 $R$ 与性能-成本摘要 $S$ 做选择,事后用终端回执与注册表哈希验证决策,再把结果追加进 FIFO 记忆供后续任务参考。
Table 4 显示完整自路由 71.27/60.96 逼近 Oracle 73.16/63.61,这是「能力树提供语义匹配基础」这一主张的直接证据。
研究动机
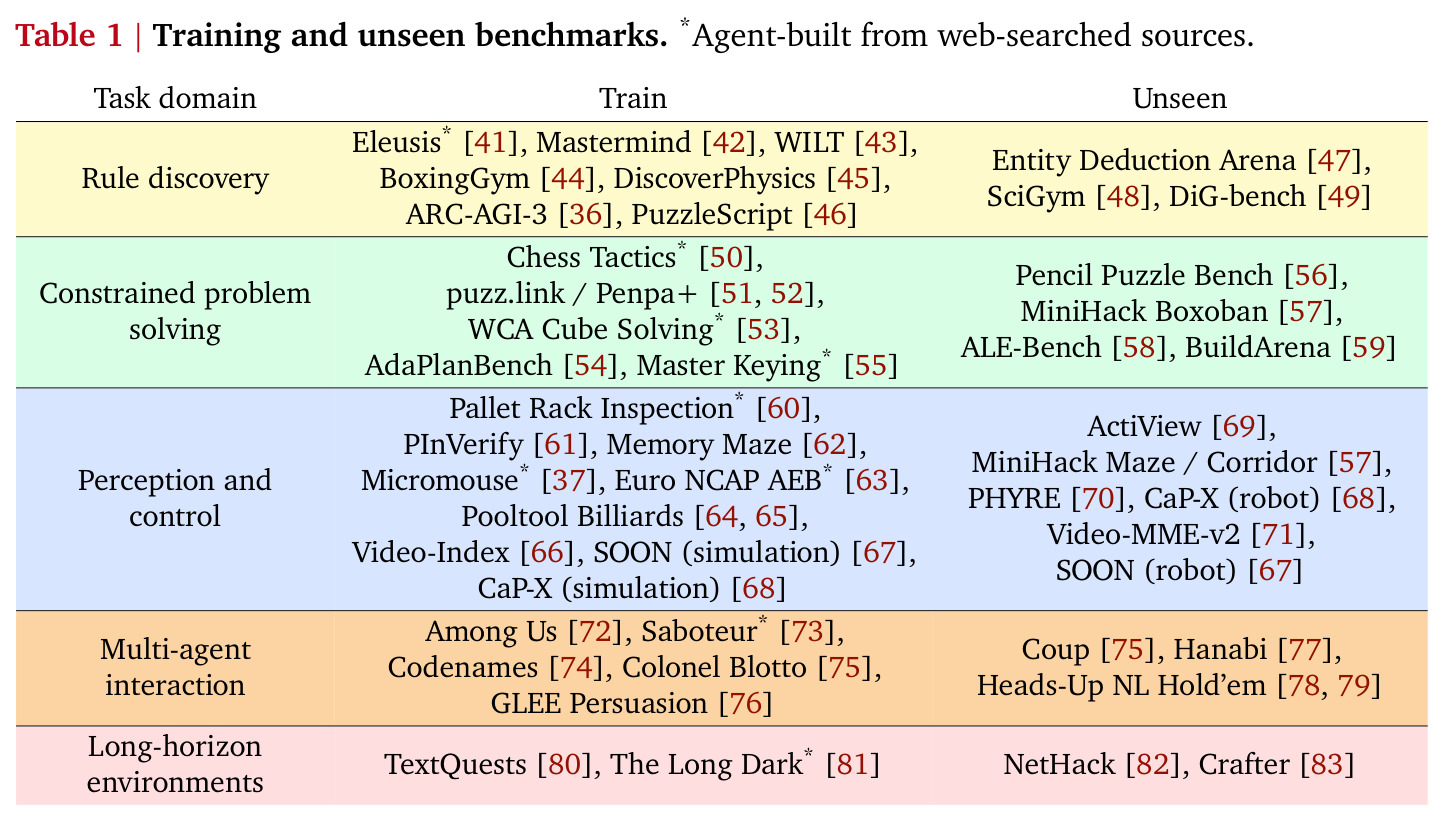
多模态智能体在交互式游戏、GUI 操作与具身任务上的表现越来越受限于 Harness(围绕冻结模型的控制流编排层),而这一层的人工迭代无法跟上任务规模与复杂度的增长。论文指出两个具体瓶颈:其一,手工构建大规模、异构、可验证的训练环境成本极高——要在规则发现、约束求解、感知控制、多智能体交互、长程环境五个需求域上覆盖 28 个训练基准加 18 个未见基准,人工建环境完全不现实;其二,现有 Harness 递归自我改进(RSI)工作几乎都集中在纯文本任务(编程、数学)上并采用任务特定进化,在异构多模态任务上容易过拟合、跨任务泛化差;反过来用一个全局单一 Harness 又无法兼容相互冲突的任务需求,例如具身任务中性能与效率的权衡。结果是环境扩建和框架迭代两条线都卡在人工环节,无法形成自动闭环。
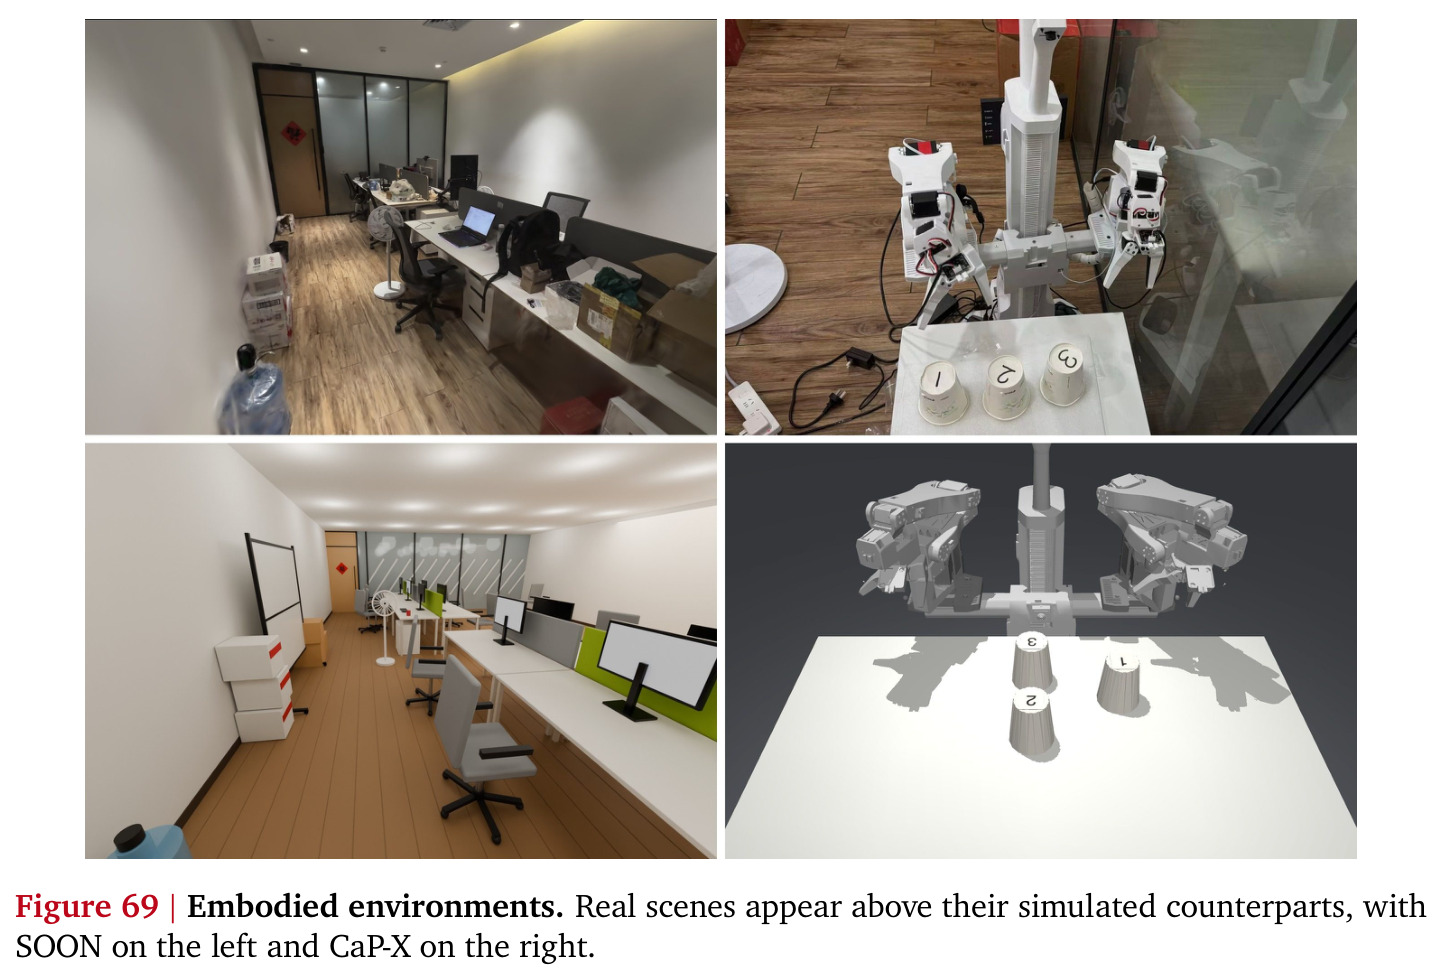
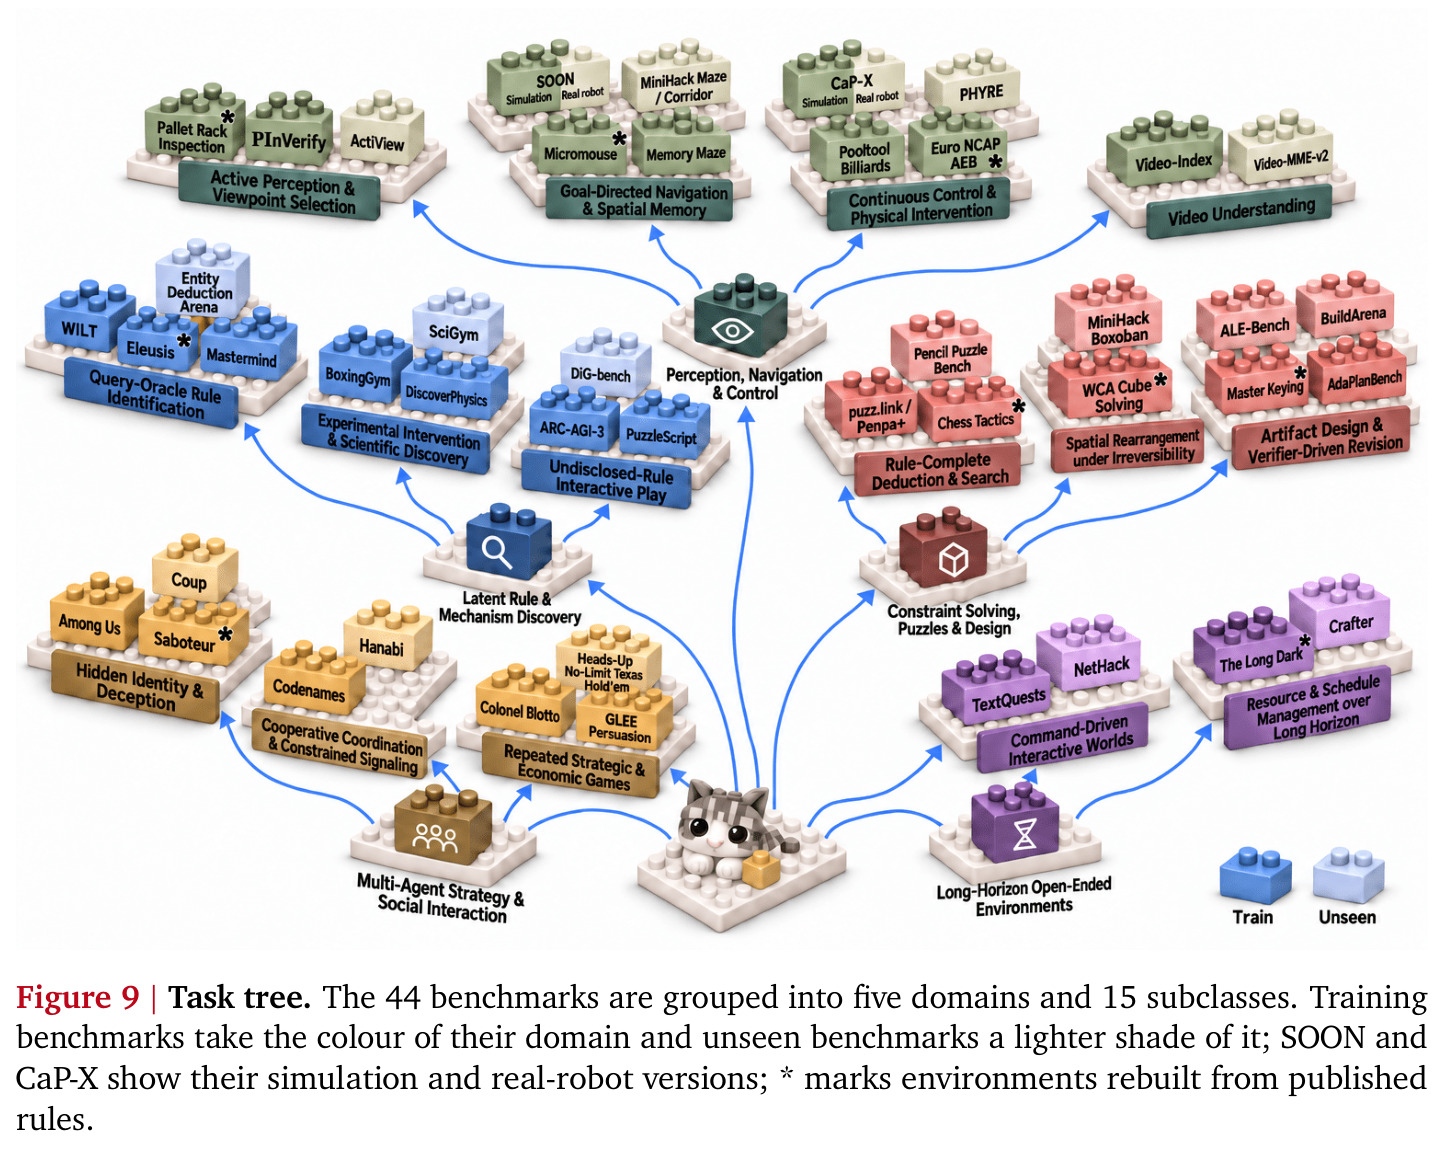
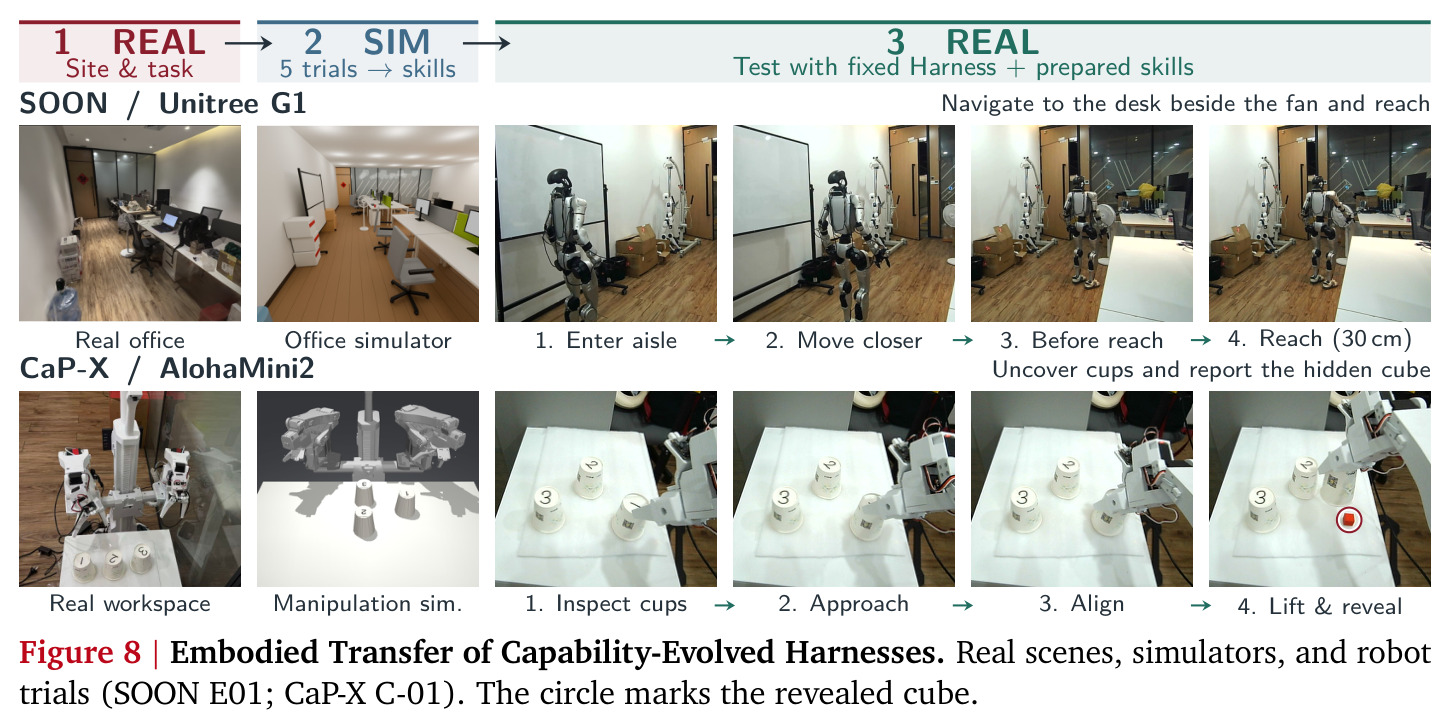
本文的目标是本文的目标是把「世界生成 + Harness 进化」这条人工闭环改造成自动递归闭环:以共享能力需求为组织原则,把 44 个异构基准重组为一棵层级能力树;在每个节点自动生成简化且可验证的模拟世界作为能力训练课程;通过选择性继承沿树进化出能力专精的可复用模块化 Harness;再用能力感知路由器按公开任务信息自动选配。量化目标非常明确:在骨干模型(Claude Opus 5)完全冻结、树拓扑固定的前提下,28 个训练基准平均提升约 34 分、18 个未见基准提升约 26 分,并把进化后的 Harness 迁移到 SOON(Unitree G1 机器人导航伸手)与 CaP-X(AlohaMini2 杯子操作)两个真实具身任务上验证迁移效果。
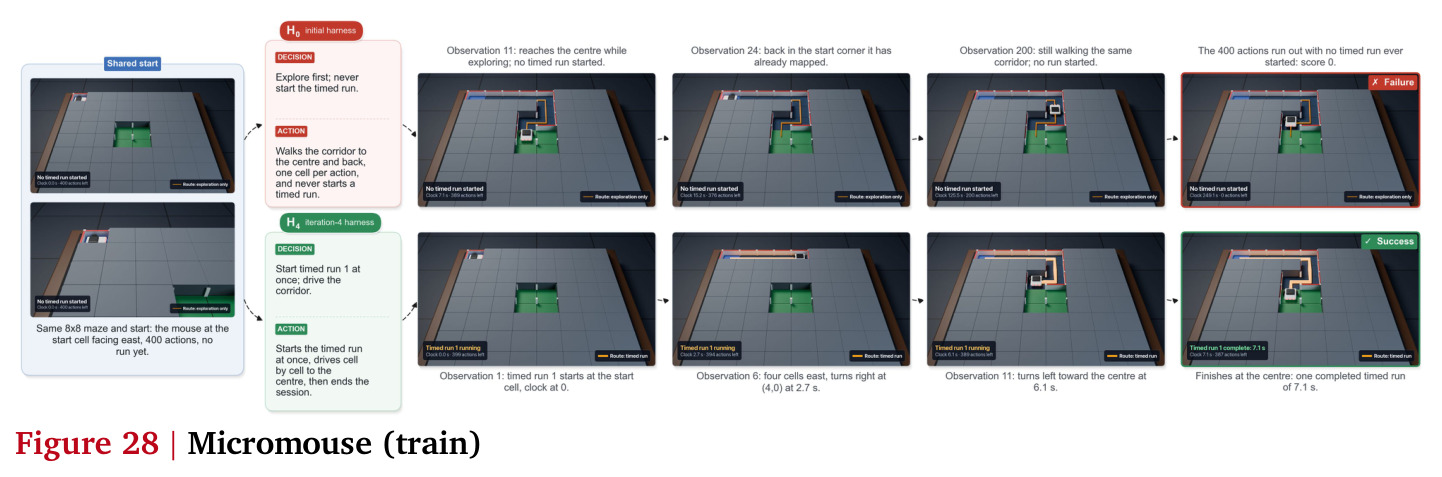
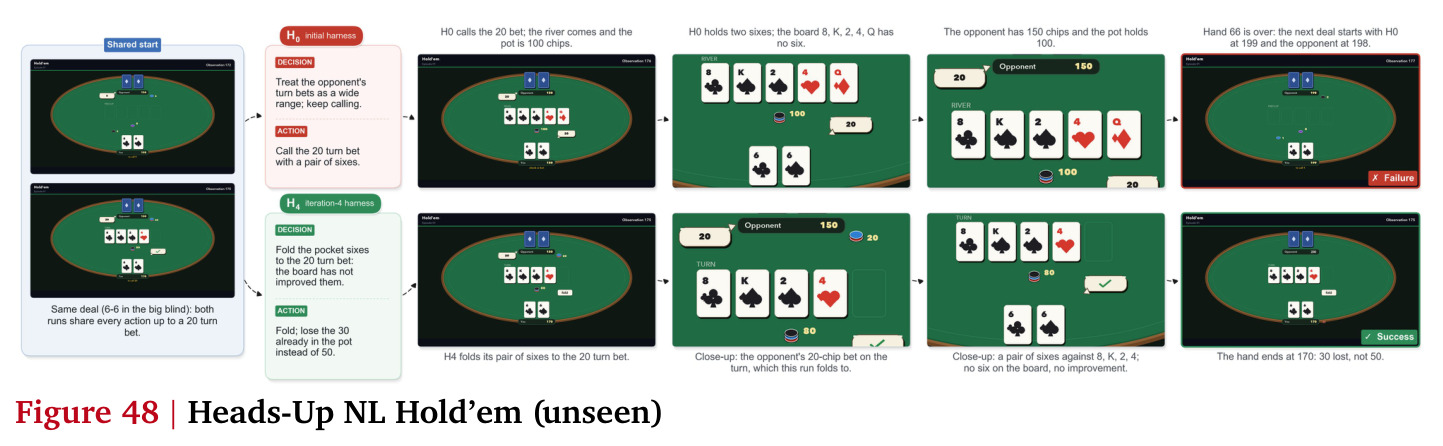
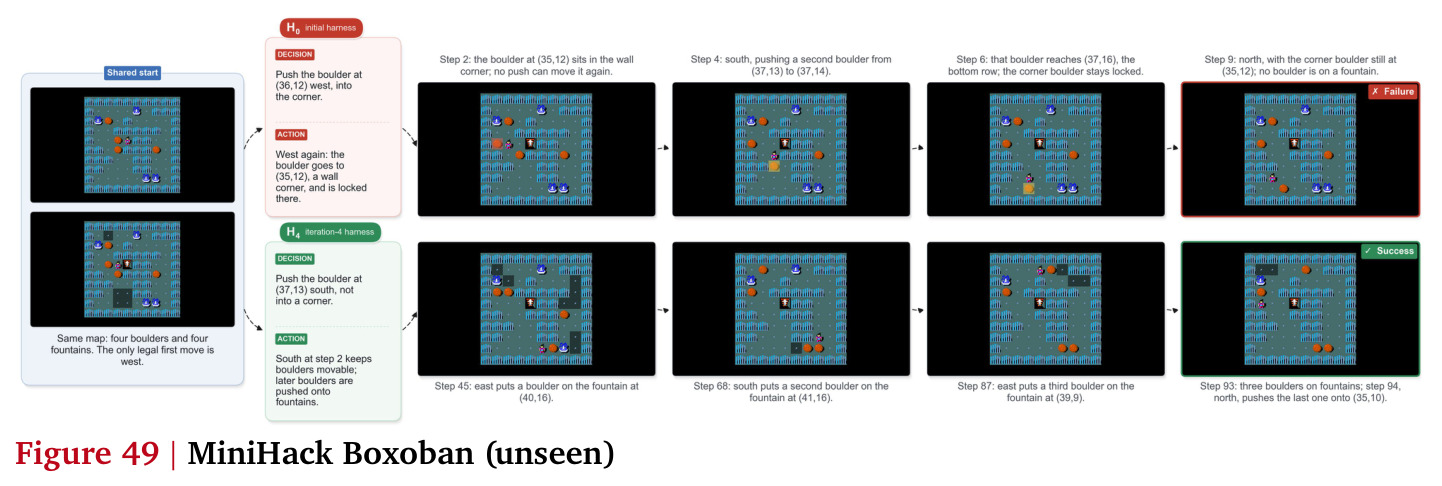
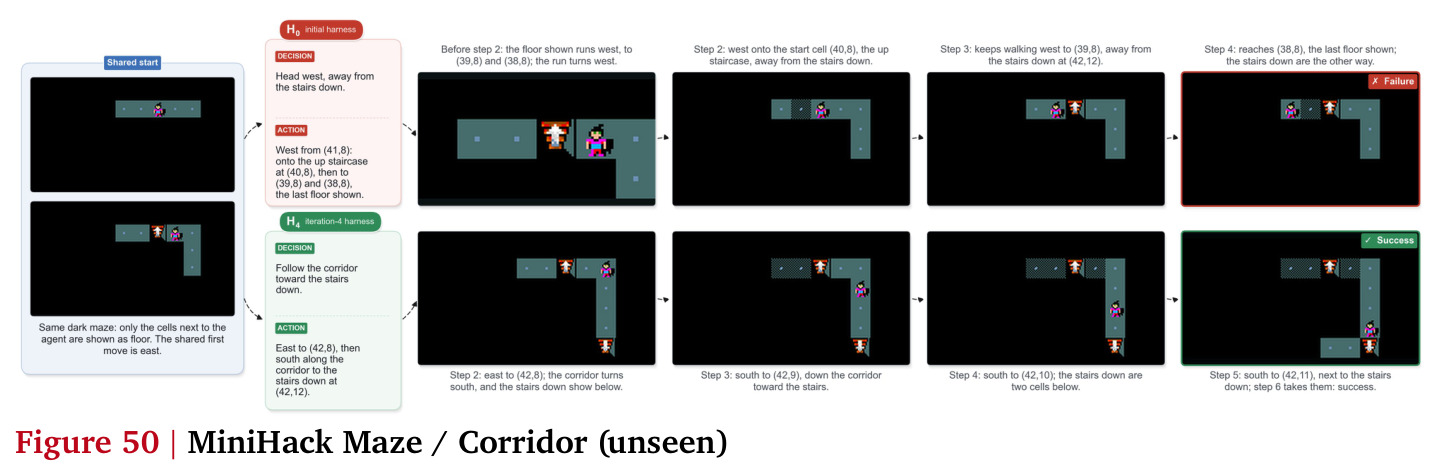
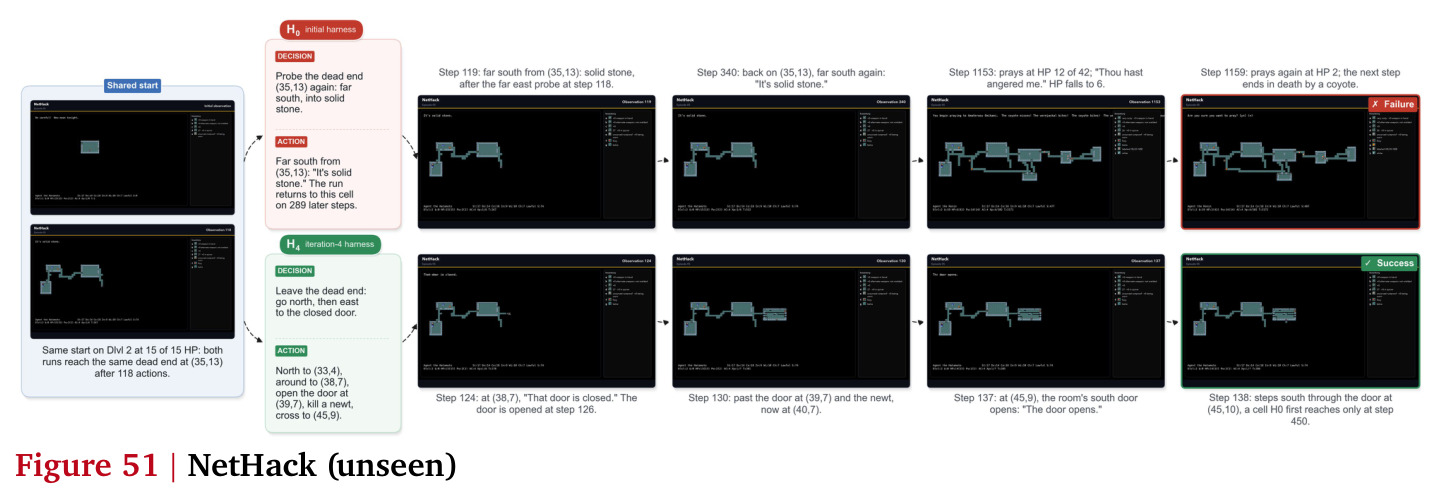
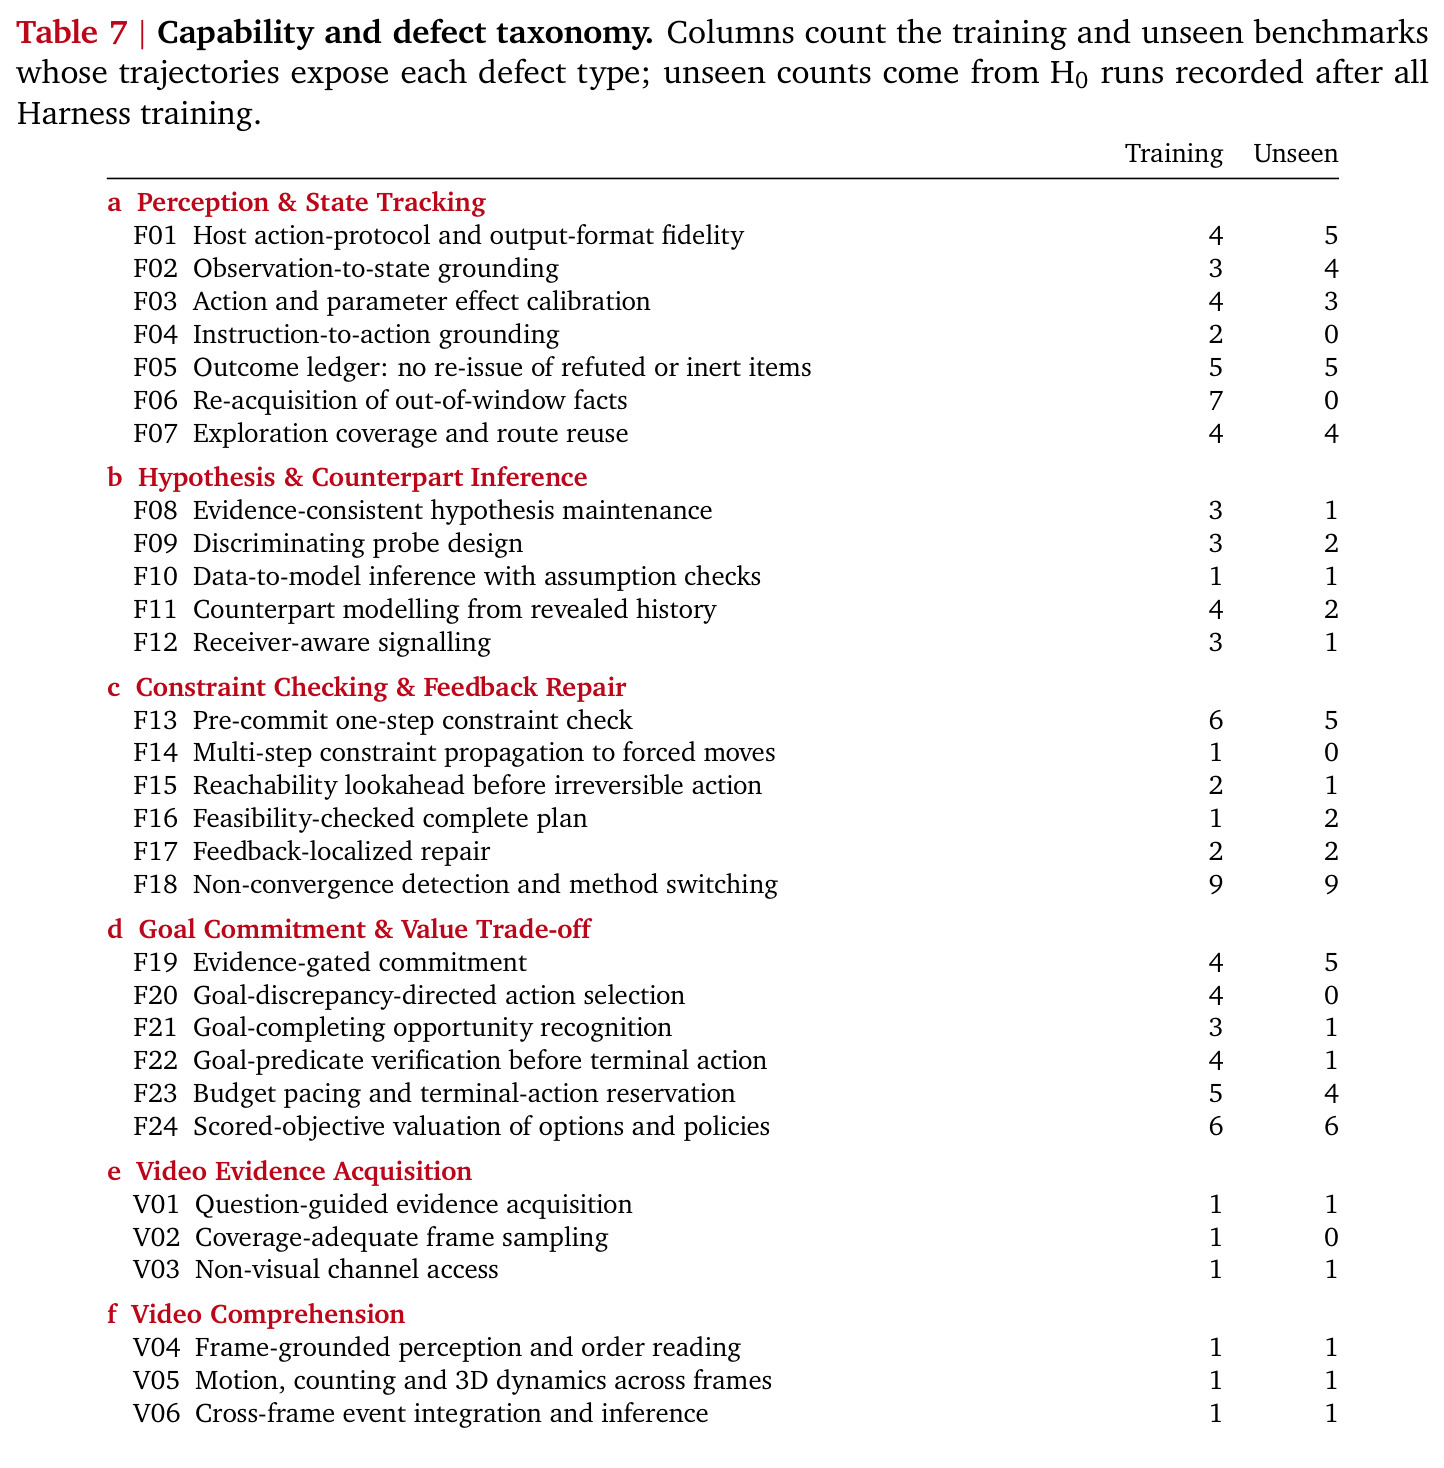
与已有工作不同的是,已有 RSI 工作按任务类别组织进化(task-specific),或干脆训练一个全局 Harness,两头都不理想。本文抓住一个被忽视的关键洞察:不同模态、不同表面形式的任务可能共享相同的底层能力需求——例如 ARC-AGI-3(识别网格状态及其变化)与 Micromouse(迷宫探索中持续更新环境信息)任务结构完全不同,但都依赖精确感知与状态跟踪。据此论文完成三步转向:用已验证的执行轨迹归纳每个任务的需求集 $K_\tau$,按确定性序排序后用 Trie 合并公共前缀形成层级能力树,使跨领域任务在同一节点汇聚;用 Capability-Driven Real2Sim2Real 把节点公共需求抽象成排除目标任务布局与解法的合成世界;让验证过的模块沿树选择性继承、跨迭代累积。这是从任务驱动到能力驱动的范式转移,也自然引出了按能力匹配 Harness 的路由设计。
核心方法
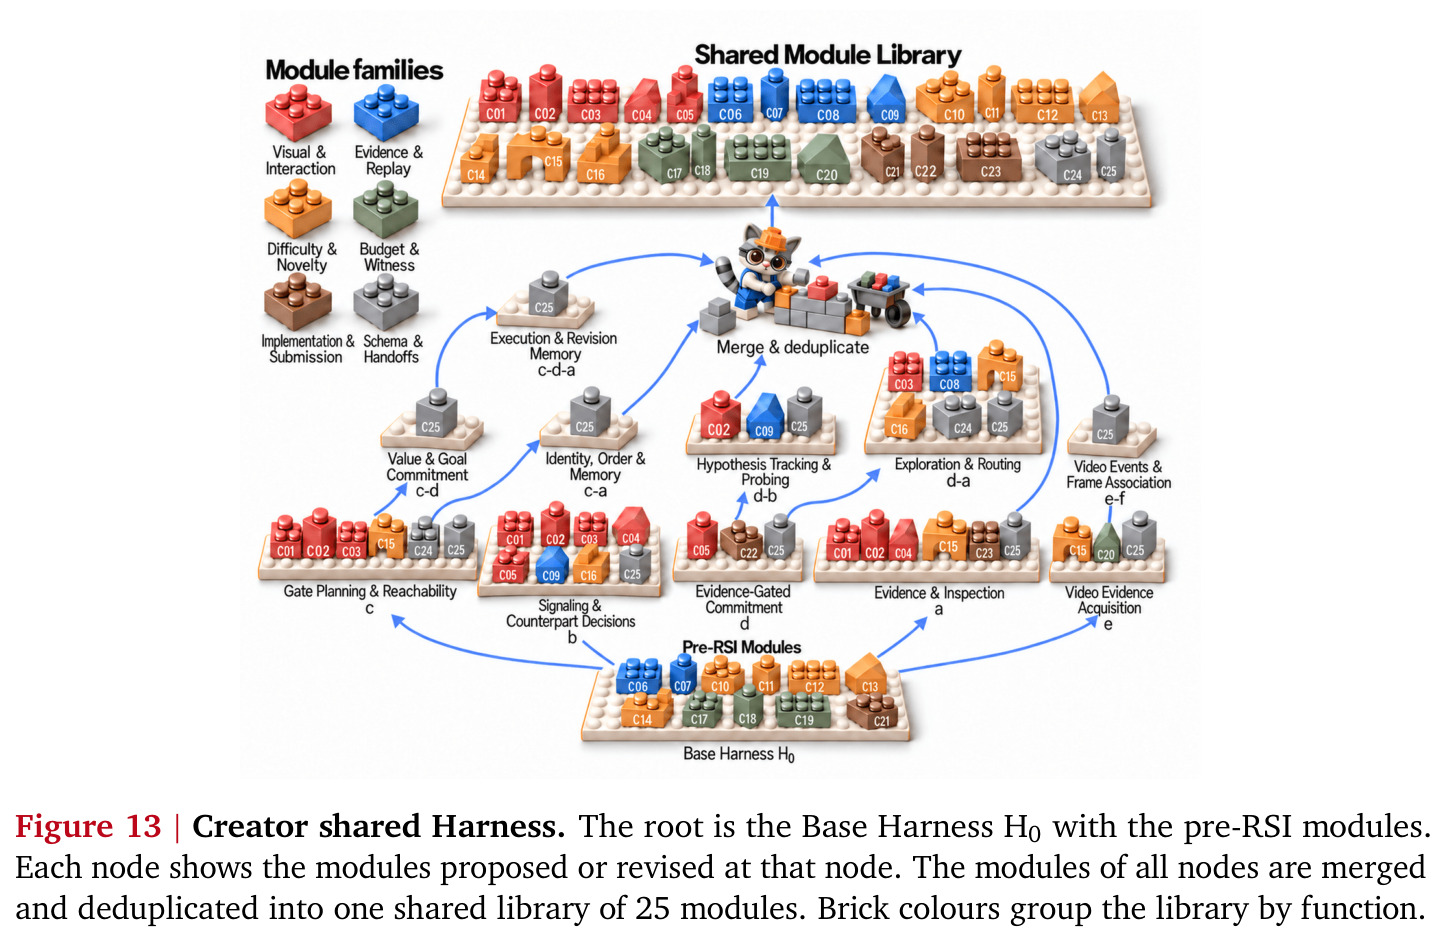
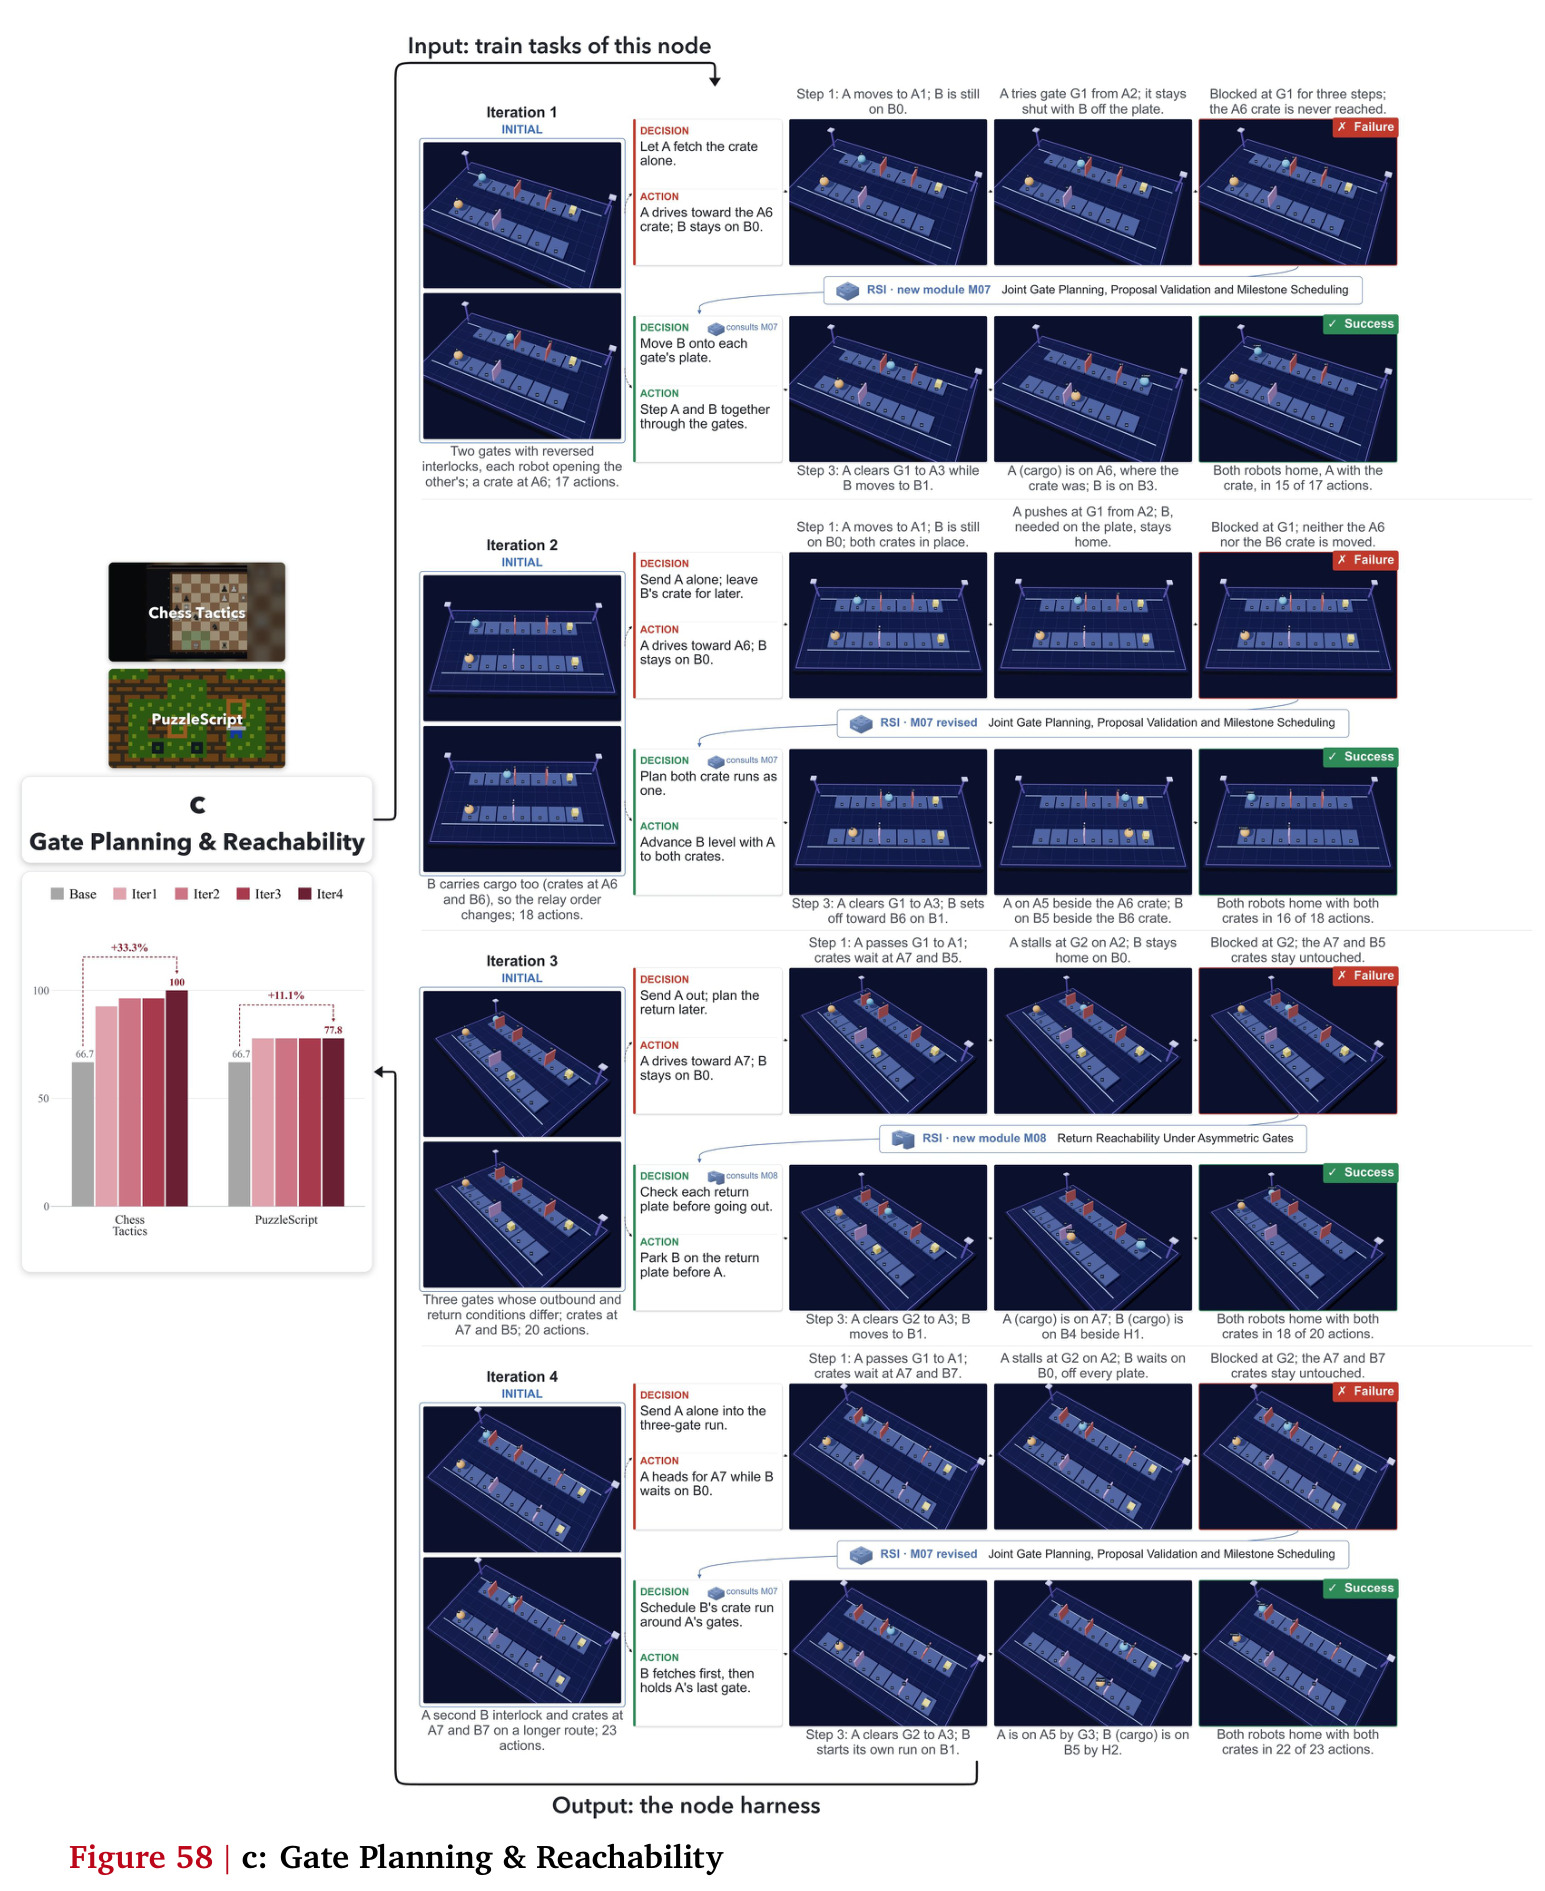
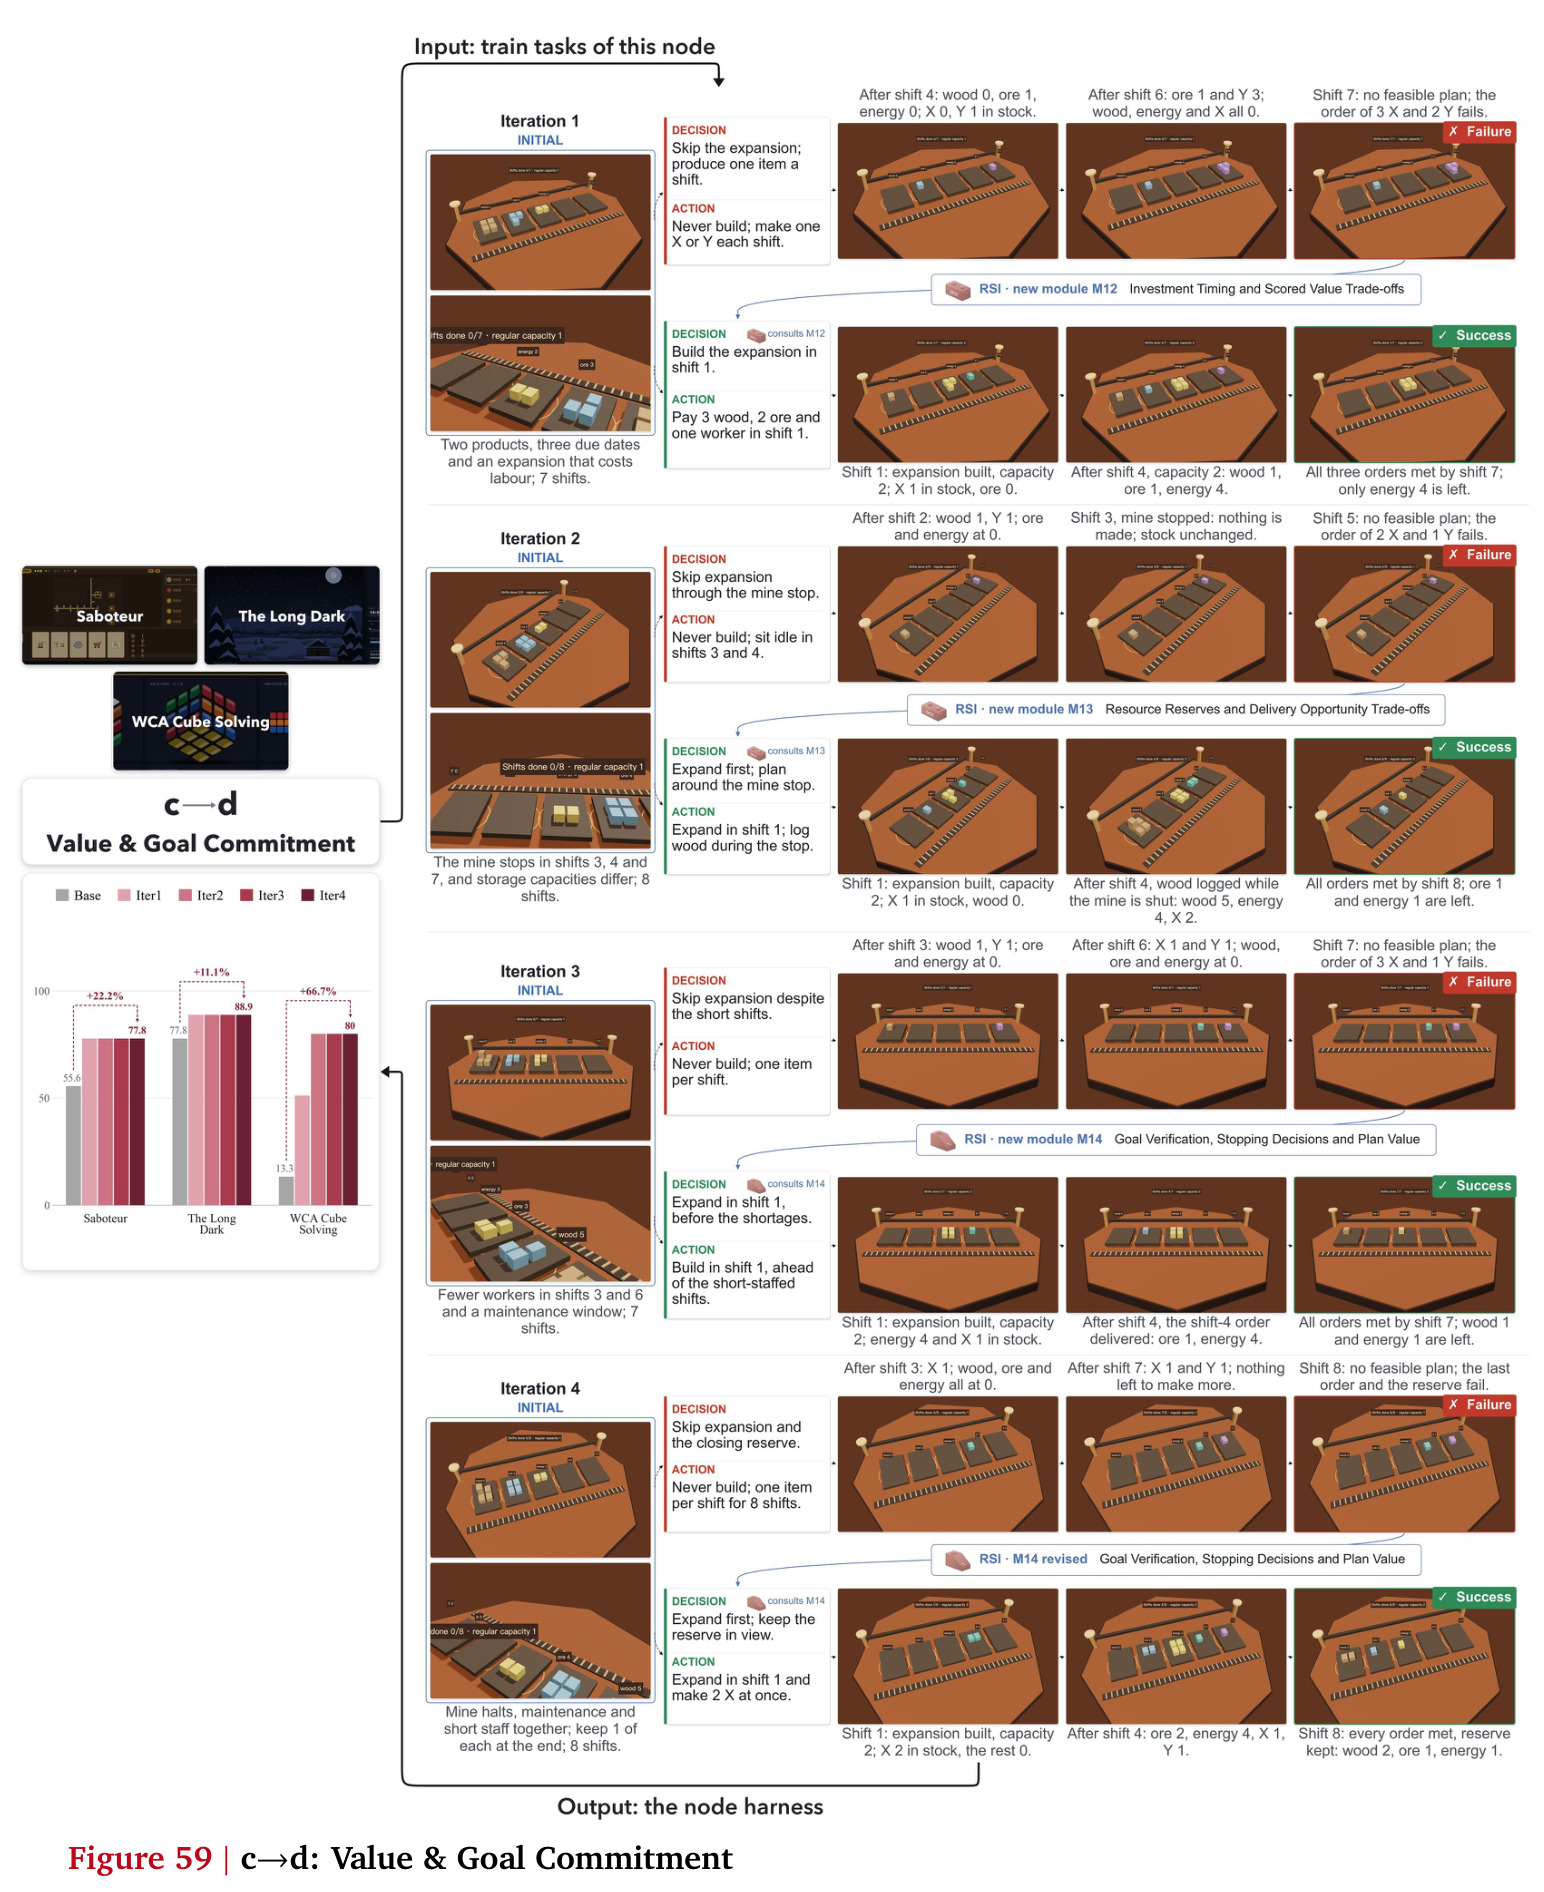
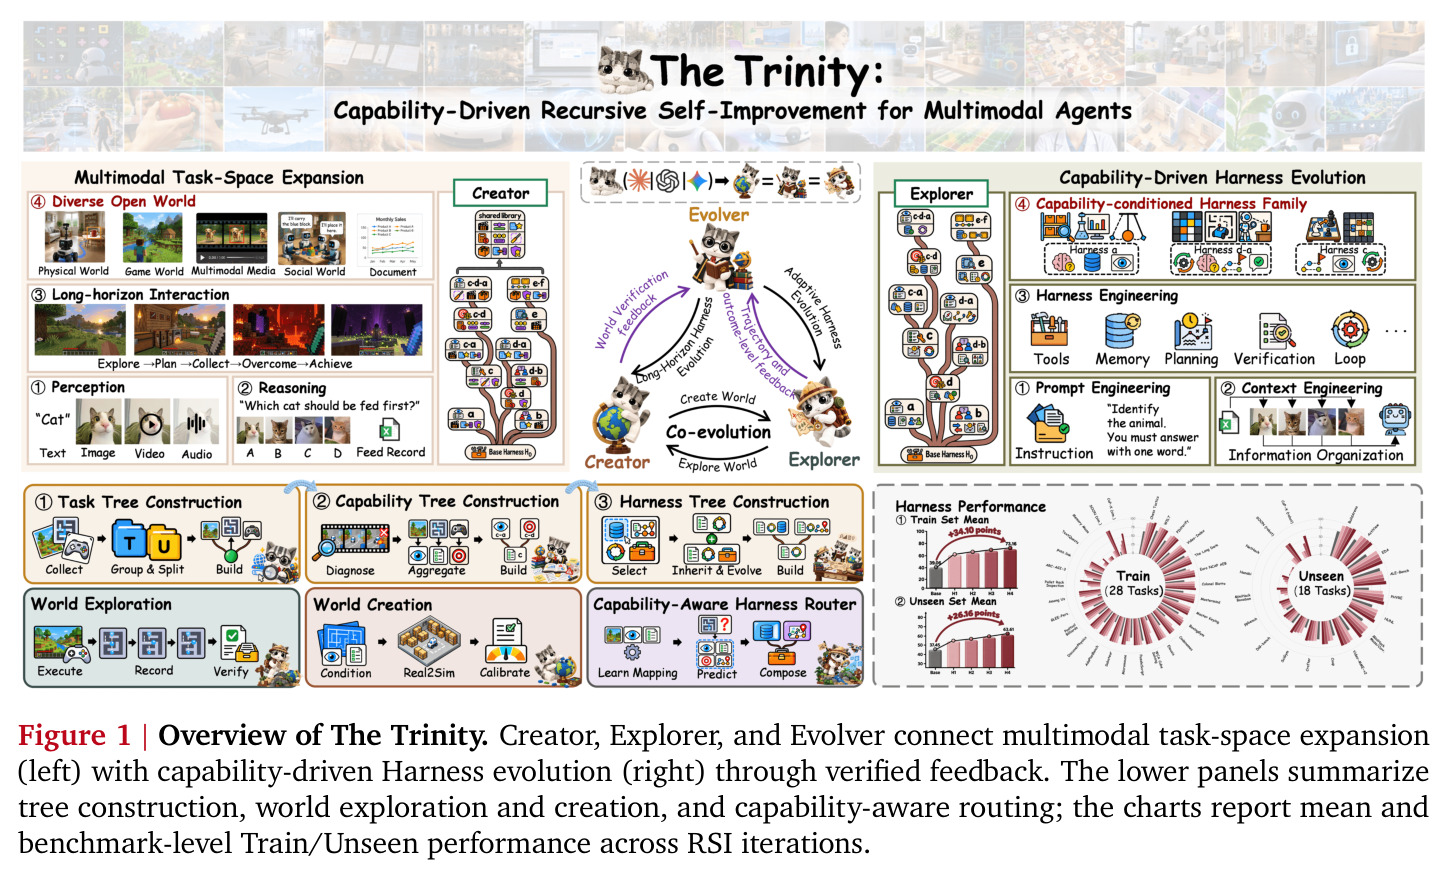
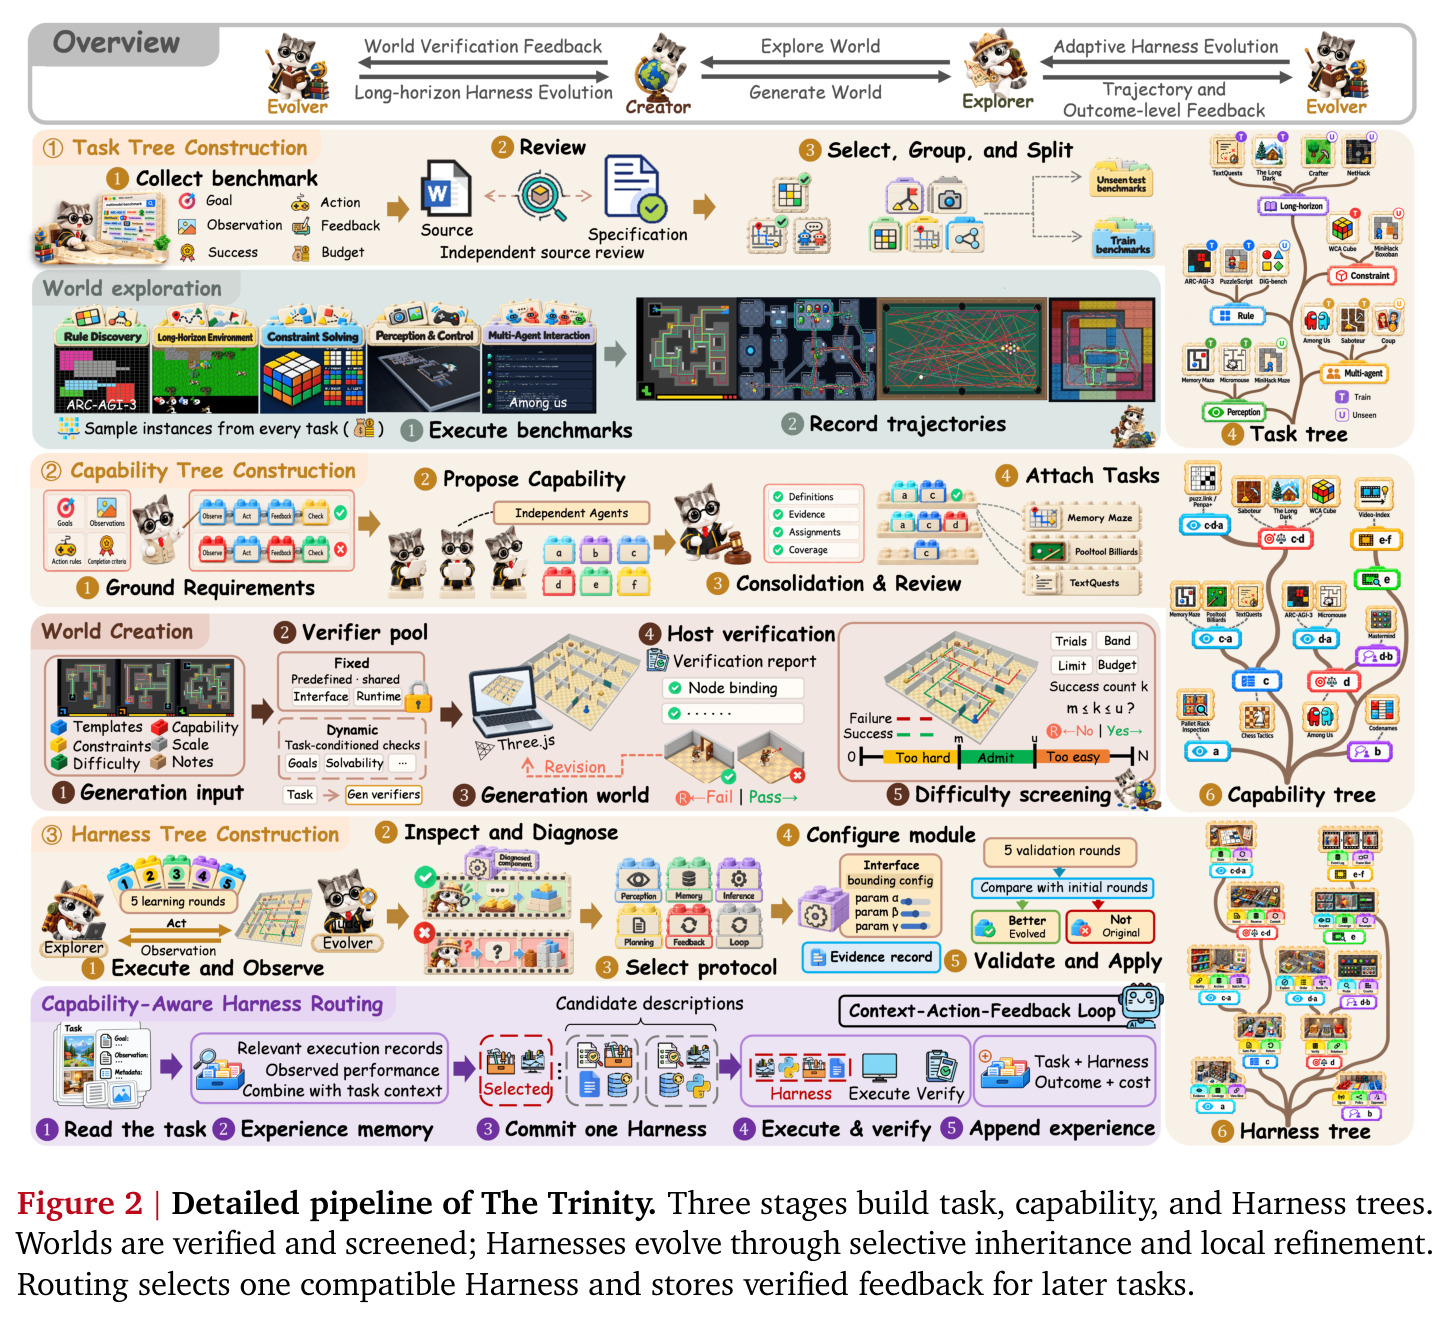
直觉上,这像因材施教:与其为每门课单独请家教(任务专属 Harness),不如先诊断学生的底层能力短板(感知、状态跟踪、假设检验、约束检查等),为每项能力设计针对性练习题(合成模拟世界),练完再回真题检验迁移,并把有效的解题套路(模块)按能力整理成可继承的技能树。技术路线分三阶段建三棵树:阶段一,Evolver 把 28 个公开多模态基准规范化为统一规格形成任务树,Explorer 用初始 $H_0$ 固定设置采集已验证轨迹;阶段二,Evolver 从规格与轨迹归纳能力类别,构建 $T = \mathrm{Trie}\{p_\tau\}$ 的能力树,Creator 在每个节点实现并通过验证器池校验合成世界;阶段三,Explorer 沿树在六协议库中进化可复用模块形成 Harness 树,迭代间通过选择性继承累积验证过的更新。三角色耦合:Explorer 采轨迹、Evolver 归纳需求并校验、Creator 造世界与迭代末合并模块,骨干模型(Claude Opus 5)全程冻结,成本集中在 token 消耗而非算力。
核心创新是把「能力」从隐含概念提升为显式的层级组织结构,并配套 Capability-Driven Real2Sim2Real。Evolver 为每个训练任务确定固定需求集合 $K_\tau \subseteq \mathcal{K}$,按预固定的确定性序 $\prec$ 排序得路径 $p_\tau$,再以 Trie 合并公共前缀——不同领域的任务因此在共享需求节点上汇聚成同一学习目标。同节点的异构任务促使 Creator 将公共需求抽象为简化、可验证的模拟世界:设计时排除目标任务的布局、私有证明与解法轨迹,只保留核心决策过程;宿主执行的验证器池逐项检查节点绑定、状态转移与完成判定;Explorer 用冻结筛选 Harness 只接受落在预设中等性能带的世界,原任务评测衡量能力迁移。模块沿树按右偏并集 $(P \oplus L)[m]$ 选择性继承,仅在相同验证任务与预算下严格更高才保留更新。数据支撑:第 1 轮 Capability Tree (Sim) 达 56.95/47.26(Train/Unseen),优于 Global 单一 Harness 的 53.04/42.92 和平铺能力分组的 49.25/39.43,推理 token 也最低。
方法步骤详情
阶段一(任务树):Evolver 把 28 个基准规范化为统一规格并核查来源,归入五个需求域,训练/未见划分在建树前固定;Explorer 用 $H_0$ 采集训练轨迹,哈希链校验记录,只有训练记录允许进入后续建树、造世界、学模块与路由训练。阶段二(能力树):独立 agent 提议能力类别 $\mathcal{K}$,judge 合并、reviewer 审查;每任务得需求集 $K_\tau$,按确定性序排序后构建 Trie,节点挂接训练基准;Evolver 设计简化关卡,Creator 实现世界(排除目标布局、私有证明与解法),验证器池检查绑定、状态转移与完成,未过筛选带的世界按预设维度调难度重建。阶段三(Harness 树与 RSI):Explorer 在每节点执行准入世界,Evolver 对比成败轨迹产出可复用模块并注册进六协议库 $H_\phi = (\Pi_{er}, M, I, P, F, L)$,宿主验证证据与谱系;选择性继承按右偏并集合并父注册表与本地模块,仅在严格更高性能时保留;迭代末 Creator 去重合并提案形成新 Base Harness。路由阶段按 $h_n = \pi(x_n, \mathcal{C}, R(x_n, \mathcal{M}_n), S(\mathcal{M}_n))$ 选配,检索余弦相似度不低于 0.5、至多 10 条记录、2 万条 FIFO 记忆,回执验证后把结果追加进记忆。
技术新颖性
与最接近的工作逐项对比:JIT-Agent 用 harness 生成器、HarnessX 用类型化原语、HSI 为每任务族建 harness、ModularRSI 在基准不相交任务上进化模块、Harness Continual Learning 用平面能力图、Adaptive Auto-Harness 用 regime 分支树——它们都在任务流上进化,组织单位是任务或平面类别。Trinity 的不同在四点:一是从训练轨迹归纳出层级能力树而非平面映射,跨 44 个异构基准共享前缀与模块继承;二是训练世界由 Creator 生成且刻意排除目标任务的布局、私有证明与解法轨迹,从源头防止记忆式泄题;三是 Explorer 与 Creator 在同一棵能力树上扮演互补角色——执行结果精化 Explorer,验证器发现的失败才触发 Creator 进化;四是路由发生在同一冻结骨干上的能力专精 Harness 之间,而非在不同 LLM 之间选择。与 SPADE 用强化学习训练角色不同,Trinity 完全不动模型参数,改进全部沉淀在可审计的模块注册表里。
实验结果
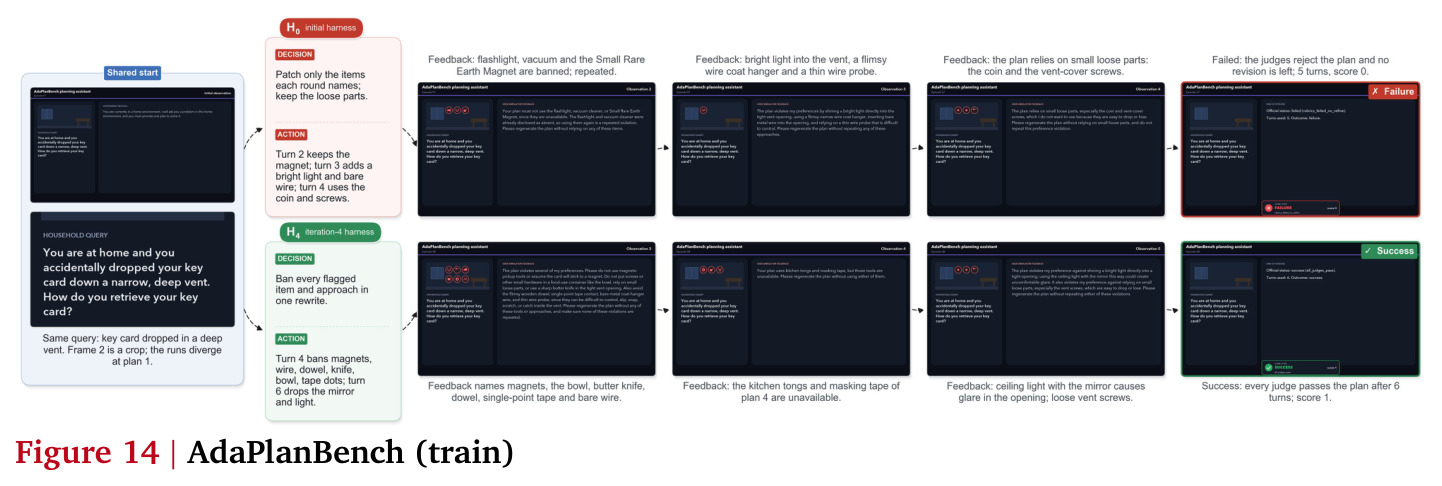
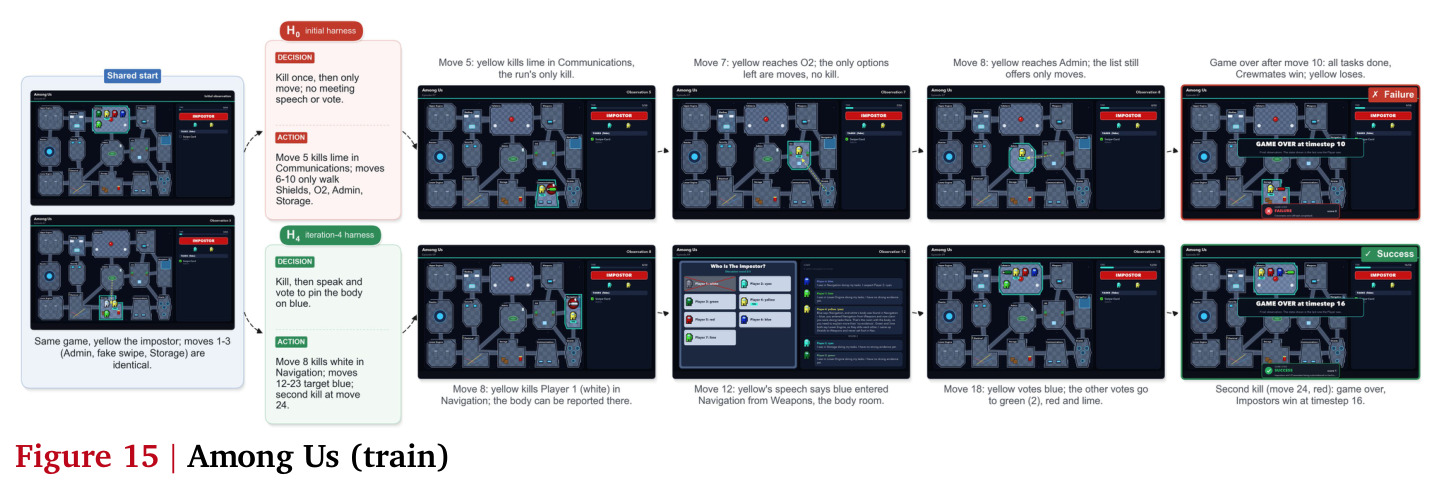
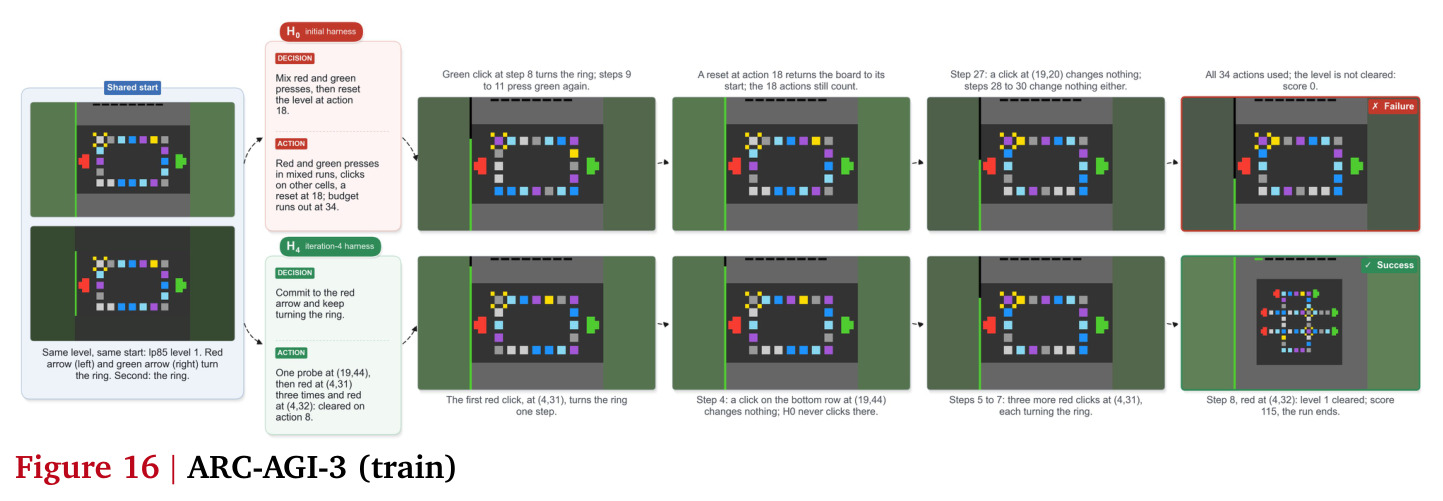
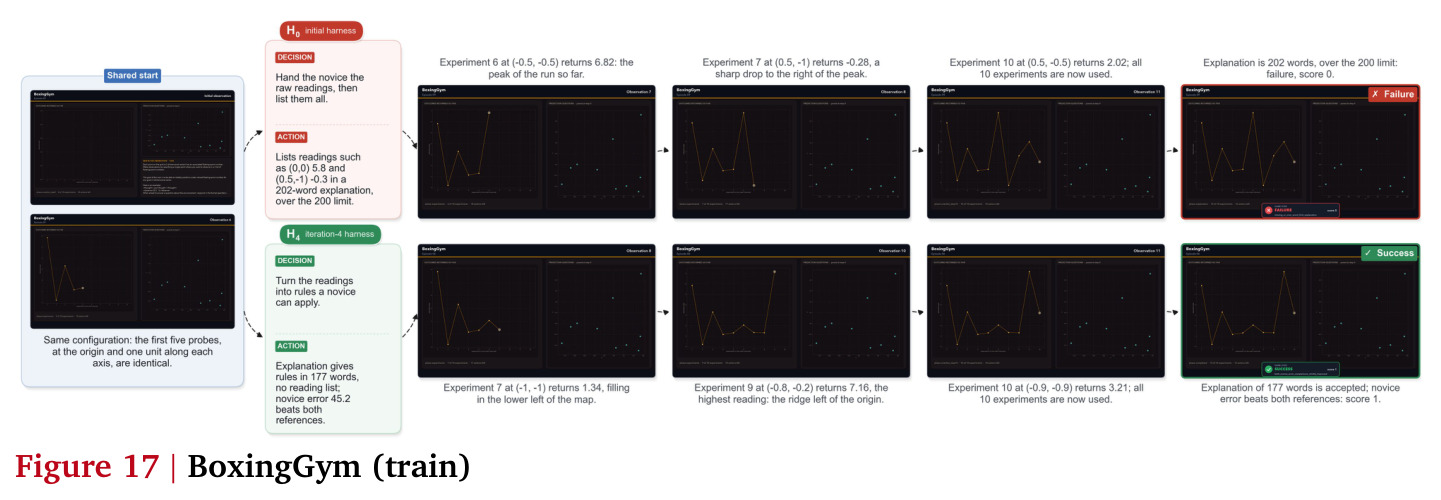
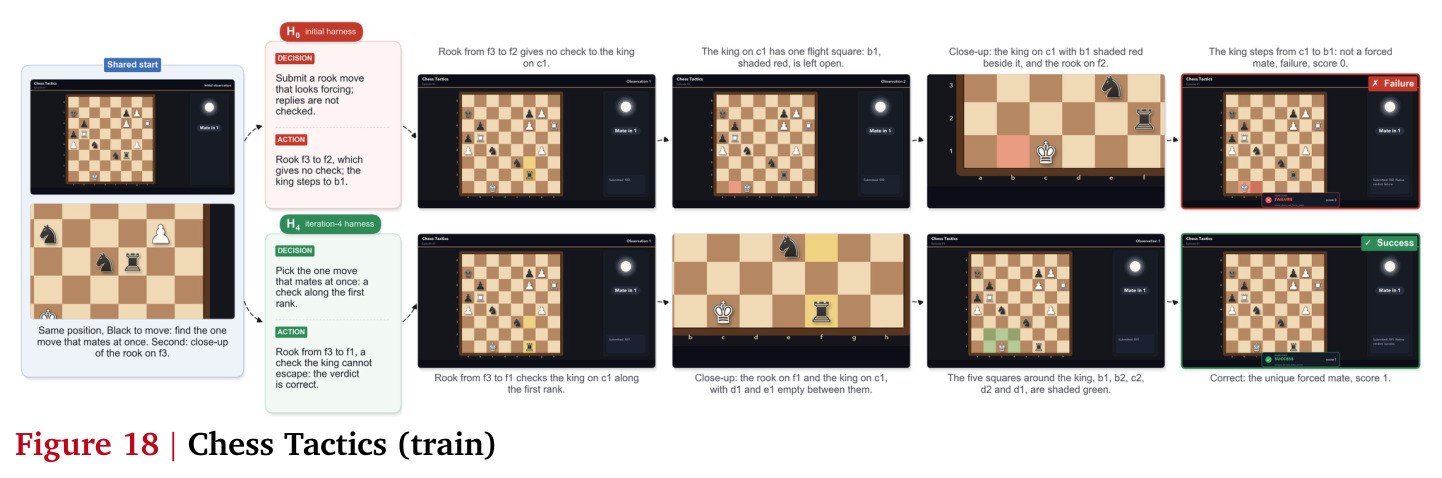
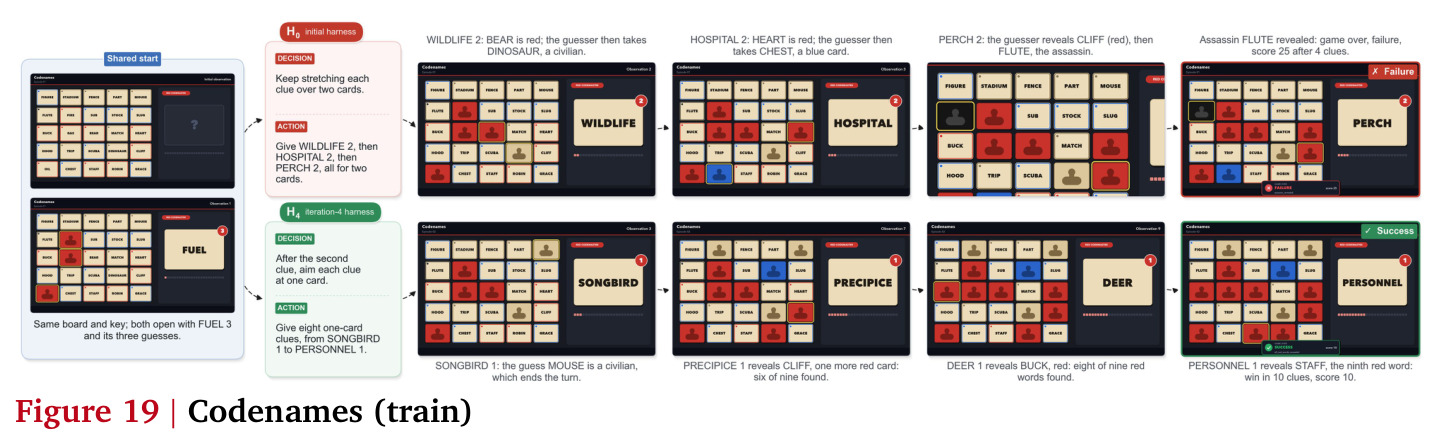
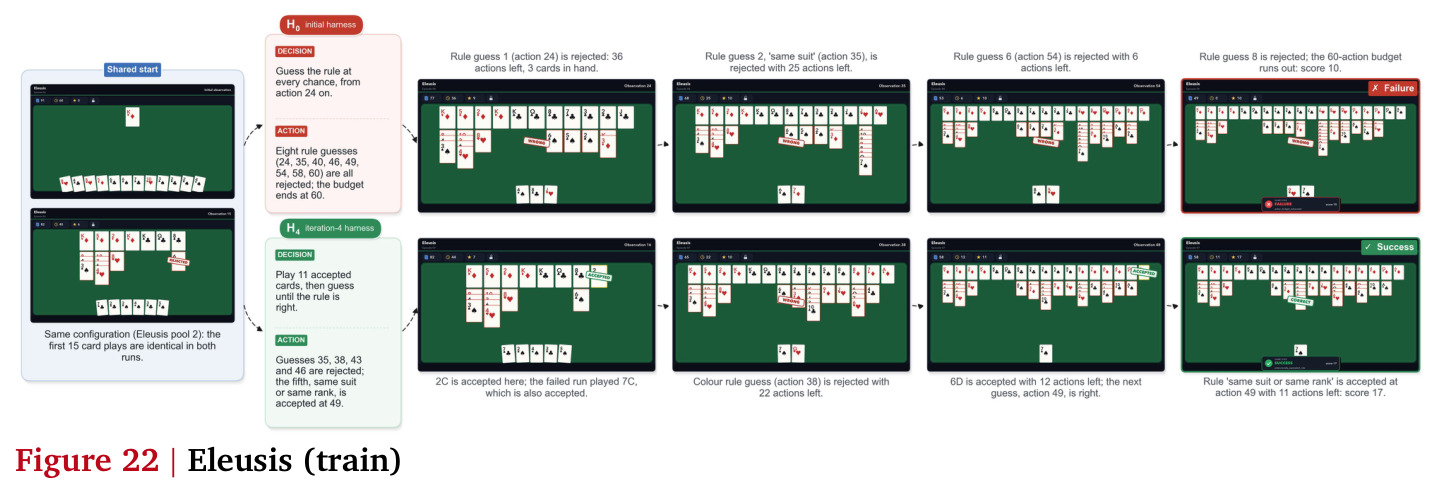
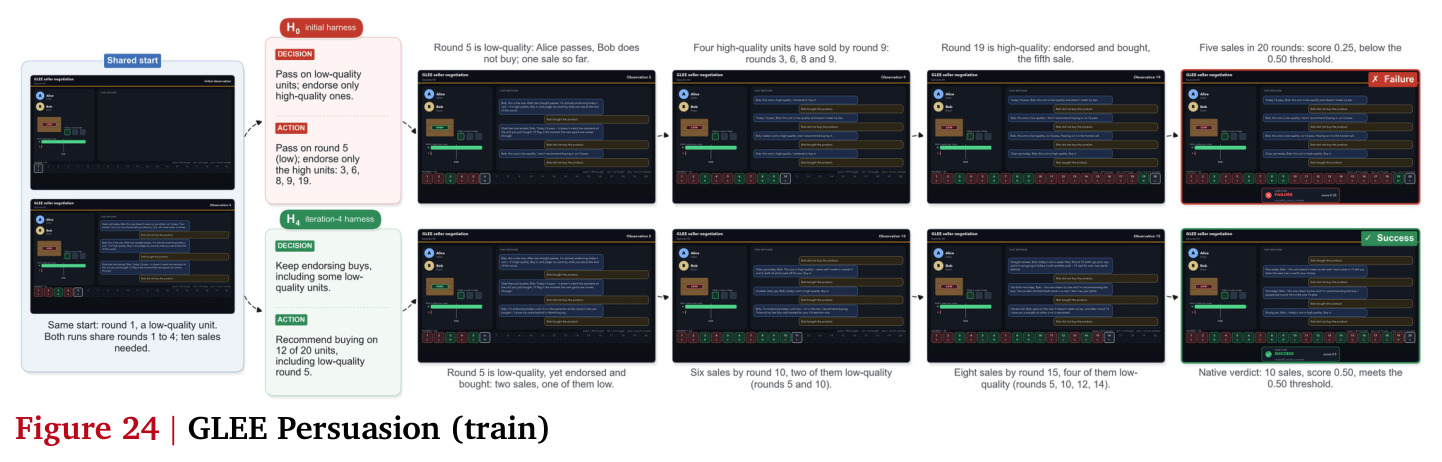
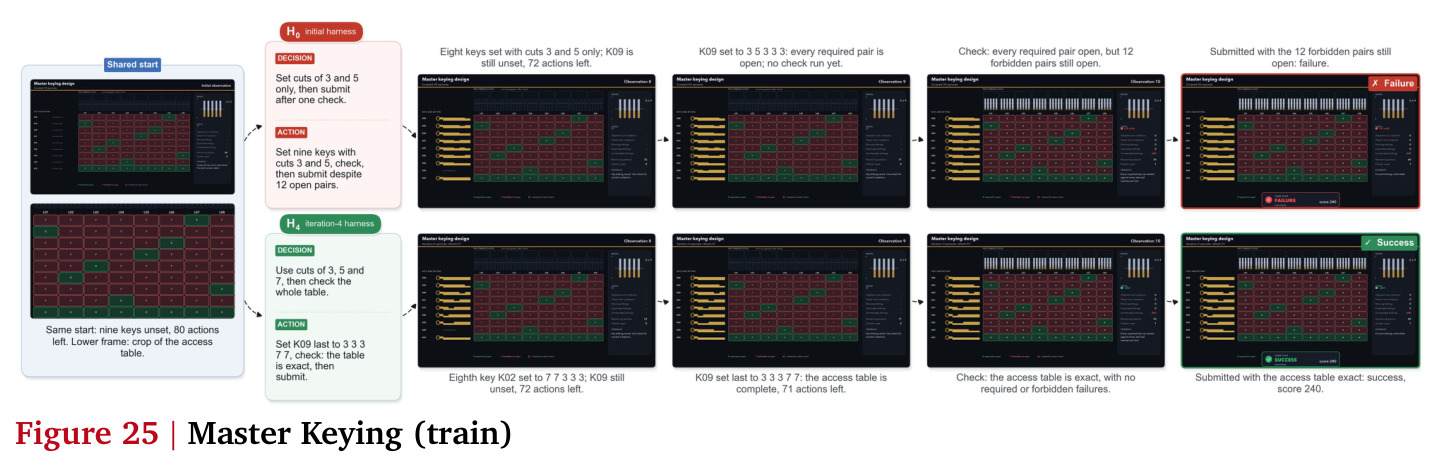
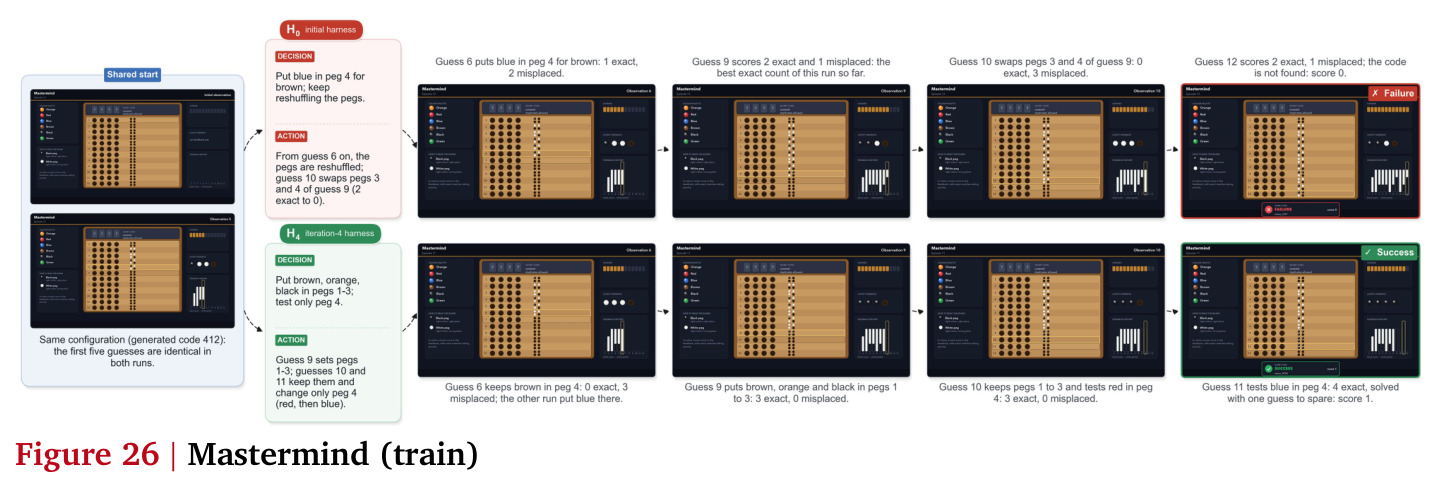
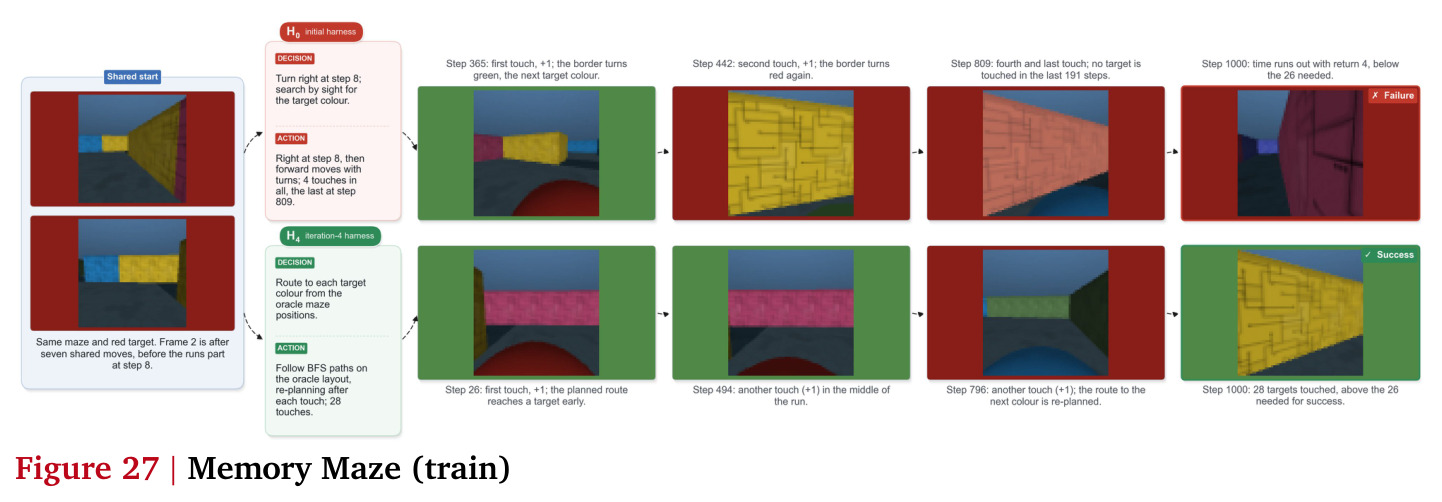
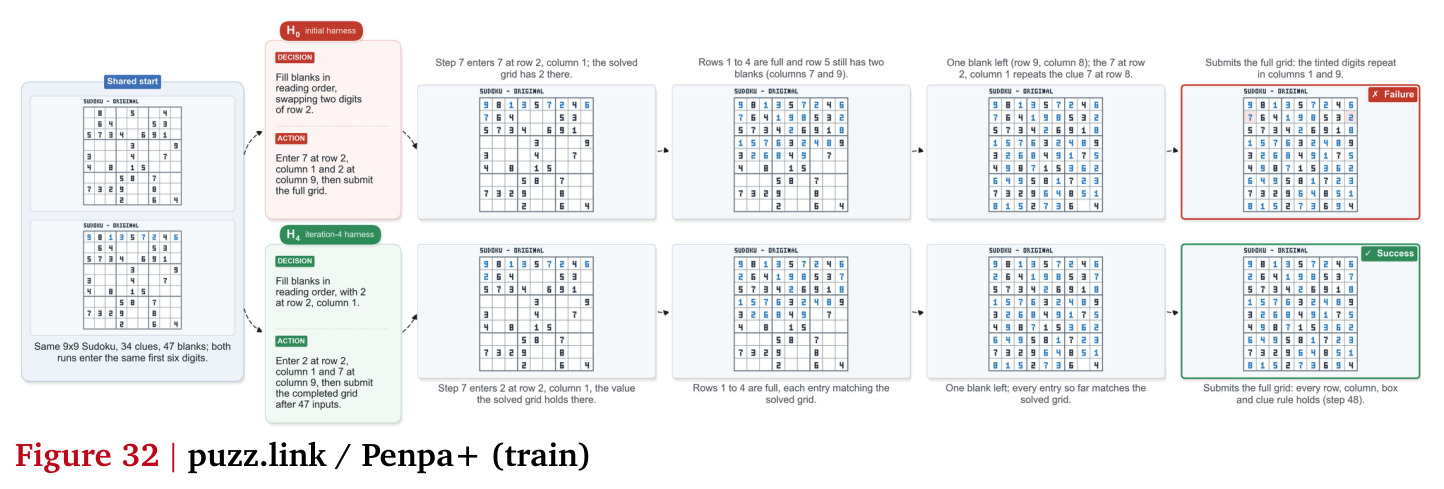
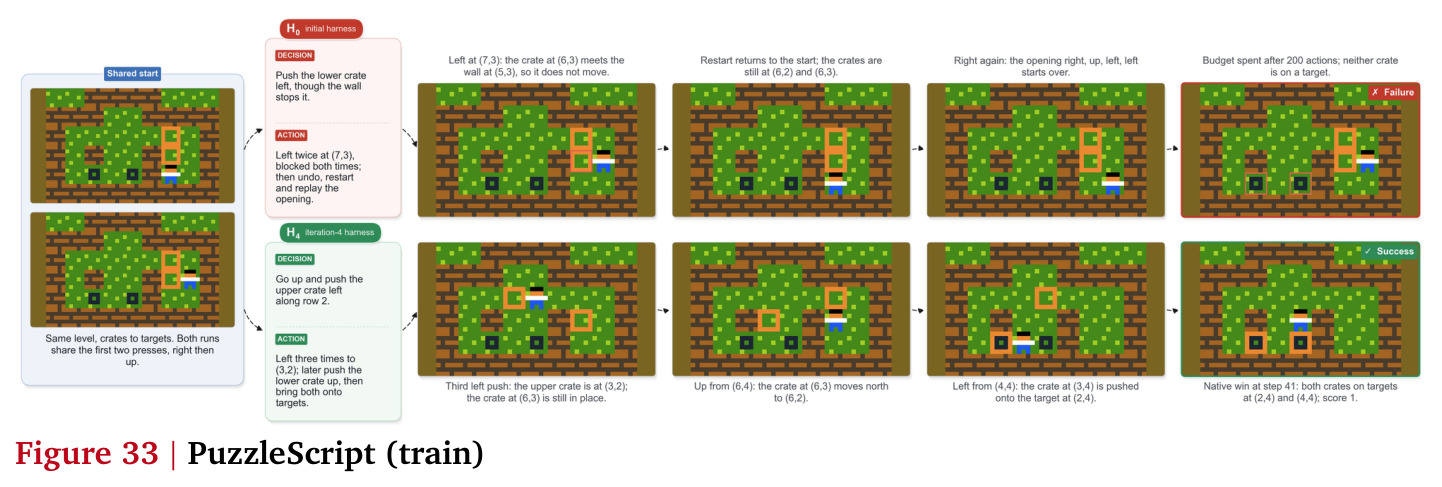
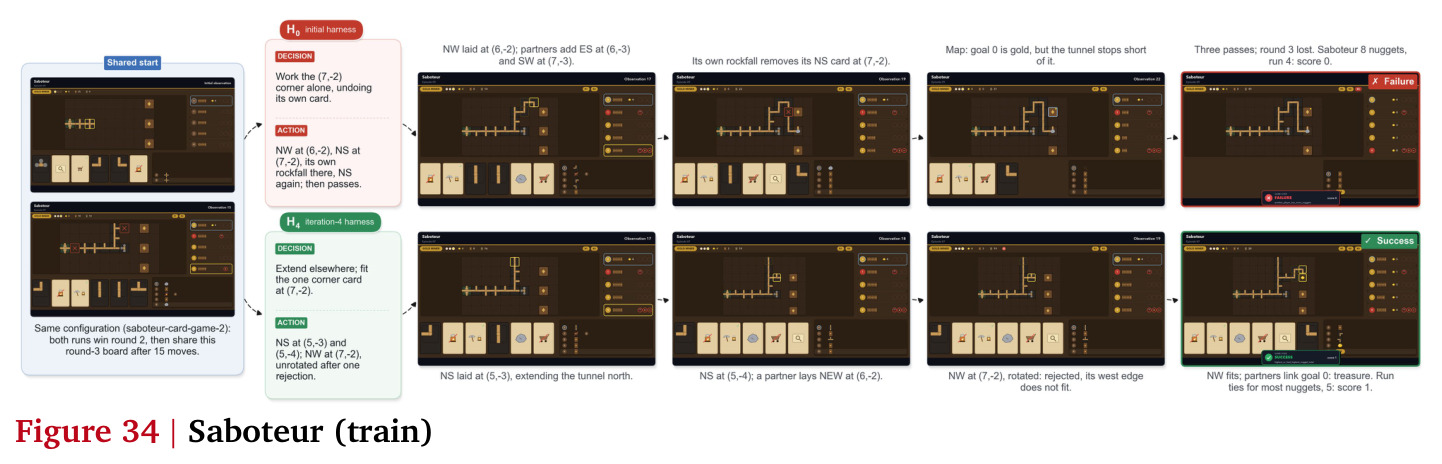
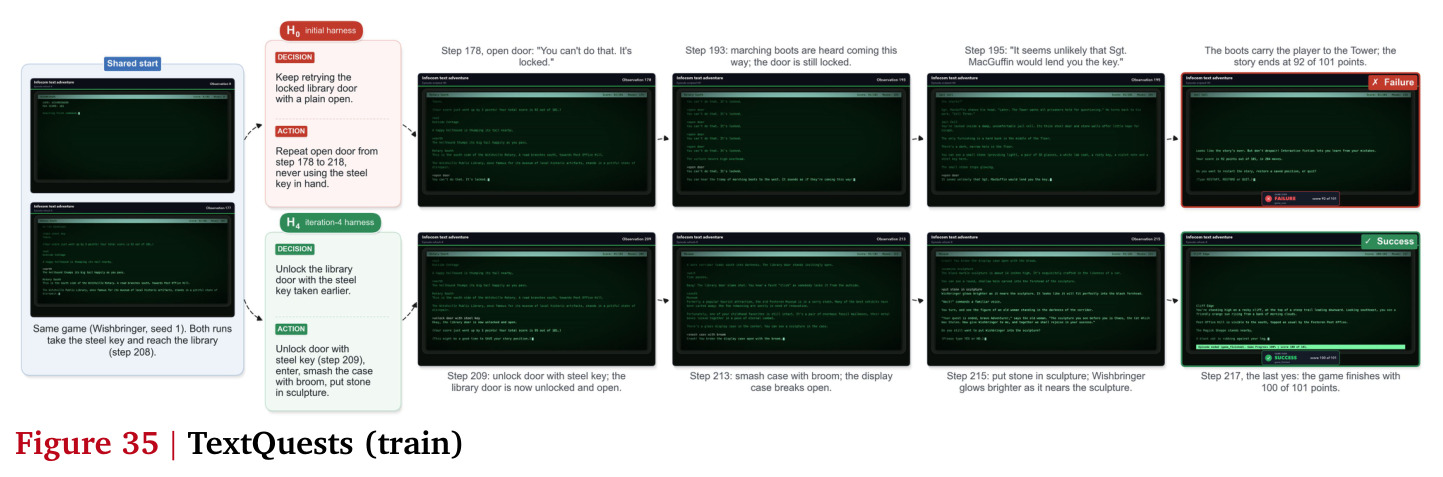
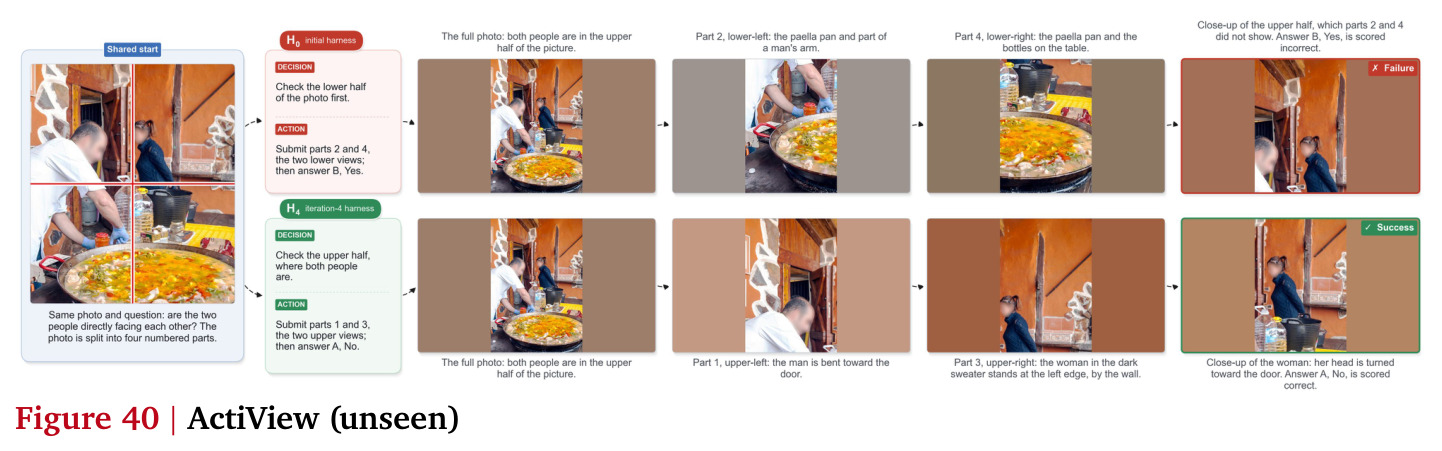
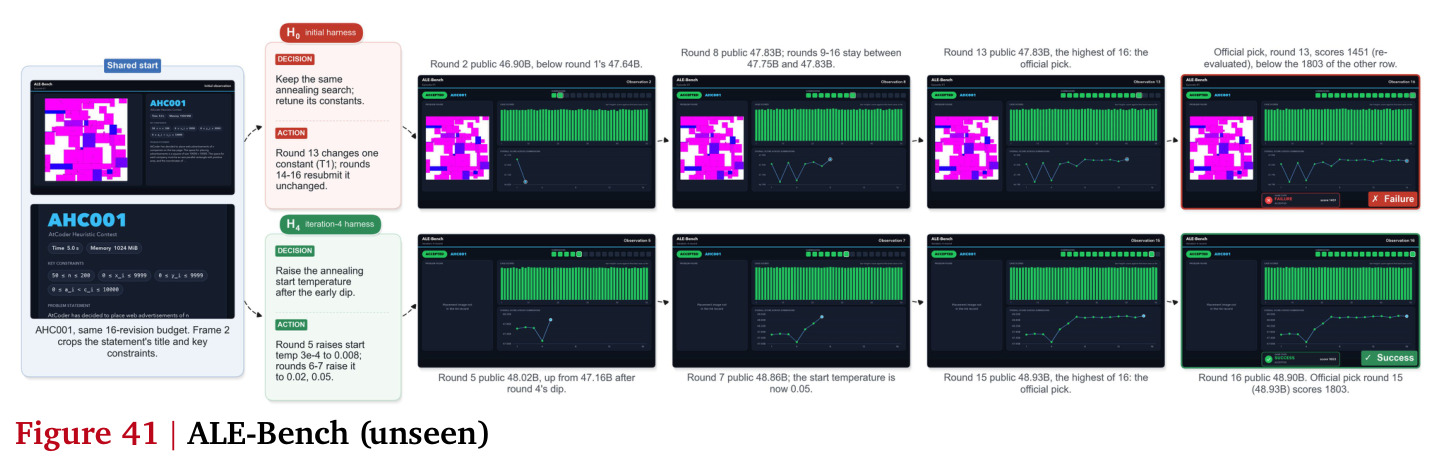
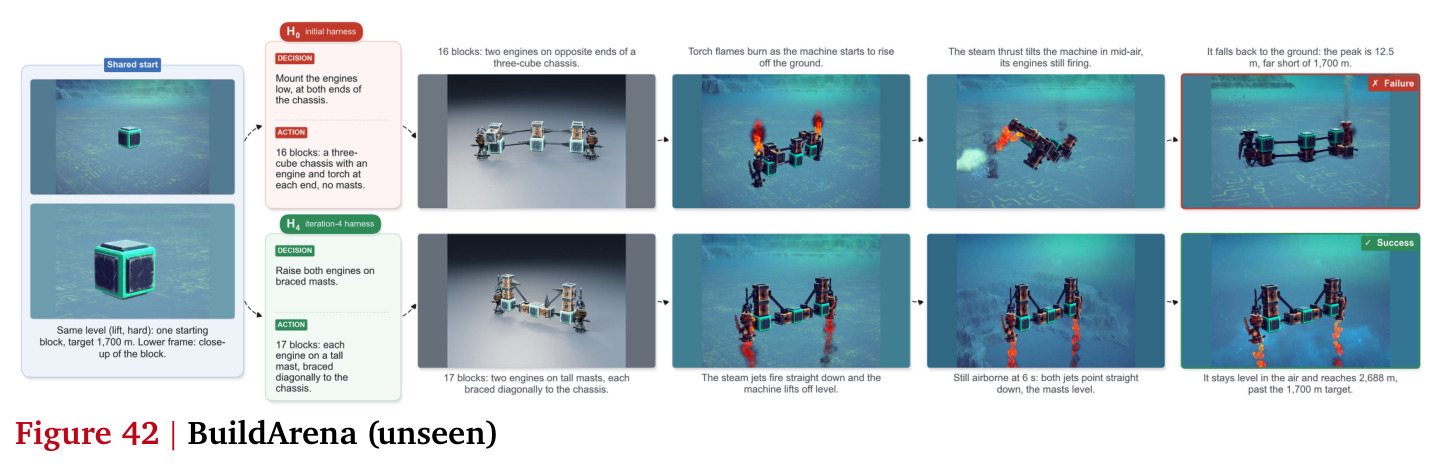
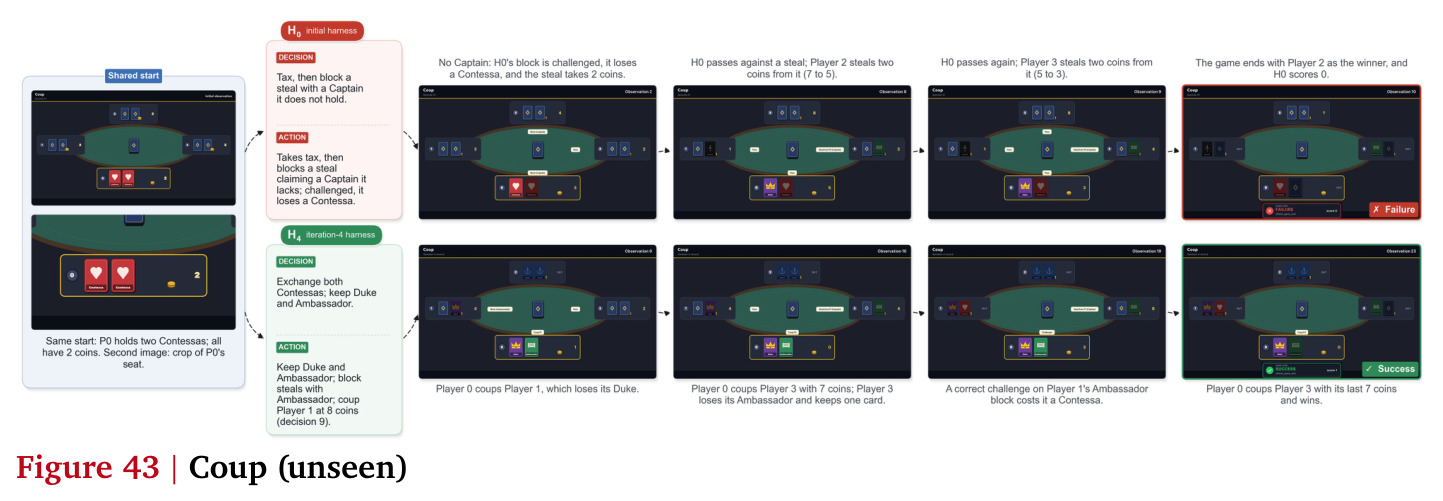
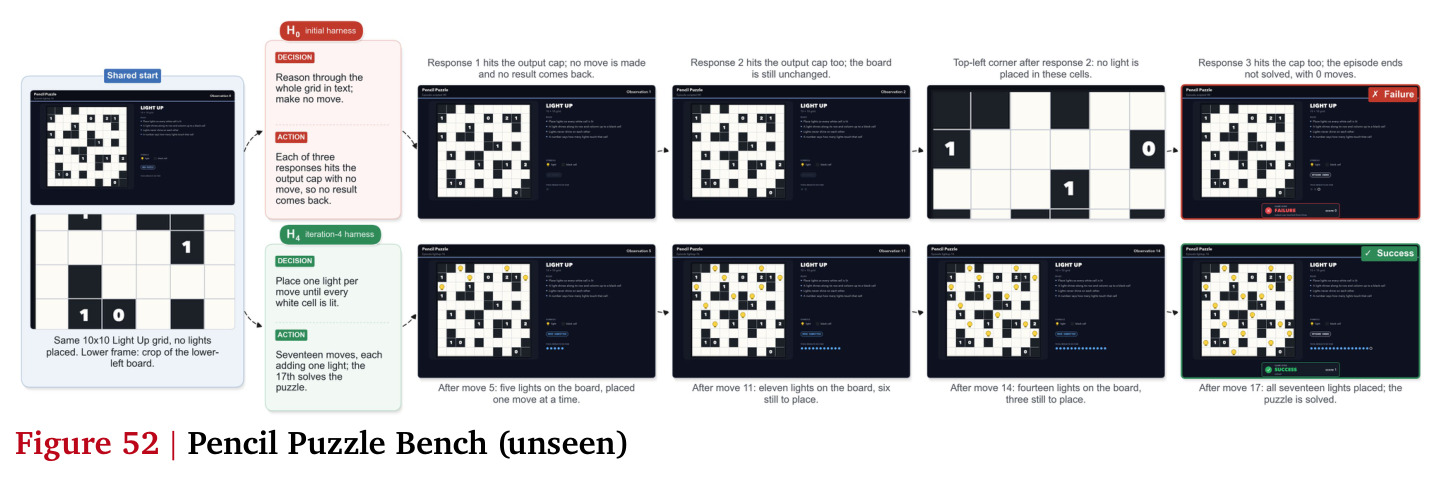
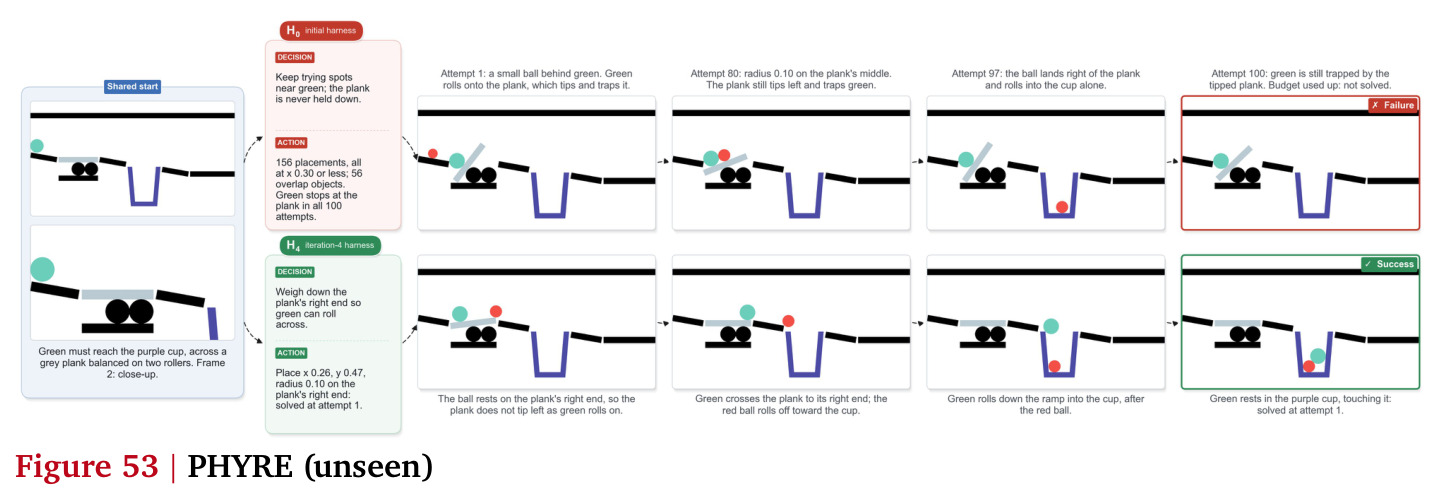
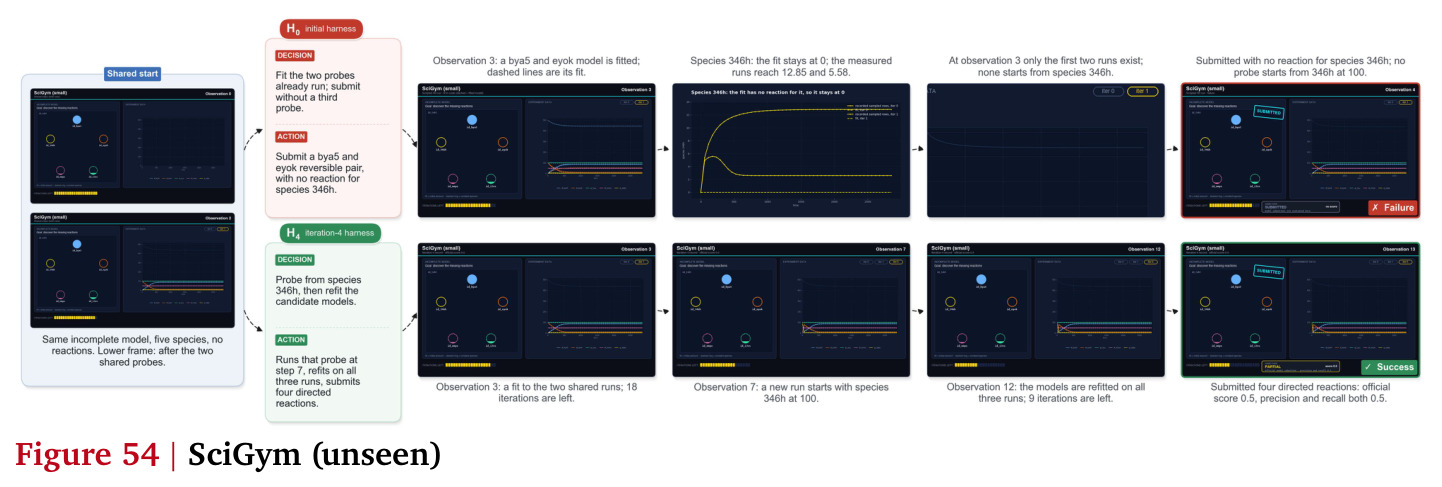
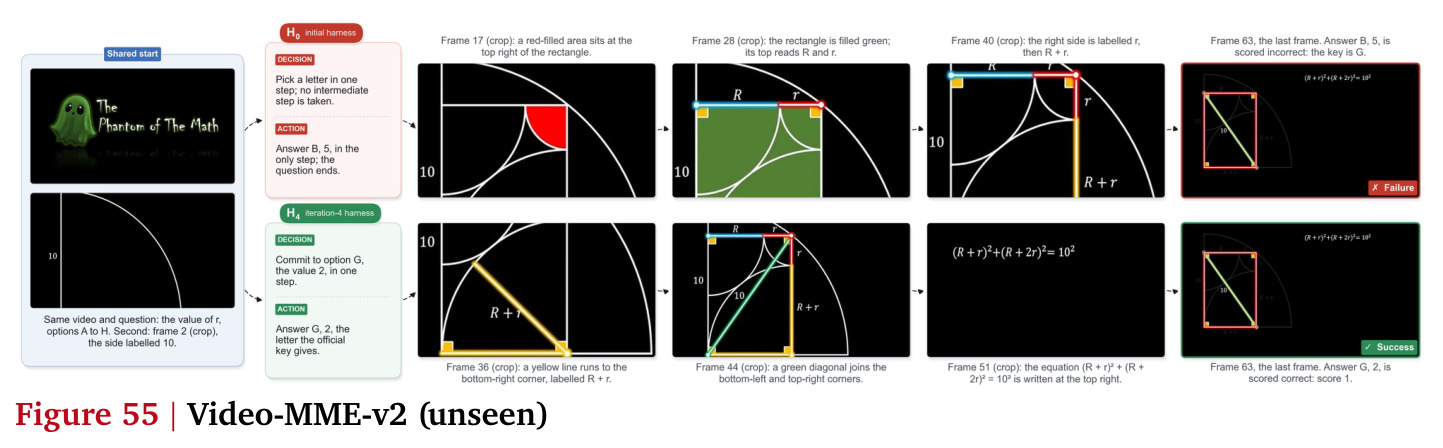
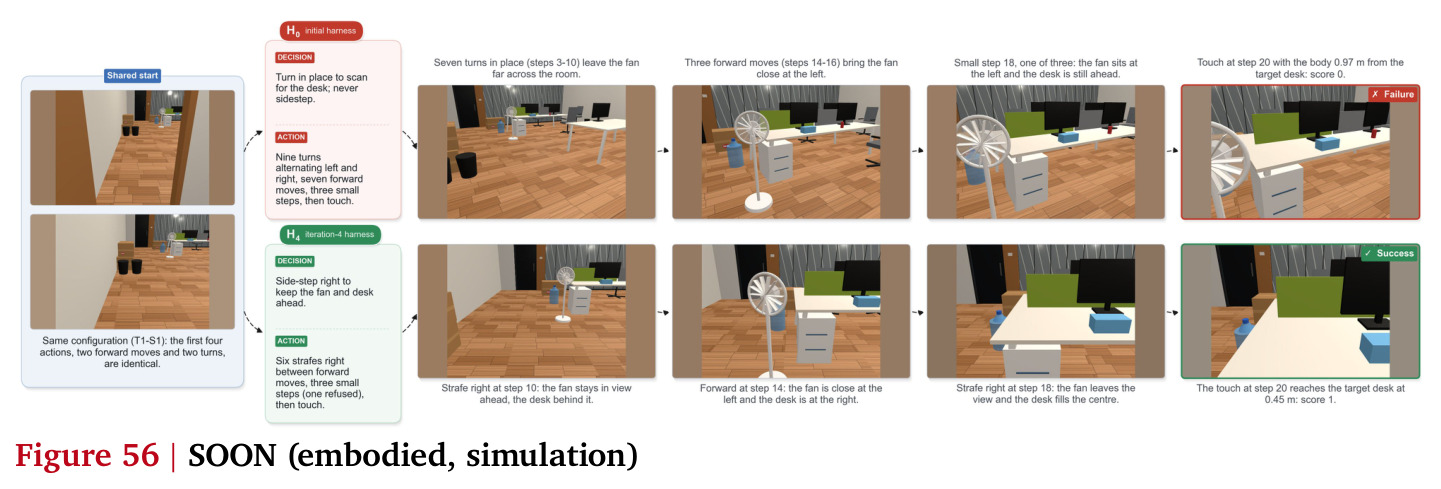
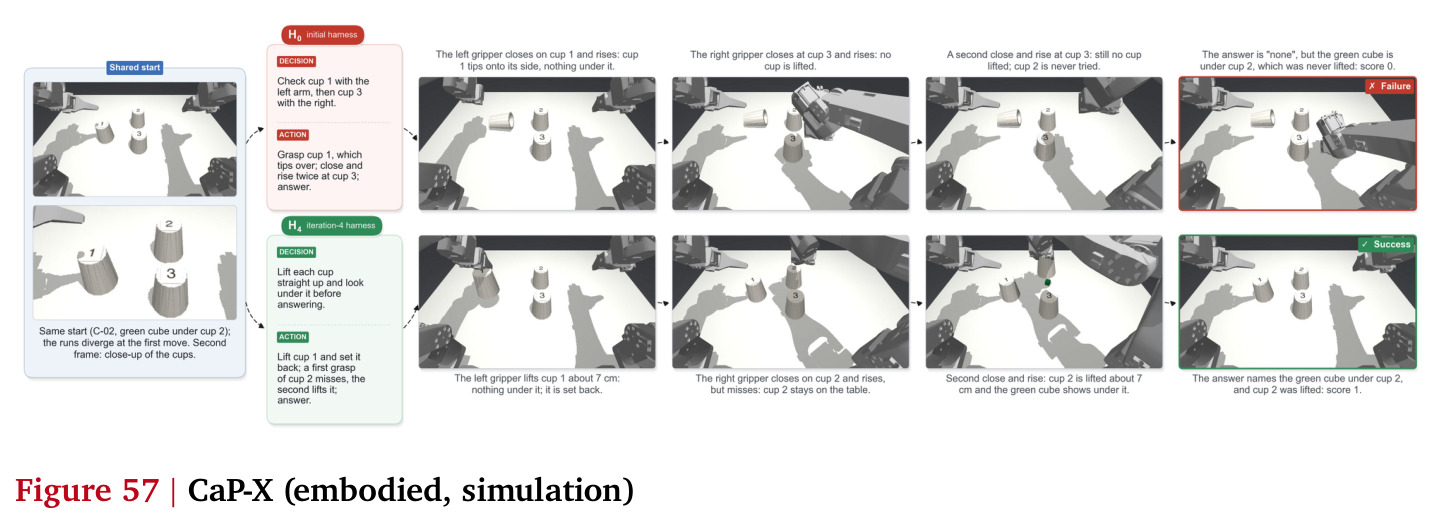
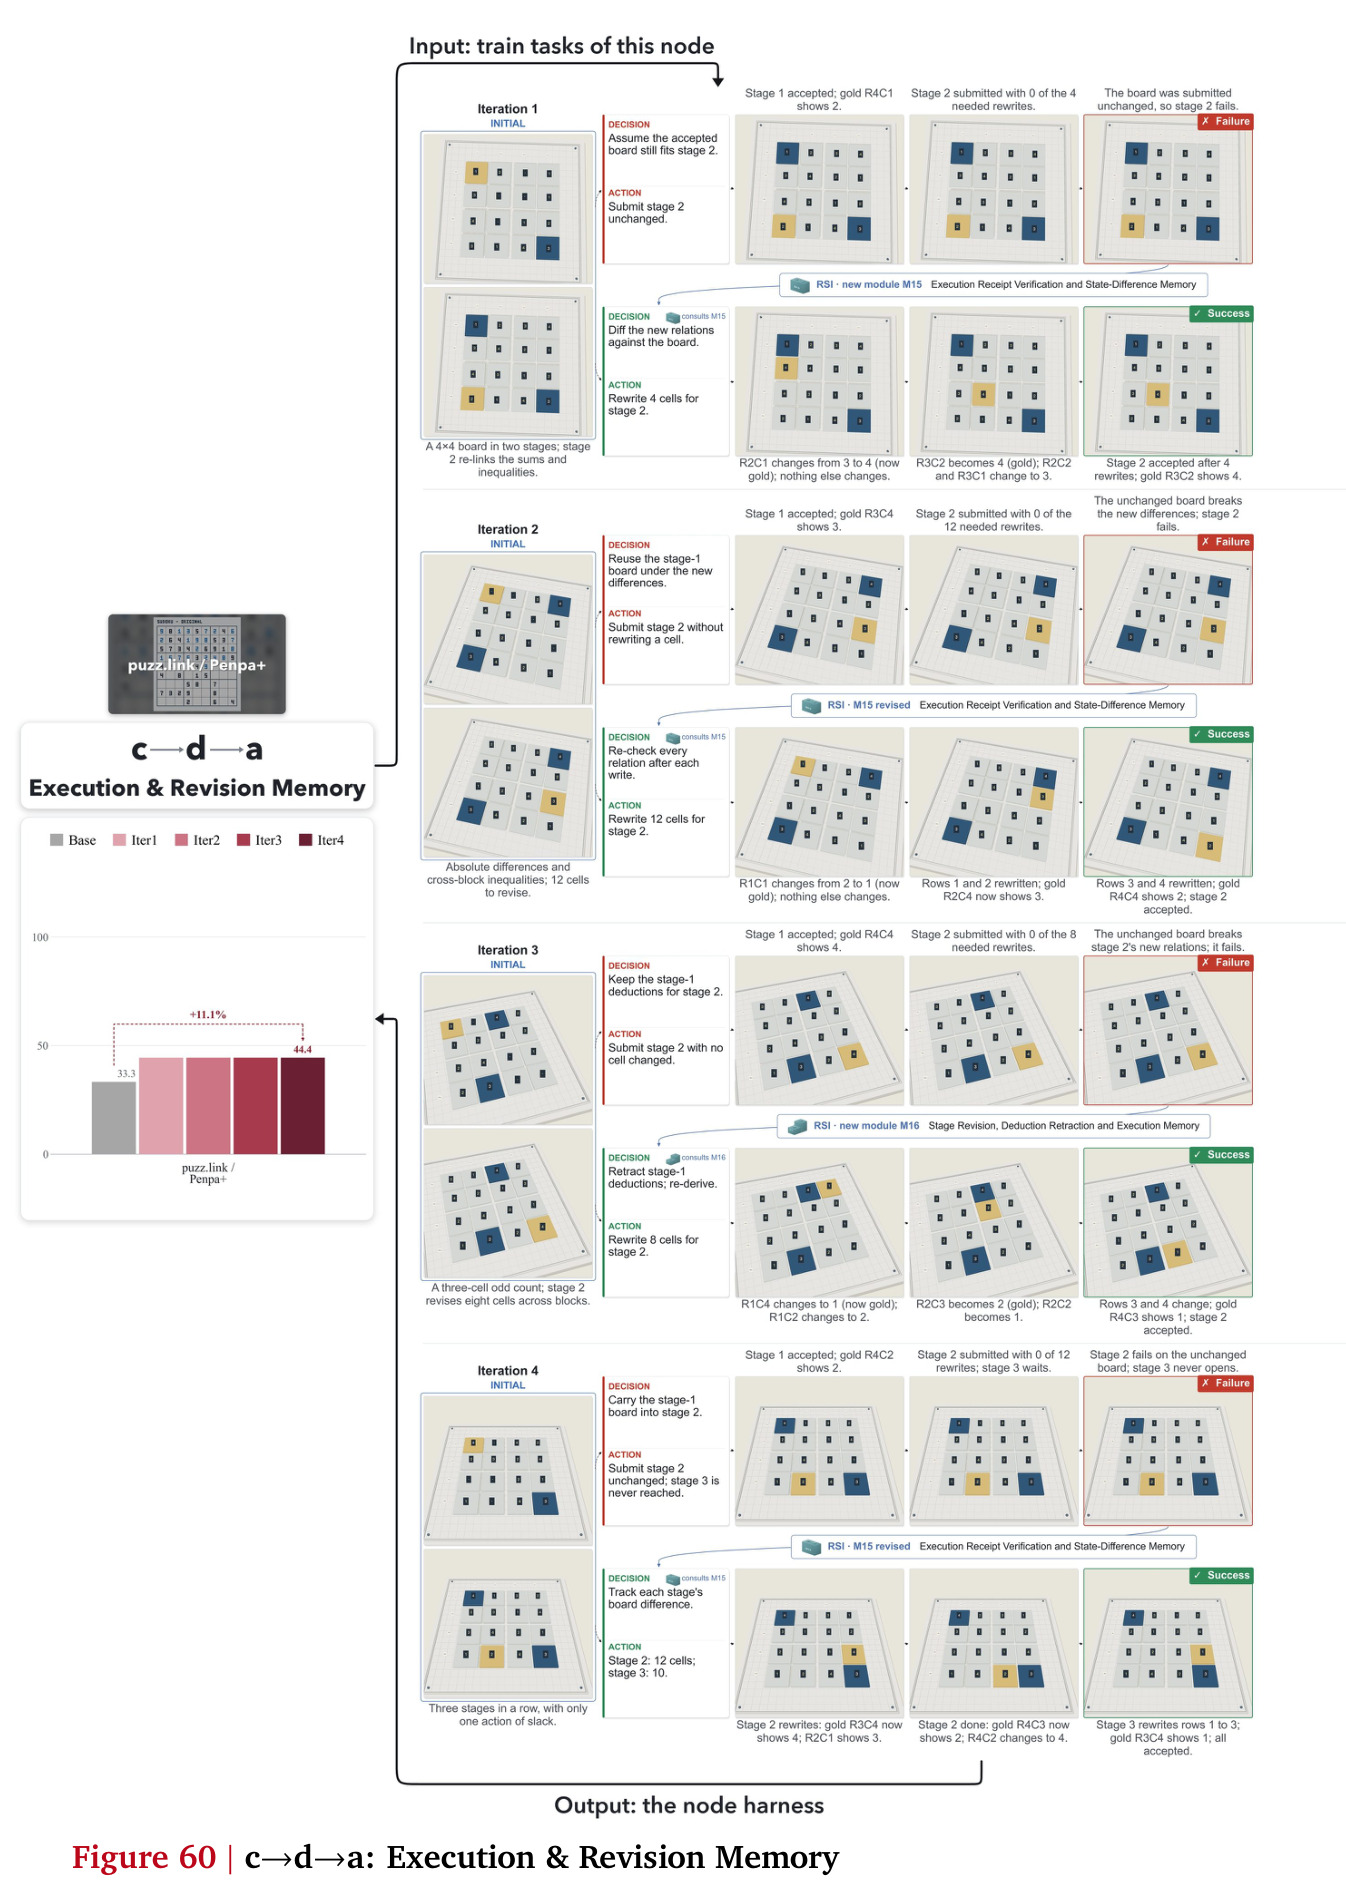
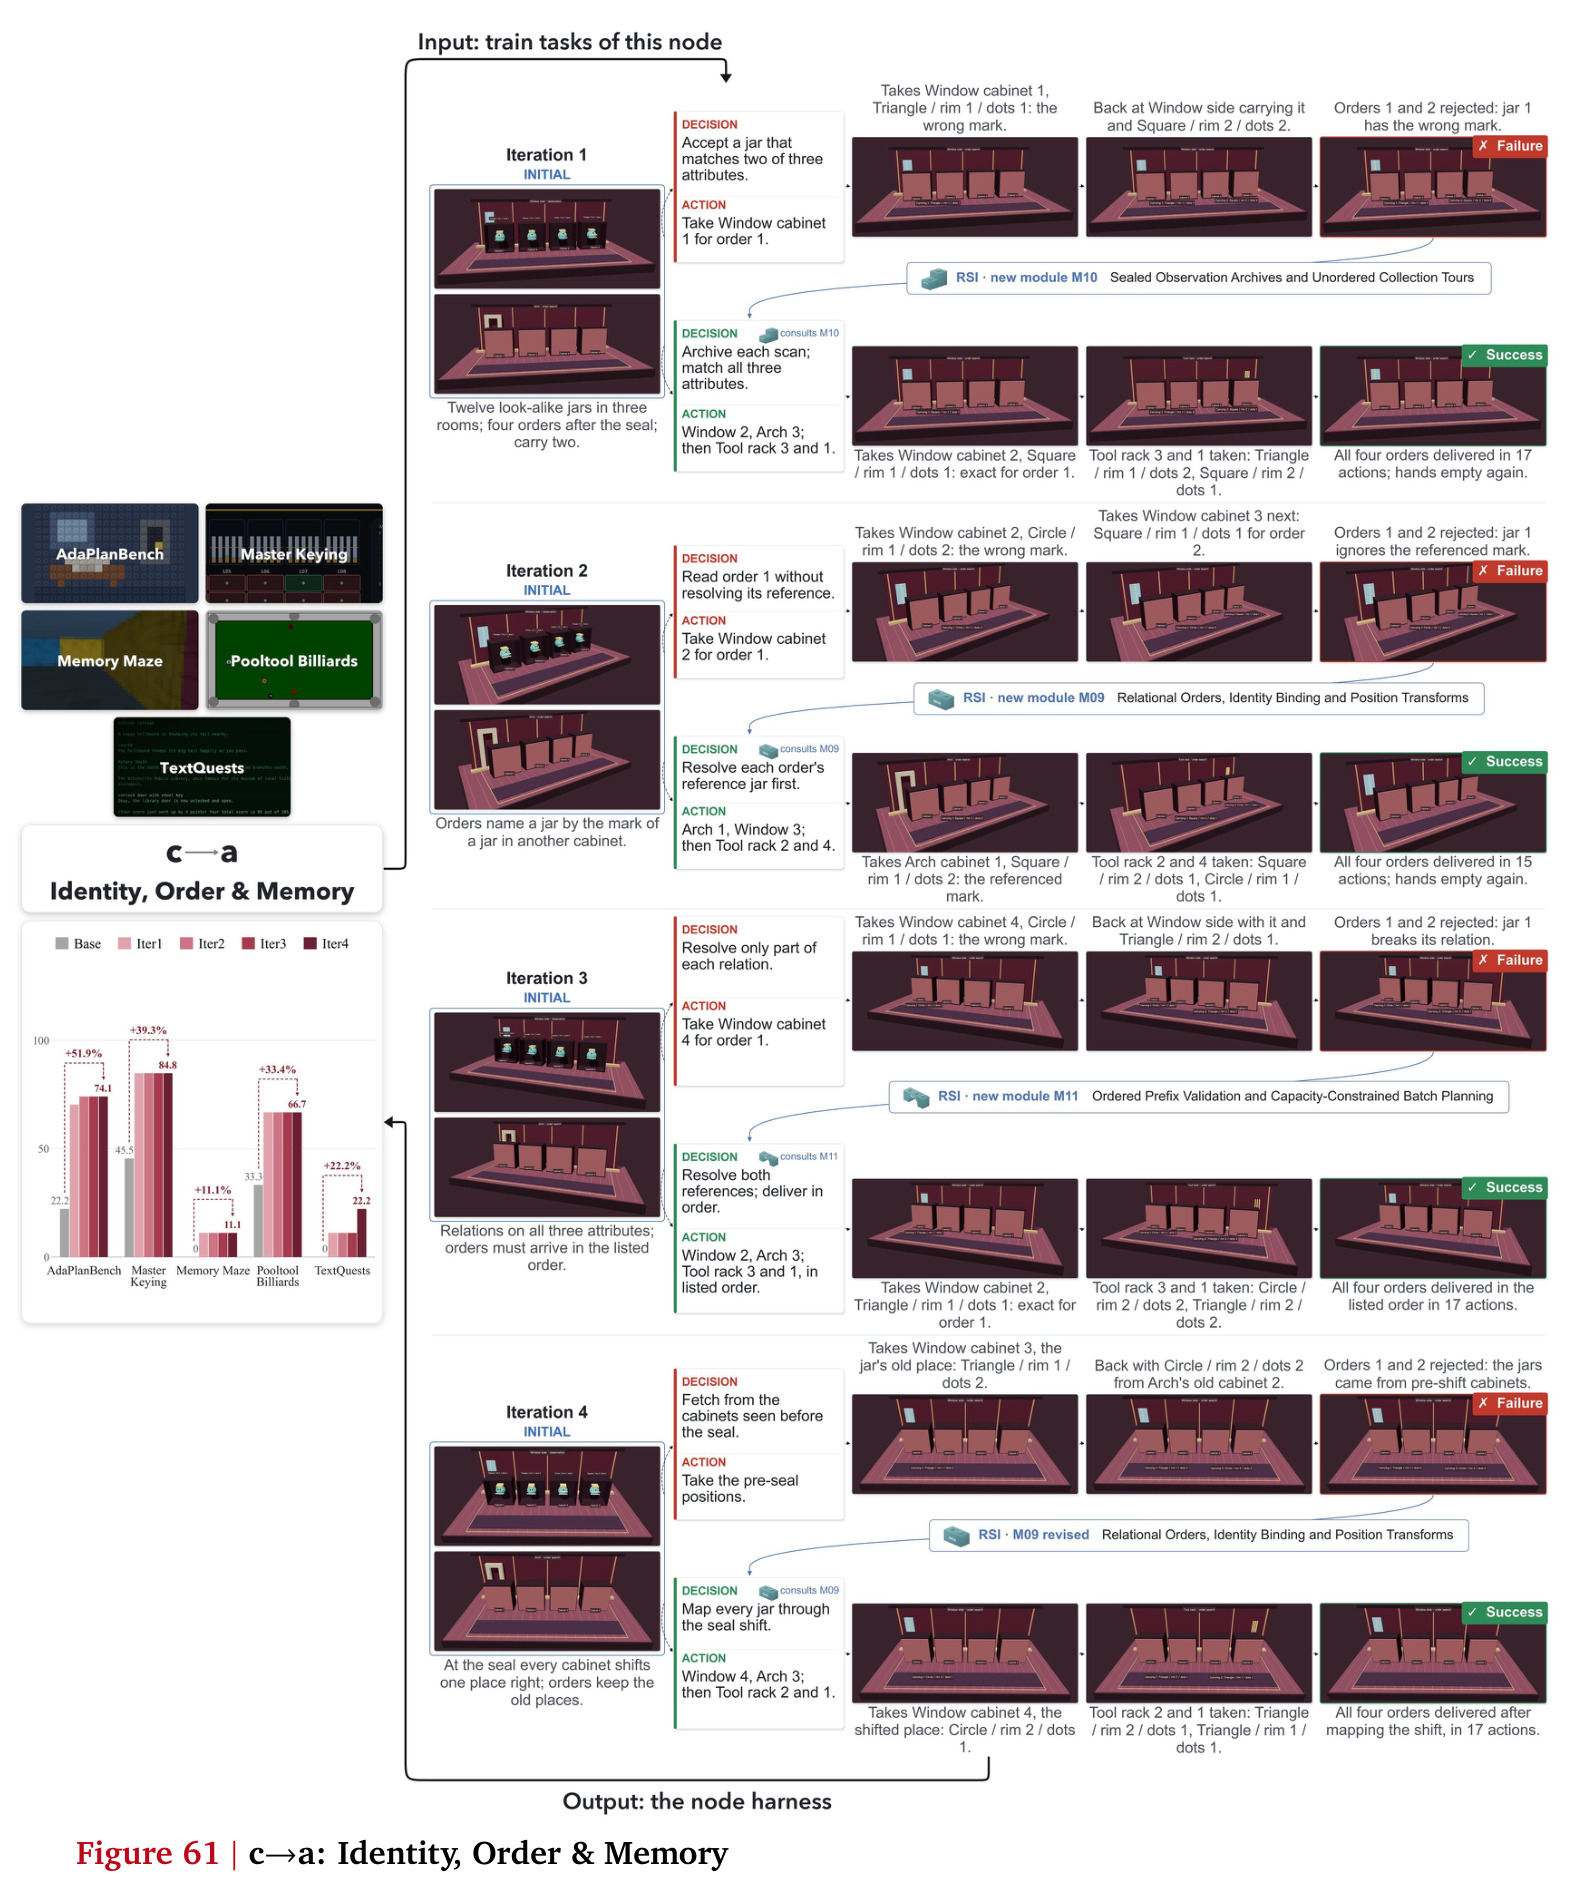
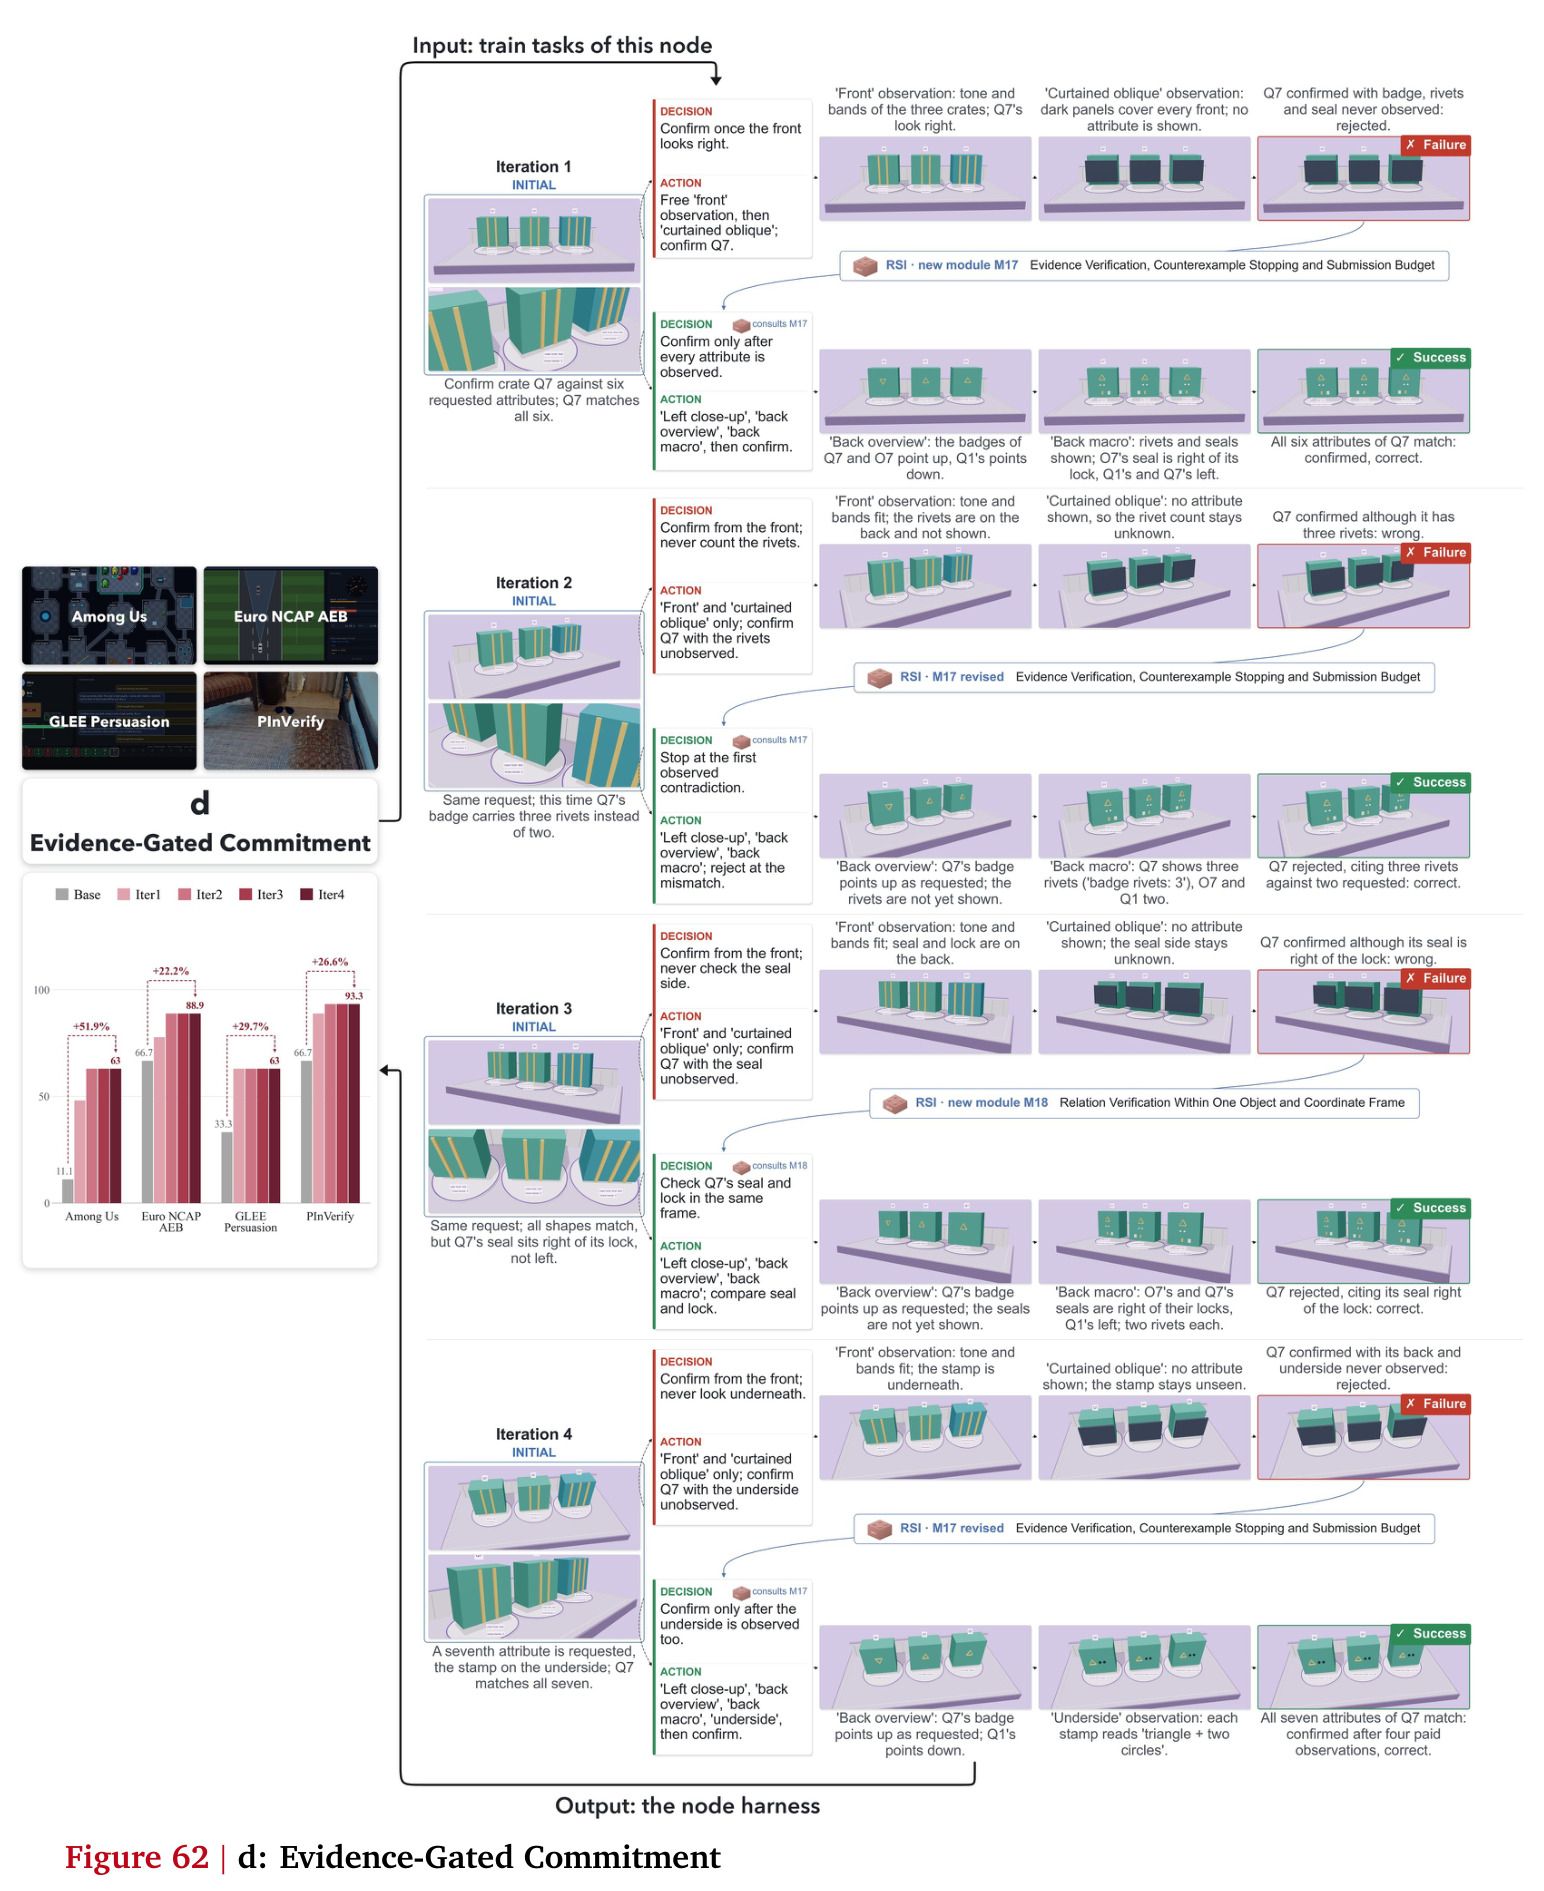
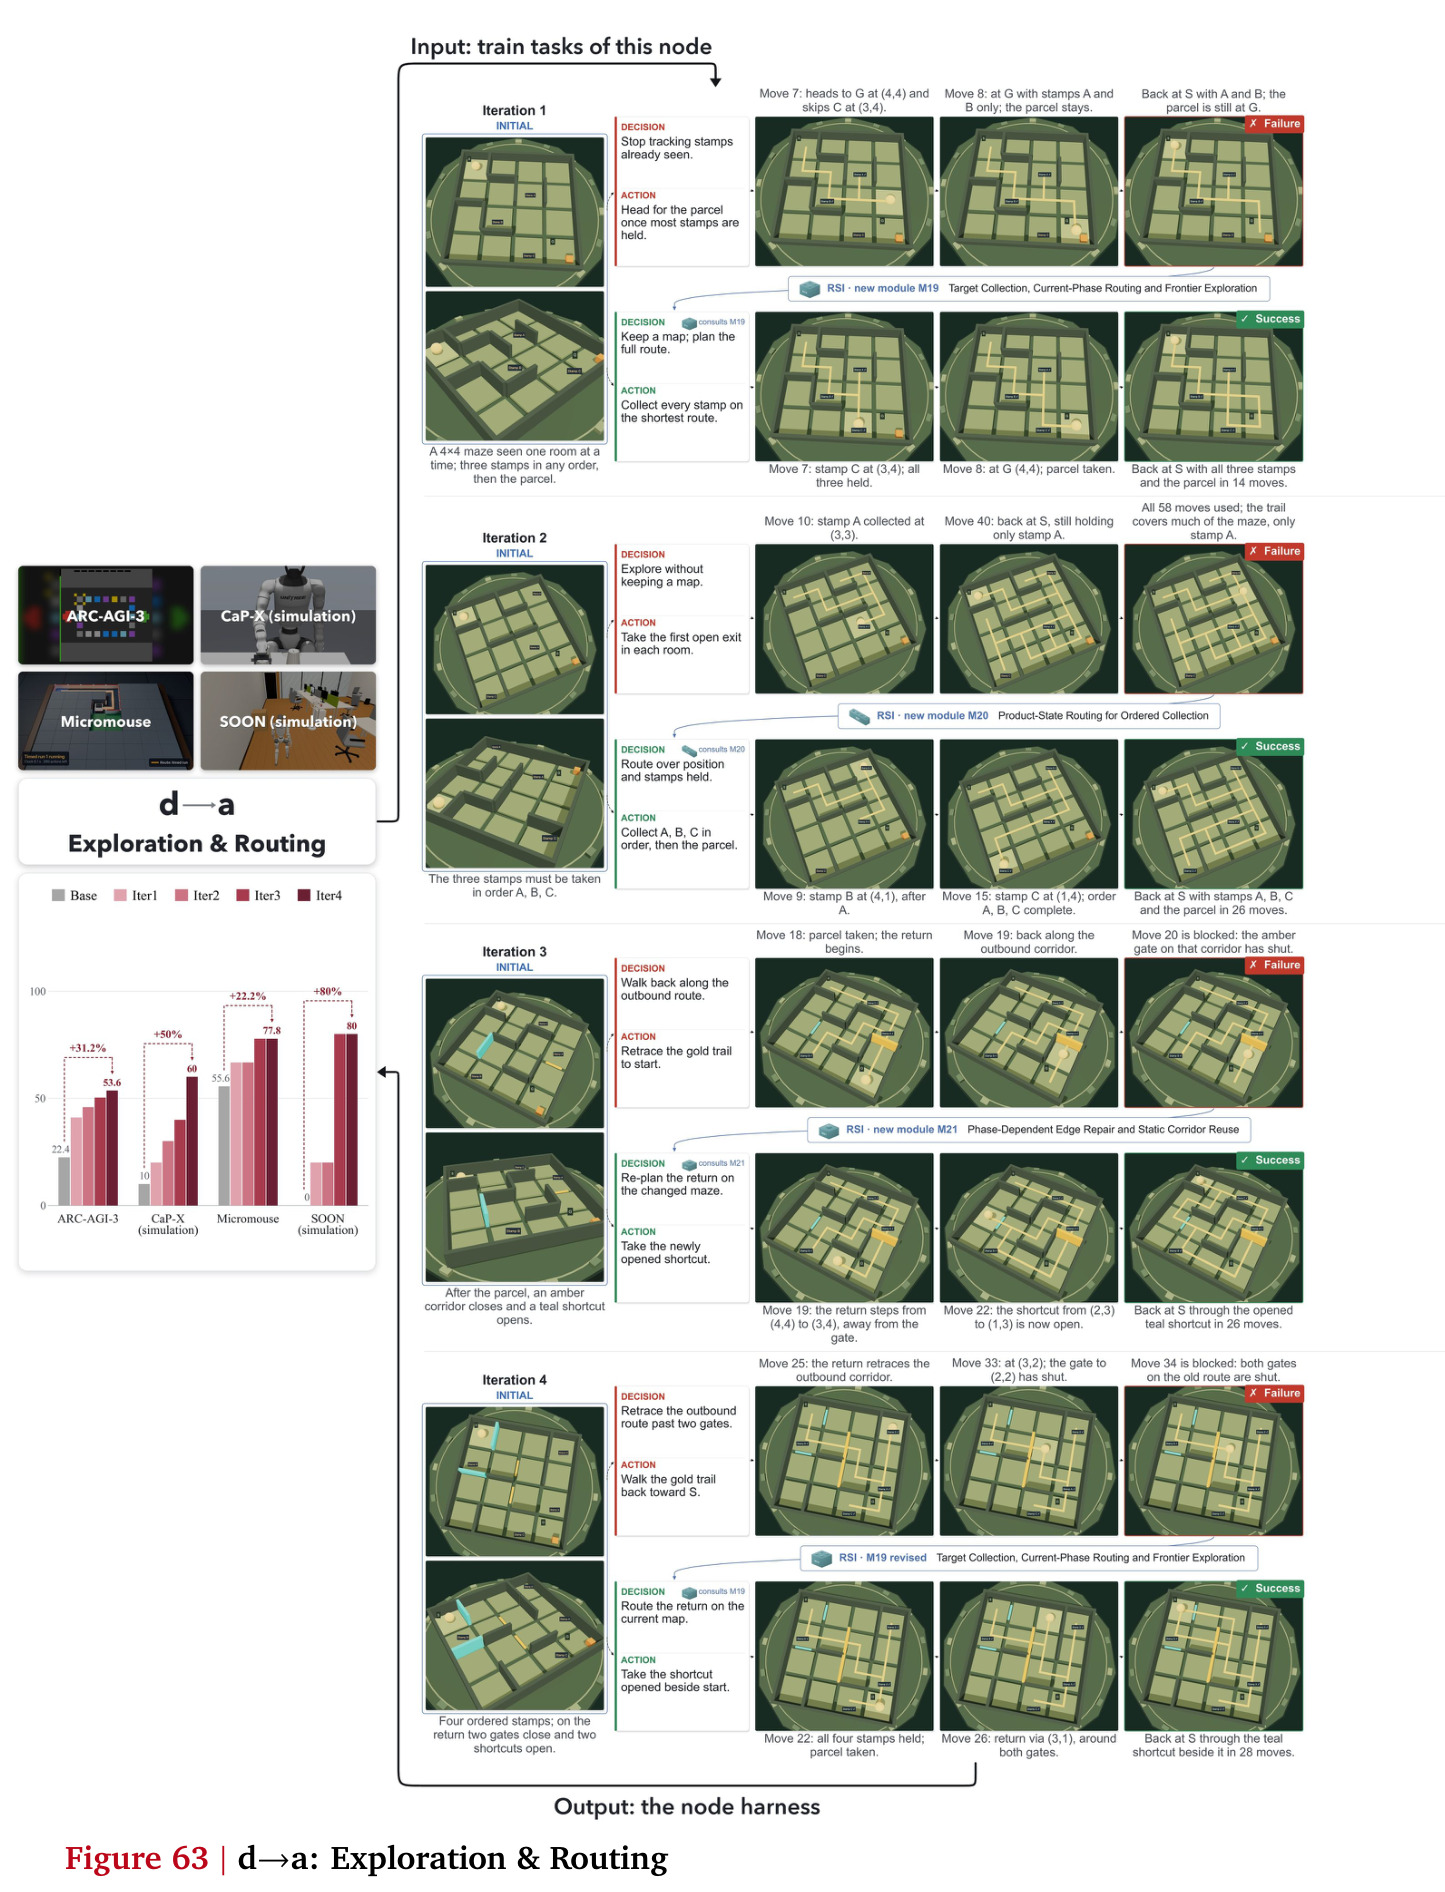
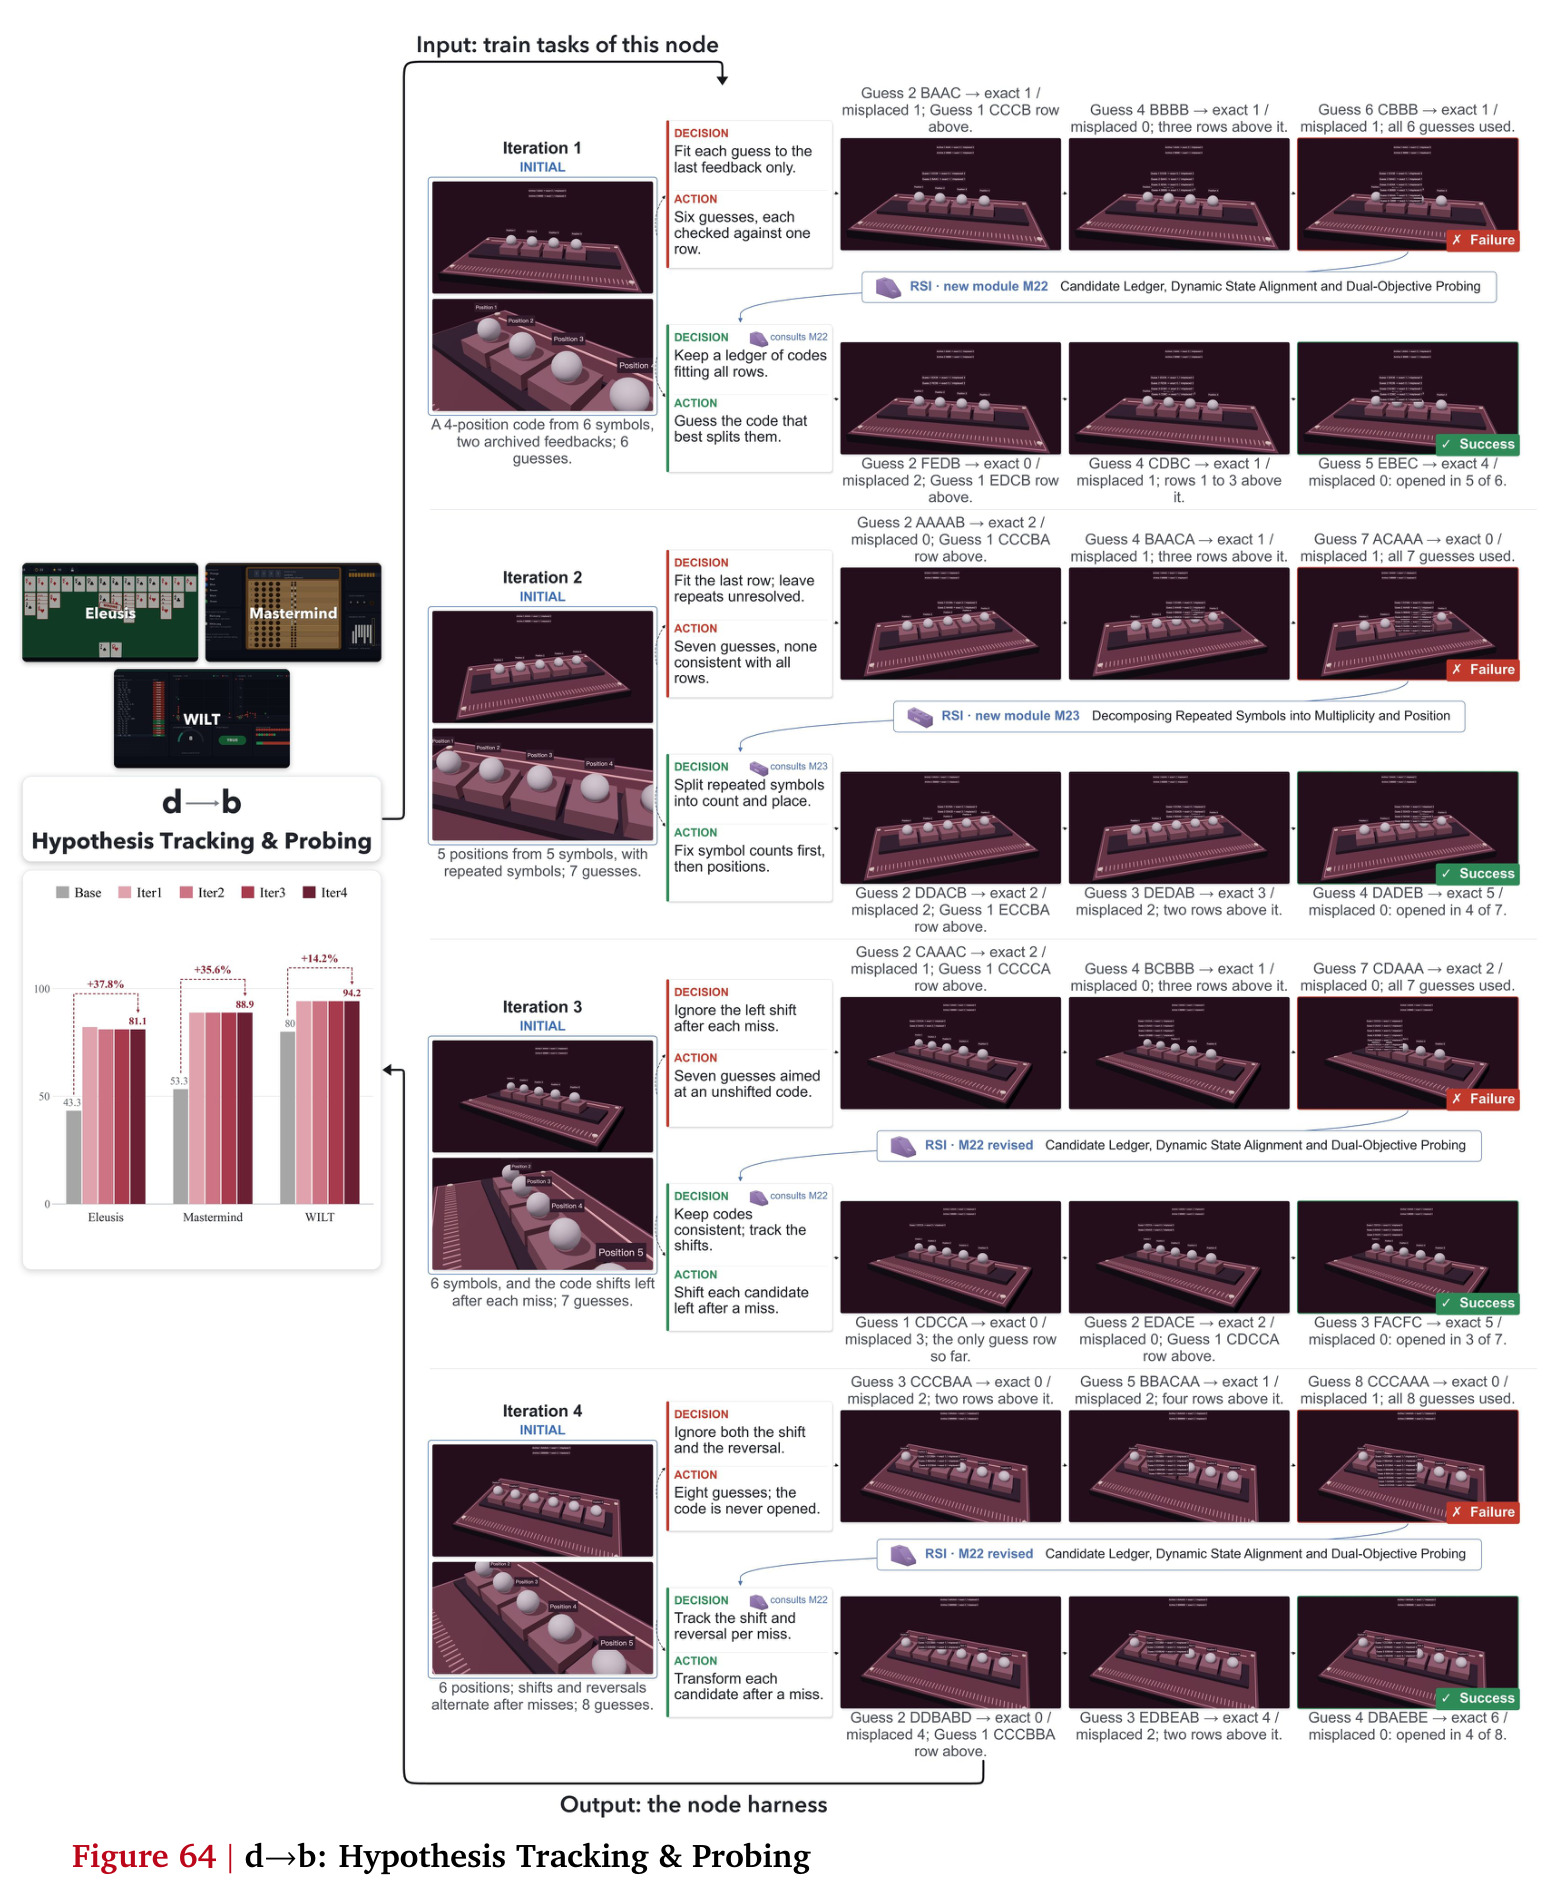
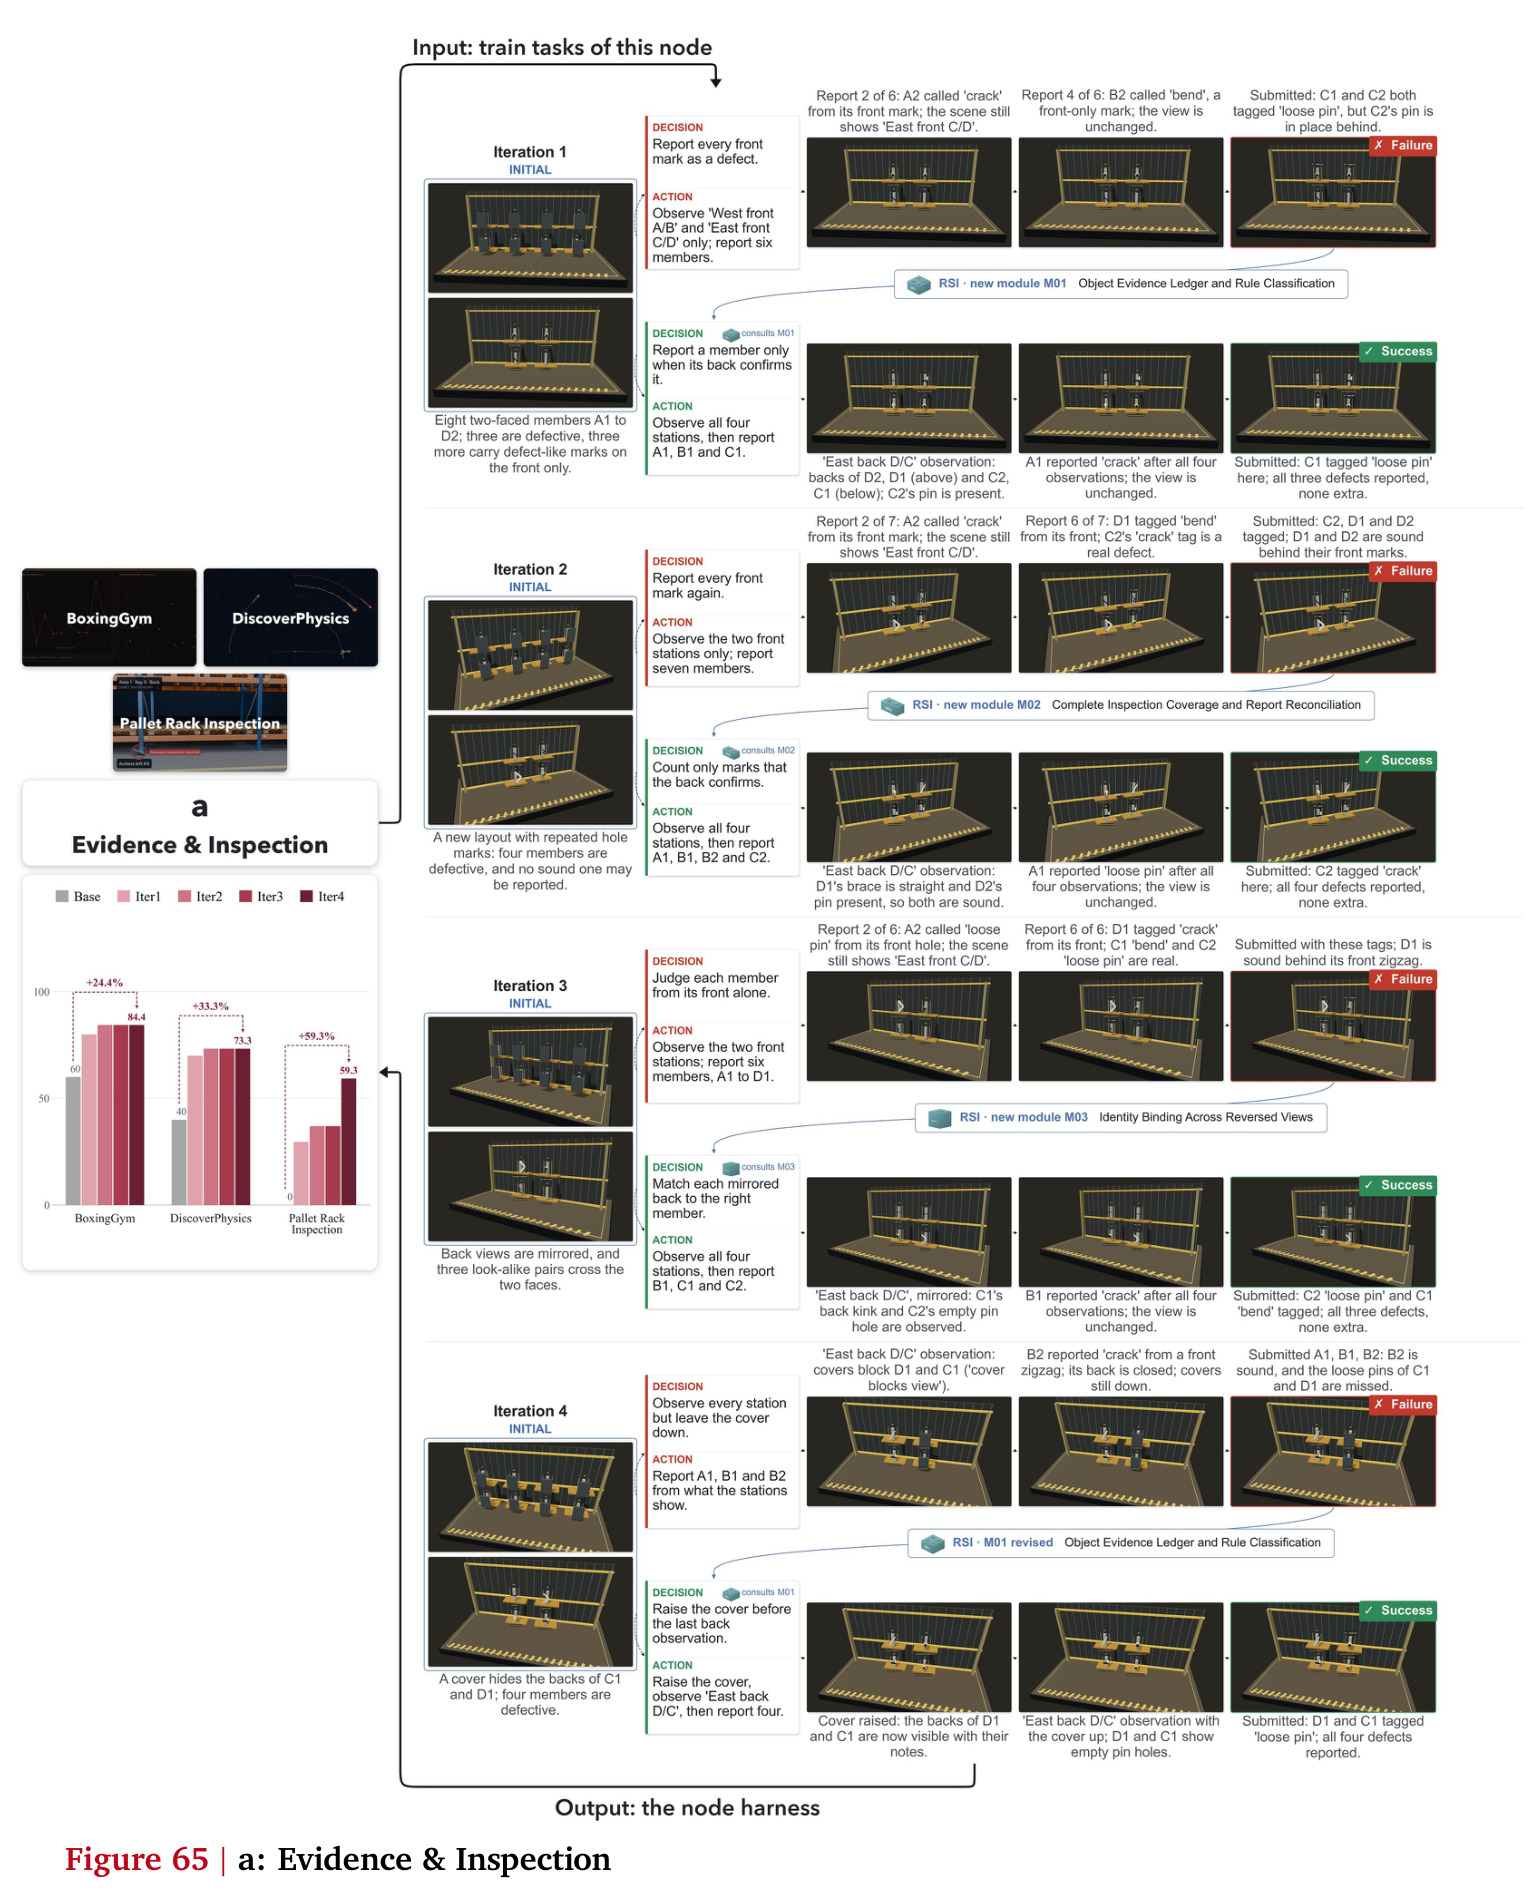
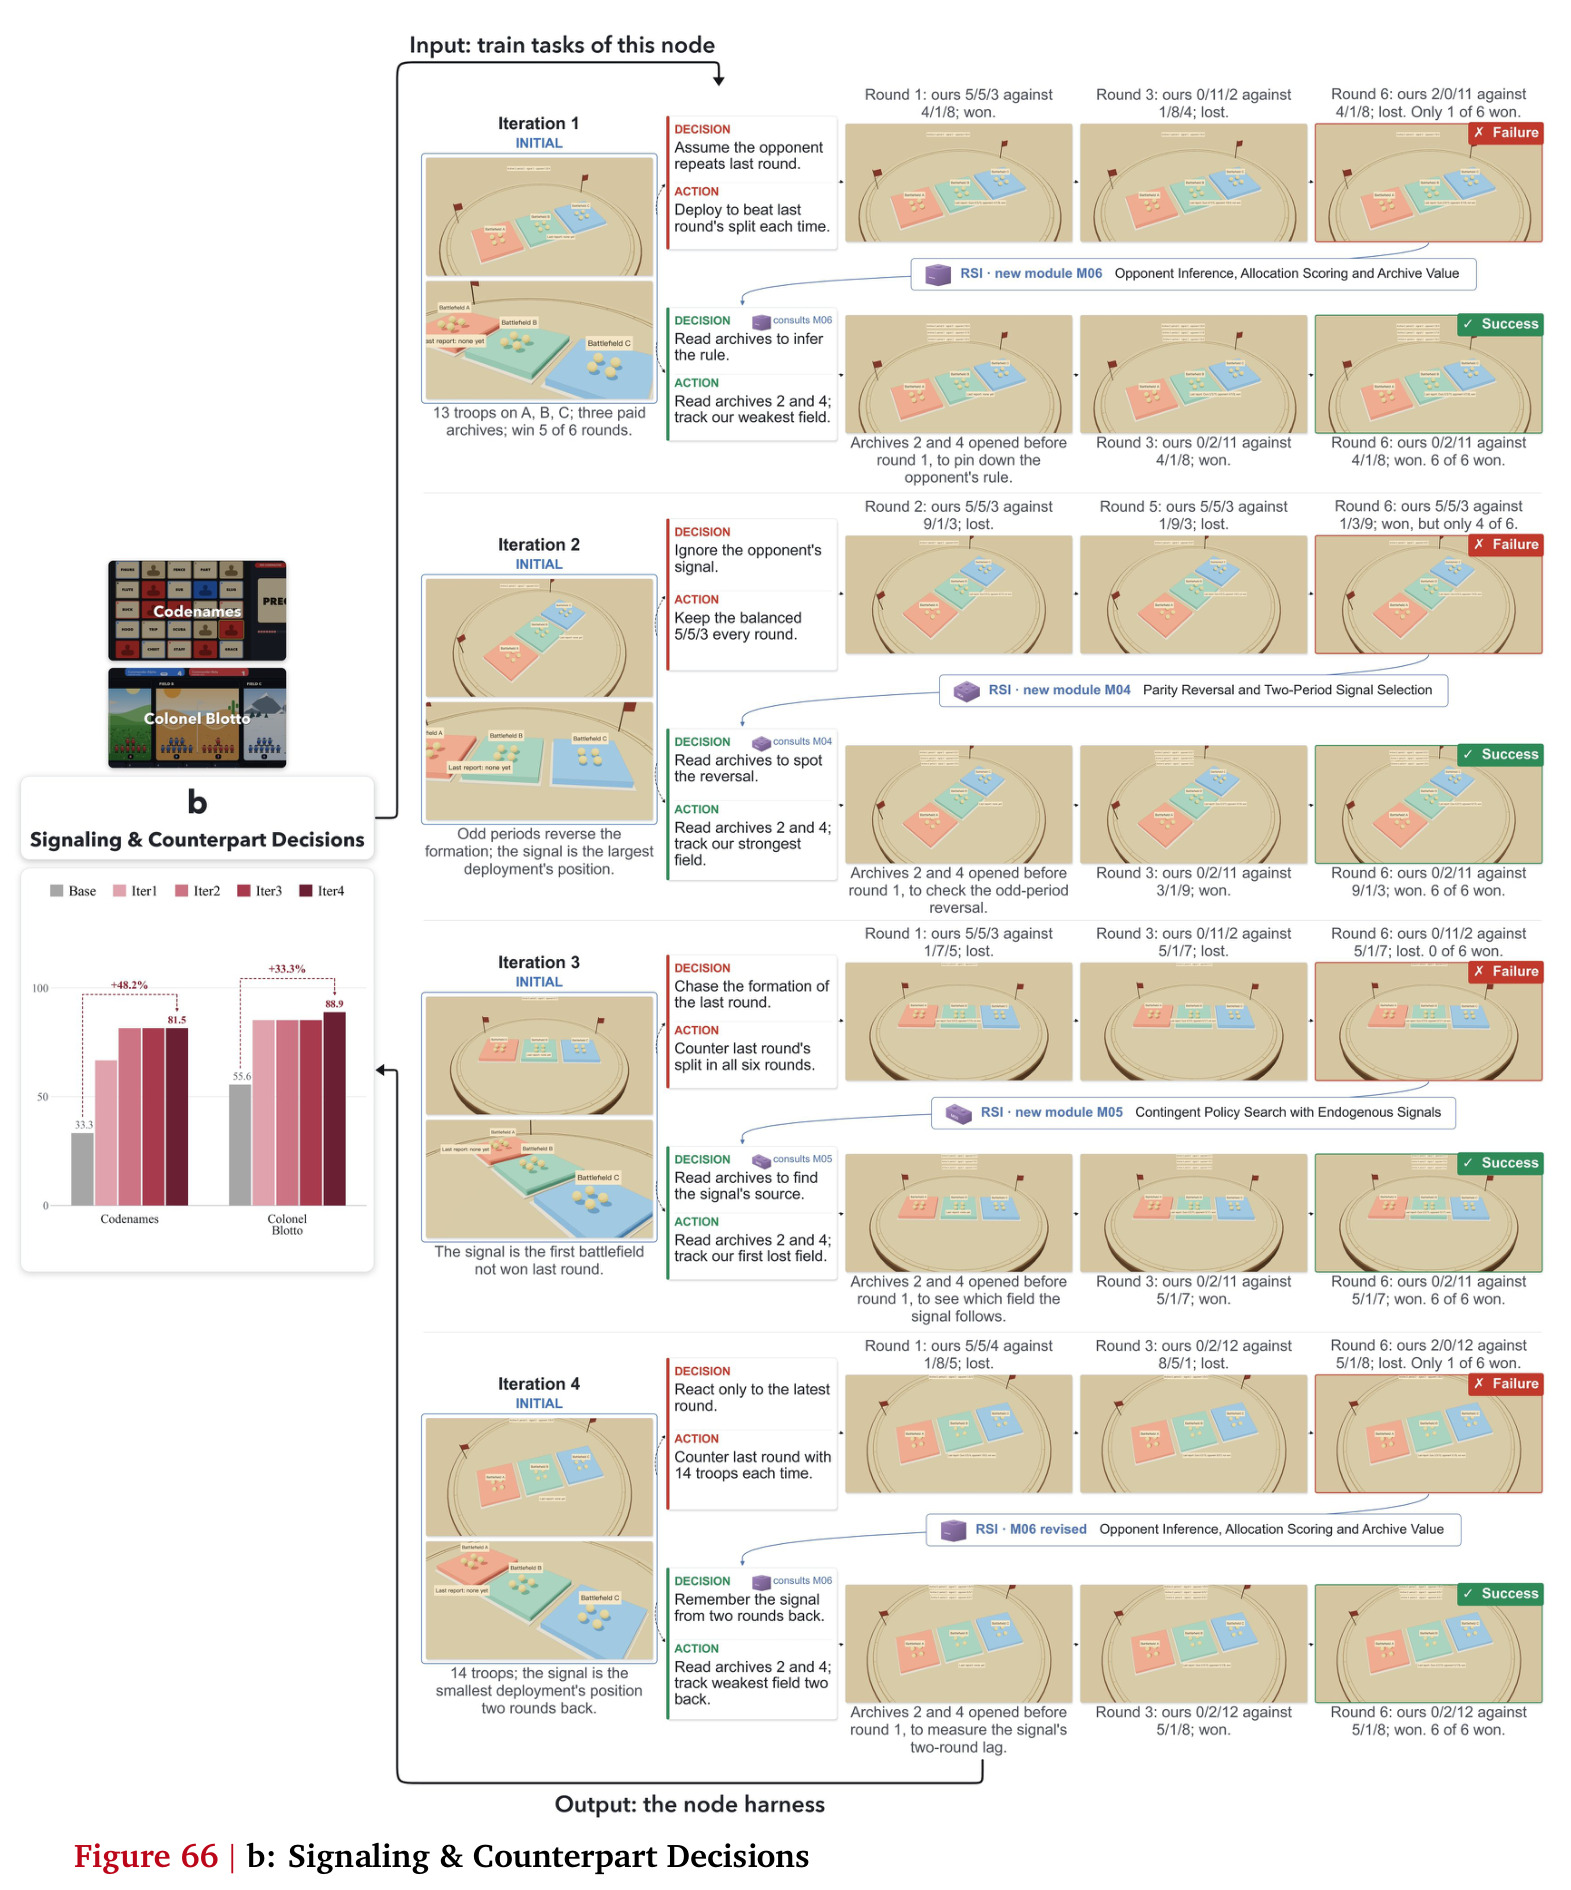
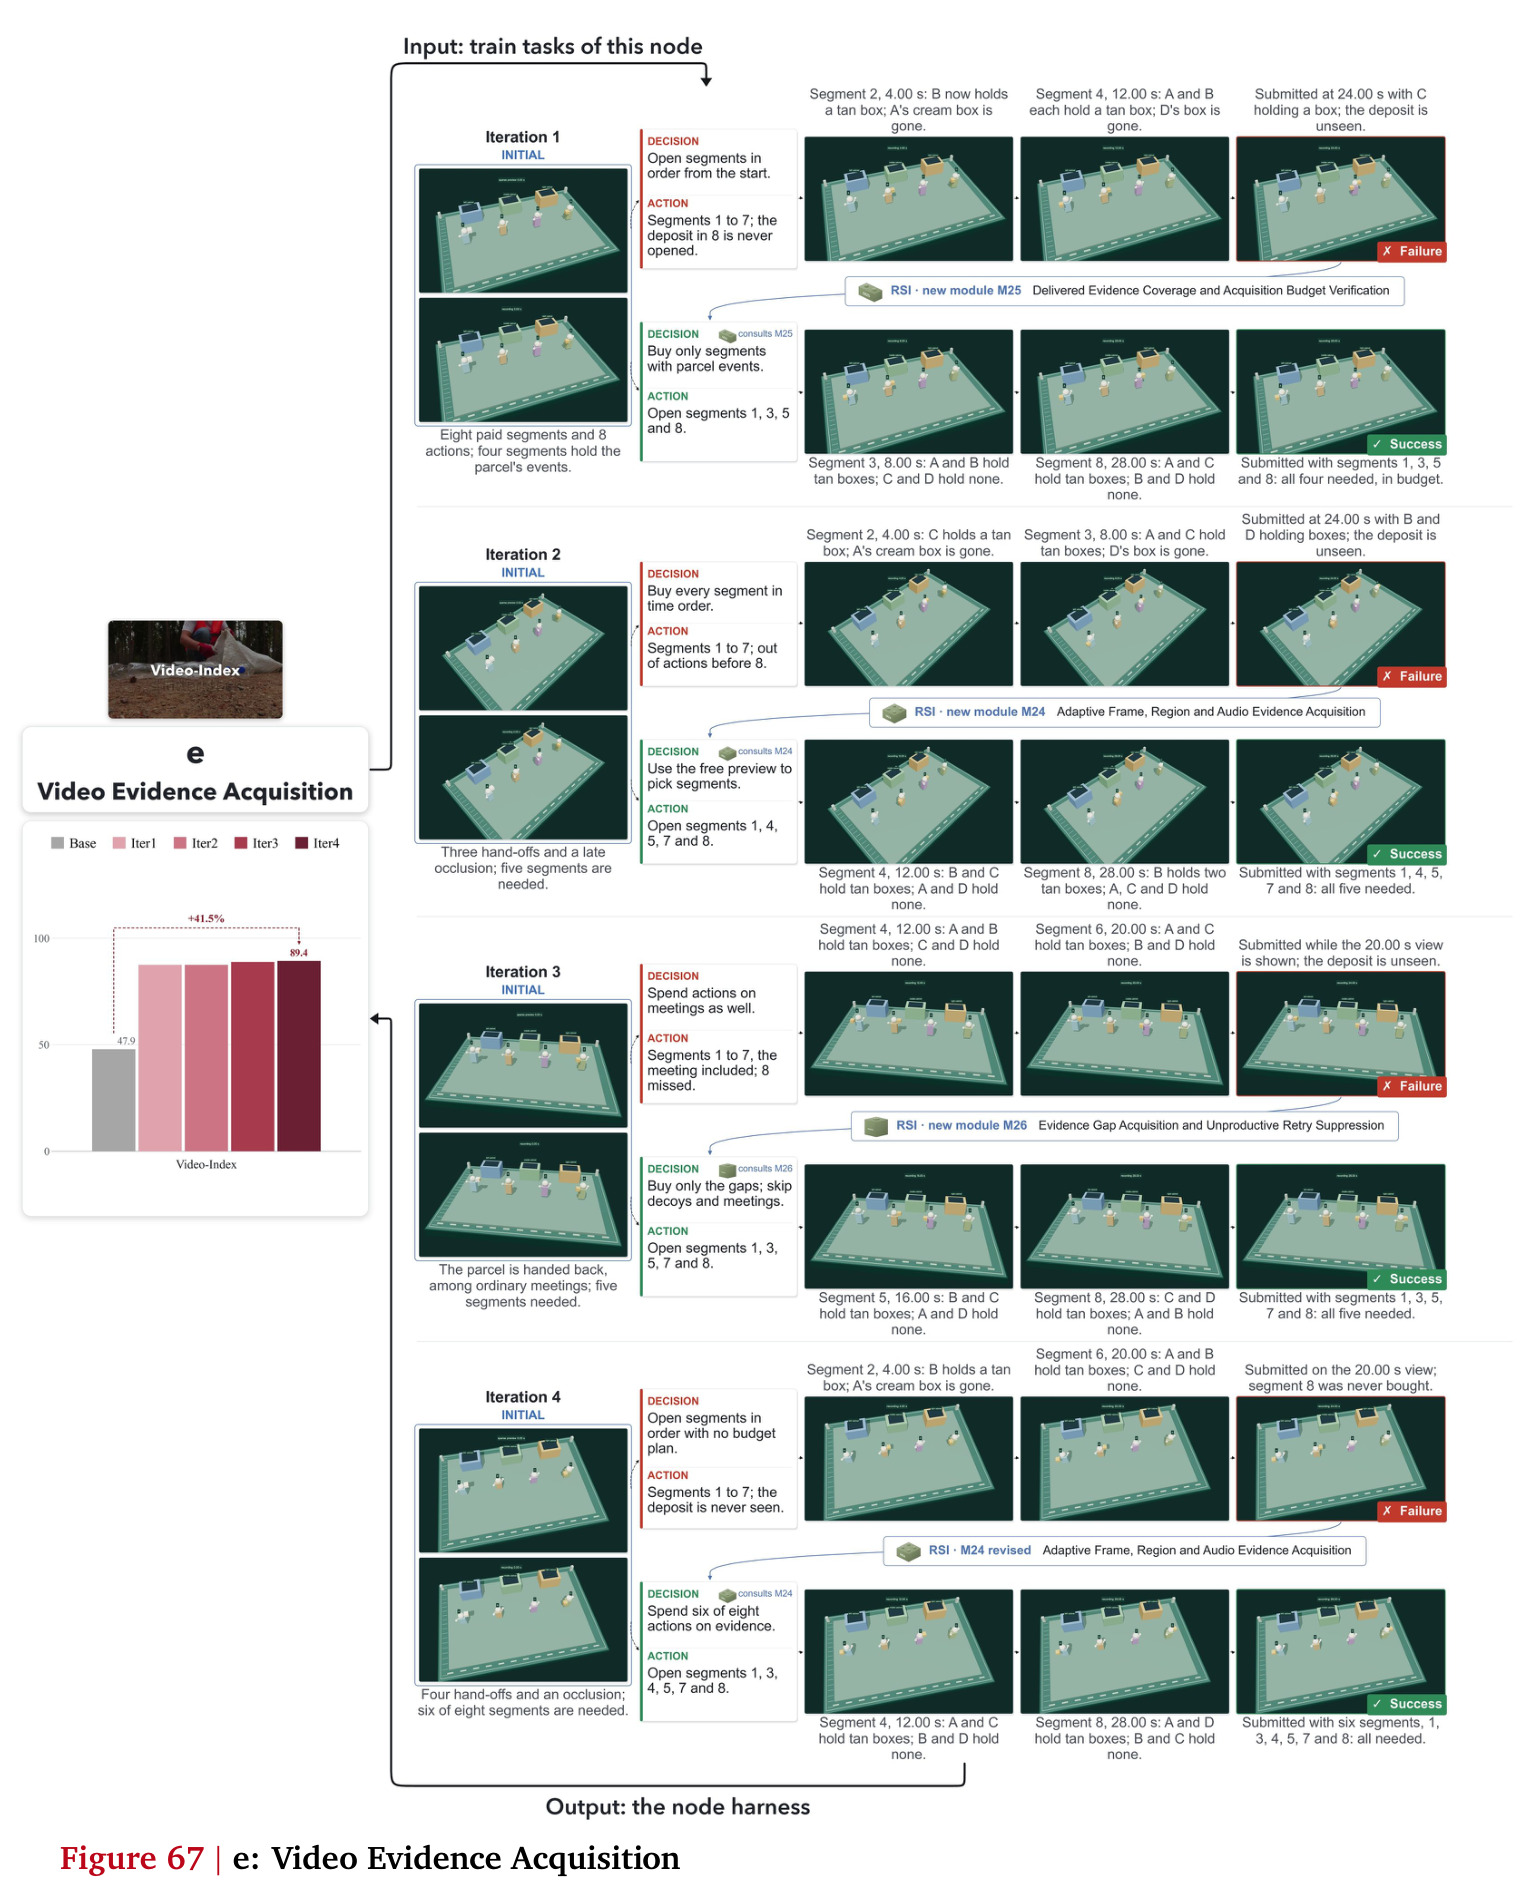
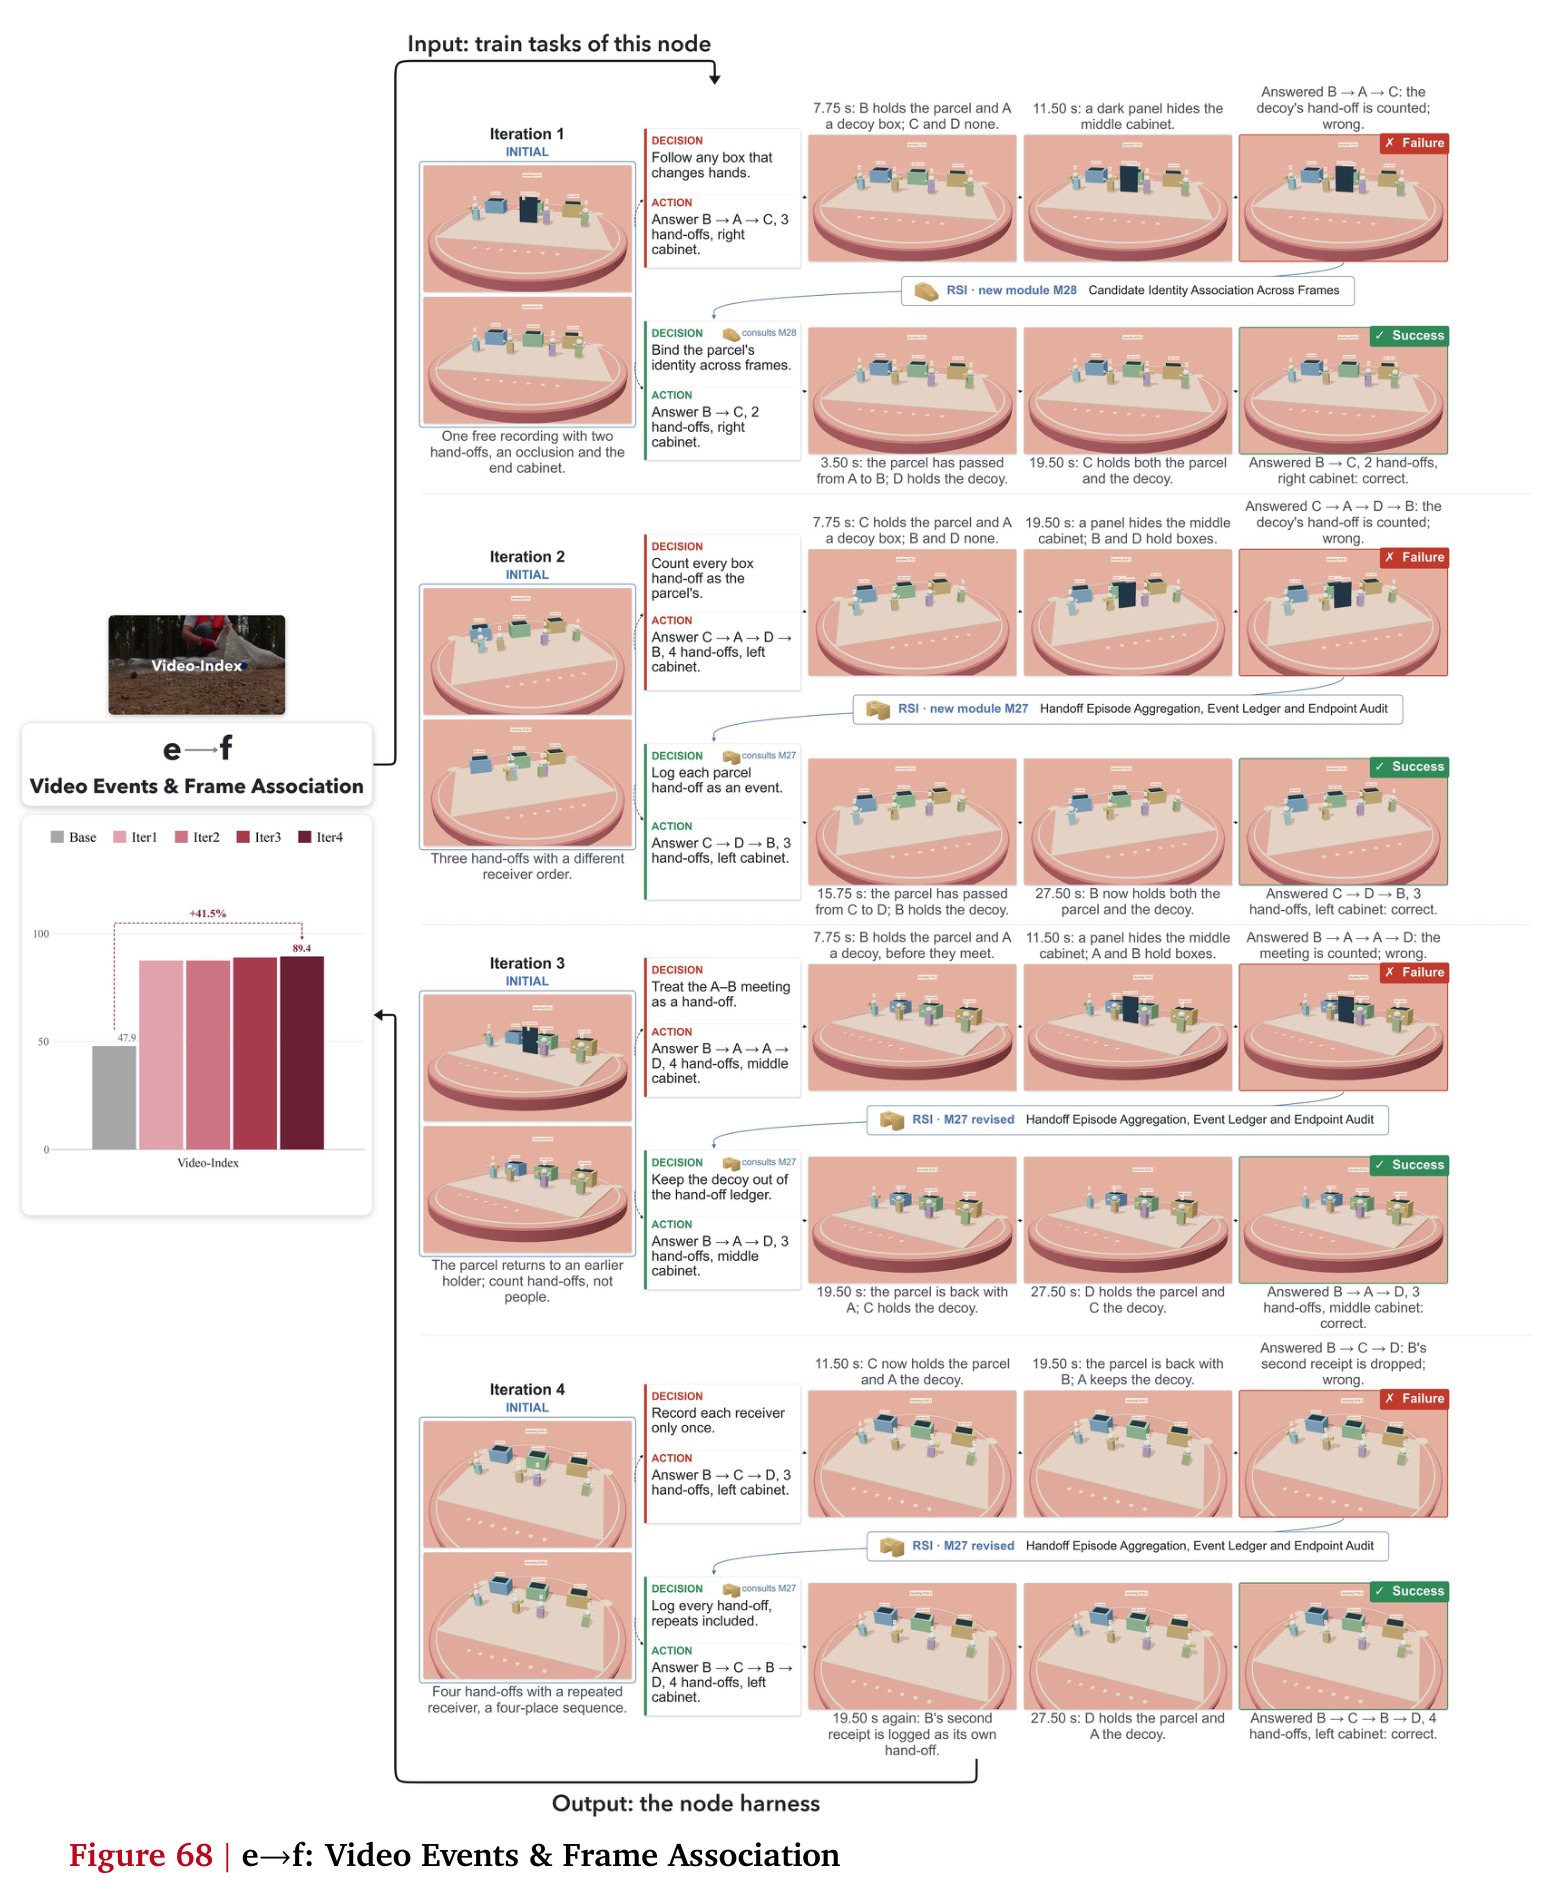
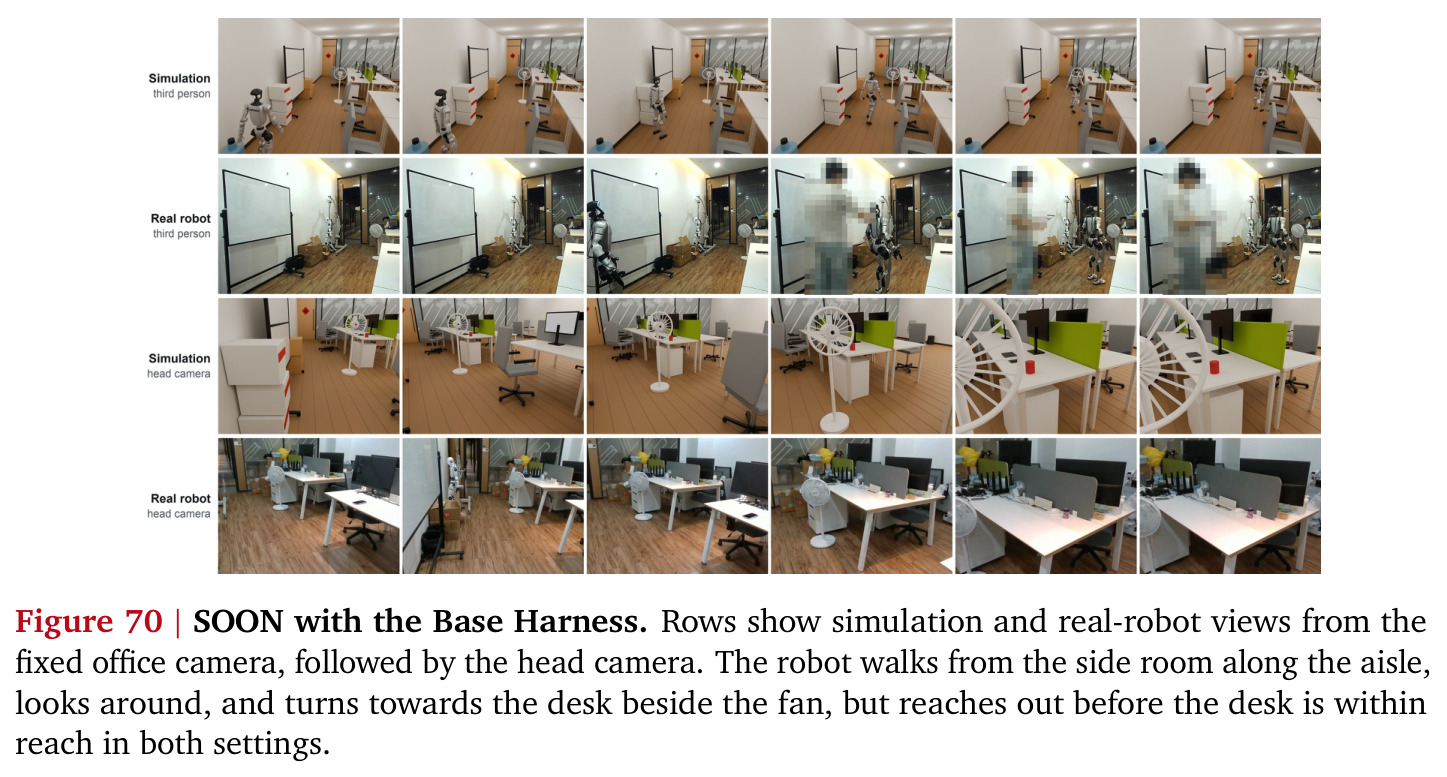
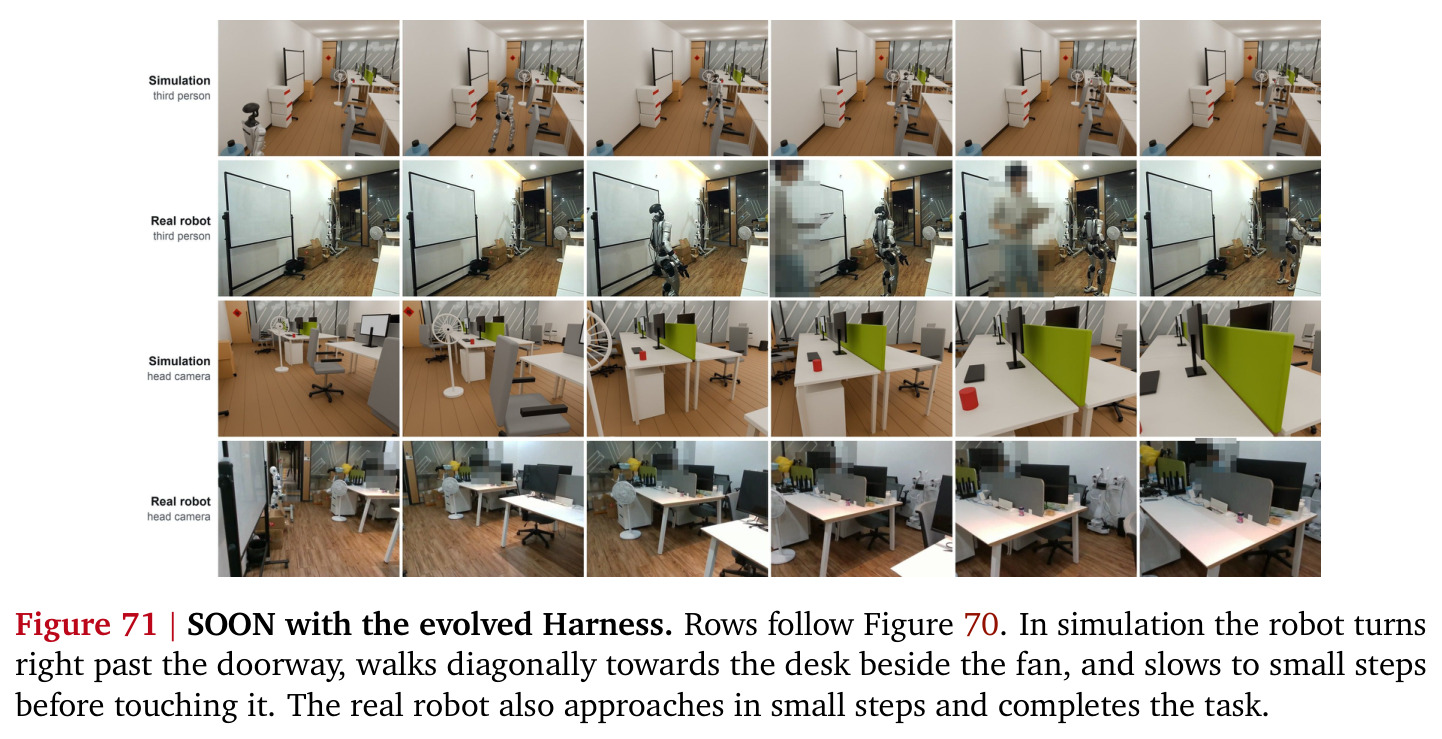
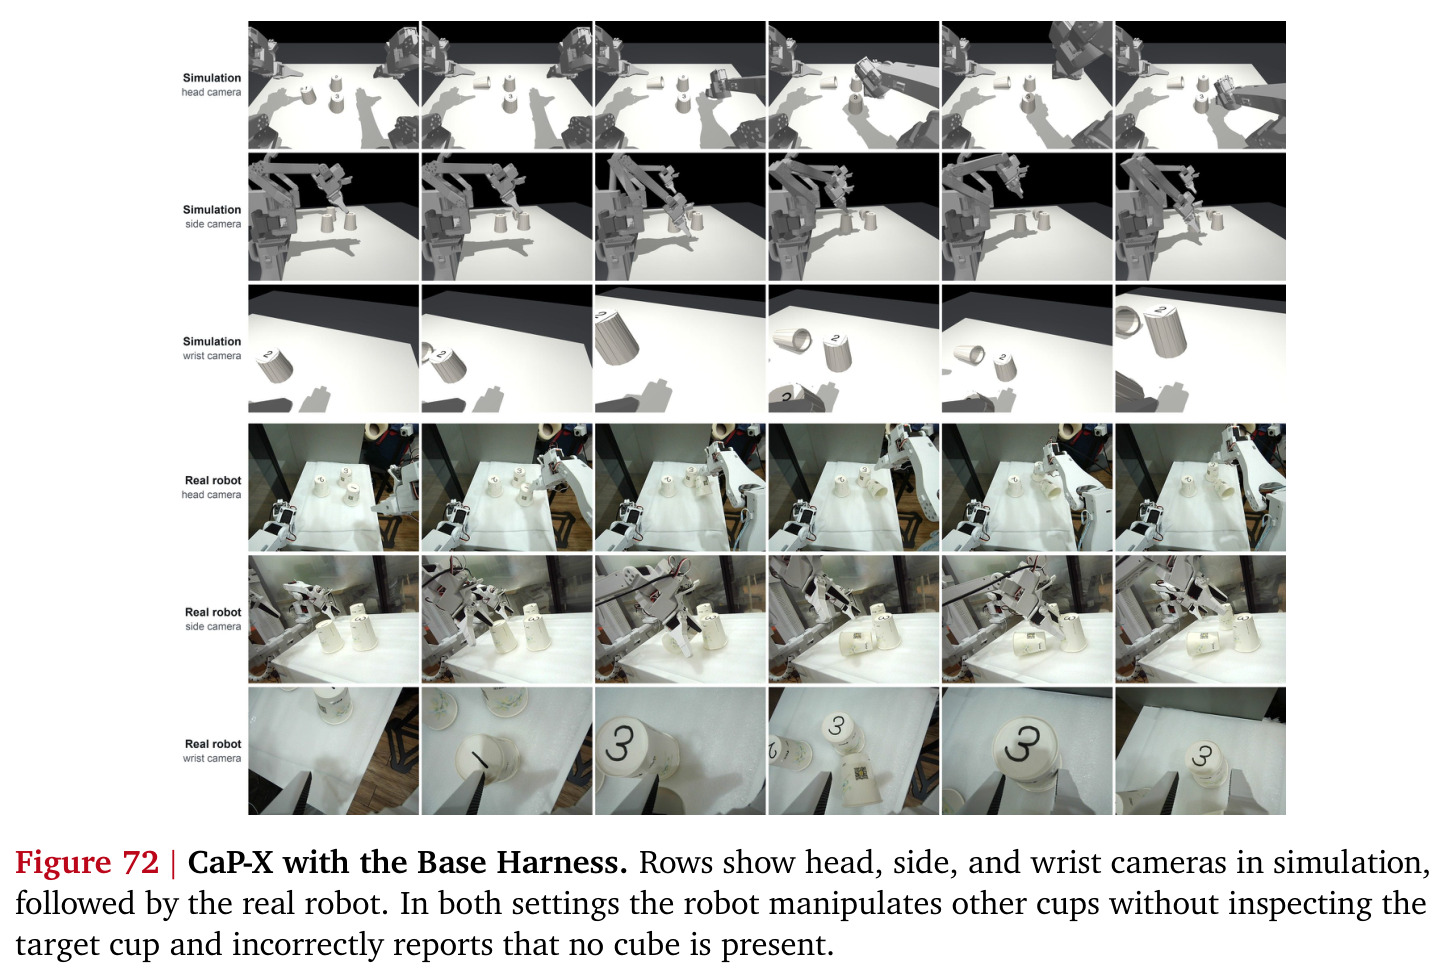
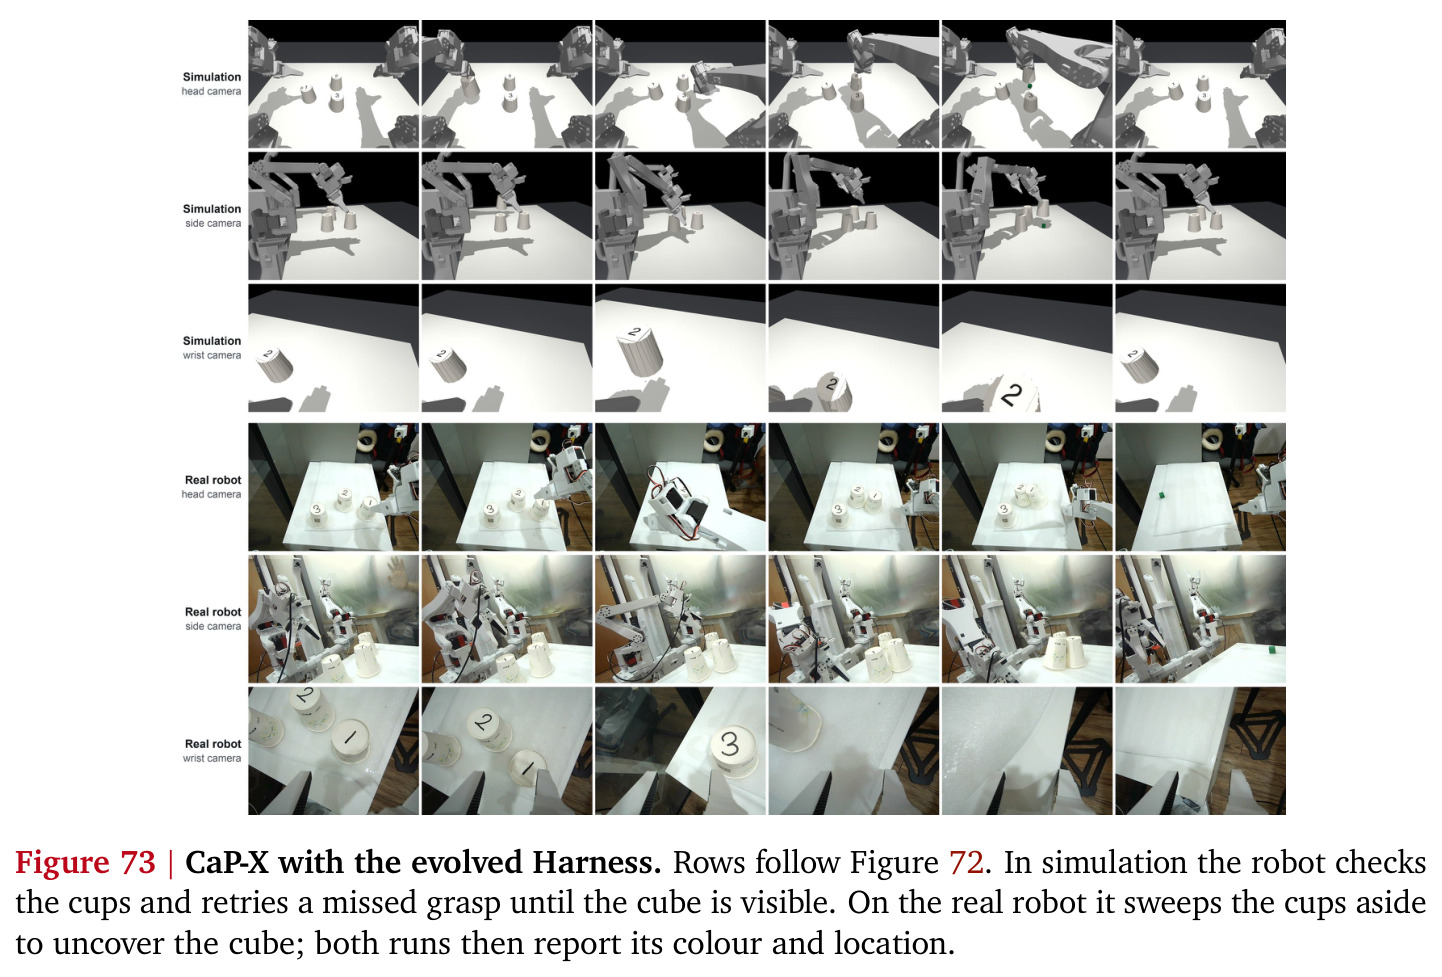
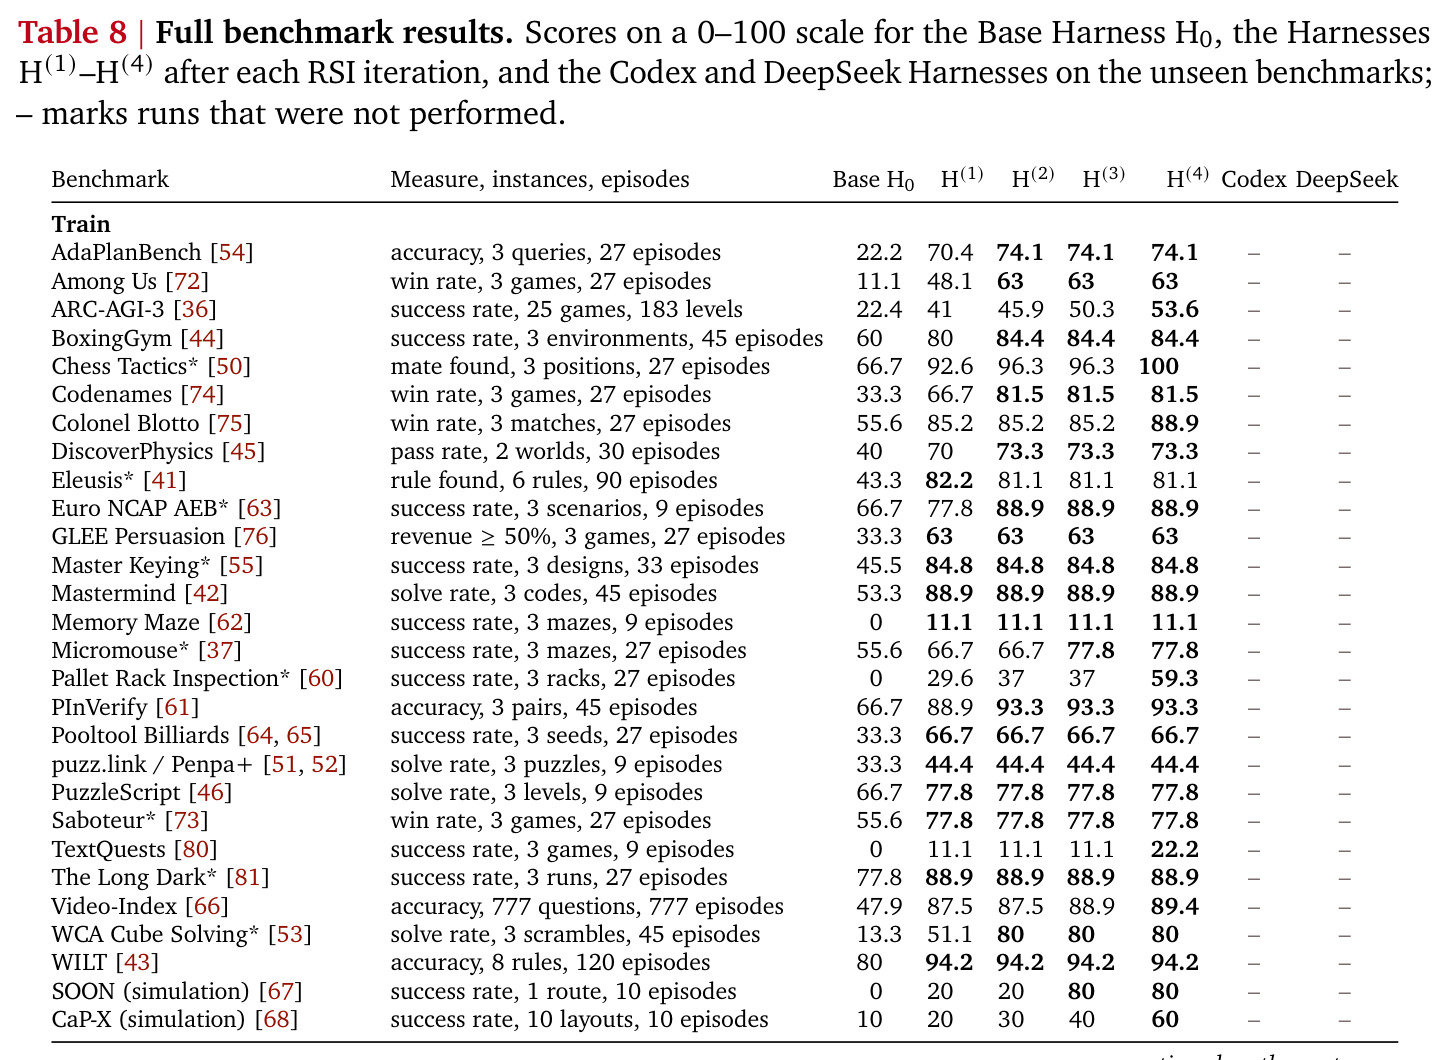
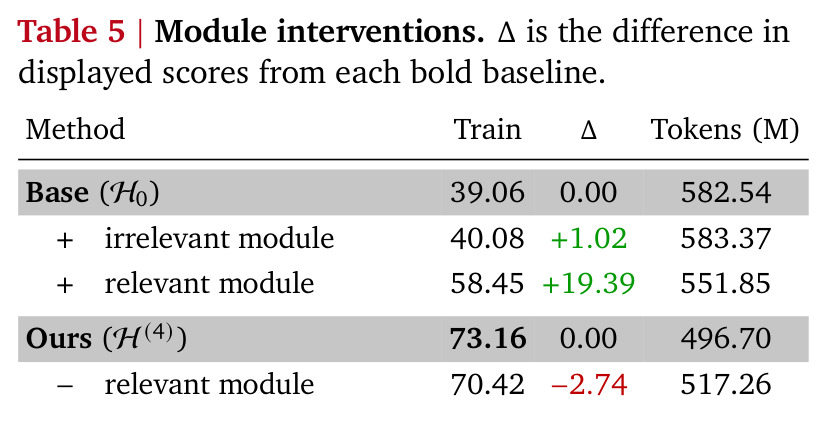
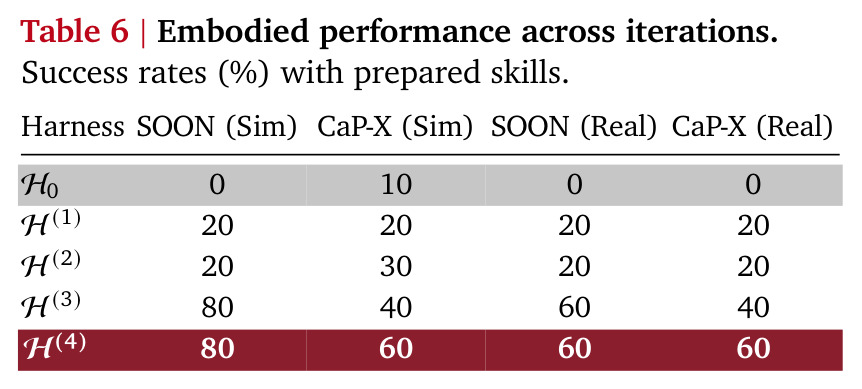
五组实验各有结论。(1) 组织对比(Table 3):Base 39.06/37.45;Global 53.04/42.92;Task-Domain 51.17/40.82;Capability-Domain 平铺 49.25/39.43;Capability Tree (Sim) 最佳 56.95/47.26,推理 token 也最低,验证能力驱动组织优于任务驱动。(2) 模块与技能(Table 2):仅模块 56.95/47.26,仅技能 58.86/48.67,结合 63.80/53.53,互补而非替代。(3) RSI 曲线(Figure 6):Train 39.1→73.2,Unseen 42.1→64.1;第 1 轮增益最大,第 2-4 轮再加 9.4/6.4 分,改进可持续;逐基准看 ARC-AGI-3 41.0→53.6、SciGym 45.2→57.1、BuildArena 93.3→97.8,但 Mastermind 停在 88.9、Eleusis 微降至 81.1;最终 Unseen 均值超过 Codex(47.5)与 DeepSeek(46.2)参考,Crafter 与 DiG-bench 除外。(4) 路由(Table 4):完整自路由 71.27/60.96 逼近 Oracle 73.16/63.61,Random 仅 52.74/46.23,去掉能力定义与经验记忆降至 65.79/52.36。(5) 模块干预(Table 5):给 Base 加相关模块 +19.39(39.06→58.45),加无关模块仅 +1.02;从 $H^{(4)}$ 移除相关模块 -2.74(73.16→70.42)。相关性上(Figure 7)HCI-Inference 0.744 最强。具身迁移(Table 6):SOON 模拟 0→80%、真实 0→60%;CaP-X 模拟 10→60%、真实 0→60%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 28 个训练基准平均 | benchmark-equal mean(0-100) | 73.2(第 4 轮迭代) | Base H0:39.1 | +34.1 分 |
| 18 个未见基准平均 | benchmark-equal mean(0-100) | 64.1(第 4 轮迭代) | Base:42.1 | +22.0 分 |
| 未见基准 vs 参考模型 | 非机器人基准均值 | 高于两条参考线 | Codex 47.5 / DeepSeek 46.2 | 最终 Unseen 均值超过两者(Crafter、DiG-bench 除外) |
| 能力感知路由(Train) | benchmark-equal mean | 71.27(完整自路由) | Oracle 73.16 / Random 52.74 | 逼近 Oracle 上限,token 远低于 Random 的 567.08M |
| SOON 真实机器人(Unitree G1 导航伸手) | 成功率(%) | 60%(H4,模拟 80%) | Base H0:0% | +60 个百分点 |
| CaP-X 真实机器人(AlohaMini2 操作) | 成功率(%) | 60%(H4,模拟 60%) | Base H0:0% | +60 个百分点 |
局限与改进
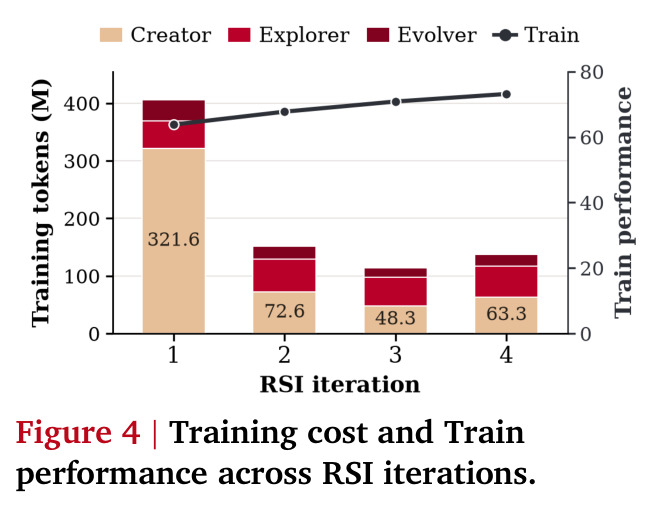
作者承认两点:基准发现依赖 web 检索,覆盖范围与结果质量随查询波动;当前研究聚焦 Harness 层面的自我改进,不触及模型参数训练。我的补充观察:一是训练成本高,第 1 轮 405.70M token 中 Creator 的世界构建占主导(Figure 4),虽有世界复用摊销,冷启动代价仍大;二是评估流程复杂——每个基准-Harness 对要先跑 5 次预备试验生成技能并冻结,复现门槛高;三是收益不均衡,Mastermind 持平 88.9、Eleusis 微降至 81.1、Crafter 与 DiG-bench 低于参考模型,说明能力树对部分任务并不匹配;四是具身实验只覆盖两个任务、每配置仅 5 次预备加少量正式测试,0→60% 的成功率差异样本量小,统计置信度有限;五是 Figure 7 的能力-模块相关性只是描述性统计(如 HCI-Inference 0.744),因果性主要靠 Table 5 的小规模干预实验支撑,单模块抽样难以覆盖组合效应。
独立分析的弱点
第一,能力类别 $\mathcal{K}$ 与排序 $\prec$ 在建树前固定,树拓扑在整个 RSI 期间不可变:若初始归纳遗漏关键能力或前缀排序不当,后续所有迭代都被锁死在错误结构上,ARC-AGI-3 这类任务的有限收益可能与此有关;改进方向是支持在线增量插节点与周期性重构,用未见任务的失败信号触发扩树。第二,模拟世界筛选要求落在预设「中等性能带」,阈值全局固定:对冷启动能力节点可能把过简或过难的世界都筛掉,浪费 Creator 构建成本;改进:按学习者当前进度自适应调整筛选带。第三,成本结构上 Creator 主导第 1 轮 405.70M token,小团队难以负担;改进:跨节点复用世界模板库、用小模型承担 Creator 的实现。第四,路由按文件顺序单次处理任务并维护 2 万条 FIFO 记忆,任务分布漂移时早期经验会误导选择,且无效选择无回退直接记 0 分;改进:记忆加时间衰减、低置信度回退 Base Harness。第五,unseen 基准由同一团队用 web 检索挑选,存在选择偏差风险,26 分的泛化提升可能被高估;改进:委托第三方独立评测集复核。
未来方向
作者展望两个方向:动态扩展能力树以捕捉新兴能力需求;把能力驱动范式从 Harness 层延伸到模型参数训练,让能力感知路由与 RSI 形成闭环,联合驱动能力的发现、获取与精炼。基于本文成果还可延伸:在多个模型家族上验证进化模块的可移植性(当前仅用冻结的 Claude Opus 5,模块是否绑定特定模型行为未知);把模块干预实验升级为自动化的模块组合搜索,用 Table 5 展示的 +19.39/-2.74 效应量作为搜索信号;利用 HCI-Inference 0.744 这类能力-协议相关先验为新任务冷启动推荐初始 Harness 配置,跳过探索阶段;把能力树扩展到多智能体协作与工具使用场景,检验共享前缀继承在非单体智能体上是否同样成立。
复现评估
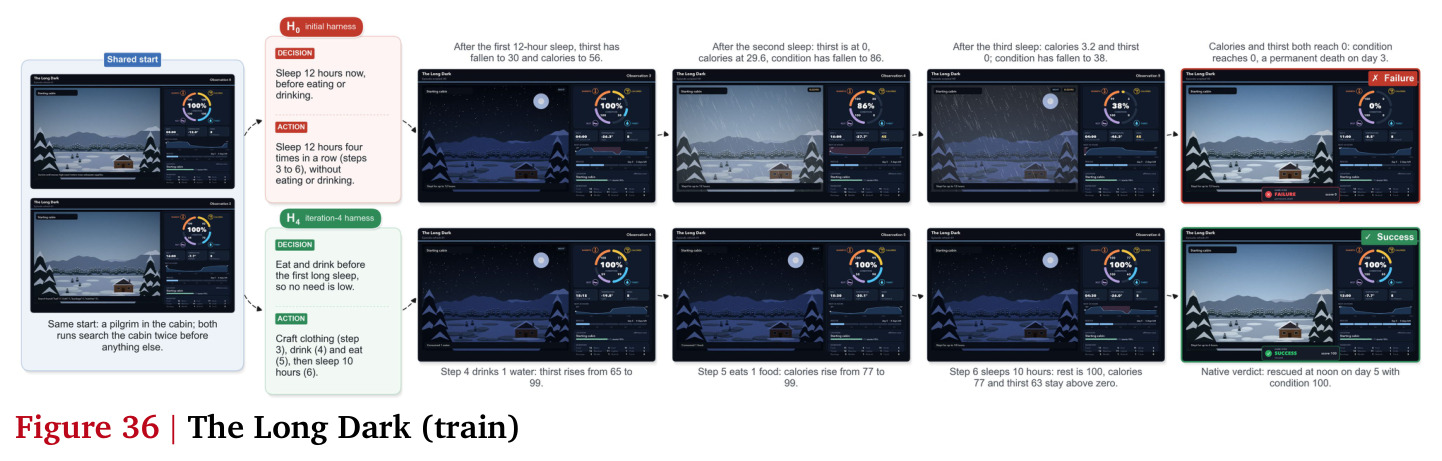
论文附 Project Page 与 GitHub 链接,但正文未明确代码、合成世界与轨迹数据是否完整开源。复现要点:44 个基准中有多个自建基准(标注 *,如 Eleusis、Micromouse、Chess Tactics、The Long Dark 等,由 agent 从 web 检索源构建),需要重建这些环境;骨干为冻结的 Claude Opus 5,按论文 token 统计第 1 轮训练 405.70M、各切分推理 497.89-594.25M,按 API 定价成本不低,但无 GPU 训练需求(进化发生在配置层,冻结权重不需要反向传播);工程上需要严格的宿主校验基础设施——哈希链、终端回执验证、类型化输入输出断言、注册表谱系检查——这是复现的最大工作量。方法本身数学不深(式 (1)-(9) 都是集合与注册表操作),附录 A-E 提供了树结构、各节点课程与评测细节。综合评估:复现难度中高,难在工程流程而非算法,若官方开源质量足够则研究组可复现,个人开发者建议只借鉴「能力树 + 世界生成」的思路。
论文图表