自进化智能体Harness:模型权重固定下的脚手架递归自我改进框架 Self-Evolving Agent Harness
固定模型权重,用执行反馈持续修订智能体软件脚手架,并给出泛化、留存与准入的理论保证
前置知识
Harness(模型–脚手架分解)
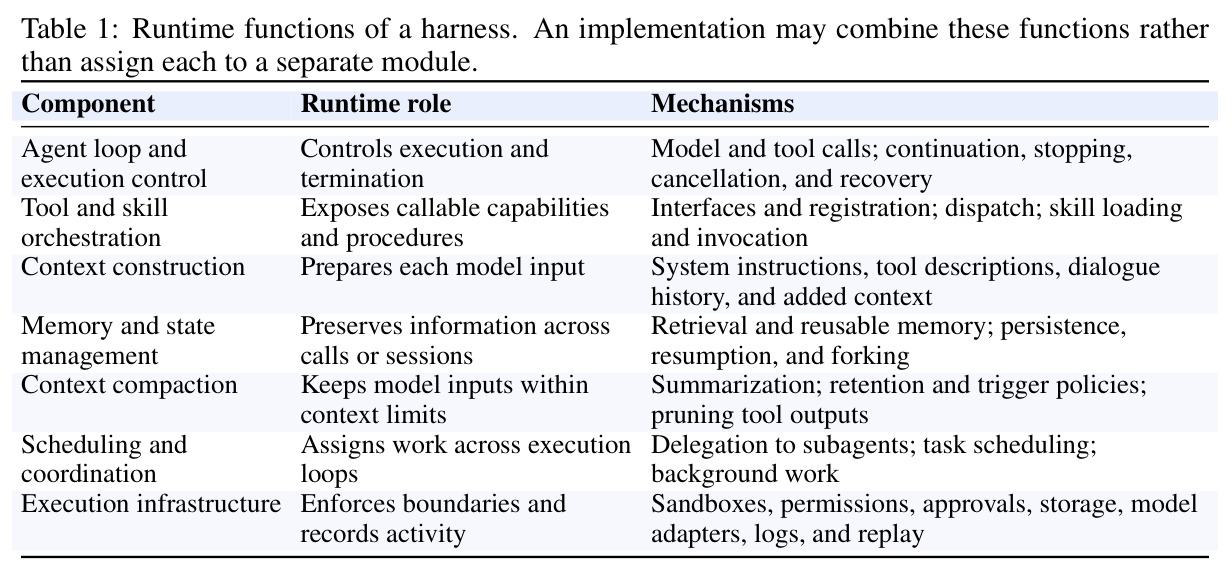
指 governing 模型执行的软件与配置层,包含七类运行时功能:智能体主循环与执行控制、工具与技能编排、上下文构建、记忆与状态管理、上下文压缩、调度与协调、执行基础设施(沙箱、权限、审批、日志、模型适配器)。模型适配器属于 harness,习得参数属于模型;当模型权重固定时,harness 直接决定模型在任务环境中的行为。
本文所有「进化」的对象都是 harness,论文的分类法(解释态 vs 可执行态)、理论分析与安全建议全部建立在能准确划分哪些部件可被修订、哪些不可触碰的前提上,不懂 harness 的构成就无法理解论文的变异边界。
递归自我改进(RSI)
源自 Good (1965) 的智能爆炸猜想与 Schmidhuber 的 Gödel Machine:系统能够改进自身(甚至改进改进机制本身)。本文将其限定为 harness RSI——权重不动、只修订软件脚手架,且不假设每次修订必然带来增益;「自进化」指更新过程,「自改进」专指经比较证实的增益。
论文标题与整个研究领域的命名都来自 RSI;理解它才能分清本文与权重微调类自我改进、以及无更新机制的固定 scaffold 的本质区别。
算法稳定性(replace-one 稳定性)
度量学习算法对训练数据的敏感度:把第 $s$ 个任务替换为独立同分布新任务后重跑全部下游更新,在耦合随机性下比较新旧输出的损失差,取平均得到 $\beta_{s,k}$。经典结果表明稳定性上界控制期望泛化差距:$E[R_s(H_k)-\hat{R}_s(H_k)]\le\beta_{s,k}$。
论文第 4.2 节的两个理论支柱之一,泛化界与留存界都由它推出;不懂稳定性就无法理解为什么「小代码补丁不等于稳定」。
Hoeffding 不等式与联合界(union bound)
Hoeffding 不等式给出独立有界随机变量均值偏离期望的概率上界;联合界把多轮、多候选比较的失败概率加总。配对差值落在 $[-1,1]$(宽度为 2),同时控制至多 $KT$ 次比较可得以至少 $1-\delta$ 概率同时成立的不等式:$\Delta_k(H')\le\hat{\Delta}_k(H')+\sqrt{2\ln(KT/\delta)/m}$。
准入规则 Eq.(8) 是本文最有可操作性的理论产出,它完全由这两个经典工具构造;理解它们才能明白为什么验证集必须新鲜且独立。
进化算法搜索结构(精英选择 / 档案多样性)
(1+1) 精英搜索比较单个候选与现任者并保留胜者;档案式搜索保留多个程序谱系供后续选择与变异;Pareto 选择按成本–性能前沿或多准则接受;MAP-Elites 将候选按语义单元分格保留局部精英。三者都在经验适应度上做选择,因此接受修订都可能过拟合或遗忘。
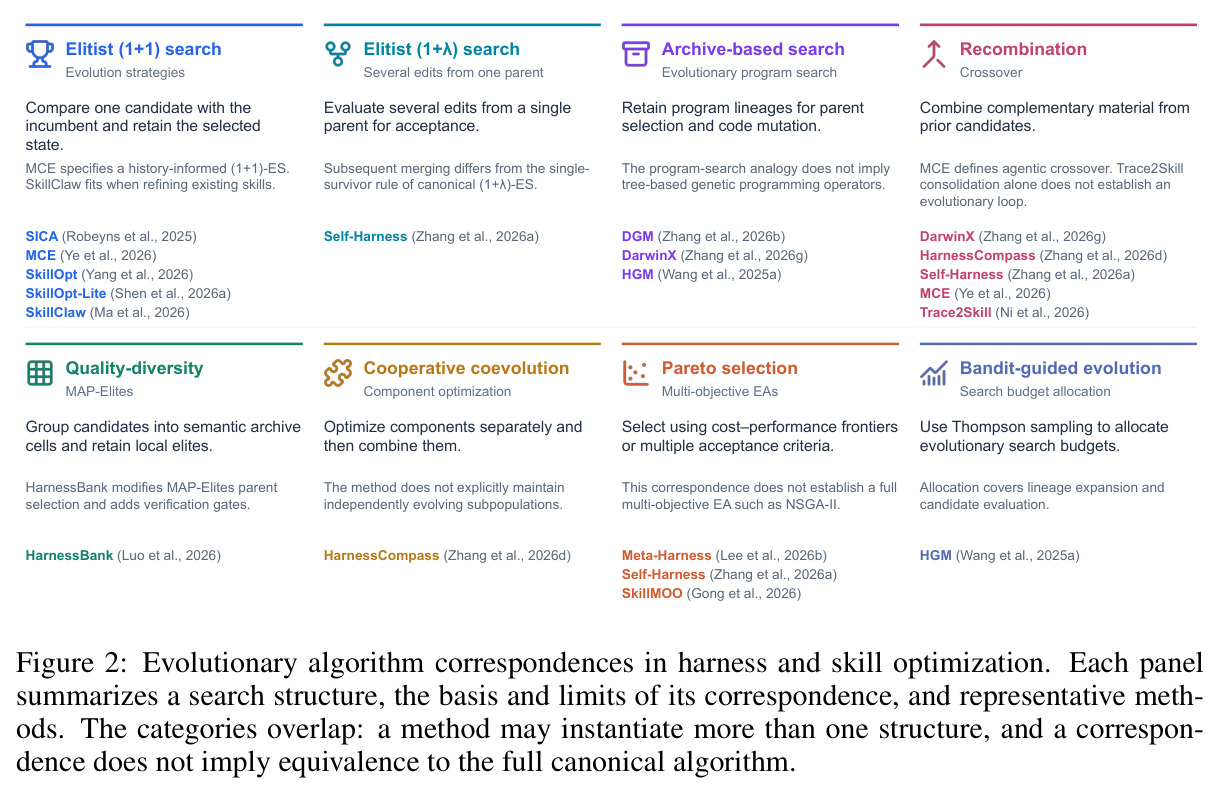
第 4.1 节用八类对应关系(Figure 2)把 HarnessOpt、Self-Harness、DGM、DarwinX 等代表方法映射到这些结构上,是读懂本文文献综合与理论动机的地图。
遗忘与后向迁移(持续学习)
持续学习中,学习新任务导致旧任务性能下降称为遗忘,定义 $F_{s,k}=R_s(H_k)-R_s(H_s)$,正值即遗忘、负值为后向迁移。若后续每次转移的回归量 $R_s(H_u)-R_s(H_{u-1})\le\varepsilon_{s,u}$,伸缩求和给出 $F_{s,k}\le\sum_{u=s+1}^{k}\varepsilon_{s,u}$。
留存界 Eq.(6) 直接依赖这个量;论文强调回归预算是外生假设而非稳定性的推论,理解这一点才能正确评估理论结果的强度与局限。
研究动机
部署之后任务与环境持续变化,智能体需要持续适应机制。适应有两条路:改模型权重或改 harness。改权重的代价很具体:需要重训与额外 checkpoint 存储,通过专有 API 部署的模型根本拿不到权重,且在不同 checkpoint 之间归因行为差异需要额外对照实验。而改 harness 的现有方法(Reflexion、ExpeL、GEPA、Voyager、Darwin Gödel Machine、Self-Harness 等)在「改什么、怎么生成候选、怎么决定接受」三个维度上各行其是,缺乏统一分类:有的只改提示词,有的整理记忆,有的重写代码与运行时逻辑。更关键的是,仅凭经验选优不能建立泛化与留存——精英式选择会让修订过拟合评估条件或遗忘既有能力;持久化修订还会让错误跨任务传播:个人工作区里临时补丁会变成长期规则、注入指令跨任务存活,企业里带缺陷的共享技能可能引发相关联错误,机器人场景中错误的动作代码会造成不可逆的物理后果。
本文的目标是本文要为 harness 自进化建立一个可操作的统一框架:给出满足两个必要条件(运行反馈与更新机制持续可用;被接受修订跨运行持久化)的形式化定义;按「修改对象」建立分类法,区分解释态更新(指令、记忆、基于固定算子的工作流编排)与可执行修订(组件实现、仓库级控制逻辑、插件组合);用经典稳定性与集中不等式给出三个条件性理论结果——期望泛化界、依赖历史回归预算的留存界、基于全新独立验证数据的高概率准入规则;最后在个人工作区、企业自动化、科学发现、机器人、公共服务五类场景中讨论系统设计权衡与安全边界。
与已有工作不同的是,独特切入有三点。第一,解耦三个常被混为一谈的维度:更新目标(改什么)、提议机制(怎么生成候选)、准入机制(怎么决定接受),并指出分类更新目标本身并不能保证满足反馈、连续性与持久化要求。第二,把 harness 搜索映射到进化算法结构(精英、档案、Pareto、协同进化等八类对应),再从持续 PAC 学习视角处理「接受修订」的统计有效性:特别强调验证数据必须与候选构造条件独立,指出 HarnessBank 复用训练任务筛选、Self-Harness 复用留出回归切分的现有做法不满足独立性假设,保密与比较次数修正都移除不了自适应依赖。第三,明确「档案成员资格」与「部署采用」是两件事,以及修订不可逆时的安全边界设计。
核心方法
直觉上,模型固定时 harness 是行为的「可编程层」,可以像软件一样经历诊断—修补—验证—发布的生命周期。形式化:harness $H$ 在任务环境 $E$ 中 governing 模型 $M$ 的执行,一次执行产生 rollout $\tau\sim\mathrm{Run}(M,H,E)$,最终评估为 $y=J(\tau)$,其中 $J$(打分、结果核验及决定结果的记录)不可被修改。第 $k\ge 1$ 轮:现任 $H_{k-1}$ 产生批量 $b$ 条 rollout $B_k=\{\tau_{k,i}\}_{i=1}^b$(各含轨迹、结果与可用反馈),然后更新 $H_k=\mathrm{Update}(H_{k-1},B_k)$。更新算子组合诊断、提议、评估、准入四步,可利用历史反馈、归档候选与额外验证 rollout;若无修订被接受则保持 $H_k=H_{k-1}$。被接受的修订持久化并在后续运行加载,其执行反馈又指导下一次更新,形成闭环。
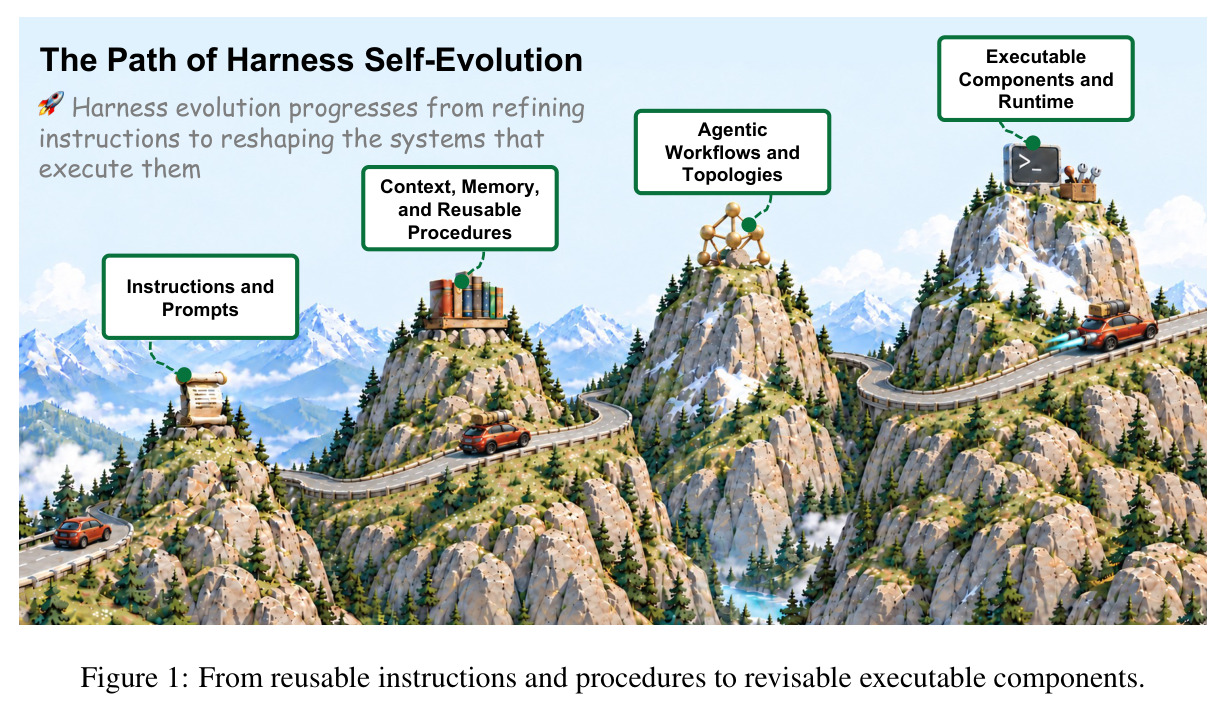
核心创新一:按变异边界组织更新目标的分类法。解释态修订改指令、存储经验、基于固定协调接口与预定义算子的任务级工作流(包括仅组合这些算子的代码);可执行修订改组件实现、仓库级控制逻辑(上下文构建、编排循环、执行钩子、恢复与终止)或插件组合(运行时服务如记忆存储、工具分派、主循环的绑定与替换)。判据是「编辑对象的角色」而非编程语言:编辑记忆管理函数是可执行修订,仅整理记忆条目是解释态。核心创新二:准入的统计证书。在来自历史混合分布的 $m$ 个新鲜独立任务上计算配对差值 $\hat{\Delta}_k(H')$,用 Hoeffding 加联合界得到高概率上界,只接受上界为负的候选——这与「经验选优即接受」的现有方法有本质区别。
方法步骤详情
完整生命周期六步。(1) 运行:现任 $H_{k-1}$ 产生批量 $b$ 条 rollout $B_k=\{\tau_{k,i}\}_{i=1}^b$,每条含轨迹、结果与反馈,$y=J(\tau)$ 打分。(2) 诊断:结合历史反馈与归档候选,从轨迹与失败中定位改进点。(3) 提议:生成候选修订 $H'$,变异可来自单亲多编辑、谱系变异或重组(对应 Figure 2 八类结构)。(4) 评估:从历史混合分布 $\bar{R}_k$ 抽 $m$ 个新鲜独立任务构成 $V_k$,计算配对差值 $\hat{\Delta}_k(H')=\frac{1}{m}\sum_{z\in V_k}[\ell(H',z)-\ell(H_{k-1},z)]$。(5) 准入:若 $\hat{\Delta}_k(H')+\sqrt{2\ln(KT/\delta)/m}<0$ 则接受,否则保留现任;评估器偏差为 $\eta$ 时改用 $\hat{\Delta}_k(H')+\sqrt{2\ln(KT/\delta)/m}+2\eta<0$。(6) 持久化:接受修订写入存储,后续运行加载,反馈指导下轮更新。理论上以稳定性界 $E[R_s(H_k)-\hat{R}_s(H_k)]\le\beta_{s,k}$ 与留存界 $ER_s(H_k)\le E\hat{R}_s(H_s)+\beta_{s,s}+\sum_{u=s+1}^{k}\varepsilon_{s,u}$ 控制泛化与遗忘。
技术新颖性
与 ADAS、Darwin Gödel Machine 等「自动设计智能体系统」工作的区别:本文不提出新优化器,而是给出统一形式化、分类法与条件性理论,把散落的方法放进同一坐标系(Figure 2 的八类 EA 对应、Table 1 的七类运行时功能)。与 Gödel Machine 的区别:不要求证明最优性,用统计准入替代可证明准入,代价是结论条件化于独立采样与回归预算假设。技术上的清醒之处在于负面陈述:小代码补丁不等于完整更新过程的稳定性;回归预算 $\varepsilon_{s,u}$ 是独立假设而非稳定性推论且逐轮累积;准入证书只在历史混合分布上成立,混合分布上的增益不保证分组留存;保护 $J$ 也不能阻止 specification gaming。这些界定把「经验涨点」与「可靠自我改进」之间的鸿沟形式化了。
实验结果
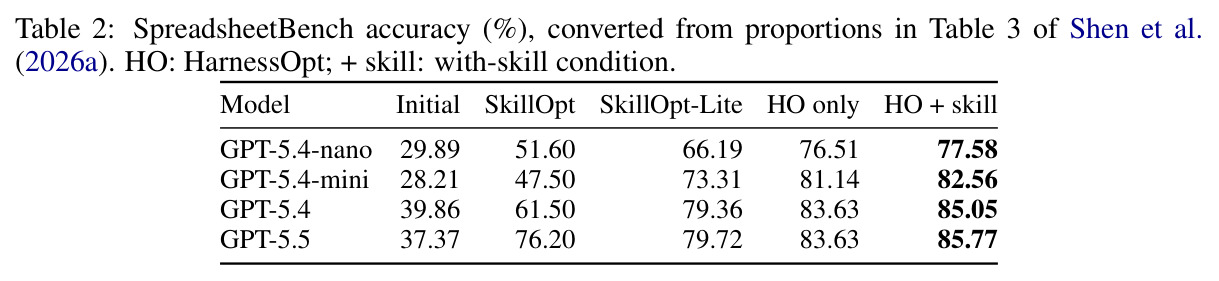
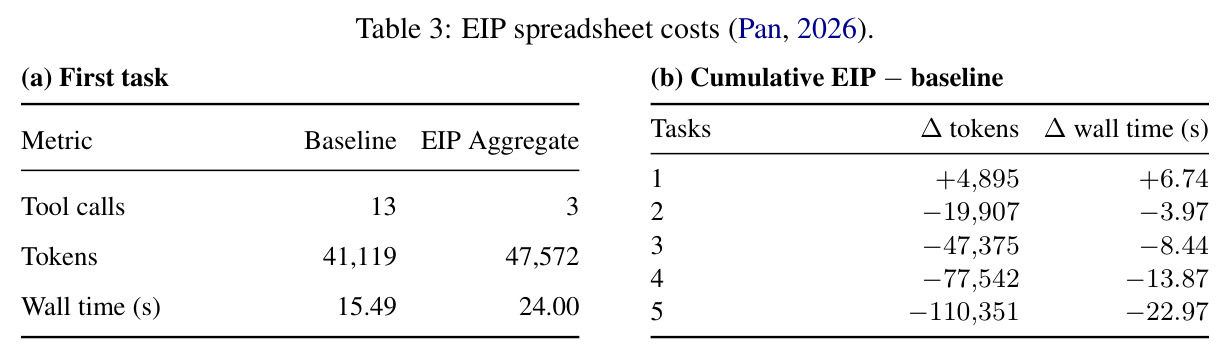
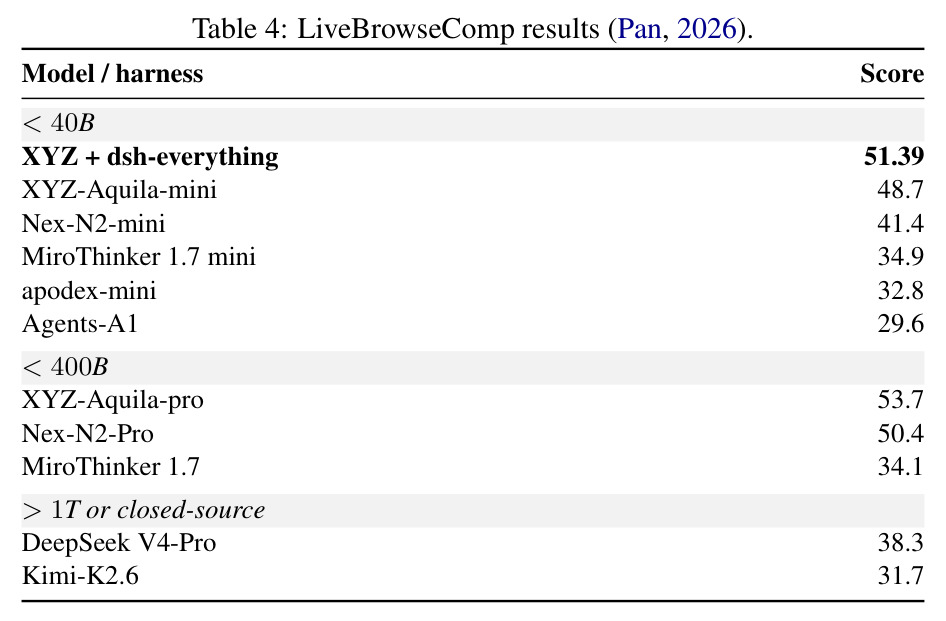
本文为框架/立场论文,自身无新实验,定量证据来自二手案例分析。(1) HarnessOpt(把 SkillOpt-Lite 扩展到运行时修订)在 SpreadsheetBench 上:GPT-5.4-nano+HO+skill 达 77.58%,超过 GPT-5.5+SkillOpt 的 76.20%(初始仅 29.89%);四模型上 HO+skill 相对 SkillOpt-Lite 提升 5.69–11.39 个百分点,构成模型–harness 配对的交叉证据,但作者承认未建立等成本优越性。(2) EIP/DSH Everything 案例:Codex 自生成批量查找与汇总工具,首轮工具调用 13→3,代价为 wall time +54.9%(15.49→24.00s)、tokens +15.7%(41,119→47,572);累计序列第 2 个任务起转为节省,5 个任务后累计节省 110,351 tokens、22.97s;但首轮隐含 +6,453 tokens/+8.51s 与累计表 +4,895/+6.74 存在未解决的不一致。(3) LiveBrowseComp:XYZ+dsh-everything 得 51.39,居 <40B 组六者之首(次名 48.7),11 条目中第二(XYZ-Aquila-pro 53.7),单位未说明。(4) 理论产出为 Eq.(5) 稳定性界、Eq.(6) 留存界、Eq.(8) 高概率准入规则与 Eq.(9) 评估器偏差修正。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SpreadsheetBench(GPT-5.4-nano) | 准确率 (%) | HarnessOpt + skill:77.58 | 初始 harness 29.89;SkillOpt 51.60;SkillOpt-Lite 66.19 | 较初始 +47.69pp,较 SkillOpt-Lite +11.39pp,且超过 GPT-5.5+SkillOpt 的 76.20 |
| SpreadsheetBench(跨四模型) | 准确率 (%) | HO+skill:77.58 / 82.56 / 85.05 / 85.77 | SkillOpt-Lite:66.19 / 73.31 / 79.36 / 79.72 | +5.69 至 +11.39 个百分点 |
| EIP 模拟办公负载(首个任务) | 工具调用次数 / tokens / wall time | 3 次调用 / 47,572 tokens / 24.00s | 无插件基线:13 次调用 / 41,119 tokens / 15.49s | 调用 −77%;代价为 tokens +15.7%、wall time +54.9% |
| EIP 累计成本(5 个任务) | 累计 Δtokens / Δwall time (s) | −110,351 tokens / −22.97s | 无插件基线 | 第 2 个任务起转正为节省,节省逐任务扩大(第 2 任务 −19,907/−3.97) |
| LiveBrowseComp(<40B 组) | score(单位未说明) | XYZ + dsh-everything:51.39 | XYZ-Aquila-mini 48.7;Nex-N2-mini 41.4 | +2.69(组内第一,全部 11 条目中第二,仅次于 <400B 的 XYZ-Aquila-pro 53.7) |
局限与改进
理论结果高度条件化:任务需在轮内与轮间从外生分布独立抽取,真实流式负载难以满足;相关会话需分组或依赖感知分析,非可加指标需另行论证;回归预算 $\varepsilon_{s,u}$ 是外生假设而非可检验推论,且 allowances 逐轮累积,检查需对部署组合(含合并编辑与共享路由)做组级不确定度控制;准入证书只在历史混合分布上成立,不覆盖未来分布漂移;评估器–目标风险差 $\eta$ 需要可执行检查或独立人类评估的证据,没有它证书只对评估器定义的损失有效,而保护 $J$ 也无法阻止 specification gaming。实证部分全是二手引用:数据来自单一来源演示(甚至包括一篇知乎回答)、无重复运行、无匹配预算与匹配质量对照、Table 4 单位未说明、Table 3 两套数字不一致(首轮隐含 +6,453 tokens/+8.51s vs 累计表 +4,895/+6.74),作者也反复承认「未建立等成本优越性」。我自己的观察:文中稳定性参数 $\beta_{s,k}$ 与 $\eta$ 均无可操作估计方法,理论离真实部署还有相当距离。
独立分析的弱点
弱点一:独立性与自适应复用的张力。准入要求每轮从混合分布抽 $m$ 个新鲜任务,但长期运行的系统会自然耗尽任务预算;论文引用 Dwork 等的可复用 holdout 却未给出可实现协议。改进方向:把 Eq.(8) 升级为 always-valid 推断或 ladder 式预算化准入,并实证 fresh 验证的成本曲线。弱点二:$\beta_{s,k}$ 不可操作化。更新算子包含 LLM 提议器,理论上无法计算其 replace-one 敏感度,论文也没给出估计程序;改进方向:借鉴差分隐私的敏感度上界或经验稳定性估计,给出黑盒近似。弱点三:分类法判据含糊。「仅组合固定算子的代码算解释态」依赖对「算子」的界定,插件组合被作者承认可跨类别(一个修订可属多类);改进方向:形式化接口契约与绑定语义,使分类可判定。弱点四:安全建议缺乏强制机制。「$J$ 不可改、急停与限额放在可编辑面之外」只是设计原则,没有威胁模型与攻击面评估;改进方向:与数据流/工具序列运行时约束(如 Doshi 等)结合做可评测原型,用攻击成功率、隔离时间、合法工作开销三个指标验证。
未来方向
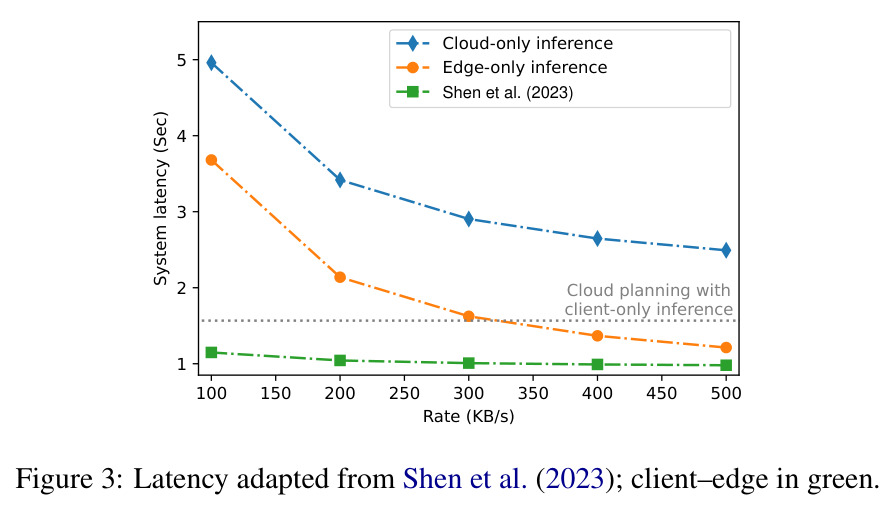
作者在第 6 节提出五个方向。模型–harness 协同设计:等预算比较模型选择、技能优化、运行时修订与权重更新,同时计入适应与后续执行成本,用冻结/迁移/再进化 harness 跨 checkpoint 测试区分可迁移增益;交叉证据是 GPT-5.4-nano+HO+skill 的 77.58% 胜过 GPT-5.5+SkillOpt 的 76.20%。分布式执行与边缘基础设施:参考 Shen et al. (2023) 的 Jetson Nano 客户端 + RTX 4090 边缘 + Azure 在 10% 分类/40% captioning/50% VQA 负载、100–500 KB/s 下的延迟数据,把 harness 合成、验证与分发成本计入部署比较。插件创建与复用生命周期:度量多少相关任务能回收生成与验证成本(EIP 案例第 2 个任务起累计节省 19,907 tokens)。分布与评估器漂移下的持续验证:时间戳任务、版本固定环境、难度校准,以及校准/准入/回归检查间的预算分配。安全边界:最小权限、时限授权、隔离,「创建能力不得赋予权限」。可延伸方向:为 $\beta_{s,k}$ 与 $\eta$ 设计经验估计基准;把准入规则与在线多重检验(always-valid 推断)结合。
复现评估
论文自身材料开源良好:代码与持续更新的补充材料在 GitHub(zgcagi/Harness-RSI),66 页配套技术报告在 OpenReview(openreview.net/pdf?id=m5jsFGXUM2)。复现难度分层明显:理论部分用经典工具(replace-one 稳定性、Hoeffding、联合界)即可独立复验,几乎零算力;但复现引用案例数字很难——SpreadsheetBench 的 HarnessOpt 结果需要第三方系统(arXiv:2607.03451)与 GPT-5.4/5.5 级专有模型 API,EIP 案例的完整来源甚至是一篇知乎回答与一个 GitHub 仓库(dsh-everything),无重复运行与匹配预算,且 Table 3 内部数字不一致、Table 4 单位未说明。此外论文自身无任何新实验,所有「结果」均依赖对第三方报告的忠实转述。综合评估:复现框架与理论容易,复现实证结论基本不可行,适合将其视为领域地图与议程设置文献而非实证基线。
论文图表