几何的学习与推理:生成如何助力空间理解 Learning and Reasoning with Geometry: How Generation Helps Spatial Understanding
统一模型共训深度/多视角生成与空间理解,并学会按需生成深度证据修正答案
前置知识
视觉自编码器(VAE)
将图像压缩到低维潜空间、再从潜变量重建图像的编码器-解码器,是 BAGEL 等统一生成模型的骨干组件。本文冻结在 RGB 图像上预训练的 VAE:生成任务在潜空间预测速度场,最后由解码器还原图像。关键技巧是把深度图也编码成三通道"伪图像"送入同一 VAE,从而不改架构就能生成深度。
MMDC 的全部设计都围绕"让度量深度兼容冻结 RGB VAE 的有界输入"展开,不懂 VAE 就无法理解这一约束以及解码端加权融合的动机。
流匹配(Flow Matching)
一类生成训练目标:对数据潜变量加噪,训练网络预测从噪声到数据的概率流速度场,推理时沿速度场积分即可从噪声采样出目标。相比扩散模型的逐步去噪,它训练稳定、采样路径更平直。本文的度量深度生成、多视角生成与 exo-to-ego 生成三类任务统一采用速度预测目标,仅条件和目标图像不同。
论文所有几何生成任务共享"冻结 VAE + 流匹配速度预测"这一机制,方法部分的任务统一设计与训练损失都建立在该概念上。
仿射不变深度与度量深度
单目深度估计常输出仿射不变深度:预测与真值只差一个未知的尺度和平移,需按每张图 2%/98% 分位数归一化(如 Marigold),推理时因不知这两个统计量而无法还原真实米数。度量深度以米为单位、跨图像尺度一致。本文用固定枢轴 $c$ 的可逆映射 $y=(d-c)/(d+c)\in(-1,1)$ 编码度量深度,生成后可直接换算回米制。
全文的核心动机正是绕开仿射不变表示、让生成深度成为可测量的证据,这组对比是理解 MMDC 与深度实验的前提。
RLVR 与 GSPO
可验证奖励强化学习(RLVR)用可自动判定的奖励(如答案对错)训练语言模型策略。GSPO 是轨迹级组相对优化:同一问题采样 G 条 rollout,以组内奖励均值 $\bar r$ 为基线,优势 $A_i=(r_i-\bar r)/(s_r+\epsilon)$,$s_r$ 为组内标准差。本文发现当组内所有 rollout 都生成时,代价 $\lambda$ 在该式中相消,因而为决策 token 设计了专门优势。
"何时生成深度"的决策完全靠这套 RL 信号学出来,公式 5–7 的推导与 Table 3 消融是方法的核心创新。
循环准确率(Circular Accuracy)
选择题模型常带选项位置偏好。循环准确率把每题按两种选项顺序各测一次,只有两个顺序都答对才计为正确,同时可统计"两顺序答同一字母"的比例作为偏置指标。论文主表全部采用该指标:直接回答的位置偏置为 9.7%,总是生成降到 0.1%,GeoUG 为 0.7%。
Table 1/2 与 3DCueBench 分析中的所有数字都是循环准确率,不了解定义就无法正确比较各模型成绩。
exo-to-ego 生成(跨视角透视取位)
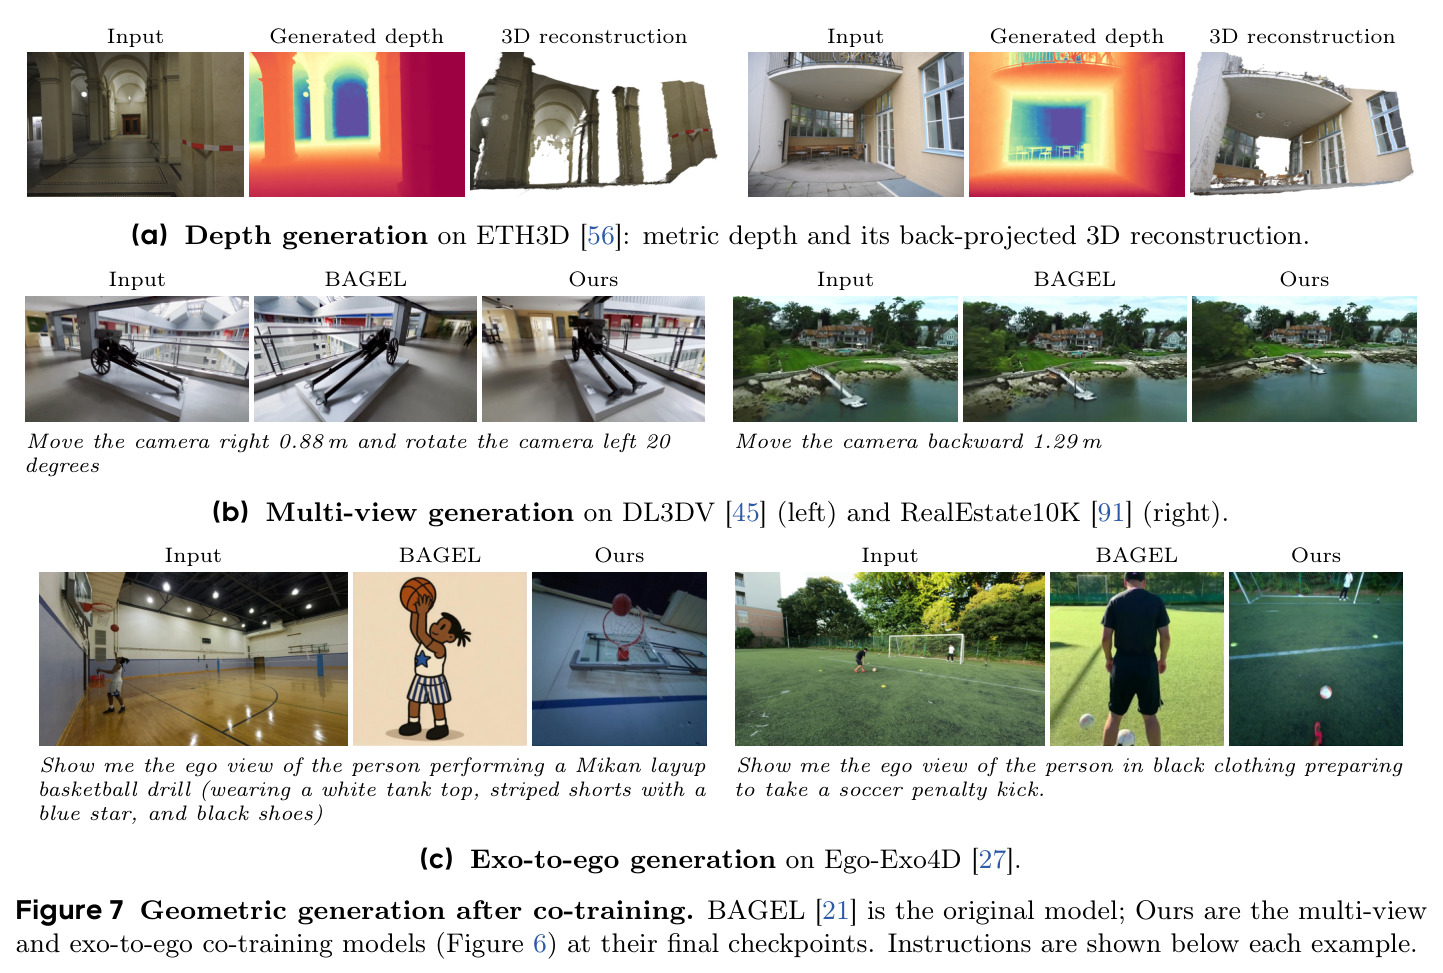
给定第三人称(exo)图像和人物描述,模型需渲染出该人物头戴相机看到的第一人称(ego)画面,要求模型定位人物、推断其视线方向并想象他人视角下的场景,即"透视取位"。训练对来自 Ego-Exo4D 的同步 exo/ego 帧,共 171,558 对,ego 目标缩放到 512×512。
它是论文三类几何生成任务之一,实验显示其与多视角生成共同给 MindCube 等多视角空间理解带来 2.21/2.31 点提升。
研究动机
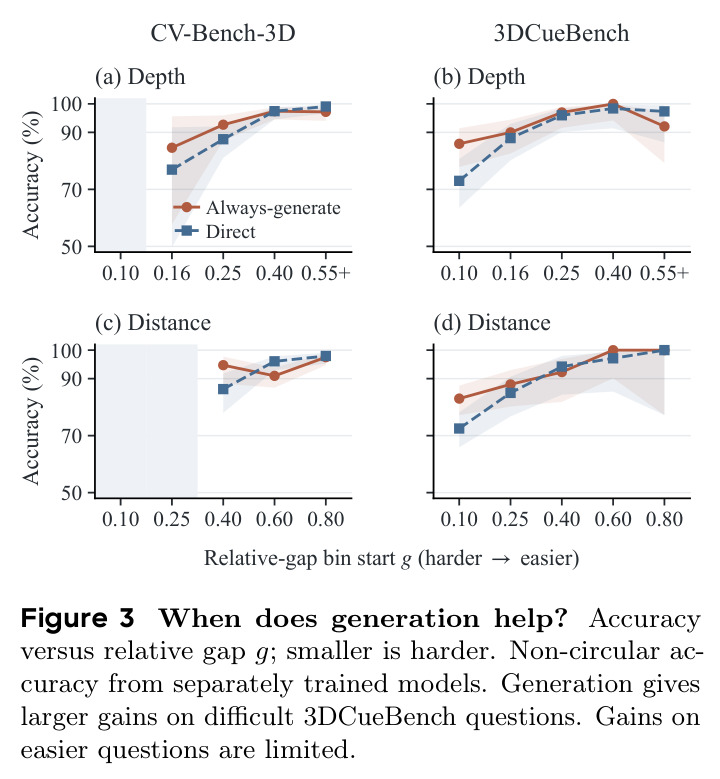
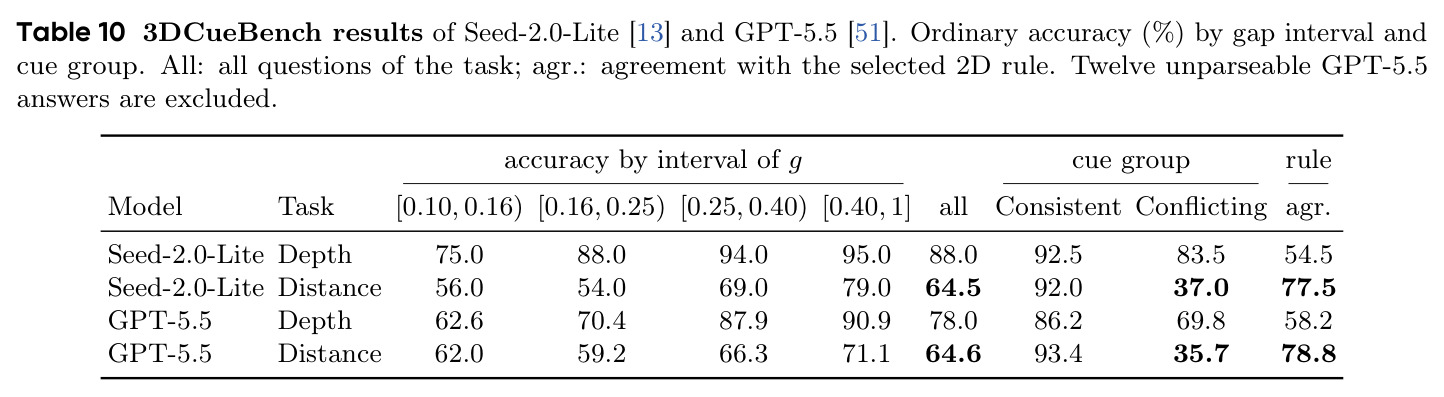
视觉语言模型(VLM)的空间理解既薄弱又被评估捷径污染。作者对现有基准做规则审计:在 CV-Bench-3D 的 600 道 Depth 题上,"图中包围盒更低者更近"这条图像平面规则竟能答对 85.3%,且全部 1200 题没有一道相对间隙 $g<0.16$(Depth 中位数 0.49、Distance 中位数 0.76,75%/98.8% 落在最简单的 $g\ge0.40$ 区间);在为"规则指向错误答案"构造的 3DCueBench Distance 子集上,Seed-2.0-Lite 和 GPT-5.5 仅得 37.0% 和 35.7%,而对规则一致的题都超过 92%,预测与规则的符合率高达 77.5%/78.8%——高分主要来自 2D 捷径而非 3D 几何。训练侧,VQA 只对问题问到的关系提供稀疏监督;统一模型预训练研究(MetaMorph 等)又表明生成与理解的知识迁移不对称且依赖任务,几何生成到底能不能、以及何时能帮助空间理解,此前缺乏定量答案。
本文的目标是论文要让几何生成在"学习"与"推理"两个阶段都发挥作用并量化收益。学习阶段:把度量深度生成、相机运动条件的多视角生成、exo-to-ego 生成与空间 QA 联合训练,回答哪种生成任务迁移到哪种空间能力;推理阶段:让模型把自生成的度量深度当显式几何证据——生成深度图、经 MMDC 解码成米制深度、用工具查询物体深度或 3D 距离,以核实或修改草稿答案,并解决"何时值得生成"的决策问题:目标是学到按需生成的策略,在远低于 100% 的生成率下保持接近"总是生成"的准确率,最终在 CV-Bench-3D、3DCueBench、DA-2K 上取得最强循环准确率(97.9%/90.8%/94.2%),并发布可控难度的 3DCueBench。
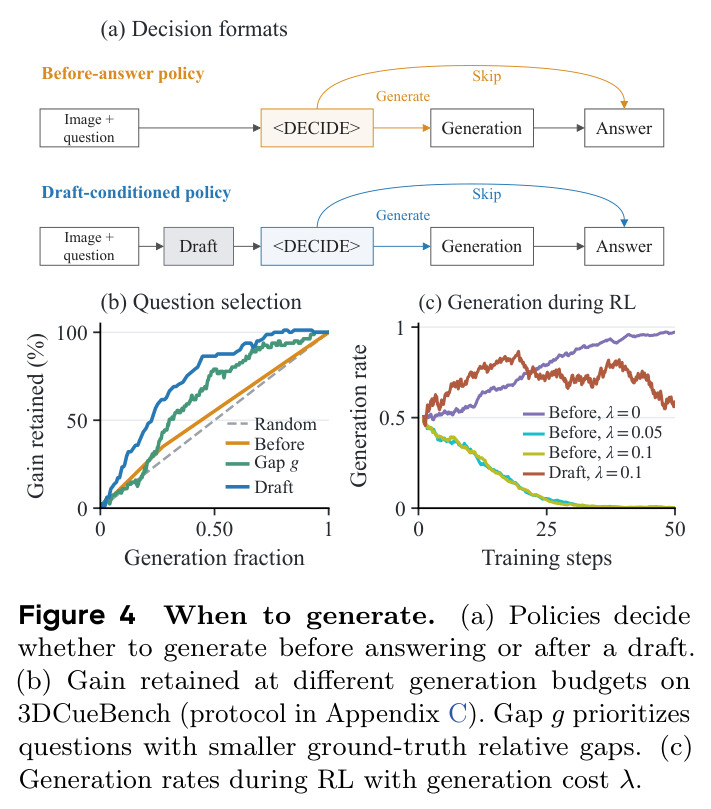
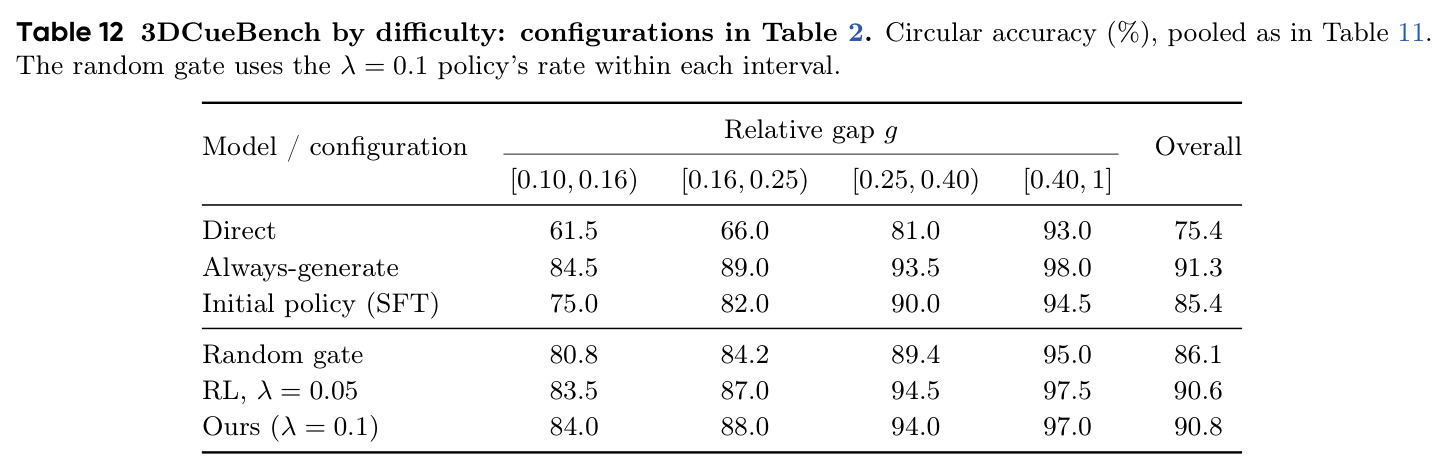
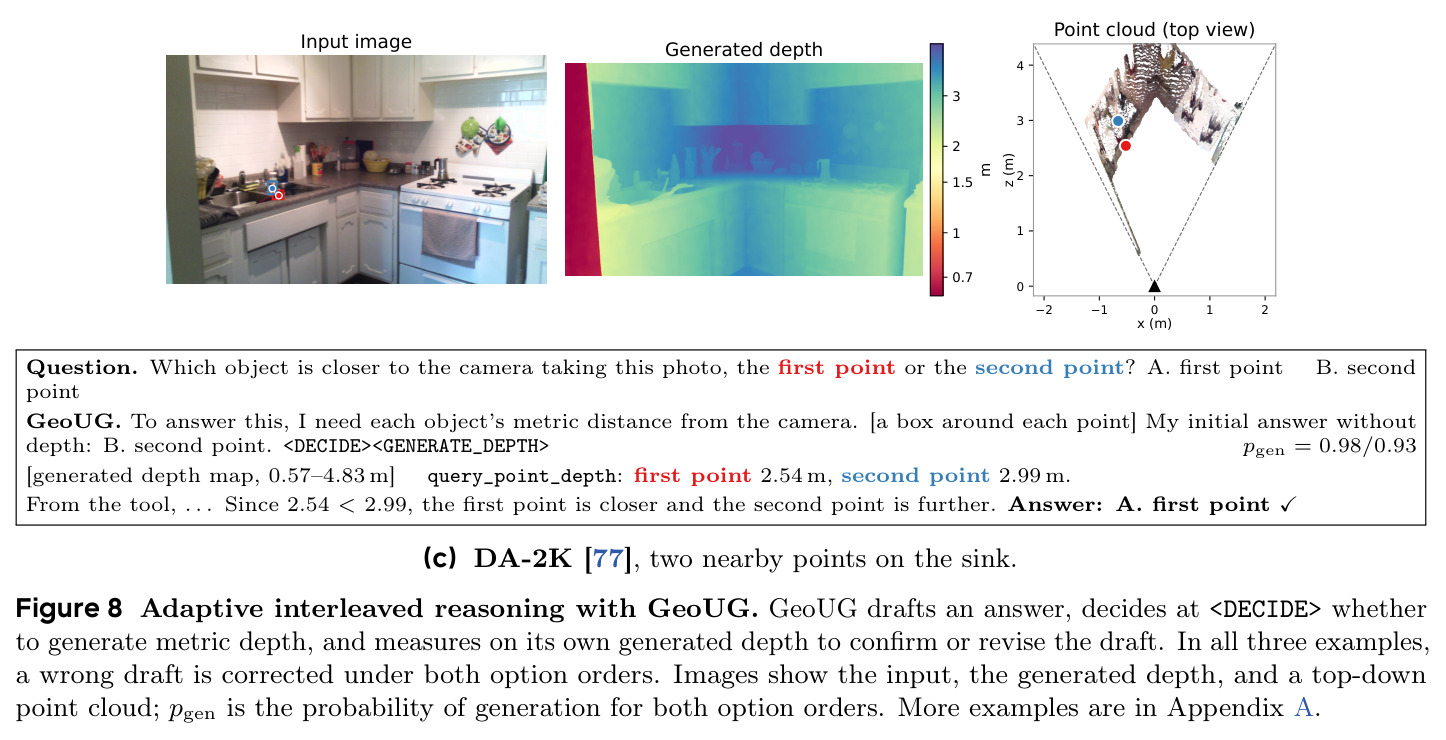
与已有工作不同的是,已有工作分三类:数据侧(SpatialVLM、VST、OpenSpatial 构造空间指令数据,但只是"属性-物体-关系"级的稀疏监督);表示侧(VLM-3R 加几何编码器提取隐式 3D token);推理侧(COOPER 学相对深度与分割的自适应交错推理、外接深度工具增强 VLM)。本文的独特切入有三点:一是表示层的 MMDC——用固定枢轴把度量深度可逆编码进冻结 RGB VAE,免参数即可生成并还原米制深度,与 Marigold 式逐图归一化(推理时无法复原尺度)本质不同;二是评估层的 3DCueBench——在四个相对间隙 $g$ 区间内平衡 2D 线索一致/冲突,首次把"生成增益"与"几何难度"解耦,发现 $g$ 越小生成增益越大;三是决策层的草稿条件化——先答草稿再决定是否生成,把决策变成对照草稿的 reconsideration,50% 预算下保留 86% 增益,而先决定再答的 before-answer 策略只有 55%,接近随机的 50%。
核心方法
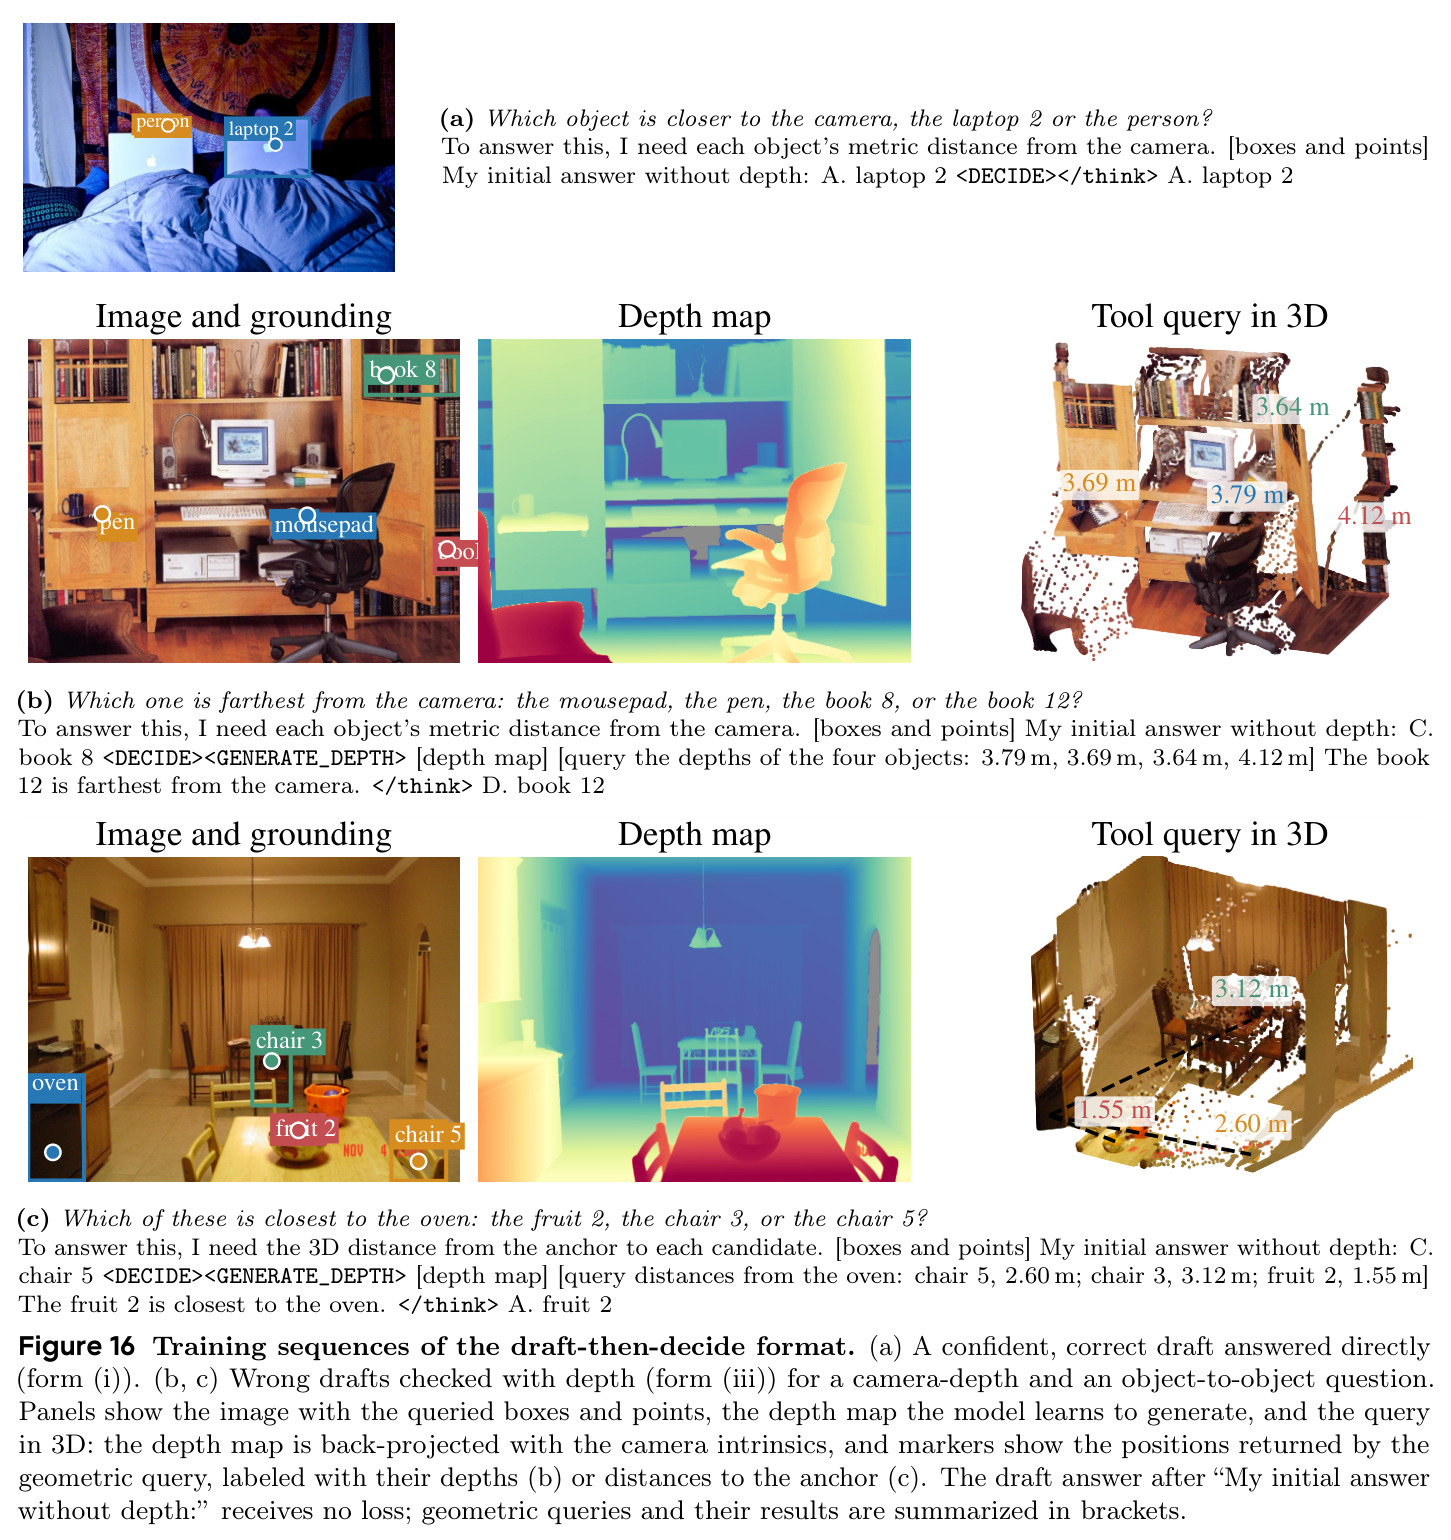
GeoUG 建立在统一理解-生成模型 BAGEL(MoT 架构)之上。思路的直觉是:空间理解缺的正是语言难以精确表达的连续几何,那就让模型自己"画"几何——生成既是稠密的学习监督,其产物又是可测量的推理证据。技术路线:训练时对文本 token 用交叉熵、对视觉生成用流匹配速度预测联合优化;深度目标先经 MMDC 编码成三通道有界伪图再进冻结 VAE;多视角与 exo-to-ego 生成的目标直接是 RGB 视图。三类生成任务共享同一机制,只有条件和目标不同。推理时执行"草稿→决定→生成→修正"的交错流程:先基于图像和问题给出草稿答案,在 token 处决定是否 ,若生成则解码深度并调用 query_point_depth / query_3d_distance 工具测量,再确认或改写答案。该决策先由构造的 CoT 数据监督冷启动(草稿 token 不计损失),再用奖励 $r_i=c_i-\lambda a_i$($\lambda=0.1$)的 GSPO 式分段优势强化学习精调。
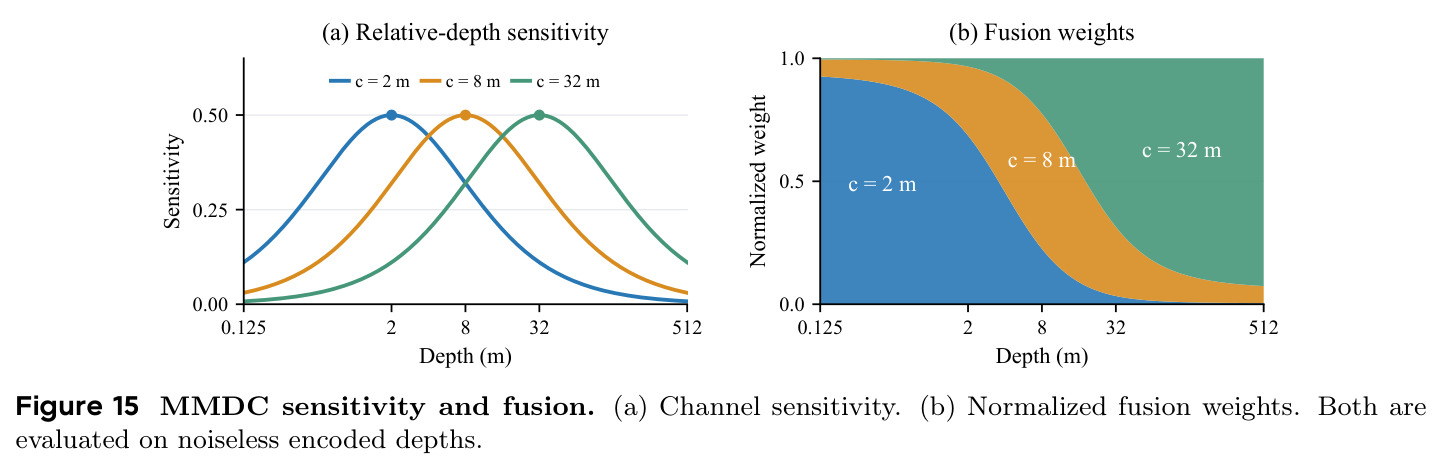
核心创新有三层。表示层:MMDC 用固定枢轴 $(c_1,c_2,c_3)=(2,8,32)$ 米把度量深度编码为 $Y_i=(d-c_i)/(d+c_i)$,三通道各覆盖一个深度尺度,解码时按灵敏度加权 $w_i=(1-\hat Y_i)^2$ 融合,免参数就让 RGB VAE 输出可还原米数的深度。评估层:3DCueBench 用相对间隙 $g=|d_a-d_b|/\max(d_a,d_b)$ 控制难度、用 cue 一致/冲突各半堵住捷径,发现生成的深度在 $g$ 小的难题上增益最大,把"何时生成有用"变成可量化的几何量。决策层:把生成决策放在草稿之后,草稿正确性 $c_{d,i}$ 可由标签得知,决策 token 因此获得"生成 vs 保留草稿"的对照优势——生成时 $(1-p_i)(c_i-\lambda-c_{d,i})$,保留时 $-p_i(\hat Q_{gen,i}-\lambda-c_{d,i})$——并用强制生成 rollout 估计 $\hat Q_{gen}$,解决了标准 GSPO 轨迹级优势中代价相消、策略坍缩的失效模式。
方法步骤详情
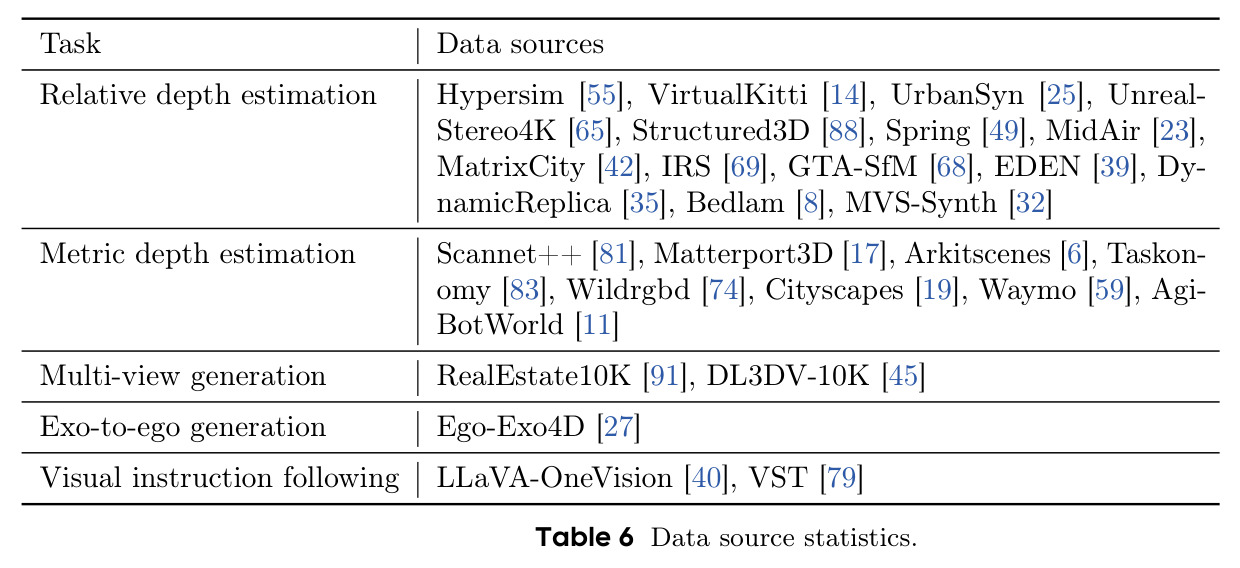
第一步,数据构建:度量深度用合成教师(DA3)与真实传感器深度做掩码最小二乘对齐 $\hat D=\hat a\tilde D+\hat b$;多视角用 DA3 重估 RealEstate10K/DL3DV 位姿统一尺度,由 Pose→Instruction 算法把旋转+平移转成带米数/度数的 Dolly/Truck/Pan 指令并平衡分布;exo-to-ego 取 Ego-Exo4D 的 171,558 对。第二步,编码:$Y_i=(d-c_i)/(d+c_i)$,枢轴 2/8/32 米。第三步,共训:空间 QA 交叉熵 + 三类生成的流匹配损失联合优化。第四步,推理:图像与问题→定位物体→草稿答案→→(若生成)输出深度图、MMDC 解码、工具查询深度/3D 距离→确认或修改草稿。第五步,训练策略:在 COCO/ADE20K 上构造 262K 题、312K 条序列(草稿错误率约 22%)监督冷启动 1500 步;再在 ScanNet++/nuScenes 的 800 道题上用 LoRA(r=32)、每题 16 rollout(4 个强制生成)做 50 步 RL。
技术新颖性
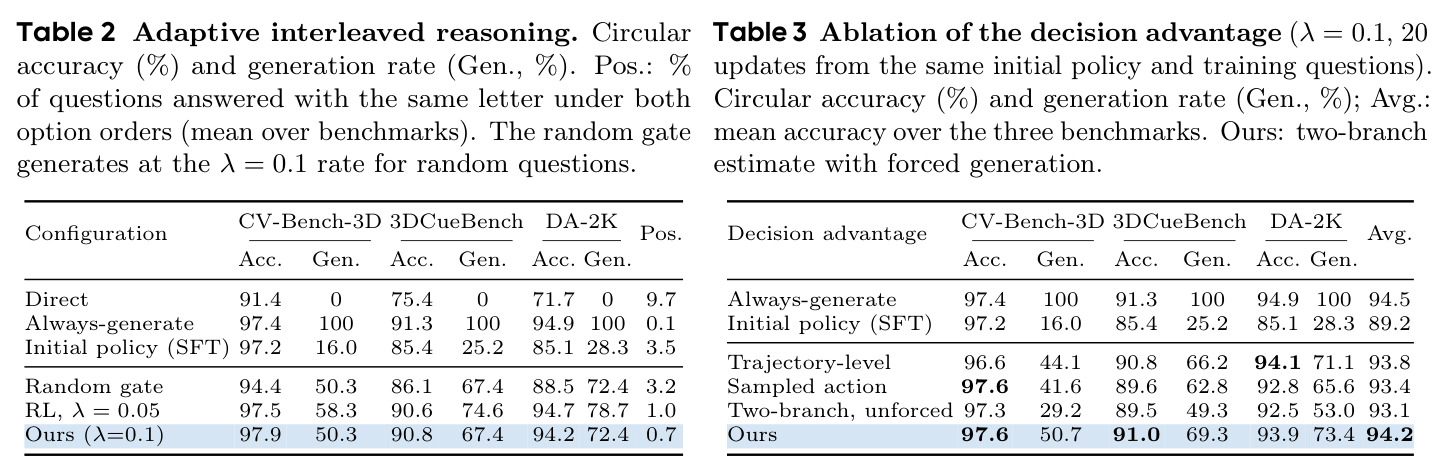
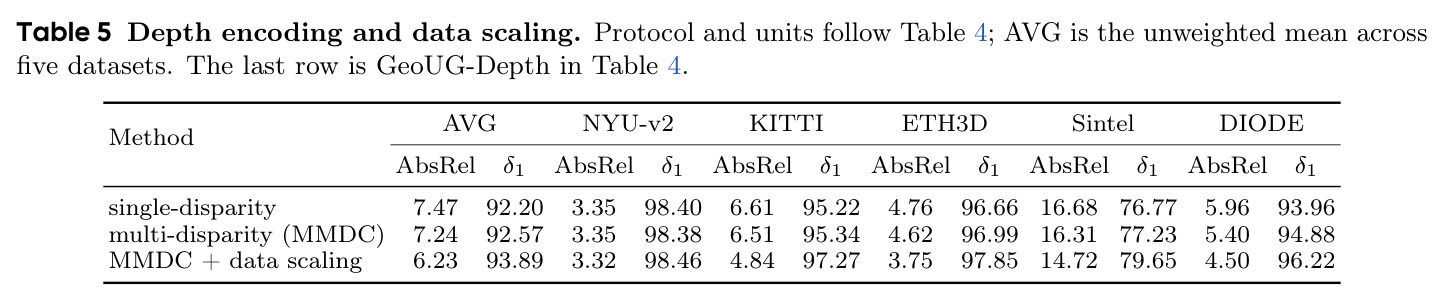
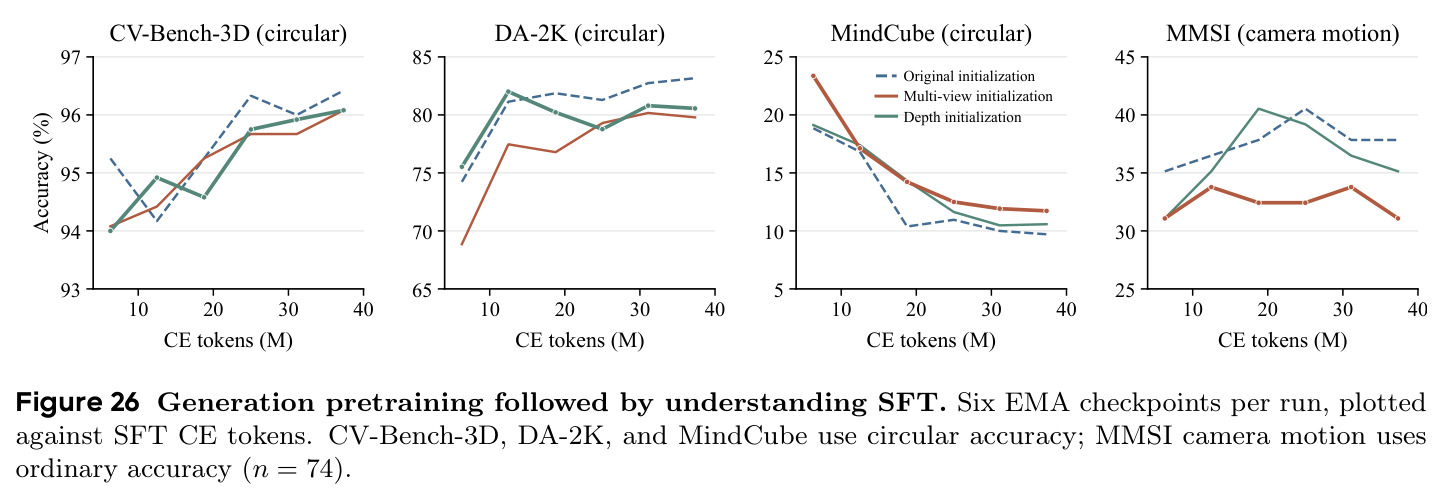
新颖性有四点。(1) 表示:MMDC 是首个免参数、推理时可逆解码回米制深度的 VAE 兼容深度编码,且有理论支撑——编码可写成 $Y_i=\tanh(\log(d/c_i)/2)$,灵敏度 $\partial Y_i/\partial u_i=(1-Y_i^2)/2$ 在 $d=c_i$ 处峰值,三个等 log 间隔枢轴铺开精度,融合权重由 inverse-variance 解 $w_i\propto(1-Y_i)^2$ 推出(Figure 15)。(2) 评估:3DCueBench 首次解耦"2D 捷径有效性"与"几何难度",并配盲文本审计(Qwen 无图准确率 48.9–50.4%、GBT 探针 53.5–56.1%)证明文本无残余捷径。(3) 决策:draft 条件化分段优势 + 强制生成估计是对 GSPO 的实质改造,消融显示比轨迹级优势高 0.34、比仅采样动作基线高 0.81、比无强制生成高 1.09 点(Table 3)。(4) 结论:"共训有效、先生成预训练再理解 SFT 无效"(DA-2K 掉 2.61/3.38 点,Figure 26)是反直觉的重要证据。
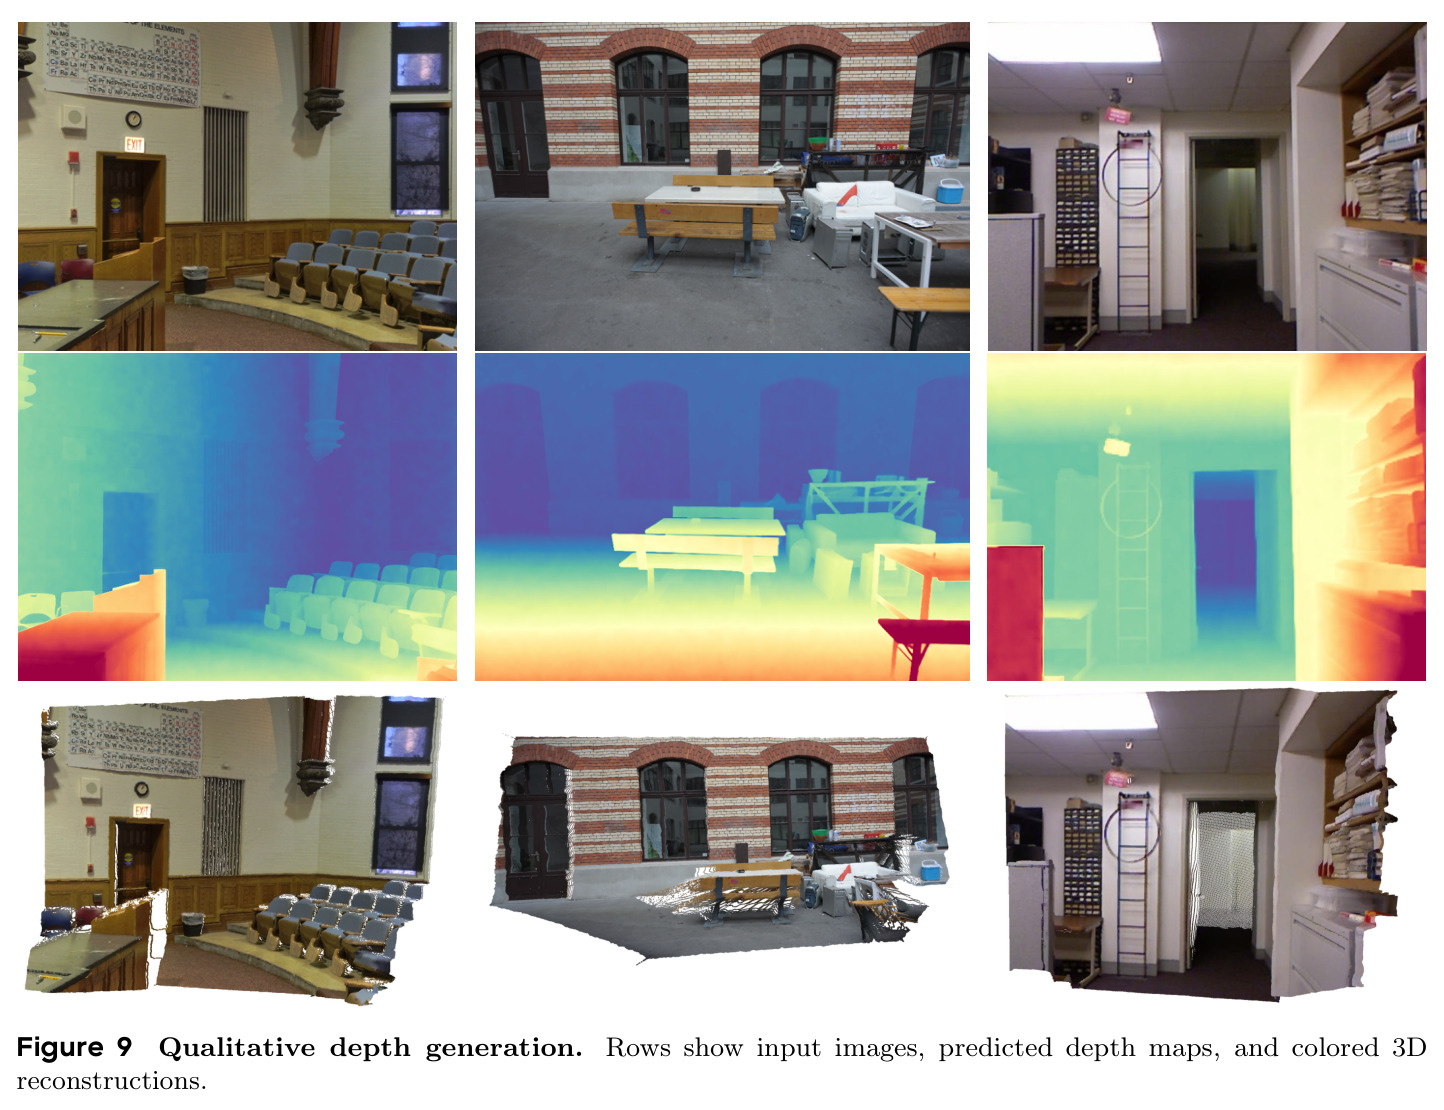
实验结果
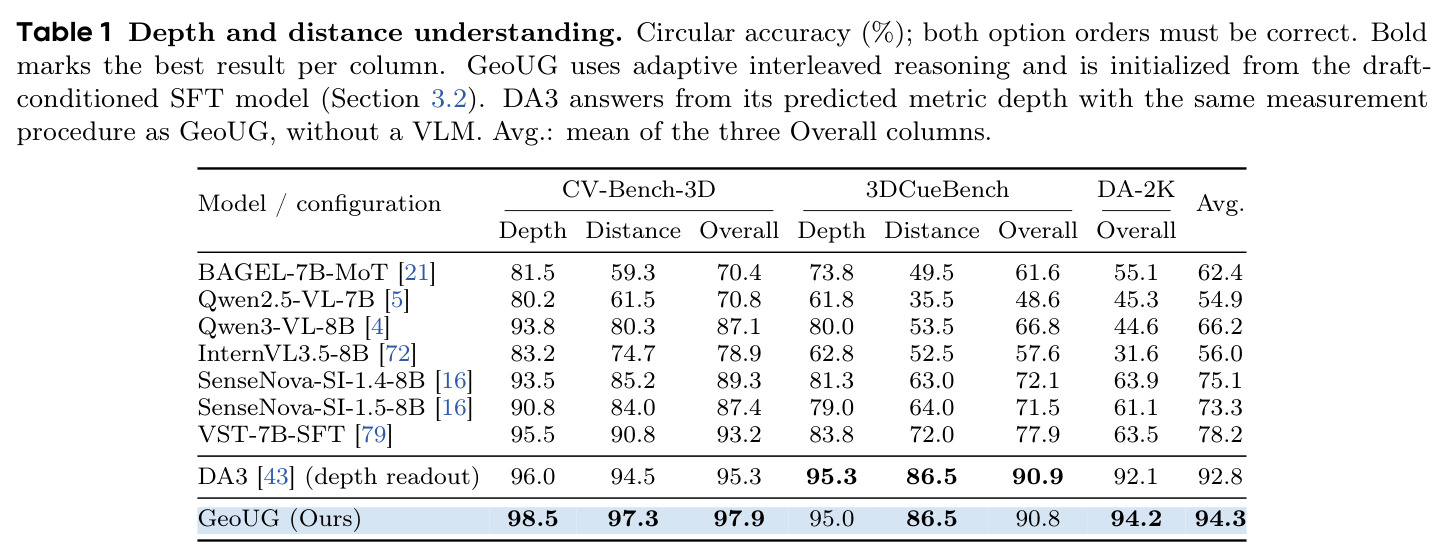
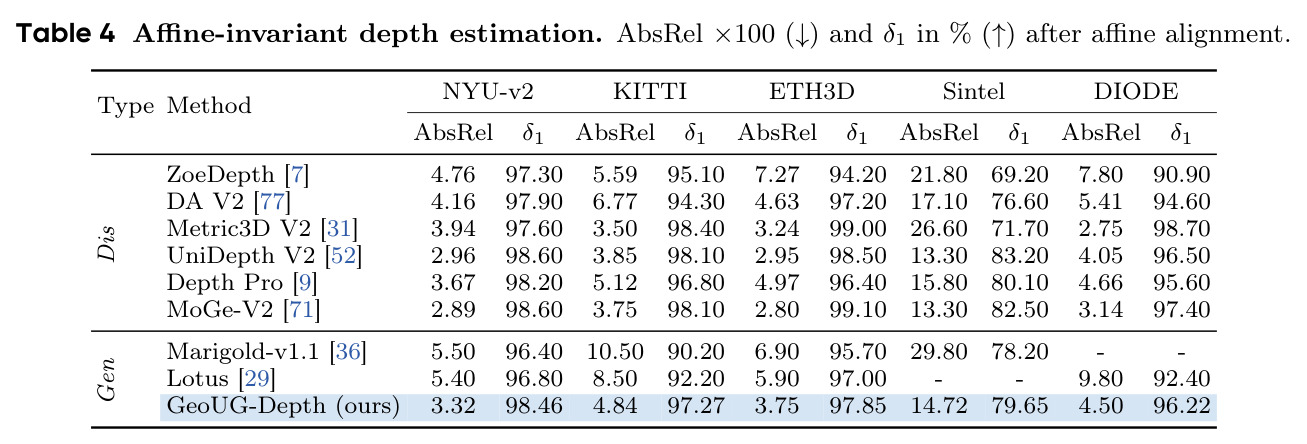
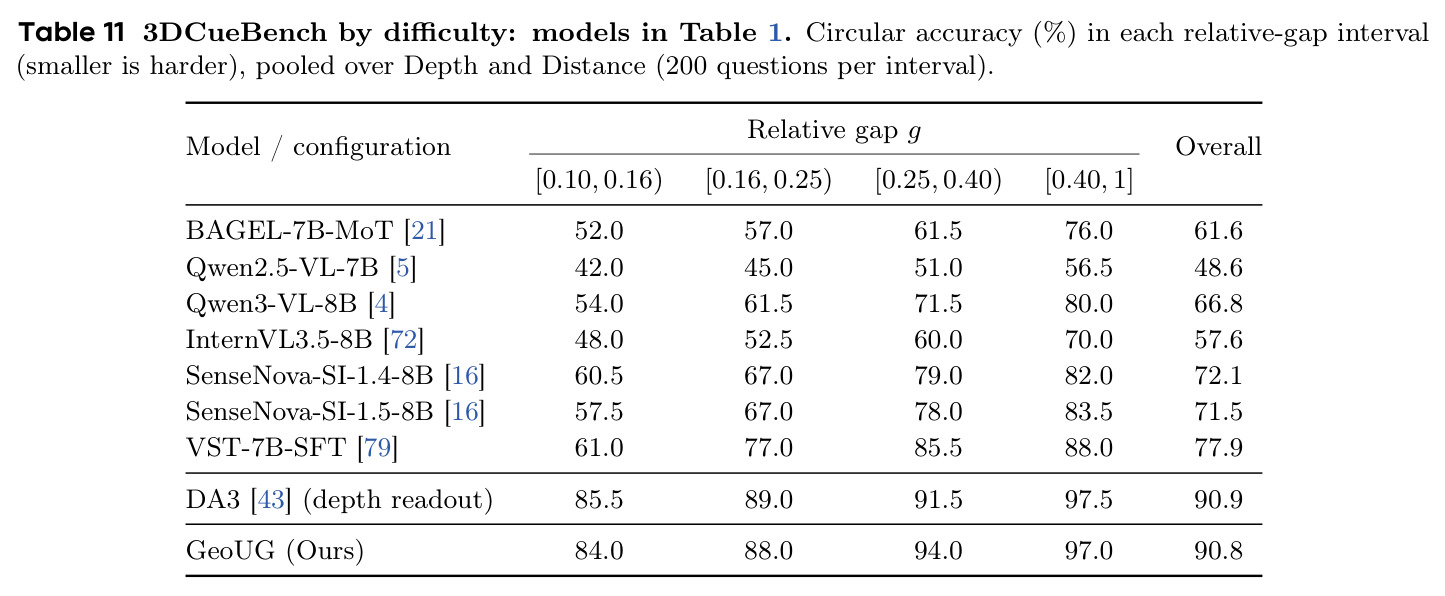
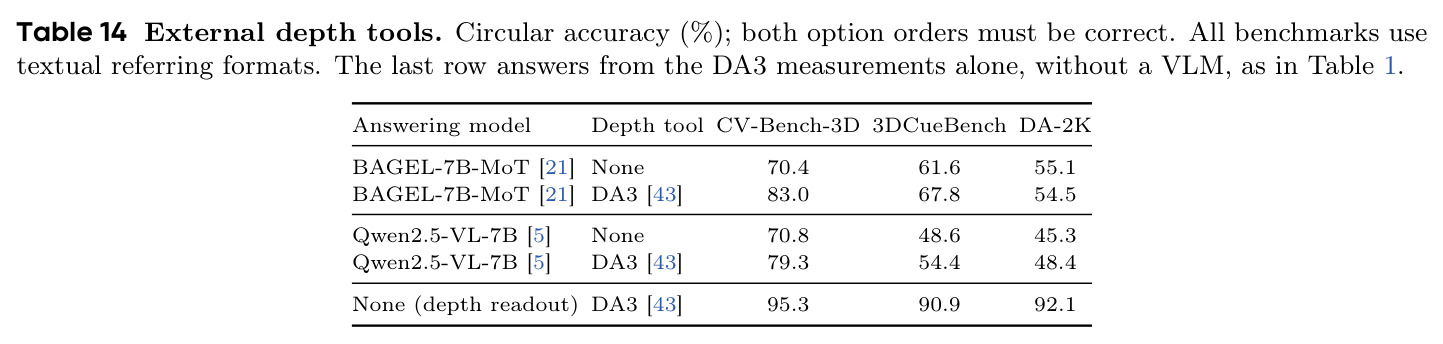
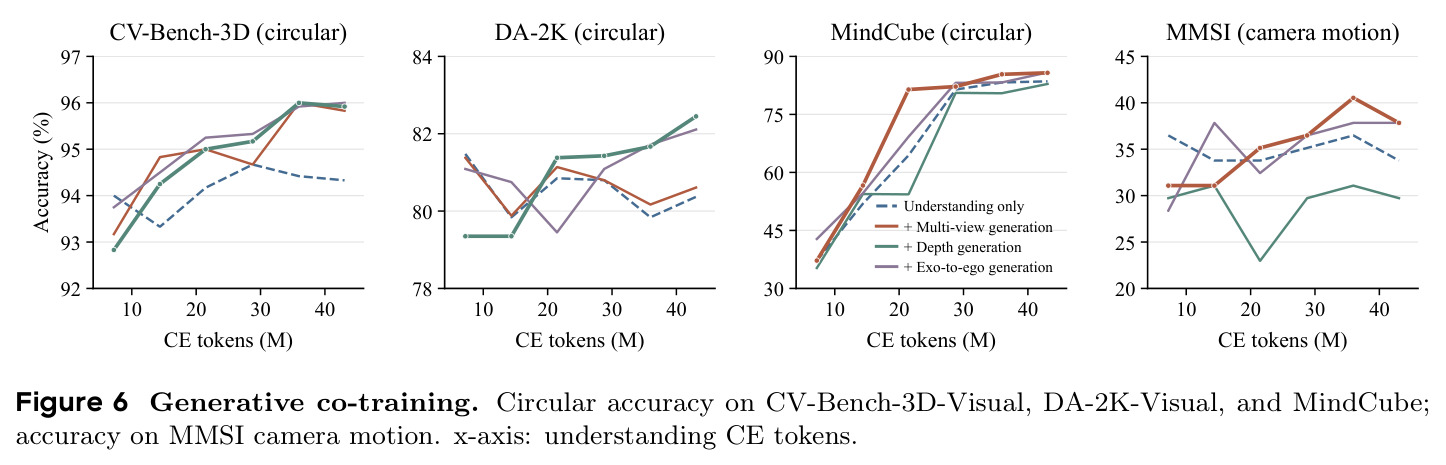
共训增益任务依赖(Figure 6):三任务使 CV-Bench-3D-Visual 升 1.50–1.67 点;深度生成对 DA-2K-Visual 增益最大(+2.08),多视角与 exo-to-ego 对 MindCube 提升 2.21/2.31 点。主结果(Table 1):GeoUG 循环准确率 97.9/90.8/94.2,比最强 VLM 基线 VST-7B-SFT(78.2)高 16.1 点、比 DA3 深度读出(92.8)高 1.5 点,且 3DCueBench 上 32.6% 的题未生成。交错推理(Table 2):总是生成较直接回答提升 6.0/15.9/23.2 点;GeoUG(λ=0.1)以 50.3–72.4% 生成率距总是生成 ≤0.7 点,比同比率随机门控高 3.5–5.7 点;生成增益随难度递减——最难区间 23.0 点、最易区间仅 5.0 点(Table 12)。深度估计(Table 4):五基准全面超 Marigold/Lotus/DA V2(NYU-v2 AbsRel 3.32 vs 4.16),但 MoGe-V2 更低(2.89)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CV-Bench-3D(Depth+Distance) | 循环准确率 (%) | 97.9(Depth 98.5 / Distance 97.3) | 最强 VLM:VST-7B-SFT 93.2;DA3 深度读出 95.3 | +4.7 vs 最强 VLM;+2.7 vs DA3 读出 |
| 3DCueBench(本文新基准,800 题) | 循环准确率 (%) | 90.8(Depth 95.0 / Distance 86.5) | VST-7B-SFT 77.9;DA3 读出 90.9;BAGEL-7B-MoT 61.6 | +12.9 vs 最强 VLM;与 DA3 读出持平,仅 67.4% 题生成深度 |
| DA-2K | 循环准确率 (%) | 94.2 | DA3 读出 92.1;VST-7B-SFT 63.5 | +2.1 vs DA3;+30.7 vs VST |
| 自适应交错推理 vs 随机门控 | 同生成率下的循环准确率差(点) | +3.5 / +4.7 / +5.7(三个基准) | 同比率随机门控(生成率 50.3–72.4%) | 以约 2/3 生成率保住"总是生成"≥99% 的精度(差距 ≤0.7 点) |
| 多视角生成(RealEstate10K/DL3DV/ScanNet++ 共 1500 对) | PSNR (dB) / SSIM / LPIPS | 13.85 / 0.495 / 0.477(RealEstate10K 上 PSNR 14.93) | 原始 BAGEL:13.16 / 0.476 / 0.520 | PSNR 最高 +1.25 dB,LPIPS −0.071 |
| exo-to-ego 生成(Ego-Exo4D 469 对) | PSNR (dB) / LPIPS | 12.41 / 0.670 | 原始 BAGEL:7.75 / 0.839 | PSNR +4.66 dB,LPIPS −0.169 |
| 单目深度估计(NYU-v2/KITTI/ETH3D/Sintel/DIODE) | AbsRel ×100 ↓ / δ1 (%) ↑(仿射对齐) | NYU 3.32/98.46;KITTI 4.84/97.27;ETH3D 3.75/97.85;Sintel 14.72/79.65;DIODE 4.50/96.22 | Marigold-v1.1:5.50/10.50/6.90/—/—;DA V2:4.16/6.77/4.63/17.10/5.41 | 两项指标全面超过 Marigold、Lotus、DA V2;MoGe-V2 的 AbsRel 仍更低(如 NYU 2.89) |
局限与改进
作者承认的局限:(1) 生成误差会反噬——直接回答在简单题上有时比生成更准,深度或测量误差可能把正确草稿改错,Figure 14 给出失败案例:草稿正确但策略生成深度并跟随工具读数改错,两个选项顺序皆错;(2) "先生成预训练再理解 SFT"实验并非完全匹配,作者明说不能确立共训是必要条件;(3) Table 14 外接工具对比未控制提示与分辨率差异。我的补充观察:(1) $\lambda$ 是与真实延迟无关的常数代价,实际部署中 50 步去噪生成远慢于直接回答,最优生成率可能被高估;(2) RL 仅在 800 道两物体比较题、50 步更新、LoRA 秩 32 上进行,对计数、朝向、多物体排序等任务的泛化未验证;(3) 深度估计 AbsRel 仍逊于 MoGe-V2(NYU 3.32 vs 2.89),度量精度封顶距离推理上限;(4) 3DCueBench 最小间隔组三种深度定义仅 44.7% 一致,小间隙题标签有定义噪声;(5) 闭源大模型只有 Seed-2.0-Lite 与 GPT-5.5 的普通准确率参考。
独立分析的弱点
弱点一:不对称纠错风险。策略一旦生成便倾向跟随工具读数,而生成深度 AbsRel 达 3–15%,在最需要它的 $g<0.10$ 区间(基准已排除)测量误差可能大于被比较的深度差;改进方向:让策略估计测量不确定性(多次采样取中位数与方差),间隙小于误差范围时回退草稿。弱点二:代价模型粗糙。$\lambda$ 不反映 token 数、延迟与显存占用,若换成真实时延代价,"按需生成"的经济性需重估;改进方向:引入可微成本估计头或延迟感知奖励。弱点三:任务面窄。RL 数据只有两物体深度/距离比较(ScanNet++/nuScenes 各半、每图一题),门控能否识别其他几何任务的需求未知;改进方向:扩展到计数、区域关系、遮挡推理并检验选择能力迁移。弱点四:共训存在任务干扰。深度生成会降低 MMSI 相机运动准确率,说明统一堆叠生成目标之间有冲突;改进方向:分析任务间梯度冲突、按能力分组路由或课程化调度。弱点五:MMDC 的融合权重假设逐像素独立同方差噪声,是一阶近似,对生成的大面积失败(边界撕裂、天空漂移)缺乏鲁棒机制;改进方向:联合预测置信图或引入多帧一致性校验。
未来方向
作者提出的方向:系统研究生成与理解迁移的条件——附录 F.1 显示"先生成预训练再理解 SFT"不可靠而共训有效,其机制值得深挖;把选择性几何证据获取推广到更多任务与证据形式。基于本文成果可延伸:(1) 把 MMDC 的可逆编码思路推广到其他物理量(表面法线、材质、辐照度、运动场),把"生成即可测量"变成通用范式;(2) 把 draft-conditioned 决策抽象成通用自验证框架——任何可被工具验证的中间结论都可套用"对照草稿 + 强制 rollout 估计分支价值"的优势设计;(3) 用 3DCueBench 的 cue 平衡与难度分层方法净化现有空间基准(MMSI、SpatialVLM 等),并自动审计训练数据的捷径污染;(4) 结合多帧深度融合、3D 一致性约束或不确定性校准降低单帧生成误差,打开小间隙题的上限;(5) 在视频/流式输入下做在线几何证据获取,与空间记忆结合,服务具身智能与机器人操作。
复现评估
代码见 https://github.com/hku-sail/GeoUG,基座 BAGEL-7B-MoT 权重公开;MMDC 免参数、实现极简,3DCueBench 的 800 题与构建协议在附录 E.2 有完整描述,应可复现。成本主要在数据引擎:度量深度涉及 14 个合成 + 8 个真实数据集并用 DA3 做仿射对齐;多视角需用 DA3 重估 RealEstate10K(约 2633 万样本)与 DL3DV(约 485 万)位姿并运行 Pose→Instruction 投票算法;exo-to-ego 需 VLM 标注 171K 对。RL 阶段轻量:LoRA(r=32)、800 题、50 步、每题 16 rollout(4 个强制生成),单节点多卡即可。评测需复现 7 个开源 VLM 基线并调用 GPT-5.5 / Seed-2.0-Lite API。总体难度中上:推理与评测容易,完整数据管线工程量大,但超参(学习率 $5\times10^{-5}$、$\lambda=0.1$、枢轴 2/8/32 米等)披露细致,附录含训练模板与失败案例,可复现性属较高水平。
论文图表
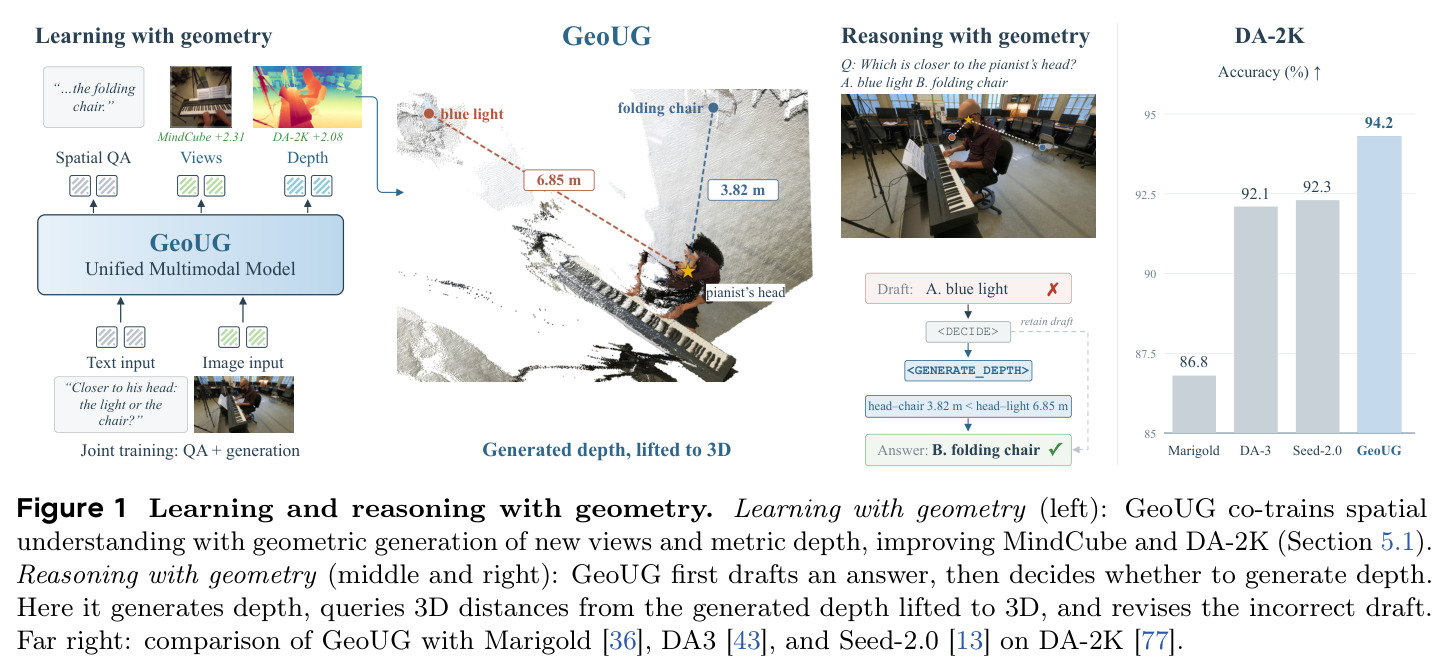
总览图。左(学习侧):GeoUG 将空间 QA 与新视角、度量深度生成共训,MindCube +2.31、DA-2K +2.08;中(推理侧):对"哪个离钢琴家头部更近",模型先草稿选 blue light,在 <DECIDE> 处生成深度并查询 3D 距离(头-椅 3.82 m < 头-灯 6.85 m),修正为 folding chair;右:DA-2K 上与 Marigold、DA3、Seed-2.0 的准确率对比(GeoUG 94.2%)。
一图概括论文两大支柱(生成作为训练监督与推理证据)和最终成绩,是理解全文框架的入口。
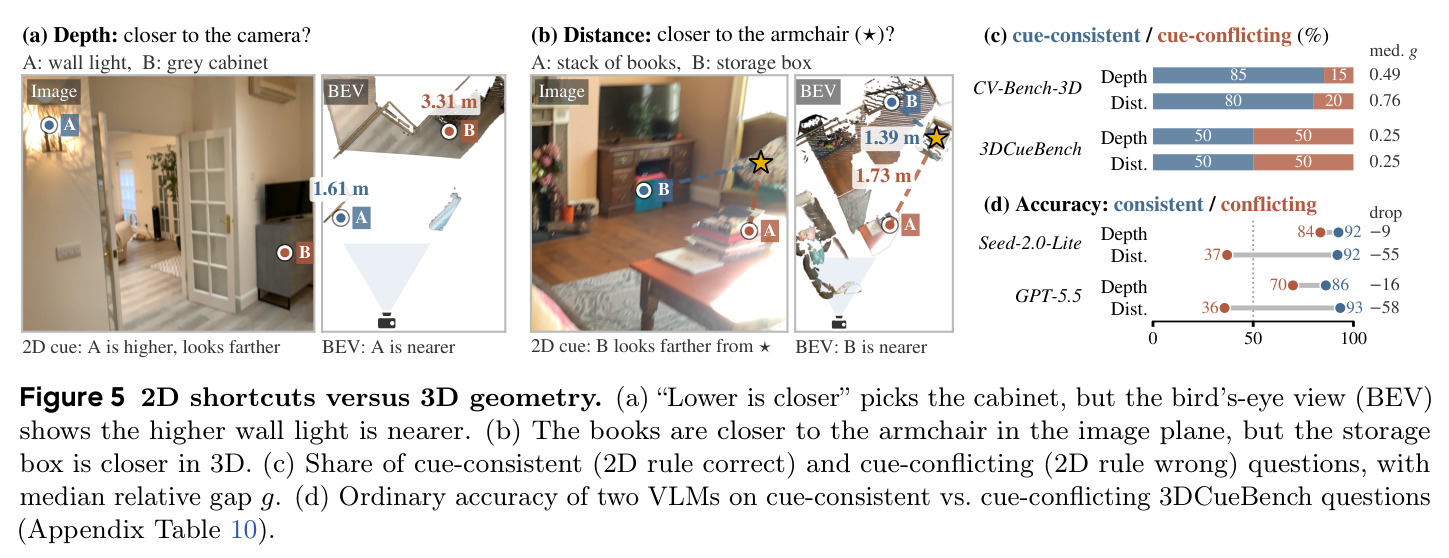
(a)(b) 两个 2D 捷径反例:"图中更低者更近"与"图面更近即 3D 更近"均被真实几何(鸟瞰图)反驳;(c) 各基准中 cue 一致/冲突比例与中位间隙(CV-Bench-3D Depth 规则准确率 85.3%、无 $g<0.16$;3DCueBench 各半、规则恰 50%);(d) Seed-2.0-Lite 与 GPT-5.5 在冲突题上跌至 37.0%/35.7%。
揭示现有基准被 2D 捷径污染的完整证据链,是引入 3DCueBench 的动机。
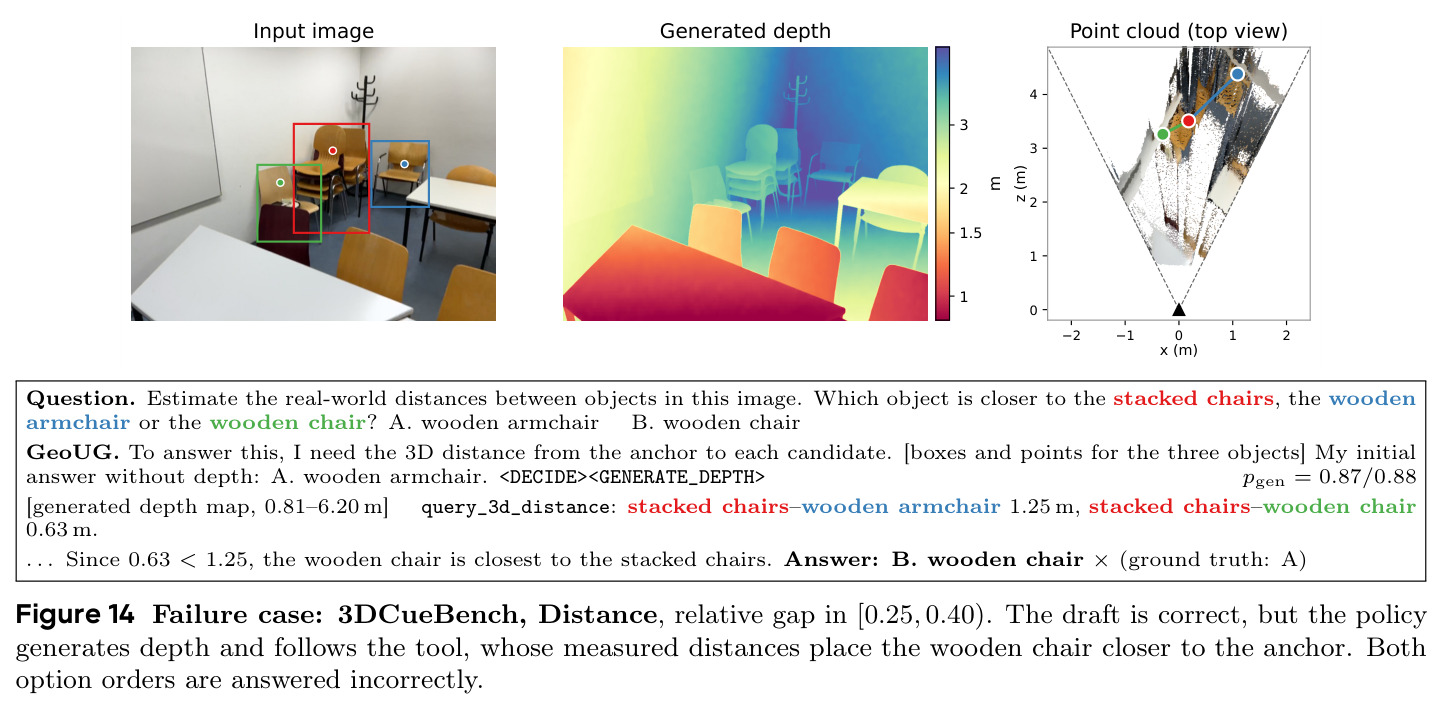
失败案例:草稿本来正确(wooden armchair 更近),但策略生成深度并跟随工具读数(stacked chairs–armchair 1.25 m vs chair 0.63 m)改成错误答案,两个选项顺序均错。
诚实暴露"生成可能把对的改错"的风险,是理解方法边界与误差来源的必备案例。
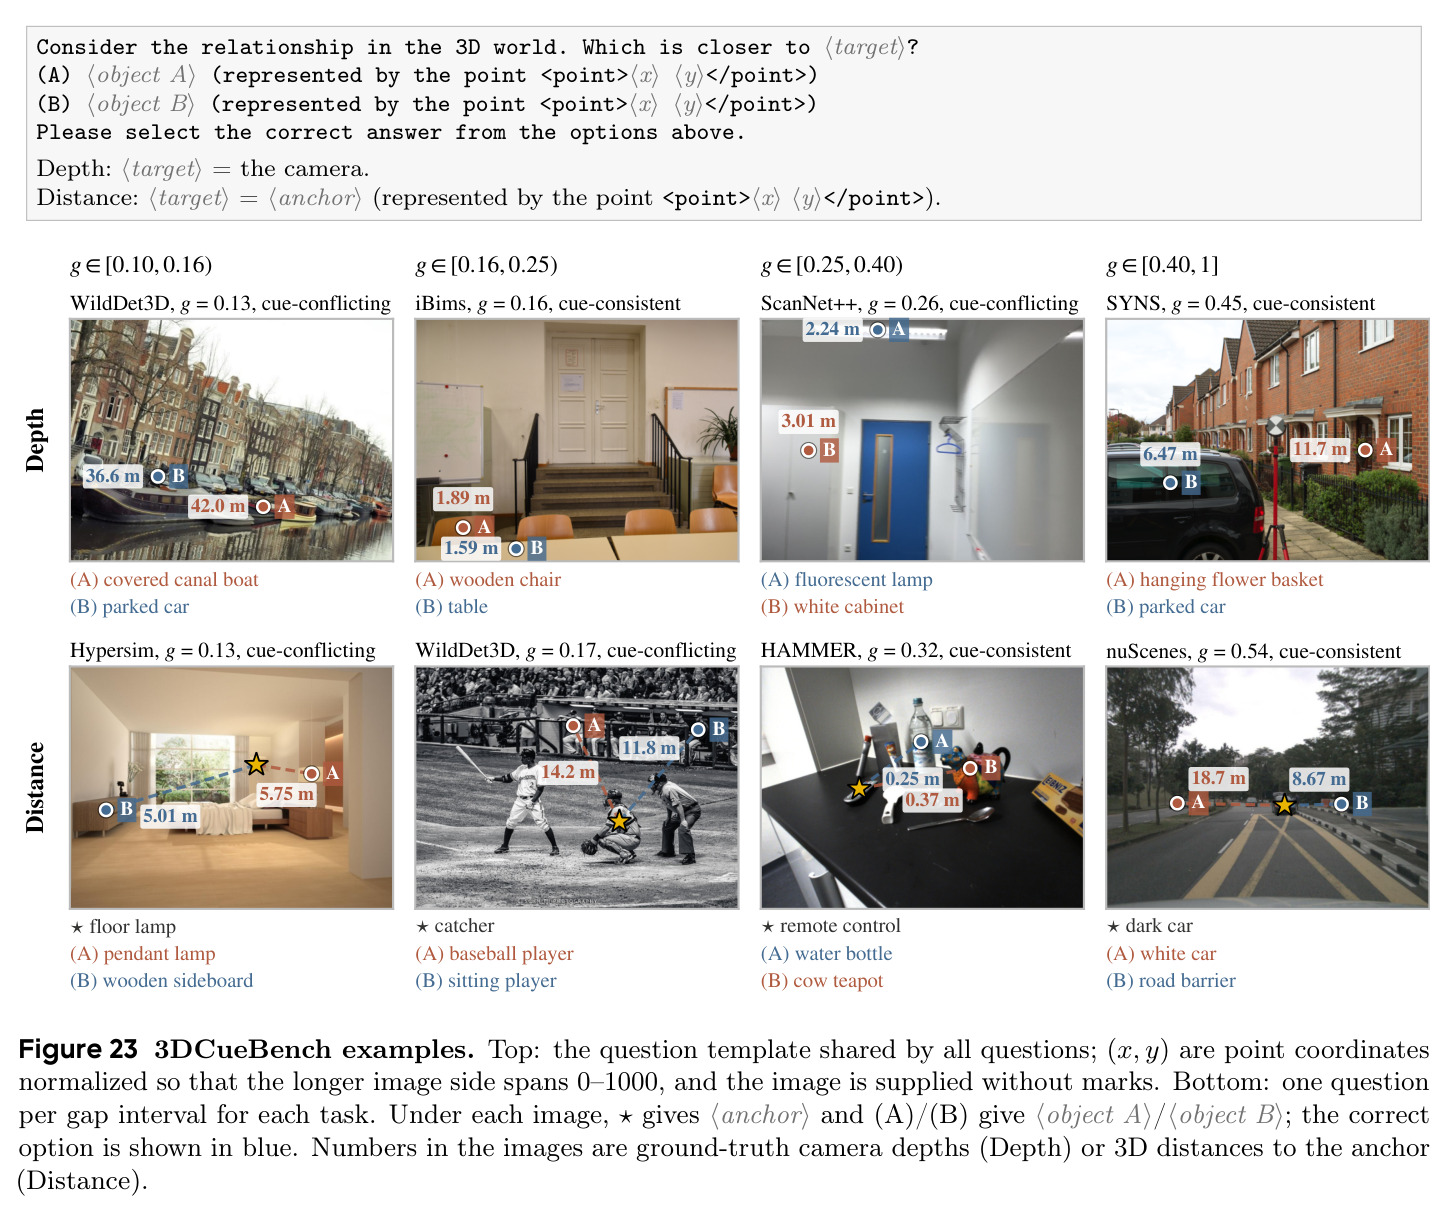
顶部为统一题目模板(点坐标归一化到 0–1000,图像不带标记);底部为 Depth/Distance 两任务在四个相对间隙区间各一道例题,标注真值深度/距离(如 36.6 m vs 42.0 m;1.89 m vs 1.59 m)与 cue 一致性。
直观展示新基准的题型、标注格式与难度控制方式,便于理解其构建原则。