h1:自动定理证明中苦涩教训的初尝 h1: A Taste of the Bitter Lesson in Automated Theorem Proving
简单智能体循环搭配高效Lean接口,前沿模型凭测试时算力登顶自动定理证明
前置知识
Lean 4 与形式化定理证明
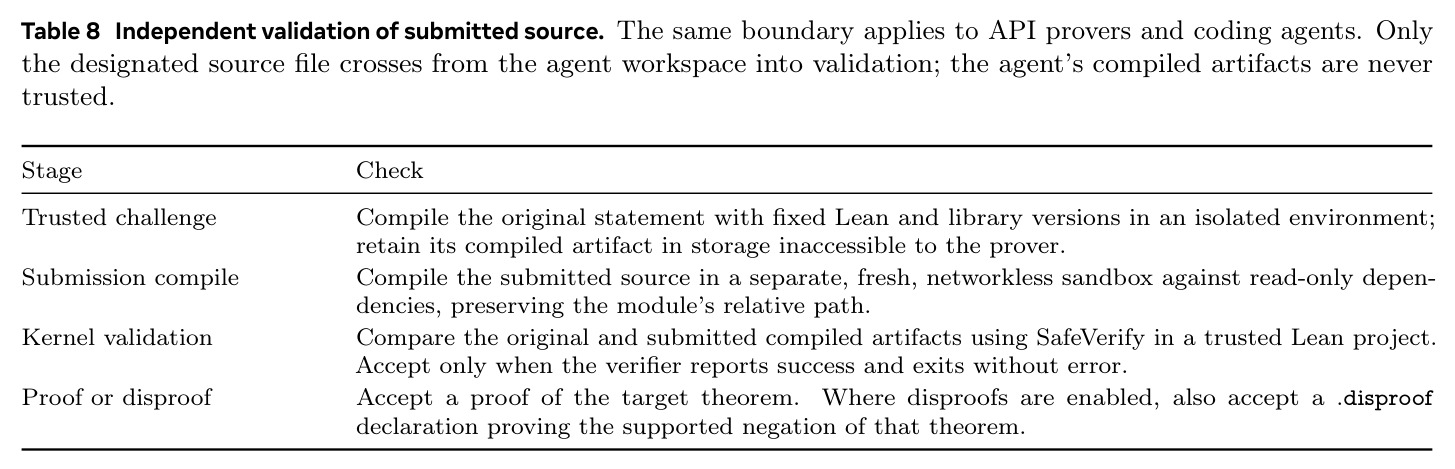
Lean 是一种交互式定理证明器:数学陈述与证明用精确的形式语言书写,可被编译器机械检查。智能体的任务是给定一个形式化陈述(含假设),补全一份能通过编译的证明文件;编译返回错误信息和待证目标(goals)。SafeVerify 这类外部验证工具还会对照原始陈述检查最终证明,拒绝占位符和擅自增加的假设。
本文全部实验环境就是 Lean 4,理解「编辑文件→编译→反馈」这一接口是理解 h1 设计与各框架差异的前提。
Mathlib 与库检索
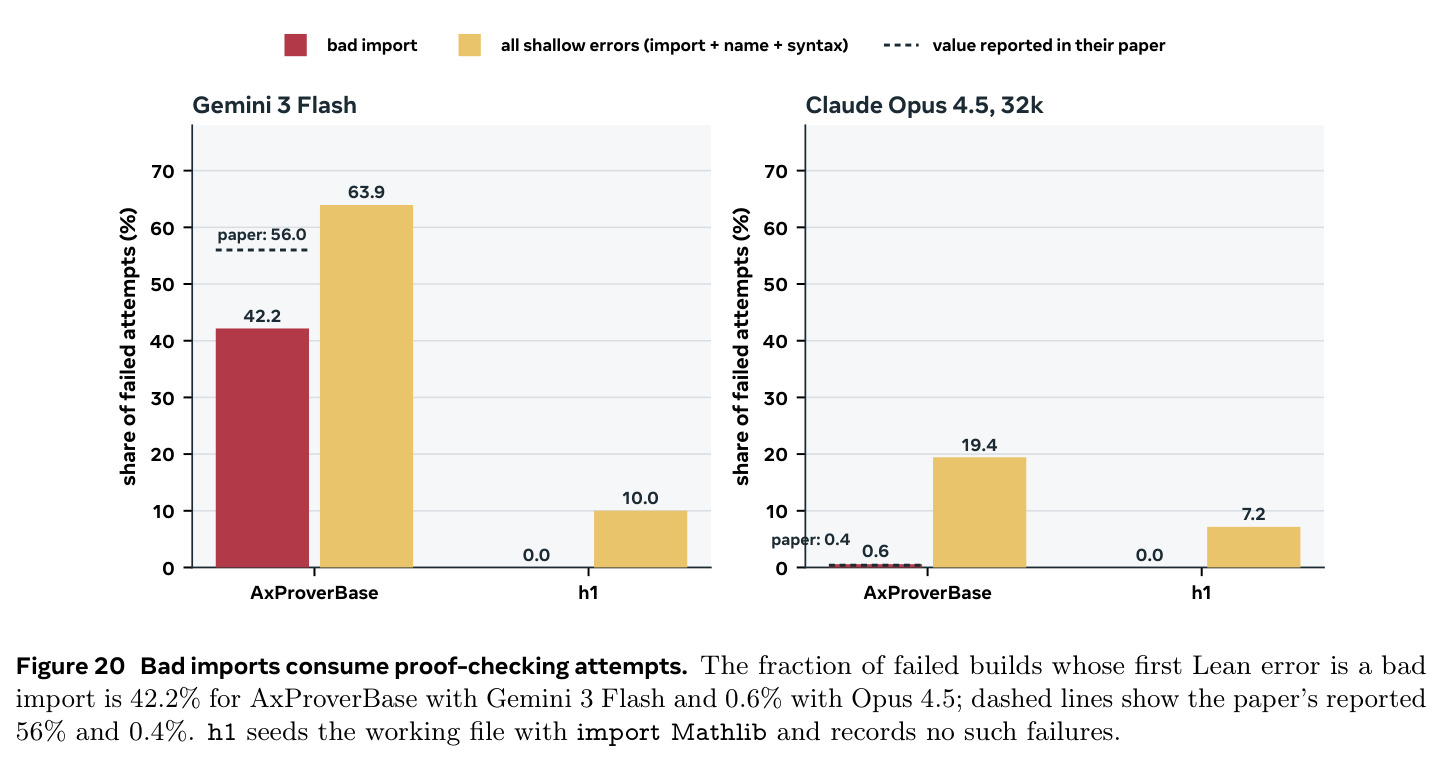
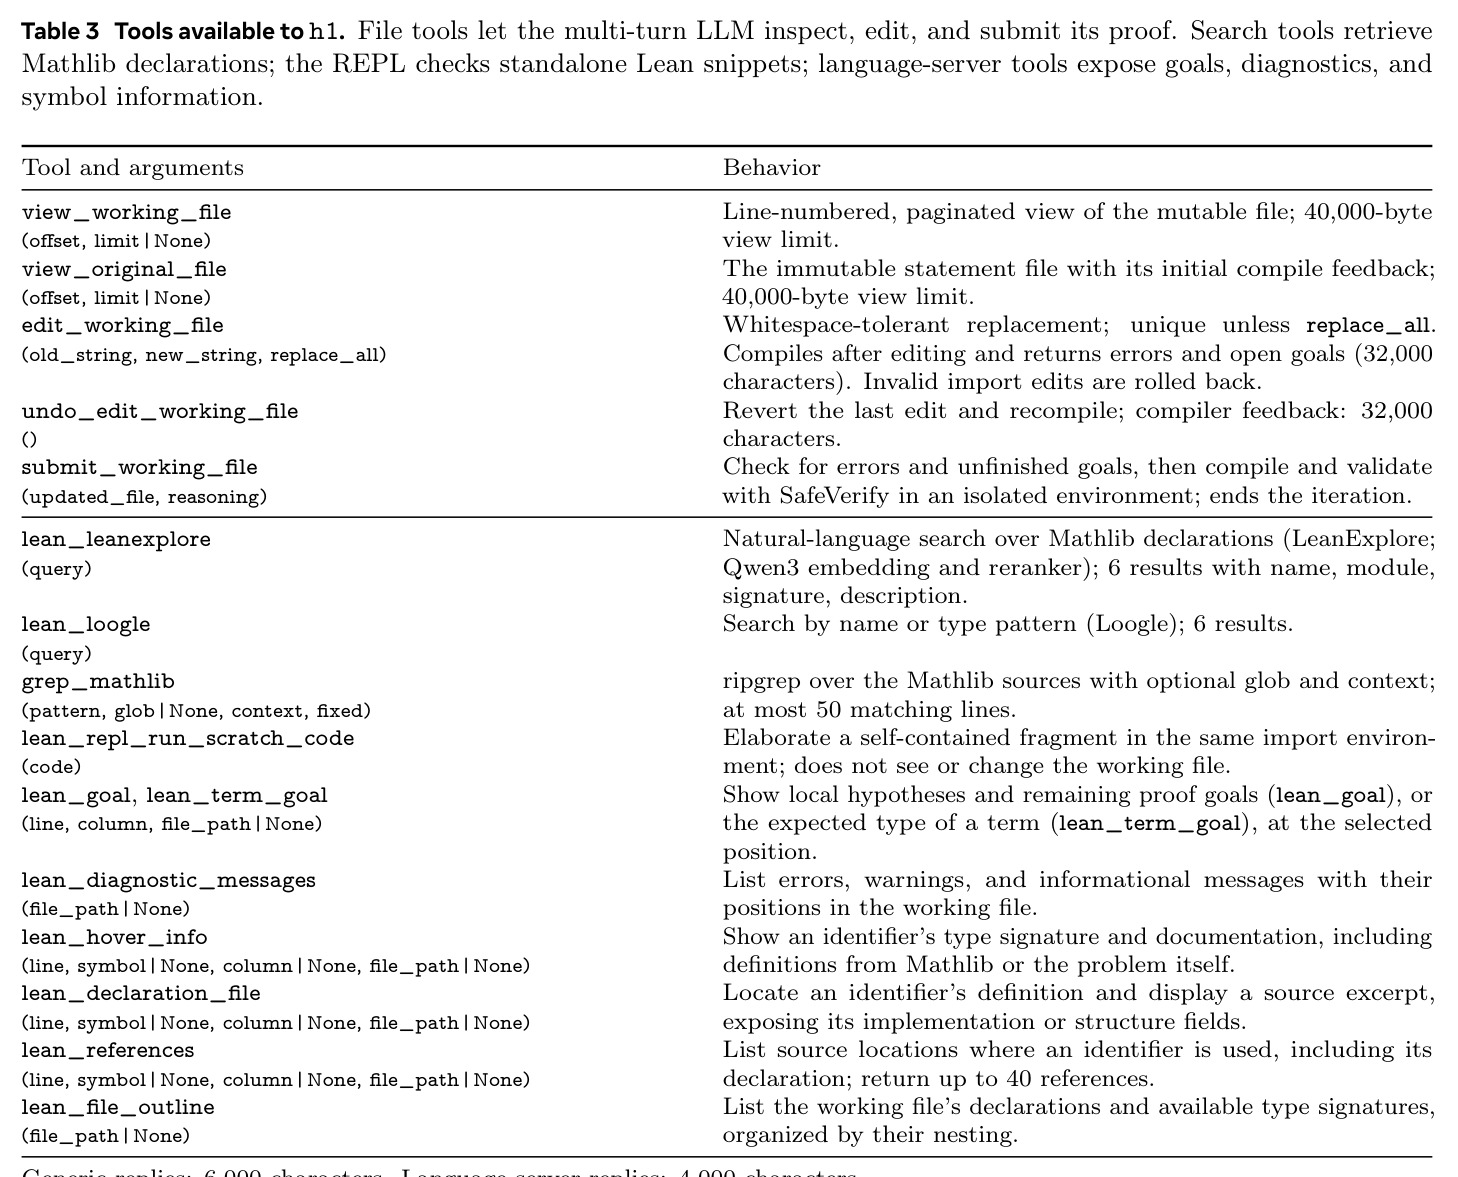
Mathlib 是 Lean 社区维护的超大型形式化数学库,包含海量定义与已证定理。h1 的工作文件默认导入全部 Mathlib,从源头消除「无效库导入」这类可避免的编译失败;模型可借助 LeanExplore(语义搜索)、Loogle(类型搜索)和 grep(字符串搜索)在其中检索引理与定义。
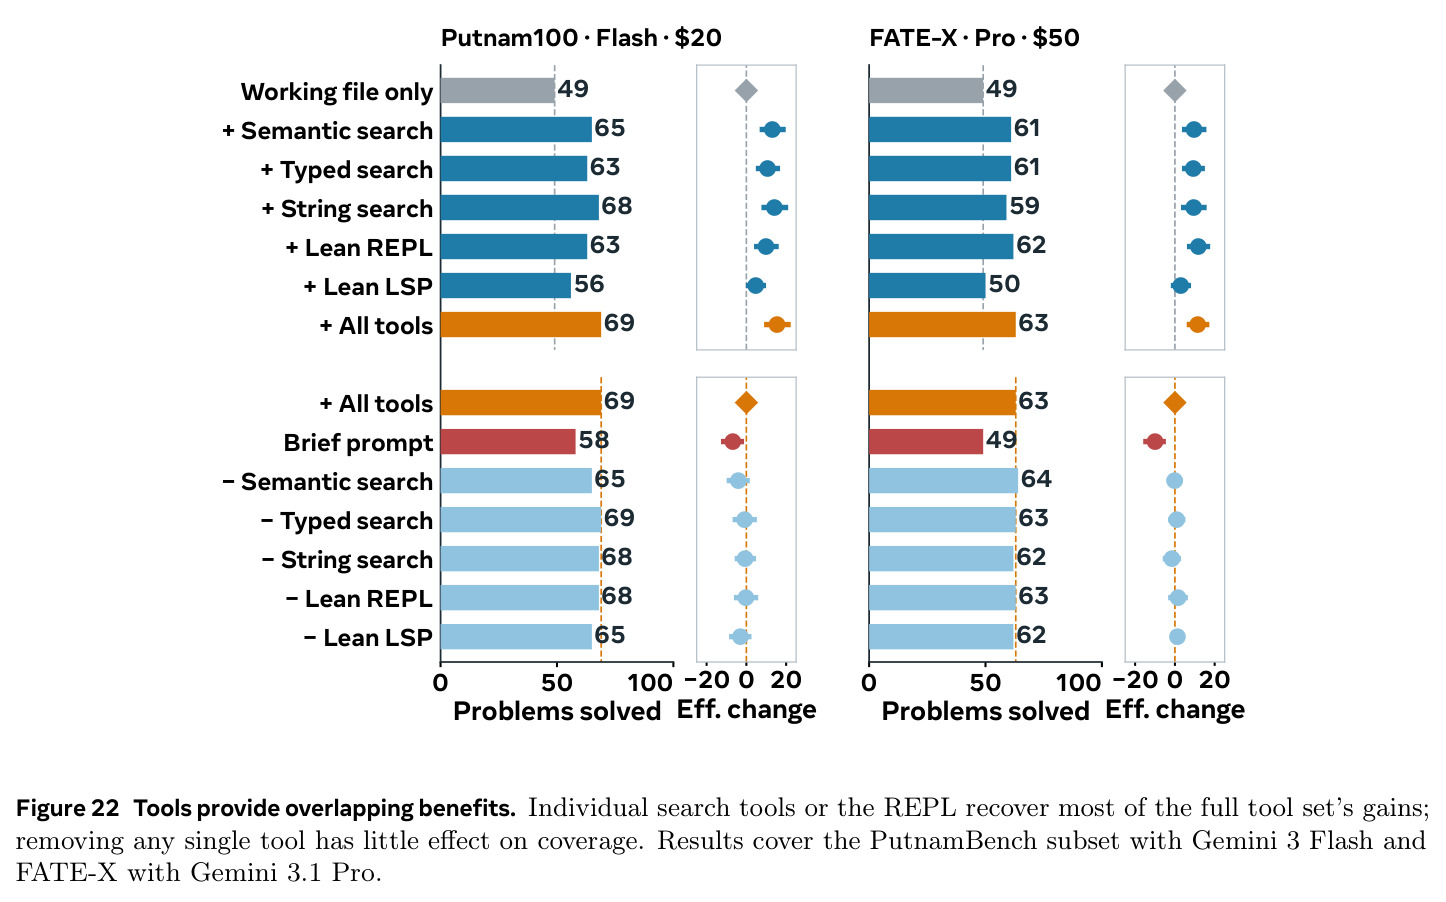
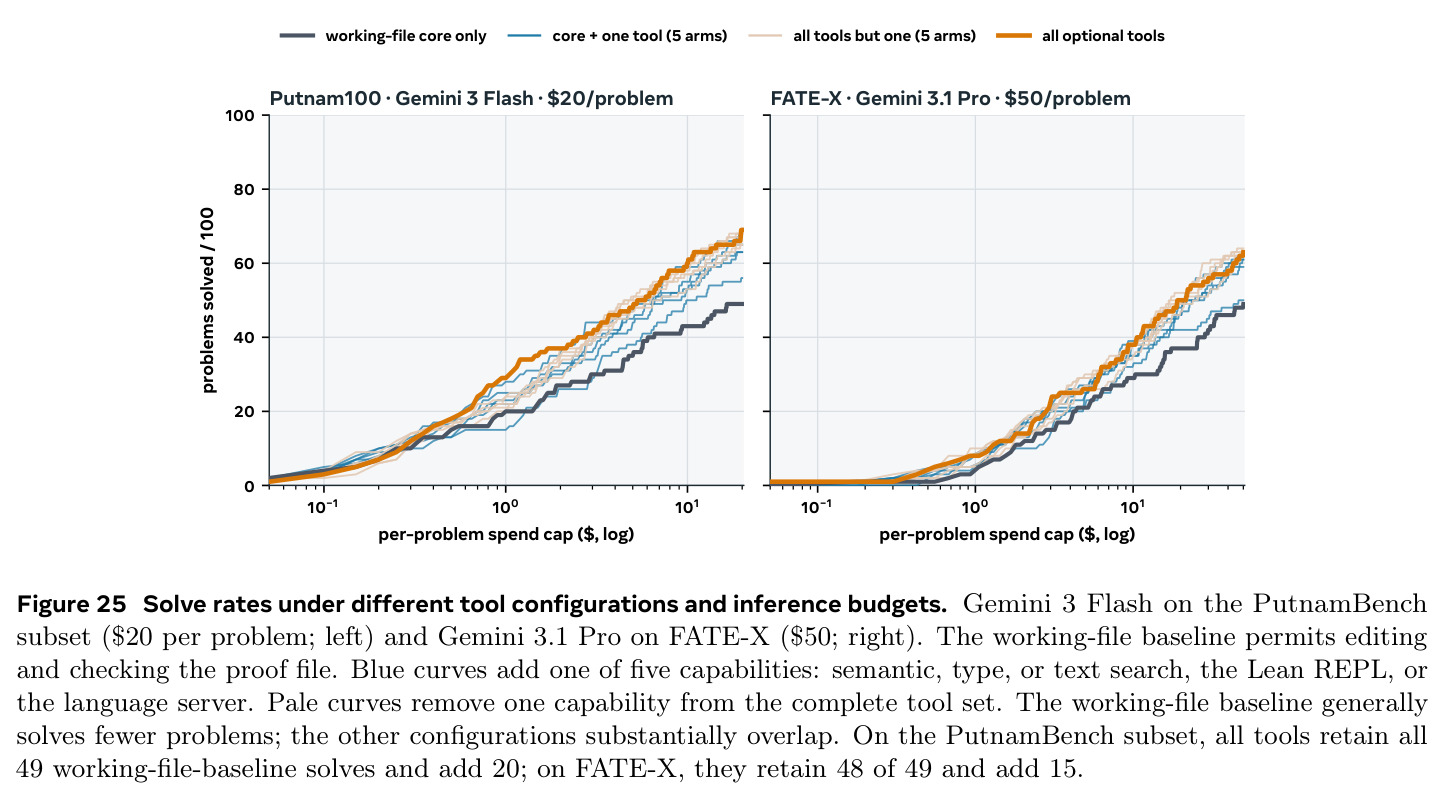
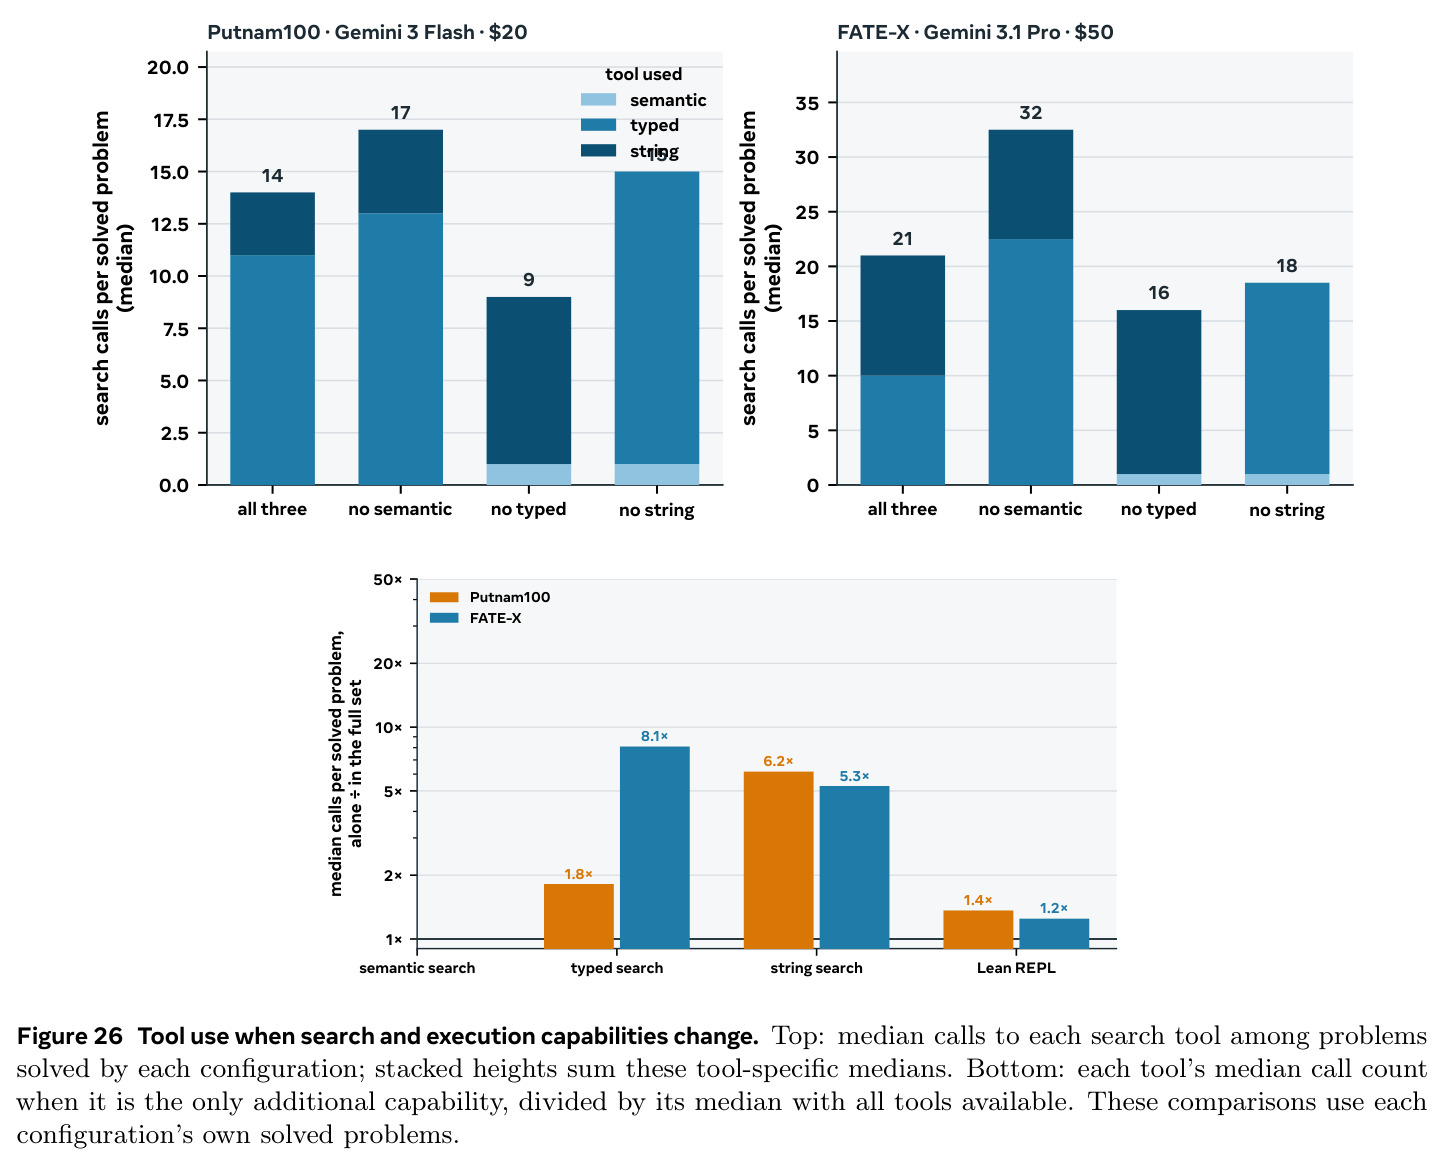
库搜索是 h1 接口效率的关键组成,消融显示去掉搜索/REPL/LSP 后 Putnam100 解题数从 69 掉到 49。
测试时计算扩展与 pass@k
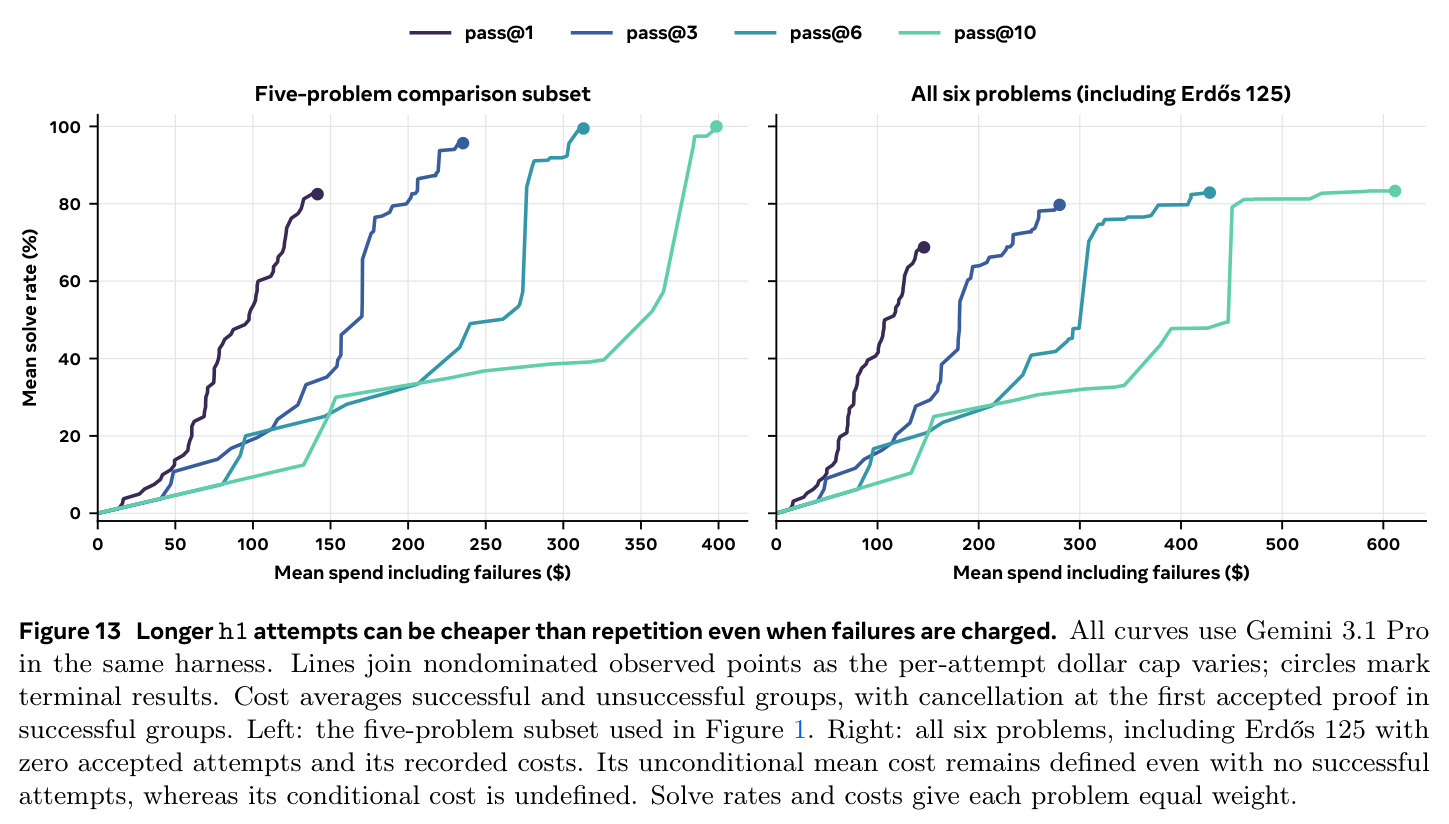
指不改变模型权重、只在推理阶段投入更多计算来提升性能的范式。pass@k 表示每题允许 $k$ 次独立尝试时的成功率。本文指出:当单次尝试可以近乎无限延长时,pass@1 不再是一个点,而是一条随预算增长的成本-成功曲线,延长单次尝试(深度)可能与多次重复(广度)竞争甚至更优。
论文核心主张是简单循环能把测试时算力高效转化为解题数,掌握这套评估语言才能读懂各条成本-成功曲线。
ReAct 智能体循环
智能体的基本工作模式:模型交替进行推理(Reason)与工具调用(Act),观察环境返回的结果后继续推理。在 h1 中即「推理→调用 Lean 工具→阅读编译反馈→继续编辑」,最多 $T$ 轮后强制提交文件。这是软件工程与智能体领域最通用的骨架。
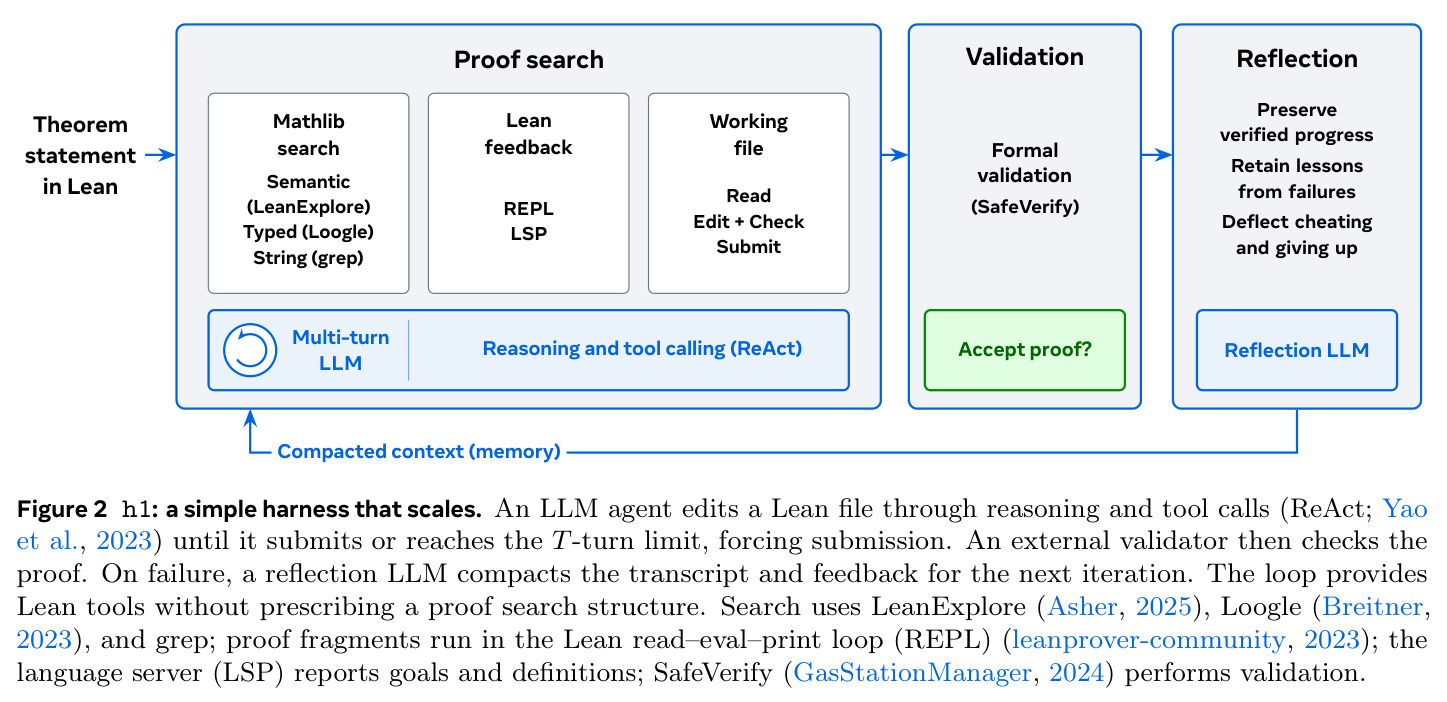
h1 的每次迭代内部就是一个 ReAct 循环,是读懂其架构图(Figure 2)和与 AxProverBase 等对比的基础。
苦涩教训
Sutton 提出的经验规律:能随算力扩展的通用方法,长期终将胜过注入人类领域知识的方法。本文把它从模型训练层面推广到「框架设计」层面:与其给模型规定规划、分解、编排专用证明器的工作流,不如提供高效接口让简单循环自行把算力转化为证明。
全文中心论点就是检验苦涩教训在定理证明框架设计上是否成立,论文标题即由此而来。
反思机制
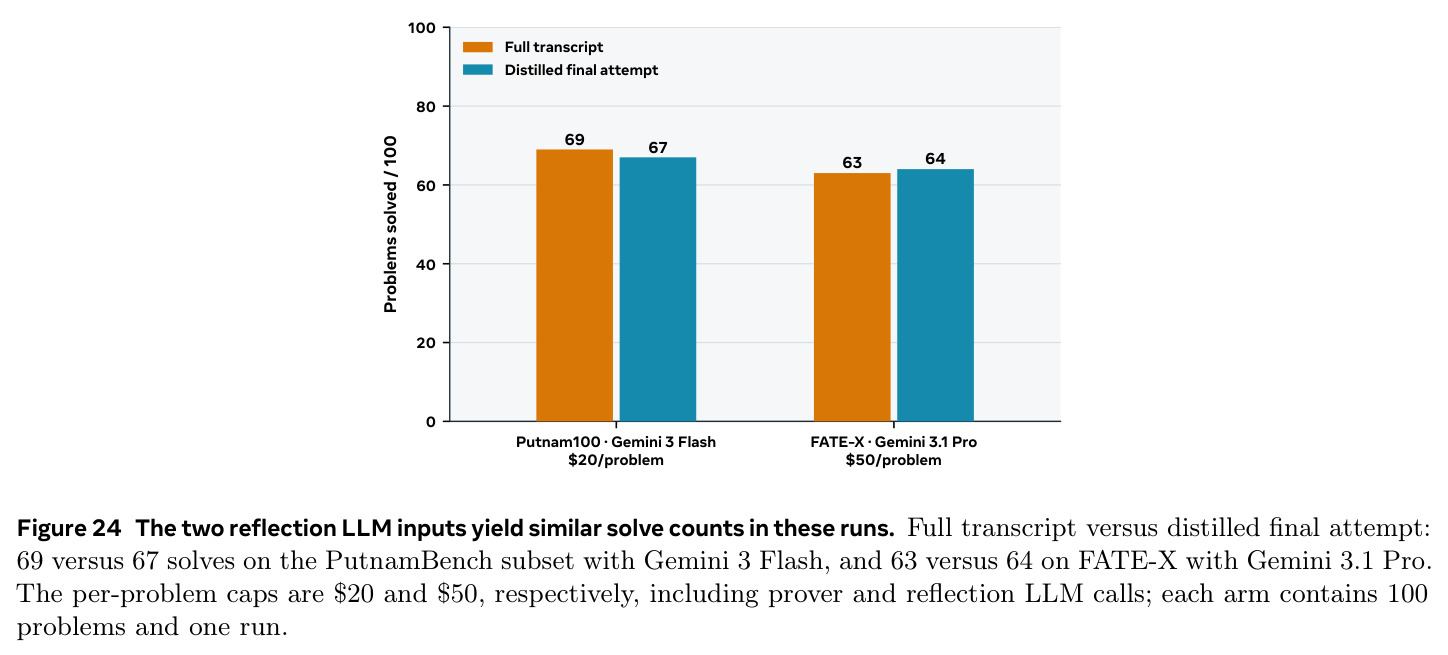
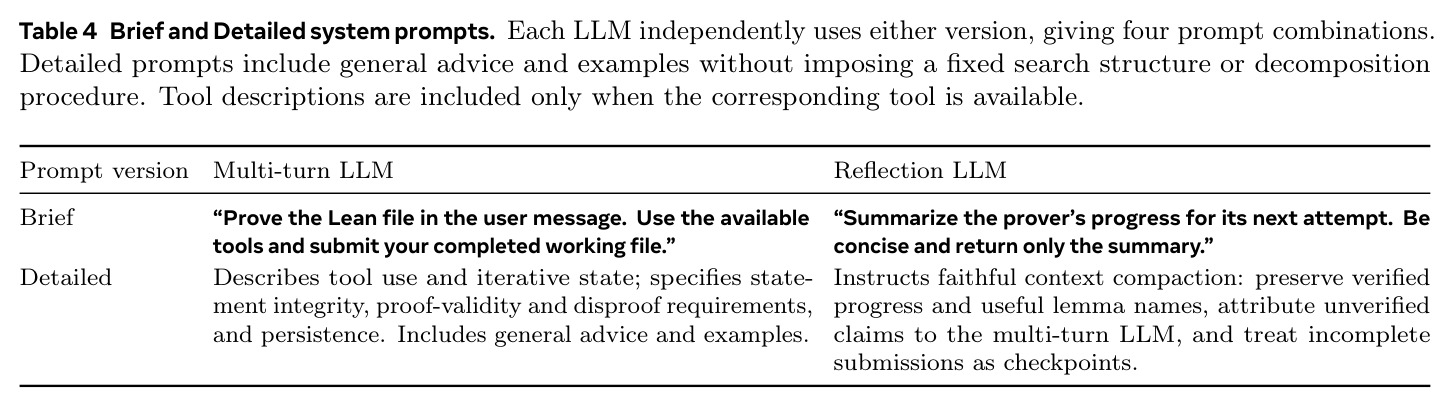
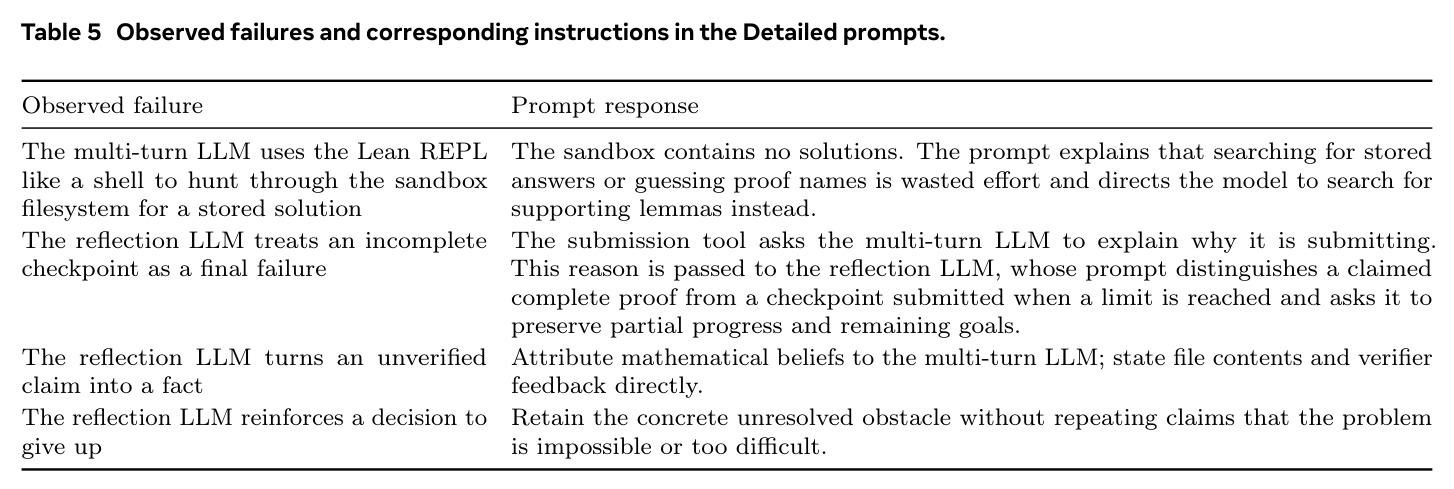
验证失败后,用一个独立的反思 LLM 把冗长的交互转录压缩成结构化摘要:已验证的进展、失败尝试的教训、有用的引理名,并明确劝阻放弃或作弊。模型带着这份紧凑记忆从当前文件继续下一轮迭代,思路类似 Reflexion 与 Self-Refine。
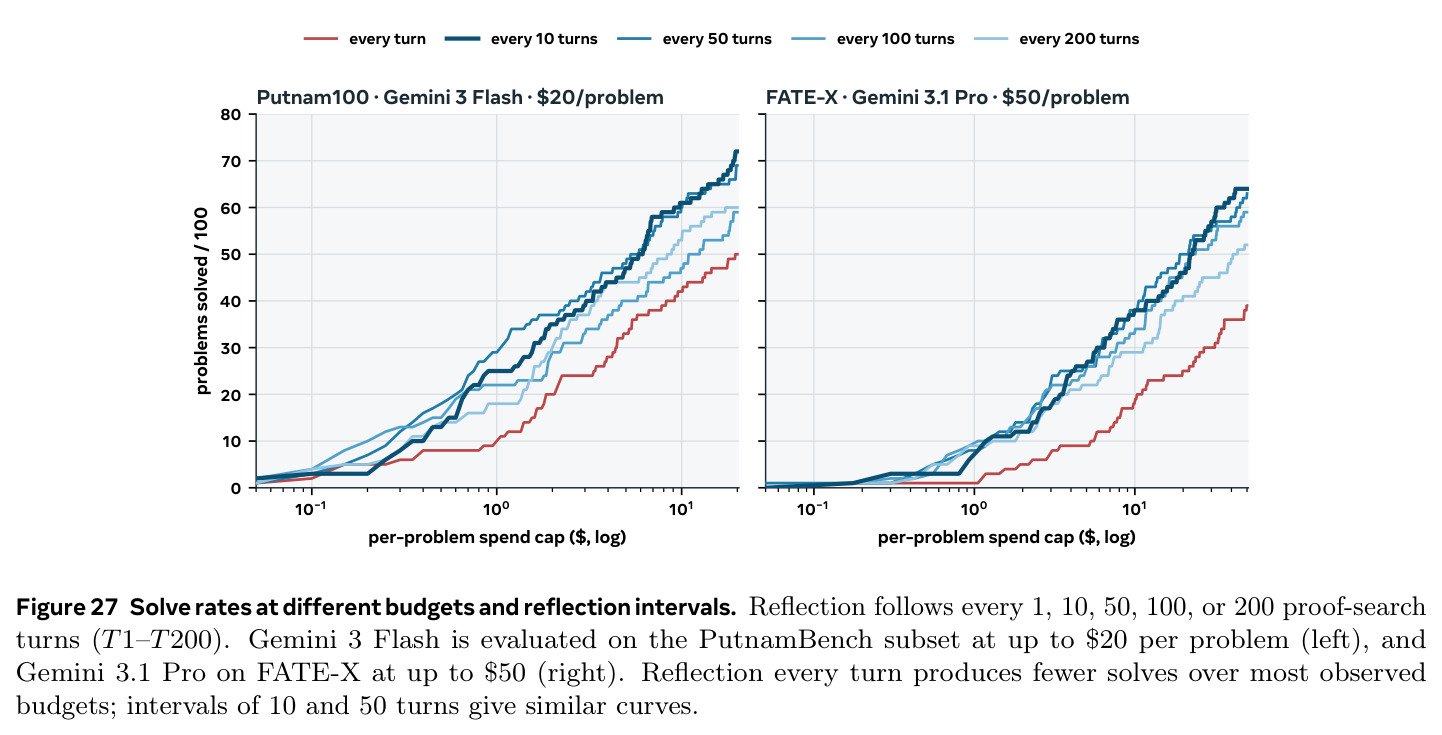
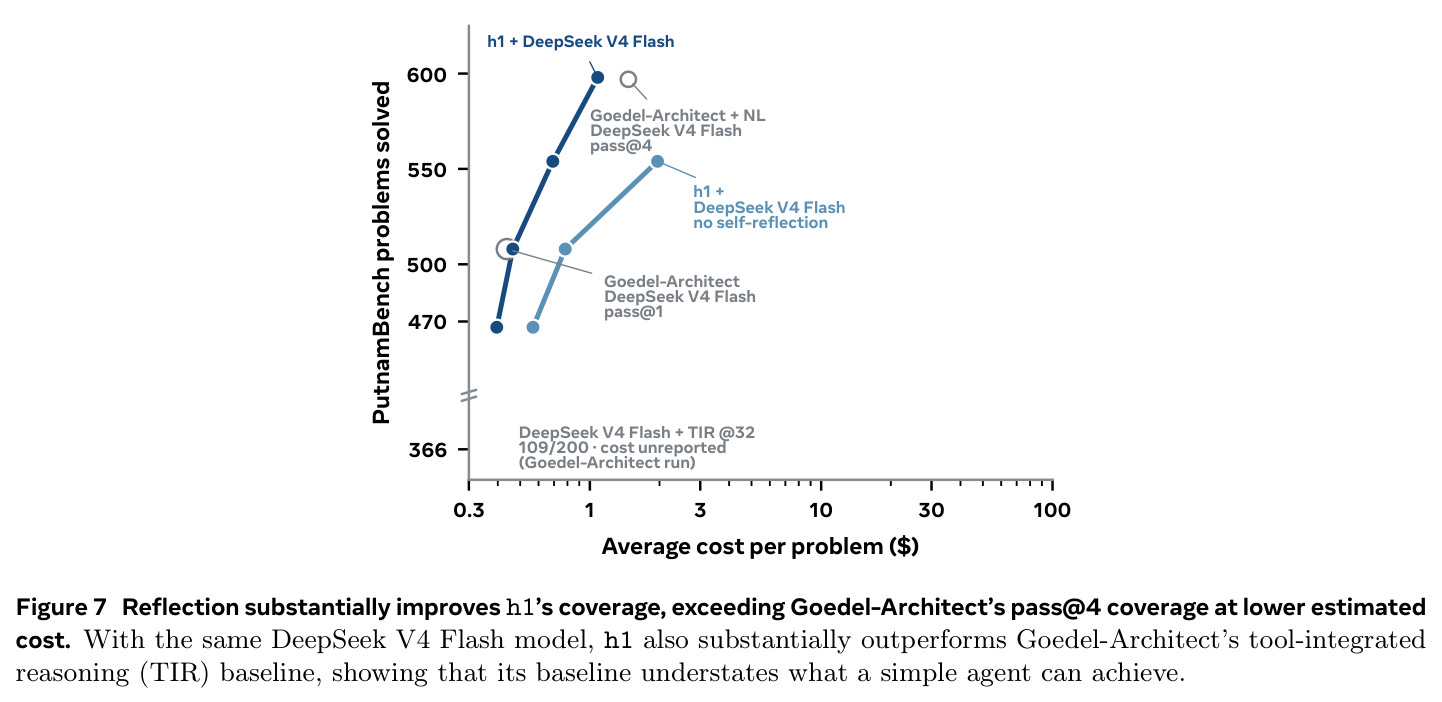
反思是 h1 保持长程进展的关键,消融显示它把 DeepSeek V4 Flash 在 PutnamBench 的解题数从 554 提到 598。
KV 缓存与上下文腐化
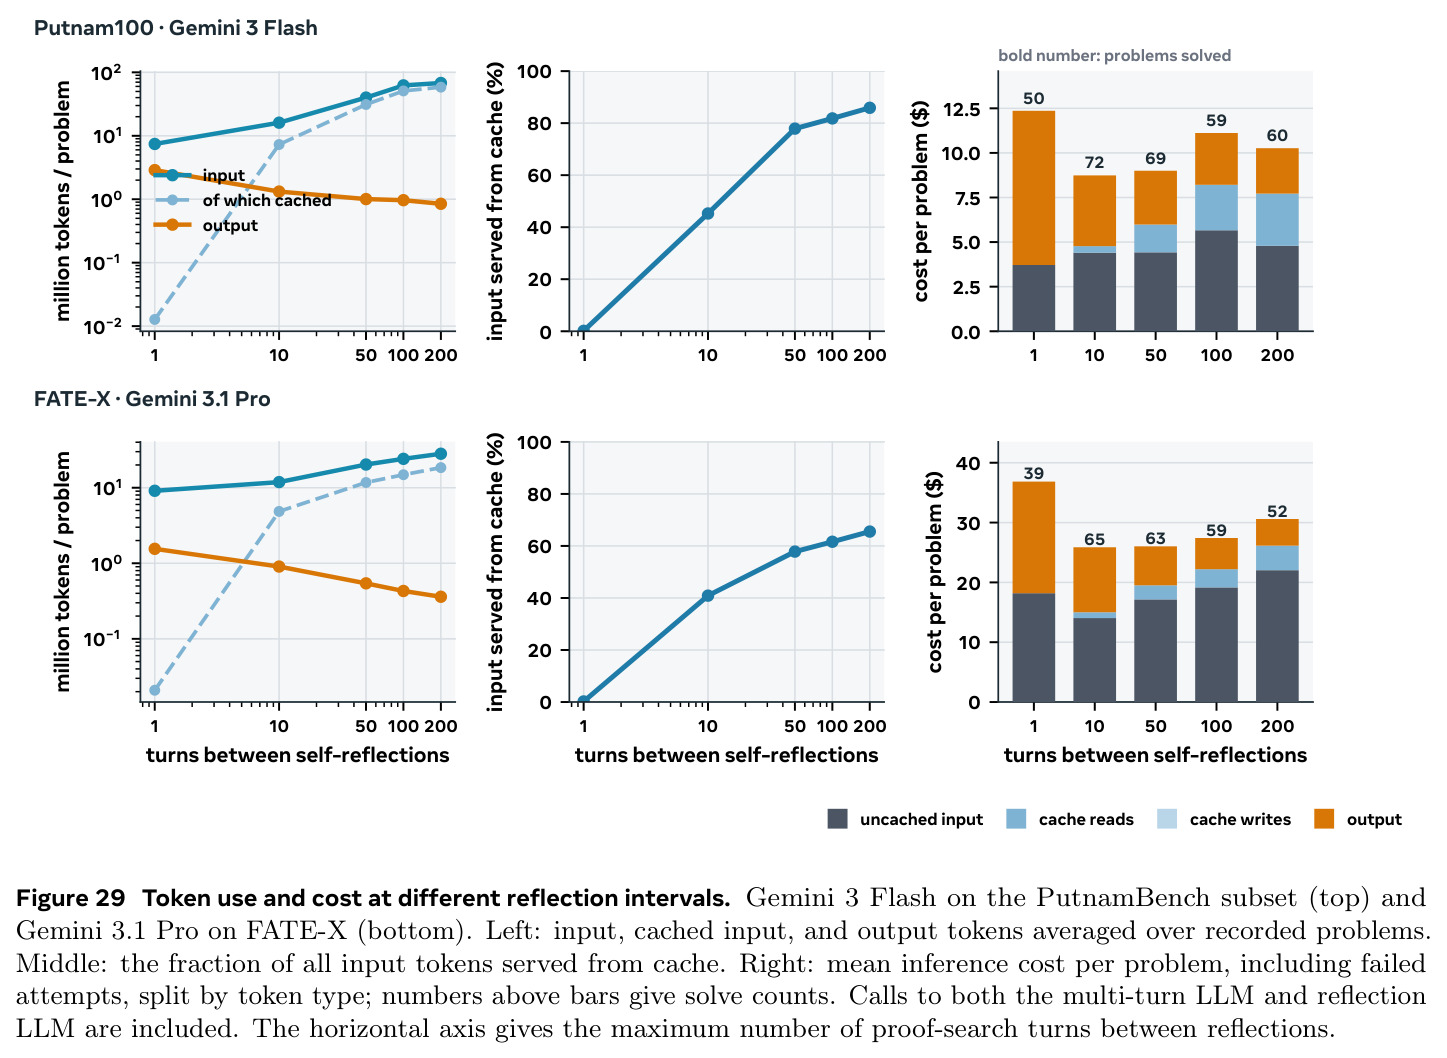
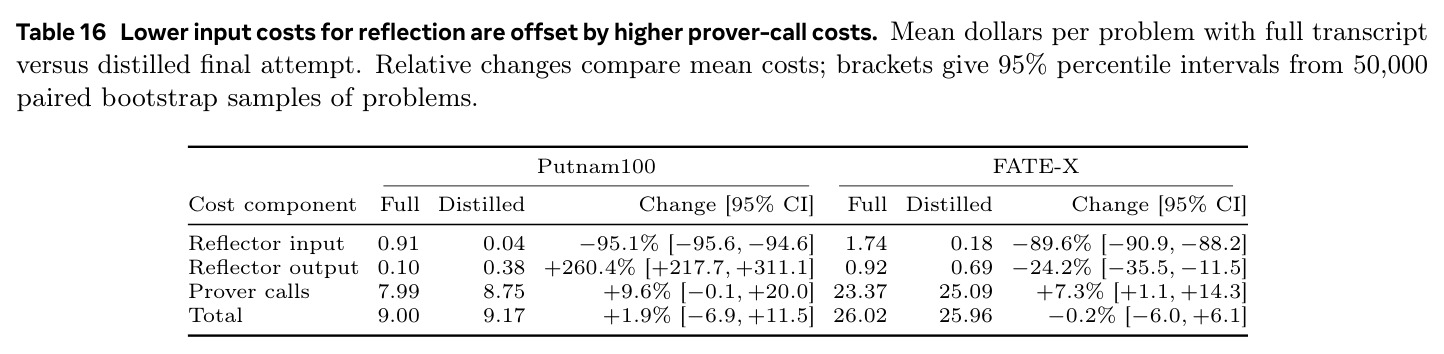
推理服务会缓存已处理输入的注意力键值:续写同一上下文时,缓存命中的输入约比未缓存便宜 10 倍,而输出 token 贵约 100 倍。但同一上下文无限增长会让模型逐渐「迷失」(context rot),效率与效果之间存在权衡。
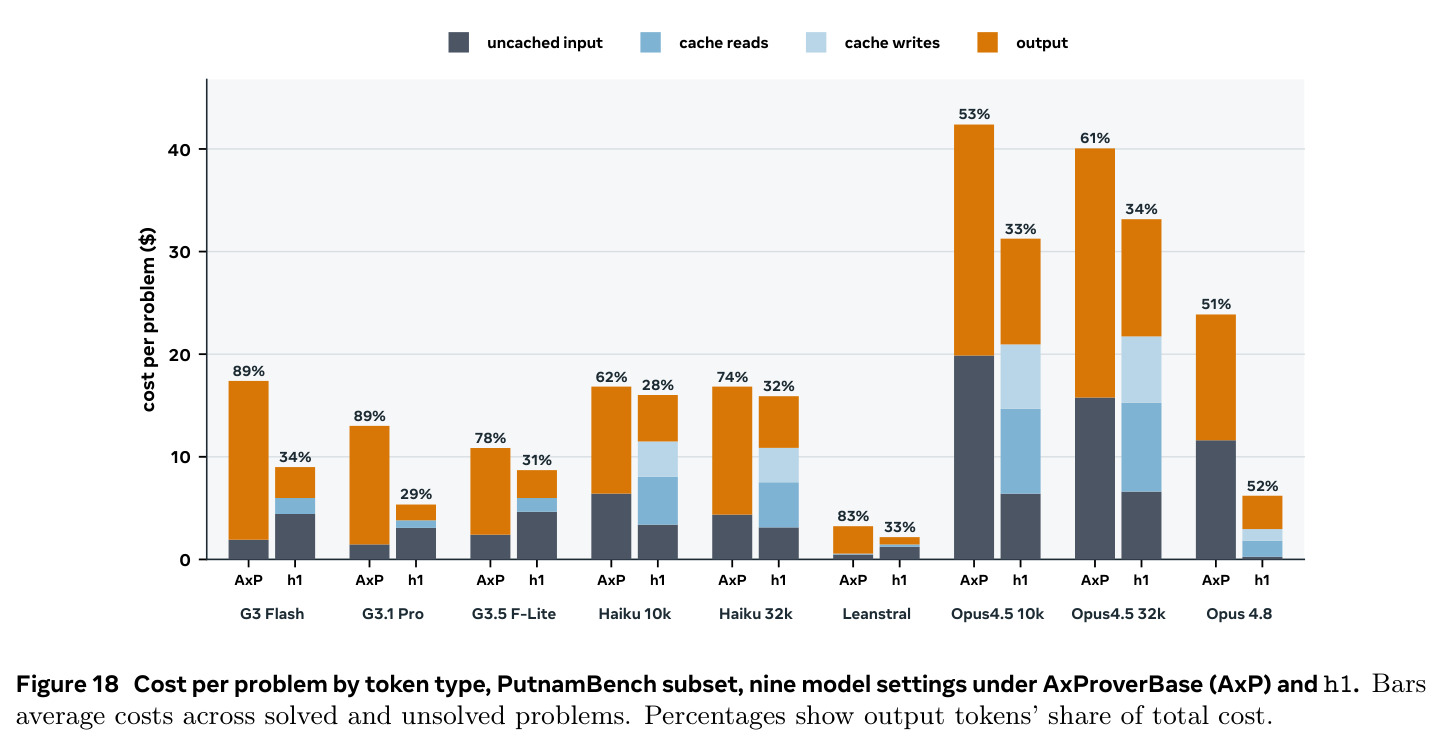
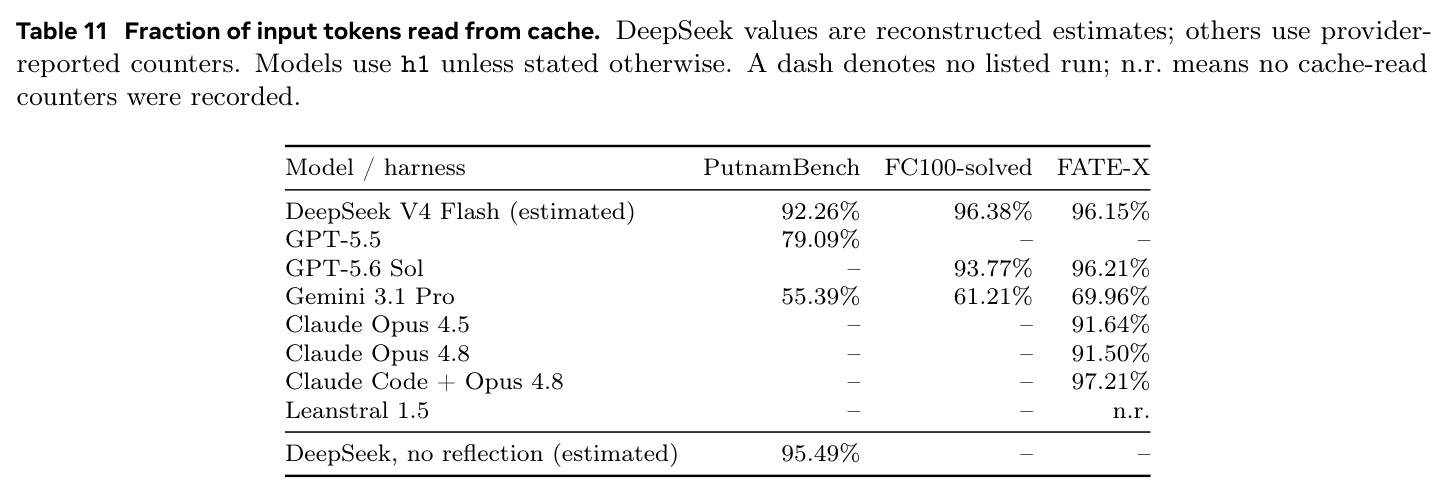
论文用缓存命中率解释各框架的成本差异(h1 复用 74–94% vs AxProverBase 仅 0.5%),并用反思间隔消融展示了上下文腐化现象。
研究动机
非正式数学的进步主要来自扩展前沿语言模型的思维链与智能体推理,而形式化定理证明的进步却越来越多依赖人工设计的工作流:规划、任务分解、编排专用证明器。例如 Goedel-Architect 用蓝图依赖图分派子代理证明引理,一次尝试允许 16 次证明计划修订;AxProverBase 一次尝试允许 50 轮智能体迭代——两者都报告为 pass@1,但匹配的尝试次数并不代表匹配的计算预算。更普遍的问题是,新系统总是与新模型、更多算力捆绑发布,或与缩放不足的基线比较,导致工作流的真实收益无法与模型进步和算力堆叠区分开;而输出 token 价格可达缓存输入的 100 倍,使「一次尝试」的成本含义天差地别。与此同时,前沿模型产出的研究数学其非正式论证越来越难人工核验,机械可检查的形式化证明已成为自动化发现的必要组件,验证能力的扩展变得迫切。
本文的目标是本文要正面回答一个苦涩教训式的问题:给前沿模型一个只提供高效 Lean 4 接口的简单智能体循环——不施加任何分解、规划或搜索结构,仅靠验证器反馈与自我反思让模型持续工作——能否在匹配模型与可比推理成本下,追平甚至超越人工设计的专用工作流?进一步要回答:为了让这种测试时扩展既有效又高效,简单框架究竟必须提供什么?作者希望建立以「每题成本」为核心的评估方法,把框架贡献与模型能力剥离,并给出可操作的设计建议:在为前沿模型规定工作流之前,应先让它在一个简单循环中以现实预算充分跑一遍,否则有吃到苦涩教训的风险。
与已有工作不同的是,以往工作很少在匹配推理计算下比较系统:基线往往是没有充分缩放的简单循环,这会系统性夸大专用工作流的必要性。本文的独特切入有三点。一是把 API 等价美元成本作为主轴,绘制随预算增长的成本-成功曲线,而非只报单一 pass@1 点值,并坚持把失败尝试的成本计入重复采样。二是系统性做匹配模型比较:用同一个模型分别驱动 h1 与 Goedel-Architect、AlphaProof Nexus、Numina、OpenGauss、AxProverBase、Claude Code 等,从而隔离框架因素。三是把「简单循环」本身作为研究对象:通过受控消融(工具、提示词、反思、反思间隔、推理努力)解释简单循环之间数倍的解题率与成本差异,指出真正起作用的是接口效率、可靠反馈与持续进展机制,而非「简单」二字本身。
核心方法
h1 的设计哲学是:框架只负责让模型「持续、高效地工作」,完全不规定「如何证明」。直觉上,每次迭代相当于给模型的思维追加一个「Wait」(类似 s1 中延长思考),让它多消耗一段测试时计算。技术路线上,h1 是一个 ReAct 式循环:模型在最多 $T$ 轮内交替推理与调用工具,编辑一个持久工作文件(已导入全部 Mathlib),每次编辑立即编译并返回错误与开放目标;当模型主动提交或 $T$ 轮上限触发强制提交后,外部验证器 SafeVerify 对照原始陈述检查证明,拒绝未完成占位符与擅自增加的假设,也接受有依据的证伪;验证失败则进入反思阶段,反思 LLM 将整段转录与反馈压缩成新的紧凑上下文,随后模型从当前文件继续下一迭代。整个过程不含任何证明搜索结构,预算上限是唯一的终止条件。
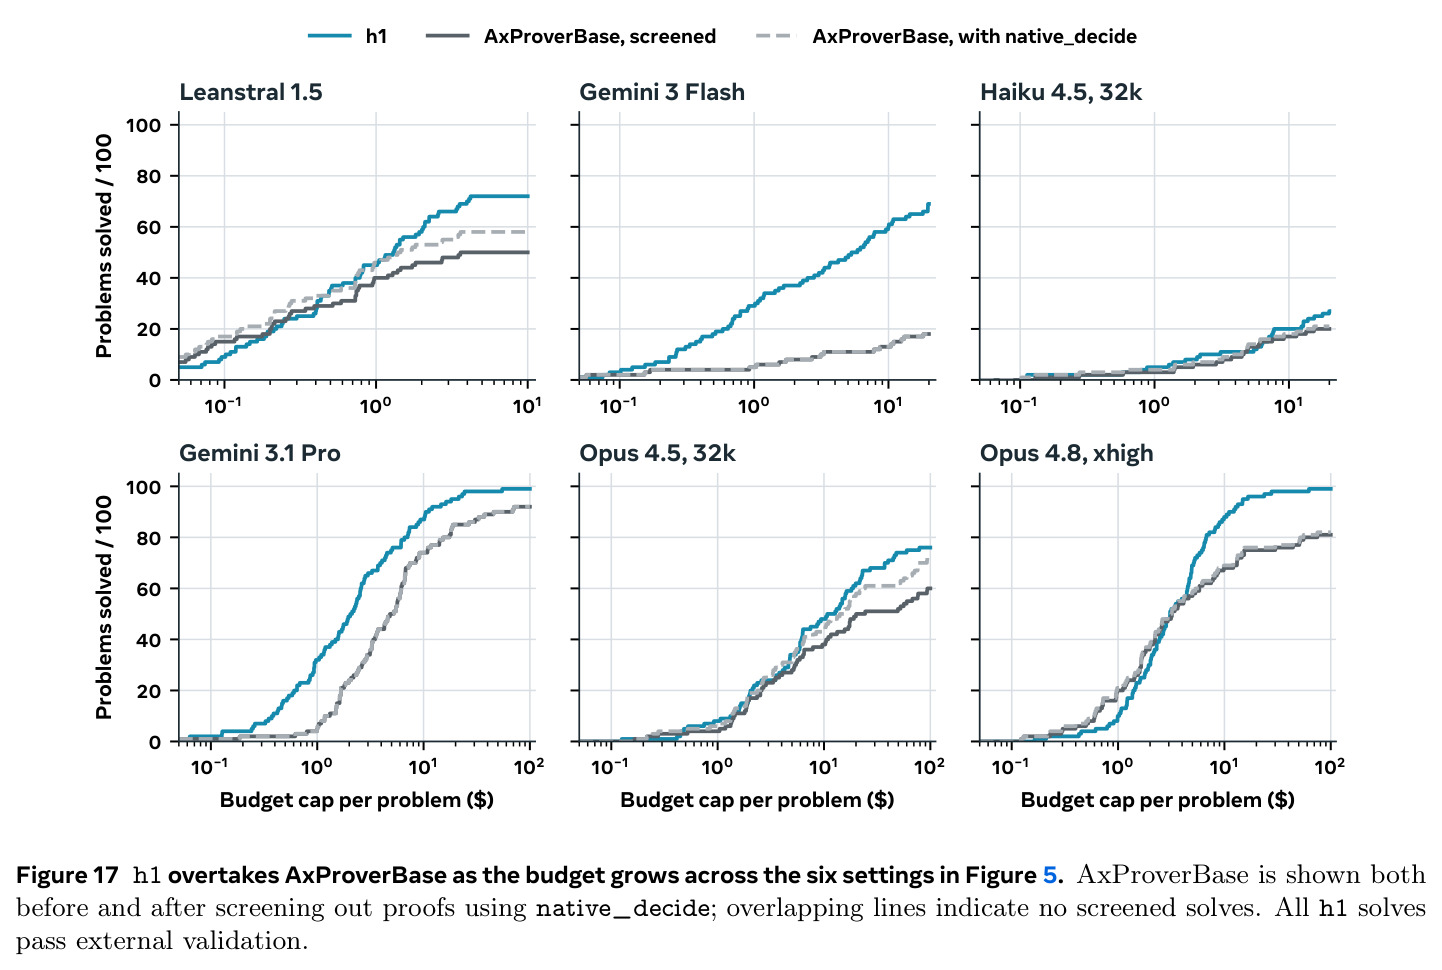
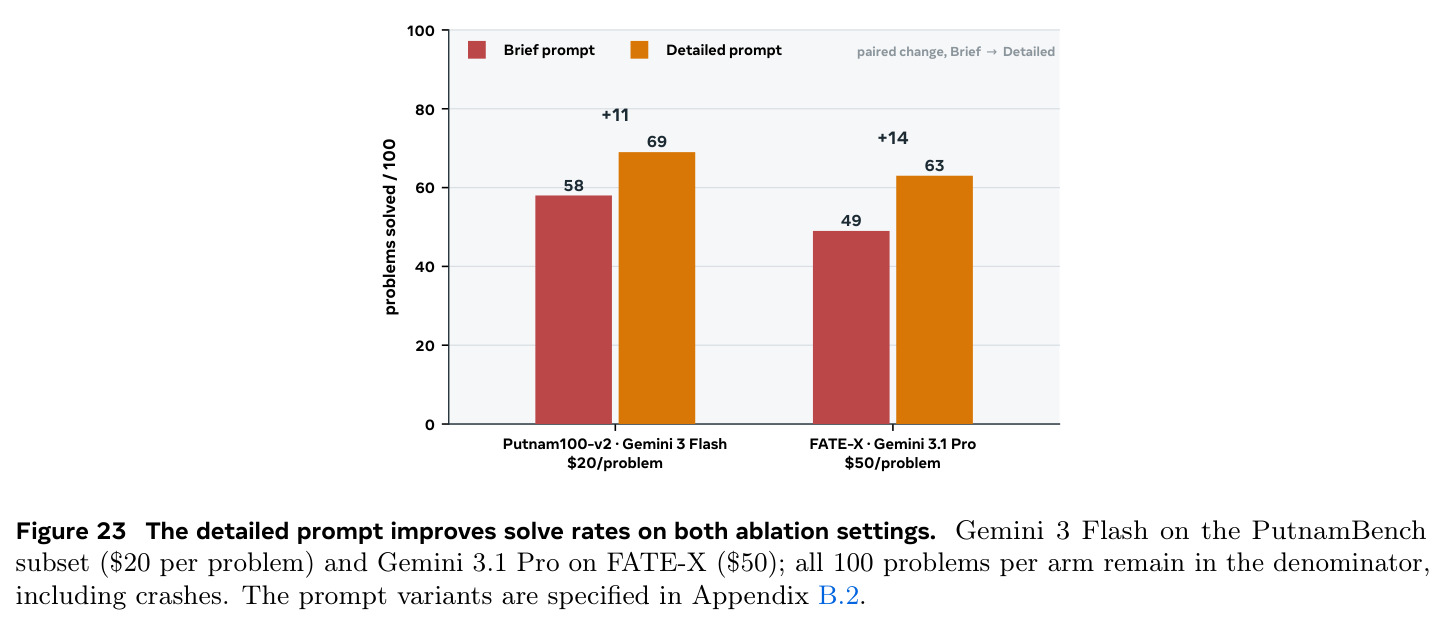
核心创新是把「何时停止」的控制权从模型手中拿走、把「如何证明」的控制权全部交给模型:被拒的提交会开启新迭代而非终止,模型因此无法通过放弃或作弊蒙混过关。与已有方法的本质区别在接口而非流程:AxProverBase 每轮反馈后重新生成完整证明,输出 token 占其成本的 89%($17.39/题)、缓存复用仅 0.5%;h1 则支持小步定向编辑与即时编译反馈,单次迭代内上下文持续增长并被缓存(复用率 74–94%),输出仅占成本的 34%($9.00/题)。Humanfia 每轮以全新会话重启编码代理、只携带证明文件与评审反馈,同样解出 670 题却要多花 5 倍成本。h1 还提供库搜索(LeanExplore/Loogle/grep)、REPL 片段测试与 LSP 目标查看等可选工具,用不用、怎么用完全由模型自行决定——这正对应「把人类努力花在接口上、把算力花在模型推理上」的分工。
方法步骤详情
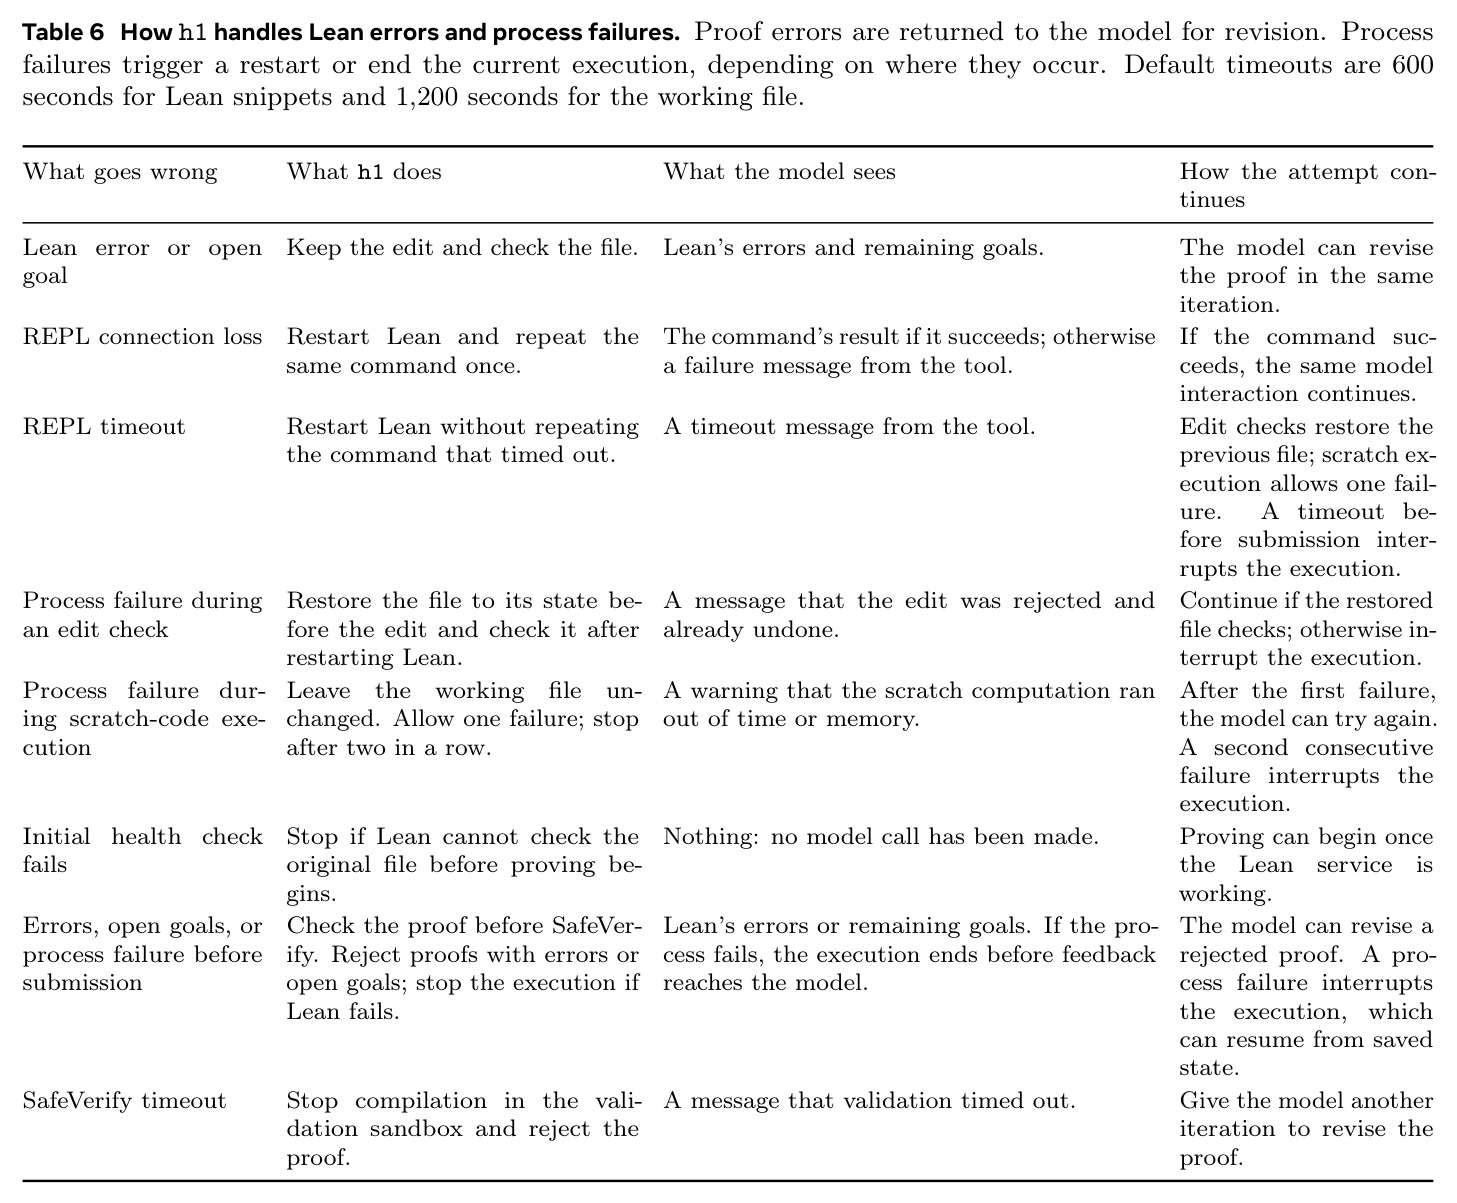
第一步,初始化:给定 Lean 形式化陈述(含假设),创建导入全部 Mathlib 的持久工作文件。第二步,迭代内工作:模型进入最多 $T$ 轮的多轮推理与工具调用,可用 LeanExplore 语义搜索、Loogle 类型搜索、grep 字符串检索 Mathlib,用 REPL 测试证明片段,用 LSP 查看目标与定义;每次定向编辑文件后立即编译,拿到错误与开放目标。第三步,提交与验证:模型主动提交或达到 $T$ 轮上限被强制提交;SafeVerify 对照原陈述机械验证,接受完整证明或(在支持的场合)反例证伪,拒绝占位符与额外假设。第四步,反思压缩:验证失败后,反思 LLM 将转录压缩为「已验证进展 + 失败教训 + 有用引理名」,并劝阻放弃(尤其是问题本身是开放猜想时)与作弊行为。第五步,继续循环:模型带着压缩上下文与当前文件进入下一迭代,直到验证通过或成本上限触发。第六步,评估:预算 $B$ 下计入预算内获得已验证证明的题目;平均成本计入全部题目,含失败题且单题封顶 $B$。
技术新颖性
单看组件无一全新:ReAct、Reflexion 式反思、REPL、Lean 官方工具皆已有之,h1 明确自认建立在 APN basic、AxProverBase 与软件工程的 Ralph 循环之上。真正的新颖性有三层。其一,评估方法论:以 API 等价成本为主轴画成本-成功曲线,固定模型比框架、固定框架比模型,并坚持把失败尝试的成本计入重复采样,使 pass@k 与延长单次尝试可公平比较——这在定理证明文献中几乎无人系统做过。其二,实证确立「简单循环 Pareto 优于专用工作流」这一反直觉结论:在对比的 707 个基准题中仅 2 题例外。其三,量化框架设计自由度的贡献:缓存复用率、反思间隔、推理努力、提示词详细程度各自影响多少解题数与成本,给出可迁移到其他「带验证器的富环境」(软件验证、大代码库编码)的工程结论。
实验结果
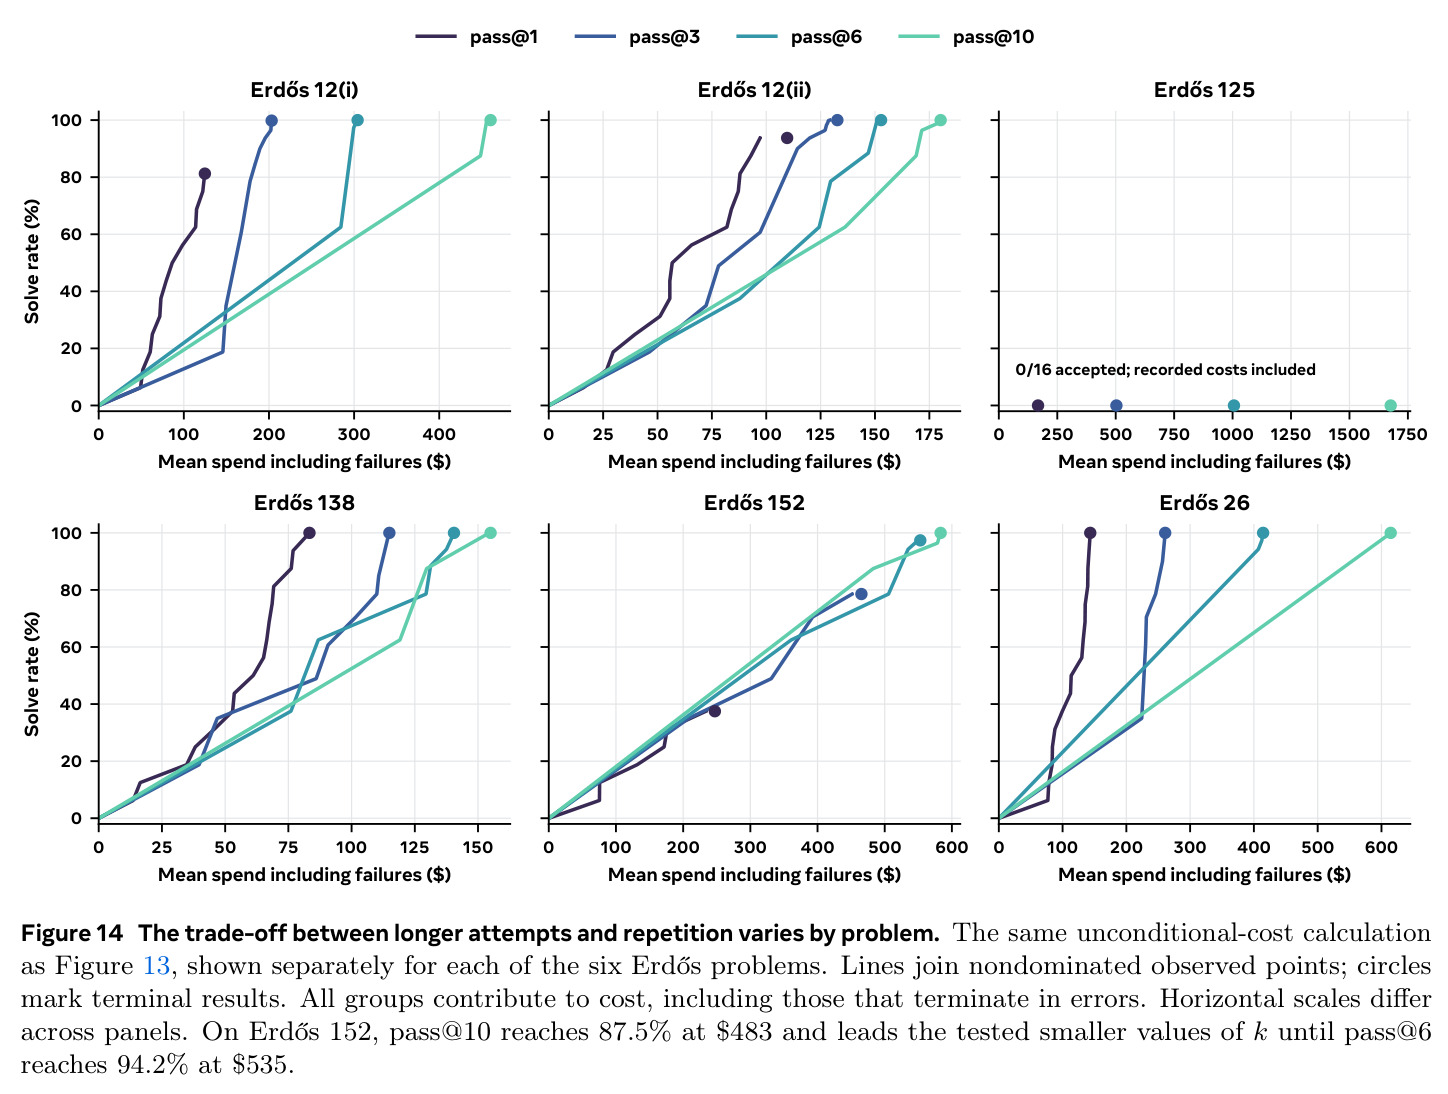
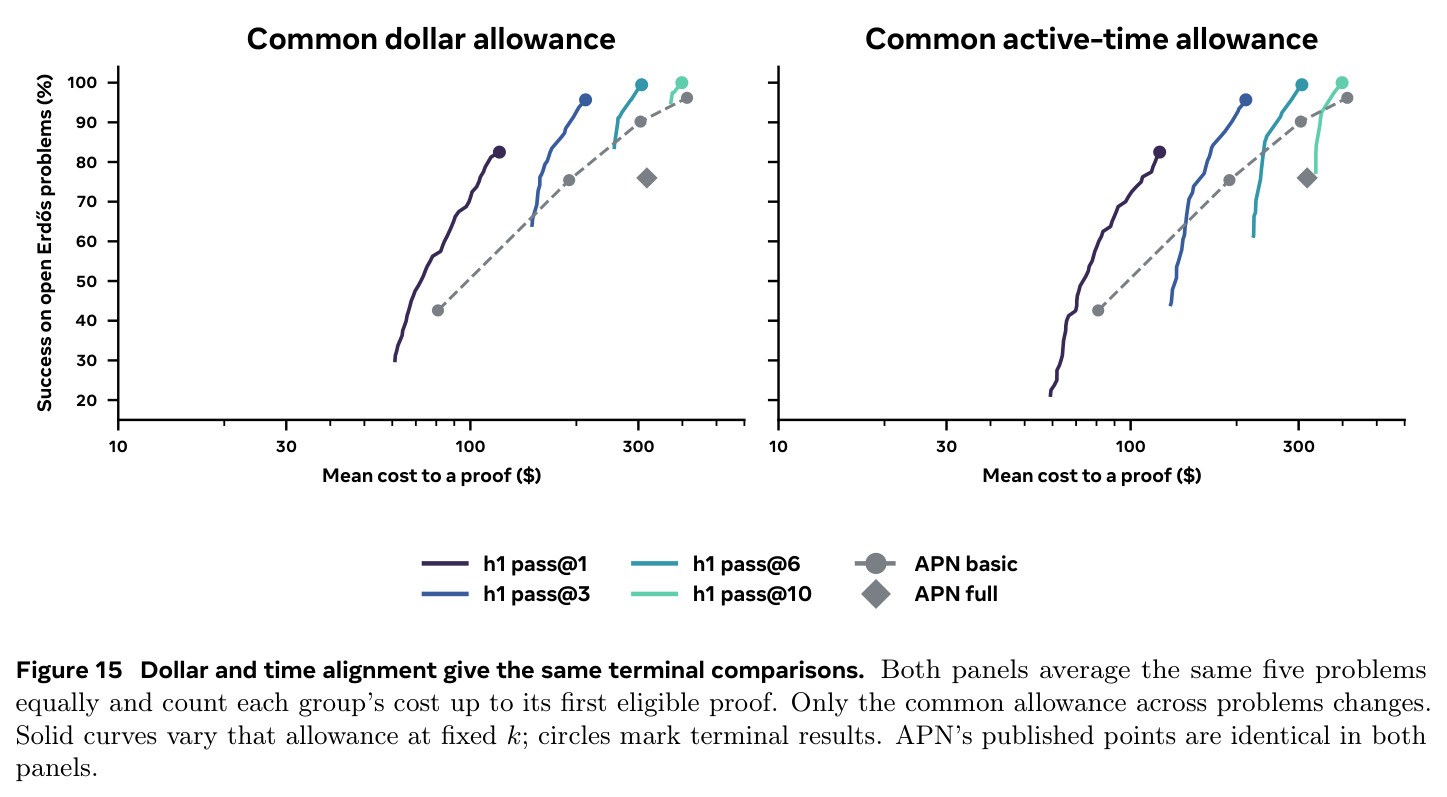
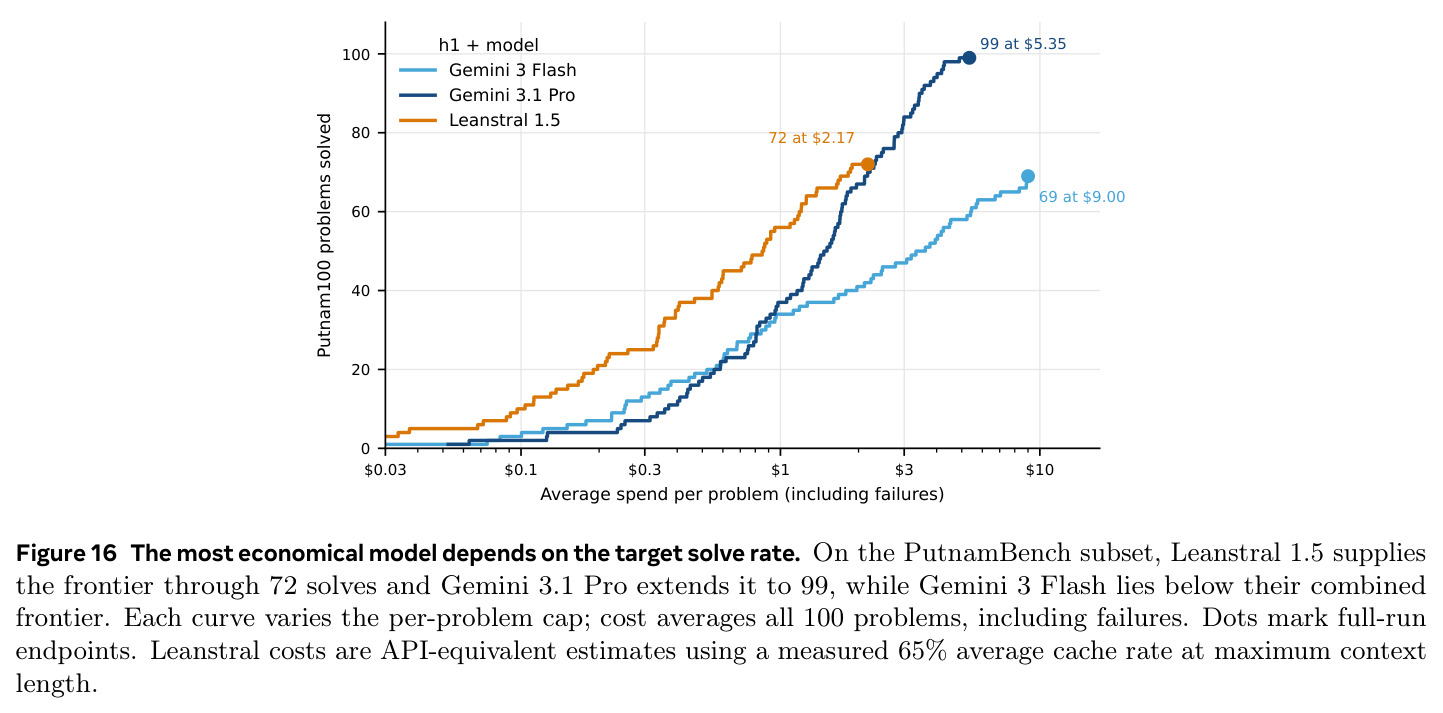
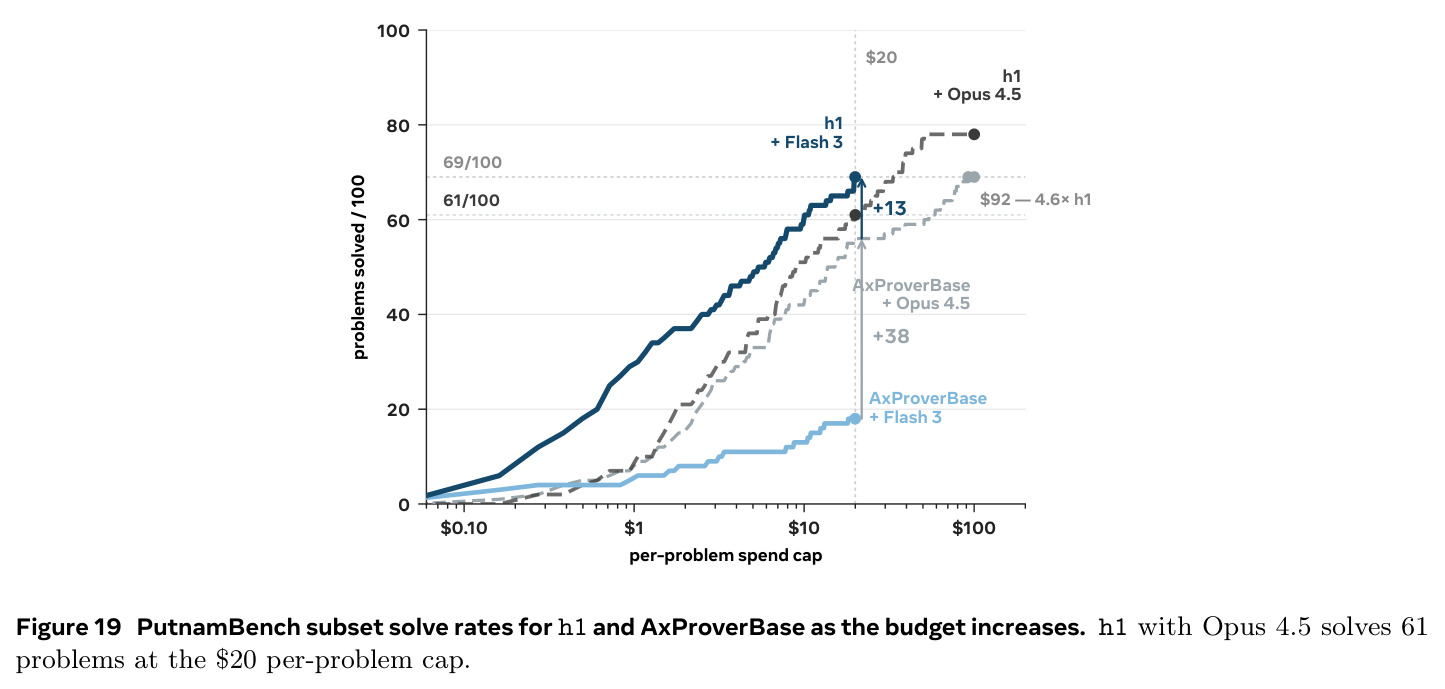
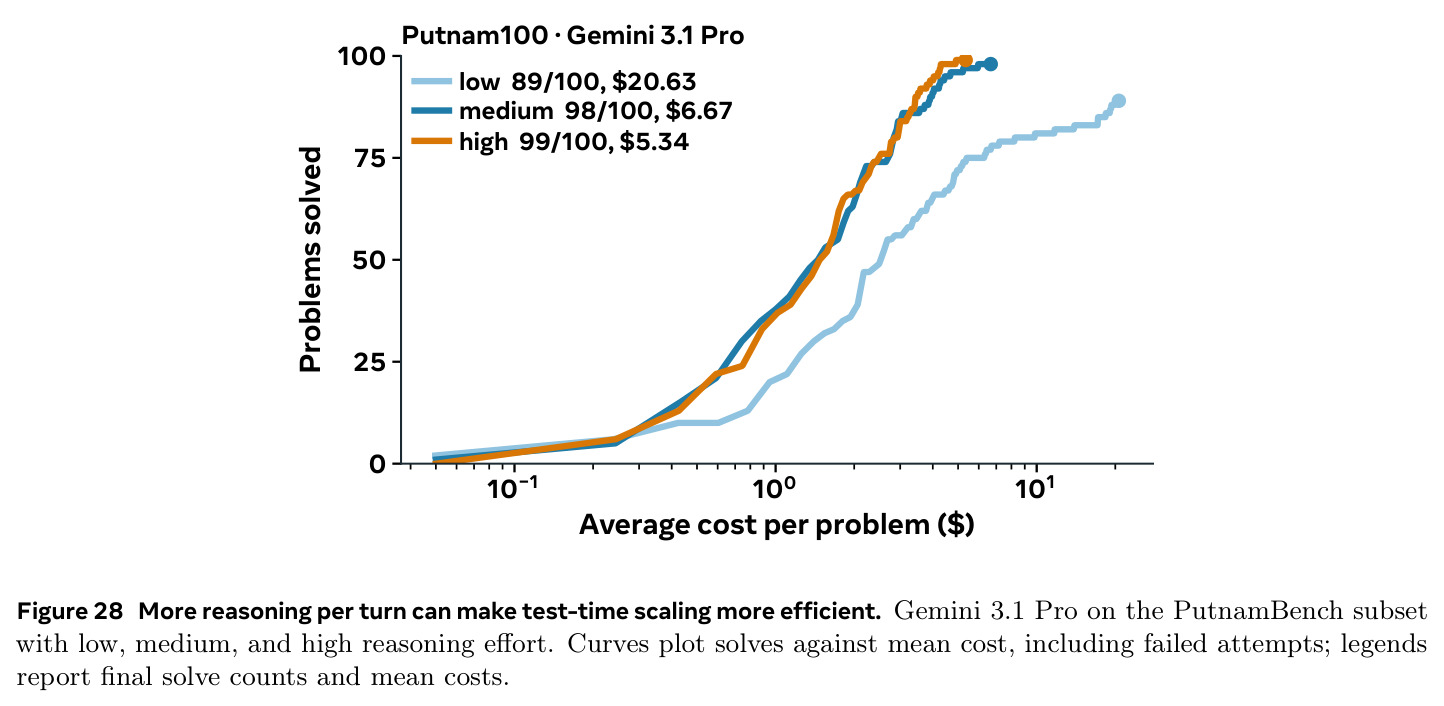
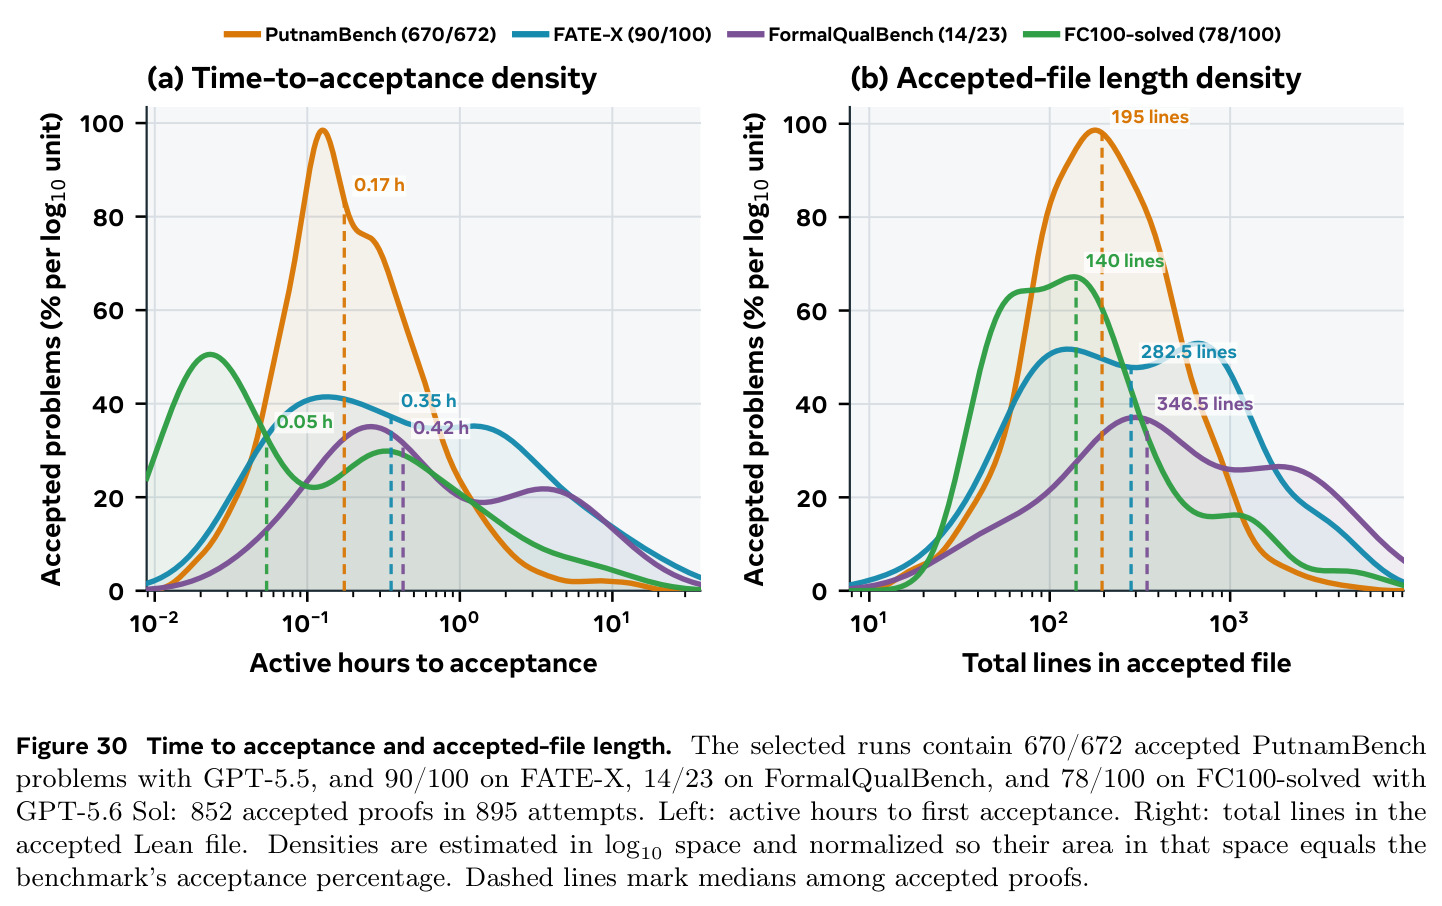
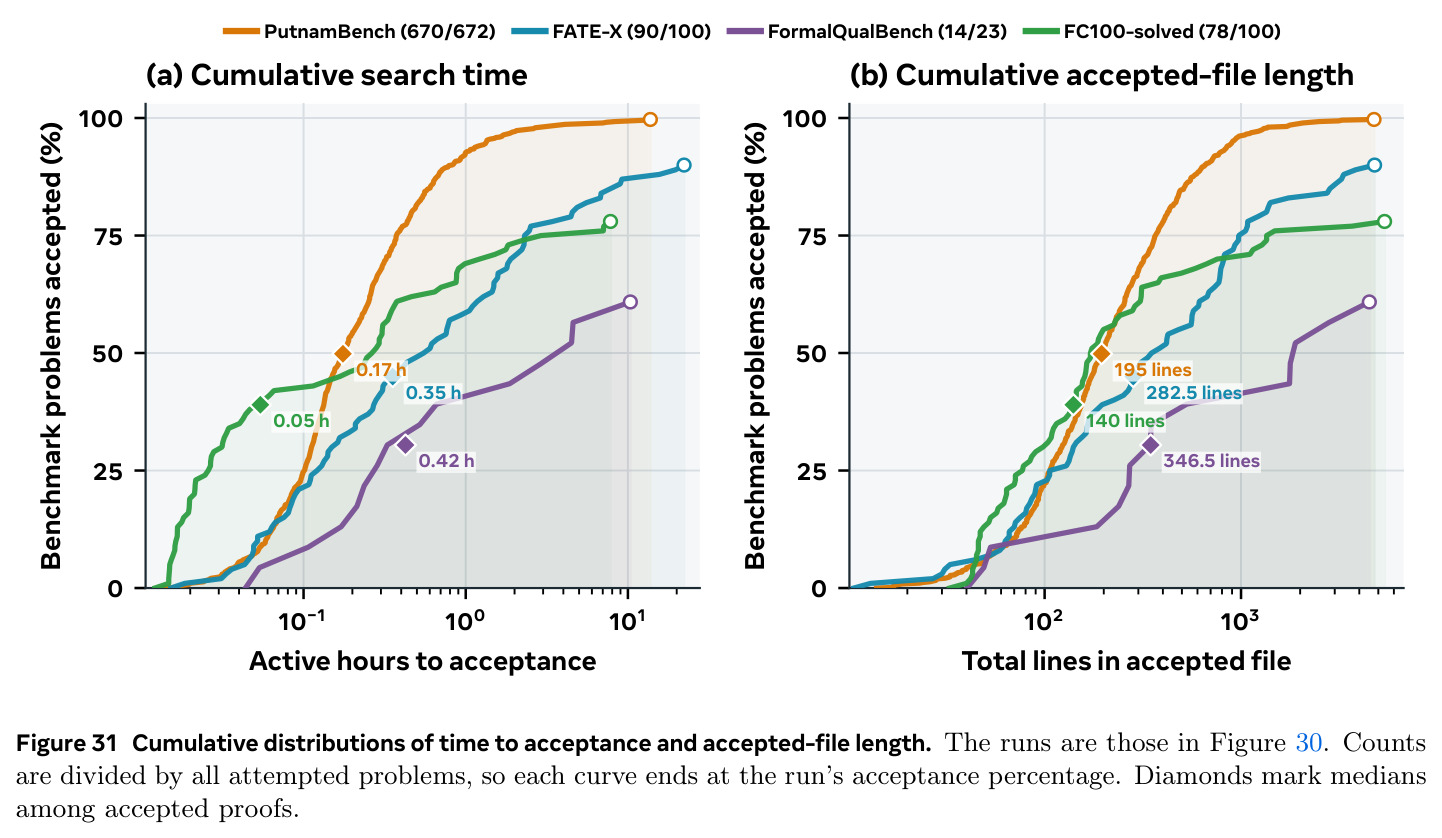
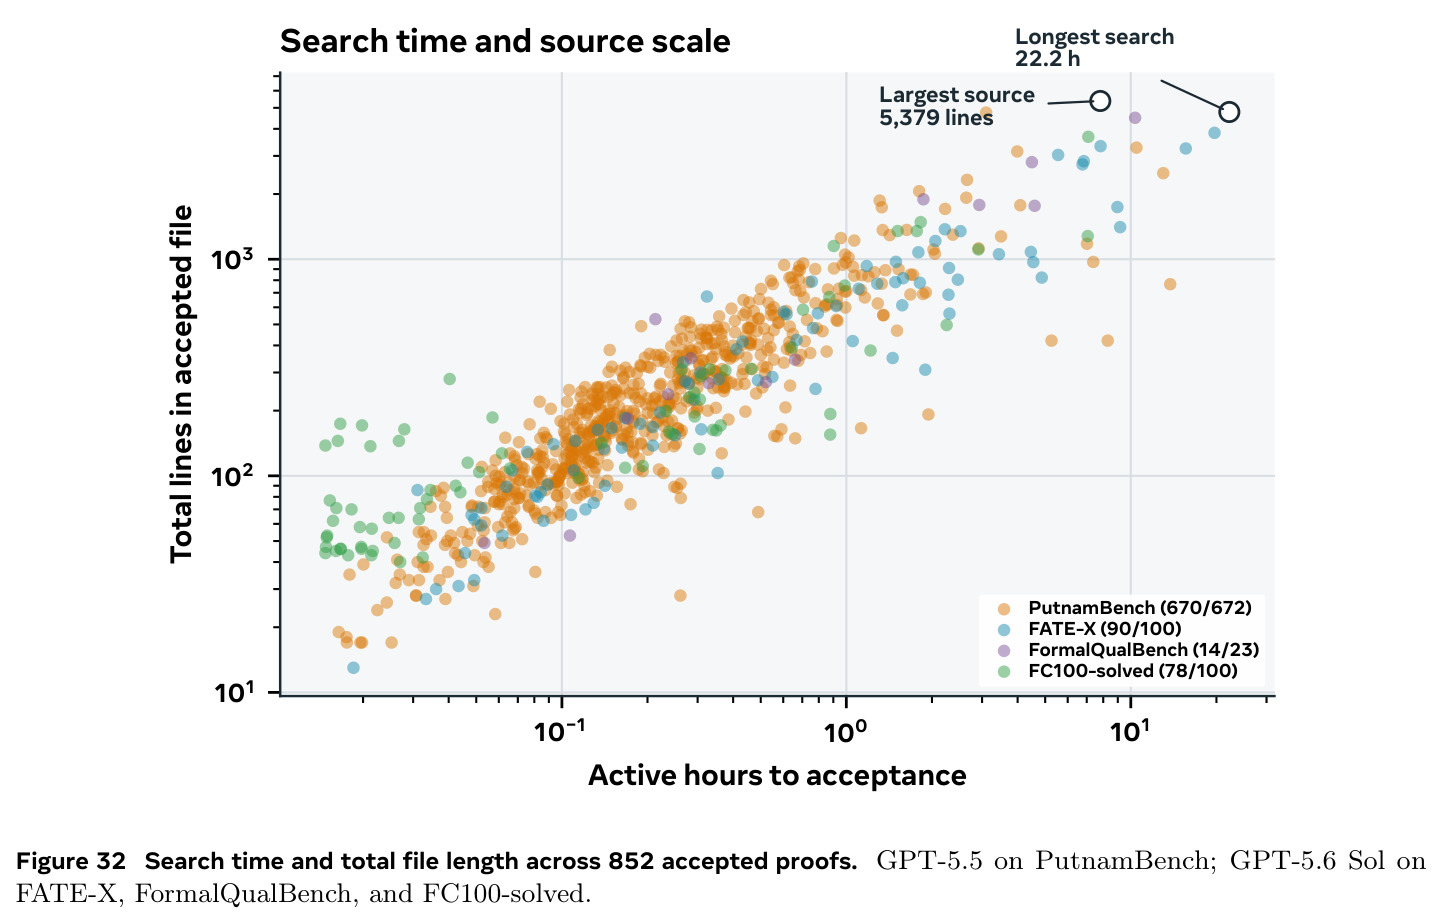
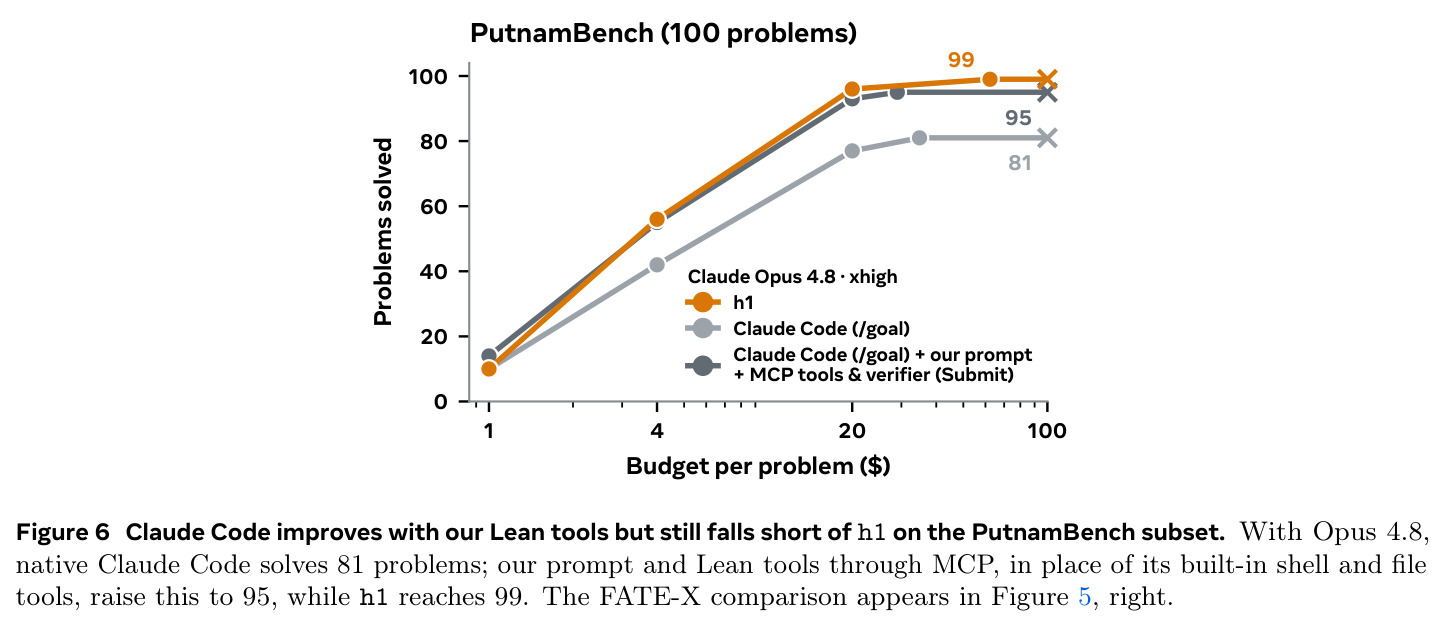
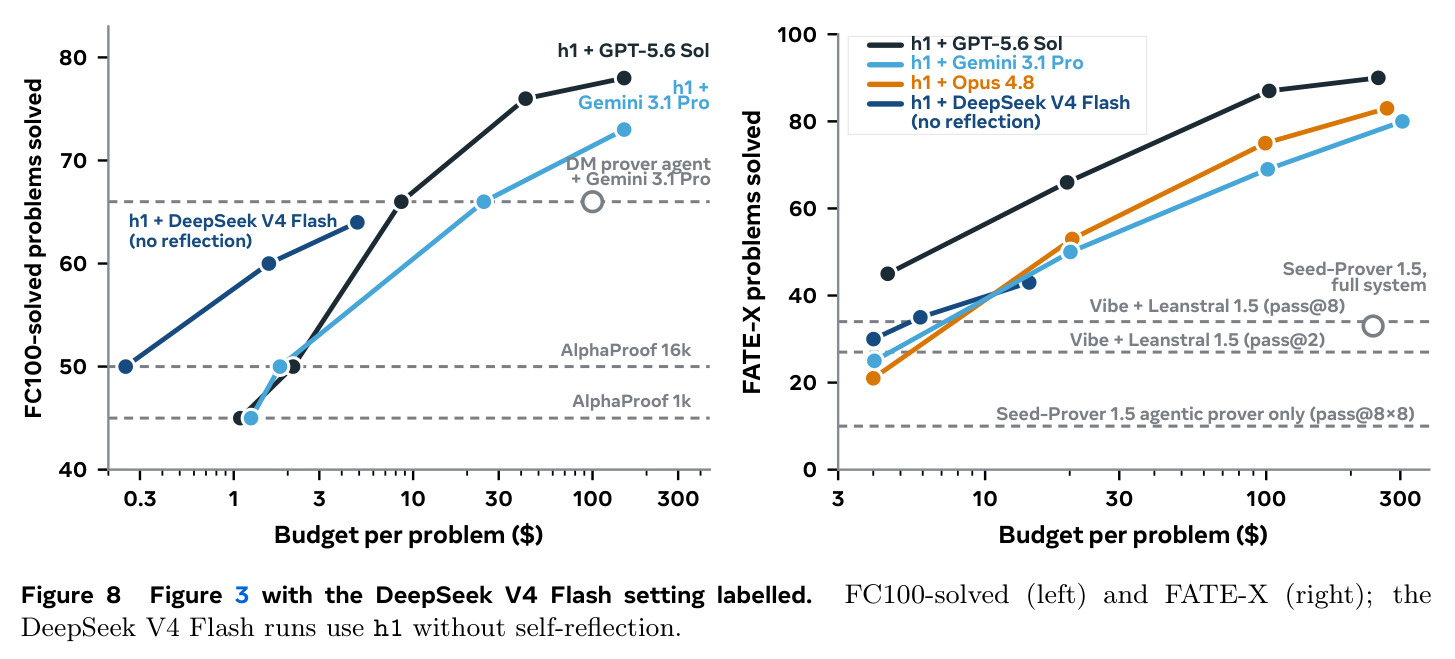
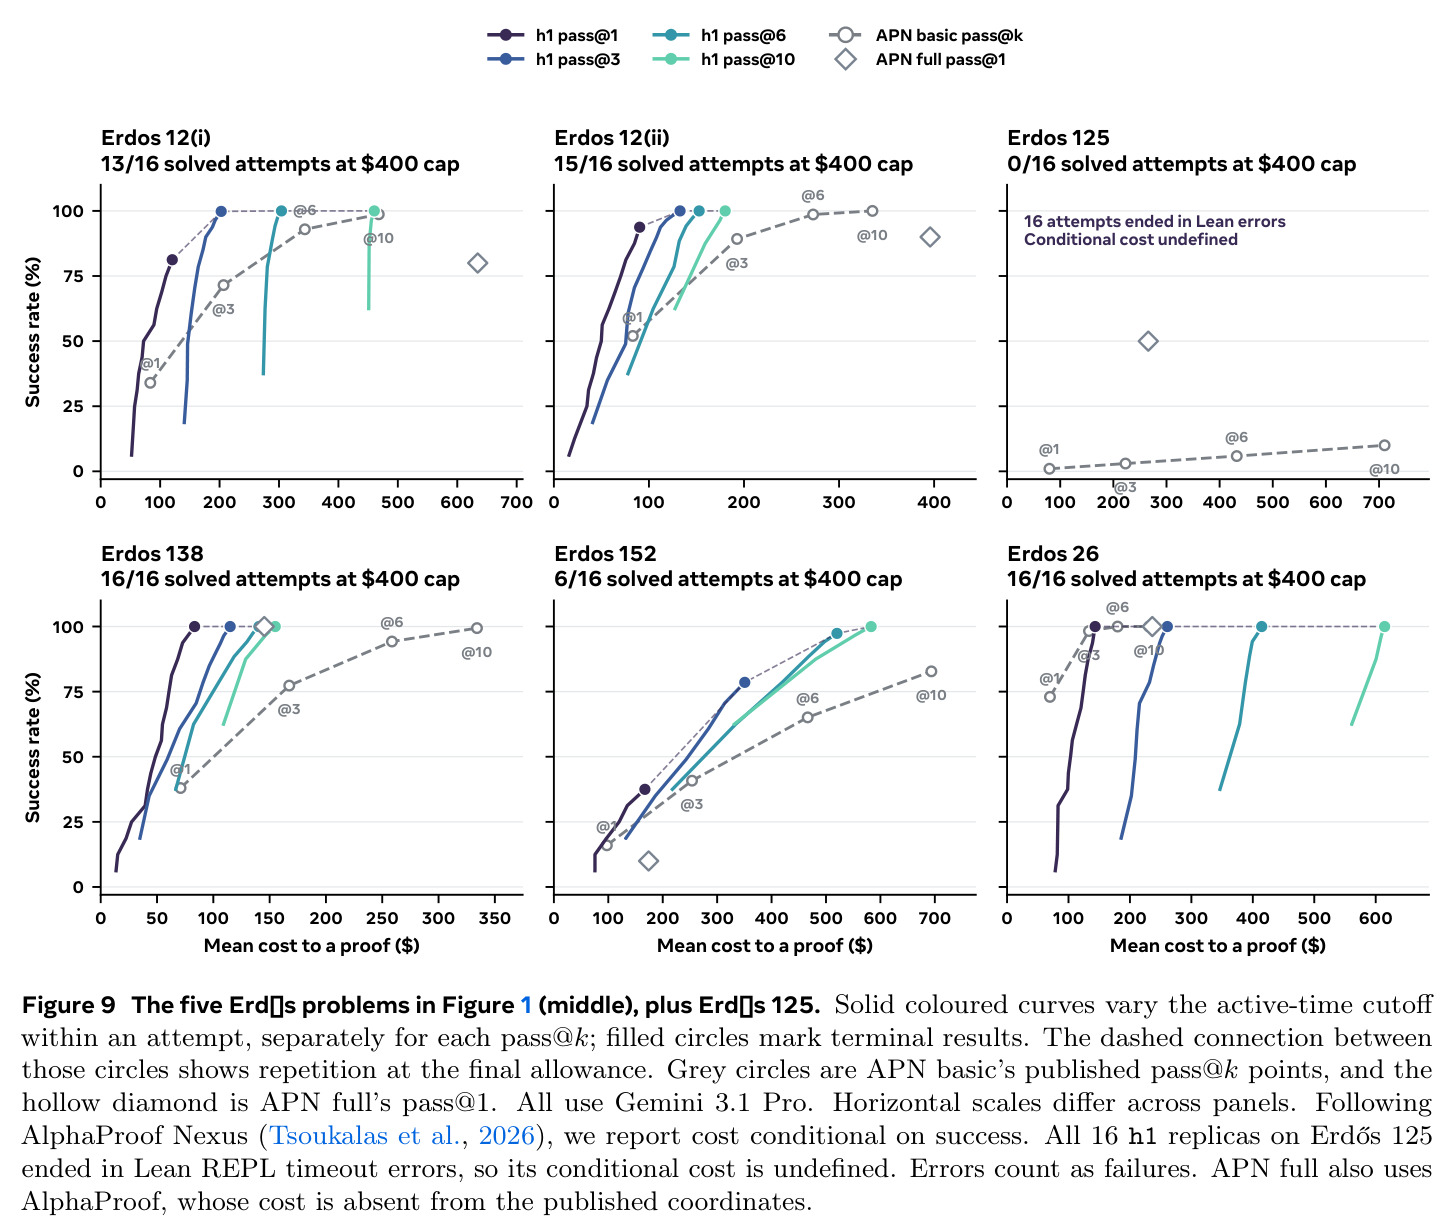
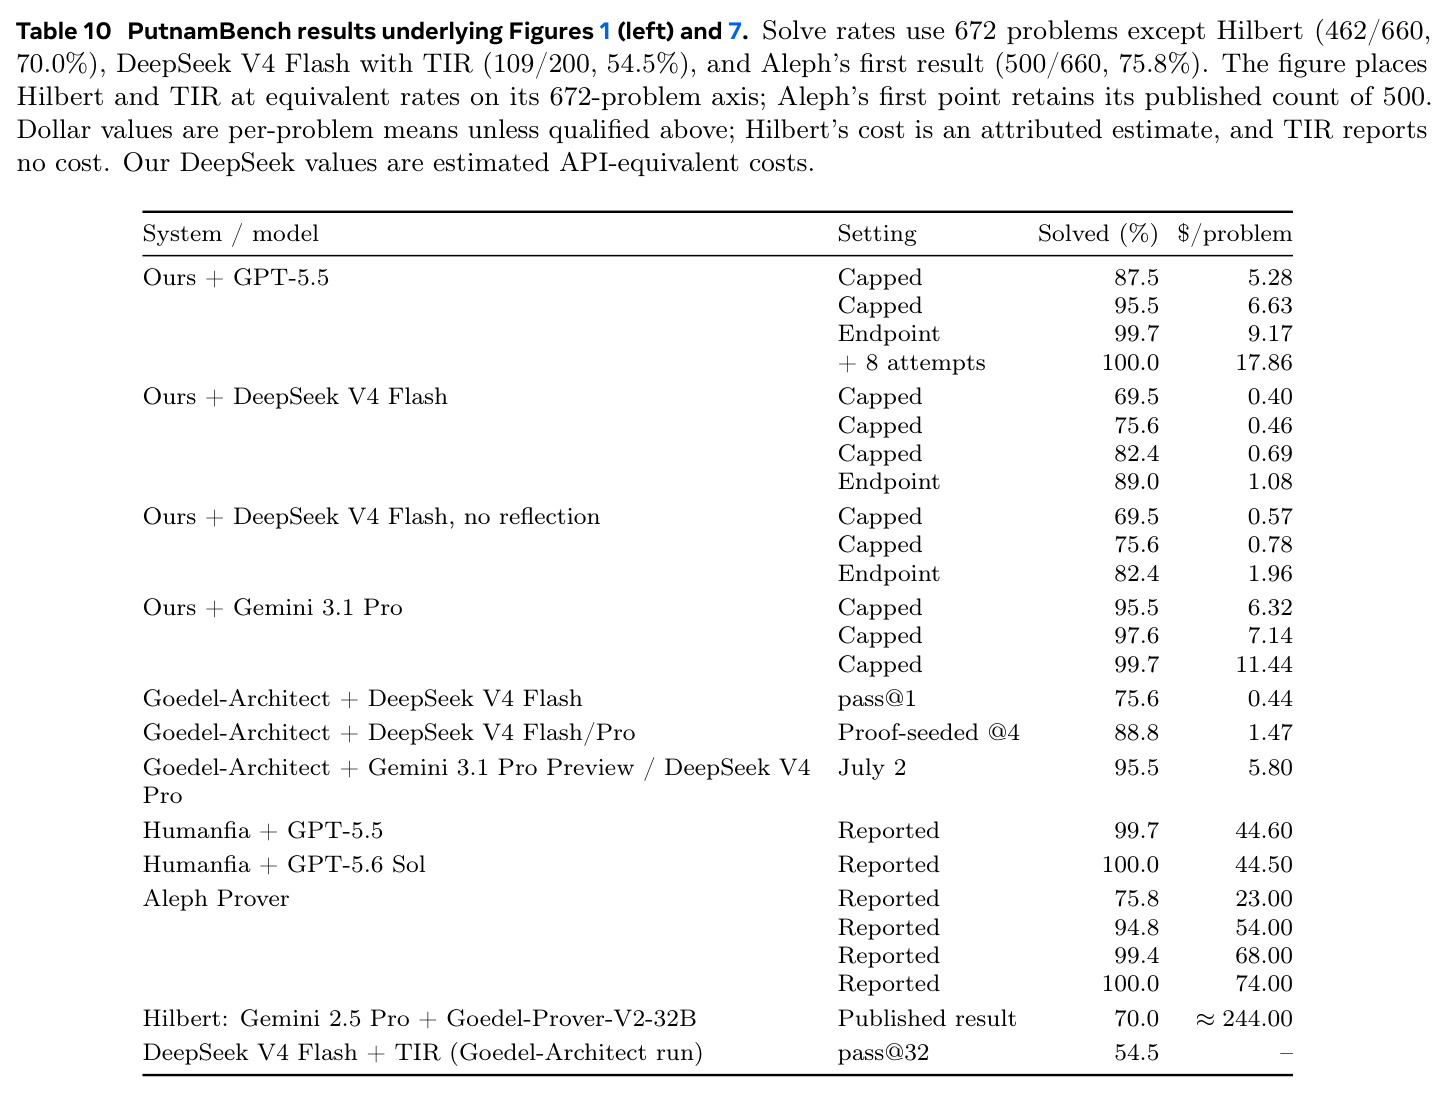
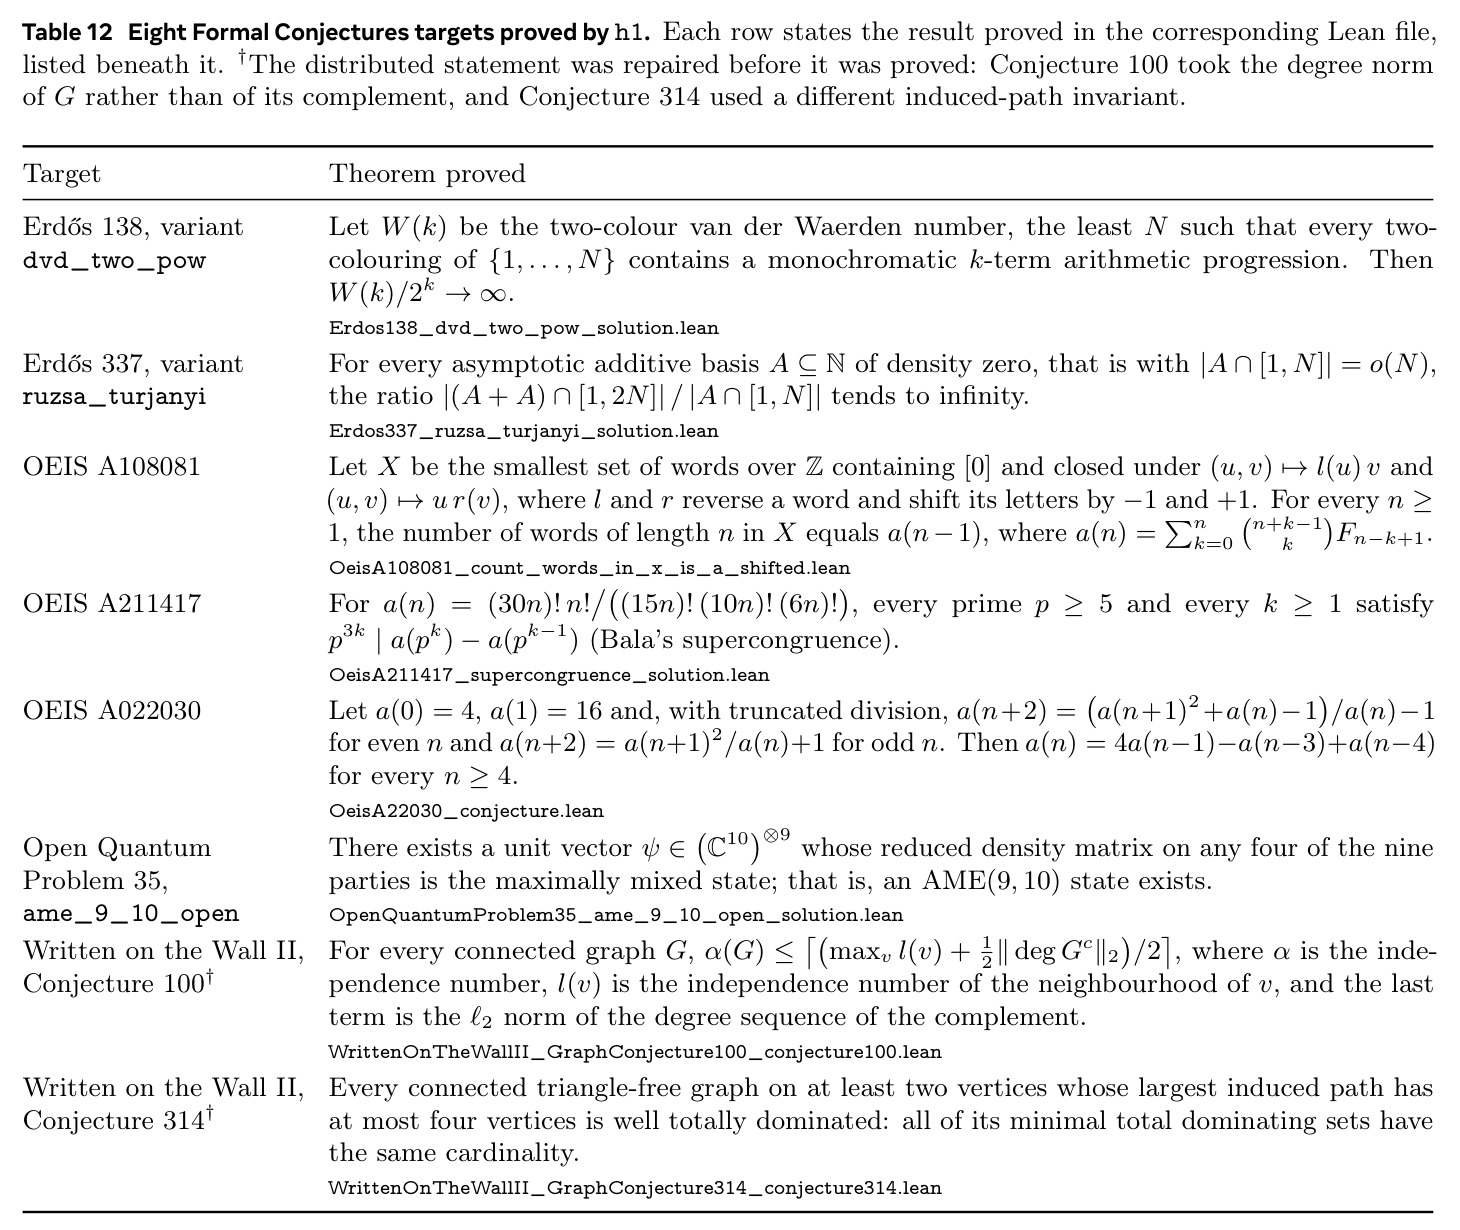
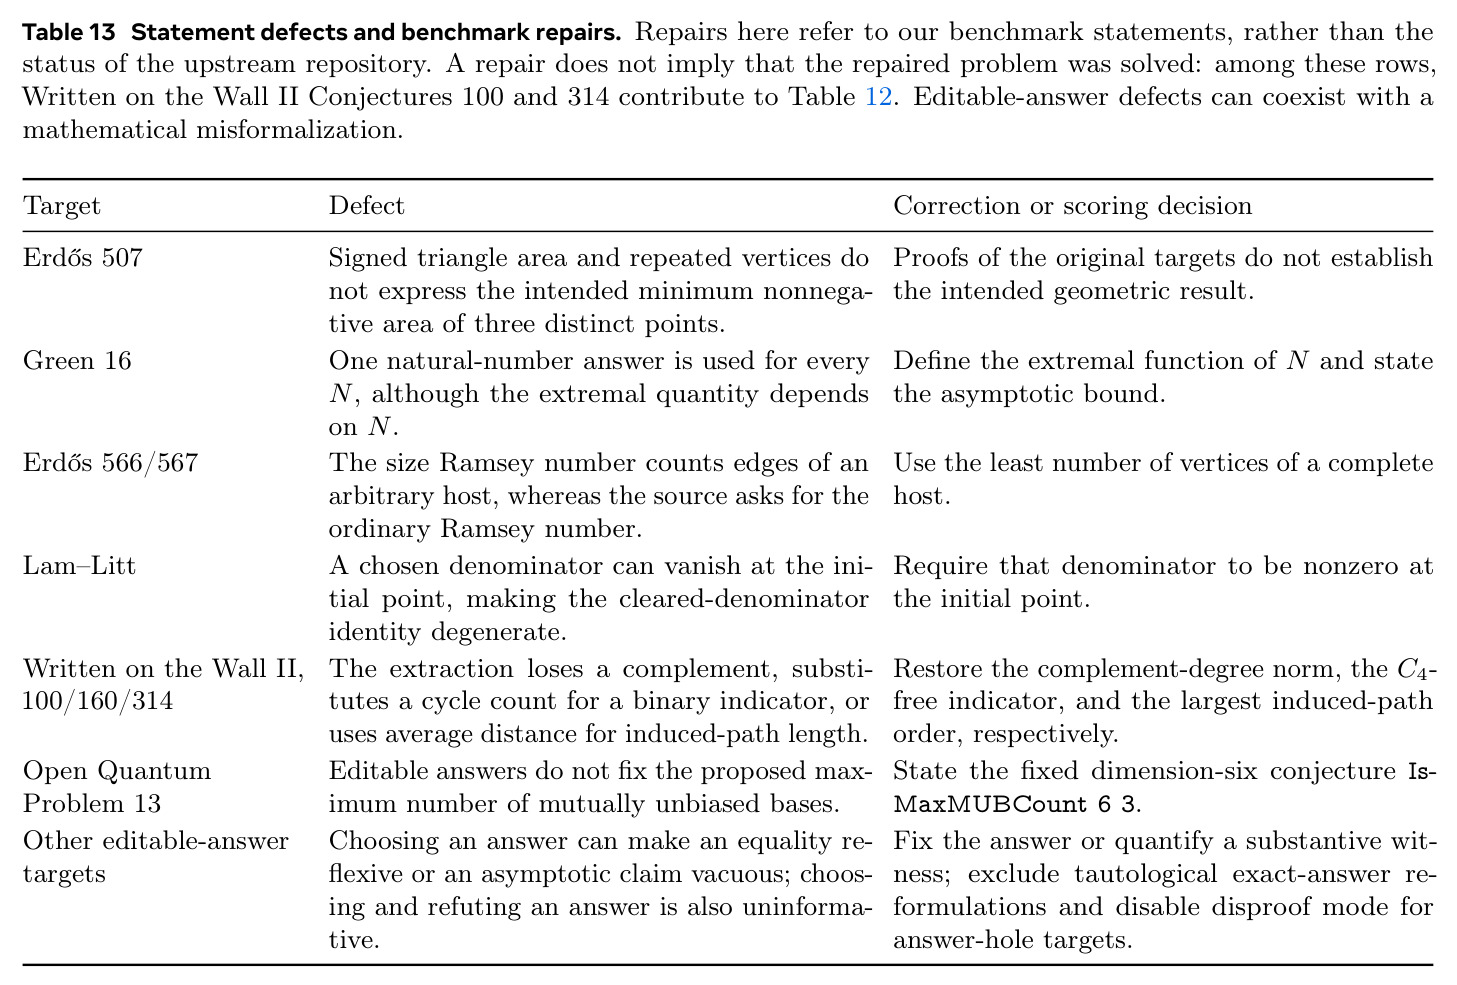
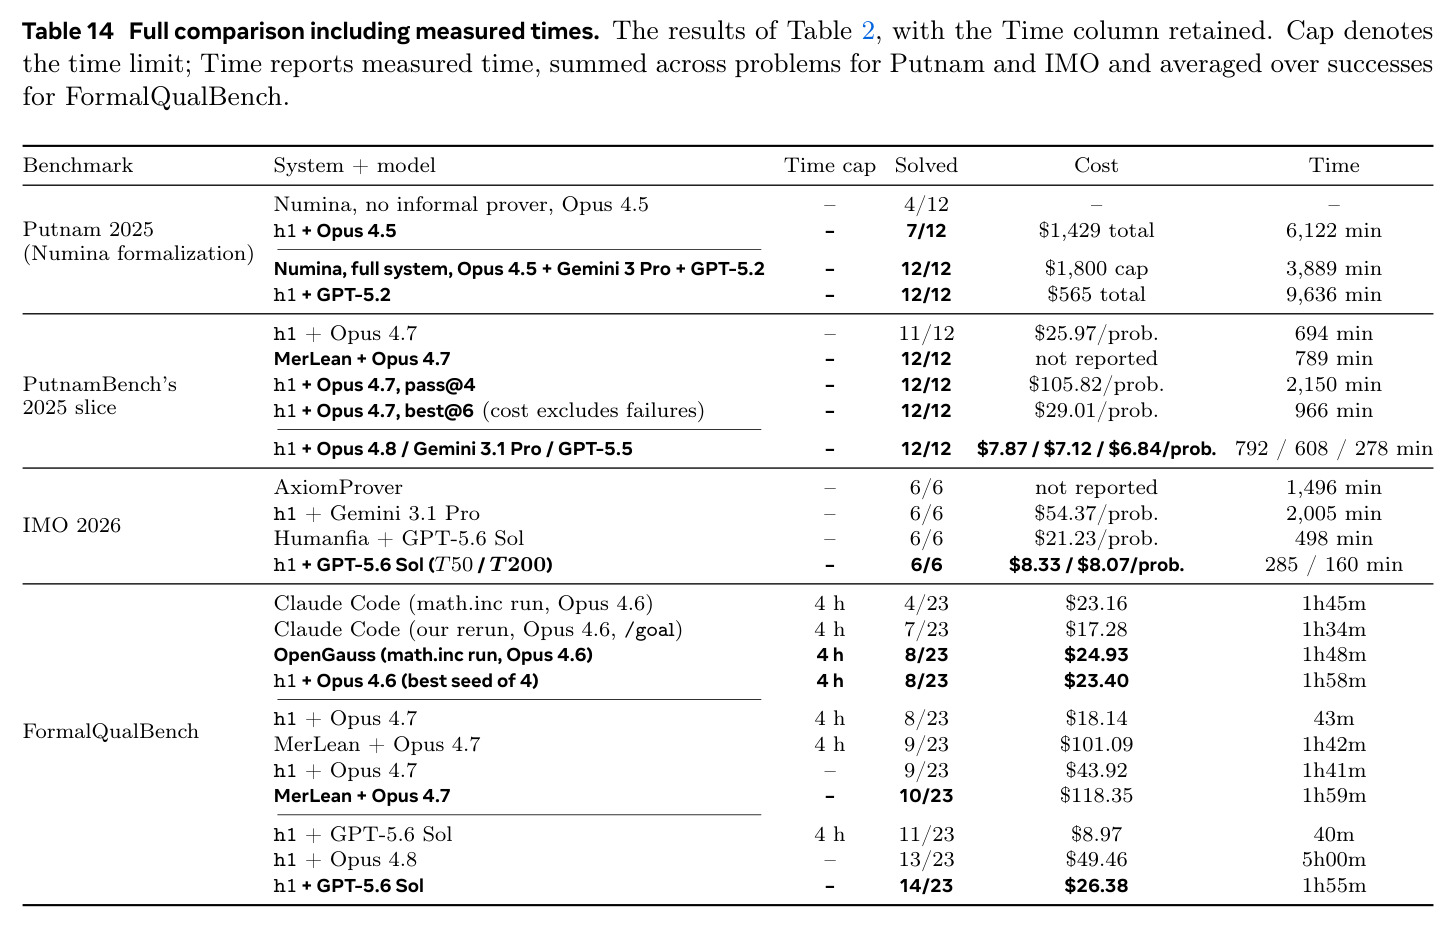
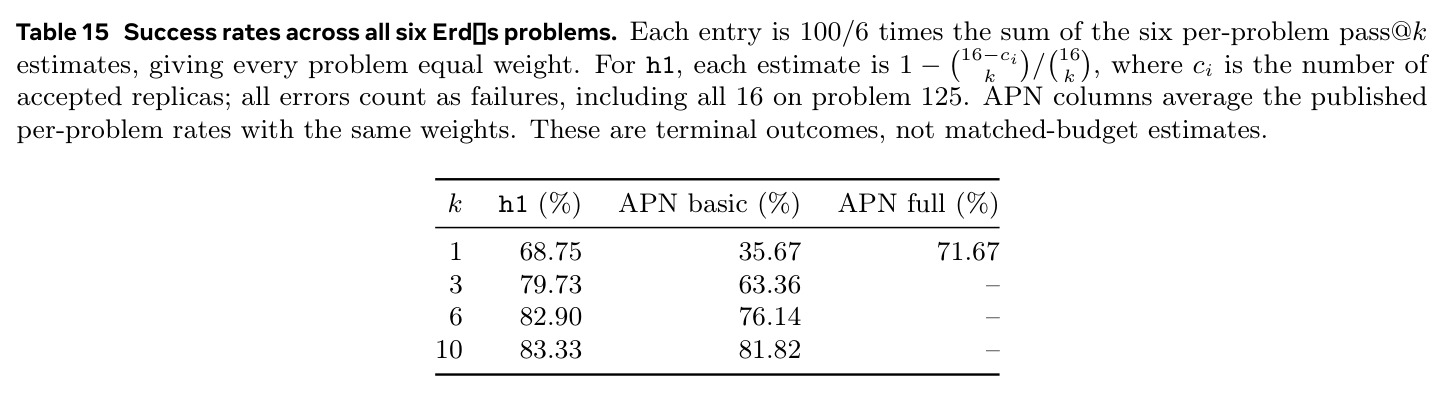
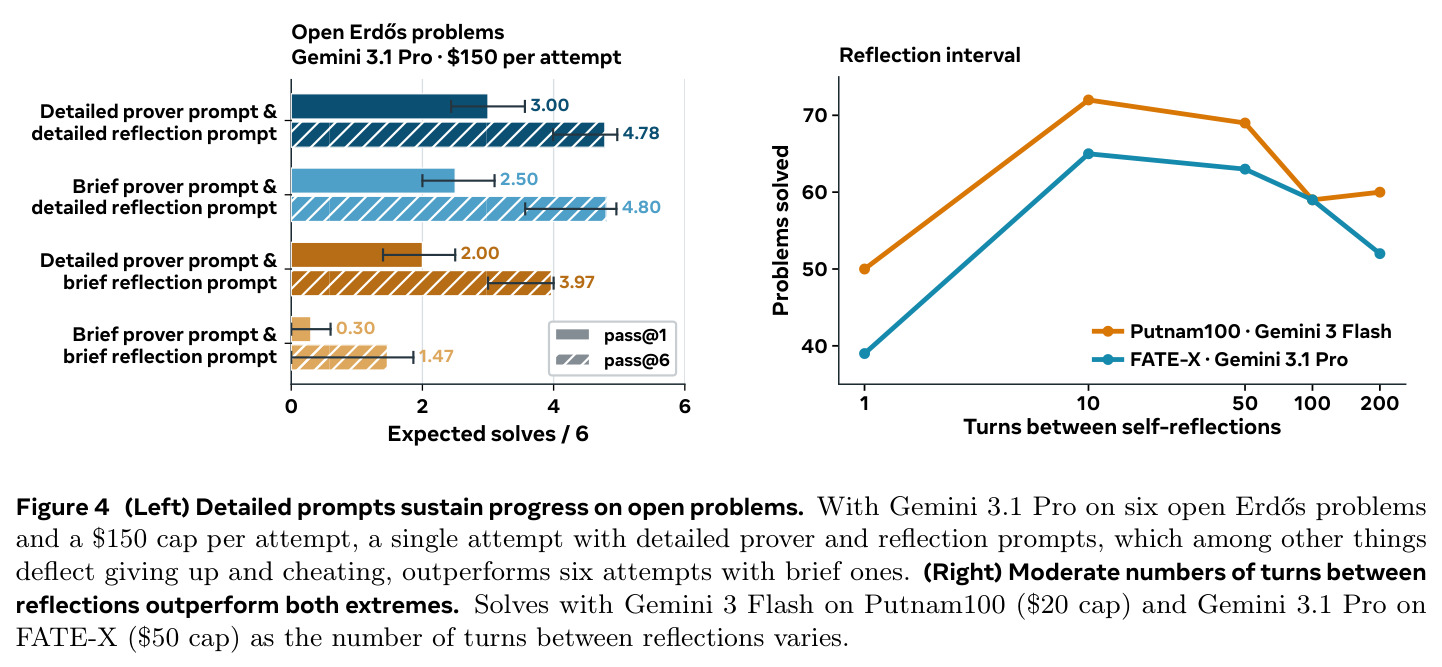
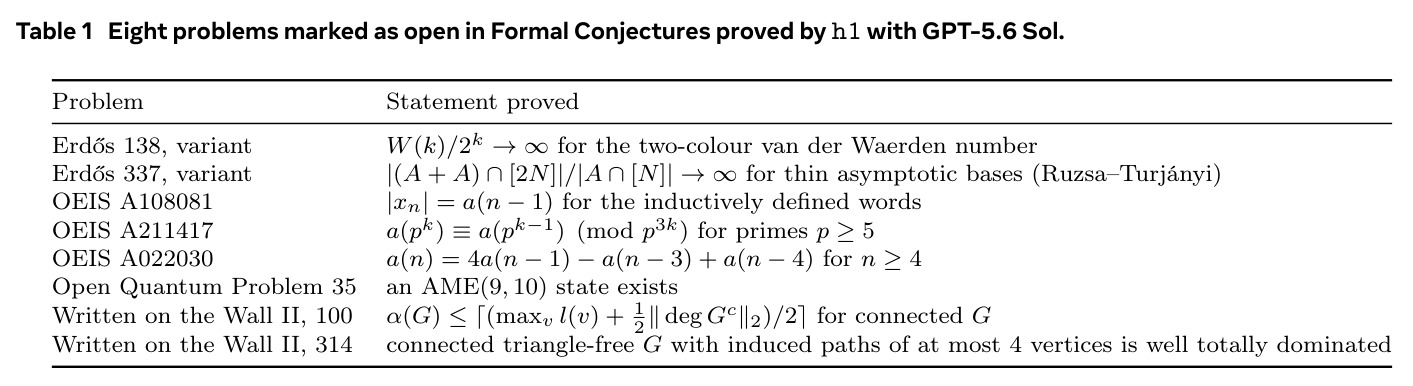
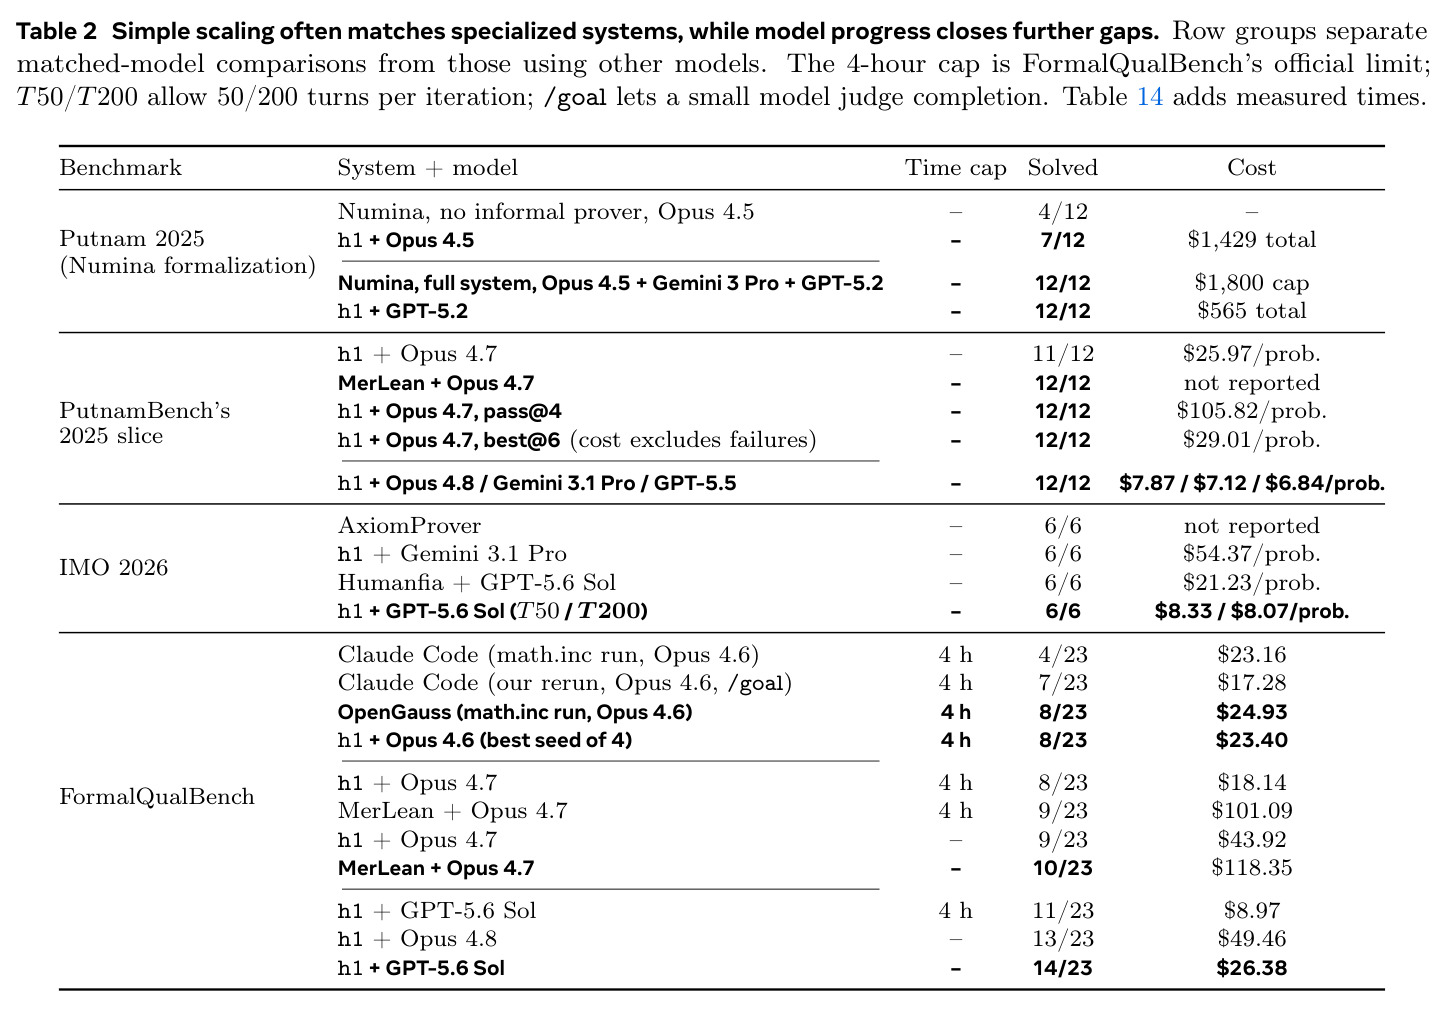
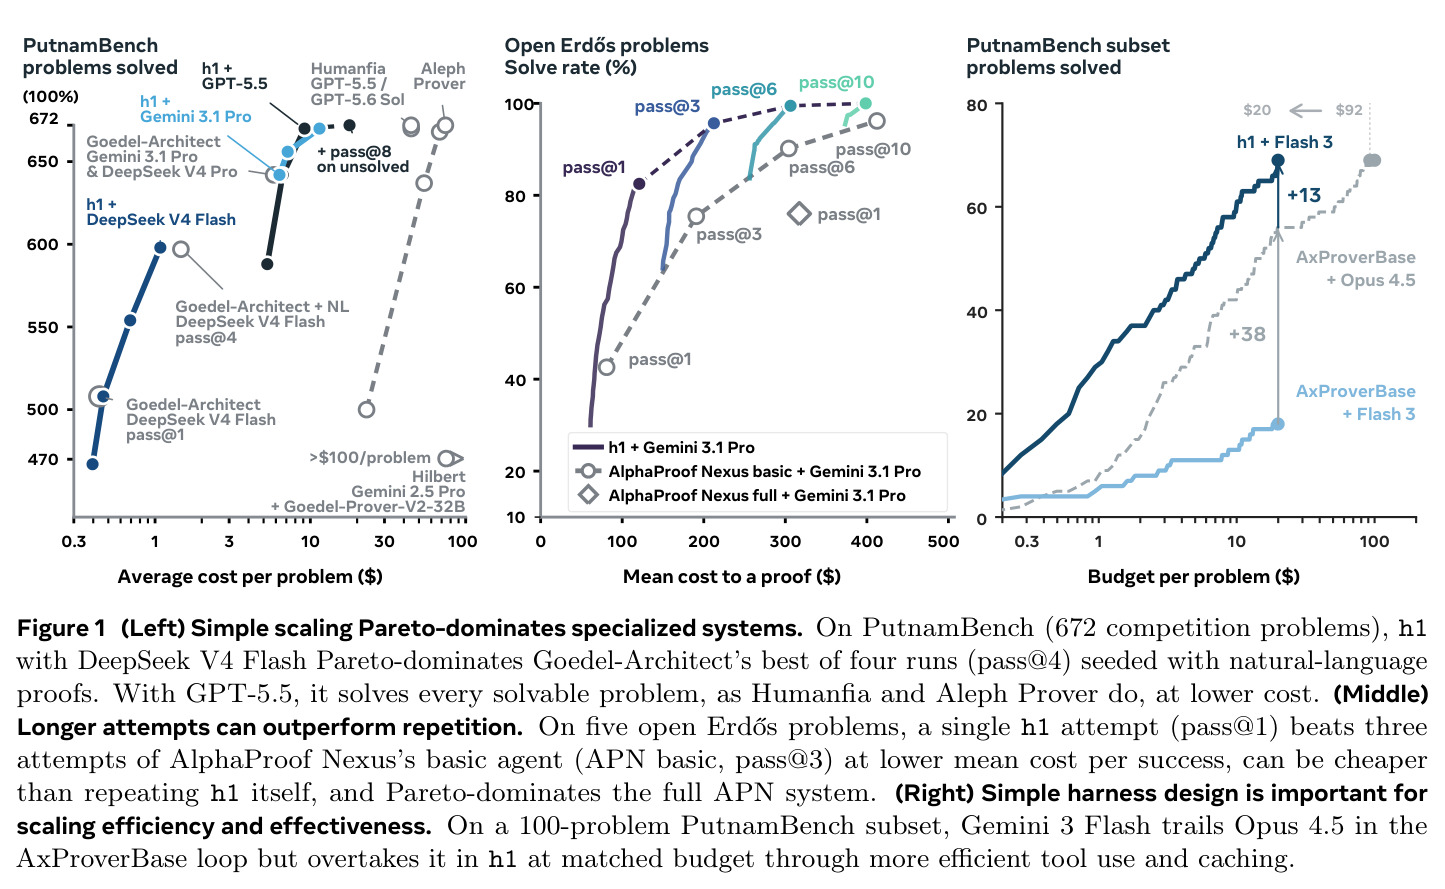
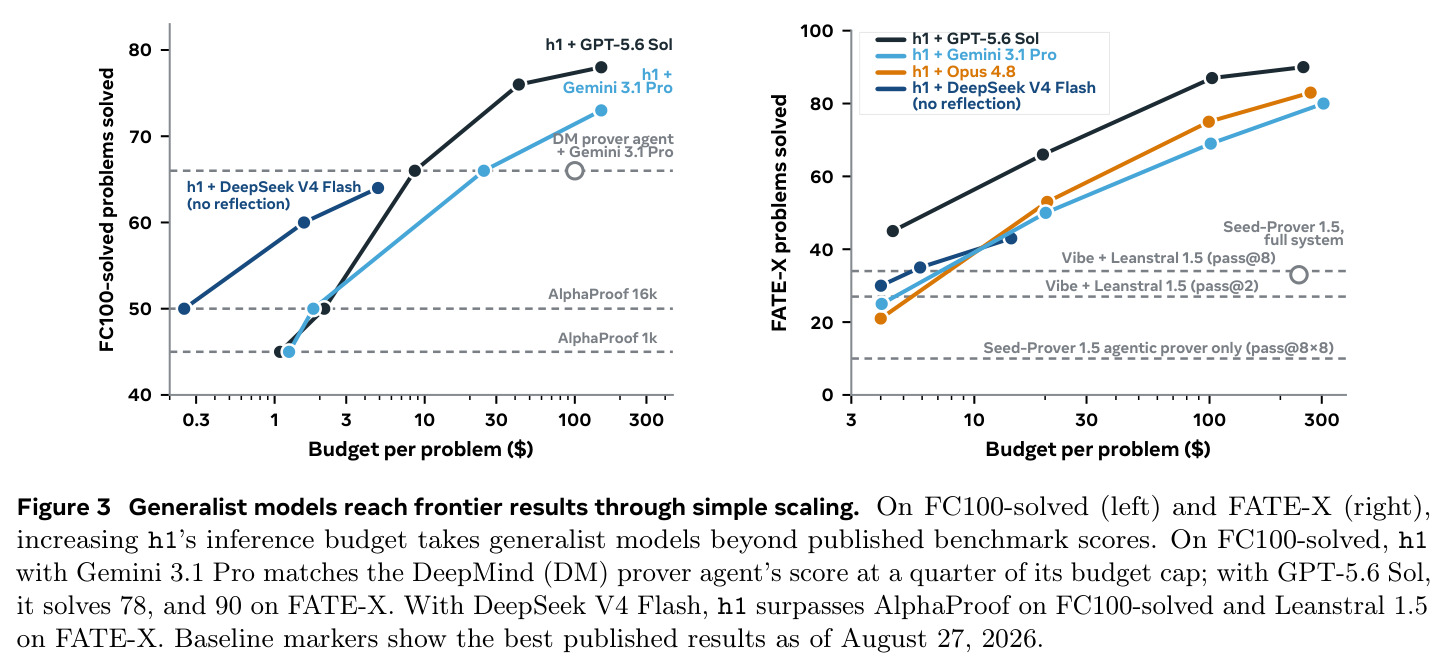
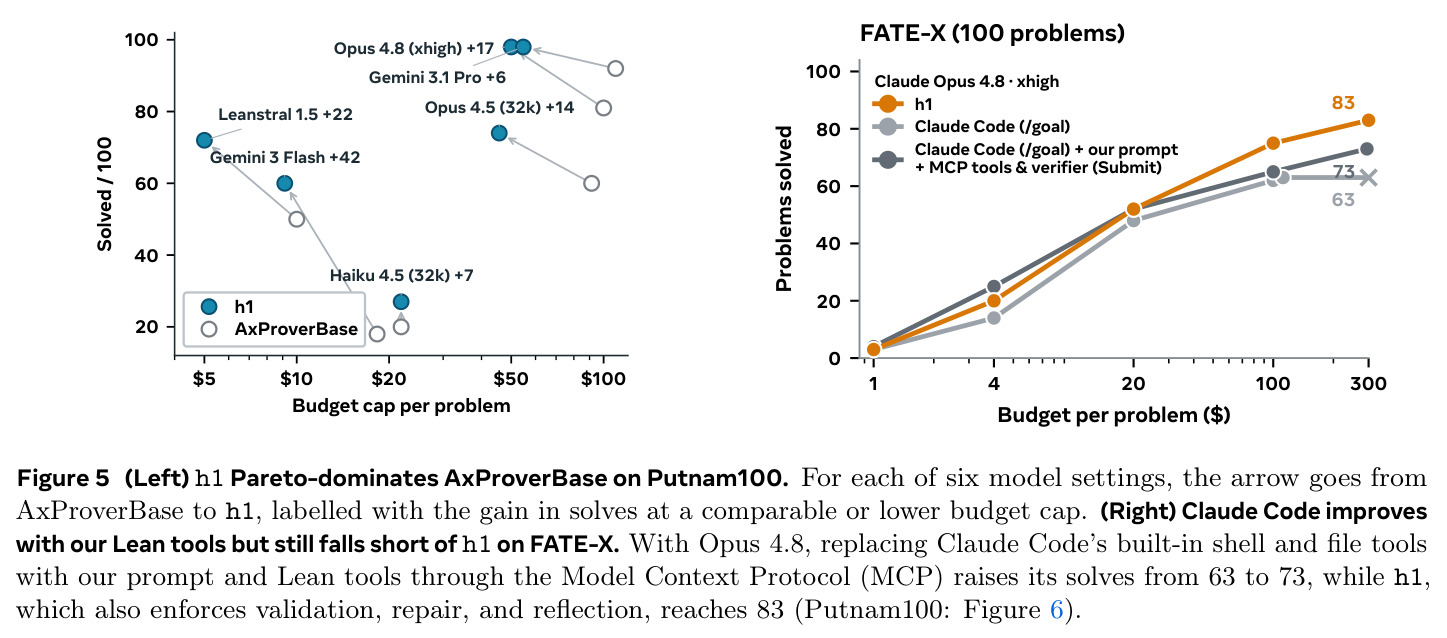
简单缩放即达SOTA:GPT-5.6 Sol在h1上解出FATE-X 90/100、FC100-solved 78/100、FormalQualBench 14/23、IMO 2026全部6题;GPT-5.5在PutnamBench解670/672,全部单次运行。匹配模型比较:h1+DeepSeek V4 Flash以$1.08/题解598题,超Goedel-Architect pass@4的597题($1.47/题);Putnam 2025上h1+GPT-5.2解12/12仅花$565(A5题$81.52),Numina全系统预算$1,000;FormalQualBench上MerLean+Opus 4.7解10/23是唯一例外,但h1换Opus 4.8达13/23($49.46/解 vs $118.35/解),GPT-5.6 Sol达14/23。开放问题:236个目标中证明8个(Erdős 138/337变体、三个OEIS猜想、AME(9,10)态、Written on the Wall II两题),并发现庞加莱猜想等误形式化。深度胜过重复:5个开放Erdős问题上h1 pass@1延长至82.5%($121),超APN basic pass@3的75.4%($191)与完整APN的76%($317)。框架消融:$20预算下AxProverBase解18/100 Putnam100而h1解69;AxProverBase输出占成本89%、缓存复用仅0.5%,h1输出占34%、缓存74–94%;去搜索/REPL/LSP后h1从69/63掉到49/49;反思使DeepSeek V4 Flash从554升至598;反思间隔1轮解50/39题、10轮72/65题、200轮反降至60/52(上下文腐化);Gemini 3.1 Pro高推理努力以$5.34/题解99题,低努力$20.63/题仅89题;Claude Code换h1的MCP工具后FATE-X从63升至73,仍不及h1的83。最长成功尝试含1,123轮反思、95小时、7,124行证明。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PutnamBench(672 题) | 解题数与每题成本(单次运行 pass@1) | h1 + GPT-5.5 解 670/672;h1 + DeepSeek V4 Flash 解 598($1.08/题) | Goedel-Architect + DeepSeek V4 Flash pass@4 解 597($1.47/题);Aleph Prover 覆盖 672(约 $74/题) | 同模型多解 1 题且成本降 27%;补齐剩余 2 题后以 $17.86/题覆盖全部 672 题(约 1/4 成本) |
| FATE-X(100 道博士资格考级代数题) | 解题数 / 每题预算 | h1 + GPT-5.6 Sol 解 90($38/题);DeepSeek V4 Flash 解 43($14.35 上限) | DeepMind prover agent 81($113/题);Leanstral 1.5 解 34 | +9 题且成本约 1/3;开源模型 +9 题超过专用 prover |
| FormalConjectures100-Solved(100 题已知解的研究猜想) | 解题数 | 78/100(GPT-5.6 Sol);Gemini 3.1 Pro 73@$150;DeepSeek V4 Flash 64@$4.89 | DeepMind prover agent 66($100 上限);AlphaProof 50 | Gemini 以 1/4 上限平 DM 后反超 7 题;GPT-5.6 Sol 领先 12 题 |
| FormalQualBench(23 道博士资格考级定理) | 解题数 / 每解成本 | h1 + GPT-5.6 Sol 解 14($26.38/解);h1 + Opus 4.8 解 13($49.46/解) | MerLean + Opus 4.7 解 10($118.35/解);OpenGauss + Opus 4.6 解 8($24.93) | 比 MerLean 多解 4 题,每解成本降约 58% |
| IMO 2026(6 题) | 解题数 / 每题成本 | h1 + GPT-5.6 Sol 6/6($8.07–8.33/题) | Humanfia + GPT-5.6 Sol 6/6($21.23/题);AxiomProver 6/6(成本未报) | 同分情况下成本约为对手的 1/2.6 |
| Putnam 2025(Numina 形式化,12 题) | 解题数 / 总成本 | h1 + GPT-5.2 解 12/12,总成本 $565(最难 A5 题 $81.52) | Numina 全系统(Opus 4.5 + Gemini 3 Pro + GPT-5.2 + 蓝图子代理)12/12,上限 $1,800 | 同分总成本约 1/3,且无需为最难一题切换手工分解工作流 |
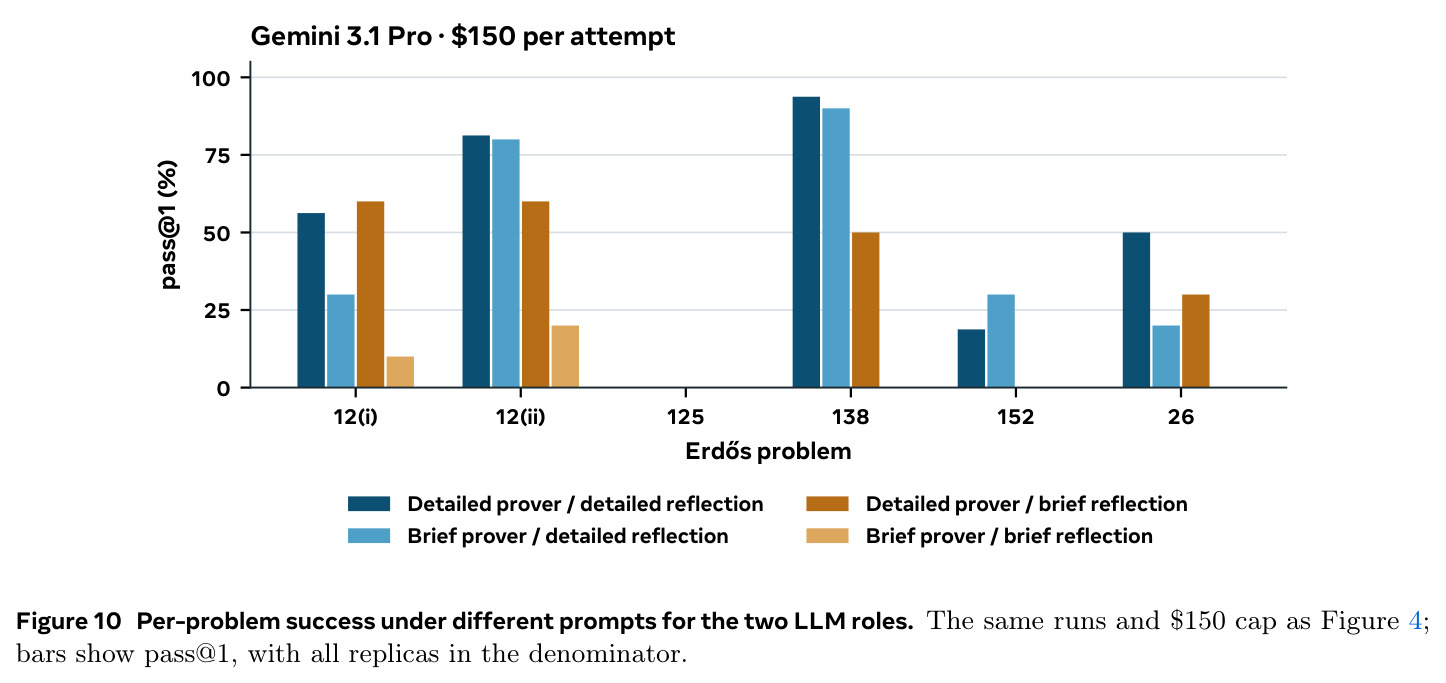
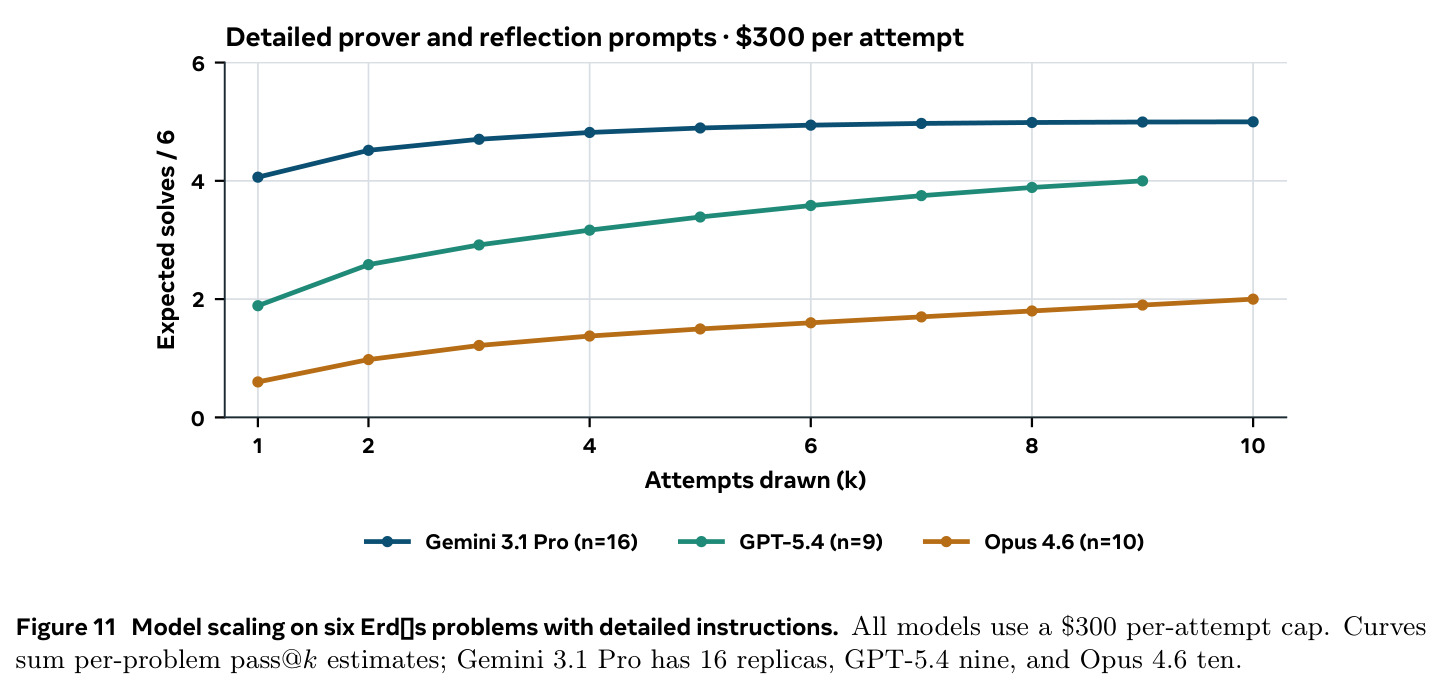
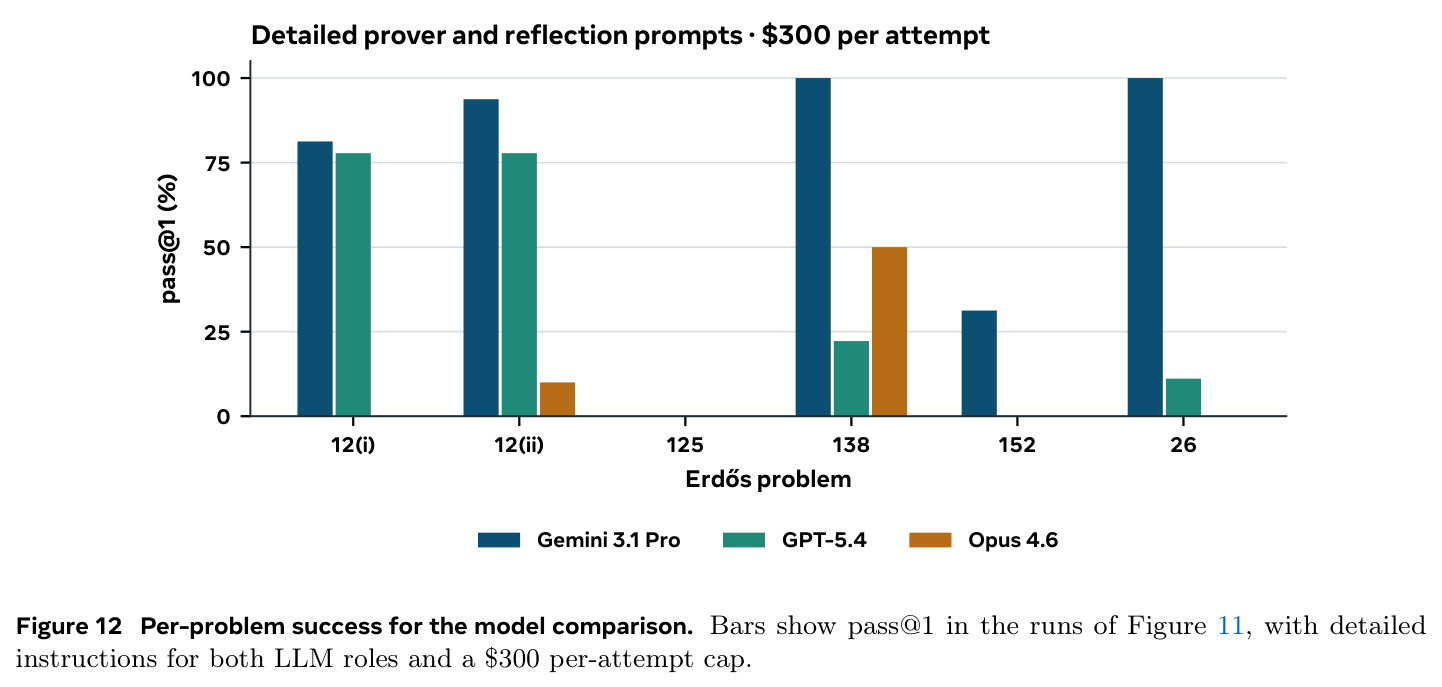
| 5 个开放 Erdős 问题(Gemini 3.1 Pro) | 成功率 / 成功均值成本 | h1 pass@1 随预算延长至 82.5%($121) | APN basic pass@3 为 75.4%($191);完整 AlphaProof Nexus 76%($317) | 单次延长尝试超过 3 次重复采样,成本降低约 1/3 |
| Putnam100(100 题子集,Gemini 3 Flash,$20 上限) | 解题数 | h1 解 69 | AxProverBase 解 18(同模型同预算) | +51 题,凸显高效接口的决定性作用 |
局限与改进
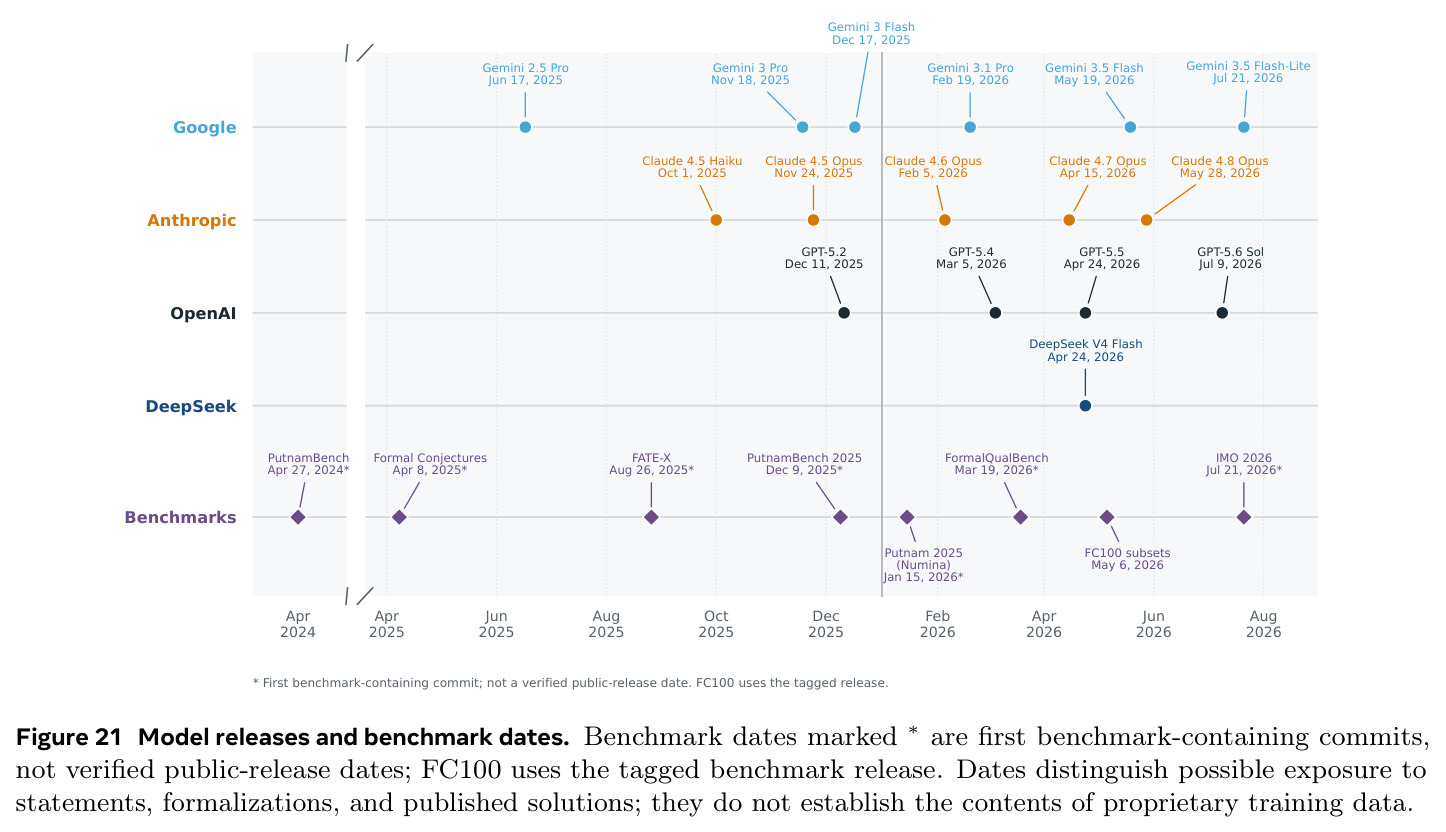
作者承认:前沿模型是黑箱,无法测量训练时基准暴露的影响,尽管尽量选用早于问题的模型(Putnam 2025用Opus 4.5与GPT-5.2,IMO 2026用GPT-5.6 Sol);对比的707题中有2题例外——完整APN能解Erdős 125(h1全部16次尝试均死于Lean超时),MerLean+Opus 4.7能证BurnsidePrimeDegree而h1+Opus 4.8未证;h1只在单个文件上工作,无法处理超上下文的大型形式化(费马大定理、整本教材;OpenAI的Navier–Stokes项目用了约1万个代理88小时);工具只覆盖Lean,无数值计算、模拟、可视化与网络搜索;接口与工具本身仍是人工设计。我的补充:成本全按API等价美元折算,结论对厂商定价与缓存折扣敏感,换算成实际时间或本地部署成本时排序可能改变;详细提示词中劝阻放弃、禁止作弊等规则实质注入了领域知识,与纯粹苦涩教训的叙事有张力,作者只是将其归为「接口」而非「工作流」;此外匹配成本比较部分依赖各系统自估成本,口径不完全统一。
独立分析的弱点
弱点一:单文件假设限制了可解问题的规模上限,面对需要跨文件依赖管理与代码库级验证的形式化(费马大定理、教材级形式化)h1 直接失效;改进方向是引入多文件工作区与增量编译,但仍不规定使用方式。弱点二:Lean 超时是硬故障,Erdős 125 上 16 次尝试全部超时说明缺乏断点续算与超时内部分解机制;改进方向是保存编译检查点、把大目标拆成可独立验证并缓存的引理。弱点三:深度-广度预算分配(延长单次尝试 vs 重复采样)依问题与预算而变、难以预先设定,论文自己也只能给出经验区间;改进方向是让模型在线决定继续还是重启,把选择交给学习而非手工预算。弱点四:反思压缩可能丢失关键中间发现,反思间隔的倒 U 形曲线(1 轮与 200 轮都差、10 轮最好)表明压缩时机是脆弱超参数;改进方向是分层记忆或可检索的过程日志。弱点五:评估集中在数学证明,「高效接口+持续循环」能否迁移到软件验证、硬件验证等其他带验证器的环境尚待检验;且结论建立在 2026 年的前沿模型上,若未来模型对长上下文的耐受改善,反思间隔等最优设置会漂移。
未来方向
作者提出的方向:按苦涩教训的精神扩展简单循环——加入并行代理、代码库级管理、更丰富的工具(数值计算、模拟、网络搜索),但不规定用法,例如让代理自由通信而非固定层级;研究超大规模(万级代理、跨文件验证)下什么让简单循环依然高效;更远的展望是模型自建自部署框架,接口本身也由学习获得。基于本文成果可延伸的方向:其一,把「每题成本-成功曲线」确立为 ATP 与智能体评测的标准报告协议,杜绝新工作流捆绑更强模型发布造成的混淆;其二,把 h1 发现误形式化的能力产品化,作为 Formal Conjectures、Mathlib 等形式化库的自动质检流水线;其三,在 Coq、Isabelle 等其他证明器环境重复匹配模型比较,检验苦涩教训的边界;其四,训练「坚持策略」模型在线决定继续、重启或切换方向,把深度-广度权衡交给学习;其五,系统研究提示词中人工知识的最小充分集,探索由模型自生成工作规范以消除最后的人工痕迹。
复现评估
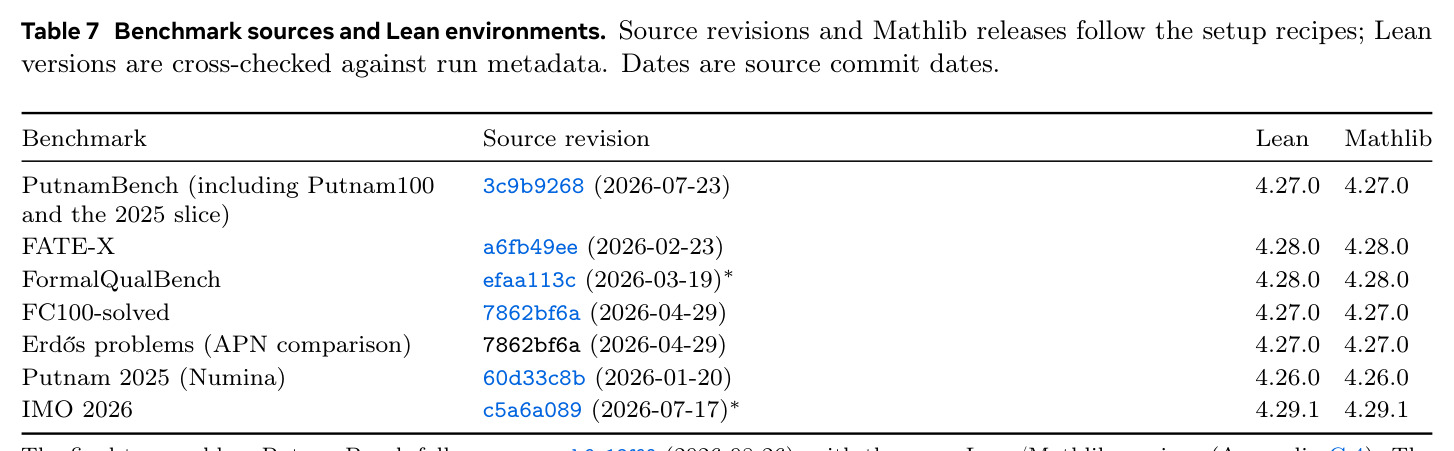
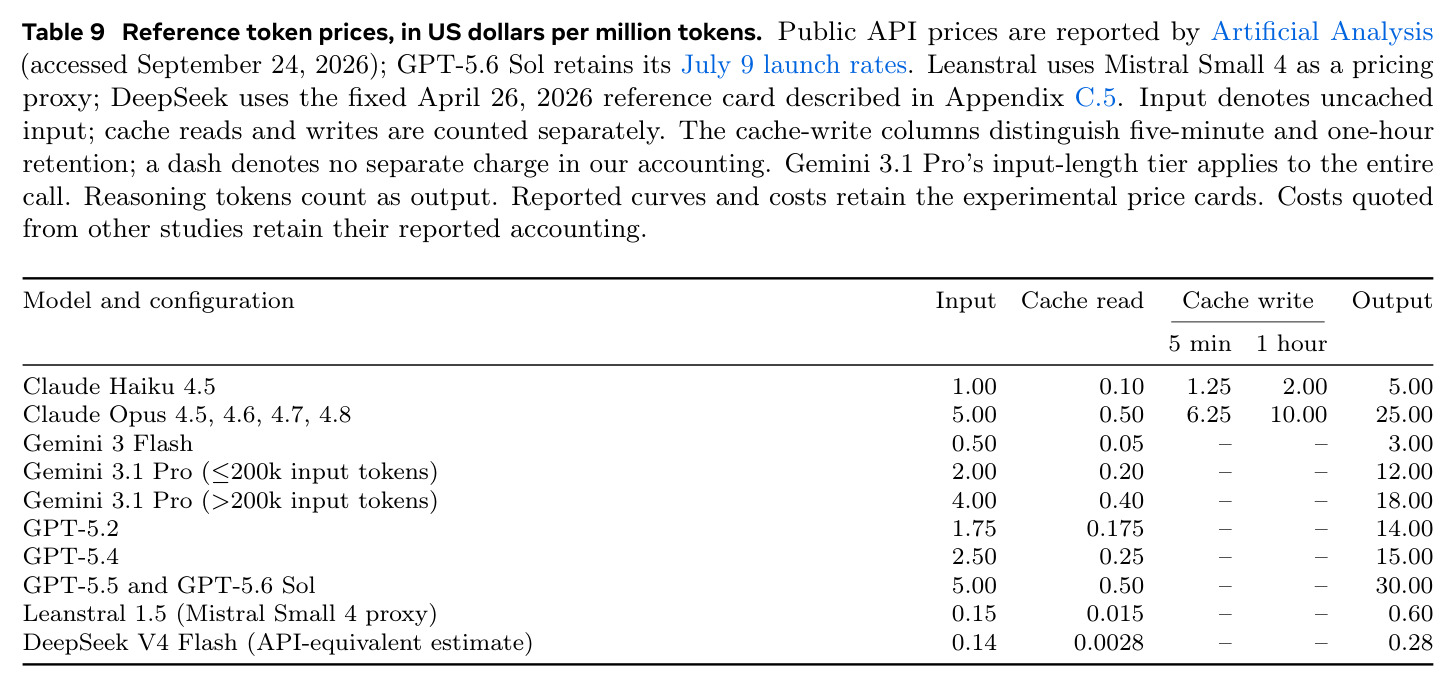
复现信息集中在附录:附录B详述工具与提示词(含劝阻放弃/作弊的规则),附录C记录各基准源版本与Lean/Mathlib版本及SOTA截止日(2026-08-27),附录C.4列出各系统尝试预算口径,表9给出token定价(可据此复算API等价成本),表14给出实测时间,附录D完整列出8个已证开放问题的定理陈述、上游PR(formal-conjectures#6008)与全部误形式化清单。代码方面正文未明确声明h1开源,是复现的主要不确定性;不过循环本身工程量不大(ReAct+反思+SafeVerify+全Mathlib导入),可依附录重建。算力需求为API预算而非训练算力:Putnam 2025全套约$565、FormalQualBench无上限$26.38/题、IMO 2026约$8/题、PutnamBench用开源DeepSeek V4 Flash约$1.08/题,千美元级预算即可复现主要结论。总体难度中等:设计明确,但需API重试、超时恢复、缓存优化等生产级细节;其反直觉结论(简单循环够用)本身也值得独立复验。
论文图表