MatAnyone-E:面向高效高分辨率视频抠图的稀疏记忆传播 MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
低分辨率传播筛选需细查的查询与记忆,仅对选中对做高分辨率匹配,4K提速7.4倍且省13倍显存
前置知识
Alpha 抠图与视频抠图
图像抠图为每个像素估计一个连续的 alpha 值 $\alpha \in [0,1]$,表示前景的不透明度,从而把半透明结构(发丝、烟雾)从背景中精细分离;视频抠图还要在相邻帧间保持 alpha 的时间一致性,否则合成结果会闪烁。评价指标包括 MAD、MSE、梯度误差 Grad 和时间误差 dtSSD,数值越低越好。
这是论文的任务本身,理解 alpha matte 的连续性与时间一致性要求,才能明白为什么作者坚持直接处理原生 4K 而不是降分辨率再上采样。
基于记忆的时序传播
把之前帧的特征存入记忆库,当前帧每个位置的查询向量 $\mathbf{Q}_t$ 与记忆键 $\mathbf{K}_m$ 计算相似度得到亲和度矩阵 $\mathbf{A}_t$,再加权求和记忆值 $\mathbf{V}_m$ 得到检索读出。查询数和记忆条目数都随空间分辨率平方增长,稠密匹配代价为 $N_q \times N_m$ 对,是高分辨率下的主要计算瓶颈。
论文的全部效率优化都围绕这套匹配机制展开,SMP 本质上就是对查询端和记忆端做双向剪枝,不理解记忆匹配就无法理解剪枝在省什么。
不确定度门控与时间融合
MatAnyone 2 在记忆检索后用融合公式 $P_{t,i} = U_{t,i} V^{m}_{t,i} + (1-U_{t,i}) V_{t-1,i}$,其中 $U_{t,i} \in [0,1]$ 由不确定度预测器从检索读出中预测。它不表示预测置信度,而是逐位置门控:值小说明该位置时间稳定、沿用上一帧信息即可,值大说明必须依赖新检索的记忆。
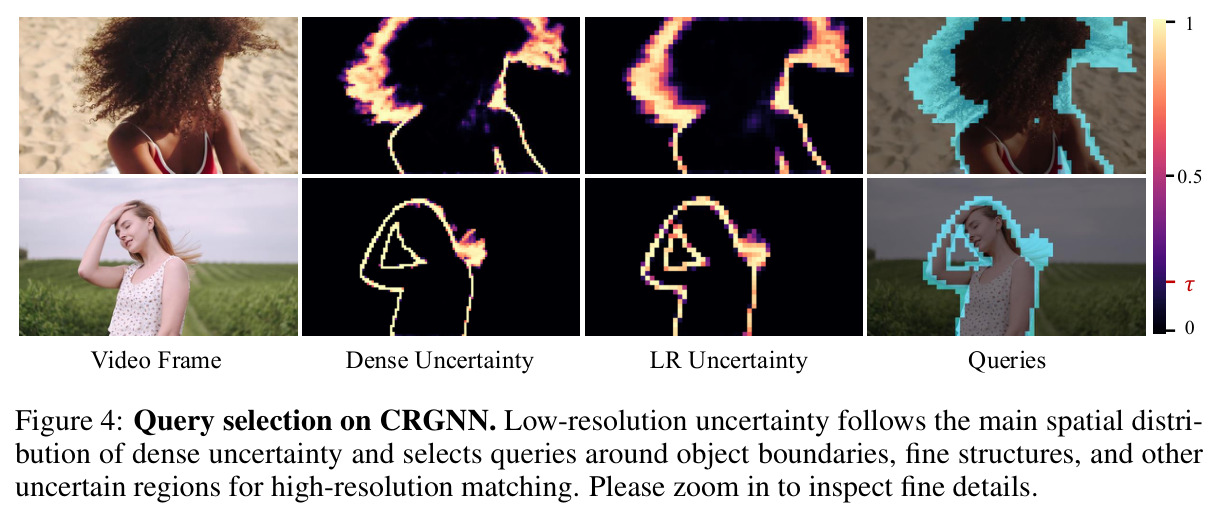
这个门控值天然刻画了"每个位置有多需要精细记忆匹配",是本文查询剪枝的选择信号;理解它才能看懂为什么一次低分辨率传播能同时回答"哪里"和"哪些记忆"两个问题。
知识蒸馏
让一个小容量学生模型模仿大容量教师模型的输出以保留其表征能力。本文用冻结的 MatAnyone 2 解码器做教师,逐阶段最小化 $\mathcal{L}_{distill} = \sum_{l=1}^{4} \| ilde{F}_S^l - F_T^l\|^2$,通道不一致时用可学习的 $1 \times 1$ 适配器对齐维度,训练结束后把适配器删掉,推理零额外开销。
轻量解码器单独训练会损失发丝等高频细节,蒸馏是保住质量指标(MAD 只涨 0.04)的关键手段,也是轻量化论文的常用套路。
深度可分离卷积与算术强度
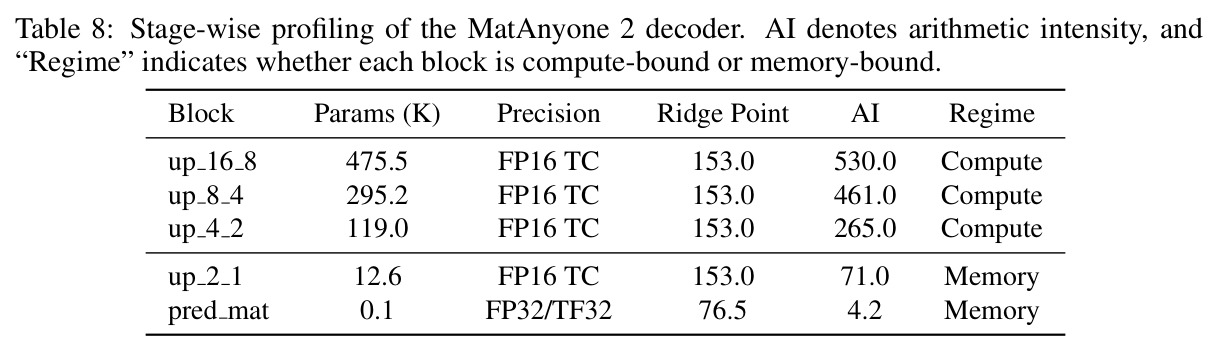
深度可分离卷积把标准卷积拆成逐通道的 $3 \times 3$ 卷积加 $1 \times 1$ 逐点卷积,FLOPs 大幅下降,但算术强度(每字节数据搬运摊到的运算量,AI = FLOPs / Bytes)随之降低。当 AI 低于硬件 ridge point(如 FP16 Tensor Core 约 153)时瓶颈从计算转为访存,此时继续降 FLOPs 不再降低延迟。
论文解码器设计完全由实测算术强度驱动:低分辨率段 compute-bound 换 DWConv,末端高分辨率段 AI=71 属 memory-bound 则保留稠密卷积只缩通道,避免"低 FLOPs 不等于快"的陷阱。
研究动机
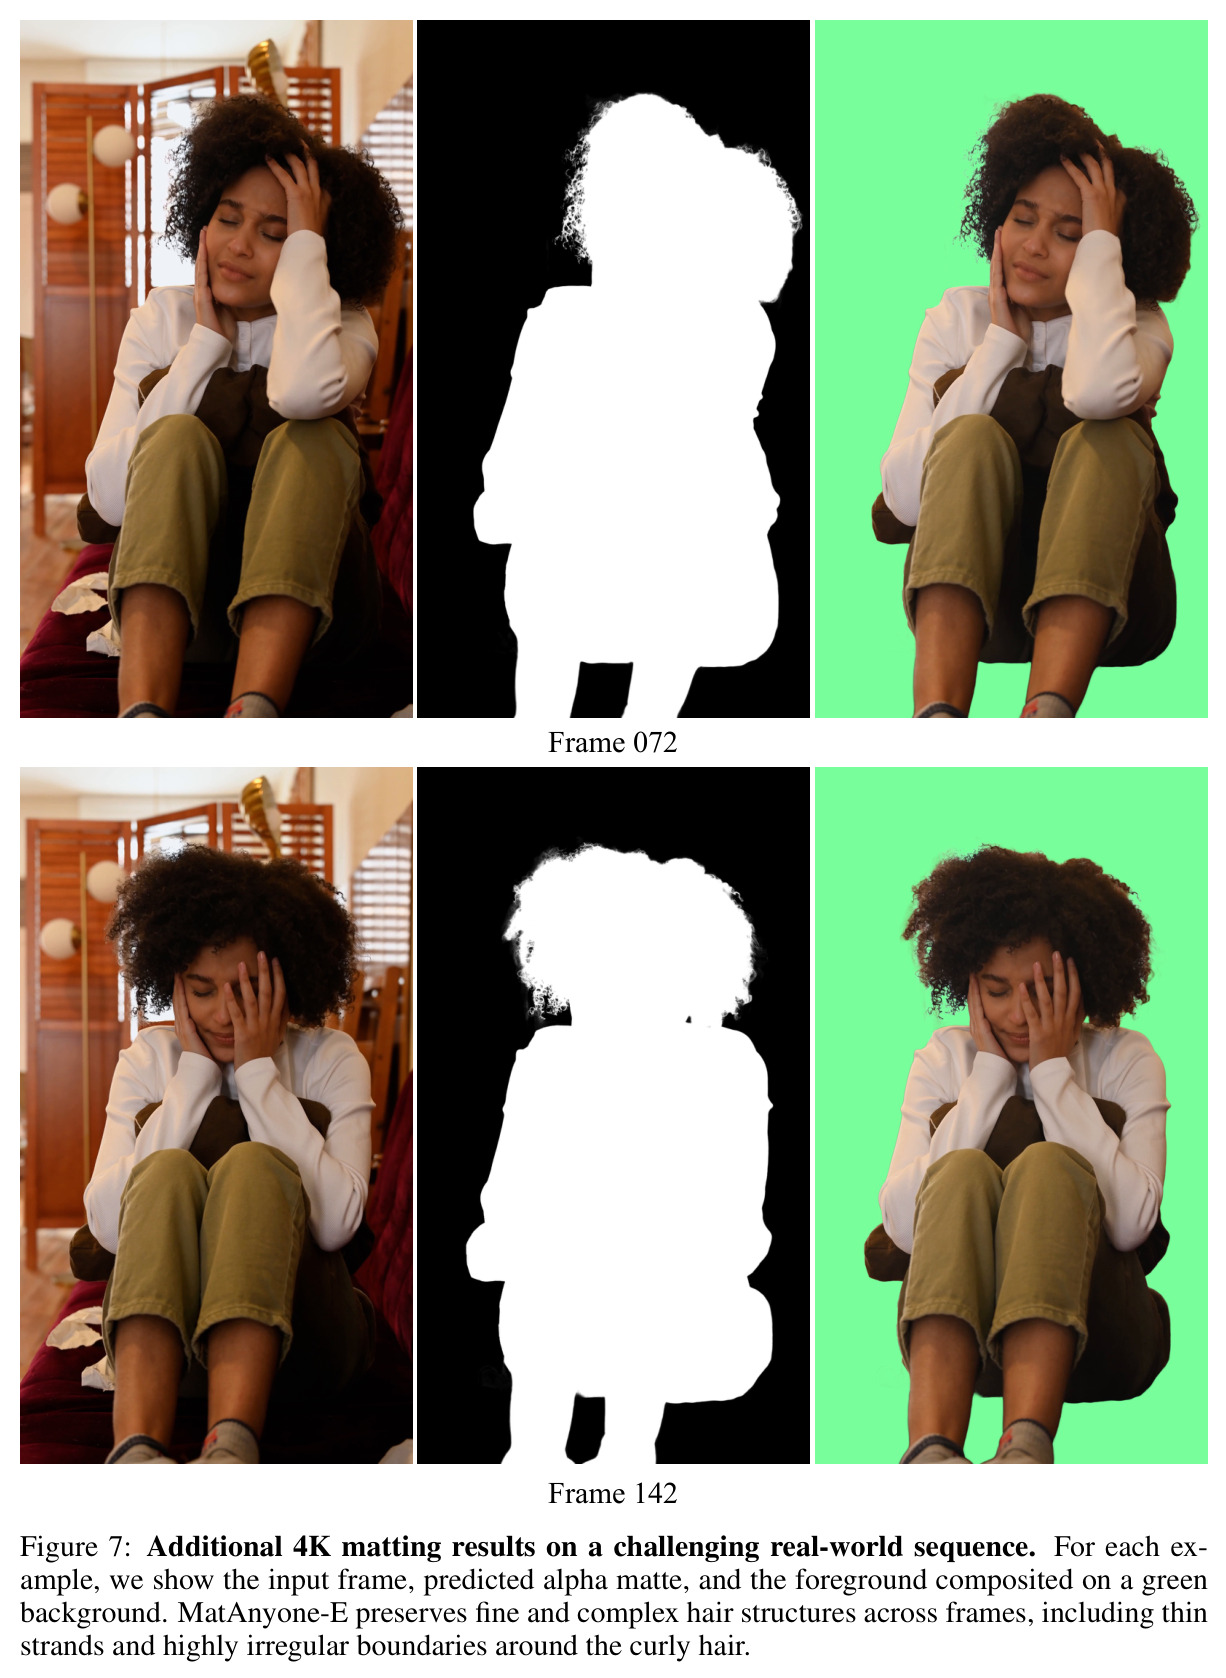
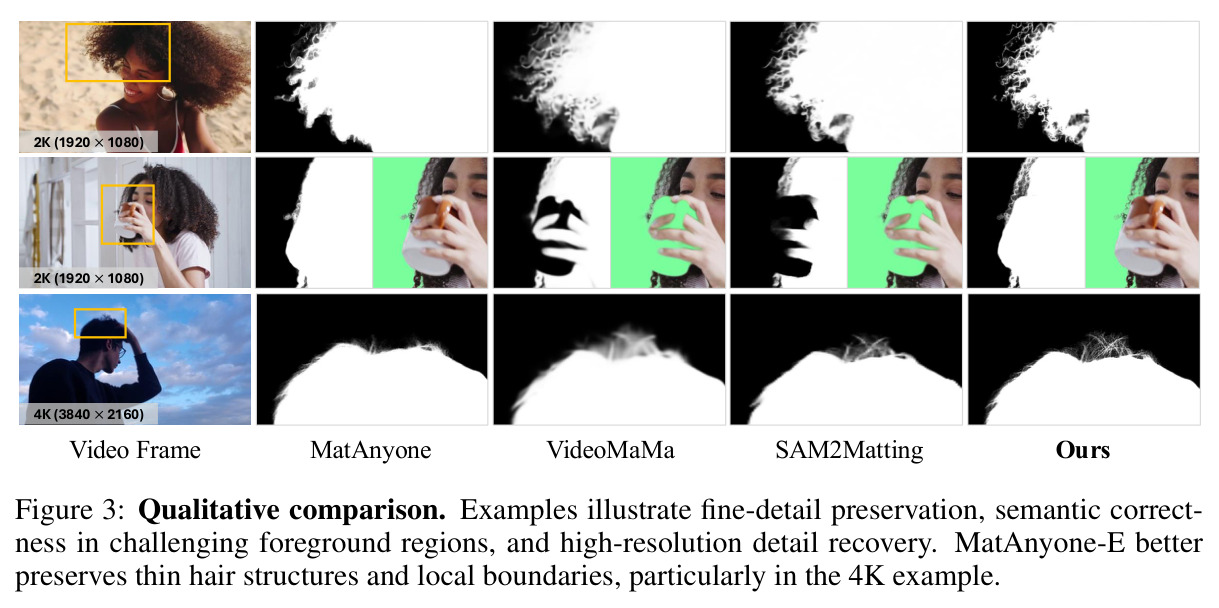
视频抠图要为每帧预测连续的 alpha matte,把前景合成到新背景上。高分辨率(2K/4K)应用要求恢复发丝、细结构和软透明度,同时保持时间一致性不闪烁。基于记忆的方法(MatAnyone、MatAnyone 2)靠当前帧与早期帧记忆库匹配获得高质量结果,但匹配代价随分辨率爆炸式增长:查询数 $N_q$ 和记忆键值数 $N_m$ 都随空间分辨率平方增大,稠密匹配要评估 $N_q \times N_m$ 个查询-记忆对。实测中 MatAnyone 2 在 1080p 需 73.5ms/帧(记忆传播占 46%),1440p 时占 65%,4K 时记忆传播约 779.8ms、总时延约 911ms,且完整记忆库峰值显存约 79.69GB,直接超出 80GB 的 A800 而无法推理。效率导向方法(RVM、SparseMat)虽然快,但在困难场景下细结构和时间一致性差;VideoMaMa、SAM2Matting 借助生成或分割先验,但处理分辨率受限,无法从原生 4K 输入恢复足够细节。
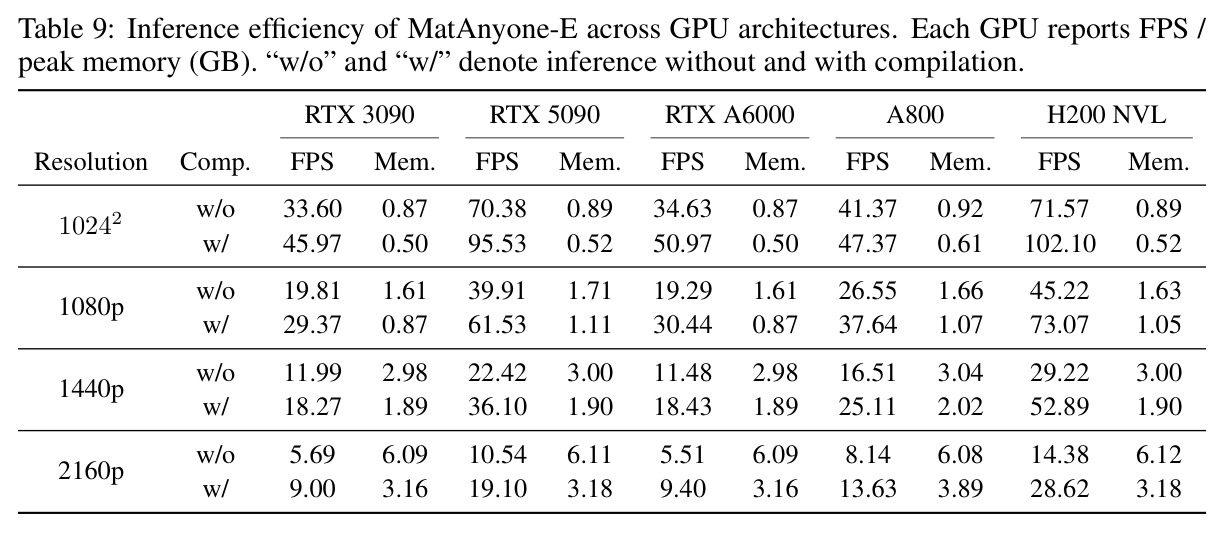
本文的目标是目标是在保持 MatAnyone 2 抠图质量的前提下,把高分辨率推理开销压缩到实用水平。可量化的目标包括:4K 分辨率下相对 MatAnyone 2 实现约一个数量级的加速和显存缩减,同时质量差异控制在 MAD 不超过 0.04、dtSSD 不超过 0.07;在单张 80GB A800 上以完整记忆库做原生 4K 推理且不再 OOM,峰值显存压到个位数 GB;配合编译优化冲击 1080p 实时(37.6 FPS)和 4K 半实时(13.6 FPS);在 RTX 3090 到 H200 的多种 GPU 上保持一致的可扩展性,最终在 H200 上做到 1080p 73.07 FPS、4K 28.62 FPS。
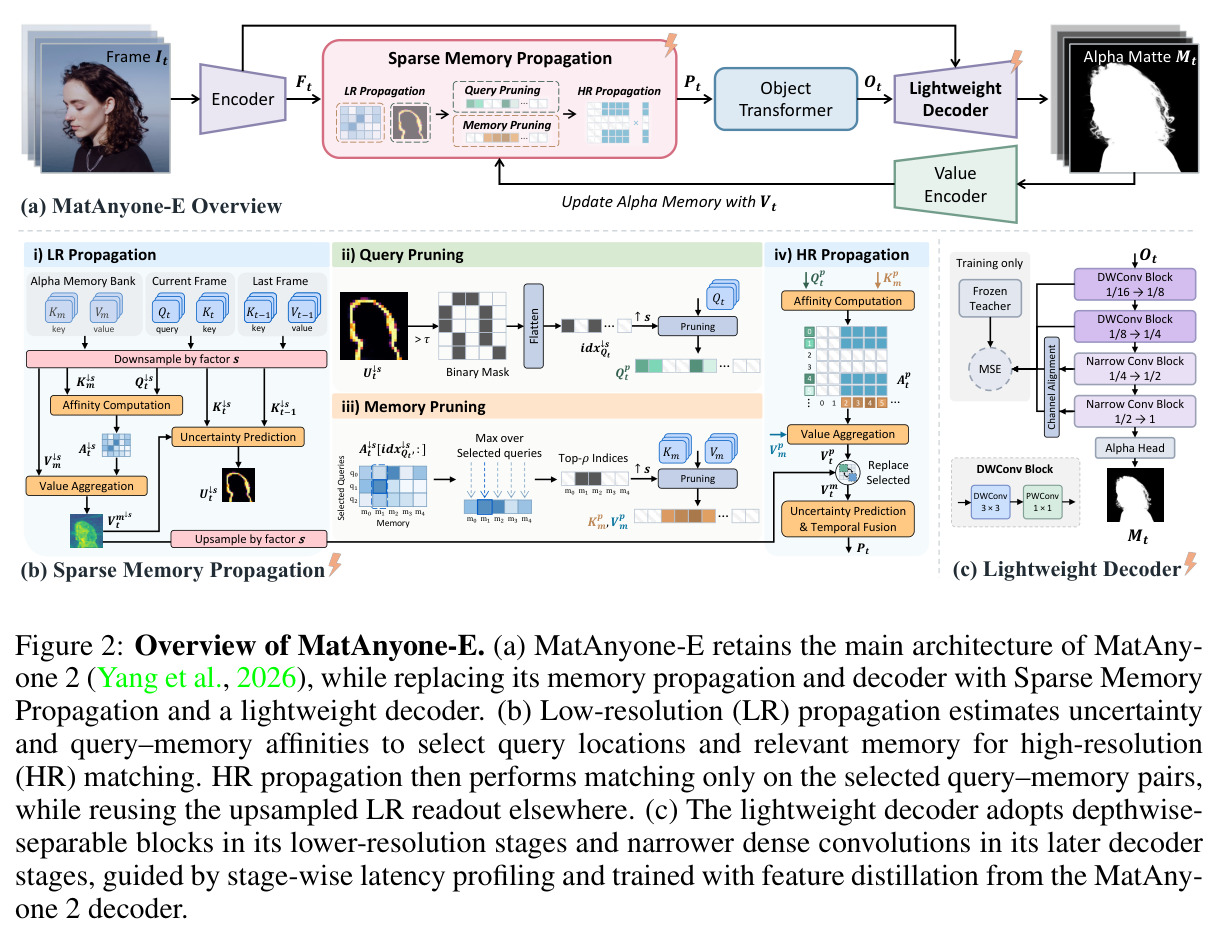
与已有工作不同的是,本文抓住了两个被忽视的点。其一,时间融合门控 $U_{t,i}$ 本身就编码了"每个位置有多依赖新检索的记忆",但它只有在昂贵匹配完成后才可得到——存在"先匹配才知道哪里值得匹配"的循环依赖。作者用一次廉价的低分辨率传播提前估计不确定度,把这个信号变成可以先行回答的问题。其二,此前选择性计算工作(SparseMat、µMatting)只裁剪 matte 精炼阶段,没有工作直接压缩底层时序记忆匹配本身;而且只剪查询位置并不够——保留下来的每个查询仍要搜索整个记忆库。作者同时利用低分辨率传播已经算出的亲和度去剪记忆端,让匹配开销在查询和记忆两个维度同时下降。此外,轻量解码器的设计以实测瓶颈(算术强度)为准绳而非纸面 FLOPs,这与常见"到处换 DWConv"的做法有本质区别。
核心方法
先说直觉:视频里大部分位置的时间信息可以直接"抄"上一帧,只有少数不确定位置(物体边界、发丝、遮挡处)才真正需要去记忆库做精细检索;而且这些位置相关的记忆条目高度集中——保留 15% 的记忆就能召回 98% 的稠密匹配候选。技术路线:MatAnyone-E 保留 MatAnyone 2 的主干架构,只替换两个随分辨率增长最快的模块。第一是稀疏记忆传播(SMP):先把查询、记忆键、值空间下采样 $s=2$ 倍,做一次完整的低分辨率匹配(只评估约 $1/s^4$ 的查询-记忆对);由低分辨率不确定度选出超过阈值 $\tau=0.15$ 的查询位置(约占 7%),再由低分辨率亲和度给记忆位置打分 $w_j$,保留 top-$\rho=15\%$;然后只在选中的查询与选中的记忆之间做原生分辨率匹配,其余位置复用上采样的低分辨率读出。第二是轻量解码器:按各阶段实测的算术强度分而治之——低分辨率段用深度可分离卷积,高分辨率段保留稠密卷积但缩窄通道,并用冻结的 MatAnyone 2 解码器做特征蒸馏($\lambda_{distill}=0.001$)保住表征能力。两部分叠加,4K 下实现约 7.4 倍加速、峰值显存降至 6.08GB。
核心创新是:用一次便宜的低分辨率传播同时回答"哪里需要精细匹配"和"哪些记忆参与匹配"两个问题。MatAnyone 2 的融合门控 $P_{t,i} = U_{t,i} V^{m}_{t,i} + (1-U_{t,i}) V_{t-1,i}$ 中,不确定度 $U_t$ 度量每个位置对记忆检索的依赖程度,理论上应作为选择性匹配的依据,但它只能在匹配之后计算——本文用低分辨率传播的不确定度 $U^{\downarrow s}_t$ 作为代理打破了这个循环依赖。与已有工作的本质区别有两点:第一,已有选择性抠图方法(SparseMat、µMatting)只在 matte 精炼阶段做选择,本文首次直接对时序记忆匹配做稀疏化,这是分辨率增长的主要瓶颈(4K 时占总时延约 85%);第二,已有高效 VOS 工作(EdgeTAM、Efficient-SAM2)通常只压缩记忆或只做稀疏检索,本文是查询端与记忆端的双向剪枝——以 $w_j=\max_{i \in idx_{Q_t}} A^{\downarrow s}_t[i,j]$ 给记忆打分并保留 top-15%,把高分辨率匹配成本从 $N_q N_m$ 降到 $N_q N_m / s^4 + n_q n_m$。解码器侧同样以算术强度而非 FLOPs 为准绳做分阶段轻量化,二者共同命中两大开销来源。
方法步骤详情
第一步,低分辨率传播:将查询 $\mathbf{Q}^{\downarrow s}_t$、记忆键 $\mathbf{K}^{\downarrow s}_m$、值 $\mathbf{V}^{\downarrow s}_m$ 下采样 $s=2$ 倍,执行 $\mathbf{A}^{\downarrow s}_t = \mathrm{Norm}_m(\mathrm{Sim}(\mathbf{Q}^{\downarrow s}_t, \mathbf{K}^{\downarrow s}_m))$,只评估约 $1/s^4$ 的查询-记忆对。第二步,查询剪枝:用继承自 MatAnyone 2 的不确定度预测器处理 LR 特征得 $U^{\downarrow s}_t$,取 $idx^{\downarrow s}_{Q_t} = \{i \mid U^{\downarrow s}_{t,i} > \tau\}$($\tau=0.15$),每个 LR 位置对应 HR 网格上 $s \times s$ 区域,汇成查询子集 $\mathbf{Q}^p_t$(约占 7%)。第三步,记忆剪枝:对每个记忆位置计算 $w_j = \max_{i \in idx^{\downarrow s}_{Q_t}} \mathbf{A}^{\downarrow s}_t[i,j]$,保留 top-$\rho=15\%$ 得到 $\mathbf{K}^p_m, \mathbf{V}^{m,p}$,只作用于本次检索、不改持久记忆库。第四步,高分辨率传播:只在选中集合间匹配 $\mathbf{A}^p_t = \mathrm{Norm}_m(\mathrm{Sim}(\mathbf{Q}^p_t, \mathbf{K}^p_m))$,稠密读出按位置拼装——选中处用 $V^{m,p}_{t,i}$,其余用上采样的 $[\mathrm{Ups}(V^{m\downarrow s}_t)]_i$,随后照常做 HR 不确定度预测与时间融合。第五步,轻量解码器:四阶段上采样(1/16 到 1),低两段用 DWConv+PWConv,高两段保留稠密卷积但缩通道(宽 [256,128,64,32,16]),训练时以冻结教师做 $\mathcal{L} = \mathcal{L}_{mat} + \lambda_{distill} \sum_l \|\tilde{F}^l_S - F^l_T\|^2$($\lambda_{distill}=0.001$)。4K 实际使用附录的多级 4 到 2 到 1 调度(空间预算 $M=4096$)。
技术新颖性
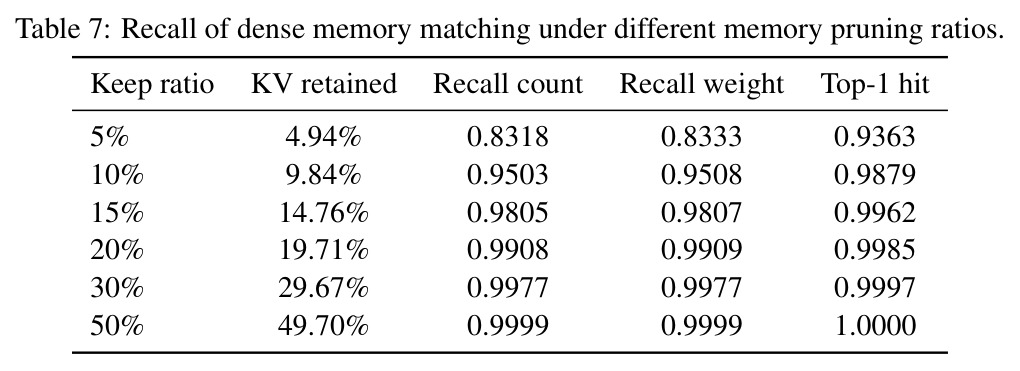
技术新颖性有四点。第一,任务特定的选择信号:不用额外训练门控网络,直接复用 MatAnyone 2 自带的不确定度预测器,把为时间融合设计的信号转用于查询剪枝,零训练成本且语义对齐——不确定度本来就表示该位置需要多少新记忆。第二,查询-记忆双向稀疏化:分析显示 15% 记忆保留率即可召回 98.1% 的稠密候选与 99.6% 的 top-1 命中,说明记忆相关性高度集中,这一实证发现支撑了双端剪枝的合理性,而记忆剪枝按当前查询集的 max 亲和度排序、只局部于单次检索,简单且无副作用。第三,profiling 驱动的解码器设计:用算术强度对比硬件 ridge point(FP16 TC 约 153)判断 compute-bound 与 memory-bound(末端块 AI=71、pred_mat AI=4.2 均为 memory-bound),据此分阶段选择 DWConv 或窄稠密卷积,避免降 FLOPs 反而变慢的坑。第四,多级扩展:Algorithm 1 把单级 SMP 推广为 4 到 2 到 1 的多级调度,使方法适用于任意分辨率,8K 下编译后仍能跑到 3.3 FPS。
实验结果
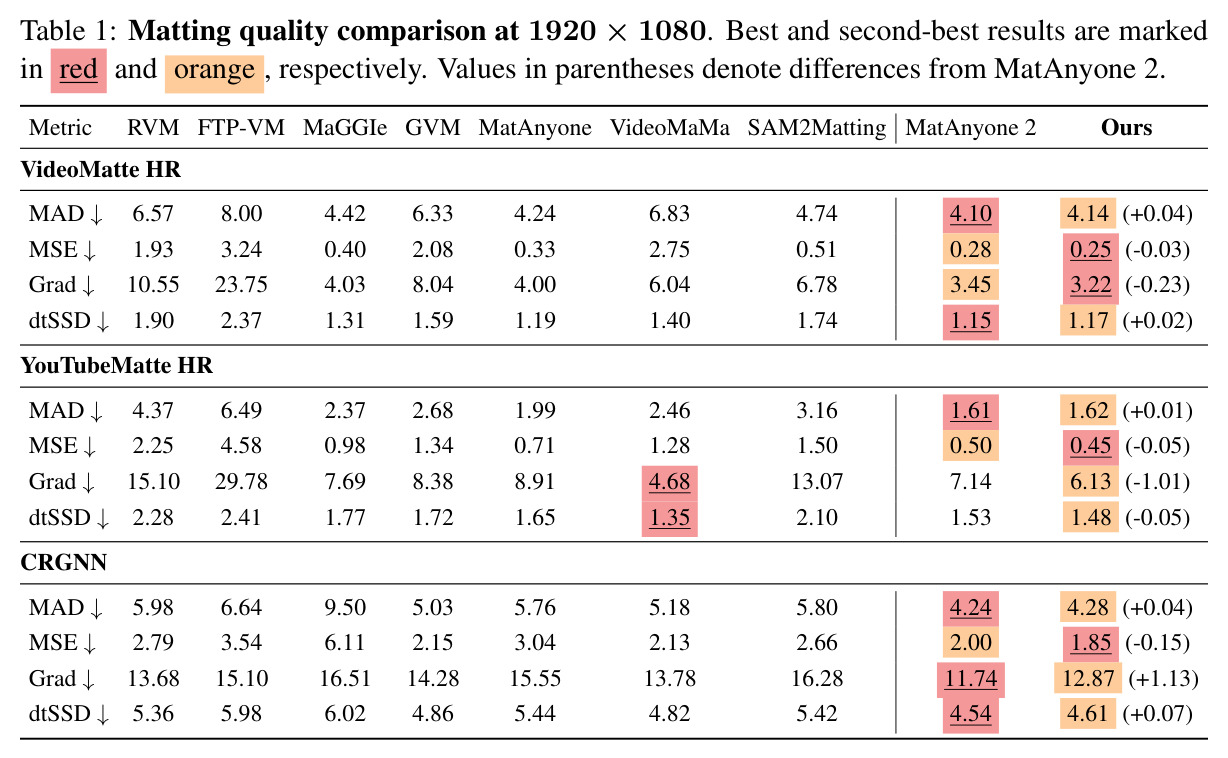
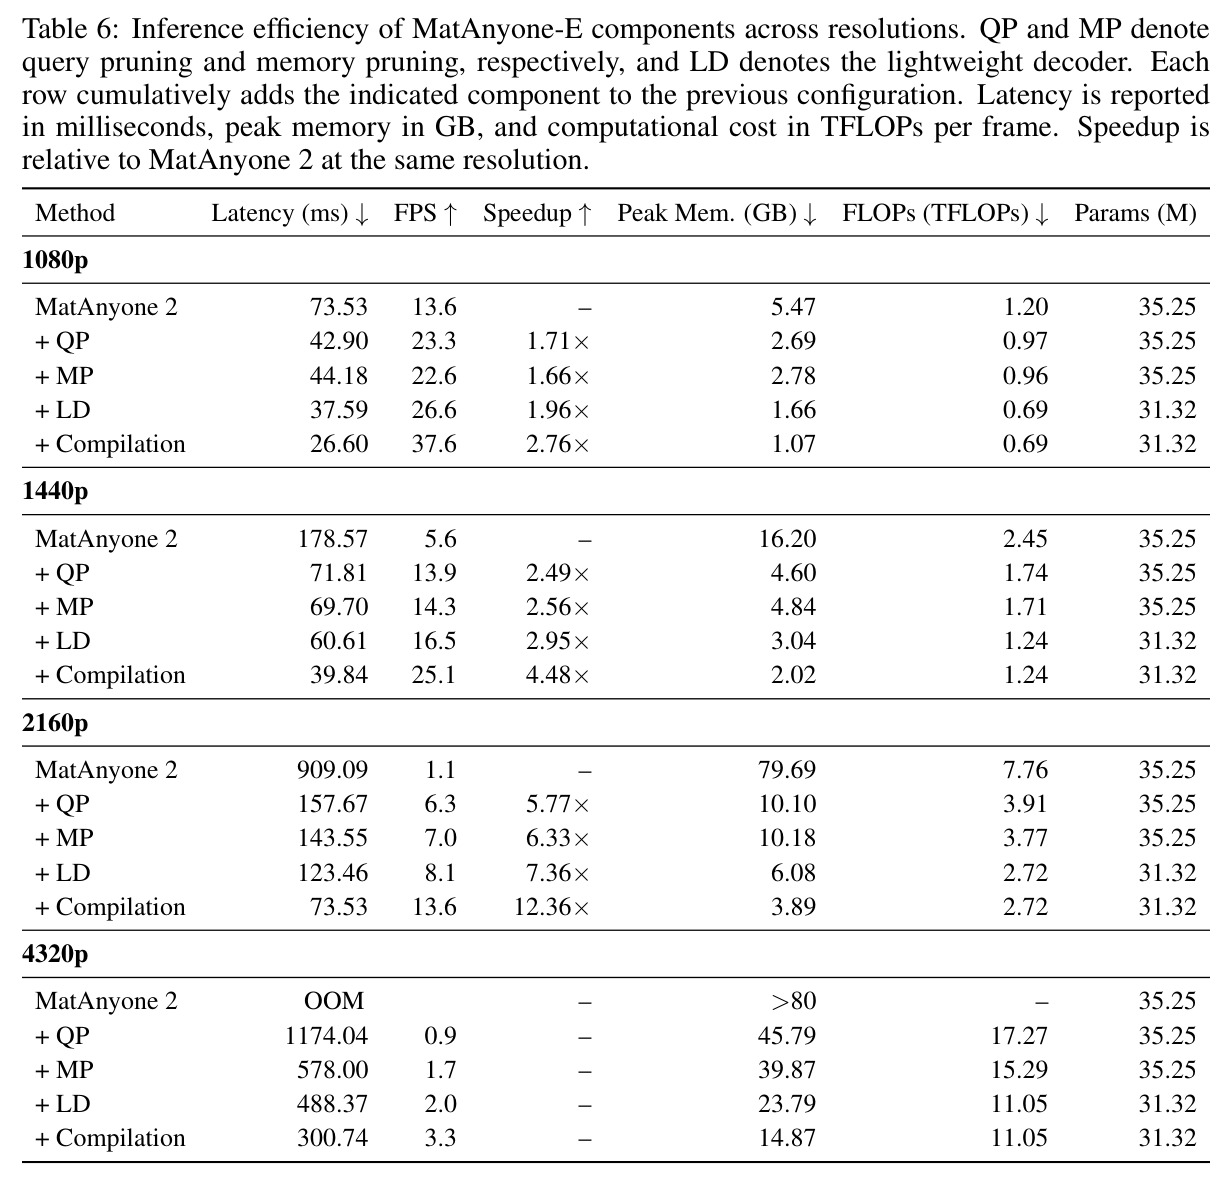
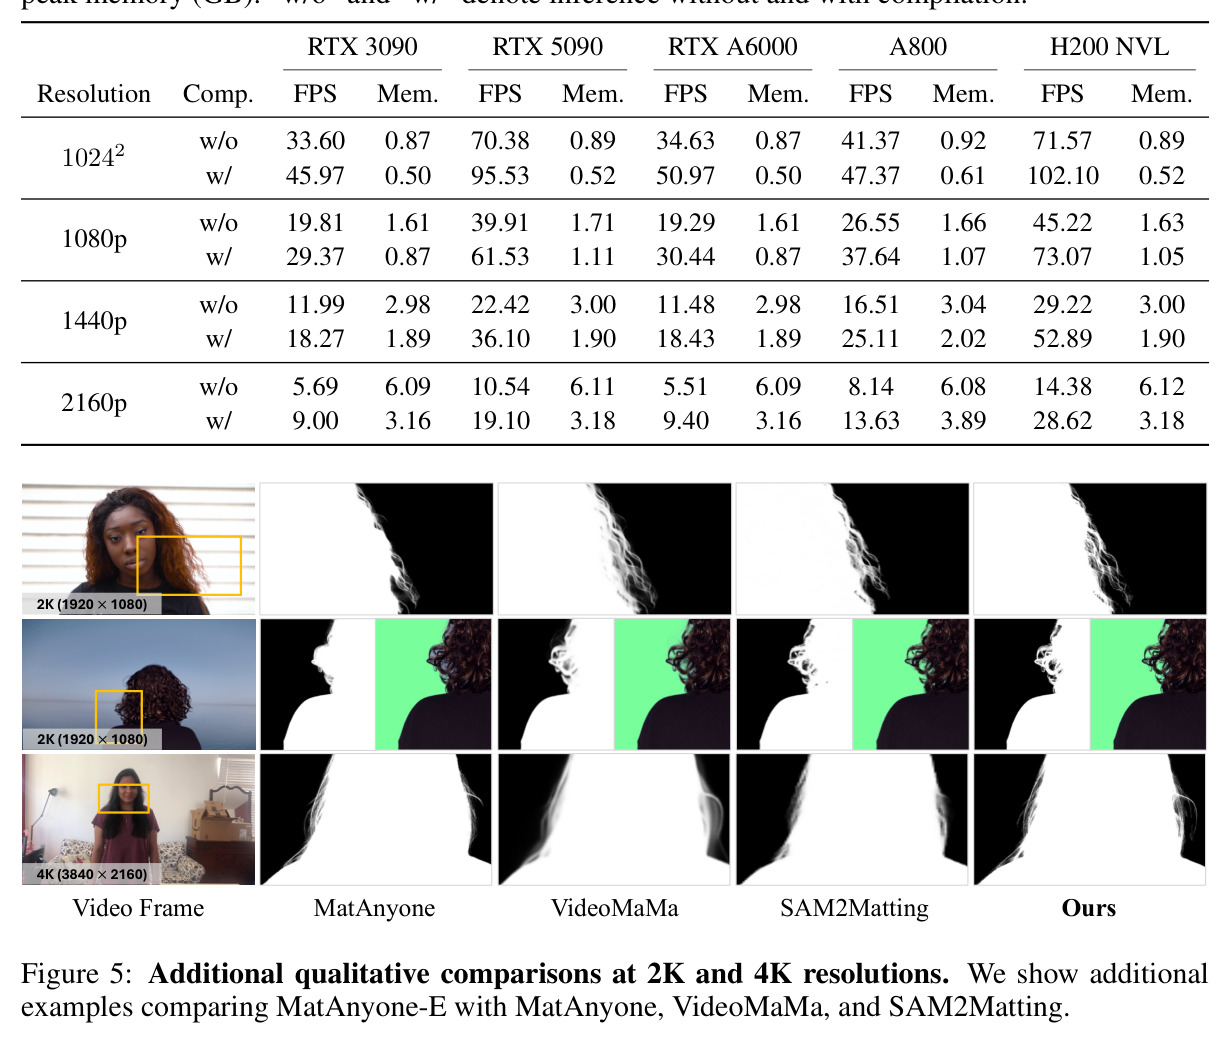
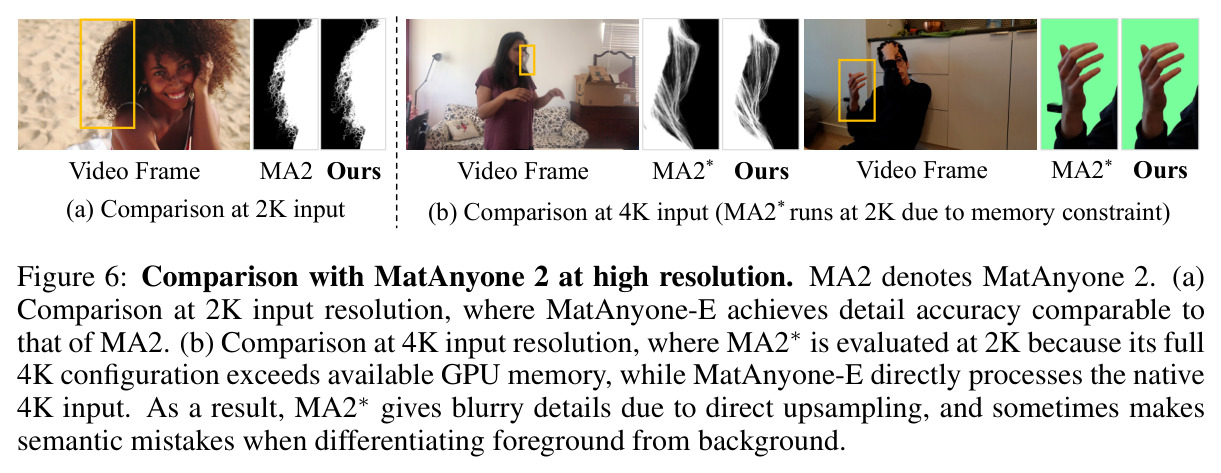
质量方面(Table 1,1080p):三个基准与 MatAnyone 2 几乎持平——VideoMatte HR 上 MAD 4.14 vs 4.10(+0.04)、MSE 0.25 vs 0.28(更低)、Grad 3.22 vs 3.45;YouTubeMatte 上 MSE 0.45 vs 0.50、Grad 6.13 vs 7.14;CRGNN 上 MSE 1.85 vs 2.00;同时全面超过 SAM2Matting(YouTubeMatte MAD 1.62 vs 3.16、MSE 0.45 vs 1.50),MAD 与 MSE 均低于 VideoMaMa。效率方面(Table 2):4K 下 8.1 FPS、峰值显存 6.08GB,而 MatAnyone 2 完整配置直接 OOM(外推约 1.1 FPS、79.69GB),即约 7.4 倍加速、显存降至 7.6%;1080p 26.6 FPS(1.96 倍)、1440p 16.5 FPS(2.95 倍);编译后 4K 13.6 FPS,H200 上 1080p 达 73.07 FPS、4K 达 28.62 FPS。消融(Table 3):SMP 单独把时延 73.53ms 降到 44.18ms、显存 5.47GB 降到 2.78GB;解码器单独降到 66.61ms、4.35GB;合并 37.59ms、1.66GB,MAD 仅 +0.04。查询策略(Table 4):同约 7% 预算下,不确定度引导 MAD 4.26 优于均匀采样 4.39 与 alpha 边界 4.34。记忆剪枝分析(Table 7):保留 15% 记忆召回 98.1% 稠密候选、top-1 命中 99.6%。组件分解(Table 6):4K 下查询剪枝单独把 909.09ms 降到 157.67ms、显存 79.69GB 降到 10.10GB;8K 编译后 3.3 FPS(14.87GB),MatAnyone 2 OOM。跨 GPU(Table 9):编译后 4K 在 RTX 3090 达 9.0 FPS、RTX 5090 19.1 FPS、H200 NVL 28.6 FPS。
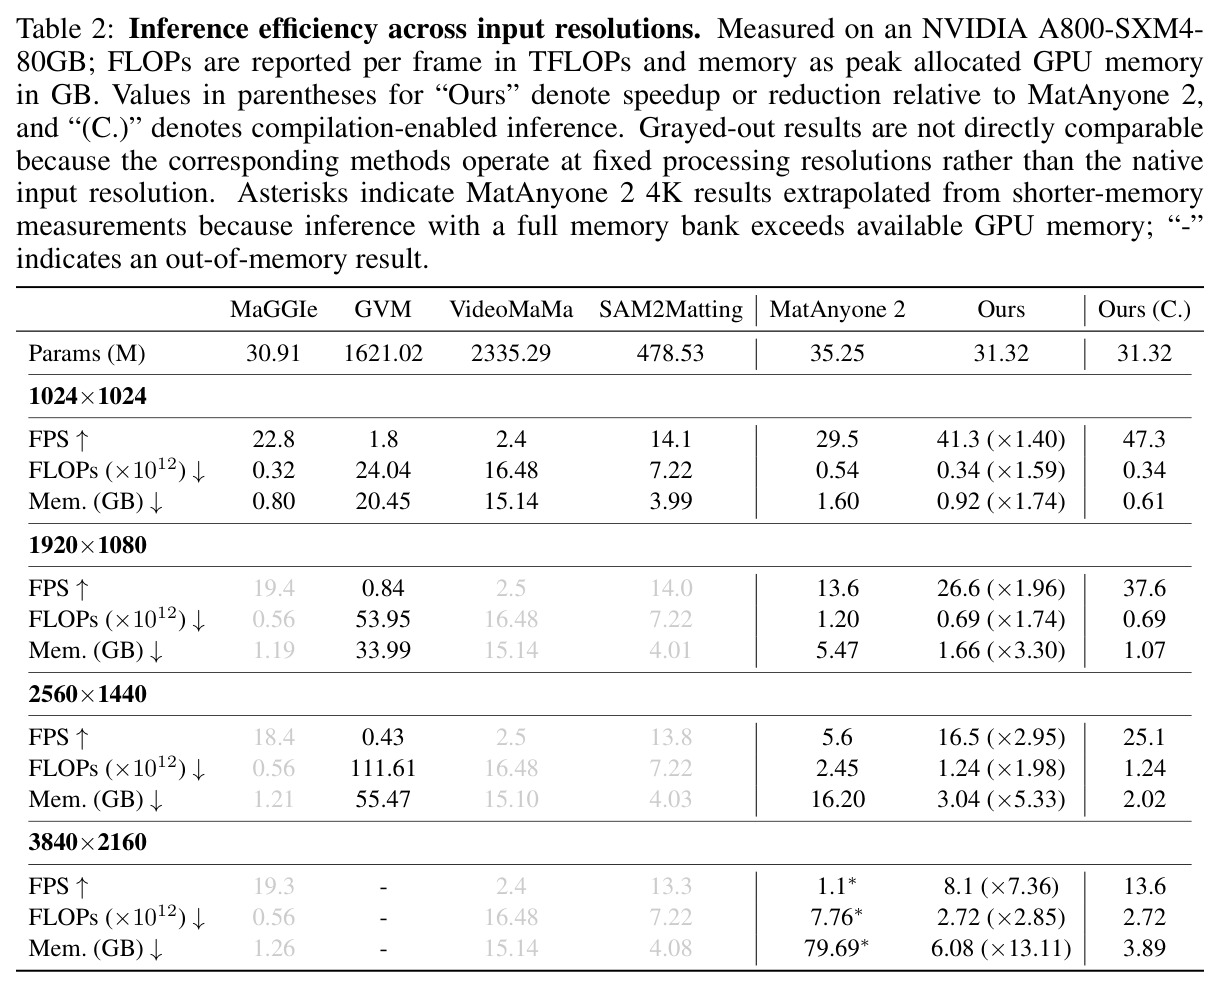
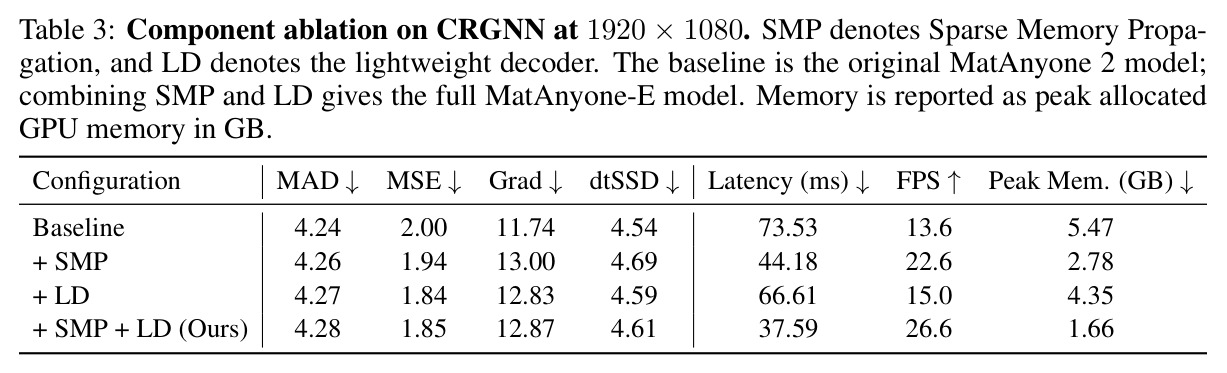
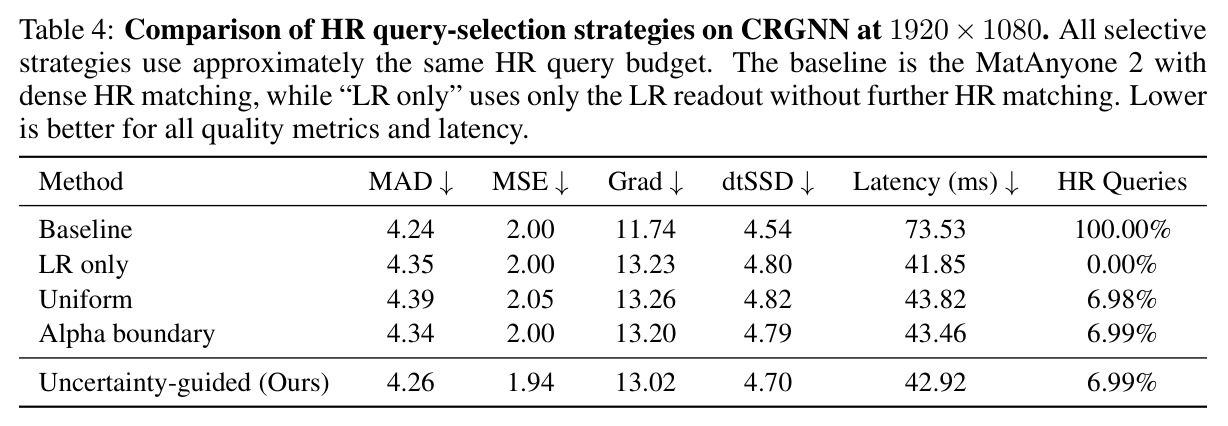
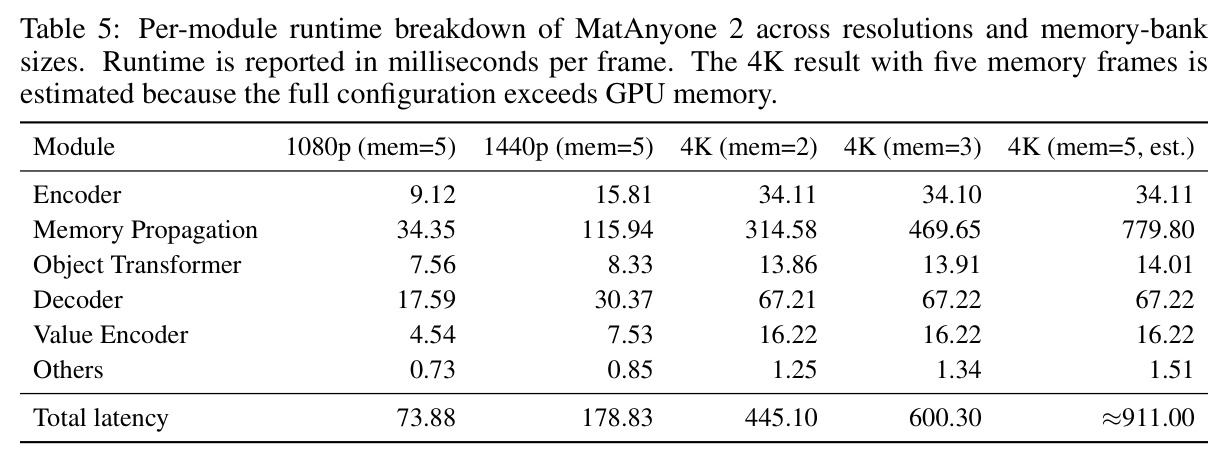
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 4K 视频抠图推理效率(A800-80GB) | FPS / 峰值显存 | 8.1 FPS / 6.08 GB(编译后 13.6 FPS / 3.89 GB) | MatAnyone 2 外推约 1.1 FPS / 79.69 GB(完整配置实际 OOM) | 约 7.4 倍加速,显存降至 7.6%(13.1 倍缩减) |
| VideoMatte HR 抠图质量(1080p) | MAD / MSE / Grad | 4.14 / 0.25 / 3.22 | MatAnyone 2:4.10 / 0.28 / 3.45 | MAD 基本持平(+0.04),MSE 和 Grad 更优 |
| YouTubeMatte HR 抠图质量 | MAD / MSE / Grad | 1.62 / 0.45 / 6.13 | MatAnyone 2:1.61 / 0.50 / 7.14;SAM2Matting MAD 3.16 | 与 MA2 持平且 MSE/Grad 更优,MAD 不到 SAM2Matting 的一半 |
| CRGNN 抠图质量 | MSE / MAD | 1.85 / 4.28 | MatAnyone 2:2.00 / 4.24 | MSE 降低 0.15,MAD 基本持平(+0.04) |
| 1080p 端到端推理 | 时延 / FPS / 峰值显存 | 37.59 ms / 26.6 FPS / 1.66 GB(编译后 26.60 ms / 37.6 FPS / 1.07 GB) | MatAnyone 2:73.53 ms / 13.6 FPS / 5.47 GB | 1.96 倍加速、显存约 30%,编译后 2.76 倍 |
| 记忆剪枝有效性 | Recall count / Top-1 hit | 保留 15% 记忆:98.1% / 99.6% | 稠密匹配(保留 100% 记忆库) | 以 15% 的记忆量保留几乎全部相关候选 |
局限与改进
作者承认的局限:其一,MatAnyone 2 的 4K 结果是外推的(完整配置超出 80GB 显存),因此"7.4 倍加速"是估计值而非同条件实测;其二,SMP 的有效性依赖低分辨率特征图的可靠性,输入分辨率较低时下采样图过粗,定位不确定区域和区分记忆候选都会变难,所以收益随分辨率降低(Table 6 显示 1080p 时记忆剪枝增益有限,4K 以上才显著);其三,质量上有轻微退化,如 CRGNN 的 Grad 从 11.74 升到 12.87、dtSSD 从 4.54 升到 4.61。我自己的观察:第一,不确定度阈值 $\tau=0.15$ 是全局固定超参,遇到边界占比极高的场景(人群、舞蹈)时选中查询比例可能远超 7%,时延上界不受控,最坏情况退化回接近稠密匹配;第二,低分辨率传播是额外计算分支,管线复杂度上升,小分辨率下净收益可能为负;第三,评估基准(VideoMatte、YouTubeMatte、CRGNN)以单人物为主,对多目标抠图、大面积半透明物体(烟雾、玻璃、婚纱)和非人物体没有验证;第四,不确定度信号的可信度绑定在 MatAnyone 2 的训练上,换底座模型需要重新验证代理质量。
独立分析的弱点
弱点一:固定阈值的查询剪枝导致时延不可预测。$\tau=0.15$ 和 top-15% 记忆保留率都是静态超参,遇到舞池、演唱会人群等高不确定度场景时选中区域占比会飙升,显存和时延随之波动,对直播等硬实时系统是隐患。改进方向:引入硬性空间预算约束,把"超阈值即选"改为带预算的不确定度排序选择(附录多级调度已有 $M=4096$ 的雏形,可推广到单级配置)。弱点二:记忆剪枝打分只用 $w_j = \max_i A^{\downarrow s}_t[i,j]$,只关心"是否被任一选中查询强关联",忽略了记忆条目间的冗余与覆盖多样性,多目标场景下一个目标的记忆可能挤掉另一目标的候选。改进:混合打分(max 亲和度 + 条目使用频率)或按场景自适应 $\rho$。弱点三:4K 基线靠外推,7.4 倍的结论说服力打折。改进:在缩减记忆库的配置下实测 MatAnyone 2 并明确标注外推比例,同时补充 2K 记忆库下的公平对照。弱点四:蒸馏只对齐中间特征,CRGNN 上 Grad 相比基线 +1.13 暗示高频细节有损。改进:加入梯度域或拉普拉斯金字塔蒸馏项,直接约束边缘结构。弱点五:低分辨率分支在低分辨率输入下收益有限甚至为负,缺少分辨率感知的自动开关。
未来方向
作者提出的方向:把选择性高分辨率计算确立为记忆类抠图乃至记忆类 VOS 的通用效率范式,并继续优化多级调度的级数与空间预算 $M$ 的配置。基于成果可延伸的方向:第一,端到端学习查询-记忆选择,用可微 top-k 或 Gumbel 采样联合训练 $\tau$ 和 $\rho$,取代手工超参;第二,把框架移植到生成先验抠图(GVM、VideoMaMa),这类方法计算开销更大,稀疏化的收益空间可能更高;第三,与量化、TensorRT 等部署栈协同设计——编译已带来额外约 1.7 倍提升,记忆键值的低比特量化还有压缩空间;第四,面向流媒体直播做时延-质量自适应控制,根据 GPU 负载动态调整 $\tau$ 与 $\rho$,提供有界时延保证;第五,把"廉价低分辨率传播引导昂贵高分辨率计算"的思想推广到视频编辑、视频生成中的对应关系估计等同样受分辨率制约的任务。
复现评估
复现评估:论文提供了项目主页(shuyun-wang.github.io/projects/MatAnyone-E),按团队惯例(MatAnyone 与 MatAnyone 2 均已开源)代码与权重大概率会放出,但正文未直接给出仓库链接,使用前需确认。训练侧门槛较高:需要 8 张 A800-80GB、总 batch 16、每样本 8 帧 480×480 随机裁剪,从 MatAnyone 2 预训练权重初始化,数据为公开视频抠图数据集加 VMReal 训练集(后者是否公开待确认);个人研究者难以完整重训,但蒸馏只需冻结教师前向,可显著压缩算力需求。推理侧门槛很低:所有超参在论文中完整给出($s=2$、$\tau=0.15$、$\rho=0.15$、解码器通道宽 [256,128,64,32,16]、$\lambda_{distill}=0.001$、4K 用 4 到 2 到 1 调度且 $M=4096$),单张 RTX 3090 即可跑 1080p(33.6 FPS);评估基准 VideoMatte、YouTubeMatte、CRGNN 的高分辨率子集均公开。总体判断:拿到权重后推理复现容易(一天内可完成),完整训练复现需要数据中心级算力与 VMReal 数据,难度中高。
论文图表
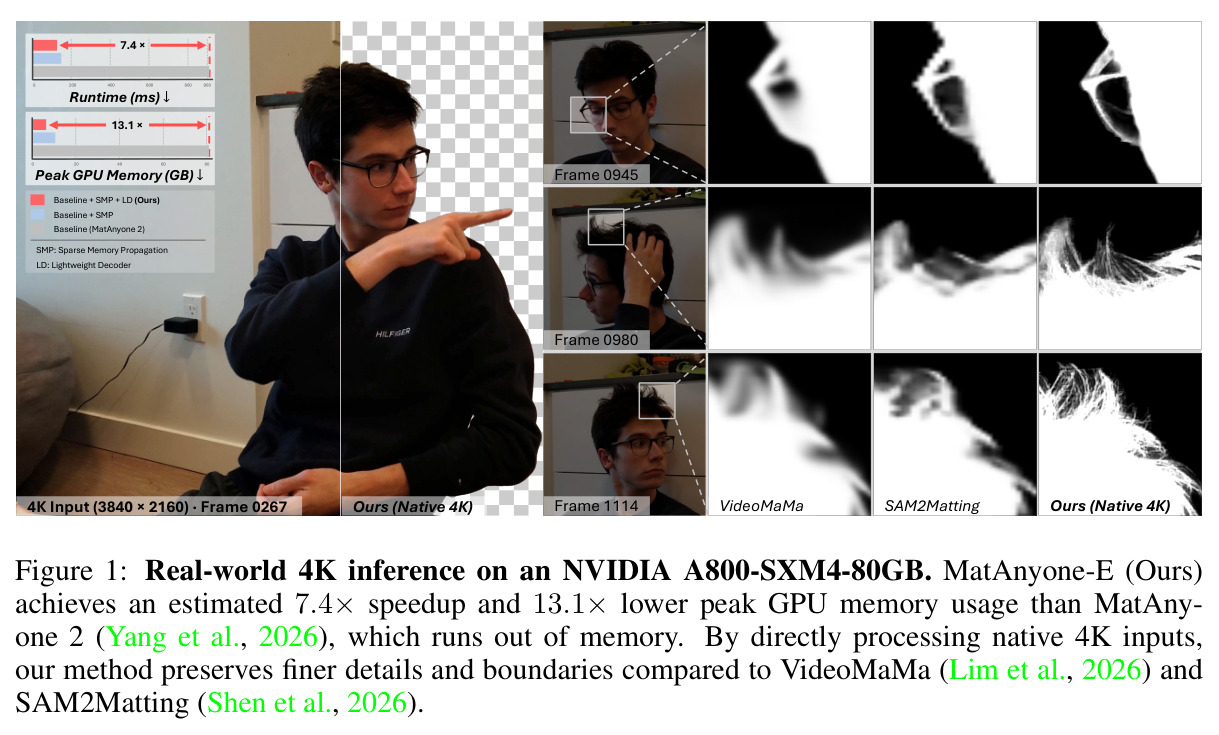
首图对比:MatAnyone-E 相对 MatAnyone 2 实现约 7.4 倍加速和 13.1 倍峰值显存降低(后者在 4K 直接 OOM),并展示原生 4K 输出与 VideoMaMa、SAM2Matting 的细节对比(Frame 0267/1114 等)。
一眼看懂论文的两大卖点(效率数量级提升 + 原生 4K 细节),是判断是否继续读下去的入口。