以轨迹为证:面向 AI Agent Harness 可靠性与失败归因的基准测试 Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
以95个机制任务与双层评分,把 agent harness 作为被测系统评估可靠性并归因失败
前置知识
Agent Harness(智能体执行框架)
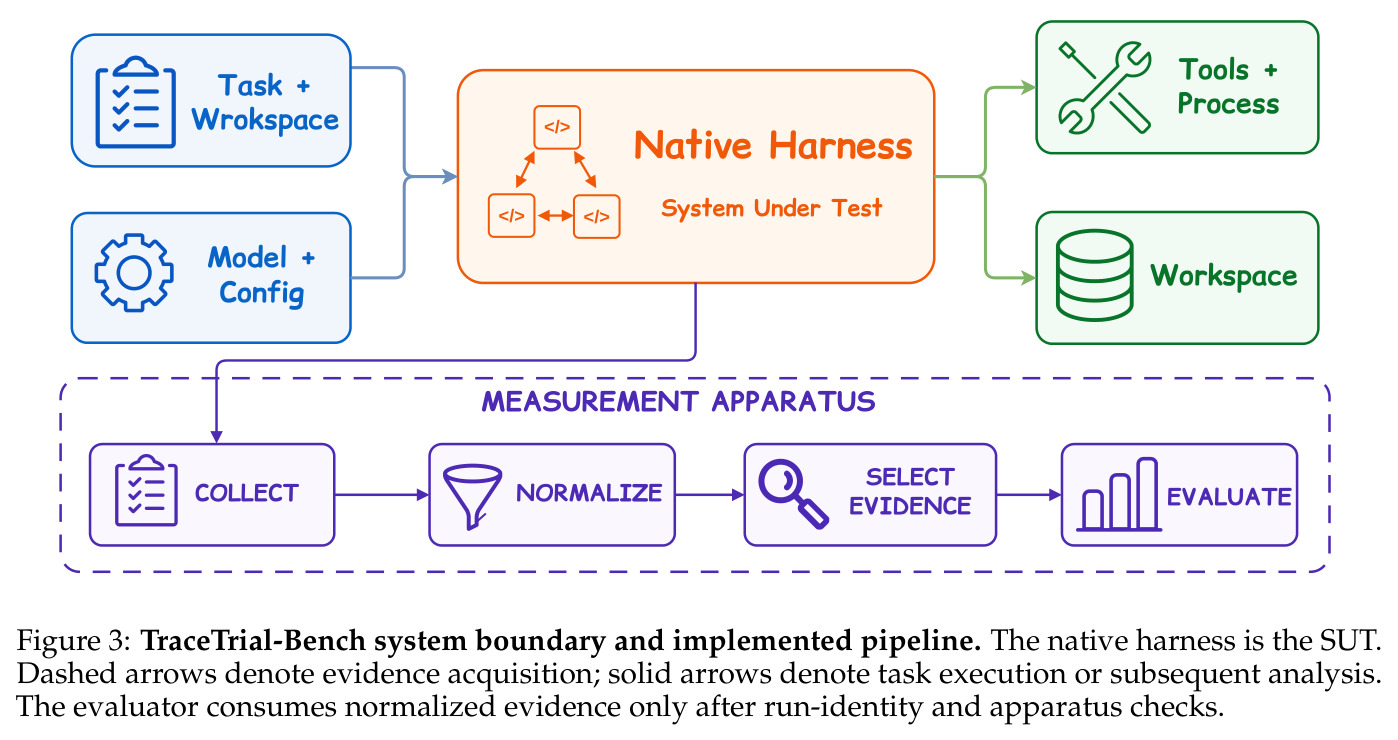
现代 agent 系统可抽象为 Agent = Model + Harness:模型负责解读信息、选择动作;harness 负责构建上下文、暴露工具接口、传输调用与结果、维护持久状态、执行权限与生命周期控制。它与 scaffold(提示词/工作流)和 runtime(进程/文件系统)概念有交叠,本文把编排与控制功能都划入 harness 边界,而工具实现、任务环境与评估器属于边界之外。
论文的核心主张是把 harness 当作被测系统(SUT)。若不能区分模型与 harness 各自的职责,就无法理解为什么要做双层评估,也无法理解为什么 31.1% 的“任务成功”被认定为掩盖了 harness 缺陷。
执行轨迹与 Trace IR
轨迹是 agent 运行期的有序事件记录,包括模型输入、工具调用与结果、上下文压缩边界、子代理生命周期、策略事件等。Trace IR 是本文定义的规范化中间表示:每个事件带 schema_version、seq、timestamp、run_id、event_type 公共信封,类型专属字段仅在原生来源支持时填充,原始记录保留在 raw_event 字段以便审计;四个 harness 通过各自适配器把异构日志映射到该统一格式。
harness 层所有判据的证据都来自轨迹。理解 Trace IR 的信封结构与“来源保留”原则,才能明白跨 harness 的分数为什么可比、证据为什么可信。
证据边界与权威源
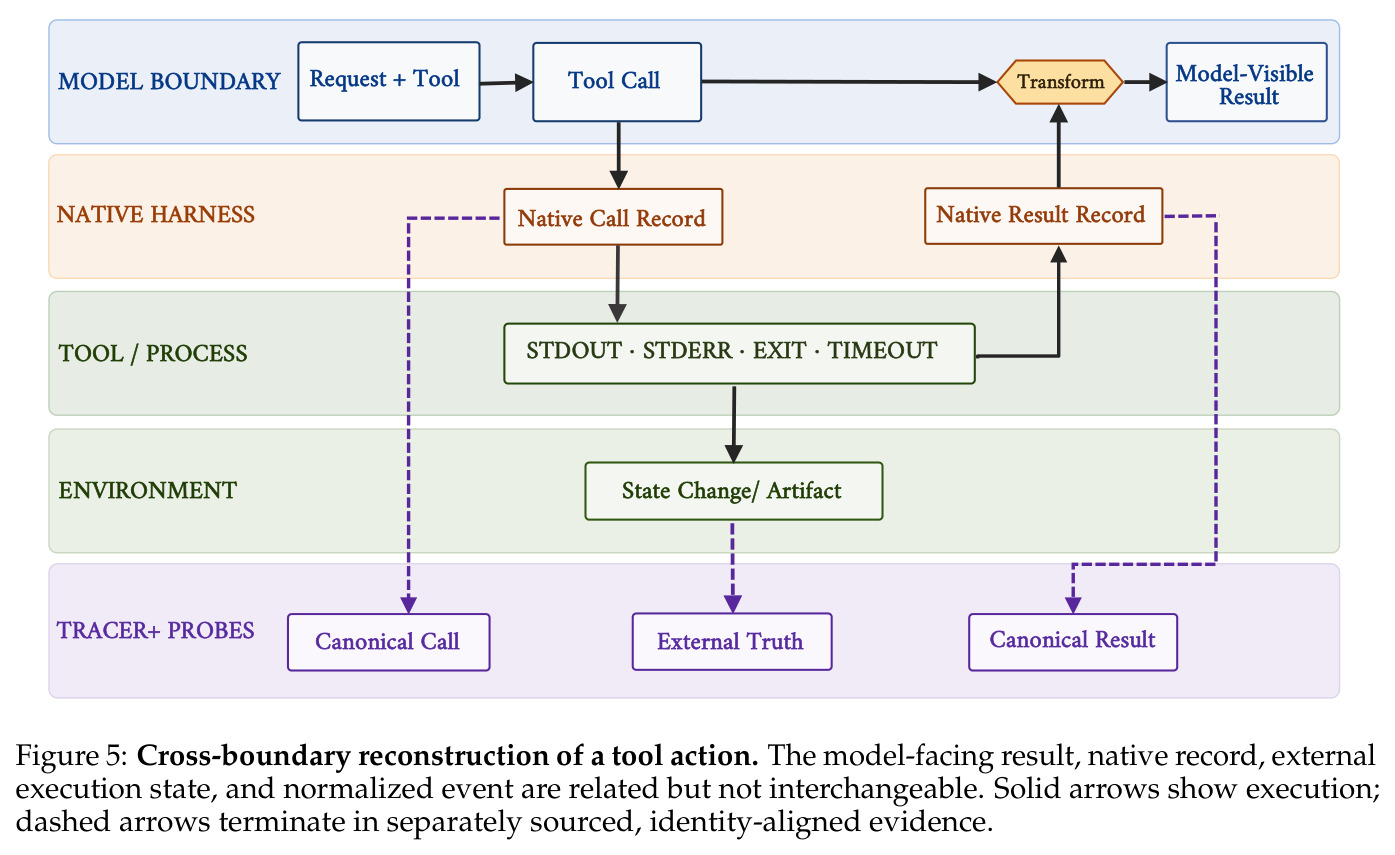
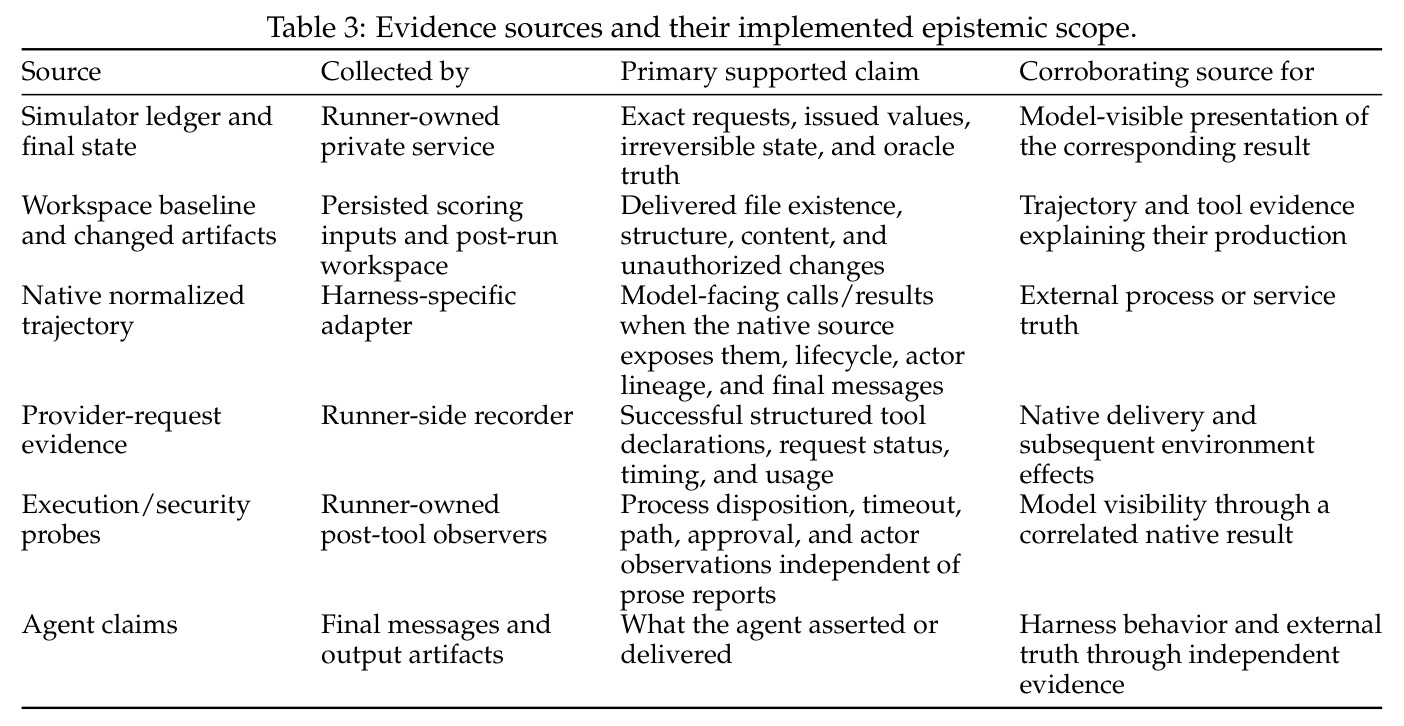
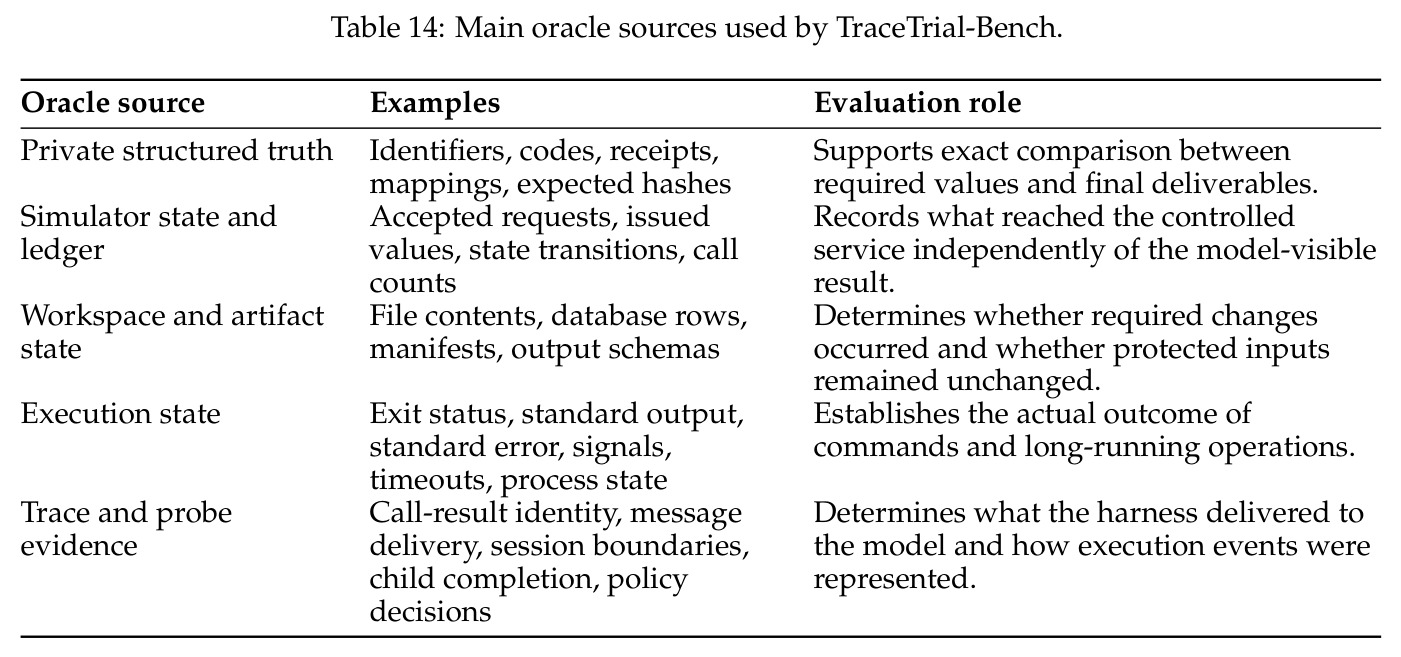
同一个“工具结果”在不同边界有互不等价的表示:外部进程的真实输出、harness 转换后模型可见的载荷、原生会话归档、评测器看到的规范化事件。本文按问题指定权威源——环境/模拟器状态回答“实际发生了什么”,模型可见记录回答“模型能观察到什么”,工作区变更回答“最终交付了什么”——并规定一个边界的证据不能自动替代另一个边界。
“跨边界保真度判据”是全文的方法论基石:正因为区分了外部真值与模型可见表示,才能测出“harness 向模型隐瞒了超时或错误”这类深层缺陷。
LLM Judge 与确定性验证器
判据分两类:确定性规则直接对任务状态、工件或轨迹属性做程序化检查(本文 909 条);语义判据(430 条)由独立的语义评分模型 deepseek-v4-flash 基于限定大小的证据包打分。每个语义判据预先声明检索契约(事件类型、字段、关键词、返回上限),Judge 的提示、响应、解析分数与理由全部存档,评测过程中不可更改。
论文报告的 68.3% harness 通过率混合了两种判据来源。知道哪些结论依赖 LLM 评判、评判输入如何被限定,是正确解读实验结果的前提。
机制链与失败归因(Failure Attribution)
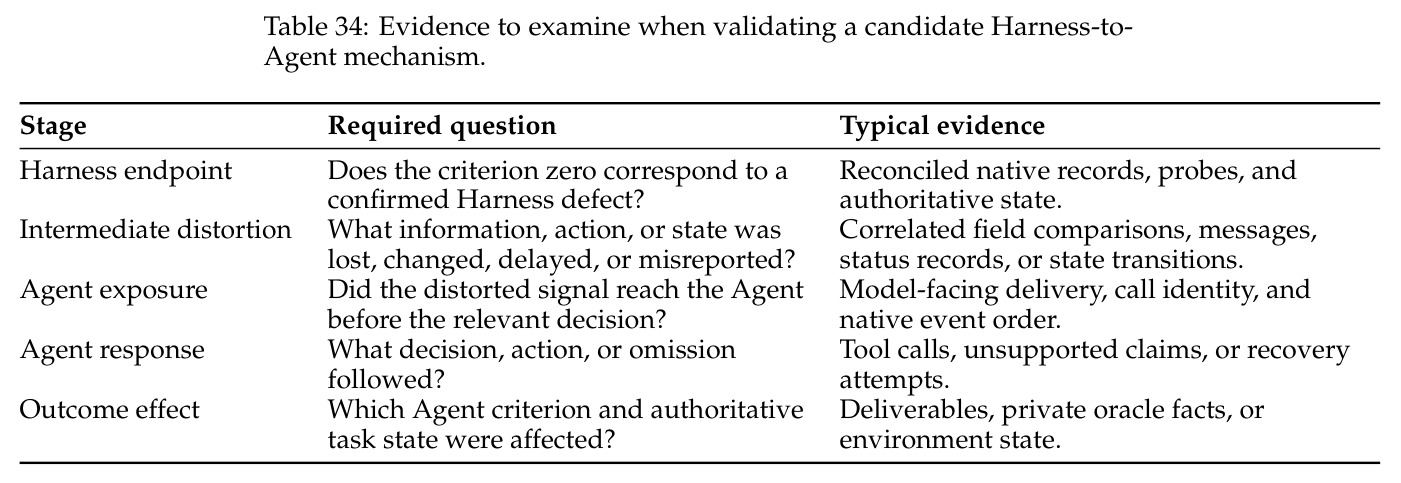
机制链 $\ell = (h_\ell, a_\ell, \mu_\ell)$ 在执行前预声明“harness 判据 $h_\ell$ 失败 → 中间失真 $\mu_\ell$ → agent 判据 $a_\ell$ 失败”的候选传播路径。运行时当两端判据同时失败且激活条件 $q_\ell(R)=1$ 时自动生成候选链接集合 $L_{act}$;要升级为“已验证传播”$L_{val}$,还需人工复核两端判定、找到可观察的中间失真、事件顺序与机制一致并排除竞争解释。
这是论文区分“失败共现”与“失败传播”的关键设计。理解它才能明白 harness_caused 标签为何只是候选激活而非因果结论,也才能读懂归因相关的全部表格。
研究动机
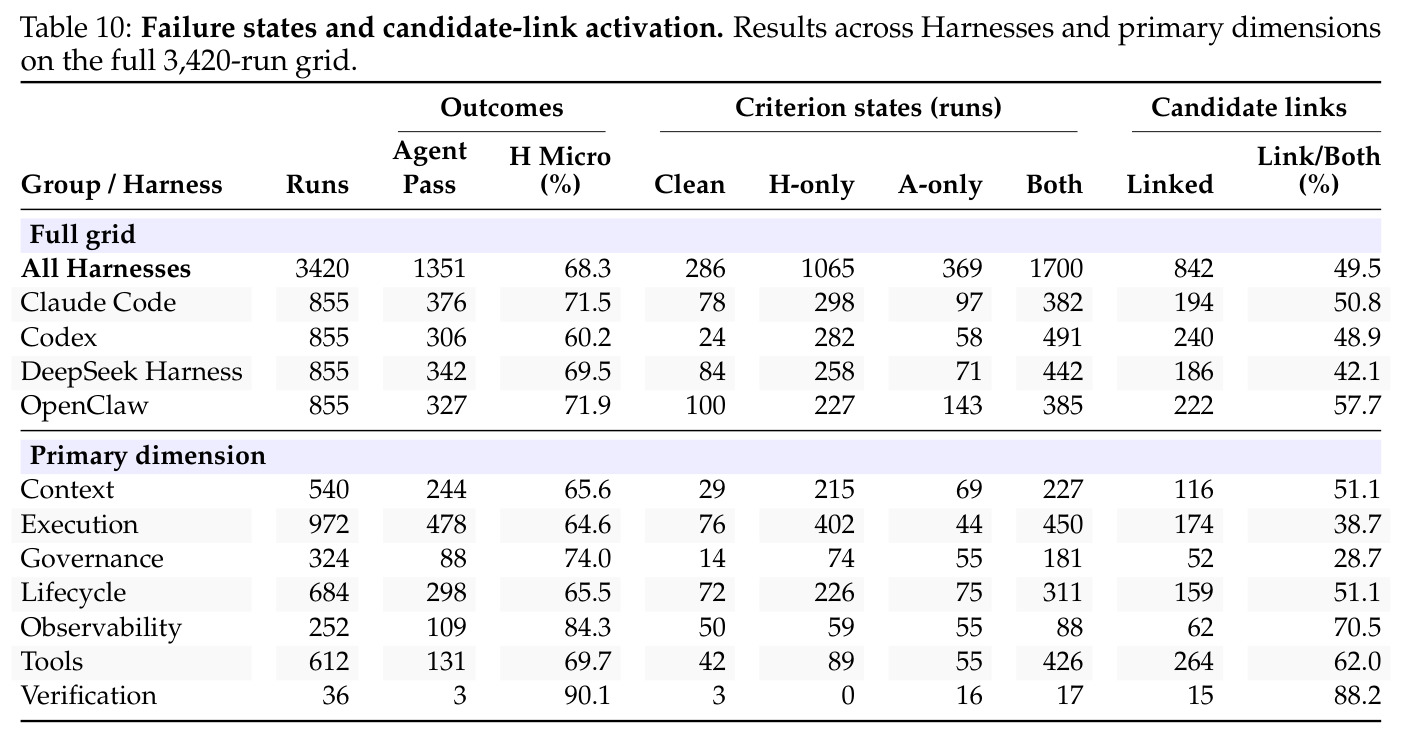
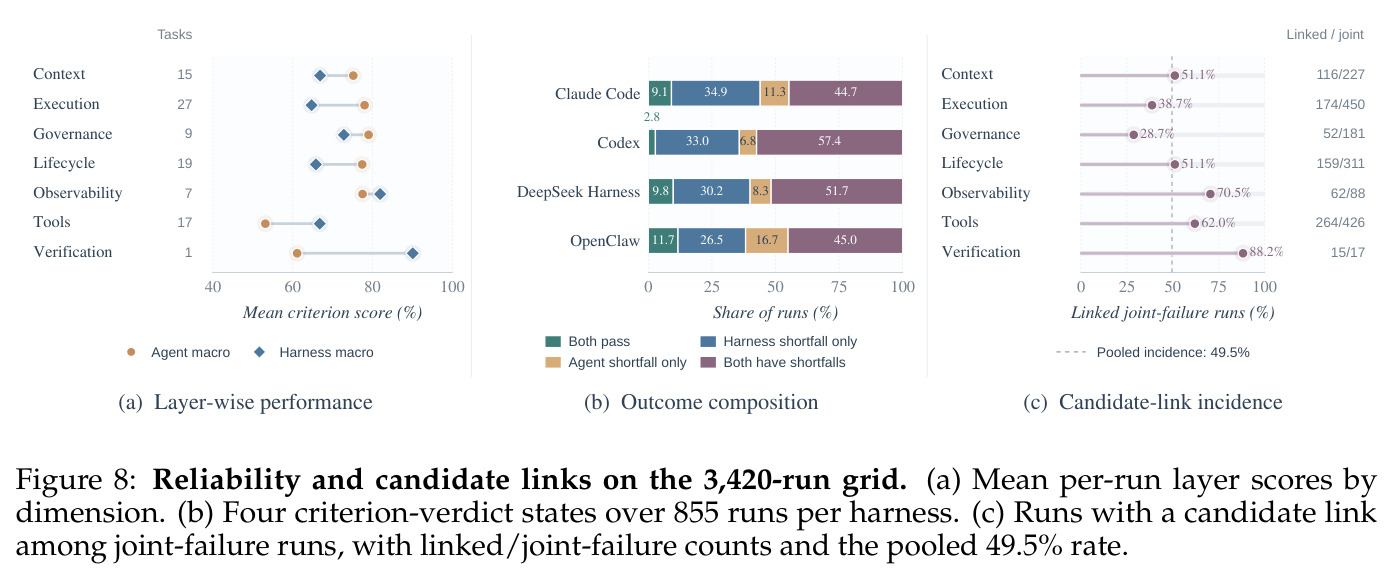
现有 agent 基准(如 SWE-Bench Pro、Terminal-Bench)几乎都只以最终交付物、测试通过或环境终态来判定任务完成,这衡量的是模型与 harness 的叠加效果,无法回答“某个 harness 机制是否可靠”。论文 Figure 1 刻画了两类系统性错位:任务成功可能掩盖上下文丢失、工具结果失真或生命周期违规;任务失败也可能发生在 harness 忠实执行之下——错误出在模型决策。即使把模型固定,结果层面的对比也无法定位是哪些 harness 行为造成了差异。作者在全网格 3,420 次运行中量化了这一盲区:31.1%(1,065 次)的运行在至少一项 harness 判据失败的情况下仍达成任务成功;agent 任务成功率仅 39.5%,而两层判据全部通过的只有 8.4%(286 次)。也就是说,outcome-only 评测既会漏报 harness 缺陷——成功的交付物背后可能是被掩盖的失败通道或丢失的状态转换——也会把模型的错误决策记到系统头上。近期 Harness-Bench、HarnessAudit 等工作开始关注 harness 配置与执行保真,但缺少机制粒度、证据可审计的系统性评估工具。
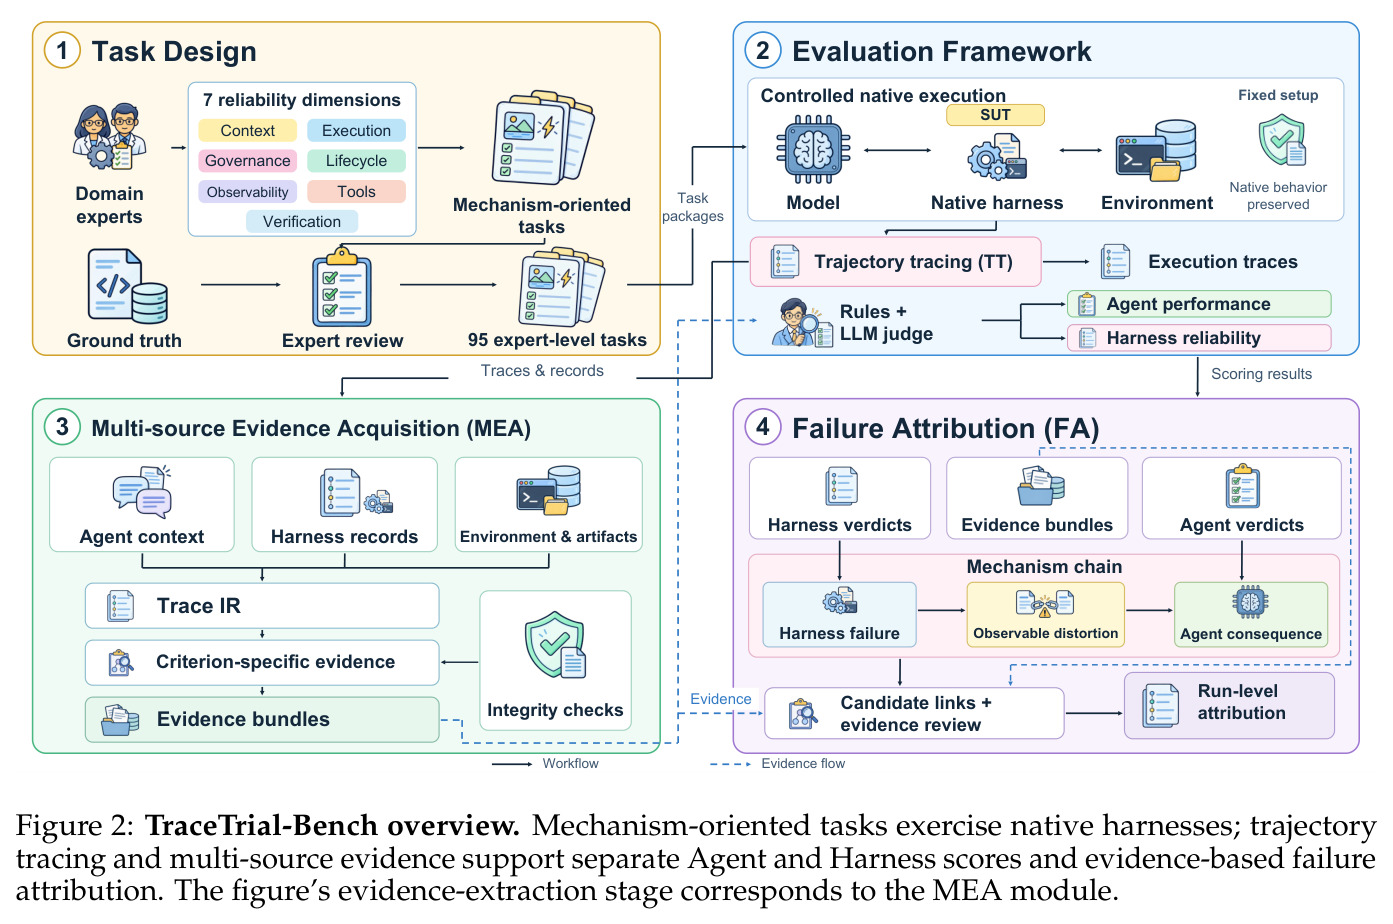
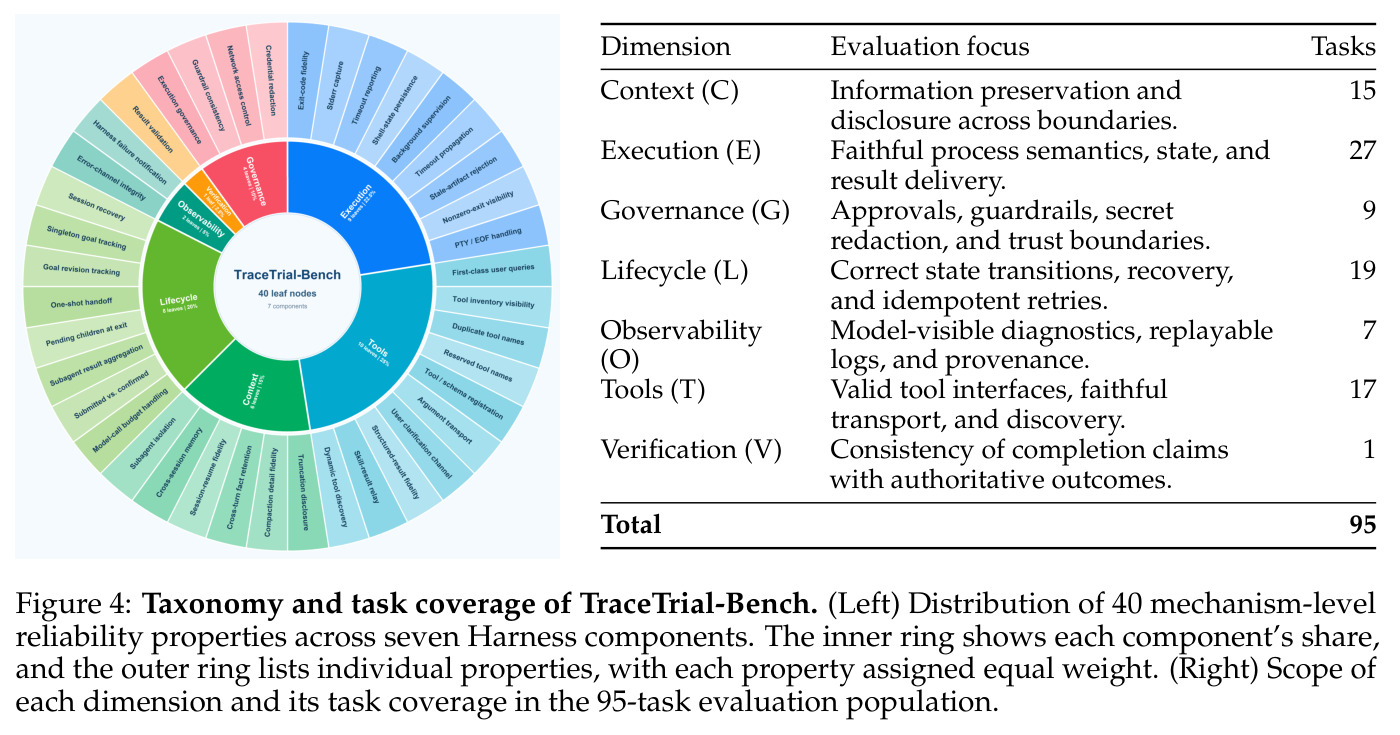
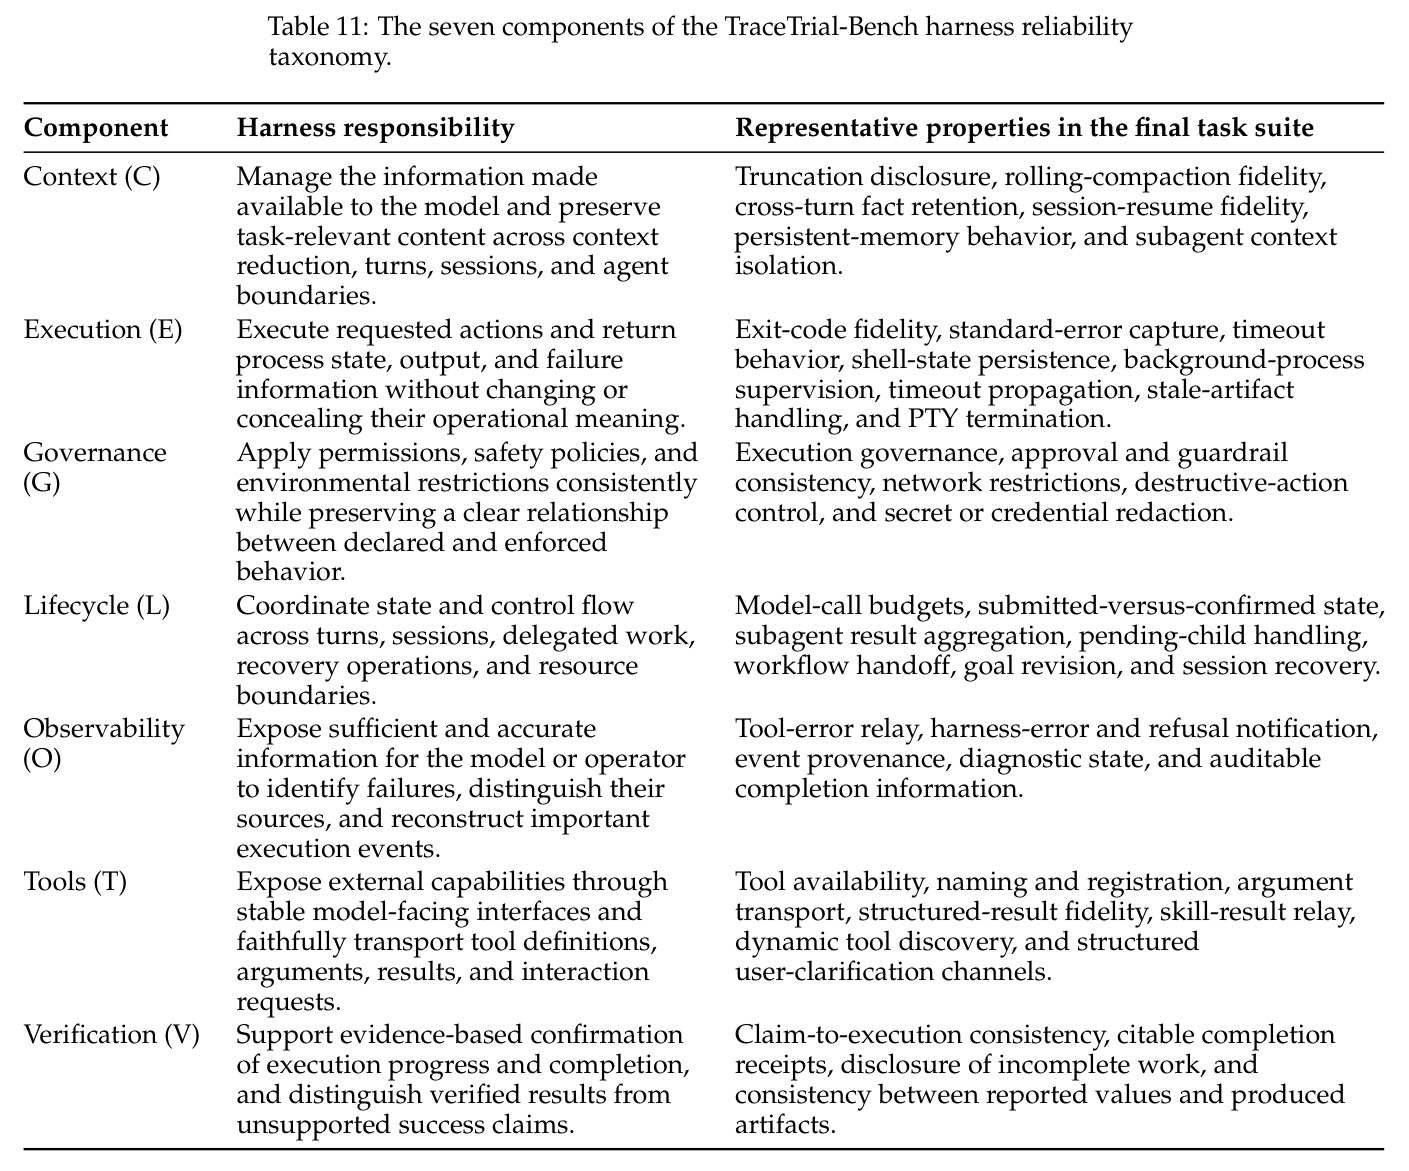
本文的目标是本文构建 TraceTrial-Bench:一个把“原生 harness 当作被测系统(SUT)”的机制导向基准,目标有四。其一,把 harness 可靠性组织为七个组件——Context、Execution、Governance、Lifecycle、Observability、Tools、Verification(C/E/G/L/O/T/V),落到 40 个机制级属性,建成 95 个专家级任务;每个任务把明确的行为义务与 agent 交付物配对,并提供可执行或基于状态的真值锚点。其二,设计轨迹追踪(TT)模块:在保留来源(provenance)的前提下,把四个 harness 异构的原生记录重建为统一的 Trace IR。其三,建立双层评估框架:由多源证据获取(MEA)模块按判据组装证据包,先通过测量装置准入门,再分别结算 agent 任务表现与 harness 义务履行两套判定向量。其四,通过预声明的机制链做失败归因(FA),把“候选链接”与“经证据复核验证的传播”严格分开。最终在 4 个 harness(Claude Code、Codex、OpenClaw、DeepSeek Harness)、9 个模型、95 个任务上完成 3,420 次选定执行,发布任务、配置、轨迹与判定,为 harness 对比、缺陷诊断与“harness 设计如何影响模型行为”的研究提供可审计、可复现的基础。
与已有工作不同的是,本文的独特切入是把评测对象从“模型能力”整体挪到“harness 系统行为”,并为此补齐三块此前缺失的基础设施。第一是语义等价的跨 harness 执行协议:source-specific 适配器固定任务契约与预言机、保留各 harness 的原生接口与执行策略,允许表示归一化但禁止引入能力、增强模型可见证据或改变通过条件——这让“同一模型-任务在不同 harness 下”真正可比,而不是把 harness 差异和适配器差异混在一起。第二是证据边界理论:论文明确区分外部结果、模型可见载荷、原生会话记录、规范化事件四种互不等价的观察,按问题指定权威源,并定义四级主张层级(判据判定 → 确证缺陷 → 激活候选链接 → 验证传播),防止把运行时标签当成因果结论。第三是预声明机制链:在执行前登记 harness-agent 判据对及其激活条件,把归因从“事后读日志讲故事”变成“候选自动激活 + 人工证据复核”的可审计流程。相比之下,Harness-Bench 只在共享条件下比较配置,HarnessAudit/HarnessRisk 检查执行保真与对抗风险,Who&When/AgentRx 做失败定位与诊断,但都没有把“双层判据 + 证据边界 + 机制链”组合成完整闭环。
核心方法
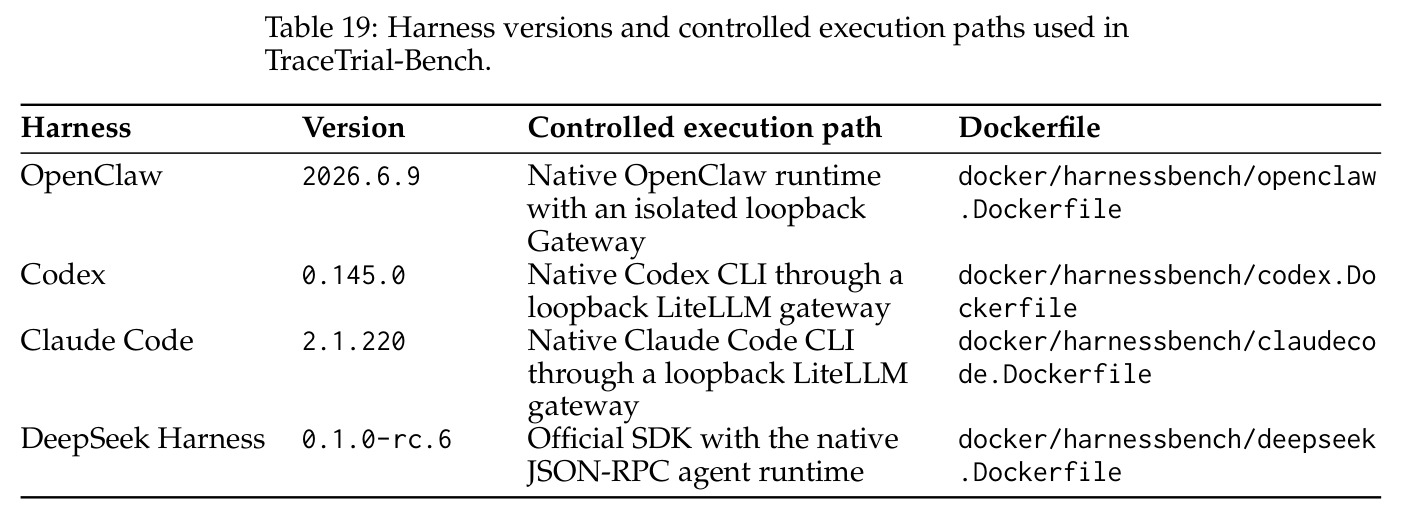
直觉上,论文给每次 agent 运行记两本账:agent 层问“任务做完没有、交付物对不对”,harness 层问“系统是否忠实地传递信息、执行语义、维护生命周期”。两本账用不同证据、不同判据表分别结算,之后再问第三个问题:agent 层失败能否沿预声明机制链追溯到 harness 层失败。技术路线五步。第一步任务设计:从分类学子维度锁定被测机制、模型可见后果与外部真值锚点,任务包固定提示词/轮次、初始工作区、工具、预算、确定性验证器与两张评分表——全库共 783 条 harness 判据、556 条 agent 判据(909 条程序化规则、430 条语义判据)。第二步跨 harness 执行:适配器分别启动 Claude Code 2.1.220、Codex 0.145.0、OpenClaw 2026.6.9、DeepSeek Harness 0.1.0-rc.6,保留原生行为,在 Docker 内冻结配置。第三步 TT 轨迹追踪:把 JSON 事件流、stream-json、session JSONL、JSON-RPC 通知流归一化为带信封的 Trace IR,用原生调用 ID 关联调用与结果,并在 provider 边界捕获结构化工具声明。第四步 MEA:把归一化轨迹、工作区相对基线的 diff、模拟器台账与探针证据按判据声明组装成有界证据包。第五步双层评估与 FA:准入检查后先固化确定性规则,再由固定 Judge(deepseek-v4-flash)先评 agent 语义判据、后评 harness 语义判据,最后按 $L_{act}=\{\ell\in C_{runt}\mid h_\ell\in F_H,\ a_\ell\in Z_A,\ q_\ell(R)=1\}$ 激活候选链接;综合分按 $S = 50\frac{p_H}{n_H} + 50\frac{p_A}{n_A}$ 结算。
核心创新是“义务与结果分离评分”加“证据边界权威制”,与已有方法的本质区别有三。第一,现有基准把 harness 当作模型的透明包装只评最终交付物;本文给每个任务配两张评分表:agent 层对照权威状态检查必需动作与交付物,harness 层检查原生系统是否履行信息与执行义务,两个判定向量独立保留,唯一的显式依赖是 harness 语义判据的“未触发”状态 2 由 agent 结果消解(agent 全过则记过、否则记败)。第二,现有失败分析多从日志文本自由推断;本文规定每个问题的证据权威源——环境/模拟器状态确立“发生了什么”,模型可见记录确立“模型能看到什么”,工作区变更确立“交付了什么”,provider 请求证据只支持其捕获的结构化工具声明——并以四级主张层级防止把共现当因果。第三,归因不是开放式解释:机制链 $\ell=(h_\ell,a_\ell,\mu_\ell)$ 在执行前声明,运行时只有 harness 端点落在原始失败集 $F_H$、agent 端点落在 $Z_A$ 且激活条件成立才生成候选链接;升级为验证传播 $L_{val}$ 需人工确认两端判定、观察到中间失真、事件顺序一致并排除竞争解释。这套设计让“任务成功但 harness 有判据失败”(31.1%)与“双失败中仅 49.5% 有候选链”这两类现象第一次被系统性量化。
方法步骤详情
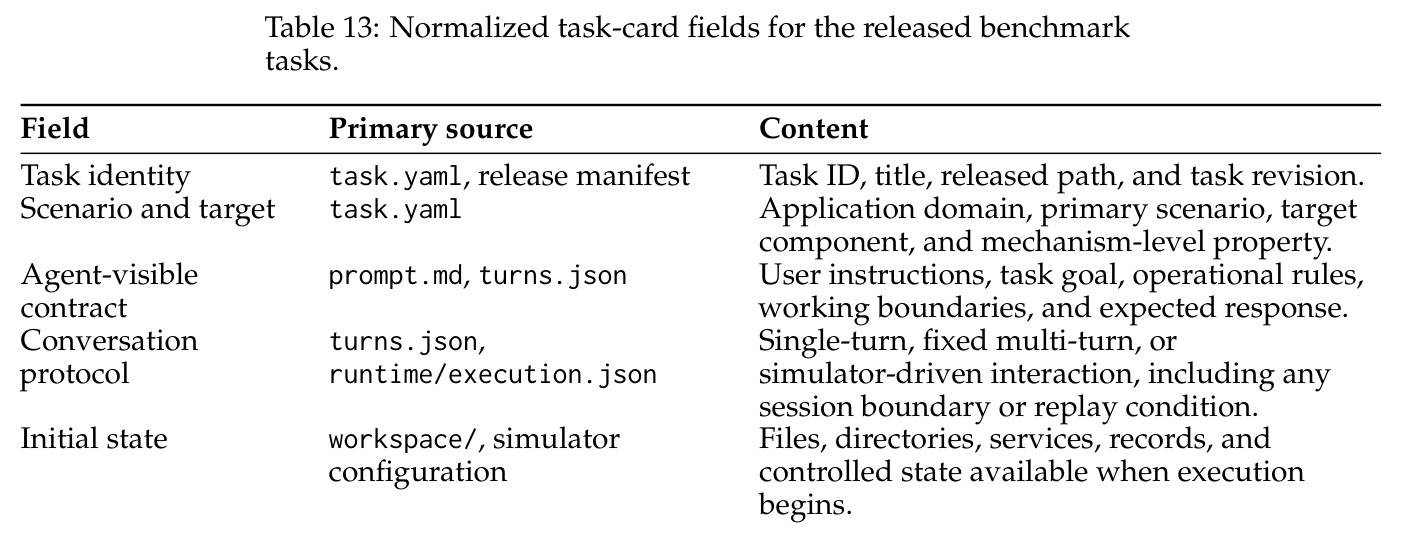
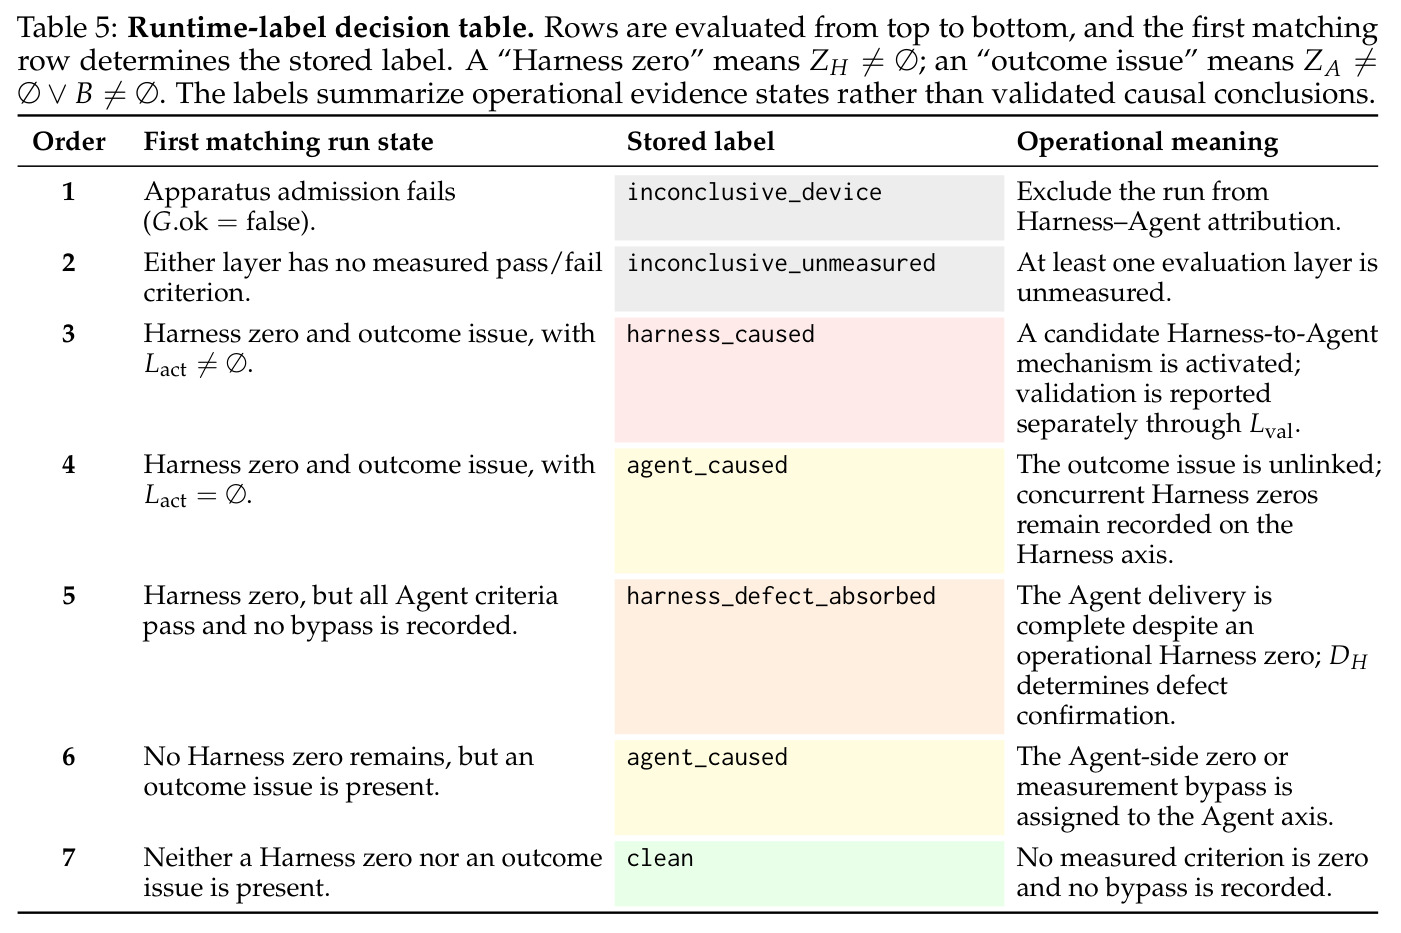
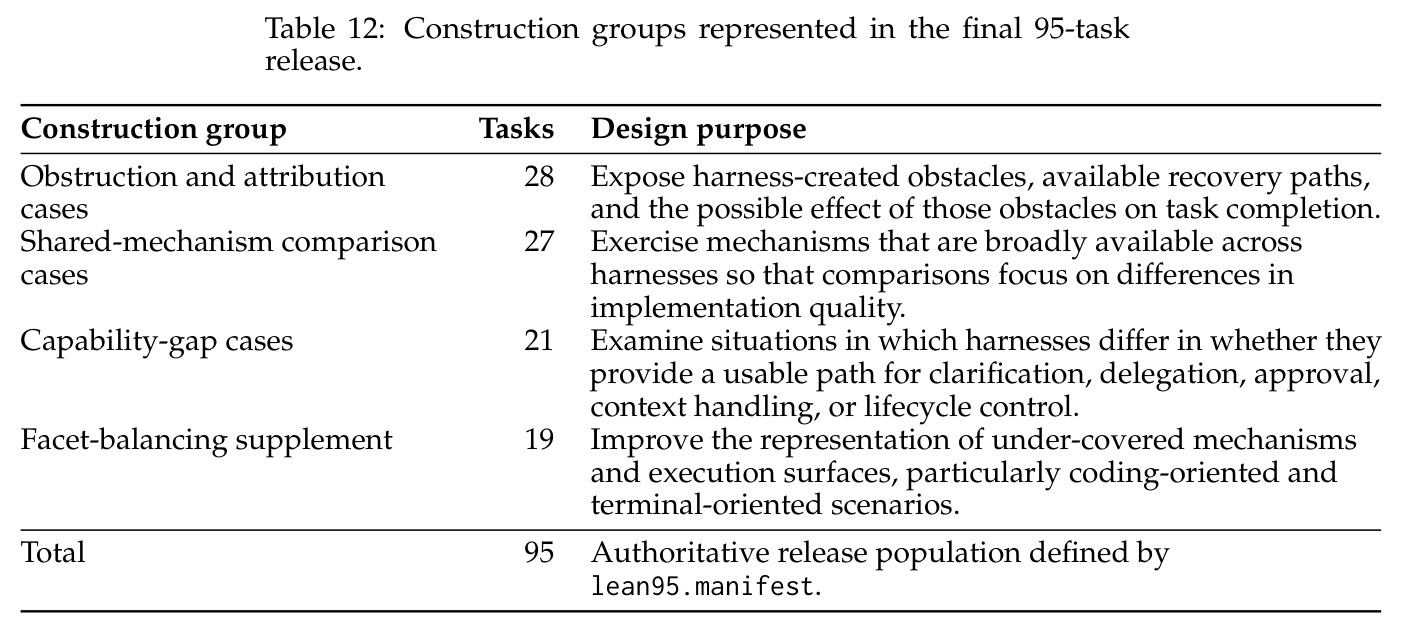
第一步,任务构建:从七维分类学选子维度并锁定触发器、预期行为、观察边界与判定条件,按四个构造组(障碍与归因 28、共享机制对比 27、能力缺口 21、补充均衡 19)产出 95 个任务,覆盖 40 个机制属性;形态为 46 单轮、45 固定多轮、4 模拟器驱动。任务包固定提示/轮次、初始工作区、工具、预算(墙钟 120–5,400 秒、1–120 轮、5–300 次工具调用上限)、验证器与两张评分表;私有预言机与基线快照放在 agent 不可写区域。第二步,跨 harness 执行:适配器冻结任务修订、解析配置、镜像与预算后启动原生 harness(Claude Code 与 Codex 经 loopback LiteLLM 网关、OpenClaw 用原生 Gateway、DeepSeek Harness 用 SDK+JSON-RPC),不改写提示构造、工具传输与权限。第三步,TT 轨迹追踪:适配器把各自原生流(Codex JSON 事件流、Claude Code stream-json+会话记录、OpenClaw Gateway JSON+session JSONL、DeepSeek JSON-RPC 通知流)映射为带连续 seq 信封的 Trace IR 事件数组;工具结果用原生调用 ID 关联,配不上的显式保持未链接;记录器还在 provider 边界提取结构化工具清单(只存声明元数据,不落请求体)。第四步,MEA 证据获取:每个语义判据声明事件类型、字段、字面量与返回上限,选择器产出带 scanned/matched/returned 计数与截断标志的有界证据包;完整归档保留供审计重放,凭据递归脱敏。第五步,双层评估与 FA:准入门校验运行身份、归档完整性、轨迹可评分性、探针与预言机完整性;先固化确定性规则,再评 agent 语义判据(以工作区变更为主要证据),后评 harness 语义判据(轨迹+探针证据);最后激活候选链接,按七条有序决策规则输出运行级标签(clean、agent_caused、harness_caused、harness_defect_absorbed、inconclusive_*)。综合分为 $S=50\,p_H/n_H+50\,p_A/n_A$。
技术新颖性
新颖性可从四个层面评估。概念层面:首次把 Agent = Model + Harness 中的 harness 作为独立被测系统,并用七维义务分类学(源自 ETCLOVG 分解)把模糊的“可靠性”翻译成 40 个可触发、可观察、可判定的机制属性;与 HARBOR、HarnessFix 等优化/修复 harness 的工作互补——它们改 harness,本文提供度量标尺。测量层面:Trace IR 与来源保留的归一化是关键工程贡献,八条规范化规则(保留原生内容、保守配对、原生 ID 可恢复、最强原生顺序优先、不合并多主体、损坏记录可见、缺失信息不脑补、装置证据分离)保证了跨 harness 可比性;在 provider 边界捕获结构化工具清单且不落请求体与授权材料,是少见的设计。协议层面:四级主张层级与六标签决策表把“分数、缺陷、候选归因、验证传播”严格分层,避免评测论文常见的过度因果声明;对测量旁路(measurement bypass,如 agent 用包装命令替换被测命令的退出码)的处理——旁路判据保留零分但不进归因集合 $Z_H$——体现了对“agent 行为污染测量”问题的自觉。实证层面:3,420 格的全因子矩阵无缺失、无插补,在 harness 评测中罕见;作者也诚实声明这是每格一次选定执行的观察性描述,不估计格内重复性。整体看,论文的价值主要在评估基础设施与协议设计,而非新模型或新算法。
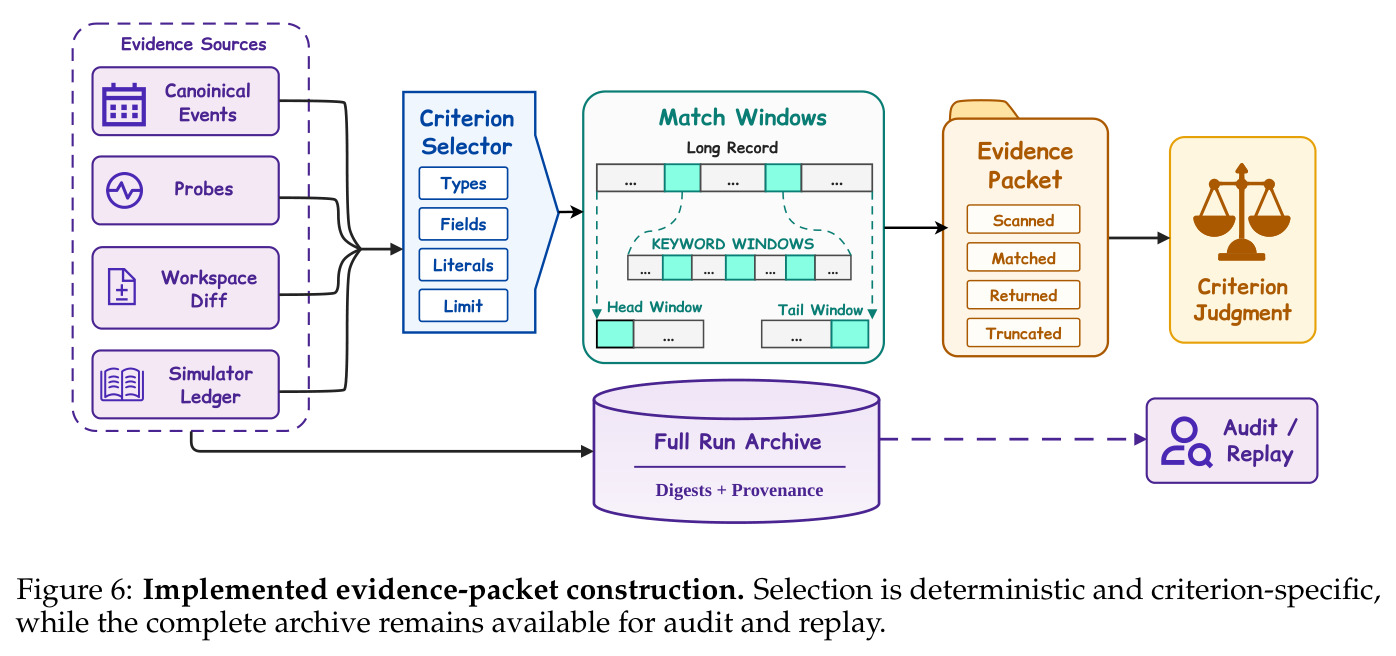
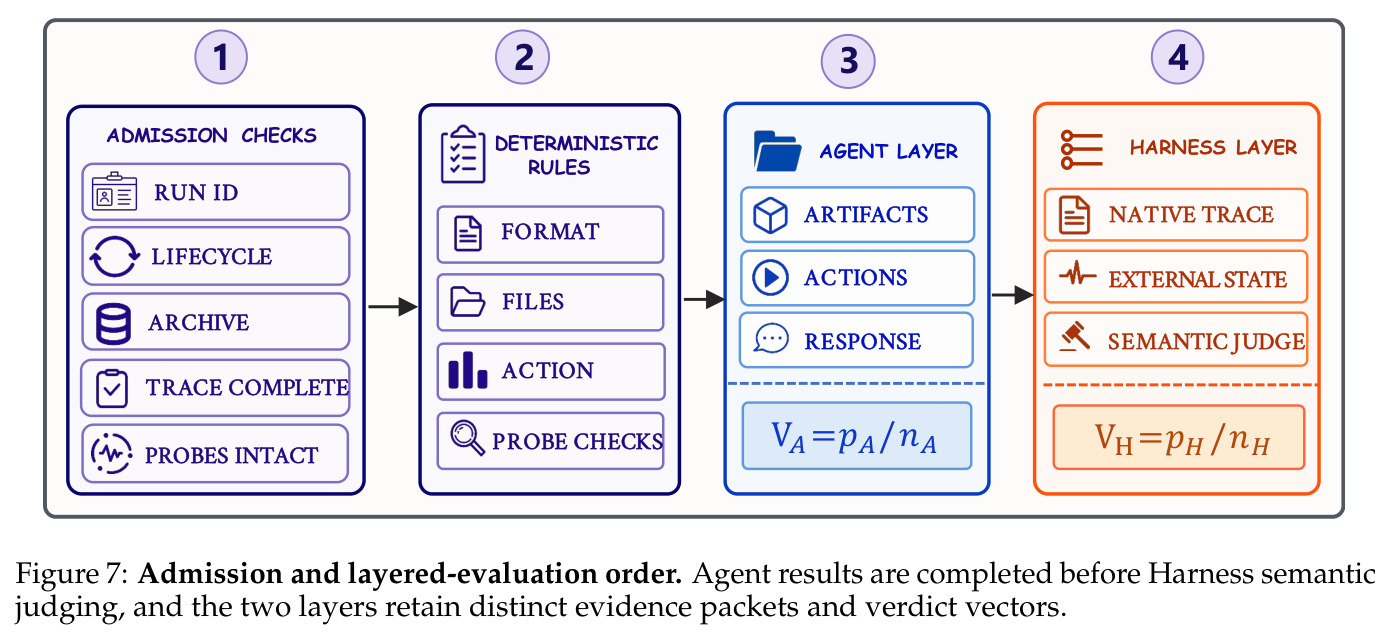
实验结果
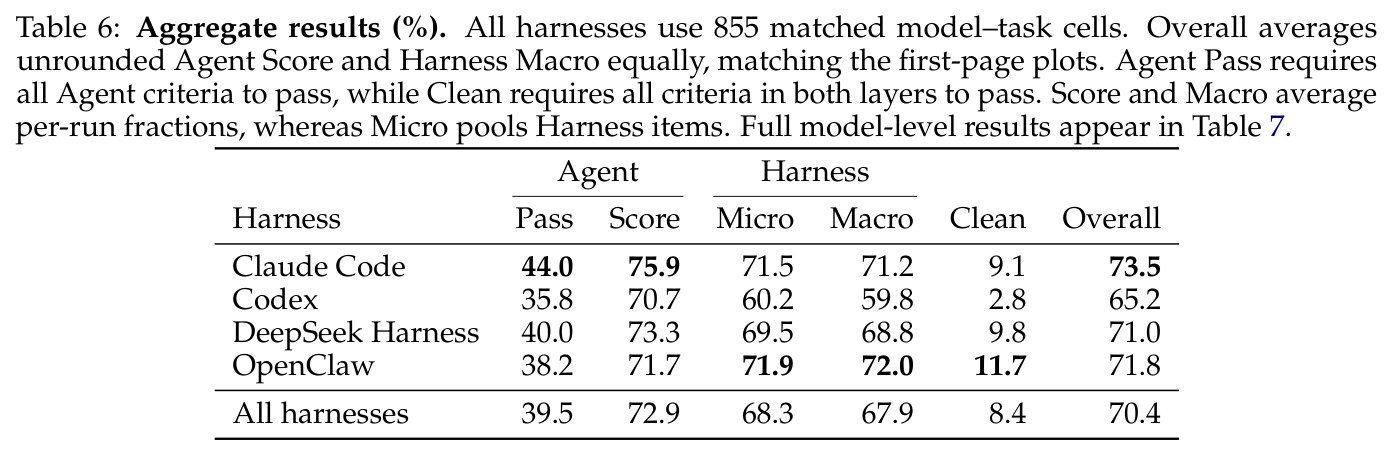
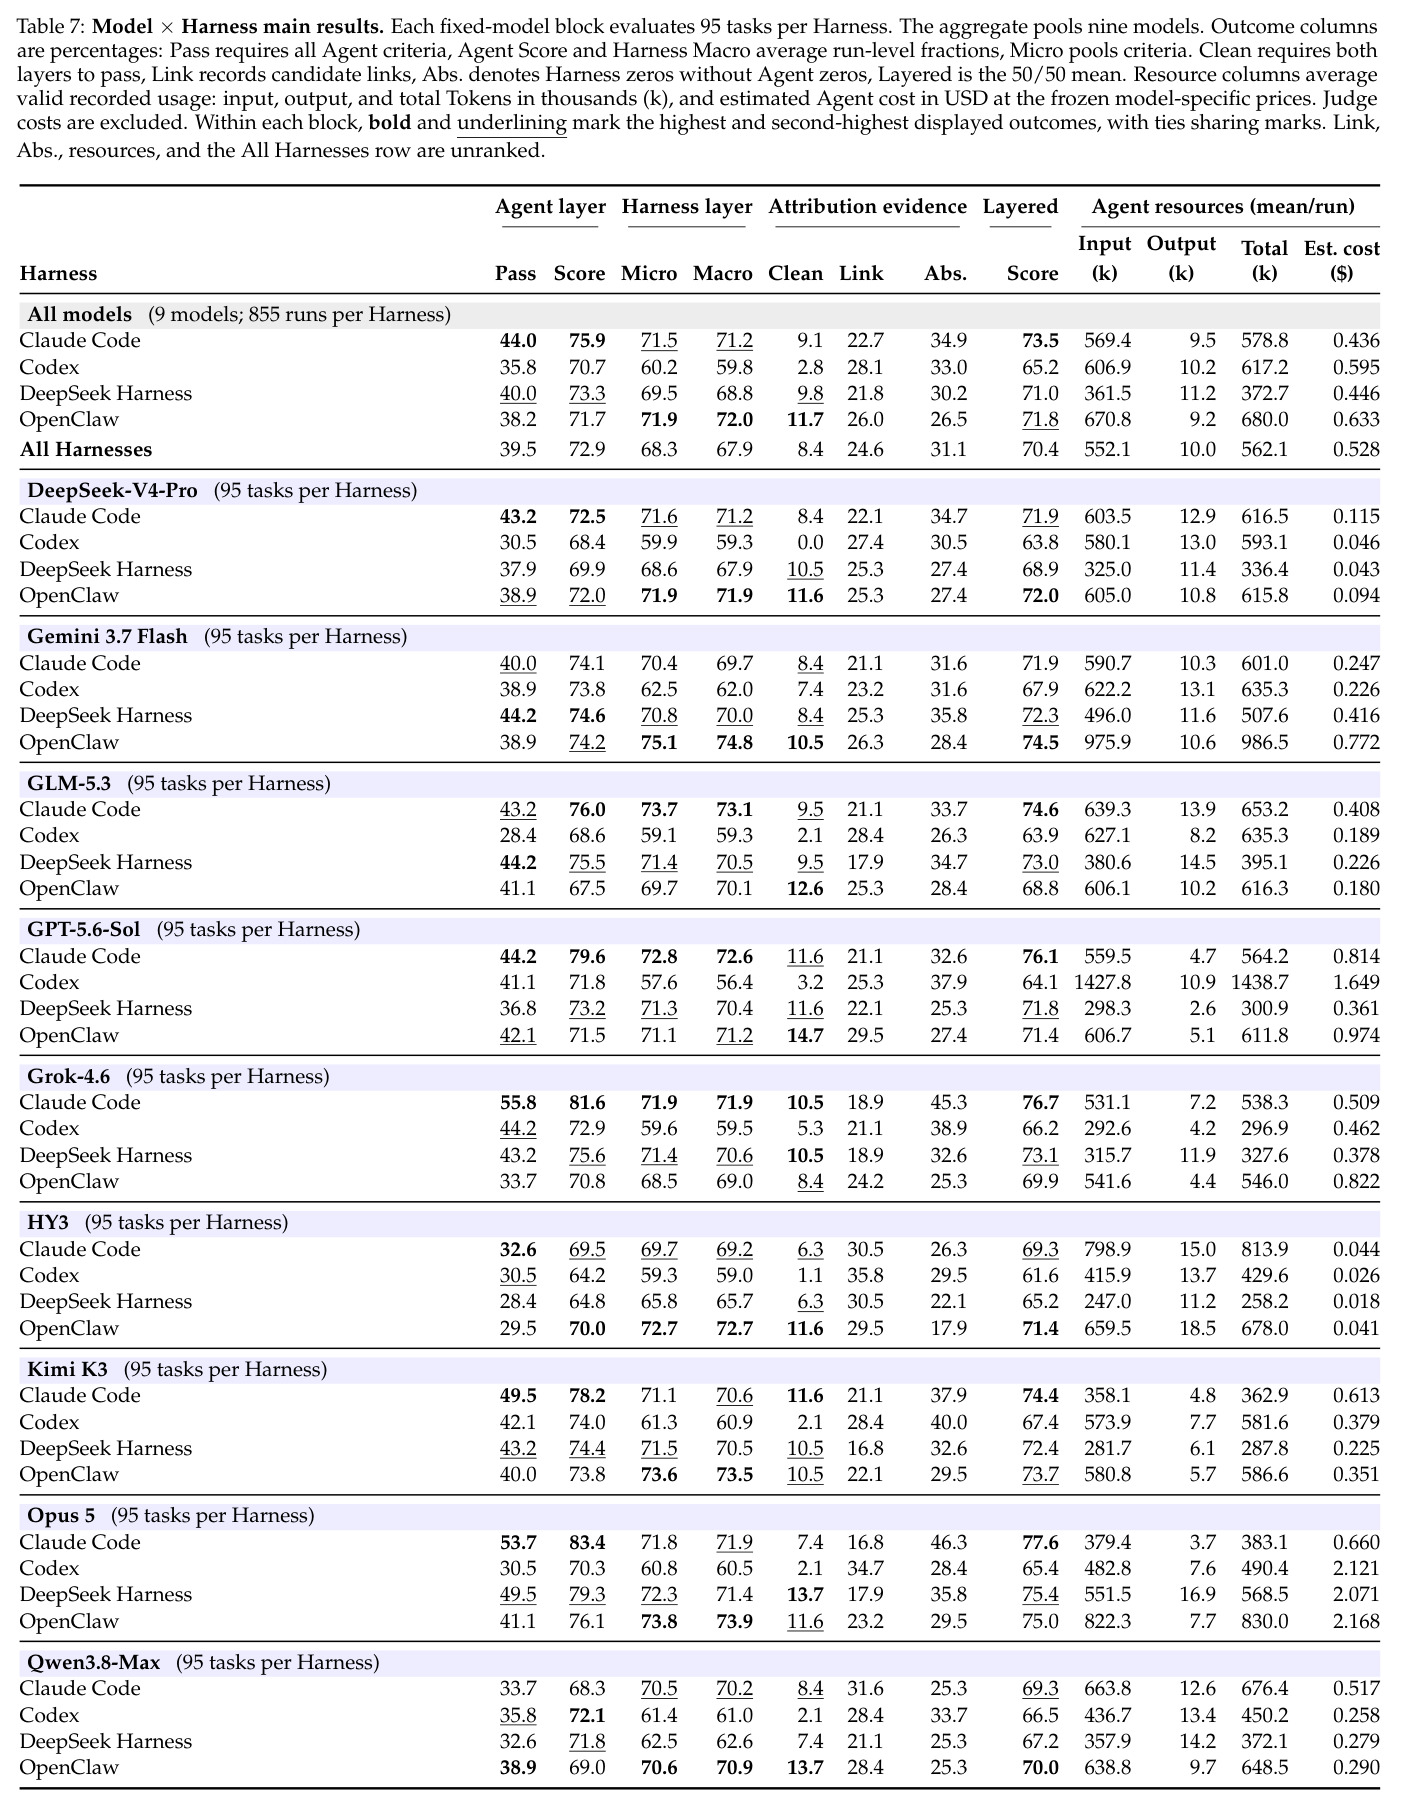
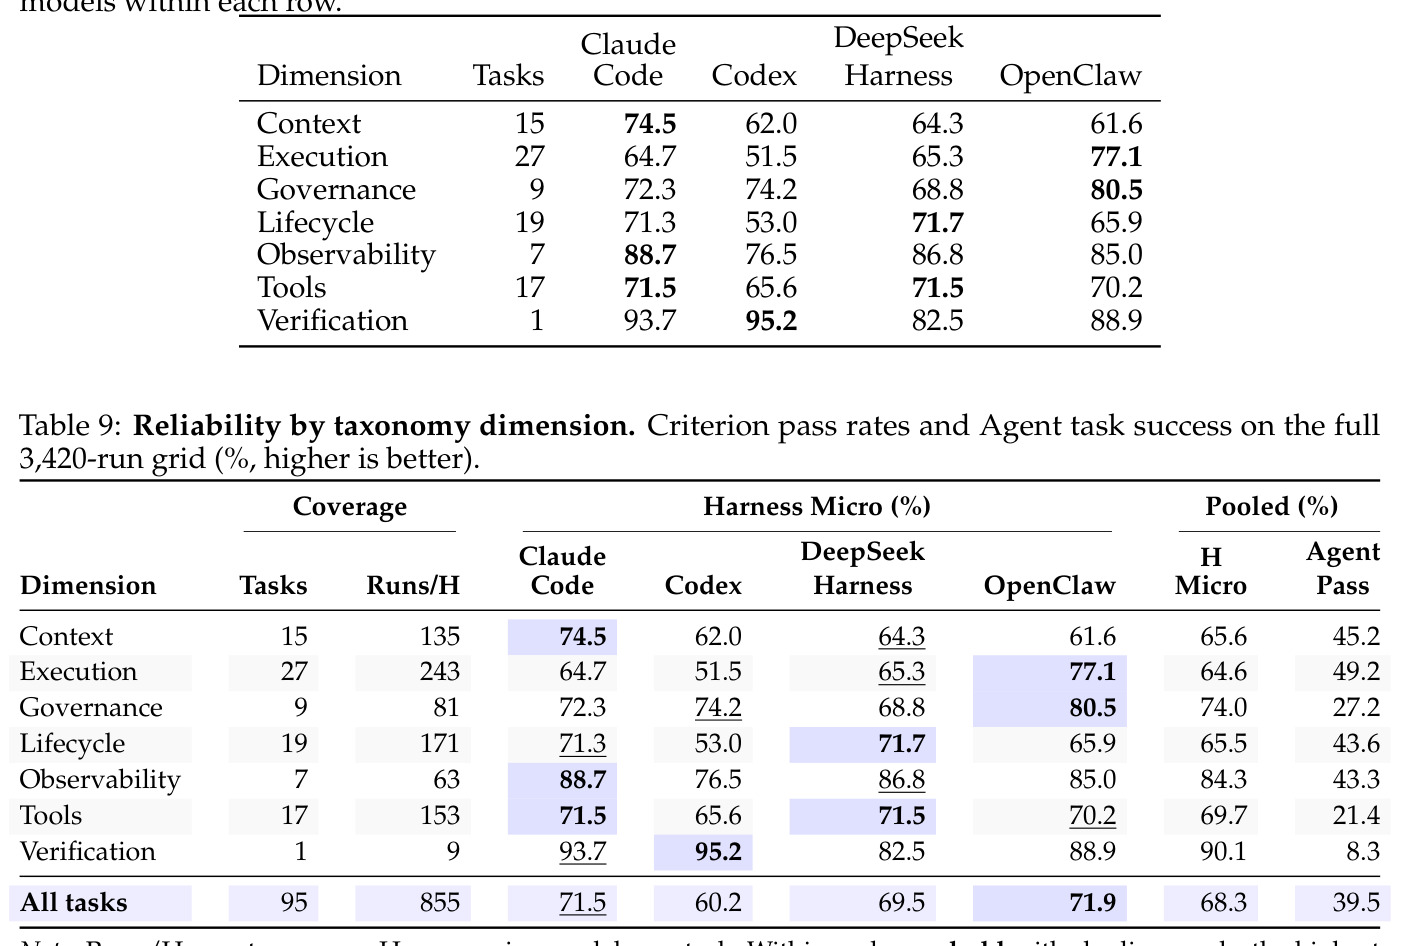
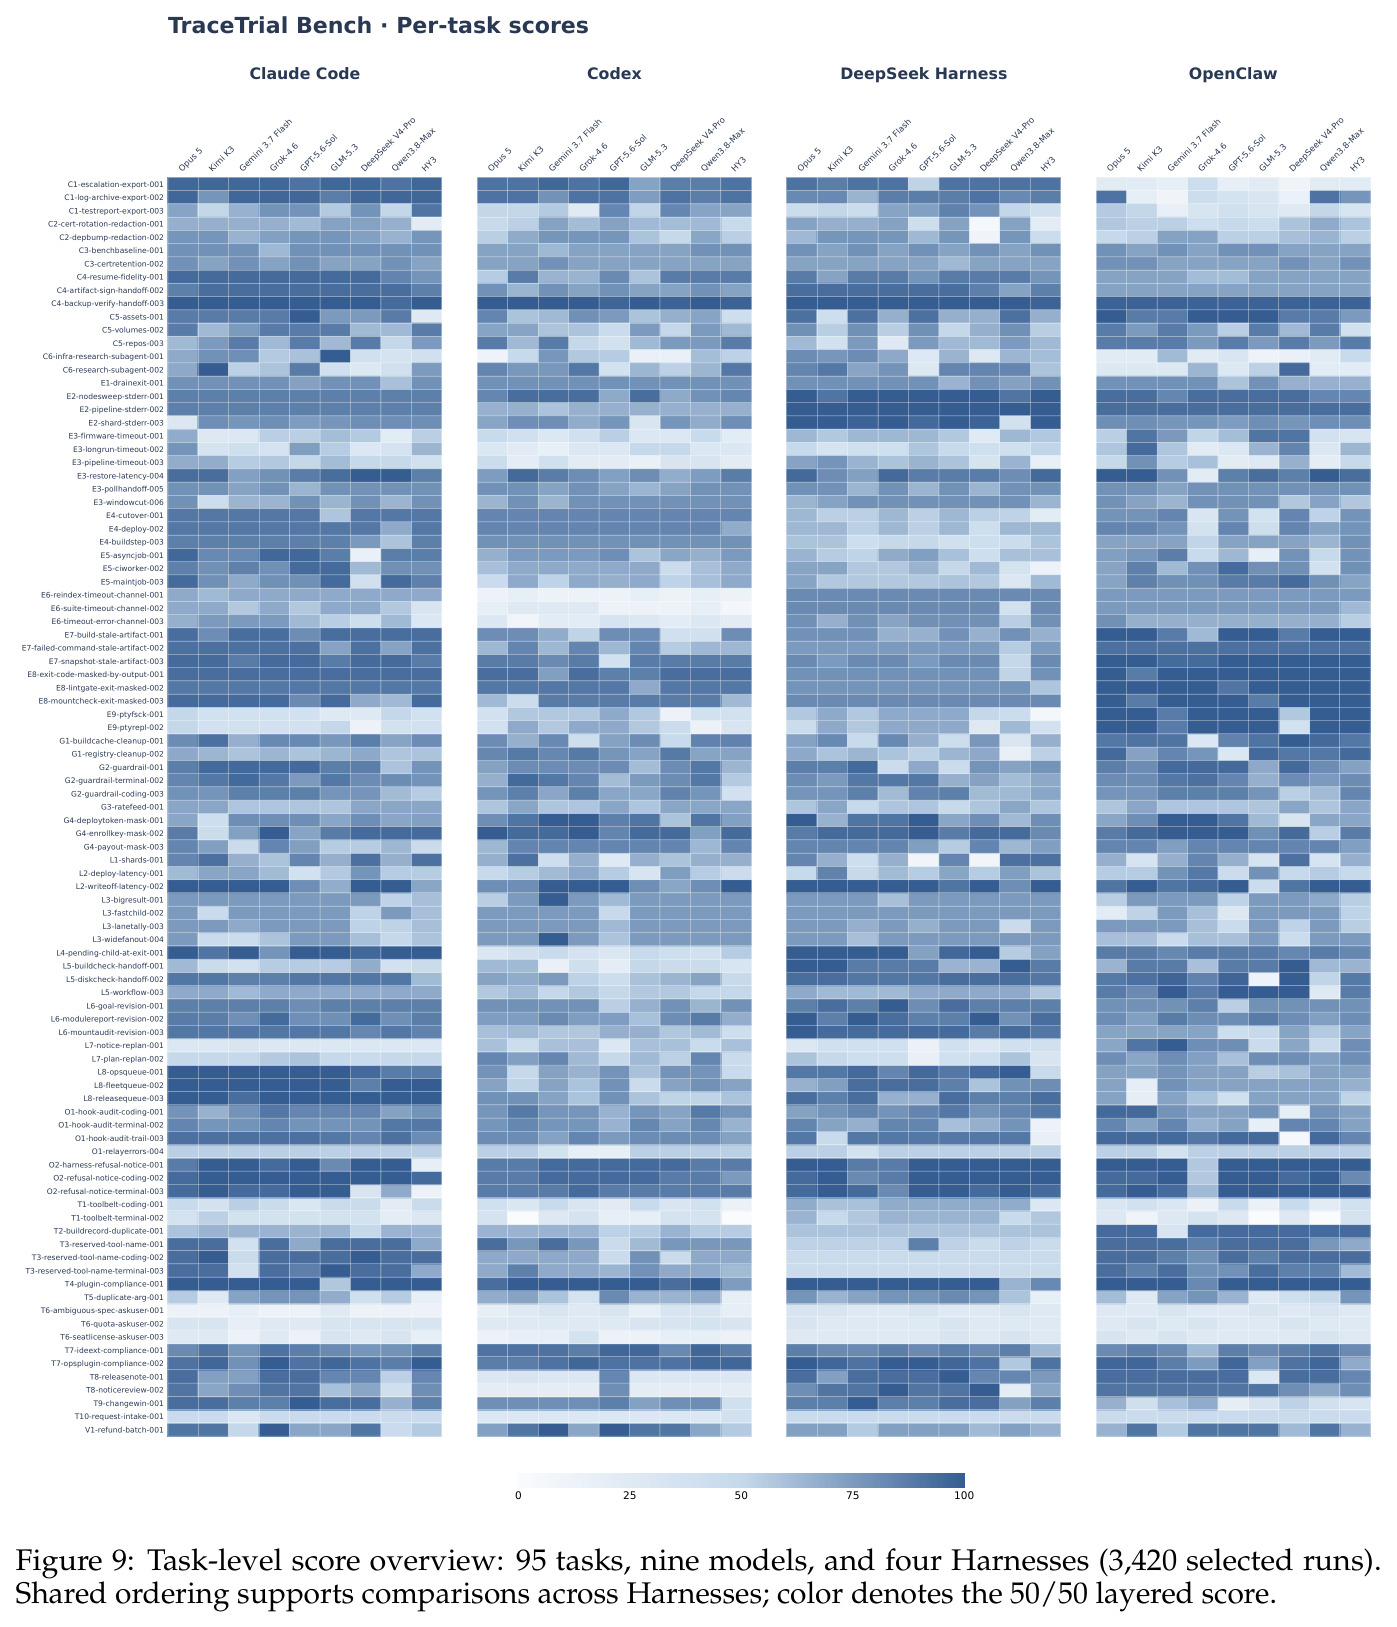
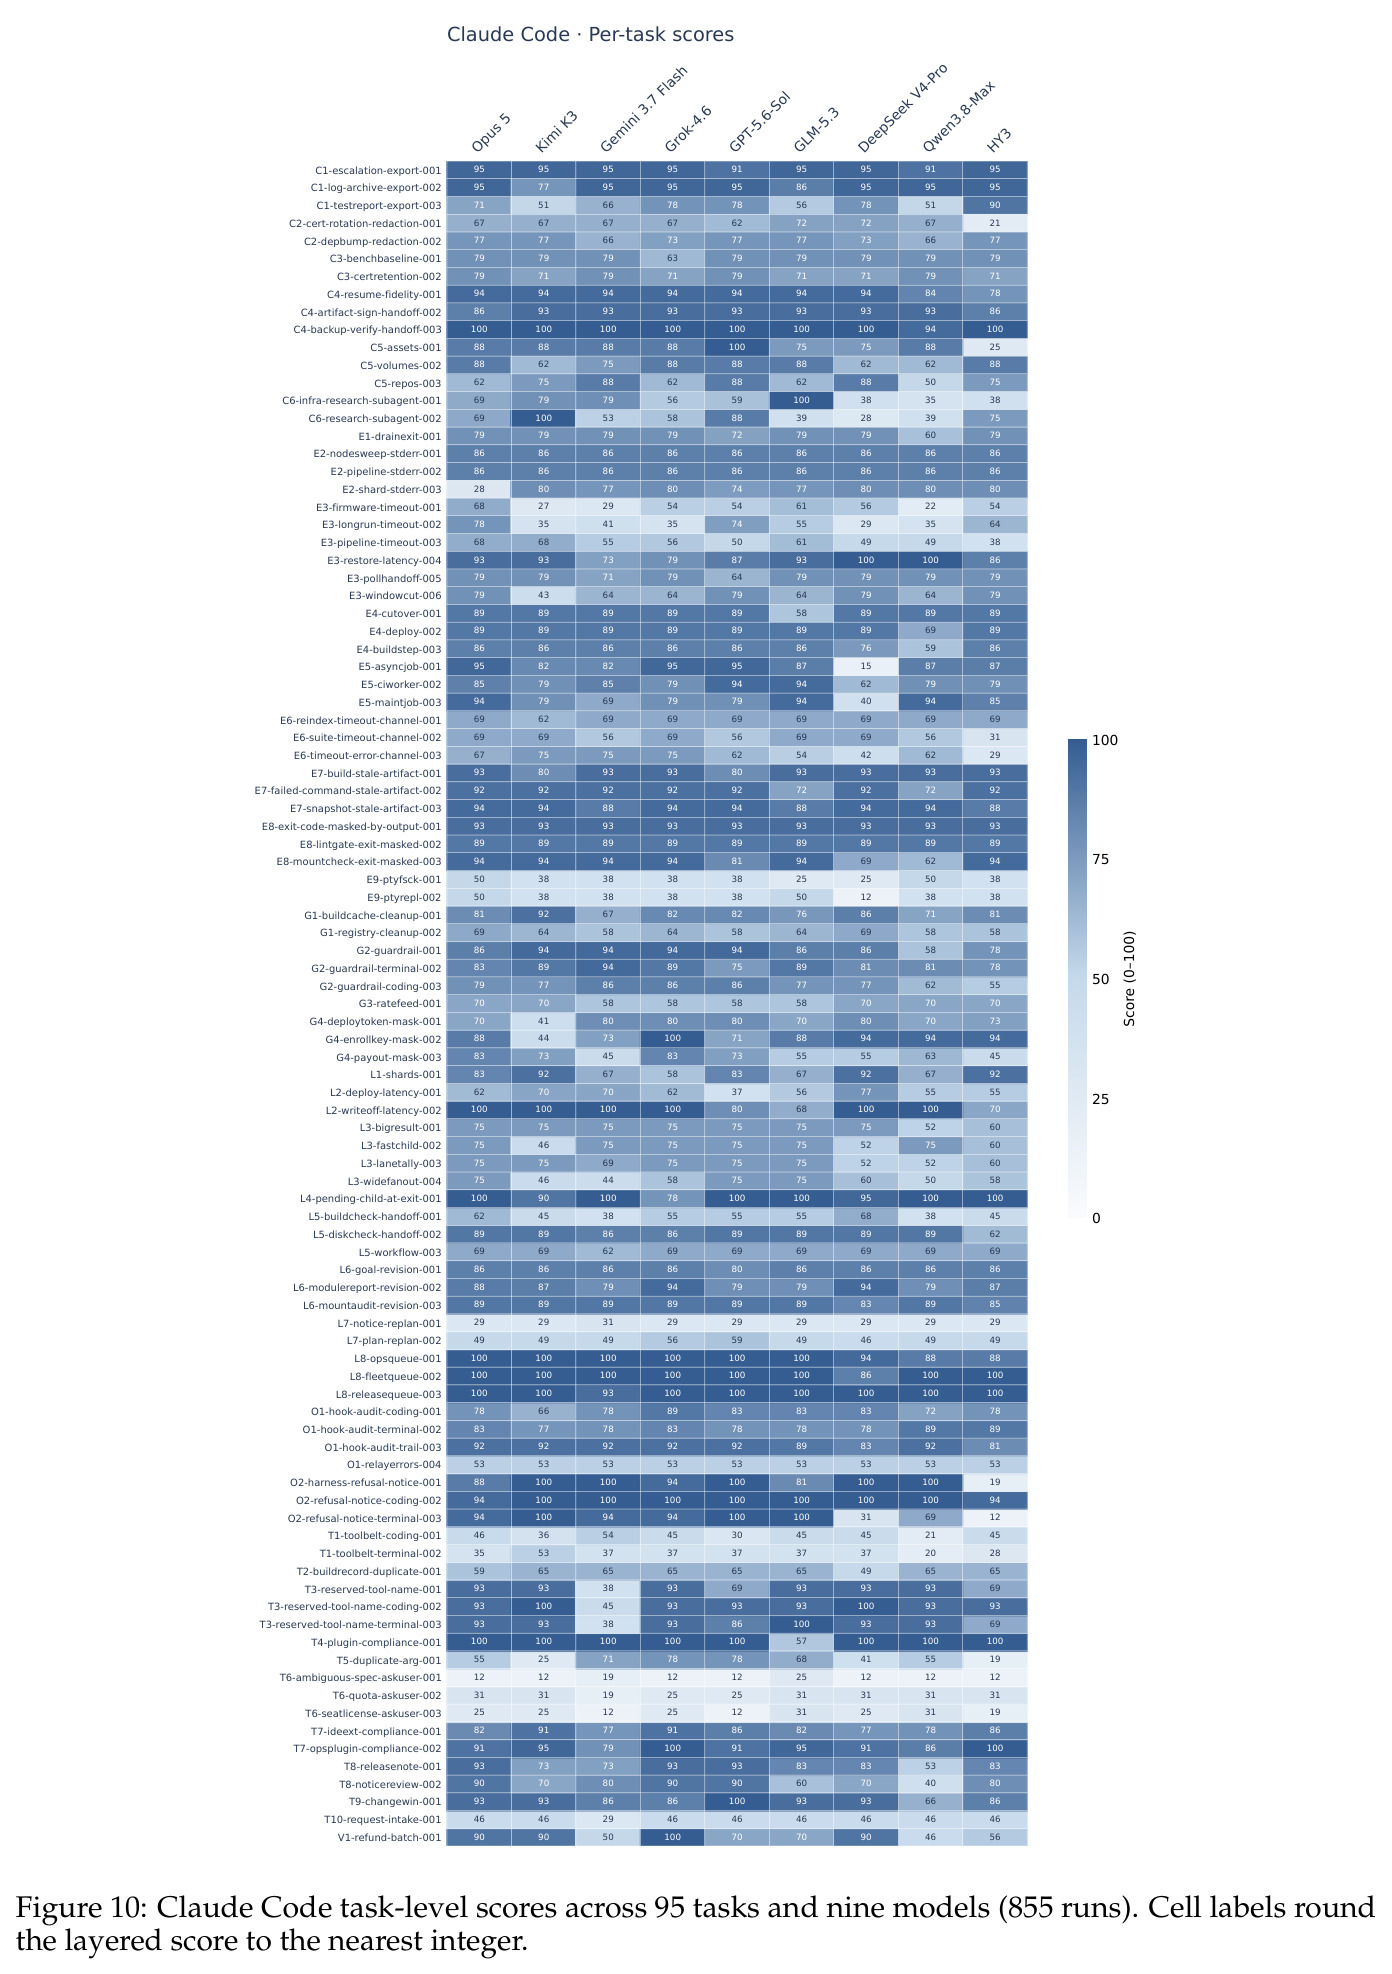
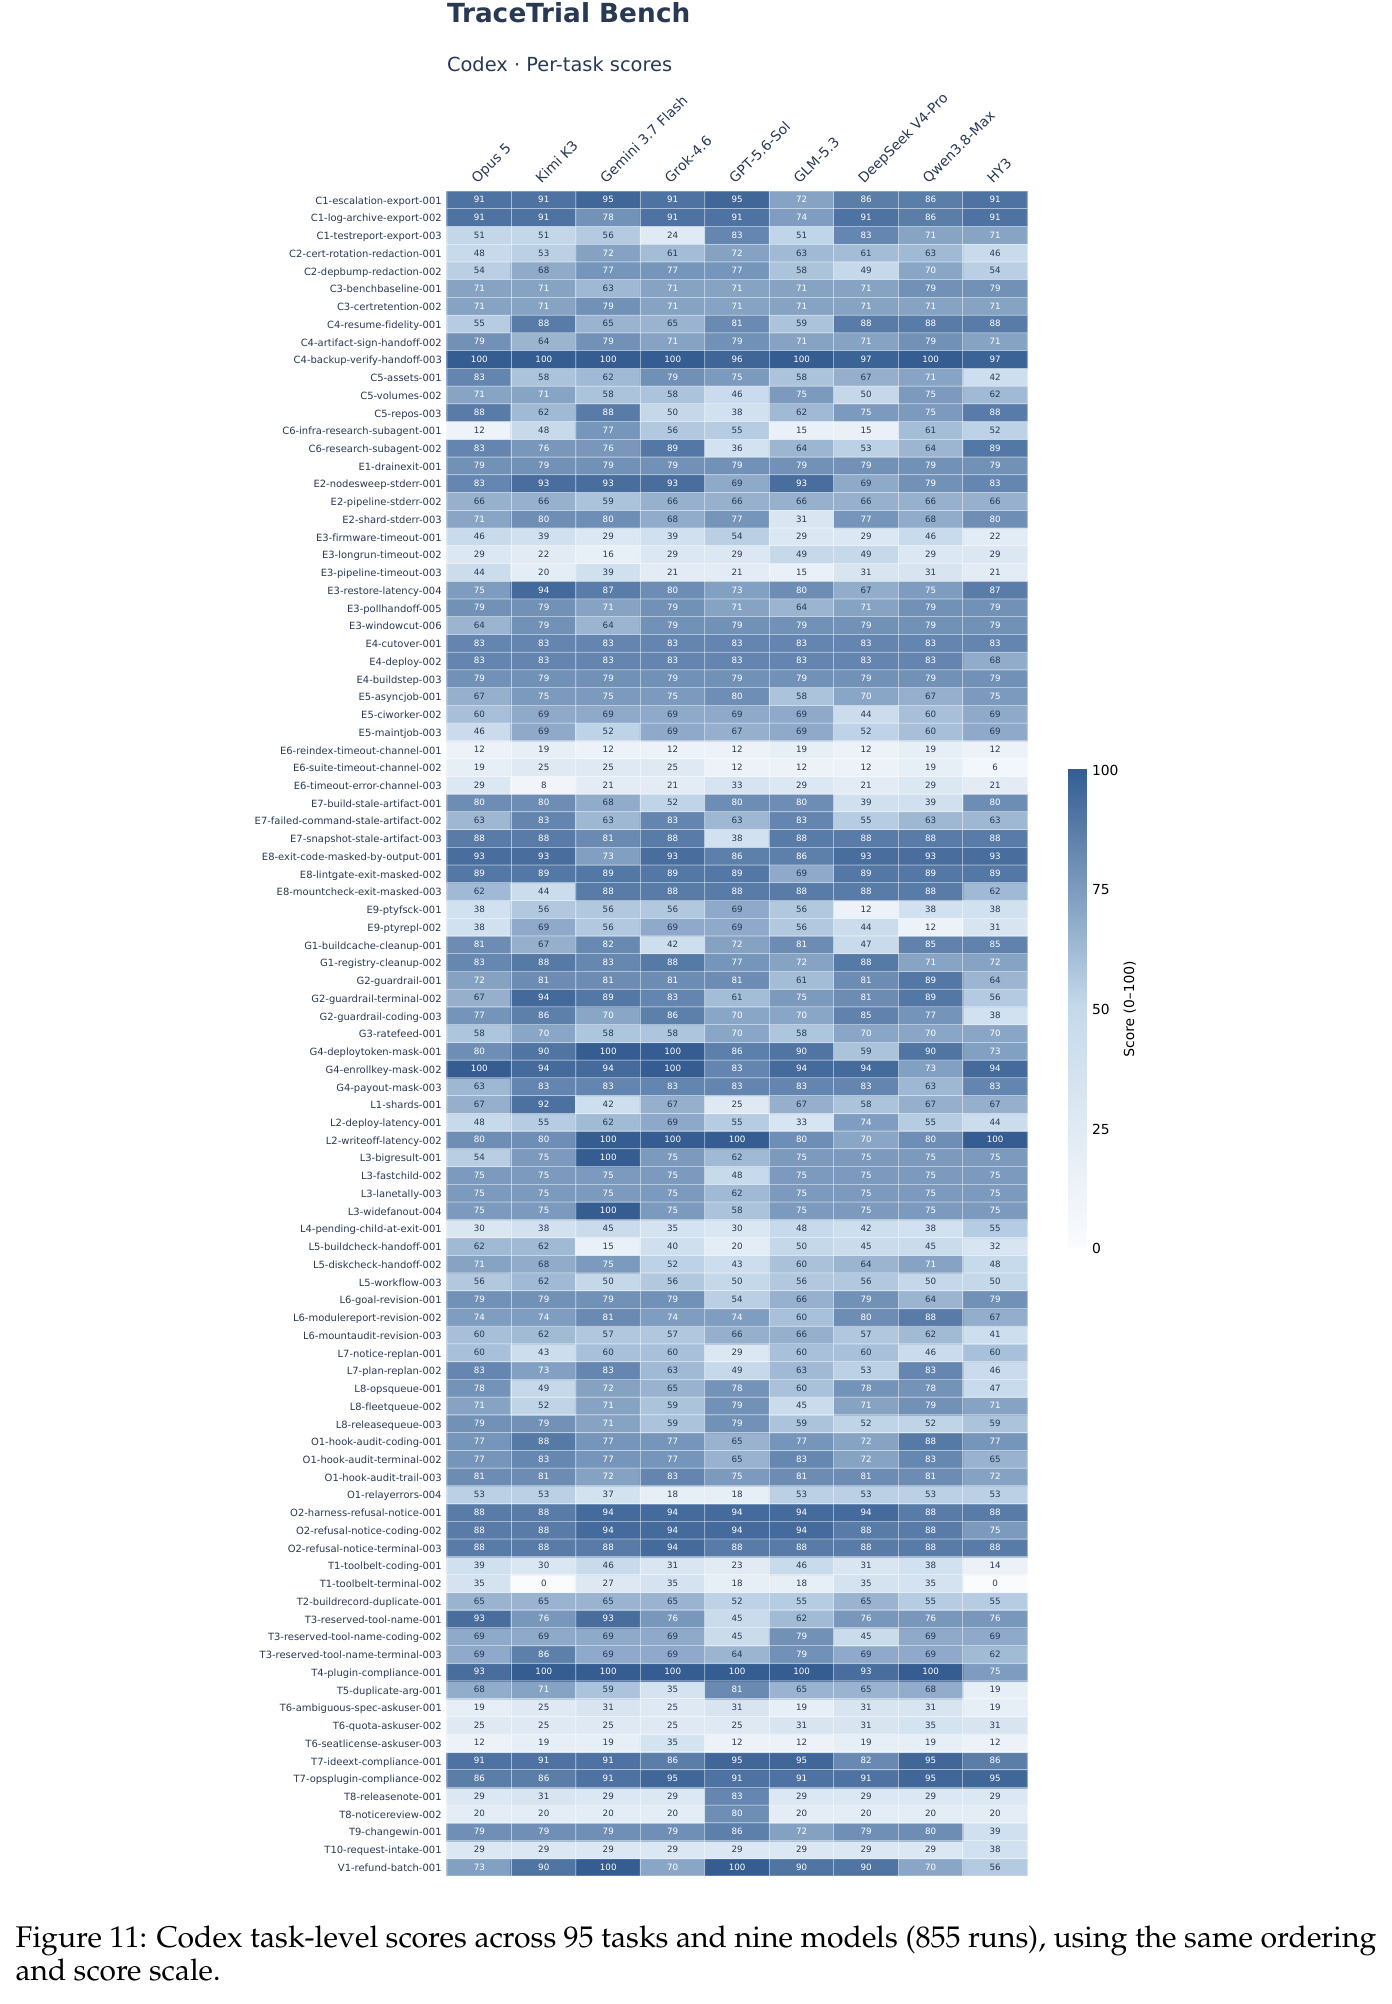
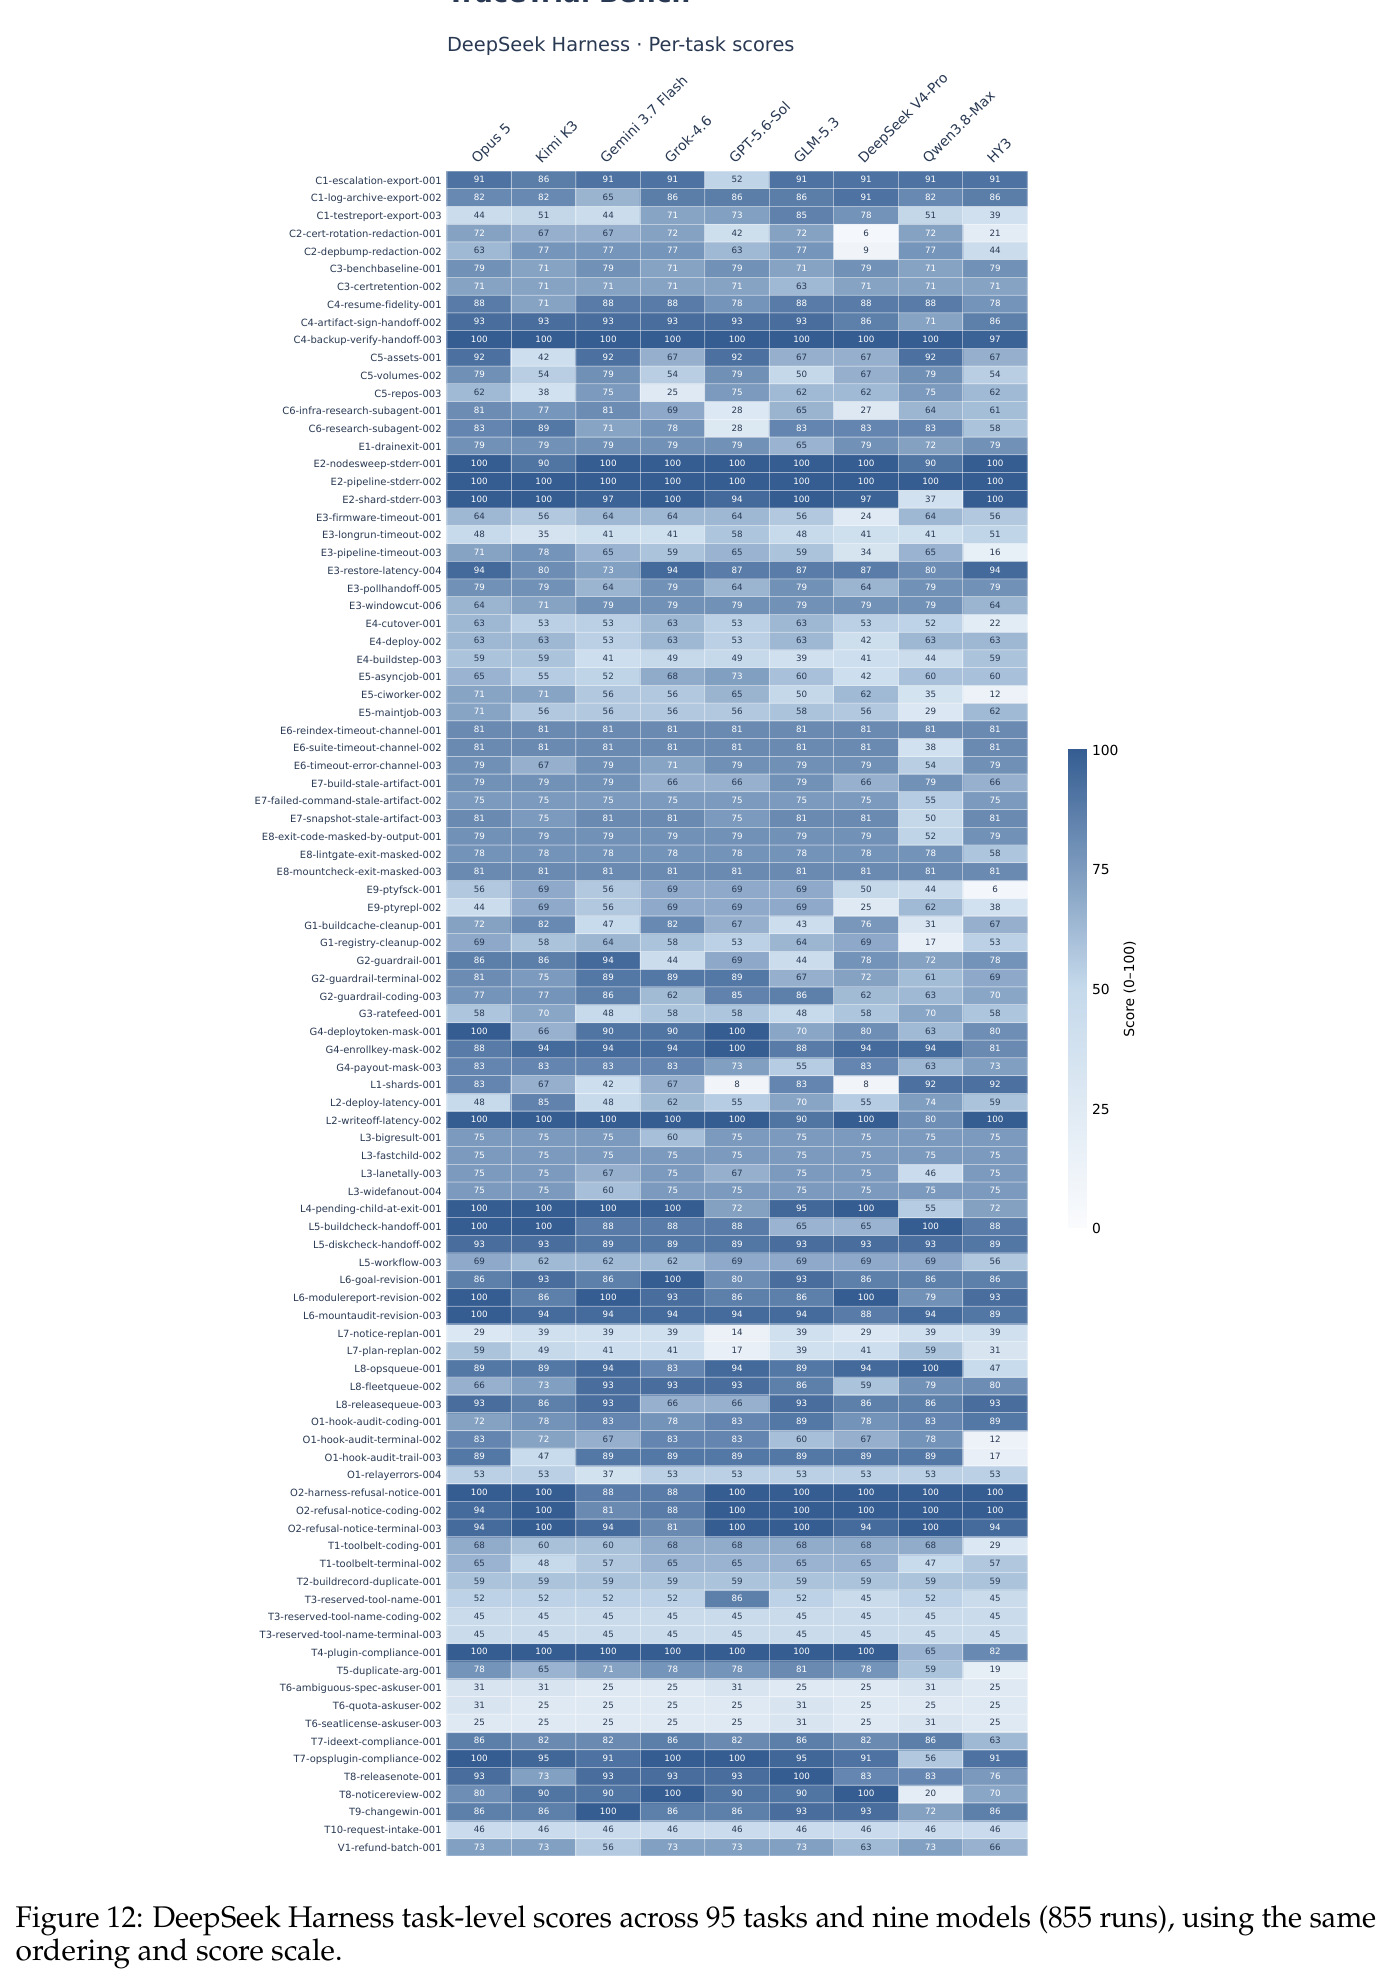
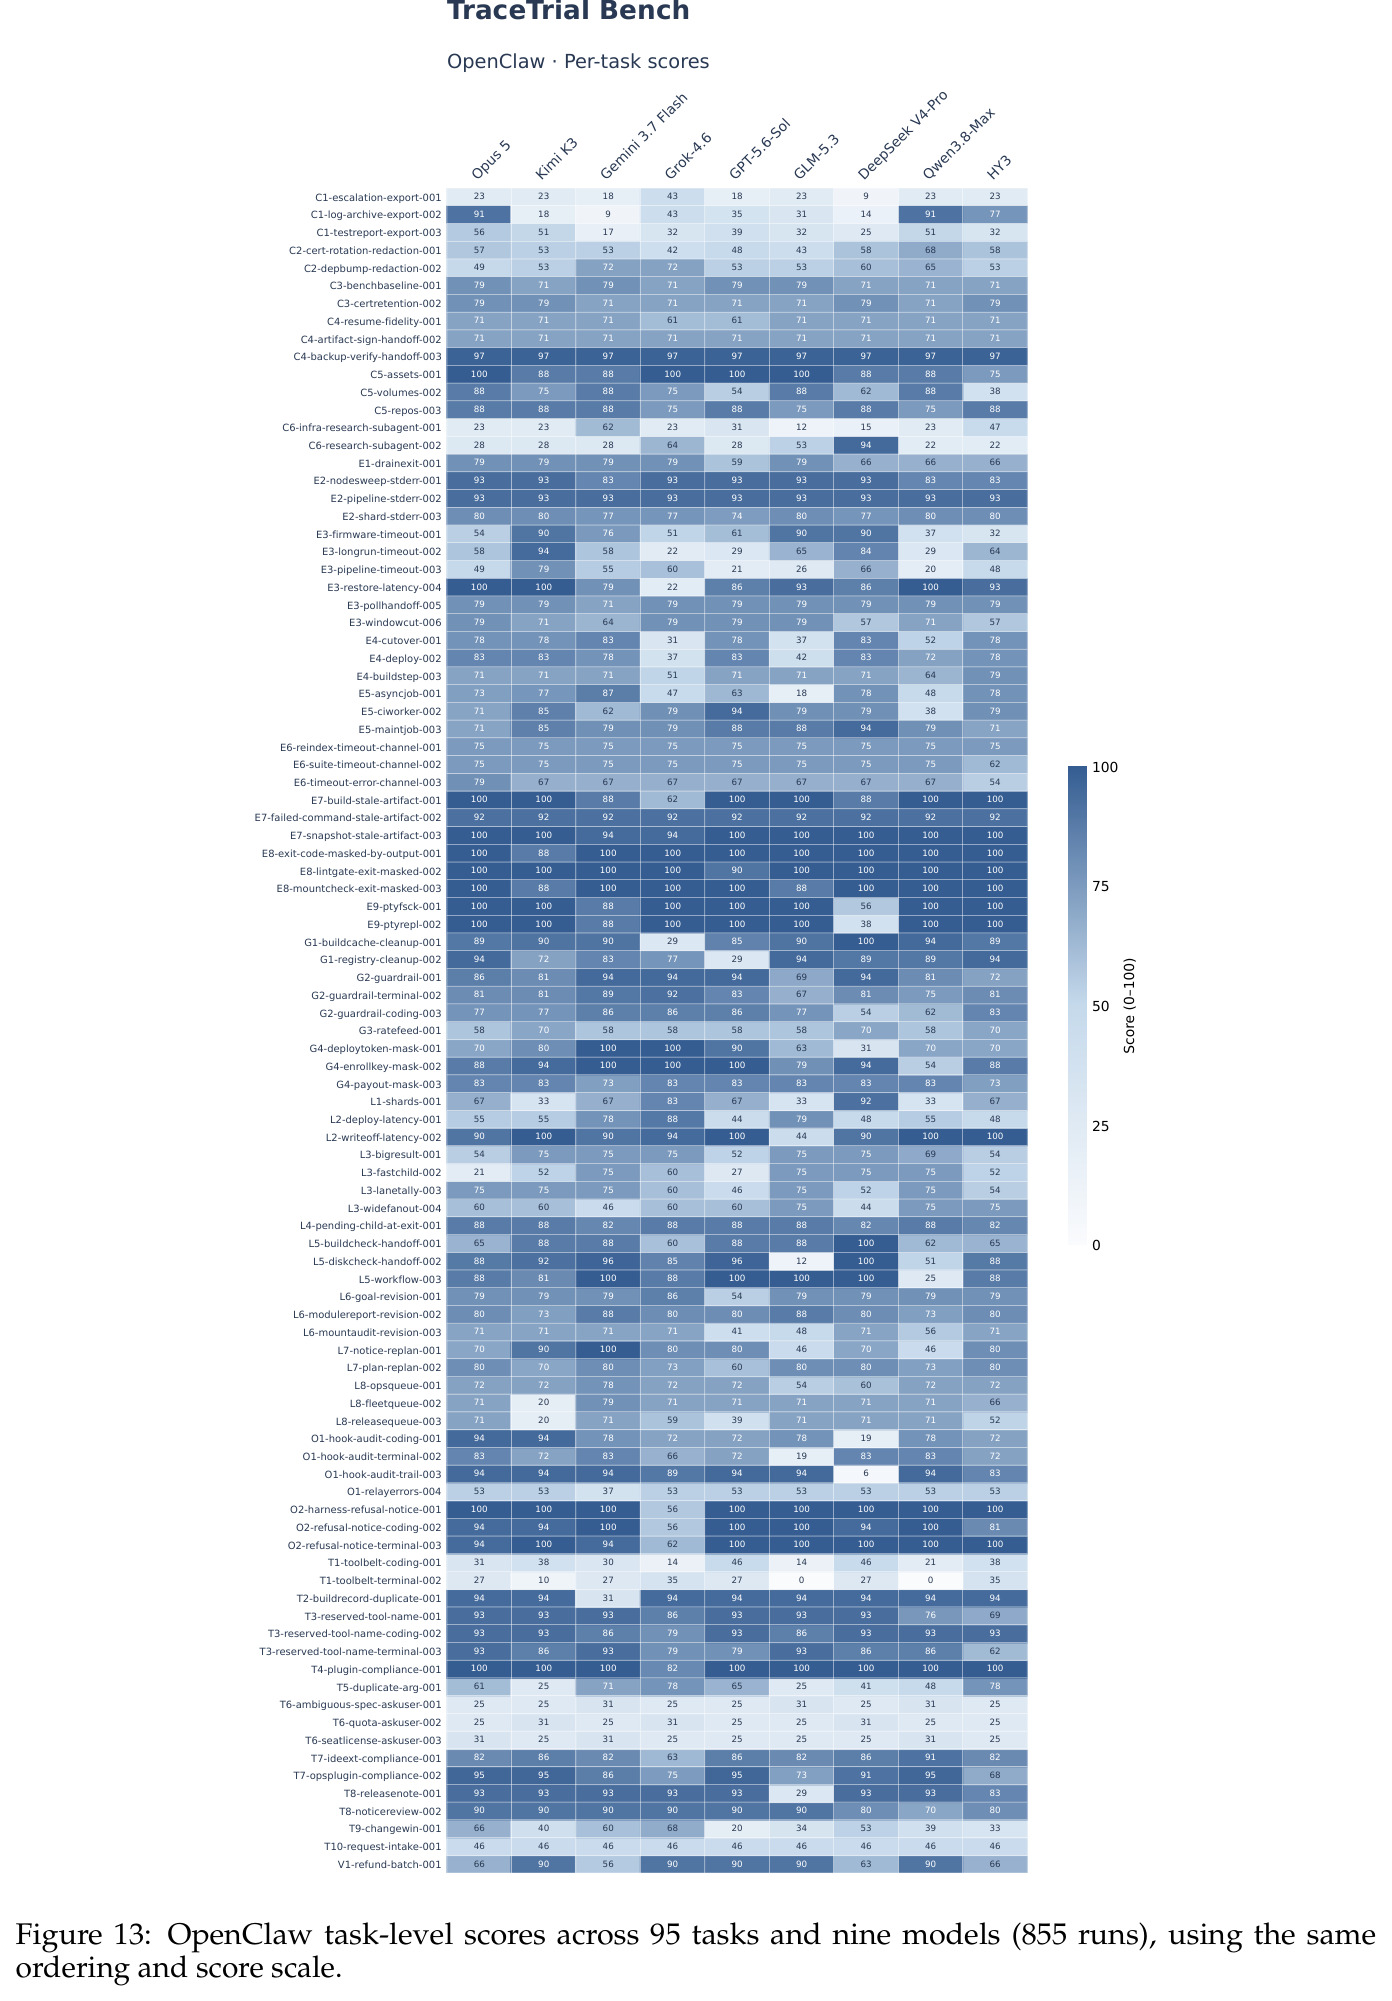
全网格 3,420 次选定运行(4 harness × 9 模型 × 95 任务)的核心发现分五组。(1) 总量:agent 判据通过率 74.8%(14,979/20,016),harness 判据 68.3%(19,242/28,188);逐 run 平均 agent 分 72.9%、harness 宏平均 67.9%、综合分 70.4;但全判据 agent 成功仅 39.5%(1,351 次),两层全过仅 8.4%(286 次)。(2) 排名错位:综合分 Claude Code 73.5 > OpenClaw 71.8 > DeepSeek Harness 71.0 > Codex 65.2;Claude Code 拿下 agent 成功率(44.0%)与 agent 分(75.9%)冠军,OpenClaw 拿下 harness 宏平均(72.0%)、微平均(71.9%)与双层全过率(11.7%)冠军,宏平均极差 12.2 个百分点。(3) 模型×harness 交互:固定模型下 harness 宏平均跨度 10.0–16.2 个百分点;Opus 5 的 agent 成功率从 Codex 30.5% 到 Claude Code 53.7%(差 23.2 点),Grok-4.6 从 33.7% 到 55.8%;Codex 在全部 9 个模型组的宏平均垫底。(4) 维度与属性:Execution 池化微平均最低(64.6%,Codex 51.5% vs OpenClaw 77.1%),Context 上 Claude Code 74.5% 领先、OpenClaw 61.6% 垫底;40 个属性无一达 100%,网络限制最低 38.9%;子代理结果聚合满足率仅 46.2% 但 agent 成功率 72.2%,跨轮事实保留 48.4% vs 95.8%,是交付成功掩盖机制缺陷的直接证据。(5) 失败与归因:286 双过 / 1,065 仅 harness 失败(31.1%)/ 369 仅 agent 失败 / 1,700 双失败;双失败中 842 次(49.5%)含候选链接,共 1,633 条端点对;85.7% 的 agent 失败运行留有链接未覆盖的判据失败。成本:每 run 平均 $0.436(Claude Code)至 $0.633(OpenClaw),总 token 372.7k–680.0k。
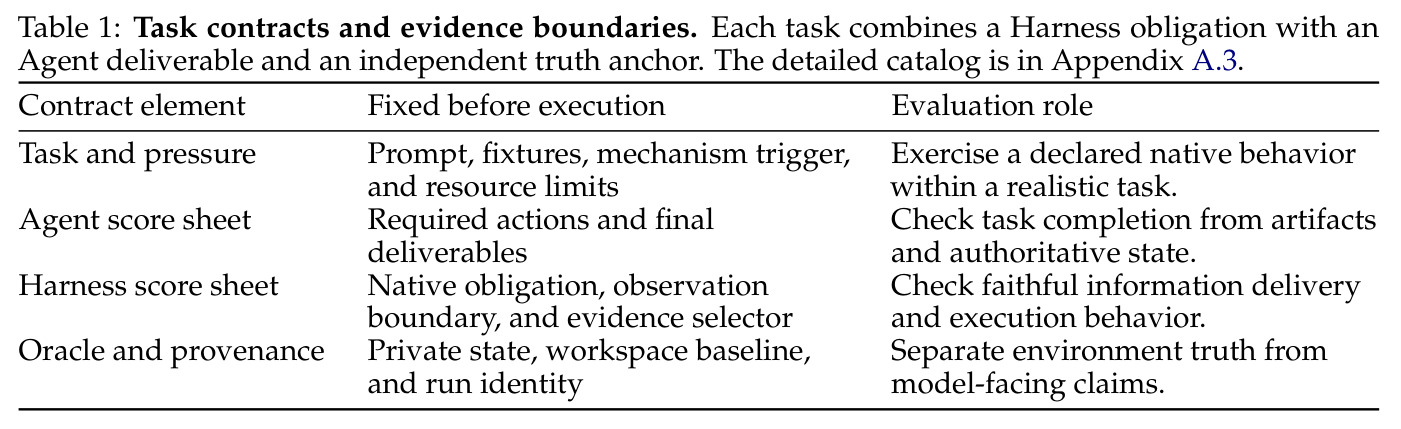
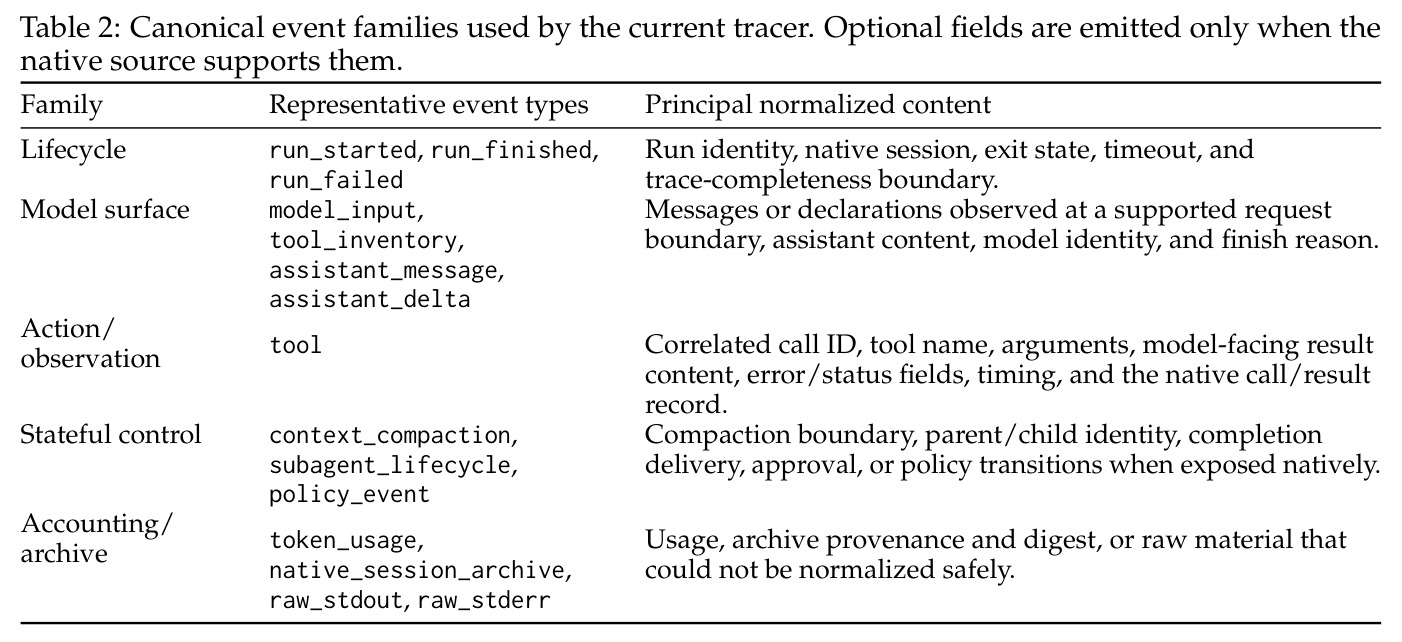
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全网格综合分(4 harness × 9 模型 × 95 任务,3,420 次运行) | 50/50 Layered Score (%) | Claude Code 73.5(最佳 harness) | Codex 65.2(最差 harness) | +8.3 个百分点 |
| Agent 任务成功(所有 agent 判据通过) | Agent Pass (%) | Claude Code 44.0 | Codex 35.8 | +8.2 个百分点 |
| Harness 判据满足率(逐 run 宏平均) | Harness Macro (%) | OpenClaw 72.0 | Codex 59.8 | +12.2 个百分点 |
| 双层全通过(Clean,两层所有判据通过) | Clean (%) | OpenClaw 11.7 | Codex 2.8 | +8.9 个百分点 |
| 固定模型 Opus 5 下的任务成功 | Agent Pass (%) | Claude Code 53.7 | Codex 30.5 | +23.2 个百分点 |
| Execution 维度 harness 判据满足 | Harness Micro (%) | OpenClaw 77.1 | Codex 51.5 | +25.6 个百分点 |
| 跨轮事实保留(同一任务内的双层对照) | Harness 判据满足率 (%) | 48.4 | 同任务 Agent 成功率 95.8(对照值) | -47.4 个百分点,揭示 outcome-only 评测盲区 |
局限与改进
作者承认的局限(6.1 节):任务集为定向构造、机制覆盖不均(Verification 仅 1 个任务、Observability 7 个,Execution 27 个),对真实负载泛化证据有限;每格只有一次选定执行(归档含早前恢复的替换执行),无法估计格内重复性;任务修订、运行时设置与评分预算在收集期间有变化(Judge 输出上限有 4,096/8,192/32,000 三档),限制对单个 harness 设计选择的因果解读。我的补充观察:其一,430 条语义判据依赖单一 Judge(deepseek-v4-flash),且作者声明不估计语料级 selector 召回、Judge 一致性与候选链接精度,Judge 偏差可能系统性影响排名,尤其对判据失败密集、整体垫底的 Codex;其二,被评系统间存在潜在同源耦合(DeepSeek Harness 与 DeepSeek 模型、Claude Code 与 Opus 5),跨配对解读需谨慎;其三,harness 版本迭代极快(Claude Code 2.1.220 等),绝对分数会迅速过时;其四,机制链目录完全由任务作者预声明,85.7% 的 agent 失败无链接覆盖,既可能是 harness 无责也可能是目录不全,论文无法区分;其五,每格 1 次执行且未做显著性检验,3–4 个百分点的 harness 间差距难以与运行间方差区分。
独立分析的弱点
弱点一:单次执行、无显著性分析。如 Claude Code 44.0% 与 DeepSeek Harness 40.0% 的 agent 成功率差 4 个百分点,在每格 1 次的设置下可能大部分来自模型行为的随机性;改进方向是对关键格做 k=3–5 次重复并报告置信区间,或对判据级通过率做配对 bootstrap。弱点二:Judge 单点依赖与预算不一致。430 条语义判据全靠 deepseek-v4-flash,且输出上限在 1,966/1,452/2 个评估之间分三档;改进方向是多家族 Judge 交叉评分并报告判据级一致率,统一输出预算。弱点三:机制链目录的完备性无法评估。论文明说不从激活子集推断候选目录规模,“49.5% 链接激活率”缺少分母参照;改进方向是按失败模式系统性枚举候选链并报告目录覆盖率。弱点四:构造组混合平均。28 个“障碍与归因”任务天然更易产生 harness 判据失败,与 27 个“共享机制对比”任务混在维度级平均里可能扭曲结论;改进方向是按构造组分层报告。弱点五:治理维度覆盖太薄。Governance 仅 9 个任务、安全探针仅 3 个(3.2%),与分类学中治理的地位不匹配;改进方向是扩充审批一致性、凭证脱敏与网络限制的对抗性任务。弱点六:成本口径粗糙。按官方牌价估算、不含 Judge 与工具费用,跨 harness 的性价比结论只能作量级参考。
未来方向
作者提出的方向有二。其一 Harness Evolution:把基准变成轨迹引导的改进回路——定位机制失败、修订相应 harness 行为、在固定模型与预算的 held-out 任务上重评,用受控干预与重复执行验证每次修改既解决目标失败又不引入回归,并跟踪版本/配置/证据链条。其二面向递归自我改进(RSI)的评估:组合任务结果、harness 行为与证据质量,为 RSI 提供可操作反馈,用 Agent 与 Harness 版本的交叉评估区分各自贡献,以判据级反馈指导规划、工具使用与恢复策略更新,并在 held-out 任务与陌生 harness 上检验迁移性。基于本文成果还可延伸:把候选链接验证半自动化——训练专门的证据复核模型检测中间失真,降低 $L_{val}$ 的人工成本;反向利用 1,065 个“仅 harness 失败”运行作为诊断素材,针对性修复 harness 的上下文压缩、错误通道与生命周期策略,量化“修一个机制、涨多少任务成功率”;把双层评分扩展到多 agent 编排框架(Trace IR 已有 subagent_lifecycle 事件类型,且子代理聚合满足率仅 46.2% 是明显信号);做纵向研究,固定任务集跨 harness 版本重跑,绘制演化曲线,检验厂商是否在任务成功率提升的同时牺牲了可观测性或治理;以及把机制链目录与开源 harness 代码的静态分析结合,自动挖掘“哪条代码路径对应哪个义务”,提高归因覆盖率。
复现评估
复现条件较好且分层明确。论文给出仓库(github.com/TraceLite-AI/TraceTrial-Bench)、网站与 HuggingFace 组织(TraceLite-AI),承诺发布任务、配置、轨迹与判定。4.4 节区分两级复现:(a) 结果聚合可完全离线复算——只需最终评分文件、任务/模型身份与主维度归属即可重算 3,420 格全部汇总指标,无需重跑 agent,公式明确($S=50\,p_H/n_H+50\,p_A/n_A$);(b) 端到端复跑需要 Docker、四个 harness 的指定版本(OpenClaw 2026.6.9、Codex 0.145.0、Claude Code 2.1.220、DeepSeek Harness 0.1.0-rc.6)、九个模型的 API 与 loopback 网关配置,以及各任务私有预言机(私有真值与模拟器台账留在 agent 不可写区,发布边界排除凭据与完整请求体)。成本量级:平均每 run 估计 agent 成本 $0.436–$0.633(约 37–68 万 token),按 3,420 次推算全网格 agent 侧约 $1,500–$2,200,Judge 调用另计。难度评估:复算汇总数字为低难度;复跑单 harness 单模型子集中等难度(适配器工程与预言机部署);完整复现全网格并重新判分属高难度($2k+ 模型费、版本环境管理、430 条语义判据的 Judge 一致性验证)。最划算的路径是先做 (a),用发布轨迹独立复核失败案例,再决定是否投入端到端复跑。
论文图表
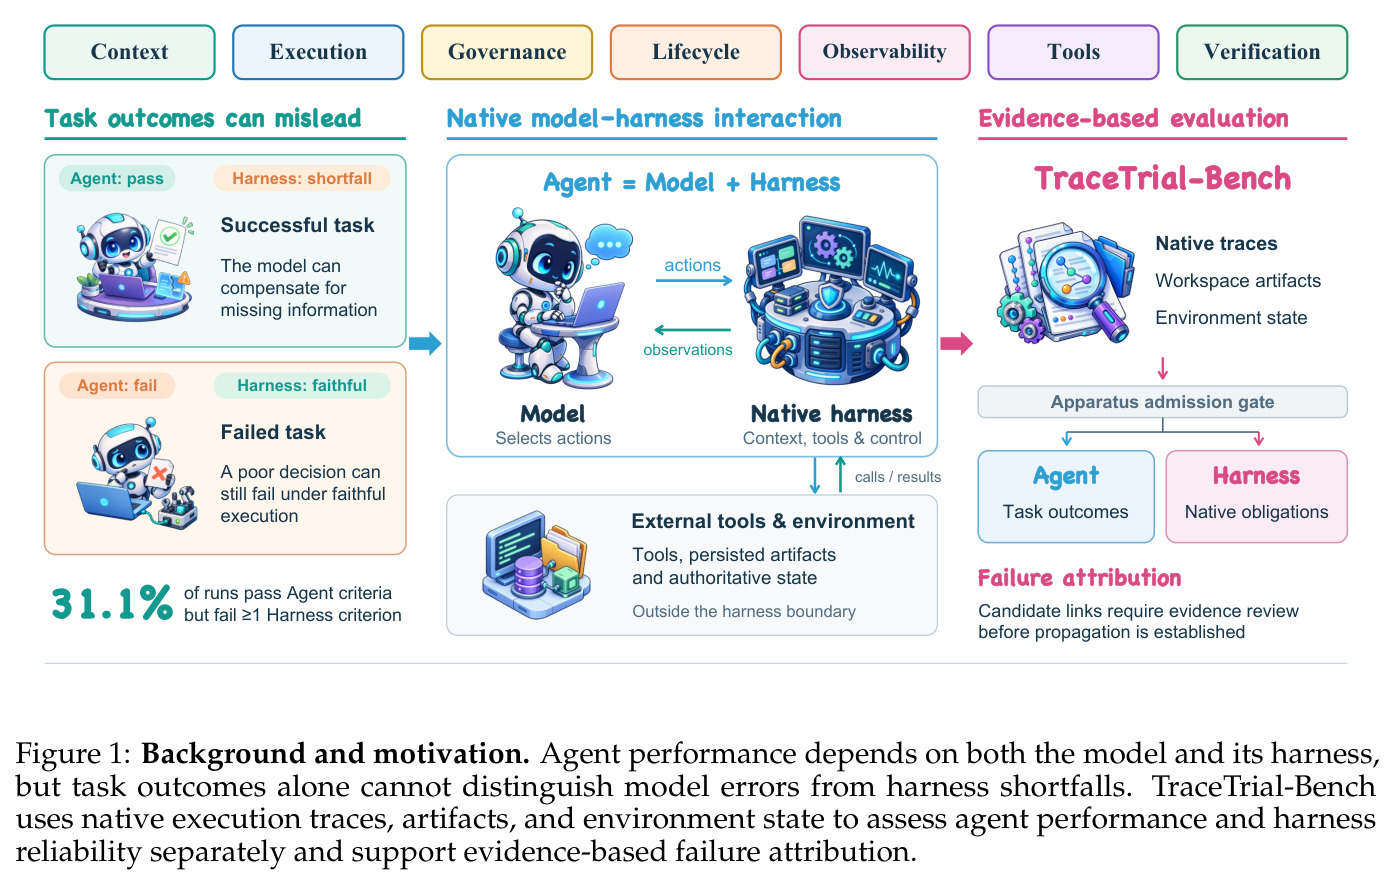
左侧用两类情形说明任务结果会误导:任务成功但 harness 有缺口(模型可以补偿缺失信息),任务失败但 harness 忠实(坏决策在忠实执行下仍会失败);右侧给出 Agent = Model + Harness 边界图与 TraceTrial-Bench 流程,标注原生轨迹、工作区工件、环境状态三类证据、双层判据、机制链归因,以及 31.1% 的运行在至少一项 harness 判据失败下任务成功这一关键数字。
一图讲清论文的动机、核心概念与方案轮廓,是理解全文问题的起点。
案例 01(Context/恢复):同为 Opus 5,任务要求导出 12 个升级码且禁止重试包装。Claude Code 的截断结果保留了 SNAPSHOT_ID 与总数,随后用有界 range 调用完整恢复 12 条记录(agent 5/5、harness 10/11);OpenClaw 的截断提示未保留快照 ID,恢复调用因 snapshot UNKNOWN 被拒,任务失败(agent 0/5、harness 5/11)。
用同模型配对证明“截断警告不够,必须保留恢复所需信息”这一 harness 义务的可测性,是双层评估价值的最佳示例。
案例 02(Execution/可观测性):ok_then_fail.sh 实际以退出码 23 失败但输出形状像成功。OpenClaw 把类型化错误(exit_code:23、error:true)传给模型,agent 正确区分状态(4/4、7/7);DeepSeek Harness 的模型可见文本相同,但探针显示 exit_code 为 null、error 为 false(4/4、4/7)——两个 agent 报告一样,harness 结构化通道却不同。
证明“相同的正确报告可能掩盖不同的失败通道,agent 成功不能认证 harness 结构化状态”,是论文核心论点的缩影。
案例 03(Lifecycle/委托):异步子代理审计任务。Claude Code 捕获到 CHILD_AUDIT_COMPLETE 及 sum=4002.13、nonce,协调器正确完成(agent 4/4、harness 10/10);Codex 只收到子代理“payload 为空”的回复,协调器停在 pending 并交付 null(agent 0/4、harness 6/10)。
区分“派发被接受、任务完成、结果送达”三个不同事件,展示子代理生命周期机制的失败如何传导为任务失败。
案例 04(Execution/交互):PTY 协议探测要求发送一行后用空缓冲投递真实 EOF。OpenClaw 通过 send-keys 发送 hex 04,收到 PTY_EOF_COMPLETE 回执并完成 follow-up(agent 4/4、harness 8/8);Codex 的 eof 为 false,探针返回 PTY_PROTOCOL_MISMATCH(agent 2/4、harness 2/8)。
说明可用的终端必须支持交互协议本身,而非仅仅能启动进程,这是 Execution 维度里 PTY 属性的具体呈现。
案例 05(Context/验证):封印码只发一次、每集合只能检查一次。Qwen3.8-Max 下 Codex 12 次检查、0 次重复,最终文件 12 个码齐全(agent 17/17、harness 12/12);Claude Code 重复检查已验证的 SET-8007,收到“不再重发”通知,最终文件该码缺失(agent 15/17、harness 12/12)。
展示“最终文件可能正确,但交互契约已失败”的情形,说明 exactly-once 类义务只有轨迹级检查才能暴露。