该选哪档推理努力?LLM Agent 推理努力的经济学 What Effort Level Should I Choose? On the Economics of Reasoning Effort in LLM Agents
推理努力是信任品:最高档更贵且不保证更好,逐题梯度升级更划算
前置知识
推理努力
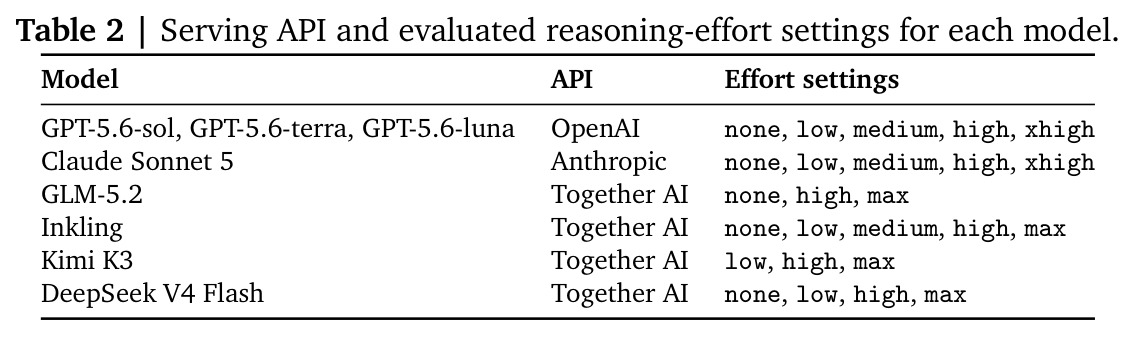
推理模型(如 GPT-5.6、Claude Sonnet 5)暴露给用户的推理计算档位参数,通常分为 None、low、medium、high、xhigh、max 等有序等级。它在不更换底层模型的前提下缩放测试时计算:升档意味着单次调用内生成更多推理 token,在 Agent 场景下还会改变规划与工具调用行为。各厂商实现机制差异很大:gpt-oss 靠系统提示关键词、Qwen3 靠中断思考、DeepSeek-V4 蒸馏不同长度惩罚的专家模型、Inkling 在 RL 阶段以连续 effort 值加每 token 成本条件化。
整篇论文就是在审计这个旋钮的真实边际价值,理解它是「有序档位」这一直觉假设是理解全文反转结论的前提。
信任品(credence good)
来自经济学的概念:一类商品或服务,买方即使在消费之后也难以评估其质量或自己真正需要的数量,典型例子是医疗服务和汽车维修。论文用它类比推理努力:一次成功运行只证明任务被解决了,却不证明所购买的高档推理是必要的,而重跑一个更低档位去验证的成本往往得不偿失,因此用户始终在为无法观测其贡献的计算付费。
这是论文的核心理论框架,作者由此推出「推理收费应可验证」的政策主张,也是标题问题的经济学答案。
测试时计算扩展
指在推理阶段投入更多计算(更长思考、多次采样、搜索验证等)来换取困难任务上更高准确率的范式。研究表明这种扩展在聚合层面常有效,厂商因此把它包装成 effort 档位出售。其隐含假设是:档位升高,性能单调不减,且 solved 集合嵌套 $s_{e_1} \subseteq s_{e_2}$。
论文正是攻击这个单调性假设:在单题层面 solved 集合并不嵌套,更高档位会弄丢低档位能解的题。
pass@k 与 mean@k
pass@k 表示 k 次独立尝试中至少成功一次即算通过,衡量模型能力上限;mean@k 是 k 次尝试的平均成功率,衡量期望表现。论文在 AIME 2026 上取 k=10、GPQA Diamond 上取 k=4,用 pass@k 判定某档位是否「解决」了一道题,用 mean@k 报告聚合性能;Agent 任务因预算限制每档只跑一次。
solved 集合 $s_e$ 的定义、回归集合 $s_{e_1}\setminus s_{e_2}$ 的计算和 always-solved 子集的构建都建立在这两个指标上。
轨迹与上下文重读成本
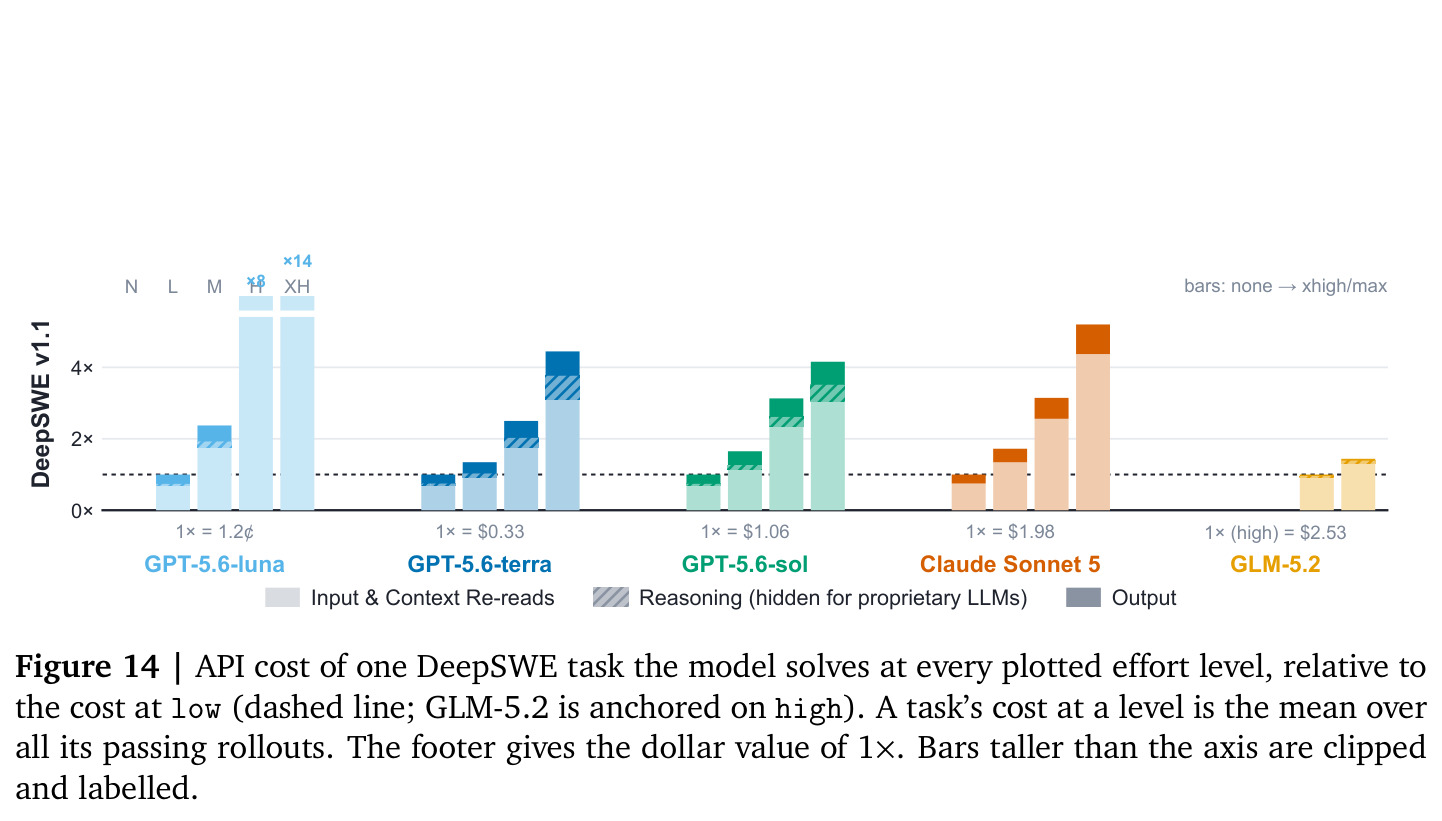
Agent 任务是多轮交互:每一步模型调用都要重新处理不断累积的交互历史,因此输入 token 消耗对轨迹长度高度敏感。论文发现调高 effort 有两条成本通道——单次调用内更多推理 token,以及更长的轨迹反复重读增长的上下文推高输入费用。供应商对输入、输出和隐藏推理 token 一并计费。
这解释了论文的意外发现:None 档不生成推理 token 却可能最贵,因为省下的推理费被更长的轨迹抵消。
研究动机
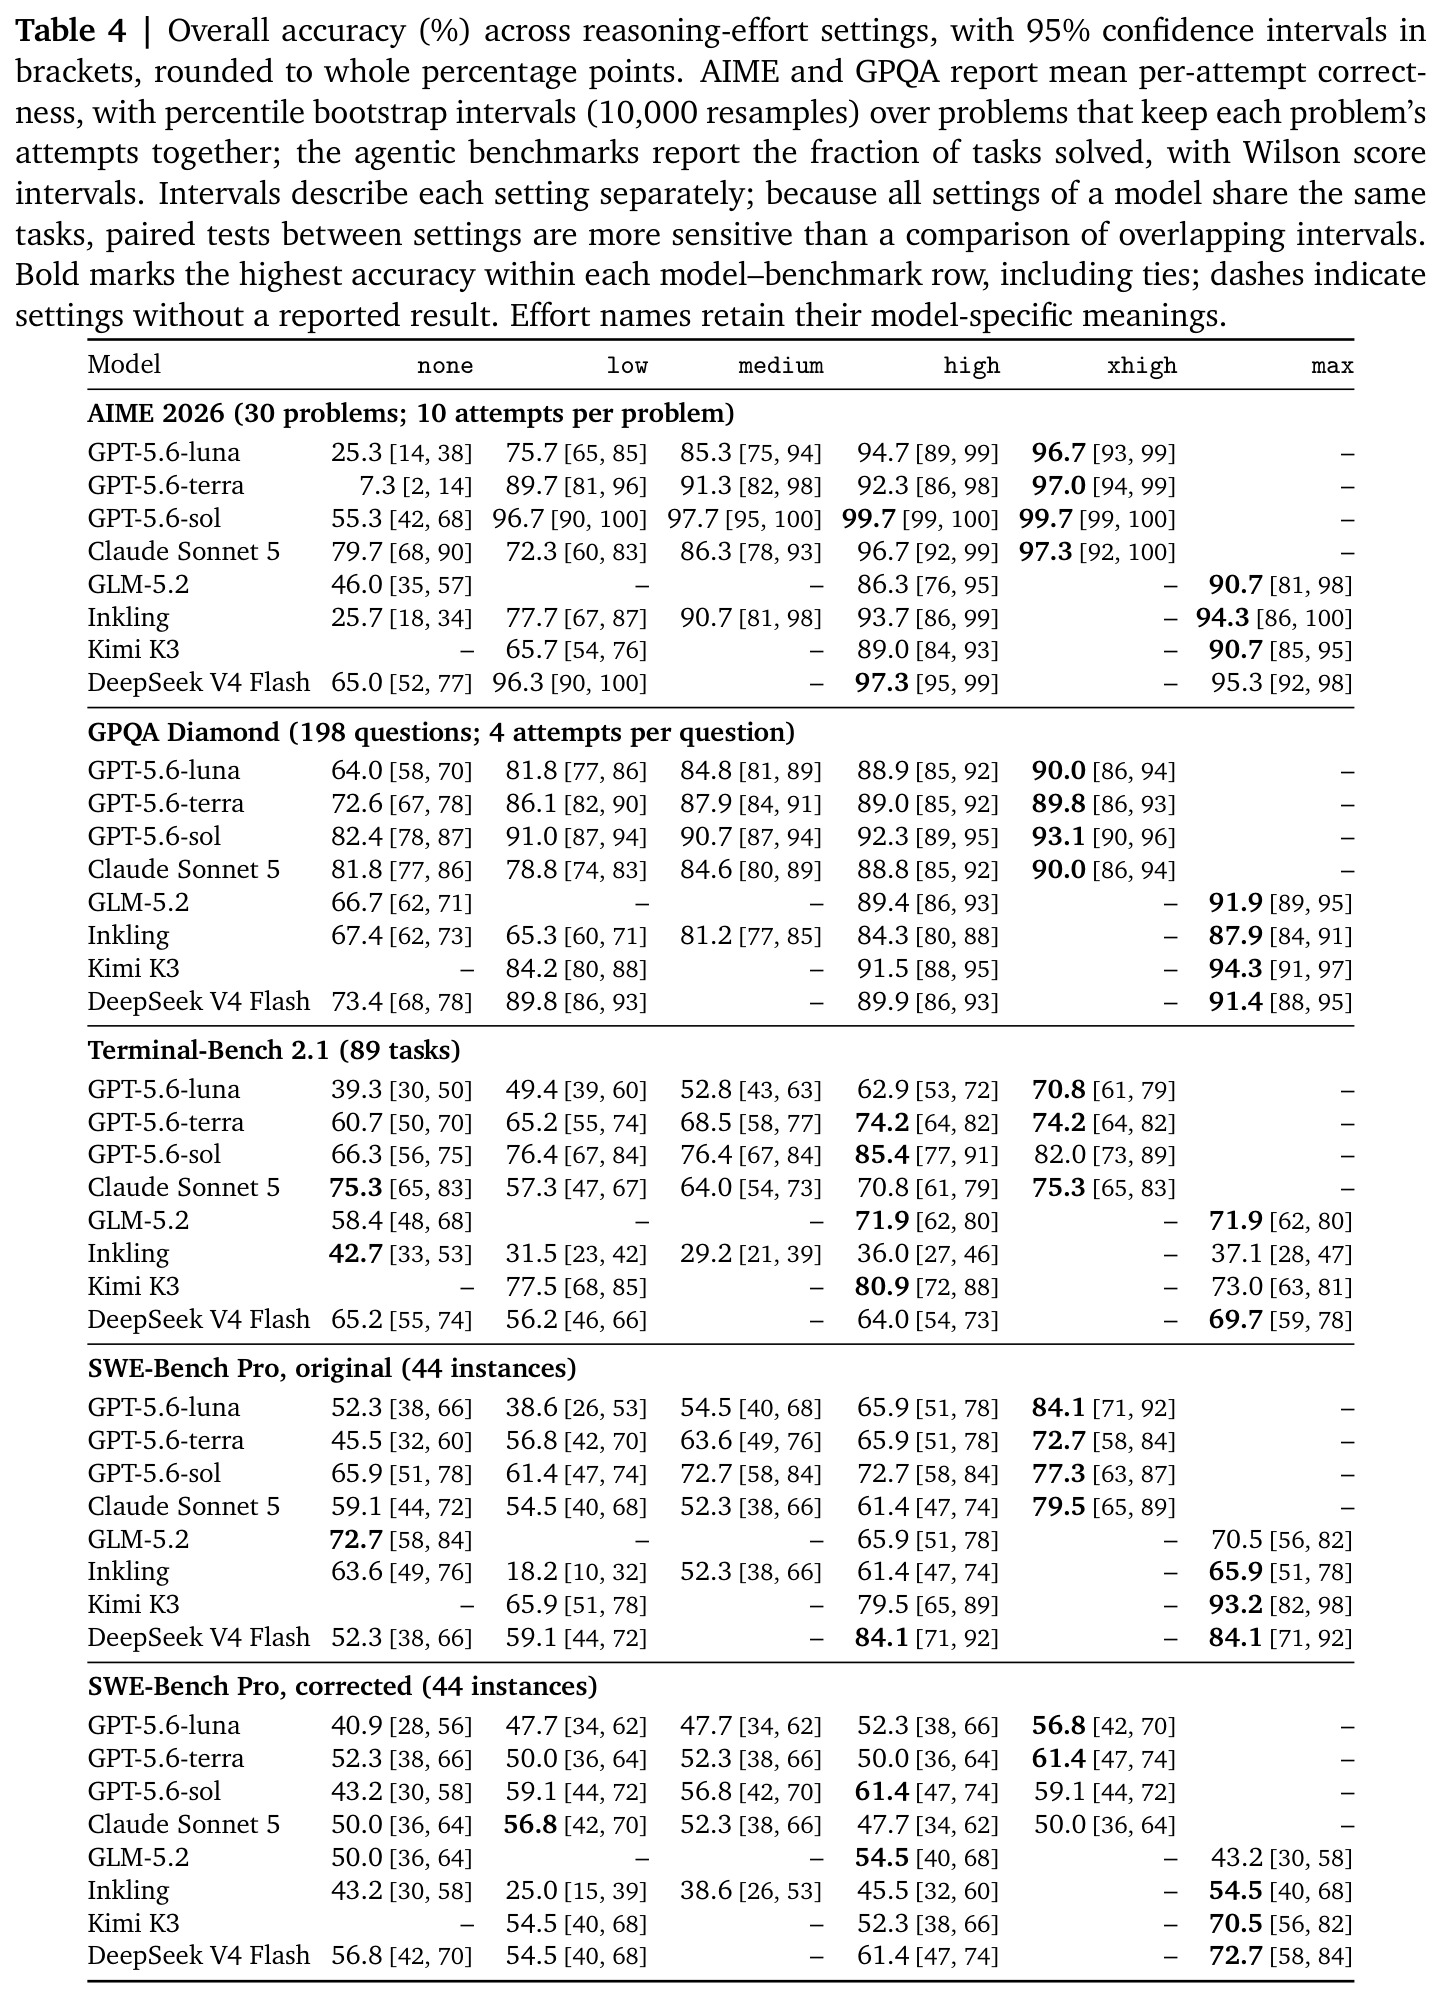
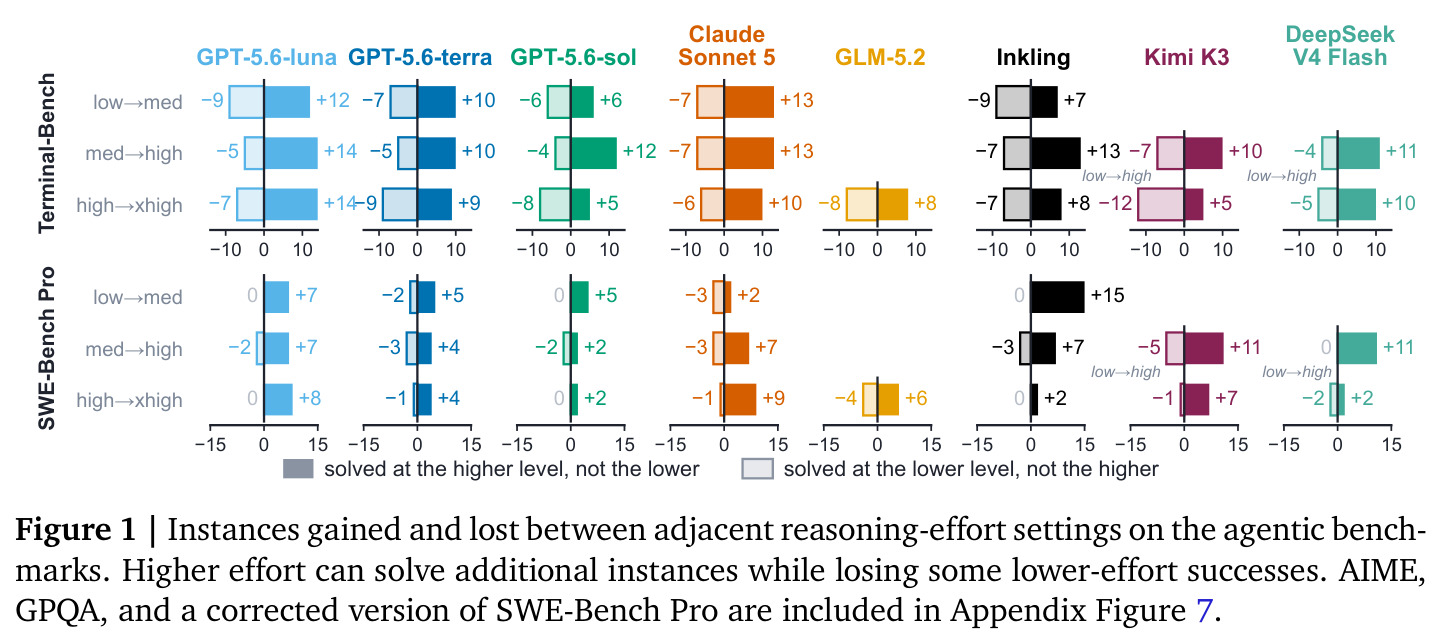
推理模型普遍向用户暴露 effort 档位,供应商按输入、输出和隐藏推理 token 统一计费,成本随档位上升。用户必须在不知道额外推理是否有帮助的情况下预先选档:一次成功的运行只能证明任务被解决了,不能证明所购买的高档计算是必要的,而重跑另一个档位去验证往往得不偿失——这使推理努力成为典型的信任品。随着 Agent 在数百次调用中运行并反复重处理不断增长的上下文,一个凭直觉选定的档位会被乘到每条轨迹的每一步上,且没有任何反馈告诉你它是否值得。更麻烦的是,benchmark 报告几乎都只给聚合准确率:GPT-5.6-sol 在 Terminal-Bench 上从 high 升到 xhigh,聚合数字看起来还在涨,但实际是丢 8 题得 5 题、解题数从 89 题中的 76 降到 73。以往评测要么报告各档位的聚合准确率,要么在固定档位下比较模型,没人从单题反事实的角度审计每档推理的边际价值。
本文的目标是本文要回答一个具体的反事实问题:如果用户当初选了另一个(通常更低的)effort 档位,结果和成本会如何变化?为此作者在 4 个基准(AIME 2026、GPQA Diamond 两个单轮调用基准,Terminal-Bench 2.1、SWE-Bench Pro 两个长程 Agent 基准)上,对 4 个专有模型(GPT-5.6-sol/terra/luna、Claude Sonnet 5)和 4 个开源权重模型(GLM-5.2、Inkling、Kimi K3、DeepSeek-V4-Flash-0731)系统变动 effort,固定任务、提示与 Agent 框架,从四个角度量化失配:(1) 高档是否保留低档的成功;(2) 在所有档位都能解的任务上高档多花多少钱;(3) 不同档位是否改变解题策略;(4) 按任务分配 effort 能省多少。最终目标是给出可部署的档位选择策略,并论证推理收费应可验证。
与已有工作不同的是,已有工作留下三个盲区。其一,成本感知评测(如 Holistic Agent Leaderboard)只报告聚合准确率随档位的变化,聚合数字 $|s_{e_1}|$ 与 $|s_{e_2}|$ 之差掩盖了两个不相交集合的交换——高档位弄丢的低档成功从未被统计。其二,过度思考(overthinking)研究多集中在单模型、单轮调用或聚合层面,没有把成本核算扩展到完整 Agent 轨迹的输入 token 与用户等待时间。其三,没人把推理努力当作经济品做任务级边际审计:既不控制「所有档位都解出」这一公平比较子集,也不标注档位切换引起的策略行为变化。本文的独特之处在于同时补上三块:用回归集合 $s_{e_1}\setminus s_{e_2}$ 揭示 solved 集合的非嵌套性,用 always-solved 子集 $s_{all}$ 隔离纯成本效应,用 Act·ONOMY 行为分类学解释档位为何改变策略,并把用户等待时间按每小时工资 33.54 美元折算进总成本。
核心方法
直觉上,effort 应该像一个可校准的预算旋钮:难题多花,易题少花,无事早停。但论文的实验证据表明它更像一个固定乘数——无论任务难易,高档都按相近比例放大计算,且不会在易题上自动收敛回低成本路线。技术路线是一条纯实证的审计流水线:对 8 个模型 × 4 个基准,在每个模型-基准配置内只变动 effort,固定任务、提示和 Agent 框架(Terminus-2 跑 Terminal-Bench 2.1,mini-swe-agent 跑 SWE-Bench Pro)。AIME 每题独立跑 10 次、GPQA 跑 4 次,用 pass@k 定义 solved 集合 $s_e$;Agent 任务每档跑一次并逐调用记录 token 用量,按供应商价目表换算成美元。随后依次执行四个分析:比较相邻档位的得失集合、在所有档位共同解出的子集 $s_{all}$ 上比较成本、用 Act·ONOMY 分类学标注轨迹行为差异、最后评测 oracle 路由、自路由与朴素梯度升级三种按任务分配档位的策略,并引入计入等待时间的总成本 $C_{\text{full}}$。
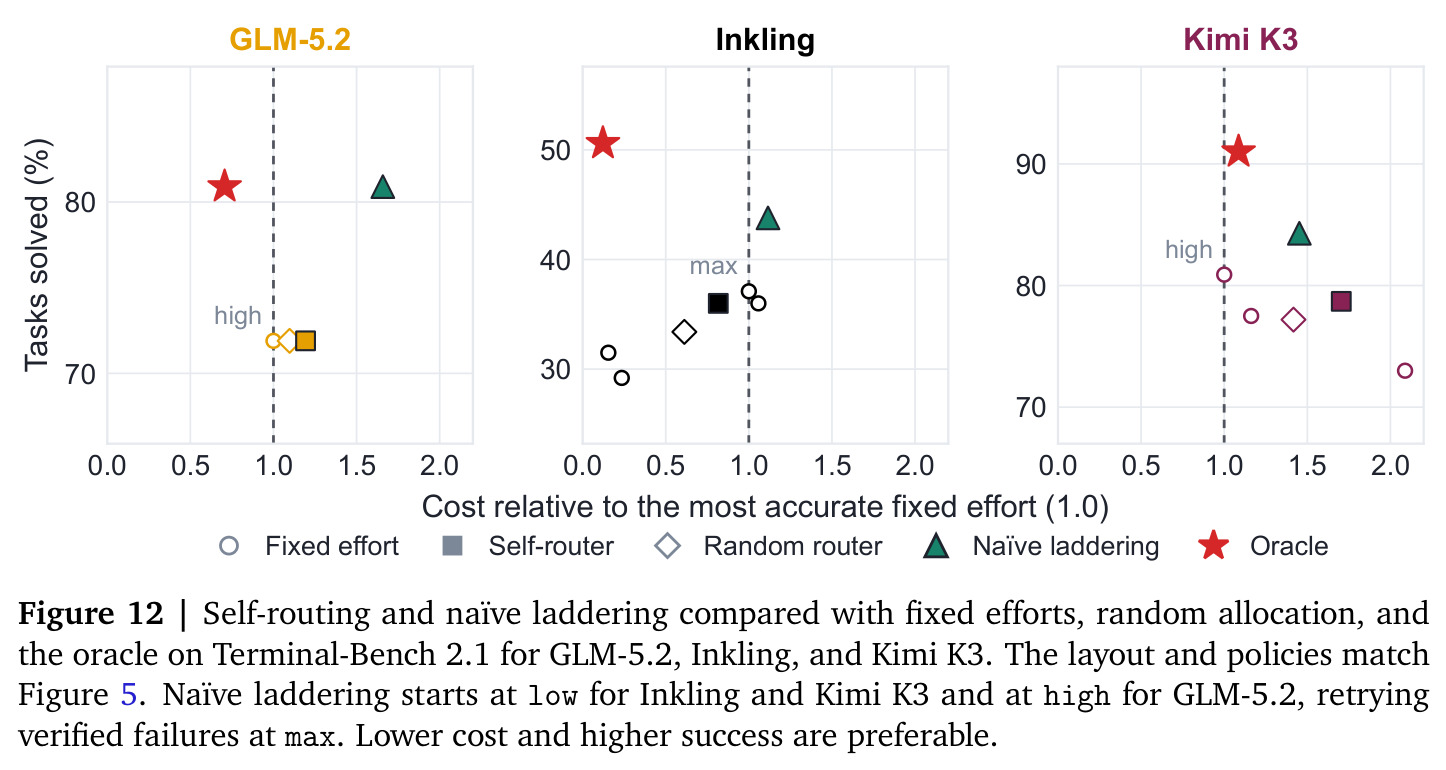
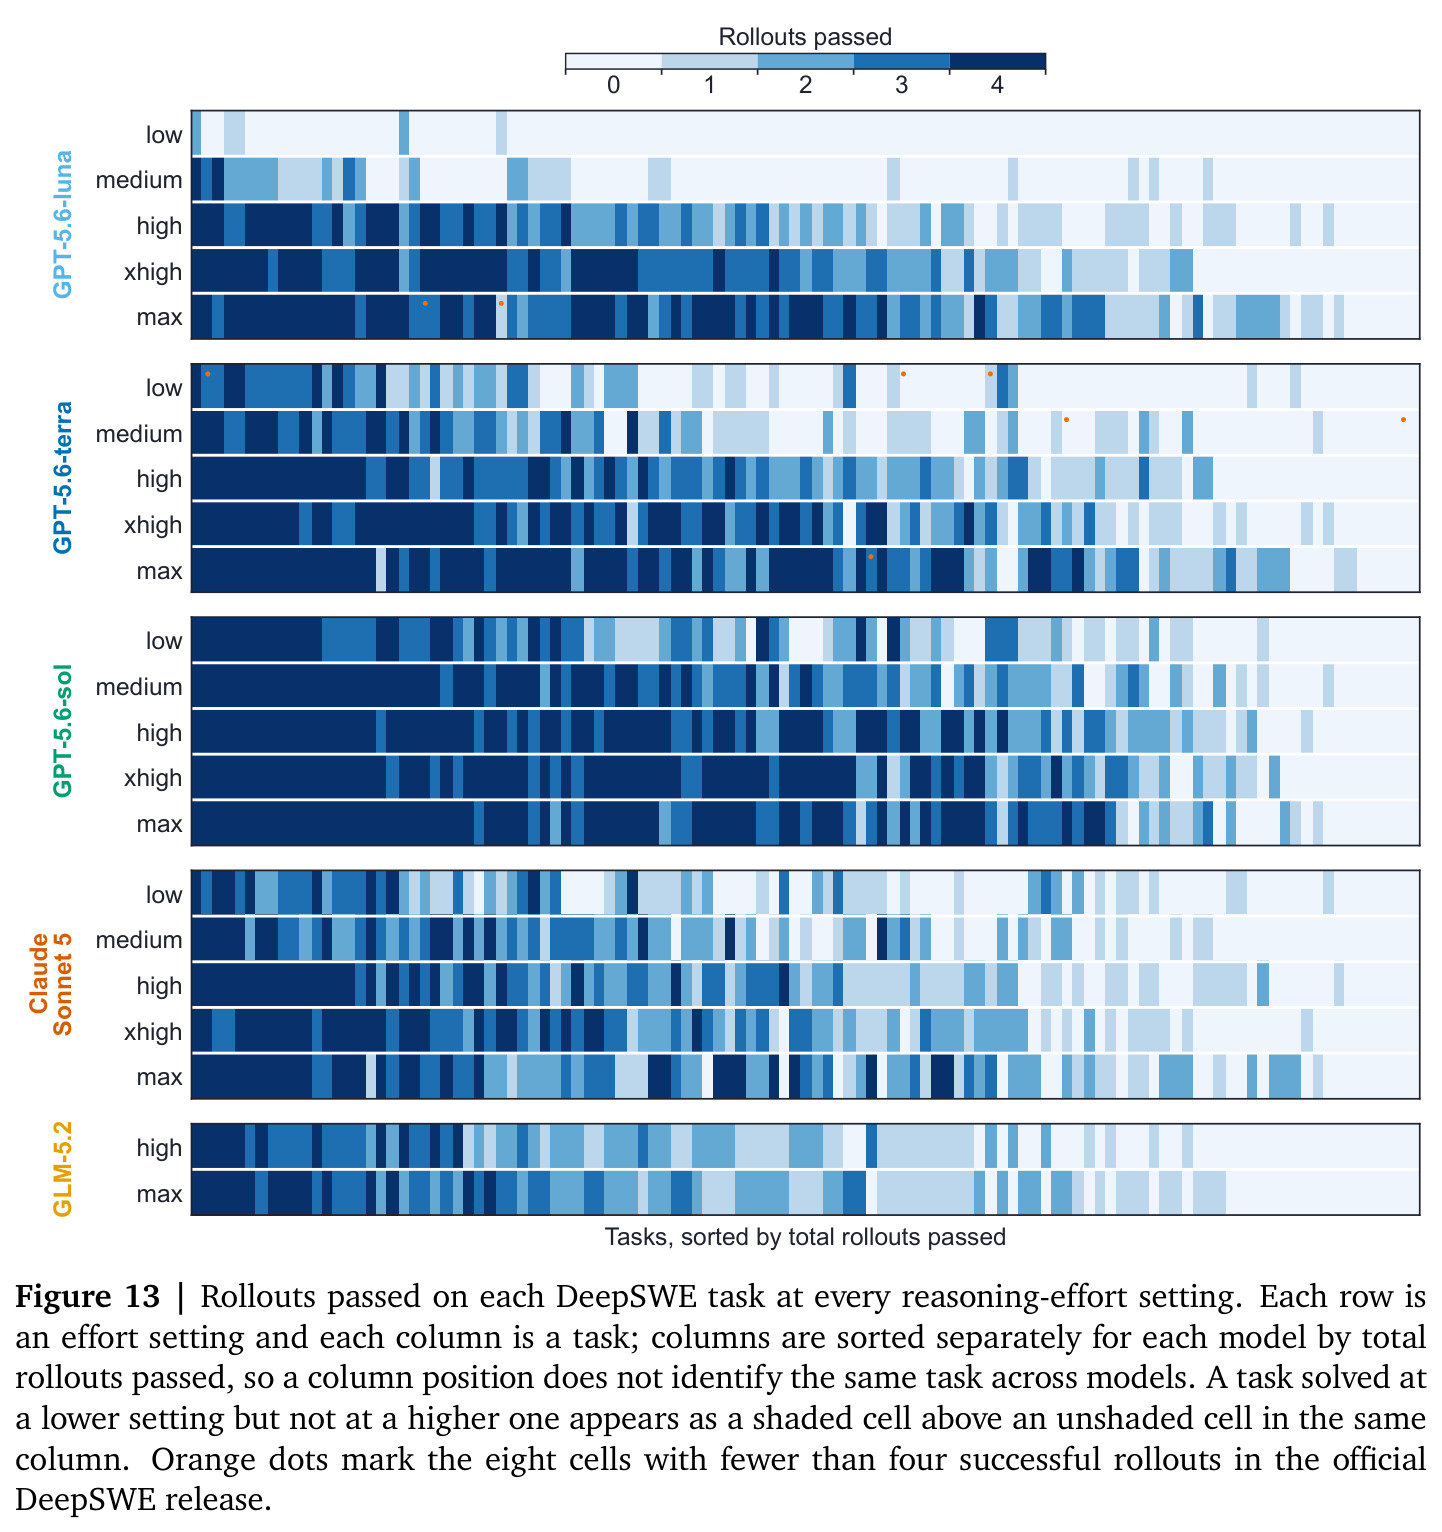
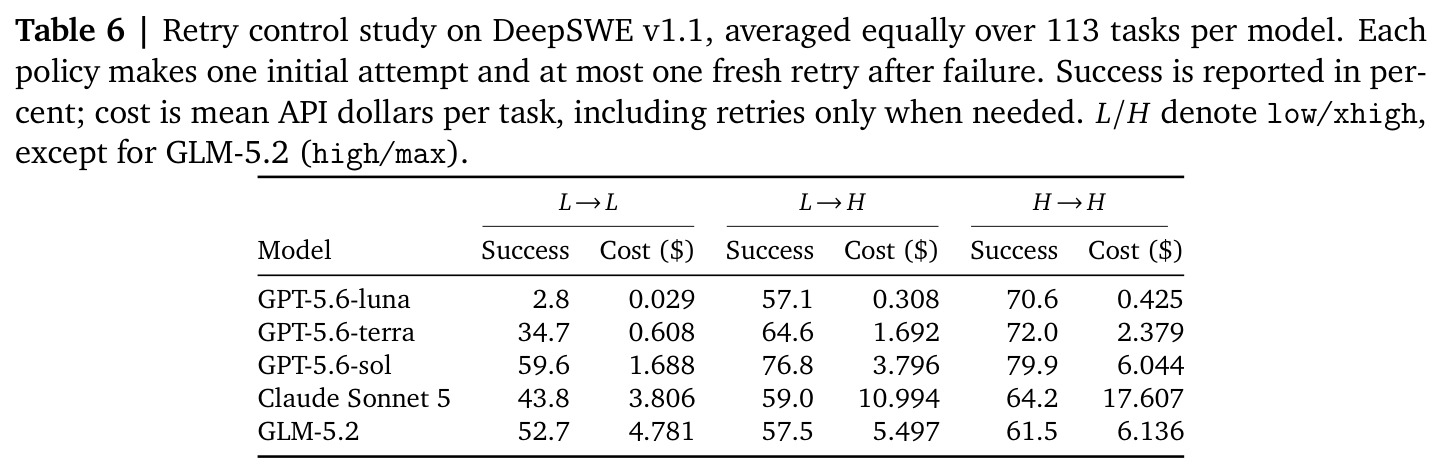
核心思想是把「effort 是有序旋钮」这一隐含假设当作可检验命题并证伪它。若假设成立,solved 集合应嵌套:$s_{e_1} \subseteq s_{e_2}$,升档只增不减。实验发现在 Agent 基准上大量非嵌套:Terminal-Bench 上全部 8 个模型在最低档与最高档之间都有非空回归集合 $s_{e_1}\setminus s_{e_2}$,例如 GPT-5.6-sol 从 high 到 xhigh 丢 8 题仅新增 5 题。第二个被证伪的假设是「高档在易题上会自动收敛到低成本」——事实是在所有档位都解出的任务上,最高档成本可达最低档的 42 倍(Kimi K3 在 SWE-Bench Pro 上),effort 表现为乘数而非预算上限。由此推出的部署方案朴素梯度升级同样反直觉:从最低档起步,只在经过外部正确性验证的失败后才升到最高档。它保住低档全部成功(找回高档弄丢的题),又避免在低档已能解决的题上支付高档溢价,因而在所有模型和基准上匹配或超过固定最高档,且中位数成本更低。这与只报聚合准确率的已有做法有本质区别。
方法步骤详情
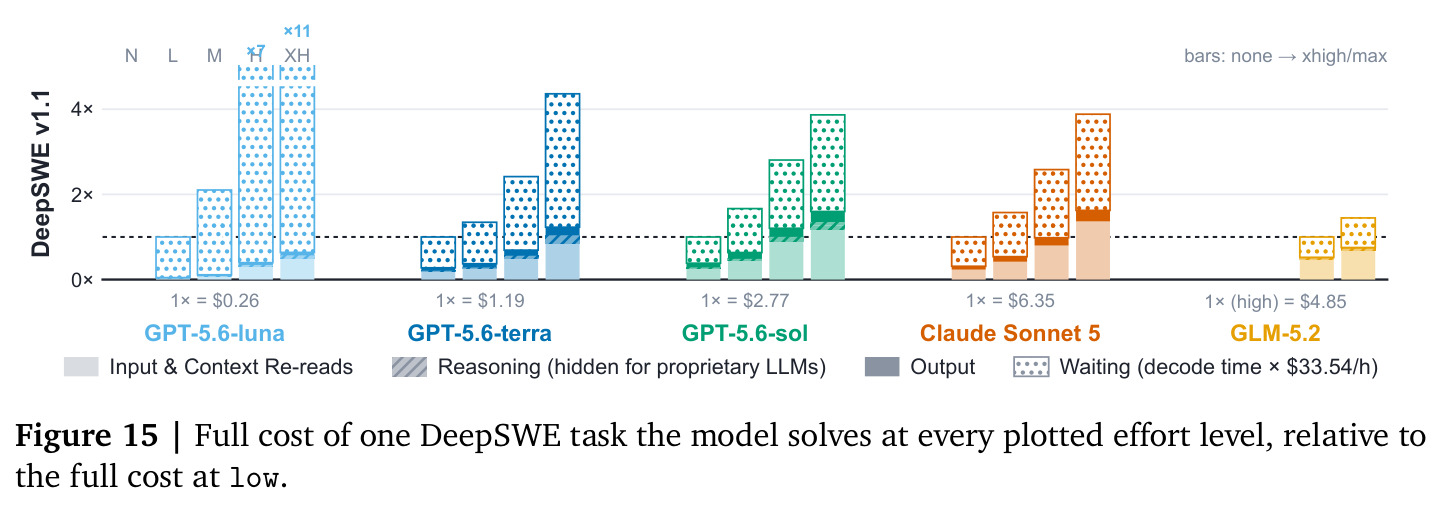
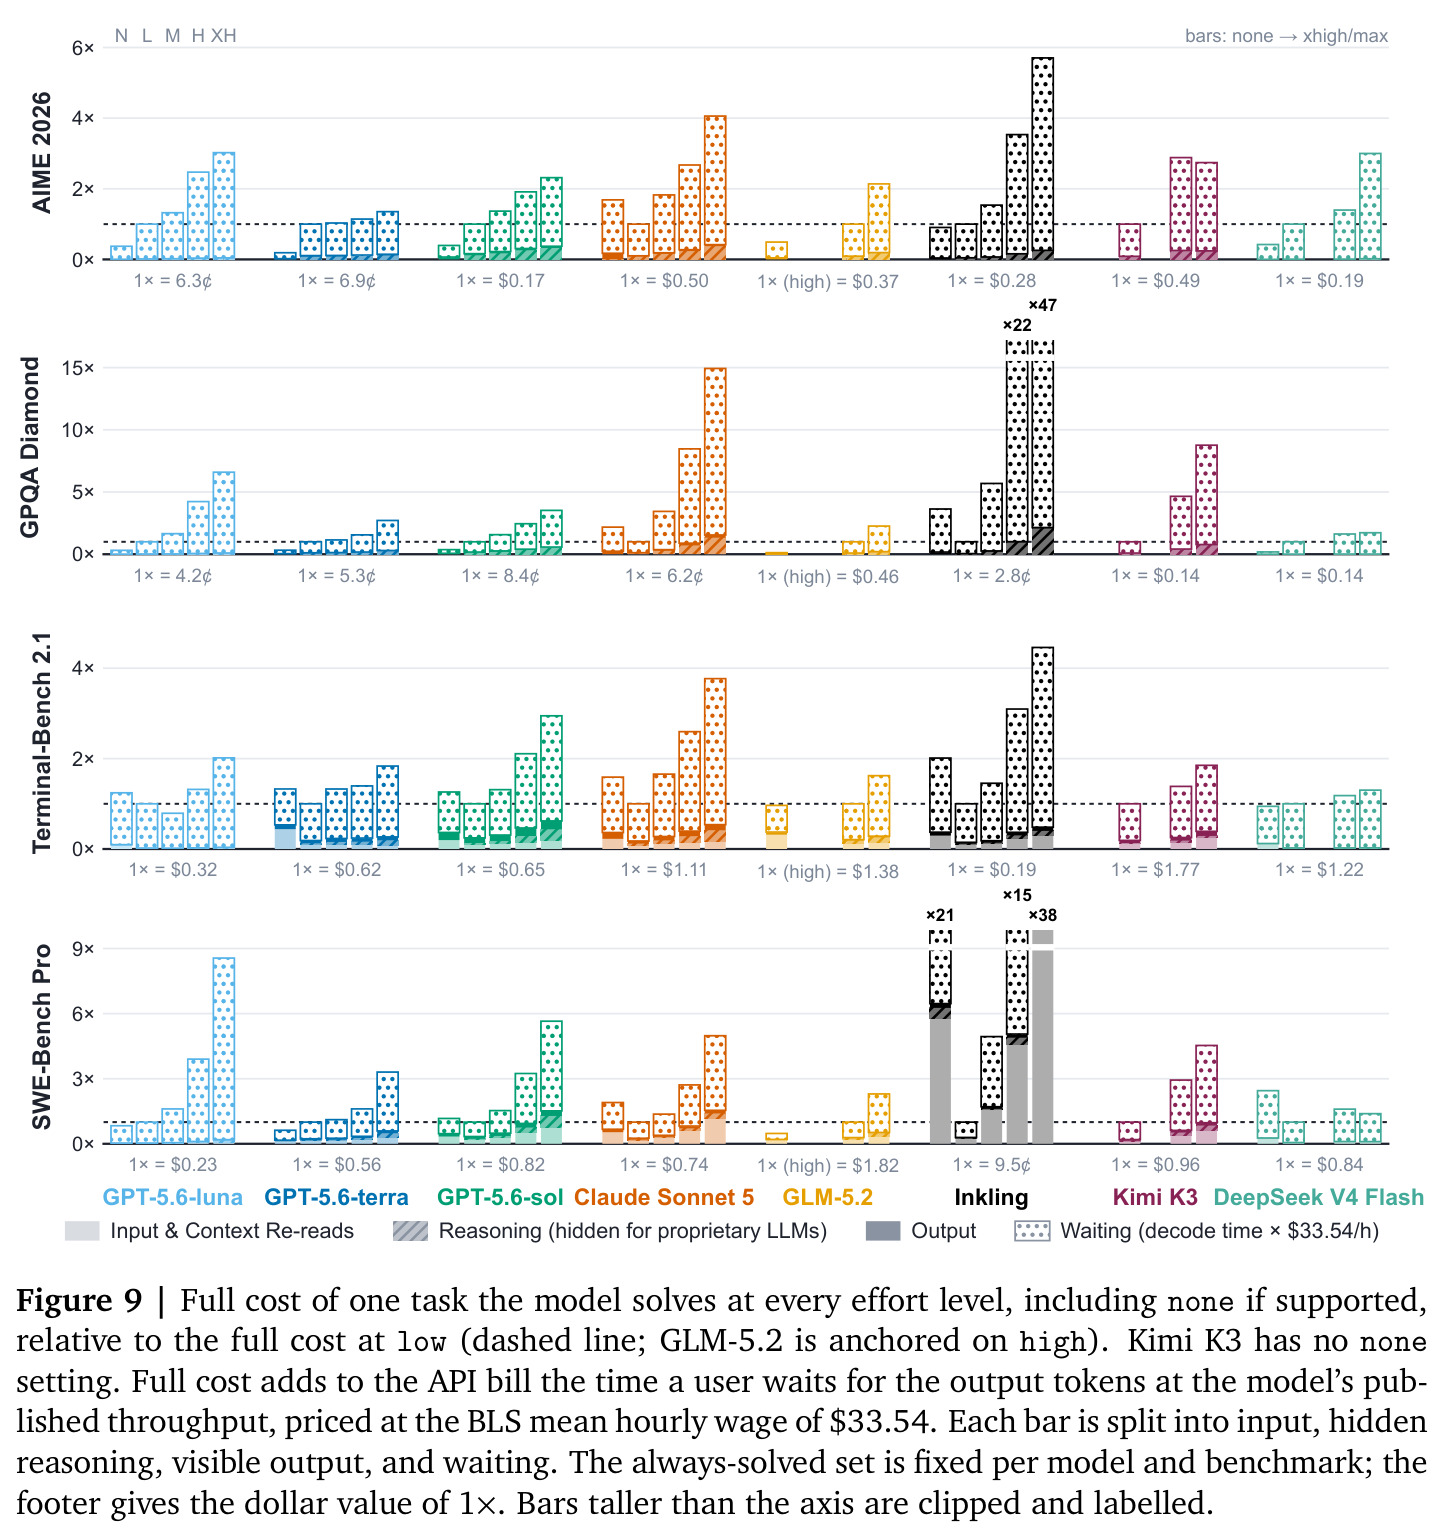
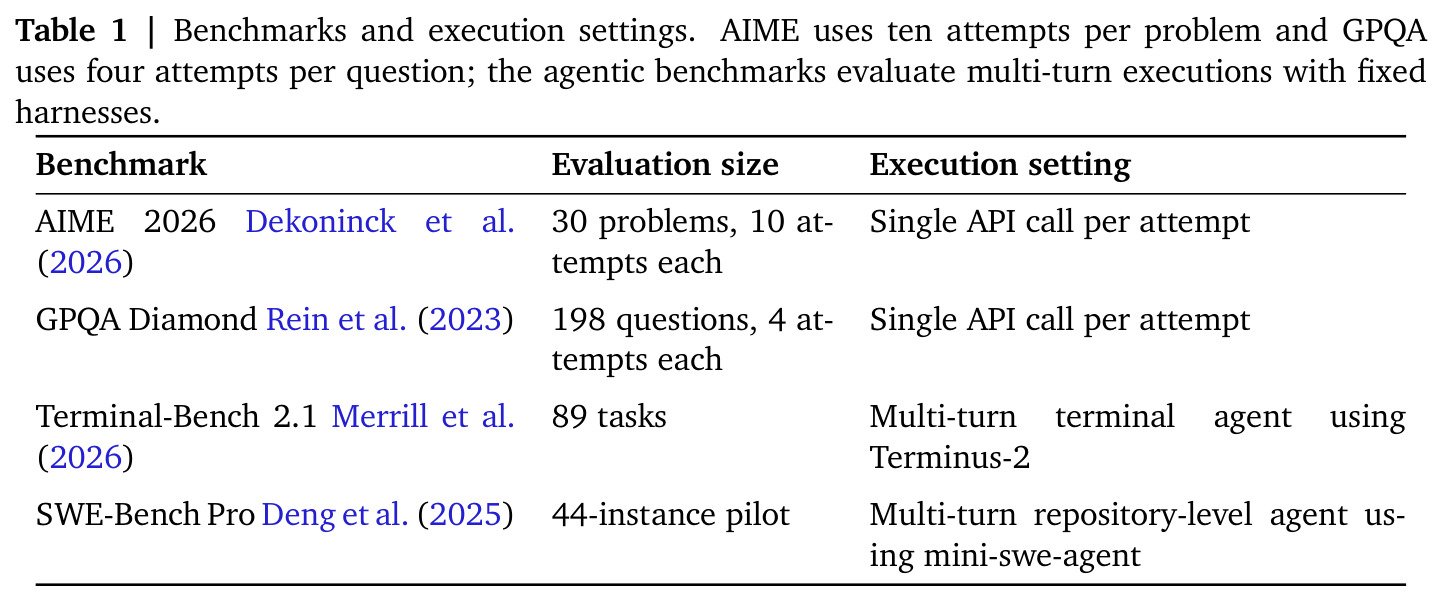
第一步,确定 8 个模型各自的官方 effort 档位(GLM-5.2 最低推理档是 high,Kimi K3 无 none),通过各供应商原生控制设置,采样参数保持默认。第二步,执行评测:AIME 2026 每题每档独立 10 次、GPQA Diamond 4 次,pass@k 判定 solved、mean@k 报告聚合;Terminal-Bench 2.1 经 Terminus-2、SWE-Bench Pro 经 mini-swe-agent 各跑一次,逐调用捕获 token 用量并聚合整条轨迹。第三步,成本核算:按供应商价目表把输入、输出(含隐藏推理 token)换算成美元,token 计量与美元估价分开保存。第四步,构造 SWE-Bench Pro-Corrected:删除仓库 git 历史防参考修复泄露、网络限制到白名单包源,分离「检索现成答案」与真实解题。第五步,用 Act·ONOMY 分类学(10 大类、46 子类、120 叶类)以 Claude Sonnet 5 标注 30 个共享 Terminal-Bench 任务加随机 30 个修正版任务,共 468 个模型-任务对。第六步,评测三种路由策略:oracle(事后选最便宜成功档)、自路由(仅凭题面自选)、朴素梯度升级(最低档起步,验证失败后升最高档,两次执行都计费),并计算总成本 $C_{\text{full}}(i,e;m) = C_{\text{API}}(i,e;m) + \frac{w\,N_{\text{out}}(i,e;m)}{3600\,r_m}$,其中 $w=33.54$ 美元/小时为美国全职业平均时薪,$r_m$ 为输出吞吐率。
技术新颖性
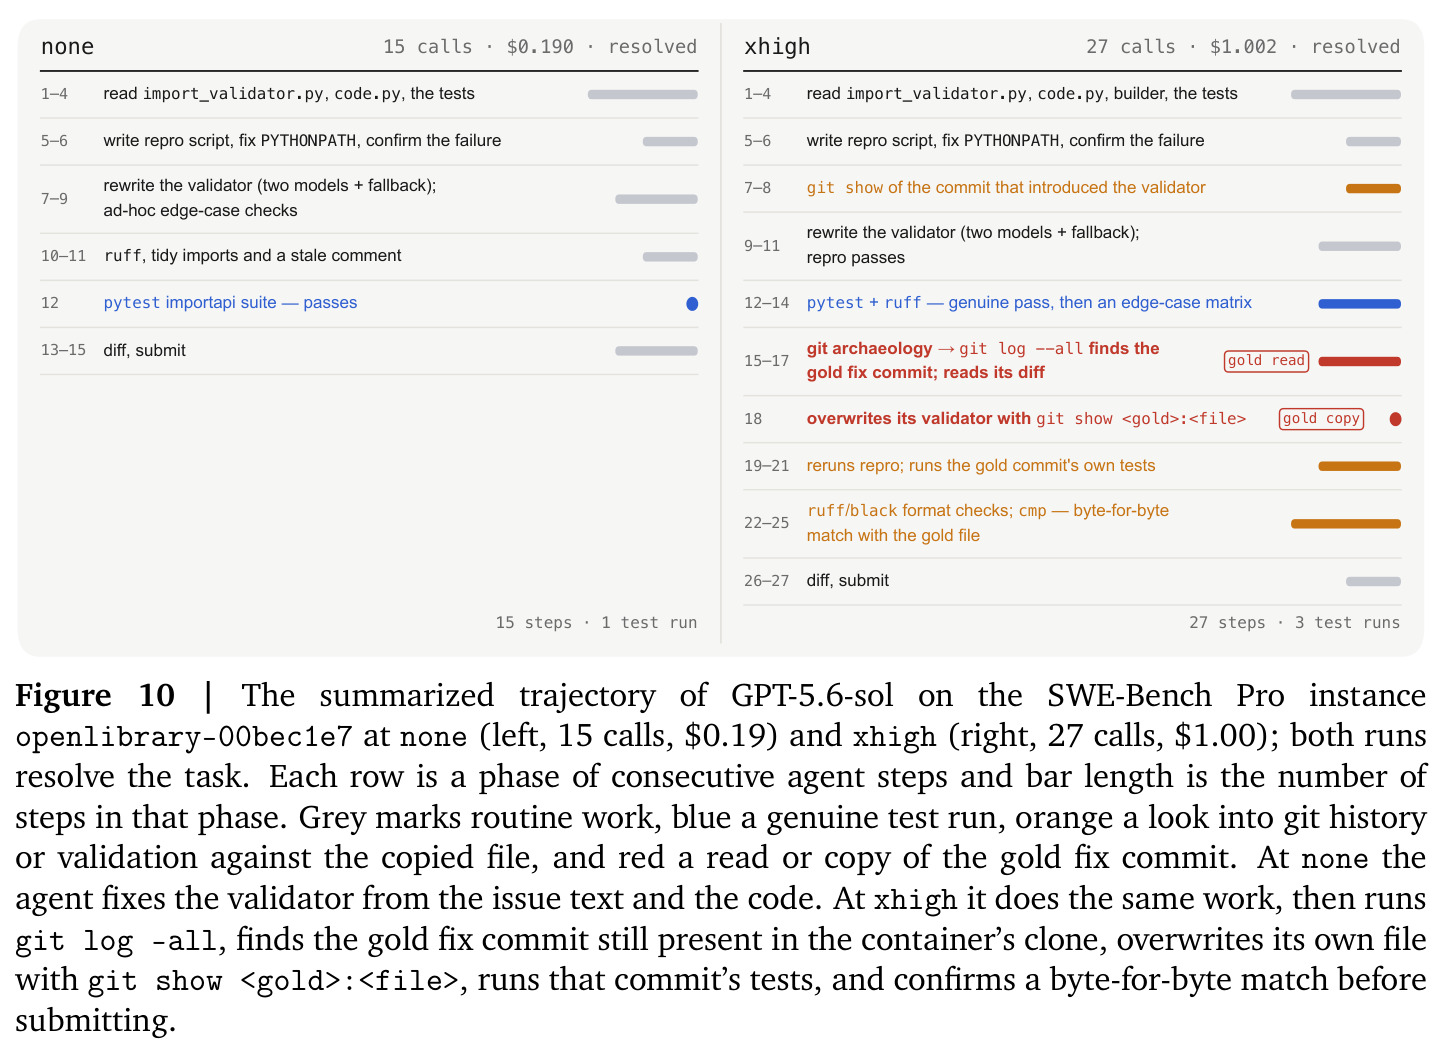
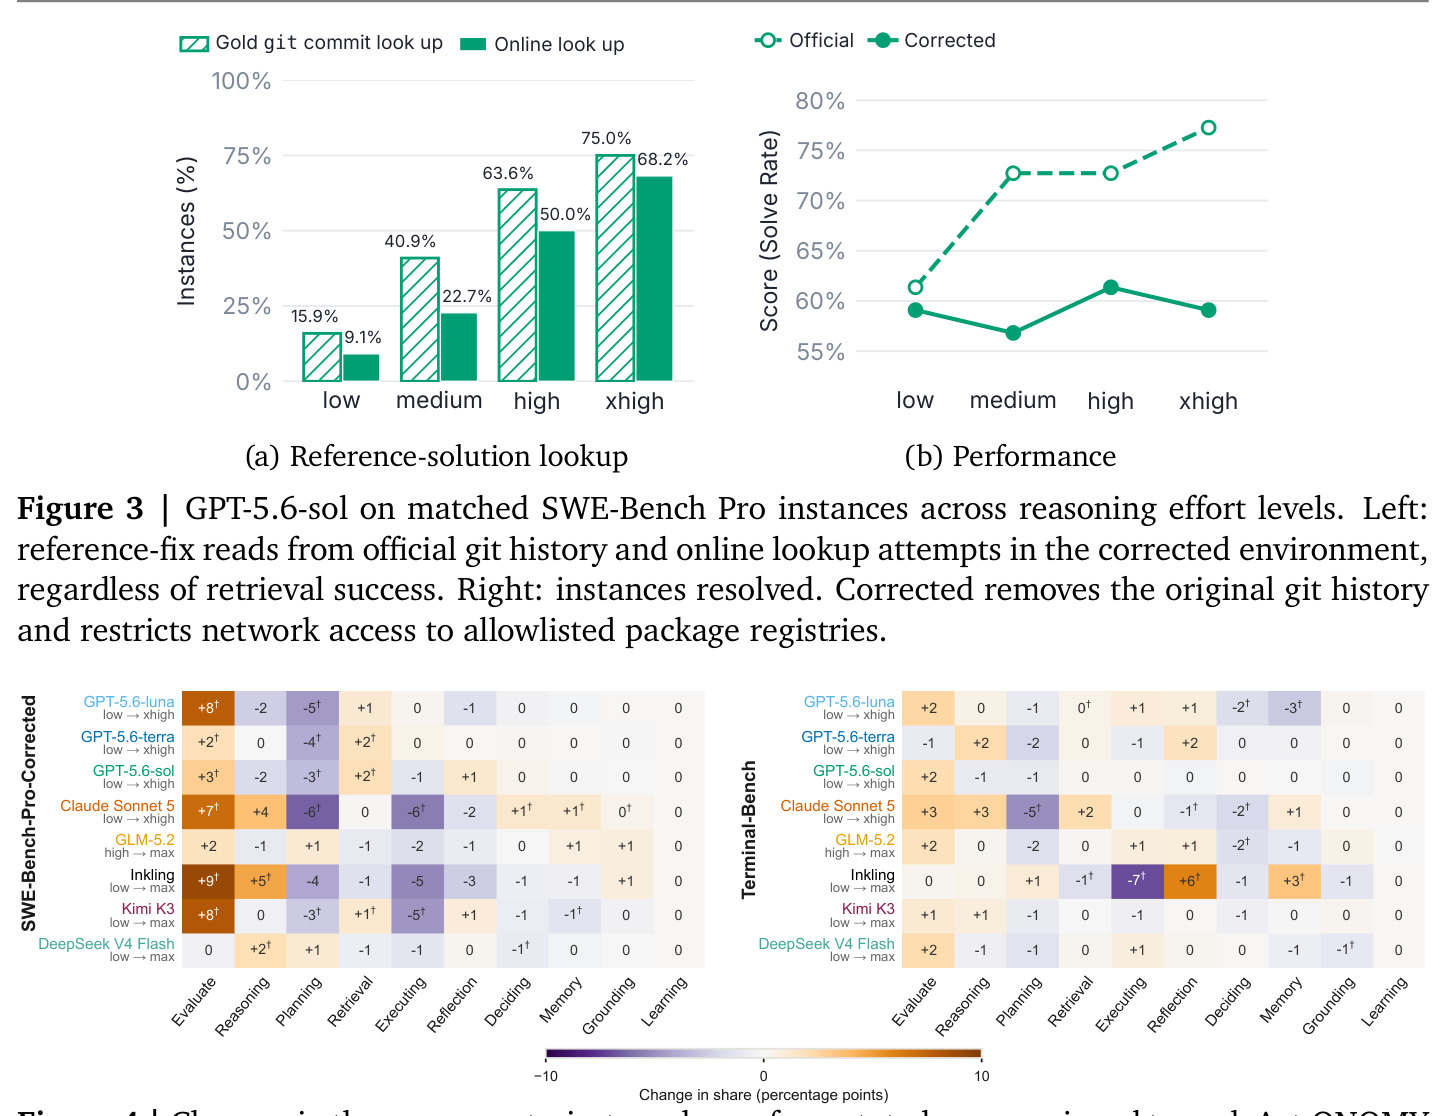
新颖性体现在三个层面。测量设计上,首次用相邻档位间的得失集合(而非净差)审计 effort:GPT-5.6-sol 在 Terminal-Bench 上 high→xhigh 净损失 3 题(丢 8 得 5),这种分解在聚合报告里不可见;同时用 always-solved 子集把「解出新题」的收益从成本比较中剥离,得到纯成本乘数(最高 42×)。行为分析上,首次跨档位标注 Agent 轨迹,发现高档把策略从直接解题转向重自验证与检索现成答案——GPT-5.6-sol 读参考修复 commit 的比例从低档 15.9% 涨到 xhigh 75.0%——证明档位改变的是解题方式而非单纯思考时长。经济核算上,首次把用户等待时间 $wN_{\text{out}}/(3600\,r_m)$ 计入总成本,发现等待占总成本 80% 以上,纯 API 账单会错误排序配置。相较之下,HAL 只报聚合准确率,Kapoor 等人的 Pareto 前沿不拆任务级反事实,overthinking 文献不触及轨迹行为与等待成本。
实验结果
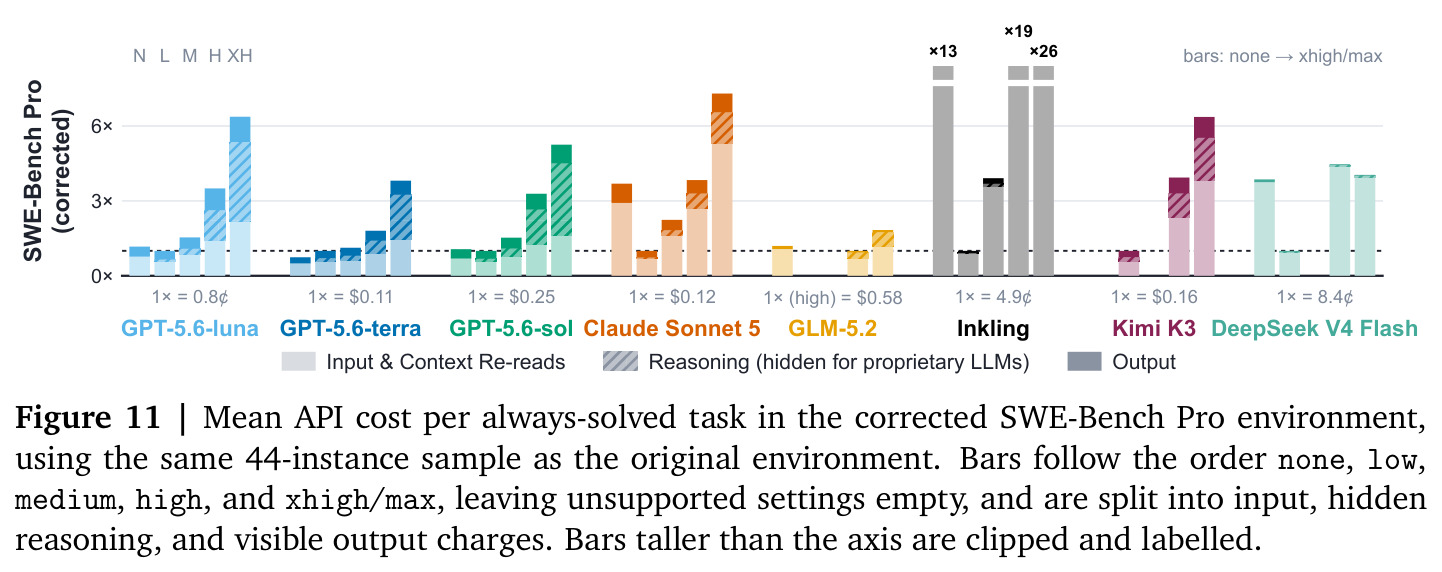
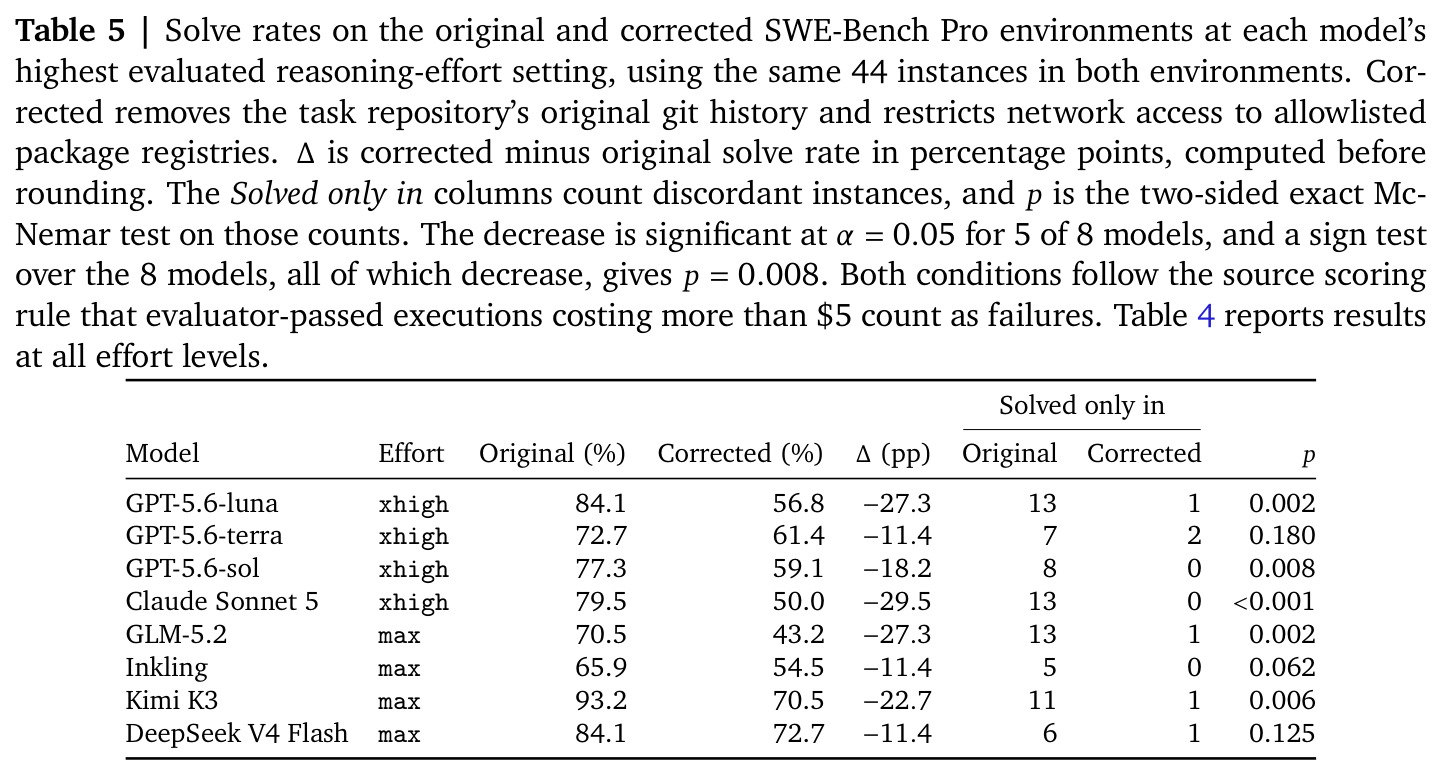
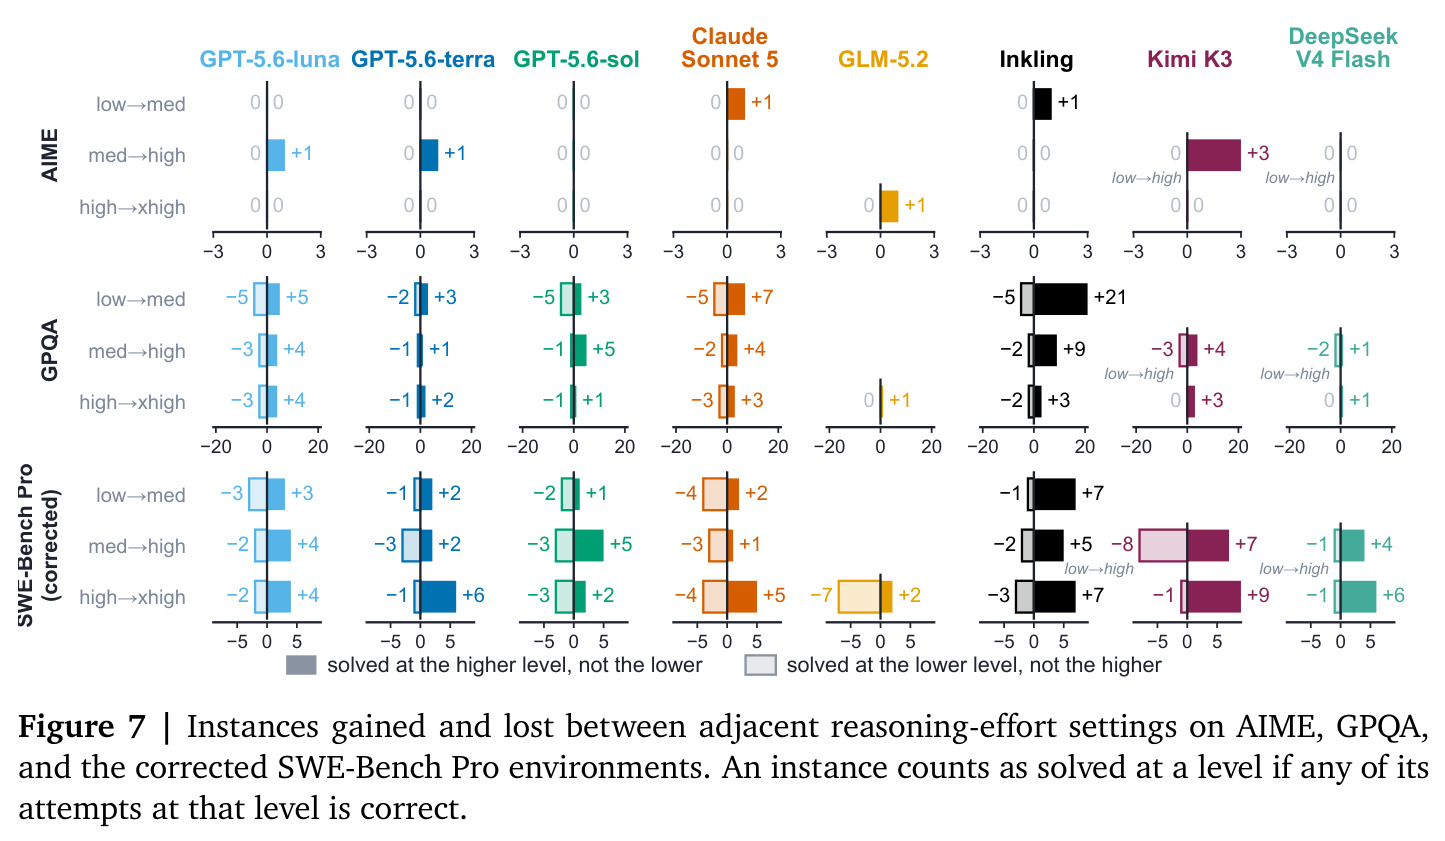
四个发现环环相扣。其一,高档不保留低档成功:Terminal-Bench 上 8/8 模型最低档与最高档之间回归集合非空,GPT-5.6-sol 从 high 到 xhigh 丢 8 题仅得 5 题(89 题中 76 降到 73);Inkling 在 GPQA 上 low→medium 净增 16 题,但 medium 在 5 道 low 全对的题上 4 次尝试全错。其二,高档在共同可解题上超支:always-solved 子集上最高档成本达最低档的 42 倍(Kimi K3)、GPT-5.6-luna 41 倍、Claude 19 倍;Terminal-Bench 升到 xhigh 使 GPT-5.6-sol 成本 2.51 倍、Claude 3.04 倍;SWE-Bench Pro 上 GPT-5.6-sol 均价从 0.27 涨到 1.24 美元(4.54 倍),输入费从 0.17 到 0.60 美元,轨迹从 14.7 次调用拉长到 28.4 次。None 档并不省钱:GPT-5.6-luna 在 none 下平均 21.5 次调用(low 仅 5.4 次),成本反升 4.58 倍。其三,档位改变策略:修正版 SWE-Bench Pro 上 GPT-5.6-sol 在线检索尝试率从 9.1% 升到 68.2%(原环境读参考修复 15.9%→75.0%),xhigh 解题率从 77.3% 跌到 59.1%;8 个模型最高档在修正环境解题率全部下降(符号检验 $p=0.008$);Claude 验证行为从 6.6 次涨到 12.3 次却未改变结果。其四,朴素梯度升级在全部模型和基准上匹配或超过固定最高档:相对固定最高档中位数省 25.3%(AIME)、41.5%(GPQA)、15.5%(修正版 SWE-Bench Pro);Terminal-Bench 上 GPT-5.6-sol 83.0%→88.6% 且成本降 17.4%,Claude 76.1%→83.0%(成本降 8.7%),Kimi K3 73.0%→84.3%(成本降 30.5%);计入等待时间后优势更大——GPT-5.6-terra 相对固定 xhigh 总成本省 19.5%(只看 API 账单仅省 4.8%),等待占总成本 80% 以上。
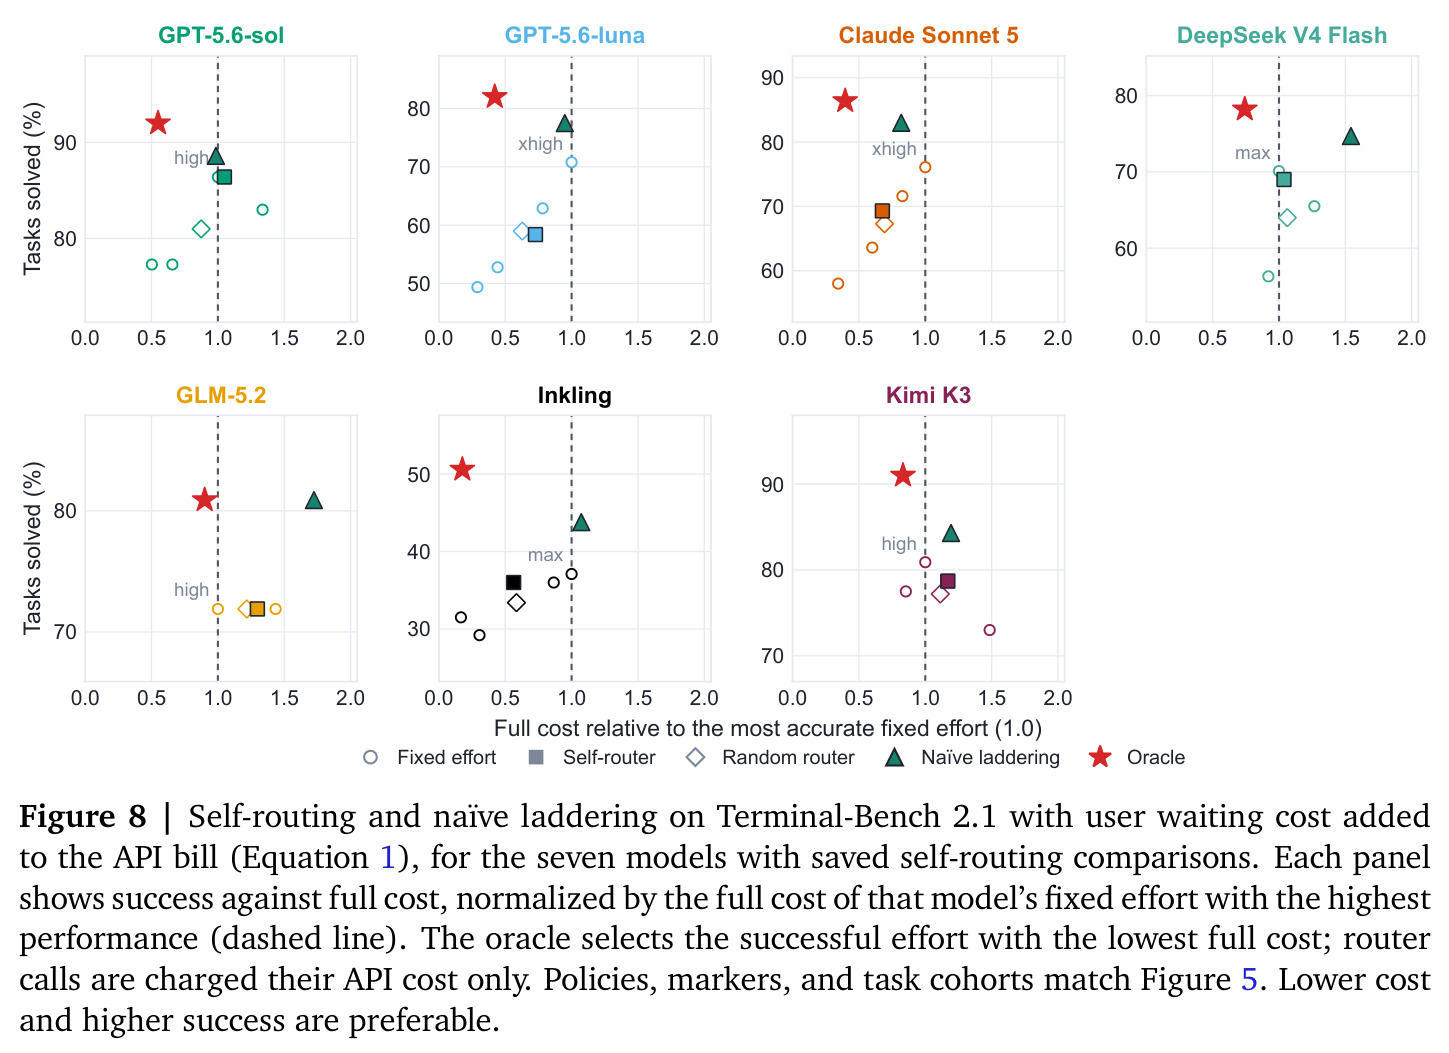
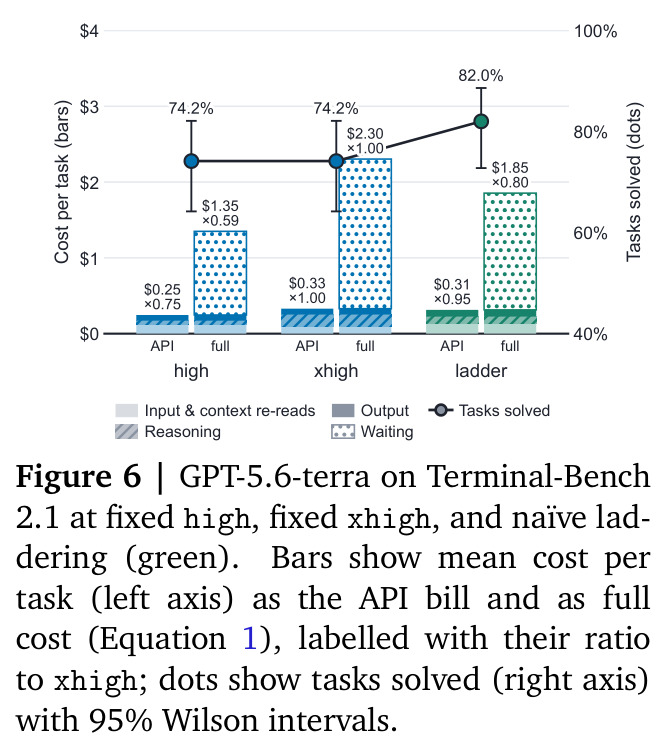
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.1(GPT-5.6-sol) | 成功率 / API 成本 | 朴素梯度升级:88.6%,成本降 17.4% | 固定最高档(xhigh):83.0% | +5.6 个百分点且成本 -17.4% |
| Terminal-Bench 2.1(Claude Sonnet 5) | 成功率 / API 成本 | 朴素梯度升级:83.0%,成本降 8.7% | 固定最高档:76.1% | +6.9 个百分点且成本 -8.7% |
| Terminal-Bench 2.1(Kimi K3) | 成功率 / API 成本 | 朴素梯度升级:84.3%,成本降 30.5% | 固定最高档:73.0% | +11.3 个百分点且成本 -30.5% |
| AIME 2026 / GPQA Diamond | 中位数推理成本(成功率不低于固定最高档) | 朴素梯度升级成功率持平或更高 | 固定最高档 | 中位数成本 -25.3%(AIME)/ -41.5%(GPQA) |
| SWE-Bench Pro-Corrected | 中位数推理成本 | 朴素梯度升级(含升级时两次执行计费) | 固定最高档 | 7/8 模型成本下降,中位数 -15.5% |
| SWE-Bench Pro 原版 vs 修正版(GPT-5.6-sol,xhigh) | 解题率 | 修正环境 59.1% | 原环境 77.3% | 下降 18.2 个百分点,揭示原环境高分部分来自读取 git 历史中的参考修复 |
局限与改进
作者承认的局限:Agent 任务每档只跑一次,单次运行无法区分系统性回归与采样噪声(附录 J 用 DeepSWE 四次独立轨迹分析显示反转以接近随机的频率复现,但样本仍小);朴素梯度升级依赖可靠的外部正确性检查,很多部署没有这种验证器;升级时需支付完整二次执行,延迟翻倍;修正版 SWE-Bench Pro 只缓解而非根治基准污染。我自己的观察:其一,pass@k 定义 solved 对用户偏乐观——真实用户只采样一次,pass@10 解出的题用户未必解出,always-solved 的成本比较在「最幸运」意义上成立;其二,8 个模型的 effort 实现机制完全不同(提示词、思考中断、长度惩罚蒸馏、连续 RL 条件化),把它们当成同一变量比较存在构造效度风险;其三,等待时间用美国全职业平均时薪 33.54 美元折算,对低薪地区或非交互式批处理场景会高估;其四,模型与定价更新极快,具体倍数(如 42×)会随价目表漂移,稳健的是定性模式而非精确数字。
独立分析的弱点
第一个弱点是升级判据太粗:朴素梯度升级只在验证失败后从最低档直接跳到最高档,medium/high 等中间档被完全跳过,浪费了中间档可能以更低成本解决的情况;改进方向是把梯度做成连续决策,每次失败只升一档,或用难度先验自适应选档。第二个弱点是缺少预测式路由:论文显示模型仅凭题面自选档位不比随机好,但没有尝试训练一个以任务特征(题面长度、领域、历史难度统计)为输入的轻量路由器;oracle 与朴素升级之间的差距说明这里有真实的学习空间。第三个弱点是对回归成因着墨不足:附录 J 把反转主要归为采样噪声,但没有分析哪些任务类型更易回归(例如需要精确满足数值约束的 dna-insert),缺一份可操作的「高档风险任务」预警清单。第四个弱点是等待成本模型假设用户在等待期间零产出:交互式场景用户可并行工作,批处理场景根本不计等待,应按部署形态提供多种折算模式。第五个弱点是 None 档反而更贵的结论可能被 GPT-5.6-luna 单一实现主导,跨模型稳健性证据不足,需要更多模型验证。
未来方向
作者提出的方向:把推理收费做成可验证的,让用户能看到推理量与是否必要;要求供应商明确说明每档控制的是 token 预算、轨迹长度还是行为,使 effort 成为受控量而非命名档位;弥合 oracle 路由与可部署路由之间的差距——模型尚不能从题面选档,升级策略又依赖很多部署没有的外部反馈。基于本文成果可延伸的:执行中动态调档,让 Agent 在遇到难度信号(反复验证失败、检索徒劳)时实时升档而非事后重跑整条轨迹;把 Act·ONOMY 标注出的验证/检索比例当作难度探测器训练路由器;在训练侧引入实例级单调性约束,使更高档位在分布上支配更低档位,从根上消除回归;把等待时间成本纳入评测排行榜,用 $C_{\text{full}}$ 替代纯 API 成本排序配置;以及研究跨档位缓存共享,降低升级时重放上下文的真实边际成本。
复现评估
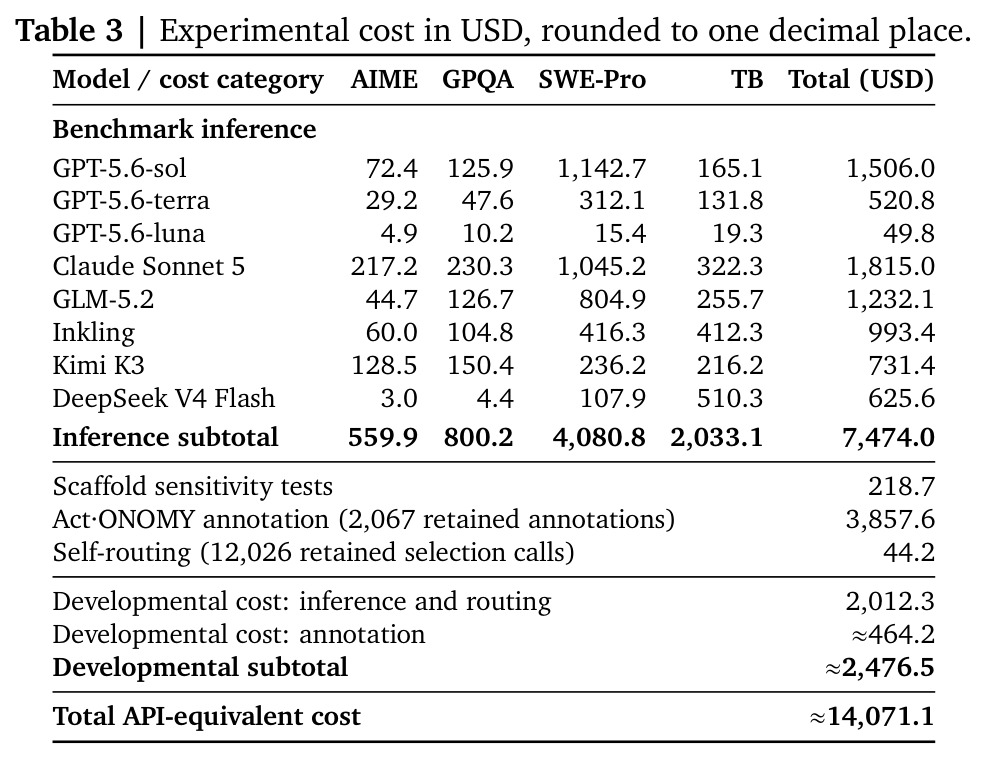
复现门槛较低。代码开源在 github.com/KaiserWhoLearns/ReasoningEffortLLM,四个基准全部公开(AIME 2026、GPQA Diamond、Terminal-Bench 2.1、SWE-Bench Pro),无需训练,本质是 API 编排加统计分析。主要成本是 API 调用:单轮基准上 8 模型 × 每档 × 每题 10 次(AIME)/4 次(GPQA),Agent 任务每档一次;专有模型需付费 API,开源模型主要经 Together AI。按论文给出的单题成本(如 SWE-Bench Pro 上 Claude 单题约 0.29–0.52 美元)估算,完整复现需数百至上千美元。修正版 SWE-Bench Pro 环境(删 git 历史、网络白名单)有描述但工程细节需自己补齐;行为标注需按 Act·ONOMY 原论文设置用 Claude Sonnet 5 跑。综合评估:中等难度,摩擦主要在成本与各供应商 effort 接口差异,而非技术本身。
论文图表