ChronoReplay:单一答案接口不足以支撑流式空间智能 ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence
按时间序回放异构空间监督并平衡接口损失,让单一模型同时提升三类流式空间基准
前置知识
视觉语言模型(VLM)与后训练
VLM 将视觉编码器与大型语言模型拼接,输入图像或视频帧加文本,以自回归方式生成文本回答,典型代表如 Qwen3-VL 系列。后训练(post-training/SFT)指在预训练基座上用指令-答案数据继续微调,使模型掌握特定任务的回答格式与能力。本文以官方 Qwen3-VL-8B-Instruct 为基座,只训练语言模型与视觉 merger,冻结视觉编码器。
论文的全部对照实验都建立在这个基座和训练范围上:所有可训练变体从同一 pinned revision 独立启动,理解哪些参数被训练、哪些被冻结是读懂实验设计的前提。
流式(因果)视频理解
模型按时间顺序逐段接收视频流,回答问题时只能使用当前时刻之前观察到的历史(因果前缀),不能偷看未来帧。StreamingBench、OVO-Bench 等基准将这种带时间戳的因果访问协议形式化;论文中用 $c_{ij} \preceq c_{i,j+1}$ 表示回合间前缀嵌套的因果包含关系。
本文全部设定建立在“同一因果历史”上:OVO-S、OST、UCS 三个基准都要求每个答案只依赖其合法因果前缀,这也是方法中“把目标挂回时间轴”的动机来源。
多任务学习与损失平衡
当多个任务的损失共享同一组参数时,数据量、答案长度、损失尺度都会决定谁对参数影响更大,需要归一化和显式加权来控制各任务贡献。常见做法包括不确定性加权、梯度手术、动态调度等;本文选择更简单的路线:在家族层面归一化风险后按固定比例 $\lambda=\alpha/(1+\alpha)$ 混合。
ChronoReplay 的家族平衡目标是多任务损失平衡思想在空间监督上的应用:不归一化时 33,180 条单轮样本会天然压过 6,381 条 episode,重现论文要解决的接口锁定问题。
负迁移与灾难性遗忘
在单一分布上微调会擦除其他分布上学到的能力(灾难性遗忘),或多任务目标竞争同一参数导致互相干扰(负迁移)。表现为:在自家任务上涨分、在相关任务上退化或停滞。这是多任务学习和指令微调混合文献中的经典现象。
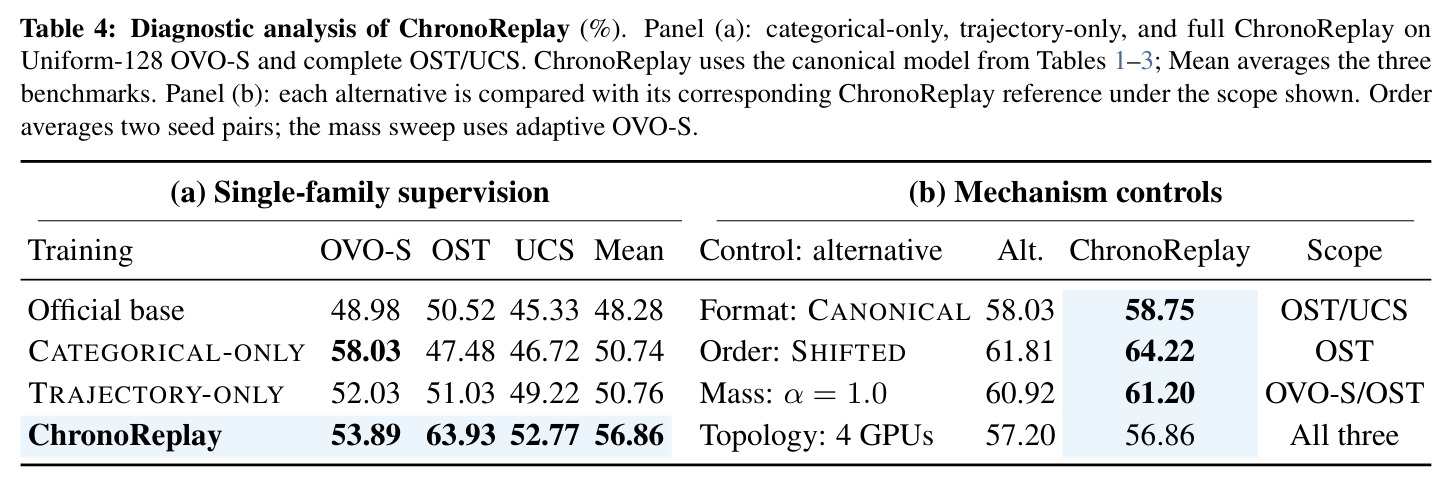
论文提出的“接口锁定”(interface lock-in)本质是空间读出之间的负迁移:类别-only 训练把 OVO-S 提到 58.03 却让 OST 从 50.52 跌到 47.48,识别这一现象是理解全文动机的钥匙。
指令数据构造:扁平化 vs 结构保留
把多轮标注转成 SFT 数据时有两种做法:扁平化为互相独立的问答对(每条样本只有自己的帧和问题),或保留原始时间顺序与上下文组织成 episode。答案如何序列化(保留原生单位/时间戳,还是统一成规范字段)同样改变模型学到的内容。
本文的核心贡献恰好在数据构造层面:时间序回放、原生格式保留、家族级控比,三者都对照常见的扁平化 QA 对做法,SHIFTED/CANONICAL 两组对照实验的设计也直接源于这两个维度。
研究动机
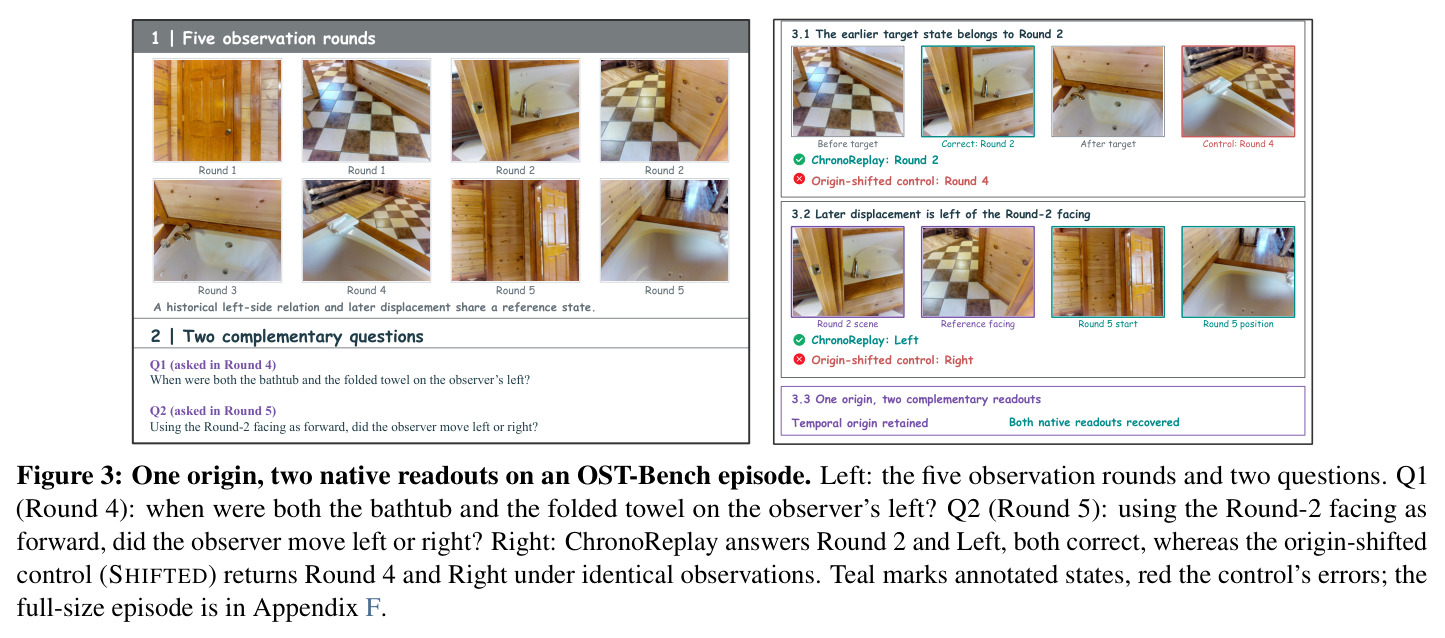
现有空间智能的后训练通常是“单接口”的:一套数据只监督一种答案格式(类别选项、带单位的数值、时间戳),然后在共享该格式的基准上报告成绩。论文用 Qwen3-VL-8B 做了诊断:仅用类别监督训练,OVO-S 从 48.98 涨到 58.03,但 OST 从 50.52 跌到 47.48;仅用轨迹监督训练,OST 几乎不动(51.03)。作者把这种“强项读出涨分、其他读出持平甚至退化”的经验现象命名为接口锁定(interface lock-in)。第二个问题是目标的歧义性:度量或时间目标只在产生它的历史下有效——观察者朝北前进后再问“之前看到的物体在哪”,与朝东前进后问同样的问题,近期观测和局部位移完全一样,答案却不同;若监督把目标与其合法因果前缀解耦(例如把多轮标注扁平化成独立 QA 对),目标本身就变得有歧义。此外,架构侧的流式模型(视觉记忆、有界 KV 缓存、场景图等)通常只服务单一接口,混合定性与度量问题的工作又只训练在单张静态图上,“一个模型能否在同一因果历史上同时服务类别、度量、时间戳三类查询”此前未被检验。
本文的目标是本文的目标是:不新增记忆模块、不新增标注,仅通过改变监督的组织方式,让一个 Qwen3-VL-8B checkpoint 在同一因果观测历史上同时提升三类答案接口的流式空间基准——类别型 OVO-S-Bench、度量型 OST-Bench、时间戳因果型 UCS-Bench。评测上坚持模型-only 的公平比较:所有对照在固定观测访问(OVO-S Uniform-128 帧、完整场景隔离的 OST 协议、全部 UCS 题目)下进行;同时把推理时的观测访问(自适应帧选择)作为正交因素单独分解,避免把系统收益记在训练头上。方法层面还要求回答机制归因问题:收益究竟来自原生格式、时间序、还是家族损失质量比?论文为此设计了 SHIFTED(只打乱顺序)、CANONICAL(只改答案序列化)、α 扫描(只改权重)等逐一可控的干预实验。
与已有工作不同的是,本文的独特切入是不造新架构,而是把“监督保留了哪些区分度、异构历史如何组织、目标挂在什么前缀上”当作第一研究对象。具体有三个此前没人系统做过的角度:其一,保留每个源接口的原生值空间(选项语义、单位与精度、时间戳),而不是把所有答案折叠成一种规范格式——因为答案格式本身会改变模型“看起来知道什么”;其二,把监督按源回合的视频时间轴重放成时间有序的 episode,每个目标附着在使其成立的因果前缀上(temporal-origin alignment),让模型在“同一 origin 不断增长的历史”上学习累积本身;其三,在家族层面归一化风险并显式设定质量比,而非让 token 数量或回合数决定影响力。这是把多任务学习的数据侧问题(混合什么、如何排序、如何加权)搬到流式空间智能上的首次系统检验:此前没有工作问过“类别、度量、时间戳三种格式在一个因果流上联合训练是否互相干扰”。
核心方法
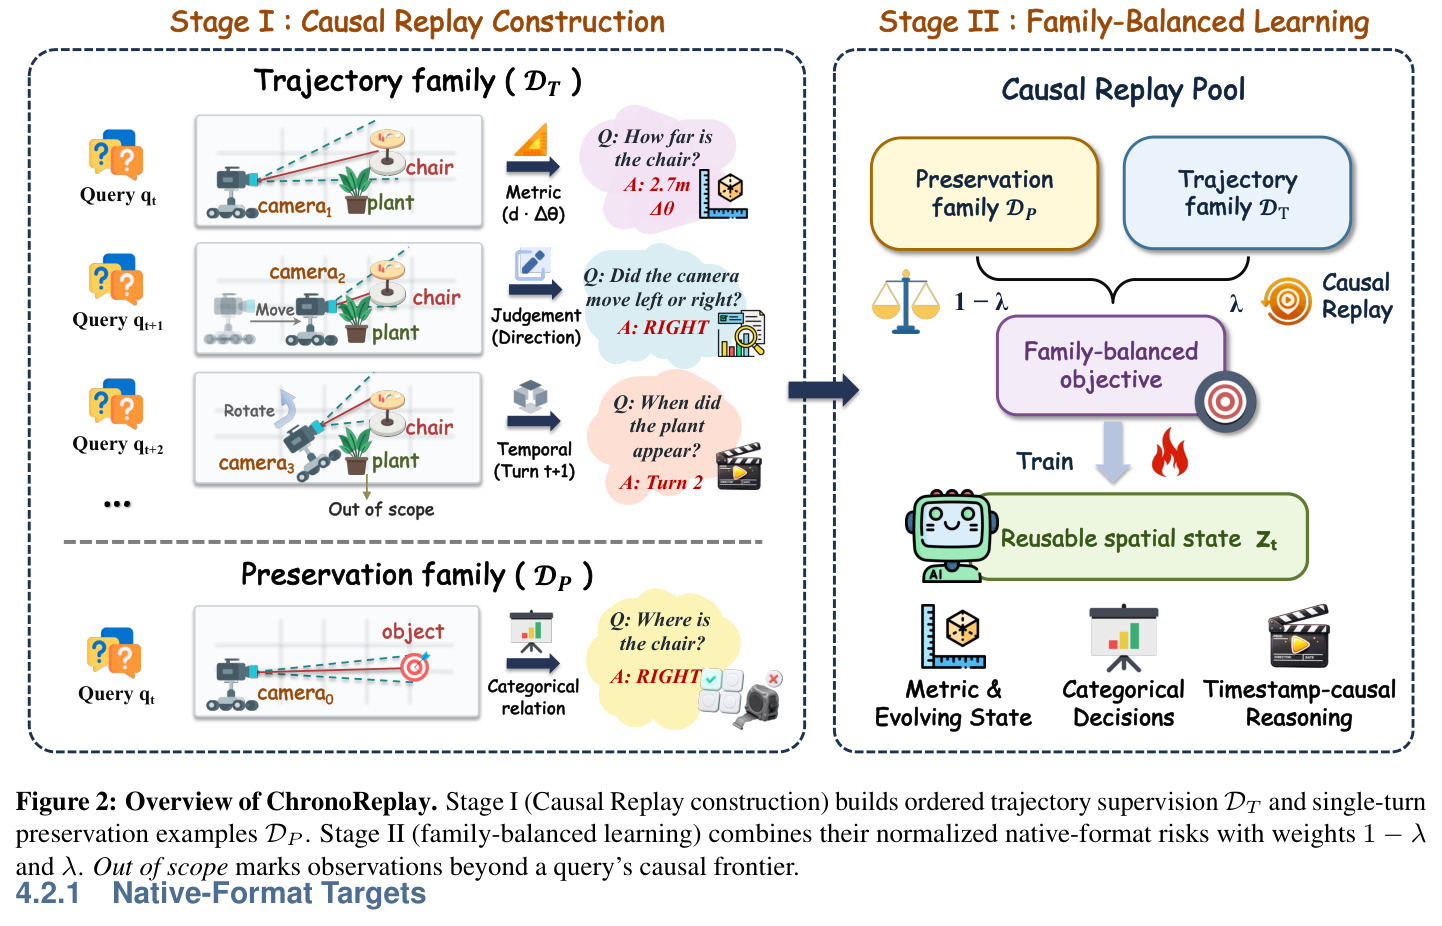
直觉来自一个场景:家用机器人陪你走一遍公寓后,要回答“镜子在我左还是右”(选项)、“沙发离这儿多远”(米数)、“什么时候经过植物”(回合/时间戳)——一次行走、三种答案形式,必须共享同一个隐式状态 $z_t=\mathcal{F}_\theta(h_t)$。ChronoReplay 分两阶段:阶段 I(Causal Replay Construction)构造回放池,所有目标保留源原生格式,所有监督按原始时间顺序组织成 episode,每个目标 $y_{ij}$ 附着在合法因果前缀 $c_{ij}$ 上,前缀满足 $c_{ij}\preceq c_{i,j+1}$。阶段 II(Family-Balanced Learning)在家族层面归一化损失并显式控比例:$\mathcal{L}_{replay}=(1-\lambda)\mathcal{L}_P+\lambda\mathcal{L}_T$,$\lambda=\alpha/(1+\alpha)$,主实验 $\alpha=0.5$,即轨迹家族占 1/3、保留家族占 2/3。训练只更新 Qwen3-VL-8B 的语言模型与视觉 merger(视觉编码器冻结),并用规范场景隔离保证测试场景不进训练。全程不添加地图、记忆模块或辅助状态损失,隐式状态轨迹完全留在 VLM 内部,与架构侧工作天然互补。
核心创新是与已有方法的三点本质区别。第一,原生格式目标:接口 $\kappa$ 的读出风险 $R_\kappa=\mathbb{E}[-\log G_\kappa(Y^\kappa\mid Z,Q)]$,固定表征时最优风险等于条件熵 $H(Y^\kappa\mid Z,Q)$,低风险要求表征保留恢复原生目标所需的全部信息——把答案统一折叠成规范格式可能丢掉接口本身承载的区分度;CANONICAL 对照发现的 OST/UCS 交叉效应印证了这一点。第二,时间序回放:episode $E_i=(c_{ij},q_{ij},y_{ij},\kappa_{ij})_{j=1}^{m_i}$ 前缀嵌套,模型在共享 origin、逐回合增长的历史上学习累积本身,而非孤立快照——这是与“扁平化成独立 QA 对”的普通 SFT 的本质区别,SHIFTED 对照证明仅打乱顺序就损失约 2.41 个 OST 点。第三,家族平衡目标:显式设定 $\mathcal{L}_P$ 与 $\mathcal{L}_T$ 的质量比,把答案长度(每回合平均 token 损失)、监督频率(回合等权)与家族体量(家族级控比)三个混杂因素解耦,避免类别样本以 33,180 条的规模优势在联合训练内部重现接口锁定。
方法步骤详情
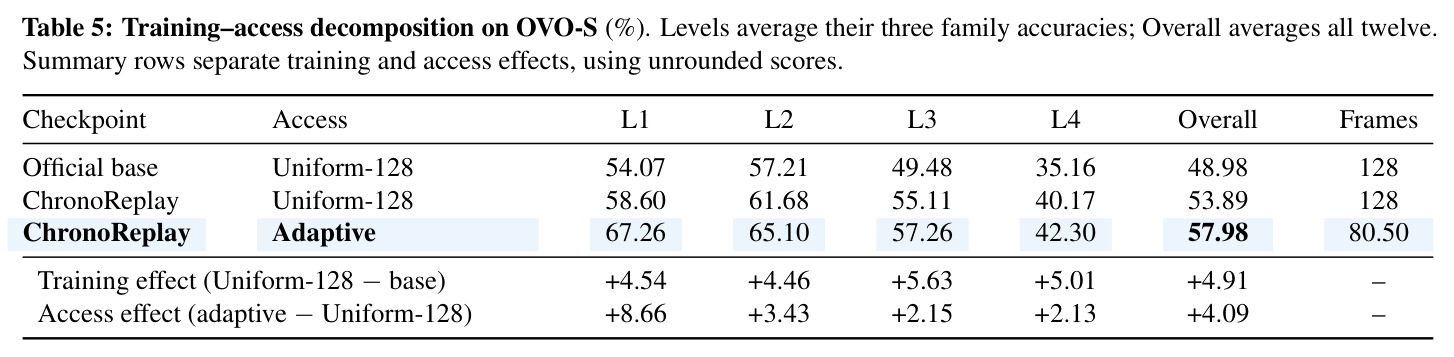
第一步,构造保留家族 $\mathcal{D}_P$:33,180 条单轮样本(30,635 类别 + 2,545 数值),每条带源定义权重 $w_r$,目标保持原生格式(选项集合、带单位与精度的数值)。第二步,构造轨迹家族 $\mathcal{D}_T$:6,381 条时间有序 episode,共 45,006 个受监督回合(度量、计数、判断、时间戳),回合 $j$ 的目标挂在合法因果前缀 $c_{ij}$ 上,单轮样本即 $m_i=1$。第三步,计算家族风险:$\mathcal{L}_P=\frac{\sum_{r\in\mathcal{D}_P}w_r\ell^P_r}{\sum_{r\in\mathcal{D}_P}w_r}$,$\mathcal{L}_T=\frac{1}{|T|}\sum_{(i,j)\in T}\ell^T_{ij}$,$T$ 为全部受监督轨迹回合集合。第四步,组合为 $\mathcal{L}_{replay}=(1-\lambda)\mathcal{L}_P+\lambda\mathcal{L}_T$,$\lambda=\alpha/(1+\alpha)$,$\alpha=0.5$;轨迹家族内回合等权,每回合贡献平均 token 损失以防长答案主导。第五步,从固定的官方 Qwen3-VL-8B-Instruct revision 出发训练语言模型与视觉 merger,视觉编码器冻结,规范场景身份确保测试场景在训练之外。第六步(正交增强),在同一 checkpoint 上应用推理时自适应帧选择,平均帧数 128→80.50,获得额外涨分。
技术新颖性
技术新颖性有四点。其一,首次命名并系统记录“接口锁定”现象:单家族训练在自家读出涨分、其他读出退化(类别-only:OVO-S 58.03 但 OST 跌到 47.48),作者明确声明这是经验模式而非内部机制刻画,表述克制。其二,temporal-origin alignment 是纯数据构造规则而非新模块:不改架构、不加记忆、不加辅助损失,与保留流式的架构工作(视觉记忆、有界缓存、场景图)正交互补。其三,机制归因的实验设计严谨:CANONICAL 是保持目标内容不变的无损序列化干预,SHIFTED 只动顺序不动内容,两者分离出格式与顺序的独立贡献——结果是有趣的交叉:NATIVE 在 UCS 高 2.92 点、两基准均值 58.75 对 58.03,CANONICAL 在 OST 高 1.48 点,说明答案格式是在端点之间重新分配收益而非普适更优,作者拒绝过度声明。其四,把观测访问作为正交因素分解(训练 +4.91 与自适应访问 +4.09 分开报告),并用配对种子、四 GPU 拓扑复现(差 0.34 点内)等手段控制方差,这种“每个成分单独一个对照”的做法在后训练论文中少见。
实验结果
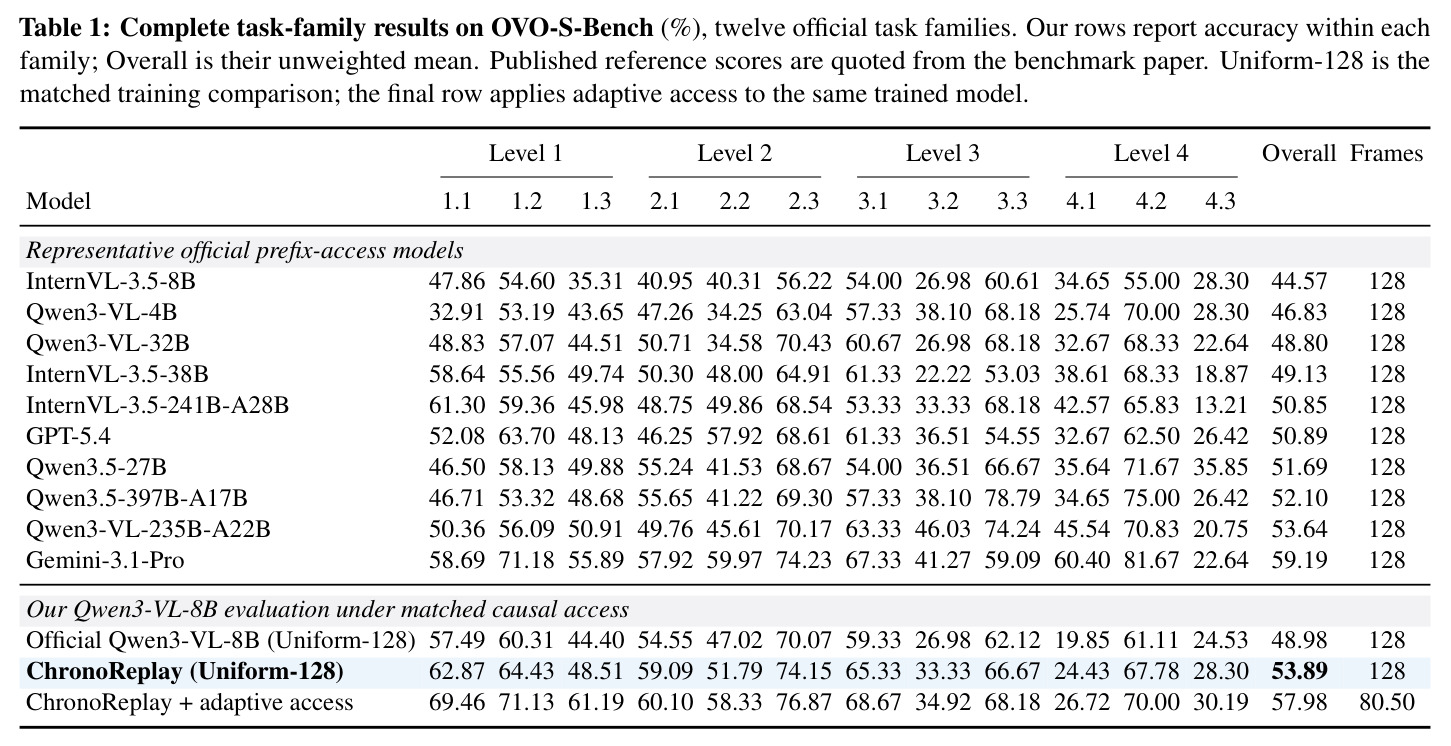
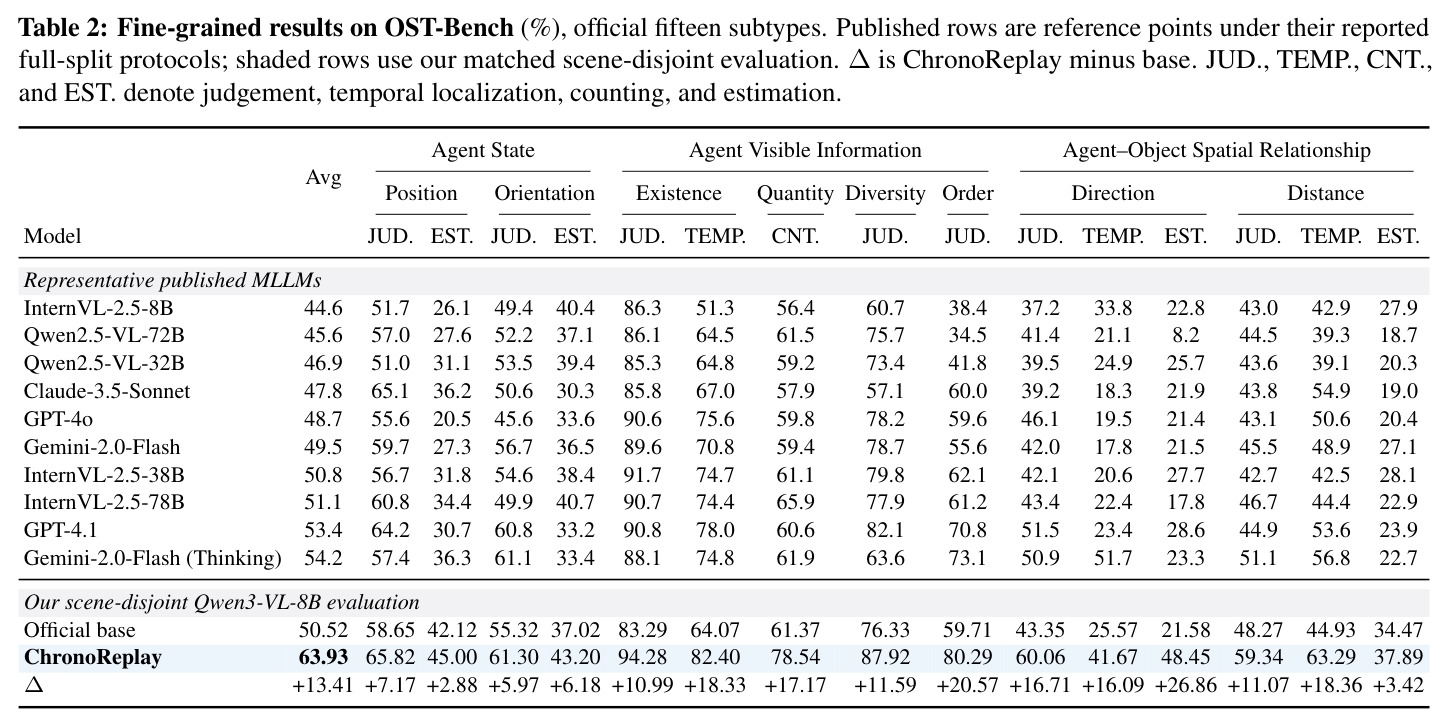
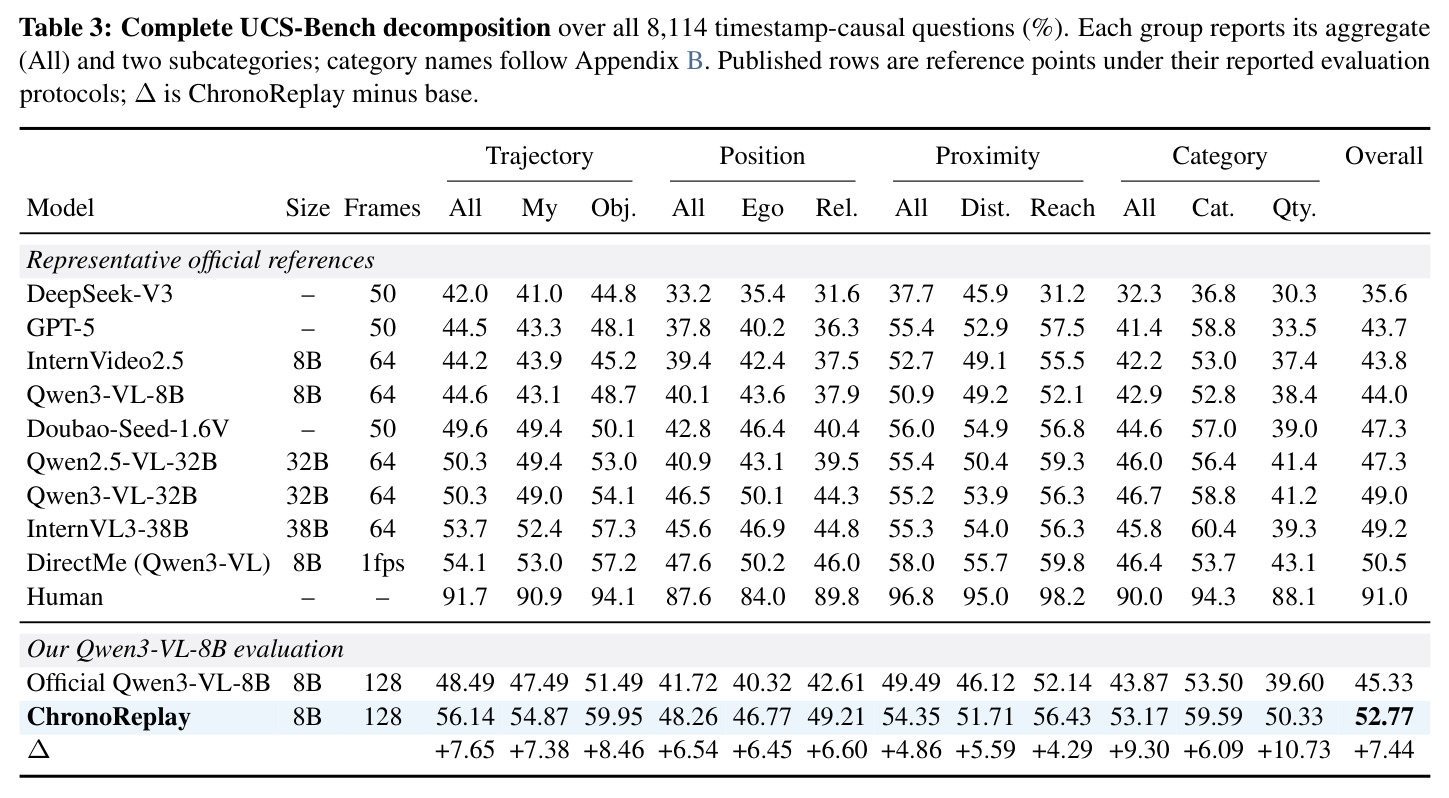
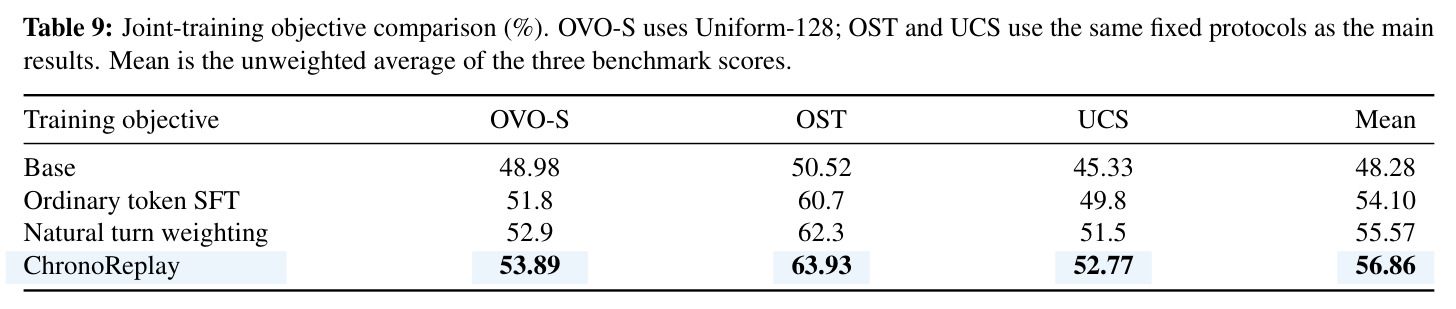
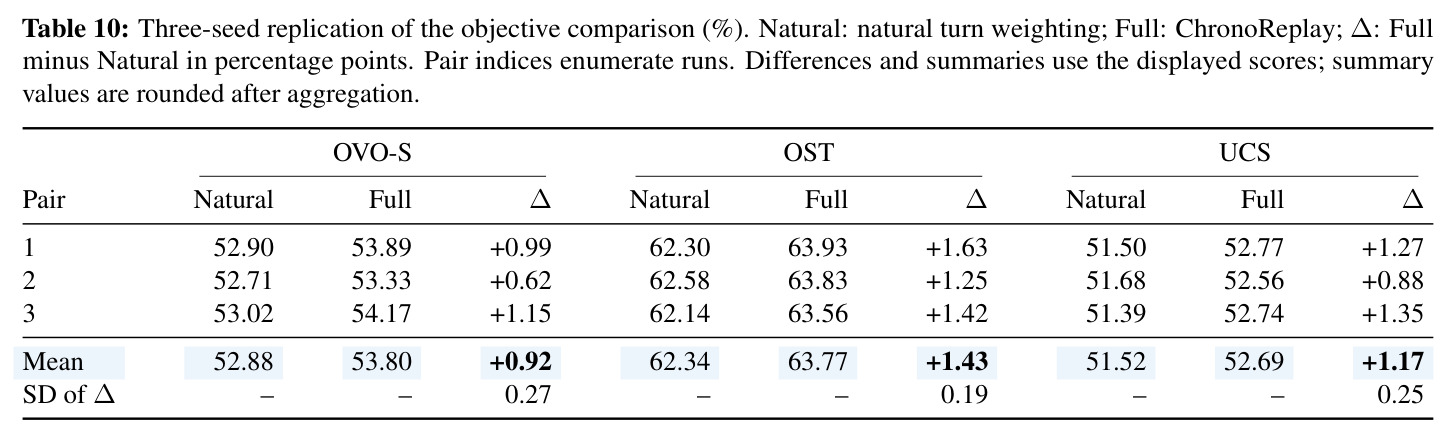
RQ1 跨接口迁移(固定 Uniform-128 观测):OVO-S 48.98→53.89(+4.91),12 个任务家族全正,追平 Qwen3-VL-235B-A22B 的 53.64;OST 50.52→63.93(+13.41),15 个子类型全正,方向估计 +26.86、顺序判断 +20.57、距离时间定位 +18.36,收益集中在需多回合累积状态的题目;UCS 45.33→52.77(+7.44),8 个子类全正,数量 +10.73、物体轨迹 +8.46。RQ2 单家族诊断:类别-only 均值 50.74、轨迹-only 50.76,ChronoReplay 三基准均值 56.86(53.89/63.93/52.77)最高。RQ3 机制对照:SHIFTED 在两个配对种子下分别落后 2.42/2.41 个 OST 点(均值 2.41);NATIVE 在 UCS 高 2.92 点(两基准均值 58.75 对 58.03),CANONICAL 在 OST 高 1.48 点;对比同池普通 token SFT(51.8/60.7/49.8,均值 54.10)与自然回合加权(52.9/62.3/51.5,均值 55.57),ChronoReplay 全端点更高,三配对种子平均配对增益 OVO-S 0.92±0.27、OST 1.43±0.19、UCS 1.17±0.25;α=0.5 的 OVO-S/OST 均值 61.20 优于 α=1.0 的 60.92;四 GPU 复现差 0.34 点内。RQ4 访问分解:训练效应 +4.91(L4 也 +5.01),自适应访问在固定模型上再 +4.09(L1 最大 +8.66),帧数 80.50,系统总分 57.98。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式类别空间推理(OVO-S-Bench,12 个官方任务家族,Uniform-128 因果访问) | 总体准确率(%,12 家族无权平均) | 53.89(ChronoReplay);57.98(+自适应访问,平均 80.50 帧) | 官方 Qwen3-VL-8B(Uniform-128):48.98;发布参考 Qwen3-VL-235B-A22B:53.64 | +4.91,全部 12 个家族为正,8B 模型追平 235B 参考 |
| 多回合探索下的连续状态估计(OST-Bench,官方 15 子类型,场景隔离协议) | 总体准确率(%) | 63.93 | 官方 Qwen3-VL-8B:50.52 | +13.41,15 个子类型全正;方向估计 +26.86、顺序判断 +20.57、距离时间定位 +18.36 |
| 时间戳因果推理(UCS-Bench,全部 8,114 题,128 帧) | 总体准确率(%) | 52.77 | 官方 Qwen3-VL-8B:45.33(发布参考中最好的 DirectMe 为 50.5,32B/38B 为 49.0–49.2) | +7.44,8 个子类全正;数量 +10.73、物体轨迹 +8.46 |
| 三基准均值(单家族监督对照,Uniform-128 OVO-S + 完整 OST/UCS) | OVO-S/OST/UCS 三者平均 | 56.86(ChronoReplay) | 类别-only:50.74;轨迹-only:50.76 | 约 +6.1,且无单家族设置在任何基准组合均值上占优 |
局限与改进
作者承认的局限:接口锁定是经验模式而非内部机制刻画;单家族诊断中两个变体的源与任务覆盖不同,无法把差异完全归因于答案格式本身(附录 D.7);NATIVE 与 CANONICAL 在 OST/UCS 上的交叉效应说明原生格式并非普适更优的编码;自适应访问是系统效应,完整配方的 +13.41 中时间序只贡献约 2.41 点,作者明确拒绝把全部增益归于单一成分;评测只覆盖室内场景,其他环境未测试;OVO-S L4 层虽从 35.16 提到 40.17(加自适应访问 42.30),仍是最低分段。我的观察:所有结果只在 Qwen3-VL-8B 一个基座上验证,规模与架构外推未知;收益高度依赖源标注的几何确定性与质量,迁移到弱标注域存疑;三个基准的答案格式与训练数据同源,可能存在格式先验带来的“应试”成分,跨基准的真正泛化需要更多第三方基准佐证;与发布模型的对比各自沿用其原始协议,只有 Qwen3-VL-8B 内部对比是严格 matched 的;最终系统数字(如 57.98)混合了训练与访问两种效应,引用时容易被误读。
独立分析的弱点
第一,成分归因不完全:+13.41 的 OST 提升中顺序对齐只贡献 2.41 点,其余来自原生格式、家族权重与数据覆盖的组合,无法进一步分离。改进方向:构造内容完全相同、只在单一成分上差异的全因子网格(格式×顺序×权重),并加入更多种子。第二,接口锁定的诊断被混杂因素污染:两个单家族变体的数据源与任务覆盖不同,作者自己也在附录 D.7 承认。改进方向:从同一源数据切分出覆盖匹配的纯类别/纯轨迹子集做严格受控对照,或用合成数据精确控制两类监督的几何内容。第三,格式选择缺乏原则性答案:NATIVE 与 CANONICAL 交叉意味着实践者不知道新任务该选哪种。改进方向:按查询类型在解码时做格式路由,或训练时混合格式并学习逐样本选择策略。第四,视觉编码器全程冻结:空间几何信息的天花板可能受限于编码器表征。改进方向:部分解冻视觉塔或引入几何感知目标(深度、位姿辅助损失),同时监控是否加剧接口干扰。第五,评测与验证范围窄:仅室内场景、仅 8B 规模、仅三个与训练格式同源的基准。改进方向:扩展到户外/大尺度场景、32B 级基座,以及与训练数据格式无关的第三方空间基准。
未来方向
作者明确指出的方向:把观测访问与训练进一步联合——当前自适应帧选择是训练后固定的推理策略,作者把它定位为正交因素,下一步自然是学习式证据访问(模型自己决定看哪些帧)并与训练目标联合优化;在多任务理论视角下研究哪些空间区分度能在共享表征中幸存(正文引用了多任务学习、指令混合与遗忘文献),为接口锁定寻找机制解释。基于本文成果可延伸的方向:其一,将 ChronoReplay 与架构侧记忆模块(视觉记忆、场景图、有界 KV 缓存)叠加,检验“正交因素”是否真可加;其二,把固定 $\lambda$ 换成按验证信号或梯度冲突动态调度的家族权重;其三,把时间序回放思想推广到其他流式能力(音频事件、操作序列、多智能体轨迹);其四,针对仍是最低分段的 L4 层(42.30)做失败模式驱动的数据增补,正文已给出一个固定观测下的 L4 布局失败案例作为线索;其五,评测扩展到户外、大尺度与数小时长时程场景,检验 origin 对齐在更长历史下的可扩展性。
复现评估
开源情况良好,属于后训练论文中复现条件较完备的一类。资源三件套齐全:代码、配置、冻结的训练选择清单与评分脚本在 GitHub(yihaohu0118/ChronoReplay),项目主页提供论文与资源总览,模型权重与转换后的训练标注通过单个 Hugging Face collection 发布;数据发布保留了冻结样本顺序、原生目标、训练权重与监督掩码,但不捆绑原始媒体与保存的预测。附录 B–I 给出评测契约、回放数据、场景隔离、优化设置、四 GPU 复制实验以及可执行配置、生成参数、评分器契约和源清单。所有可训练对照都从同一 pinned 的 Qwen3-VL-8B-Instruct revision 独立启动,无中间续训或模型融合;四 GPU 重训与八 GPU 的三基准均值差 0.34 点内,说明对算力拓扑不敏感。复现门槛:需要 4–8 张高端 GPU 训练 8B 模型(视觉编码器冻结降低了显存压力)、搭建三个基准的评测管线,并自行获取源视频媒体(发布数据不含原始视频);由于标注清单完整、种子配对实验可复跑,总体属于中等偏低难度。
论文图表
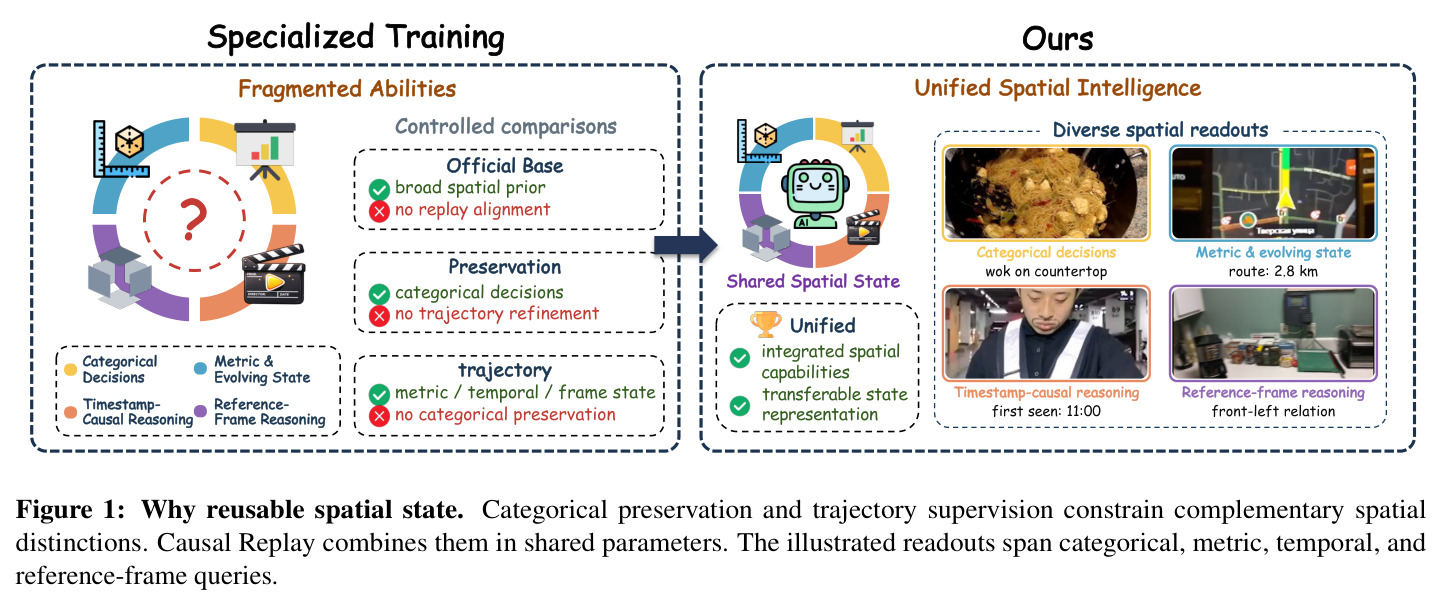
对比图:左侧“Specialized Training”产生碎片化能力(类别决策、度量与演化状态、因果推理、参考系/帧推理各自为政,缺回放对齐、轨迹精化与类别保持),右侧“Ours”在共享空间状态上形成统一空间智能,支持多样空间读出;中间是控制实验与官方基座的对比逻辑。
一张图讲清论文的核心论点:为什么需要可复用的空间状态,以及单接口专门化与统一训练的差别,是理解动机的最佳入口。