记忆税:剖析智能体记忆的净价值 Memory Tax: Dissecting the Net Value of Agent Memory
以朴素RAG为参照,把智能体记忆的价值分解为收益与税收,发现许多记忆系统净值为负
前置知识
RAG(检索增强生成)
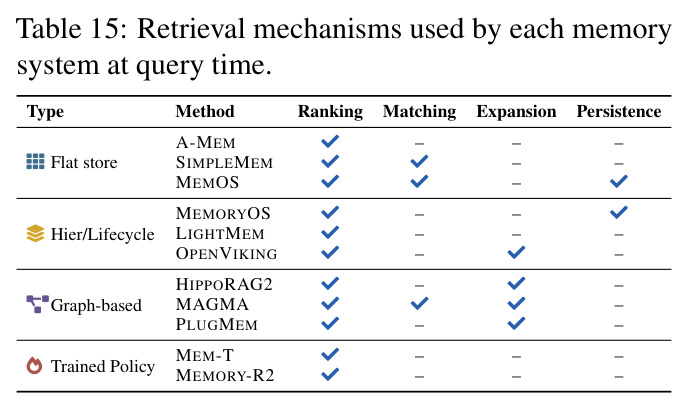
把外部语料切块建立索引,查询时由 BM25 等词法检索与 embedding 稠密检索各自召回候选,合并去重后交重排器打分,再把 top-k 块塞进 LLM 上下文生成答案。本文的 naive RAG 采用会话 turn 级、约 1024 字符 buffer 合并切块,混合检索加 Qwen3-Reranker-0.6B 重排,单轮/双轮两种变体。
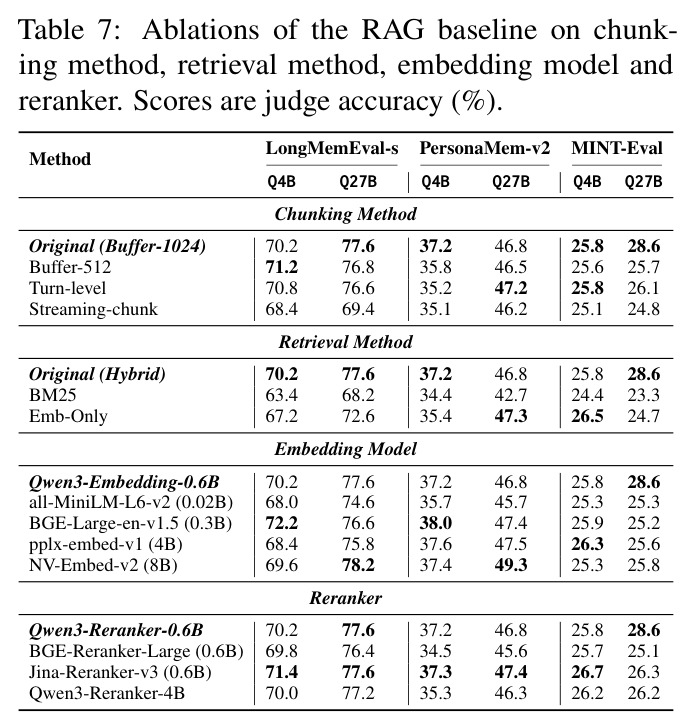
全文所有结论都以 naive RAG 为参考零点,不熟悉其切块、检索、重排流程,就无法理解 Retrieval Scope 对齐、RAG(1rd/2rd) 差异以及附录 B 的消融实验为何重要。
智能体长期记忆(Agent Memory)
为跨越单次上下文窗口限制而设计的持久化存储:把交互历史经抽取、摘要、重构等构建过程 ingest 成事实条目、分层摘要、知识图谱或文件树等记忆单元,查询时检索相关单元注入上下文。本文按存储组织方式覆盖扁平存储、层级/生命周期、图结构、训练策略四大类共 13 个系统。
这些系统正是论文的解剖对象,理解它们的构建与检索机制,才能看懂记忆税在哪个环节产生。
LLM-as-Judge
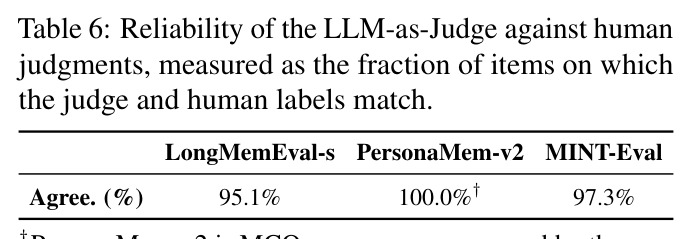
用 LLM 替代人工为生成答案打分的评测方式。本文用 Qwen3.6-27B 判断答案与 gold 是否一致,刻意弃用 F1/BLEU 等词面指标以免惩罚正确的改写;三个基准上与人工标注的一致率分别为 95.1%、100%、97.3%。
论文所有准确率数字均出自该 judge,其模型选择与配置(temperature 0、关闭推理)直接决定结论可信度,附录还报告了与人工的比对。
Retrieval Scope(检索范围)
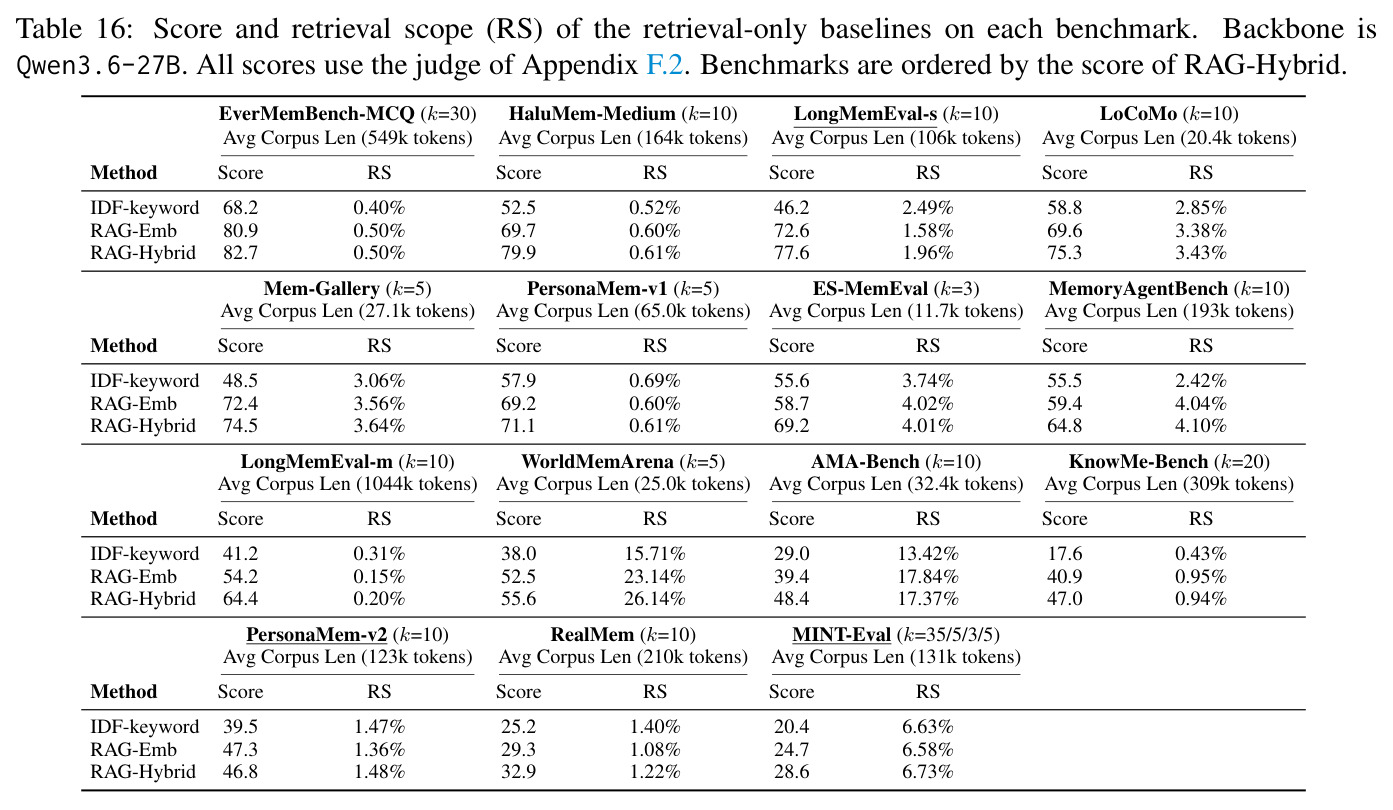
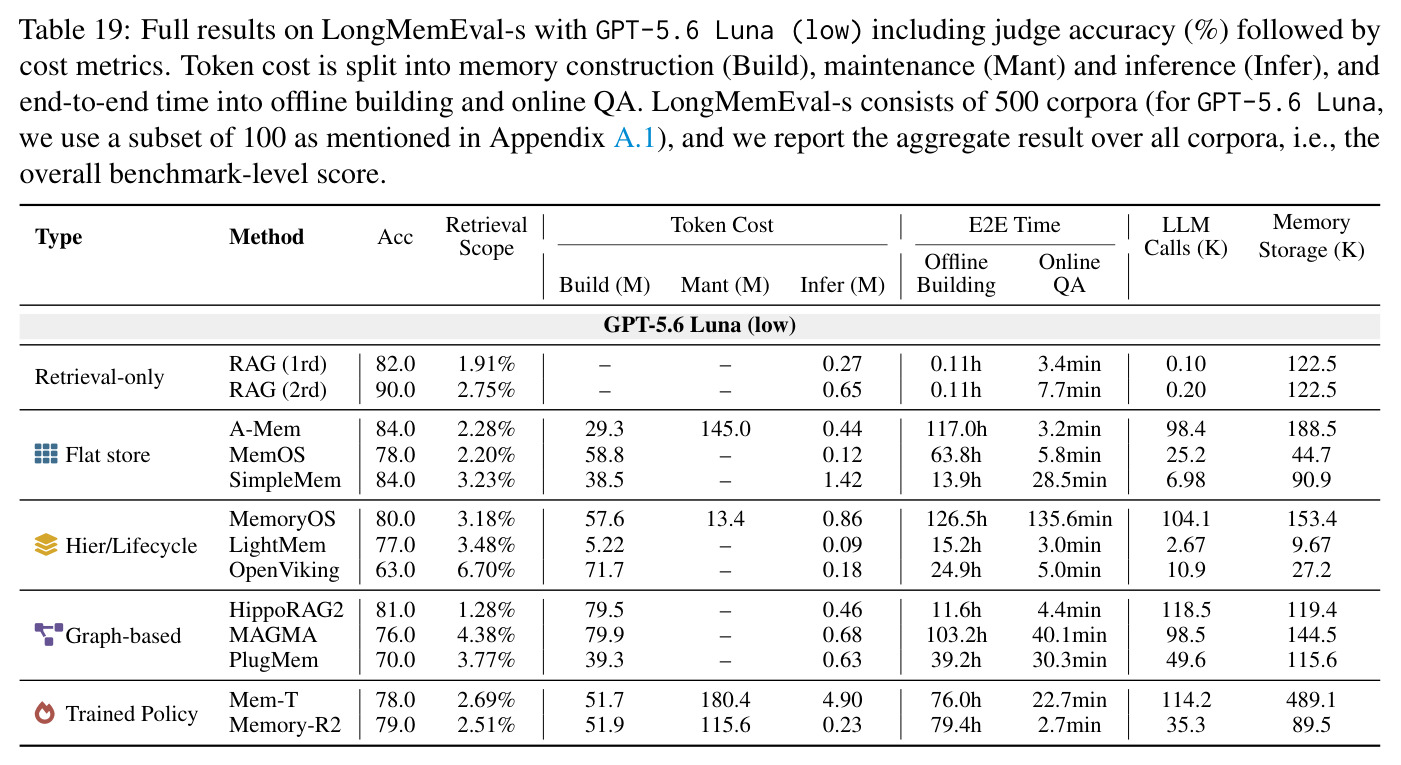
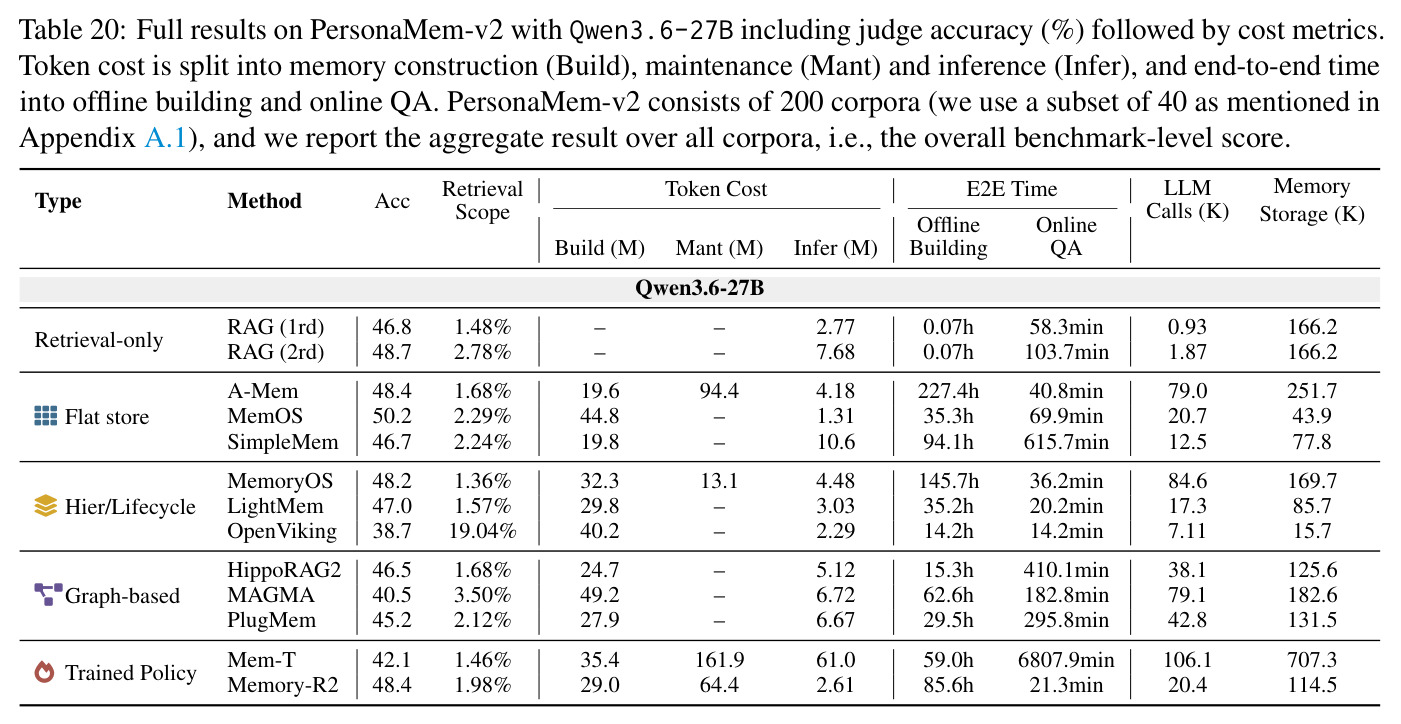
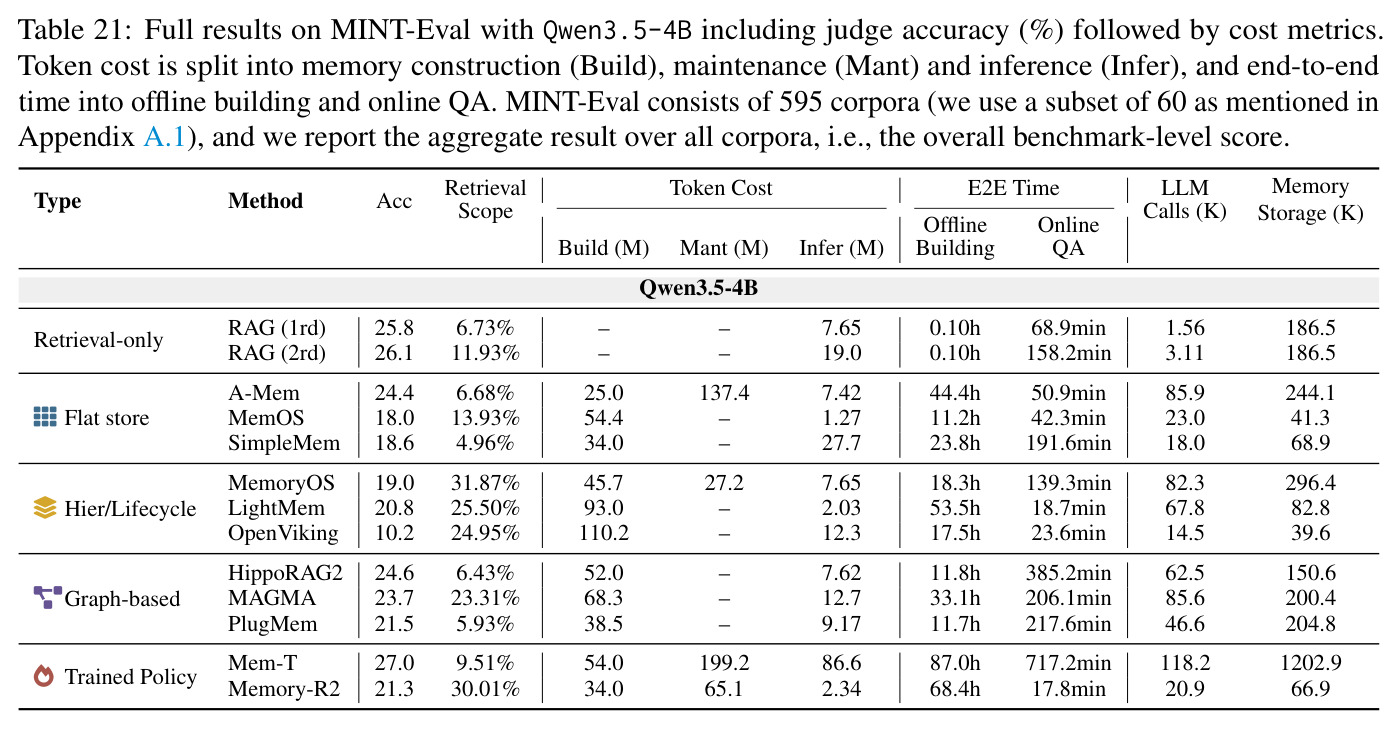
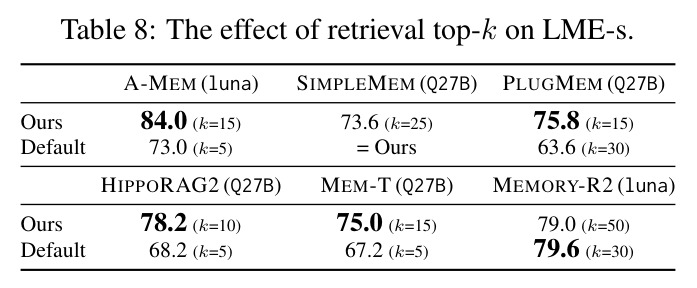
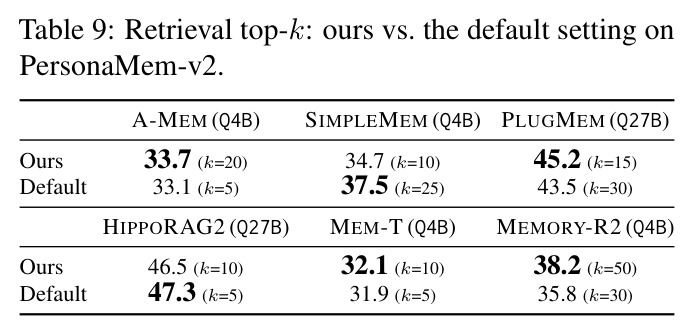
不同记忆系统的记忆单元粒度差异巨大(从一行事实到整段会话摘要),同样的 top-k 暴露给 LLM 的信息量天差地别。RS 定义为从检索到答题全过程中 LLM 实际看到的 token 数占系统可检索存储总 token 的比例,据此调整各系统 top-k,使其检索预算不低于 RAG 单轮且彼此大致相当。
这是本文实现公平比较的关键协议,不理解 RS 就无法判断主表对比是否系统性偏袒或亏待某个记忆系统。
语义相似度与相似度漂移
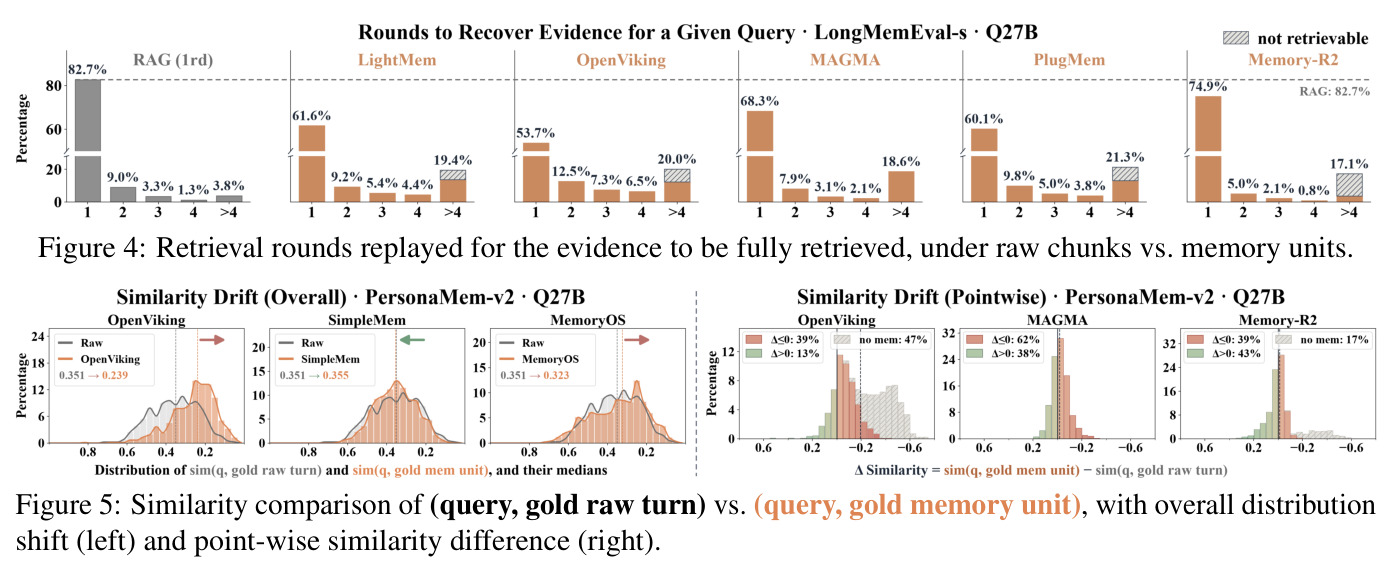
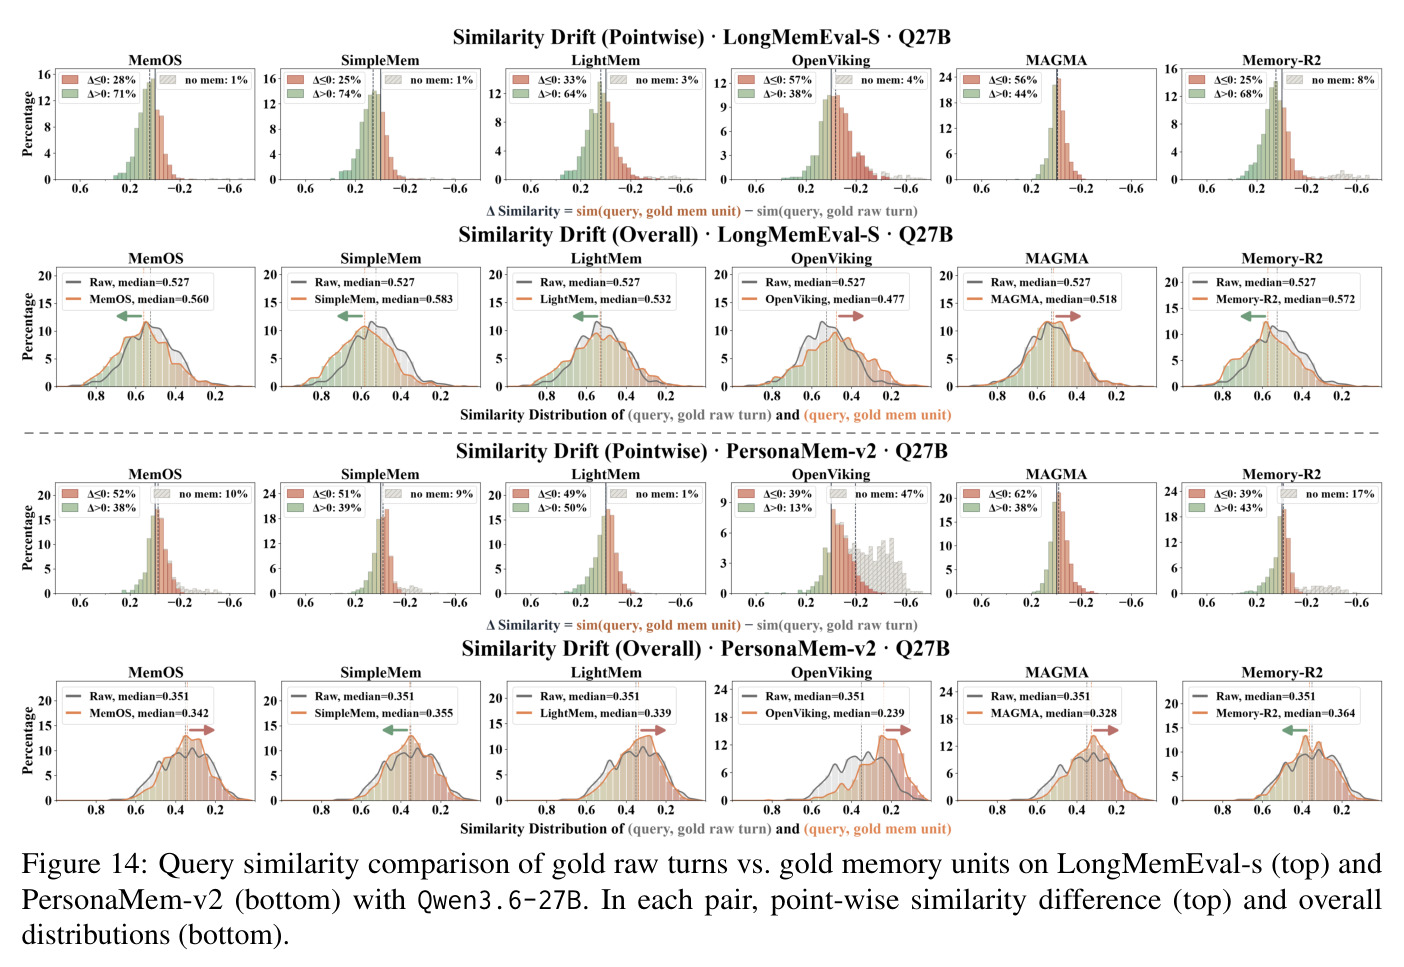
embedding 模型把查询和文档映射到同一向量空间,以余弦相似度 $\mathrm{sim}(q,d)$ 衡量相关性,检索质量高度依赖查询与证据的向量对齐。本文对比 query 与 gold raw turn、gold memory unit 的相似度,发现记忆构建会让同一证据的向量偏离查询分布,即相似度漂移。
可访问性分析的核心证据就是这种漂移,它解释了信息明明存进了记忆却检索不到的现象。
PSNR/SSIM/LPIPS
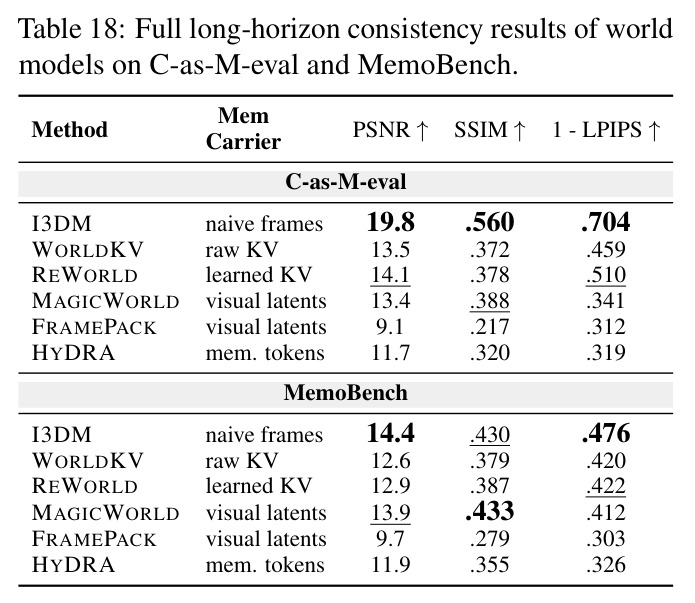
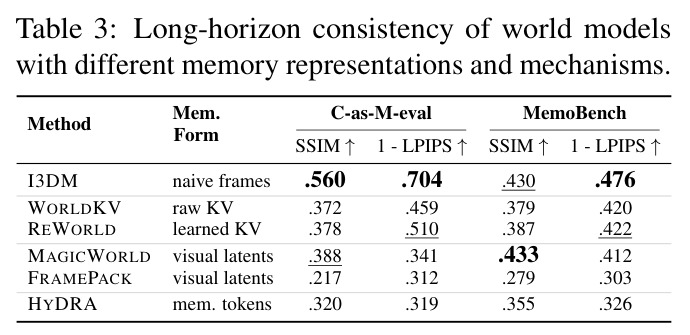
三个图像质量指标:PSNR 峰值信噪比衡量像素级误差,SSIM 衡量结构相似性,LPIPS 是深度特征感知距离(常报 $1-\mathrm{LPIPS}$,越大越像)。三者均为越高越好,常用于视频生成与世界模型评测。
论文 5.2 节用这三个指标量化世界模型长时程场景一致性(生成帧与原始视角对比),不认识它们就读不懂 Table 3/18。
研究动机
长时程 LLM 智能体几乎都在堆记忆:MemOS、A-MEM、MemoryOS、HippoRAG2、OpenViking、LightMem 等系统分别用抽取事实、分层生命周期、知识图谱、文件树组织对话历史,构建动辄多次 LLM 调用、token 开销成倍增长。但作者调查发现,这些工作大多只和其它记忆系统比较:在本文复现的 11 篇有影响力记忆论文中,只有 3 篇(LightMem、PlugMem、Mem-T)报告了 RAG 结果,其余要么没有检索基线,要么配置语焉不详(如 LightMem 用 all-MiniLM-L6-v2 却不说明检索预算,Mem-T 用 BGE-M3 top-5 却不说明切块策略)。而在 LongMemEval-s(每题约 115k token 对话史)、PersonaMem-v2(约 123k)、MINT-Eval(约 139k)这类典型规模上,「把原始历史切块后直接混合检索加重排」这一最朴素的做法能拿多少分一直缺乏可信答案。缺少这个参照,记忆系统的分数就无法区分是「组织信息的功劳」还是「检索本身的功劳」,复杂度是否值得也无从判断,记忆的真实净价值被系统性高估。
本文的目标是本文要回答一个基础问题:相对于直接从原始历史做朴素 RAG,构建记忆的净价值(net value)到底是多少?目标分四层:第一,在 3 个对话记忆基准(LongMemEval-s、PersonaMem-v2、MINT-Eval)× 3 个骨干模型(Qwen3.5-4B、Qwen3.6-27B、GPT-5.6-luna low)上,对 4 类共 13 个代表性开源记忆系统与 RAG(单轮/双轮)做受控对比,统一 embedding、重排器、judge 和检索预算;第二,把净价值逐 query 分解为 memory benefit(记忆答对而 RAG 答错的题)与 memory tax(记忆答错而 RAG 答对的题)并量化;第三,从忠实性(信息是否存得住)、可访问性(存住的能否查得到)、鲁棒性(换骨干是否崩)三个维度定位税的来源,并揭示评测侧因素(benchmark headroom)如何放大税感;第四,把该视角推广到经验记忆与世界模型记忆,并给出能直接套在现有系统上、不引入新架构的减税设计。
与已有工作不同的是,独特之处是视角反转。先前工作把记忆当作纯粹的增益(augmentation),报告绝对分数或与其它记忆系统的相对分数;本文把 naive RAG 设为参考零点,把记忆理解为「对原始历史的偏离(deviation)」——任何非平凡的记忆加工都改变了信息被组织和访问的方式,这种偏离天生是双刃剑:既有设计意图内的收益(把散落事实归位、把顺带提到的偏好显式化、把相对时间锚定到绝对日期、执行遗忘请求),也有设计副作用(证据被删、被碎片化、被改写后与查询的相似度漂移)。由此提出 memory tax 概念,把注意力从「记忆能加多少分」转到「记忆会丢多少分」,并首次指出评测侧因素——大量基准题目本身检索友好、提升空间有限——会让税收更显眼。该框架不绑定任何记忆形态,因此能统一解释对话记忆、经验记忆、世界模型记忆三个领域里「复杂记忆打不过朴素检索」的同构现象。
核心方法
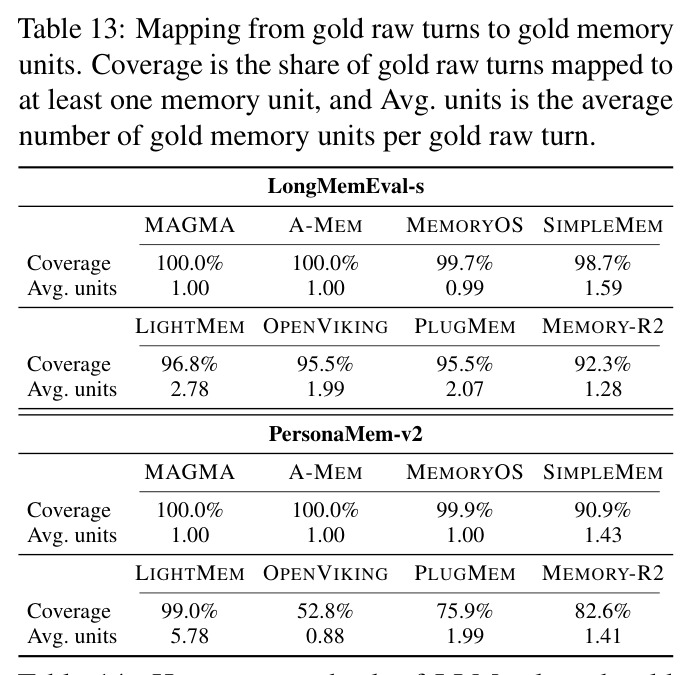
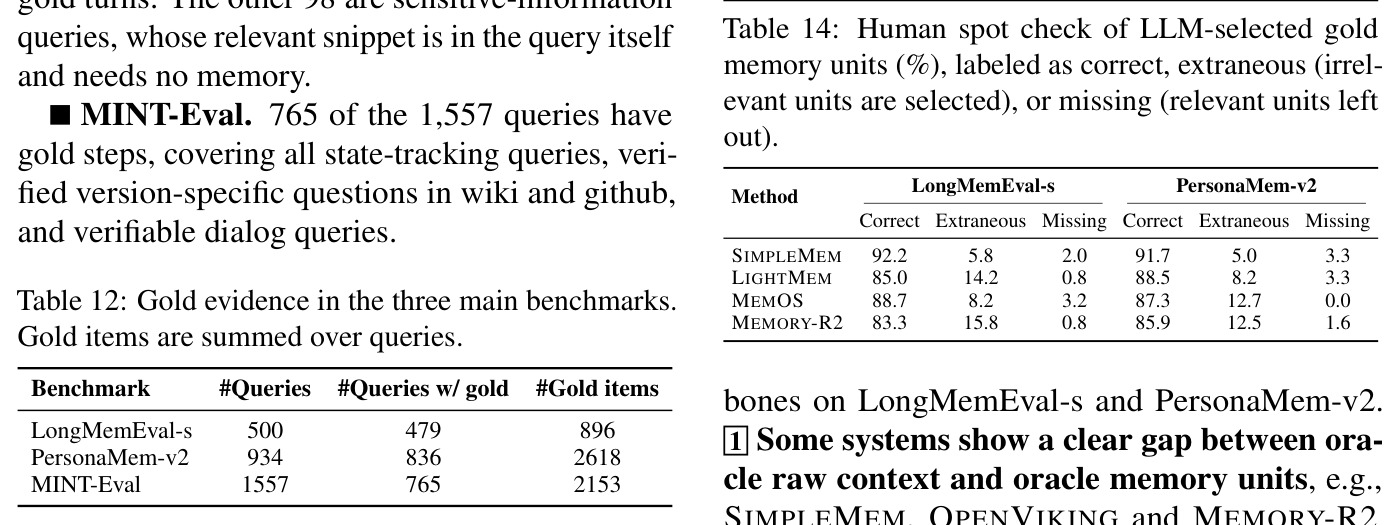
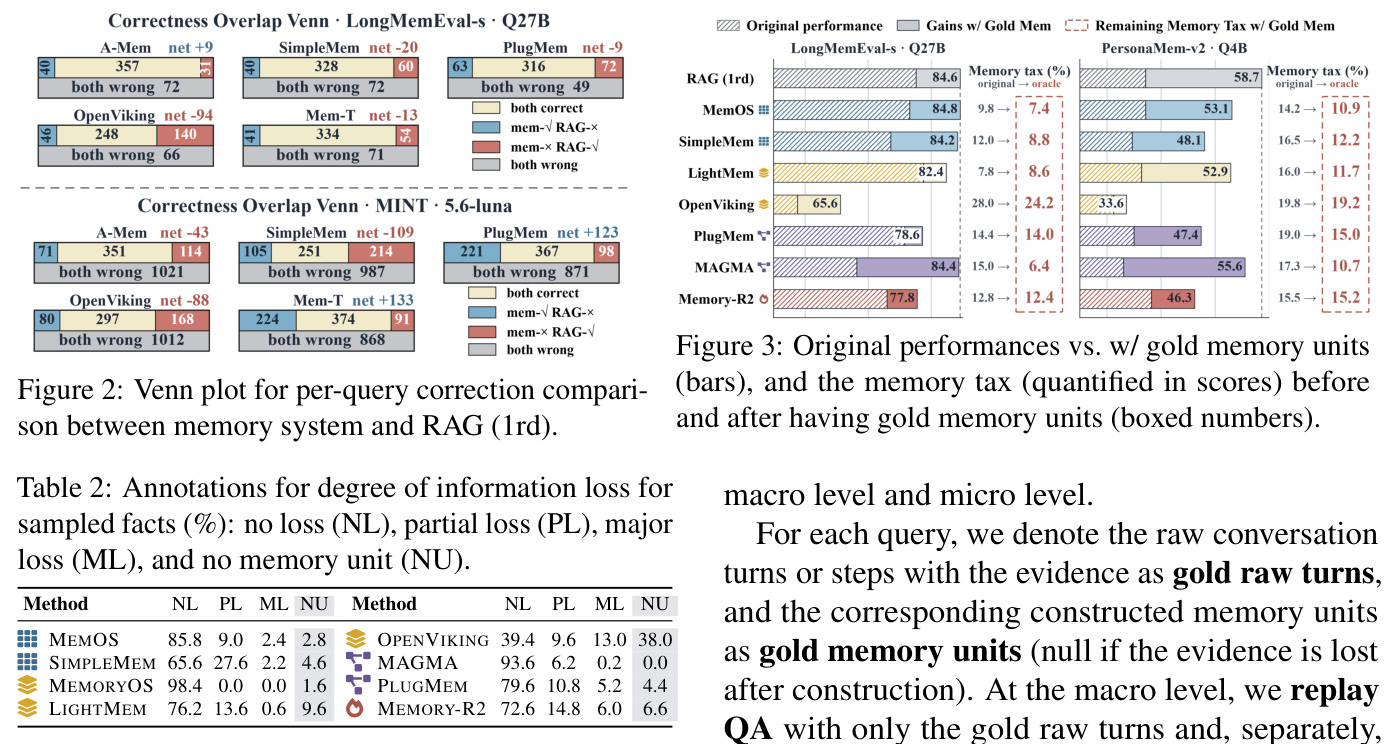
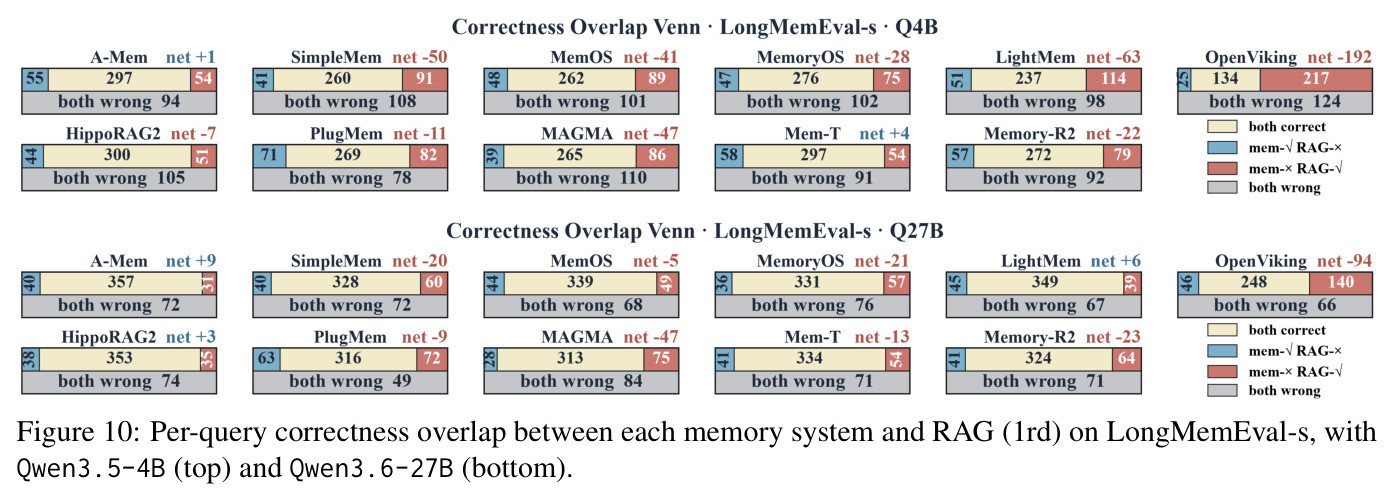
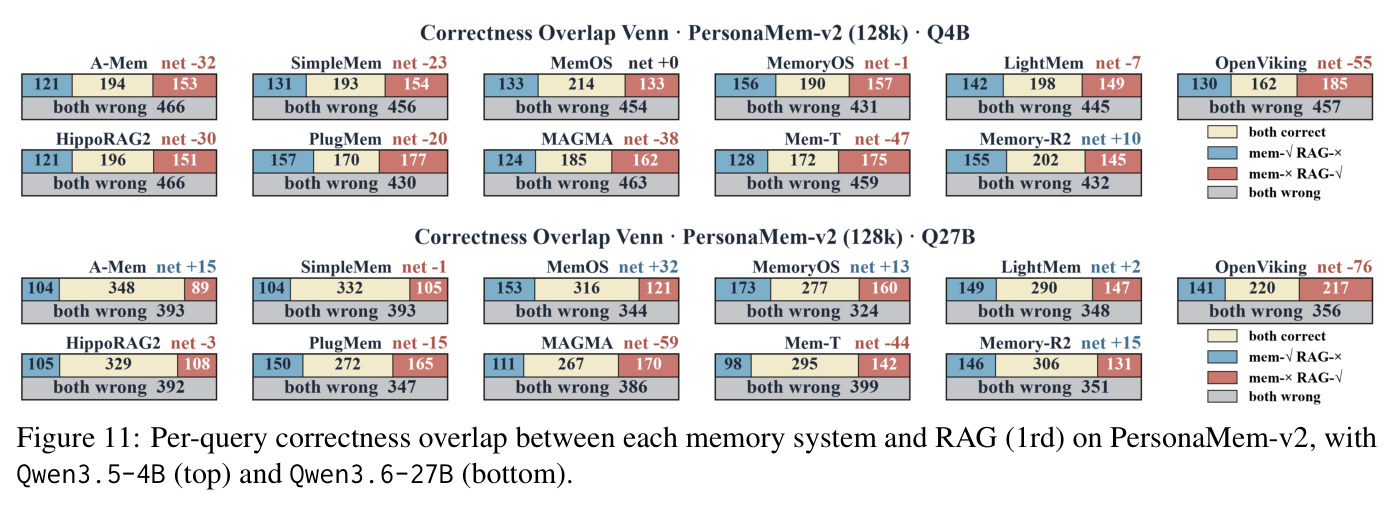
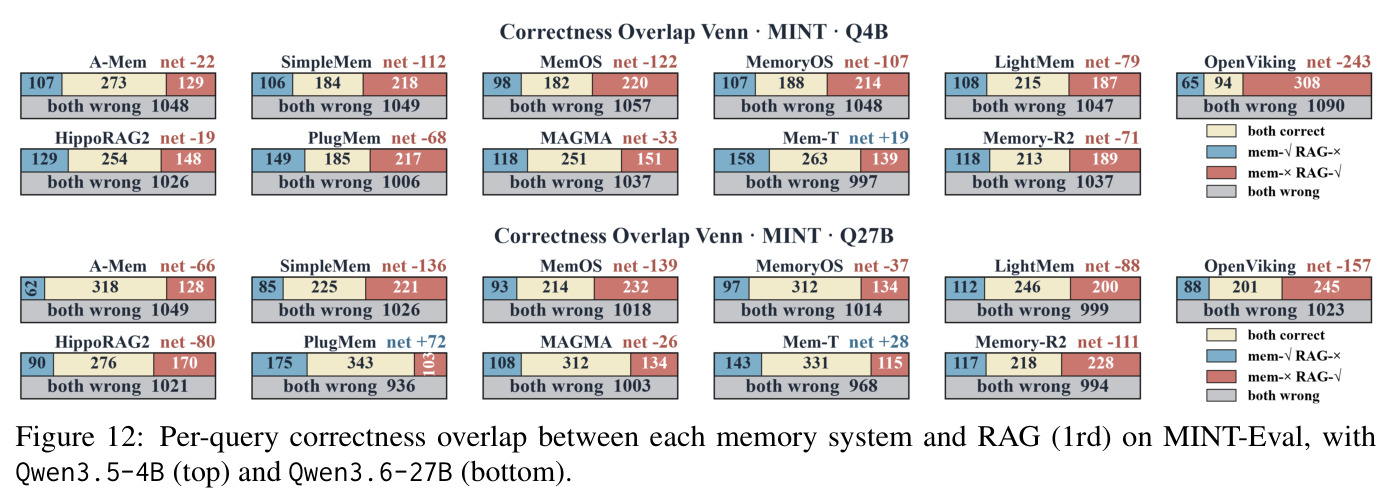
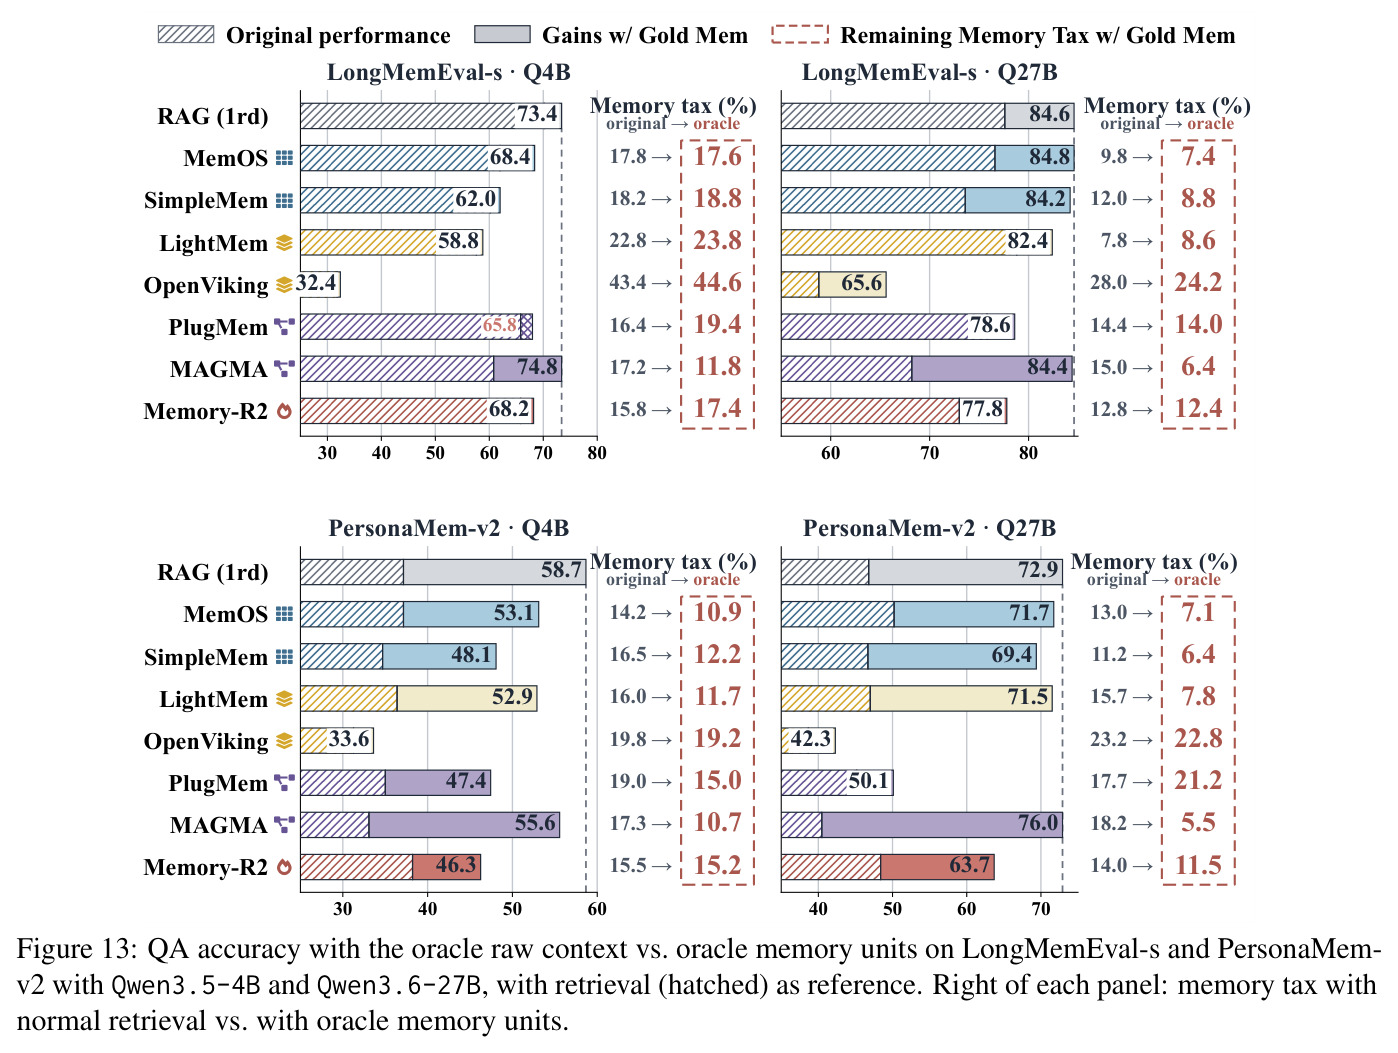
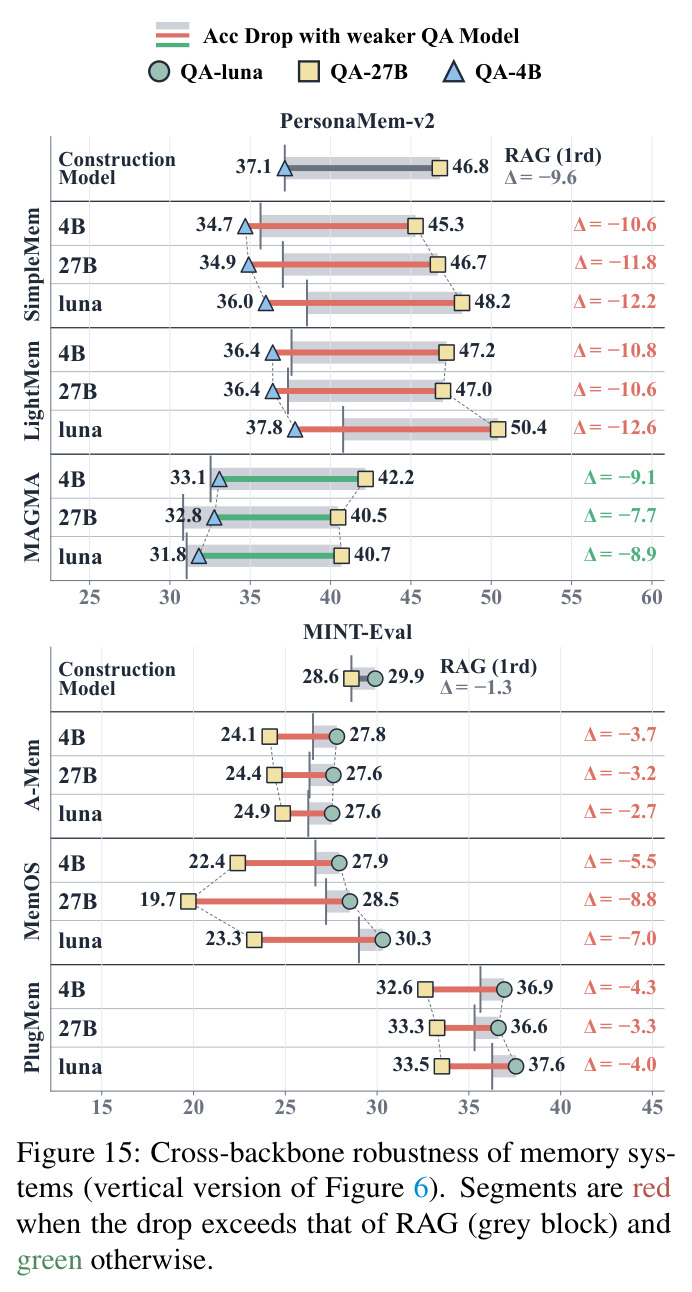
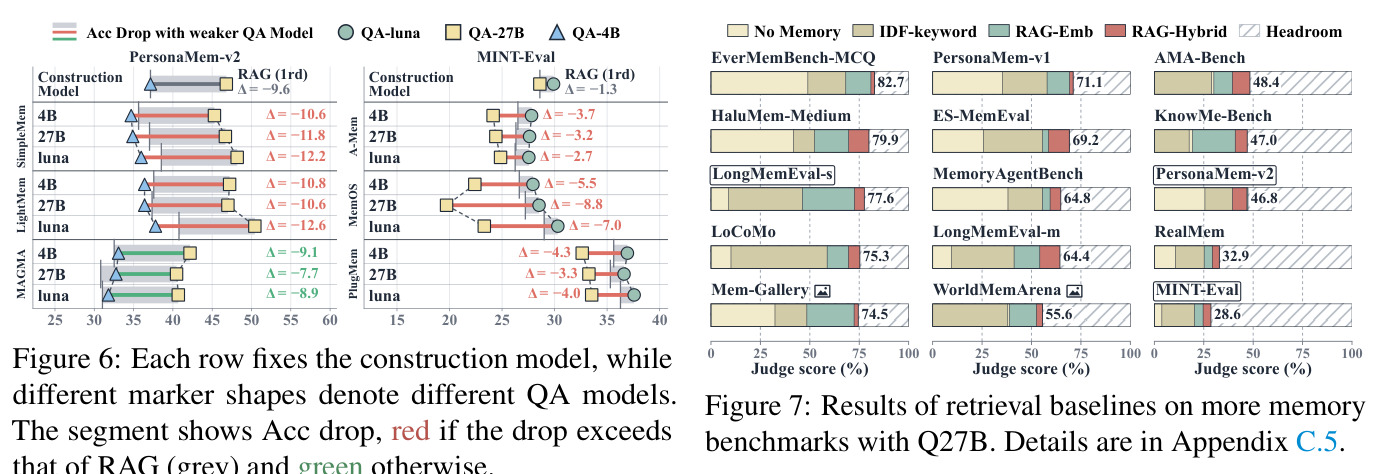
直觉上,记忆对原始历史的任何加工(抽取、压缩、重构、链接)都可能「帮一把」或「丢一点」,净效果要靠任务表现结账。技术上形式化为:交互历史 $H=\{h_1,\dots,h_T\}$,构建 $M=I(H)$,检索 $C=R(q,M)$,生成 $\hat{y}=G(q,C)$;naive RAG 相当于 $M\approx H$。测量分三层:逐 query 与 RAG(1rd) 做集合差(Venn)得 benefit/tax;宏观归因——用 gold raw turns 或经双模型标注、人工仲裁的 gold memory units 直接做 QA(oracle 回放),后者消除检索失败,剩余税收即构建期损失;微观归因——采样 500 条原始轮次人工追踪到记忆单元,标注无/部分/严重丢失或无单元(NL/PL/ML/NU)。可访问性用迭代检索回放测取回全部 gold units 所需轮数,并以 $\mathrm{sim}(q,\text{gold raw turn})$ 与 $\mathrm{sim}(q,\text{gold memory unit})$ 的漂移刻画对齐度;鲁棒性做 3×3 构建/QA 骨干交叉实验。
核心创新是「净价值分解」的测量框架而非新架构。本质区别有三点。第一是参照系:坚持让每个记忆系统与同一套强配置朴素 RAG 对打(会话 turn 级约 1024 字符 buffer 切块、BM25+稠密混合检索、Qwen3-Reranker-0.6B 重排),并发明 Retrieval Scope 解决公平性——不同系统记忆单元粒度差几个数量级,固定 top-k 不可比,RS 定义为 LLM 从检索到答题实际看到的 token 占可检索存储的比例,调 top-k 使各系统 RS 不低于 RAG(1rd)。第二是度量对:benefit/tax 是逐 query 的互补分解,二者之和即净差,可按系统、基准、骨干任意切片统计。第三是归因链:把税依次映射到「存的时候丢了(faithfulness)」「存住了但查不到(accessibility:碎片化/稀释/改写)」「换模型就抖(robustness)」,再叠加「benchmark headroom 不足放大税感」的评测侧因素,构成一个完整的因果故事,而以往工作只报告总分,从不解释损失从何而来。
方法步骤详情
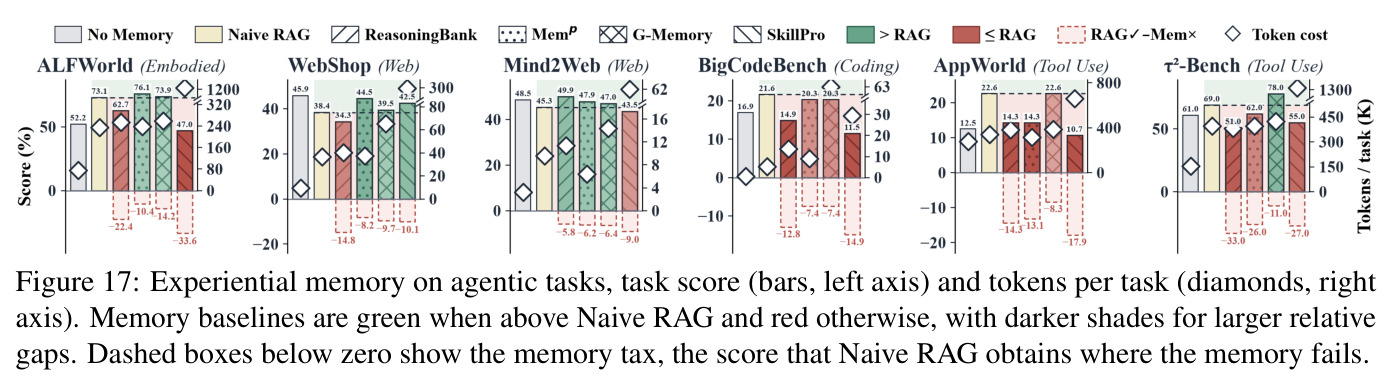
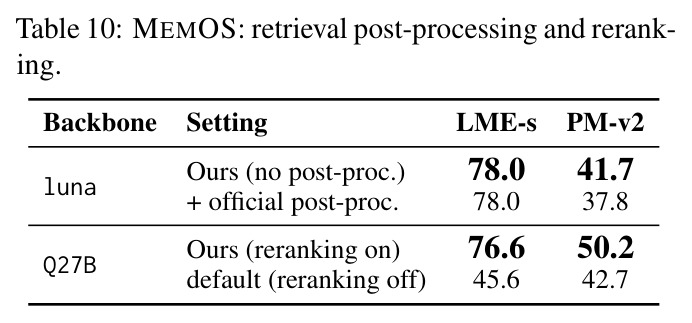
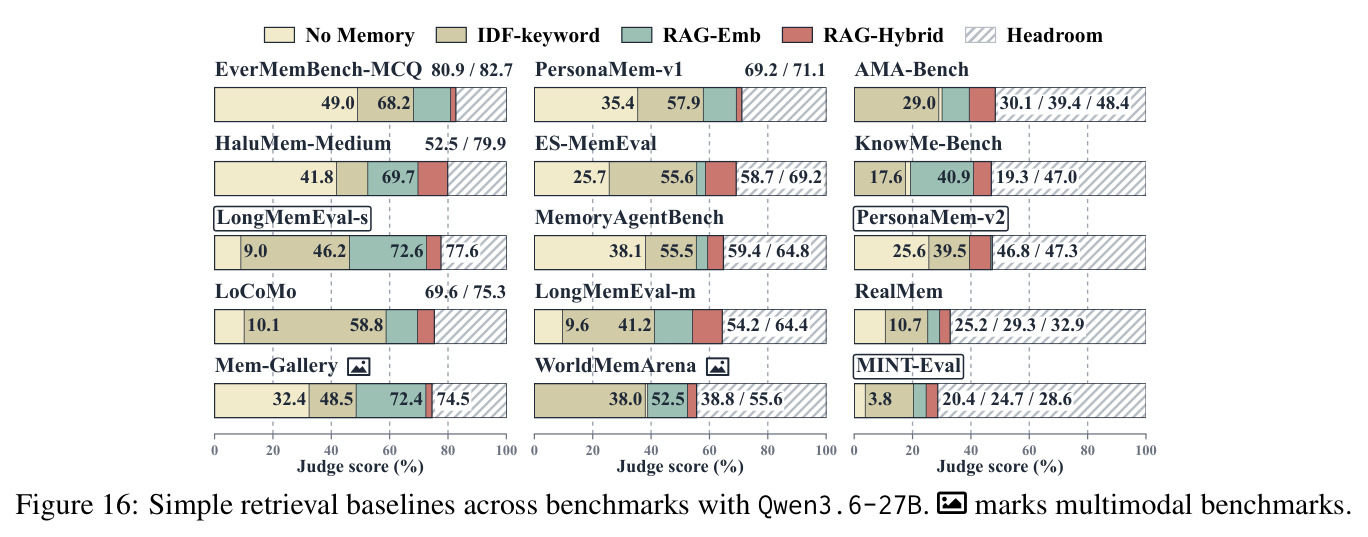
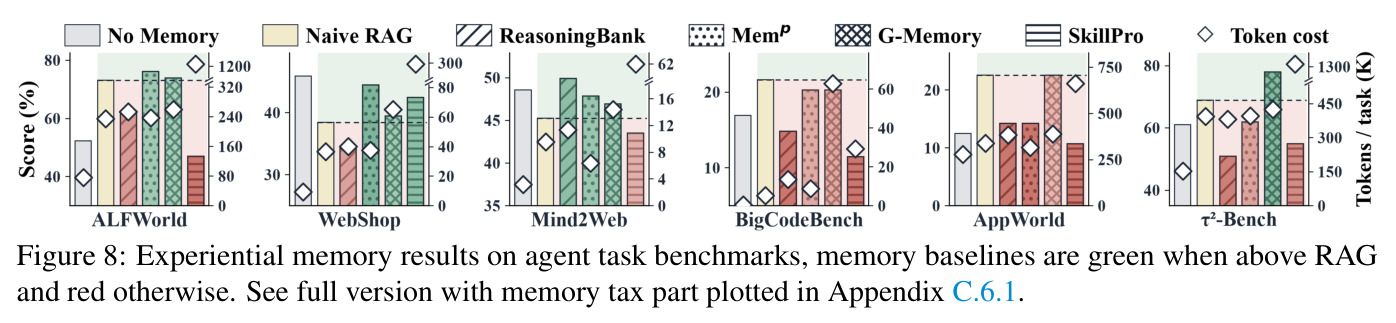
第一步,选型分组:扁平存储(A-MEM、MEMOS、SimpleMem)、层级/生命周期(MemoryOS、LightMem、OpenViking)、图结构(HippoRAG2、PlugMem、MAGMA)、训练策略(MEM-T、Memory-R2),另设 RAG(1rd/2rd)与 No/Full/Gold Context 参考。第二步,统一实现:共用 Qwen3-Embedding-0.6B、Qwen3-Reranker-0.6B 与同一 QA prompt,答案由 Qwen3.6-27B 判分,辅以 token 成本、耗时、调用数、存储大小四项成本指标。第三步,按 Retrieval Scope 调 top-k 对齐检索预算(如 A-MEM luna k=5→15,73.0→84.0)。第四、五步,跑 3 基准 × 3 骨干主表并 Venn 分解 benefit/tax。第六步,忠实性:gold 轮次到记忆单元的映射覆盖率,加 500 条事实人工丢失注释。第七步,可访问性:多轮检索回放测恢复全部 gold units 的轮数,并测查询-证据相似度漂移。第八步,鲁棒性:3×3 骨干交叉网格。第九步,headroom:15 个基准上跑 No Memory、IDF-keyword、RAG-Emb、RAG-Hybrid。第十步,泛化:6 类 agent 任务上比较 MEMp、ReasoningBank、G-Memory、SkillPro 与 naive RAG;2 个世界模型基准上比较 6 种记忆载体。第十一步,验证 src-aug 与 recursive 两个减税设计。
技术新颖性
新颖性不在算法而在测量科学与概念框架。其一,首次系统地把「记忆 vs 直接检索」作为主问题,并用消融证明结论稳健:RAG 在换切块(buffer-512/turn 级/流式窗口)、换检索(BM25-only/Emb-only)、换 embedding(0.02B 到 8B 五个型号)、换重排器后大多只在默认配置几个点内波动,说明强 RAG 不是调参运气。其二,Retrieval Scope 概念解决了记忆系统比较中「top-k 不可比」的老问题——有的系统一个单元是一整段会话摘要,有的是一行事实,这是以往记忆评测普遍忽视的混淆变量。其三,税收的三个维度都配有可复现的测量协议(oracle 回放、迭代检索 replay、3×3 骨干交叉),把抽象概念落到可操作的数字。其四,同一框架跨域成立:对话记忆、经验记忆(轨迹/技能蒸馏)、世界模型记忆(原始帧 vs KV cache vs visual latents vs 记忆 token)中都能定义并测出 benefit/tax,证明「记忆=带偏离的源信息变换」的普适性;案例还证明同一机制(原子抽取、时间锚定)在同一系统内既能产生收益也能产生税收。
实验结果
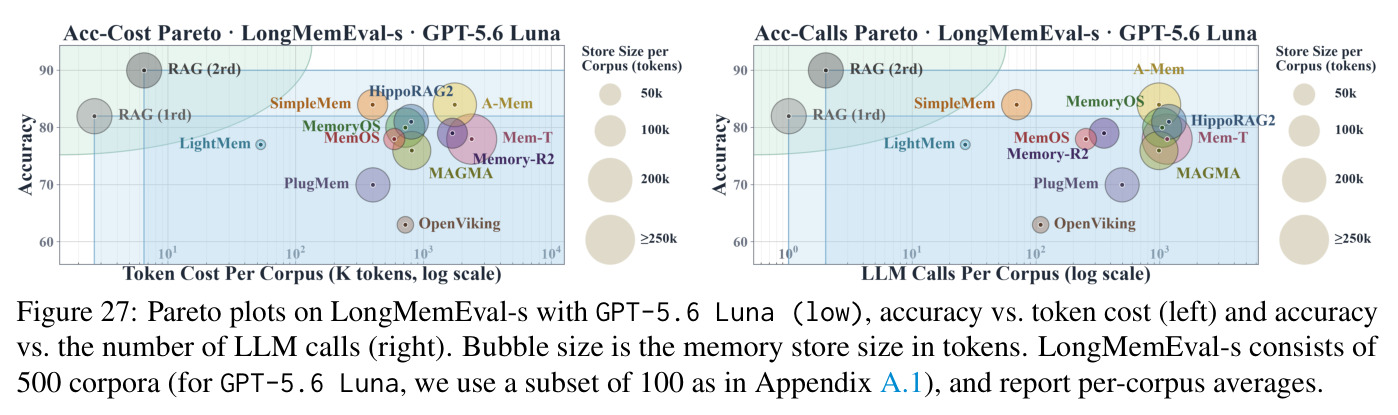
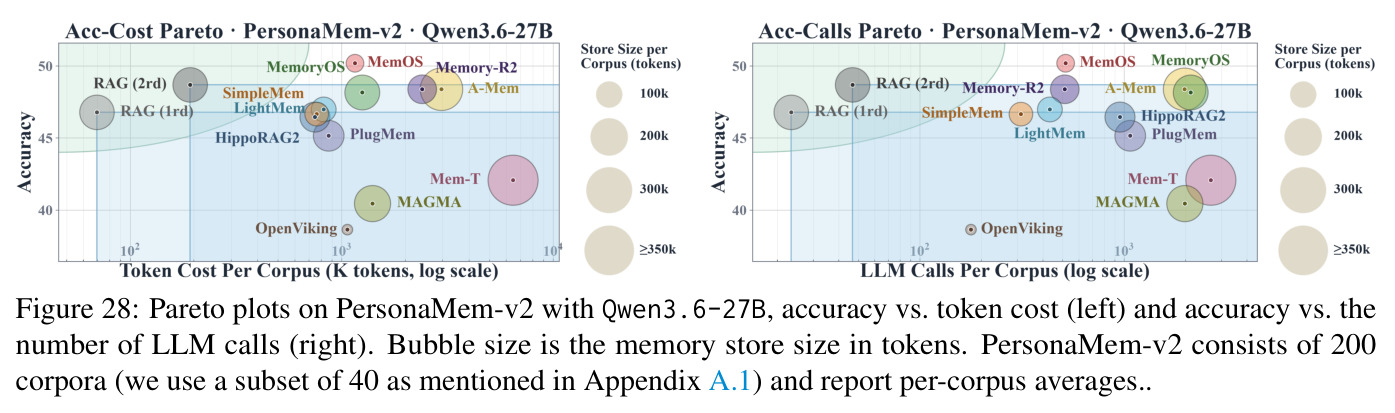
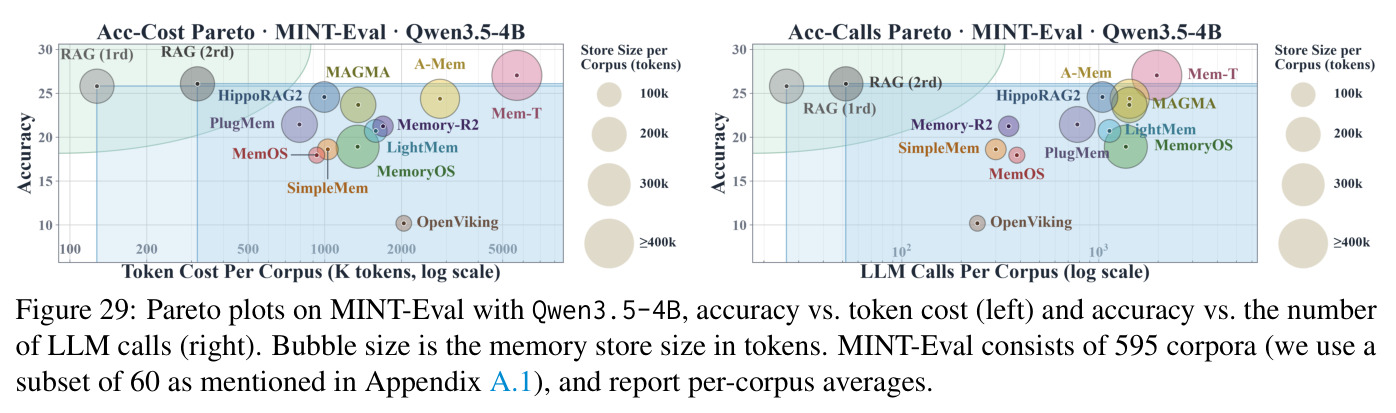
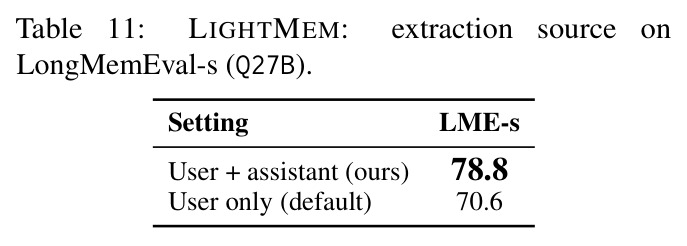
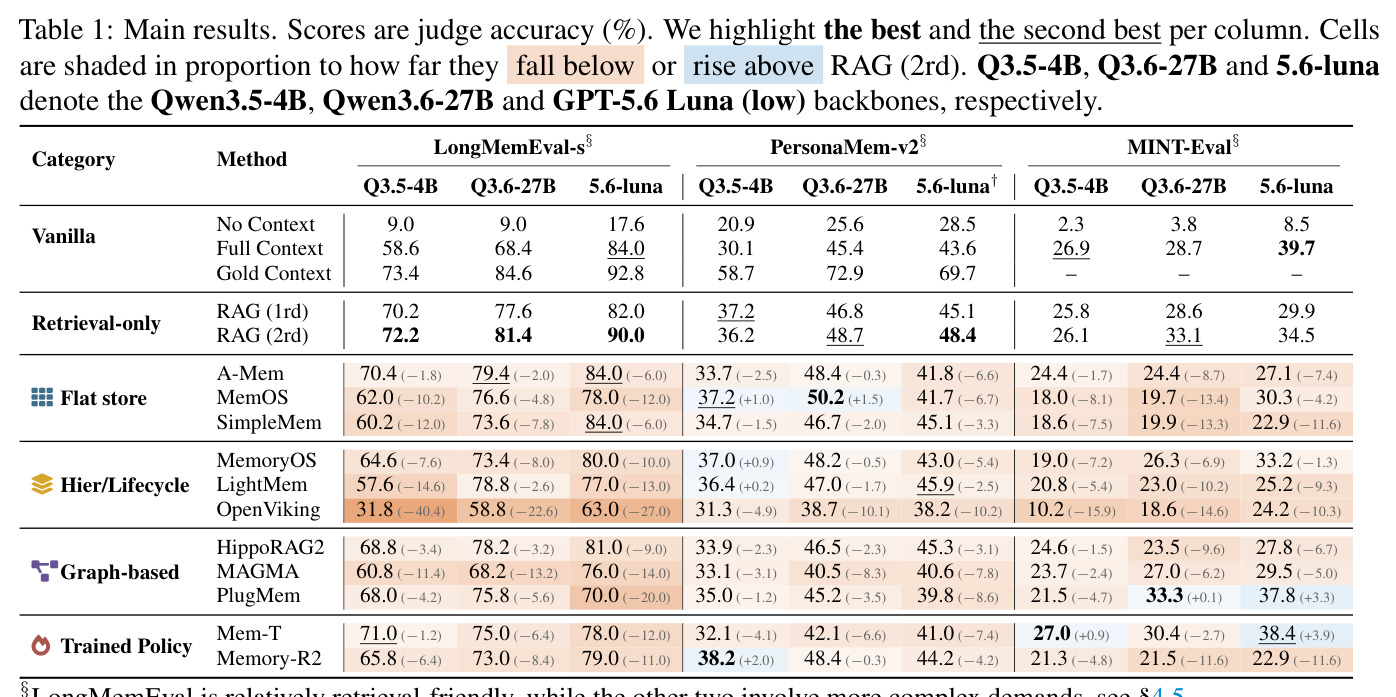
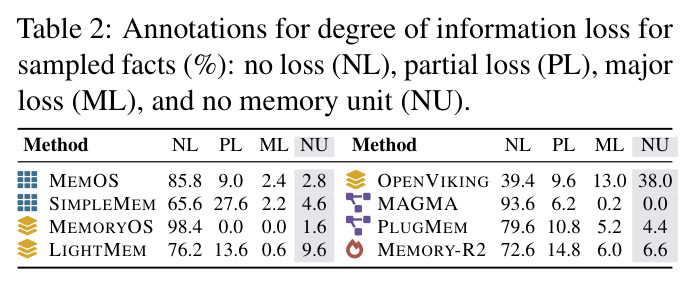
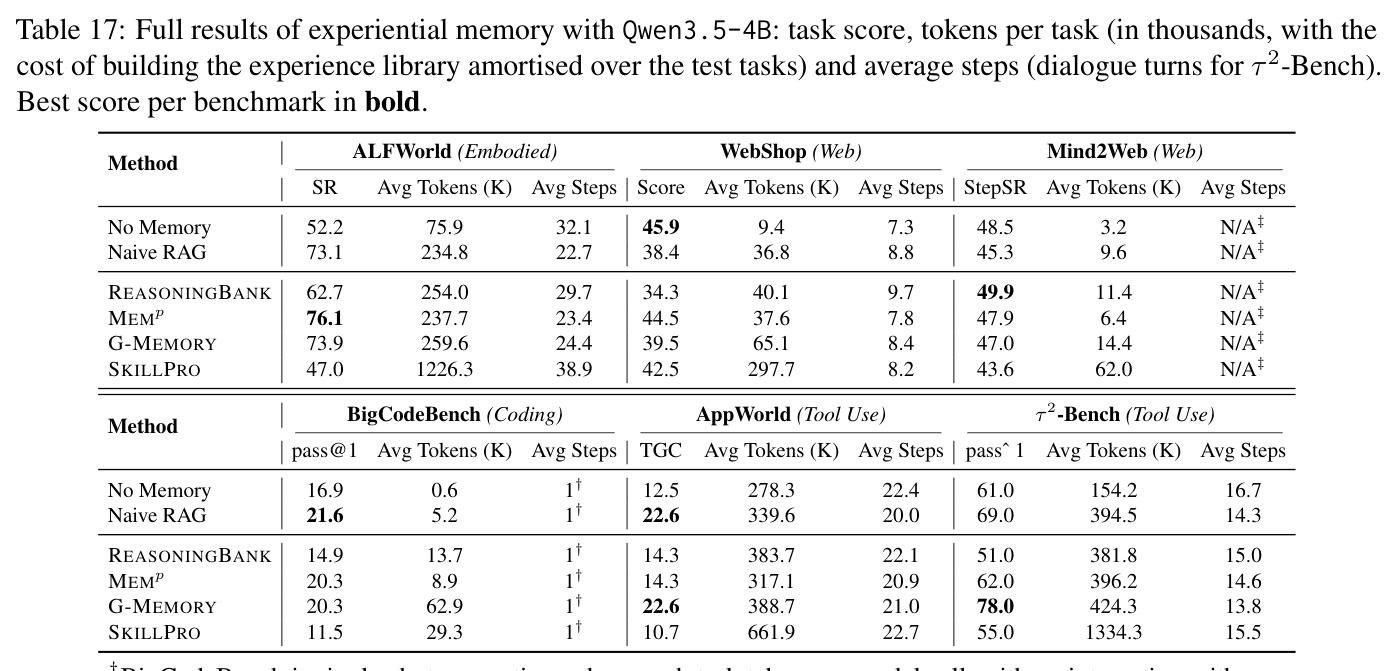
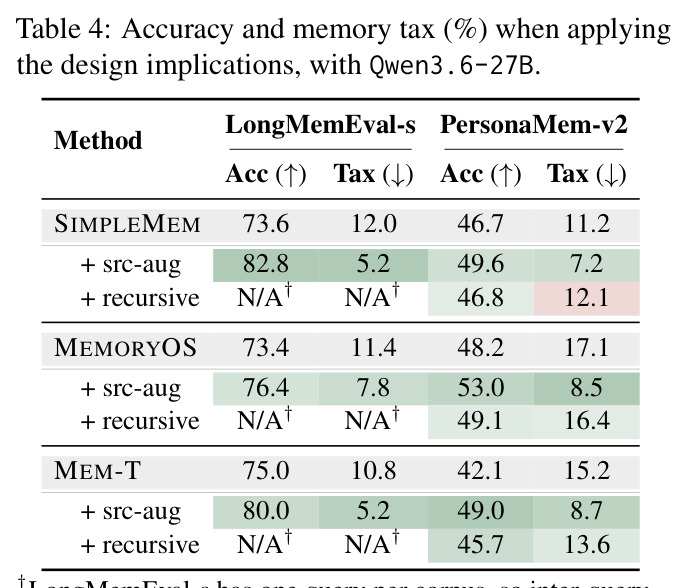
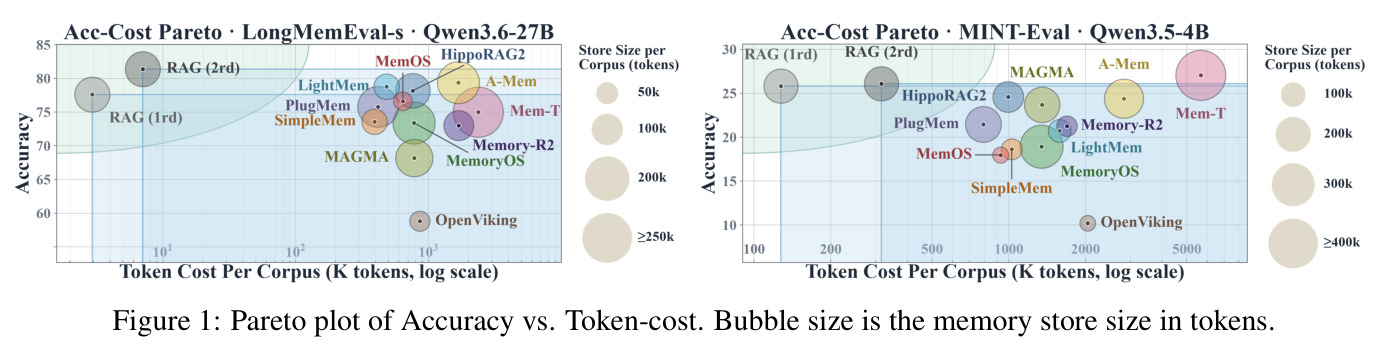
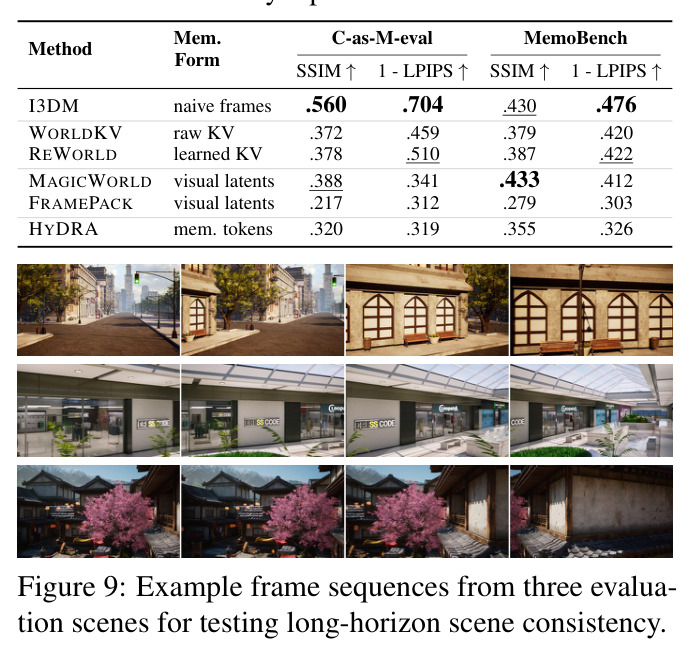
主表(Table 1)结论刺眼:13 个记忆系统在 3 基准 × 3 骨干共 9 列中绝大多数低于 RAG(2rd)(其在 LongMemEval-s 为 72.2/81.4/90.0,PersonaMem-v2 为 36.2/48.7/48.4,MINT-Eval 为 26.1/33.1/34.5)。OpenViking 最惨,LongMemEval-s 低 40.4 分(仅 31.8);LightMem(Q4B)低 14.6;仅 MINT-Eval 上 Mem-T 38.4(+3.9)、PlugMem 37.8(+3.3)与 PersonaMem-v2 上 Memory-R2 38.2(+2.0)为正。Figure 1 显示记忆系统 token 成本更高却大多不占优。税有三源:忠实性——500 条采样事实中 OpenViking 仅 39.4% 无损失、38.0% 无对应记忆单元,MemoryOS 则 98.4% 无损失;换 gold memory units 后税降但不归零(MAGMA 从 15.0 到 6.4),另一半在访问端。可访问性——记忆系统首轮取回 gold units 少于 RAG,退化为碎片化、稀释、改写。鲁棒性——削弱 QA 骨干时掉分常超 RAG(PersonaMem-v2 上 SimpleMem 掉 12.2、LightMem 掉 12.6,对 RAG 的 9.6)。评测侧:RAG-Hybrid 在 EverMemBench-MCQ 达 82.7、LME-s 77.6,IDF-keyword 也能过半,许多基准检索友好、headroom 有限。泛化:ALFWorld 上 MEMp 76.1 胜 RAG 73.1,WebShop 无记忆 45.9 全场最高,τ2-Bench 上 G-Memory 78.0 胜 RAG 69.0;世界模型中 naive frames(I3DM)SSIM .560 压过 WorldKV .372。减税立竿见影:src-aug 使 SimpleMem 73.6→82.8、税 12.0→5.2;MemoryOS(PersonaMem-v2)48.2→53.0、税 17.1→8.5。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 对话记忆问答 LongMemEval-s(Qwen3.5-4B) | Judge 准确率 (%) | OpenViking 31.8 | RAG (2rd) 72.2 | −40.4(最严重的负净值案例) |
| 对话记忆问答 LongMemEval-s(GPT-5.6-luna) | Judge 准确率 (%) | PlugMem 70.0 | RAG (2rd) 90.0 | −20.0 |
| 多目标干扰记忆 MINT-Eval(GPT-5.6-luna) | Judge 准确率 (%) | Mem-T 38.4 | RAG (2rd) 34.5 | +3.9(少数正收益) |
| 个性化记忆 PersonaMem-v2(Qwen3.6-27B) | Judge 准确率 (%) | MemoryOS + src-aug 53.0 | RAG (2rd) 48.7 | +4.3(设计启示使负转正) |
| LongMemEval-s(Qwen3.6-27B)减税验证 | 准确率 / 记忆税 (%) | SimpleMem + src-aug 82.8 / 5.2 | SimpleMem 原版 73.6 / 12.0 | +9.2 / −6.8 |
| 具身任务 ALFWorld(Qwen3.5-4B) | 成功率 SR (%) | MEMp 76.1 | Naive RAG 73.1 | +3.0(经验记忆的正例) |
| 工具调用 τ2-Bench(Qwen3.5-4B) | pass^1 (%) | G-Memory 78.0 | Naive RAG 69.0 | +9.0 |
| 网页任务 WebShop(Qwen3.5-4B) | 任务得分 (%) | 最佳记忆系统 MEMp 44.5 | 无记忆 45.9 | 所有记忆系统均未超过无记忆基线 |
| 世界模型长时程一致性 C-as-M-eval | SSIM ↑ | I3DM(naive frames) 0.560 | WorldKV(raw KV) 0.372 | +0.188(朴素帧优于全部压缩记忆) |
局限与改进
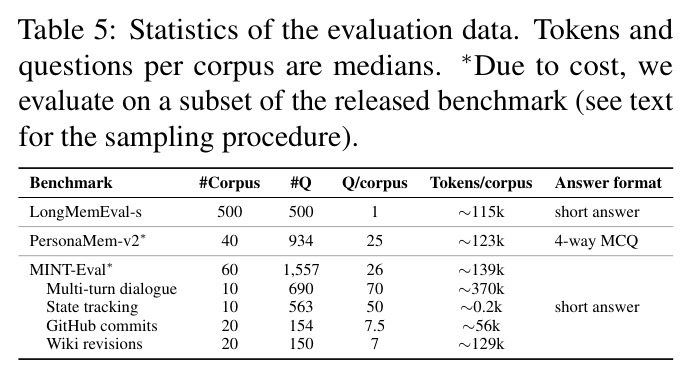
作者承认:基线选择代表性而非穷尽;沿用官方配置,系统特定调优可能更好(B.3 已验证配置偏移有利或无害);主基准静态、离线、英语,未覆盖交错查询与多语言;未涉及 omni-modal、latent、参数化记忆;受算力与 API 成本限制,未测比 GPT-5.6 Luna(low) 更强的模型,并使用子集(PersonaMem-v2 20%、MINT-Eval 10%、luna 下 LongMemEval-s 20%)。我的补充:其一,税收以 RAG(1rd) 为参照零点,参照强弱左右结论——headroom 分析暗示聚合推理型任务上 RAG 参照变弱、benefit 变大,但论文缺正面案例;其二,judge 是 Qwen3.6-27B 且关闭推理,给 GPT-5.6 开放式答案打分有偏置风险,作者也发现 luna 在 PersonaMem-v2 上倾向通用选项而异常低分;其三,基准语料最长约 1MB、单查询对单语料,无法体现记忆数月尺度使用的复利价值,「负净值」部分是评测设置的结果;其四,src-aug 与「显式遗忘」冲突——保留源历史会让被要求忘记的内容仍可检索,隐私场景不可用;其五,经验记忆仅 Qwen3.5-4B 单骨干,结论未必迁移。
独立分析的弱点
第一,参照依赖性:税收相对 RAG(1rd) 定义,聚合抽象型任务上 RAG 参照偏弱、税被低估,纯召回任务上又被放大;改进是同时报告对 Gold/Full Context 多参照的税区间并按 query 类型分层。第二,测量较粗:benefit/tax 只看最终对错,分不清「检索到但推理错」与「根本没检索到」;改进是引入检索命中 gold 的中间标签,做(检索,推理)二维分解。第三,src-aug 的可用性矛盾:恢复路径等于保留原文,与遗忘权、存储成本、上下文污染冲突,论文未讨论长期开销;改进是指针化/版本化存储,把可恢复性定义为「可从记忆单元回溯到原文位置」。第四,归因停留在系统粒度:同一机制(原子抽取)已显示既有收益又有税收,但定量分析未到操作级;改进是建立记忆操作算子库,输出「操作 × query 类型 → 净效应」矩阵。第五,judge 单模型、温度 0、关推理,可靠性只在三基准抽样;改进是多 judge 集成并扩大人工复核。第六,泛化实验单骨干或小样本(C-as-M-eval 60、MemoBench 90),统计功效有限;改进是扩样本、多骨干、报置信区间。
未来方向
作者提出的方向:其一,递归/自指记忆(「记住自己怎么记」)——把过去查询、命中证据、检索路径写入记忆,让深层检索结果对后续相似需求直接可达,形成 inter-query 维度的 test-time scaling,Table 4 已给出概念验证;其二,建模未来需求——在预先构建(AoT,成本高且偏离盲目)与即时构建(JiT,用户延迟敏感)之间找中间路线,用兴趣、习惯、访问模式作为「未来相关性」先验,选择性决定对哪些信息做何种偏离,作者称之为把记忆看作隐式推荐系统;其三,扩展到 omni-modality、latent、参数化记忆;其四,多语言、在线动态、真实长周期部署评测。基于成果可延伸的:把 tax 用作训练信号,如以「相对 RAG 的净增」为奖励做 RL 训练记忆策略(MEM-T/Memory-R2 的自然升级);构造 headroom 更大的新基准(多会话聚合、跨会话约束满足、干扰追踪);设计可撤销记忆(版本树+指针,兼顾遗忘请求与证据恢复);在世界模型中探索统一记忆载体并复用 benefit/tax 协议做标准化评测;把「操作级税」做成开源回归测试集,让记忆系统每次迭代自动测净价值。
复现评估
复现条件较好。开源:作者明确承诺开源代码与全部结果;13 个系统均为开源实现或开源权重(MEM-T 用 Qwen3-4B 策略、Memory-R2 用 Qwen2.5-7B-Instruct),3 个主基准与 15 个 headroom 基准全部公开。协议:附录 A 给出基准规模与分层采样,A.3/A.4 给出 judge prompt、Retrieval Scope 定义与 top-k 调整表,B.3 逐项列出对官方配置的修改及验证(MemOS 关闭 relativity 阈值+MMR、开启 rerank;SimpleMem ingestion 窗口 40→10;Memory-R2 输出上限 2048/1024→4096),对公平复现很关键。算力:H20 服务 Qwen3.6-27B/4B(温度 0、关推理),H100 跑世界模型(50 步推理),GPT-5.6-luna 走 API。难度:主要工程量在适配 13 个系统的构建与检索流程,无需训练;单人可复现主表,世界模型需多卡 H100;全量 15 基准 × 多系统开销可观,作者自己都只测了子集。总体属「工程量大、算力中等、协议透明」的中等偏易复现。
论文图表