复杂智能体记忆并非总是必要:朴素 RAG 比想象中更强 Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
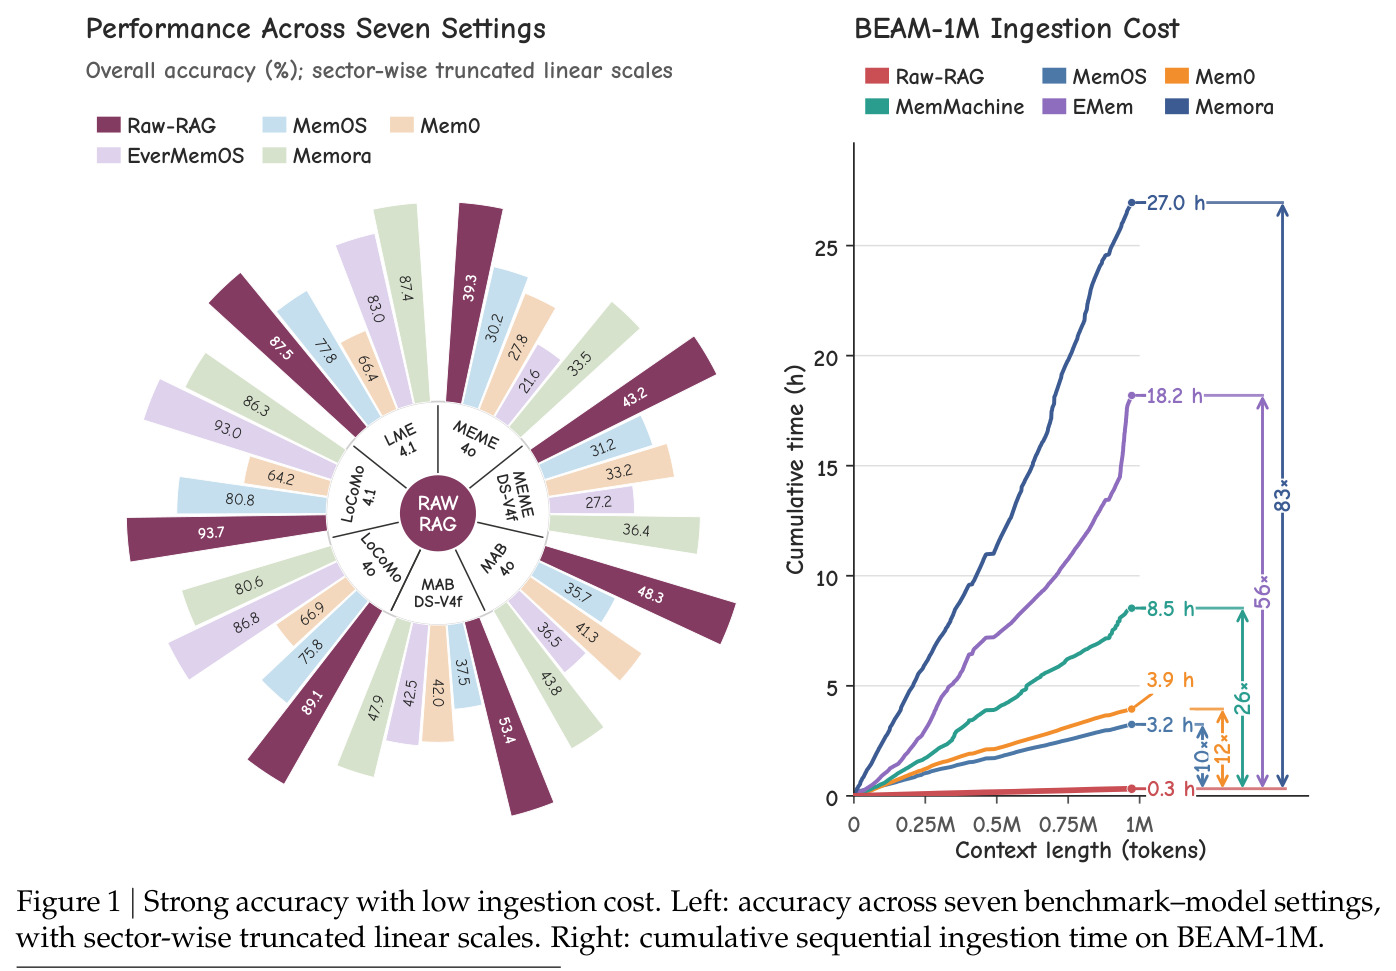
原始历史+密集检索+重排的朴素RAG在7项设置中6项击败复杂智能体记忆系统
前置知识
检索增强生成(RAG)
RAG 在回答问题前先从外部语料中检索相关片段,再把检索到的证据连同问题一起交给生成模型(reader)。典型流程是:文档切分成 chunk、用嵌入模型向量化建索引,查询时按相似度召回候选,最后拼接进 prompt 生成答案。它把"知识"放在模型参数之外,可随时更新、可溯源。
本文的主角 RAW-RAG 就是最朴素的 RAG:直接在原始对话历史上做密集检索加重排,不给任何记忆加工。读懂它的设计和为什么有效,必须先理解 RAG 的基本管线。
智能体记忆系统(agentic memory)
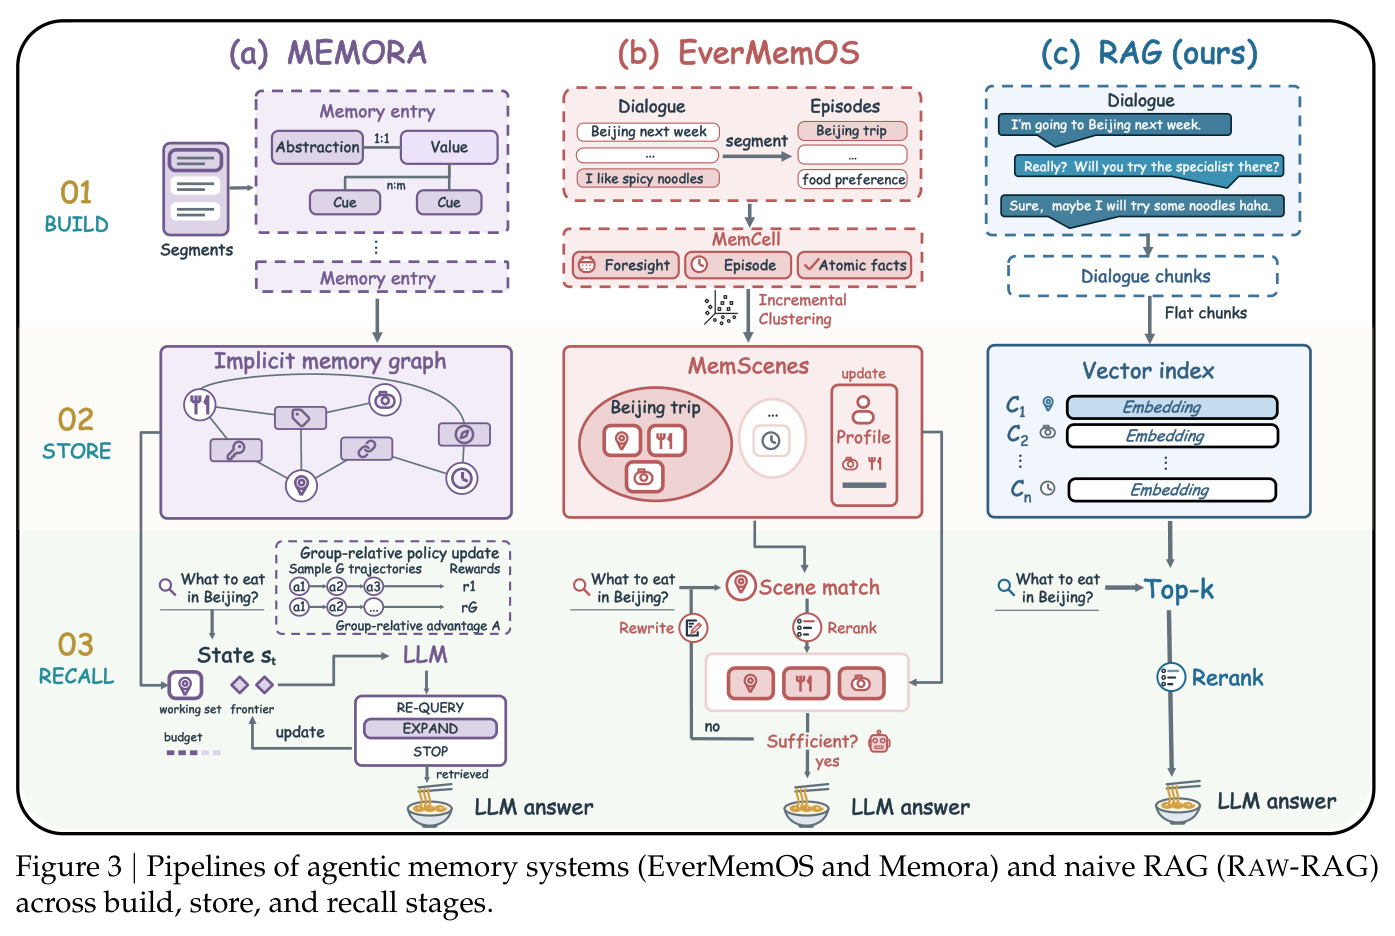
为 LLM 长期对话设计的外部记忆架构,超越固定上下文窗口,在写入、管理、读取三个阶段引入复杂操作:用 LLM 抽取原子事实、生成摘要、执行 UPDATE/DELETE 等记忆突变(mutation)、构建时间图或知识图、分层 consolidate、甚至学习检索策略。代表系统包括 Mem0、MemOS、EverMemOS、Memora、MemMachine 等。
这些系统是本文的批判对象。论文的核心问题正是:这些复杂操作对长对话理解任务到底带来了多少收益?理解它们的典型管线(build-store-recall)才能看懂对比实验的设计。
密集检索与交叉编码器重排
密集检索用双塔嵌入模型把查询和 chunk 映射到同一向量空间,按余弦相似度快速召回大量候选(本文取 top-128);交叉编码器重排器(cross-encoder)则把"问题-候选"拼成一个输入 jointly 打分,精度更高但算力更贵,只对候选精排选出最终 few 条(本文 top-15)。两阶段兼顾召回率和排序精度。
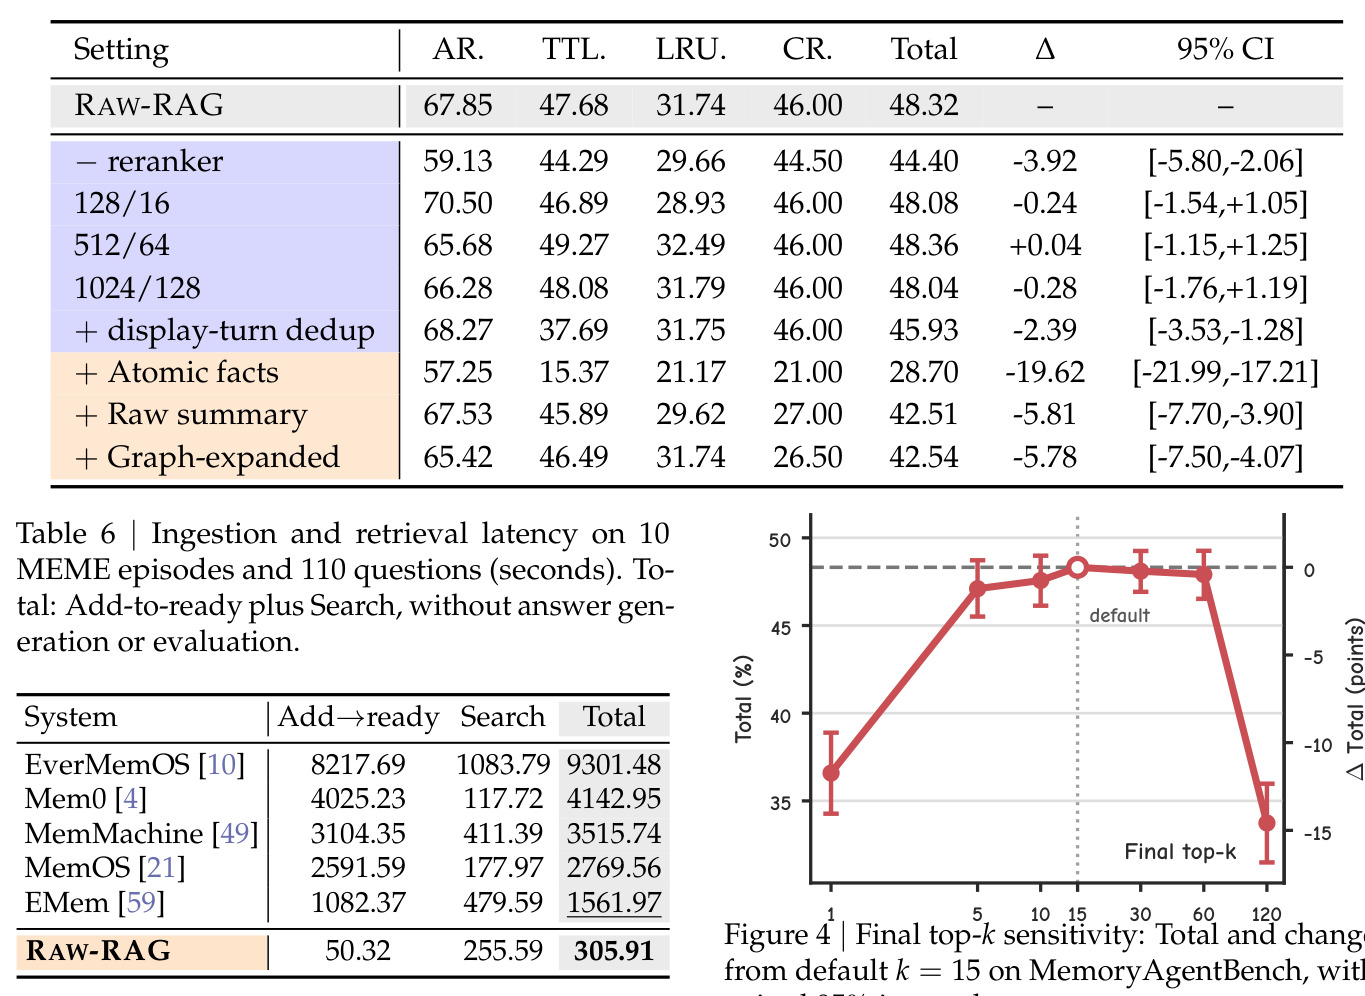
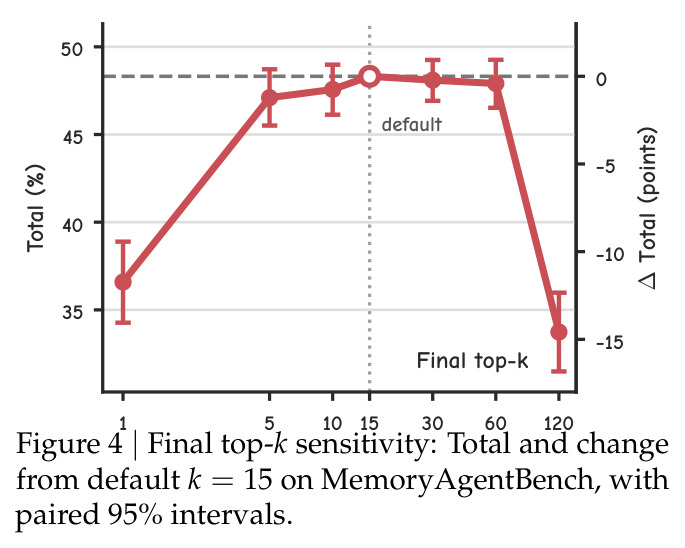
这是 RAW-RAG 仅有的两个技术组件。消融实验显示去掉重排掉 3.92 点、只返回 1 条掉 11.73 点、返回 120 条掉 14.57 点,说明这个"朴素"设计其实经过了仔细调优,是基线强度的来源。
记忆突变与写决策(mutation / write decisions)
智能体记忆系统在写入时会对记忆条目执行 ADD(新增)、UPDATE(更新)、DELETE(删除)或 NONE(不动)等操作,称为写决策。突变指 UPDATE 和 DELETE 这类会改变已有状态的写操作。"有效突变"定义为真正持久化改变了存储文本的操作(排除了重复提议、格式错误、无效操作)。
论文的动机实验就是审计 Mem0 的写决策分布:UPDATE+DELETE 只占 4.39%(LoCoMo)和 2.46%(LongMemEval),有效突变仅 1.90% 和 1.34%。这直接动摇了"必须显式维护状态"的前提,是全文论证的起点。
覆盖率(coverage)与利用率(utilization)
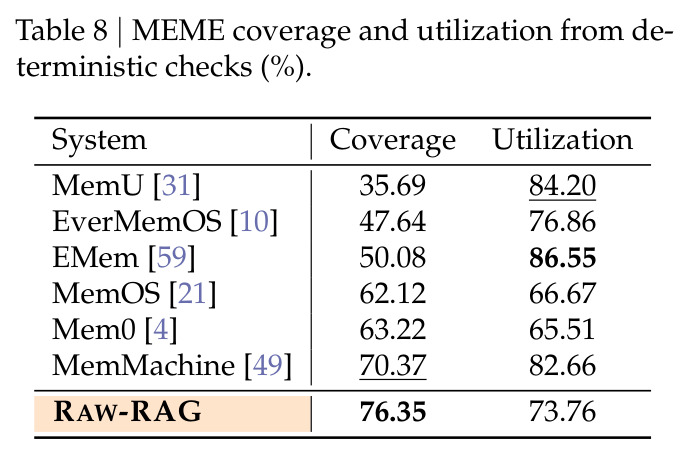
覆盖率是检索到的证据"足以回答该问题"的问题比例;利用率是条件准确率,即在证据充分的问题子集上 reader 答对的比例。用公式表达:系统总分可近似分解为 $\hat{C}_s = \frac{1}{N}\sum_i C_{is}$(覆盖率)与 $\hat{U}_s = \frac{\sum_i C_{is} Y_{is}}{\sum_i C_{is}}$(利用率)的组合。覆盖率反映"找不找得到证据",利用率反映"给了证据会不会用"。
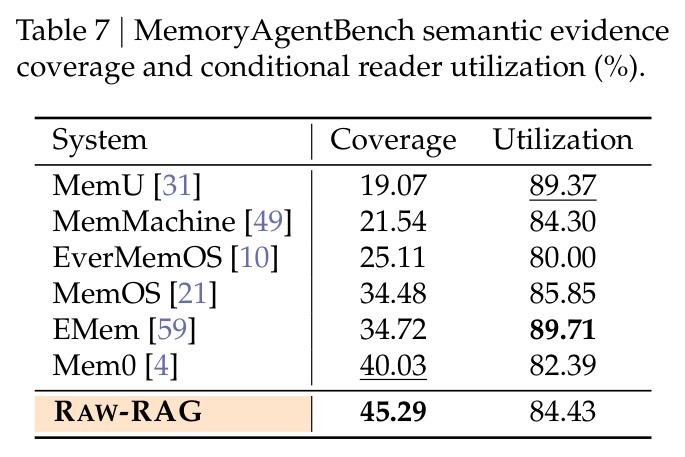
这是论文诊断分析的骨架:各系统利用率差异很小(80-90%)而覆盖率差异巨大(19-76%),说明证据获取才是主要瓶颈,RAW-RAG 靠高覆盖率取胜。
研究动机
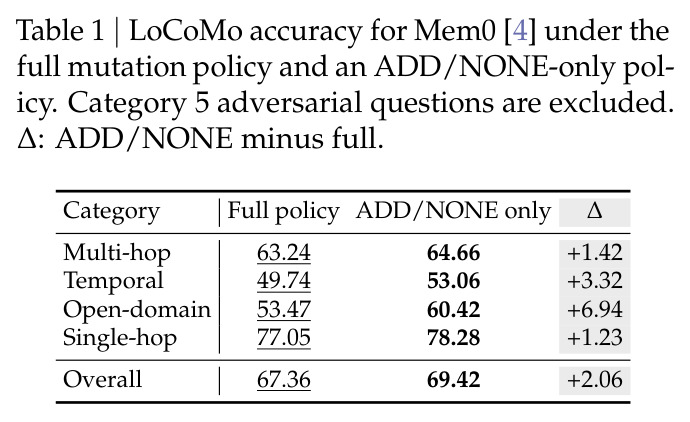
LLM 在长期交互中需要利用跨会话积累的信息,但历史远超上下文窗口,于是催生了大量智能体记忆系统:抽取事实、摘要、突变、合并、建图、社区发现、学习式检索等。然而复杂度是否必要从未被认真检验。反对朴素 RAG 的理由有二:概念上认为 RAG 适合静态语料,无法处理被取代的事实、删除和依赖状态变化;经验上 prior 评测一致报告 RAG 落后于记忆系统。作者先做了两个诊断实验:审计 Mem0 在 LoCoMo 全部 33,902 个写决策和 LongMemEval 全部 428,858 个写决策,发现 UPDATE+DELETE 合计仅占 4.39% 和 2.46%,其中真正持久化生效的"有效突变"只有 1.90% 和 1.34%,大量提议是重复或格式错误的;而且把 UPDATE 替换成只增不改(ADD/NONE-only)后,LoCoMo 准确率反而从 67.36% 升到 69.42%(+2.06),没有任何题型下降。另一方面,作者复查 14 项先前工作,发现多个被引用的 RAG 基线存在明显缺陷:Nemori 的 RAG 用 4096-token 粗分块(得分仅 30.20)、Memobase 公开配置 k=1、Memora 500-token 块只取 k=3、BEAM 只取 top-5、xMemory 干脆没有重排器。所谓"RAG 不行"可能只是基线太弱。
本文的目标是本文的目标是严格回答"复杂智能体记忆是否总是必要"。具体分三层:第一,构建一个设计干净、调优到位的朴素 RAG 基线 RAW-RAG——只在原始历史上做密集检索与交叉编码器重排,不做任何 LLM 抽取、摘要、建图或突变,把状态重建完全交给 reader LLM;第二,在 LoCoMo、LongMemEval、MEME、MemoryAgentBench 四个基准、多个 reader(GPT-4o-mini、GPT-4.1-mini、DeepSeek-V4-Flash)上,与 EverMemOS、MemOS、EMem、SimpleMem、MemU、MemMachine、Mem0、Memora、Nemori、MemoryOS、A-MEM、RecMem 等 12 个记忆系统做对齐评测,看朴素 RAG 能否匹敌;第三,不止于排名,还要解释"为什么朴素 RAG 够用":把系统差异分解为证据覆盖率、条件利用率、依赖路径保留率,并用完全存储 oracle 隔离检索失败与摄取时信息丢失。
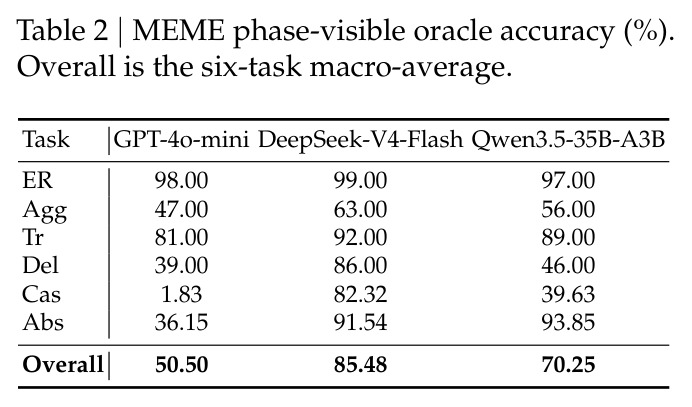
与已有工作不同的是,本文的独特之处在于它是"反创新"研究——不提出新系统,而是对整个方向做必要性审计。切入角度有三个独特点。其一,用全量写决策审计量化动态性:不问"系统声称能处理动态变化",而问"实际发生了多少次真实的状态修改"(有效突变率 1.90%/1.34%),并用禁用突变的对照实验证明显式状态维护在此设置下无收益甚至有害。其二,用 phase-visible oracle 证明强 reader 能直接从原始证据解决状态转换:给 DeepSeek-V4-Flash 按时间序提供查询时刻可见的全部原始证据后,MEME 级联任务达 82.32%、失效识别达 91.54%——所谓"必须建图才能处理依赖"的直觉被推翻。其三,诊断粒度新:提出 result/path 分解(检索到答案值不等于保留了推导该值的时间序与依赖路径)、覆盖率×利用率分解、完全存储 oracle 三件套,把"检索没找到"和"写入时就丢了"这两种失败模式第一次分开度量。
核心方法
直觉上:既然长期对话任务里真正需要改写旧状态的操作极少(有效突变不到 2%),而现代 reader LLM 面对带时间戳的完整原始对话足以自行推断状态变化(oracle 实验中 DeepSeek 级联 82.32%),那么在写入时把原始文本替换成派生表示(事实、摘要、图节点)就是在引入信息损失风险,不如把原始历史原样保住、在查询时精准取回,把所有语义加工推迟到 reader。技术路线完全对应这个直觉:RAW-RAG 摄取阶段零 LLM 调用——把对话按消息序列化(含日期、说话人、图片 caption),切成 256-token 窗口、32-token 重叠,嵌入进平面向量索引;查询阶段把问题原文嵌入、余弦召回 128 个候选窗口,再用交叉编码器重排取 top-15,形式化为 $D_q = \mathrm{Top}_{128}\{\cos(e(q), e(c)) : c \in \mathrm{chunks}(H)\}$,$S_q = \mathrm{Top}_{15}\{r(q,c) : c \in D_q\}$;选中的窗口展开为完整对话轮次后连同问题交给 reader,由 reader 自行解决时间顺序与状态变化。检索器可选 text-embedding-3-small + Cohere Rerank-v3.5 或 Qwen3-Embedding-4B + Qwen3-Reranker-4B。
核心创新点是一种立场而非组件:证明在被评测的长对话任务分布上,记忆管理的复杂组件不仅无益反而有害,"原始保真"(source preservation)本身就是一个设计原则。与已有方法的本质区别在于信息加工的时机与可逆性:Mem0、MemOS、EverMemOS 等系统在摄取时就把原始文本替换为抽取的事实、摘要或图节点,这是破坏性转换——写入时丢掉的信息之后任何检索器都找不回来;RAW-RAG 的索引只是原文的窗口化视图,检索只做选择不改写,整条管线从原始文本到 reader 输入是可追溯、无损的。论文用三组实验把这一立场钉死:给 RAW-RAG 加原子事实抽取使 MemoryAgentBench 总分从 48.32 崩到 28.70(-19.62),加摘要增强降 5.81,加图扩展降 5.78——同一检索骨架下,任何记忆管理操作都只减分;完全存储 oracle 进一步显示,即便给系统绕过检索、用 gold 信息直接从完整持久化存储中选证据,派生型存储仍比原始证据低 4.06 到 30.54 点,证明损失发生在摄取而非检索。
方法步骤详情
第一步(摄取):输入对话历史 $H=(m_1,\dots,m_T)$,每条消息带日期、说话人、内容,缺失日期标记为 unknown,图片以 caption 文本进入;用 GPT-4 tokenizer 切成 256-token 窗口、步长 224(即 32-token 重叠),每个窗口保留指向原消息的映射,供展示时展开为完整轮次;所有窗口嵌入后存入会话内的平面向量索引,全程 0 次 LLM 调用、0 个 token 消耗。第二步(检索):问题原文直接作为查询(不做查询改写),嵌入编码器召回余弦相似度前 128 个窗口 $D_q$。第三步(重排):交叉编码器对每个"问题-窗口"对打相关性分,取前 15 名构成 $S_q$;top-15 是消融确认的稳健区间(5/10/30/60 均差异不显著)。第四步(证据组装):默认把选中窗口展开为完整源轮次(MemoryAgentBench 关闭展开;其 FactConsolidation 来源每条带序号的事实单独成块,保留"序号大=更新"的冲突线索;MEME 按时间序呈现以保留时序进展)。第五步(生成):reader 收到证据、问题及任务指令(如问题日期提醒、选项列表),温度 0 生成答案。第六步(评测):LLM judge 每个固定答案判 3 次取平均,与 12 个基线在各基准的原始评测设置下逐一对齐。
技术新颖性
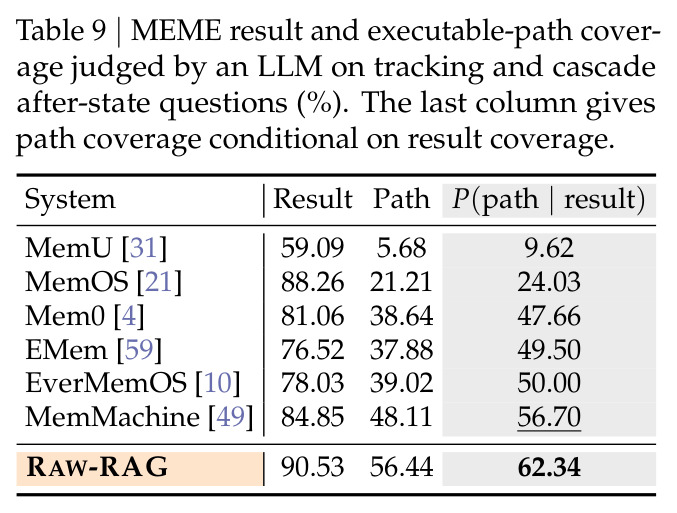
技术新颖性体现在度量与方法论而非模型结构。第一,"有效突变率"是新指标:区分系统发出的写决策、返回的动作与真正持久化改变文本的操作三层,用持久化文本变化定义有效性,首次给出主流记忆系统真实动态性的量化画像。第二,result/path 分解是新的诊断维度:在 MEME 的追踪和级联任务上分别判定"结果覆盖"(包含答案值)与"路径覆盖"(还包含时序或依赖规则与上游触发),并报告条件路径保留率 $P(\mathrm{path}\mid\mathrm{result})$,揭示检索到值的系统之间在保留推理路径上的巨大分化(62.34% vs 9.62%)。第三,完全存储 oracle 实验设计巧妙:用 gold 信息绕过各系统的原生检索,直接从其导出的完整持久化存储中按打分函数 $s(m)$ 选证据,与同条件的原始证据对照(都配 5000-token 装箱与任务策略),从而把检索失败与摄取失真分离。第四,统计严谨性罕见:20,000-50,000 次 paired bootstrap、Holm 多重比较校正、exact McNemar、Cochran's Q,覆盖率和利用率的 21 对系统两两比较均给出置信区间,这在记忆系统评测文献中几乎前所未有。
实验结果
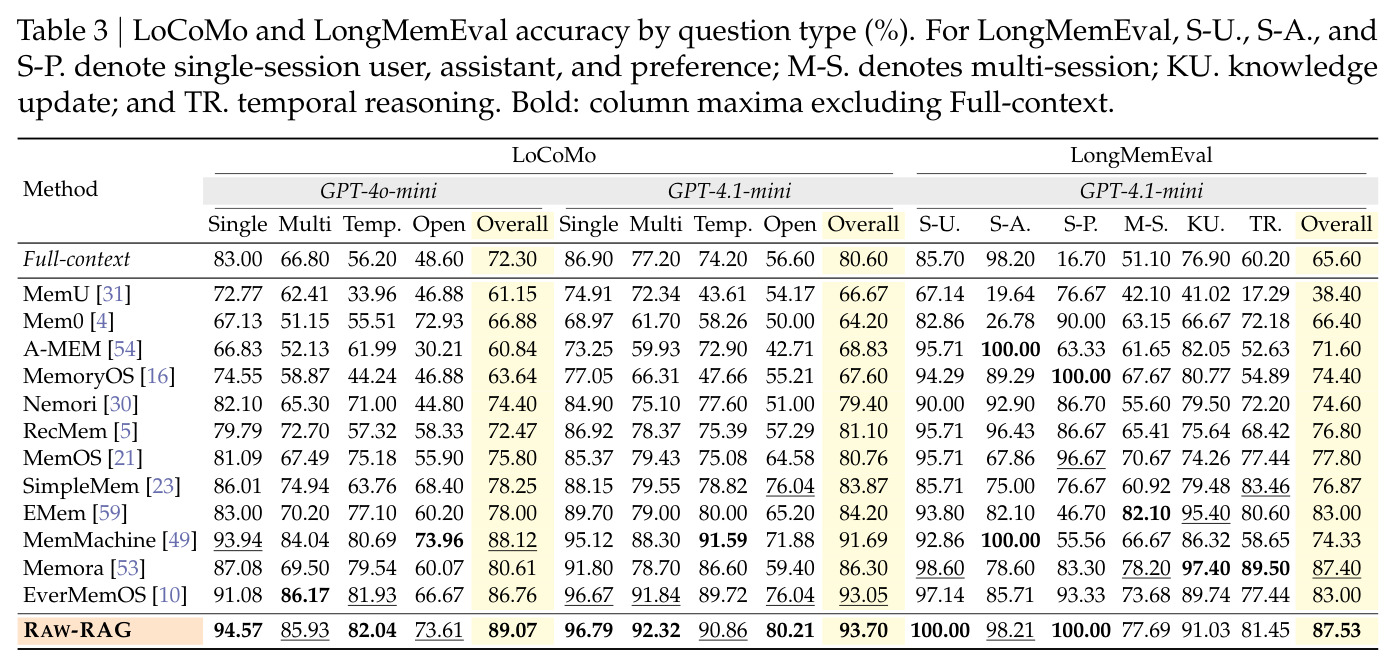
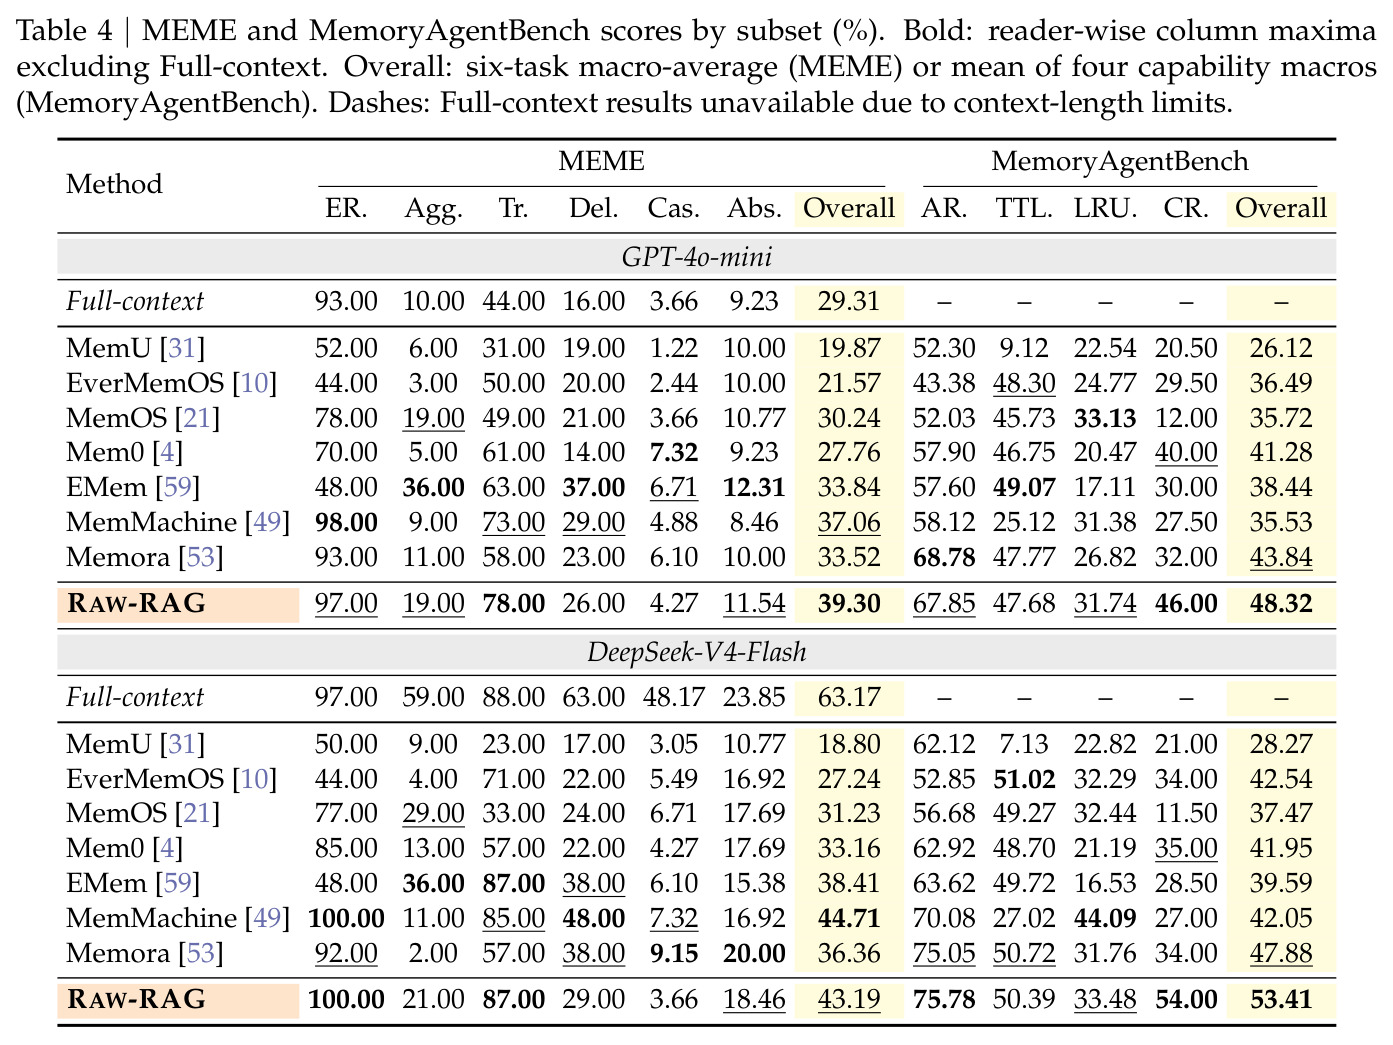
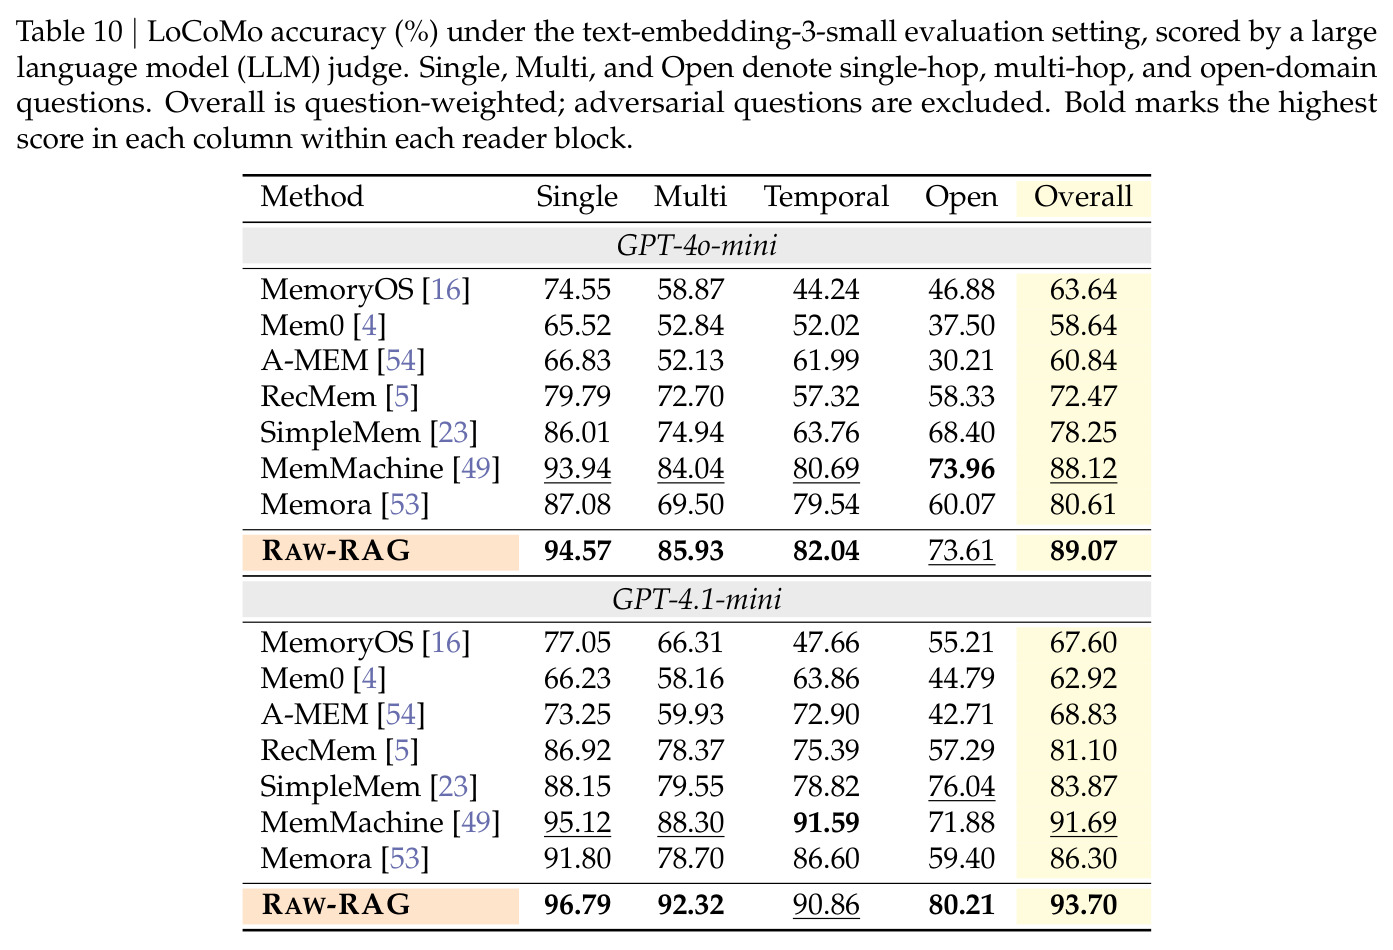
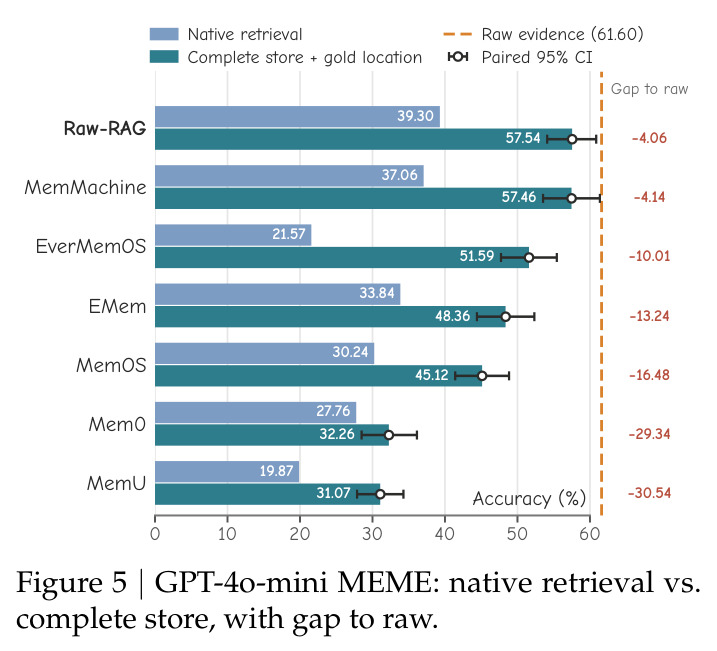
第一,主榜结果:在 LoCoMo、LongMemEval、MEME、MemoryAgentBench 四个基准共七个"基准-reader"设置中,RAW-RAG 在六个设置上排名第一,领先最强对比系统 0.13-5.53 点。具体为:LoCoMo GPT-4o-mini 89.07%(超 MemMachine 88.12)、GPT-4.1-mini 93.70%(超 91.69);LongMemEval 87.53%(超 Memora 87.40 仅 0.13);MEME GPT-4o-mini 39.30%(超 MemMachine 37.06);MemoryAgentBench GPT-4o-mini 48.32%(超 Memora 43.84)与 DeepSeek-V4-Flash 53.41%(超 47.88)。唯一例外是 DeepSeek 的 MEME:MemMachine 44.71% 领先 RAW-RAG 的 43.19%,且 Full-context(63.17%)领先 RAW-RAG 19.98 点。Qwen3 检索设置下同样领先(LoCoMo 89.13/94.55,LongMemEval 89.93 vs EverMemOS 83.00);但 PersonaMem-v2 上 49.62% 仅列第三(EverMemOS 53.25、MemOS 50.72)。第二,消融(MAB,配对 bootstrap + Holm 校正):去重排 -3.92($p_{\mathrm{Holm}}$=0.0012),只返回 1 条 -11.73,返回 120 条 -14.57(长程理解与冲突解决崩溃),而 k∈{5,10,30,60} 与分块 128-1024 差异均小于 1.3 点;三种记忆管理增强全部降分——原子事实抽取 -19.62(TTL 从 47.68 崩到 15.37),原始摘要增强 -5.81,图扩展 -5.78。第三,效率:MEME 10 集 110 问的摄取+检索总时 305.91 秒,比次快系统 EMem(1561.97s)快 5.1 倍、比 EverMemOS(9301.48s)快 30.4 倍;BEAM-1M(1710 条消息近百万 token)流式摄取 0.33 小时 vs Memora 26.95 小时;三种记忆管理增强需 21.6-109.3M LLM tokens 和 2.9-8.8 小时,RAW-RAG 只要 12 分钟。第四,诊断:覆盖率是主要瓶颈——MAB 上各系统覆盖率 19.07%-45.29%(RAW-RAG 45.29 最高)而利用率只在 80.00%-89.71% 之间波动;MEME 同型(覆盖率极差 40.66 点 vs 利用率 21.04 点),RAW-RAG 覆盖率 76.35% 最高但利用率 73.76% 并非最高,高覆盖抵消了低利用。条件路径保留率 $P(\mathrm{path}\mid\mathrm{result})$ RAW-RAG 62.34% 最高、MemMachine 56.70%、MemU 仅 9.62%。完全存储 oracle:七个存储在 gold 选证下全部提升,但仍落后原始证据 61.60%——RAW-RAG 57.54(-4.06)、MemMachine 57.46(-4.14)、EverMemOS 51.59(-10.01)、EMem 48.36(-13.24)、MemOS 45.12(-16.48)、Mem0 32.26(-29.34)、MemU 31.07(-30.54),去掉 5000-token 装箱上限后仍差 7.58-29.38 点且区间全部不含零,说明摄取时丢弃或失真的信息无法靠检索修复。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LoCoMo 整体准确率(GPT-4o-mini reader,1540 题) | LLM judge 准确率 (%) | 89.07 | 88.12(MemMachine,最强对比系统) | +0.95 |
| LoCoMo 整体准确率(GPT-4.1-mini reader) | LLM judge 准确率 (%) | 93.70 | 91.69(MemMachine) | +2.01 |
| LongMemEval-S 整体准确率(GPT-4.1-mini,500 题) | 准确率 (%) | 87.53 | 87.40(Memora) | +0.13 |
| MEME 六任务宏平均(GPT-4o-mini,1188 题) | 宏平均准确率 (%) | 39.30 | 37.06(MemMachine) | +2.24 |
| MemoryAgentBench 四能力宏平均(GPT-4o-mini,2071 题) | Overall (%) | 48.32 | 43.84(Memora) | +4.48 |
| MemoryAgentBench(DeepSeek-V4-Flash) | Overall (%) | 53.41 | 47.88(Memora) | +5.53 |
| MEME 切片(10 集 110 问)摄取+检索延迟 | Add-to-ready + Search 总时间 (s) | 305.91 | 1561.97(EMem,次快系统) | 5.1× 加速(vs EverMemOS 30.4×) |
| BEAM-1M 流式摄取(1710 条消息,近百万 token) | 累计 Add 时间 (h) | 0.33 | 3.25(MemOS,次快完成) | 约 9.8× 加速(vs Memora 26.95h 约 82×) |
| MemoryAgentBench 证据充分性(7 系统对比) | 覆盖率 (%) | 45.29 | 40.03(Mem0,次高) | +5.26 |
| MEME 证据充分性(确定性检验) | 覆盖率 (%) | 76.35 | 70.37(MemMachine) | +5.98 |
局限与改进
作者承认的局限:证据只覆盖公开基准上的离线对话,不确立交互式、多模态或运营场景的表现;原始历史留存带来存储随历史线性增长与隐私合规问题;状态重建依赖 reader 能力——MEME phase-visible oracle 中 DeepSeek-V4-Flash 总分 85.48% 而 GPT-4o-mini 仅 50.50%(级联只有 1.83%),弱 reader 能否从原始证据重建状态仍是开放问题。我自己的观察:其一,RAW-RAG 在 DeepSeek 的 MEME 上被 Full-context 甩开 19.98 点,且自身在删除(26.00)、级联(4.27)、失效(11.54)等子任务上很弱,说明需要复杂状态推理时朴素检索确实不够;其二,PersonaMem-v2 仅列第三,个性化偏好类任务未必受益;其三,top-120 时 -14.57 的崩溃暗示固定候选深度与重排器在长历史上可能失效,RAW-RAG 对超长分散证据的召回没有保证(作者也承认固定预算可能漏掉低相似度证据);其四,turn expansion 和重叠窗口造成证据冗余(LoCoMo 证据均值 4778.8 token),lost-in-the-middle 类位置效应未被处理;其五,complete-store 诊断只能导出最终存储快照,被覆写/删除的对象不可得,信息丢失的估计偏保守;其六,5k 预算对照实验中部分涨分来自 judge 重复判定的波动(LoCoMo 未改证据的 1499 题贡献了 +0.281 中的大头),显著性未检验。
独立分析的弱点
第一,检索管线完全静态:固定 top-128 召回、top-15 输出、无查询改写、无迭代检索、无任务感知的检索控制。当证据分散在多个会话或与问题词汇相似度低时(LongMemEval 多会话组合题 RAW-RAG 只有 77.69),一次向量召回容易漏,改进方向是查询分解、会话级粗排+窗口级细排的两级检索、或带停止判据的迭代检索(如 ReFind 的多轮词法检索思路)。第二,不支持权威状态与删除:原始日志永远保留旧值,无法对外暴露"当前有效状态"给下游工具,也无法响应隐私删除请求(GDPR 类合规硬伤),改进方向是原始日志+轻量可撤销视图的混合架构,用墓碑记录实现逻辑删除而不破坏原始保真。第三,reader 依赖过强:同一检索下 GPT-4o-mini 在 MEME 级联只有 4.27% 而 DeepSeek 能到 82.32%(oracle 设置),弱 reader 场景下原始证据反而难用,改进方向是为弱 reader 增加推理时状态构造,例如检索后按实体重组时间线、显式 chain-of-state 提示或轻量 state-tracking 模块。第四,证据组装固定:展示时轮次展开造成大量重复 token(三个基准证据均值均近 4000-12000 token),没有去重、没有位置感知排序,5k 对照显示去掉展开在 LongMemEval 还涨 1.67 点,改进方向是智能去重(实验显示朴素 display-turn 去重反而 -2.39,需要更精细的策略)、证据压缩与 relevant-first 排序。第五,评测只覆盖静态离线 QA,未测交互式写入、主动记忆维护、多用户共享记忆等真实运营需求。
未来方向
作者明确提出的方向:在更长历史和更多模型上评测,同时纳入显式隐私与删除约束;识别结构化或压缩记忆何时真正优于原始检索,把精度-延迟-算力成本的权衡显式化;检验显式状态维护是否对弱 reader 有益、或能减少跨查询的重复推理成本。基于本文成果可自然延伸的方向:其一,把 RAW-RAG 与其覆盖率/利用率/路径保留诊断做成社区标准工具,要求所有记忆系统论文报告对 well-specified 朴素基线的增益与诊断分解,从评测文化上杜绝弱基线;其二,混合架构研究——原始日志保底、按查询需求选择性构建结构索引(按需建图而非预先建图),可能兼得覆盖与推理便利;其三,把本文的写决策审计推广到更多系统与真实用户日志,刻画"什么任务分布下突变率会超过 2%"从而划定 agentic memory 的适用边界;其四,检索器与 reader 的协同设计:既然利用率各系统接近(80-90%),下一步提升空间在覆盖率,可探索多查询、多粒度索引(窗口+轮次+会话三层)与检索-重排联合训练;其五,交互式、多模态、运营记忆场景的新基准,以及带隐私约束的原始留存机制(加密检索、按需遗忘、检索结果差分隐私过滤)。
复现评估
复现条件较好。代码开源于 GitHub(Litmeb/RAW-RAG),四个主基准加两个补充基准(PersonaMem-v2、BEAM)全部公开。RAW-RAG 本身算力需求极低:摄取零 LLM 调用,只需嵌入模型与重排器(text-embedding-3-small + Cohere Rerank-v3.5,或开源的 Qwen3-Embedding-4B + Qwen3-Reranker-4B),MemoryAgentBench 11 个源的 Add+Search 仅 718.4 秒、0 个 LLM token,单卡或纯 API 即可跑主方法。附录质量很高:附录 D.3 逐一给出 12 个基线系统的配置,附录 G 复现全部 prompt 模板(reranker、三种记忆管理变体、各基准 reader 与 judge),附录 C.6 规定统计流程。难点主要有三:基线对比部分依赖托管服务(Mem0、MemOS 用早期 hosted 配置),API 成本与行为随时间变化会影响复现;评测用 GPT-4o-mini judge 每答案判三次,存在随机波动(作者自己指出部分对照涨分含 judge 变异性);完整复现所有诊断(5 万次 bootstrap、七个系统存储的 gold 导出与 oracle 实验)工程量不小,但主榜结果和消融是容易复现的。总体难度:主结果中等偏低,全套诊断中等偏高。
论文图表
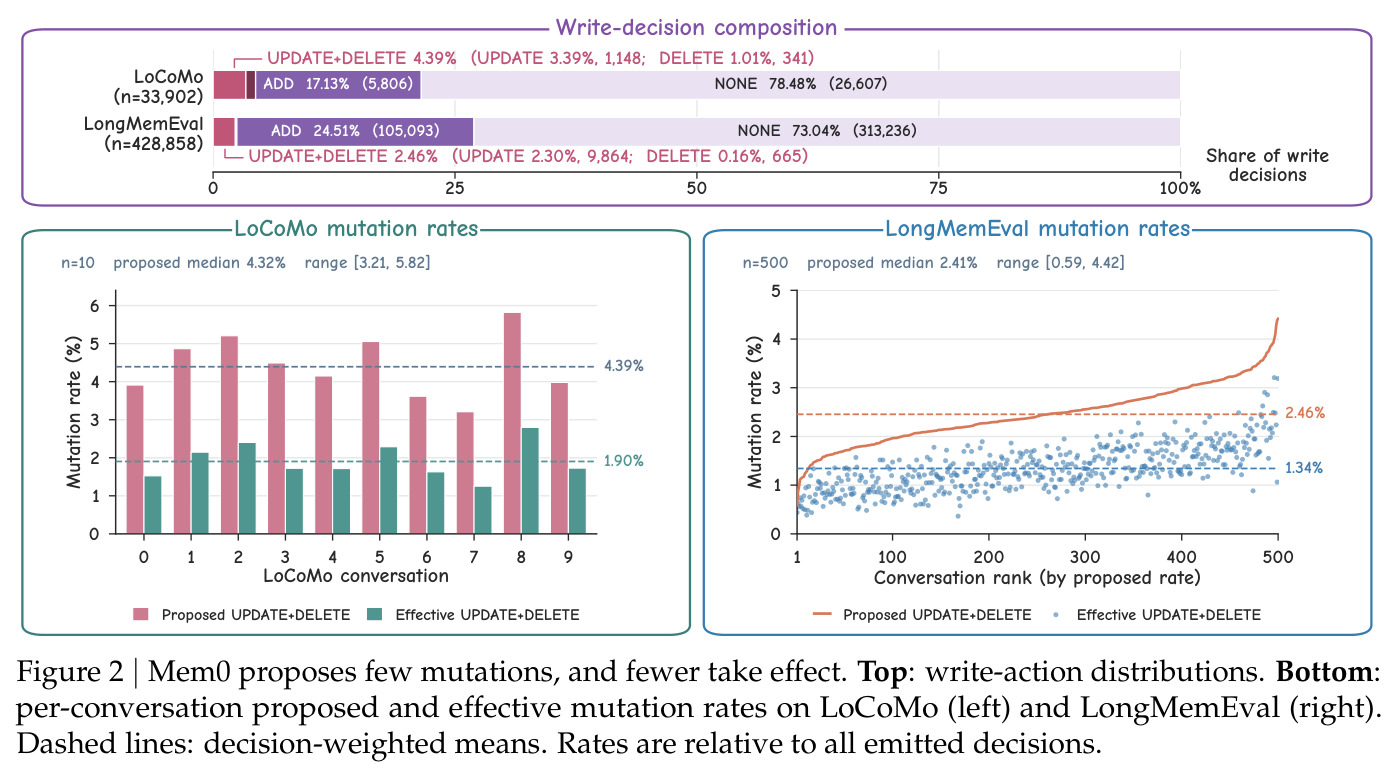
动机审计图。上半部分是 Mem0 写决策分布的堆叠条形图:LoCoMo 33,902 个决策中 NONE 占 78.48%(26,607)、ADD 占 17.13%(5,806)、UPDATE+DELETE 仅 4.39%(UPDATE 3.39% 1,148 次,DELETE 1.01% 341 次);LongMemEval 428,858 个决策中 NONE 73.04%、ADD 24.51%、UPDATE+DELETE 2.46%。下半部分逐对话展示"提议突变率"与"有效突变率":LoCoMo 提议中位数 4.32% 而均值仅 1.90%,LongMemEval 提议中位数 2.41% 而均值 1.34%,说明大量提议是重复或无效的。
这是全文论证的起点:用数据证明显式状态修改在真实记忆任务中极少发生且常常无效,直接动摇了复杂智能体记忆系统存在的必要性前提。