ReGE:通过经验合成打造更强的智能体 ReGE: Stronger Agents through Experience Synthesis
单次教练调用把多次尝试记录合成为自包含指引,同款模型免训练平均提升约9个百分点
前置知识
推理时扩展与重复采样
在不改变模型参数的情况下,通过多次采样同一任务来提升成功率。Large Language Monkeys 等工作已证明 pass@K 随采样数 $K$ 上升,远高于 pass@1。但拿到 $K$ 条轨迹后如何利用是关键:Self-Consistency 只做答案投票,Best-of-N 依赖评判模型挑最好的一条,两者都丢弃过程信息。
ReGE 正是在回答「$K$ 条轨迹如何高效复用」这一问题:它把源池 $P=\{\tau_1,\dots,\tau_K\}$ 变成新执行的指引。不先了解重复采样这条研究线,就无法理解论文的问题设定与基线选择。
Self-Consistency 与生成式聚合
Self-Consistency(SC)对多条推理链的最终答案做多数投票 $y=\mathrm{majority}\{y_i\}$,简单但丢掉全部过程信息。Self-MoA 等生成式聚合则把多个候选放进同一上下文,由模型一次性综合出更优答案,但产物仍是「答案」而非可执行的过程指引,且不涉及后续的环境交互。
ReGE-Syn 与 Self-MoA 同属单次联合聚合,但把聚合目标从「给出答案」改为「写出供学生在重置环境中执行的计划」,这一区别是论文全部对比实验(Table 1、Table 9)的核心。
Reflexion 与智能体记忆
Reflexion 在任务失败后用自然语言反思生成经验教训供下一轮使用,属于串行的自我改进,需要多轮迭代。后续工作如 ExpeL(从积累经验中提炼洞见)、Agent Workflow Memory(归纳可复用工作流)、AutoGuide/AutoManual(自动生成指南与手册)、Voyager 与 A-MEM(技能库与链接记忆)进一步把经验沉淀为跨任务资产。
论文用 Reflexion 作为基线之一,并把 ReGE 定位为「任务内、并行的经验复用」,与这些跨任务记忆方法形成正交互补。理解这条脉络才能看清 ReGE 的定位与局限。
交互式智能体基准
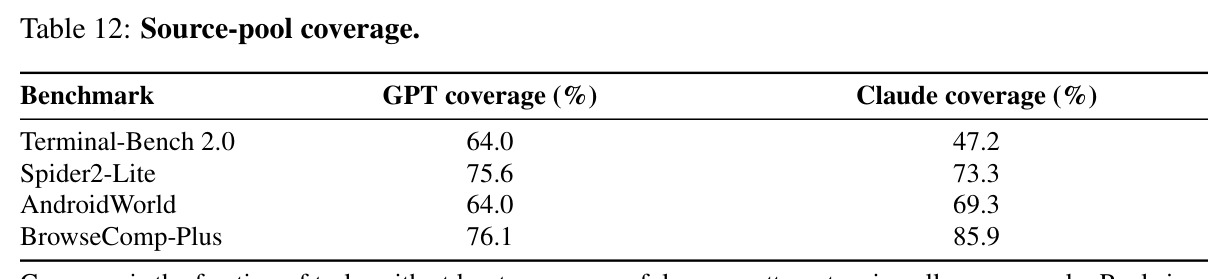
Terminal-Bench 2.0(89 个终端任务,30 步预算)、Spider2-Lite(135 个本地 SQLite 文本转 SQL 实例,18 次 SQL 调用上限)、AndroidWorld(安卓模拟器操作,114 个模板,T3A 文本智能体)、BrowseComp-Plus(830 个深度检索问答,100,195 篇固定文档语料,40 步预算)都需要智能体在多步交互后由官方评测器打分。
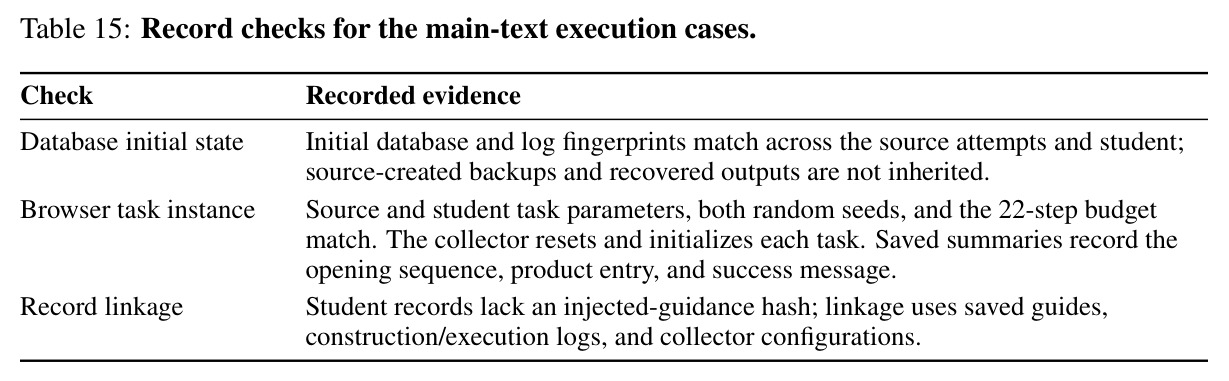
ReGE 的核心设定是「环境重置后状态不保留」:上一次创建的文件、到达的页面都不会自动带过来。这些基准正是检验学生能否在新环境中按指引重新执行操作的地方,理解各基准的交互形式才能读懂实验。
token 成本与推理开销计量
LLM API 按输入加输出 token 计费。论文把开销拆为三段:源池生成($K$ 次尝试)、指引构造(教练/评审/摘要调用)、学生执行。主指标是构造+执行的 input+output 总量(不含源生成),同时用相对 Control 的倍数和每任务美元成本(含与不含源池两种口径)报告。
ReGE 的卖点一半在精度、一半在成本:构造 token 相比 AggAgent 减少 98.2%/95.5%,但学生执行更贵。不熟悉这套计量口径就看不懂 Table 3、Table 5 与 Figure 1 中成本数字的真正含义。
教师-学生框架
传统做法由更强的教师模型产出蒸馏信号或指导,学生模型学习模仿,往往涉及参数微调。ReGE 刻意不这么做:源生成、经验合成与学生执行使用同一个基础模型 $\theta$,无参数更新、无更强教师,教练和学生只是同一模型的两种提示角色。
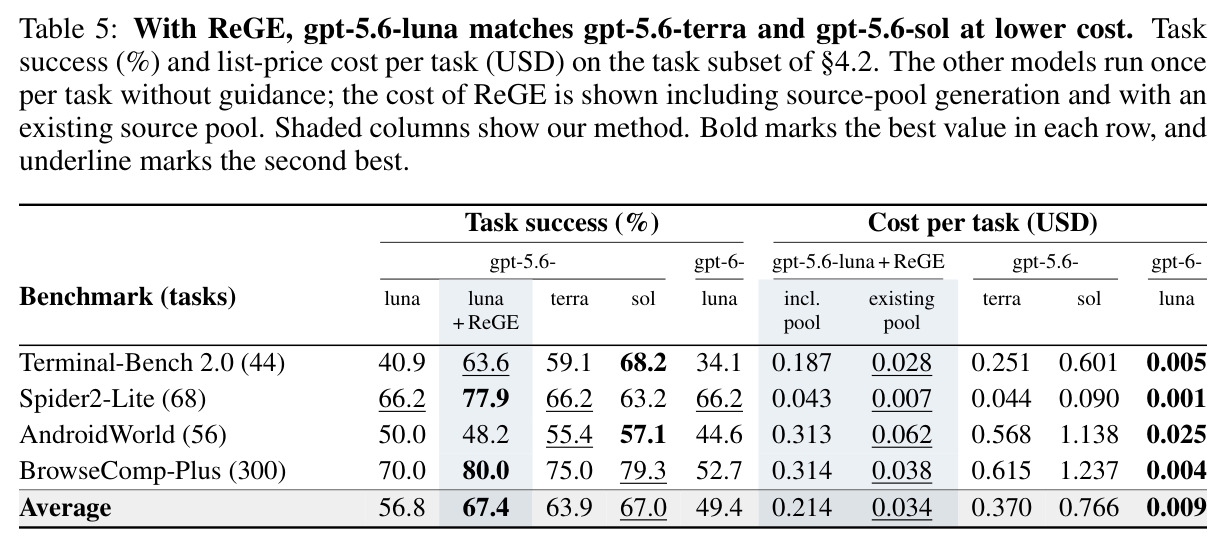
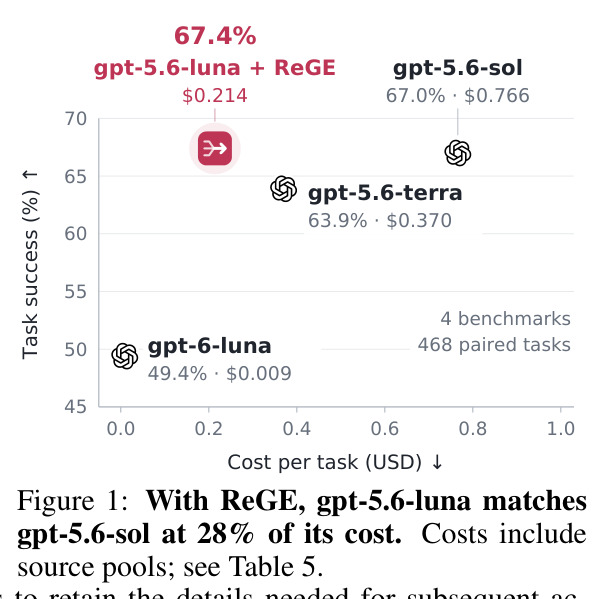
「同款低价模型靠组织自身经验能否匹敌高价模型」是论文的旗舰结论(gpt-5.6-luna+ReGE 以 28% 成本追平 gpt-5.6-sol),理解这一设定才能把握 §4.2 实验设计动机。
研究动机
交互式任务中,智能体反复尝试同一任务能发现单次运行遗漏的事实、可用操作与失败教训,重复采样研究已证明 pass@K 远高于 pass@1。但把这些经验喂给下一次尝试存在三个具体障碍。其一是环境重置性:上一次尝试创建的文件、到达的应用状态都不会自动保留——比如数据库恢复任务里找到的 XOR 解码密钥 0x42 只是一段文字记录,新执行必须对初始状态重新完成备份、解码、恢复等全部操作。其二是记录冗长且正确性未知:四次尝试的完整轨迹可达数十万字符,真假信息混杂,而基准的正确性标签对教练和学生都必须隐藏,无法靠评分筛掉错误发现。其三是现有复用方案各有短板:Self-Consistency 投票只保留最终答案、丢弃全部过程信息;AggAgent 让聚合智能体用工具迭代检查候选轨迹,构造开销巨大(BrowseComp-Plus 上平均每查询 232.9k token,成功率仅 75.3%);PDR 式独立摘要对每条轨迹单独摘要再拼接,各摘要之间无法交叉整合信息。核心难题是:如何既保留后续行动所需的细节,又把新智能体要消化的历史压到最小?
本文的目标是本文的目标是在不更新任何参数、不引入更强教师的前提下,回答「智能体如何把自身尝试的经验转化为更有效的后续执行」。具体拆成三个可检验的子目标。第一,提升成功率:在 Terminal-Bench 2.0、Spider2-Lite、AndroidWorld、BrowseComp-Plus 四个基准上,相对无指引执行取得稳定的百分点提升,且学生必须在重置后的环境中真正执行操作而非复述答案。第二,压低经验复用成本:指引构造阶段要远比迭代式聚合便宜(对照 AggAgent 每查询 200k+ token 的构造开销),同时构造加执行的总 token 不高于各基线。第三,验证自举上限:同一低价模型(gpt-5.6-luna)借助自身经验能否匹敌同族更高价模型(gpt-5.6-terra、gpt-5.6-sol)。方法约束包括:源生成、合成、执行共用同一基础模型 $\theta$;教练和学生都看不到正确性标签;指引必须自包含——学生只拿指引、不看原始轨迹,从而模拟真实部署中「经验可迁移、状态不可迁移」的情形。
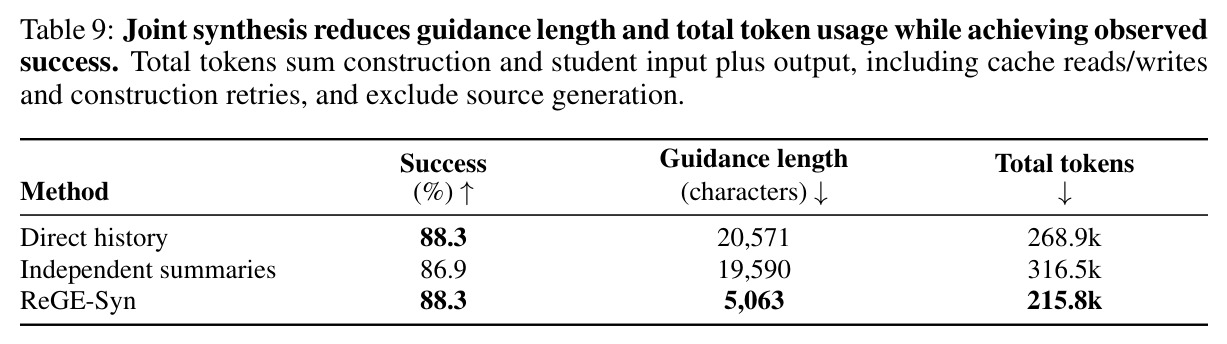
与已有工作不同的是,论文的独特切入是把「聚合」与「再执行」连成一个闭环。已有工作要么聚合后直接给出答案(SC、Self-MoA,没有学生重跑),要么反思-重试串行进行(Reflexion,一条轨迹反复改进),要么用智能体反复调用工具检查轨迹(AggAgent,构造昂贵且不重跑)。ReGE 的关键观察是:有用的发现天然分散在不同尝试中——一次尝试找到关键事实、另一次找到可用命令、第三次暴露失败陷阱——因此最优做法不是先各自摘要再拼接,而是把有界的执行记录整体放进同一个共享上下文,让教练在一次调用里完成跨轨迹的取舍与连接,产出按执行顺序组织的计划,把精确路径、命令、数值、格式要求放在对应步骤旁边,并附上陷阱警告和候选答案的验证方式。这既区别于独立摘要的分而治之(Independent summaries 指引长 19,590 字符),也区别于把原始历史直接塞给学生(Direct history 指引长 20,571 字符且总 token 268.9k,均劣于 ReGE-Syn 的 5,063 字符与 215.8k)。作者还强调该方案与 agent swarm 互补:并行子智能体系统的记录正需要廉价的整合手段。
核心方法
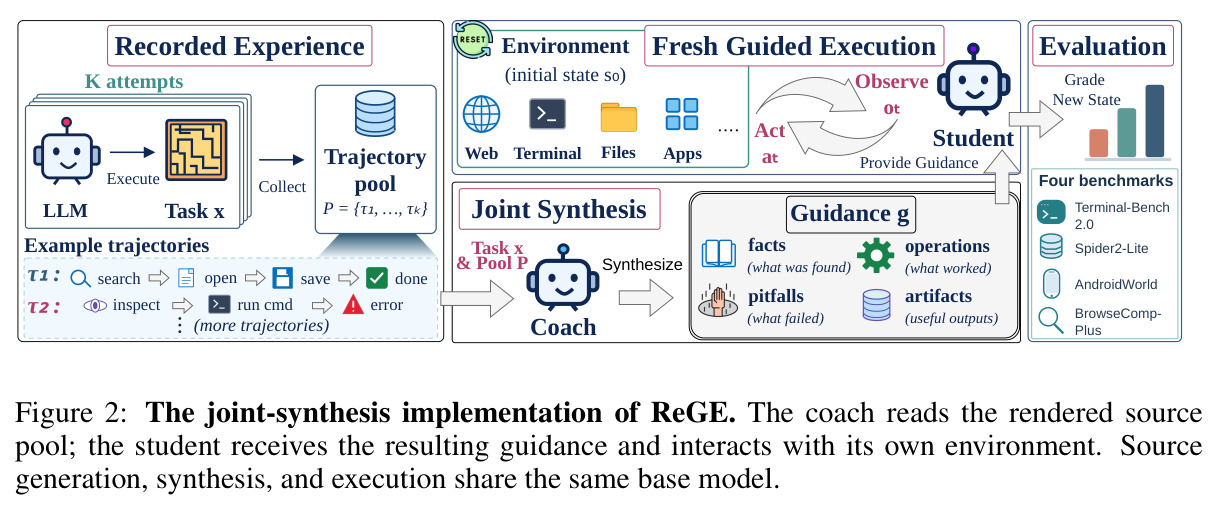
ReGE(Re-execution Guided by Experience)的整体思路可以概括为「先抄好笔记,再照着做但要当场核对」。形式化地,任务由指令 $x$、初始环境状态 $s_0$ 和基准评测器组成。第一步,源池生成:用同一基础模型 $\theta$ 对任务独立执行 $K=4$ 次得到源池 $P=\{\tau_1,\dots,\tau_K\}$。第二步,渲染与联合合成:程序化地把每条轨迹渲染成文本块 $V(P)$(按步保留推理叙事与命令,后接最终 artifact),交给教练做单次调用合成指引 $g=C_\theta(x,\,V(P);\,p_{\mathrm{syn}})$,要求输出可执行的编号步骤计划,把发现的具体路径、数值、命令、格式要求与踩坑警告放到对应步骤处;若证据足以支撑候选答案,则把答案连同验证方法一并写入计划。第三步,学生执行:新学生策略 $\pi_\theta$ 只拿指引 $g$,从 $s_0$ 出发开始全新交互 $\tau^g\sim\mathrm{Run}(\pi_\theta,\,x,\,s_0;\,g)$,用当前观察采纳、调整或跳过建议操作,结束后由基准评测器对最终状态或提交输出打分。全程无参数更新,源生成、合成、执行三个阶段共用同款模型。框架还包含变体 ReGE-Sel(评审单选一条轨迹作指引)。
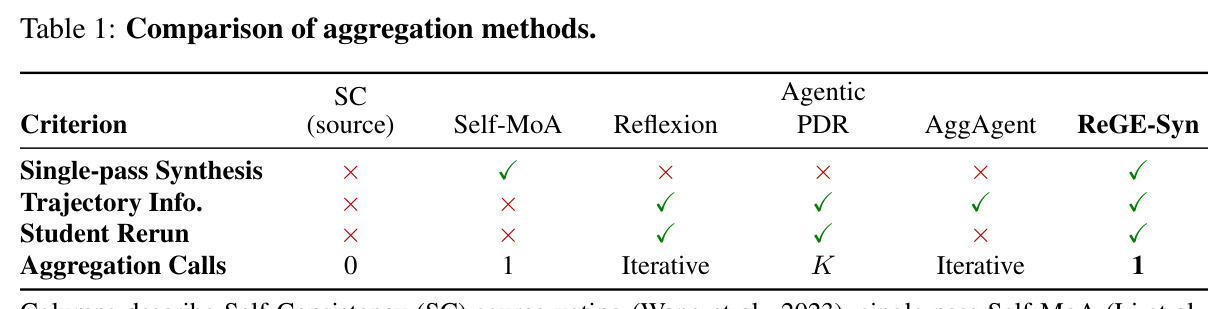
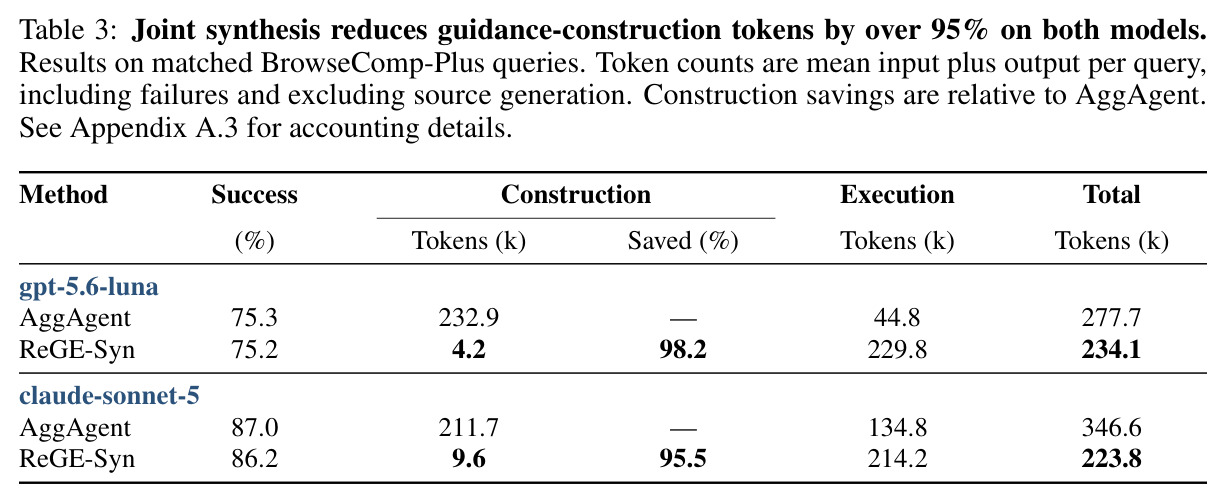
核心创新点是「单次联合合成」这一构造方式及其产物的重新定位。与 Self-MoA 的本质区别在产物:Self-MoA 聚合出最终答案就结束,ReGE-Syn 聚合出的是供学生在重置环境中继续交互、边执行边验证的计划,把聚合与执行解耦成教练/学生两个角色。与 Reflexion 和 agentic PDR 的区别在决策时机:独立摘要式方法在拼接之前各自决定保留什么,信息无法跨轨迹互补,Reflexion 还需多轮迭代;ReGE-Syn 让所有源块共享一个上下文,一次前向就完成「哪些发现该保留、哪些失败该警告、哪个候选答案可信」的联合决策。与 AggAgent 的区别在构造成本:AggAgent 让聚合智能体反复用工具检查轨迹(每查询构造 232.9k token),ReGE-Syn 只需一次教练调用(GPT 4.2k、Claude 9.6k token),构造成本降低 98.2%/95.5% 而成功率几乎不变(75.2% vs 75.3%)。另一个关键设计是承认经验不可全信:源尝试成败标签不可见,指引必须自包含且附验证要求,由学生在真实环境中核对——Table 1 的对比矩阵显示,此前没有方法同时做到单次合成、保留轨迹信息并让学生重跑。
方法步骤详情
步骤一(源池构建):对每个任务独立执行 $K=4$ 次尝试,保留推理叙事、命令与最终 artifact(Terminal-Bench 产出文件、Spider2 的 SQL 与结果、BrowseComp-Plus 提交答案、AndroidWorld 动作摘要);空尝试也留在池中。渲染时每源最多 120 步,推理每步截 200 字符、命令 160 字符,artifact 上限 6,000 字符;总序列化超 350,000 字符时先删 artifact 正文只留路径,仍超限则硬截断并标记。逐步环境观察与正确性标签均不进入教练输入。步骤二(联合合成):教练系统提示为「你是聚合智能体,多次尝试的正确性未知,你没有标准答案」,要求输出:(1) 按执行顺序编号的步骤;(2) 放在对应步骤处的关键事实(路径/数值/命令/格式/边界情况);(3) 陷阱与规避方法;(4) 若证据支持最终答案,写出答案及验证方式。步骤三(指引交付):配 header「follow it but verify as you go」,在 Terminal-Bench/Spider2 前置于指令、AndroidWorld 走 T3A 原生 guideline 接口、BrowseComp-Plus 追加到用户消息。步骤四(学生执行与评分):学生从 $s_0$ 重新开始,预算与 Control 一致(Terminal-Bench 30 步、BrowseComp-Plus 40 步),由官方评测器打分。变体:ReGE-Sel 用评审单选一条轨迹作指引;ReGE-A 让教练改输出「解释+答案」两段。
技术新颖性
技术新颖性可归纳为四点。第一,方法学定位:Table 1 的对比矩阵显示,ReGE-Syn 是唯一同时满足单次合成、保留轨迹级信息、支持学生重跑且只需 1 次聚合调用的方法——SC 单次但丢弃轨迹,Self-MoA 单次但无学生重跑,Reflexion/PDR 有轨迹但需迭代多次(PDR 逐轨迹摘要 $K$ 次再拼接),AggAgent 迭代且不重跑。第二,正确性不可知下的经验合成:源尝试成败未知,教练被要求把候选答案与验证方法一并写入指引,学生负责在真实环境中核对,这形成「教练负责整合、学生负责证伪」的分工,无需评测器或更强模型介入。第三,成本结构重设计:把经验整合从推理开销的大头变成一次廉价调用,实测构造 token 从 232.9k 降到 4.2k(GPT),构造+执行总 token 234.1k 反而低于 AggAgent 的 277.7k,是 Control/Reflexion/AggAgent/ReGE-Syn 四者中最低。第四,同款模型自举:不用更强教师,靠组织自身经验让低价模型 gpt-5.6-luna 达到 67.4%,追平 gpt-5.6-sol 的 67.0%,成本仅 28%,为 agent swarm 等并行系统的记录整合提供了低成本范式。
实验结果
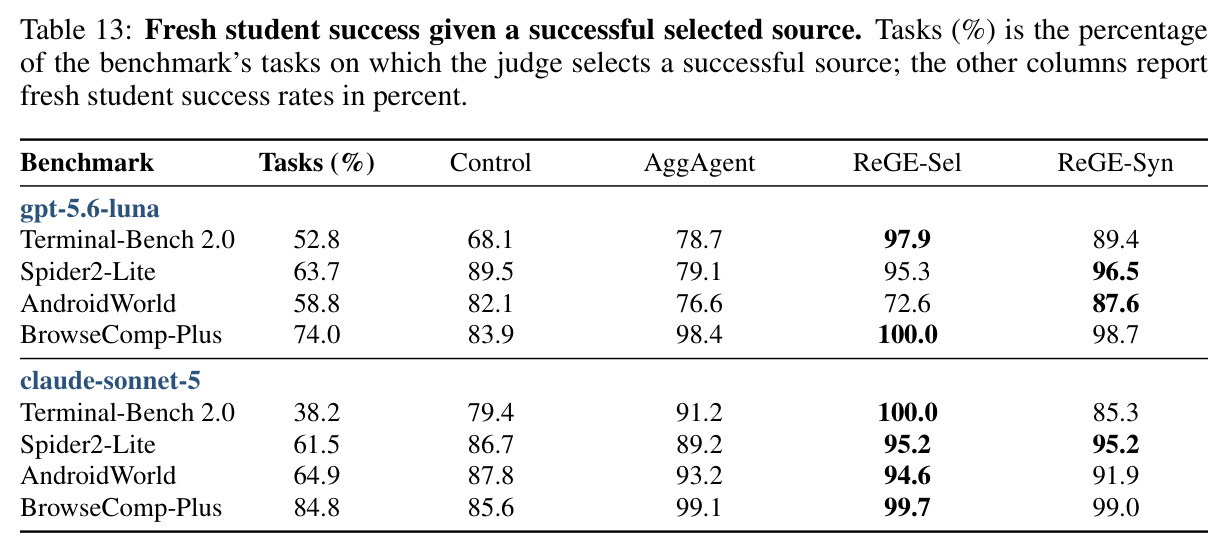
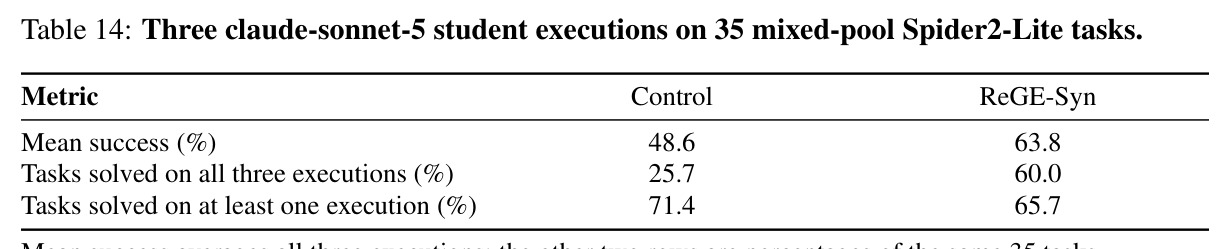
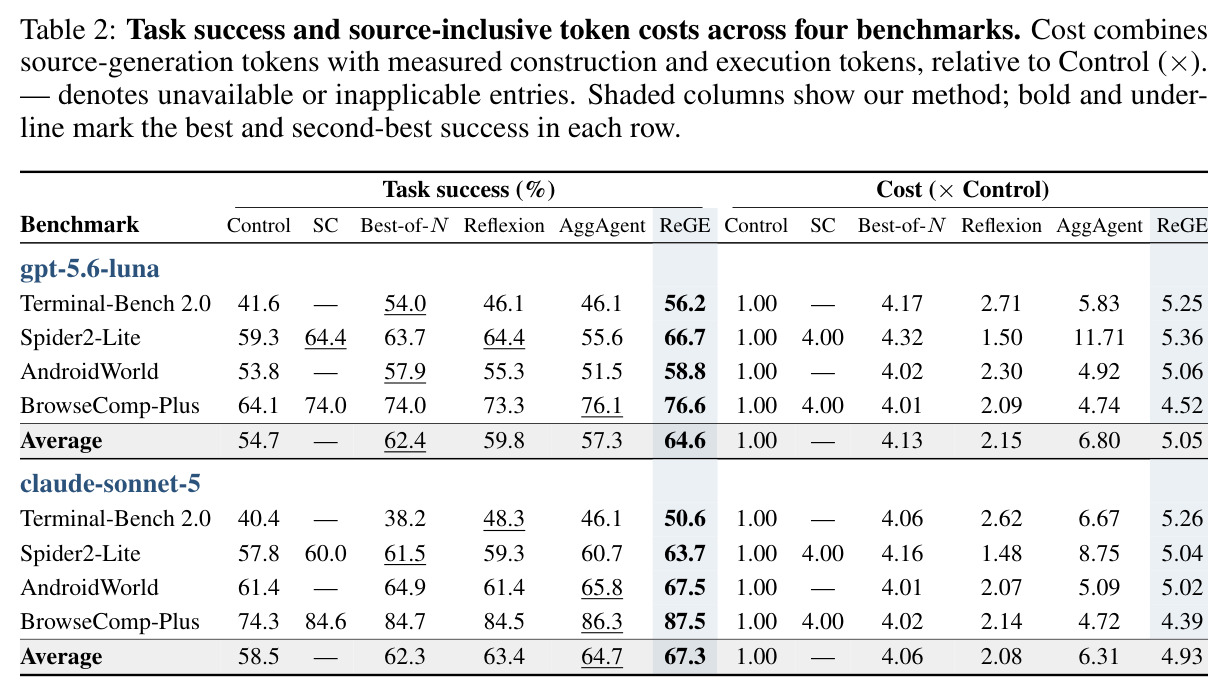
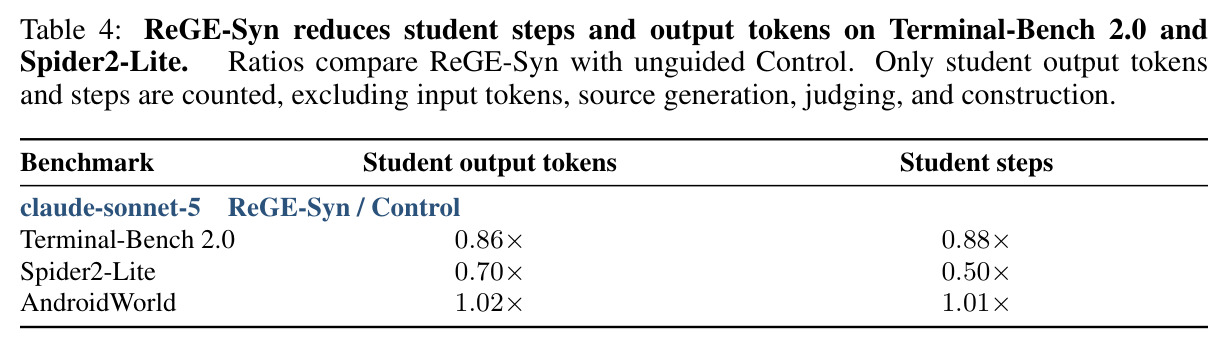
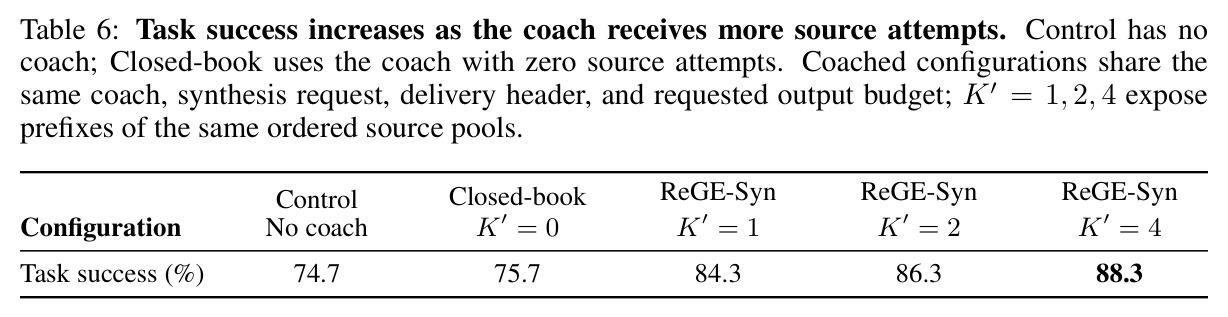
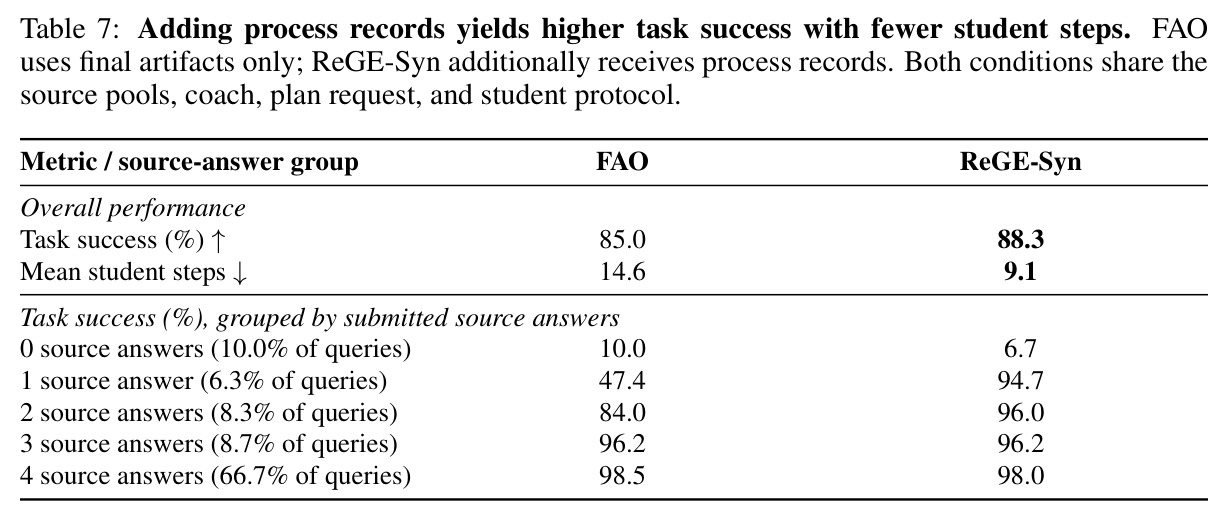
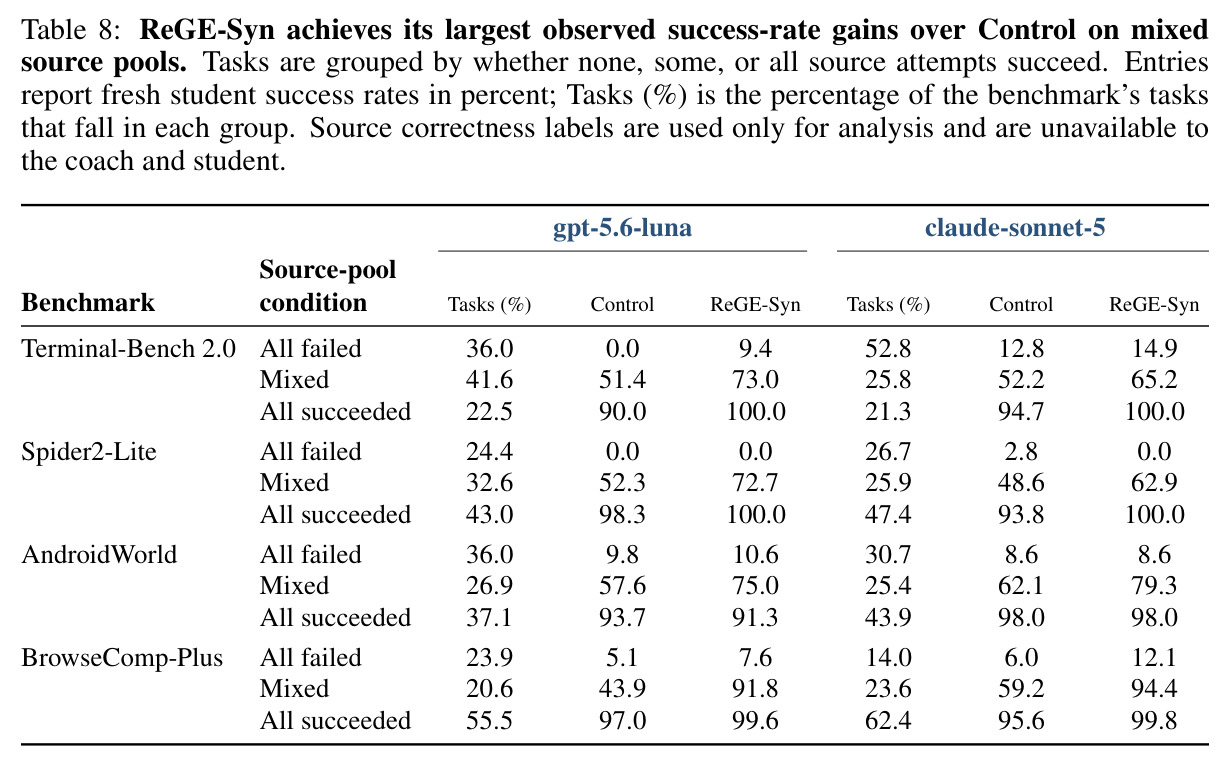
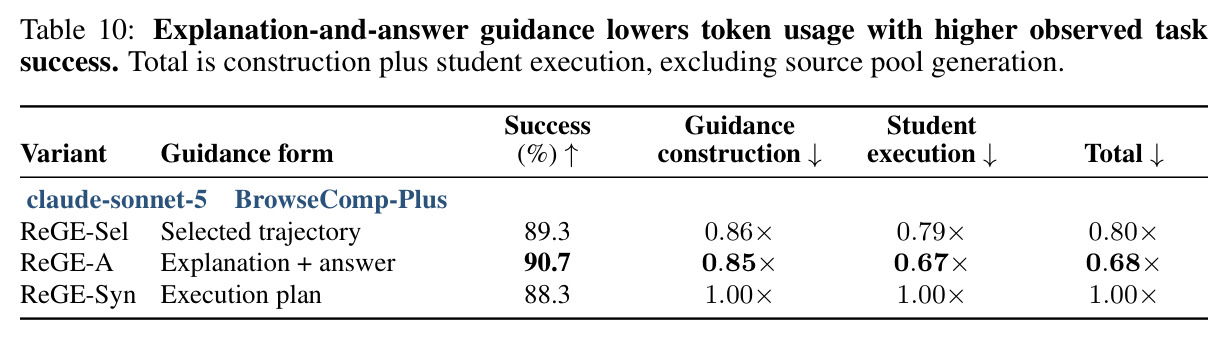
主结果分六组。(1) 总体提升:四个基准上 gpt-5.6-luna 平均成功率 54.7%→64.6%(+9.9pp),claude-sonnet-5 58.5%→67.3%(+8.8pp);GPT 在 Terminal-Bench 2.0 提升 14.6pp(41.6%→56.2%)、BrowseComp-Plus 提升 12.5pp(64.1%→76.6%),ReGE 几乎处处最佳或次佳。(2) 构造成本:匹配 BrowseComp-Plus 子集上 ReGE-Syn 构造 token 仅 4.2k(GPT)/9.6k(Claude),较 AggAgent 的 232.9k/211.7k 节省 98.2%/95.5%;学生执行虽更贵,构造+执行总量仍下降 15.7% 与 35.4%。(3) 跨模型对标(468 个配对任务):gpt-5.6-luna+ReGE 平均 67.4%,超 gpt-5.6-terra(63.9%)、追平 gpt-5.6-sol(67.0%),远超 gpt-6-luna(49.4%);含源池生成成本 $0.214/任务,为 sol($0.766)的 28%,源池已存在时仅 $0.034。(4) 源数量消融:无教练的 Closed-book 75.7%≈Control 74.7%,K'=1/2/4 分别为 84.3%/86.3%/88.3%,证明增益来自经验本身而非教练提示。(5) 过程信息价值:只给最终答案的 FAO 85.0%、均 14.6 步,完整输入 88.3%、9.1 步;仅一条源答案的查询上 FAO 47.4% vs ReGE 94.7%,94.1% 的 FAO 失败源于耗尽 40 步预算。(6) 混合源池收益最大(BrowseComp-Plus GPT 43.9%→91.8%,+47.9pp),全失败池收益有限(GPT Spider2-Lite 0%→0%);变体 ReGE-A 90.7%(总 token 0.68×)、ReGE-Sel 89.3%(0.80×)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.0(GPT,终端任务) | 任务成功率 | 56.2%(ReGE) | 41.6%(Control) | +14.6 个百分点 |
| Spider2-Lite(GPT,文本转 SQL) | 任务成功率 | 66.7%(ReGE) | 59.3%(Control) | +7.4 个百分点 |
| AndroidWorld(GPT,安卓模拟器操作) | 任务成功率 | 58.8%(ReGE) | 53.8%(Control) | +5.0 个百分点 |
| BrowseComp-Plus(GPT,深度检索问答) | 任务成功率 | 76.6%(ReGE) | 64.1%(Control) | +12.5 个百分点 |
| Terminal-Bench 2.0(Claude) | 任务成功率 | 50.6%(ReGE) | 40.4%(Control) | +10.2 个百分点 |
| BrowseComp-Plus(Claude) | 任务成功率 | 87.5%(ReGE) | 74.3%(Control) | +13.2 个百分点 |
| BrowseComp-Plus 匹配子集(GPT) | 指引构造 token(均值/查询) | 4.2k(ReGE-Syn) | 232.9k(AggAgent) | 节省 98.2% |
| BrowseComp-Plus 匹配子集(Claude) | 构造+执行总 token | 223.8k(ReGE-Syn) | 346.6k(AggAgent) | 下降 35.4% |
| 468 个配对任务(跨模型对标) | 成功率 / 每任务成本 | 67.4% / $0.214(gpt-5.6-luna+ReGE,含源池) | 67.0% / $0.766(gpt-5.6-sol 单跑) | 精度持平,成本降至 28% |
局限与改进
作者承认的局限:评测仅覆盖四个基准,消融只在选定子集(BrowseComp-Plus 300 条、468 个配对任务)上进行,缺少更广任务类型和同设置下重复执行的方差估计。我补充几点观察。第一,源池生成不便宜:含源生成时 ReGE 总成本是 Control 的约 5.05–5.25 倍(Table 2),只有本来就打算并行采样或源池可复用时才划算。第二,全失败源池收益不稳定:GPT Spider2-Lite 上 0.0%→0.0%,说明经验复用依赖池中存在可提取的有效信息。第三,学生努力下降并不普遍:AndroidWorld 上学生输出 token 比值 1.02×、步数 1.01×,几乎没有节省,效率收益集中在 Terminal-Bench(0.86×)与 Spider2-Lite(0.70×,SQL 调用减半)。第四,Table 6 中源数量与输入长度同步增长,无法分离「更多经验」与「更长上下文」的贡献,作者自己也承认这不是等成本对比。第五,6 源实验只在 100 条查询上进行,+4/−0 的差异 p=0.125 不显著。第六,成本结论绑定特定商业模型定价(如 gpt-5.6-sol 每百万输出 token $20),价格变动会改变对标结论。第七,未测试教练与学生异构、或源池模型弱于学生时的表现,也未涉及指引质量随源池规模超线性变化的场景。
独立分析的弱点
独立分析三个弱点。其一,经验只限任务内:ReGE 仅复用同一任务的并行尝试,与 Agent Workflow Memory、ExpeL 等跨任务工作流学习正交;像「先备份再打开数据库」这类教训其实是可泛化的操作模式,改进方向是在任务级指引之上增加一层跨任务洞见库,按任务类型检索注入。其二,对源池质量敏感且无失败出口:当四次尝试全失败(GPT Terminal-Bench 36% 的任务如此)时翻案率仅 9.4%,而教练仍会产出看似可信的指引,可能误导学生浪费预算;改进方向是给教练增加「信息不足」的显式声明机制,让学生对无经验覆盖的子问题回归自主探索,或在合成前引入源池自评/答案一致性过滤。其三,指引形式与模型强耦合:Table 10 显示 ReGE-A(解释+答案)在 Claude 上 90.7% 优于计划式 88.3% 且总 token 仅 0.68×,但在 GPT 的 100 条查询对比中反而 80% vs 82% 落后,说明最优形式因模型而异;可做指引形式的自动路由,或让学生自选粒度。此外学生执行 token 显著上升(GPT 229.8k vs AggAgent 学生的 44.8k),可在指引中附「预期步数」或早停条件来约束学生的探索范围。
未来方向
作者明确提出的延伸方向是 agent swarm 记录整合:Kimi K2.5 等并行子智能体系统会在同一任务上产生大量记录,ReGE-Syn 提供了把它们廉价整合为单次新执行指引的互补方案。基于论文成果可继续推进的方向包括:(1) 与跨任务记忆结合,把高频成功操作沉淀为可检索的工作流库,形成任务级指引与通用经验的两级复用;(2) 指引形式自适应——依据任务类型、源池质量或模型偏好,在执行计划(ReGE-Syn)、解释+答案(ReGE-A)、单轨迹选择(ReGE-Sel)之间自动路由;(3) 串行叠加的迭代 ReGE——学生失败后再补一次合成与执行,检验多轮「执行-再合成」的收益曲线与停机准则;(4) 源内冲突消解:不同尝试给出矛盾数值或互斥命令时(如 Spider2 任务中四种年份解析导致四个不同计数),如何做置信度加权与证据仲裁仍待研究;(5) 更真实的成本核算:把缓存读写、构造重试、评审调用全部纳入的帕累托前沿分析;(6) 把该框架接入开源基准的持续评测管道,让经验池随版本自动积累与淘汰。
复现评估
代码已开源(GitHub: TIGER-AI-Lab/ReGE),四个基准全部公开:Terminal-Bench 2.0(89 任务)、Spider2-Lite(135 实例,本地 SQLite 只读)、AndroidWorld(安卓模拟器,剔除 2 个崩溃模板后 114 模板)、BrowseComp-Plus(830 查询 + 100,195 篇固定文档,无实时网络)。附录 A.1/A.2 给出完整复现规格:渲染字段映射、截断限制(每源 120 步、推理 200 字符、命令 160 字符、artifact 6,000 字符、总量 350k)、教练/评审/独立摘要的全部 prompt 原文、token 计费口径与重试规则。复现门槛主要是 API 费用而非算力:无需训练、无需 GPU,按论文价目含源池生成约 $0.214/任务(gpt-5.6-luna),全量复现主表加消融估计需数百美元;AndroidWorld 需本地模拟器环境,BrowseComp-Plus 评审用 DeepSeek-V4-Flash(关闭推理)。风险点:论文使用 2026 年的商业模型(gpt-5.6-luna、claude-sonnet-5、gpt-5.6-sol 等),若无对应 API 权限需换模型并重调提示;成本对标依赖厂商定价。整体属于中等偏易复现,工程量集中在环境搭建与 token 记账。
论文图表