X-Tree:将可复用经验标记化以实现高效智能体泛化 X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
用类BPE方法从轨迹中零LLM调用挖掘技能树,并以数据、奖励、上下文三种方式注入智能体训练
前置知识
SFT(监督微调)
用人工标注或模型合成的(任务,动作序列)数据对预训练语言模型做下一词元预测训练。标准做法是每条训练样本监督一个动作,损失函数对序列中每个 token 均匀加权,因此轨迹中反复出现的子过程(哪些动作组成一个技能)不会获得任何额外权重,层次结构被扁平化处理。
均匀加权、自底向上的扁平训练正是本文批判的基线范式;理解 SFT 才能理解论文要修复的问题,以及所有对比实验共同的热启动起点。
RLVR 与 GRPO
RLVR(可验证奖励强化学习)指用环境或验证器给出的可检验信号作为奖励做在线强化学习。GRPO 是 DeepSeek 提出的策略梯度算法:对每个任务采样一组 $n$ 条 rollout,用组内奖励的归一化(减均值除标准差)作为 advantage,不需要价值网络。其痛点是当整组 rollout 全部失败时,组内对比为零、advantage 为零、梯度消失。
本文的在线 RLVR 集成(式 3 的自适应技能加成)正是为填补 GRPO 在全败组零梯度的空窗而设计的,读懂 GRPO 才能理解奖励设计的动机。
BPE 分词
字节对编码(Sennrich et al., 2016):从字符流开始,反复合并语料中共现频率最高的相邻符号对,逐步构建词表;词表本身构成一棵合并层次树。整个过程只靠计数统计,确定性强、无需任何模型调用,是现代 NLP 分词的事实标准。
X-Tree 的挖掘就是对 BPE 的直接类比与改造:把字符换成规范化动作,把纯频率换成综合考虑复现、长度、成功率的 X-Score。
OPSD(在线策略自蒸馏)
学生模型对任务自行采样 rollout,同时让同一个模型在特权上下文(额外的技能/提示信息)条件下充当教师;由于师生对相同的响应 token 计算概率,仅上下文不同,可逐 token 计算对数概率差并在 RL 损失上叠加蒸馏项,把特权信息带来的概率增量蒸馏进权重。
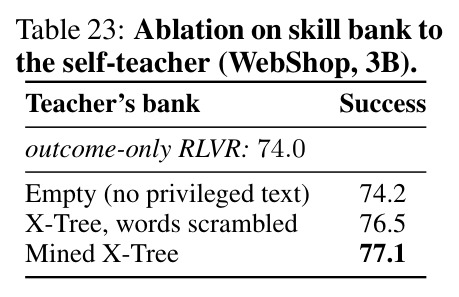
本文第三种集成把 OPSD 的特权上下文从「LLM 写的技能库」换成 X-Tree 的渲染文本,用零 LLM 成本打平了 GPT-o3/gpt-oss-120b 写的技能库。
层次强化学习与技能复用
认知科学发现人类会自发把重复的动作序列组块化(chunking)为可复用程序,规划自目标到子目标再到原子动作(Miller 的 7±2、Botvinick 的层次行为理论)。RL 中的对应物是 options、skill tree 等时间抽象框架,传统方法需要在线学习或拟合生成模型来切分轨迹。
这是本文的动机来源:作者论证扁平的 SFT/RLVR 训练浪费了数据中已有的层次结构,并主张用纯统计方法离线、确定性地把它恢复出来。
奖励塑形(reward shaping)
在任务结果奖励之外加入辅助信号(如给中间步骤加分)以引导学习、缓解稀疏奖励。其风险是可能改变最优策略或引发 reward hacking。本文的做法是让辅助项的权重 $\lambda_g$ 随组内胜率上升自动退火到零,即只在工作窗口内发声的塑形,而非常驻加项。
在线 RLVR 集成的核心贡献就是设计了一个不扭曲最终目标、只在验证器信号稀缺时提供对比的塑形项,理解塑形才能评判这一设计的取舍。
研究动机
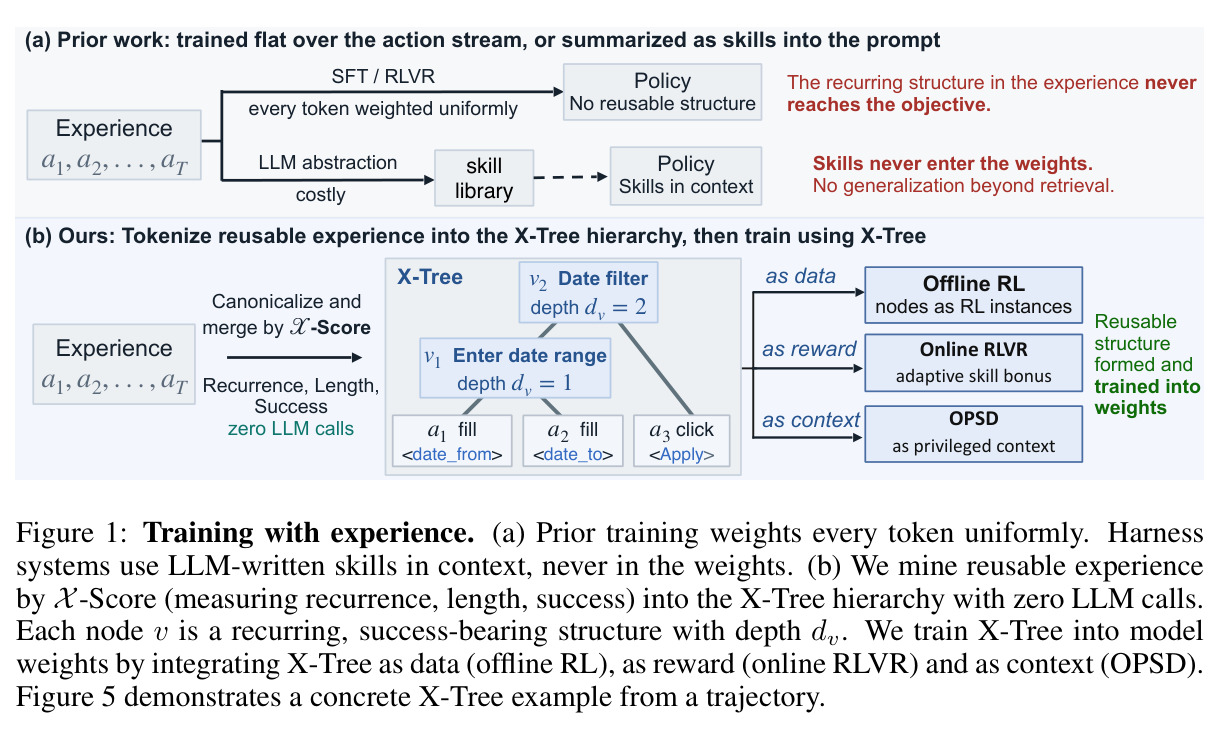
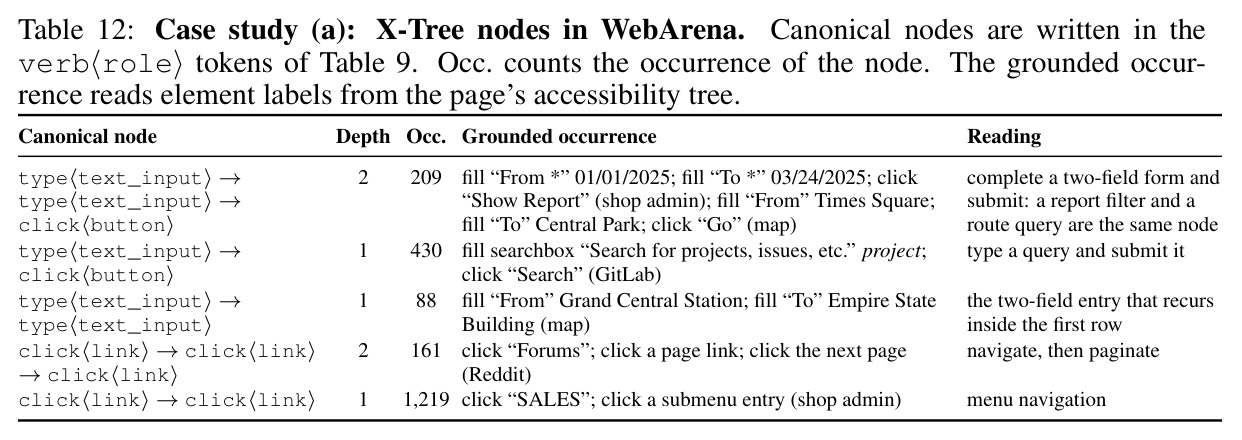
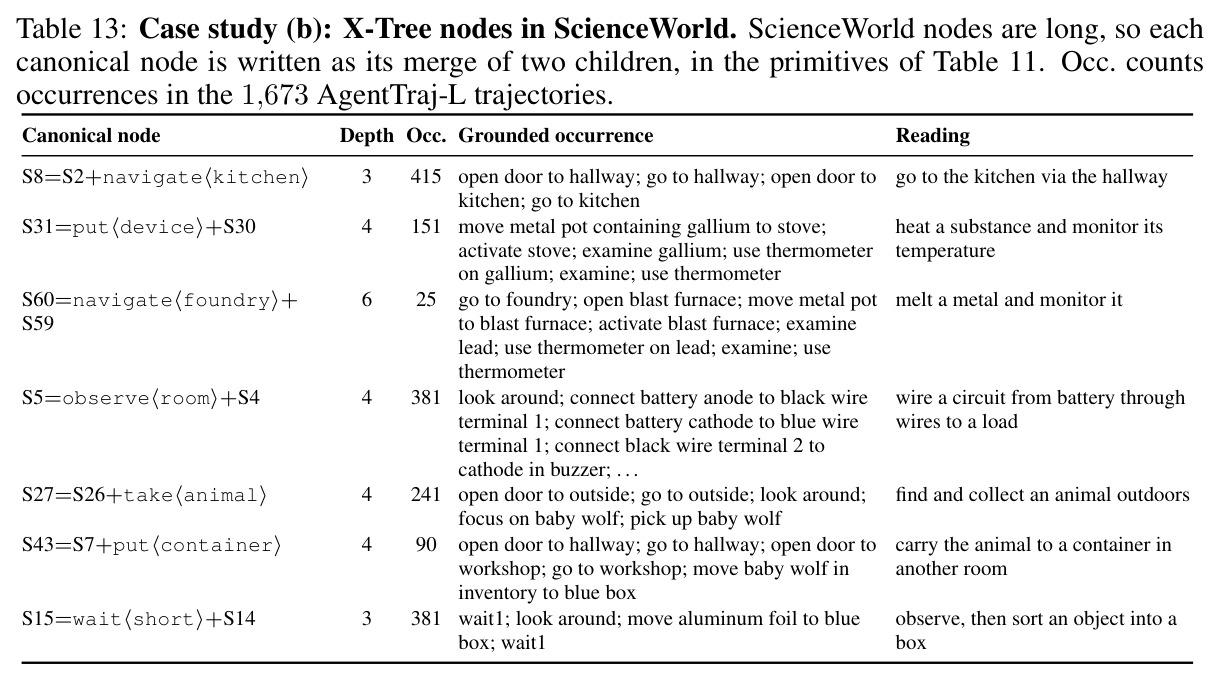
现有多步智能体训练把轨迹当作扁平动作流:无论 SFT 还是 RLVR,损失对每个 token 一视同仁,完全忽略跨任务反复出现的子过程——例如网页操作里「填起始日期、填截止日期、点 Apply」的日期筛选三连,或 ScienceWorld 里「开门—穿走廊—再开门」的去厨房路线。这种均匀加权让层次结构明明存在于数据中、却进不了训练目标,每条稀缺轨迹的价值远未被榨干。而智能体经验恰恰极其昂贵:轨迹要么靠人工标注(如 Open-CUA),要么由模型合成再验证(如 Go-Browse 为 WebArena 构建 7.9k 条轨迹),环境搭建、任务编写、验证器校准都无法像网页文本那样规模化。另一类方法(ExpeL、AWM、Agent Workflow Memory、SkillWeaver 等 harness)请 LLM 把经验总结成自然语言技能放回上下文重放,但技能从未被压缩进权重,无法泛化到检索之外,且 LLM 抽象步骤昂贵、不可控、产出的技能库无法仅从数据复现。在线 RLVR 还有一个具体痛点:GRPO 在整组 rollout 全部失败时 advantage 为零、没有任何梯度,训练早期信号极稀疏。
本文的目标是本文的目标是:在完全不动用 LLM 的前提下,从给定轨迹池中自动恢复人类学习者那种「目标→子目标→原子动作」的层次结构,并把该结构以互补的方式注入训练,让每条有限经验产生更多学习信号,在数据与算力严格对齐的条件下提升多步智能体的泛化。具体拆成三个可验证子目标:(1) 设计一个确定性的经验分词器,把轨迹语料压缩成一棵可复用经验树 X-Tree,每个节点是一个高频、成功率高、由子技能组合而成的技能;(2) 证明这棵树能分别以三种形态进入三种现实训练设定——只有轨迹没有环境时作为离线 RL 的训练实例,有环境有验证器时作为在线 RLVR 的自适应奖励加成,自蒸馏时作为 OPSD 自教师的特权上下文;(3) 在 WebArena、ScienceWorld、WebShop 三个环境、1.5B/3B/7B 三个模型规模上,用消融实验(随机树、随机 span、整轨迹、二元奖励等)把增益严格归因到树结构与集成设计,而非额外数据或算力。
与已有工作不同的是,本文的独特切入角度是把文本分词器的构造逻辑移植到经验上,并让产出的层次直接进入权重而非提示词。这与三条现有路线形成鲜明对比。其一,层次 RL(options、skill tree)早就指出扁平训练浪费结构,但传统方法要在线学习选项或拟合生成模型来切分演示;X-Tree 只用语料统计即可离线、确定性、可审计地完成切分。其二,LLM 技能库(Voyager、AWM、SkillWeaver、WALT 等)依赖专有模型写技能,成本高且不可控,技能停留在上下文里不能泛化;X-Tree 用零 LLM 调用的确定性挖掘器替代 LLM 抽象器,再通过训练把技能压进参数。其三,最接近的 PRISE 与 Subwords-as-Skills 虽然也对动作做 BPE,但对象是量化后的连续控制动作、合并准则只有频率、词表被当作固定宏动作空间;本文的字母表是规范化后的类型化动作 $\text{verb}\langle\text{role}\rangle$,合并准则是综合复现、长度、成功率三要素的 X-Score,词表的用法也不是固定动作空间,而是作为先验以数据、奖励、上下文三种形态指导训练。
核心方法
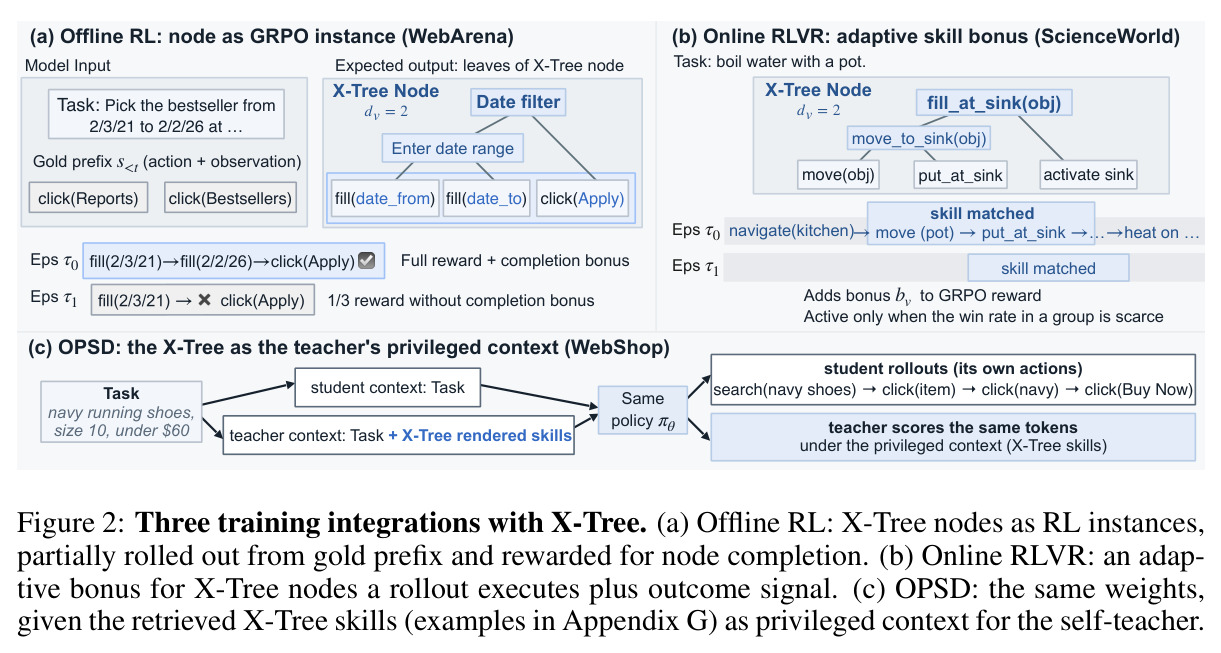
直觉上,人学技能时会自动把「打开门→走过走廊→打开另一扇门」打包成「去厨房」这个可复用子程序,之后调用子程序而非逐步重想。X-Tree 把这种打包过程做成了确定性的统计流水线,全程零 LLM 调用。技术路线分两步。第一步是构造:把每条轨迹中的原始动作(不含思考文本)规范化为类型化 token $\text{verb}\langle\text{role}\rangle$,例如 $\text{fill}(\text{bid},\text{\'2/2/26\'}) \mapsto \text{type}\langle\text{date}\rangle$,使结构相同的动作共享符号、让复现可见;然后仿照 BPE 反复合并相邻符号对,但合并准则换成可复用性度量 $X(u,v) = f_{uv}\cdot(\ell_u+\ell_v)^{p_\ell}\cdot(\text{succ}(uv)+\epsilon)^{p_s}$(式 1),并施加压缩约束 $f_{uv}-1 > \eta(\ell_u+\ell_v)$,递归合并直到无对可并,得到叶子为规范化动作、内部节点为技能的树。第二步是消费:同一个 X-Tree 以三种形态进入三种训练设定——离线 RL(WebArena,只有轨迹)把每个节点当一个 GRPO 训练实例,从金标前缀部分展开、按步匹配加深度缩放的完成奖励打分;在线 RLVR(ScienceWorld/WebShop,有环境和验证器)给 rollout 执行到的技能节点发自适应奖励加成;OPSD 把渲染成文本的 X-Tree 作为自教师的特权上下文。附录还给出第四种集成:与 SFT 结合时每节点一行,监督 token 省 4 倍。
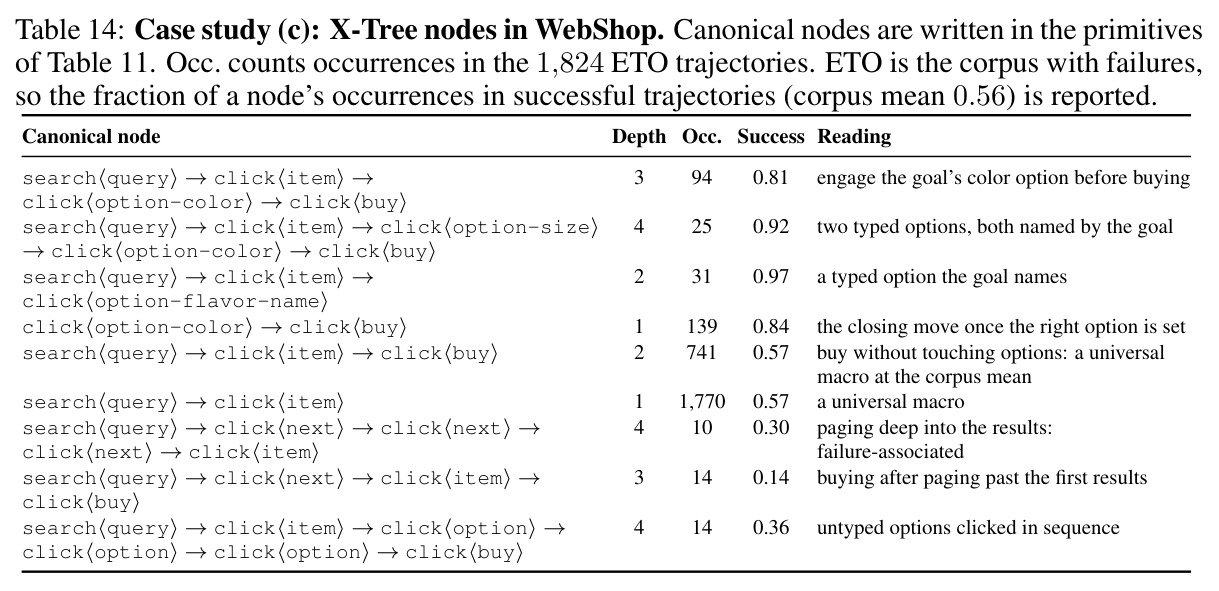
核心创新是「经验的分词化」这一视角转换:文本分词器按共现频率把字符流压缩成词表,X-Tree 按可复用性把动作流压缩成技能树。与已有方法的本质区别有三点。第一,X-Score 重新定义了什么值得合并:$X(u,v)=f_{uv}\cdot(\ell_u+\ell_v)^{p_\ell}\cdot(\text{succ}(uv)+\epsilon)^{p_s}$ 同时考察复现次数 $f_{uv}$、展开长度 $\ell_u+\ell_v$、成功轨迹占比 $\text{succ}(uv)$,因此「长而可靠、反复出现」的结构优先于「高频但短」或「高频但易失败」的结构——这是纯频率的文本分词器无法做出的判断。论文以 WebShop 为例:点名目标选项的节点(选颜色再购买)成功率 81–97%,而翻页链只有 14–36%,X-Score 能把两者分开。第二,层次进入权重而非上下文:每个节点记录「一个高频且成功的技能由哪些子技能组成」,训练时以深度 $d_v$ 调制奖励信号,深层组合获得更强的完成奖励。第三,一套结构、三种消费方式(作为数据、作为奖励、作为上下文)覆盖了有无环境、有无验证器的全部现实训练场景,且挖掘认为完全确定、可审计、可仅从数据复现。
方法步骤详情
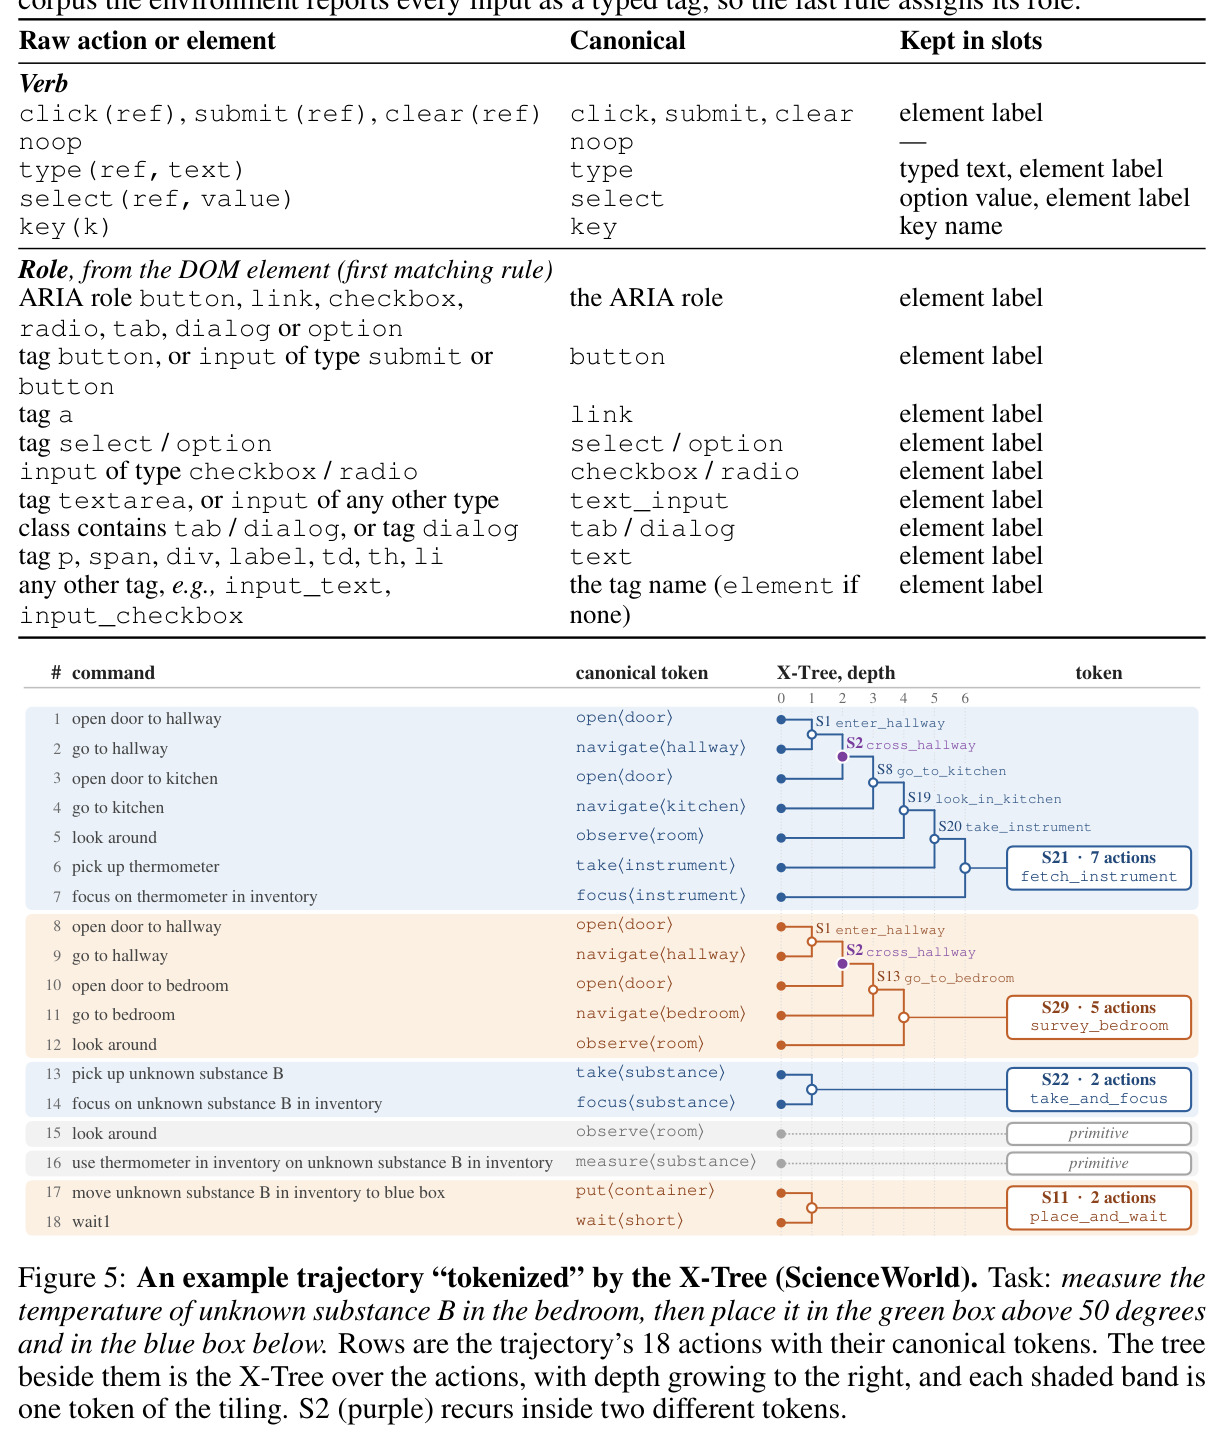
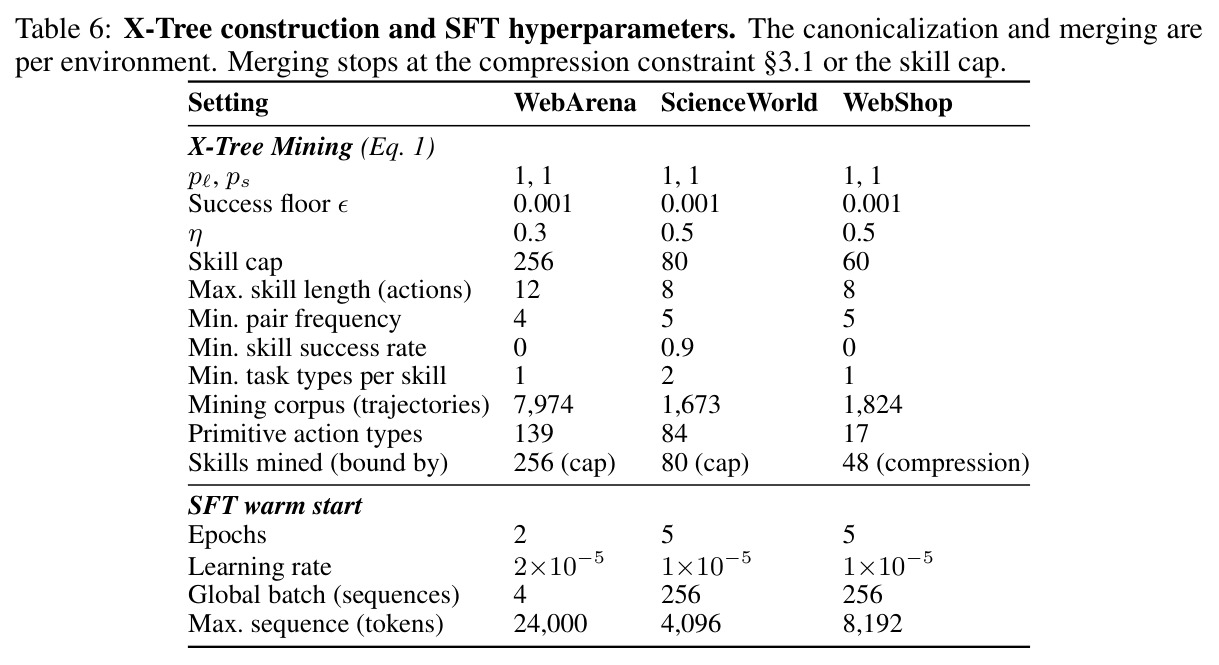
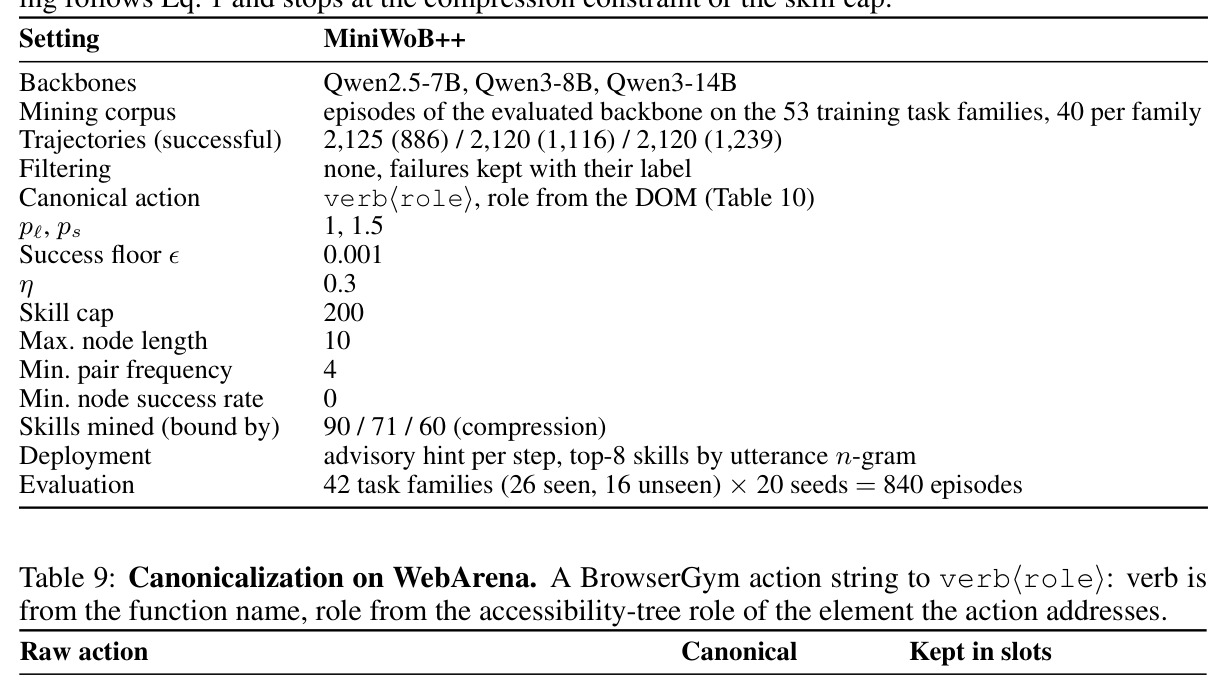
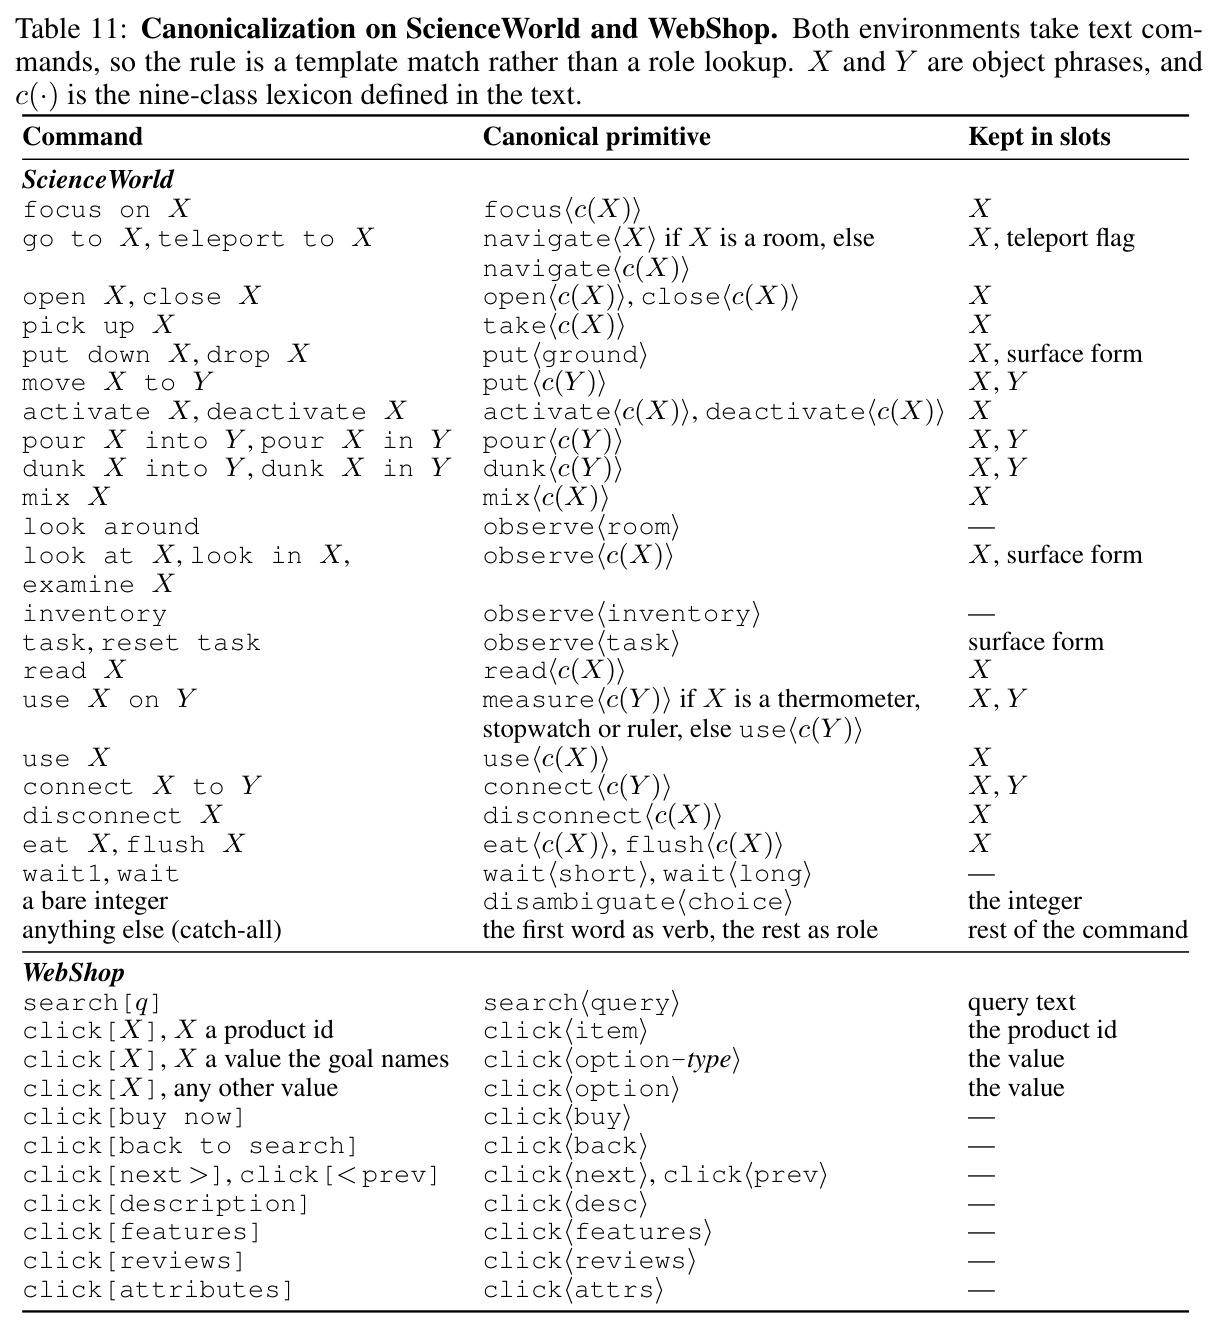
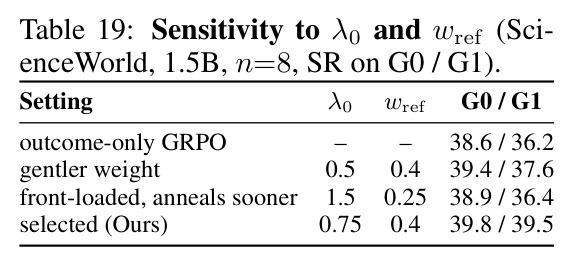
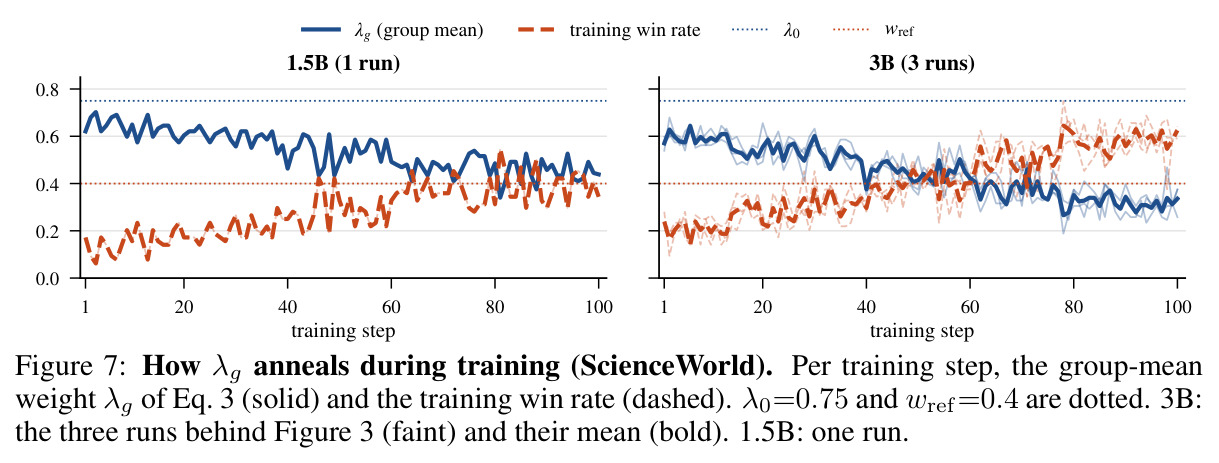
整个流程分四步。第 1 步规范化:按每个环境写一次的确定性模板(WebArena 按浏览器无障碍树角色定 role、按 BrowserGym 函数名定动词;ScienceWorld 按九类物品词典 door/instrument/container/device 等匹配名词),把原始动作映射为 $\text{verb}\langle\text{role}\rangle$,被剪掉的值(元素 id、输入文本、物体名)保留在槽位中,思维链不进入字母表。第 2 步挖掘:对语料 $\mathcal{D}$ 中所有相邻符号对计算 X-Score(式 1,$p_\ell=p_s=1$,$\epsilon=0.001$),合并得分最高且满足压缩约束 $f_{uv}-1>\eta(\ell_u+\ell_v)$ 的一对,新节点深度 $d_v$ 为较深子节点深度加一;递归直到无对通过约束或达到技能上限(WebArena 256 个、ScienceWorld 80 个、WebShop 48 个,语料分别为 7,974、1,673、1,824 条轨迹)。第 3 步按设定集成:(a) 离线 RL——节点 $v$ 实例化于位置 $t$ 时,以金标前缀 $s_{<t}$ 为条件让策略最多生成 $\ell_v$ 步,逐步与金标比对,$c_v=\prod_j \text{match}_j$ 为完全匹配指示子,GRPO 奖励 $r=(1-\alpha)\frac{1}{\ell_v}\sum_j \text{match}_j+\alpha(1+\gamma d_v)c_v$($\alpha=0.3,\gamma=0.5$,式 2);(b) 在线 RLVR——奖励 $r_i=R_{\text{out}}(\tau_i)+\lambda_g\sum_{v\in\text{matched}(\tau_i)}b_v$,$\lambda_g=\lambda_0\,\text{clip}(1-w_g/w_{\text{ref}},0,1)$ 随组内胜率 $w_g$ 上升自动退火($\lambda_0=0.75$;ScienceWorld 的 $b_v=1+\gamma d_v$,WebShop 的 $b_v=s_vk_v/T$,式 3);(c) OPSD——教师 prompt 前置检索到的 X-Tree 渲染文本,逐 token 蒸馏项 $c\cdot\frac{1}{|y|}\sum_t g_t[\log\pi_{\bar\theta}(y_t|s^{\text{tea}})-\log\pi_\theta(y_t|s^{\text{stu}})]$,门控 $g_t=\sigma(\beta\delta_t)$ 只在教师更有信心的 token 上生效,$c=0.01$(式 4)。第 4 步训练与评估:全部从相同 SFT 热启动出发,三种子取均值,数据与算力严格对齐。
技术新颖性
技术新颖性可从四个维度评估。算法层面:把 BPE 的「频率驱动递归合并」改造成「可复用性驱动递归合并」,用 X-Score 把成功率与长度编码进合并决策,并加了压缩约束防止语料塌缩成少数巨型符号;产出的不是扁平词表而是树,树本身携带组合信息(如 $S8=S2+\text{navigate}\langle\text{kitchen}\rangle$ 这样的等式,深度逐层加一)。训练层面:三个集成各自解决一个真实痛点——离线 RL 用「节点即实例 + 步级匹配奖励 + 深度缩放完成奖励」把稀疏的轨迹级结果信号细化成密集的结构化信号(比二元结果奖励高 4.7 SR);在线 RLVR 的自适应权重 $\lambda_g$ 专门填 GRPO 全败组零梯度的空窗,并按胜率自动退火(训练后期平均 $\lambda_g$ 从 0.50 降到 0.18–0.26),是「有工作窗口的装置」而非常驻加项;OPSD 侧则首次证明无需 LLM 写技能即可匹配 GPT-o3/gpt-oss-120b 写的技能库。工程层面:全程零 LLM 调用、确定性、可审计,技能库可仅从数据复现,而 LLM 基线的技能库依赖专有模型、不可复现。相比 PRISE/Subwords-as-Skills 把 BPE 词表当固定宏动作空间,本文把词表当作训练先验并给出三种集成用法,这在使用方式上也是新的。
实验结果
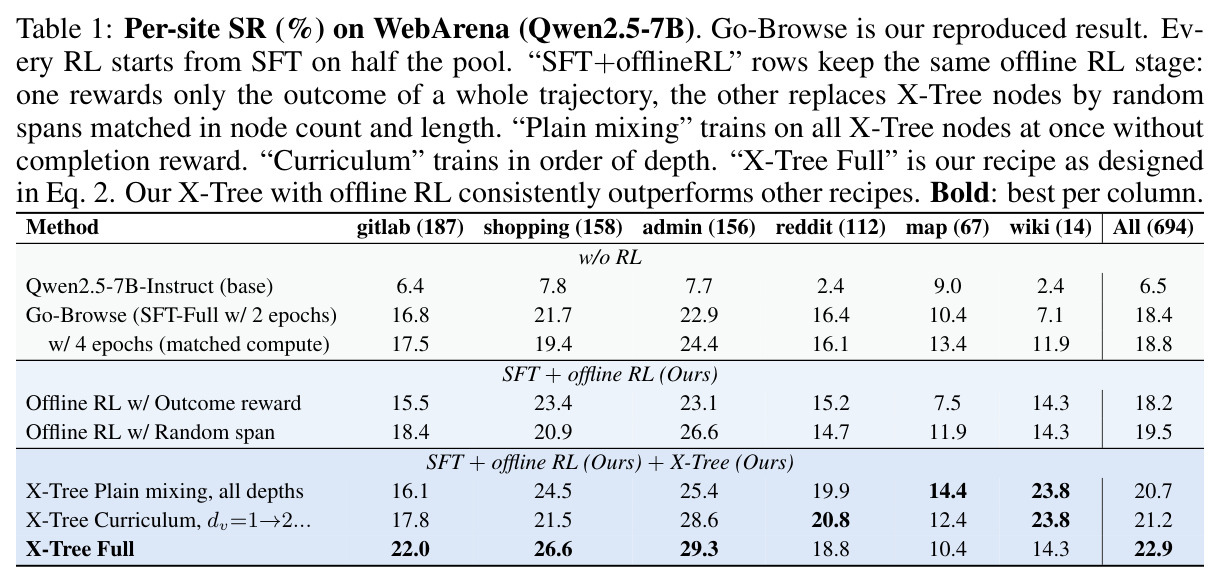
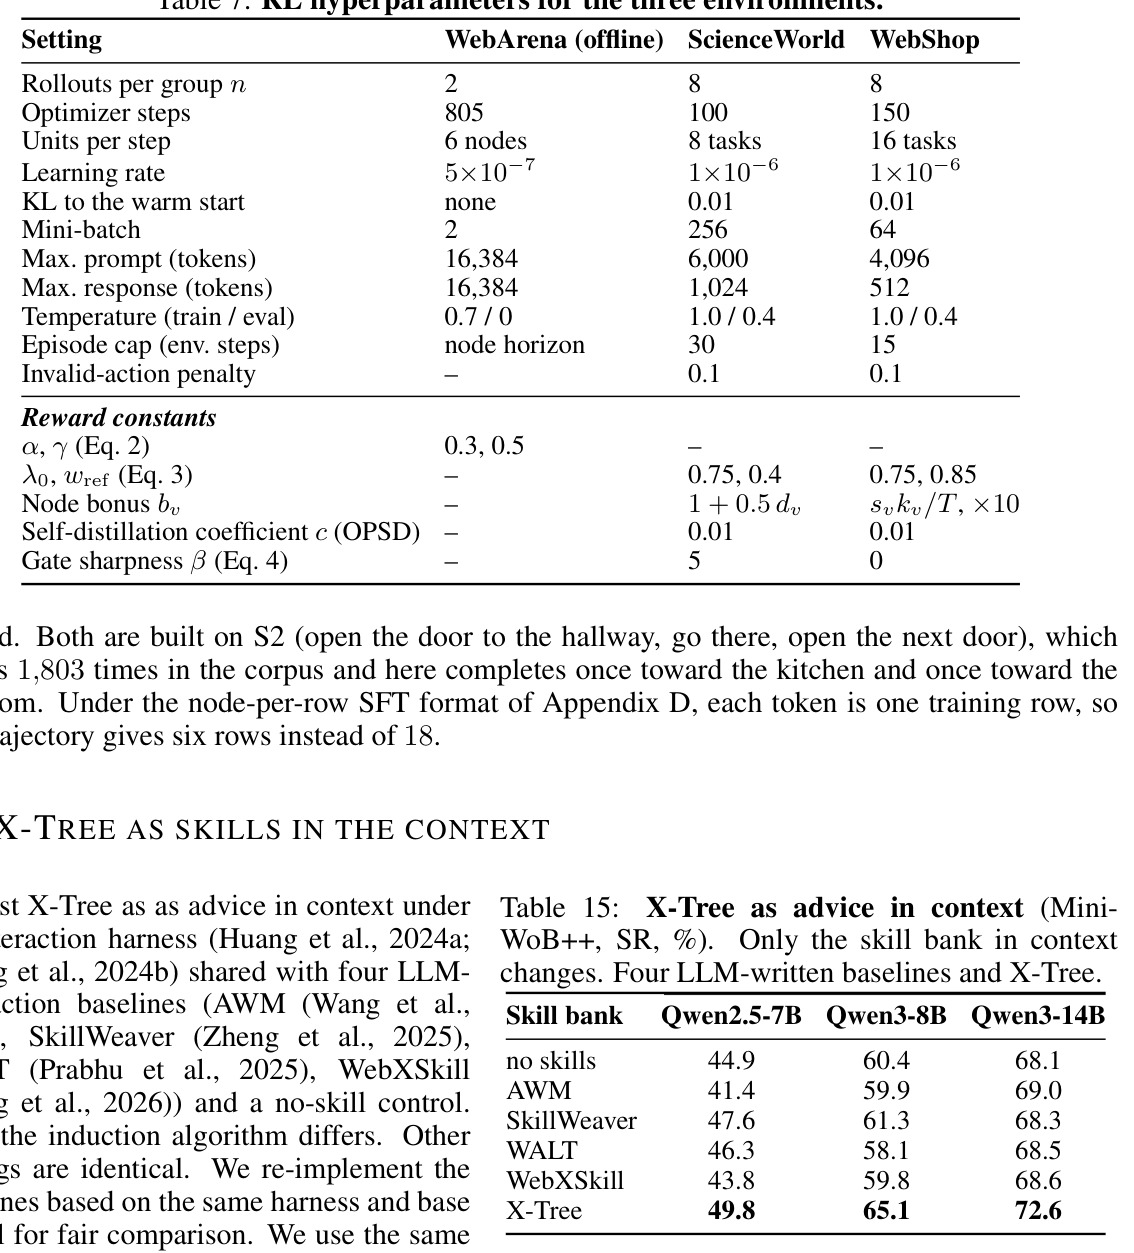
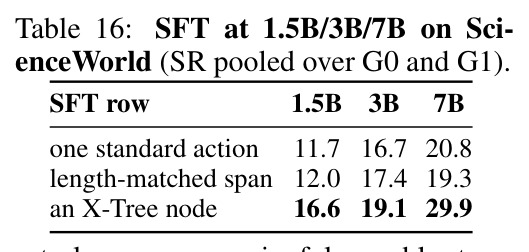
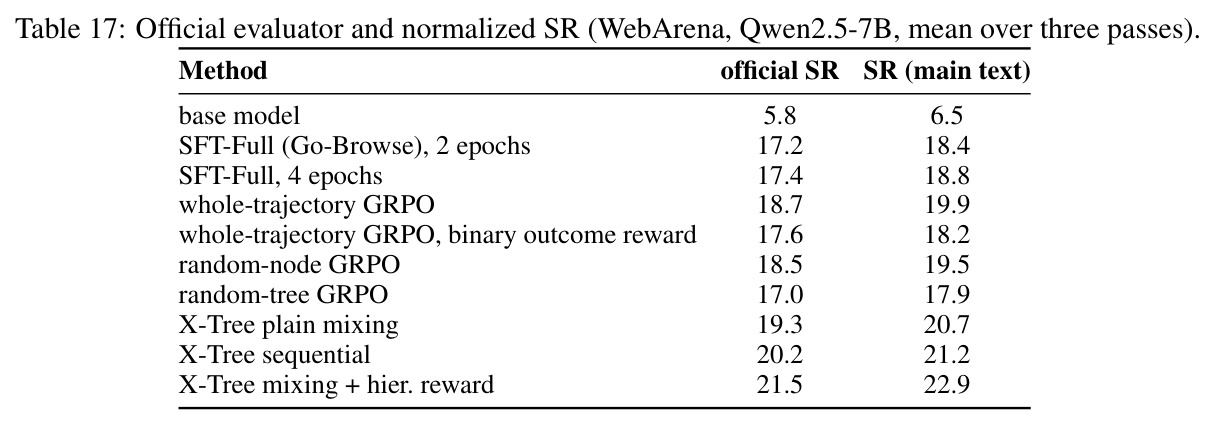
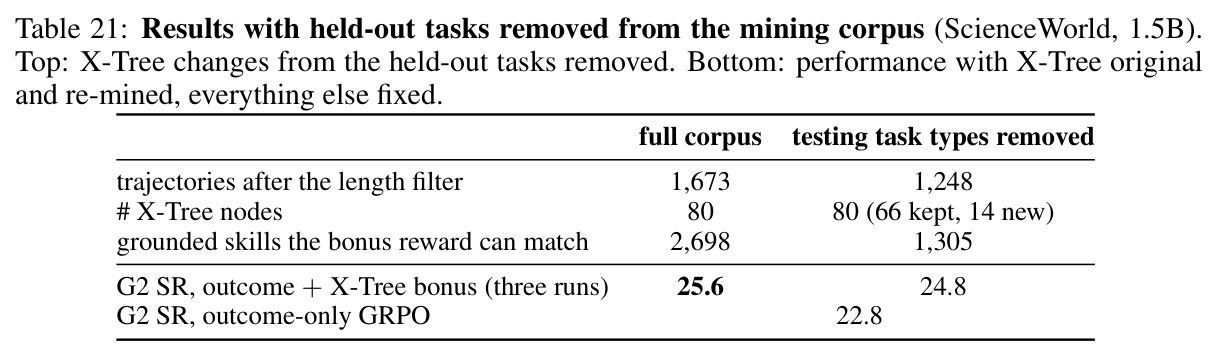
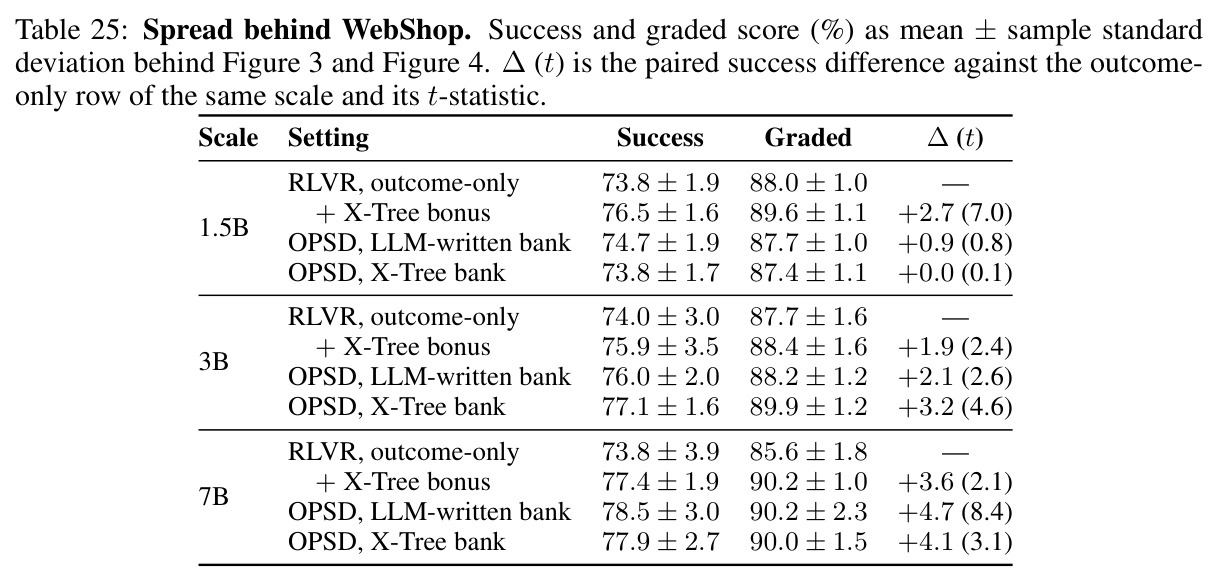
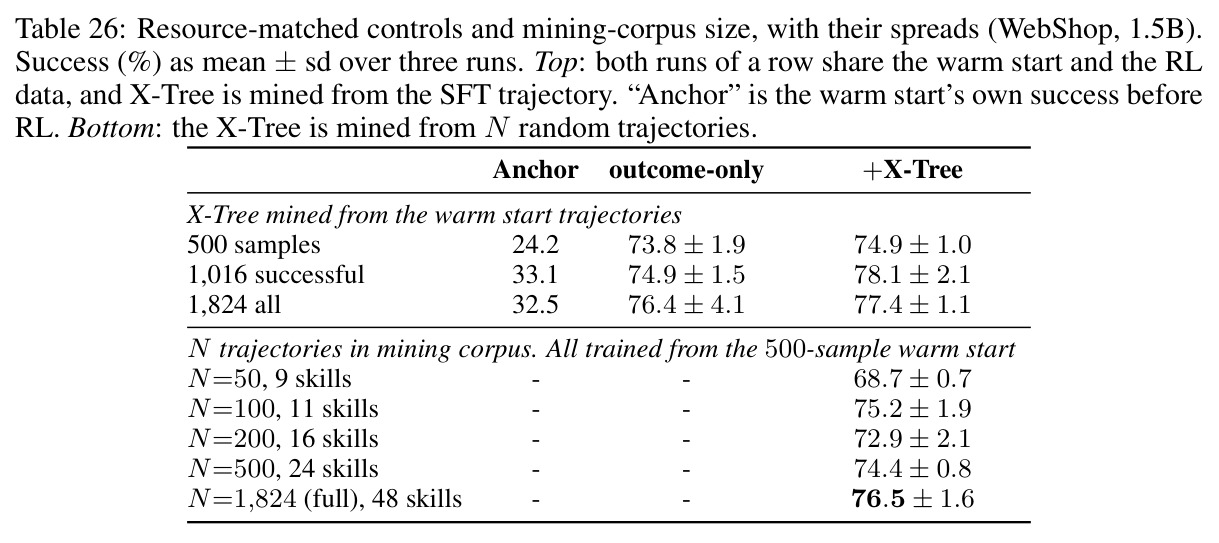
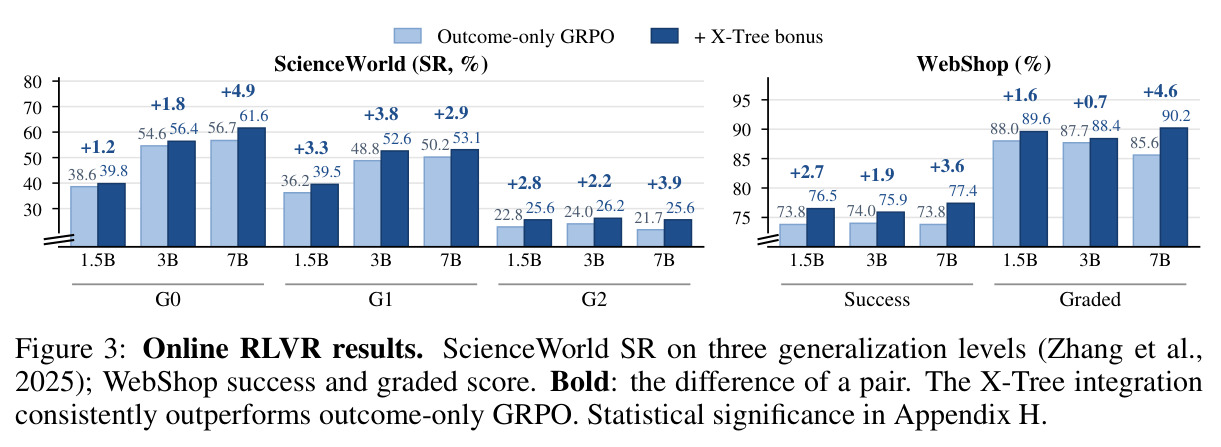
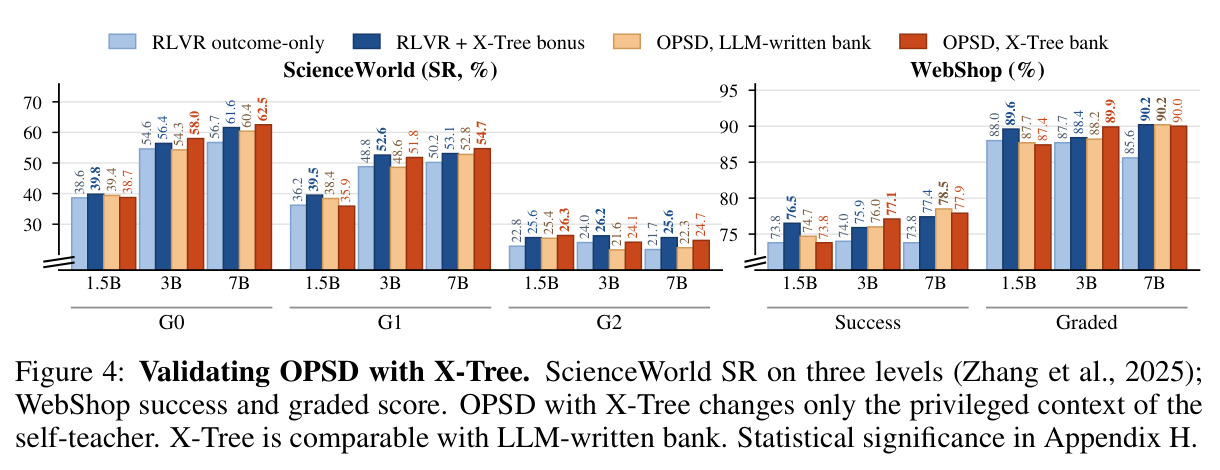
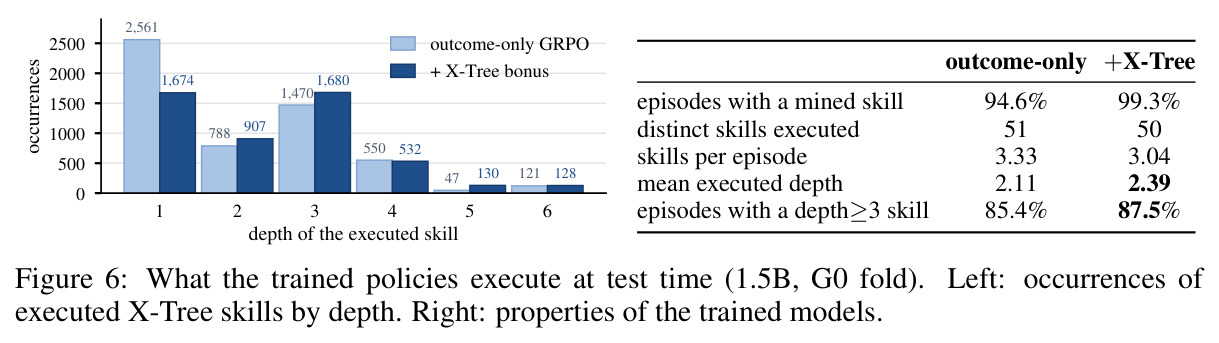
论文在三个环境、三个模型规模上做了数据与算力严格对齐的实验。离线 RL(WebArena,Qwen2.5-7B,694 个确定性任务):X-Tree 全配方达到 22.9% SR,比 Go-Browse 复现的 SFT-Full(18.4%)高 4.5 点(相对提升 24%);把 SFT 从 2 epoch 加到 4 epoch 只涨 0.4 点,排除了算力解释。分站点看,程序性强的站点收益最大:admin +6.4、gitlab(流程最重)+5.2、shopping +4.9,而靠查询表述驱动的 reddit/map/wiki 增益小。消融显示增益同时来自树与方法:随机树 −5.0、随机等长 span −3.4、整轨迹 −3.0、二元结果奖励 −4.7、去掉完成奖励的 plain mixing −2.2、深度课程 −1.7。在线 RLVR:ScienceWorld 上 X-Tree 加成在所有规模全面领先,G0/G1 最高 +4.9 SR(7B G0:61.6 vs 56.7),held-out 任务 G2 每个规模都领先、最高 +3.9(7B:25.6 vs 21.7);WebShop 上 7B 成功率 77.4 vs 73.8(+3.6)、分级分 90.2 vs 85.6(+4.6)。rollout 数缩放实验(1.5B)中 12 个格子赢了 11 个,n=4 时增益最大(G0 +3.8/G1 +3.6/G2 +4.4),n=16 时收窄,印证加成只在验证器信号稀疏时发力。资源对齐实验排除了「额外挖掘语料」的解释:仅用 SFT 数据本身挖树仍 +1.0~+3.2;且 100 条轨迹挖出 11 个技能就已达 75.2(超 outcome-only 的 73.8)。OPSD:X-Tree 渲染文本作特权上下文与 LLM 写的技能库(ScienceWorld 用 gpt-oss-120b、WebShop 用 GPT-o3)打平且多数占优(最高 +3.7/+1.7),零 LLM 成本;7B 上比 outcome-only RLVR 高 5.8 SR(ScienceWorld G0:62.5 vs 56.7)与 4.4 分级分(WebShop)。附加发现:MiniWoB++ 纯上下文设置下 X-Tree 以 49.8/65.1/72.6 全面超过 AWM、SkillWeaver、WALT、WebXSkill;SFT 集成省 4.0 倍 token(每监督动作 446 vs 1,766 token)且 7B 上 +9.1 SR(29.9 vs 20.8)。
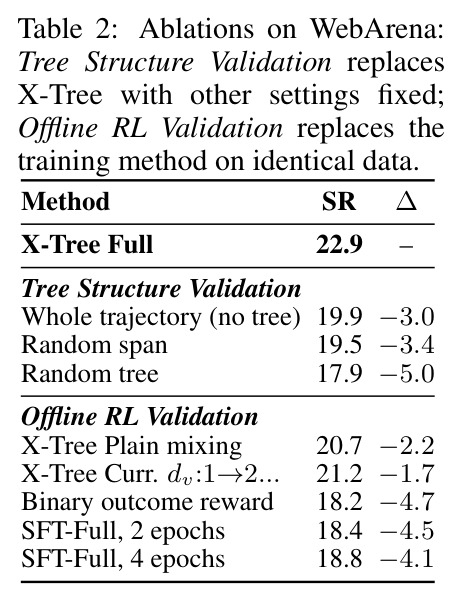
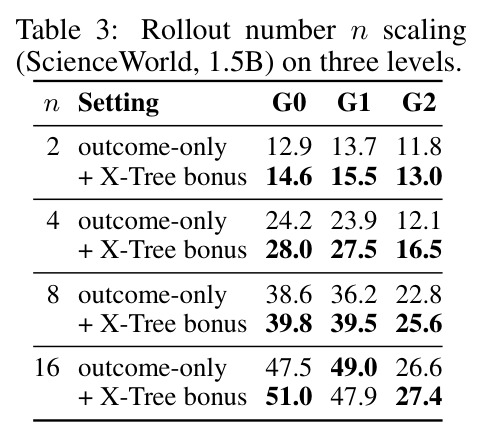
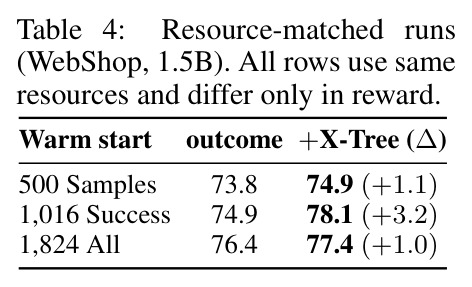
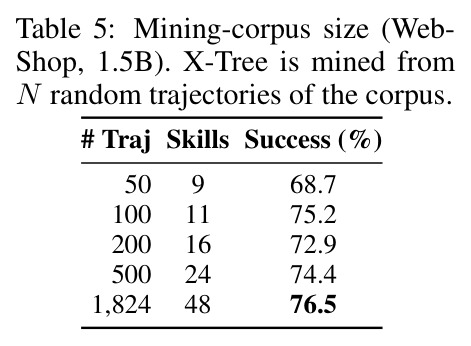
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WebArena 离线 RL(Qwen2.5-7B,694 确定性任务) | 成功率 SR (%) | 22.9(X-Tree Full 离线 RL) | 18.4(Go-Browse SFT-Full,2 epochs) | +4.5(相对 +24%);4 epochs SFT 仅 18.8,排除算力解释 |
| ScienceWorld 在线 RLVR(7B,已见任务 G0) | SR (%) | 61.6 | 56.7(outcome-only GRPO) | +4.9(G0/G1 上所有规模全面领先) |
| ScienceWorld 在线 RLVR(7B,held-out 任务 G2) | SR (%) | 25.6 | 21.7 | +3.9(三个规模均领先 held-out 任务) |
| WebShop 在线 RLVR(7B,512 held-out episodes) | Success (%) | 77.4 | 73.8 | +3.6(7B 增益最大,随规模扩大) |
| WebShop 在线 RLVR(7B) | Graded score (%) | 90.2 | 85.6 | +4.6 |
| ScienceWorld OPSD(7B,G0) | SR (%) | 62.5(X-Tree 特权上下文) | 56.7(outcome-only RLVR);60.4(LLM 写的技能库) | 较 RLVR +5.8;与 LLM 技能库相当且零 LLM 调用 |
| WebShop OPSD(7B) | Graded score (%) | 90.0 | 85.6(outcome-only RLVR) | +4.4 |
| MiniWoB++ 上下文技能(Qwen3-14B,交互式 harness) | SR (%) | 72.6(X-Tree 技能库) | 68.6(WebXSkill,最强 LLM 基线);68.1(无技能) | +4.0;三 backbone 全面领先(8B 上 65.1 vs 61.3,+3.8),且零 LLM 调用 |
| ScienceWorld SFT 集成(7B,G0+G1 合并) | SR (%) | 29.9(每行一个 X-Tree 节点) | 20.8(标准单动作行 SFT) | +9.1,且监督 token 省 4.0 倍(446 vs 1,766 token/动作) |
| WebArena 离线 RL 迁移(GLM-4-9B / Qwen2.5-14B) | SR (%) | 16.9(GLM-4-9B)/ 25.7(14B) | 14.9(GLM-4-9B SFT-Full)/ 24.1(14B SFT-Full) | +2.0 / +1.6,验证跨模型家族与更大规模可迁移 |
局限与改进
作者承认的局限:X-Tree 只从固定池挖掘一次、训练过程中不更新,「策略生成轨迹→重挖→策略更强」的闭环尚未实现;三种集成每次只用一种、从未组合进同一个模型;X-Tree 只能重组已有经验,不能创造缺失的经验(但可以反过来利用统计标记语料的稀薄之处,定位值得定向合成的轨迹)。我自己的观察:其一,规范化步骤依赖人工为每个环境编写的确定性模板(WebArena 的无障碍树角色表、ScienceWorld 的九类物品词典),迁移到动作空间开放或语义模糊的环境(如 OSWorld、真实浏览器)时模板工程成本高且易碎;其二,离线 RL 的步级匹配奖励假设金标轨迹值得逐步模仿,WebShop 语料本身成功率均值只有 0.56,若语料含大量次优轨迹,匹配奖励可能强化坏习惯;其三,奖励超参按环境手调($w_{\text{ref}}$ 在 ScienceWorld 取 0.4、WebShop 取 0.85,$b_v$ 形式也因环境而异),跨环境自动化未验证;其四,OPSD 的增益随模型规模增大(1.5B/3B 上只有几个点甚至与 RLVR 打平),说明其依赖底座读懂技能文本的能力;其五,WebArena 主指标用自定义「归一化 SR」而非官方评估器(官方口径下 21.5 vs 17.2),归一化器虽冻结且对所有方法一致,但与文献已发表数字的直接可比性略降;其六,训练后期方差不小(7B ScienceWorld 单元 std 最高 8.7),部分配对对比的 t 值偏低(如 WebShop 1.5B 的 OPSD 与 outcome-only 打平)。
独立分析的弱点
独立分析四个弱点并给出改进方向。(1) 模板依赖:规范化是「每环境写一次」的人工规则,这是零 LLM 路线的隐性成本;改进方向是用小型开源模型半自动归纳动作模板、或学习可撤销的规范化器,同时保留确定性审计接口。(2) 匹配式离线奖励的脆弱性:步级匹配要求逐动作复现金标,当存在多个合理动作顺序(如先选尺寸再选颜色 vs 反过来)时会被误判为失败;改进方向是把匹配从精确序列放宽为节点级的集合/图匹配,或对同一节点保留多条备选路径并在任一匹配时给分。(3) 奖励超参按环境手调:$w_{\text{ref}}$ 取 0.4 还是 0.85、$b_v$ 用深度形式还是成功率形式全凭经验;改进方向是把 $b_v$ 统一为「语料成功率 × 有效长度 / 回合长度」的规范化量,让 $w_{\text{ref}}$ 随验证器难度自适应估计(附录 F.3 只在单环境测了两个方向,敏感性结论外推有限)。(4) 结构静态与小模型失效:树在训练期间不演化,策略学到的技能不反哺树;OPSD 在 1.5B/3B 上几乎无增益,说明小模型读不懂长技能文本。改进方向是把附录 F.1 的「执行深度分布」观测用作重挖信号,训练中周期性重挖形成自我改进循环;为小模型蒸馏更浅层节点或压缩渲染文本,而非全套渲染。
未来方向
作者明确提出的方向:(1) 从策略自身轨迹在线重挖 X-Tree,让结构与策略在闭环中共同改进;(2) 把三种集成合而为一——同一个模型同时在 X-Tree 节点上做 RL、拿技能加成、并从 X-Tree 蒸馏;(3) 利用 X-Tree 记录的「哪些动作对从未共现、哪些从未成功」定位语料空白,指导定向合成数据。基于其成果可延伸的方向:(4) 跨环境技能迁移——规范化 token 的抽象层次($\text{click}\langle\text{button}\rangle$、$\text{put}\langle\text{container}\rangle$)在环境间天然重叠,可研究「通用技能树 + 环境专属槽位」的层次化复用;(5) 更强的技能检索——目前 OPSD 只按任务行检索每族一个渲染,论文自己也承认更好的检索器值得探索,可按当前观测状态或部分轨迹做动态检索;(6) 与过程奖励模型(PRM)对比或结合——X-Tree 加成本质是「从数据免费挖出的 PRM」,可测试其与学习型 PRM 的互补性;(7) 应用到代码智能体(SWE-bench)等更长程、验证器更昂贵的领域,那里离线 RL 集成(无需环境)的价值可能最大。
复现评估
复现条件相当好。代码承诺开源(github.com/sitaocheng/X-Tree),项目页为 sitaocheng.github.io/xtree,论文承诺随文发布规范化器、挖掘器、训练配置与评估 harness。挖掘部分完全确定且零 LLM 调用:只要拿到三个环境的公开轨迹语料(WebArena 7,974 条来自 Go-Browse、ScienceWorld 1,673 条来自 AgentTraj-L、WebShop 1,824 条来自 ETO),按附录表 6–8 的超参($p_\ell=p_s=1$、$\epsilon=0.001$、$\eta=0.3/0.5$、技能上限、最小配对频率等)即可逐位复现树。训练基于开源框架 verl、verl-agent 与已发布的 OPSD trainer,模型为开源的 Qwen2.5-Instruct 1.5B/3B/7B/14B 与 GLM-4-9B,7B 级 GRPO 在单节点多卡上可行,无预训练需求。需要注意的坑:WebArena 评估只用 694 个确定性任务并用自定义归一化(与 Go-Browse 发表的 21.7 存在口径差,附录 E.2 给了官方口径对照);OPSD 的 LLM 技能库基线需要 gpt-oss-120b 与 GPT-o3 的 API;部分结果方差较大(尤其 7B 与 held-out G2),复现时应按附录 H 做三种子与配对 t 检验。总体难度中等:数据、代码、超参齐全,主要成本是环境搭建与多卡训练时间。
论文图表
OPSD 特权上下文的实际渲染样例:以「### TASK: goal requires a color option ###」开头,列出最多六条按语料成功率排序的链,每行含规范化链(如 search⟨query⟩→click⟨item⟩→click⟨option-color⟩→click⟨buy⟩:81% 成功,94 回合,ABOVE base)、固定短语释义,结尾附一句任务规则计划。
展示「零 LLM 渲染」的成品长什么样:全部由模板从统计量生成,却能传达与 LLM 写的技能等价的操作建议,是理解 OPSD 打平 LLM 基线机理的入口。
ScienceWorld 全部单元格的均值±样本标准差:1.5B/3B/7B 的四种设定与 n 缩放实验。标准差在 7B 和最小 rollout 预算下最大(如 7B outcome-only G0 为 56.7±8.4),X-Tree 系运行的方差在多数格子里更小;G2 列在各规模都最噪。
论文透明度关键件:让读者检验「+4.9」这类均值差异是否被种子方差支撑,也显示 X-Tree 的增益不是靠增大方差买来的。