ExpVoyager:面向动态 Agent 技能合成的直接经验导航 ExpVoyager: Direct Experience Navigation for Dynamic Agent Skill Synthesis
将技能合成重构为对原始经验轨迹的按需主动导航,让 agent 动态策展任务专属技能
前置知识
LLM Agent 与 ReAct 范式
LLM agent 通过「推理—行动」交替循环与环境交互:每步读取观察 $o_t$,生成思考与动作 $a_t$,循环执行直至任务完成或步数耗尽。ReAct 是最经典的实现,把思维链与环境动作交织,使模型能基于环境反馈逐步修正决策。agent 的执行质量同时取决于模型自身能力与运行时注入的上下文知识。
ExpVoyager 的最终产物正是供冻结 executor 在 ReAct 式执行中使用的任务专属技能,论文全部收益都以 ReAct 基线为对照来度量,步数、成功率等指标也定义在这个执行循环之上。
Agent Skill(智能体技能)
指不修改模型权重、以自然语言指令、流程和检查清单形式打包的程序性知识(如 Anthropic 的 Agent Skills 与 SKILL.md 文件),在运行时按需注入上下文以引导 agent 行为。它是 agent harness 的一个重要层次:把「怎么做」的知识与模型本身解耦,便于积累、复用与更新。
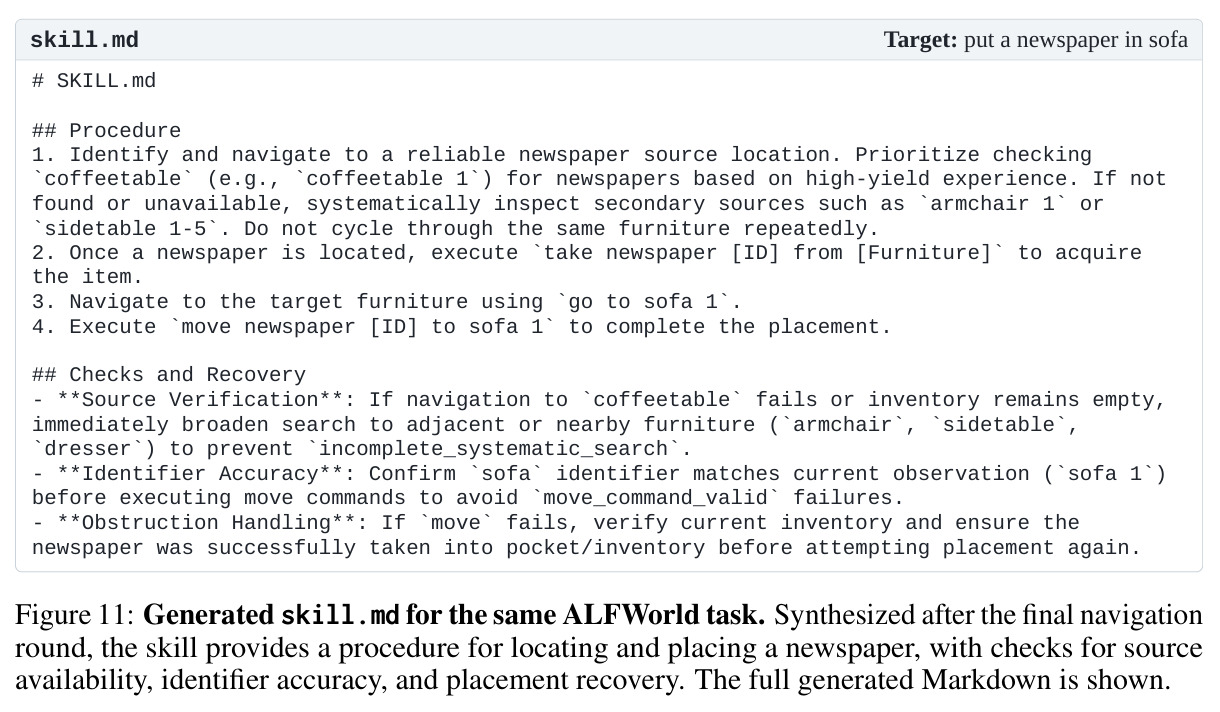
本文研究的核心问题就是「技能从哪里来」:不从人工编写而来,而是让 agent 从自身历史经验中动态合成技能,理解技能的形态(SKILL.md、Procedure、Checks and Recovery)才能看懂方法输出。
经验蒸馏式技能库(AWM / ReasoningBank 等)
一类自进化 agent 方法:预先从历史轨迹中抽取可复用的工作流或推理策略并存入技能库——AWM 从成功轨迹抽取工作流,ReasoningBank 从成败轨迹提炼推理记忆,Trace2Skill 用层级 map-reduce 合并轨迹教训——推理时用嵌入相似度检索 top-k 条注入上下文。
它们是本文的核心对照基线。论文的第一性分析正是量化这类「预抽象」范式会丢弃多少对下游任务真正有用的知识,从而论证按需合成的必要性。
top-k 相似度检索
用嵌入模型把查询与候选编码为向量,按余弦相似度返回最相近的 k 条记录。它是 RAG 与经验复用的标准接口,但属于「被动」访问:返回什么、返回什么粒度都由相似度分数决定,无法保证返回内容真正包含任务所需的过程性知识。
论文用预实验 II 说明相似度检索在知识级的召回与精度都很有限:加大 k 召回增益递减而精度骤降。理解这一局限才能理解作者为何要把接口换成「主动导航」。
函数调用(Function Calling)
LLM 通过 API 输出结构化的工具调用请求(函数名加上 JSON Schema 约束的参数),由运行时解析并执行对应函数后把结果回传给模型。这让模型能以受控方式操作外部系统,例如搜索引擎、数据库或文件读取器。
ExpVoyager 的两个导航动作 search_exp 与 inspect_traj 就是以原生函数调用实现的,附录给出了完整 schema;理解这一机制才能明白主动导航如何工程落地。
研究动机
现有自进化 agent 方法普遍走「先抽象、后复用」路线:在下游需求完全未知的时刻,就把积累的执行轨迹蒸馏成固定形态的程序性知识——AWM 抽取工作流、ReasoningBank 提炼推理记忆、Trace2Skill 合并轨迹教训——存入库中,等未来任务到来时用嵌入相似度检索取用。这种提前承诺有两个结构性风险:一是丢弃,抽象时无法预知哪些细节日后关键而被压缩掉;二是冗余,技能中混入大量只对源任务实例有意义的细节。论文在 ALFWorld 上做了严格量化:先用「生成—执行验证」流程构建 80 个经执行验证确实有效的 oracle 技能,再标注 300 条源轨迹中可支撑这些技能的 oracle 知识,按 claim 级语义匹配度量保留率。结果(Figure 1):AWM 仅保留 12.7%,Trace2Skill 31.5%,ReasoningBank 40.9%——最好的方法也丢掉了近六成日后有用的知识。改用「检索原始轨迹再合成」也无法解决:Figure 2 显示各检索范式的知识召回率整体很低,把检索深度 $k$ 从 1 拉到 20,召回的边际增益递减,而精度因混入大量无关知识快速下滑。
本文的目标是本文的目标是把技能合成从「未来需求未知时的一次性预抽象」改造为「任务执行时的按需动态合成」:给定积累的原始经验库 $\mathcal{E}$ 和当前目标任务 $x$,由一个技能策展人(curator)$\phi$ 现场从 $\mathcal{E}$ 中定位与 $x$ 真正相关的程序性知识,合成任务专属技能 $S_{\mathcal{E},x}$ 供冻结执行器 $\theta$ 使用,即 $S_{\mathcal{E},x}=\phi(\mathcal{E},x)$,$a_t\sim\theta(\cdot\mid x,h_t,S_{\mathcal{E},x})$。具体包含四个可检验的子目标:(1) 在 ALFWorld、WebShop、ScienceWorld 三个基准上稳定超越预抽象技能与测试时合成基线;(2) 经验库从零在线增长时也能自进化,且随经验规模扩大优势递增而非饱和;(3) 能与已部署的预构建技能协同,以既有技能为起点做按需精化而非推倒重建;(4) 全过程在受控的经验访问预算(token)内比朴素的 agentic search 更有效。
与已有工作不同的是,独特切入角度在于问题重构:与其问「如何更好地预先抽象经验」,不如问「如何让 agent 在需要时主动探索经验」。作者指出一条朴素路线——检索 top-k 相似轨迹再合成(如 SkillTTA)——仍是被动的:相似性无法刻画「过程相关性」,相似轨迹里往往塞满无关知识,而表面不相似的轨迹中可能藏着局部关键线索,例如某次失败记录里一句关于操作顺序的推理。因此论文把经验访问定义为 agent 自身的主动决策过程:curator 逐轮决定「看哪里、看多细」,可在轨迹级与步级视图间切换分辨率,也可把局部记录展开成完整轨迹上下文;再以持续演化的导航状态把「已确认什么、还缺什么」显式化,让每轮访问由知识缺口驱动。这与经验学习文献(预抽象派)和 agentic search 文献(查询改写派)都不同:前者改变了访问时机(预→按需),后者改变了访问接口(被动检索→为经验结构定制的多分辨率导航加上状态管理)。
核心方法
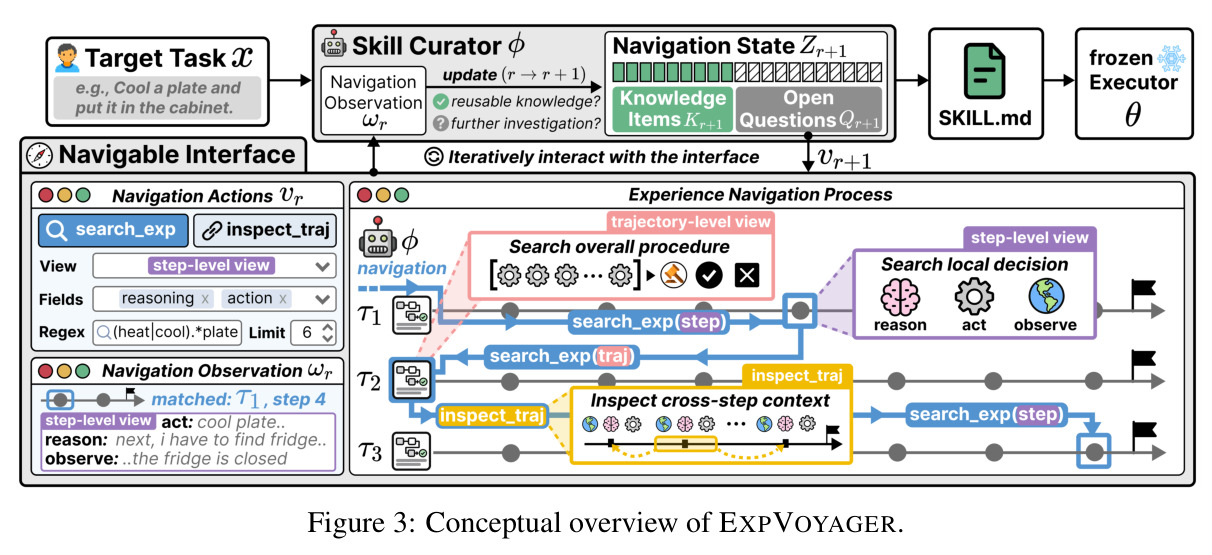
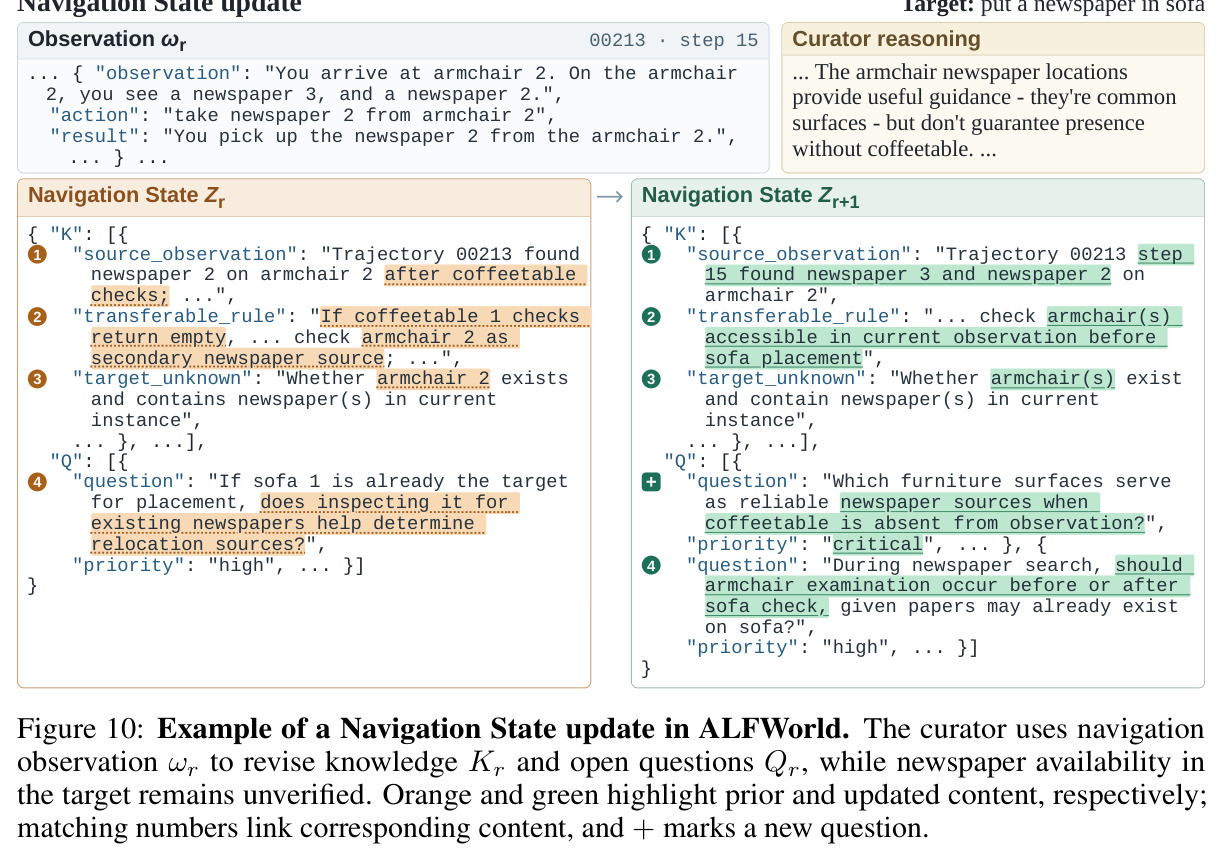
直觉是:一条历史轨迹中对当前任务有用的知识往往散落在不同侧面——整体动作序列揭示高层流程,某个失败动作的局部推理揭示触发条件,跨步骤的先后关系揭示顺序约束,任何一次性、单一粒度的压缩都会顾此失彼。ExpVoyager 采用「策展人—执行器」分工:冻结的 executor 负责与环境交互,curator(与 executor 同一或更强的 LLM)在任务开始前对经验库做至多 $R{=}20$ 轮导航,产出一份任务专属的 skill.md。技术路线由两个组件构成:其一,Navigable Interface 把经验组织成轨迹级视图(有序动作序列、执行结果、任务元数据)与步级视图(动作前后观察、记录的推理、动作、即时结果),curator 通过两个原生工具访问:search_exp 按指定索引、字段、正则模式与结果上限检索记录,inspect_traj 沿记录中的引用展开完整轨迹;其二,Navigation State $Z^r=(K^r,Q^r)$ 维护已策展知识 $K^r$(区分源观察、可迁移规则、待执行验证的未知项)与开放问题 $Q^r$,每轮按 $(Z^{r+1},\nu^{r+1})=\phi_{\text{nav}}(Z^r,\omega^r;x)$ 更新,使「访问什么」由「还缺什么」驱动;当 curator 判断继续调查无益或预算耗尽时,由 $S_{\mathcal{E},x}=\phi_{\text{synth}}(Z^R,x)$ 合成最终技能。
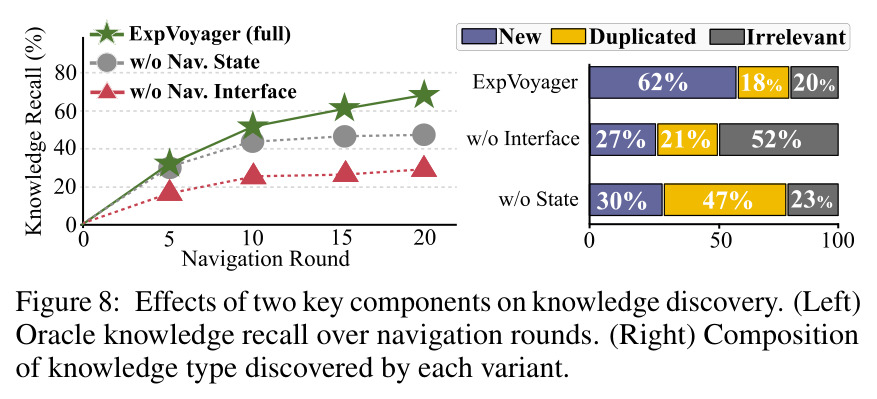
核心创新是把「经验→技能」的映射从离线的、需求无关的压缩,改为在线的、需求条件化的导航式策展。与 AWM/ReasoningBank/Trace2Skill 的本质区别有三点。第一,信息保真:原始经验永不改写,视图只是重新索引(JSONL),一切抽象都发生在已知当前任务 $x$ 之后,因此不会预先丢弃日后关键的知识——这正是对 Figure 1 中 12.7%–40.9% 保留率的直接回应。第二,访问粒度可控:curator 可以只看一条步级记录的推理字段,也可以展开整条轨迹;检索返回完整记录以保留「上下文—决策—后果」的执行语义,而非孤立文本块。第三,过程有状态:$Q^r$ 把知识缺口转成具体调查目标,$K^r$ 强制区分「源里发生了什么」(source_observation)、「什么可迁移」(transferable_rule)、「什么必须执行时验证」(target_unknown),从机制上抑制把源实例细节误当目标事实。与 SkillTTA 的区别是主动 vs 被动:不是由相似度分数决定看什么,而是 curator 依据演化中的理解自主选择。与 agentic search(查询改写循环)的区别在于接口为经验结构定制,且显式状态管理避免重复访问——Figure 8 显示去掉状态后重复知识占比从 18% 涨到 47%。
方法步骤详情
完整流程五步。第一步,经验物化:把源轨迹整理成两个 JSONL 索引——trajectory index 每行含有序动作序列与最终结果,step index 每行含动作前后观察、执行器当时的推理、动作与即时结果,两视图均保留指向完整轨迹的路径引用。第二步,状态初始化:从目标 $x$ 的指令与初始观察构造 $Z^0$,生成初始程序性问题(如「目标物品通常放在哪里」)。第三步,导航循环(至多 20 轮):每轮 curator 先从 $Q^r$ 中挑最高优先级的开放问题,再发起一次导航动作 $\nu^r$——调用 search_exp 时需指定索引、检索字段、大小写不敏感的正则模式与结果上限,系统返回完整存储记录及其源引用;调用 inspect_traj 时按引用返回按时间序的整条轨迹(支持 offset/limit 分页)。随后另一次模型调用解释新观察 $\omega^r$ 并输出完整新状态 $Z^{r+1}$:判断证据是否真的回答了问题、把源观察投影为可迁移规则或失败教训、把只能当前环境验证的事实放入 target_unknown、增删开放问题。第四步,终止:状态已足以支撑有用技能且继续检索不太可能改善时返回 FINISH。第五步,技能合成:从 $Z^R$ 生成 skill.md——已确认程序作为主干流程、检索先验仅作为待现场核对的候选、失败教训转为检查与恢复指引、未决条件保留为执行时检查点。
技术新颖性
技术新颖性可从四个层面评估。问题层面:这是首个把技能合成形式化为「对经验空间的主动导航决策问题」的工作,与经验学习(预抽象)和 agentic search(查询改写)两条线都正交,访问时机与访问接口同时被改变。接口层面:Navigable Interface 的关键洞察是经验记录自带执行语义结构(context–decision–consequence),值得为其定制视图与操作,而非像通用语料搜索那样对序列化文本直接 grep——消融显示去掉结构化视图后,发现的知识中无关项占比从 20% 升至 52%。状态层面:$Z^r$ 的角色分离设计(三元组 source_observation/transferable_rule/target_unknown,知识项按 confirmed procedures、search priors、failure lessons 组织)是一种轻量、可审计的知识状态机,明确隔离「源事实」与「目标推断」,这在记忆管理文献中少见。工程层面:整个方法无需训练任何模型——正则匹配、JSONL、原生函数调用即可实现,天然兼容任意 LLM 后端,论文展示了 9B curator 提升 31B executor 的可行性;相比之下 SkillOS 等工作需用强化学习训练策展策略,成本与复杂度显著更高。当然,用正则做语义检索在表达力上有上限,这是新颖性与实用性之间一次明确的取舍。
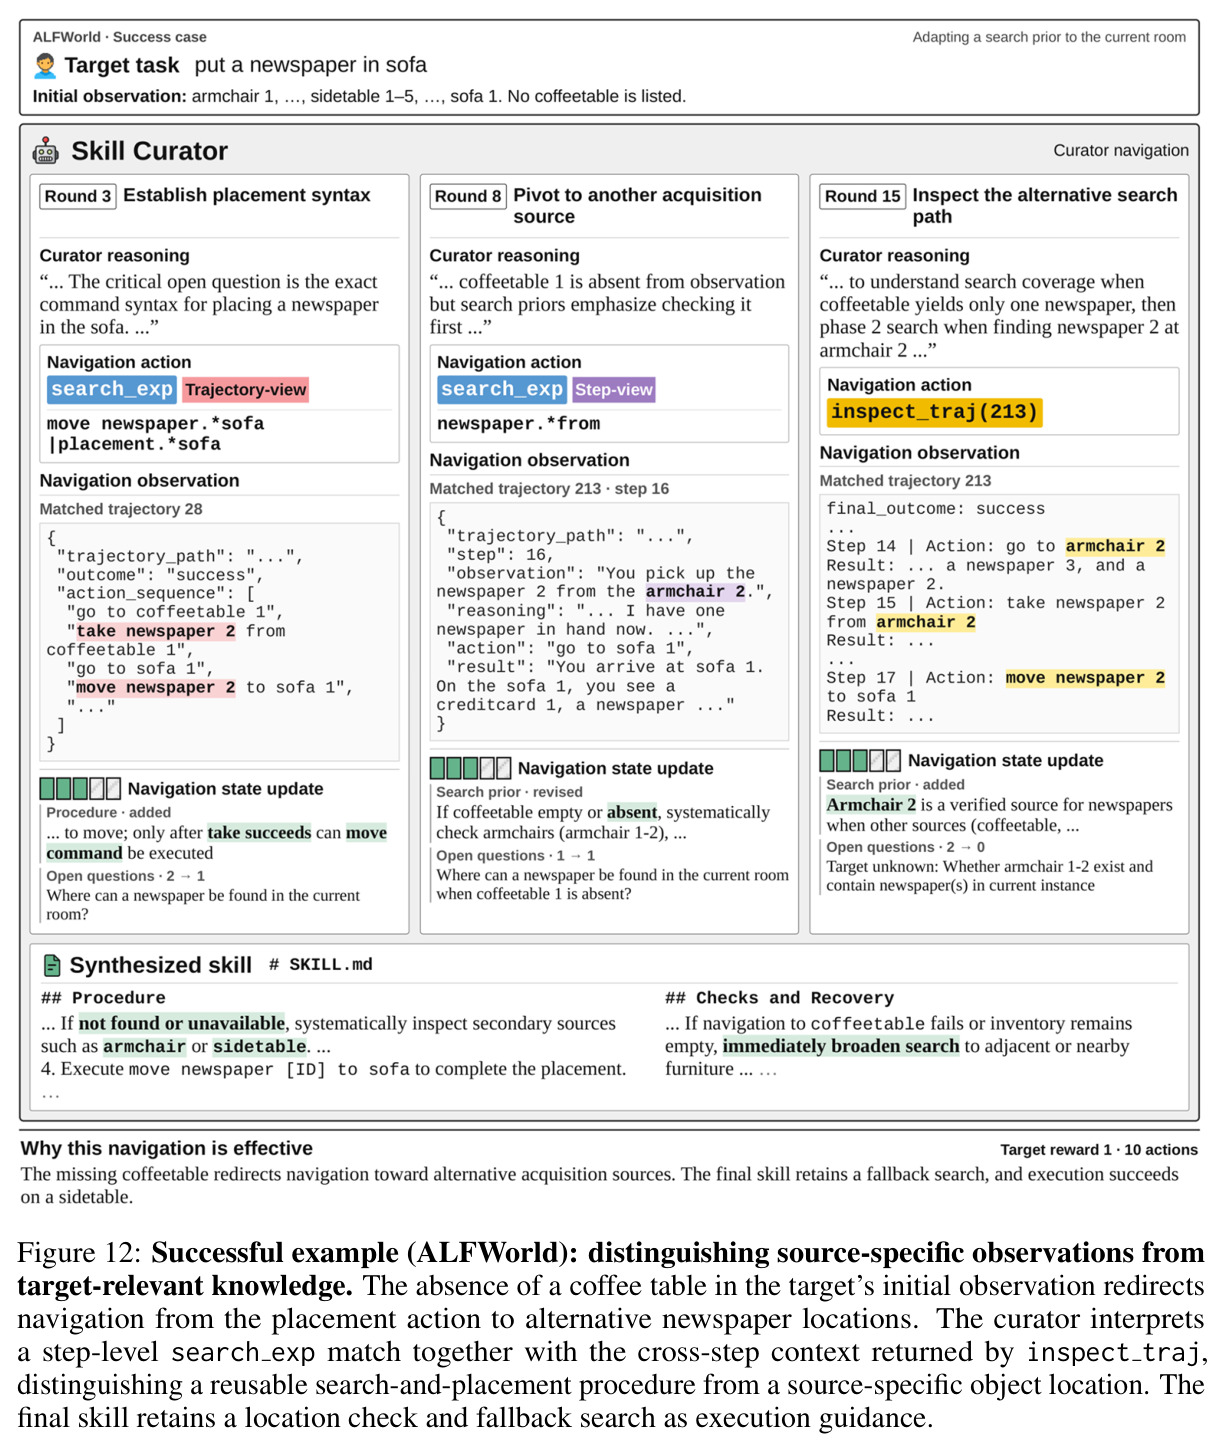
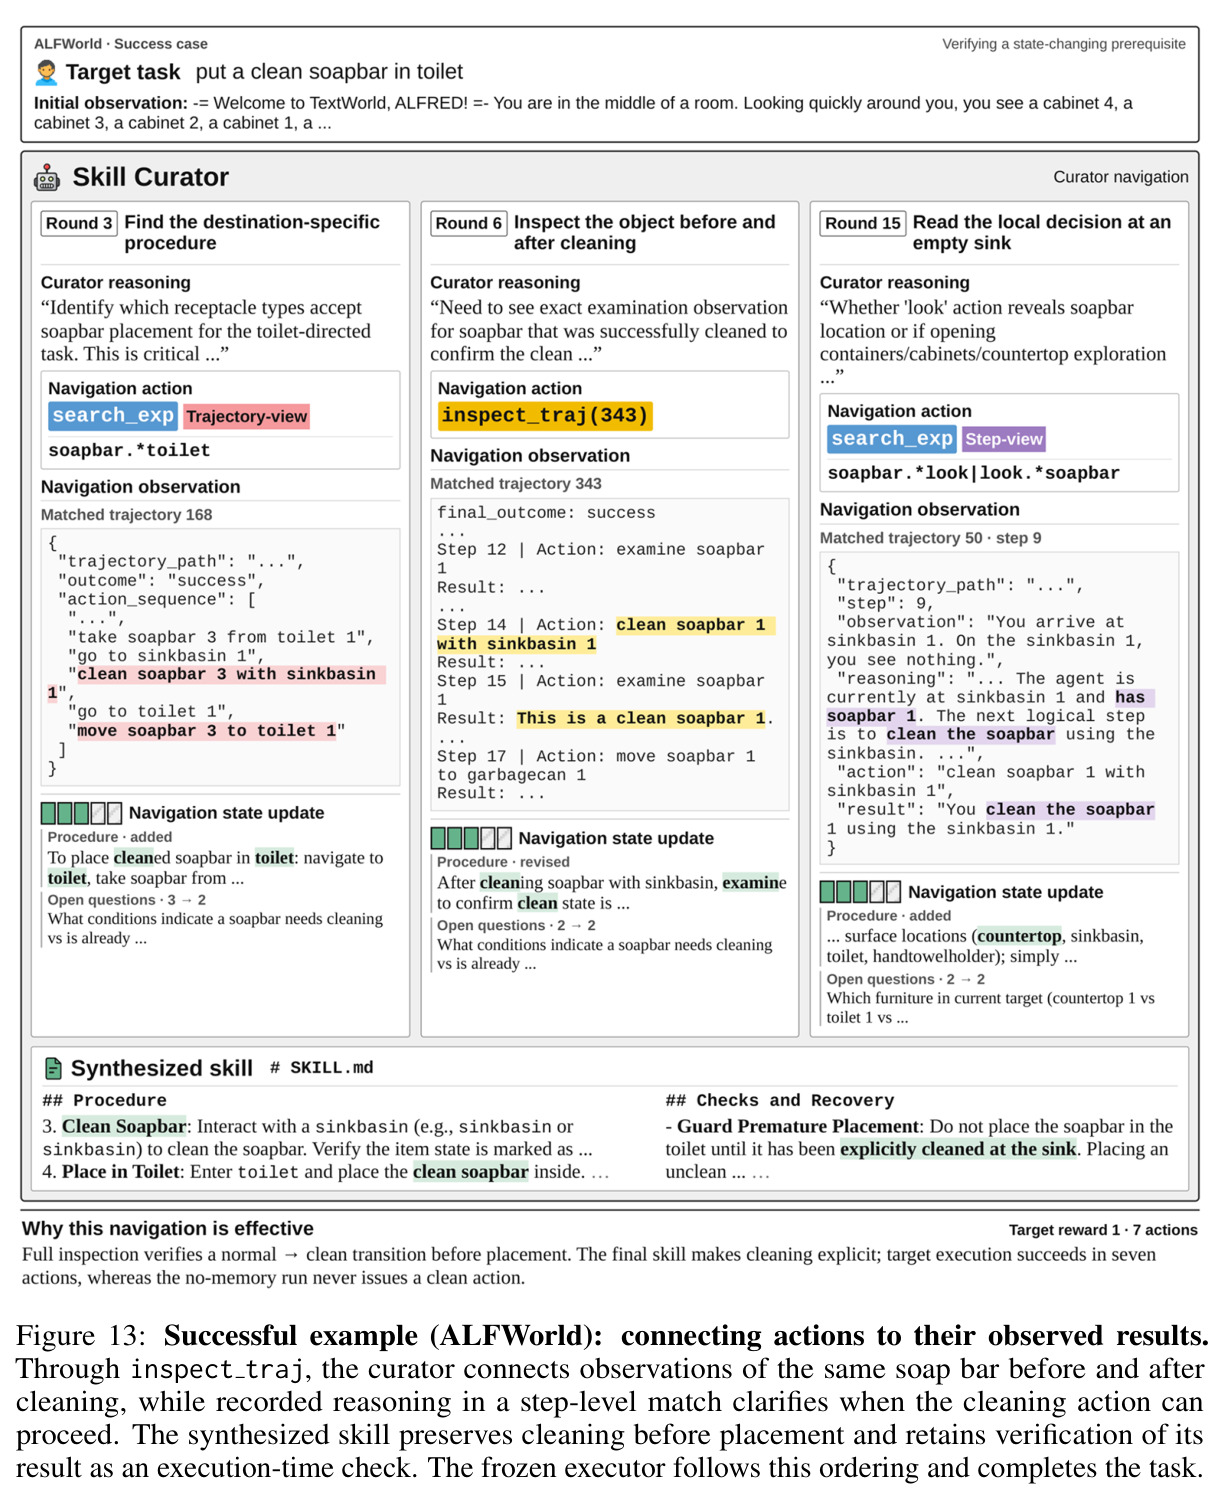
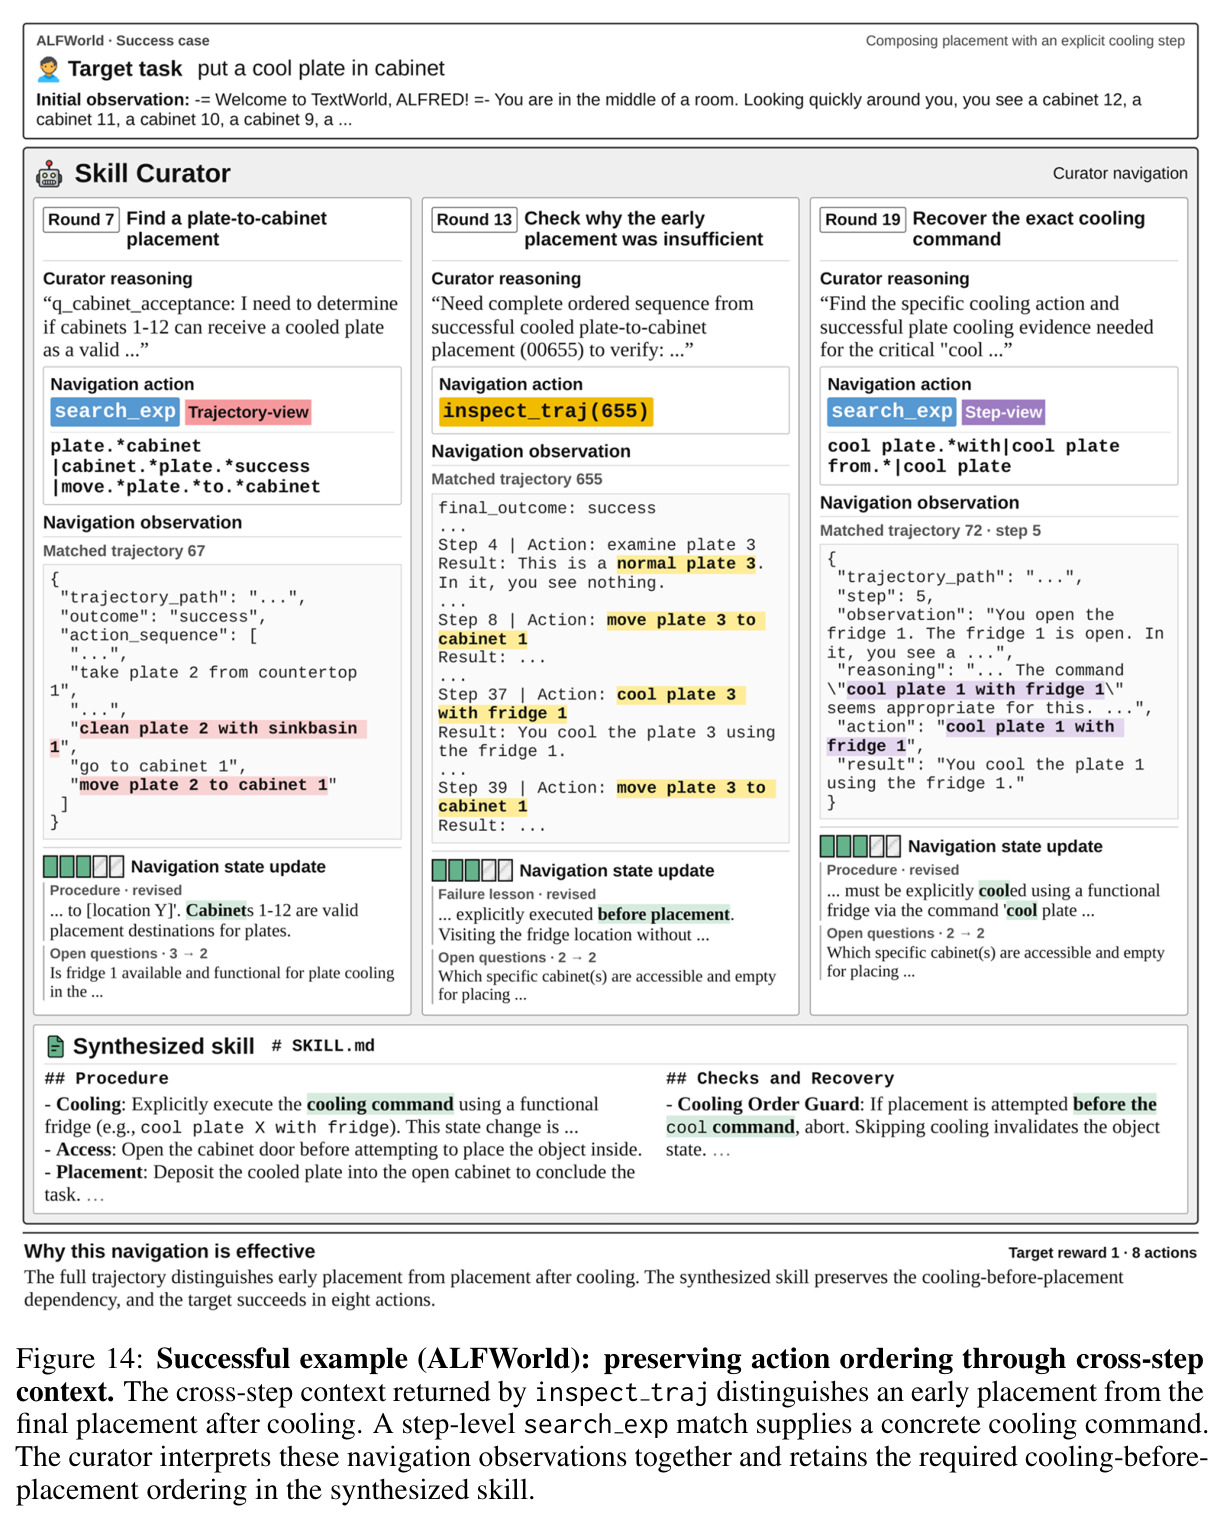
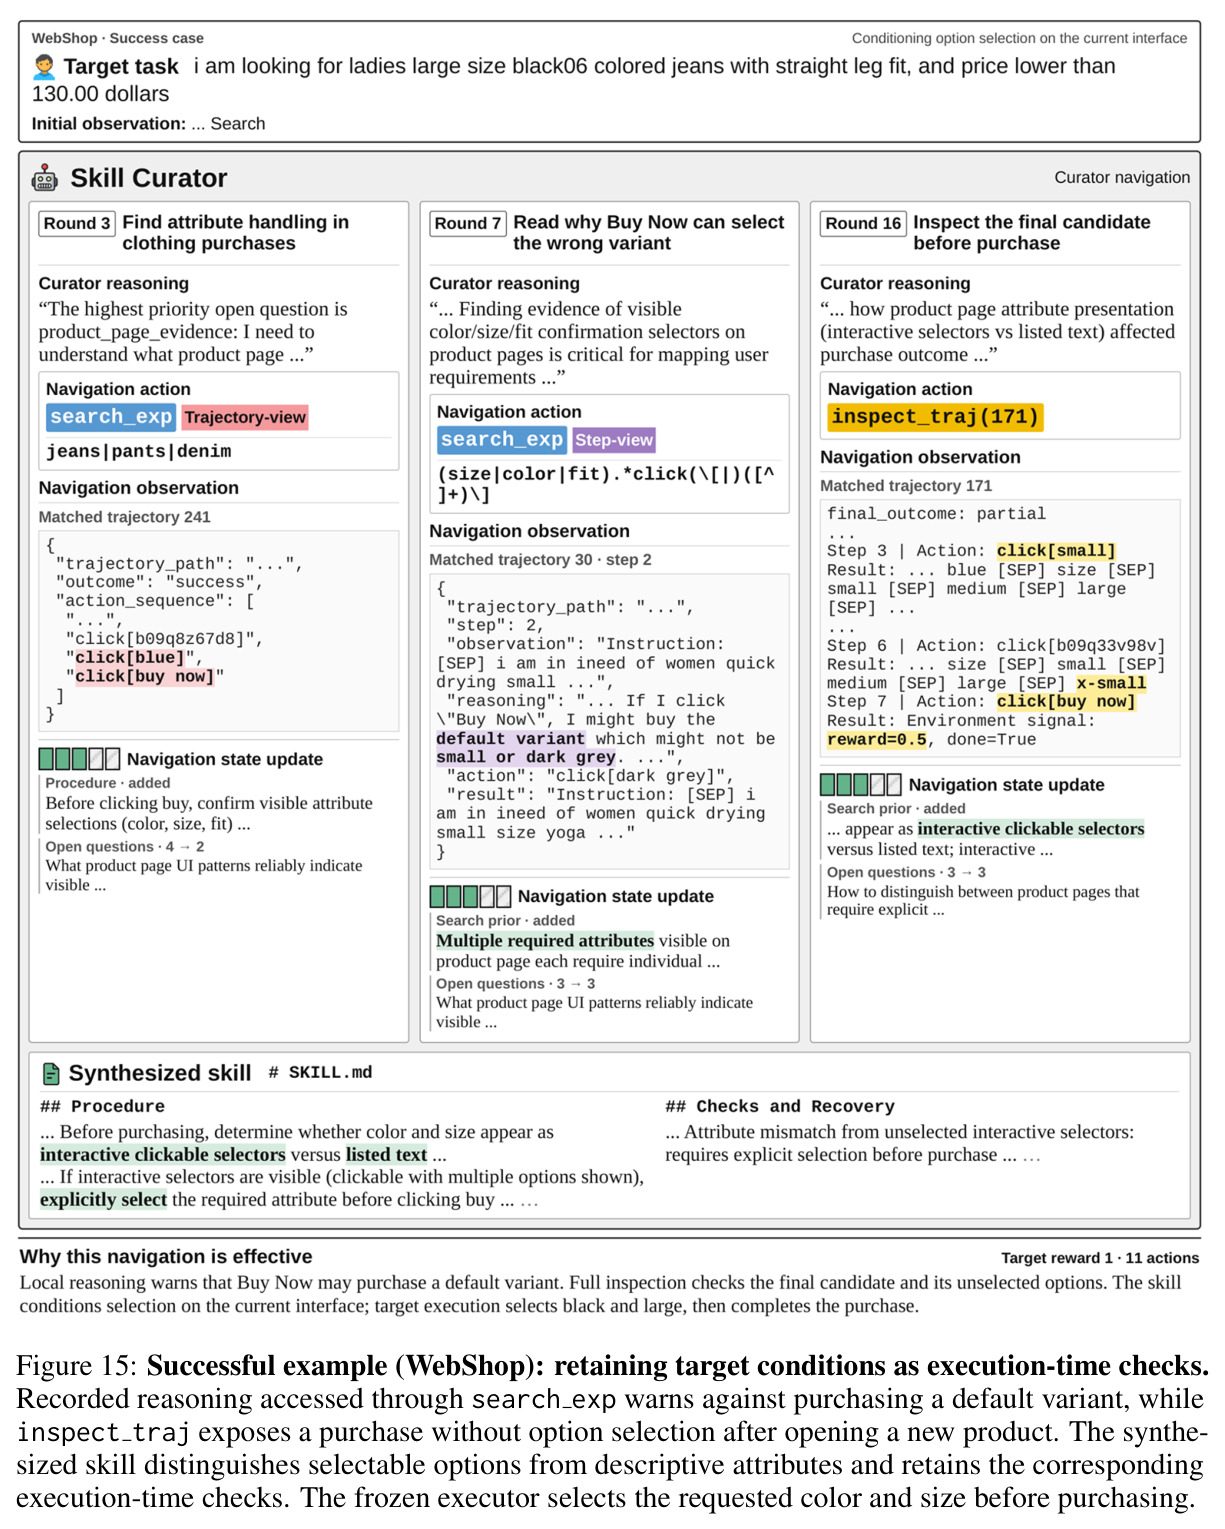
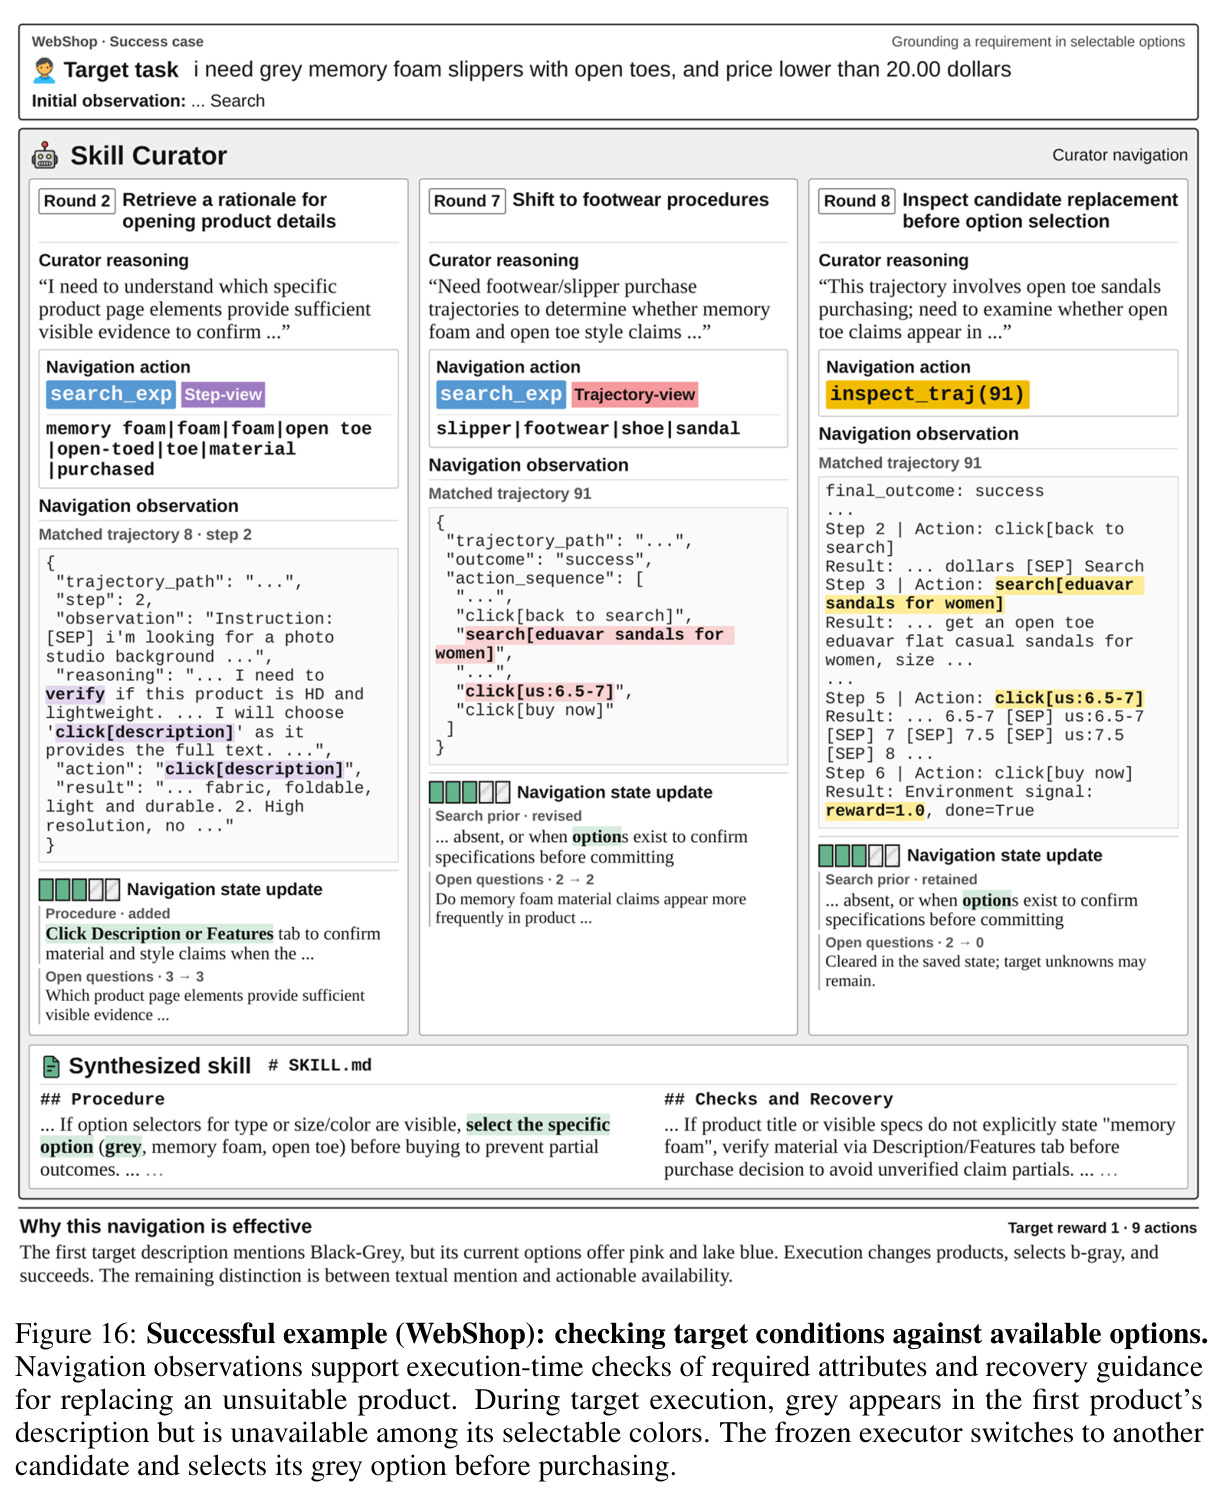
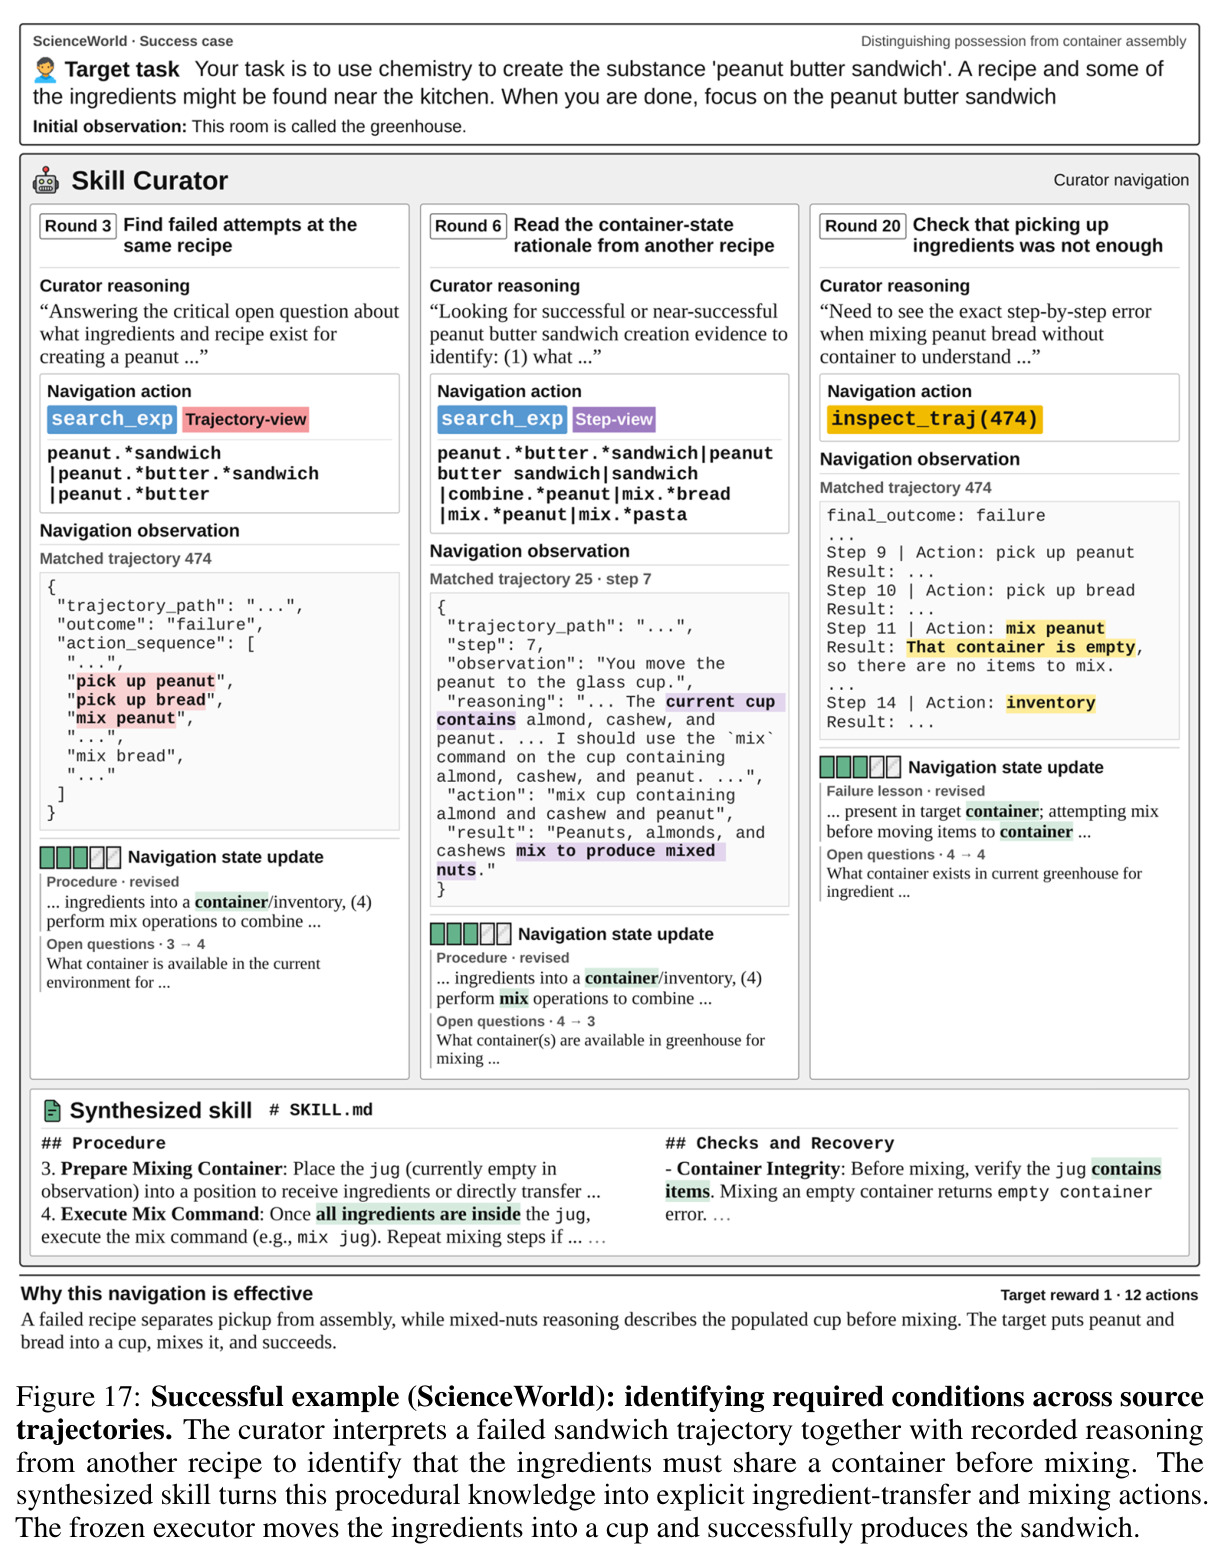
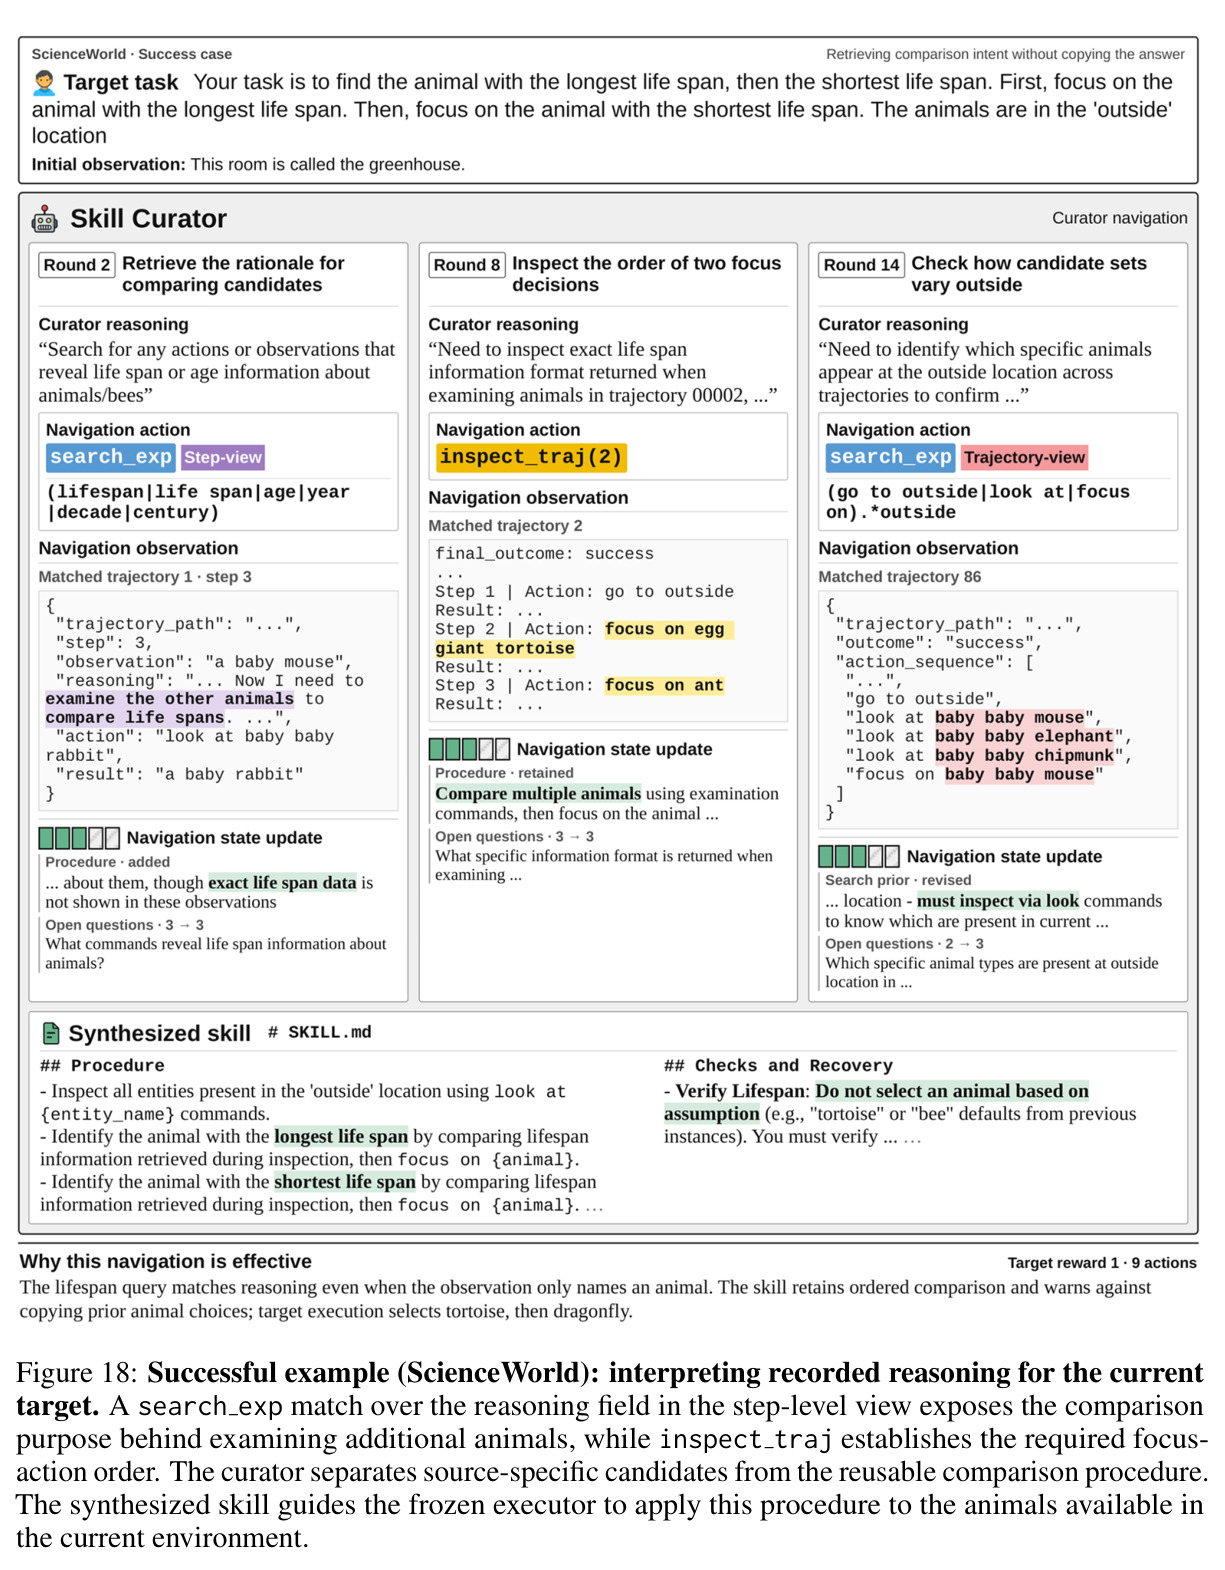
实验结果
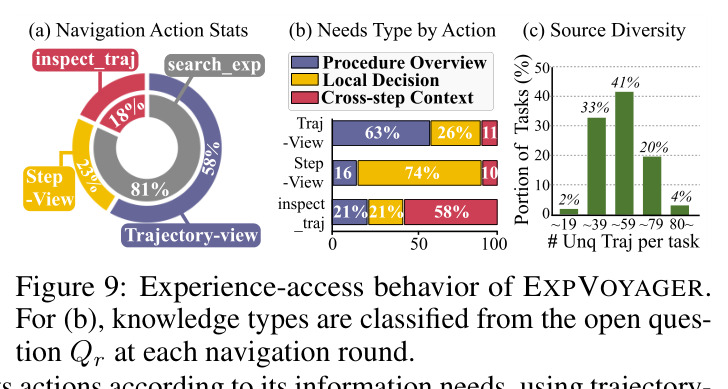
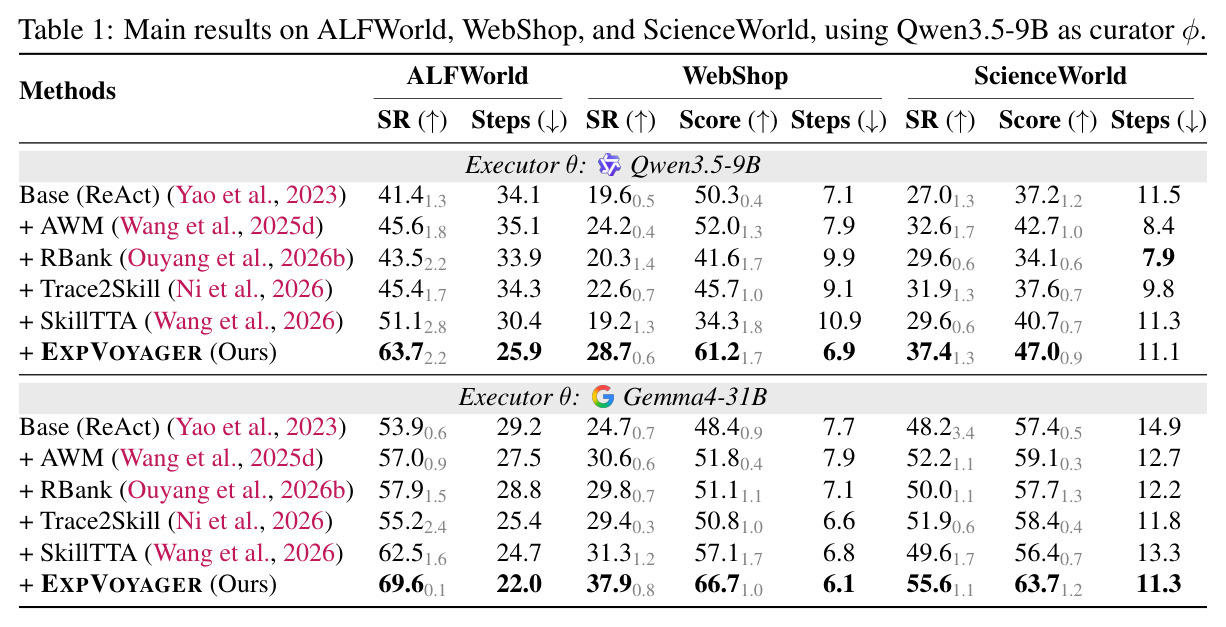
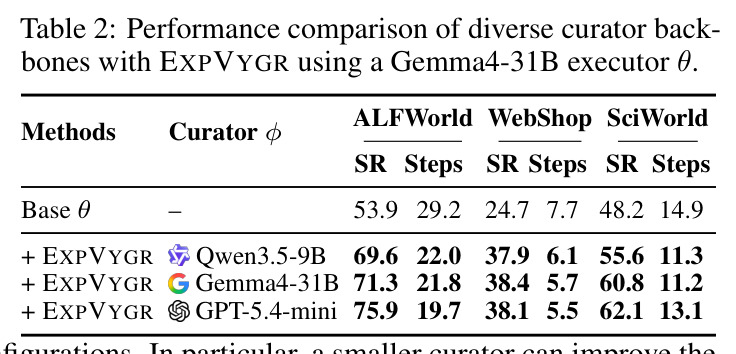
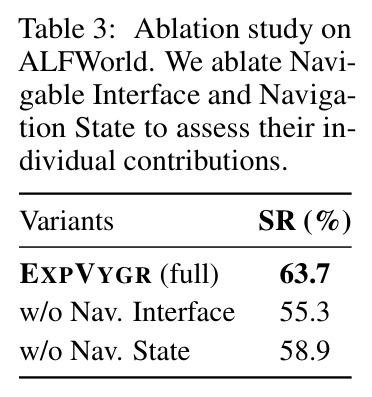
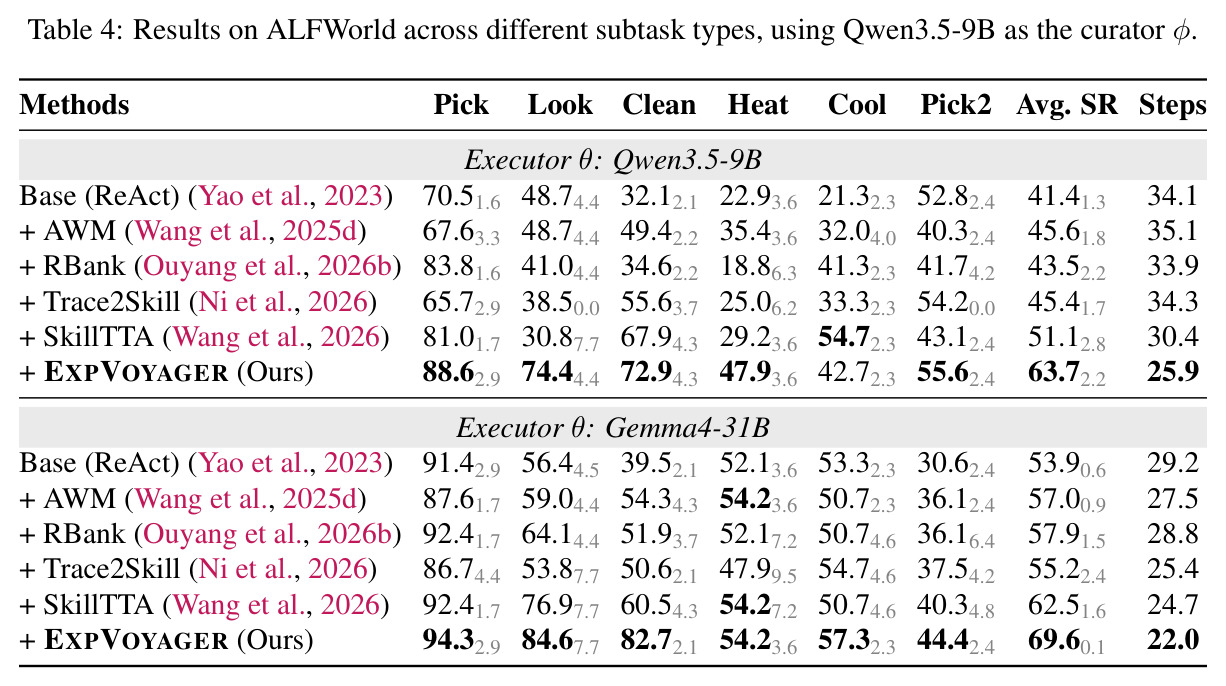
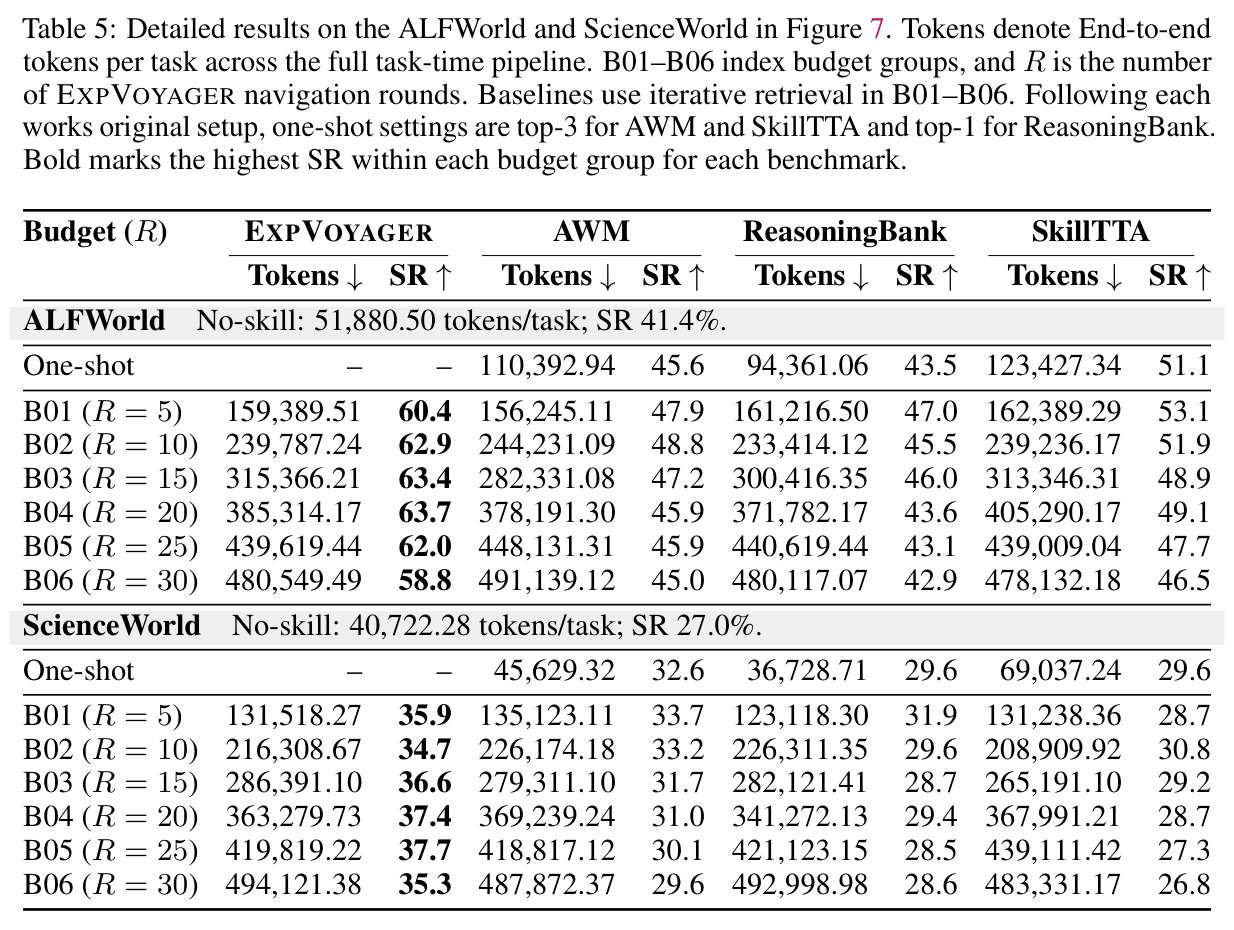
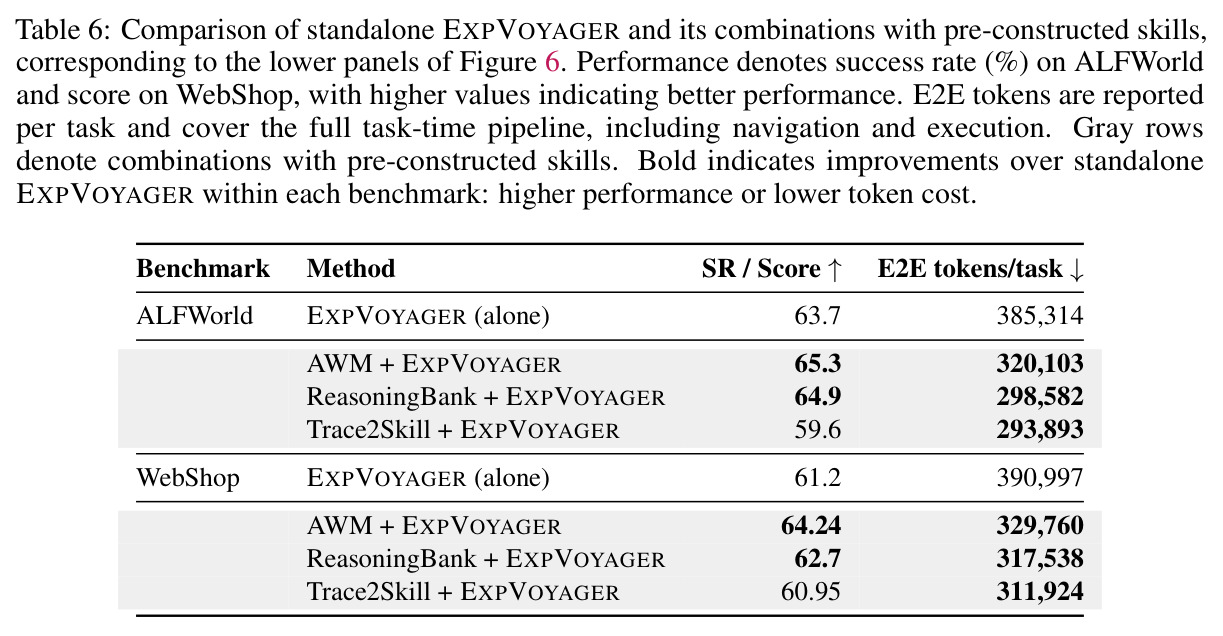
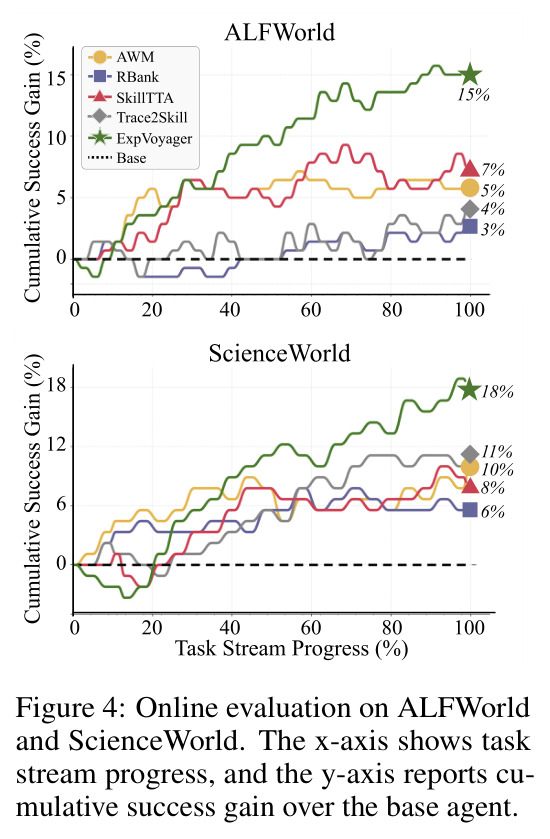
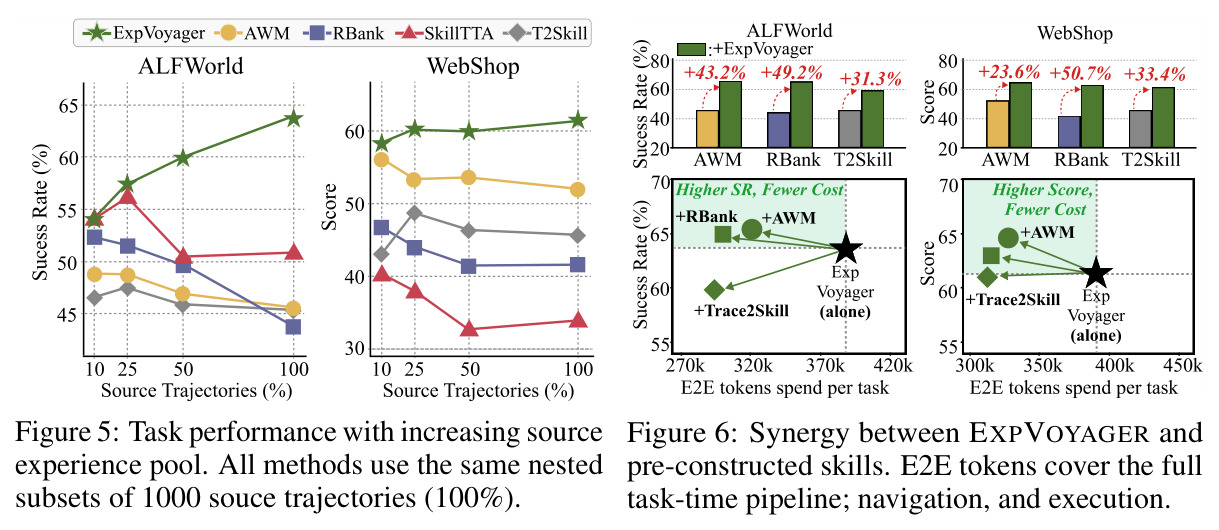
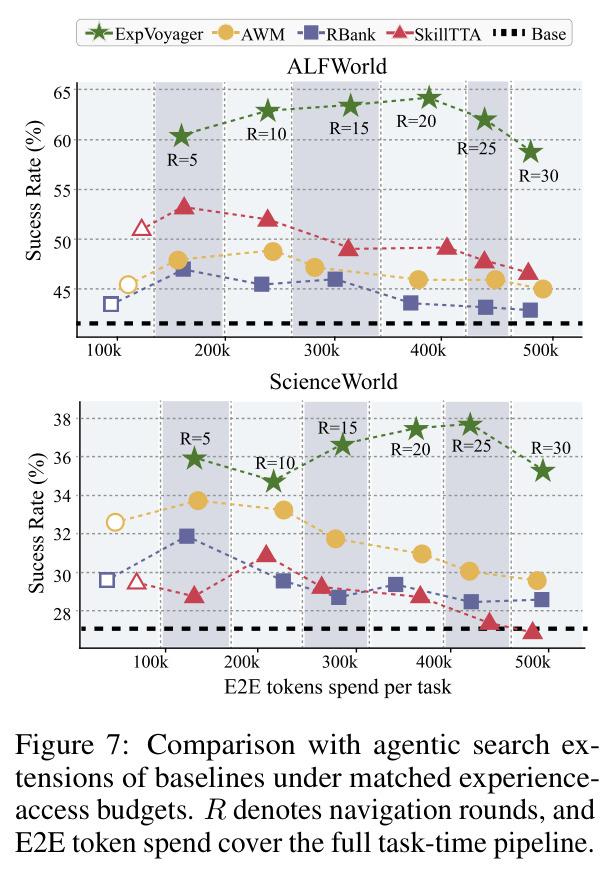
逐一过实验。(1) 主结果(Table 1,curator=executor=Qwen3.5-9B,离线 1000 条源经验):ALFWorld 成功率 41.4%→63.7%(+22.3),平均步数 34.1→25.9;WebShop 成功率 19.6%→28.7%、评分 50.3→61.2;ScienceWorld 成功率 27.0%→37.4%、评分 37.2→47.0。换 Gemma4-31B 执行器趋势一致:ALFWorld 53.9%→69.6%、WebShop 24.7%→37.9%(评分 48.4→66.7)、ScienceWorld 48.2%→55.6%,且步数在所有对照中最少。(2) curator 迁移性(Table 2):同一 Gemma4-31B 执行器下,Qwen3.5-9B/Gemma4-31B/GPT-5.4-mini 三种 curator 分别取得 ALFWorld 69.6/71.3/75.9,9B 策展即可大幅提升 31B 执行器。(3) 在线自进化(Figure 4):任务流初期经验稀薄时收益有限甚至为负,但随经验积累持续爬升;基线约在 40% 进度后趋平(ALFWorld 增益 3–7%、ScienceWorld 6–11%),本文持续扩大优势。(4) 规模扩展(Figure 5):源轨迹从 10% 增至 100%(1000 条),基线成功率不升反降,ExpVoyager 单调上升,ALFWorld 相对提升最高约 +43%–51%、WebShop 约 +24%–33%。(5) 与预构建技能协同(Figure 6/Table 6):AWM+ExpVoyager 在 ALFWorld 达 65.3,每任务端到端 token 从 385,314 降至 320,103;WebShop 评分 64.2、token 390,997→329,760,性能与成本双赢。(6) 预算公平比较(Figure 7/Table 5):同预算下全面超过迭代检索式 agentic search 扩展(如 ALFWorld 385K token 处 63.7% vs AWM 45.9%、RBank 43.6%、SkillTTA 49.1%);基线加预算近乎无益甚至有害,本文在 20 轮达峰、30 轮回落至 58.8%。(7) 消融(Table 3/Figure 8):去接口降至 55.3%(无关知识 52%)、去状态降至 58.9%(重复知识 47%),完整版 63.7%。(8) 行为分析(Figure 9):约 82% 动作为 search_exp、18% 为 inspect_traj,不同视图精准对应不同需求类型,多数任务访问数十条不同源轨迹。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld(家务交互,140 个测试任务,Qwen3.5-9B 执行器) | 成功率 SR (%) / 平均步数 | 63.7 / 25.9 | ReAct 基线 41.4 / 34.1;最强基线 SkillTTA 51.1 / 30.4 | +22.3 vs 基线,+12.6 vs 最强基线,步数同时最少 |
| WebShop(在线购物,500 条测试指令,Qwen3.5-9B 执行器) | 成功率 SR (%) / 评分 | 28.7 / 61.2 | ReAct 19.6 / 50.3;最强基线 AWM 24.2 / 52.0 | SR +9.1,评分 +10.9 |
| ScienceWorld(科学推理,90 个实例,Qwen3.5-9B 执行器) | 成功率 SR (%) / 官方评分 | 37.4 / 47.0 | ReAct 27.0 / 37.2;最强基线 AWM 32.6 / 42.7 | SR +10.4,评分 +9.8 |
| ALFWorld(Gemma4-31B 执行器,更换 curator) | 成功率 SR (%) | 69.6(Qwen3.5-9B curator)/ 71.3(Gemma4-31B)/ 75.9(GPT-5.4-mini) | ReAct 53.9;最强基线 SkillTTA 62.5 | +15.7 vs 基线;9B curator 也能大幅提升 31B 执行器 |
| 经验规模扩展(ALFWorld,源轨迹 10%→100%) | 成功率相对提升 (%) | 随规模单调上升,100% 处相对提升最高约 +43%–51% | AWM/RBank/SkillTTA/Trace2Skill 随规模增大而下降 | 趋势反转:基线为负增长,本文把更多经验变成红利 |
| 经验访问预算比较(ALFWorld,约 385K tokens/任务) | 成功率 SR (%) | 63.7(R=20) | 同预算 agentic search 扩展:AWM 45.9 / ReasoningBank 43.6 / SkillTTA 49.1 | +14.6 ~ +20.1 |
局限与改进
作者实验中显现的局限:其一,导航收益存在甜点区,ALFWorld 上 R=20 达峰 63.7%、R=30 回落至 58.8%,归因于过量访问引入冗余或低相关信息干扰执行,但论文未给出可靠的自动早停信号,轮数需人工调节;其二,成本高昂,每任务端到端约 385K token(ALFWorld),是无技能执行(51.9K)的 7 倍以上,对延迟和费用敏感的场景难以直接上线;其三,在线冷启动弱,经验少时甚至劣于基线,说明该范式依赖一定规模的多样化经验。我的补充观察:第一,接口用字面正则匹配,存在词汇鸿沟——若历史轨迹用不同措辞描述同一操作(如 grab 与 take),召回依赖 curator 自己枚举同义词,这一点论文未量化;第二,三个失败案例(Figure 19–21)揭示合成阶段仍是信息瓶颈:导航中已识别的顺序约束可能在多观察合并成单份 skill.md 时被压平,识别出前提条件不等于能给出建立该条件的动作序列;第三,状态更新与动作选择每轮各需一次强模型调用,小模型能否稳定输出合规结构化状态、失败率多少未讨论;第四,oracle 知识标注与消融分析主要在 ALFWorld 上完成,WebShop/ScienceWorld 缺少同等深度的知识级分析。
独立分析的弱点
弱点一:正则检索的语义盲区。search_exp 依赖大小写不敏感的正则字面匹配,无法处理同义改写、指代与跨语言表达,在开放域(如真实网页购物)中同一意图的表述空间极大,漏检风险随经验库词汇多样性上升。改进方向:在正则之上叠加轻量语义召回(嵌入预筛 + 正则精读),或让 curator 自动扩展同义词模式集合做联合查询。弱点二:任务时延与成本。每任务约 20 轮导航意味着约 40 次模型调用(动作选择 + 状态更新),385K token 的开销在批量场景下被放大。改进方向:任务聚类与技能缓存(相似任务复用导航产物)、蒸馏小型导航策略模型、或用 SkillOS 式 RL 离线优化导航策略以减少轮数。弱点三:合成阶段的信息丢失。失败案例显示导航发现的顺序约束、「状态变化后条件需重验」等细节在合成单份 skill.md 时可能被压平。改进方向:让技能保留与触发条件绑定的结构化检查点,或在合成后加一轮「状态—技能一致性校验」。弱点四:执行状态感知不足。WebShop 失败案例中 executor 重开商品后未重新选择选项即购买,说明技能未把条件表达为可重查的谓词。改进方向:把执行历史纳入导航上下文,将条件建模为随状态变化需重验的谓词。弱点五:冷启动依赖。经验稀薄时收益为负,可结合协同实验的思路回退到预构建技能加低导航预算的混合模式。
未来方向
作者方向:论文结尾定位于「为自进化 agent 提供基础」,并暗示与 harness 深度集成——把经验访问作为 harness 的一层按需知识源;协同实验表明预构建技能可作为可按需特化的基础层,指向「预抽象 + 按需精化」的混合落地形态。可延伸的研究:其一,学习型导航策略——把 curator 的导航决策作为可训练对象,用任务成功信号做 RL(类似 SkillOS、GrepSeek 的路线),有望把 20 轮压缩到个位数并自动学会早停;其二,语义—词法混合索引,弥补正则表达力的缺口并降低对 curator 提词能力的依赖;其三,经验库治理——随经验无限增长需要去重、分层与遗忘机制,$Z^r=(K^r,Q^r)$ 或可推广为跨任务的长期记忆结构;其四,多任务与多 agent 共享:跨任务缓存与合并导航产物,把单任务技能升级为任务族技能;其五,把失败案例暴露的三类合成缺陷(顺序丢失、条件重验、前提到动作的翻译)固化为针对性评测基准,驱动合成器改进;其六,为「导航预算—知识召回—任务性能」建立量化关系模型,指导预算在不同任务难度间的动态分配。
复现评估
复现友好度中上。有利因素:模型全部可及——Qwen3.5-9B 与 Gemma4-31B 用 vLLM 本地部署(论文用 6 卡 RTX A6000 48GB、BF16、32K 上下文、温度 1.0,9B 单卡即可),GPT-5.4-mini 走 API;三个基准(ALFWorld 1000 源轨迹/140 测试、WebShop 1000/500、ScienceWorld 500/90)公开且切分明确;方法本体无需任何训练,实现即正则搜索 + JSONL 索引 + 原生 function calling;附录给出全部提示词(Tables 7–13)、状态 JSON 结构与工具 schema,论文标注了 CODE 开源链接。不利因素:完整评估算力不低——主表为两套执行器 × 三基准 × 三次随机运行,预算实验每组至多约 48 万 token/任务,在线实验还需 3 种任务序重跑,总推理开销预计达数亿 token 量级;预实验的 oracle 标注依赖 GPT5.6 Sol 级模型、每技能至多 20 轮执行验证加人工复核(80 个技能 × 300 条源),成本很高,但该部分仅用于动机分析,复现方法与主结果可完全跳过。总体判断:工程复现(方法 + 主结果)难度中等,2–4 张 48GB 级显卡可行;完整复刻全部分析则需可观预算。
论文图表
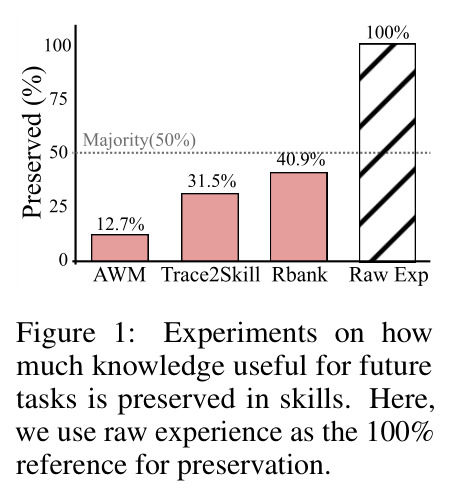
柱状图对比三种预构建技能对源轨迹中 oracle 知识的保留率:AWM 仅 12.7%,Trace2Skill 31.5%,ReasoningBank 40.9%,原始经验为 100% 参照线。
用受控的 claim 级语义匹配实验量化了「预抽象丢失知识」这一核心动机,是全文立论的基石数据。
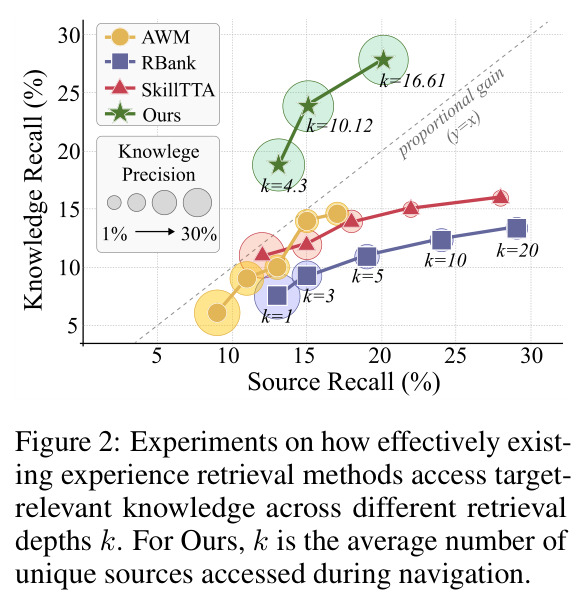
以源召回率为横轴、知识召回/精度为纵轴,画出 AWM、ReasoningBank、SkillTTA 与本文方法在不同检索深度 k(1/3/5/10/20)下的表现,并标注平均访问源数(k=16.61、k=10.12、k=4.3)。基线知识召回普遍很低,k 增大后精度迅速下滑;ExpVoyager 以约 10 个不同源的访问量取得更优的召回—精度权衡。
证明被动 top-k 检索无法高效触达目标知识,为「主动导航」接口提供直接动机。
散点图(x:每任务端到端 token;y:性能),比较各基线单独、与 ExpVoyager 组合、ExpVoyager 单独三种设定。组合版同时实现更高性能与更低成本:ALFWorld 上 AWM+ExpVoyager 达 65.3 SR、320K tokens,优于 ExpVoyager 单独的 63.7、385K。
证明按需精化可与已部署技能库共存互补,是对工程落地最相关的实验。
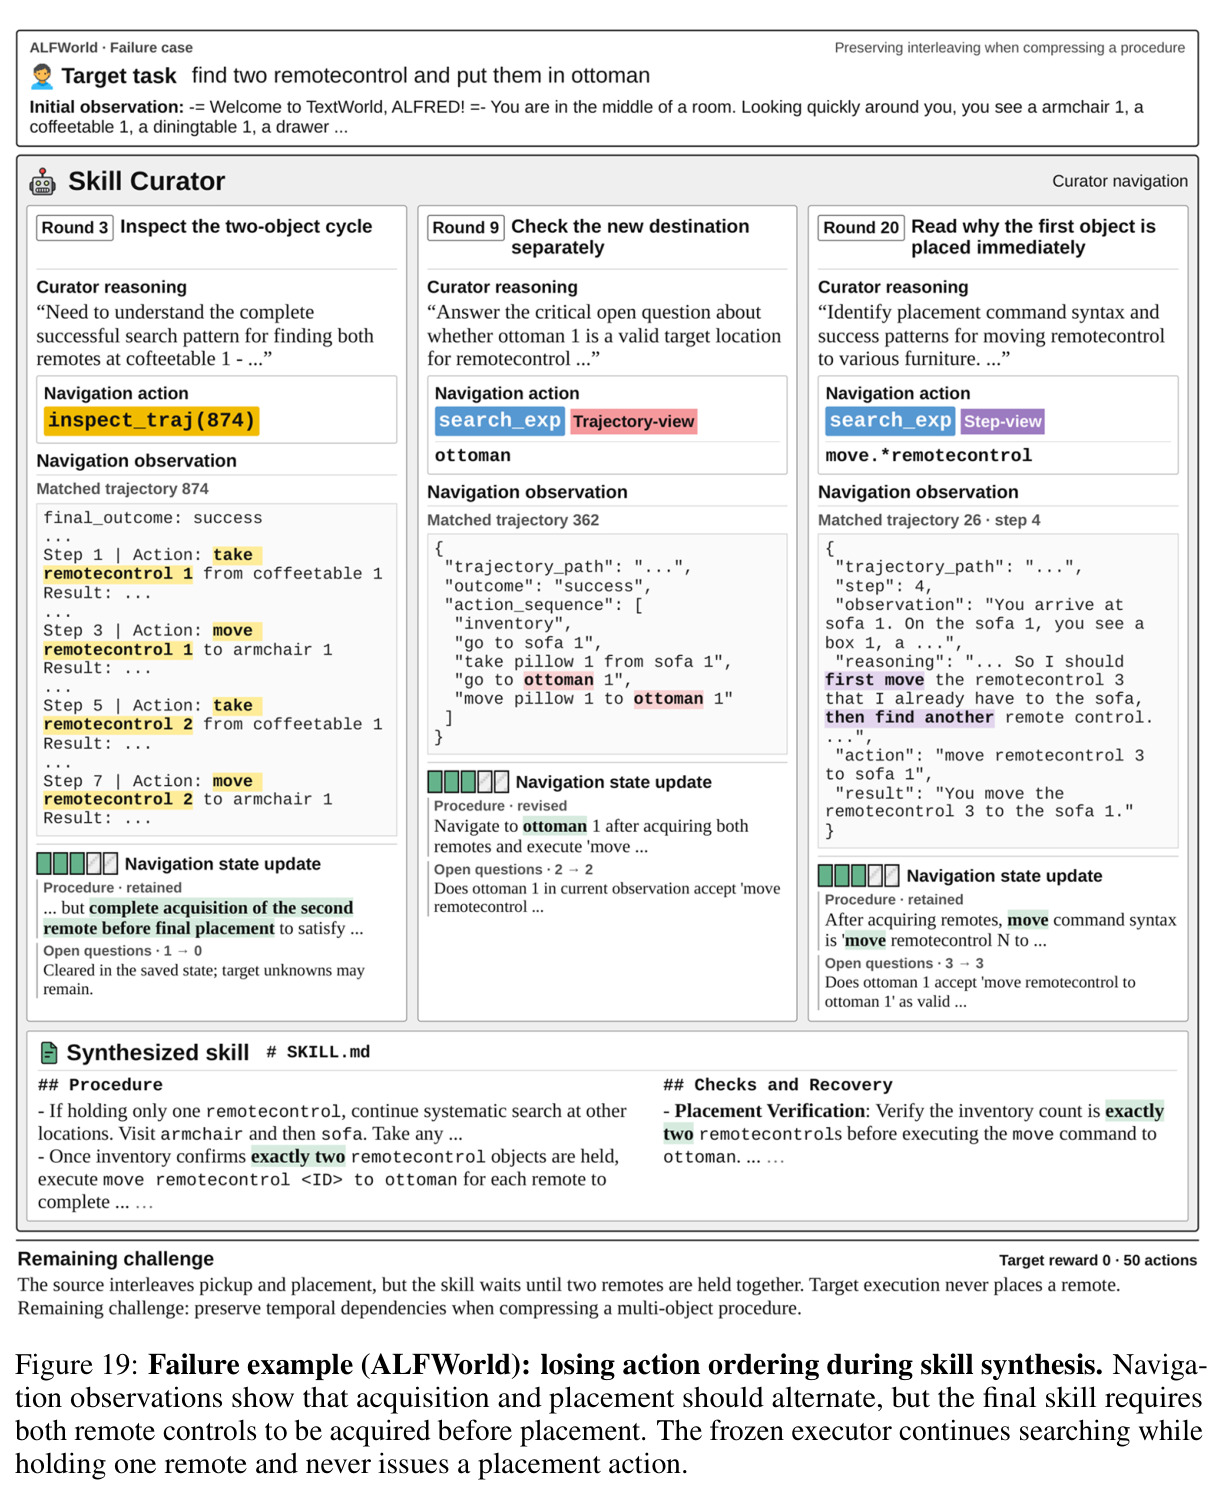
两个遥控器任务:导航已发现「取一放一再取下一个」的顺序证据,但最终技能错误要求先取两个遥控器再放置,executor 一直搜索而从未放置。
失败案例 1:揭示合成阶段可能压平导航已发现的顺序约束。
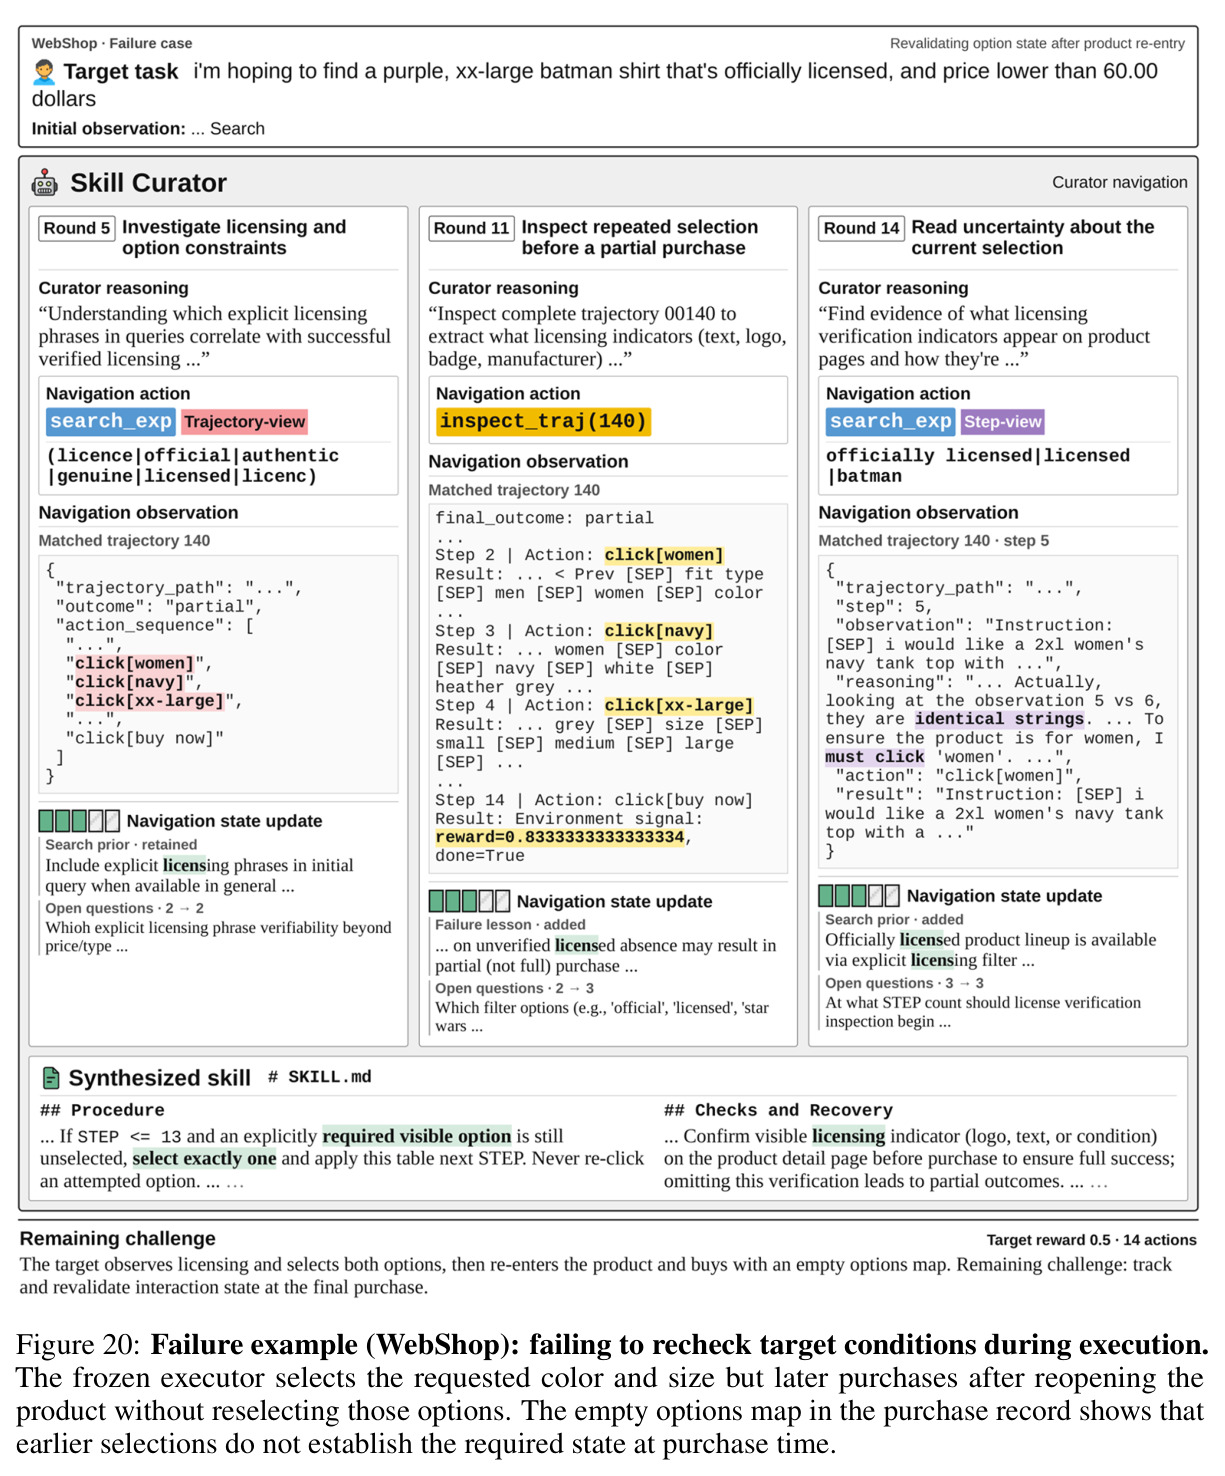
蝙蝠侠 T 恤任务:executor 曾选中颜色和尺寸,但离开并重开商品后未重新选择即购买,购买记录的选项映射为空。
失败案例 2:暴露技能缺乏「状态变化后条件需重验」的执行状态感知。
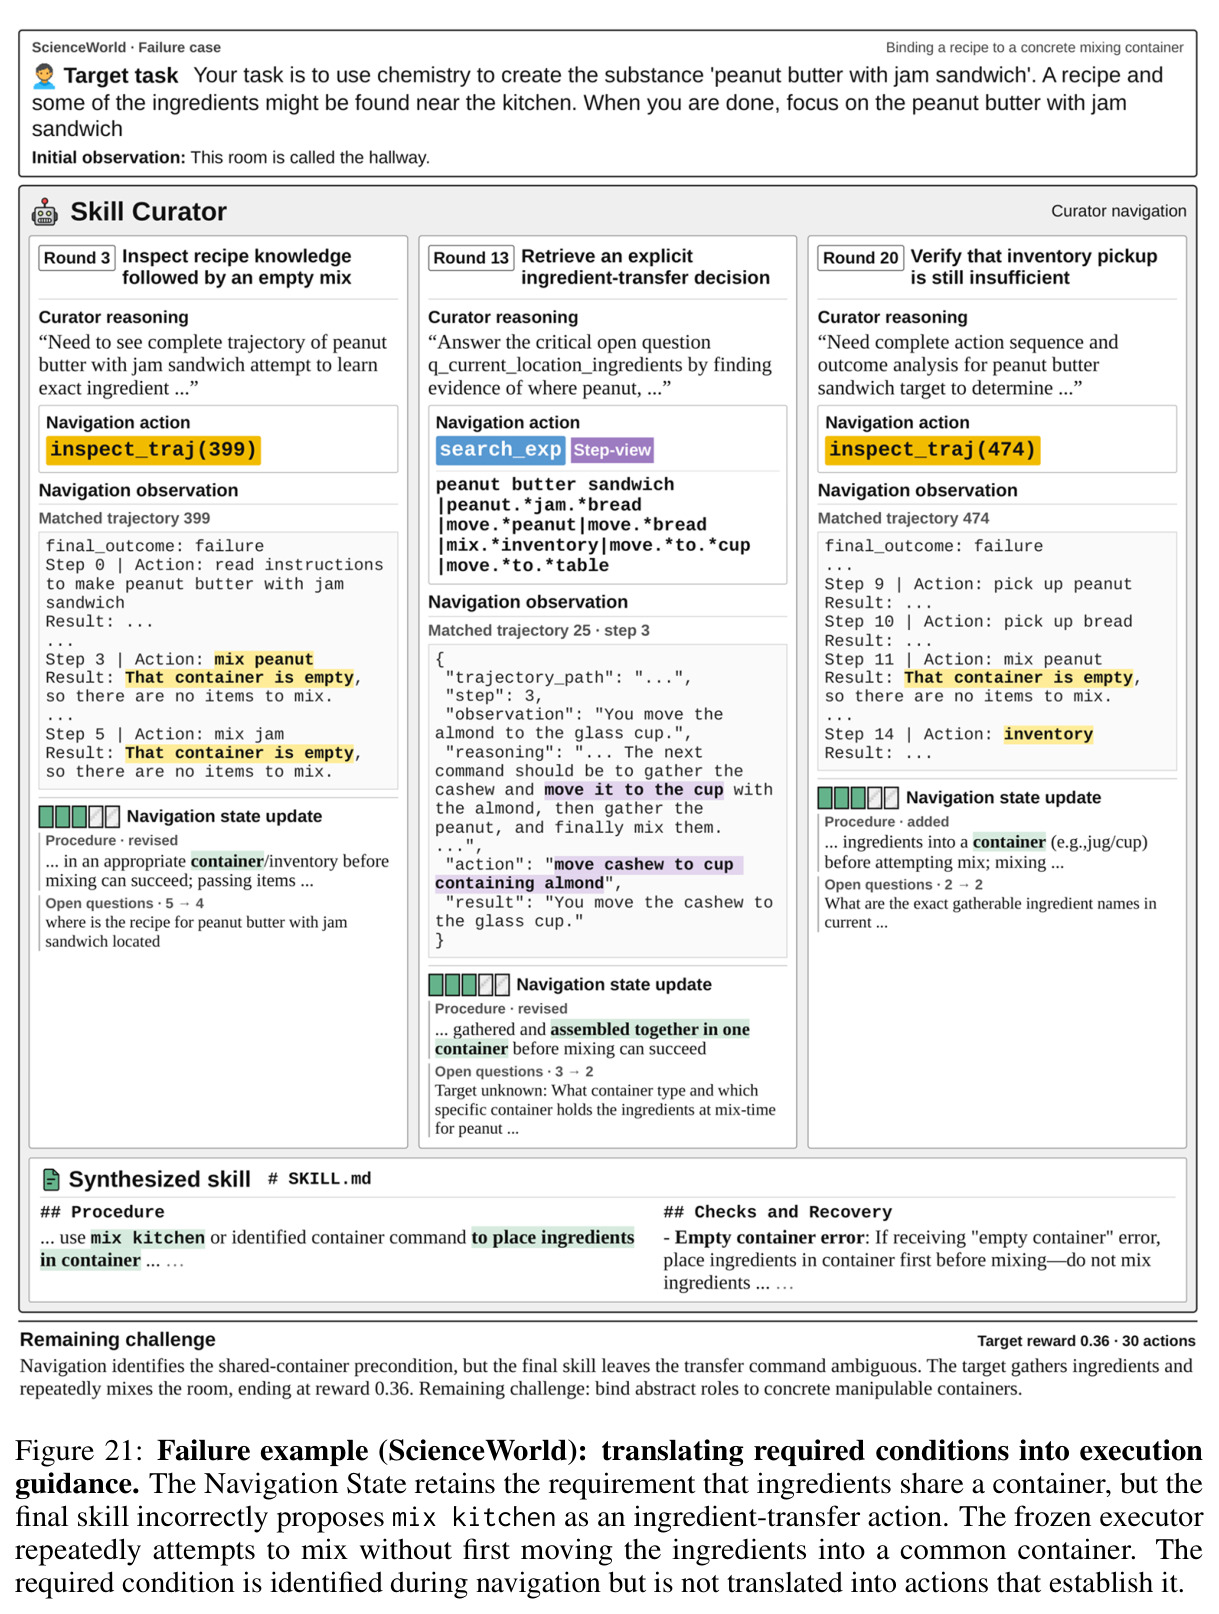
花生酱果酱三明治任务:导航正确识别「食材须共容器」前提,但技能错误提出 mix kitchen 作为转移手段,executor 反复混合而未先转移食材。
失败案例 3:识别前提不等于能给出建立前提的动作序列,指出合成器的翻译缺口。