测试时记忆进化(TTME):科学发现中替代测试时训练的高效方法 Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
TTME以自进化外部记忆替代测试时训练,五个数学任务全面胜出且计算成本降82.8–84.6%
前置知识
测试时训练(Test-Time Training, TTT)
指在推理阶段对模型做在线训练的范式:TTT-Discover、ThetaEvolve 让 LLM 在迭代搜索中生成候选程序,把每次评估的成功与失败当作强化学习数据,用 LoRA 等参数高效方法持续更新权重,使模型逐步内化本次搜索的经验,从而指导后续候选的生成。
本文的全部动机与实验都围绕「TTT 是否必要」展开,理解它的流程与开销才能读懂 TTME 的对照实验设计。
进化式程序搜索(FunSearch/AlphaEvolve 范式)
把科学发现建模为程序进化:维护一个候选程序档案,每步从档案选父代程序,让 LLM 修改或重写生成新候选,执行并用任务验证器打分,再按分数更新档案。FunSearch、AlphaEvolve、TTT-Discover、ThetaEvolve 都属于这一范式,区别只在父代选择与档案更新规则。
TTME 不改动这套搜索机制,只增强生成时的上下文;理解父代-候选循环是理解方法定位的前提。
PUCT 与 MAP-Elites
两种父代选择策略。PUCT 源自 AlphaZero 的树搜索,按价值加探索奖励选节点,TTT-Discover 用它从复用缓冲区每步选 8 个父代;MAP-Elites 按行为特征维持多样化精英档案,ThetaEvolve 用 10 个岛屿、10000 容量的档案鼓励探索不同区域。
论文声明完全保留框架原有的父代选择规则,这两种算法决定了算力如何分配,是读懂实验设置的基础。
LoRA 与在线强化学习
LoRA 在冻结的原权重旁挂一对低秩矩阵,只训练极小部分参数。TTT-Discover 用 rank 32 的 LoRA 做测试时 RL,并指数级上调高奖励样本的权重。即便如此,训练仍引入大量前向与反向传播的额外 FLOPs,这是 TTT 昂贵的根源。
理解 TTT 的成本来源(Table 3 中 26–33 EFLOPs)才能体会 TTME 冻结权重后省 82.8–84.6% 算力的意义。
Jaccard 相似度
两个集合交集与并集大小之比 $J(A,B)=|A\cap B|/|A\cup B|$,取值 0 到 1。TTME 用它判断新旧教训是否重复:把教训转成小写词集合,相似度不低于 0.5 视为同一条教训,保留旧文本、重现计数加一并刷新确认步数,否则作为新条目入记忆。
这是 Guideline Memory 去重合并的核心机制,决定记忆不会被重复内容塞满、能长期保持精炼。
自相关不等式与 Erdős 最小重叠问题
论文的评测任务:AC1–AC3 构造函数 $f$,优化 $\|f*f\|_\infty/\|f\|_1^2$ 等比值以收紧自相关常数的上下界;Erdős 问题构造 $[-1,1]$ 上积分为 1 的密度 $h$,最小化它与补函数的最大平移重叠;Hadamard 求 29×29 ±1 矩阵的最大归一化行列式。
读懂任务定义与分数方向(哪个方向更好)是理解正文与附录所有结果表格的前提。
研究动机
让开源权重 LLM 在科学发现任务上超越基于前沿闭源模型的推理系统,是 TTT-Discover、ThetaEvolve 等测试时训练(TTT)框架的核心卖点:模型在迭代搜索中生成候选程序,用评估反馈做在线强化学习,把搜索经验内化进权重。但这条路线的计算代价很高。以 TTT-Discover 配 Qwen3-8B 为例,即使只更新 rank 32 的 LoRA 参数,单任务也需要约 11.7–12.7 小时的训练加推理时间、26.2–33.1 EFLOPs 的计算量(论文 Table 3),且权重更新必须贯穿整个发现过程。这意味着想把 TTT 扩展到更大的模型(如 120B 以上)或更复杂的发现任务时,在线训练开销会成为主要瓶颈,甚至完全不可行。
本文的目标是作者提出的核心问题是:在完全相同的发现框架下,能否找到一种比测试时训练更高效、性能还更好的测试时适应方法?他们的假设是:当前 LLM 已经具备广博的基础知识、推理与编程能力,缺的不是新知识,而是把本次搜索中积累的经验及时组织起来供后续步骤使用;因此持续蒸馏并整理外部记忆,可能足以替代昂贵的权重更新。据此论文提出 TTME(Test-Time Memory Evolution)——一个即插即用的自进化记忆系统:模型权重全程冻结,仅通过更新外部记忆引导后续候选生成,并在两个 TTT 框架的五个数学构造任务上与 TTT 做严格的一对一对照。
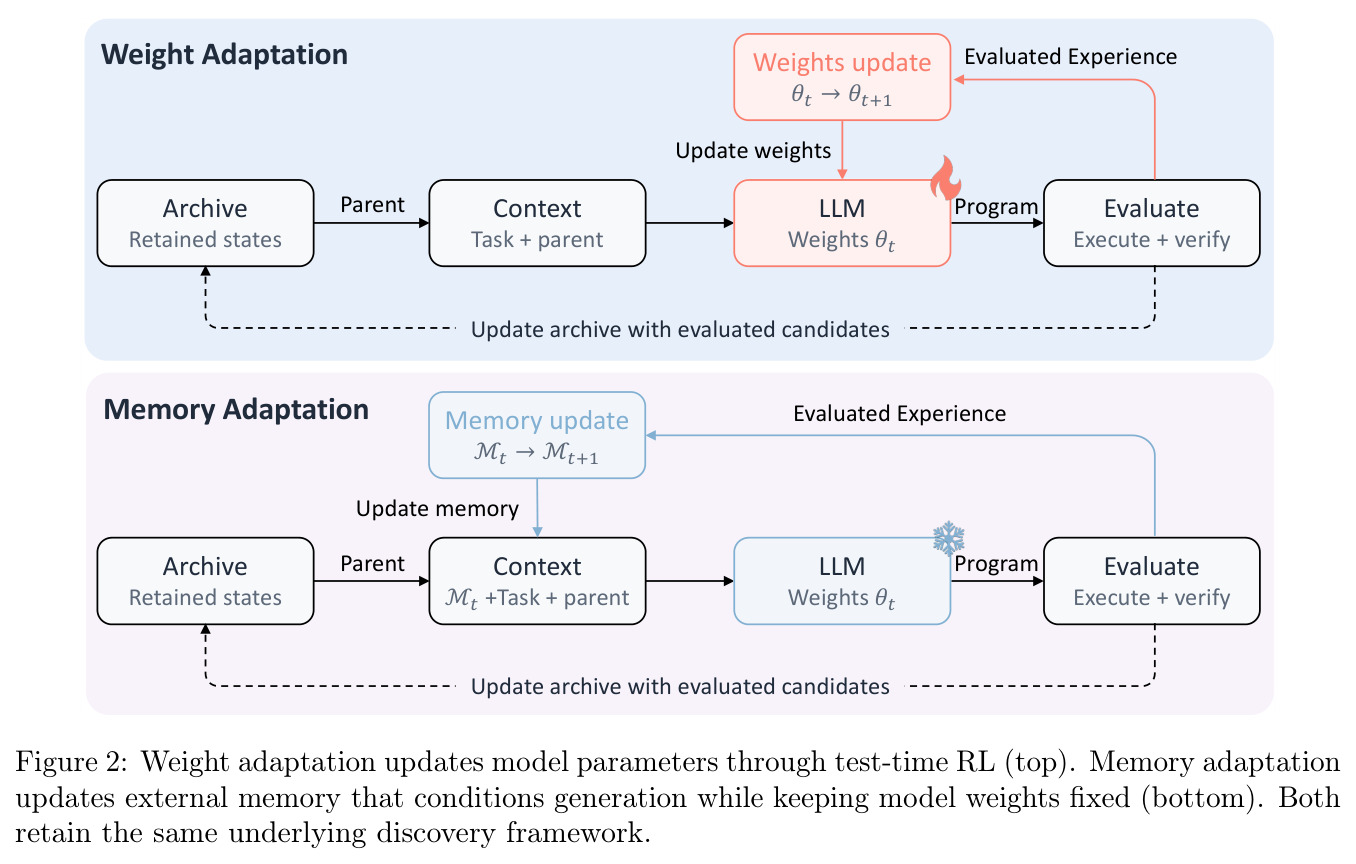
与已有工作不同的是,本文的独特之处在于把「适应机制」本身抽象成可替换模块,做了一场控制变量的对比实验。已有的非参数方法(FunSearch、AlphaEvolve 等)把执行反馈用于搜索策略与算子设计,改进的是搜索组织方式,并没有把经验积累当作独立的适应机制来研究;已有的参数方法(TTT-Discover、ThetaEvolve)则把经验内化进权重。TTME 的切入角度是:保留底层框架的父代选择、档案更新规则与任务验证器,只把权重更新 $\theta_{t+1}\leftarrow\mathcal{U}_{RL}(\theta_t,D_t)$ 换成记忆更新 $M_{t+1}\leftarrow\mathcal{U}_{mem}(M_t,D_t)$($\theta_t\equiv\theta_0$),从而首次系统地回答「进化外部记忆能否胜过进化权重」。
核心方法
TTME 的直觉是:一次搜索经历里其实包含两类截然不同的知识——「怎么把候选程序写对、跑通」的操作教训,以及「什么想法能真正提升分数」的算法思路——把它们分别存进两份互补的外部记忆,就能在不改权重的前提下持续改进生成质量。技术路线是:Guideline Memory 存操作教训,每条形如「触发条件 → 机制 → 具体动作」;Strategy Memory 存算法策略,把来自不同成功修改的经验笔记按底层思想聚成策略族。搜索时框架照常选父代,TTME 先为每个父代从策略库中选策略并改写成针对该父代的修改指令,再以 $\alpha=1/2$ 的比例把候选预算分给「直接生成」与「策略引导生成」两条分支;每 $K=2$ 步用最新评估结果更新两份记忆。整个过程在 TTT-Discover 与 ThetaEvolve 上原样运行,唯一区别是把 TTT 换成 TTME。
核心创新是把「测试时适应」从参数空间搬到外部记忆空间:权重适应写为 $\theta_{t+1}\leftarrow\mathcal{U}_{RL}(\theta_t,D_t)$,记忆适应写为 $M_{t+1}\leftarrow\mathcal{U}_{mem}(M_t,D_t)$ 且 $\theta_t=\theta_0$。与以往把反馈临时塞进提示词的做法不同,TTME 对经验做了结构化组织:Guideline Memory 用 Jaccard 相似度(阈值 0.5)合并重复教训、按重现次数排序并保留至多 24 条、20 步未再确认即过期;Strategy Memory 不只记录「哪个修改有效」,而是把共享同一底层思想的不同实现归入一个策略族,条目写明机制、各种执行模式、适用条件与可改写部分。这样策略可以被选择、改编并跨搜索分支组合复用,而不是一次性消费的历史日志。
方法步骤详情
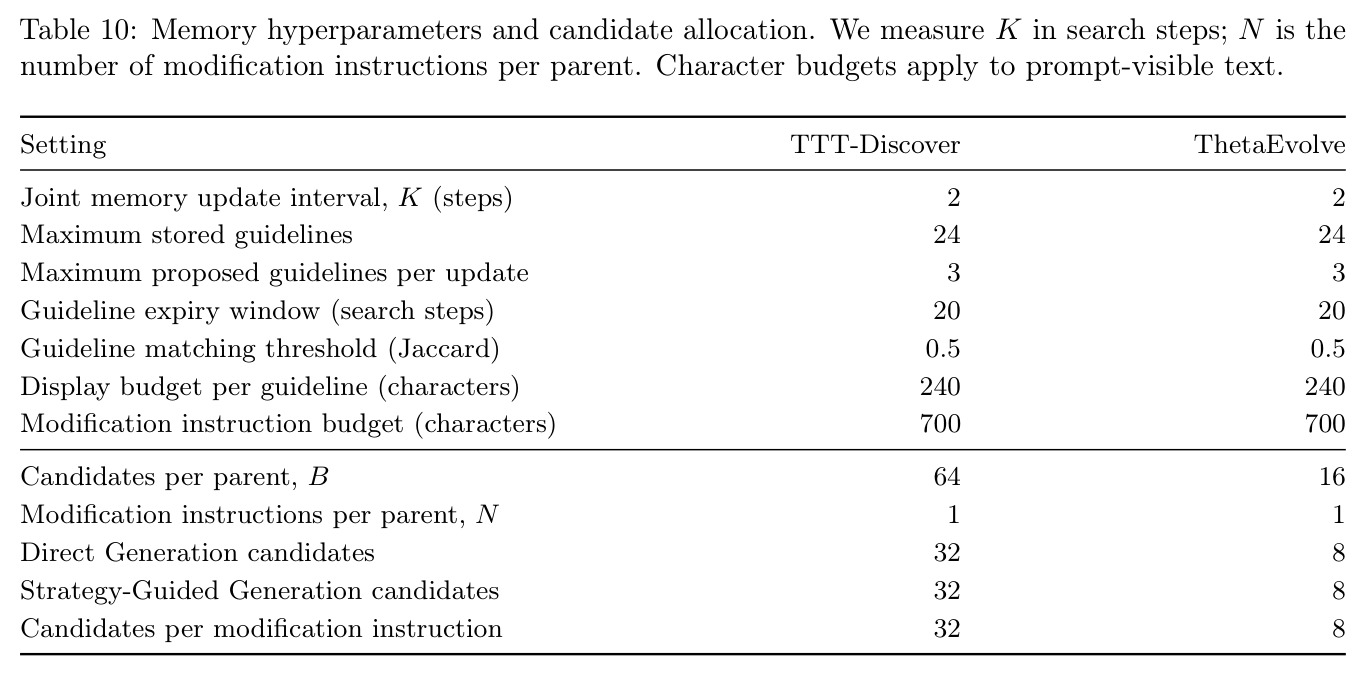
完整流程见 Algorithm 1。第 1 步:底层框架按自身规则选父代——TTT-Discover 用 PUCT 每步选 8 个,ThetaEvolve 用带岛屿的 MAP-Elites 每步选 32 个。第 2 步:选择器(同一基座模型)按 $a_i^{(t)}=\mathrm{Select}(C_i^{(t)},\hat{S}_t,A_{<i}^{(t)})$ 依次为每个父代从策略摘要中最多选 $N=1$ 个策略,避免与同一步其他父代重复。第 3 步:改编器读取策略完整条目与父代代码,生成不超过 700 字符的父代特定修改指令 $d_i^{(t)}$;无合适策略则提出新想法。第 4 步:生成候选——直接生成分支产 $\alpha B$ 个,策略引导分支每条指令产 $(1-\alpha)B/N$ 个(TTT-Discover $B=64$ 即 32+32,ThetaEvolve $B=16$ 即 8+8),提示都附带 Guideline Memory。第 5 步:执行验证候选,记录有效性、分数与反馈,按框架规则更新档案。第 6 步:每 $K=2$ 步,用结果摘要蒸馏至多 3 条新教训并入 Guideline Memory,再从「子代有效且优于父代」的案例抽取经验笔记、聚族更新 Strategy Memory。
技术新颖性
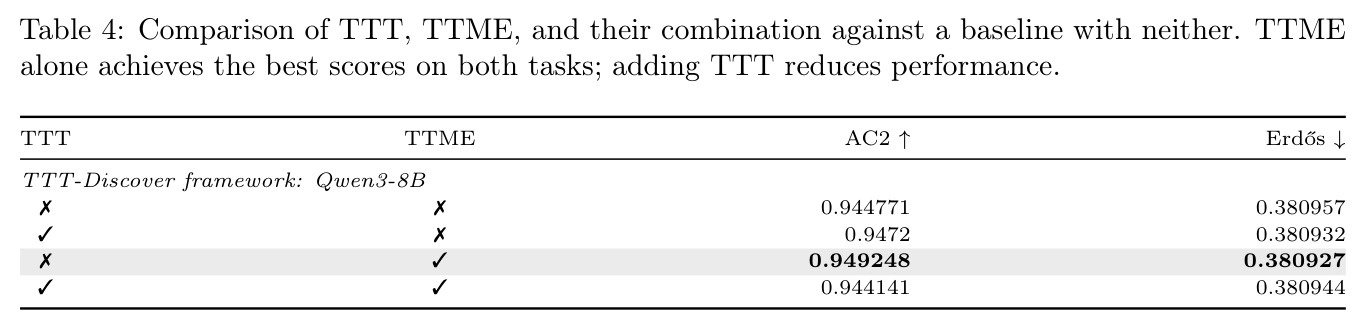
技术新颖性体现在三点。其一,模块化:TTME 不发明新搜索算法,只替换适应机制,框架的父代选择与档案更新规则原封不动,使结论可干净归因于适应方式本身。其二,记忆结构设计:把经验分为操作教训与算法思想两类分别维护,尤其是策略族把「同一思想的多种实现方式」连同适用条件一起保存,使记忆可复用、可改编、可组合,而非扁平历史日志。其三,实证层面首次给出「记忆 vs 权重」的同框架对照,并证明叠加 TTT 反而拖累 TTME(Table 4:AC2 从 0.949248 跌到 0.944141),说明两者是替代而非互补关系,这挑战了「科学发现必须在线更新权重」的默认认知;同时报告了包含全部记忆调用在内的 82.8–84.6% FLOPs 节省。
实验结果
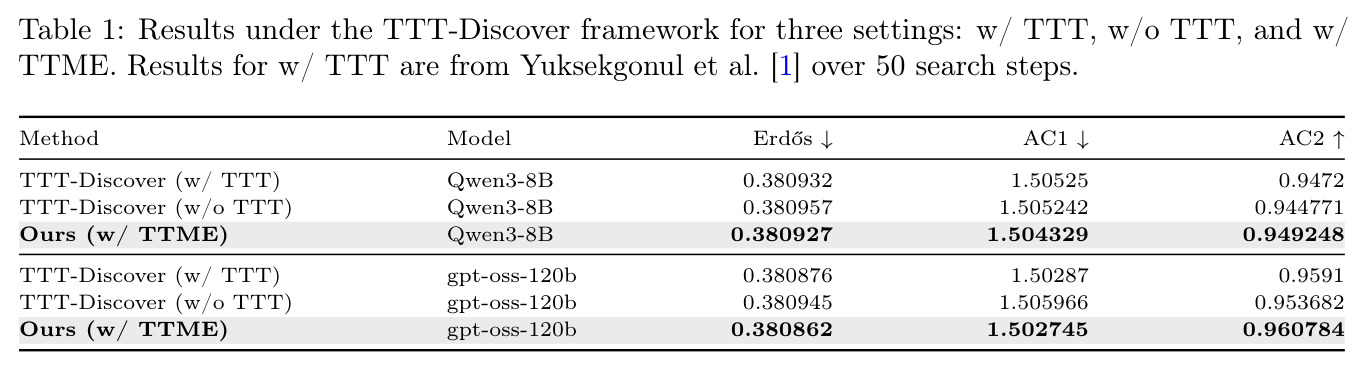
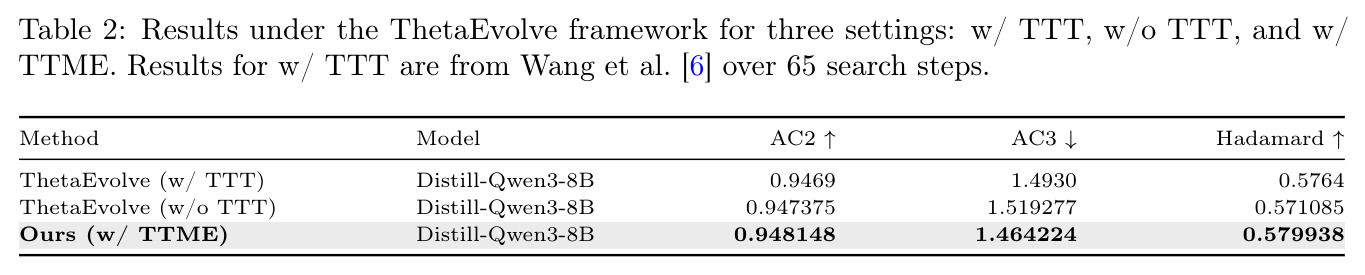
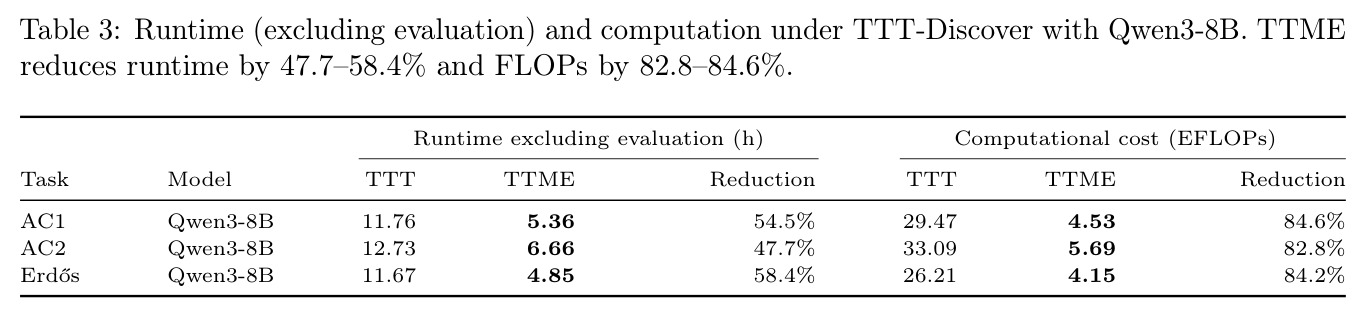
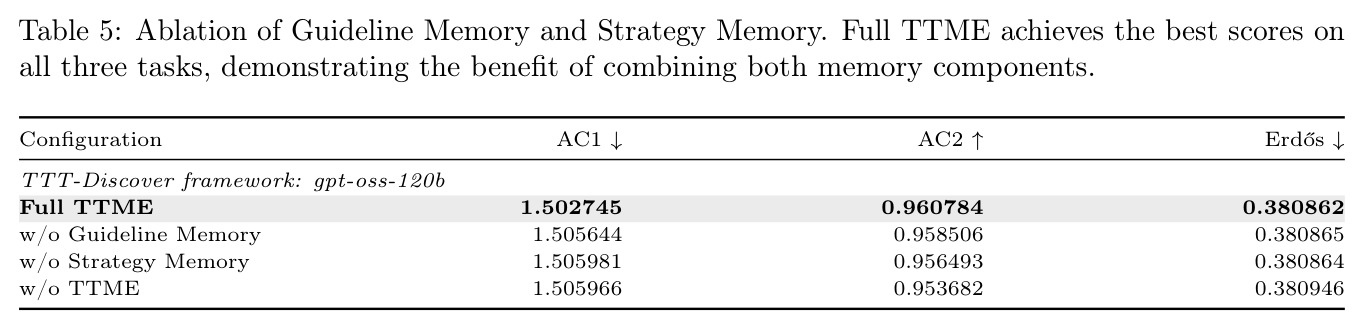
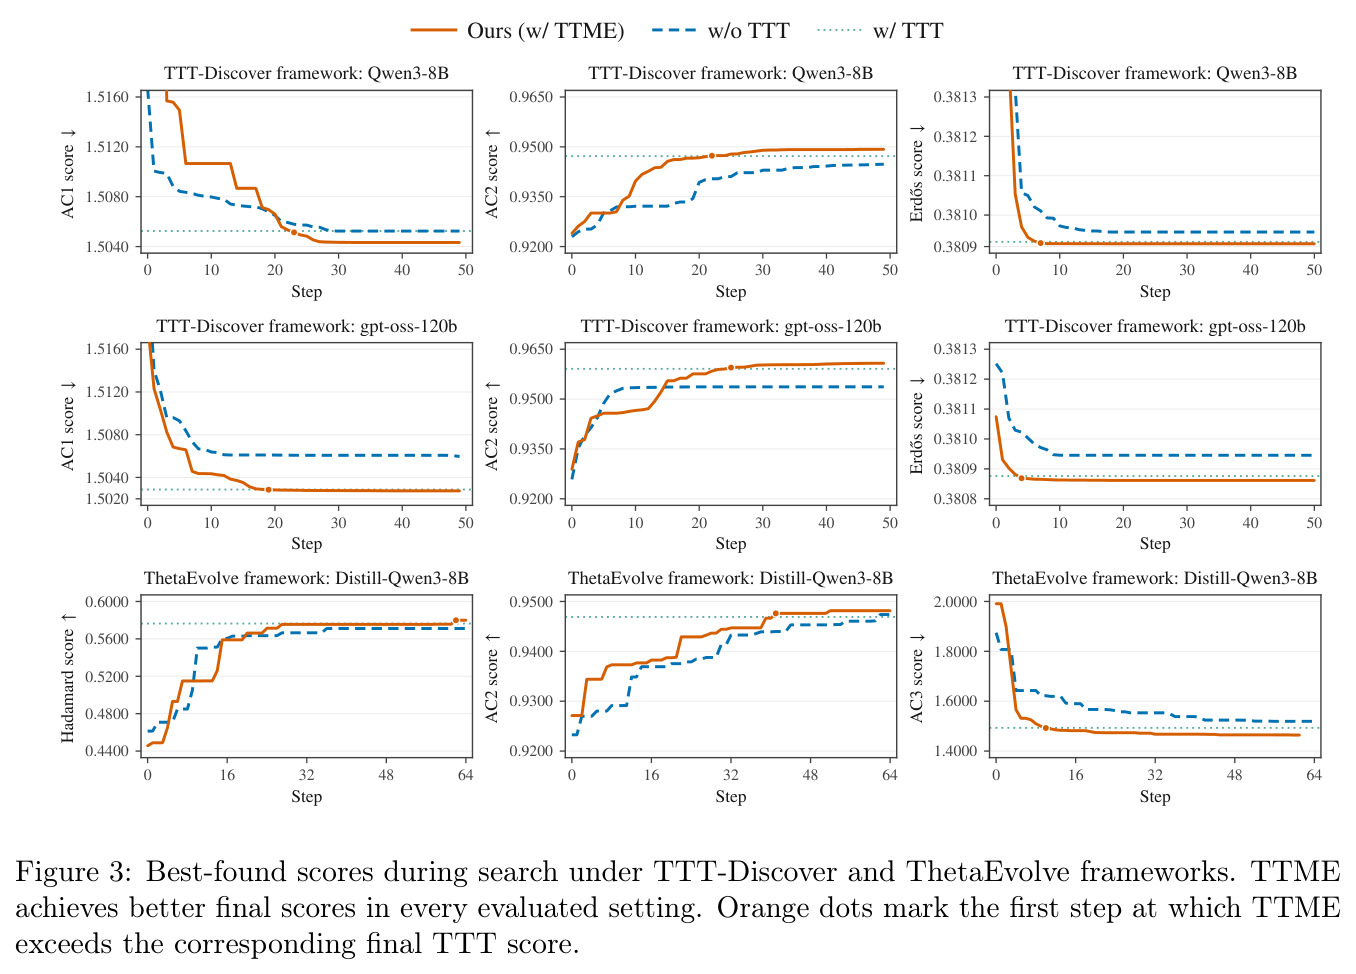
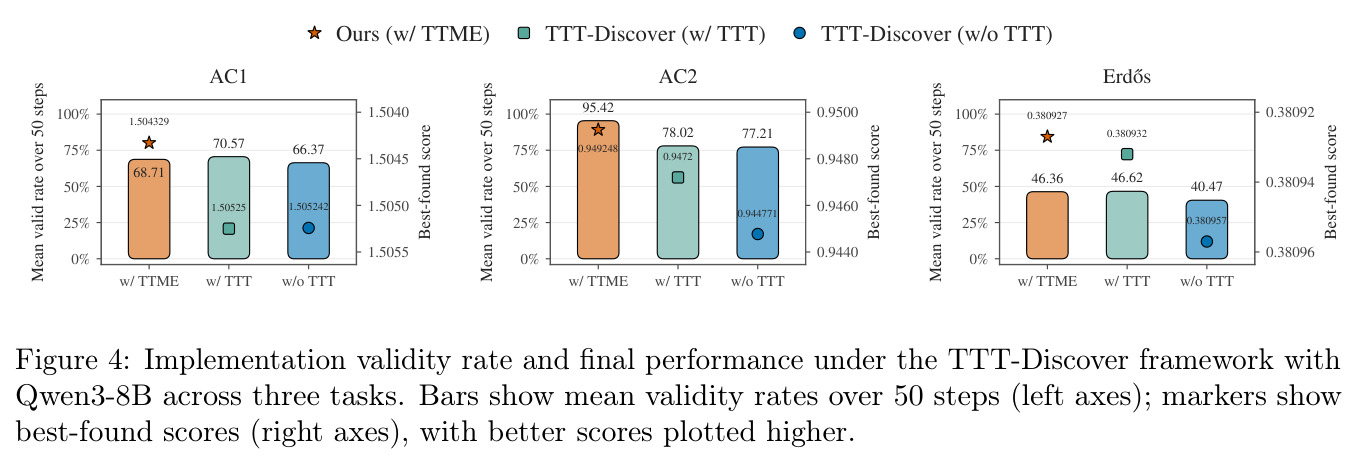
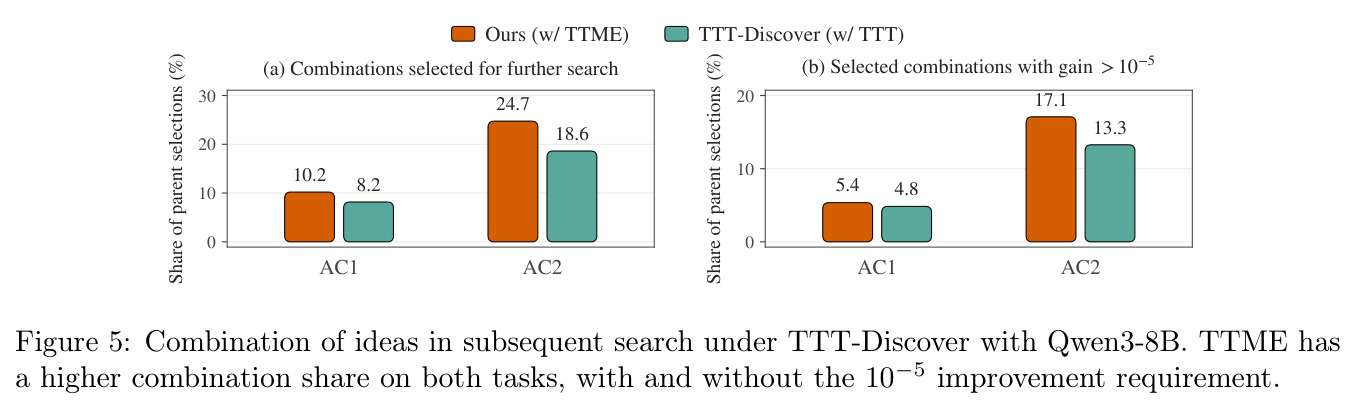
在两个框架、三个模型、五个任务上 TTME 全部胜过 TTT(Tables 1–2)。TTT-Discover 框架 Qwen3-8B:AC1 从 TTT 的 1.50525 降到 1.504329,AC2 从 0.9472 升到 0.949248,Erdős 从 0.380932 降到 0.380927;gpt-oss-120b 三任务为 1.502745、0.960784、0.380862,均优于 TTT。ThetaEvolve 框架:AC2 0.948148、AC3 1.464224、Hadamard 0.579938,对 TTT 的 0.9469、1.4930、0.5764。效率上(Table 3,含全部记忆调用):AC1 运行时间 11.76h→5.36h(省 54.5%)、29.47→4.53 EFLOPs(省 84.6%);AC2 12.73h→6.66h(47.7%)、33.09→5.69(82.8%);Erdős 11.67h→4.85h(58.4%)、26.21→4.15(84.2%)。Fig. 3 显示 TTME 在全部 TTT-Discover 任务上 25 步内即超过 TTT 跑满 50 步的最终分数。消融(Table 5)表明去掉任一记忆组件都变差。Fig. 4:两者都提升编译有效率(Erdős 约 46.4%/46.6% 对基线约 40.5%),但 TTME 分数更高,优势来自想法质量;Fig. 5:TTME 更频繁组合跨分支想法(AC2 24.7% 对 18.6%,要求增益大于 $10^{-5}$ 时为 17.1% 对 13.3%)。
局限与改进
作者承认评估范围限于五个拥有廉价可执行验证器的数学构造任务,每任务只有一个分数指标。我的补充观察:其一,绝对提升极小——Erdős 上 0.380927 对 0.380932 的差距在第 5–6 位小数,且未做多种子显著性检验(ThetaEvolve 原文用 42/1234/3407 三个种子,本文对照只用 3407),差异可能部分来自运行间方差。其二,运行时间对比剔除了评估环节,TTME 的记忆操作也额外增加了 LLM 请求数与延迟。其三,任务全部是可自动打分的程序搜索,对缺乏廉价验证器的假设驱动科学问题是否适用未经验证。其四,记忆容量存在硬限制(至多 24 条教训、策略摘要至多 400 字符),在更长搜索预算或更复杂领域中可能成为瓶颈;超参 $K=2$、$\alpha=1/2$、$N=1$ 的敏感性也未系统探索。
独立分析的弱点
独立分析几个弱点。第一,统计严谨性:所有对比基本都是单次运行的最好分数,而这类进化搜索方差很大,第 5 位小数级别的「胜出」很可能落在种子噪声之内;改进方向是为每个设置跑 3 个以上种子并报告分数分布而非单点。第二,记忆操作完全依赖同一个 8B 基座模型自我蒸馏,小模型在抽取算法思想、合并策略族时可能产生幻觉或遗漏关键细节;可引入更强的模型定期审计记忆,或用后续执行结果回验策略有效性并淘汰无效条目。第三,策略选择基于至多 400 字符的文字摘要而非语义检索,当策略族数量增长后选择质量会退化;可换成嵌入检索加重排序的两阶段方案。第四,TTT+TTME 组合反而显著变差(AC2 从 0.949248 降到 0.944141),作者只呈现现象未解释机制;值得研究 RL 更新导致的输出分布漂移如何破坏记忆与生成之间的一致性。
未来方向
作者方向上,TTME 最大的卖点是省算力,最自然的延伸是把记忆进化扩展到 120B 以上模型或更长的搜索预算——这些场景里 TTT 的在线训练开销难以承受,而 TTME 的成本几乎只随生成线性增长。基于成果还可以延伸:其一,跨任务持久记忆,让策略库在多个相关问题上复用,沉淀成真正的「科学经验库」并研究遗忘与冲突消解;其二,把 TTME 迁移到有真实验证器的工程与科学领域,如芯片设计、CUDA 核优化、实验方案设计;其三,理论层面刻画外部记忆适应与参数适应在样本效率、容量、遗忘特性上的差异,并解释两者组合为何反而变差;其四,多模型协作——用大模型蒸馏高质量策略、小模型执行大规模生成,进一步压低成本;其五,扩展记忆类型学,如失败模式库、数据结构模板库,并让容量上限与过期窗口随任务复杂度自适应。
复现评估
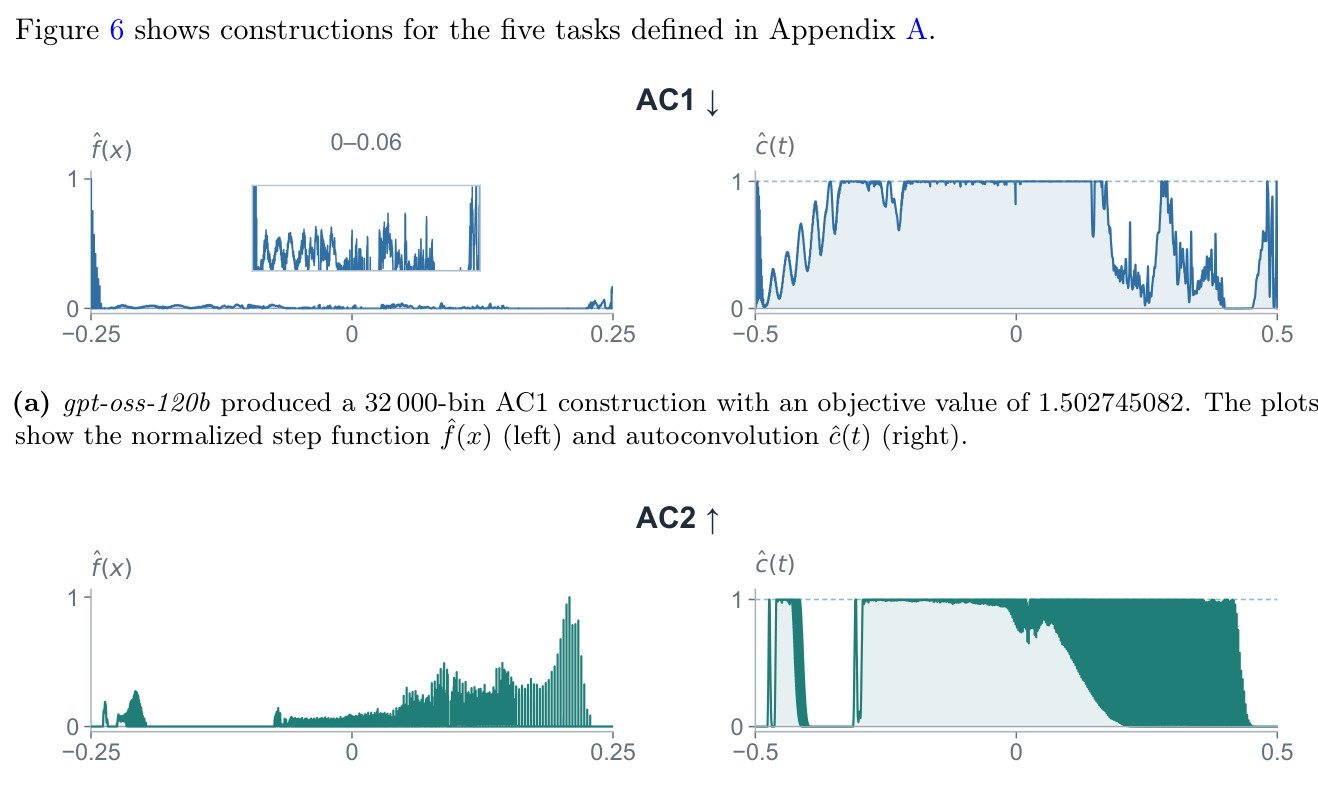
复现条件较好。代码已在 GitHub 开源(yepengliu/TTME),并基于公开的 TTT-Discover(commit 6c40e82d)与 ThetaEvolve(commit 7c12898f)代码库构建;三个模型全部开放权重(Qwen3-8B、gpt-oss-120b、DeepSeek-R1-0528-Qwen3-8B)。附录给出完整超参数($K=2$、至多 24 条教训、每次至多提议 3 条、20 步过期窗口、Jaccard 阈值 0.5、每条教训显示 240 字符、修改指令预算 700 字符、$\alpha=1/2$、$N=1$)以及五个记忆操作的提示词模板和真实示例输出,附录 E 还展示了各任务发现的构造。算力需求中等:TTME 单任务约 5–7 小时、约 4–6 EFLOPs,用 vLLM 以 32k 上下文生成约 2.5 万个候选;程序评估便宜(每个至多约 1000 秒)。总体难度中上,主要成本在 GPU 推理而非训练,单卡或小集群即可尝试较小规模复现。
论文图表
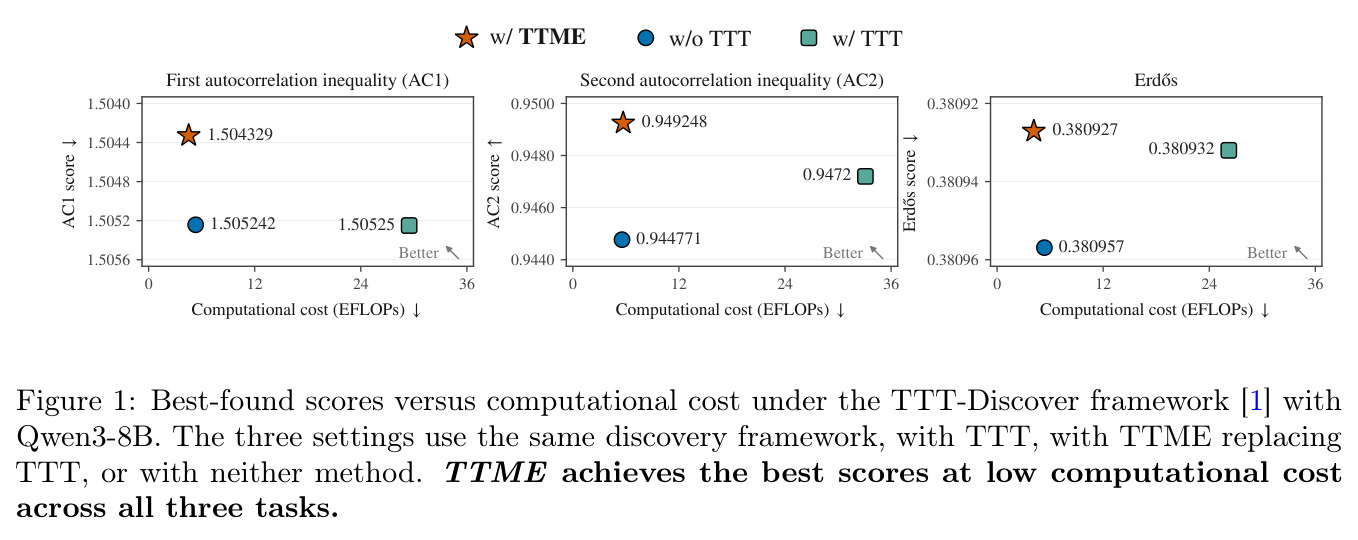
在 AC1、AC2、Erdős 三个任务上对比 w/ TTME、w/o TTT、w/ TTT 三种设置的最佳分数随计算成本(EFLOPs)的变化曲线。TTME 以最低的成本达到最好的分数:例如 AC1 在约 4.5 EFLOPs 处达到 1.504329,而 TTT 花费约 29 EFLOPs 也只到 1.50525(数值越低越好)。
一图概括论文核心卖点——性能与算力双赢,是对标题问题「记忆进化能否超越测试时训练」最直观的答案。