TWIG:每个权重都是一条共享离散决策的路径 Every Weight Is a Path of Shared Discrete Decisions
把每个权重写成树上共享离散决策的乘积,统一模型压缩、加法器电路与离散优化三种视角
前置知识
量化与组缩放 (Quantization & Group Scales)
把训练得到的浮点权重映射到有限的离散取值集合(网格)上存储,例如每个权重只用3或4比特。为保持精度,通常让一组权重共享一个缩放因子(group scale):权重只存小整数编码,反量化时乘回缩放因子恢复量级。
本文的核心论断是量化只是状态树上的一种「编辑」(缩小叶字母表),读懂量化才能理解TWIG如何把各种压缩方法统一到同一对象上。
GPTQ 与 Hessian 误差代理
一种后训练量化算法:用校准数据估计层输入的二阶矩 $H$,以 $f_H=\mathrm{tr}(EHE^\top)$ 度量层输出误差($E=W-\hat{W}$),逐列选择量化状态并把已量化列的误差反馈传播到剩余列,从而在输入相关时比逐权重舍入更准。
GPTQ既是本文电路实验的基线,又被作者解读为「零温单遍扫描」的玻尔兹曼机求解器,是被统一框架吸收的代表性方法。
浮点格式与块浮点/微缩放 (FP16/BF16/MX)
浮点数把一个权重拆成符号、指数、尾数三段决策的乘积,如 $w=(-1)^s 2^{e-b}(1+m/2^p)$。块浮点与微缩放(MX)格式让一整块权重共享一个指数;共享微指数(MX6/MX9)与HiFloat4再叠一两级共享的1比特移位。
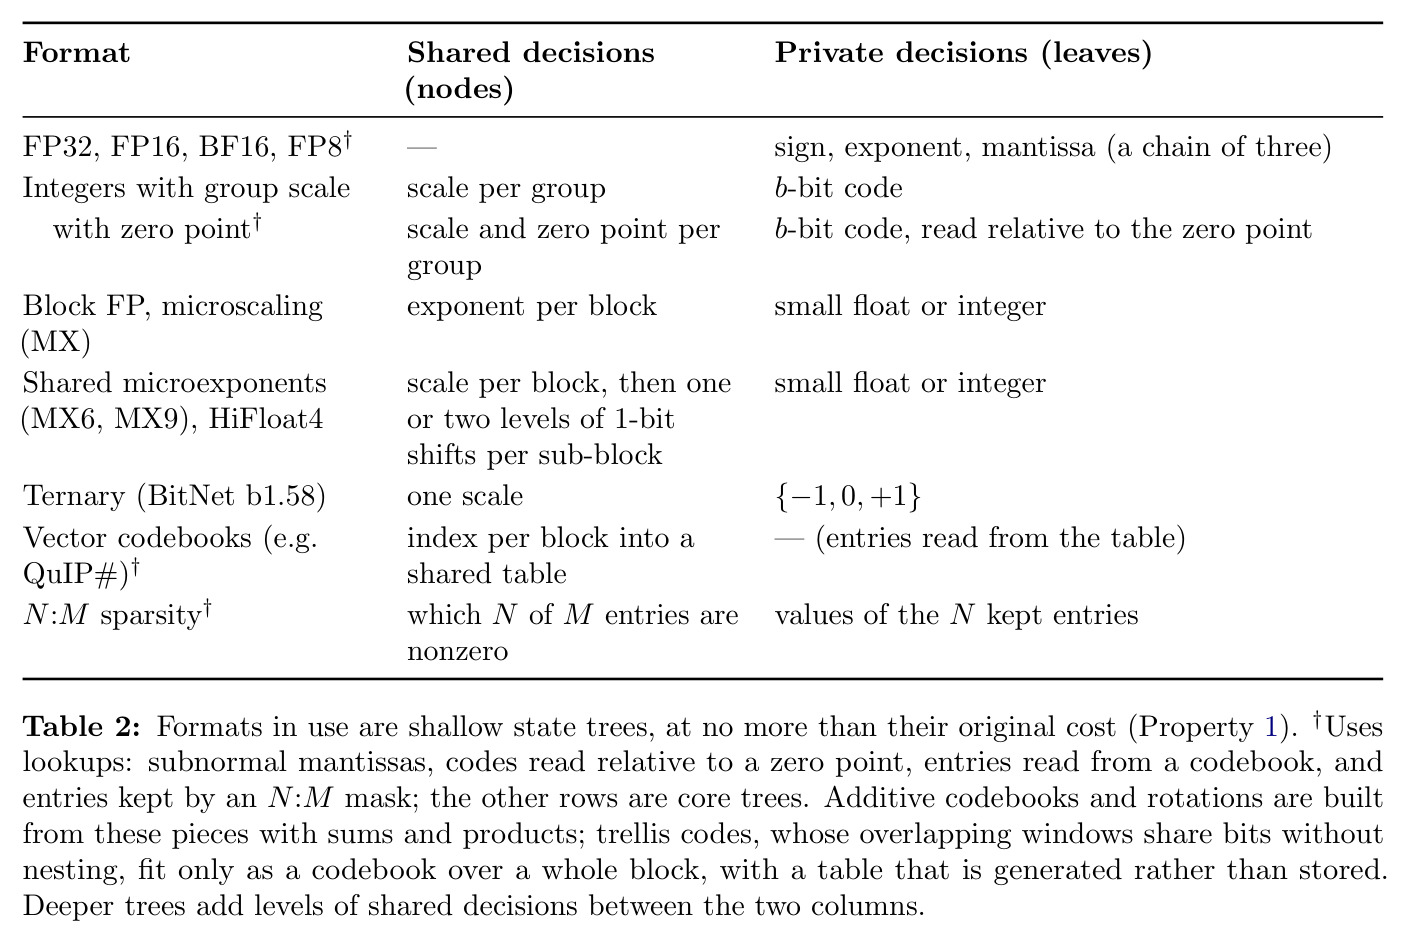
论文证明所有在用格式都是不超过5层的浅状态树(Property 1),这是「TWIG不损失任何现有能力」的关键论证,也是理解Figure 1与Table 2的基础。
QUBO / Ising / 玻尔兹曼机
由 $N$ 个二值单元 $z_p\in\{0,1\}$ 组成的能量模型 $E(z)=\sum_{p<q}J_{pq}z_pz_q+\sum_p h_pz_p$,寻找最低能量配置即QUBO问题;用自旋 $\sigma_p=2z_p-1$ 改写就是Ising模型。模拟退火、量子退火机与QAOA都是为求其基态设计的。
论文证明选择状态树的状态等价于求一个高阶玻尔兹曼机的基态,这把权重选择正式接入离散优化与量子求解器的生态。
移位与加法电路 (Shift-and-Add)
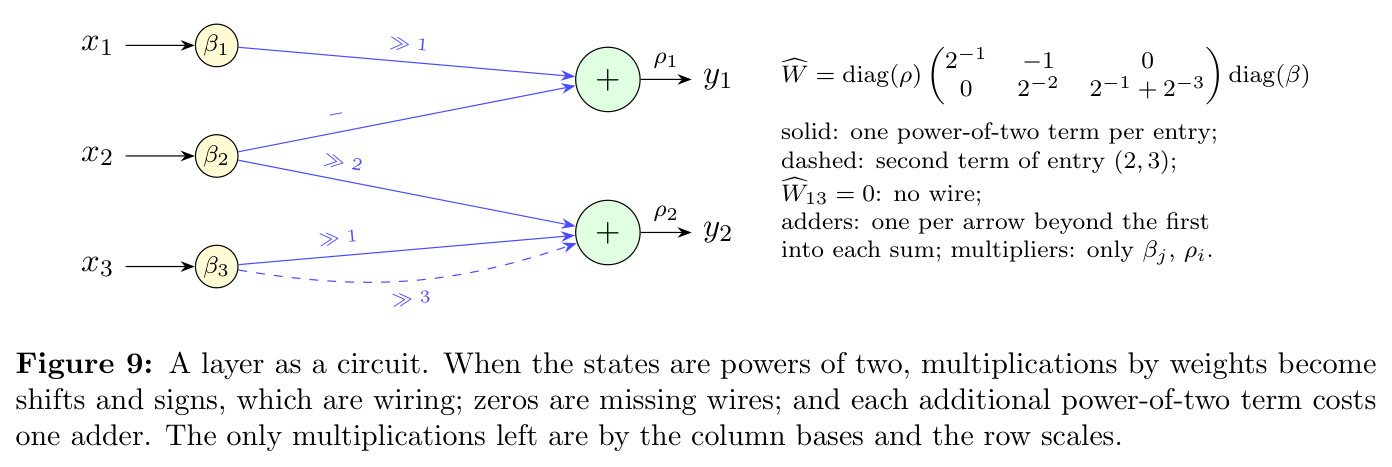
二进制里乘以 $2^k$ 就是移位:在权重固定于制造阶段的电路中,移位只是重新连线(零成本),而通用乘法器的面积和能耗远高于加法器。因此每个非零的2的幂项各需要一个加法器,零项则什么都不占。
这是「电路读法」的基础:当所有状态都是2的幂时,层计算只由连线与加法器构成,加法器数量成为可显式优化的硬件成本。
低秩分解与向量码本
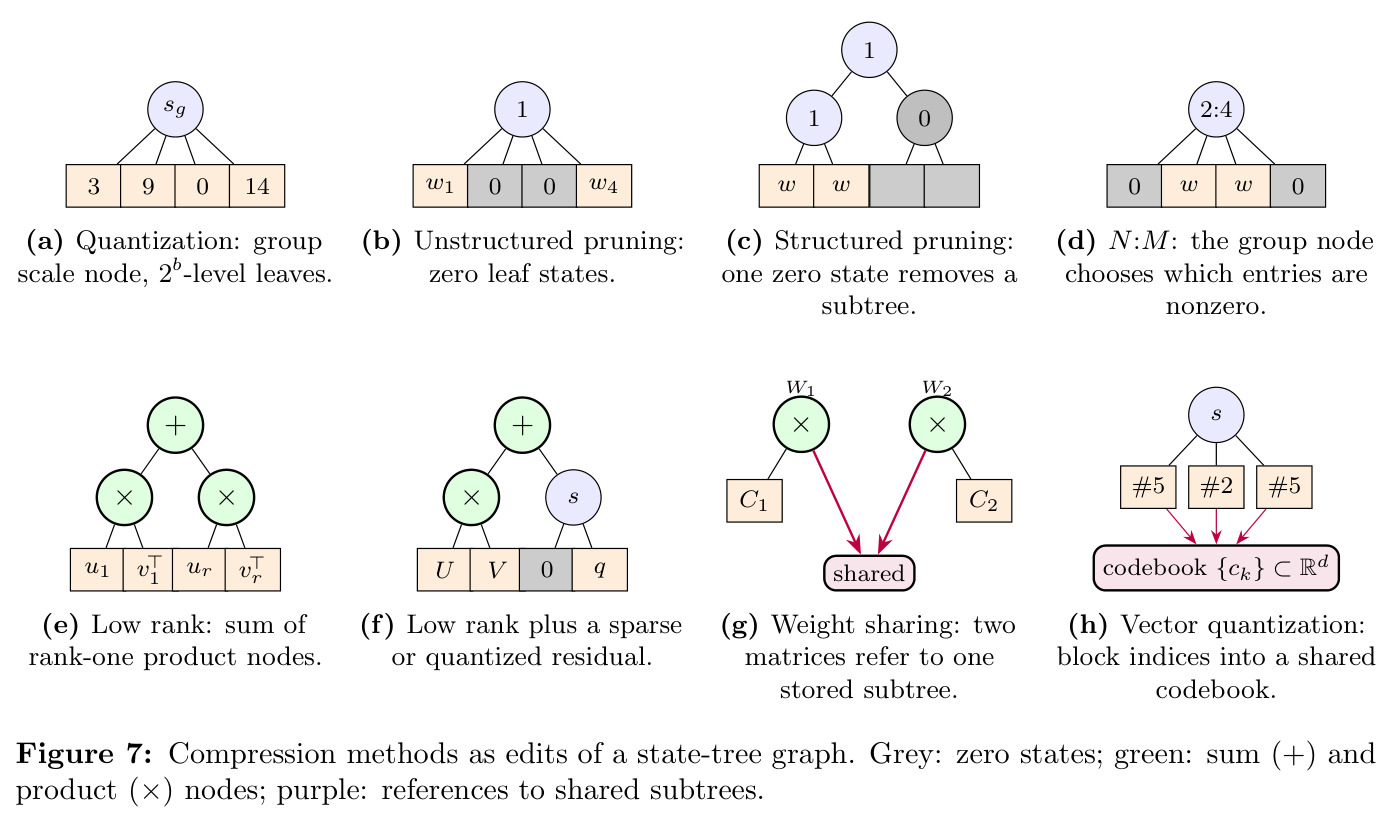
低秩分解把大矩阵 $W$ 换成瘦矩阵乘积 $W\approx UV$;向量码本(如QuIP#)把每 $d$ 个权重换成共享码表中一个向量的索引。两者都是重要的压缩家族,但通常与量化分属不同框架、各有各的求解器。
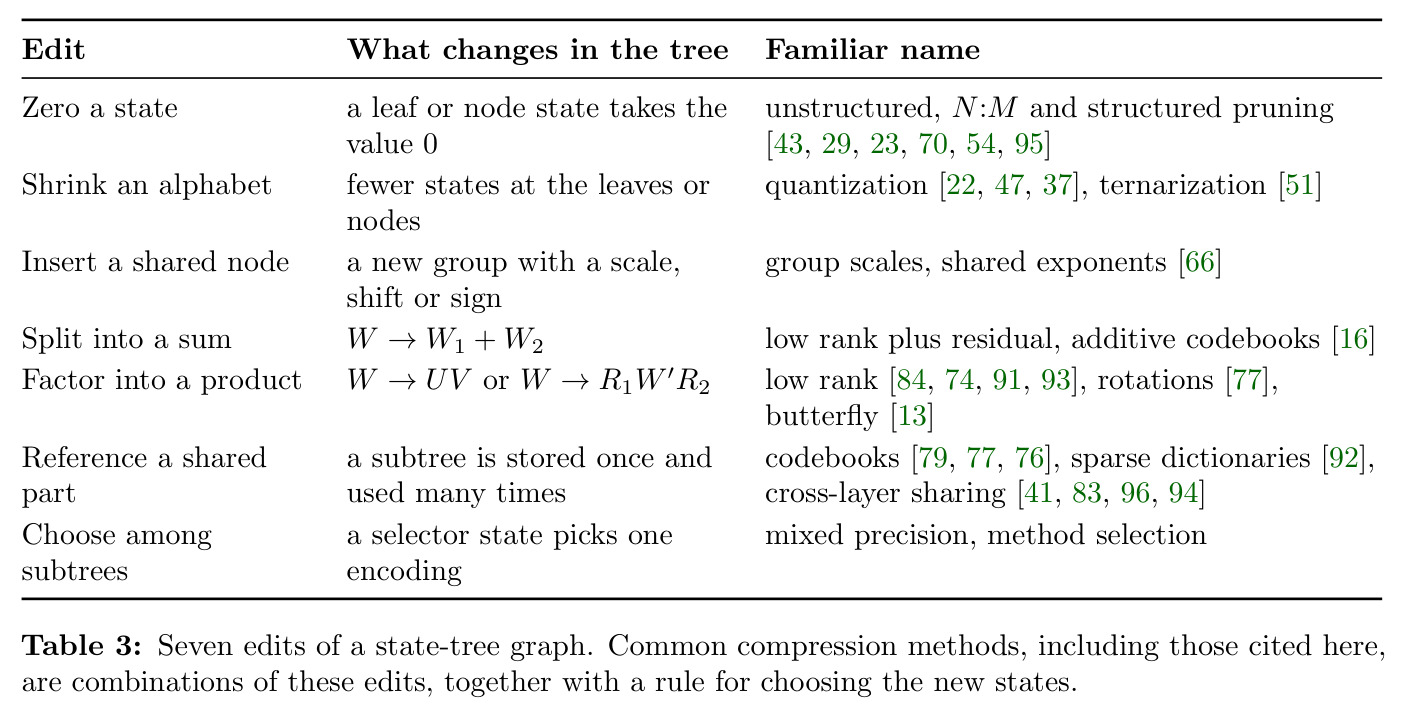
TWIG用「乘积节点」和「引用共享子树」两种操作把低秩与码本也纳入同一棵树,使所有方法可在同一预算优化器下混选与比较。
研究动机
神经网络在连续空间里训练,却必须在离散硬件上运行,而从学习到的连续模型到可执行离散对象的转换已发展成一个碎片化领域:剪枝删除权重、量化限制到有限网格、低秩分解用瘦矩阵乘积替代、码本把权重块映射到共享表项、权重共享跨层复用参数——每个家族都有自己的存储格式、求解器甚至专用kernel,把它们组合起来(例如一层4比特、另一层剪掉一半、第三层加低秩校正)至今主要靠手工设计,缺乏统一标尺。还有两个问题几乎被排除在这一图景之外:其一是计算成本——数字逻辑中乘法器远比加法器大且耗能,而在权重固定于制造阶段的电路(印刷分类器、硬接线整个语言模型的芯片)中,每个权重都需要一个专用常数乘法器;其二是离散优化的覆盖面——选择离散权重本是组合问题,但退火机、采样器与量子优化器这类专为此设计的设备至今只能处理狭窄子问题,例如单层的自适应舍入。
本文的目标是本文的目标是提出一个单一表示,把存储、计算与优化三件事统一到同一个对象上:让每个权重都写成一条小的离散决策路径的终点——一个符号、一次2的幂移位、一个零门、一次共享表索引——并让「属于一起」的权重共享路径的上部,每个决策被其下方所有权重继承,因而只存储一次、只应用一次。作者希望这一表示同时满足:任何已训练网络都能写成它;当决策为2的幂时权重层变成几乎只由连线和加法器构成的电路,适合硬接线芯片;剪枝、量化、低秩分解、码本与共享全部变成对同一对象的编辑,由一个带预算的优化器为整个网络统一选择;而选择决策这一步恰好是高阶玻尔兹曼机的基态问题,可对接经典采样器、退火机与量子优化器。
与已有工作不同的是,作者的独特切入是把一个已经存在的趋势推到极致。实践中格式早已在向「共享决策」演进:组量化让一组权重共享一个缩放,块浮点与微缩放格式共享指数,稀疏格式让权重一确认为零就结束描述,码本用表项描述整块权重,共享微指数和HiFloat4甚至叠了两三层共享尺度——但每种格式只共享一种固定类型的决策,且共享层级事先固定。TWIG则允许在树的任意层级共享任意类型的决策,并证明所有常用格式都是它的浅层特例、不付任何额外代价。更关键的是,TWIG显式给出两本账:存储比特与电路加法数,并揭示二者并不一致(共享移位省比特但不省加法,因为固定电路中移位免费),从而使「为存储优化」与「为电路优化」成为同一表示下可交换的两种目标——这是以往任何单一格式都没有提供的能力。
核心方法
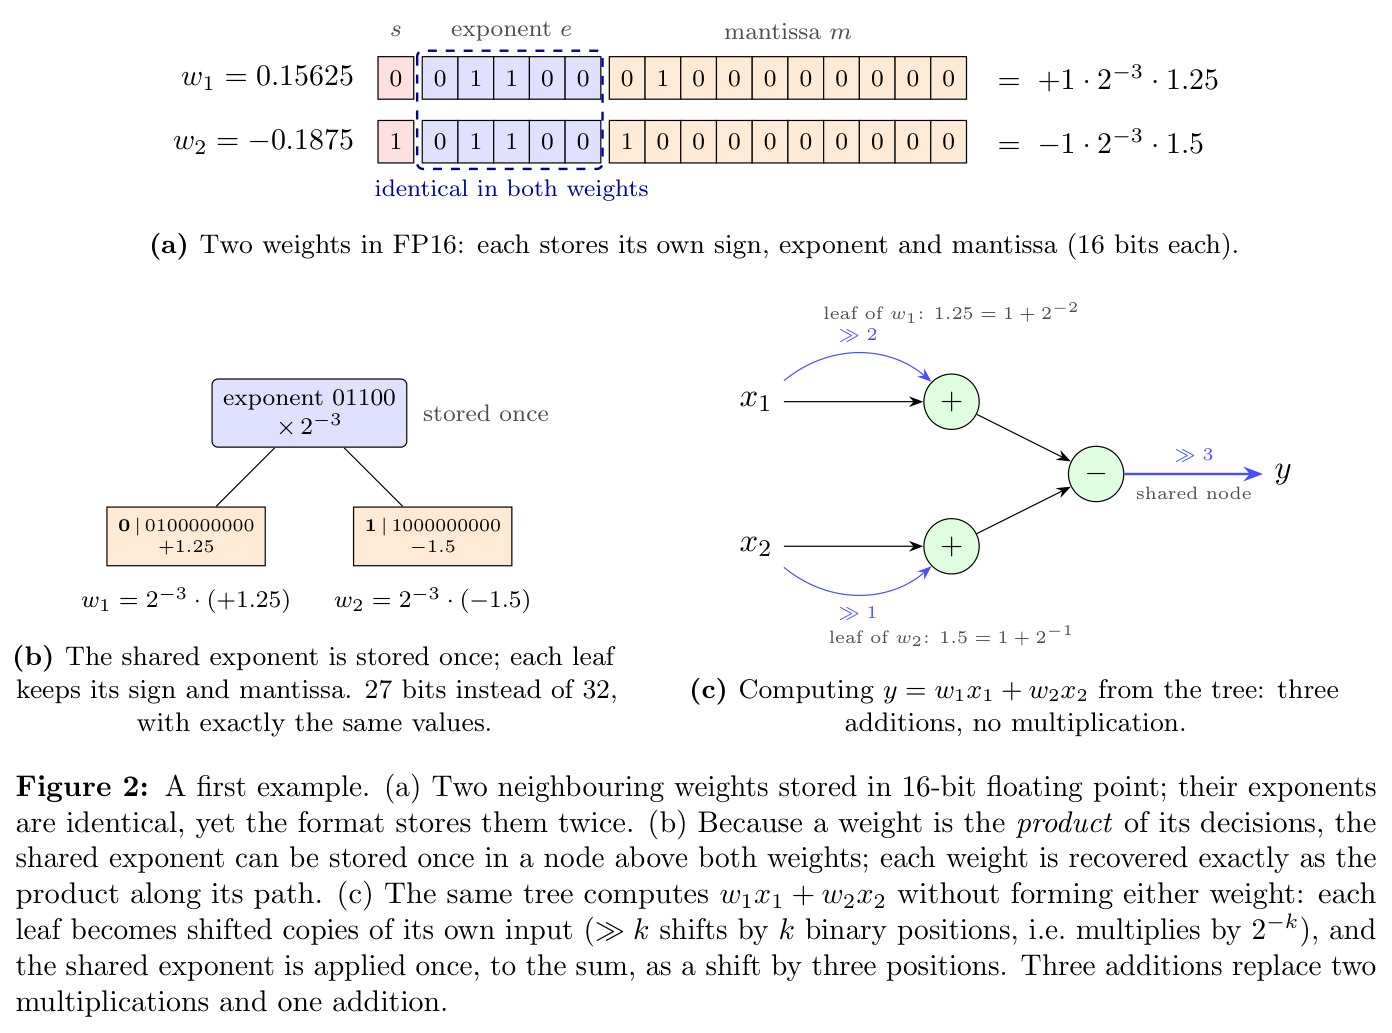
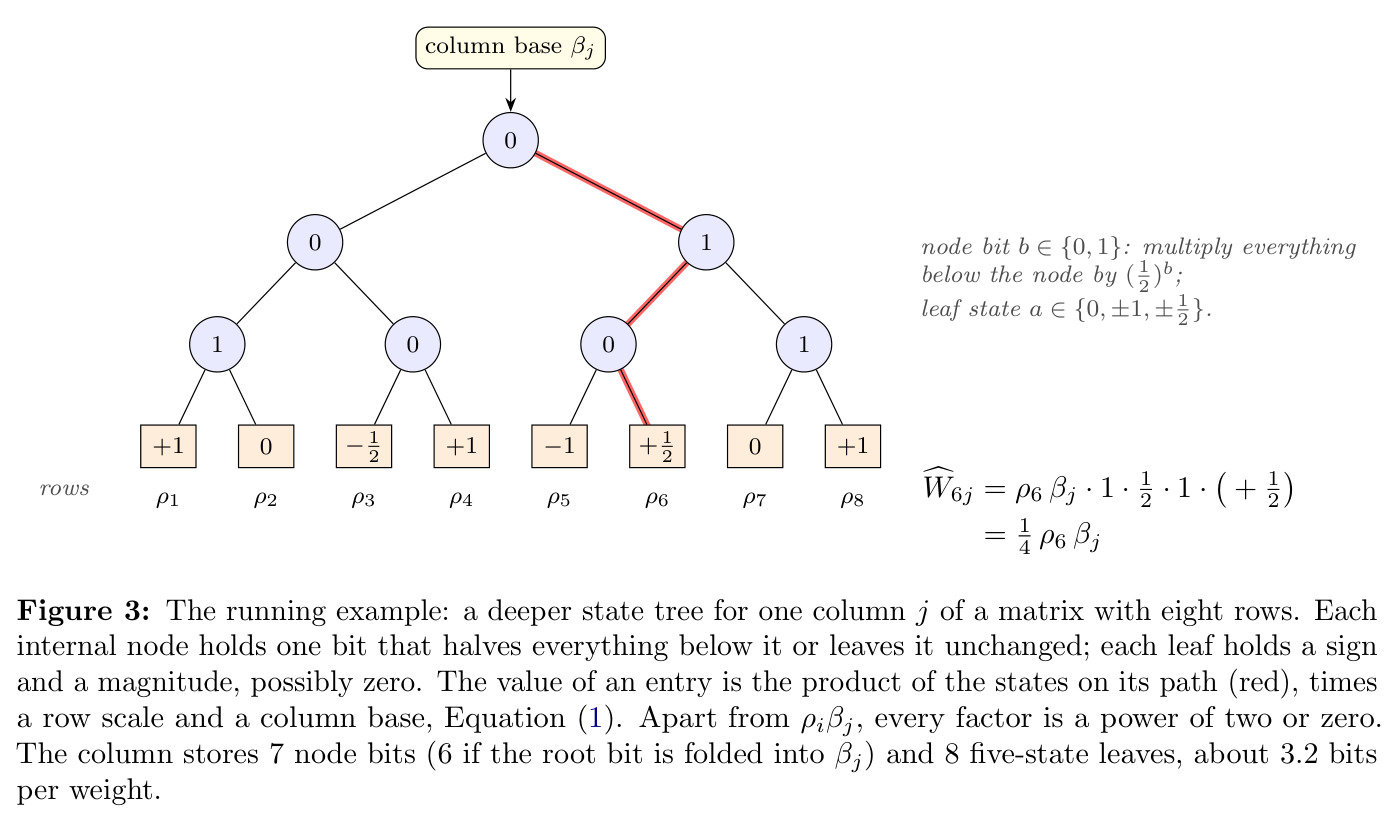
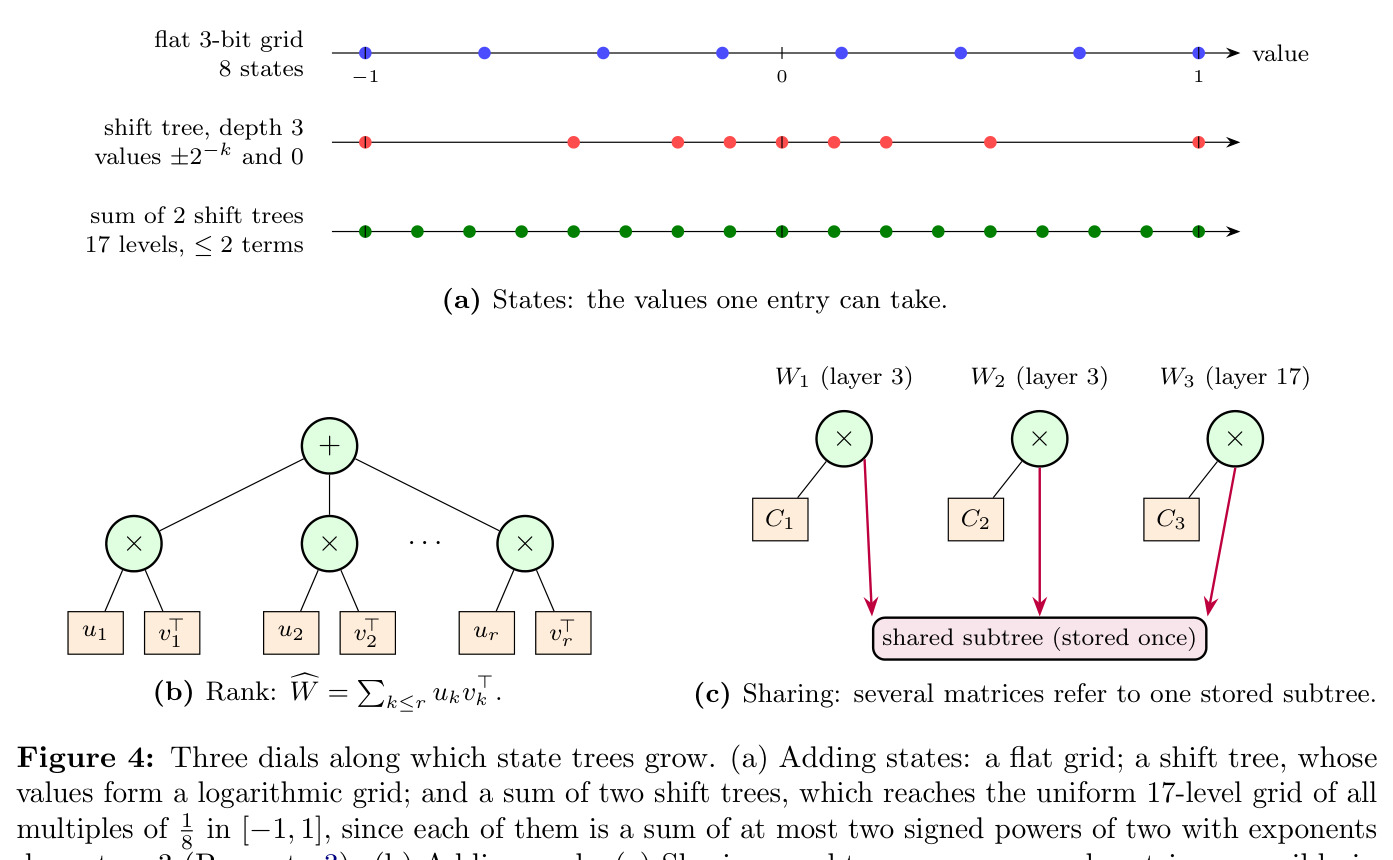
直觉上,一个数字本身就是一串决策:FP16权重 $w_1=0.15625$ 读作符号、指数、尾数三个因子的乘积 $w_1=(+1)\cdot 2^{-3}\cdot 1.25$;相邻权重 $w_2=-0.1875$ 的指数与它相同,却被格式存了两次。既然权重值是决策的乘积,公共因子就可以上提到两者的最近公共祖先节点只存一次,每个权重沿路径求积即可无损恢复(32比特降到27比特)。技术路线是定义状态树:叶对应矩阵元素,内部节点持有小字母表上的状态(移位、零门、透明态、符号/小量级、查表),元素值为 $W_{ij}=\rho_i\beta_j\prod_{v\in\pi(i,j)}c_v$(式1),行尺度 $\rho_i$ 与列基 $\beta_j$ 用普通格式存储;树之间可用求和(精度/残差校正)、求积(低秩/旋转)与引用(码本/跨层共享)三种操作组合成状态树图。每棵树自带两本账:存储比特(每个活动状态计 $\log_2|S_v|$ 比特,闭门之下不计)与电路加法数(每个非首2的幂项一个加法器)。
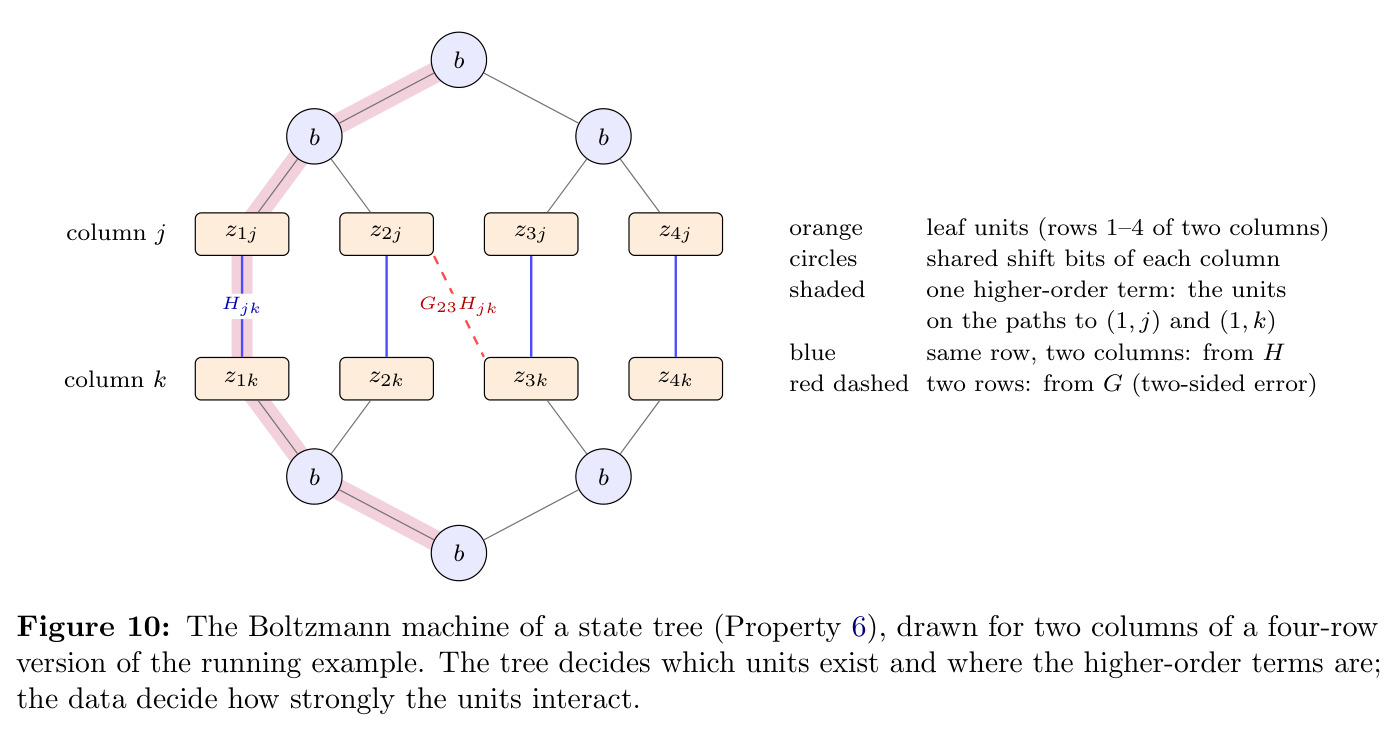
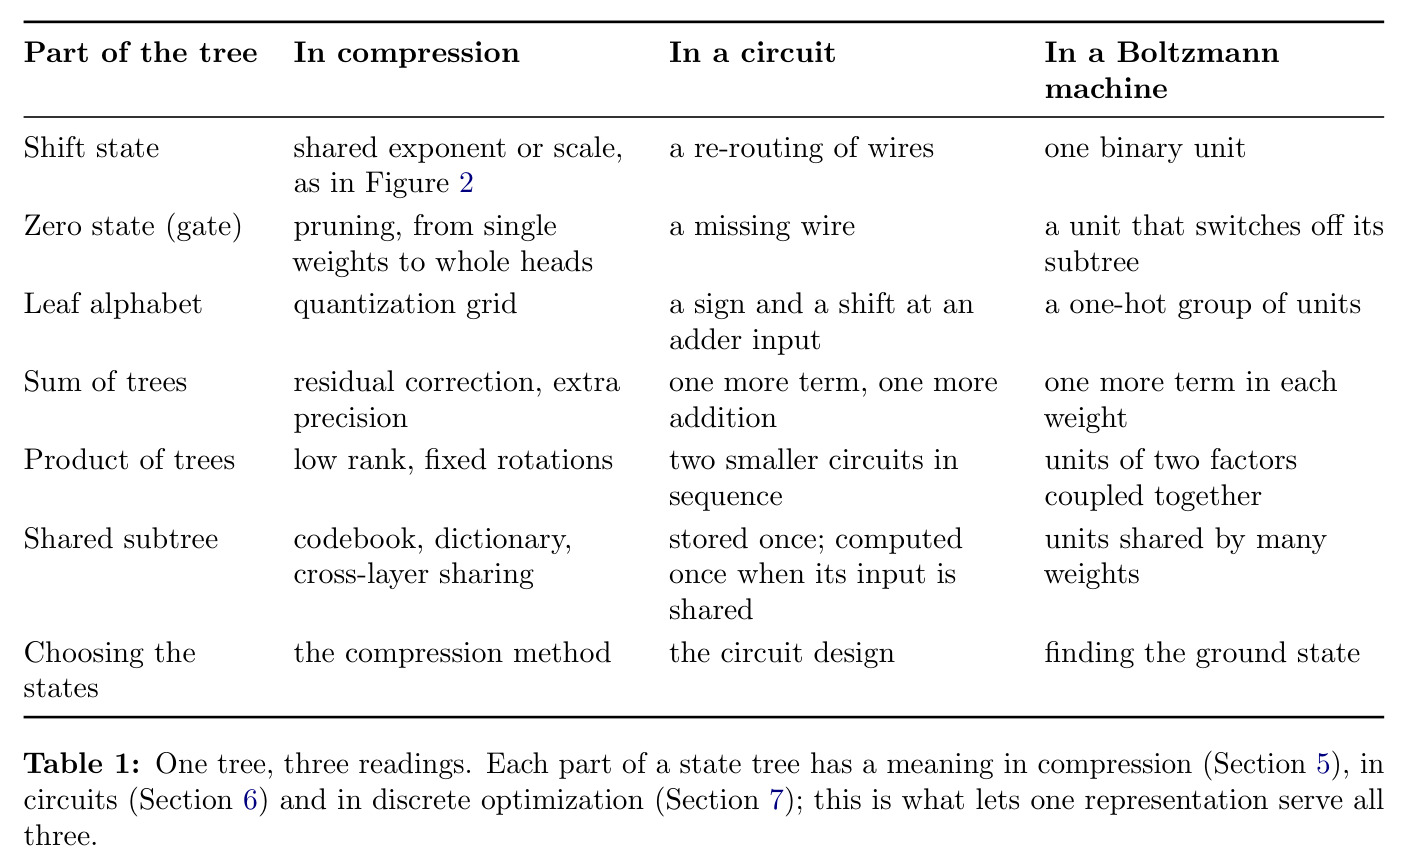
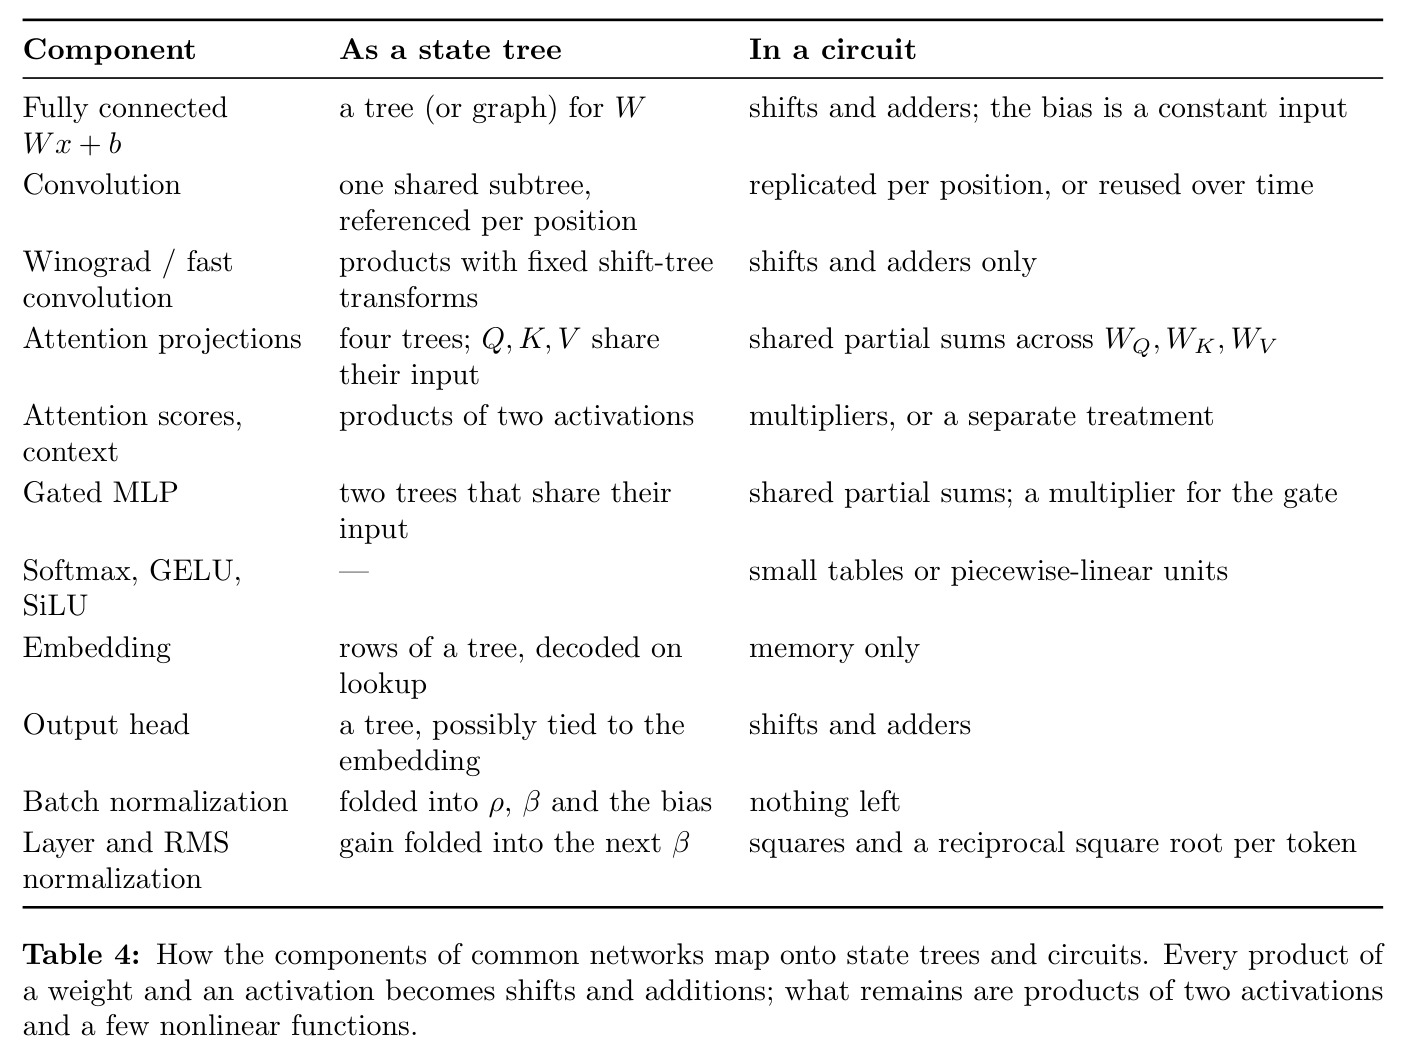
核心创新是把权重存储、硬件执行与离散优化统一到同一棵树上,三种读法共享一套词汇(Table 1)。与已有方法的本质区别有三点。第一,现有压缩格式是固定的浅树:只共享一种决策、层级写死;TWIG的共享是递归继承的——一个节点的状态自动作用于其整个子树,因此「插入共享节点」这一个动作就生成了组缩放、块指数、微指数等全部现有格式。第二,两本账显式分离:共享决策节省比特,但固定电路中移位免费,加法只由叶上非零项数决定,所以最适合存储的树与最适合电路的树不同(实验中恰好是平坦树加法最少),表示让优化器能按硬件预算交换两种成本。第三,选择状态被证明等价于求高阶玻尔兹曼机基态(Property 6):耦合强度来自数据(输入二阶矩 $H$、输出梯度矩 $G$),高阶项的位置来自树路径,GPTQ只是它的零温单遍特例,反向列序且不裁剪时即Babai最近平面算法。
方法步骤详情
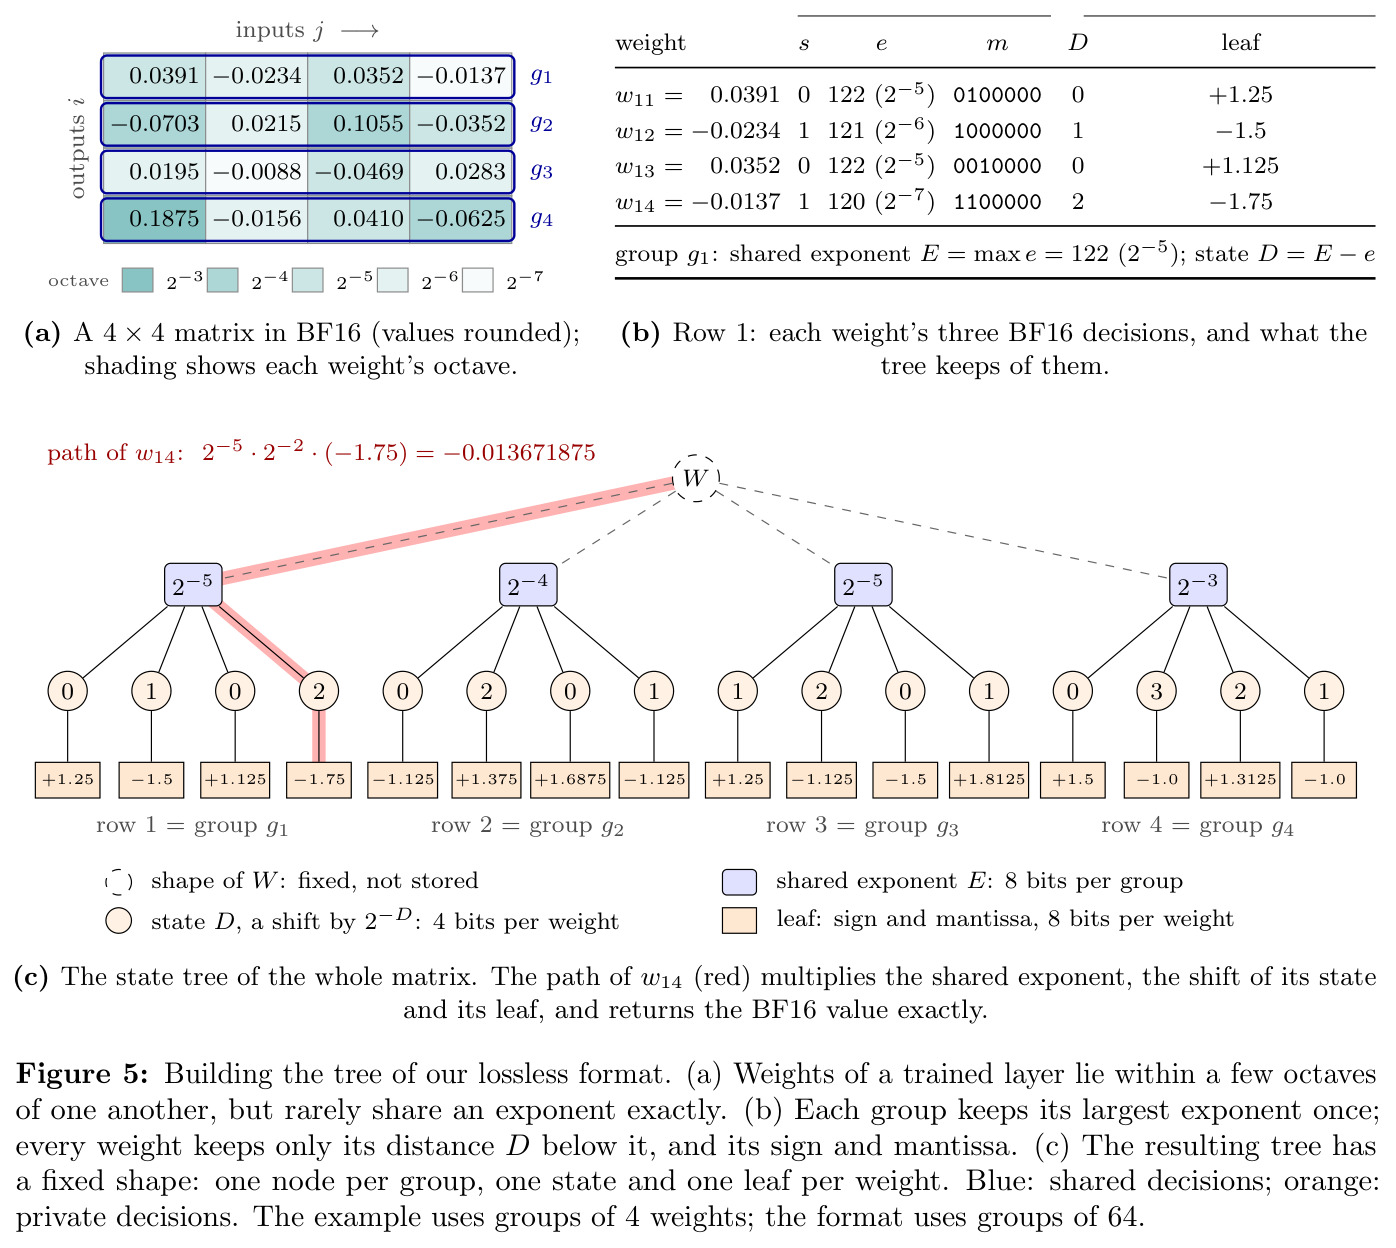
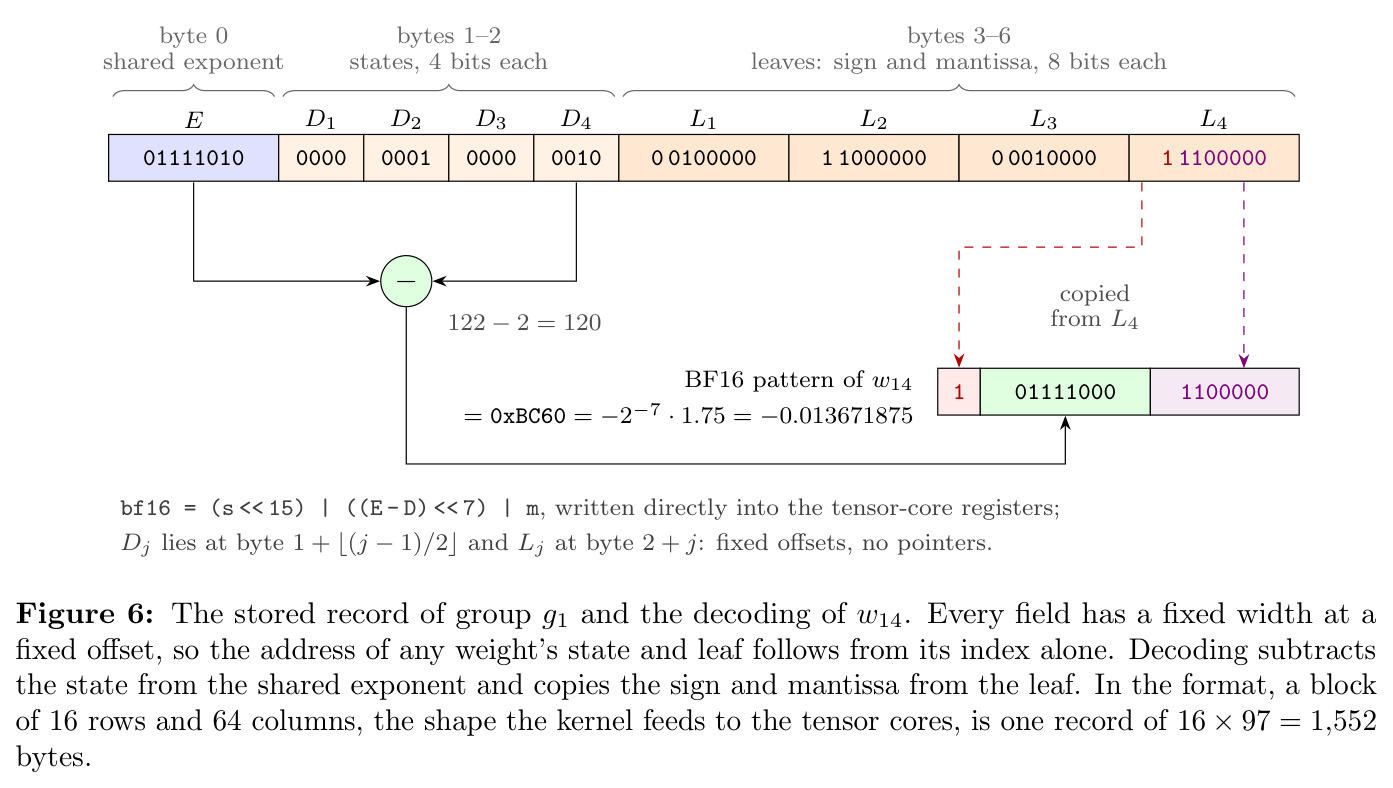
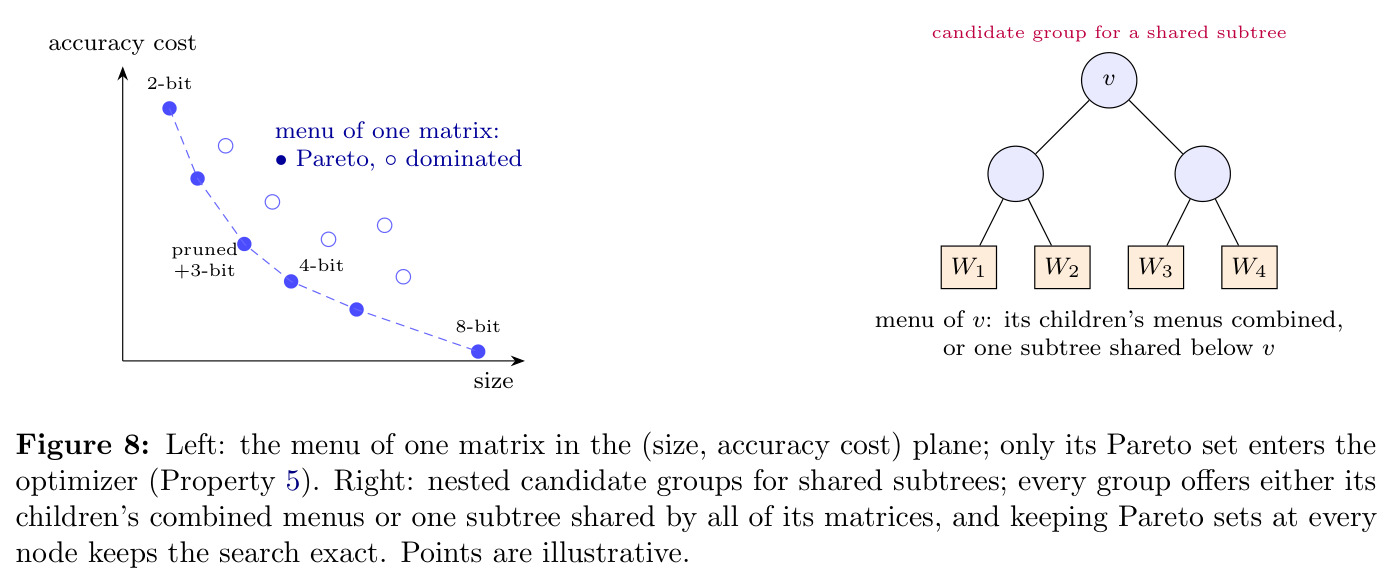
以无损BF16格式为例:第一步分组——沿输入维度取每行连续64个权重为组,组节点存组内最大指数 $E$(8比特)。第二步每权重存距离 $D=E-e$(4比特,即 $2^{-D}$ 移位)与符号加7比特尾数叶(8比特),路径乘积 $w=2^{E-127}2^{-D}(-1)^s(1+m/128)$ 逐比特还原原值;落后15个八度以上者(含精确零,约万分之一)走逃逸状态15存入侧表,最终12.13比特/权重、省24%。第三步解码:字段固定偏移、无指针,$E-D_j$ 一次减法加两次拷贝即重建BF16并写入张量核寄存器,CUDA核达带宽下限97%。第四步统一优化:每矩阵拿到覆盖量化/剪枝/低秩的(大小,代价)菜单,取Pareto前沿后用多选背包动态规划在全网预算内精确求解,代价用曲率形式 $f_H$ 度量并迭代重解。第五步电路映射按式(3) $y_i=\rho_i\sum_j\sum_\tau\pm(\beta_j x_j)\gg k_{ij\tau}$ 计数加法器,只剩 $m+n$ 个真乘法;另把全部状态编码为玻尔兹曼机单元,层误差即能量。
技术新颖性
技术新颖性体现在一组严格结果:Theorem A.4证明FP系/组缩放整数/块浮点MX/共享微指数与HiFloat4/三值BitNet/向量码本/N:M稀疏全部是至多5层的浅状态树且不超原始比特成本;Theorem A.6/A.7给出计数意义下的完备与最优($K$ 值叶用 $\log_2 K$ 比特/元素,与任何编码的下界差至多 $mn\log_2(1+\varepsilon)+1$ 比特);Theorem A.8证明 $t$ 棵移位树之和把相对误差压到 $3^{-t}$,$b$ 比特整数平均只需约 $b/3$ 个非零2的幂项;Theorem A.9/A.10刻画共享移位的可达范围(最近公共节点高 $h$ 层的两元素量级差不超过 $2^h$)并证明边比特与节点比特两种编码等价(3.58对3.32比特/权重);Theorem A.13/14给出加性代价下含共享子树的精确预算优化器;Theorem A.16构造出深度 $D$ 的树对应次数至多 $2D+2$ 的高阶玻尔兹曼机。作者标注计数界等部分结果系经典结论重述,特定于状态树的新结果是共享移位可达性、两编码等价、精确优化器与高阶机构造。
实验结果
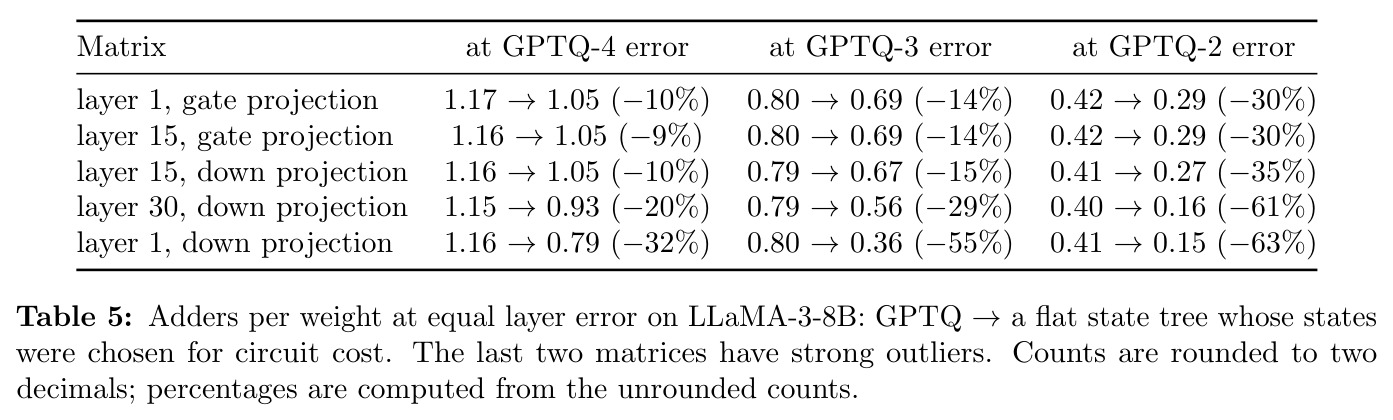
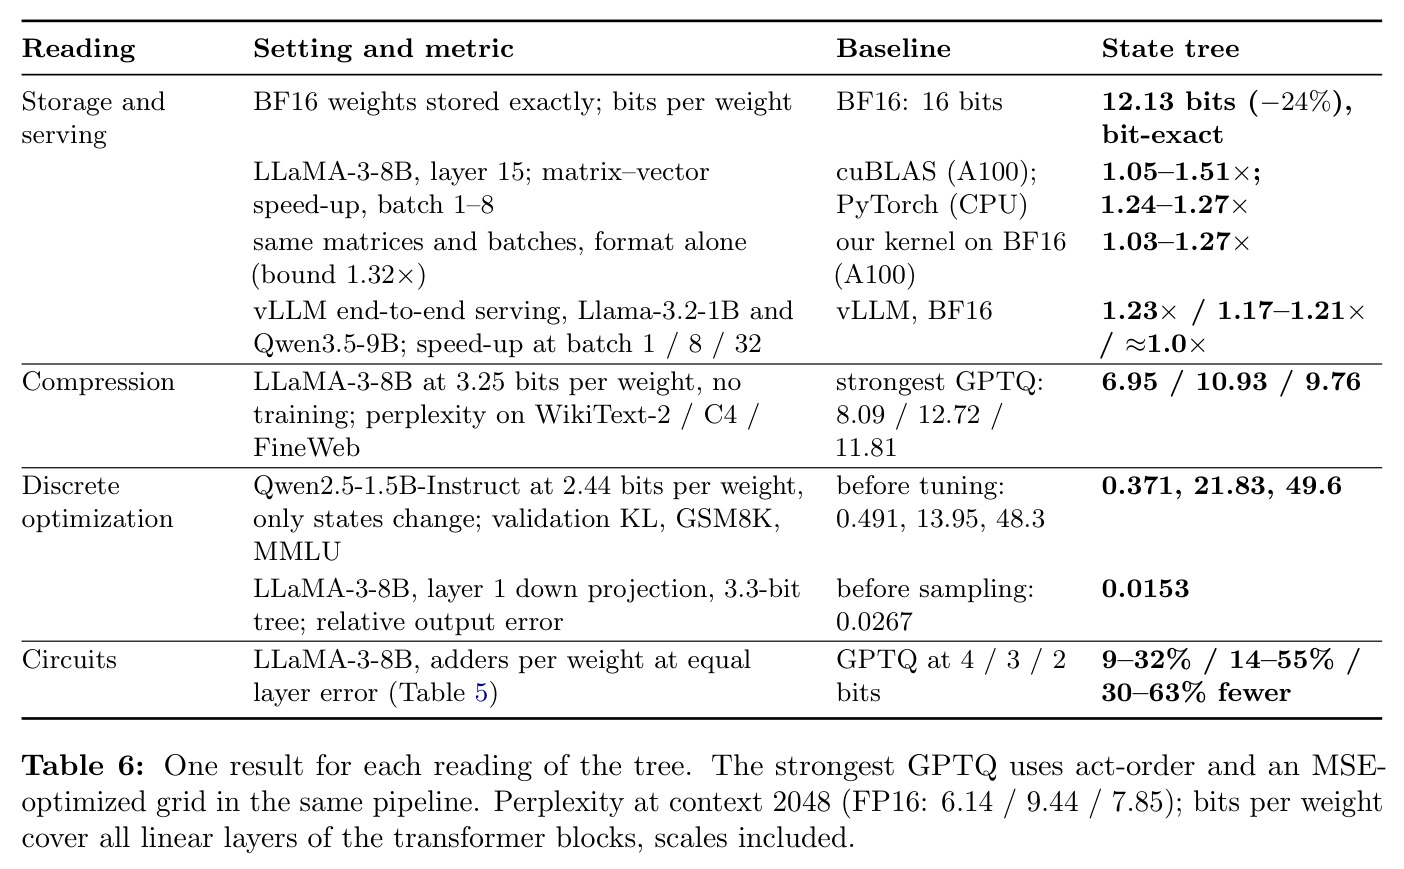
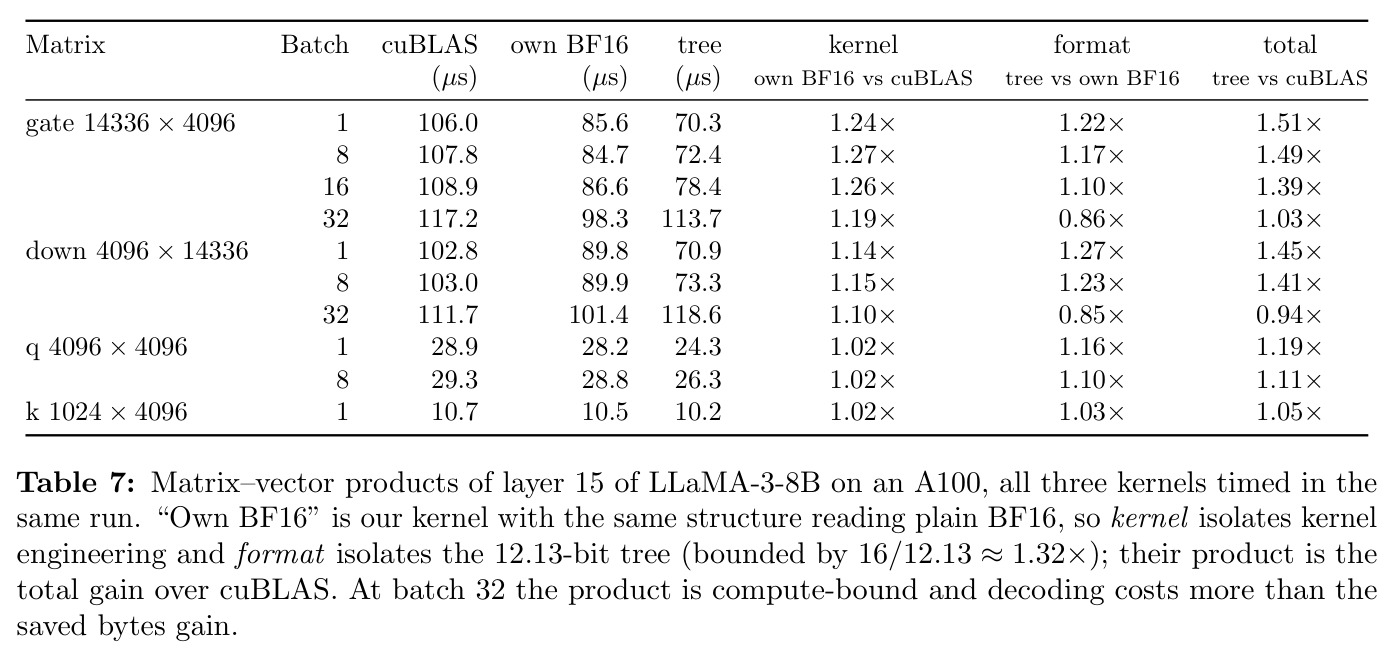
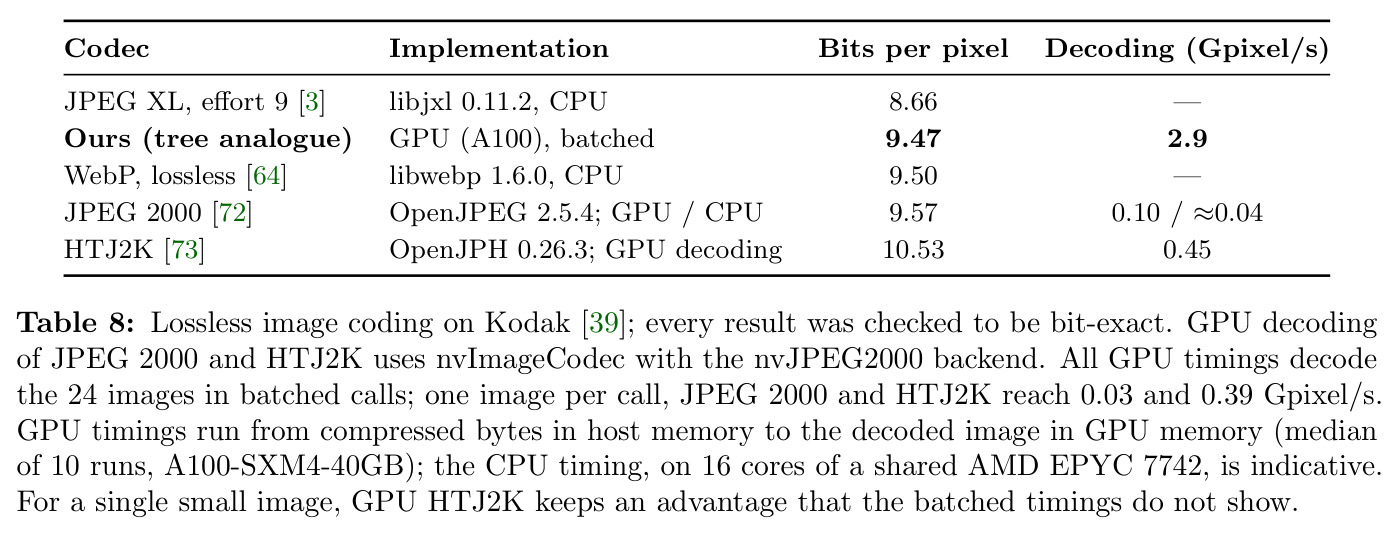
五组「首批证据」:①无损存储——BF16 bit-exact存为12.13比特/权重(−24%),层15矩阵-向量乘对cuBLAS加速1.05–1.51×。②压缩——全网动态规划在3.25比特/权重无训练下,WikiText-2/C4/FineWeb困惑度6.95/10.93/9.76,对比最强GPTQ的8.09/12.72/11.81,降14–17%。③Ising healing——Qwen2.5-1.5B-Instruct压至2.44比特后仅改46,239个码,验证KL 0.491→0.371(−24%),GSM8K 13.95→21.83(+7.9点);退火Gibbs把层1下投影输出误差降43%。④电路——等层误差下平坦树比GPTQ在典型矩阵3/4比特省9–15%加法器、2比特省30–35%;强离群的层1下投影分别省32%/55%/63%。⑤无损图像——Kodak上9.47 bpp优于WebP 9.50与JPEG 2000 9.57,GPU解码2.9 Gpixel/s约为HTJ2K(10.53 bpp)的6.4倍,码率比JPEG XL(8.66 bpp)高约9%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LLaMA-3-8B 全线性层后训练压缩(无训练) | WikiText-2 困惑度 @ 3.25 bpw | 6.95(统一预算优化器) | 最强 GPTQ:8.09;FP16:6.14 | 相对降低 14%,关闭与 FP16 差距的 58% |
| 加法器效率(LLaMA-3-8B 第 1 层下投影,强离群矩阵) | 加法器/权重 @ 等层误差,3-bit | 0.36 | GPTQ:0.80 | 减少 55%(2-bit 时 −63%,4-bit 时 −32%) |
| 加法器效率(典型矩阵:层 1/15 门投影、层 15 下投影) | 加法器/权重 @ 等层误差,3-bit / 4-bit | 0.69 / 1.05 | GPTQ:0.80 / 1.17 | 减少 9–15%(2-bit 减少 30–35%) |
| BF16 无损存储(全模型含嵌入与输出头) | 比特/权重(bit-exact) | 12.13 | BF16:16 | 减少 24%,零精度损失 |
| vLLM 端到端推理(Llama-3.2-1B / Qwen3.5-9B) | batch 1 生成加速比 | 1.23× | vLLM BF16 | 吞吐提升 23%;batch 8 时 1.17–1.21× |
| 压缩后修复(Qwen2.5-1.5B-Instruct @ 2.44 bpw,Ising healing) | GSM8K 准确率(5-shot) | 21.83 | healing 前:13.95 | +7.9 点(约 5 个标准误);验证 KL −24% |
| 无损图像解码(Kodak,GPU 批量) | 解码吞吐 / 码率 | 2.9 Gpixel/s @ 9.47 bpp | HTJ2K:0.45 Gpixel/s @ 10.53 bpp | 约 6.4× 且码率更低(JPEG XL 码率 8.66 bpp 仍最优) |
局限与改进
作者明确承认:所有测量只是「选定模型与层上的首批证据」而非普遍结论;加法计数忽略了加法器位宽(随移位跨度增长)与定点右移截断,只是电路面积的一阶代理而非面积/能耗测量;压缩菜单不含旋转与trellis量化器,完整菜单「将在后续论文描述」;GSM8K提升来自单次运行(±2点的95%区间),且healing在相同token预算下不如只调连续尺度(后者KL 0.325、GSM8K 27.5),二者作用于不同参数;图像编码器在单张小图上不及GPU HTJ2K,压缩率也不如JPEG XL与paq8px;量子求解器能否胜过经典方法是开放问题。我的补充观察:电路对比中GPTQ用「plain form」(无裁剪、无网格搜索、自然列序),加法器对比的公平性依赖人为约定的同一计数规则;几乎所有定量结果集中在LLaMA/Qwen系与单张A100,缺乏其他架构与硬件平台验证;无损格式的端到端收益与kernel工程耦合,作者自己也指出需要companion paper分离两者;此外3.25比特与2.44比特两个头条结果的完整菜单尚未公开,暂不可独立复现。
独立分析的弱点
独立分析可见五个弱点。第一,电路证据薄弱:仅五个矩阵、以计数代替综合,改进方向是把式(3)真正综合到FPGA/ASIC,报告面积与功耗随位宽的变化,并补上与APoT、ShiftAddLLM等同样以加法为目标的量化器的实测对比。第二,统一优化器假设代价可加,而激进编辑间存在交互,迫使「构建-测量-重解」迭代(4.25比特运行用了9轮才收敛),改进方向是学习带交互项的代价模型或分层贝叶斯校正以减少迭代轮数。第三,无损格式依赖「行内权重量级相近」的经验事实,逃逸率虽仅约0.01%,但对异常分布(极小模型、embedding表)可能放大,改进方向是自适应组大小或按量级重排同时保持固定寻址。第四,树形状(分组方式、行排序、深度)目前手工指定且缺乏搜索算法,实验还表明深层树对加法无益(平坦树最优),说明形状选择准则尚不成熟,值得发展自动形状搜索。第五,batch≥32时解码开销超过省字节的收益(比自家BF16核慢最多15%),说明该格式主要适合带宽受限的小批量延迟敏感推理,改进方向是与激活量化、KV cache树化协同,把解码开销摊进计算受限区。
未来方向
作者在Section 9末尾列出五个方向:在树空间中从零训练网络(Section 8给出温度退火软分布方案),让模型自己发现哪些决策值得共享而非事后强加;从模型到硅片——把整个模型编译成硬连线加法器电路,形成面积/能耗/精度的显式权衡设计流;稀疏模型更新——微调增量只动极少数状态,可作为树的小编辑补丁发布(healing只改0.004%的码即是原型);超越权重——激活与KV cache的在线树化,以及科学数组、音频、视频等其他数值数据;量子硬件——每块几十到几百单元的子问题是退火机与变分电路的天然首批负载。基于本文成果还可延伸:把旋转方法(QuIP#/Hadamard)与trellis码纳入菜单的统一预算优化;感知加法器位宽的精细化成本模型;将Ising healing扩展到更大模型并允许多家族叶同时移动;为图像编解码器学习更强的上下文模型以追赶JPEG XL的压缩率。
复现评估
复现条件中等偏上。代码已公开(无损存储、CUDA核与vLLM插件的代码已公开(github.com/ammarali32/StateTree-Representation),附录A.4给出详尽设置:128条FineWeb校准序列、困惑度在上下文2048测量并给出FP16基准、5-shot lm-eval、PyTorch 2.7.1 / Transformers 5 / vLLM 0.32.0、单卡A100-SXM4-40GB;healing的40步流程、逃逸率(约0.01%)、求解器消融数据齐全。缺口在于:全网预算优化器与healing所用的完整编辑菜单「将在后续论文描述」,3.25比特与2.44比特两个头条结果目前无法完整复现;电路部分无硬件综合产物,加法计数规则虽写明但需自行实现;图像编解码器未说明开源。算力需求:无损格式与单层实验一张A100即可;全网动态规划涉及224个矩阵的菜单构建与多轮重测,估计需数个A100-天。难度分级——无损存储/服务复现容易,层内电路计数中等,统一优化器与healing较难。
论文图表
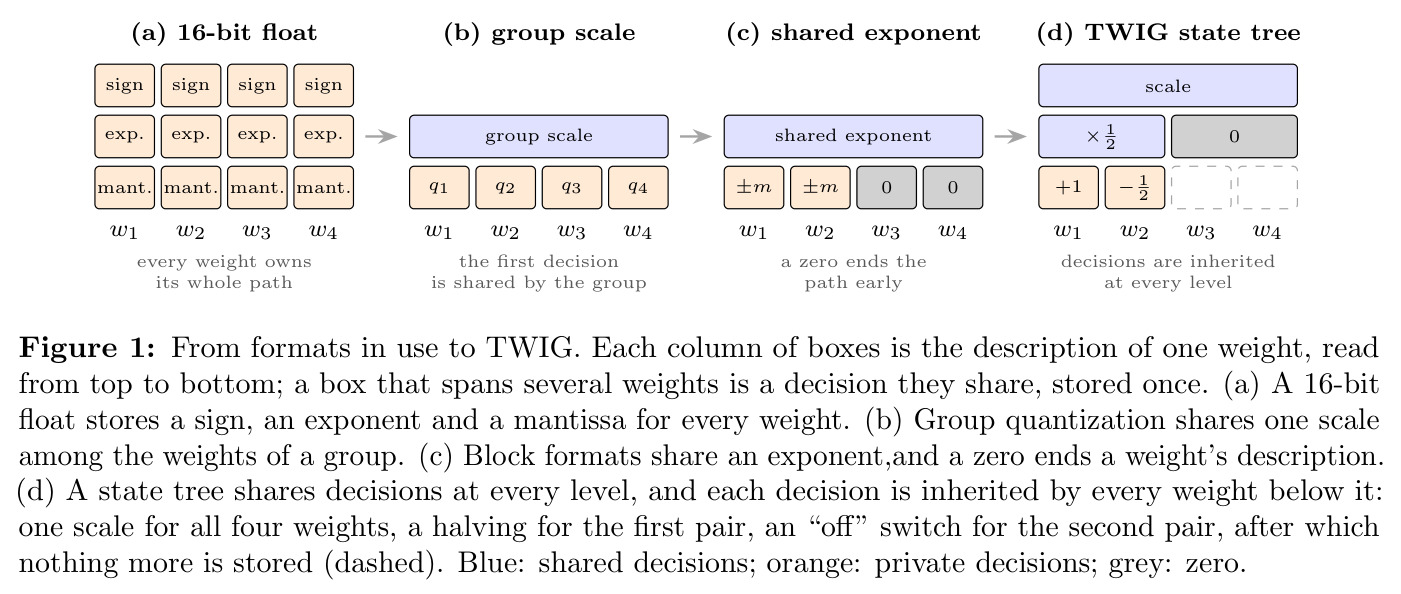
对比四列权重描述:16位浮点每权重拥有完整的符号/指数/尾数路径;组量化让第一个决策(尺度)组内共享;块格式共享指数且零值让路径提前结束;TWIG状态树在每一层共享决策并逐级继承——一个尺度服务四个权重、一对权重共享一次减半、另一对关门后其下不再存储任何内容。蓝色为共享决策、橙色为私有决策、灰色为零。
一图看懂本文动机与核心思想:把格式从「每权重存全路径」到「逐级共享决策」的演进趋势推到终点,是理解全文的入口。