LeWorldModel 是否保留了局部动作几何? Does LeWorldModel Preserve Local Action Geometry?
用Gram矩阵在三个扰动尺度上诊断预训练世界模型LeWM是否复现环境的局部动作敏感几何
前置知识
世界模型(World Model)
通过学习环境的预测动力学来支持规划与控制的模型:给定当前观测/状态与动作,预测下一时刻的观测或潜在表示,代表工作有 Ha & Schmidhuber 的 World Models 和 Dreamer 系列。LeWM(LeWorldModel)是动作条件化的世界模型,输入 3 帧观测上下文和 5 步动作块,直接预测下一帧的嵌入表示。
本文的评估对象就是预训练好的 LeWM,理解它的输入输出接口(上下文、动作块、嵌入输出)是理解整个反事实实验设计的前提。
JEPA(联合嵌入预测架构)
不在像素空间做预测,而是先用编码器把观测映射到表示空间,再在表示空间中预测目标表示,并通过防坍缩机制训练,代表如 I-JEPA、V-JEPA 2;加入动作条件后可用于机器人与世界建模(如本文的 LeWM)。它把「预测」抽象成了「表示空间中的几何变换」。
论文所有几何测量都发生在同一个冻结编码器 $E_\theta$ 的输出空间里,只有理解 JEPA 才能明白「嵌入空间中的动作敏感度」到底在度量什么。
Gram 矩阵
对映射的雅可比矩阵 $J$,其 Gram 矩阵为对称半正定矩阵 $G=J^\top J$。恒等式 $\|Ju\|_2^2=u^\top Gu$ 表明:$G$ 的特征值/特征向量刻画了响应能量在各动作方向上的分布——最大特征值对应的方向就是「推一下动作,输出变化最大」的方向。迹归一化 $\tilde G=G/\mathrm{tr}(G)$ 则丢弃总增益、只保留相对形状。
本文把 $G_\epsilon$ 作为「局部动作几何」的数学载体,所有指标($D_G$、条件数、特征空间夹角、敏感度椭圆)都由它派生。
中心差分近似雅可比
用 $\hat J e_i=(F(+h e_i)-F(-h e_i))/(2h)$ 估计 $F$ 沿坐标 $i$ 的偏导数。这不是无穷小导数而是有限尺度近似:步长 $h$ 决定测量的是哪个尺度的几何,接触、光栅化等非线性会限制局部线性程度。
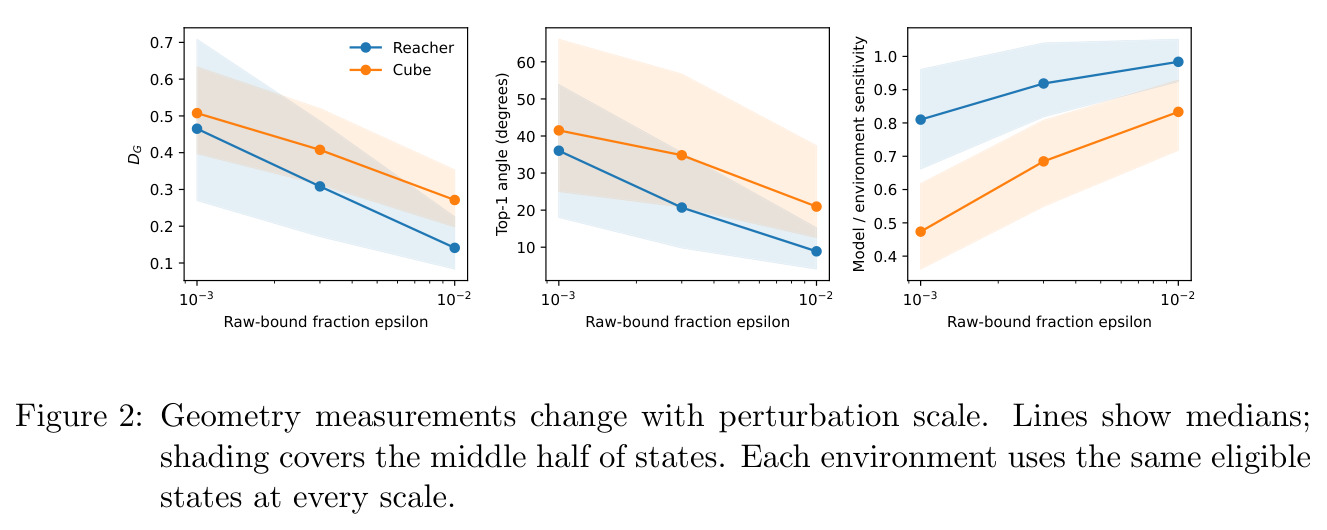
本文的核心发现之一就是几何结论随扰动尺度剧烈变化(十倍尺度使 $D_G$ 降约 70% 和 47%),理解差分机制才能明白「换尺度即换测量对象」。
WAPE(加权绝对百分比误差)
定义为 $\sum_j|\hat r_j-r_j|/\sum_j r_j$,衡量一组预测幅度相对真实幅度的总偏差百分比,对大响应的误差更敏感。本文用它逐状态评估 Gram 的二次型预测 $\hat r(u)=\sqrt{u^\top Gu}$ 是否准确,再取所有状态的中位数。
WAPE 是判断「几何有没有用」的关键指标:环境 Gram 的 WAPE 优于各向同性参照,说明 Gram 确实携带可证伪的预测信息。
Reacher 与 OGBench Cube
两个连续控制环境:Reacher 是二自由度机械臂到达任务(动作维 $d=2$,5 个 wrapper 步覆盖 0.20 秒);OGBench Cube 是五维动作的积木操控任务($d=5$,5 步覆盖 0.25 秒)。本文从数据集回合中恢复模拟器状态作为「锚点」,在其上做反事实扰动实验,共约 958 个锚点。
论文的全部实验结论都建立在这两个环境的锚点库上,动作维度不同(2 对 5)也解释了两环境结论的差异。
研究动机
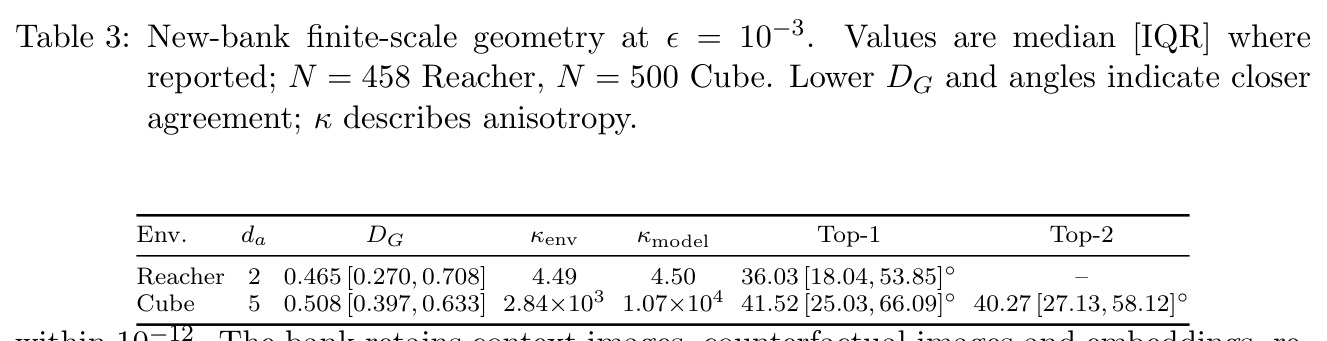
世界模型社区的主流评估方式是聚合指标:下一帧预测误差、视频生成质量或下游控制回报。V-JEPA 2、LeWM 这类动作条件 JEPA 在「采样出的动作上预测得准」,并不保证「邻近动作方向的相对效果」也对。而 MPC/CEM 等规划器恰恰依赖模型对「哪个动作方向更有效」的排序:如果模型把最敏感的动作方向弄错几十度,即使逐步预测误差看起来不大,规划出的轨迹也可能系统性偏航。论文在 Reacher(2 维力矩动作)和 OGBench Cube(5 维动作)上的预训练 LeWM 量化了这一问题:在最小扰动尺度下,环境与模型的最敏感动作方向中位夹角分别达 36° 和 42°,Cube 的前两维敏感子空间还约有 40° 失配。这类失配在常规的预测误差或回报评估中完全不可见,此前也缺少一个专门测量「局部动作几何」的诊断协议。
本文的目标是本文要构建一个无需训练、可跨模型复用的诊断流程,回答三个递进问题。第一,量化对齐:在同一冻结编码器的输出空间里,用恢复模拟器状态的反事实实验,比较环境与模型在三个扰动尺度(ε=10⁻³、3×10⁻³、10⁻²)上的动作敏感度 Gram 矩阵,并区分「敏感度强度」与「方向对齐」。第二,校准基准:把模型的差异值与三种刻意删除信息的参照(各向同性 $I/d$、随机正交共轭、打乱状态匹配)比较,判断模型是否真的学到了超出「随便一个矩阵」的几何信息。第三,验证解释力:在 held-out 方向上检验 $u^\top Gu$ 能否预测真实响应幅度,让 Gram 从描述性统计变成可证伪的预测器;同时把编码器输出空间的敏感度与物理响应、目标导向的动作选择区分开来。
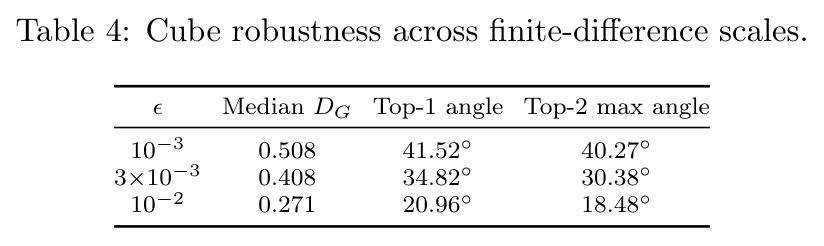
与已有工作不同的是,已有对称性与几何视角的研究多停留在单一尺度、单一输出度量的定性观察,或只分析模型自身的雅可比性质而缺乏环境对照。本文的独特切入有三点。其一,有限尺度而非无穷小导数:显式测量 ε=10⁻³、3×10⁻³、10⁻² 三个尺度,并证明结论随尺度剧烈变化(十倍扰动使中位 $D_G$ 在 Reacher 降约 70%、Cube 降约 47%),因此几何结论必须「绑定尺度」陈述。其二,匹配反事实设计:环境与模型从同一恢复的模拟器状态、同一五步动作块出发,输出共享同一冻结编码器,使两个 Gram 的差异只能归因于动力学预测本身。其三,迹归一化 $\tilde G=G/\mathrm{tr}(G)$ 刻意丢弃公共乘性增益,把「形状对齐」与「幅度大小」分开,再用 oracle 增益实验把增益误差单独量化——这种分解是以往几何评估所没有的。
核心方法
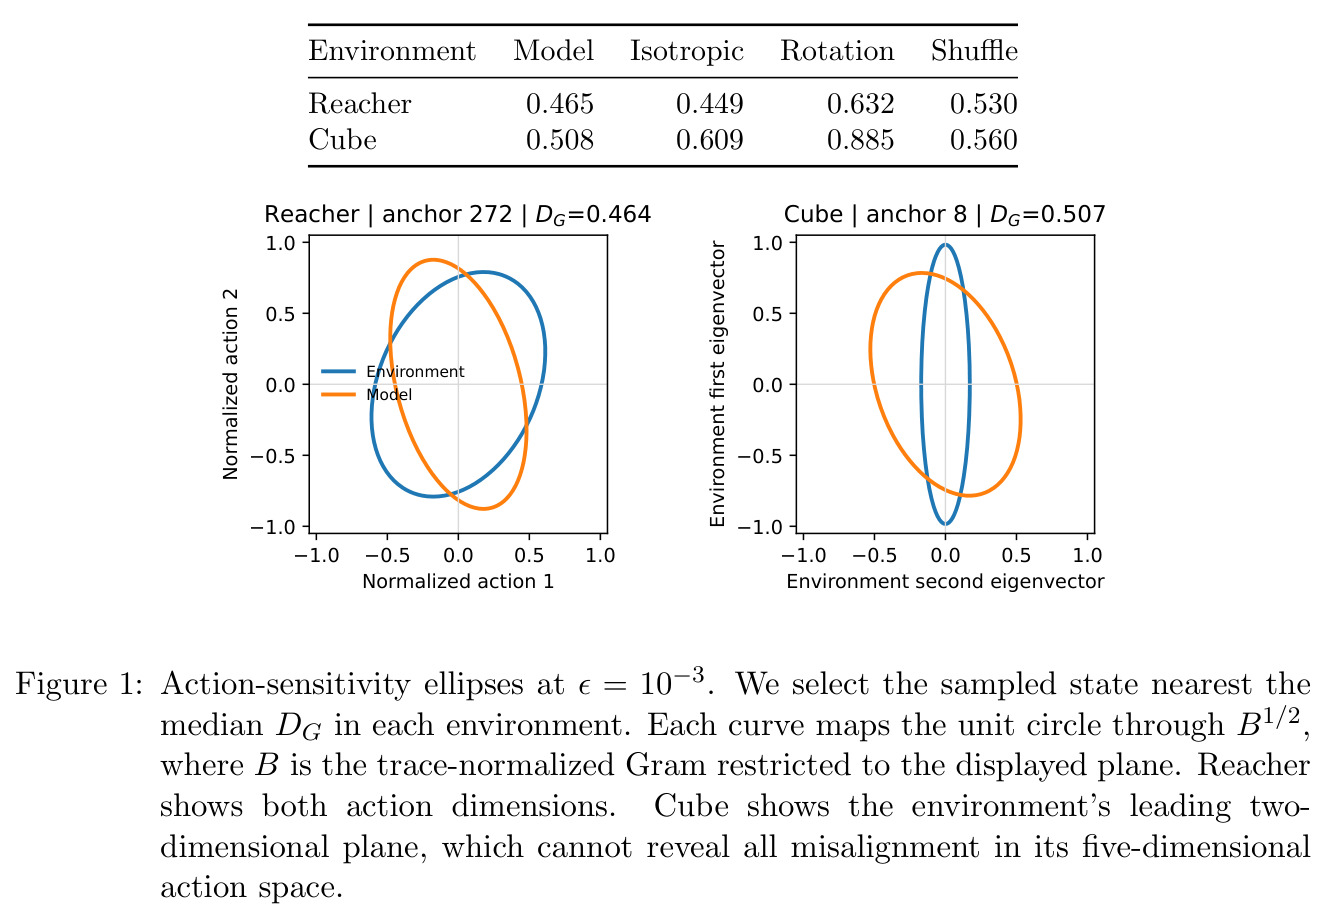
直觉上,模型对微小动作扰动的响应可以画成一个「椭圆」:单位圆经 $B^{1/2}$($B$ 为迹归一化 Gram 在所展示平面的限制)映射后的像,主轴方向即最敏感动作方向,轴长比即各向异性程度。若模型椭圆与环境椭圆方向错开几十度、形状差异大,说明模型「知道动作有强弱之分,但分错了方向」。技术路线:取 3 帧观测上下文 $H_t$ 与 5 步动作块 $A_t$,对所有动作加共享归一化偏移 $u$:$A_t(u)=(a_t+Du,\dots)$,其中 $D=\mathrm{diag}(\text{动作标准差})$。模型侧 $F^{\mathrm{model}}_t(u)$ 由 $H_t$ 与 $A_t(u)$ 预测下一嵌入;环境侧 $F^{\mathrm{env}}_t(u)$ 从恢复的模拟器状态执行相同动作块,渲染末端帧并用同一冻结编码器 $E_\theta$ 编码,两映射输出同一空间。用中心差分估计雅可比列 $\hat J_\epsilon e_i=(\hat F(+h_ie_i)-\hat F(-h_ie_i))/(2h_i)$,步长 $h_i=\epsilon(a_i^{\max}-a_i^{\min})/(2D_{ii})$,再形成 $G_\epsilon=\hat J_\epsilon^\top\hat J_\epsilon$;归一化 $\tilde G=G/\mathrm{tr}(G)$ 后计算 $D_G=\|\tilde G^{\mathrm{model}}-\tilde G^{\mathrm{env}}\|_F$,辅以特征值条件数与特征空间夹角。
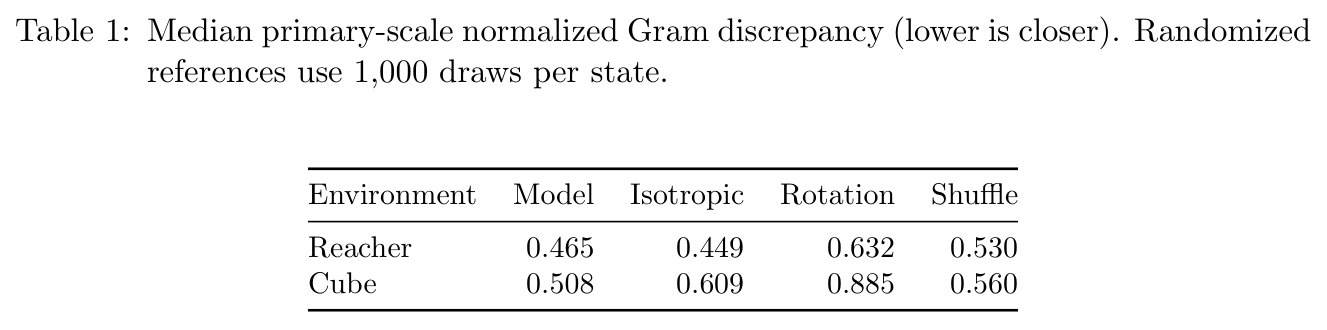
核心创新是「匹配反事实 + 三重校准 + held-out 二次型检验」的组合。以往几何评估通常只分析模型自身的雅可比性质;本文把环境响应作为对照物——同一恢复的模拟器状态、同一五步动作块、同一冻结编码器,保证两个 Gram 的差异只能归因于动力学预测的不同。三个参照各自删除一种信息:各向同性 $I/d$ 删掉「环境哪些动作方向更敏感」;环境度量的随机正交共轭保留特征谱但删掉方向;打乱状态匹配保留边缘分布但删掉状态特定结构。因此模型相对参照的位置具有可解释语义:Cube 上模型 $D_G=0.508$ 低于全部参照(0.560/0.609/0.885),说明确实学到了几何信息;Reacher 上模型 0.465 仅略高于各向同性的 0.449,说明其信息增量有限。held-out 检验则给 Gram 一个具体承诺:预测 $\hat r(u)=\sqrt{u^\top G_\epsilon u}$ 应匹配居中响应 $r(u)=\|F(u)-F(-u)\|/2$,用 WAPE 评估——几何由此成为可证伪的预测器而非事后描述。
方法步骤详情
第一步,锚点构建:从数据集回合恢复模拟器状态取锚点(审计后在当前模拟器重新生成轨迹);Reacher 保留 458 个锚点($d=2$,42 个因动作触界被剔除),Cube 保留 500 个($d=5$);上下文为 3 帧观测 $H_t$,动作块 5 步,覆盖 0.20 秒(Reacher)或 0.25 秒(Cube)。第二步,反事实响应:分别计算模型映射 $F^{\mathrm{model}}_t(u)$(由 $H_t$、$A_t(u)$ 预测下一嵌入)与环境映射 $F^{\mathrm{env}}_t(u)$(执行 $A_t(u)$ 后渲染末端帧再编码),两者输出同一空间。第三步,差分与 Gram:沿 $d$ 个坐标方向做中心差分,步长 $h_i=\epsilon(a_i^{\max}-a_i^{\min})/(2D_{ii})$,得 $\hat J_\epsilon$ 与 $G_\epsilon$;迹为零或非有限的矩阵判为无效;尺度取 ε=10⁻³(主尺度)、3×10⁻³、10⁻²。第四步,比较与校准:计算 $\tilde G$、$D_G$、条件数与特征空间夹角;三个参照每状态各抽 1,000 次;不确定性用回合 bootstrap 的 95% 区间。第五步,held-out 验证:每状态取 8 个球面方向并跨尺度复用,比较 $\hat r(u)=\sqrt{u^\top G_\epsilon u}$ 与真实居中响应,逐状态计算 WAPE=$\sum_j|\hat r_j-r_j|/\sum_j r_j$ 后取中位数;另设 oracle 增益(把模型 Gram 缩放到环境迹)以分离增益误差与形状误差。
技术新颖性
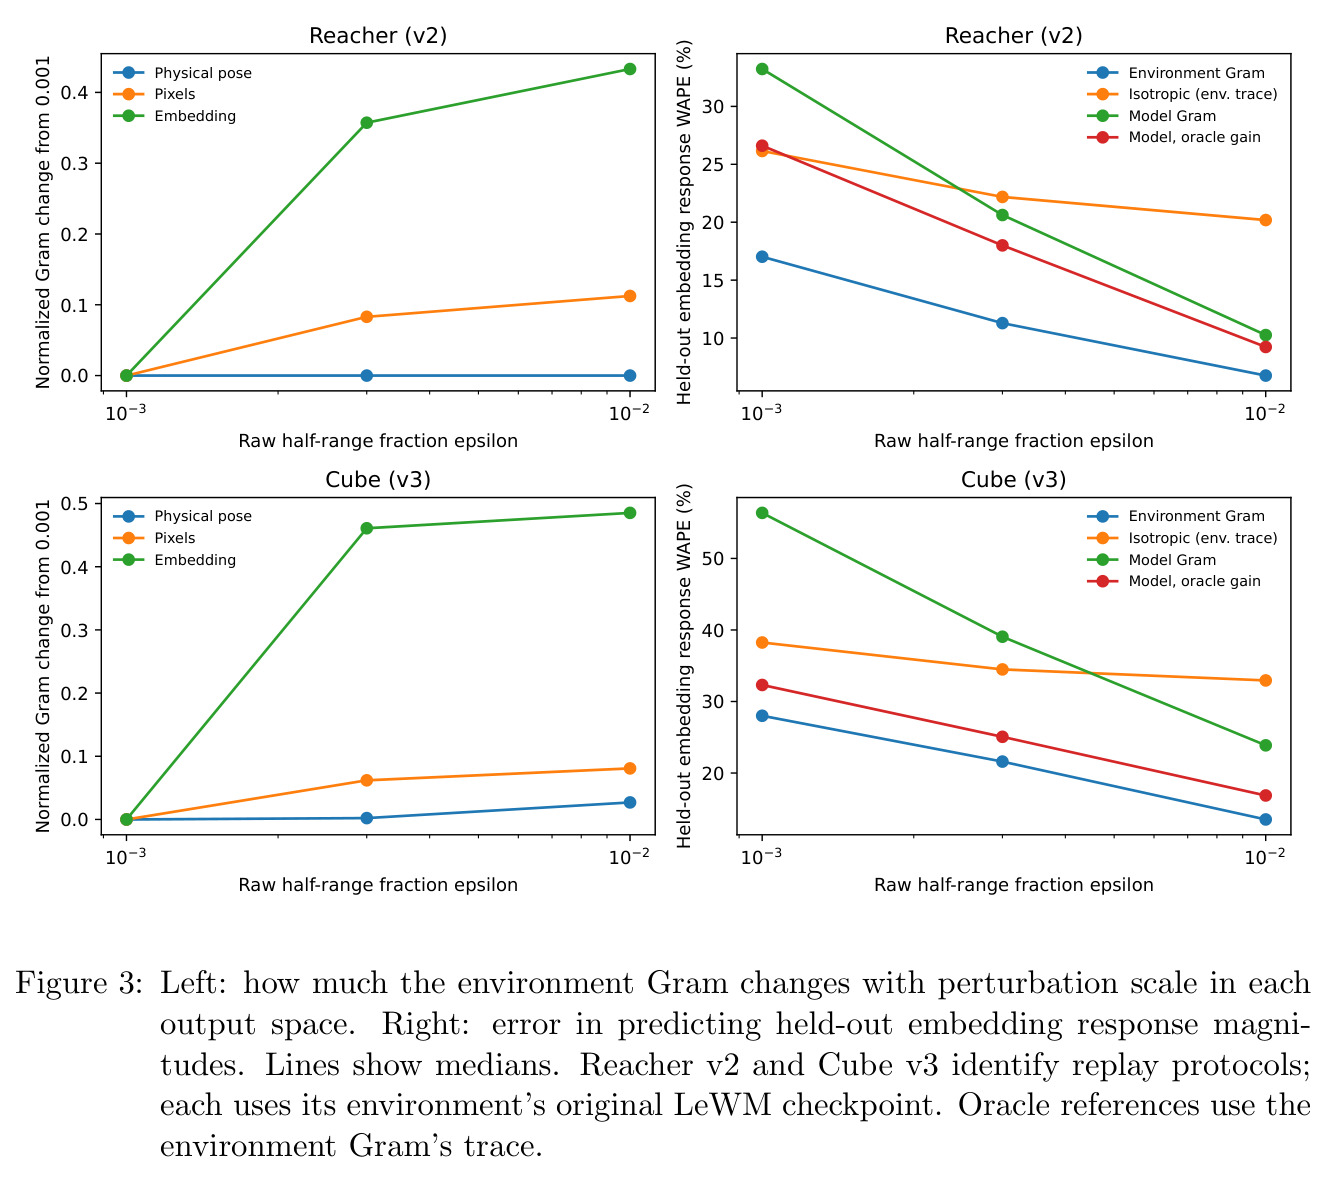
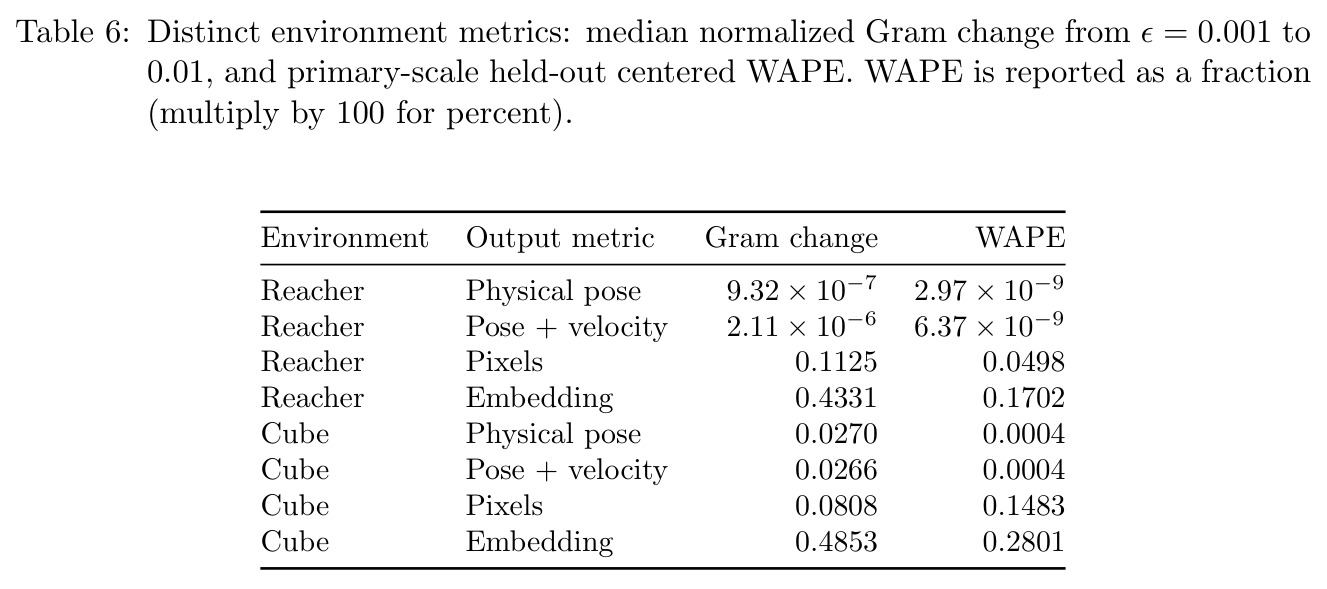
技术新颖性体现在四个层面。第一,尺度绑定评估:论文证明十倍扰动使中位 $D_G$ 在 Reacher 降约 70%、Cube 降约 47%,且同一环境响应在物理位姿几何下随尺度变化低于百万分之一、而像素与嵌入几何变化分别约 0.11/0.43(Reacher)与 0.03/0.08/0.49(Cube),说明「局部线性」假设在不同输出空间成立程度不同——任何几何结论都必须声明测量尺度与输出空间。第二,增益/形状分解:迹归一化丢弃公共增益,oracle 实验再把增益单独归还,从而把 Cube 模型 56.4% 的 WAPE 分解为约 24 个百分点的增益误差加剩余形状误差。第三,可解释的参照系:三个参照分别删除不同信息源,使「优于参照」有明确含义,而不是与随机基线的空洞比较。第四,协议透明:论文公开记录了动作对齐、输出坐标与状态恢复的审计过程、重放异常与协议变更(附录 C、D.4),并用修订后的结果取代早期结果,这种自我纠错在 workshop 论文中少见。
实验结果
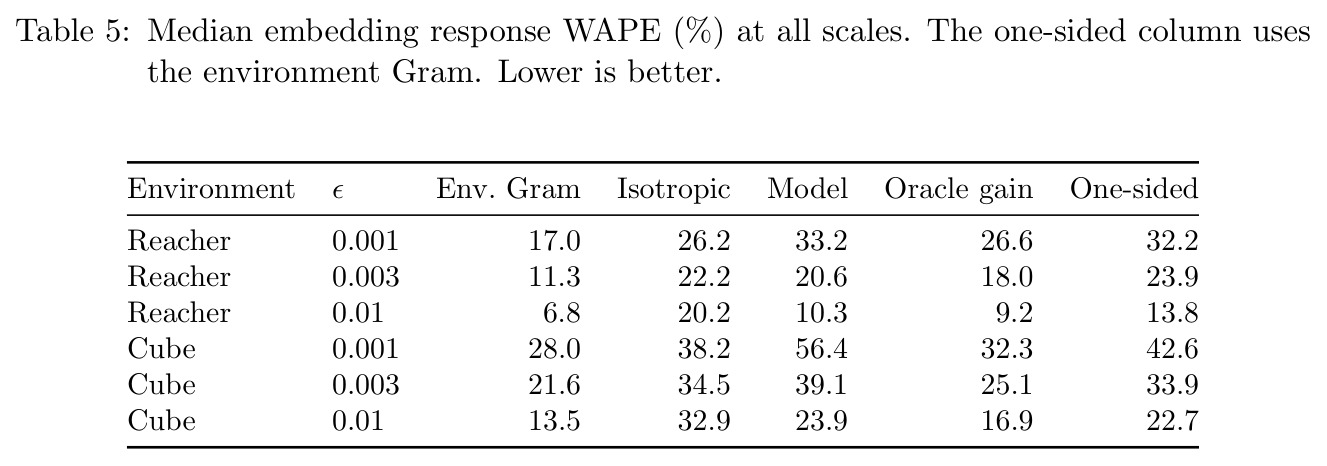
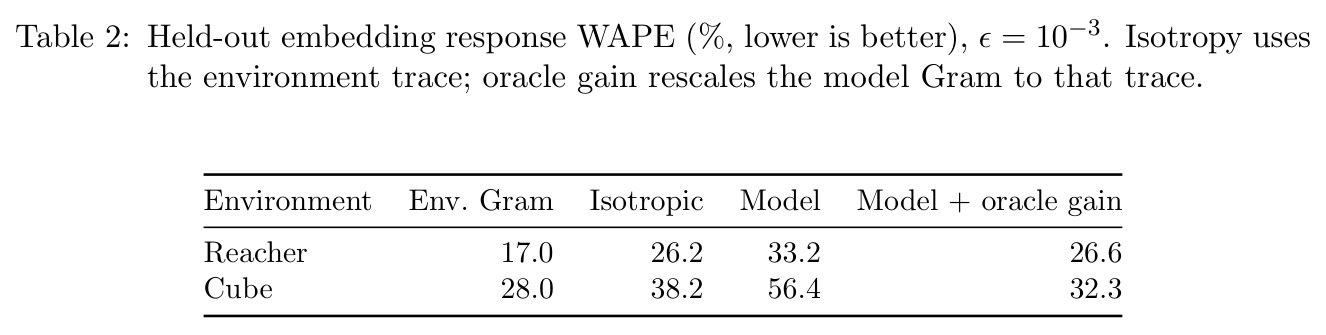
主尺度 ε=10⁻³ 下模型与环境的敏感方向明显失配:最敏感动作方向的中位夹角在 Reacher 约 36°、Cube 约 42°,Cube 前两个特征向量张成的子空间另约有 40° 失配;中位 $D_G$ 分别为 0.465(95% 区间 [0.423, 0.500])与 0.508([0.487, 0.529])。条件数:Reacher 环境与模型都接近 4.5,各向异性程度相似但方向不同;Cube 模型条件数约为环境的 4 倍,且数值下限影响约三分之一的 Cube 环境矩阵。校准(Table 1):Cube 模型 0.508 低于打乱状态 0.560、各向同性 0.609、随机旋转 0.885;Reacher 模型 0.465 优于旋转 0.632 和打乱 0.530,但各向同性 0.449 更接近环境度量。配对「模型减打乱」中位差为 Cube −0.059([−0.074, −0.029])、Reacher −0.047([−0.071, −0.014]);绝对敏感度比 $\mathrm{tr}(G^{\mathrm{model}})/\mathrm{tr}(G^{\mathrm{env}})$ 约为 Cube 一半、Reacher 五分之四。十倍扰动使 $D_G$ 降约 70%(Reacher)与 47%(Cube);同一环境响应的物理位姿几何随尺度变化低于百万分之一(Reacher),像素与嵌入约 0.11/0.43(Reacher)、0.03/0.08/0.49(Cube)。held-out 验证(Table 2):环境 Gram 中位 WAPE 17.0%/28.0%,各向同性 26.2%/38.2%,模型 33.2%/56.4%;oracle 环境迹降至 26.6%/32.3%,Cube 降约 24 个百分点,说明模型误差主要来自增益而非形状。物理位姿预测 WAPE 均低于 0.04%,像素约 5%/15%,单侧嵌入位移 32%/43%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Reacher 局部几何对齐(ε=10⁻³) | 中位迹归一化 Gram 差异 $D_G$(越低越好) | LeWM 0.465(95% 区间 [0.423, 0.500]) | 各向同性 0.449;打乱状态 0.530;随机旋转 0.632 | 优于旋转与打乱参照,但比各向同性高 0.016,说明在该环境学到的几何信息增量有限 |
| OGBench Cube 局部几何对齐(ε=10⁻³) | 中位 $D_G$(越低越好) | LeWM 0.508(95% 区间 [0.487, 0.529]) | 打乱状态 0.560;各向同性 0.609;随机旋转 0.885 | 低于全部三个参照,最接近的打乱状态参照也高出 0.052 |
| Reacher held-out 响应幅度预测(ε=10⁻³) | 中位 WAPE(%,越低越好) | 环境 Gram 17.0;模型 Gram 33.2;模型+oracle 增益 26.6 | 各向同性参照 26.2 | 环境 Gram 比各向同性低 9.2 个百分点;模型 Gram 即便修正增益后仍高 0.4 个百分点 |
| OGBench Cube held-out 响应幅度预测(ε=10⁻³) | 中位 WAPE(%,越低越好) | 环境 Gram 28.0;模型 Gram 56.4;模型+oracle 增益 32.3 | 各向同性参照 38.2 | 环境 Gram 低 10.2 个百分点;oracle 增益把模型误差从 56.4 拉到 32.3(降约 24 个百分点),但仍差于环境 Gram |
局限与改进
作者承认并可观察到的局限包括:其一,每个环境只评估一个公开检查点、全程无训练,无法估计跨种子方差,「LeWM 的几何失配是否普遍」存疑。其二,Cube 的重放协议在审计后被迫变更(图像差异),作者明确表示这限制可复现性声明,早期 50 状态子集的重复结果与修订结果不可互换。其三,数值下限影响约三分之一 Cube 环境矩阵,特征值上尾估计需谨慎;物理响应中的离群点被保留(附录 D)。其四,Gram 是无符号量:若 $J^{\mathrm{model}}=-J^{\mathrm{env}}$,两个 Gram 完全相等而动作效果完全相反,因此对训练与控制的影响仍是开放问题;五步动作块共享同一偏移 $u$,也无法分解时间维度上的误差责任。其五,实验只有 $d=2$ 与 $d=5$ 两个环境,向图像观测主导或更高维动作空间的外推未知;嵌入空间几何部分继承自共享冻结编码器,动力学误差与编码器误差并未被完全分离。
独立分析的弱点
独立分析可见几个弱点。第一,共享冻结编码器把环境与模型的测量绑定在同一嵌入空间,嵌入几何误差可能来自编码器对渲染帧的敏感度而非 LeWM 动力学本身——论文也承认渲染、编码与非线性动力学的各自贡献未解决;改进方向是用在环境与模型输出上分别训练的轻量探针做消融,分离三种来源。第二,迹归一化丢弃增益,而模型绝对敏感度只有环境的一半(Cube)到五分之四(Reacher);对依赖幅度比较的规划器(如 CEM 对采样动作排序)而言,欠敏感可能比方向失配更致命,但论文完全没给出控制层面的证据。第三,held-out 验证每状态仅 8 个球面方向,对 $d=5$ 的 Cube 远不足以约束整个 $5\times5$ 的 Gram;应增加方向数并做方向分布的敏感性分析。第四,只测幅度不测符号:$J$ 取负或施加旋转都可能在 Gram 上隐形,而这恰恰是对控制最要命的错误,应补配对符号相关或目标导向响应实验。第五,Reacher 上模型竟不敌各向同性参照,作者只用一句「信息量有限」带过,缺少对失败模式(如接触动力学、渲染混淆)的深入归因。
未来方向
作者提出的方向:评估带符号的目标导向响应(而非只有幅度的 Gram)以及闭环控制性能,以确定更好的敏感度估计是否真能改善动作选择(附录 B);增加检查点与训练种子以估计几何指标在训练过程中的方差。基于本文成果可延伸的工作有:把 $D_G$ 当作训练过程的诊断曲线,多检查点追踪几何演化与最终控制性能的相关性;在更高维动作空间(灵巧手、OGBench 全套任务)检验尺度效应与维度的关系;设计消融实验分解渲染、编码与非线性动力学对尺度依赖的贡献;把对称性感知的几何约束作为训练正则,鼓励模型敏感椭圆与环境对齐;以及研究增益失配的在线校正——例如用少量真实交互回归模型敏感度的整体幅度,再让规划器在校正后的度量上排序动作。
复现评估
复现成本总体不高:这是纯评估工作,无需任何训练,每个环境只有一个公开检查点;算力需求只是编码器前向传播级别的调用加线性代数运算,约 958 个锚点、每个坐标 2 个方向、3 个尺度,总查询量在数千到万级,单 GPU 数小时内可完成。所需的材料包括 Reacher 与 OGBench 模拟器、用于恢复锚点状态的原始数据集回合,以及回合 bootstrap 与参照抽样的实现(附录 A 给出定义)。难点在协议细节:论文指出经审计后必须在当前模拟器中重新生成轨迹,Cube 还因图像差异改变了重放协议(附录 C、D.4),因此早期结果与修订结果不可互换,完全复现作者的实验演化过程较难;但按修订后的协议复现 Table 1、Table 2 的主数字是可行的。
论文图表