LeWAM:基于 JEPA 的端到端世界与动作联合建模 LeWAM: End-to-End World and Action Modeling with JEPAs
一个模型同时学世界动力学与动作策略,规划快32倍且接触任务成功率大幅领先
前置知识
JEPA(联合嵌入预测架构)
JEPA 是一种自监督学习范式:模型在潜在空间中预测未来(或被遮挡部分)的表征,而不是重建原始像素。给定当前观测的编码 $z_t$,模型预测目标观测的表征 $z_{t+K}$,并用 MSE 等距离度量约束预测。由于不需要昂贵的像素解码,JEPA 学到的是压缩、抽象的世界表征。防崩溃手段包括动量目标编码器(I-JEPA/V-JEPA)、方差-协方差约束(VICReg)或分布约束(SIGReg)。
本文 LeWAM 就是一个 JEPA:它在潜在空间预测未来状态和动作分布,不重建像素。理解 JEPA 的'预测表征而非像素'思想是读懂其训练目标、SIGReg 正则和防崩溃讨论的前提。
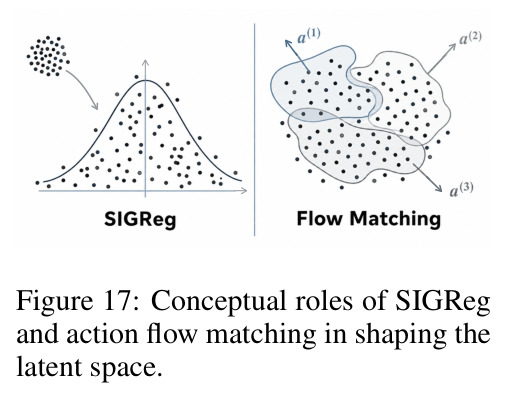
SIGReg(各向同性高斯分布正则)
SIGReg(LeJEPA,Balestriero & LeCun 2025)通过把 batch 中latent 的经验分布约束为各向同性高斯 $\mathcal{N}(0,I)$ 来防止表征崩溃。做法是采样 $M$ 个随机单位方向 $u^{(m)}$,把投影 $Zu^{(m)}$ 视为一维样本,用 Epps–Pulley 正态性检验统计量 $T$ 度量其偏离 $\mathcal{N}(0,1)$ 的程度,以 $\mathcal{L}_{sig}=?rac{1}{M}\sum_m T[Zu^{(m)}]$ 作为正则项。相比 VICReg 的多项启发式,它理论更简洁、只需一个权重。
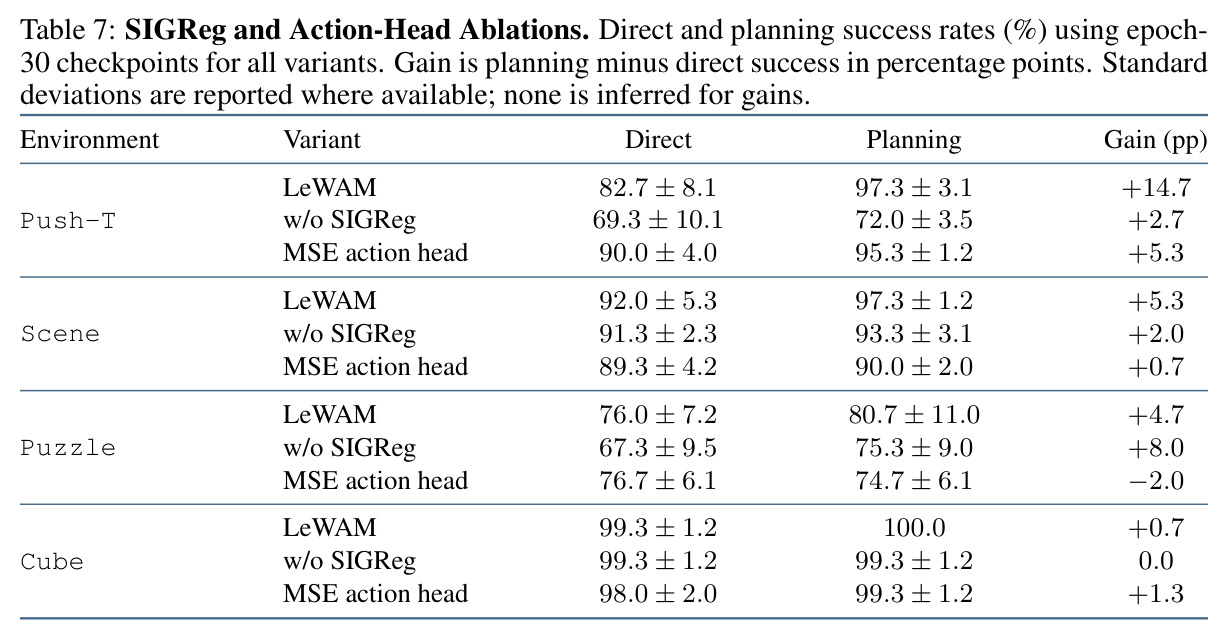
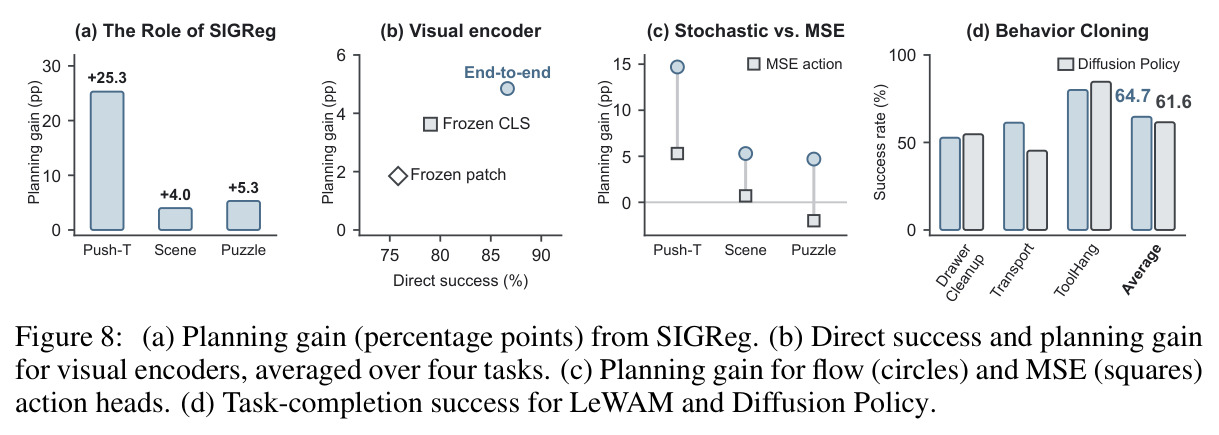
LeWAM 与基线 LeWM 都靠 SIGReg 从头训练编码器而不崩溃。论文消融显示去掉 SIGReg 后 Push-T 规划成功率下降 25.3 个百分点,理解它才能理解表征质量与规划性能的关联。
Flow Matching(流匹配)
流匹配是一种连续归一化流式的生成建模方法:定义从噪声 $\epsilon\sim\mathcal{N}(0,I)$ 到数据 $A$ 的线性插值路径 $A^{(s)}=(1-s)\epsilon+sA$,其速度场为 $v=A-\epsilon$。网络输入加噪样本和流时刻 $s\in[0,1]$,回归该速度场;推理时从纯噪声出发用 Euler 法积分常微分方程(ODE)数步即可采样。相比扩散模型路径更直、步数更少,且能表达多模态条件分布。
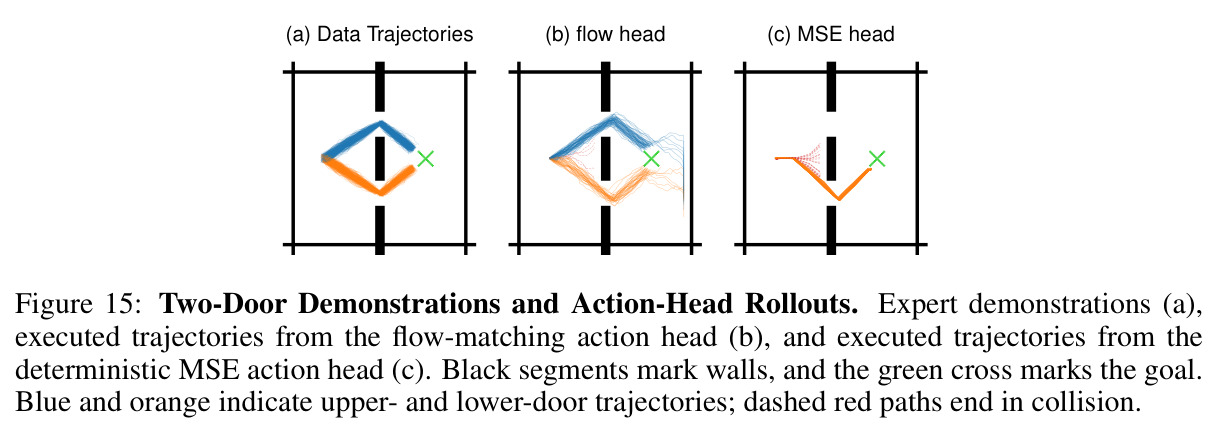
LeWAM 的策略头就是动作 chunk 上的流匹配模型,直接控制时积分 8 个 Euler 步采样动作。它让模型学到多模态动作分布(two-door 实验的关键证据),这是与 MSE 回归策略的本质区别。
CEM(交叉熵方法)与基于采样的规划
CEM 是世界模型常用的在线规划求解器:维护动作序列上的高斯分布,每轮采样一批候选(如 300 个)、在学到的动力学上 rollout、按目标代价选出精英集合、拟合新分布,迭代 30 轮左右。它的先验是宽高斯,与任务无关,因此需要大量模型调用;动作维度和规划时域增大时开销急剧上升,且在接触切换等非平滑动力学上局部优化容易失效。
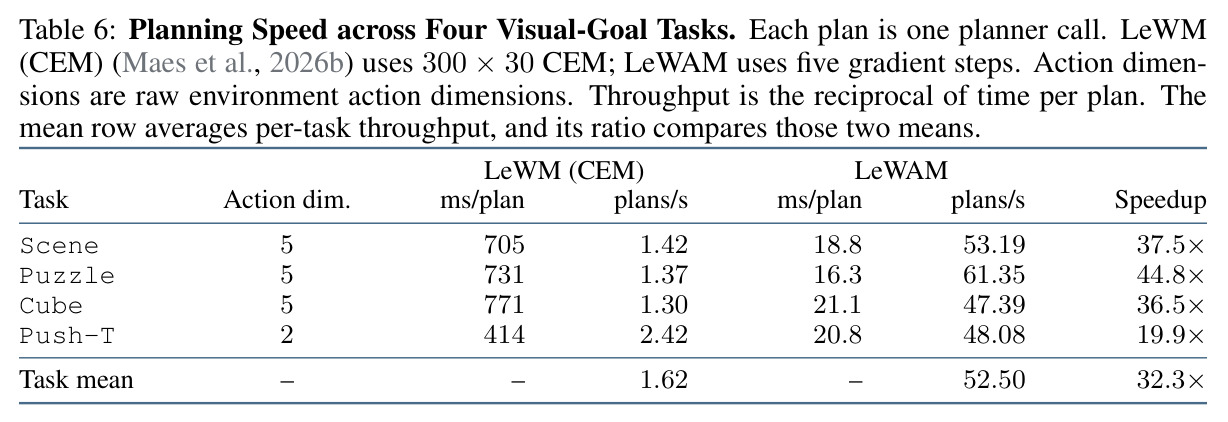
本文的对比较的核心正是 CEM:LeWM (CEM) 每次规划需 414–771ms(1.62 plans/s),而 LeWAM 用学到的动作分布做提议加梯度精炼,达到 52.50 plans/s(32.3 倍加速)。理解 CEM 的瓶颈才能理解 LeWAM 规划设计的动机。
Mixture-of-Transformers(MoT)
MoT 是一种稀疏多模态 Transformer:不同模态(这里是 latent 状态与动作)各自拥有独立的 query/key/value 投影、输出投影、归一化和前馈层参数,但共享同一个掩码自注意力运算。这样各模态有专属的处理容量,又能通过注意力交换信息,同时避免某一模态的梯度主导共享权重。
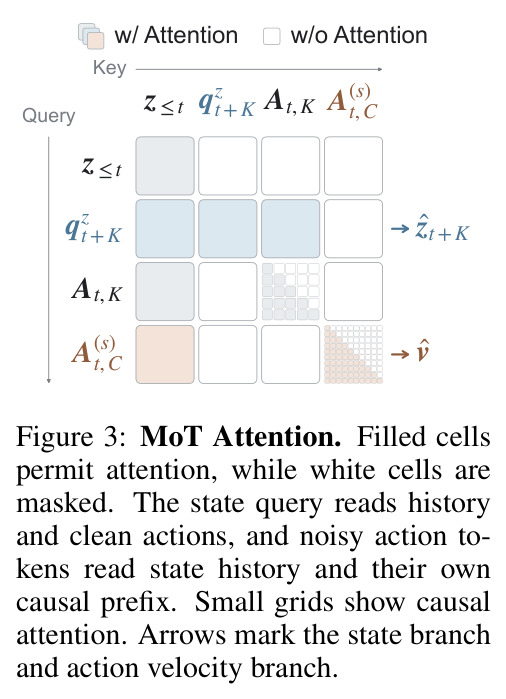
LeWAM 的预测器用 MoT 同时承载状态预测分支 $f_z$ 和动作流匹配分支 $f_a$,并通过精心设计的注意力掩码(Figure 3/10)防止 clean action 信息泄漏进策略分支。不理解 MoT 就无法理解其架构与信息流设计。
目标条件视觉规划与滚动时域 MPC
给定目标图像,智能体把当前观测和目标都编码到潜在空间,规划器在学到的动作条件动力学上想象未来 latent 轨迹,最小化潜在距离代价 $\mathcal{C}(A)= ext{MSE}(\hat{z}_{t+L}, z_g)$。执行前几步动作后观测新状态、重新规划,即滚动时域(receding-horizon)模型预测控制。评估通常用固定步数预算内的 goal-reaching 成功率。
LeWAM 的主实验就是十环境目标图像到达任务,评估协议(goal offset、执行预算、成功判据)和它的'采样-精炼'规划循环都是围绕这一范式构建的,是读懂第 4 节实验的框架。
研究动机
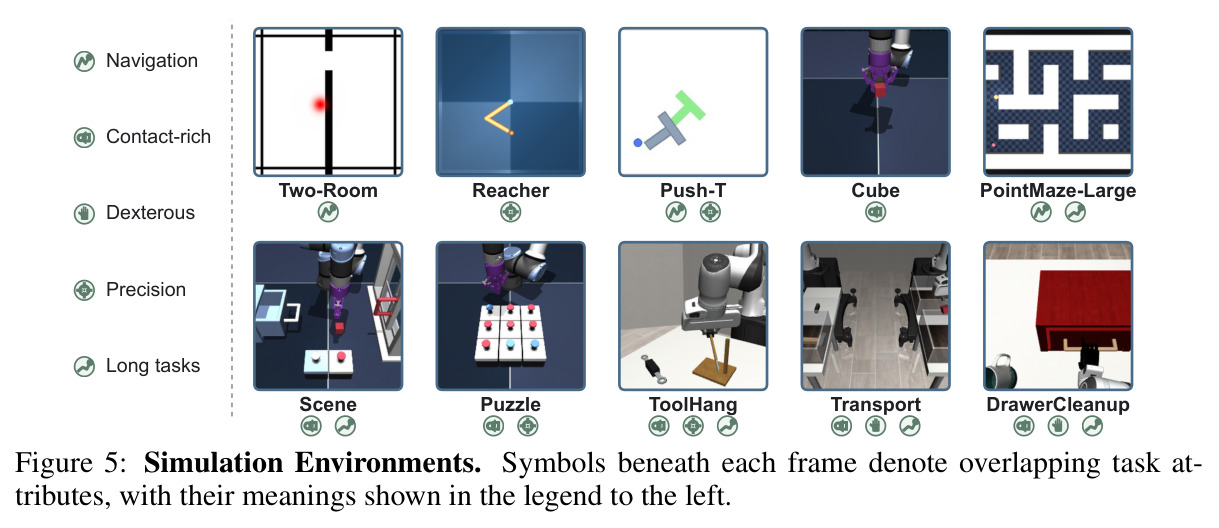
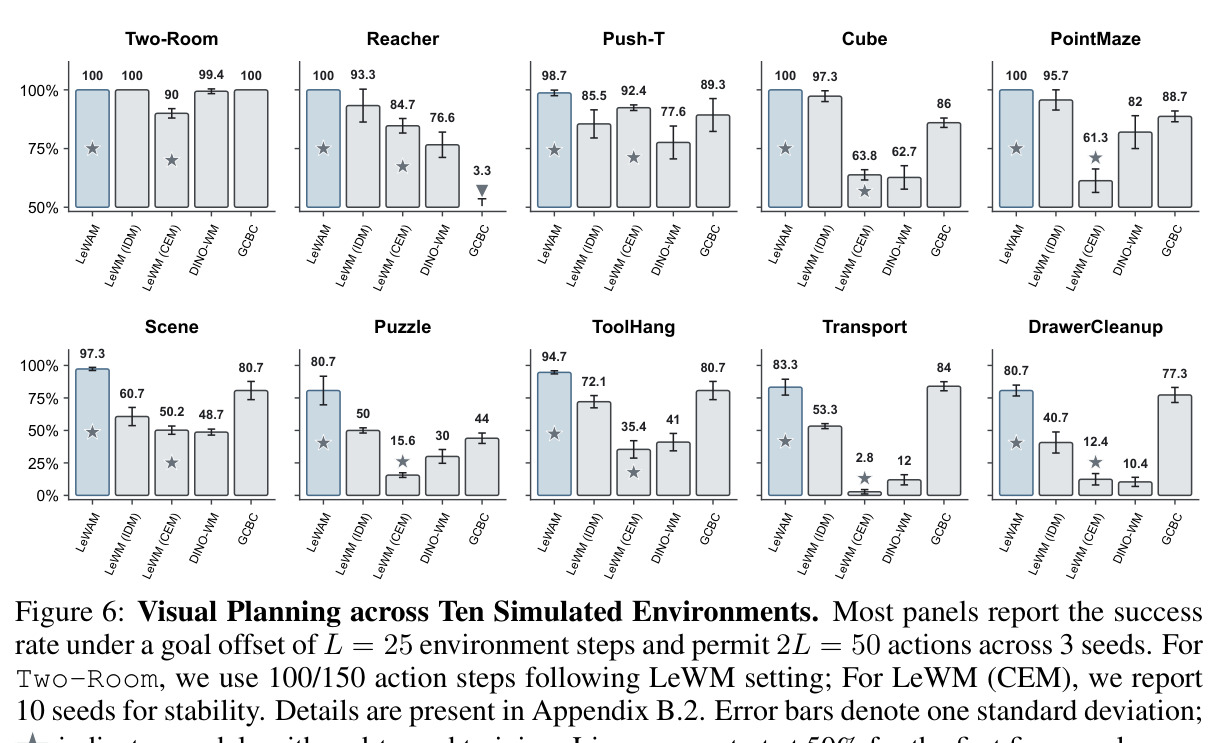
现有 JEPA 世界模型控制管线(DINO-WM、LeWM 等)是分阶段的:先获得视觉表征(预训练编码器或 SIGReg 自监督训练),再训练动作条件潜在动力学,最后把控制交给通用求解器或事后训练的动作预测器。这条管线有两大具体问题。其一是表征不保证保留控制相关信息:JEPA 天然偏向时间上持续的干扰特征(Sobal et al. 2022),动作条件动力学也可能保留与决策无关的观测信息(Brandfonbrener et al. 2023);更严重的是 LeWM 在 Push-T 上去掉 SIGReg 后线性探针的 Object/Proprio/Action $R^2$ 全部崩到 0.00,说明表征极不稳定。其二是控制效率低且在接触丰富任务上失效:CEM 从与任务无关的宽高斯先验出发采样动作序列,随着动作维度(本文最高 24 维)和规划时域增长需要海量 rollout,实测 LeWM (CEM) 每次规划耗时 414–771ms、仅 1.62 plans/s;而抓取-悬挂(ToolHang)、双臂传递(Transport)这类接触丰富任务中,接触事件会使动力学在模式间切换,附近动作产生截然不同的后果——若有限种群采样不到有效的接触分支,基于物体位置的目标代价几乎给不出排序信号,LeWM 在 25 步 goal offset 下 Transport 成功率只有 2.8%、ToolHang 只有 35.4%,100 步长时程下平均成功率仅 10.9%。
本文的目标是本文要构建一个单一、紧凑(约 16.9M 参数)、完全端到端的 JEPA——LeWAM,在无奖励离线轨迹(像素观测+动作)上一次训练同时学到三样东西:控制相关的视觉表征、动作条件的潜在动力学、以及随机动作策略。同一模型要支持两种互补的控制模式:(1)直接策略执行——积分学到的速度场直接采样动作 chunk 执行,绕过在线规划;(2)高效视觉规划——以学到的动作分布作为提议先验,采样候选计划后用梯度下降穿过学习到的潜在动力学做精炼,取代 CEM 的宽高斯种群搜索。量化目标是在十个异构仿真环境(含接触丰富和长时程任务)上大幅超越 LeWM/DINO-WM 等 JEPA 基线的 goal-reaching 成功率并实现数量级的规划加速,同时在目标无关的行为克隆任务(仿真与物理机器人)上与 Diffusion Policy、$\pi$0.5 等成熟方法竞争。
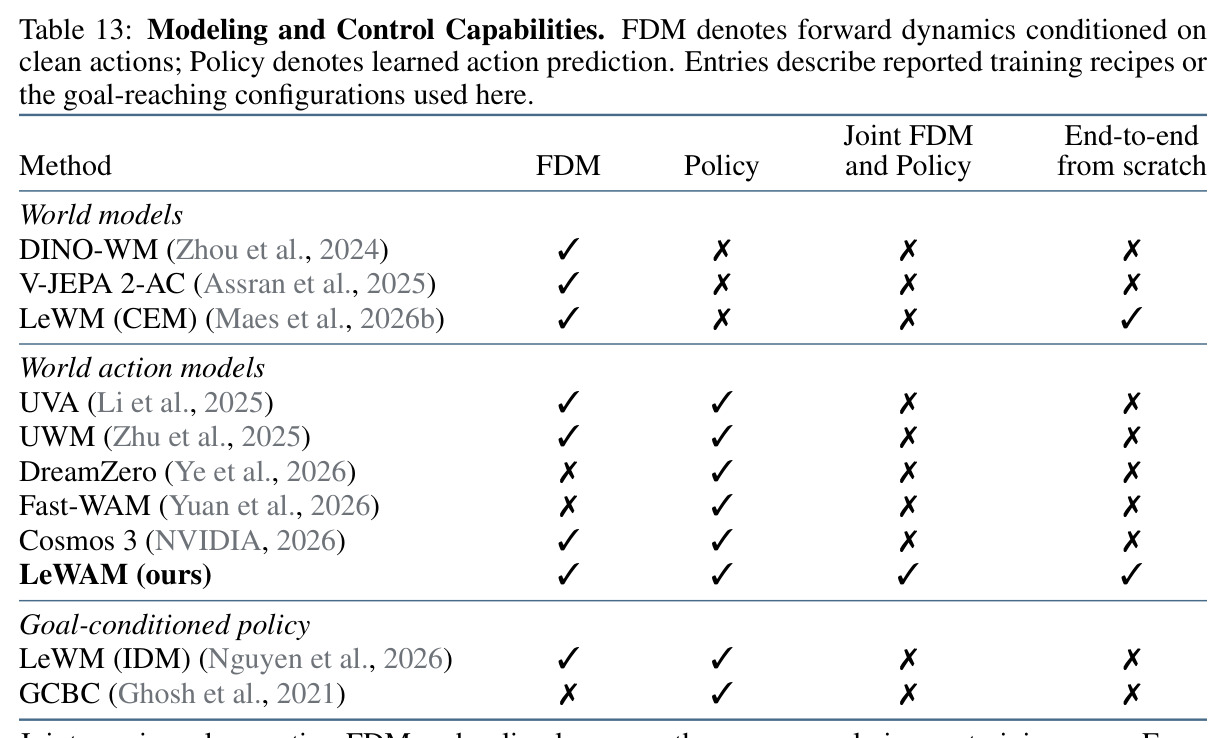
与已有工作不同的是,本文的独特切入是'联合预测':让同一个 MoT 预测器在同一个训练样本上同时接收 clean actions(做前向动力学预测)和 noisy actions(做流匹配策略学习),两个损失共同流过共享编码器。这与已有工作的区别在于三点。第一,已有 World Action Model(UVA、UWM、Cosmos 3)虽然同时有动力学和策略头,但每个样本只优化其中一个目标(Table 13),而 LeWAM 在同一前向传播中联合优化两者,使动作监督直接塑造视觉表征;第二,GC-IDM、PRISM 等在冻结的 JEPA 特征上后训练动作预测器,动作监督与表征学习完全脱节,LeWAM 则从像素开始端到端训练、无预训练无重建;第三,在规划侧,以往 JEPA 控制把策略与规划视为二选一(直接执行或 CEM 搜索),LeWAM 把学到的策略分布当作规划的提议先验——策略知道'在这种状态下该做什么',规划只需在其附近精炼,这恰好绕开了接触丰富任务中 CEM 采样不到有效接触分支的不适定问题(附录 E 的分析,Figure 18)。
核心方法
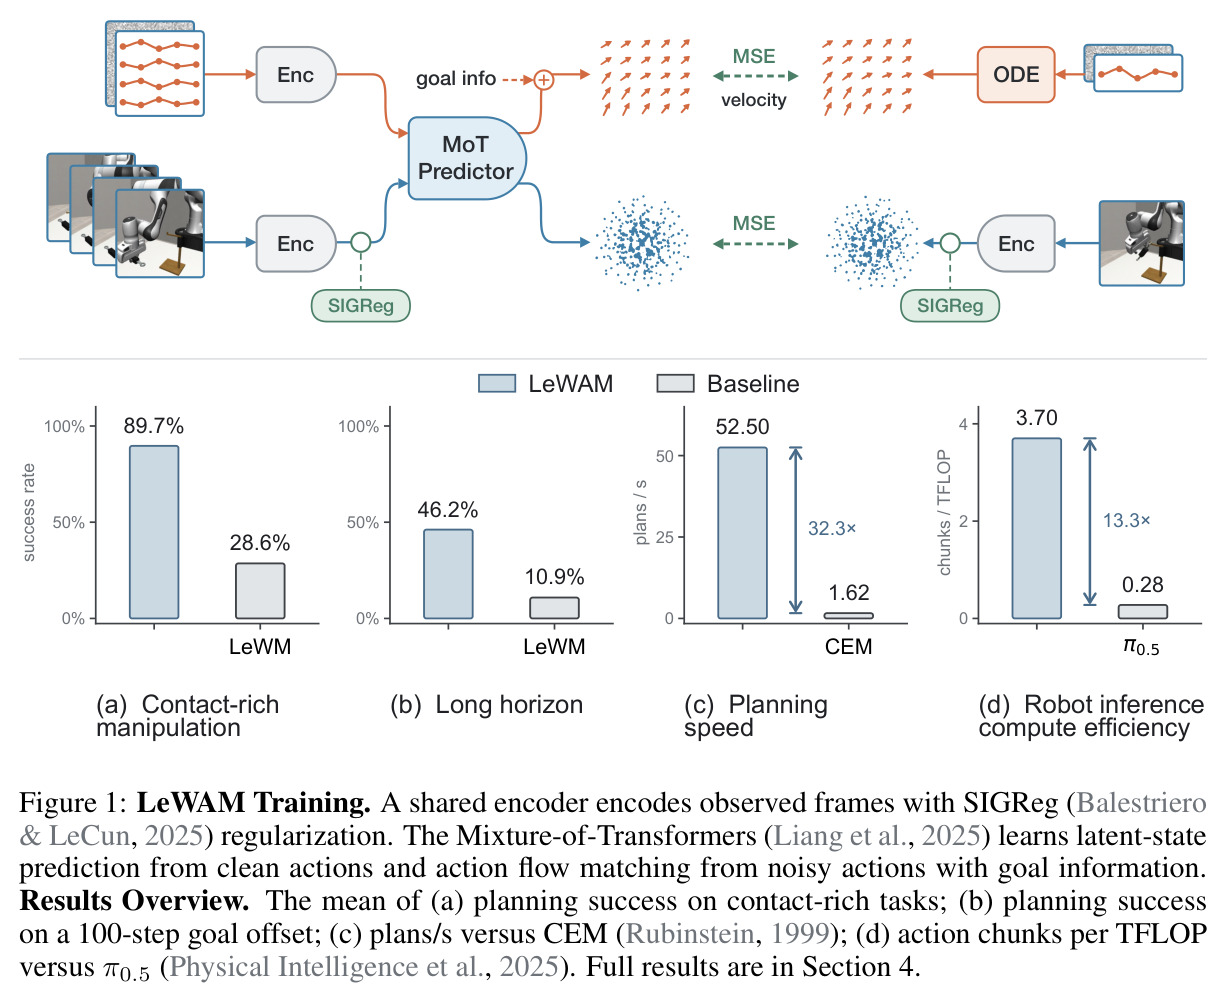
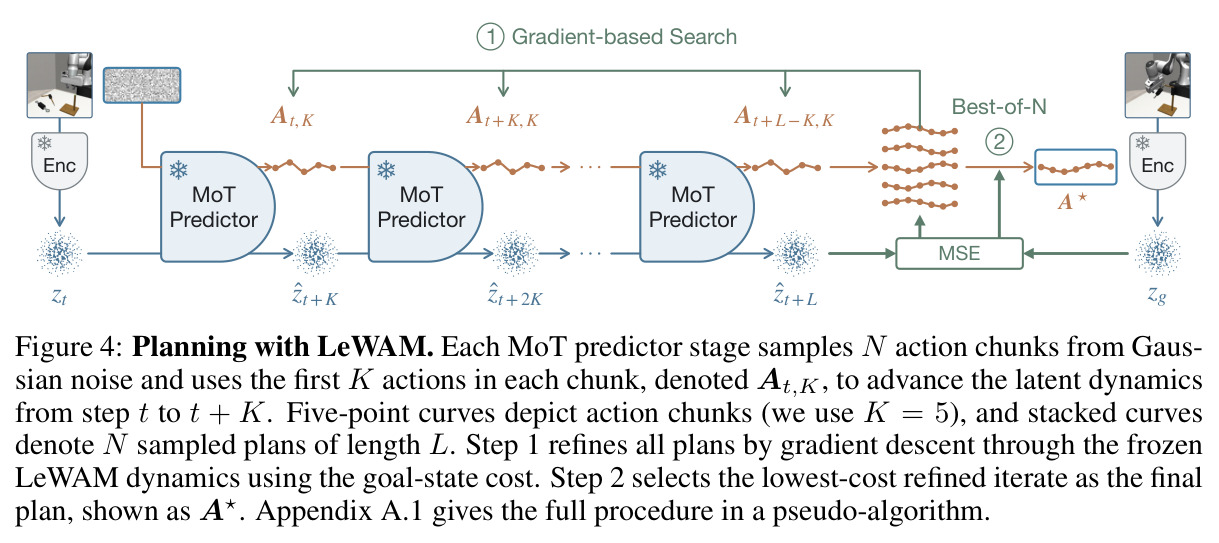
直觉上,LeWAM 想让机器人模型'既知道世界会怎样变,又知道此刻该怎么动',并且两者互相促进:动作监督把表征锚定在控制相关信息上,好的表征又让动力学预测和策略学习更准确。技术路线是:输入为无奖励离线轨迹(像素观测 $o_{1:T}$ 与动作 $a_{1:T}$)。编码器是一个从头训练的 ResNet-18(GroupNorm、224$\times$224 输入裁剪到 202$\times$202、spatial softmax 池化、两层 MLP 投影),把每帧编码为 192 维 latent $z_t=\text{Enc}(o_t)$。预测器是 MoT,含状态分支 $f_z$ 和动作分支 $f_a$:状态分支用可学习 query token $q_{z_{t+K}}$ 预测 $K=5$ 个环境步后的 latent $\hat{z}_{t+K}=f_z(q_{z_{t+K}}; z_{\le t}, A_{t,K})$;动作分支做流匹配,从加噪动作 chunk $A^{(s)}_{t,C}$($C=10$)预测速度场 $\hat{v}_{t,C}=f_a(A^{(s)}_{t,C}; s, z_{\le t}, c_t)$,目标信息 $c_t$ 含目标图像 latent $z_g$ 与归一化剩余时域。训练目标是 $\mathcal{L}_{LeWAM}=\mathcal{L}_{dyn}+\mathcal{L}_{act}+\lambda_{sig}\mathcal{L}_{sig}$,三项分别为 latent MSE、流匹配速度 MSE、SIGReg 各向同性高斯约束($\lambda_{sig}=0.04$)。推理时同一模型既能直接执行策略(8 个 Euler 步积分速度场采样动作 chunk,执行前 $K=5$ 个),也能做梯度式规划:交替'采样动作 chunk—latent 推进'生成 $N$ 个候选计划,再冻结模型对动作做 Adam 梯度下降最小化潜在目标代价,选最优者执行前 5 步并滚动重复。
核心创新是'联合预测'目标与'学习到的提议分布'的规划方式的结合,本质区别于已有方法的两个极端。一方面,以往 JEPA 世界模型(DINO-WM、LeWM、V-JEPA 2-AC)只学'后果'(动作条件动力学),动作怎么来的完全交给 CEM 这类与任务无关的求解器;LeWAM 让模型同时学'后果'和'怎么行动':$\mathcal{L}_{dyn}=\mathbb{E}[\text{MSE}(\hat{z}_{t+K}, z_{t+K})]$ 与 $\mathcal{L}_{act}=\mathbb{E}[\text{MSE}(\hat{v}_{t,C}, A_{t,C}-\epsilon)]$ 在每个样本上同时优化。这个动作监督有三重功效:其一,附录 E 用条件投影恒等式证明,若视觉历史改变条件动作速度 $\mathbb{E}[a_j-\epsilon_j\mid I_j, z_{\le t}]$,丢弃它必然升高最优回归风险,因此动作损失天然鼓励表征保留控制相关信息(探针显示相对 LeWM 的 proprio/action/IDM $R^2$ 提升 +0.21/+0.20/+0.19);其二,它充当防崩溃信号——无 SIGReg 时 LeWM 表征完全崩溃(Push-T 所有探针 $R^2=0.00$),而带动作头的 LeWAM 仍保持 0.85 以上可解码性;其三,流匹配建模的是完整条件动作分布而非条件均值,能保留'均值相近但分布不同'的状态区分(two-door 实验)。另一方面,在测试时,这个学到的动作分布成为梯度规划的高质量提议先验:CEM 需要数百次 rollout 从宽高斯里摸索有效接触分支,LeWAM 只需从策略分布采几条候选、再用 5 步 Adam 穿过学习动力学精炼,把规划从 1.62 plans/s 提到 52.50 plans/s。
方法步骤详情
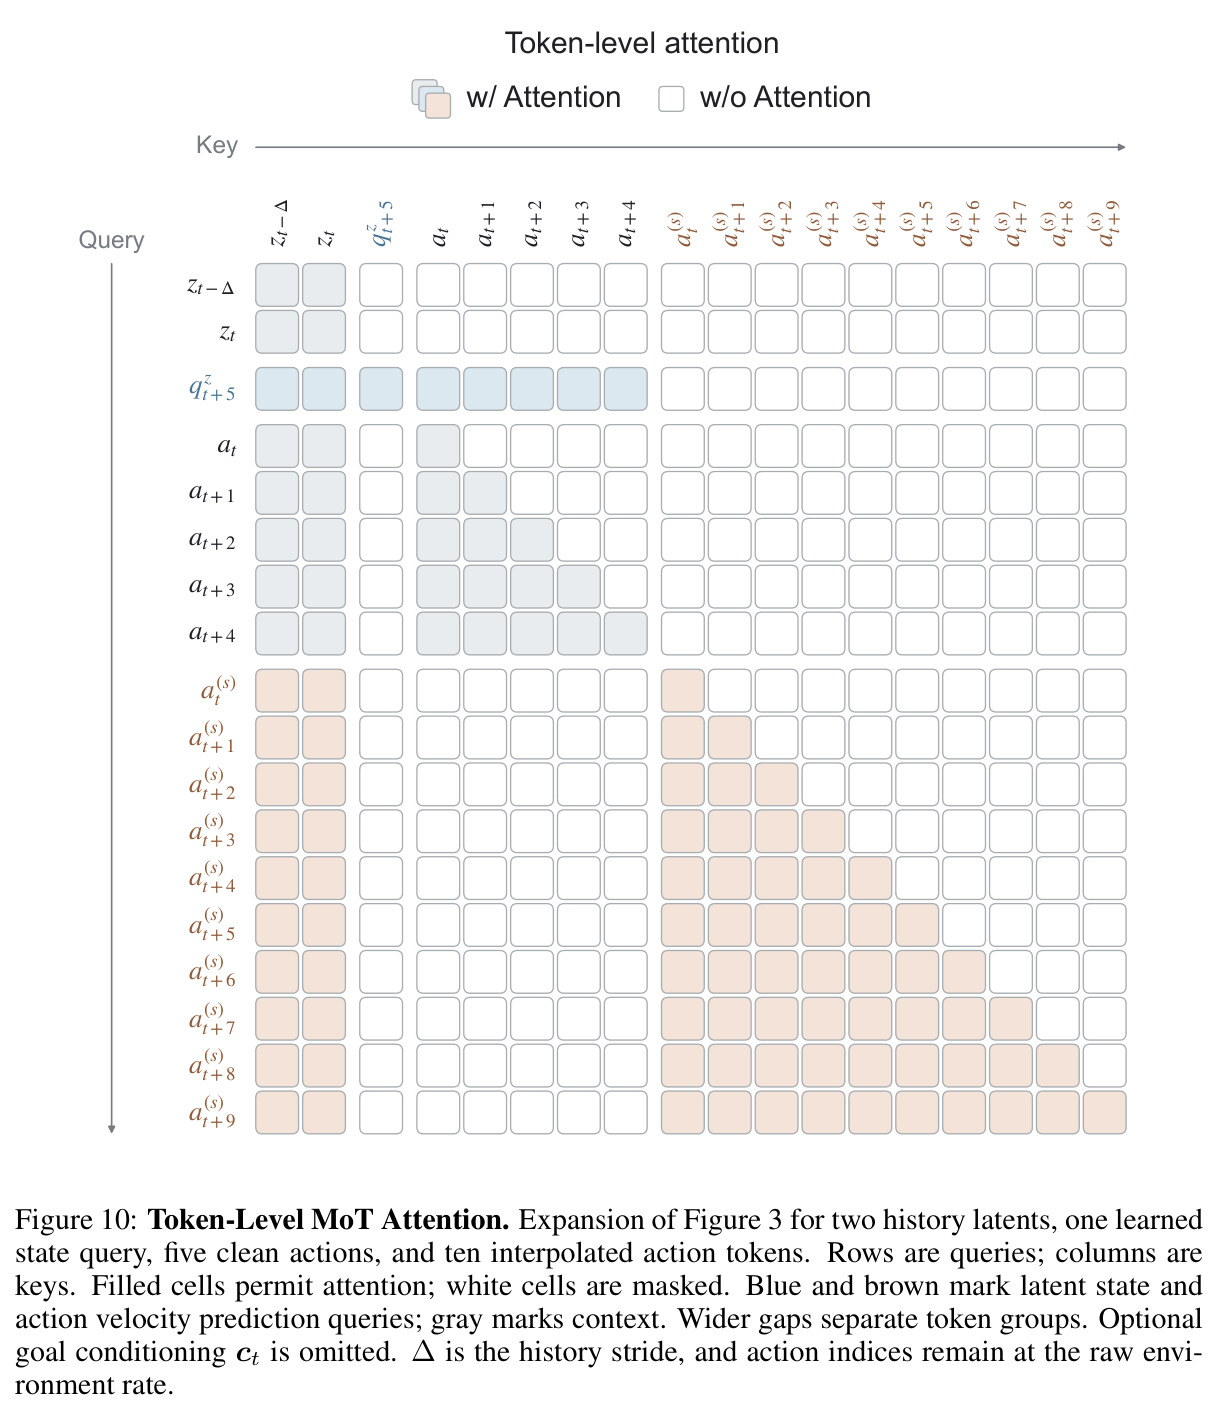
完整流程如下。第一步,数据组织:frameskip $K=5$,动作 chunk $C=2K=10$;goal-reaching 任务历史步距 $\Delta=K$,task-completion 任务 $\Delta=1$,即 MoT 输入 token 序列为 $[z_{t-\Delta}, z_t, q_{z_{t+K}}, A_{t,K}, A^{(s)}_{t,C}]$——两个历史 latent、一个学习 query、5 个 clean action token、10 个加噪动作流槽位,另有可选目标 token(仅 noisy action token 可见)和经 AdaLN-Zero 注入的归一化剩余时域。第二步,编码:ResNet-18 把每帧压成 192 维 latent,历史/目标/未来帧共用同一编码器。第三步,MoT 前向:两分支各有独立 QKV、输出投影、LayerNorm 与 FFN,共享一个掩码自注意力;掩码规则为 $V(q_{z_{t+K}})=\{z_{t-\Delta}, z_t, q_{z_{t+K}}, A_{t,K}\}$、$V(a_j)=\{z_{t-\Delta}, z_t, a_{\le j}\}$、$V(a^{(s)}_j)=\{z_{t-\Delta}, z_t, a^{(s)}_{\le j}\}$,历史 latent 只自注意,确保 clean action 信息不会跨层泄漏给策略分支。第四步,损失计算:流匹配构造 $A^{(s)}_{t,C}=(1-s)\epsilon+sA_{t,C}$、目标速度 $v_{t,C}=A_{t,C}-\epsilon$;$\mathcal{L}_{dyn}$ 为 latent MSE,$\mathcal{L}_{act}$ 为速度 MSE,$\mathcal{L}_{sig}$ 为 1024 个随机投影方向上的 Epps–Pulley 正态性统计量(17 knots),$\lambda_{sig}=0.04$。第五步,训练:goal-reaching 设 batch 128、50 epochs、AdamW 基础学习率 $1.5\times10^{-4}$、5 个 warmup epoch;task-completion 设 batch 64、120 epochs、学习率 $10^{-4}$;按验证集流匹配损失选 checkpoint(不用任务成功率)。第六步,推理——直接控制:固定历史与目标上下文,从 $A^{(0)}\sim\mathcal{N}(0,I)$ 出发积分 $\frac{dA^{(s)}}{ds}=f_a(A^{(s)}; s, z_{\le t}, c_t)$ 共 8 个 Euler 步得 $\hat{A}_{t,C}$,执行前 5 个动作后重采样。第七步,推理——规划:每个预测阶段从策略分布采 $N$ 个候选 chunk,用其前 5 个动作推进 latent 动力学、更新历史并缩短时域,重复 $L/K$ 块得到 $N$ 条完整计划 $\{A^{(n)}\}$;随后冻结模型,用 Adam(学习率 0.05、梯度裁剪 10)对动作序列最小化 $\mathcal{J}_{prox}=\text{MSE}(\hat{z}_{t+L}, z_g)+0.01\|A-A_{sample}\|_F^2$ 共 5 步(近端项防止偏离策略先验太远,动作裁剪到 $[-3,3]$),在所有候选的所有迭代中选未加罚的代价 $\mathcal{C}$ 最低者,执行前 5 个动作,观测后滚动重复。
技术新颖性
技术新颖性有四点。第一,架构身份上,据作者所知这是第一个在单次训练中联合学习视觉表征、动作条件潜在动力学与随机策略的 JEPA:Table 13 的对比矩阵显示,UVA/UWM/Cosmos 3 虽同时具备 FDM 和策略头但每个样本只优化一个目标,DreamZero/Fast-WAM 建立在预训练视频生成模型上且不做 clean-action 前向动力学,GC-IDM/GCBC 依赖冻结特征,只有 LeWAM 同时满足'Joint FDM and Policy'与'from scratch'。第二,用 Mixture-of-Transformers 承载双目标:状态和动作模态各有独立投影参数但共享掩码注意力,配合显式的 token 级掩码(Eq. 10)切断 clean action 向策略分支的信息泄漏,这一信息流设计在同类工作中是独有且必要的。第三,规划算法把'学习到的流匹配策略'作为提议先验、把'学习到的动力学'作为可微模拟器,用批量 GPU 梯度(5 步 Adam)替代 CEM 的 300$\times$30 种群评估,单次规划 16–21ms,对接触模式切换导致搜索不适定的任务特别有效——这是对'策略与规划二选一'范式的融合而非替代。第四,训练配方极简:无像素重建、无预训练、无奖励、无动量目标编码器,仅一个 SIGReg 权重 $\lambda_{sig}=0.04$,全程约 16.9M 参数,是强基线 LeWM(15M)同量级的小模型。
实验结果
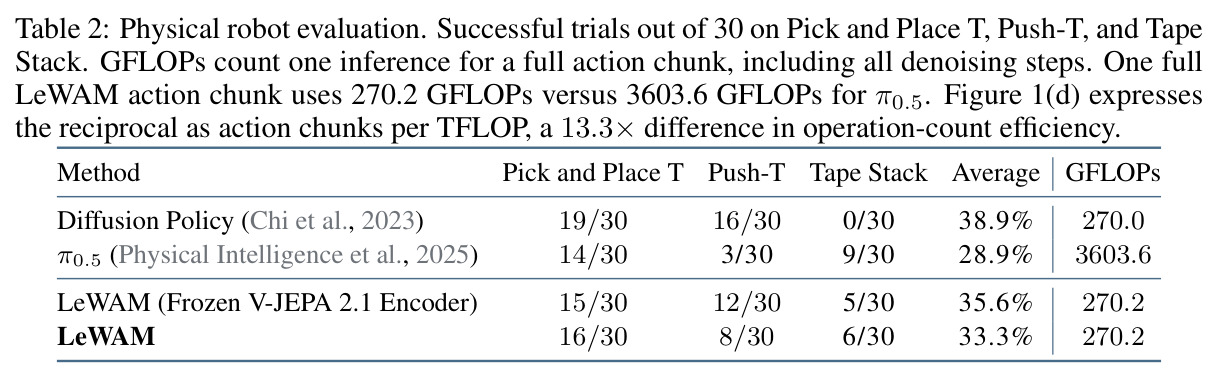
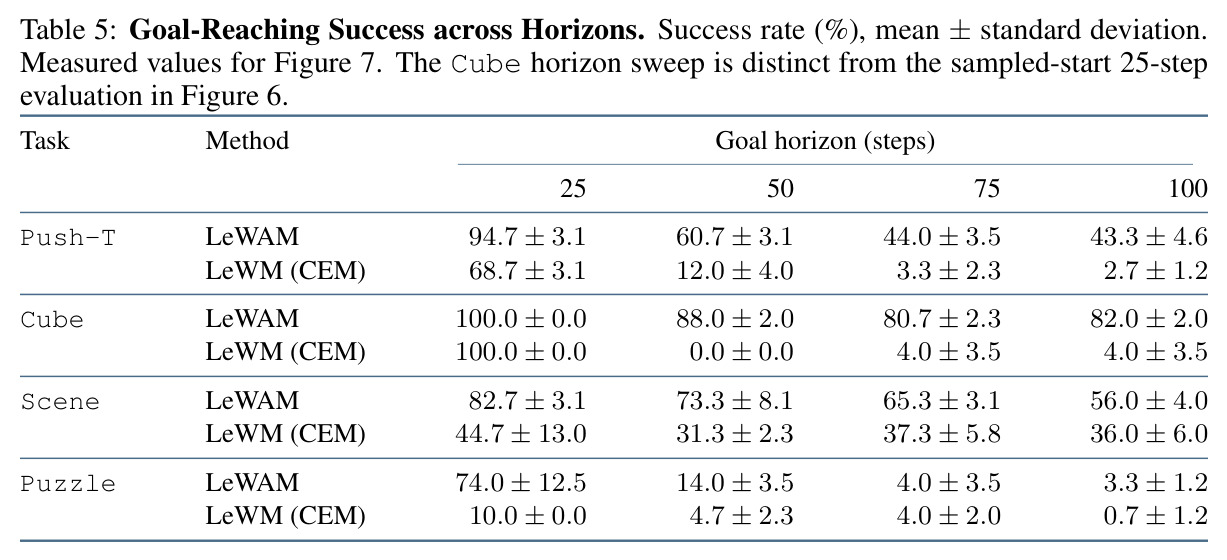
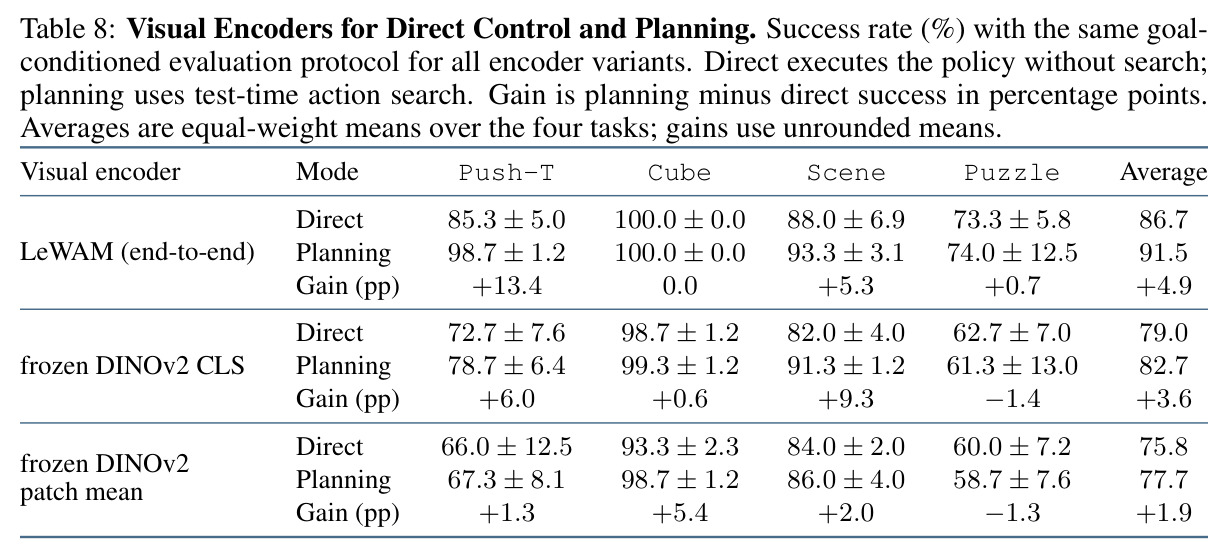
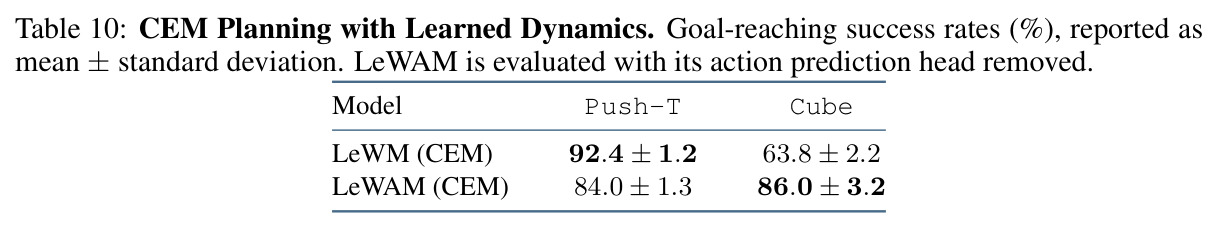
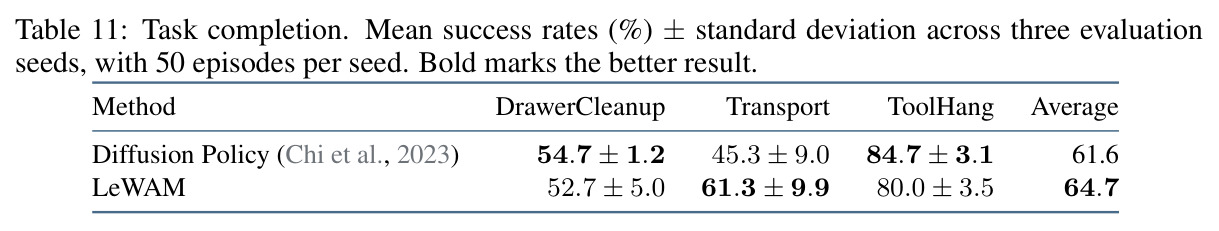
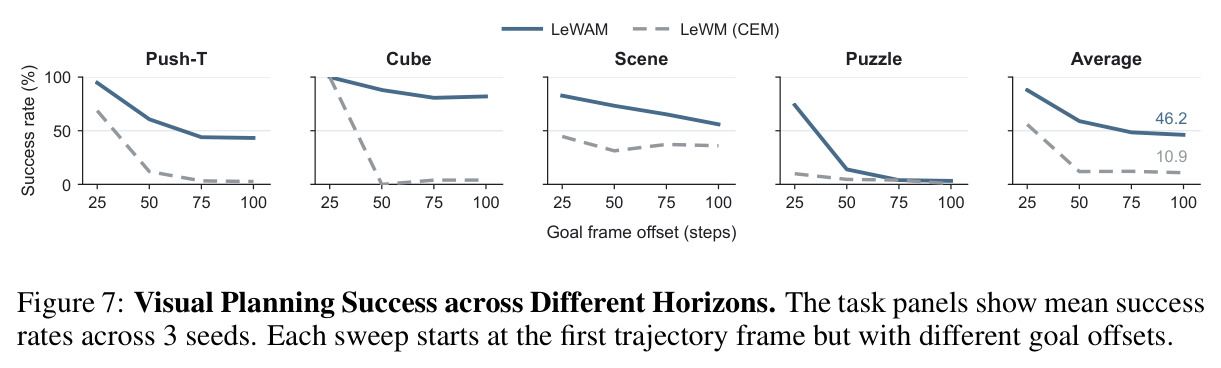
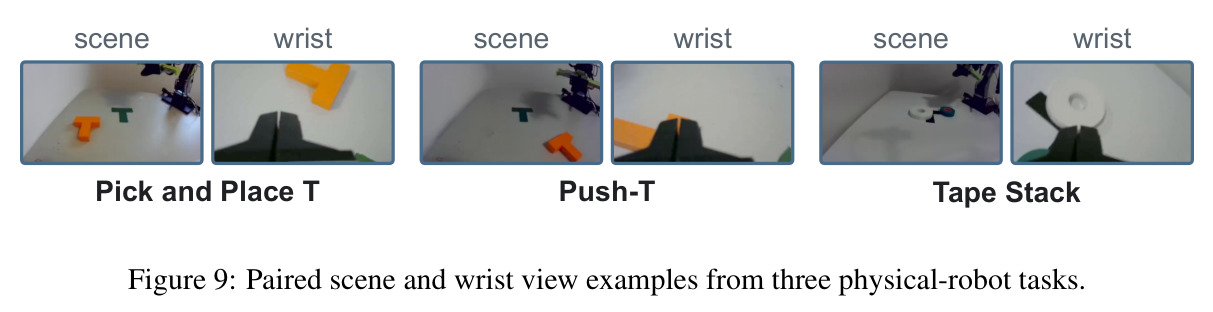
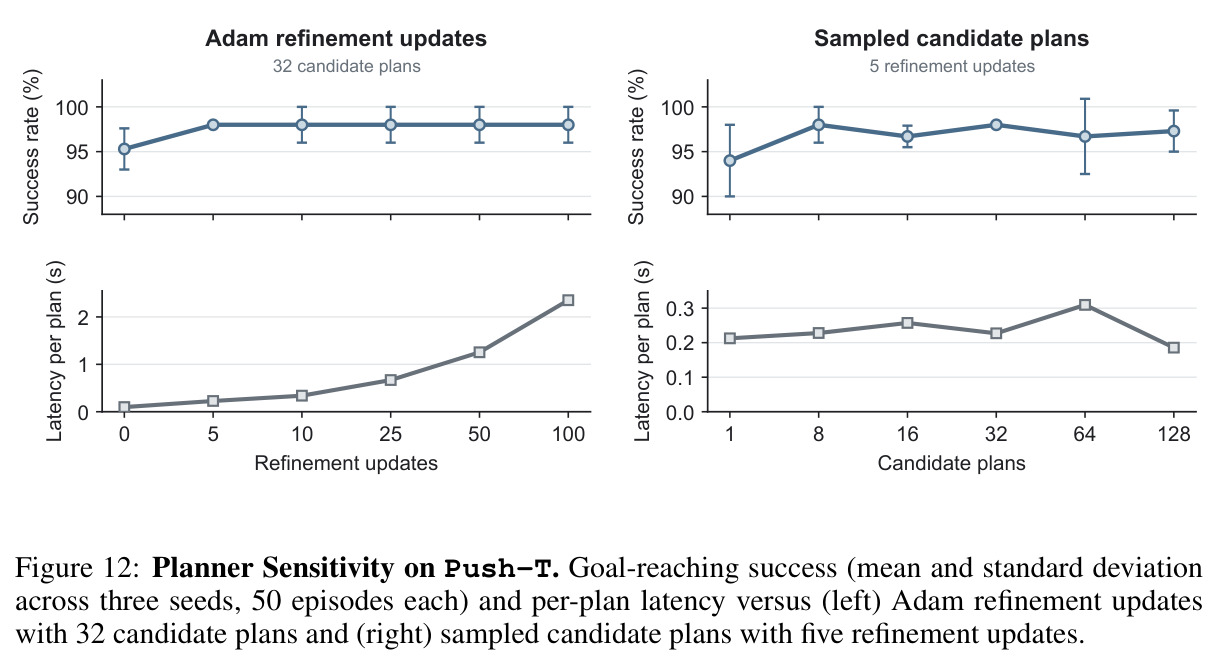
核心发现按实验逐一分析。(1)目标图像视觉规划(25 步 goal offset、50 动作预算、3 seeds$\times$50 episodes):十任务平均 LeWAM 93.5% vs LeWM (CEM) 50.9%(+42.7pp),且每个任务全胜——ToolHang 94.7% vs 35.4%、Transport 83.3% vs 2.8%、DrawerCleanup 77.3% vs 12.4%、Scene 60.7% vs 48.7%、Puzzle 80.7% vs GCBC 的 44.0%、Cube 95.7% vs 88.7%(DINO-WM)、PointMaze 98.7% 等。(2)长时程规划:从轨迹首帧出发、目标取 25/50/75/100 步后,100 步时四任务平均 LeWAM 46.2% vs LeWM 10.9%,其中 Cube 82.0% vs 4.0%、Push-T 43.3% vs 2.7%、Scene 56.0% vs 36.0%;但 Puzzle 在 100 步时仅 3.3%,暴露组合任务长时程想象的误差累积。(3)规划速度:四视觉目标任务平均 52.50 plans/s vs 1.62 plans/s(32.3$\times$),逐任务 Scene 37.5$\times$、Puzzle 44.8$\times$、Cube 36.5$\times$、Push-T 19.9$\times$;敏感性实验显示 5 次精炼步后成功率饱和、候选数超过 8 无一致增益。(4)表征探针(ridge 回归 $R^2$):LeWAM 相对 LeWM 平均提升 proprio +0.21、action +0.20、IDM +0.19;无 SIGReg 时 LeWM 在 Push-T 全部崩到 0.00 而 LeWAM 保持 Object 0.88/Proprio 0.85。(5)组件消融:去 SIGReg 使 Push-T 规划掉 25.3pp(97.3%→72.0%);端到端编码器直接控制平均 86.7% vs 冻结 DINOv2 CLS 79.0%、patch 75.8%;流匹配头 vs MSE 头在 Push-T 规划增益 +14.7pp vs +5.3pp,two-door 实验中流头保留上/下双路线而 MSE 头塌缩到下路线并撞墙。(6)纯动力学 CEM(去掉动作头):Cube 上 LeWAM 86.0% vs LeWM 63.8%(+22.2pp),Push-T 84.0% vs 92.4%(略低 8.4pp),说明联合目标基本不牺牲、甚至增强动力学质量。(7)仿真行为克隆:三任务平均 LeWAM 64.7% vs Diffusion Policy 61.6%,Transport +16pp(61.3% vs 45.3%),DrawerCleanup 52.7% vs 54.7%、ToolHang 80.0% vs 84.7% 基本持平。(8)物理机器人(reBot B601-DM,三任务各 30 次试验):LeWAM 平均 33.3%(Pick and Place T 16/30、Push-T 8/30、Tape Stack 6/30),冻结 V-JEPA 2.1 编码器变体 35.6%,Diffusion Policy 38.9%(但 Tape Stack 0/30),$\pi$0.5 仅 28.9%(Push-T 3/30);计算上单个动作 chunk 推理 LeWAM 270.2 GFLOPs vs $\pi$0.5 3603.6 GFLOPs(13.3$\times$ 差距)。总体结论:联合训练的 LeWAM 在规划类任务上大幅刷新 JEPA 基线,在模仿学习类任务上有竞争力,但物理机器人绝对成功率仍略逊于 Diffusion Policy,优势主要体现在效率与统一架构。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 接触丰富任务视觉规划(ToolHang/Transport/DrawerCleanup 等,25 步 goal offset) | goal-reaching 成功率 | 89.7%(平均) | 28.6%(LeWM CEM) | +61.1 个百分点(约 3.1 倍) |
| 长时程视觉规划(Push-T/Cube/Scene/Puzzle,100 步 goal offset) | goal-reaching 成功率 | 46.2%(平均) | 10.9%(LeWM CEM) | +35.3 个百分点(约 4.2 倍) |
| 十环境视觉规划平均 | 成功率 | 93.5% | 50.9%(LeWM CEM) | +42.7 个百分点 |
| 规划吞吐(Push-T/Cube/Scene/Puzzle 四任务平均) | plans/s | 52.50 | 1.62(LeWM CEM,300×30) | 32.3 倍加速 |
| 仿真行为克隆(DrawerCleanup/Transport/ToolHang) | 任务完成成功率 | 64.7%(平均) | 61.6%(Diffusion Policy) | +3.1 个百分点(Transport 单任务 +16pp) |
| 物理机器人行为克隆(Pick and Place T/Push-T/Tape Stack,各 30 试验) | 成功率 | 33.3%(平均) | 38.9%(Diffusion Policy)/ 28.9%(π0.5) | 落后 DP 5.6pp 但推理计算仅其 1/13.3(270.2 vs 3603.6 GFLOPs/chunk) |
局限与改进
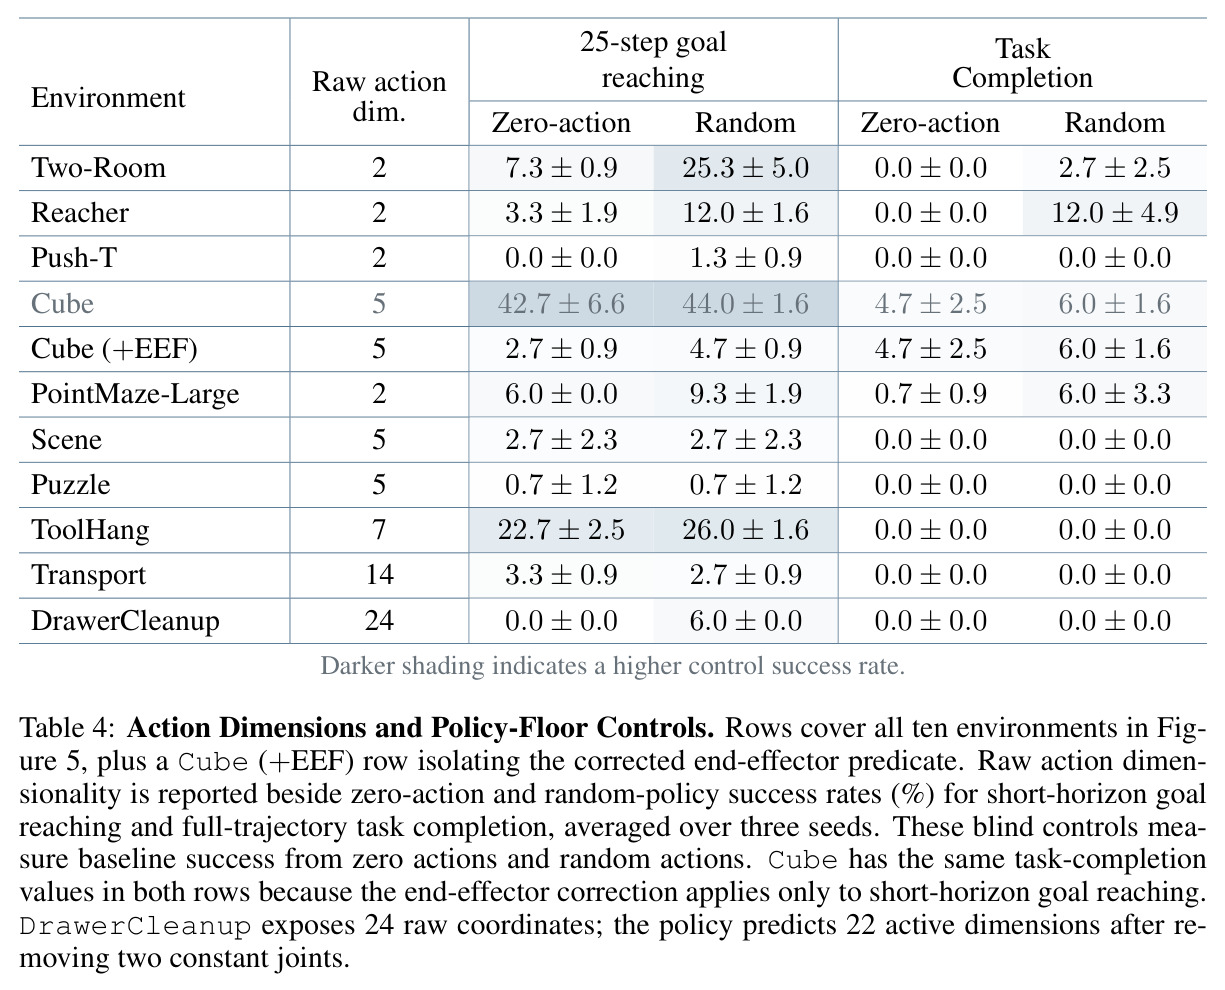
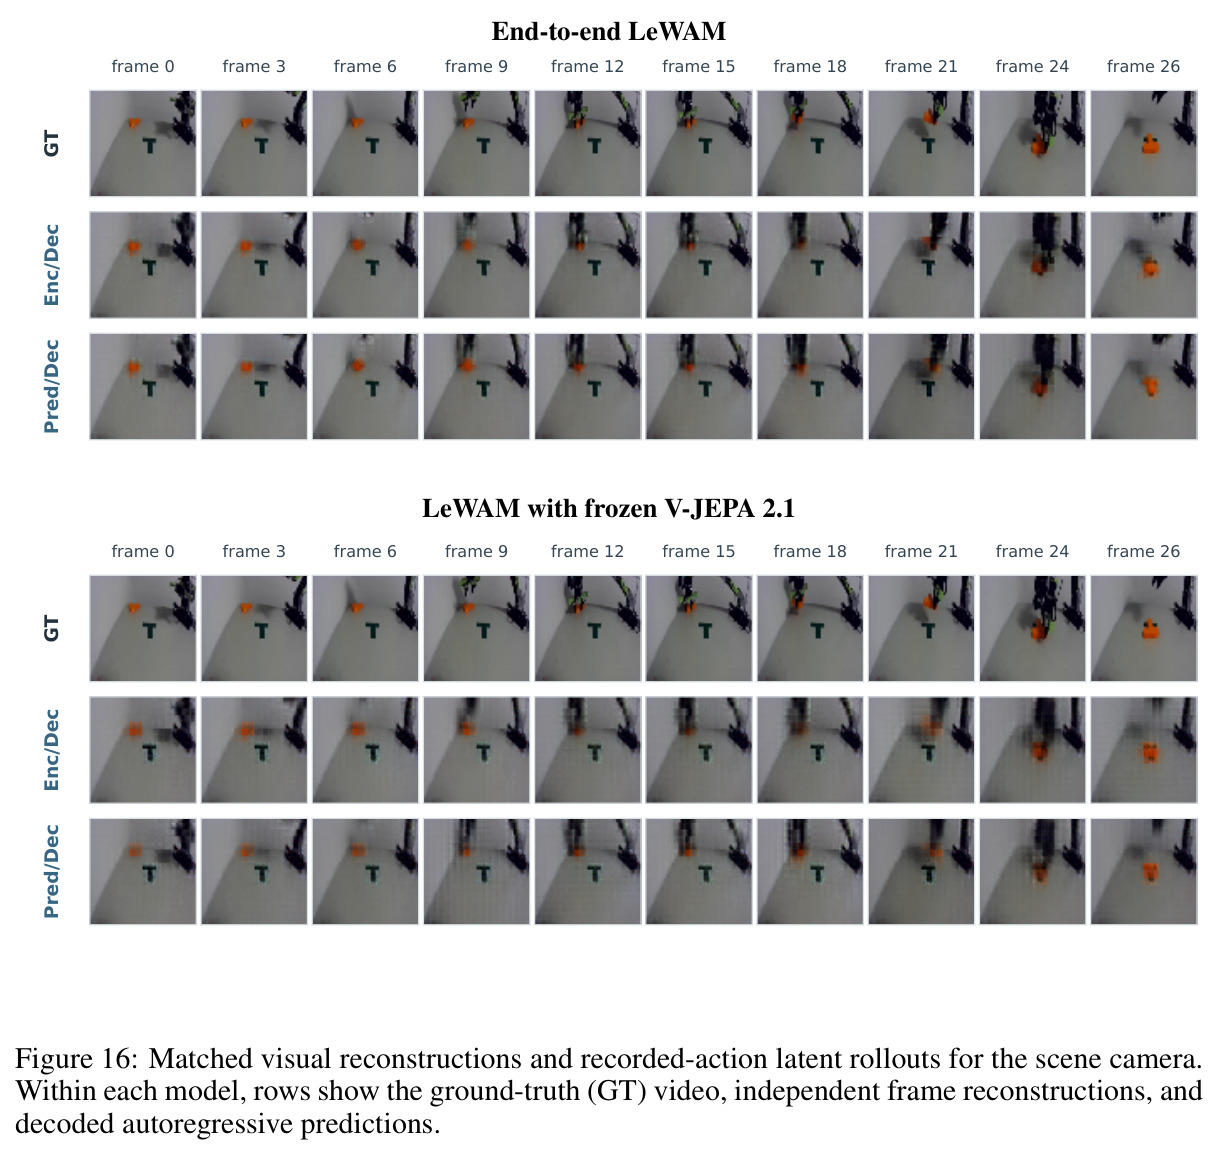
作者承认的局限包括五条:数据覆盖有限(专家演示+非专家交互,规模小,缺乏覆盖困难接触转变的 play data);泛化未测试(对陌生物体、相机视角、接触状态的行为尚无实验);单任务单本体训练(每个任务/机器人单独训练或适配,未做多任务、多本体、语言条件);缺少分层规划集成(只有低层控制,长任务需高层子目标分解);训练与规划规模小(视觉规划模型仅约 17M 参数,未验证 scaling)。我的补充观察:第一,物理机器人上 LeWAM 绝对成功率其实低于 Diffusion Policy(33.3% vs 38.9%),且每任务仅 30 次试验、单一操作员采集、无统计显著性检验,'竞争性'结论的证据较薄;第二,长时程表现极不均衡——Cube 100 步仍有 82.0% 但 Puzzle 100 步崩到 3.3%,说明按钮序列这类组合任务的 latent 想象误差随步数累积的问题并未解决;第三,goal-conditioned 评估中目标总取自同一条轨迹的未来帧,隐含'目标必然可达且在演示分布内'的较强假设,跨轨迹/跨任务的目标泛化没有测;第四,评测协议本身敏感——Cube 原始判据下零动作就能拿 42.7% 的'成功率'(Table 4),作者加了末端执行器校验才降到 2.7%,提示同类基准的数字需谨慎解读;第五,接触丰富任务上'CEM 不适定'的机理论证(附录 E)作者自认是启发式的,尚缺严格理论;第六,事后训练的像素解码器仅用于诊断可视化,不能作为模型感知质量的直接证据。
独立分析的弱点
独立分析的弱点及改进方向如下。弱点一:联合目标存在张力——在 Push-T 上去掉动作头改用 CEM 时 LeWM 反而更高(92.4% vs 84.0%),说明动作流匹配损失在某些任务上轻微挤压了动力学预测精度;改进方向是给两个损失引入动态权重调度,或把状态分支扩大为独立容量的专家分支、按不确定性门控。弱点二:物理机器人成功率偏低且对任务敏感(Tape Stack 仅 6/30),疑似与 2.5Hz 的模型采样率有关——高频接触事件(胶带对准、滑移)被时间下采样抹掉;改进方向是提高采样率、引入腕部视角更高分辨率或触觉模态,并对接触瞬间做自适应加密采样。弱点三:规划的潜在代价 $\mathcal{C}(A)=\text{MSE}(\hat{z}_{t+L}, z_g)$ 是单点回归,在多模态路径下会被'平均'(two-door 实验证明策略本身多模态,但规划代价仍可能偏向单一模式);改进方向是用分布层面的代价(能量距离、最大均值差异)或结合价值函数而非纯距离。弱点四:每次规划需 'N 次 8 步 Euler 采样 + 5 次 Adam 反传',虽然比 CEM 快 32 倍,但在 24 维动作(DrawerCleanup)任务上候选数与精炼步数的取舍仍靠手动扫参(Figure 12);改进方向是把精炼步数做成自适应(按代价下降速率早停)或一致性蒸馏减少 Euler 步。弱点五:完全缺乏分布外评测——相机被移动、物体被替换、光照变化下编码器从头训练的鲁棒性存疑,而这恰是预训练特征(DINOv2/V-JEPA 2)的传统强项;改进方向是混合预训练初始化与端到端微调,或加入域随机化数据。弱点六:checkpoint 按验证流匹配损失选择,与任务成功无直接关联,任务性能方差较大(如 Puzzle $\pm$12.5pp),改进方向是引入与任务目标对齐的模型选择指标。
未来方向
作者提出的未来方向:扩大数据覆盖(更多 play data 和接触丰富探索);测试并增强对陌生物体、视角、接触状态的泛化;多任务、多本体、语言条件联合训练,把共享动力学与策略扩展到更广设置;与分层规划结合,由高层规划器分解长任务为子目标、每段用 LeWAM 连续控制;扩大模型(17M 以上)与数据规模,以及测试时更大候选种群和更多精炼步的搜索扩展性。基于本文成果可延伸的方向:其一,把提议分布与 MPPI/iCEM 等在线自适应采样结合,在执行中随反馈收窄分布,可能进一步攻下 Puzzle 类组合长时程任务;其二,给离线轨迹叠加奖励或偏好标签,用学到的动力学做 offline RL 微调(LeWAM 的潜在动力学天然支持 value backup),从 goal-reaching 走向 reward-driven 技能获得;其三,用 VLM 生成中间子目标图像喂给 LeWAM 的目标条件接口,构成'语言→子目标→低层控制'的分层系统;其四,理论上严格化附录 E 的条件动作风险分析,给出联合预测改善表征的定理化保证(作者明言这是 future work);其五,把动作流的 8 个 Euler 步做一致性蒸馏或 Few-step 蒸馏,压低 270 GFLOPs/chunk 的推理成本以贴近 30Hz 以上的实时闭环;其六,多本体版本——物理实验只用了单臂 reBot,把 MoT 的动作 token 泛化为本体条件嵌入,可在真实双臂/灵巧手数据上验证 Transport 类双任务的可迁移性。
复现评估
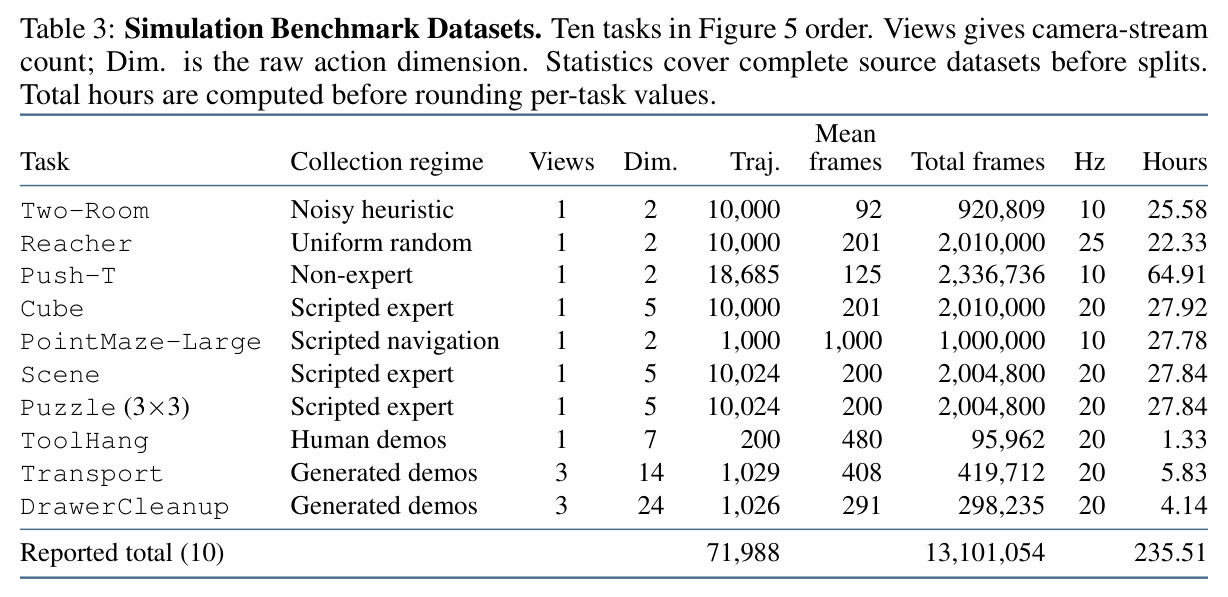
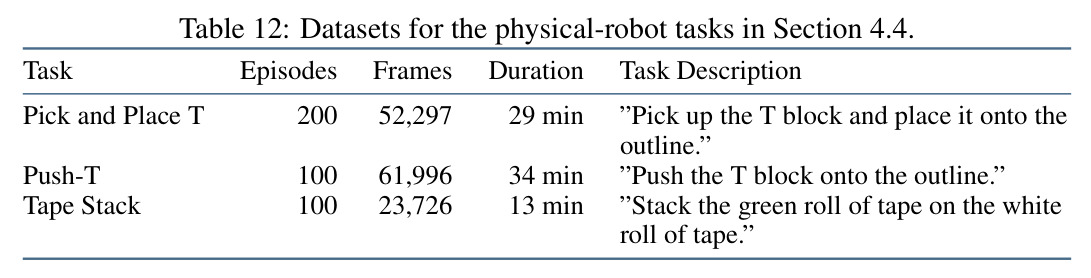
复现条件总体良好。开源情况:论文首页给出项目网站与代码仓库链接,基线实现基于公开的 stable-worldmodel 平台(Maes et al. 2026a),DINO-WM、GC-IDM、LeRobot 等均有官方仓库。数据:十个仿真数据集全部来自公开来源(LeWM 的 Two-Room/Reacher/Cube、DINO-WM 的 Push-T 非专家数据、OGBench 的 PointMaze-Large/Scene/Puzzle、robomimic 人工演示 ToolHang、DexMimicGen 生成的 Transport/DrawerCleanup),合计 71,988 条轨迹、约 1310 万帧、235.5 小时,附录 Table 3 给出每任务视角数/动作维度/帧数的完整统计。超参数在附录 A/B/D 中极为详尽:$\lambda_{sig}=0.04$、SIGReg 1024 投影 17 knots、AdamW 学习率与 warmup、规划时 Adam lr 0.05、$\lambda_{prox}=0.01$、5 次精炼步、8 个 Euler 步、裁剪界 $a_{max}=3$ 等均可直接照抄,还公布了 token 级注意力掩码(Figure 10)。算力:模型仅约 16.9M 参数,goal-reaching 训练 50 epochs batch 128,时序测量在单张 H100 上完成,学术实验室单卡即可复现仿真部分。物理机器人部分门槛较高:需要 reBot 102 主臂 + reBot B601-DM 从臂、ZED-Mini 与 Logitech C270 相机、LeRobot 遥操作管线,以及单一熟练操作员采集 400 条演示(三任务共约 76 分钟),每方法每任务 30 次人工判定试验;不过其 LeRobot 代码栈开源,复现难度中高。综合评估:仿真与消融部分复现难度低到中,物理部分需要硬件与人力投入。
论文图表
定位图,用五列对比 LeWAM 与相关方法谱系:世界模型训练后接控制的管线(LeWM)、预训练视觉特征(V-JEPA 2、DINOv2)、视频世界动作模型(DreamZero、Fast-WAM)、群体采样动作搜索(CEM、MPPI、iCEM)以及评估任务;并列出 LeWAM 的六个特征:统一世界模型与控制、控制相关表征、无重建、无预训练、策略引导搜索、梯度精炼,以及覆盖接触丰富与长时程任务。
帮助读者在相关工作的坐标系中快速定位 LeWAM 的差异化主张,是理解引言论证结构(为什么端到端联合训练是空白)的入口。
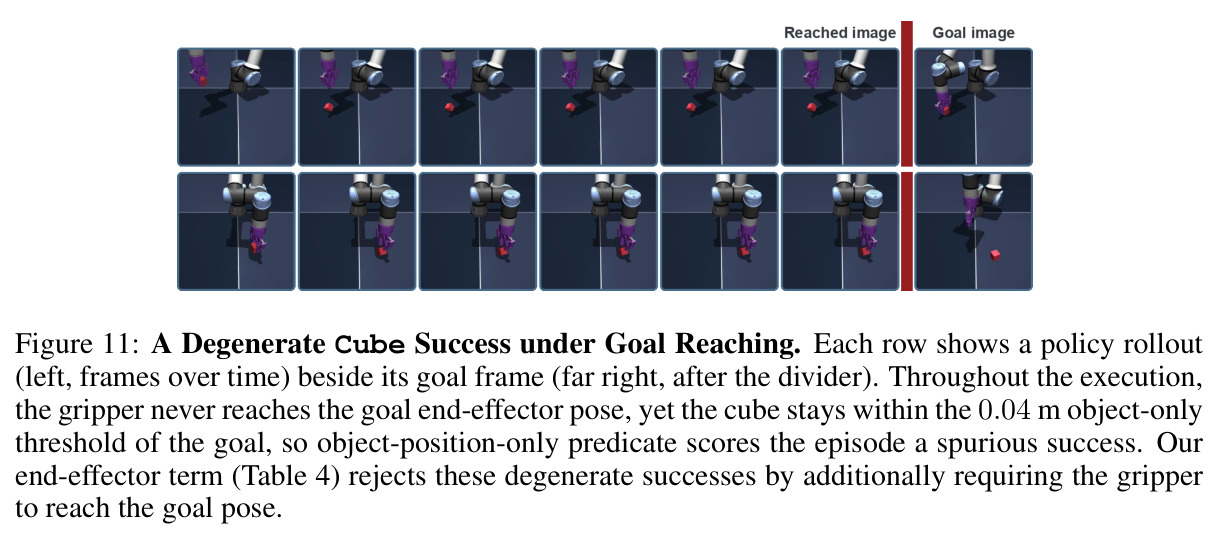
失败案例图:每行展示一次 rollout 的时间帧序列与目标帧对比。执行全程夹爪从未到达目标末端位姿,但方块恰好停在目标 0.04m 阈值内,仅检查物体位置的旧判据会给这一 episode 记为虚假成功;加入末端执行器校验后(Cube +EEF),25 步 goal 的零动作成功率从 42.7% 降到 2.7%。
揭示评测协议本身的坑——基准数字可能被判据漏洞严重污染,提醒读者在解读同类 goal-reaching 结果时必须检查成功谓词的严格性。
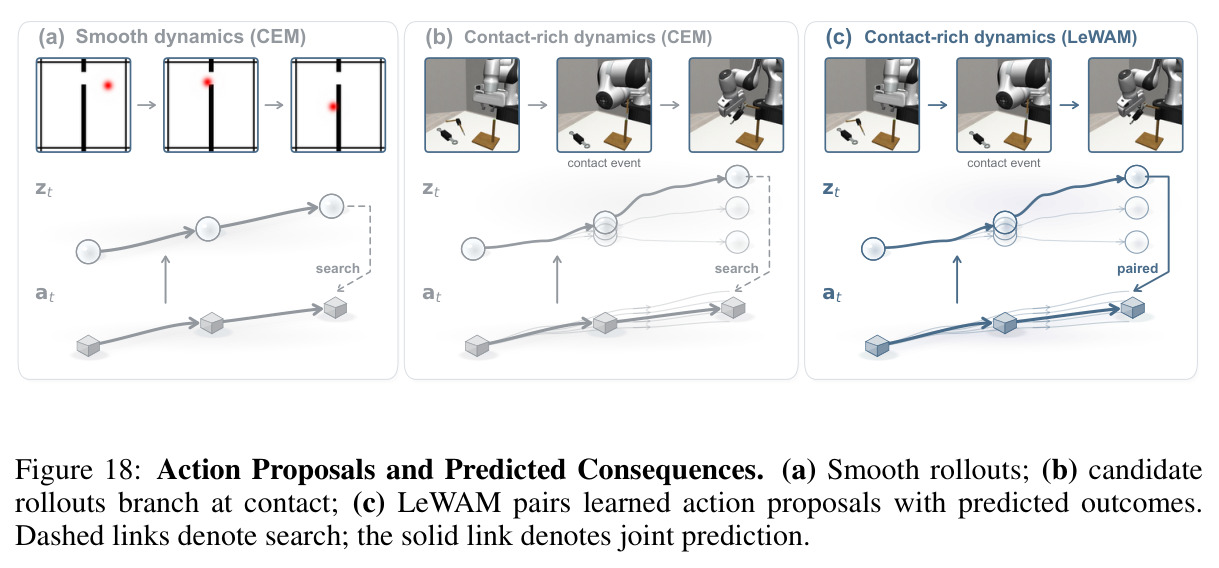
三格示意图:(a) 平滑动力学(如 2D 导航)下 CEM 搜索是适定的,候选动作可经虚线搜索链接到后果并按代价排序;(b) 接触丰富动力学下候选 rollout 在接触事件处分叉,附近动作产生截然不同后果,有限种群采样不到有效分支时物体代价给不出排序信号;(c) LeWAM 用实线把学习到的动作提议与其预测后果配对,绕开盲目搜索。
这是全文最核心的动机图:解释了 CEM 在接触丰富任务失效的不适定机理,以及'策略分布作为提议先验'这一创新为何恰好对症。
Push-T 上各变体的有效秩与线性探针 $R^2$(ridge 回归):LeWAM 带 SIGReg 时有效秩 42.90、Object 0.90、Proprio 0.86、Action (IDM) 0.40 (0.75);LeWM 无 SIGReg 时全部崩到 0.00;LeWAM 无 SIGReg 仍保持 Object 0.88/Proprio 0.85,证明动作监督本身是防崩溃信号,且 SIGReg 额外提升物体状态可解码性。
用定量探针数据回答'联合训练学到了什么表征',是理解方法消融与防崩溃论证的核心表格。
四环境(Push-T/Cube/Scene/Puzzle)上 LeWAM 与 LeWM 的有效秩与 Object/Proprio/Action(IDM) 探针 $R^2$ 完整矩阵。例如 Scene 上 LeWM 的 Object 仅 0.37、Proprio 0.07,而 LeWAM 达 0.48/0.78;Push-T 上无 SIGReg 的 LeWM 全为 0。
把'动作监督改善控制相关表征'的主张从 Push-T 扩展到全部环境,是表征层面结论的完整证据表。