感觉运动对齐:具身策略成功率的柏拉图式离线代理指标 Sensorimotor Alignment: A Platonic Proxy for Embodied Policy Success
用感觉表征与运动轨迹的近邻几何对齐度 S² 离线预测机器人模型任务成功率
前置知识
Platonic Representation Hypothesis(PRH,柏拉图表征假说)
Huh 等人 2024 年提出的假说:随着视觉、语言等不同模态的模型规模扩大并在多样任务上变强,它们的表征会收敛到对同一个真实世界的共享统计模型——每个模态只是同一"柏拉图表象"的不同投影,表征点之间的相对距离结构会跨模态趋于一致,通常用 CKA/CKNNA 等表征相似性度量来验证。
本文的全部动机就是把 PRH 扩展到"运动"这一新模态;S² 的数学定义直接复用了 PRH 论文的 CKNNA 实现。不理解 PRH 就无法理解 S² 为什么这样设计、以及实验里的正相关到底支持了什么主张。
VLA(Vision-Language-Action 模型)
在预训练视觉-语言模型(VLM)骨干上接一个动作头、再用机器人演示数据微调而成的策略模型:输入图像和语言指令,输出机械臂动作。动作头类型包括流匹配、扩散、自回归和确定性 MLP 等,VLM 骨干可以选择冻结或端到端训练。
本文的主实验对象就是 12 个 VLA:S² 与它们在 SimplerEnv 上的闭环成功率做相关;第 4 节关于模态主导和冻结视觉编码器的诊断实验也都围绕 VLA 的微调方式展开,不懂 VLA 的结构无法理解这些结论。
WAM(World Action Model,世界动作模型)
建立在视频生成模型(通常是视频扩散 Transformer)之上的动作模型:先通过迭代去噪生成未来视频的潜变量,再从这些潜变量解码出机器人动作,代表工作包括 Vidar、LingBot-VA、Motus、Fast-WAM 等。
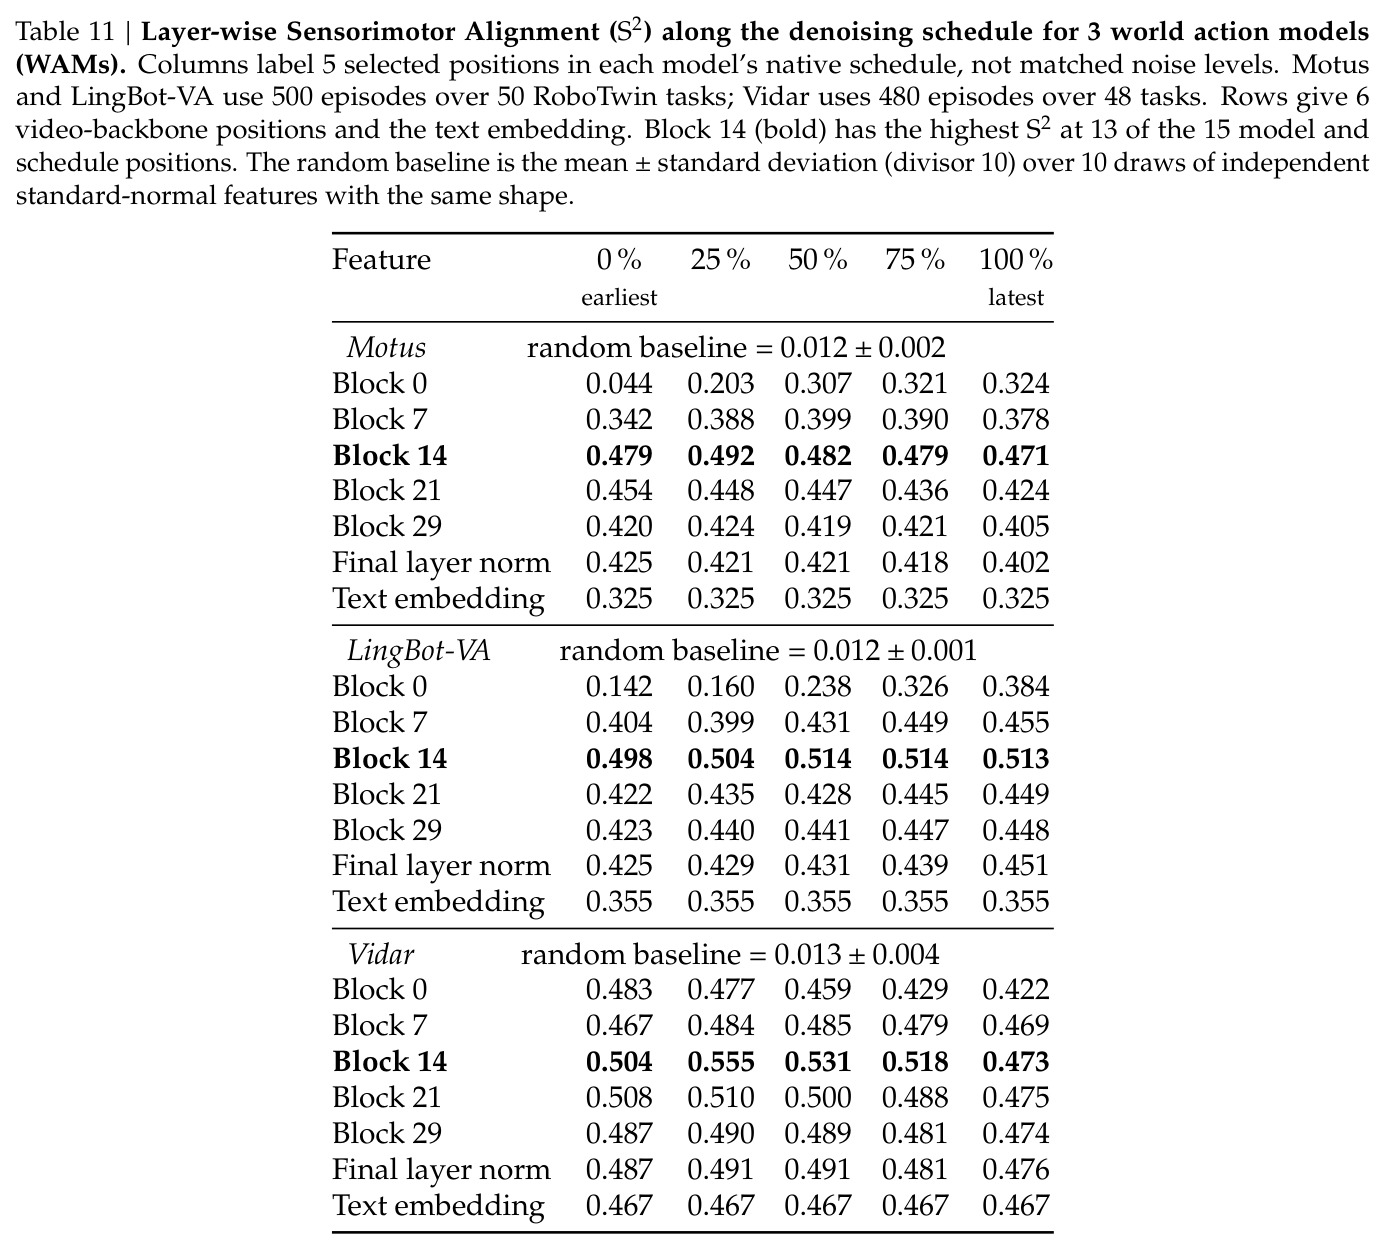
WAM 与 VLA 架构完全不同(基于视频生成器而非 VLM)。S² 在 WAM 上同样与成功率相关,证明了度量的跨架构通用性;论文中关于去噪步数和 Transformer 块深度的表征层分析实验全部基于 WAM。
CKA 与 CKNNA(centered kernel alignment / centered kernel nearest-neighbor alignment)
比较两组表征几何结构的度量。CKA 用 HSIC(Hilbert–Schmidt 独立性准则)对两个核矩阵(样本两两相似度矩阵)做全局对齐归一化打分;CKNNA 把求和限制在"互为 k 近邻"的样本对上,先做共享近邻掩码再算无偏 HSIC,从而聚焦局部近邻结构而非全局结构。
S² 的正式定义完全建立在 CKNNA 上:一侧是感觉特征的内积核,另一侧是 DTW 运动近邻指示矩阵。附录 A.3 中的掩码、无偏 HSIC 校正和归一化公式都来自 CKNNA,是读懂方法细节的前提。
DTW(Dynamic Time Warping,动态时间规整)
比较两条长度或执行速度不同的时间序列的距离:允许时间轴非线性弯折对齐,用动态规划递推 $D_{uv}=\min\{D_{u-1,v}+c_{uv},\;D_{u,v-1}+c_{uv},\;D_{u-1,v-1}+2c_{uv}\}$ 累积局部代价,使"同一动作、快慢不同"的两条轨迹距离变小。本文的局部代价由位置 L2 距离、SO(3) 旋转测地距离和夹爪开合差加权组成。
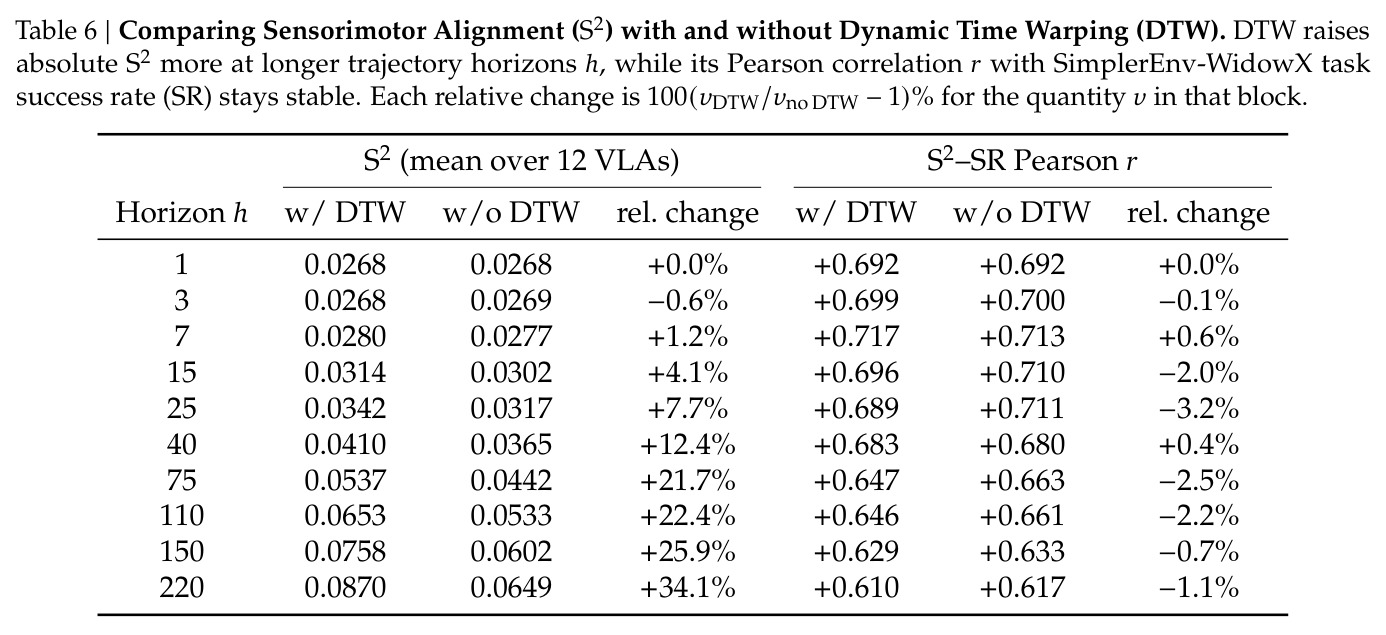
运动空间的 k 近邻集合完全由 DTW 距离决定,它直接定义了 S² 中"哪些 episode 在动作上相似"。附录 C.3 还专门验证了相关结论不是 DTW 弯折带来的伪影,可见它是方法正确性的关键组件。
SimplerEnv(仿真闭环评测环境)
基于真实机器人演示数据(如 BridgeDataV2)构建的闭环仿真评测环境:在重放的真实场景视频中执行模型动作,统计操作任务成功率,是 VLA 社区常用的低成本闭环基准,本文使用其中的 WidowX 场景。
本文几乎所有"任务成功率"数据都来自 SimplerEnv:散点图的 y 轴就是各模型在此环境上的闭环成功率,S² 与它的 Pearson 相关系数是全文核心证据。理解它是仿真代理评测有助于把握结论的外推边界。
研究动机
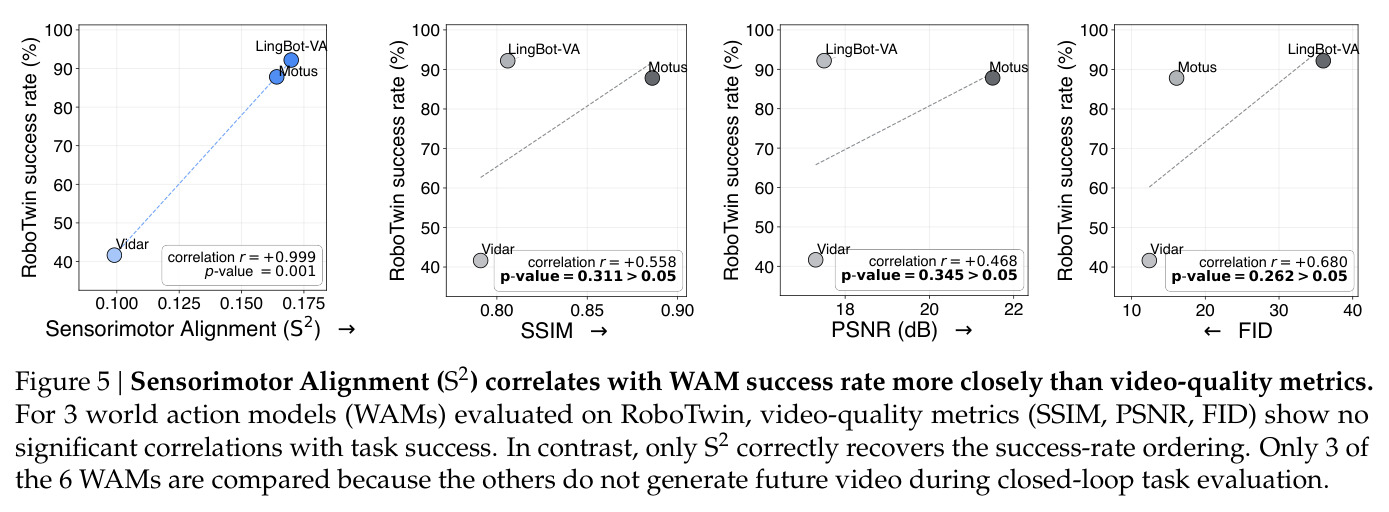
机器人基础模型(VLA、世界动作模型 WAM 等)最可靠的能力评估方式仍是闭环 rollout——在 SimplerEnv 等仿真环境或真实机器人上完整执行任务并统计成功率。这种评估又慢又贵且充满噪声:真实机器人评测中每个策略要在 3 台 Franka 上跑 40 个任务共 120 次试验,结果还依赖具体任务集、相机布置和评测协议。于是人们寻找便宜的离线代理指标,但现有感知侧指标并不胜任:VQA 分数衡量语言理解而非"为行动组织表征"——本文实测 8 个 VLM 骨干的 VQA 平均分与微调后 VLA 的 SimplerEnv 成功率相关系数仅 $r=-0.154$;FID、SSIM、PSNR 等视频质量指标衡量像素级生成质量,先前工作已发现预测视频质量与下游任务表现不一致,本文实测 FID 甚至方向相反($r=+0.680$,视频质量越差成功率反而越高)。根本矛盾在于:两个视觉上很不同的场景可能需要相似的机器人运动,两个视觉上相似的场景却可能需要完全不同的轨迹,被动感知或生成质量无法反映模型是否把表征组织成了适合执行动作的形式。
本文的目标是本文要回答两个层层递进的问题。理论上:Platonic Representation Hypothesis(PRH)认为视觉、语言等模态的模型在变强后会收敛到对同一个真实世界的共享统计模型,那么物理运动是否也是这个世界的另一个"投影"?更强的具身模型是否会把视觉-语言感觉表征对齐到运动轨迹的结构上?实践上:作者希望构造一个免训练、纯离线的度量 S²(Sensorimotor Alignment),只需在公开数据集上做一次前向传播加轨迹几何计算,就能在昂贵的闭环评测之前预测模型的任务成功率——既能为 VLA 微调挑选 VLM 骨干,也能为闭环评测排序候选模型。更进一步,作者希望 S² 能在表征层面解释以往只能靠闭环结果观察到的现象(如 VLA 忽视语言指令、冻结视觉编码器导致掉点、WAM 跳过迭代去噪几乎不掉点),成为理解具身模型内部机制的诊断工具。
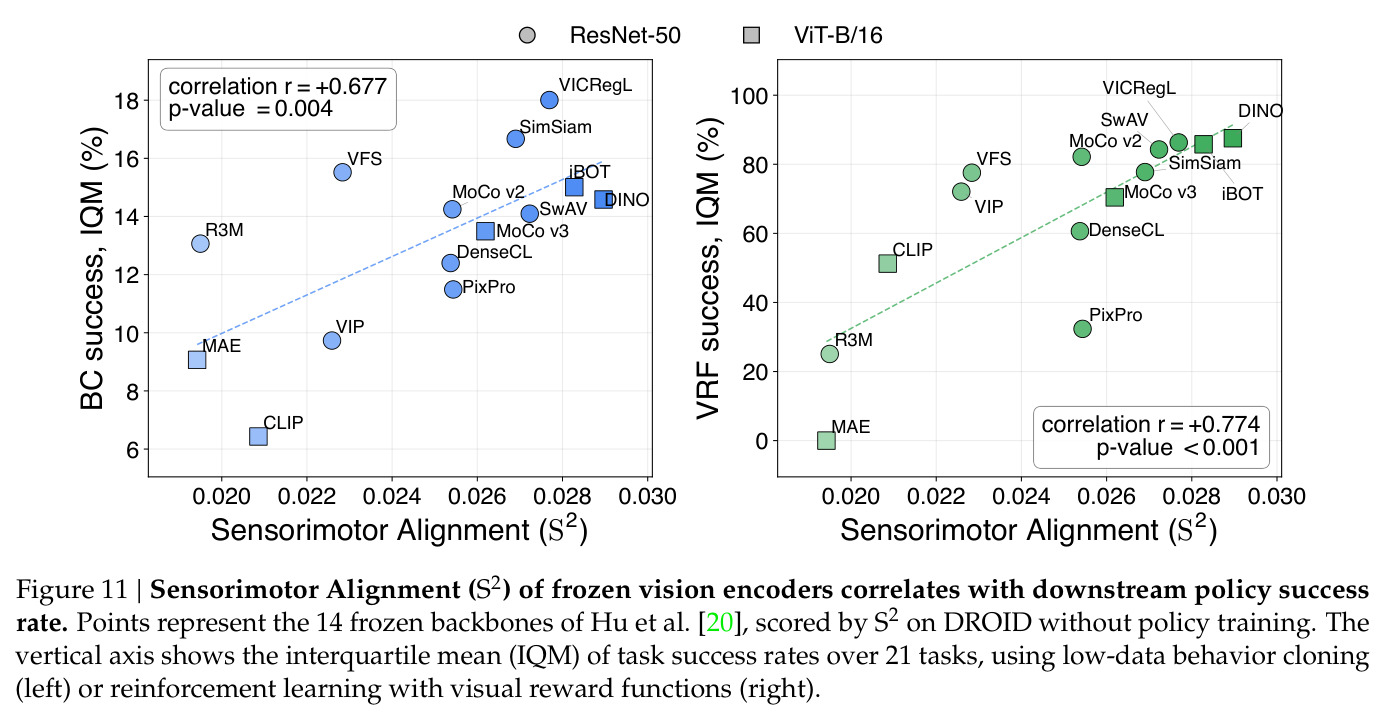
与已有工作不同的是,切入角度的独特性有三点。第一,PRH 此前的验证都停留在观测型模态(图像与文本)上,从未把"动作"当作一个模态纳入;本文第一次把机器人末端轨迹视为世界的又一投影,把 PRH 从"感知模态趋同"扩展到"感知-运动趋同",并提出可检验预言:越强的具身模型,其感觉表征与运动表征的邻域结构越一致。第二,此前研究"什么表征有利于机器人学习"的工作(如 Hu 等人评估 14 个冻结视觉编码器、Theia 的特征熵假设)都只考察视觉编码器本身,从不把机器人实际执行的轨迹纳入度量;S² 则显式比较感觉空间与运动空间的 k 近邻集合重叠。第三,与需要训练后才能评估的 VQA/视频质量指标不同,S² 可以在微调之前对原始 VLM 骨干打分,定位为"昂贵的闭环评测之前"的初筛工具;同时它保留了 CKNNA 的局部结构视角,还能下钻到特征位置、去噪步数、块深度等层面解释模型内部行为。
核心方法
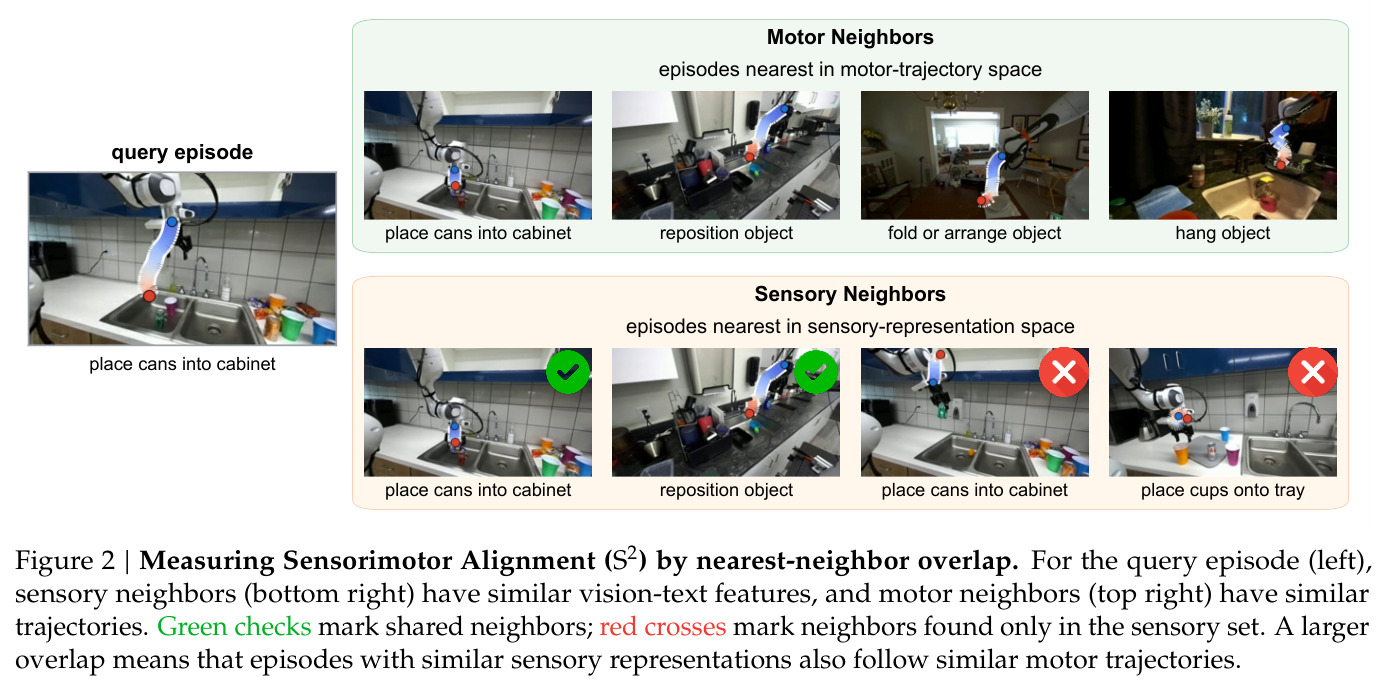
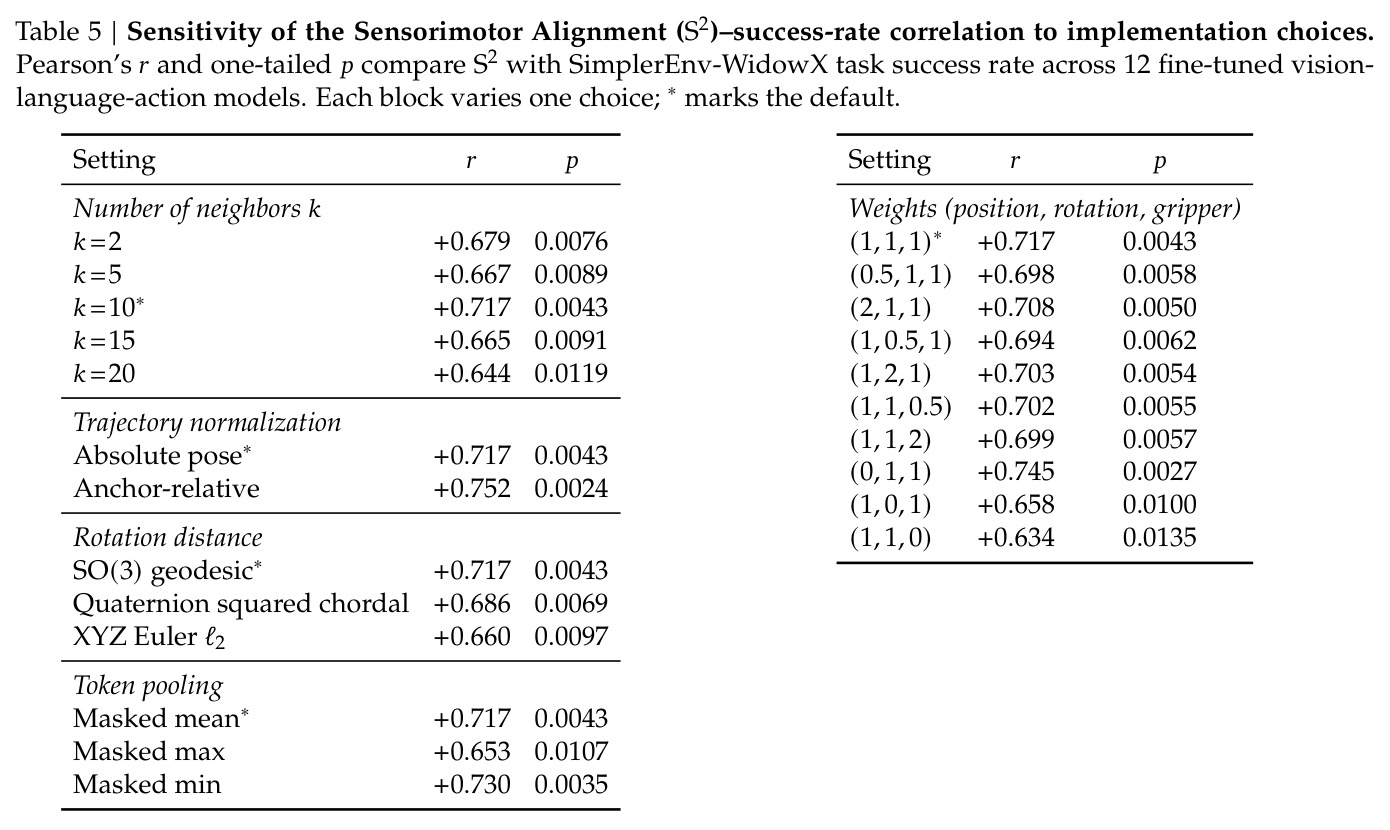
直觉上,如果一个具身模型足够强,那么在它"眼里"相似的两个 episode(感觉表征距离近),在物理动作上也应该相似(末端轨迹距离近);反之,动作相似的场景在感觉空间也应彼此靠近。S² 就是量化这两种"邻近结构"的重合程度。技术路线分四步:(1) 从参考数据集(单臂 DROID/BridgeDataV2,双臂 ALOHA 用于 WAM)采样 $N$ 个 episode(如 DROID 取 6,000 条),每个 episode 随机抽一帧图像配上任务指令作为感觉输入;(2) 用被评估模型的视觉与文本编码器编码成感觉嵌入 $z_i=f(x_i)\in\mathbb{R}^d$(token 特征平均池化);(3) 取该帧之后 $h$ 步的末端状态序列作为运动表征 $\tau_i\in\mathbb{R}^{h\times 7}$;(4) 感觉空间用余弦距离、运动空间用 DTW 距离各建 k 近邻集合,用交集比例 $m_{NN}=\frac{1}{Nk}\sum_{i=1}^{N}|\mathcal{N}_{sensory}(i)\cap\mathcal{N}_{motor}(i)|$ 衡量对齐,实际实现为中心化归一化的 CKNNA 变体(默认 $k=10$)。全程免训练,只需模型前向传播。
核心创新是把"模型是否为行动组织了表征"变成一个纯几何问题:比较两个空间里的近邻图结构,而不是给任何逐样本的绝对质量打分。与已有方法的本质区别有三。其一,VQA 分数和视频质量指标都是绝对评分,与机器人要执行什么动作无关;S² 度量的是相对结构——episode 之间的距离关系在感觉空间和运动空间是否一致,这正好对应"视觉相似 $\neq$ 动作相似"这一机器人特有的难点。其二,运动空间距离用 DTW 处理不同执行速度,用 SO(3) 测地距离 $2\arccos\min\{1,|q_i^\top q_j|\}$ 处理旋转、米制距离处理平移、夹爪状态差处理开合,使轨迹比较尊重刚体运动几何而非简单逐帧对齐。其三,实现上复用 PRH 论文的 CKNNA(对共享近邻做掩码的无偏 HSIC 再归一化),只看局部近邻结构而非全局 CKA,使度量聚焦"谁和谁邻近"这一真正决定任务成败的结构。因此 S² 是一个免训练、跨架构(VLM/VLA/WAM 通用)、可跨参考数据集迁移的统一度量。
方法步骤详情
流程分六步。①准备参考数据:DROID(Franka Panda,$N=6000$,最大时域 $H_{max}=220$)、BridgeDataV2(WidowX,$N=3245$)或双臂 ALOHA($N=839$);在最大时域下统一抽 anchor 帧并一次算好感觉嵌入,扫不同 $h$ 时只改轨迹长度。②感觉表征:anchor 帧+指令经被测模型的视觉/文本编码器,token 特征平均池化为 $z_i$ 并做 $\ell_2$ 归一化。③运动表征:取 anchor 后 $h$ 步的 7 维状态 $(x,y,z,\phi,\theta,\psi,g)$,位置用米、旋转转单位四元数。④轨迹距离:局部代价 $c_{uv}=w_{pos}d_{pos}+w_{rot}d_{rot}+w_{grip}d_{grip}$($d_{rot}$ 为 SO(3) 测地距),用 symmetric2 DTW 递推累加。⑤对齐估计:感觉侧核 $K_{ij}=\cos(z_i,z_j)$,运动侧近邻指示矩阵 $L_{ij}=\mathbb{1}\{j\in\mathcal{N}_{motor}(i)\}$,对共享近邻掩码后算无偏 HSIC,归一化得 $S^2=\mathrm{Align}_{knn}(K,L)/\sqrt{\max\{\mathrm{Align}_{knn}(K,K)\mathrm{Align}_{knn}(L,L),\varepsilon_A\}}$。⑥把各模型 S² 与其闭环成功率做 Pearson 相关与单尾检验。
技术新颖性
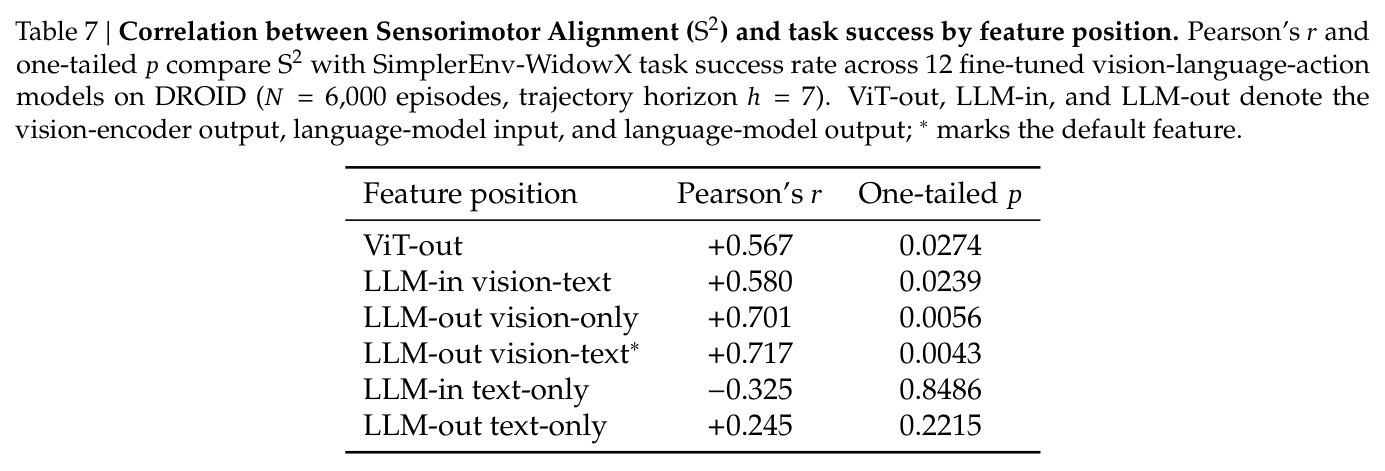
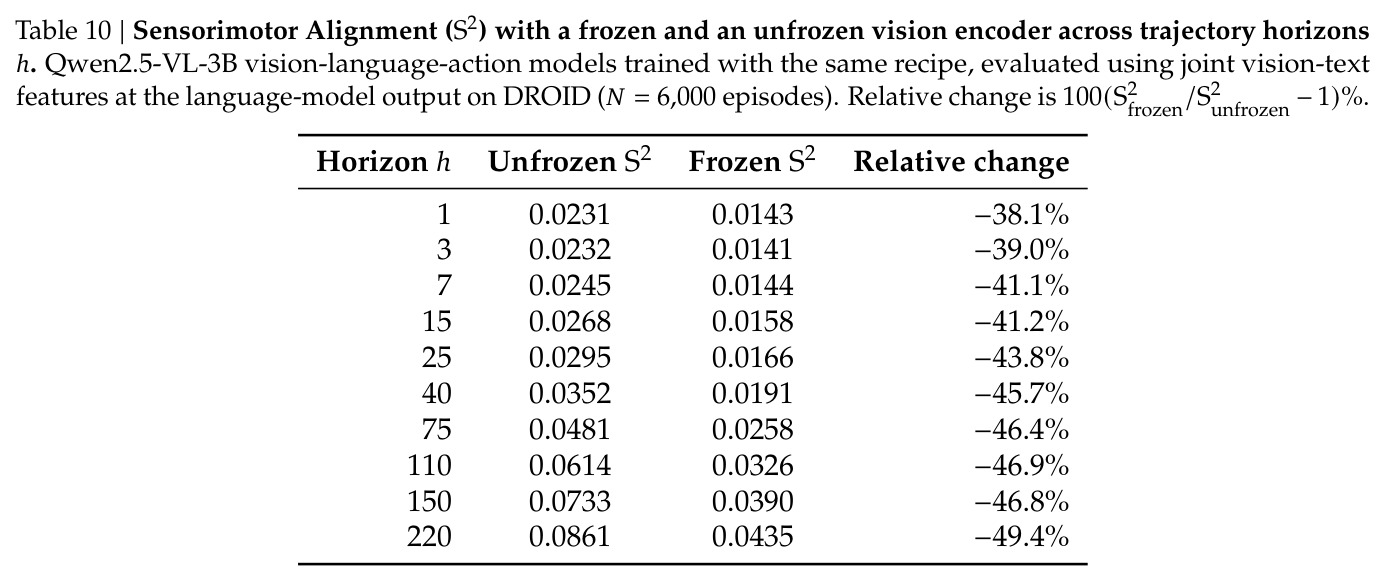
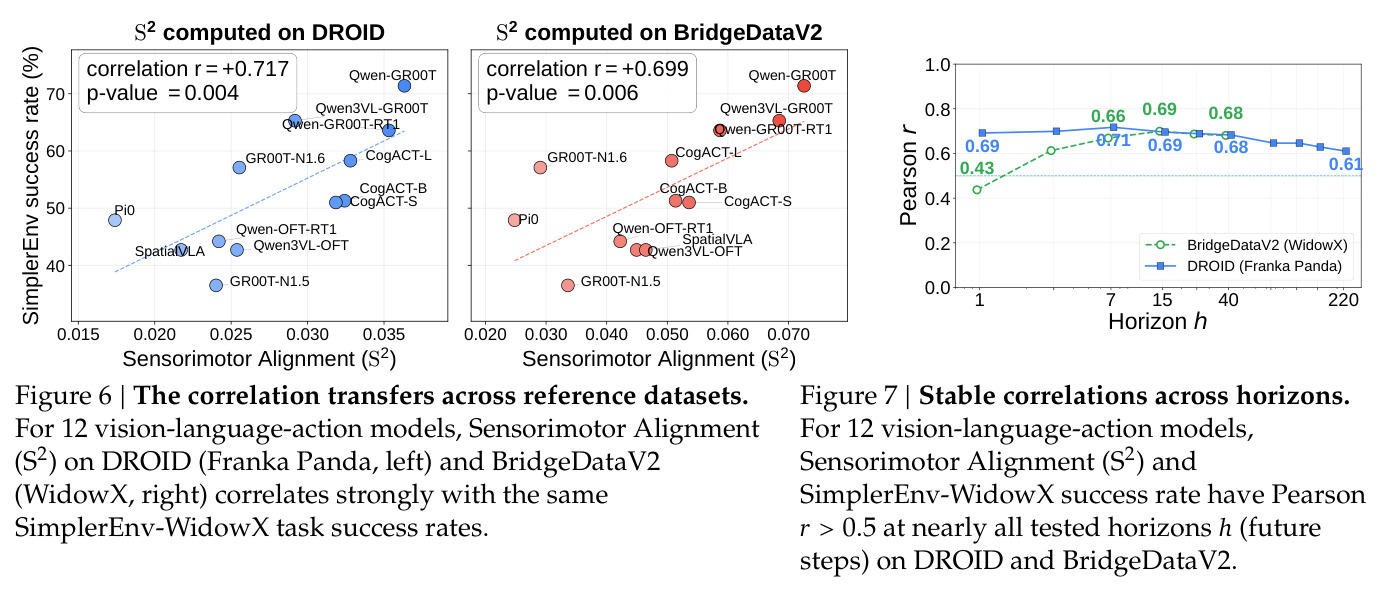
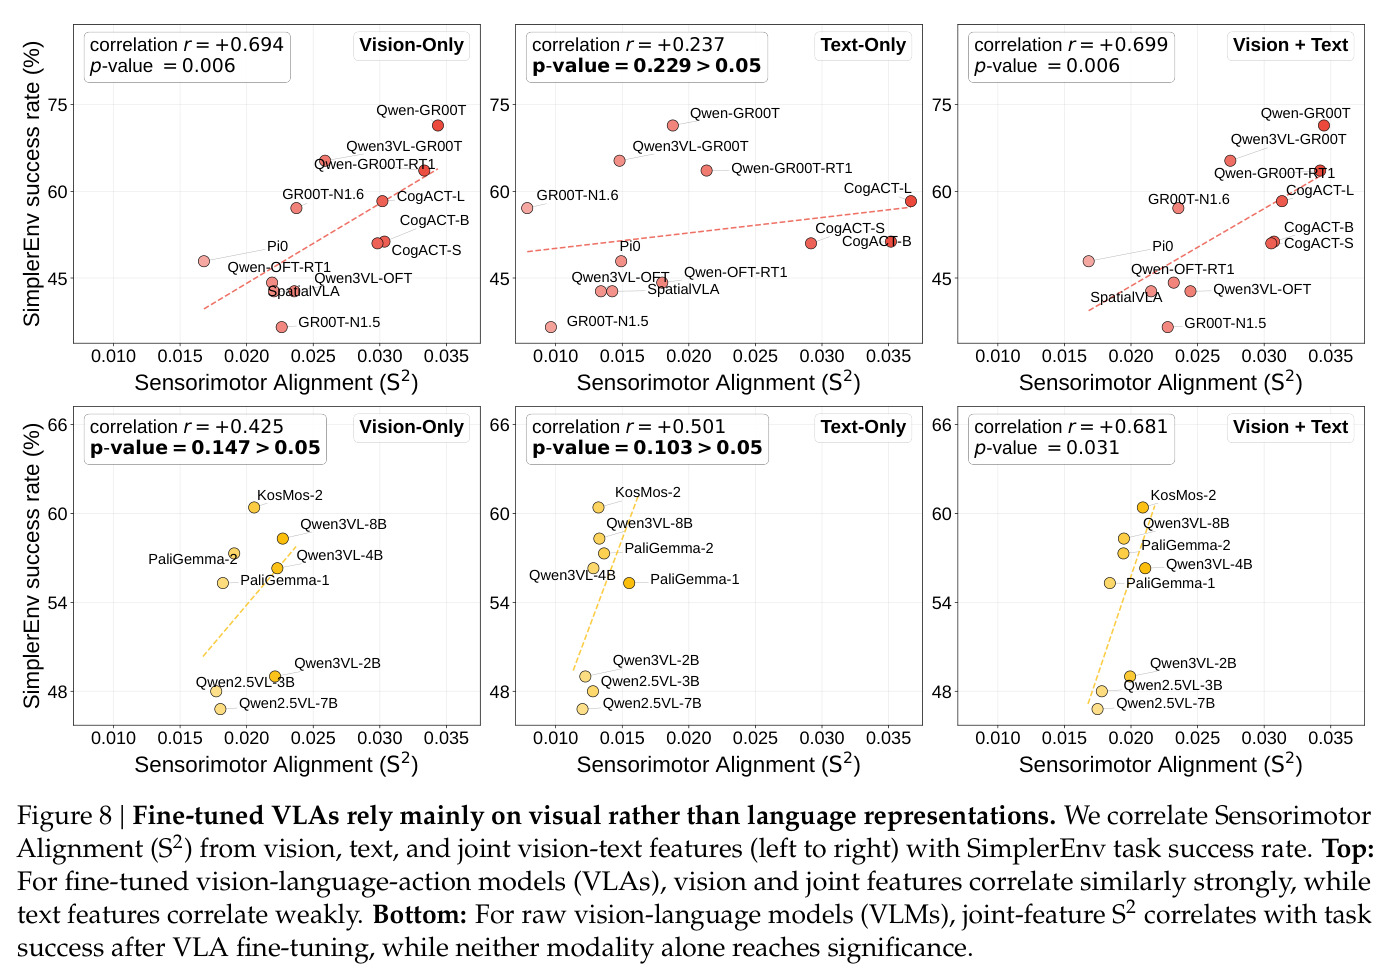
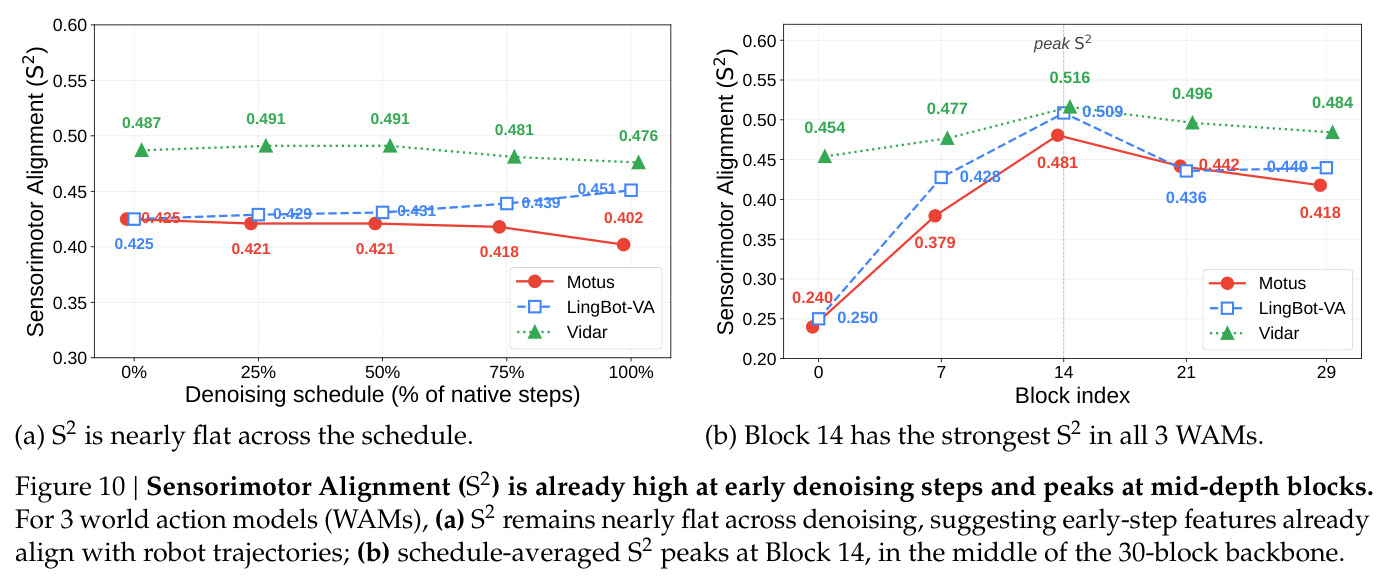
技术新颖性体现在四个层面。概念层面:首次把 PRH 的"跨模态收敛"假设扩展到动作模态,提出"更强的具身模型会把感觉表征对齐到运动结构"这一可检验预言,并给出 $r=+0.717$ 等跨模型族证据。度量设计层面:沿用 PRH 的 CKNNA,但把一侧核替换成 DTW 近邻指示矩阵,让旋转几何与时间规整进入表征评估,这套组合此前从未用于机器人模型评估。验证方法论层面:8 项稳健性检查(参考数据集、时域 $h\in[1,220]$、$k$、权重、旋转距离、池化、归一化、DTW 对比)加一个负对照(双臂模型配单臂数据,相关从 +0.999 跌至 +0.246),以及逐架构组留一交叉验证排除混淆,严谨程度在同类相关性研究中少见。诊断应用层面:用同一把尺子在表征层面解释了四个已知现象——模态主导(视觉 S² $r=+0.694$ vs 文本 +0.237)、冻结编码器(S² 降 41%、成功率降 40%)、早期去噪步(S² 全程变化不超过约 6%)、中层块(Block 14 峰值)。
实验结果
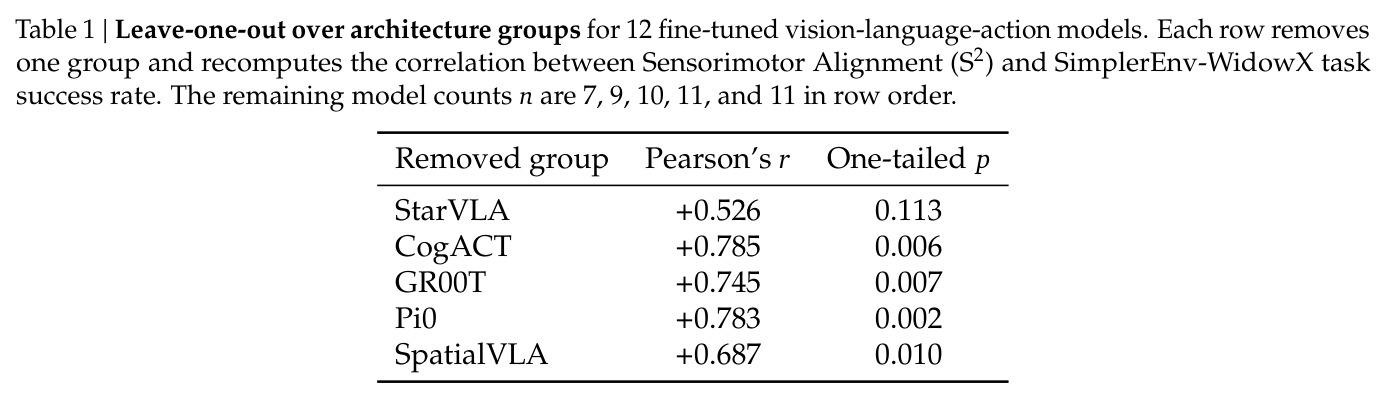
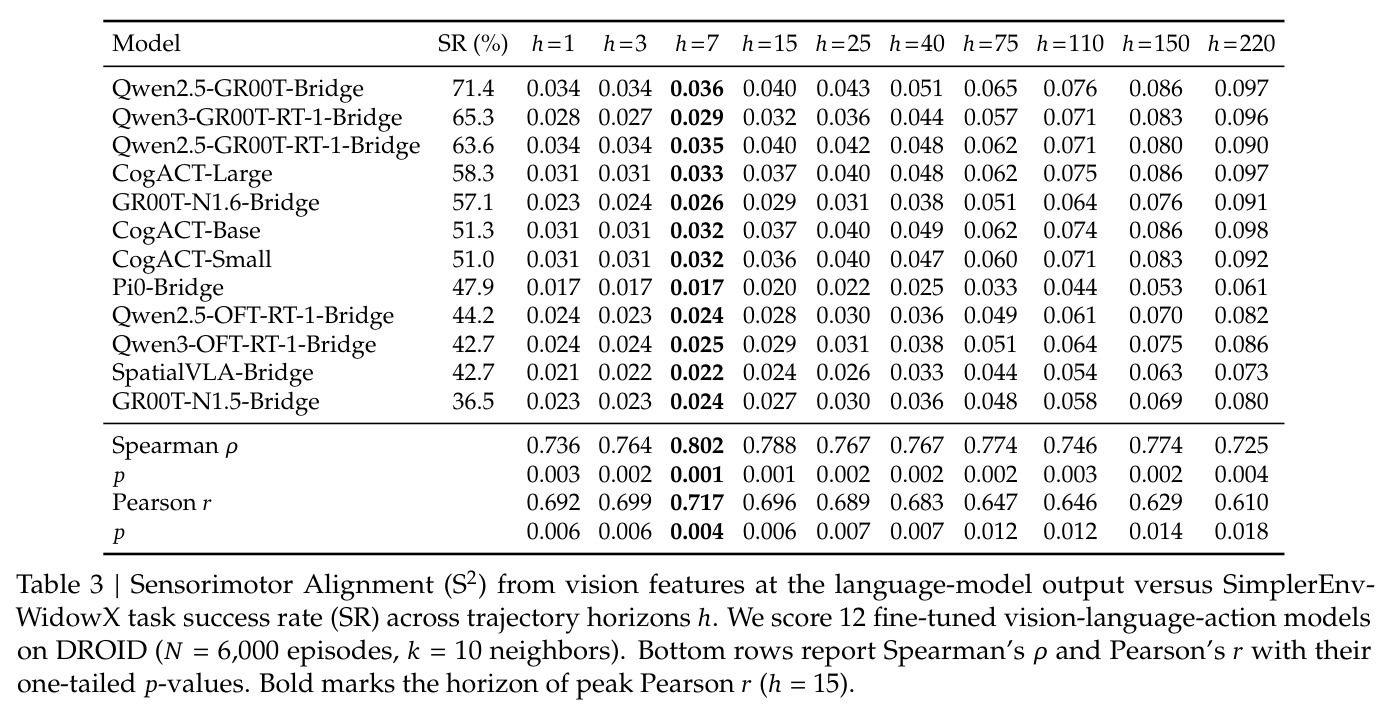
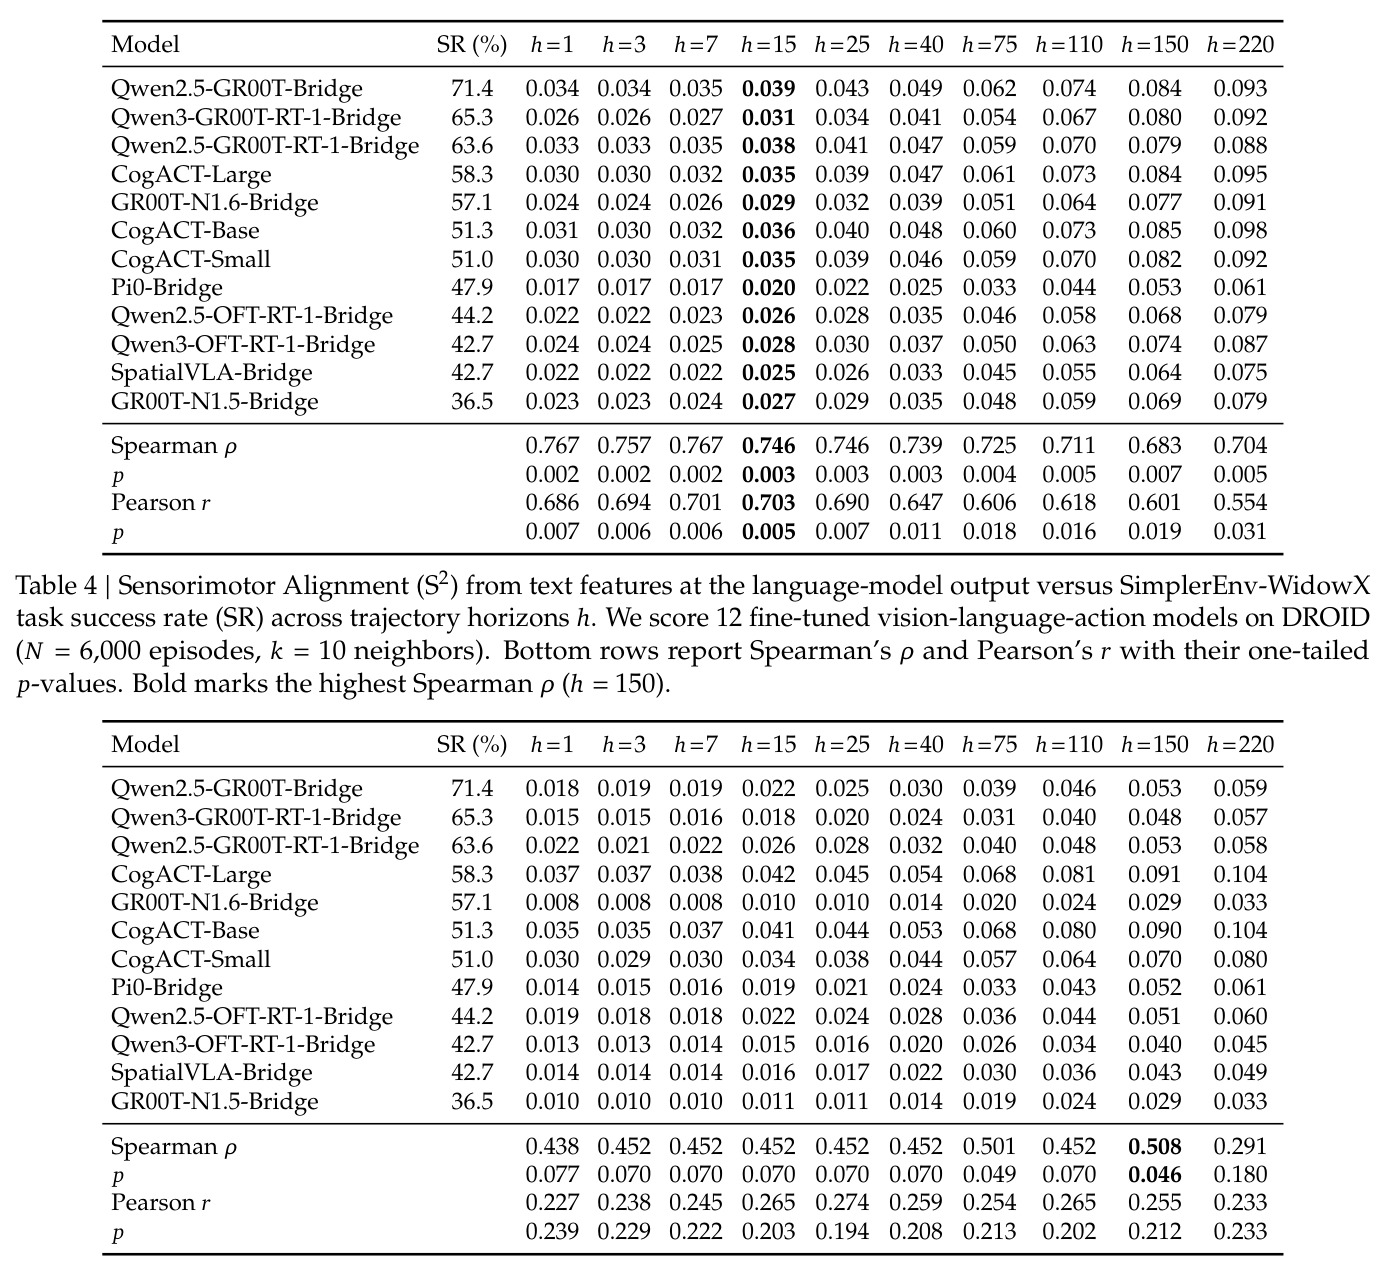
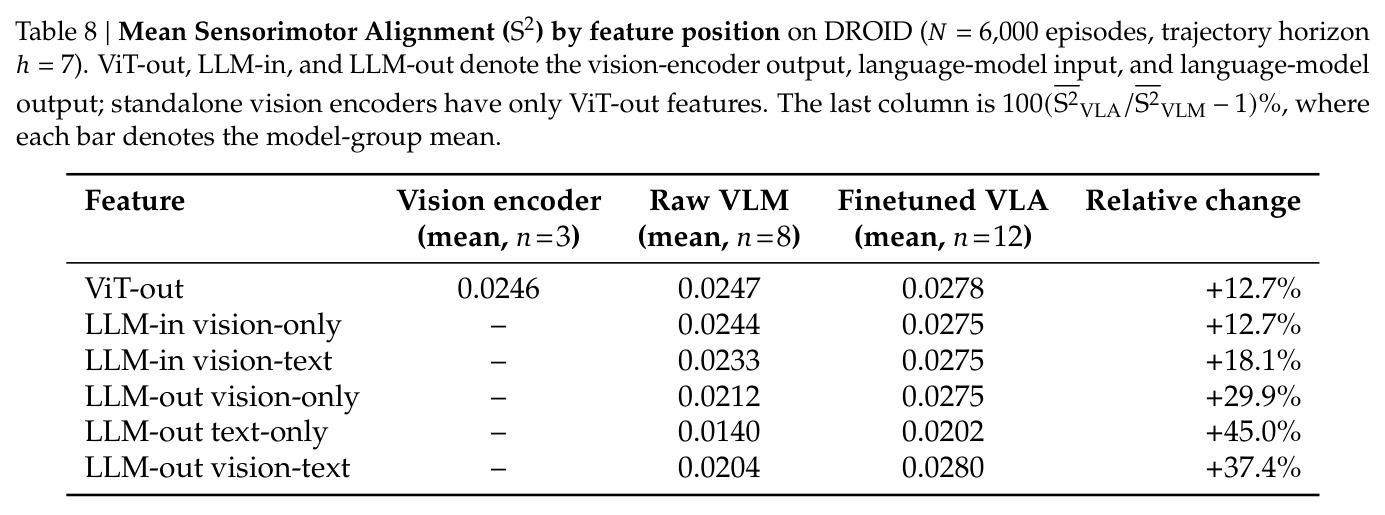
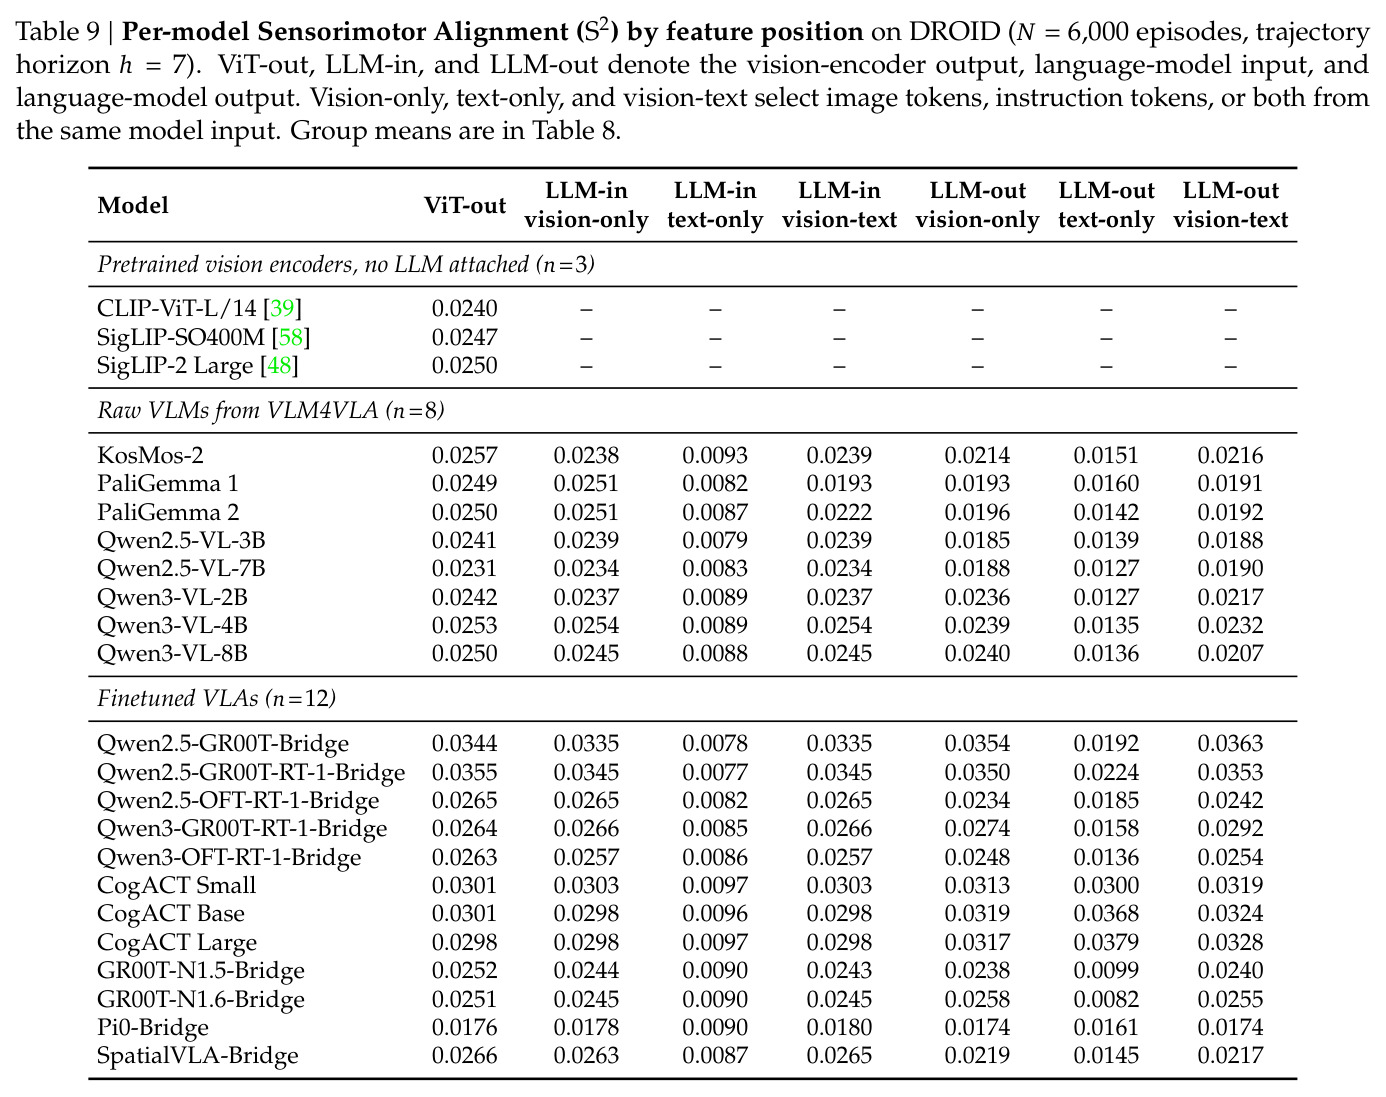
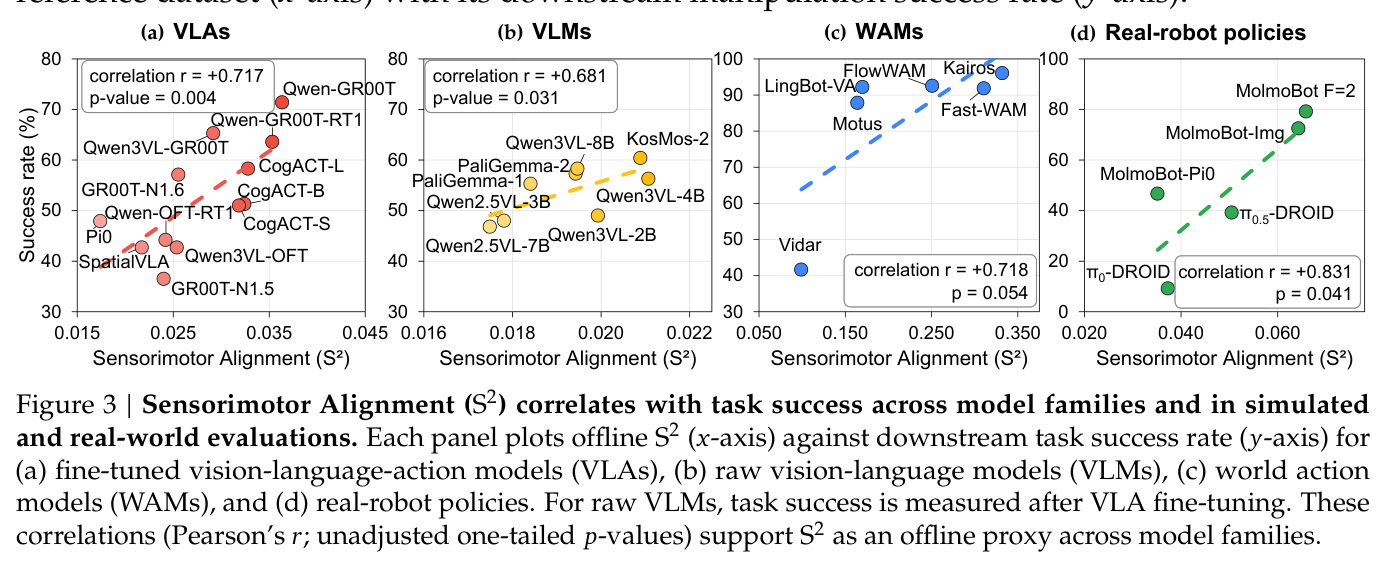
主实验覆盖四类模型。VLA:12 个微调模型的 S² 与 SimplerEnv-WidowX 成功率 Pearson $r=+0.717$($p=0.004$,95% CI $[+0.436,+0.912]$),正确排序 36.5%(GR00T-N1.5)到 71.4%(Qwen2.5-GR00T)的成功率。原始 VLM:8 个骨干微调前的 S² 与微调后 VLA 成功率 $r=+0.681$($p=0.031$),VQA 分数仅 $r=-0.154$。WAM:6 个模型 $r=+0.718$($p=0.054$);3 个可对比模型上 $r=+0.999$($p=0.001$),SSIM/PSNR/FID 仅 +0.558/+0.468/+0.680(FID 方向相反)。真机:MolmoB0T 共享评测的 5 个策略(40 任务×3 试验)$r=+0.831$($p=0.041$)。冻结编码器基准(14 个骨干):行为克隆 $r=+0.677$,视觉奖励 RL $r=+0.774$($p<0.001$)。稳健性:换参考数据集(+0.699~+0.717)、全时域、8 种实现选择均显著;双臂配单臂负对照跌至 +0.246。表征诊断:微调后 VLA 视觉特征 $r=+0.694$ vs 文本 +0.237;冻结编码器使 S² 降 41%、成功率 50.00%→30.21%;去噪全程 S² 变化≤6%,Block 14 在 15 个点中 13 次最高;LingBot-VA 去噪步 25→5 时成功率 56%→48%、S² 0.288→0.241。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 12 个微调 VLA 的 SimplerEnv-WidowX 闭环成功率预测 | Pearson r(单尾 p) | S²:+0.717(p=0.004),95% CI [+0.436, +0.912] | 无成熟可用的离线代理指标 | 首个在该设置下统计显著的离线代理指标 |
| 8 个原始 VLM 骨干预测其微调后 VLA 的成功率 | Pearson r | S²:+0.681(p=0.031) | VQA 平均分:−0.154(p=0.642,无相关) | 从完全无预测力到强相关,可在昂贵的 VLA 微调之前初筛骨干 |
| 3 个 WAM(Motus/LingBot-VA/Vidar)的 RoboTwin 成功率预测 | Pearson r | S²:+0.999(p=0.001),正确恢复全部排序 | SSIM +0.558;PSNR +0.468;FID +0.680(方向相反,不显著) | 唯一显著且方向正确的指标,大幅超越视频质量指标 |
| 6 个 WAM 的 RoboTwin 2.0 成功率预测(ALOHA 参考数据) | Pearson r | +0.718(p=0.054) | —(跨视频生成架构无既有指标对比) | 证明 S² 不限于 VLM 系模型,对视频生成系动作模型同样有效 |
| 5 个真机策略(MolmoB0T 共享物理评测:40 任务×3 试验×120 试验/策略) | Pearson r | +0.831(p=0.041,h=110) | —(该设定下无其他离线指标对比) | 把仿真中观察到的相关性迁移到真实机器人评测 |
| 14 个冻结视觉编码器的下游策略学习(21 任务 IQM 成功率) | Pearson r | 行为克隆:+0.677(p=0.004);视觉奖励 RL:+0.774(p<0.001) | 任务奖励 RL:−0.193 至 −0.002(无相关) | 在不训练策略的情况下排序视觉骨干,且相关性随方法对表征的依赖程度正确变化 |
局限与改进
作者承认三点局限:S² 与成功率只是跨模型的相关性,尚未证明在训练中直接优化感觉运动对齐能提升成功率;S² 相近的模型成功率仍可能差异很大,因此它只适合做闭环评测前的低成本初筛而非最终裁决;评测覆盖的模型族、基准和训练配方有限,每个对比中模型数很少(真机只有 5 个策略),真实机器人设定也只有一个。我的补充观察:真机相关性依赖探索性时域 $h=110$,而预注册的 $h=7$ 只有 $r=+0.429$($p=0.236$ 不显著),稳健性叙事在真机这一环打了折扣;WAM 的视频质量对比只有 3 个模型、6 模型主对比的 $p=0.054$ 也只是边缘显著;各模型成功率直接取自公开报告而非统一复跑,评测协议差异可能混入相关性;CogACT 家族内部检验($r=+0.826$)只有 3 个数据点、$p=0.191$ 缺乏统计效力;S² 数值量级很小($10^{-2}$ 量级)且 CKNNA 形式不保证落在 [0,1],跨论文横向比较困难;此外 S² 依赖带语言标注和本体感觉记录的演示数据,对没有轨迹记录的纯视频预训练语料无法直接使用。
独立分析的弱点
独立分析几个弱点。(1) 相关不等于因果:S² 高的模型成功率高,也可能是模型规模、预训练数据质量等共同原因驱动;改进方向是干预实验——在训练中加入 S² 式正则(类似 REPA 把扩散特征对齐到自监督视觉编码器)检验因果增益,作者只在结论中一句带过。(2) 对具身形态敏感是把双刃剑:负对照显示双臂模型配单臂数据相关性从 +0.999 崩到 +0.246,意味着每换一个机器人形态都要收集形态匹配的参考数据集;改进方向是研究形态无关的动作抽象或轨迹标准化。(3) 文本特征 S² 几乎不相关(微调后 $r=+0.237$,LLM 输入层甚至 $-0.325$)虽支持"VLA 忽视指令",但也可能是指令 token 池化或指令多样性不足的伪影——BridgeDataV2 每个指令最多保留 3 条 episode;改进方向是用大规模多样指令集复验。(4) S² 只能排序不能预测绝对成功率,S² 相近的模型仍需闭环确认;改进方向是校准式回归或多指标集成排序。(5) 各模型成功率取自第三方报告而非统一复跑,真机实验时域 $h$ 的选择也影响结论强度;改进方向是预注册评估协议并统一复测。
未来方向
作者在结论中明确提出:既然相关性成立,未来可以直接把感觉运动对齐作为具身模型的训练目标——例如在 VLA 微调或世界模型预训练中加入 S² 式正则项,这条路线与 REPA/CREPA(把扩散特征对齐到自监督视觉编码器)和 VIRAL(重对齐多模态 LLM 与其视觉编码器)一脉相承。基于本文成果还可延伸:(1) 数据策划——用 S² 筛选对动作结构信息量大的预训练数据,替代盲目扩大数据规模;(2) 训练监控——微调过程中在线跟踪 S²,替代频繁的闭环 checkpoint 评估,降低算力开销;(3) 机理修复——用 S² 定位指令跟随失效发生的层位、研究什么样的数据能增强文本特征的传感运动对齐,从根源解决 VLA 忽视语言指令的问题;(4) 模态扩展——把触觉、声音、力觉也当作世界的投影,检验多模态柏拉图假设在具身场景的完整图景;(5) 因果验证——通过表征干预(如微调时投影掉低 S² 子空间、或在推理时注入对齐扰动)检验对齐与成功率的因果关系;(6) 方法论改进——探索 CKNNA 分数的标准化使其可跨论文比较,以及 $h$、$k$ 的自适应选择或多种设置下的集成打分。
复现评估
复现条件较好。代码已在 GitHub(yunfeixie233/sensorimotor-alignment)开源并有项目网站;参考数据集公开(DROID、BridgeDataV2、ALOHA),被测模型全部是公开 checkpoint(StarVLA、CogACT、GR00T、Pi0、SpatialVLA、Qwen/PaliGemma/KosMos 系列、Motus/LingBot-VA/Vidar 等),下游成功率取自公开评测仓库(SimplerEnv、VLM4VLA、RoboTwin 2.0、MolmoB0T),不需要自己跑闭环。计算开销方面:只需对 $N\approx6000$ 个样本做一次前向编码加 kNN/DTW 计算,DTW 每对复杂度 $O(h^2)$、共 $O(N^2)$ 对,单机 GPU+CPU 可行;CKNNA 可复用 PRH 官方实现。难点在工程侧:需为每个模型找到正确的特征抽取位置(ViT 输出/LLM 输入/LLM 输出/去噪步/块深度)并复现各家微调配置;附录 B–D 给出了完整超参数表。总体属中等偏易的复现难度,核心相关实验一两天可跑完。
论文图表
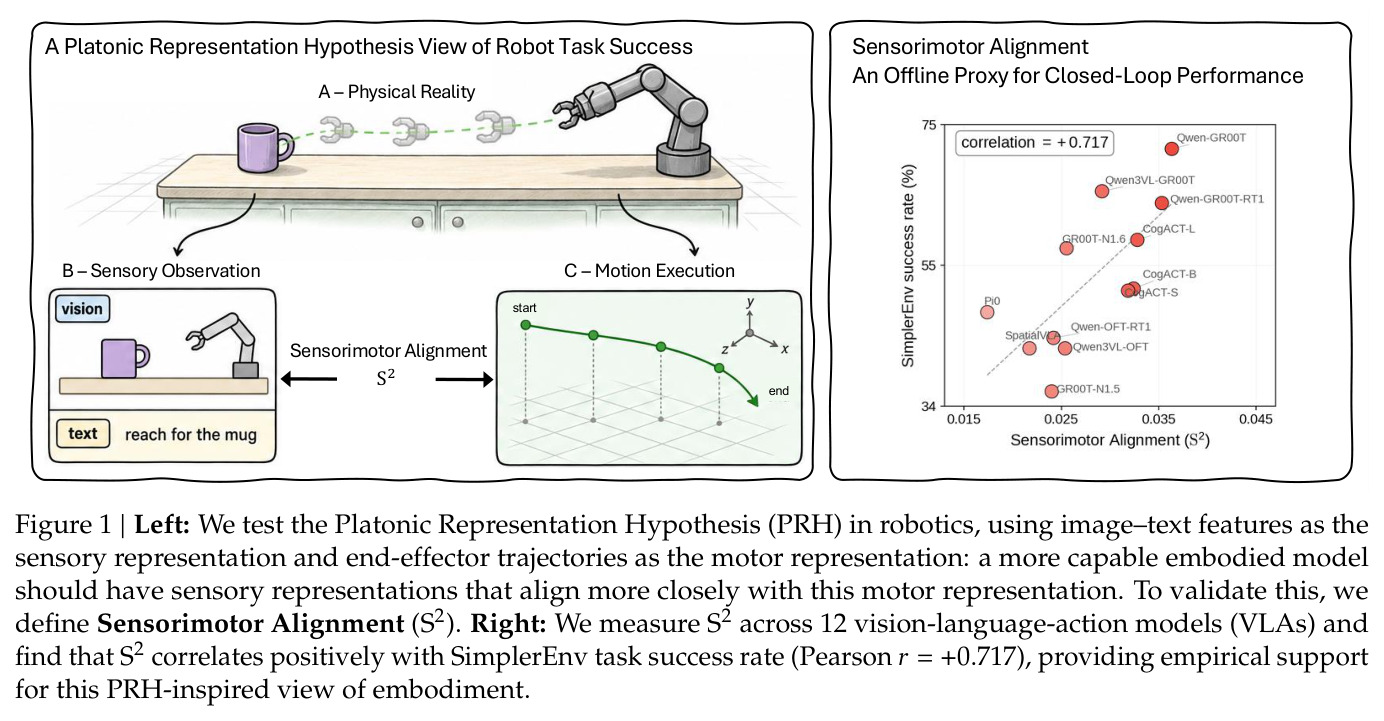
论文总览图。左半部分展示 PRH 视角的具身智能:物理现实(A)同时投射为感觉观测(B,图像-文本特征)和运动执行(C,末端轨迹),更强的具身模型应使感觉表征与运动表征更对齐,S² 即度量这种对齐。右半部分给出关键证据:12 个 VLA 的 S² 与 SimplerEnv 成功率正相关(Pearson r=+0.717)。
一图概括全文的核心假设、方法定义和最重要实验结论,是理解整篇论文逻辑起点和卖点的入口。
同一批 8 个原始 VLM(KosMos-2、PaliGemma-1/2、Qwen2.5-VL-3B/7B、Qwen3-VL-2B/4B/8B)的对比:左图 S² 与微调后 VLA 成功率相关 r=+0.681(p=0.031);右图 VQA 平均分与同一成功率的相关仅为 r=−0.154(p=0.642,无预测力)。
直接证明 S² 优于感知侧传统代理指标,是"为什么需要新指标"这一动机的关键对照实验。
对同样 12 个 VLA 和同一批 SimplerEnv-WidowX 成功率,分别用 DROID(Franka Panda,r=+0.717, p=0.004)和 BridgeDataV2(WidowX,r=+0.699, p=0.006)计算 S²,两个面板散点形态高度相似。
证明 S² 不依赖特定参考机器人:两套参考数据的机械臂运动学、场景、任务都不同但相关系数几乎一致,是方法实用性的关键稳健性证据。
对同一配方(Qwen2.5-VL-3B + FCDecoder,BridgeDataV2 微调)下冻结与不冻结视觉编码器的两个 VLA 对比:不冻结 S²=0.0245、SimplerEnv 成功率 50.00%;冻结后 S²=0.0144(下降约 41%)、成功率 30.21%(下降约 40%),h=7。
把"冻结视觉编码器为何掉点"这一已知现象归结为传感运动对齐增益被阻断,是支撑"端到端微调通过拉近感觉与运动表征来提升性能"这一解释的关键证据。
负对照实验:同样 3 个双臂 WAM 在 RoboTwin 上评测,用匹配的双臂 ALOHA 参考数据时 r=+0.999(p=0.001)正确排序;换成单臂 DROID 参考数据后相关性跌至 r=+0.246(p=0.421,不显著)。
证明 S² 真的在度量具身形态匹配的运动结构而非盲目报告对齐,这是方法有效性的关键负对照,也提示使用时必须匹配参考数据的臂型。
12 个 VLA 在 DROID(N=6000, k=10)上联合视觉-文本特征的 S² 逐模型数值,h 从 1 到 220 共 10 档:每个 h 下 Spearman ρ 为 0.725–0.802、Pearson r 为 0.610–0.717,峰值在 h=7(r=0.717),全部时域 p≤0.018 显著。
提供时域稳健性的完整逐模型数据,证明相关性与预测时域选择无关,且各模型的 S² 排序在不同 h 下高度一致。