用测试时回归重新思考序列压缩 Rethinking Sequence Compression with Test-time Regression
把序列压缩重构为端到端可学习的岭回归闭式求解,冗余 token 影响自动递减
前置知识
岭回归与对偶形式
岭回归是最小二乘加 L2 正则:$\min_h \frac{1}{2}\|Kh-v\|_2^2+\frac{1}{2}\lambda\|h\|_2^2$,因目标强凸有唯一闭式解 $h^\star=(K^\top K+\lambda I_d)^{-1}K^\top v$。当观测数 $T$ 小于特征维度 $d$ 时,可用 push-through 恒等式写成对偶形式 $h^\star=K^\top(KK^\top+\lambda I_T)^{-1}v$,把求解规模从 $d\times d$ 降到 $T\times T$,一次 Cholesky 分解即可。对偶形式中的 Gram 矩阵 $KK^\top$ 恰好编码 token 两两相似度。
本文前向传播就是一个岭回归闭式求解;理解对偶形式才能明白它为何高效、Gram 矩阵如何带来去冗余能力。
测试时训练与快权重(TTT / Fast Weights)
让网络在推理时针对当前输入自适应的范式:快权重程序员把隐状态当作小模型权重逐 token 更新;TTT 把它形式化为对自监督损失做内循环梯度优化;线性注意力、DeltaNet、Titans、MesaNet 可统一解释为在线回归——维护一个 key→value 回归器逐步拟合历史 token,MesaNet 甚至每步用共轭梯度解到收敛。
本文属于该谱系但反其道而行:利用块独立性一次闭式解到收敛,分清这一点才能看出它与 TTT 的本质差别。
分块稀疏注意力
长上下文高效注意力的主流范式:把上下文切成固定大小的块(如 64 token),为每块压缩出摘要向量作检索 key,查询对块评分选出 top-k 块,再只在选中块与局部窗口内做精细注意力,代表工作有 Landmark、MInference、NSA、MoBA、HiLS。压缩器质量直接决定远处相关信息能否被召回。
这是论文第一个实验场景;压缩器退化意味着相关块根本不会被选中,RULER 检索精度是压缩质量的试金石。
视觉 token 合并器
多模态大模型中视觉 token 通常远多于文本 token,主流做法(Qwen-VL、InternVL 等)把相邻 $2\times2$ 视觉特征拼接后过两层 MLP 压成一个 token 送入语言骨干;为更省算力可升级到 $3\times3$ 合并(token 数降为 1/9)。拼接+固定权重投影不感知组内相关性,背景 patch 等冗余特征会淹没细粒度信息。
这是第二个实验场景,检验 TTR 压缩出的表示能否保住视觉细节,尤其在 OCR 等文本密集基准上。
双层优化
嵌套优化结构:外层在参数空间优化任务损失,内层对每个输入求解一个优化问题,外层梯度穿过内层解反传(隐函数定理提供解析梯度),MAML 是典型例子。本文内层是岭回归闭式解 $h^\star(a,\rho)$,外层学习目标投影 $a$ 与正则参数 $\rho$。
TTR 的学习机制正是「外层学回归问题、内层适配输入」,不懂双层优化就看不懂它的训练方式。
研究动机
序列压缩是现代高效大模型中无处不在、却长期被当作"简单零件"的信息瓶颈。在分块稀疏注意力中,上下文被切成 64 token 的块,每块压成一个摘要向量作为检索 key,查询先对块评分再选 top-k 块做精细注意力——一旦压缩器丢掉块内的独特信息,下游无论多强都无法找回。在多模态大模型中,相邻 $2\times2$ 或 $3\times3$ 的视觉特征被合并成一个 token 再送入语言骨干,合并器决定了细粒度视觉信息的去留。然而主流实现极其简单:无参数的均值池化(均匀权重)、拼接后学习投影(固定位置权重)、或注意力加权池化(逐 token 独立打分)。论文指出它们的共同结构缺陷:聚合权重完全不考虑 token 之间的相互关系,只利用一阶统计量而忽略二阶相关性,于是冗余 token 互相加强、独特信息被稀释。瓶颈的严重性在数据里一目了然:345M 全注意力模型在超出 8K 训练长度外推到 16K/32K 时,RULER 平均精度跌到约 0.26,滑动窗口更是只有 0.06——压缩器质量直接决定长程信息可及性。
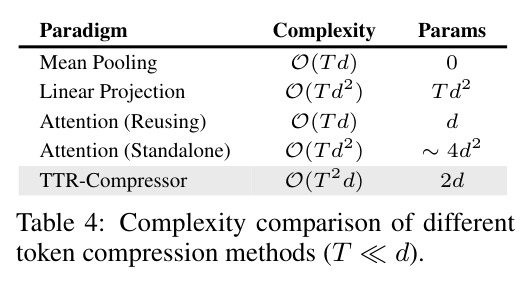
本文的目标是本文要把序列压缩从"静态加权平均"重新定义为"输入自适应的回归推断",并给出可直接用于大规模预训练的实用算子。具体目标有四条:一,压缩器显式建模 token 间二阶相关性,让冗余证据的影响力递减而非线性叠加;二,正则化强度不再依赖手工调参,而是由任务损失端到端学习,避免大模型预训练中昂贵的 ridge 超参搜索;三,在 $T\ll d$ 的典型场景(如 $T\in\{4,9,64\}$、$d\ge1024$)下计算复杂度避开 $O(d^2)$,每个压缩器只新增 $2d$ 个参数,可即插即用替换现有池化/投影;四,在两个要求截然不同的应用中同时有效:块稀疏注意力里压缩结果要当忠实的检索 key,RULER 平均精度大幅超过注意力加权池化等强基线;多模态合并里压缩结果要保真,用少于一半的视觉 token 达到标准 MLP 合并器相当的平均分。
与已有工作不同的是,测试时训练/快权重这条线(TTT、Titans、MesaNet、LaCT、DeltaNet 等)早已把序列建模解释为在线回归,但它们生成的是"输入相关的模型权重"或随后被查询的快权重记忆,且依赖逐 token 的迭代梯度更新或单步 delta 规则近似。本文抓住了一个被整个领域忽视的结构性机会:序列压缩是对互不重叠小块独立进行的,块与块之间没有任何序列依赖,因此内层回归可以不做任何迭代近似,用一次 $T\times T$ 的 Cholesky 分解精确解到收敛,既快又稳定可微;更进一步,它把回归的拟合系数本身(而非回归器权重)直接当作压缩表示输出。"无跨块依赖 + 闭式解即输出"这个组合让测试时回归第一次以极低开销变成即插即用的压缩原语,这是以往 TTT 文献从未利用的角度。
核心方法
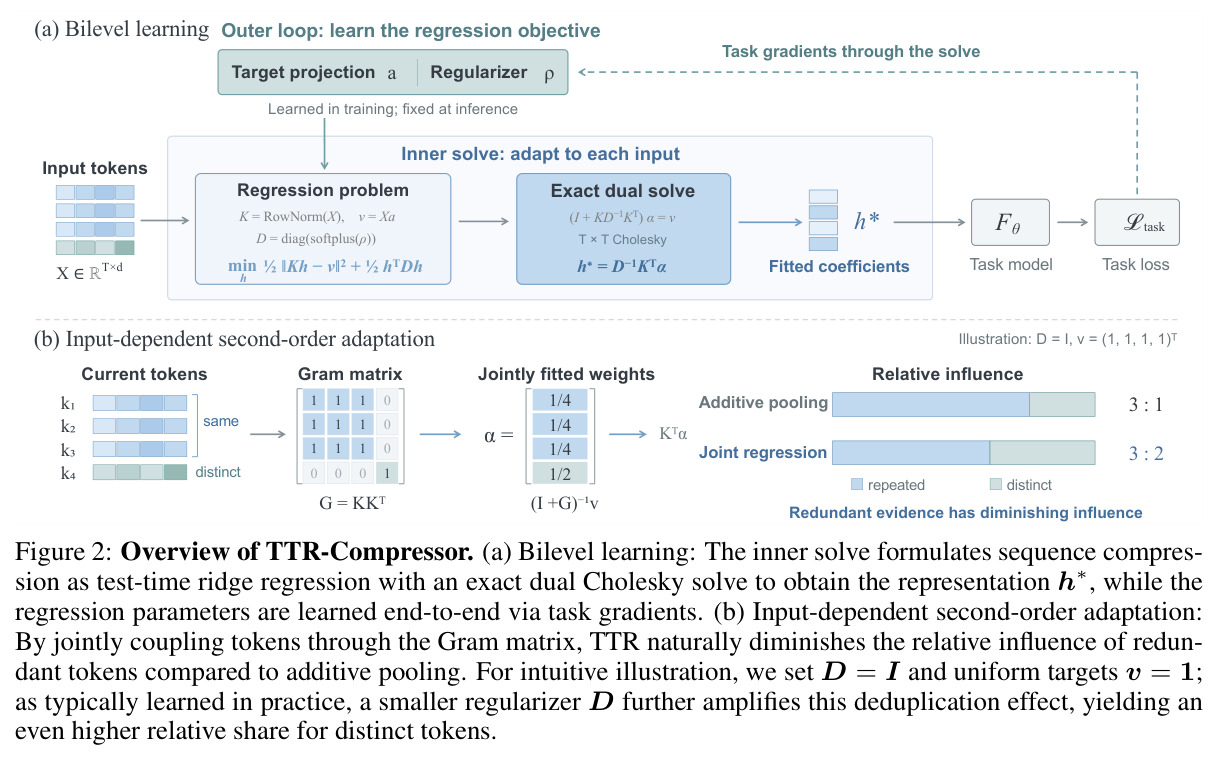
直觉上,均值池化像"每人投一票",拼接投影像"按座位发固定权重",它们都不看选民之间的关系;TTR-Compressor 换了一种问法——不让模型先验地决定聚合权重,而是让这组 token 自己定义一个回归问题:每个 token 提供自变量(归一化键 $k_t$)和因变量(标量目标 $v_t$),压缩表示取能最好拟合这些观测的回归系数 $h^\star$。因为拟合是联合进行的,两个高度相似的 token 无法让证据简单翻倍:回归把它们视为对同一信息的重复观测,边际贡献自动衰减,独特信息则保留较大影响力。技术上,给定 $X\in\mathbb{R}^{T\times d}$,构造 $k_t=x_t/\|x_t\|_2$、$v_t=a^\top x_t$($a$ 可学习),求解广义岭回归 $\min_h \frac{1}{2}\|Kh-v\|_2^2+\frac{1}{2}h^\top Dh$,闭式解 $h^\star=(K^\top K+D)^{-1}K^\top v$ 直接作为压缩输出;内层求解对 $a,\rho$ 可微(隐函数定理),端到端嵌进大模型训练,推理时对每个输入重解,无测试时迭代优化。
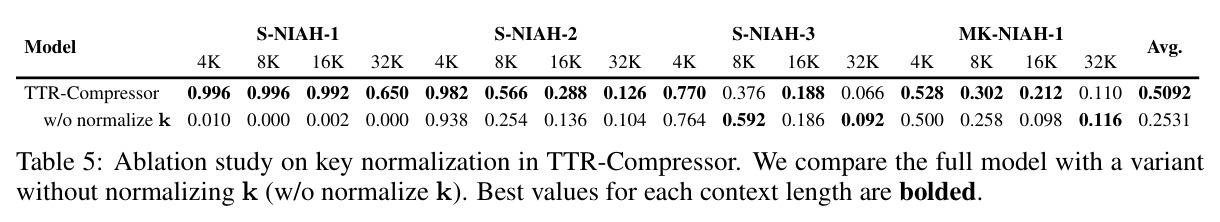
核心创新是把"用什么权重聚合 token"转化为"拟合哪个回归问题"。外层任务损失学习回归问题本身——目标投影 $a\in\mathbb{R}^d$ 与可学习对角正则 $D=\mathrm{diag}(\mathrm{softplus}(\rho))$,内层对每个输入精确求解,闭式解天然携带输入自适应的二阶结构:对偶形式 $h^\star=D^{-1/2}\tilde{K}^\top(I_T+\tilde{K}\tilde{K}^\top)^{-1}v$ 里的 Gram 矩阵元素 $G_{ij}=k_i^\top k_j$ 正是 token 两两语义相似度(键归一化保证只比较方向)。附录给出两个漂亮刻画:留一形式 $\alpha_t=r_t/(\lambda(1+q_t))$,其中 $r_t=v_t-k_t^\top h^{-t}$ 是其余 token 解释不掉的残差——若 token $t$ 被完全解释($r_t=0$)则 $\alpha_t=0$,其存在与否不影响表示;组饱和形式证明 $m$ 个重复 token 总贡献是 $S_c/(\lambda+m_c)$,第 $n$ 个重复 token 只增加 $O(n^{-2})$,而加性池化的贡献线性增长到 $m$。另一关键细节是非对称构造:键归一化、目标保留模长($v_t=a^\top x_t$);若目标也归一化,损失退化为 $\frac{1}{2}\|K(h-a)\|_2^2$,解坍缩到与输入无关的静态向量 $a$——保留模长迫使 $h^\star$ 同时整合语义与相对重要性,消融中去键归一化从 0.5092 崩到 0.2531 正是镜像证据。
方法步骤详情
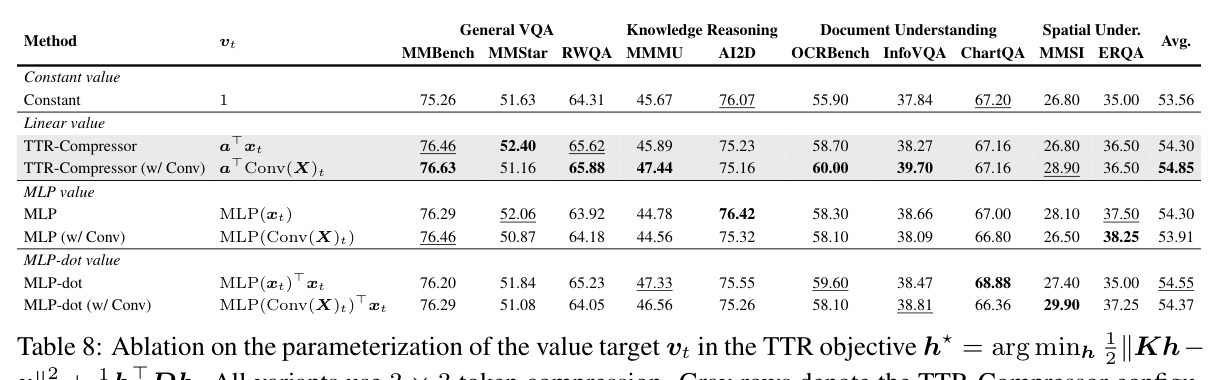
完整流程四步。第一步构造回归问题:输入是压缩窗口内 $T$ 个 token 特征 $X\in\mathbb{R}^{T\times d}$,每个 token L2 归一化得键 $k_t=x_t/\|x_t\|_2$;目标可选局部卷积增强——语言用块内核宽 5 的一维深度卷积、视觉用 $3\times3$ 深度卷积(无偏置无激活、恒等初始化),再经可学习投影得 $v_t=a^\top\mathrm{Conv}(X)_t$,键不卷积以保持归一化的几何意义。第二步内层精确求解:因块内 $T<d$,先以 $O(Td)$ 代价用 $D^{-1/2}$ 缩放键得 $\tilde{K}$,对正定阵 $I_T+\tilde{K}\tilde{K}^\top$ 做 $T\times T$ Cholesky 分解 $LL^\top$,三角求解 $LL^\top\alpha=v$,输出 $h^\star=D^{-1/2}\tilde{K}^\top\alpha$,总代价 $O(T^2d+T^3)$;卷积与投影用 BF16、回归求解用 FP32。第三步外层端到端学习:$h^\star$ 送入任务模型算损失,梯度穿过闭式解反传,$\nabla_a L=X^\top Ks$、$\nabla_\rho L=-\mathrm{sigmoid}(\rho)\odot h^\star\odot s$($s=(K^\top K+D)^{-1}g$ 为伴随量),每个压缩器只维护 $a,\rho$ 共 $2d$ 个参数、跨所有序列共享。第四步推理:$a,\rho$ 固定,对每个输入独立重解 $h^\star$。
技术新颖性
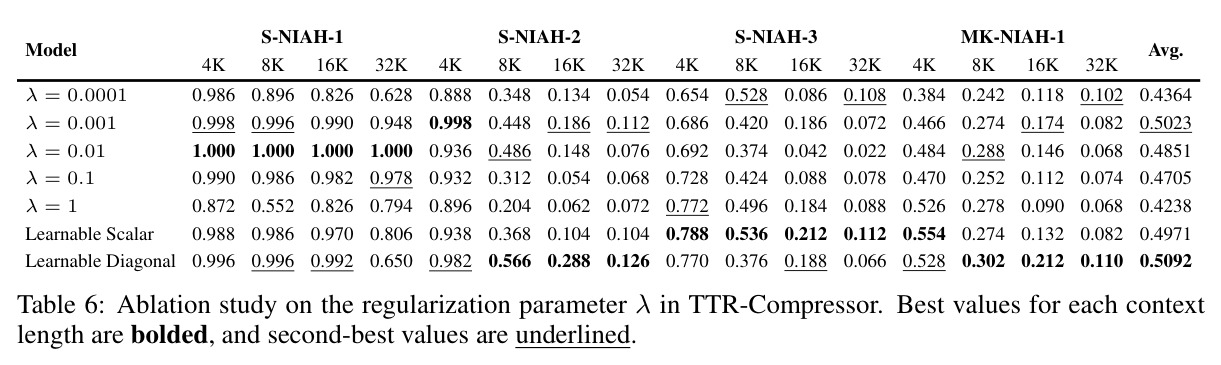
与三类已有方法的区别都触及机制层面。对比均值池化/拼接投影/注意力加权池化:它们逐 token 独立加权,组合规则固定、与输入的相关结构无关;TTR 的有效权重 $\alpha$ 由全部两两相似度与目标响应联合求解,且可学习对角 $D$ 把相似度度量变成任务塑造的各向异性几何 $\tilde{G}=KD^{-1}K^\top$——外层学"哪些维度该算冗余",内层在这个学到的几何下适配每个输入。对比线性注意力/DeltaNet/Titans 等在线回归:它们沿序列逐 token 单步更新(delta 规则近似),产物是被查询的快权重记忆;TTR 在互不依赖的小块上一次解到精确收敛,且输出直接就是表示本身。对比 MesaNet 这类把内层推到收敛的工作:后者需逐步共轭梯度迭代,TTR 用块独立性换来单次闭式 Cholesky。对比 Bertinetto 等可微分闭式求解器:那是元学习生成器权重,本文是元学习回归问题本身(目标与正则),消融显示可学习对角正则(0.5092)甚至超过人工调优的固定 $\lambda$(最好 0.5023)。
实验结果
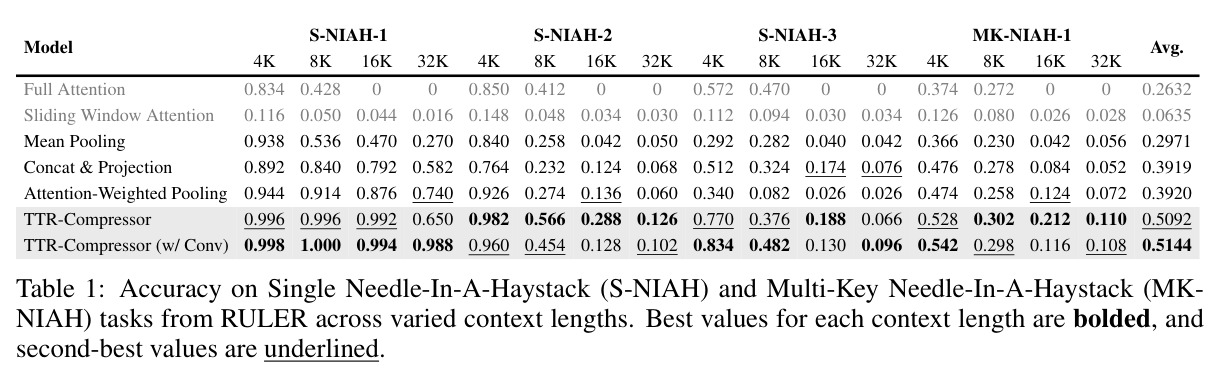
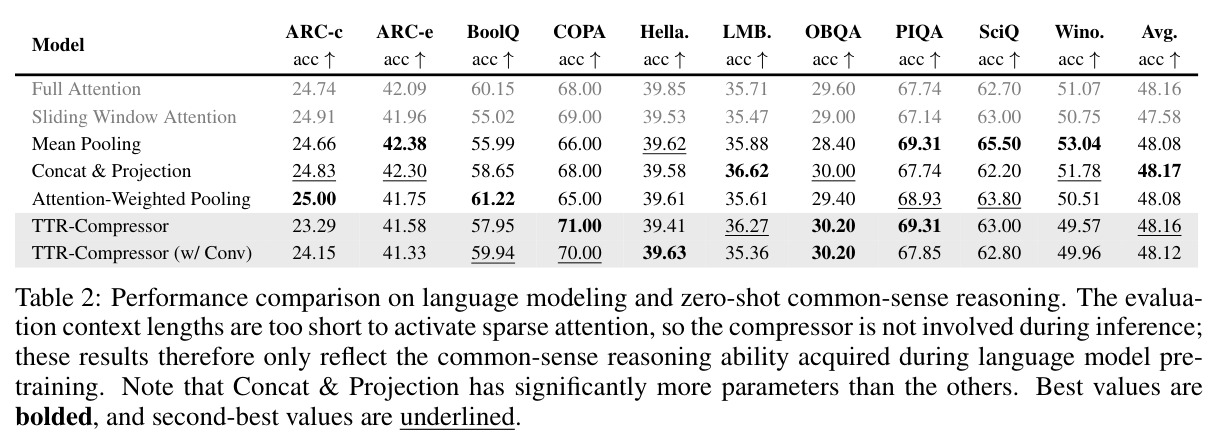
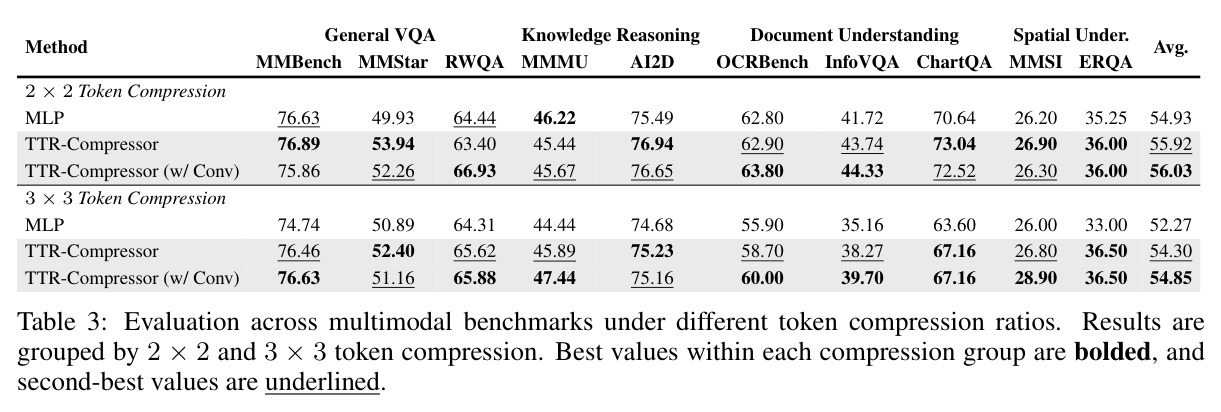
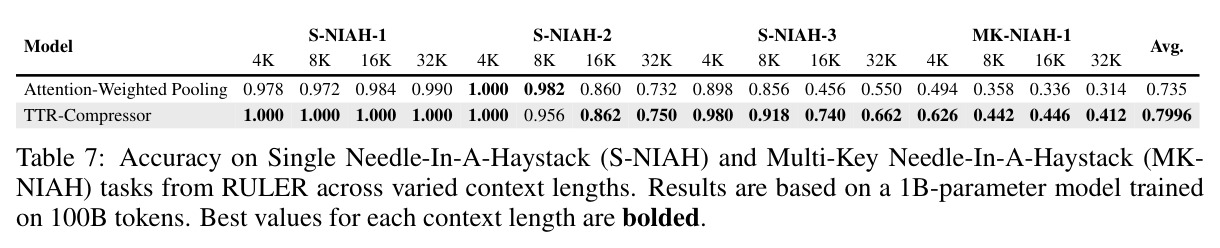
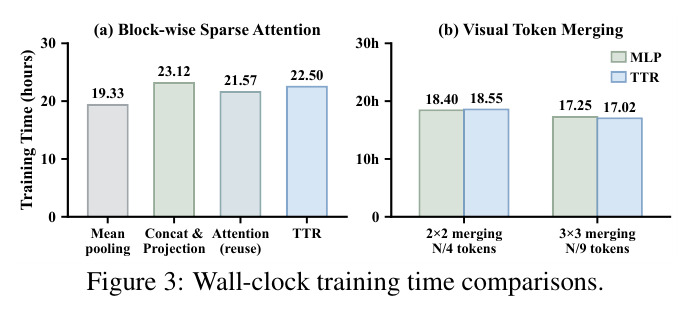
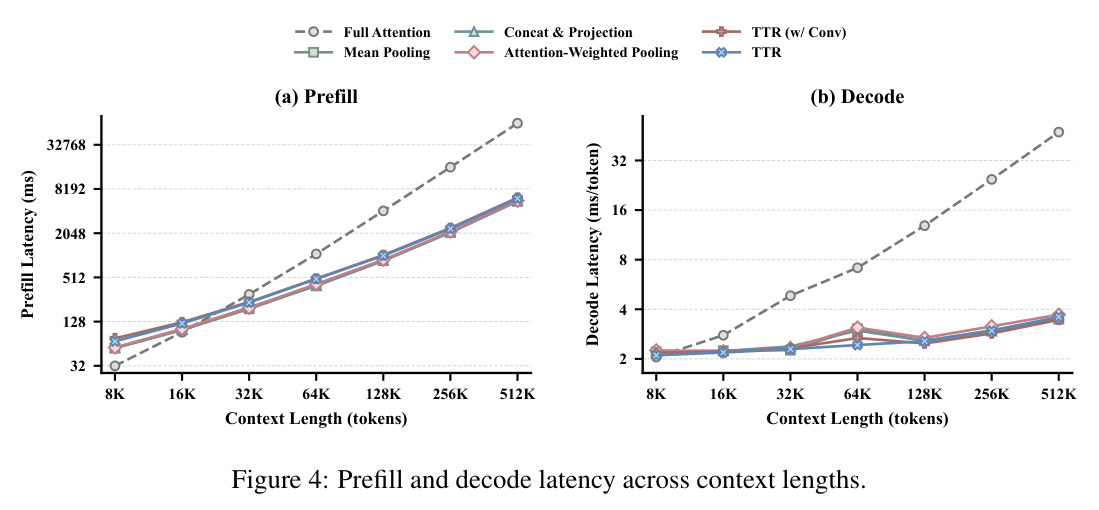
两大场景的实验都支持核心主张。块稀疏注意力(345M 模型、FineWeb 约 30B token、8K 上下文、64-token 块、每查询选 32 个远端块、512 局部窗):RULER 四类 NIAH 任务、4K–32K 上 TTR 平均 0.5092、卷积变体 0.5144,大幅超过注意力加权池化 0.3920、拼接投影 0.3919、均值池化 0.2971(卷积变体比最强基线高 12.24 分);外推优势更显著——S-NIAH-1@32K 卷积变体 0.988,而全注意力外推到 16K/32K 崩到 0。十项零样本常识基准上 TTR 平均 48.16 与全注意力持平,通用能力无损。视觉 token 合并(Qwen3-VL ViT + Qwen3-4B,两阶段训练):$2\times2$ 合并下 TTR 55.92、卷积变体 56.03,超 MLP 的 54.93;$3\times3$ 下优势扩大到 54.85 对 52.27(+2.58),增益集中在文本密集任务——OCRBench +4.10、InfoVQA +4.54、ChartQA +3.56;关键是 $3\times3$+卷积以减少 55.6% 视觉 token 的代价达到 MLP $2\times2$ 相当水平。效率上 TTR 只引入 $2d$ 参数、复杂度 $O(T^2d)$,8×H100 训练耗时约 22.5 小时与可学习基线相当,$3\times3$ 合并训练甚至快于 MLP(17.02 对 17.25 小时)。消融验证缺一不可:去键归一化崩至 0.2531;可学习对角正则 0.5092 超过一切固定 $\lambda$;扩大到 1B/100B token 后优势拉大到 0.7996 对 0.735。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RULER 大海捞针检索(S-NIAH/MK-NIAH,4K–32K) | 平均检索准确率 | TTR-Compressor 0.5092,加卷积 0.5144 | 注意力加权池化 0.3920、拼接投影 0.3919、均值池化 0.2971 | 卷积变体比最强基线 +12.24 分 |
| S-NIAH-1 @32K 上下文外推 | 检索准确率 | 0.988(w/ Conv) | 注意力加权池化 0.740;全注意力外推崩溃为 0 | +24.8 分,且远超训练长度的外推几乎无损 |
| 多模态基准 10 项平均(2×2 视觉 token 合并) | 平均分 | TTR 55.92,w/ Conv 56.03 | MLP 合并器 54.93 | +0.99 / +1.10 |
| 多模态基准 10 项平均(3×3 视觉 token 合并) | 平均分 | TTR 54.30,w/ Conv 54.85 | MLP 合并器 52.27 | +2.03 / +2.58;OCRBench +4.10、InfoVQA +4.54、ChartQA +3.56 |
| 视觉 token 用量对齐实验 | 达到 MLP 2×2 水平(54.85 vs 54.93)所需 token 数 | 3×3 合并(N/9 个 token) | MLP 2×2 合并(N/4 个 token) | 视觉 token 减少 55.6% |
| RULER(1B 模型 / 100B token 扩大规模) | 平均检索准确率 | 0.7996 | 注意力加权池化 0.735 | +6.46 分,上下文越长差距越大 |
| 零样本常识基准 10 项(ARC/BoolQ/HellaSwag 等) | 平均准确率 | 48.16 | 全注意力 48.16 | 持平,通用能力无损 |
| 训练墙钟时间(视觉合并,2×8×H100) | 小时 | 3×3 合并 TTR 17.02h | MLP 3×3 合并 17.25h | 高压缩比下训练反而更快 |
局限与改进
作者承认或隐含的局限:主实验基于 345M 小模型(作者引用 HiLS 的观点称小模型对 RULER 的 find-and-copy 类任务更有诊断性),虽有 1B/100B token 的补充实验,但距真正的大规模预训练仍有距离;RULER 以检索复制类任务为主,压缩器优势能否迁移到需要复杂推理的长上下文任务未验证;多模态实验固定在 Qwen3-VL + 4B 单一骨干上,跨骨干泛化性未知。我的独立观察:$T\times T$ 对偶求解的优势严格依赖 $T\ll d$,一旦压缩窗口增大到与 $d$ 同量级,$O(T^2d+T^3)$ 反而劣于直接的 $O(Td^2)$,论文只在 $T\in\{4,9,64\}$ 验证;块独立假设意味着跨块冗余无法消除,文档级重复内容仍会在每个块各占一个 key;非因果卷积目标依赖未来 token,流式/自回归场景不能直接使用;闭式解的可微性带来的训练稳定性,在更大规模、更长时间训练下只有损失曲线之外间接证据。
独立分析的弱点
独立分析几个弱点。一,适用窗口窄:效率论证建立在 $T\ll d$ 上,长文档摘要等 $T\sim d$ 场景优势消失,可引入 Nyström/低秩 Gram 近似或分治求解扩展适用域。二,跨块冗余盲区:块内去重做得很优雅,但文档级重复内容仍会在每个块各占一个 key,检索时浪费 top-k 名额,可加轻量跨块键合并或层级式 TTR。三,信息通道单一:键归一化后模长信息只能经标量目标 $v_t$ 单通道进入,若回归目标改成多维 $V\in\mathbb{R}^{T\times r}$ 一次输出 $r$ 个压缩向量,既保留更多信息又能让压缩比端到端可学习。四,非因果卷积目标在流式推理下不可用,应给出因果卷积或滑窗缓存变体并报告精度损失。五,语言侧只有检索型任务显出大差距,生成式长上下文任务(长文 QA、多跳推理)上的收益未量化,需补充更贴近真实用例的评测。六,FP32 求解加 BF16 训练的混合精度方案在 $D$ 条件数恶化时的数值稳定性未讨论,可研究对 $\rho$ 加约束或预条件化。
未来方向
作者展望把测试时回归确立为高效基础模型的通用原语。沿成果可延伸的方向:把标量目标推广为多维目标矩阵,一次回归输出多个压缩向量、压缩比可学习;与 KV 缓存压缩结合,把历史上下文的 KV 块用 TTR 压成低秩 key 以支持超长上下文;把块独立假设放松为重叠窗口或跨块消息传递,同时保留大部分闭式性;在音频、视频流等更长窗口的模态上验证;理论上把留一残差刻画(Proposition 2–4)推广到核化或非线性 TTR,研究外层学到的 $D$ 在收敛后的解析性质;工程上探索 Cholesky 求解的量化与端侧部署,以及与线性注意力层的统一实现——两者共享键归一化与 Gram 结构,有望合并 CUDA kernel。
复现评估
论文给出项目页 spherelab.ai/ttr-compressor,但该版本正文未附开源代码或权重链接,复现需自行实现。好在材料齐全:附录 A 给出对偶解完整推导,附录 C 给出数值精度(卷积/投影 BF16、回归 FP32)、卷积核尺寸与恒等初始化等细节;语言实验的数据(FineWeb、RULER NIAH)与架构(345M、16 层、hidden 1024、GQA 16/2 头、rank-64 查询校准、AdamW lr $3\times10^{-4}$、30K 步、全局 batch 128)全部写明;多模态侧基于公开的 Qwen3-VL ViT 与 Qwen3-4B-Instruct,训练数据(LLaVA-558K、1.3M 混合指令)与两阶段超参(lr $10^{-3}$/$2\times10^{-5}$、ZeRO-1、16K 序列)均已给出。算力门槛:语言侧 8×H100 约 22.5 小时,多模态 16×H100 约 17–19 小时——有集群的小团队可行,单卡不可行。核心算子代码量很小(构造键与目标、Cholesky 求解、梯度穿透),综合难度中等,主要成本在完整预训练与多阶段 SFT 流水线。
论文图表
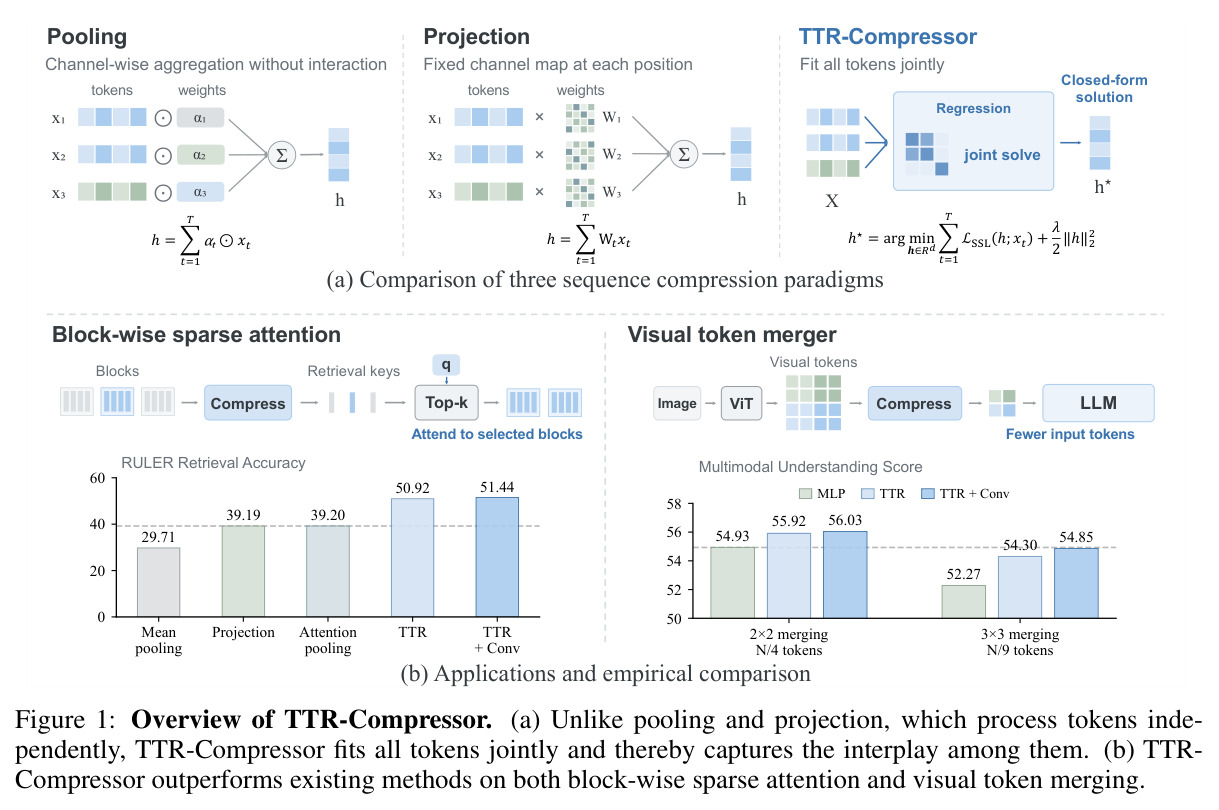
上半部分对比三种压缩范式:池化做通道级加权聚合、投影在每个位置施加固定通道映射,而 TTR-Compressor 把所有 token 放进同一个回归问题联合拟合、闭式求解;下半部分展示两大应用——块稀疏注意力中压缩后做 top-k 块检索、多模态中合并视觉 token,并给出 RULER 检索精度与多模态理解分数的实证对比。
一张图看懂论文的问题设定与两大应用场景,是快速判断这篇论文在做什么、和池化/投影本质差在哪里的入口。