基于测试时训练的潜空间压缩 Latent Compaction with Test-Time Training
冻结模型权重,测试时训练文档专属KV缓存,32×压缩下RULER达96.7%
前置知识
KV 缓存(KV Cache)
Transformer 自回归解码时,为避免每步重算注意力,会把每个 token 在每层的 key 和 value 缓存下来。一个 $N$ token 的文档在 $L$ 层、$H$ 个 KV 头上需存储 $2LHNd$ 个标量($d$ 为头维度),长上下文下成为显存与带宽瓶颈。所谓上下文压缩,本质就是把这份"文档记忆状态"变小。
本文的全部目标就是把这份缓存压到 1/32 而不丢信息,不理解缓存结构就看不懂方法设计。
测试时训练(Test-Time Training, TTT)
在推理阶段对模型(或其一部分参数)做自监督梯度更新,使其适应当前输入。经典做法(Sun et al., 2020)在测试样本上微调权重;TTT 层则把"在线学习的模型"当作循环隐状态。本文用法是:模型权重完全冻结,只对文档专属的 KV 槽位做梯度下降。
标题即方法:理解 TTT 才能明白为什么可以在不改动模型的前提下"训练"一个缓存。
注意力汇聚(Attention Sink)
LLM 倾向于在序列开头少数 token 上分配异常高的注意力质量,这些位置被称为 attention sink(Xiao et al., 2024)。丢弃它们会导致注意力分布崩溃、输出退化,因此流式推理方法都强制保留开头 token。
解释了初始化时为何把文档第一个位置强制纳入 anchor,以及注意力质量校准为何关键。
KVZip+ 重构评分
KVZip 用"遮住部分上下文再让模型重构"过程中每个 KV 对获得的最大注意力权重给条目打分;KVZip+(Jégou & Jeblick, 2026)进一步将该权重乘以投影值范数除以输入隐状态范数,衡量条目对残差流的实际贡献,得分高者优先保留。本文用它做基线和初始化信号。
preserver 全部由 KVZip+ 全局排名产生,且它是 32× 压缩下的主要对比基线。
分组查询注意力(GQA)
让多个查询头共享同一组 KV 头的架构,如 Qwen3-1.7B 用 16 个查询头共享 8 个 KV 头,可把 KV 缓存缩小数倍。本文以"层 × KV 头"为单位分配预算与训练槽位,同一 KV 头下的多个查询头共用一组条目。
预算分配、anchor 评分和 Stage 1 逐层拟合都以 KV 头为单位,不了解 GQA 会误解槽位数量。
研究动机
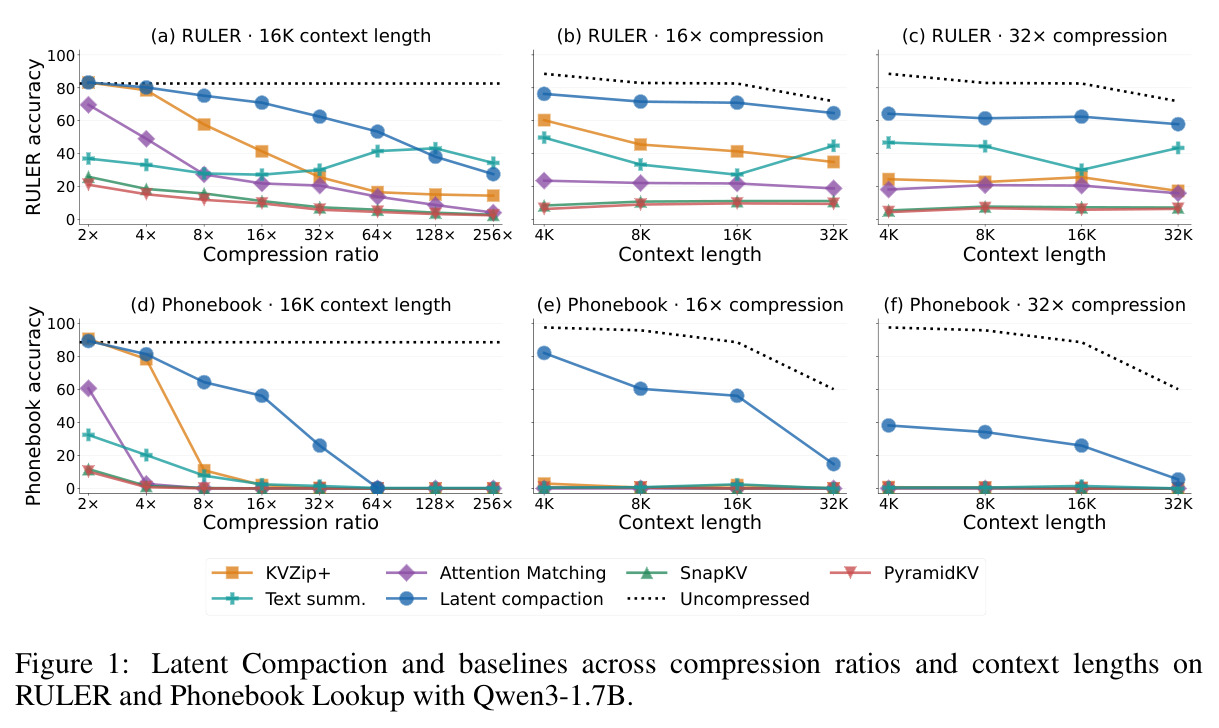
长上下文让 KV 缓存成为推理瓶颈:一个 $N$ token 的文档要在 $L$ 层、$H$ 个 KV 头上存储 $2LHNd$ 个标量,像 Qwen3-1.7B(28 层、8 个 KV 头、头维 128)处理 16K 上下文时,缓存会挤占显存、限制批大小并增加每步解码的带宽开销。现有方案各有硬伤:H2O、SnapKV、PyramidKV、Ada-KV 等驱逐方法只能从原始条目中挑选,被丢弃 token 的信息无法恢复;Claude 与 OpenAI 平台 2026 年采用的文本摘要式压缩(compaction)会漏掉"当下看不出重要、之后才被问到"的细节。关键约束是压缩发生在下游问题之前——缓存必须对任何未见问题保持信息完整。这一 query-agnostic 设定非常苛刻:32× 压缩下,最强的重构评分基线 KVZip+ 在 RULER 上只剩 40.0% 准确率。
本文的目标是本文要为每篇文档训练一个紧凑且可复用的 KV 缓存:在模型权重全部冻结、且完全看不到任何下游问题与答案的前提下,把缓存压缩到指定预算(每层每 KV 头平均 $B$ 个槽位,如 16K 文档压 32× 即 $B=128$),训练结束后固定缓存,供任意多个问题复用,使准备成本可摊销。量化目标是在 RULER、LongBench、Phonebook Lookup 三个基准上,与预算完全对齐的 KVZip+、Attention Matching、SnapKV、PyramidKV 及文本摘要基线对比,在 4×–32× 压缩区间大幅提高检索与理解准确率,并验证方法在 Qwen3-0.6B/4B/8B 和 MiniCPM5-1B/2B 上的可迁移性。
与已有工作不同的是,本文的切入角度是把 KV 缓存本身当成一个小型神经网络来训练,而不是一个待挑选的集合。已有三条线索各自停在半路:驱逐方法(KVZip 等)把条目当作不可变的原子,只做离散选择;Cartridges 用 self-study 优化语料缓存,但没有两阶段课程;Attention Matching 只拟合注意力输出与注意力质量,止步于此。本文抓住三个被忽视的缺口:(1) 初始化应组合互补规则——全局重构评分、教师注意力锚点、键空间覆盖性采样各管一件事;(2) 注意力拟合必须同时监督对数归一化因子 $\log Z$,否则文档注意力相对后续 token 的总质量无法校准;(3) 拟合之后还需端到端蒸馏做全局精炼。消融证明这三点各自贡献了决定性的性能差距。
核心方法
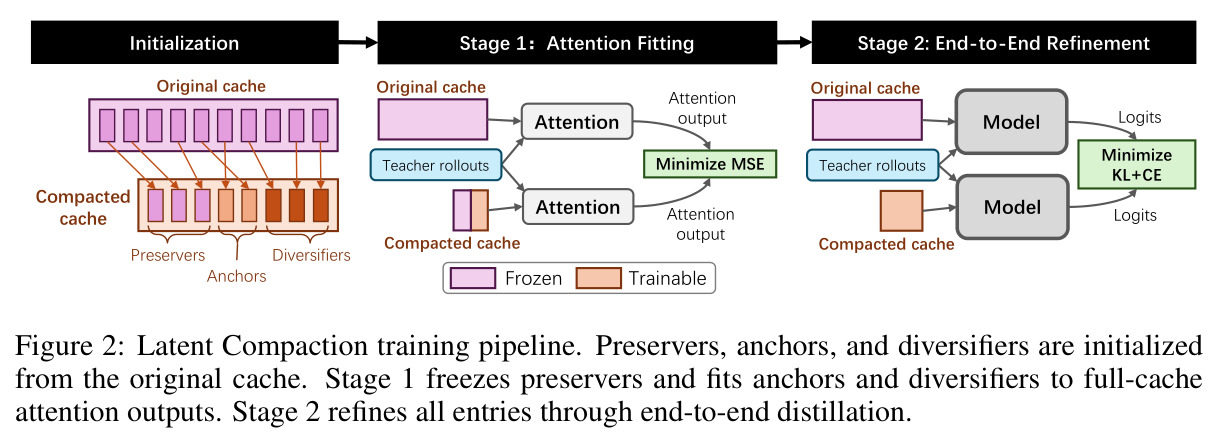
直觉上,一篇文档的完整 KV 缓存高度冗余,像一张可被有损压缩的图片:可以用每层每 KV 头平均 $B$ 个"可学习槽位"的潜表示去逼近它,并通过梯度下降不断提升逼近质量。技术路线分四步。(1) 采集教师信号:把文档预填进冻结模型得到完整缓存,用 480 条与任务无关的通用提示(24 种文档请求 × 20 种回答指令,各贪心生成至多 24 token)得到教师 rollout,全程不接触任何评测问题。(2) 初始化紧凑缓存:按全局 KVZip+ 评分选 preserver,按教师注意力峰值选 anchor(含文档首 token 作为 attention sink),用最远点采样选 diversifier,每个槽位额外带一个可学习的标量注意力偏置。(3) Stage 1 逐层做注意力拟合,用 MSE 对齐完整缓存的注意力输出与 $\log Z$。(4) Stage 2 联合优化全部槽位,用 top-20 分组 KL 蒸馏加 LM 损失做端到端精炼。推理时问题与生成 token 作为普通 KV 对追加,文档与新增两路注意力按归一化因子加权合并。
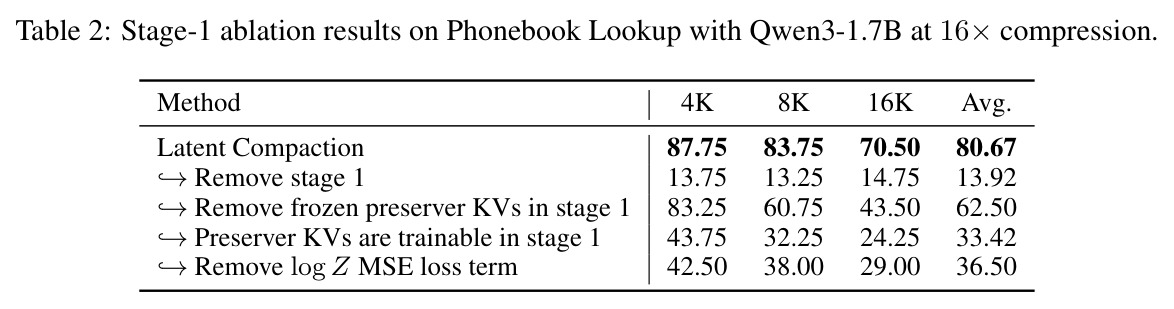
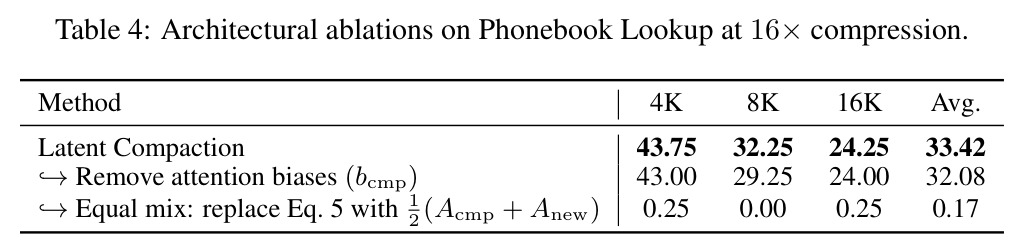
核心创新是把"压缩 KV 缓存"从一次性离散选择问题改写为对文档专属潜变量的连续优化问题,并用两阶段课程保证可训练性。每个槽位除 key/value 外还有标量偏置 $b_j$,进入打分 $\ell(q)=sK_{cmp}q+b_{cmp}$,既能改写条目相对权重、也能校准文档总注意力质量;压缩分支与后续 token 分支各自产出注意力输出和归一化因子,再按 $A_t=\frac{Z_{cmp}(q_t)A_{cmp}(q_t)+Z_{new,t}A_{new,t}}{Z_{cmp}(q_t)+Z_{new,t}}$ 合并,等价于对两路做统一 softmax。两个最反直觉的发现:其一,Stage 1 必须同时拟合注意力输出与 $\log Z$——去掉该项后 Phonebook 平均分从 80.67% 跌至 36.50%;其二,preserver 在 Stage 1 必须冻结——允许其训练反而掉到 33.42%,可见"先保住骨架、再全局放开"的课程顺序至关重要;若推理时把归一化加权换成简单平均,准确率直接崩到 0.17%。
方法步骤详情
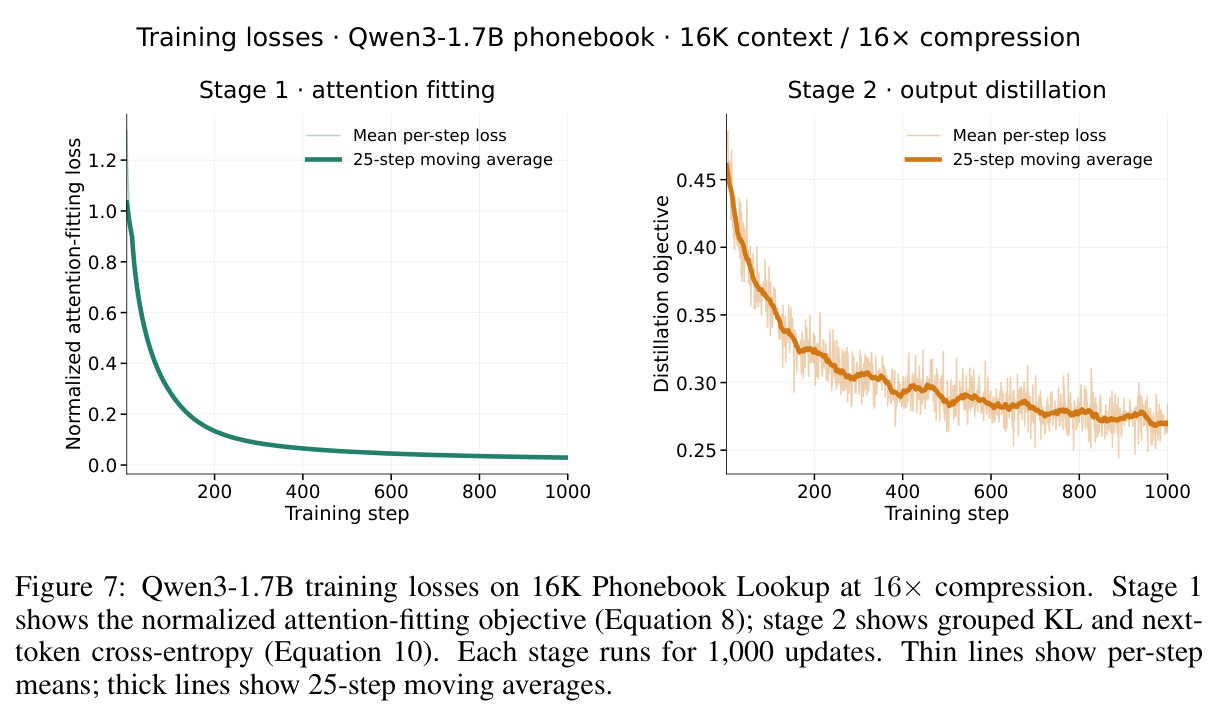
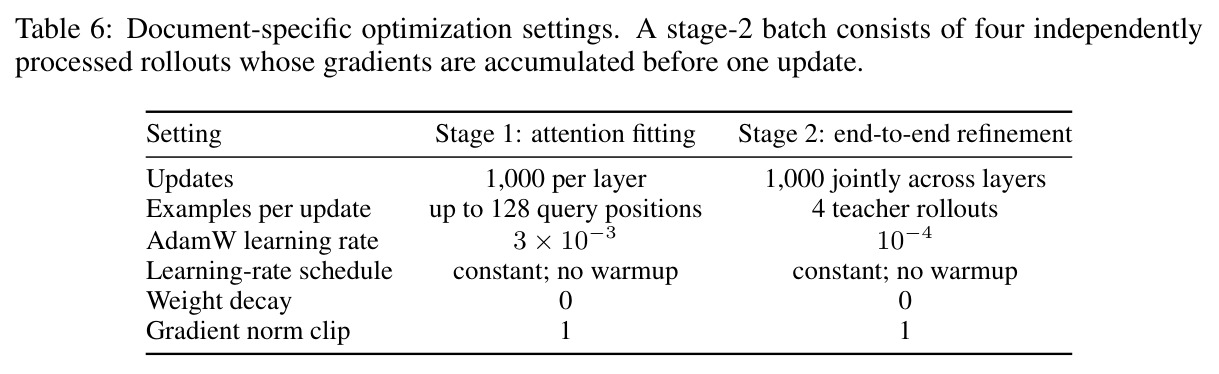
Step 1(预填与采集):输入原始文档文本,预填进冻结教师得到完整缓存;对 480 条通用提示(24 种文档请求 × 20 种回答指令)各贪心生成至多 24 token,收集每层每头的查询与教师 top-20 logits。Step 2(初始化):从预算 $B$ 取 $M=B/4$ 给 anchor+diversifier——anchor 占 $M$ 的 1/4,按文档首位置与教师注意力峰值 $a_i=\max_{q\in Q}[\mathrm{softmax}(sKq)]_i$ 选出;diversifier 用最远点采样保证键空间覆盖;其余 $LH(B-M)$ 槽位由全局 KVZip+ 排名选为 preserver。Step 3(Stage 1):每层独立训练 1000 步 AdamW(lr $3\times10^{-3}$,每步至多 128 个查询位置),以 $\mathcal{L}_{attn}=\mathrm{MSE}(\hat A_{cmp},\hat A_{full})+\mathrm{MSE}(\log Z_{cmp},\log Z_{full})$ 拟合教师,preserver 冻结。Step 4(Stage 2):全体槽位联合训练 1000 步(lr $10^{-4}$,每步累积 4 条 rollout 梯度),$\mathcal{L}_{stage2}=\mathcal{L}_{KL}+\mathcal{L}_{LM}$:分组 KL 对齐教师 top-20 与尾部质量,LM 项抬高教师贪心 token 概率。Step 5(复用):缓存固定,问题与生成 token 追加为普通 KV 对,按归一化加权合并两路注意力。
技术新颖性
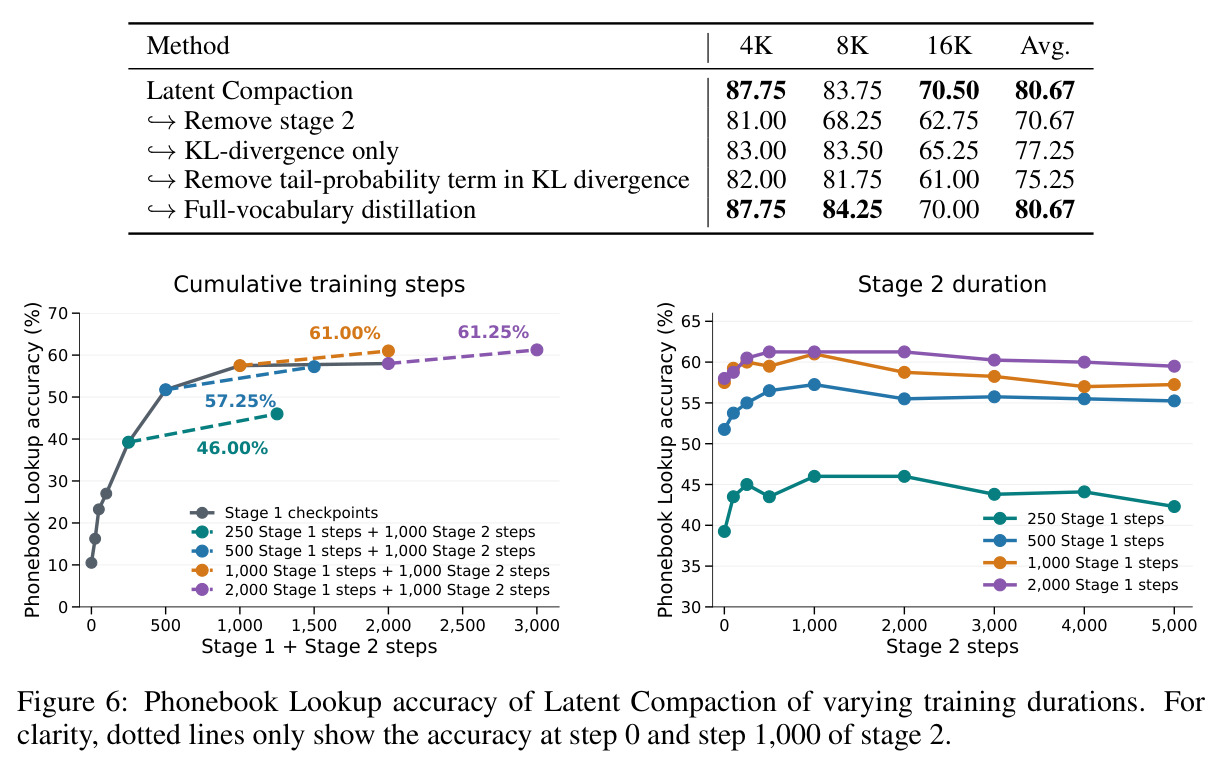
与既有工作的区别有三层。对驱逐方法(H2O/SnapKV/KVZip+):它们输出原始条目的子集,本文的条目是"潜变量"——初始化之后 K/V 与偏置继续被梯度改写,全局评分只决定初始位置而非最终形态。对学习式表示(Cartridges/Attention Matching):Cartridges 只做 self-study 蒸馏;Attention Matching 止步于注意力拟合,本文证明那只是"半成品"——补上 Stage 2 后 Phonebook 4K/8K/16K 分别再涨 6.75/15.50/7.75 个百分点。对 TTT 文献:TTT-E2E 更新模型权重且需元学习初始化,本文更新冻结 Transformer 内的文档槽位,无需改动架构。此外,分组 top-20 加尾部质量的蒸馏目标在几乎不损失精度的情况下(全词表蒸馏平均分同为 80.67%,无一致增益)大幅降低了教师目标的存储与计算成本,是工程上很实用的一笔。
实验结果
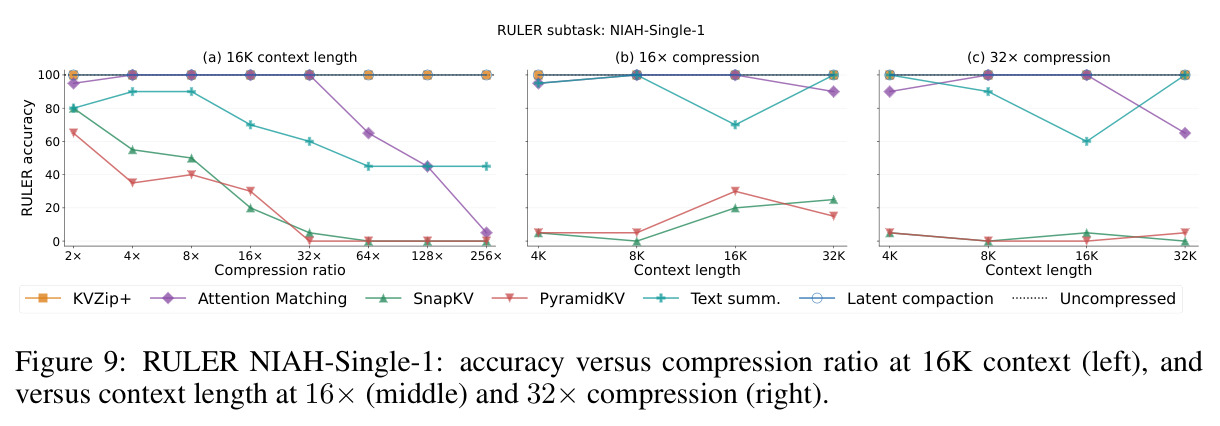
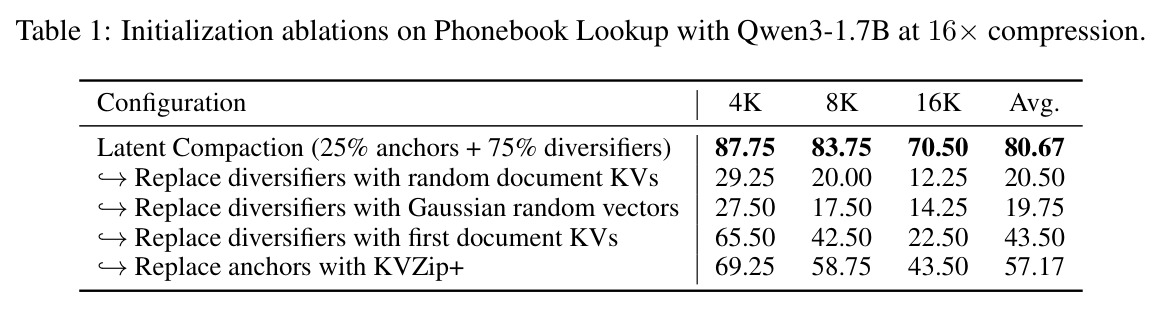
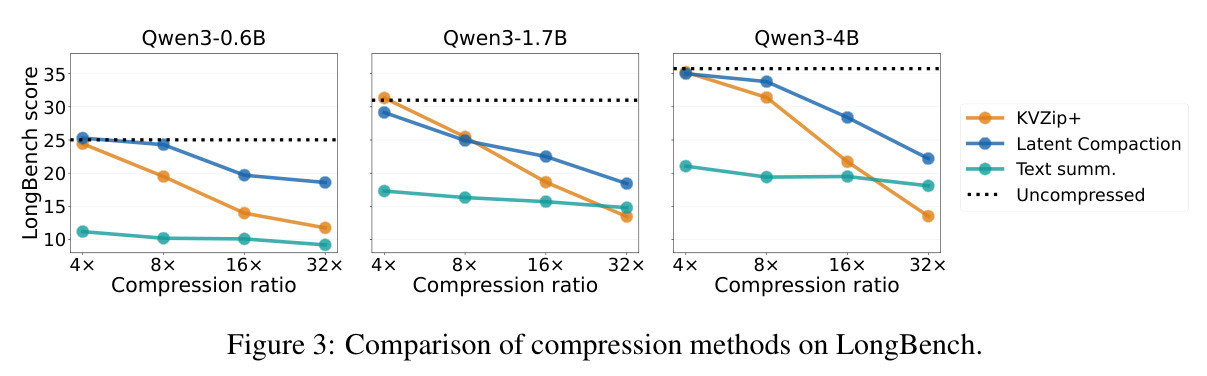
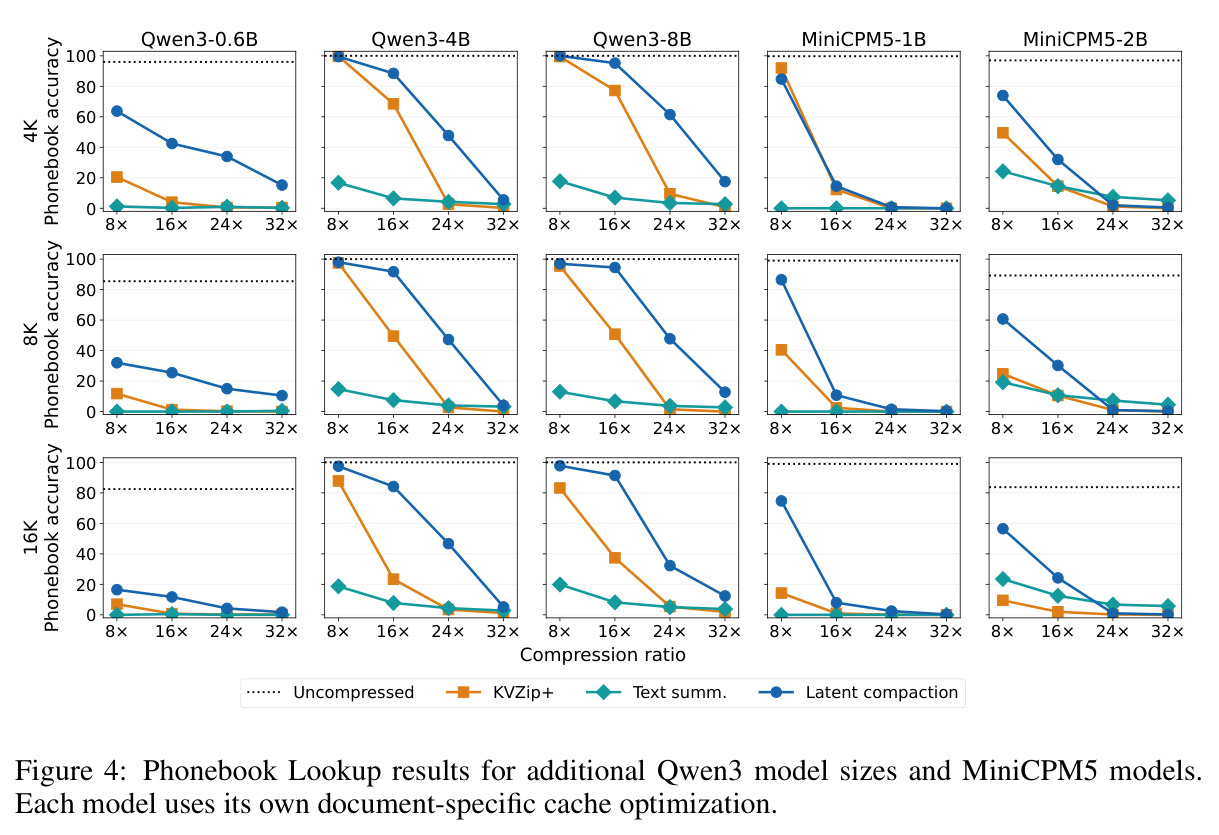
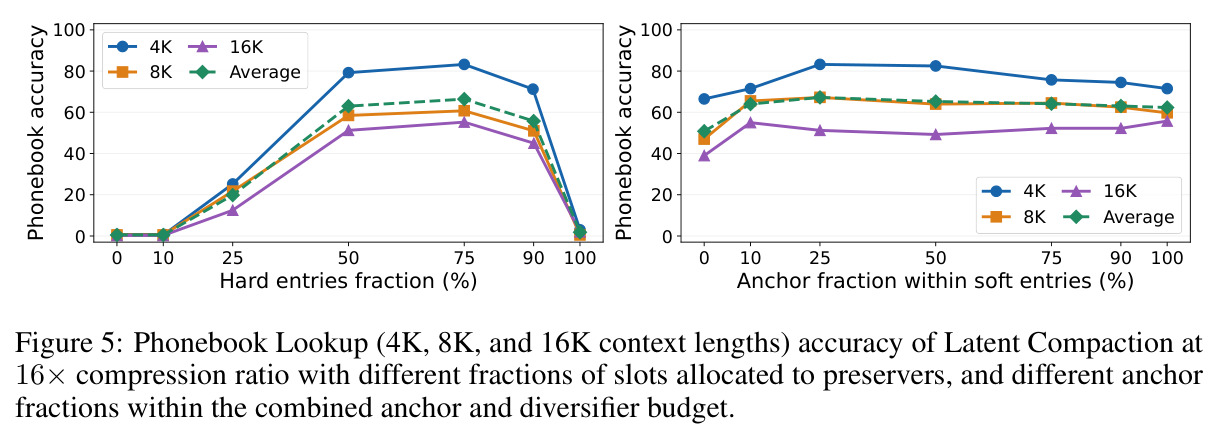
主实验覆盖三个基准与六个模型。RULER(Qwen3-1.7B,16K):32× 压缩下本文达 96.7%,KVZip+ 仅 40.0%,提升 56.7 个百分点;4K–32K 上下文、16×/32× 压缩下普遍领先,但 64× 以上所有方法趋近于零,最激进比率下文本摘要反超。Phonebook Lookup(16×):平均 80.67%,4K/8K/16K 分别为 87.75%/83.75%/70.50%,大幅领先预算匹配基线。LongBench(图 3):在 Qwen3-0.6B/1.7B/4B 上全程优于文本摘要、16×/32× 优于 KVZip+,压缩越强优势越大,但与未压缩仍有差距。迁移实验(图 4):增益在 Qwen3-0.6B/4B/8B 与 MiniCPM5-1B/2B 上全部成立。消融(16× Phonebook 平均 80.67% 为基准):diversifier 换成随机 KV、高斯向量、首部 KV 后跌至 20.50/19.75/43.50,anchor 换成 KVZip+ 跌至 57.17(表 1),preserver 占比影响最大、25% anchor 最优(图 5);去掉 Stage 1 掉到 13.92%、preserver 解冻 33.42%、去 $\log Z$ 项 36.50%(表 2);去掉 Stage 2 为 70.67%、全词表蒸馏无一致增益(表 3);1000+1000 步最优,Stage 1 翻倍仅 61.00%→61.25%、Stage 2 过长过拟合(图 6);去偏置仅微跌至 32.08%、等权平均替换归一化加权则崩到 0.17%(表 4)。
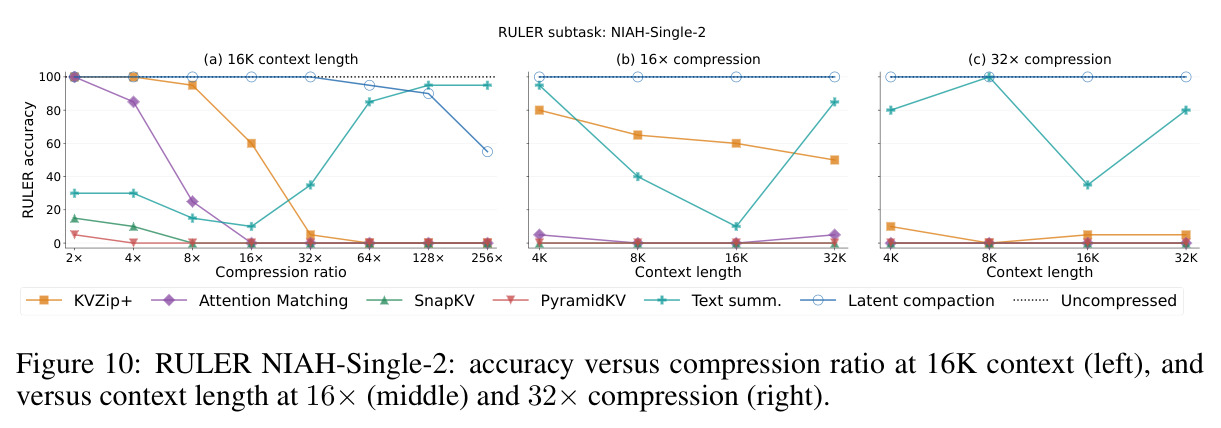
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RULER(Qwen3-1.7B,16K 上下文,32× 压缩) | 13 个合成任务聚合准确率 | 96.7% | KVZip+ 40.0% | +56.7 个百分点 |
| Phonebook Lookup(Qwen3-1.7B,16× 压缩) | 查找准确率(4K/8K/16K 平均) | 80.67%(87.75/83.75/70.50) | KVZip+、Attention Matching、SnapKV、PyramidKV、文本摘要(均远低于本文,精确值见图 1d) | 大幅领先全部预算匹配基线 |
| LongBench(Qwen3-0.6B/1.7B/4B,4×–32× 压缩) | LongBench 综合分数 | 全程优于文本摘要;16×/32× 优于 KVZip+;4× 与 KVZip+ 接近 | KVZip+、文本摘要、未压缩参考 | 压缩越强优势越大(见图 3) |
局限与改进
作者承认的局限:每篇文档的训练成本高昂(480 条教师 rollout 生成、每层 1000 步拟合、再 1000 步联合精炼);64× 以上极端压缩全部失效;且论文反复强调所有结论只针对"逻辑 KV 对预算",并未测量真实显存节省与推理加速。我的补充观察:槽位以 FP32 存储并携带偏置与掩码,实际内存收益可能低于压缩比的直觉预期;评测集中于不超过 8B 参数的模型,且合成检索类任务(RULER 13 个子任务、Phonebook)占比过重,自然文档上 LongBench 的增益随压缩增大而收窄、与未压缩差距明显;Stage 1 需逐层训练且压缩注意力路径不能用 FlashAttention(要额外输出 $\log Z$ 与偏置),工程效率存疑;基线列表中没有最相近的 Cartridges;全部实验用贪心解码,未覆盖采样式生成与真实多轮对话场景。
独立分析的弱点
弱点一:成本-收益账没算清。480 次教师生成加约 29000 步优化(28 层×1000 步 Stage 1 加 1000 步 Stage 2)只对会被反复查询的文档划算,论文未给出墙钟时间或摊销盈亏点,改进方向是报告成本-复用次数曲线,并做免训练的摊销式初始化。弱点二:物理收益未验证。FP32 槽位、每槽一个标量偏置、ragged 掩码都会吃掉压缩红利,建议把槽位量化到 BF16/INT8 并实测显存与吞吐。弱点三:归一化校准脆弱——表 4 显示推理时把加权合并换成等权平均后准确率从 33.42% 崩到 0.17%,说明方法对 softmax 实现细节极其敏感,需要更鲁棒的合并机制或在训练中加入数值扰动正则。弱点四:固定 480 条通用提示偏向"摘要式"探测,对代码库、表格等结构化文档可能失配,可按文档类型自适应生成提示或引入基于困惑度的采样。弱点五:各层各头等预算,未探索 Ada-KV 式的头间/层间自适应分配,某些头或许值得更多槽位。
未来方向
作者提出的方向是降低准备成本并扩展到更广任务。基于成果可延伸的路线:一是元学习跨文档共享的初始化(借鉴 TTT-E2E 的 meta-learned init),把每文档约 2000 步的训练压缩到几十步甚至零步;二是从单文档扩展到 Cartridges 式的语料级多文档记忆,研究多文档间的干扰与槽位共享;三是与 KVzap 结合,训练轻量评分器加速 KVZip+ 全局排名;四是给 FlashAttention 类内核暴露 $\log Z$ 与逐条偏置接口,把"逻辑压缩"变成真实加速(论文已论证数学上可行);五是在线增量压缩——对话推进时滚动更新紧凑缓存,替代 Claude/OpenAI 的文本摘要式 compaction,这正好补上摘要会丢失细节的短板;六是从理论上解释 64× 处的断崖式失效,刻画预算 $B$、文档长度 $N$ 与可保留信息量之间的标度关系。
复现评估
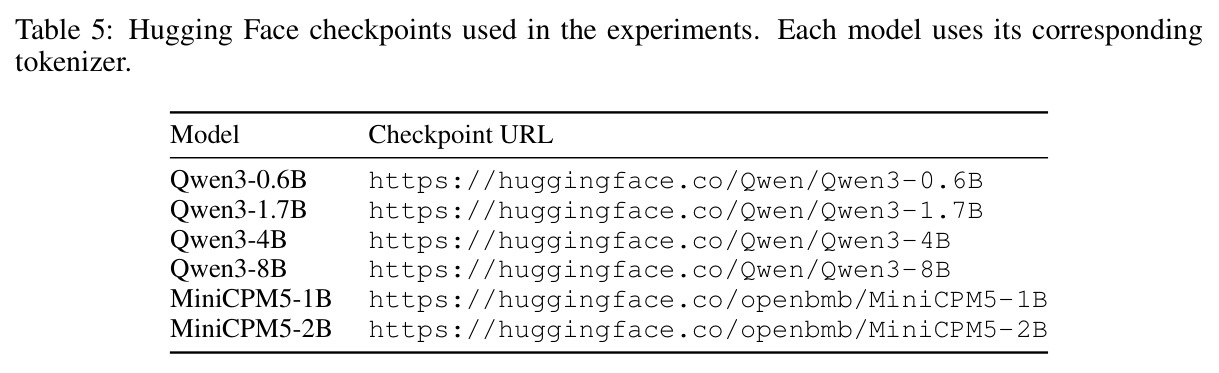
复现条件较好:代码已在 GitHub 开源(THUNLP/latent-compaction),附录 A 提供了近乎完整的配方——六个公开 HF checkpoint(Qwen3-0.6B/1.7B/4B/8B、MiniCPM5-1B/2B,哈希校验一致)、三个公开基准(RULER/LongBench/Phonebook Lookup)、全部超参数(AdamW,Stage 1 lr $3\times10^{-3}$、Stage 2 lr $10^{-4}$,各 1000 步,每步 4 条 rollout 梯度累积,梯度裁剪 1,槽位 FP32、模型 BF16),还附注意力合并的 Python 伪代码、Phonebook 提示模板和 480 条通用提示的构造规则(24 请求 × 20 指令),并声明同一文档种子跨条件配对、无基于评测题的选点。门槛主要在算力与时间:需单卡运行 Qwen3-1.7B 教师生成,Stage 1 逐层 1000 步且不走融合注意力,单文档训练可能耗时数小时。总体属于中低难度、高确定性的复现。
论文图表
Stage 2 消融:去掉 Stage 2 平均 70.67%;只用 KL 为 77.25%;去掉 KL 中的尾部概率项为 75.25%;换成全词表蒸馏为 80.67%,与默认持平。
量化端到端精炼的 10 个点贡献,并证明 top-20 分组蒸馏可以用更少的教师目标存储达到全词表蒸馏的精度,是实用性的关键证据。