V-CoLA:基于线性注意力的视觉 Token 压缩 V-CoLA: Vision Token Compression with Linear Attention
从线性注意力状态递归中挖掘内在 token 重要性信号,训练免费压缩视觉 token
前置知识
线性注意力(Linear Attention)
将 softmax 注意力的指数核替换为固定大小递归状态的注意力变体:模型把整段历史压缩进一个 $d\times d$ 矩阵状态 $S_t$,读取时通过 $o_t = S_t q_t$ 隐式检索。由于每步只做矩阵-向量运算,计算和显存对序列长度线性,而 softmax 注意力是平方复杂度。
本文所有重要性信号都源自线性注意力的状态递归动力学,不理解状态机制就无法理解重要性判据从何而来,也无法理解为何旧方法会失效。
Gated DeltaNet
近期被 Qwen3.5、InfiniteVL 等混合 VLM 采用的线性注意力变体,状态更新为 $S_t = S_{t-1}\alpha_t(I-\beta_t k_t k_t^\top) + \beta_t v_t k_t^\top$,其中 $\alpha_t$ 是衰减门、$\beta_t$ 是写入门,$k_t$ 做 $\ell_2$ 归一化。该更新等价于对逐 token 重构目标 $\frac{1}{2}\|Sk_t - v_t\|^2$ 的一步在线梯度下降。
V-CoLA 的实现和实验均针对 Gated DeltaNet 展开,其核心的重要性判据(重构误差)直接取自这个优化目标的视角,读懂式(2)(3)是理解全文的前提。
混合架构(Hybrid Architecture)
交错堆叠线性注意力层与少量 softmax 注意力层的架构设计,例如 Qwen3.5 采用 3:1 比例——每 4 个连续层包含 3 层 Gated DeltaNet 线性注意力层和 1 层门控 softmax 注意力层(带 GQA),用少量精确检索能力换取整体效率。Kimi-Linear 也采用类似设计。
论文的核心命题是现有视觉 token 压缩方法在混合架构上集体失效,Qwen3.5-9B/27B 与 InfiniteVL 是全部实验的载体。
视觉 Token 压缩
VLM 输入中视觉 token 数量远超文本 token(本文设定 880 个视觉 token 上界,长上下文达 2K–8K),成为推理延迟主导项。压缩方法分两类:基于 softmax 注意力分数剪枝的(FastV、SparseVLM、VisionZip),和基于隐层特征相似度做聚合的(DART、ToP、ToMe),目标都是在最小性能损失下减少 token 数。
本文要解决的正事:这些为 softmax 架构设计的方法无法迁移到线性注意力混合架构,需要全新的架构感知方案。
数据处理不等式与信息上限
信息论基本定理:对有损编码有 $I(M;S_L) \le H(S_L)$,编码器不可能保留超过自身容量的信息。论文据此论证:固定 $d\times d$ 状态的信息容量为 $H(S_L)=c\cdot d^2=O(d^2)$,而序列源信息 $H(M)=O(Ld)$,当 $L>d$ 时信息损失下界 $H(M|S_L)\ge\Omega(Ld-d^2)$ 随长度线性增长。
这一定理从理论上解释了注意力类和相似度类方法在混合架构上失效的结构性原因(浅层注意力集中被破坏、token 可区分性被改变),是方法设计的理论支柱。
分块并行(Chunk-wise Parallelism)
线性注意力的主流 GPU 加速实现:把序列切分为若干 chunk,chunk 之间顺序递归传递状态、chunk 内部完全并行计算,在效率与硬件并行度间取平衡。代价是状态只在 chunk 边界可访问,任意时刻无法读取中间状态,且标准前向只接受单条查询序列。
V-CoLA 的关键贡献之一是把重要性计算和 token 合并全部改造为与分块并行兼容的形式(扩展 DeltaRule 批量注入伪查询),否则方法只有理论价值、拿不到真实加速。
研究动机
VLM 的输入序列中视觉 token 数量远超文本 token(本文 Qwen3.5-9B 典型配置为 880 个视觉 token,长上下文场景可达 2K–8K),是推理延迟与显存的主导因素,因此视觉 token 压缩成为热门方向。但现有方法隐含依赖 softmax 注意力机制:注意力类方法(FastV、SparseVLM、VisionZip)用浅层注意力分数挑选重要 token,相似度类方法(DART、ToP)假设隐层特征保持可靠的相似度结构。作者在混合线性注意力架构 Qwen3.5-9B 上的系统实验(Figure 2)显示一个 surprising 的事实:这两类 SOTA 方法在 MME、MMB、GQA、SQA、TextVQA、POPE、VizWiz、MMStar 八个基准上的表现与随机剪枝基线几乎无差别,甚至全面落后——改进值在正负几个点内震荡,FastV 和 DART 都没有稳定超过 random baseline。Figure 1 的定性案例更直观:FastV 把图像顶部的烟花数字“2026”全部漏掉,DART 只从稀疏语义区域选 pivot 导致主要物体感知不足,而只有 V-CoLA 找全了所有主要区域并给出正确回答。
本文的目标是为线性注意力混合 VLM 设计一个专用的、训练免费的视觉 token 压缩框架,具体目标有三个:第一,重要性信号必须来自线性注意力自身内在机制,而不是 softmax 注意力图或特征相似度这两种在混合架构上失效的信号;第二,压缩操作要能按重要性分布自适应地分配压缩率——重要区域细粒度保留、冗余区域粗粒度合并,而非全局 top-k 硬剪枝;第三,所有计算必须与线性注意力的分块并行加速算子兼容,在真实推理中获得可测量的加速。量化目标是:在保留 50% token 时保住 99% 以上的原始平均性能,在更极端压缩率下显著超越所有现有基线,同时 prefill 阶段取得数倍加速且压缩本身开销可忽略。
与已有工作不同的是,本文的独特切入是把“线性注意力失效”反转成机会。理论上,作者用数据处理不等式证明固定大小 $d\times d$ 的递归状态存在信息上限:$I(M;S_L)\le H(S_L)=c\cdot d^2=O(d^2)$,而源信息 $H(M)=O(Ld)$,当 $L>d$ 时信息损失下界 $\Omega(Ld-d^2)$ 随序列长度线性增长——VLM 高分辨率输入下 $L\gg d$,这解释了为何依赖浅层注意力集中和特征可区分性的旧方法整体失效。但同一论证的另一面是:有限状态容量迫使式(2)中的门控有选择地写入与遗忘,模型在状态递归中的保留偏好本身就编码了 token 重要性。于是作者不再外借信号,而是直接从状态递归的“重构误差”(长期贡献)与“状态变化量”(短期唯一性)中读取重要性。此前只有 DTP 触及过类似思路,但它面向 Mamba 架构且仅用中间输出排序,性能次优;V-CoLA 是首个面向 Gated DeltaNet 混合 VLM 的系统性、可部署方案。
核心方法
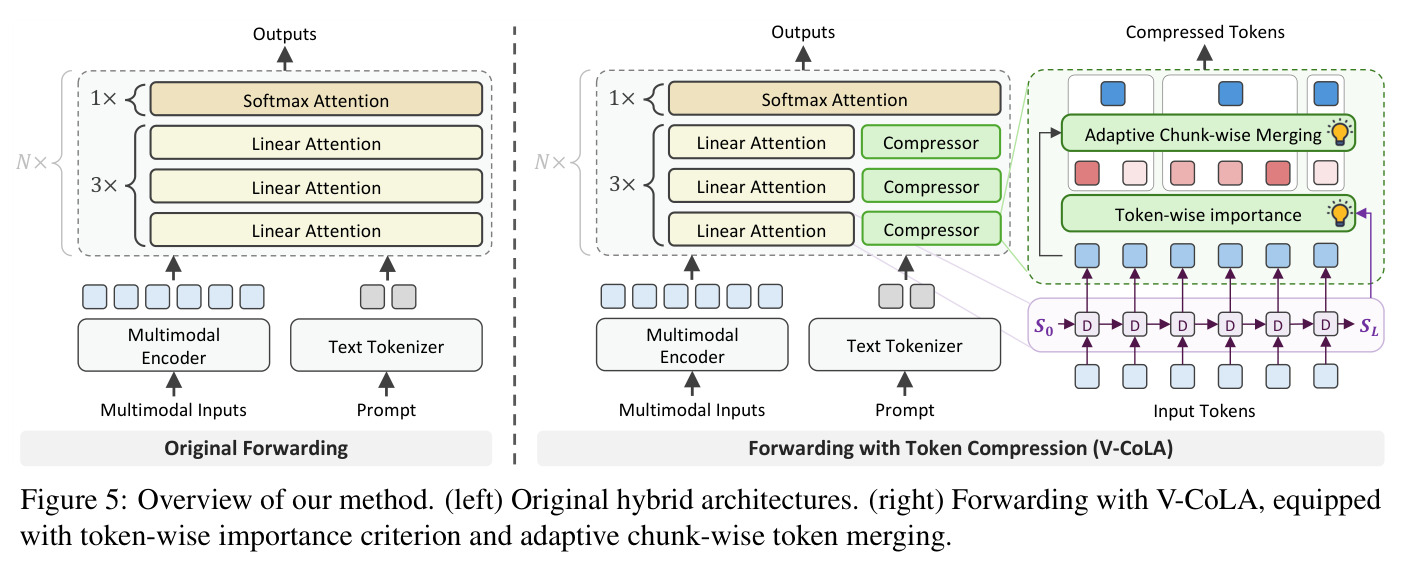
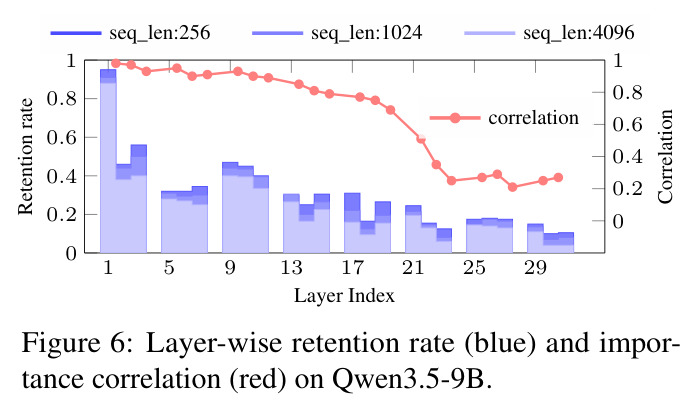
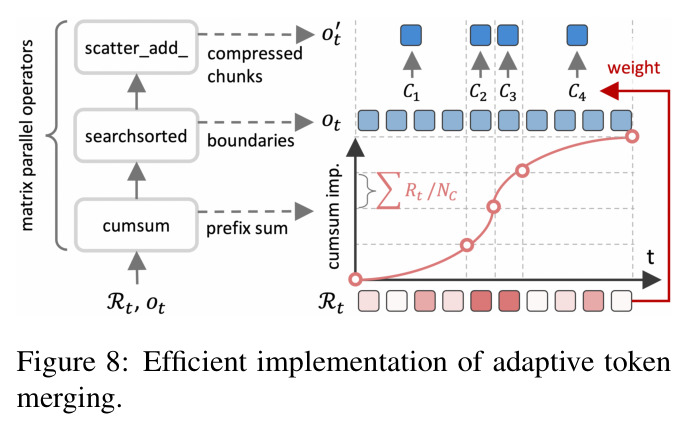
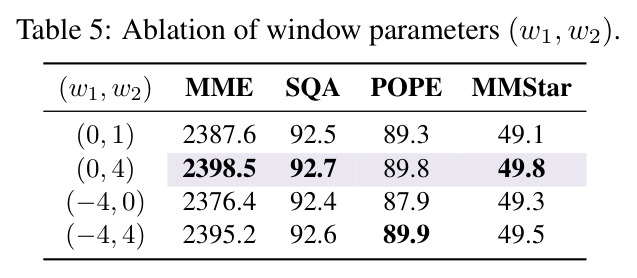
直觉上,线性注意力的状态就像一本容量固定的笔记本:模型每读一个 token 都要决定“写什么、擦什么”,被认真写入并稳定保留在最终状态里的信息就是重要信息,写入后立刻被后续更新抹平的信息则是冗余信息。V-CoLA 据此设计三步流水线:(1) 在前向过程中并行计算每个视觉 token 的唯一性感知重要性分数 $R_t$;(2) 按重要性分布把 token 序列自适应划分为“重要性质量相等”的若干 chunk,并在每个 chunk 内做 softmax 加权合并而非硬剪枝,重要区域被切得更细、冗余区域合并更狠;(3) 利用“深层几乎不再需要视觉输入”的观察(移除 layer-24 之后的视觉 token 后 MME 为 2401.6,甚至略高于全 token 的 2398.2),在第 24 层后丢弃全部视觉 token,即 early exit。工程上,所有计算都改造为与 Gated DeltaNet 分块并行兼容的矩阵运算:扩展 DeltaRule 支持批量伪查询注入,合并通过累计重要性曲线等分实现并行化。默认在 layer-1 末尾执行压缩,超参数为权重 $\lambda=0.1$、伪查询窗口 $(w_1,w_2)=(0,4)$、合并温度 $\tau=1.0$。
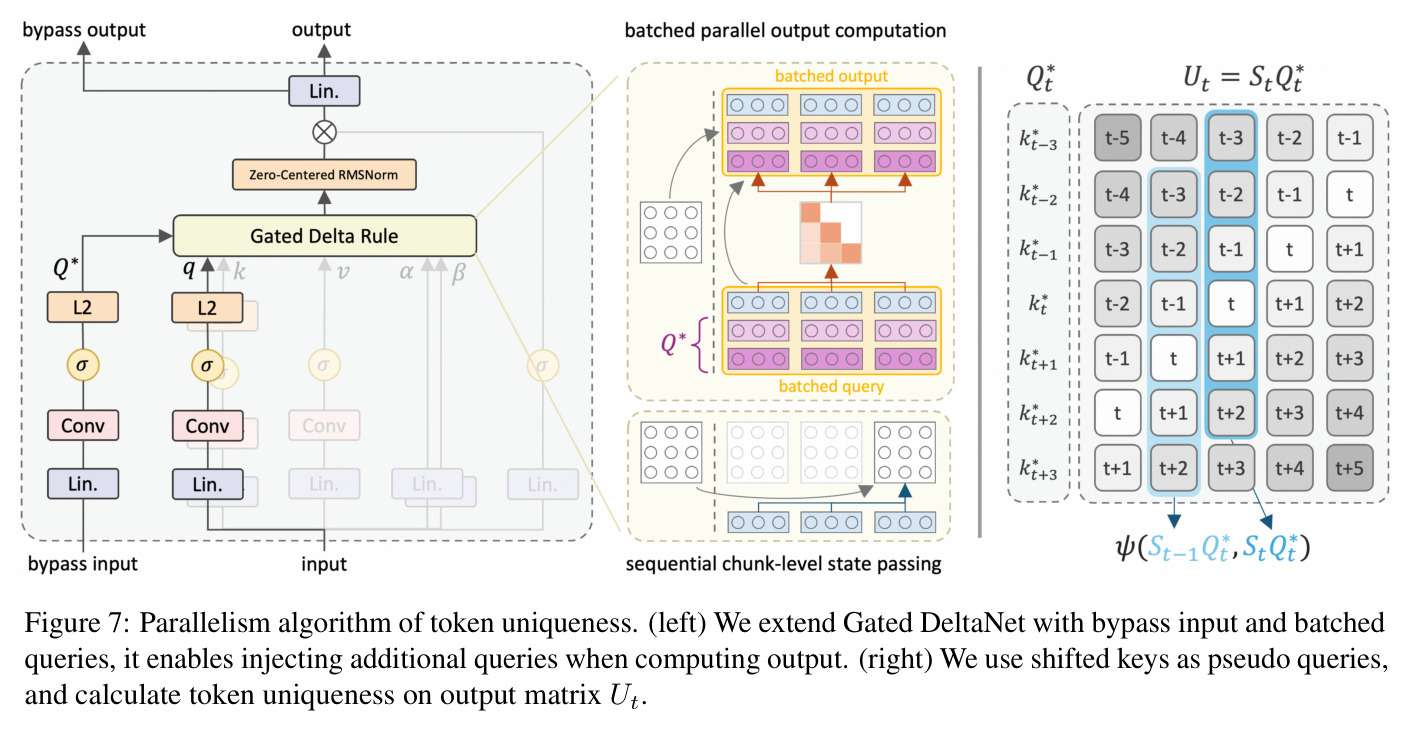
核心创新是把 token 重要性判据建立在线性注意力的“记忆重构”视角上,并从单一维度扩展为长短期结合的双判据。已有工作只看状态更新幅度一个维度,而 V-CoLA 首先用重构误差度量长期贡献:$R_{\text{impt}} = 1 - \psi(S_L k_t, v_t)$,其中 $\psi(a,b)=(1-\cos(a,b))/2\in[0,1]$ 是归一化余弦距离,$S_L$ 是序列最终状态——重构误差小说明该 token 的信息被忠实写入并保留在了最终状态中。但只看 $S_L$ 有两个盲区:会偏向显著区域选出大量冗余 token,且会漏掉“写入后交给下一层处理”或被门控累积衰减的长程 token。因此补充短期唯一性判据 $R_{\text{unit}} = \psi(S_t Q_t^{*\top}, S_{t-1} Q_t^{*\top})$:用邻近窗口 $Q_t^*=Q_{[t+w_1:t+w_2)}$ 内的 $w$ 条伪查询分别读取 token $t$ 被吸收前、后的状态,读出差异大说明后续更新对该 token 的抑制弱、即它与上下文冗余度低。最终融合为 $R_t=(1-\lambda)\cdot R_{\text{impt}} + \lambda\cdot R_{\text{unit}}$,两项都是 value 空间上的 $\psi$ 距离,$R_t$ 保持 $[0,1]$ 内可比。与已有方法的本质区别:信号完全来自状态递归动力学本身,无需注意力图、无需特征相似度假设、完全训练免费。
方法步骤详情
完整流程如下。第一步,正常前向至 layer-1 末尾,此时线性注意力层已产出递归状态,同时使用扩展版 Gated DeltaRule——它允许在计算输出时注入批量查询,且注入的查询只参与读出、不参与状态递归,故额外计算很低。第二步,计算长期重要性:对每个视觉 token $t$,用其 key 查询最终状态得 $S_L k_t$,与自身 value $v_t$ 的归一化余弦距离即 $R_{\text{impt}}$;该量只依赖原始输入与 $S_L$,天然兼容分块并行。第三步,计算短期唯一性:取位移 $\delta\in[w_1,w_2)$ 内的邻近 key 作为伪查询 $Q_t^*$(默认窗口 $(0,4)$ 即 token 右侧 4 个 key),单次前向得到伪输出矩阵 $U^*_{t,\delta}$,按 $R_{\text{unit}}=\psi(U^*_{t,\delta}, U^*_{t-1,\delta+1})$ 计算 token $t$ 被状态吸收前后的读出差异。第四步,融合 $R_t=(1-\lambda)R_{\text{impt}}+\lambda R_{\text{unit}}$。第五步,自适应分块合并:给定保留率 $\gamma$,把序列划分为 $L'=L\times\gamma$ 个 chunk,目标是每个 chunk 内重要性之和接近均值 $\bar R=\frac{1}{L'}\sum_t R_t$——实现上把累计重要性曲线视为连续函数、按目标 chunk 数等分得到理想边界,再对齐到最近的实际位置,全程并行矩阵计算;随后 chunk 内用温度 $\tau=1.0$ 的 softmax 权重 $w_t=\exp(R_t/\tau)/\sum_k \exp(R_k/\tau)$ 对 token 加权求和,得到压缩 token 序列向后传播。第六步,early exit:第 24 层起丢弃全部视觉 token。此外把温度调大可退化为硬剪枝,给用户保留灵活性。
技术新颖性
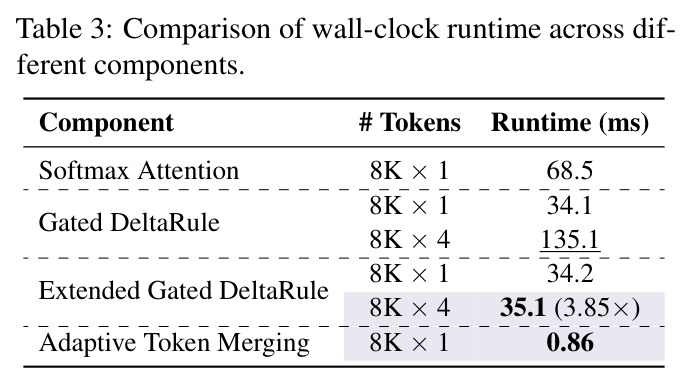
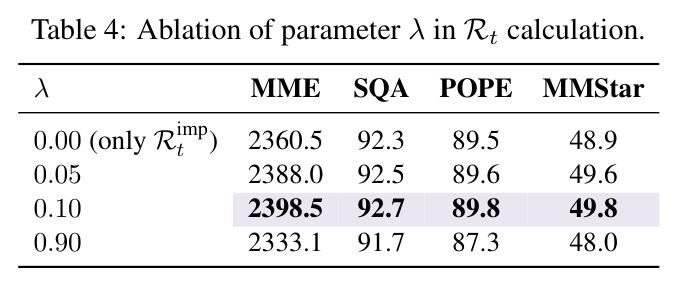
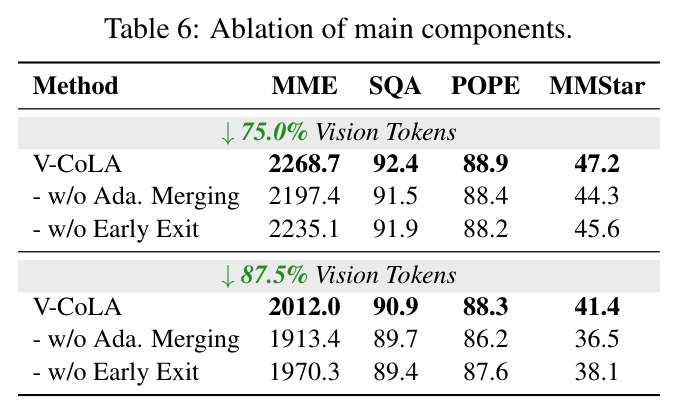
技术新颖性体现在四个层面。其一,重要性信号来源全新:不同于 softmax 注意力分数(FastV 系)或隐层特征相似度(DART/VisionZip 系),V-CoLA 直接从线性注意力的状态递归中提取信号,这是对第 2 节信息上限定理的正面回应,也是首个面向 Gated DeltaNet 混合 VLM 的系统性压缩方案。其二,长短期双判据:把“对最终状态的重构误差”(长期贡献)与“伪查询下状态读出的变化量”(短期唯一性)结合,比 DTP 仅用中间输出排序、以及 Park et al. 仅用状态更新幅度更完整;消融显示去掉 $R_{\text{unit}}$($\lambda=0$)会使 MME 从 2398.5 降至 2360.5、MMStar 从 49.8 降至 48.9。其三,合并策略创新:按重要性密度做等质量自适应分块,重要区域细 chunk、冗余区域粗 chunk,优于全局 top-k 剪枝——Table 6 显示去掉自适应合并后在 ↓75% 压缩下 MME 掉 71.3 分(2268.7→2197.4)、MMStar 掉 2.9 分。其四,工程实现创新:扩展 DeltaRule 批量注入伪查询后单查询延迟几乎不变(34.1→34.2ms)、4 查询时比原算子快 3.85 倍(135.1→35.1ms),自适应合并仅 0.86ms(8K token,约占 prefill 总成本 0.1%),使方法真正可部署——多数已有压缩方法与线性注意力加速算子根本不兼容。
实验结果
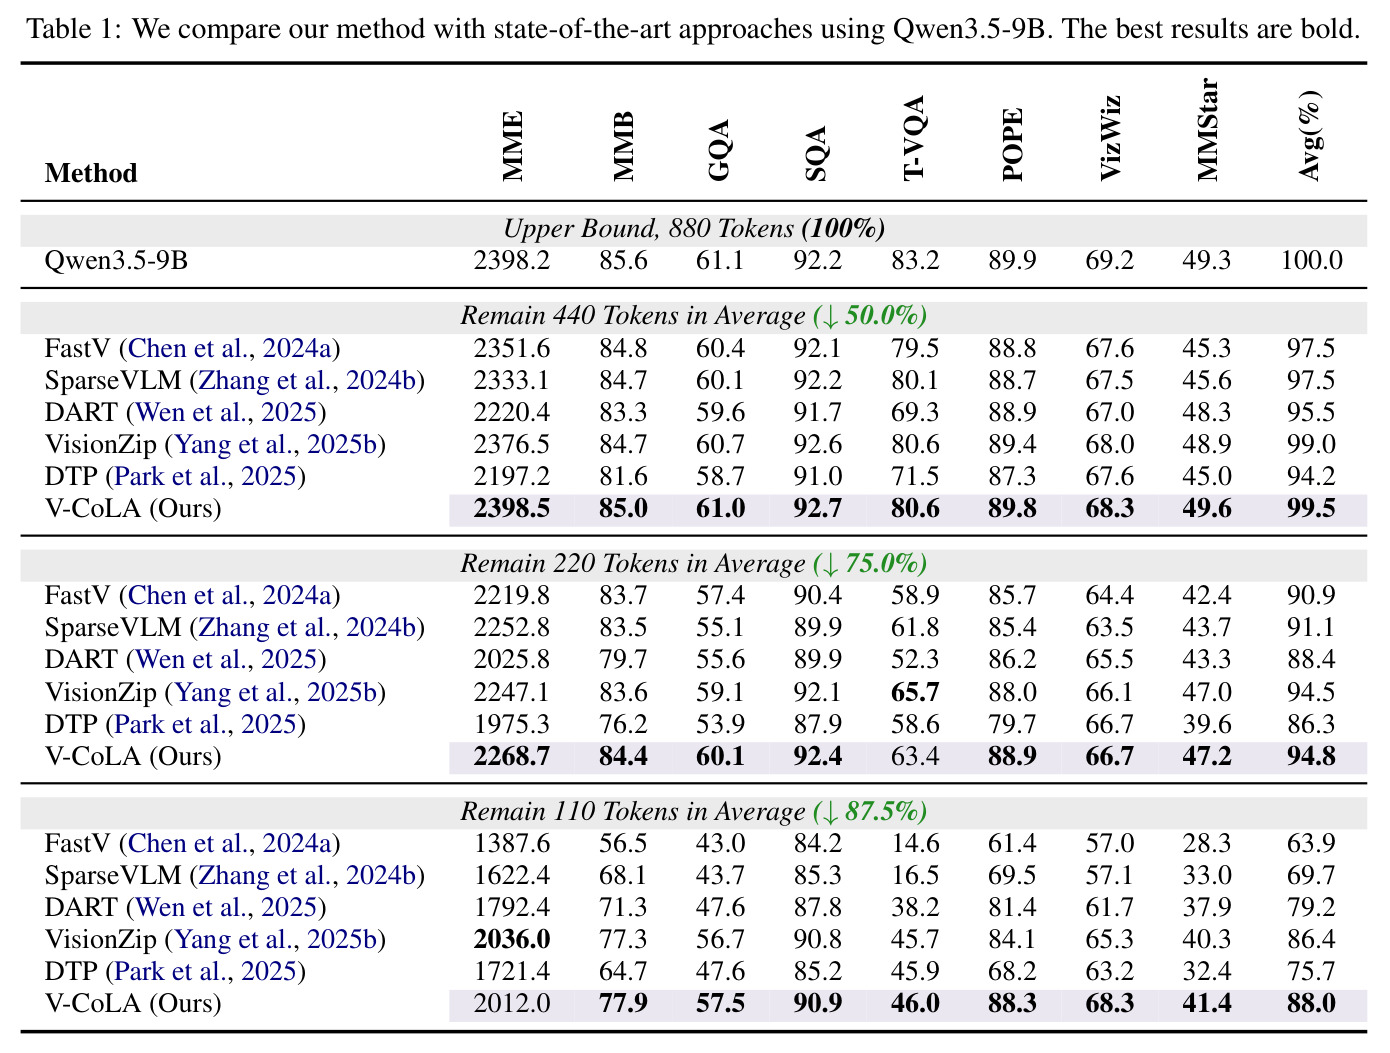
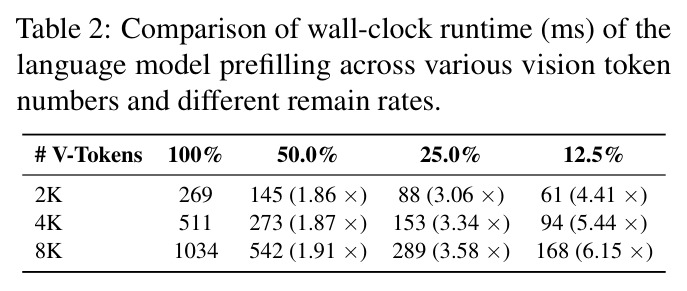
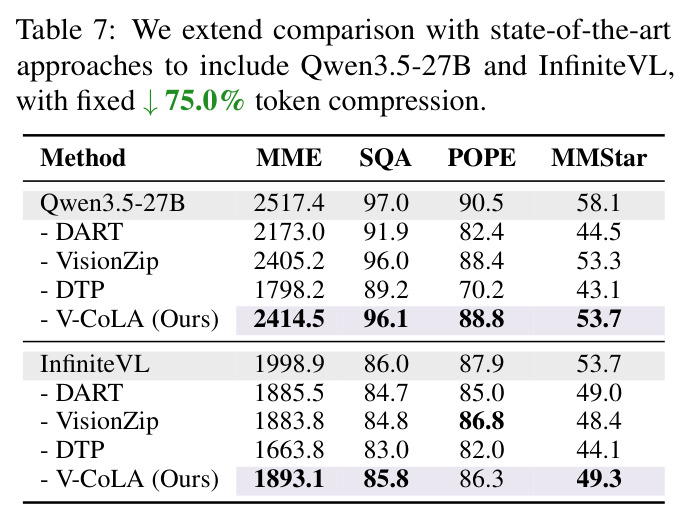
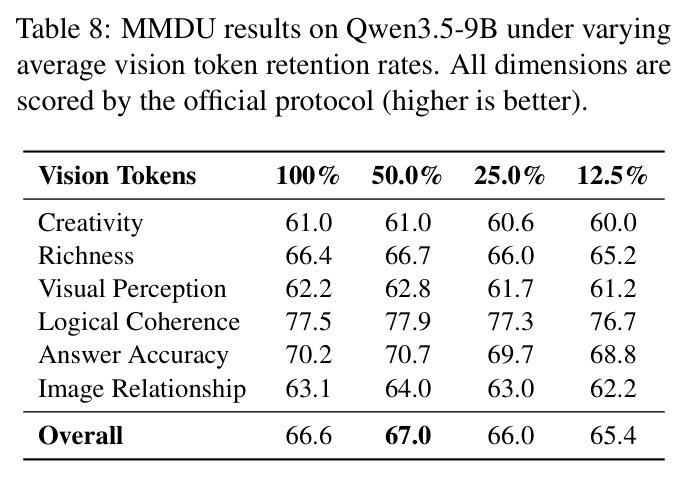
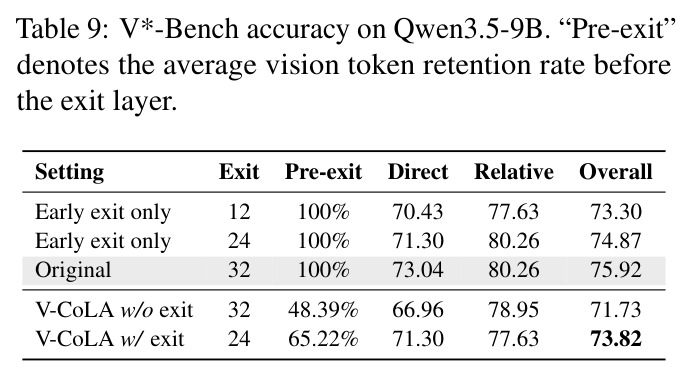
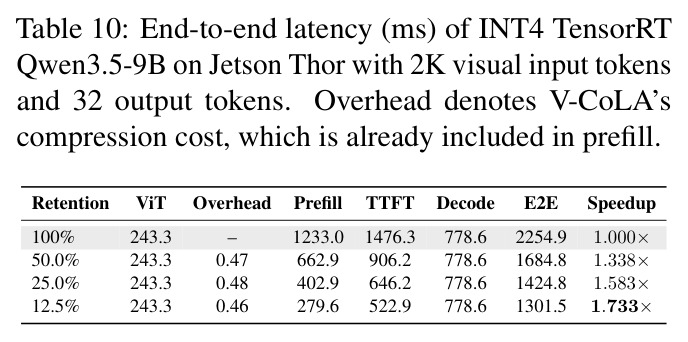
主实验在 Qwen3.5-9B(880 视觉 token 上界)上进行,所有方法对齐平均保留率。保留 50% token 时 V-CoLA 平均保持 99.5% 性能:MME 2398.5(上界 2398.2,无损)、MMB 85.0(85.6)、GQA 61.0(61.1)、SQA 92.7(92.2,反超)、TextVQA 80.6(83.2)、POPE 89.8(89.9)、VizWiz 68.3(69.2)、MMStar 49.6(49.3,反超),明显高于 VisionZip 99.0%、FastV/SparseVLM 各 97.5%、DART 95.5%、同为线性注意力设计的 DTP 94.2%。保留 25% 时平均 94.8%(VisionZip 94.5、DTP 86.3);保留 12.5% 时仍保持 88.0%(VisionZip 86.4、DART 79.2、SparseVLM 69.7、FastV 63.9),其中 POPE 达 88.3(上界 89.9)几乎无损,而 FastV 在 TextVQA 上崩到 14.6、V-CoLA 仍有 46.0。效率上 prefill 加速 1.86×(2K token、50% 保留)至 6.15×(8K token、12.5% 保留),压缩开销仅占前向约 1.6%,与 FLOPs 理论吻合(8K、$r=0.5$ 实测 1.91× vs 理论 2.0×;$r=0.125$ 实测 6.15× vs 理论 7.0×)。消融:$\lambda=0.1$ 最优,$\lambda=0$ 与 $0.9$ 均下降(MME 分别 2360.5/2333.1);窗口 $(0,4)$ 优于 $(0,1)$(2387.6)与 $(-4,0)$(2376.4);↓75% 时去掉自适应合并 MME 掉 71.3 分、去掉 early exit 掉 33.6 分。泛化性:Qwen3.5-27B(↓75%)上 V-CoLA MME 2414.5 vs VisionZip 2405.2、DTP 1798.2;InfiniteVL 上 MME 1893.1 vs DART 1885.5、VisionZip 1883.8。附加评测:MMDU 长对话在 12.5% 预算下 Overall 65.4 vs 66.6(差 1.2 分内);V*-Bench 显示 exit@24 仅掉 1.05 分而 exit@12 掉 2.62 分,且 50% 预算下 early exit 把深层 token 预算转移给浅层、比不 exit 高 2.09 分(73.82 vs 71.73);INT4 TensorRT(Jetson Thor)上 TTFT 降低 38.6–64.6%、端到端最高 1.733×(2254.9→1301.5ms)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 综合多模态(Qwen3.5-9B 八基准平均) | 相对上界保留率 | ↓50%: 99.5%;↓75%: 94.8%;↓87.5%: 88.0% | VisionZip: 99.0% / 94.5% / 86.4%;FastV: 97.5% / 90.9% / 63.9% | ↓87.5% 时比最强基线 VisionZip 高 1.6 个点,比 FastV 高 24.1 个点 |
| POPE(物体幻觉) | 准确率(%) | ↓87.5% 时 88.3 | 上界 89.9;VisionZip 84.1;FastV 61.4 | +4.2 vs VisionZip,+26.9 vs FastV |
| MME(感知/认知) | 总分 | ↓50% 时 2398.5(上界 2398.2) | VisionZip 2376.5;FastV 2351.6 | 基本无损,反超上界 |
| MMStar(视觉不可缺样本) | 准确率(%) | ↓87.5% 时 41.4 | 上界 49.3;VisionZip 40.3;DTP 32.4 | +1.1 vs VisionZip,+9.0 vs DTP |
| Prefill 延迟(8K 视觉 token) | 加速比 | 1.91× / 3.58× / 6.15×(保留 50%/25%/12.5%) | 原模型 1034ms | 与理论 1/r 到 1/r² 插值预测吻合(理论 2.0×/7.0×) |
| 端到端延迟(INT4 TensorRT,Jetson Thor) | E2E 加速比 / TTFT | 最高 1.733×;TTFT 降低 38.6–64.6% | 原模型 E2E 2254.9ms | 12.5% 保留时 E2E 降至 1301.5ms |
| MMDU(长程多轮多图对话) | Overall 分 | ↓87.5% 预算下 65.4 | 全 token 上界 66.6 | 六个维度均只降 1.4 分以内,长文本生成几乎无损 |
| V*-Bench(高分辨率小目标) | Overall 准确率(%) | w/ early exit@24: 73.82 | 原模型 75.92;无 early exit 版本 71.73 | +2.09 vs 无 early exit,距全模型仅 -2.1 |
局限与改进
作者明确承认两点局限:一是架构覆盖面——实验集中于线性注意力与 softmax 交错的混合 VLM(Qwen3.5、InfiniteVL),纯 Mamba 系或全线性注意力 VLM 未验证,届时需要重新审视重要性判据与周期性 softmax 层缺失的相互作用;二是公式范围——分析与设计主要基于 Gated DeltaNet 形式,虽然重构视角理论上可推广到一般递归形式 $S_t = A_tS_{t-1}+B_tv_tk_t^\top$(如其他门控线性注意力变体),但缺乏跨公式的系统实验。我自己的观察补充几点:其一,极端压缩(↓87.5%)时 TextVQA 从 83.2 掉到 46.0、MME 从 2398.2 掉到 2012.0,OCR 与细粒度感知仍是明显短板,softmax 加权合并对文字区域的模糊效应可能是原因之一;其二,压缩固定在 layer-1 末尾一次性执行,重要性基于第 1 层的浅层状态判断,误删不可恢复,没有逐层反馈或预算重分配机制(early exit 只是单向丢弃);其三,early exit 层号 24 是针对 32 层模型标定的(V*-Bench 显示 exit@12 损失明显变大),换模型需要重跑 PPL 拐点分析;其四,评测集中于视觉问答类基准,视频理解、多图推理等更依赖长程视觉记忆的场景只在 MMDU 上初步触及。
独立分析的弱点
第一,重构误差依赖最终状态 $S_L$:若某 token 的信息被模型选择“写入后直接交给下一层处理”而非沿序列传播到 $S_L$(论文自己在 3.2 节承认这种通路存在),其 $R_{\text{impt}}$ 会虚高而被误判为不重要;$R_{\text{unit}}$ 只是部分缓解,且伪查询窗口仅 4 条,改进方向是跨多层聚合重要性或加长滑动窗口并按层衰减加权。第二,一次性早期压缩风险:layer-1 末尾判断保留率 $γ$ 固定且不可逆,虽然 Figure 6 显示浅层重要性排序的层间相关性高,但该观察只在 9B 模型上验证,改进方向是把压缩推迟到 3–4 层分阶段执行,或引入基于重构置信度的二次修正。第三,细粒度任务损失:↓87.5% 时 TextVQA 掉 44.6%、MME 掉 16%,说明高频细节 token 在合并中信息被稀释,改进方向是对 $R_t$ 超过阈值的关键 token 禁止合并(只剪冗余)、或对文字/小目标区域做保护性预算。第四,架构泛化未经检验:Mamba-2 的 SSD 形式、RWKV 等的重构目标形式不同,判据需重新推导,改进方向是按论文提出的一般形式 $S_t=A_tS_{t-1}+B_tv_tk_t^\top$ 做统一实现并在多骨干上验证。第五,正文未明确承诺开源代码,工程实现(扩展 DeltaRule、并行合并)有较高复刻门槛,社区验证短期内可能缺位。
未来方向
作者提出的方向:把评测扩展到纯 Mamba 与全线性注意力 VLM,研究缺失周期性 softmax 层时判据的适应性;在一般递归状态更新 $S_t = A_tS_{t-1}+B_tv_tk_t^\top$ 上系统检验重构视角的通用性,覆盖更广的线性注意力公式族。基于本文成果可自然延伸的:一是把重要性信号与 softmax 层的 KV cache 压缩联动,做全栈 token/cache 预算管理;二是把固定保留率 $\gamma$ 改为由图像复杂度或任务难度预测的动态预算(论文已有按重要性自适应分空间的思想,扩展到按样本自适应很自然);三是把训练免费的判据蒸馏进模型,或作为训练时的 token 预算正则,让模型天生学会稀疏写入;四是扩展到视频 VLM——时间维度冗余更大、状态压力更高,信息上限论证在 $L\gg d$ 时更成立,收益可能更大;五是研究压缩与量化(文中已有 INT4 TensorRT 实验)、推测解码的叠加收益;六是在多轮长对话中持久化已压缩的视觉记忆状态,探索“压缩后状态复用”而非每轮重算。
复现评估
复现条件总体友好:方法完全训练免费,实验均在 NVIDIA A100 上进行;模型全部是开源权重(Qwen3.5-9B/27B、InfiniteVL),评测基于公开的 lmms-eval 框架和 8 个标准基准;超参数极少且鲁棒——默认配置($\lambda=0.1$、窗口 $(0,4)$、$\tau=1.0$)在 9B、27B、InfiniteVL 三个模型上不做任何调参均取得最优,说明配置可直接迁移。主要难点在工程层:附录 A 提供了扩展 DeltaRule 批量伪查询注入和累计重要性曲线等分合并的图示化算法,但要对齐生产级性能需要深入 Qwen3.5/Kimi-Linear 的分块并行 kernel 源码自行实现;若用朴素 PyTorch 写法,正确性可以复现、结论方向可信,但 1.86×–6.15× 的实测加速比和 0.86ms 合并开销难以达到。截至论文发布未见明确的开源代码仓库声明,第三方复现需重写核心算子。附录 C/D 给出了完整的 FLOPs 推导(理论加速公式 18)与端到端延迟分解,可用于交叉核验复现结果是否在合理区间,这降低了评估复现质量的不确定性。总体评级:算法理解容易、正确复现中等难度、性能级复现中高难度。
论文图表
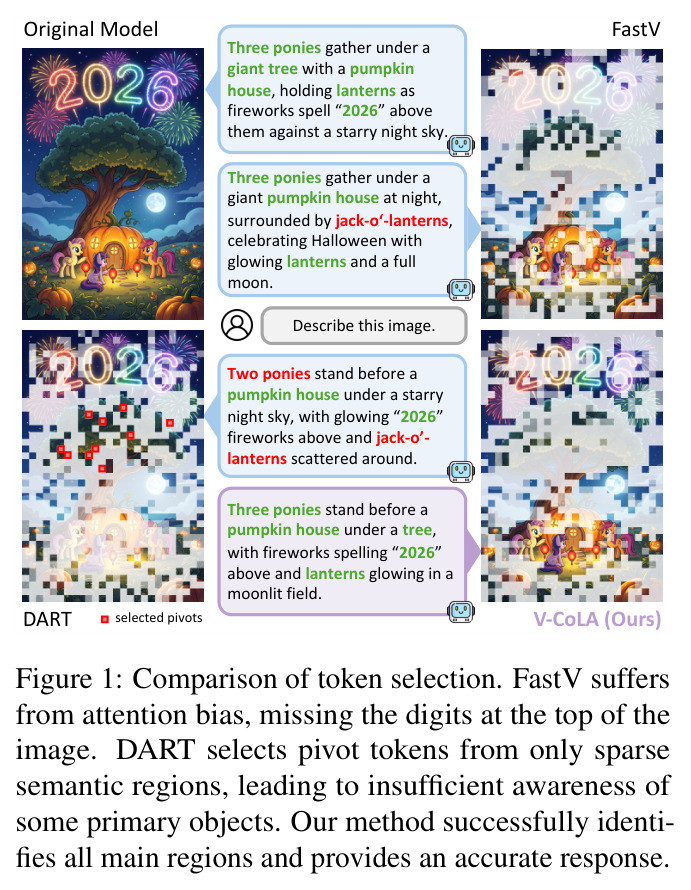
定性对比图:同一张万圣节小马图(含“2026”烟花数字、南瓜屋、灯笼等元素)在原模型、FastV、DART、V-CoLA 四种设置下的生成描述。FastV 漏掉顶部数字,DART 只从稀疏区域选 pivot 导致主物体感知不足,V-CoLA 找全所有主要区域并给出准确描述。
用直观案例展示了注意力类方法(FastV)的注意力偏置和相似度类方法(DART)的区域偏置,是理解两类旧方法失效模式的入口。
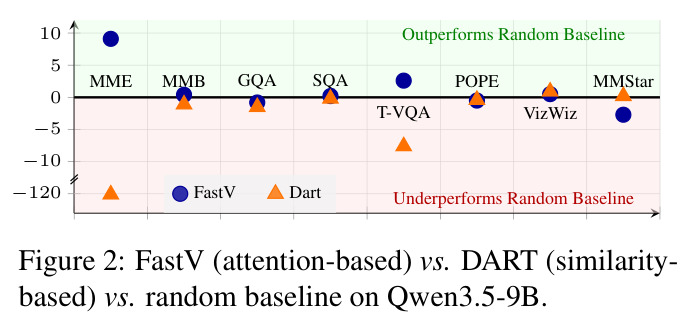
柱状图:在 MME、MMB、GQA、SQA、TextVQA、POPE、VizWiz、MMStar 八个基准上,FastV 和 DART 相对随机剪枝基线的性能差普遍在 -10 到 +5 之间震荡,标题即“Outperforms Random Baseline / Underperforms Random Baseline”的分界线,多数柱落在零线附近甚至以下。
这是全文的问题起点:两大类 SOTA 方法在混合架构上打不过随机剪枝,用系统数据证明了任务的真实难度和方法迁移的必要性。
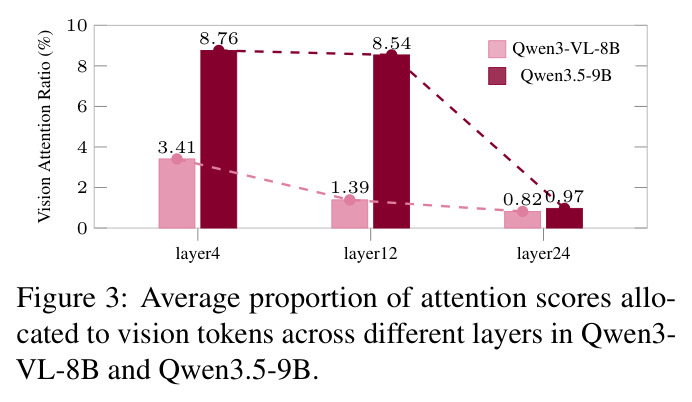
对比 softmax 层分配给视觉 token 的注意力比例:Qwen3-VL-8B 从 layer4 的 8.76% 迅速跌到 layer12 的 3.41%、layer24 的 0.82%;Qwen3.5-9B 则在 layer4 和 layer12 都保持 8.54%,到 layer24 才降至 0.97%。
揭示混合架构中视觉信息在中层仍被持续关注、深层才衰减,直接论证了“只靠浅层注意力分数不足以识别所有重要 token”(FastV 失效的机理)。
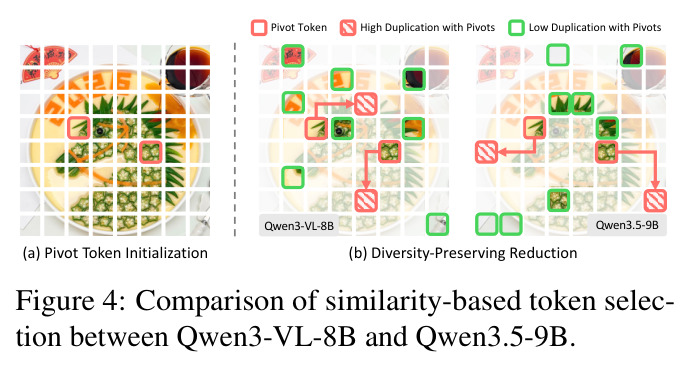
对比固定 pivot token 下冗余 token 判定的可靠性:Qwen3-VL-8B 中与 pivot 高重复/低重复 token 的比例结构清晰(0.82),而 Qwen3.5-9B 中重复比例变为 0.97 与 1.39,冗余判定的区分度明显恶化。
论证特征相似度在状态递归架构中的可区分性已被根本改变,解释了 DART 等相似度类方法失效的机理。