Echo:视觉-语言-动作模型中动作与任务状态信号的耦合去噪 Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
将停止/失败信号作为动作块附加维度联合去噪,让VLA自省成败并引导纠错动作。
前置知识
VLA 模型 (Vision-Language-Action Model)
将视觉观测与语言指令映射为机器人动作的多模态基础模型,通常由预训练视觉-语言模型骨干加动作生成头(扩散或流匹配)组成,代表工作有 π0、π0.5、GR00T N1 等。它把互联网级的视觉-语言理解能力迁移到机器人操作,但本体只输出动作,通常不具备"任务是否完成/失败"的自省能力。
Echo 就是在 π0.5 这个 VLA 上做的修改,所有设计(token 分组、注意力掩码、去噪调度、推理流程)都围绕 VLA 架构展开,必须先理解 VLA 的输入输出与工作方式,才能看懂本文在改什么、改在哪。
Flow Matching (流匹配)
一种生成式建模范式:构造 $x_\tau=(1-\tau)x_0+\tau\epsilon$ 的线性加噪路径,训练网络预测速度场 $v_\theta\approx\epsilon-x_0$,推理时从 $\tau=1$ 的纯噪声积分回 $\tau=0$ 得到干净样本;干净样本可用 $\hat{x}_0(\tau)=x_\tau-\tau v_\theta$ 估计。相比扩散模型路径更直、采样步数更少,π0 系列模型用它作为动作生成头。
Echo 的全部核心机制——动作与信号的联合去噪、异步去噪调度、逐 token 流时间——都定义在流匹配框架上;不熟悉 $\tau$、速度预测与干净样本估计,就无法理解方法部分和 Figure 3 的动机实验。
动作块 (Action Chunk) 与 Padding
VLA 每次预测未来 $H$ 步的动作序列而非单步动作,本文 $H=60$、推理频率 5Hz,即一次查询预测 12 秒的动作。采样的块可能跨过当前子任务边界或超出片段长度,超出有效边界 $T$ 的位置称为 padding,目标值重复最后一个有效动作。
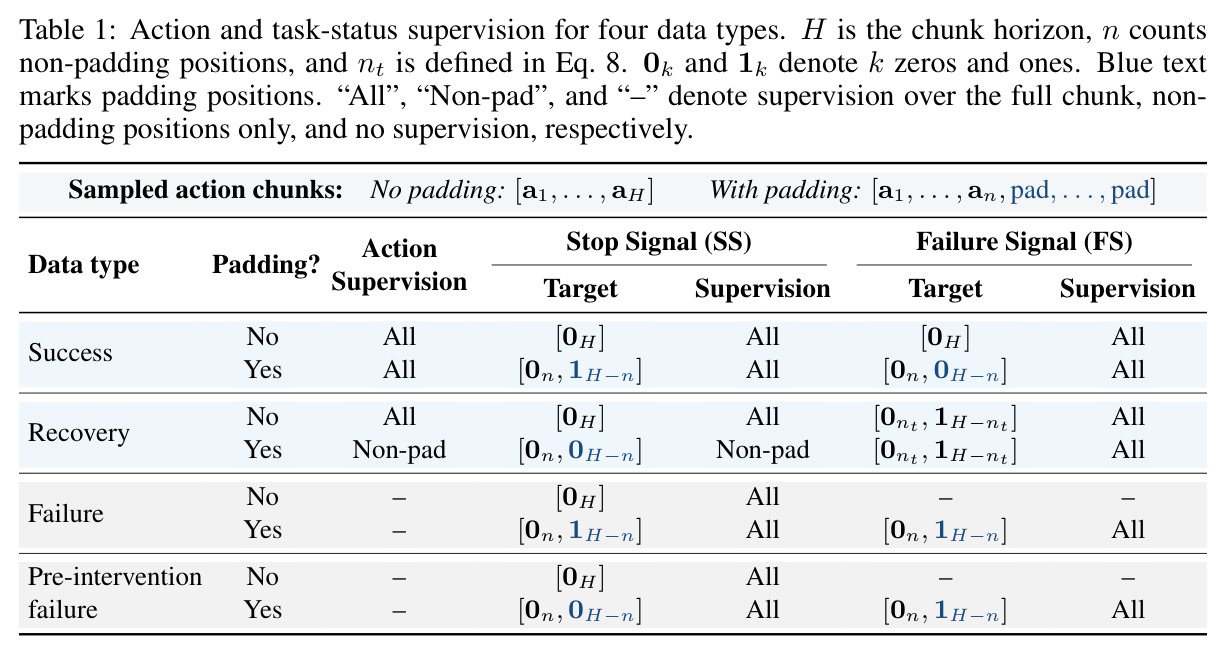
Echo 的停止/失败信号与动作共享同一个块结构($S_t,F_t\in\mathbb{R}^{H\times1}$),而 padding 掩码天然标记"执行应在何处结束",正是它免帧级标注构造信号监督的关键;不理解 chunk 与 padding 就读不懂 Table 1 的监督规则。
干预式数据收集与从失败中学习
类似 DAgger 的思想:在策略执行过程中,人类操作员在观察到可恢复失败时立即接管控制,从而同时获得"失败发生前"的片段和"人类如何纠正"的恢复演示;再配合遥操作成功演示与策略自身 rollout 产生的终结性失败数据,构成四种互补的数据来源。
Echo 不使用任何帧级进度标注,其信号监督完全由这四类数据的片段类型、片段边界和帧位置推导出来,数据构造是理解本文第二个贡献(监督方案)的前提。
Macro-F1 与轨迹级结果识别
Macro-F1 对每个类别分别计算 $\mathrm{F1}=2TP/(2TP+FP+FN)$ 后取平均,对类别不平衡敏感。本文用它评估两种能力:帧级 ongoing/success/failure 三态识别的细粒度准确性;以及轨迹级结果识别——在标注结果出现后的固定窗口 $W$(15 帧/3 秒)内是否及时给出正确的成败判定。
这两类 F1 是论文评估状态信号质量的主要指标,"Echo 的信号预测得准不准、及不及时"都要靠它们判断,是读懂实验部分(Table 2、3、9)的基础。
研究动机
可靠的机器人执行不仅要求生成正确动作,还要求知道任务当前是进行中、已成功还是已失败,从而决定何时停止、何时触发恢复或重规划。现有给 VLA 补充状态信号的做法有三类代价:其一,需要帧级细粒度进度标注,人工逐帧标注成本极高;其二,依赖外部监控模型,例如从执行视频估计任务进度的视觉-语言奖励模型 Robometer,部署时要在控制策略之外额外运行一个评估模型,增加推理开销;其三,需要复杂架构或额外优化流程,例如 VLAC 用 critic token 支持在线强化学习、GRAPE 用轨迹偏好做策略对齐、VLA-Corrector 在推理时做梯度引导的纠正重规划、ProgressVLA 通过世界模型传播进度梯度来引导动作去噪。更关键的是,这些方法预测出的信号几乎只用于事后监控或触发外挂模块,很少反过来直接改善动作生成本身,状态信号对控制的价值远未被挖掘。
本文的目标是本文目标是构建一个紧凑的单一框架,在同一个 VLA 内同时完成任务状态信号学习与动作生成:不需要帧级进度标注,不引入外部监控模型,几乎不增加参数量和推理延迟;并且让学到的信号不只是用来事后监控,而是真正参与并引导动作去噪——特别是在出现可恢复失败时,把策略的行为实时引向从恢复演示中学到的纠正动作。最终在五个真实操作任务上验证两点:信号预测足够准确(帧级 Macro-F1 约 88–92%),且任务完成分数在所有任务上全面超过使用相同动作监督数据的 action-only 基线,分布外场景下优势尤为明显。
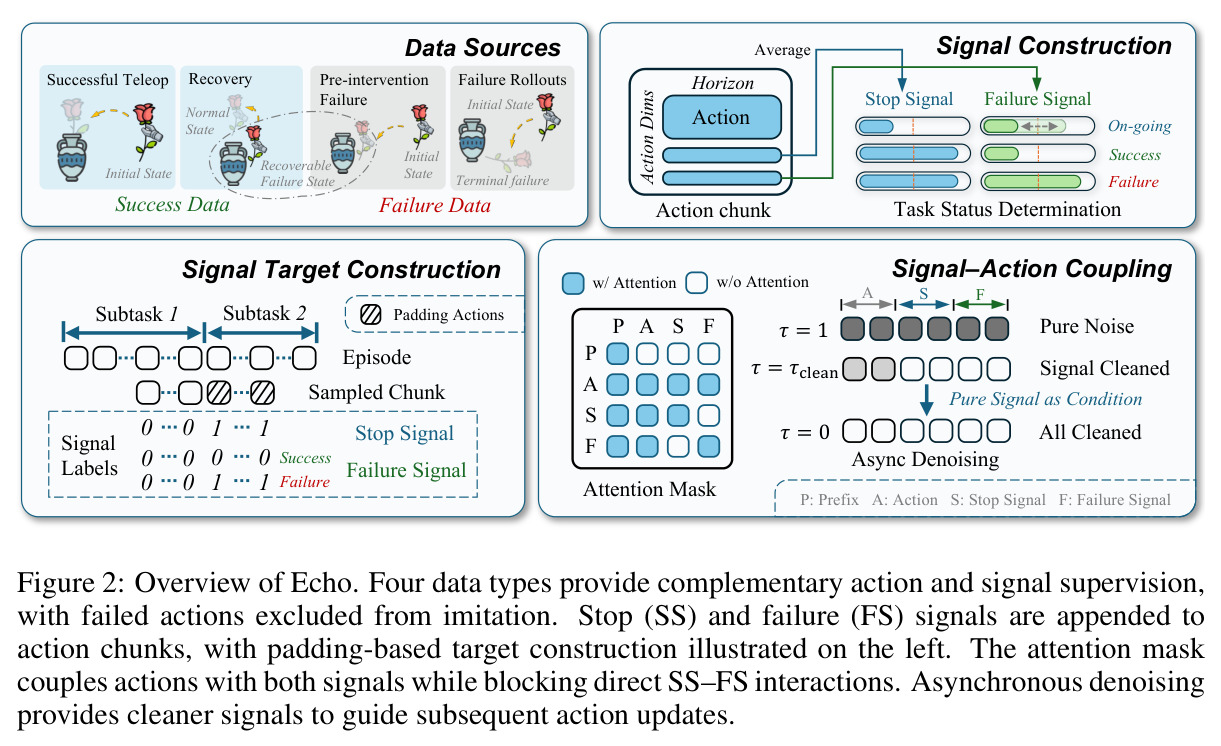
与已有工作不同的是,本文的独特切入是把状态信号"写进"动作表示本身:停止信号 SS 与失败信号 FS 作为每个动作块的两个附加维度,与机器人动作一起在流匹配过程中联合去噪,直接复用 VLA 已有的视觉、语言与机器人状态特征。监督构造上另辟蹊径——利用动作块天然的 padding 掩码加上片段级的成败标签来推导信号目标,彻底绕开帧级标注的假设。使用信号的方式也不同于以往:通过注意力掩码精确控制信号与动作之间的双向交互、同时阻断两个信号之间的直接注意力以保持语义独立,并让信号在去噪时间轴上先于动作收敛(异步去噪),使后续的动作更新始终以更干净的状态估计为条件。"信号直接住进动作块并参与同一条去噪轨迹"是与外挂监控、额外优化、推理时梯度引导这些路线的本质差异。
核心方法
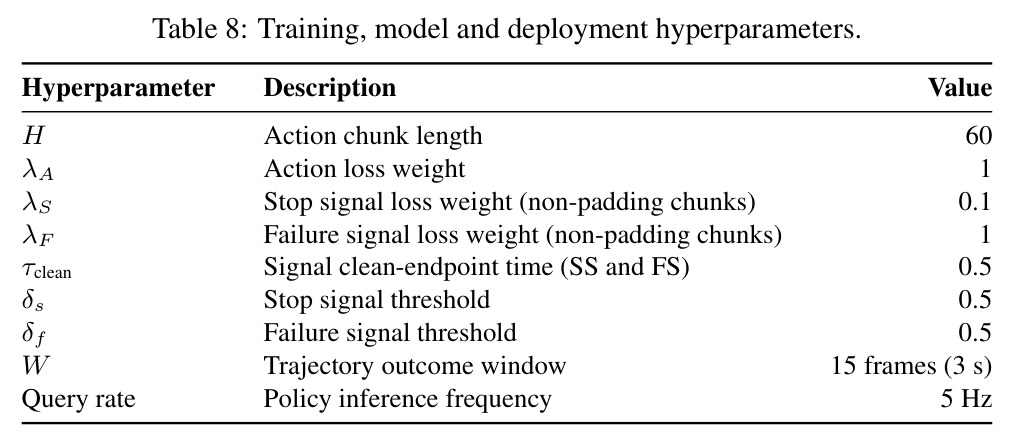
直觉上,机器人应当"知道自己干得怎么样",并把这种自知实时反馈到下一步动作里。Echo 用两个与动作块共享时域长度的信号向量刻画执行状态:停止信号 SS 表示执行是否应当终止,失败信号 FS 表示是否处于失败状态。二者组合出四种状态:低 SS 为进行中;高 SS 低 FS 为成功完成;高 SS 高 FS 为终结性失败;进行中 FS 升高则为可恢复失败。技术上基于 π0.5 流匹配骨干:将 $S_t,F_t\in\mathbb{R}^{H\times1}$ 与动作块 $\tilde{A}_t\in\mathbb{R}^{H\times d_a}$ 沿特征维拼接为 $X_t=[\tilde{A}_t,S_t,F_t]\in\mathbb{R}^{H\times(d_a+2)}$,各组经独立输入投影后由共享 Transformer 联合处理;四类数据(成功、终结失败、介入前失败、恢复)按 20:1:2:20 的比例采样训练。推理时对每个块内的信号预测取均值 $\bar{s}_t,\bar{f}_t$,与阈值 $\delta_s=\delta_f=0.5$ 比较即得执行状态,供停止与恢复决策使用。
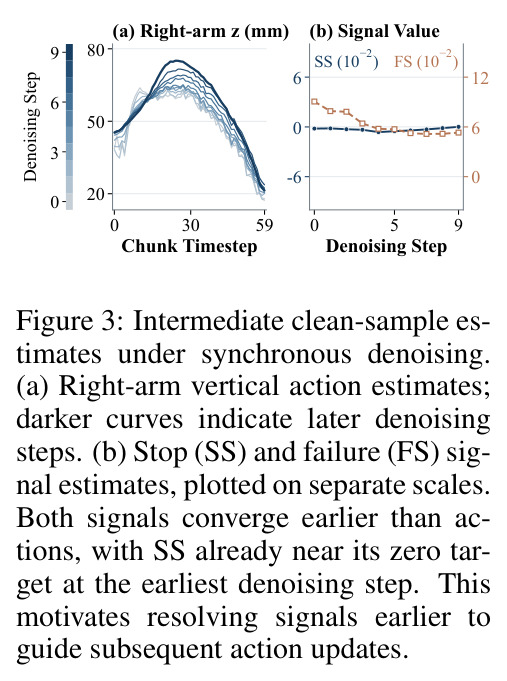
核心创新有三点。第一,状态信号作为动作块的附加维度联合去噪:与外挂监控模型或独立预测头不同,SS/FS 与动作共享同一次前向计算和同一条去噪轨迹,参数与延迟开销极小(RTX 4090 上推理延迟仅从 115ms 增至 120ms)。第二,免帧级标注的监督构造:padding 掩码天然标记"执行应在何处结束",与片段类型组合即得 SS/FS 目标;失败数据的动作被排除出模仿学习以防学坏,恢复片段的 FS 目标按 $n_t=\mathrm{round}(Hu_t)$、$u_t=(t-t_0)/(t_1-t_0)$ 随恢复进度近似线性递减,把"识别失败"与"纠正行为"绑定学习。第三,受控交互加异步去噪:动作注意两个信号组、信号注意动作,但 SS 与 FS 之间双向阻断注意力以保持"是否该停"与"是否失败"的语义独立;信号流时间按 $\tau_q=\max\big(0,(\tau_A-\tau_{clean})/(1-\tau_{clean})\big)$ 调度($\tau_{clean}=0.5$),信号在动作去噪半程即已收敛,之后的动作更新都以干净信号为条件——动机实验显示同步去噪下信号在前几步已接近终值,而动作估计到第 8–9 步仍在变化。
方法步骤详情
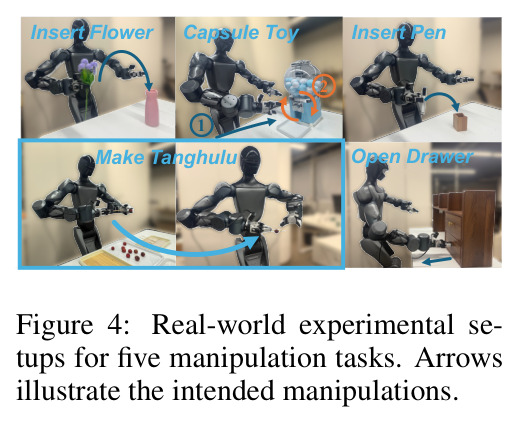
完整流程分四步。①数据收集:遥操作获得成功演示;策略测试产生终结性失败 rollout;执行中操作员在可恢复失败发生时接管,留下介入前失败片段与其后的恢复演示;多子任务片段需人工标注子任务边界并关联语言指令。②监督构造(Table 1):动作监督只来自成功与恢复演示(失败数据排除动作模仿),恢复动作只监督非 padding 位置以免学到提前停止;SS 目标由 padding 掩码与片段类型决定——成功/终结失败片段在 padding 处为 1,介入前与恢复片段全为 0(恢复只监督非 padding 位,因为其结束点不能可靠指示是否该停);FS 目标成功片段全 0,终结失败与介入前片段在含 padding 块上用 padding 掩码,恢复片段按式 (8)(9) 构造前 $n_t$ 位为 0、其余为 1 的递减目标。③训练:采样动作流时间 $\tau_A$,按式 (12) 得到各信号组流时间并分别加噪,优化流匹配速度损失 $\mathcal{L}=\mathbb{E}\big[\sum_q\lambda_q\|M_q\odot(\hat{v}_\theta^q-(\epsilon^q-x_0^q))\|_F^2\big]$,其中 $\lambda_A{=}1$、无 padding 块上 $\lambda_S{=}0.1,\lambda_F{=}1$,掩码 $M_q$ 选择 Table 1 规定的监督位置。④推理:各 token 组从高斯噪声出发按各自流时间更新,信号到达干净端点后冻结取值,动作继续去噪时经注意力以干净信号为条件;最后块内均值 $\bar{s}_t,\bar{f}_t$ 过阈值得到 Ongoing/Success/Terminal failure 判定,以 5Hz 循环执行。
技术新颖性
与已有工作的本质区别在于信号的生产与消费方式。监控路线(SAFE、Robometer、基于策略特征的失败检测、进度探针等)信号只读不用,且外置模型带来额外推理开销;改进动作的路线中,VLAC/GRAPE 需要额外的强化学习或偏好对齐训练阶段,VLA-Corrector 需要推理时梯度计算与重规划组件,ProgressVLA 依赖世界模型,CycleVLA 用子任务回溯机制。Echo 不需要外部模型、额外训练阶段或推理时梯度——同一个模型、同一次去噪同时完成状态估计与动作生成。工程上,逐 token 流时间($B\times L$ 形状的时间张量经 AdaRMS 注入共享 Transformer)是对流匹配 VLA 的实质性扩展,使不同 token 组能以不同进度去噪。表示设计上,SS 与 FS 把"终止"与"失败"解耦为两个正交维度,用纯二值信号即可区分成功终止、终结失败与可恢复失败,这是单一进度/完成信号做不到的;监督设计上用 padding 掩码免帧级标注,直接否定了"状态信号学习必须有细粒度进度标注"这一常见假设。
实验结果
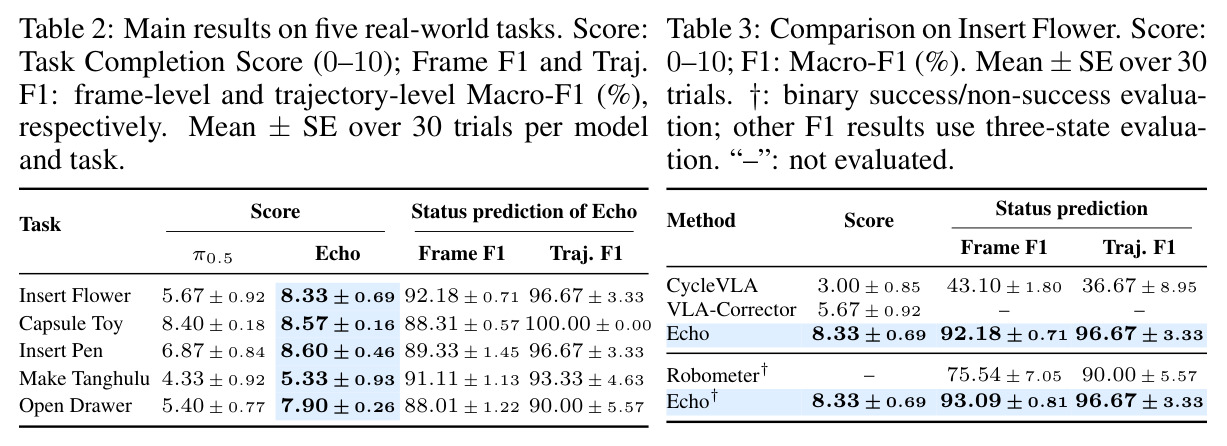
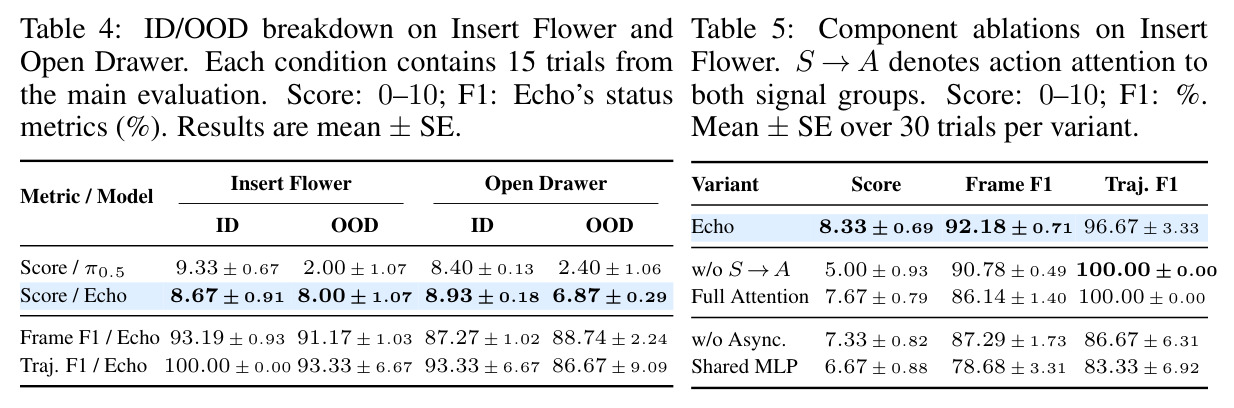
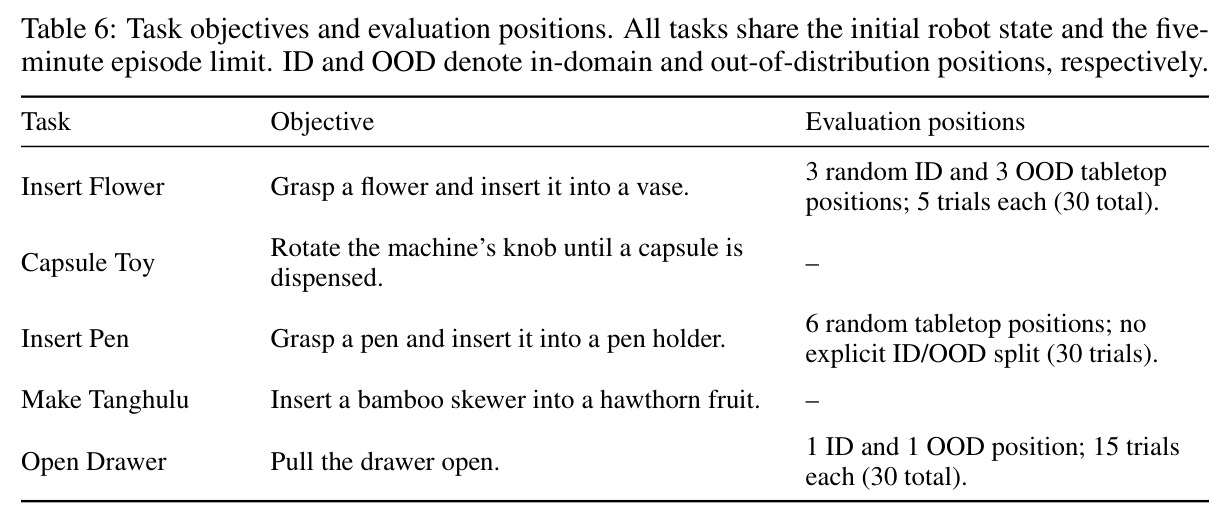
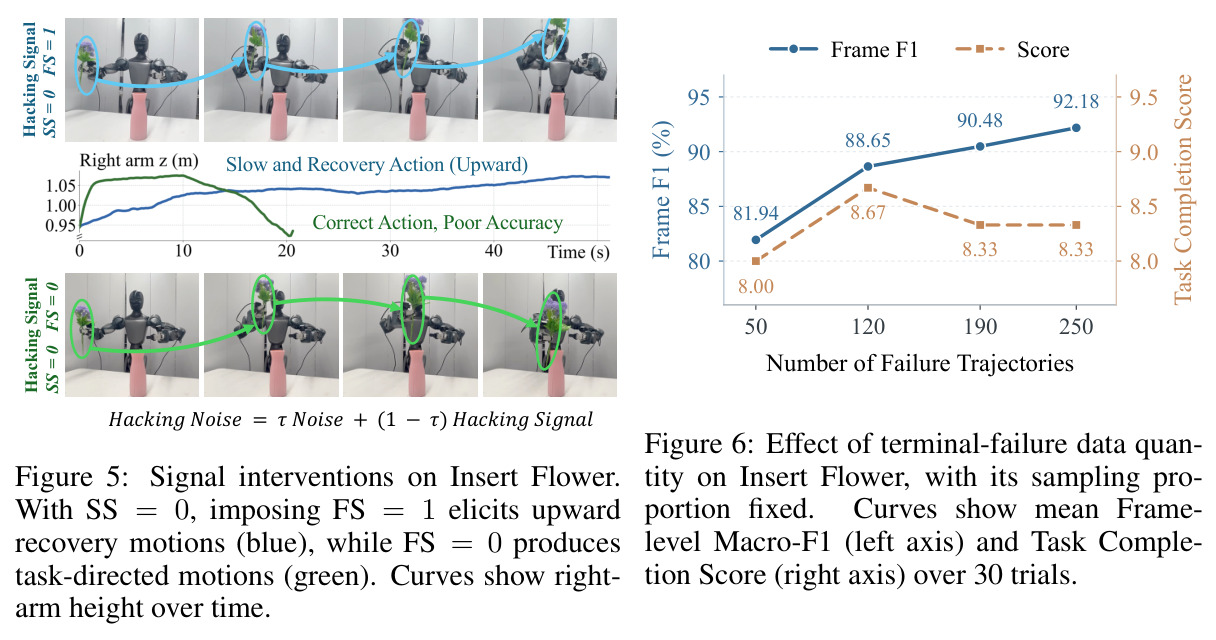
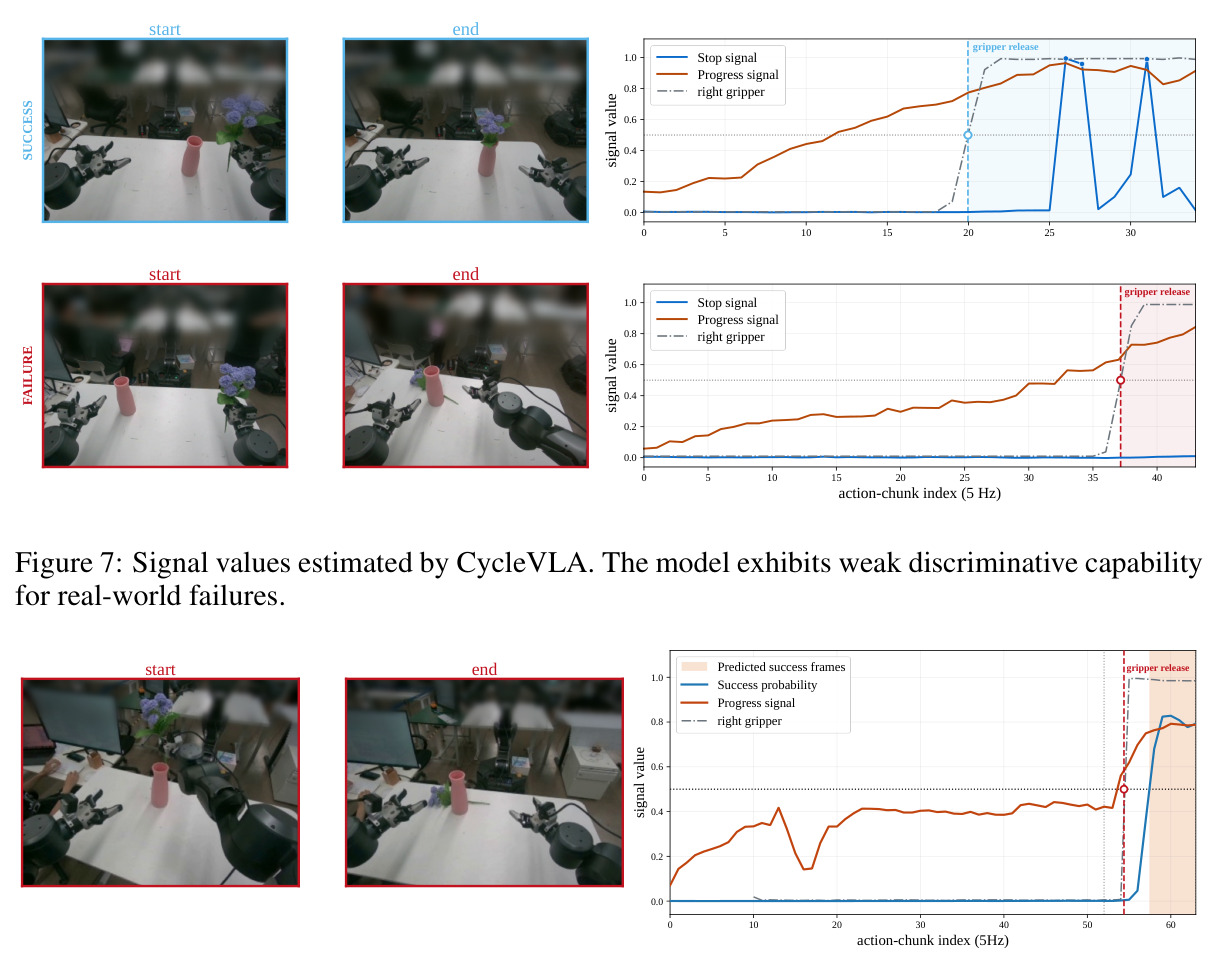
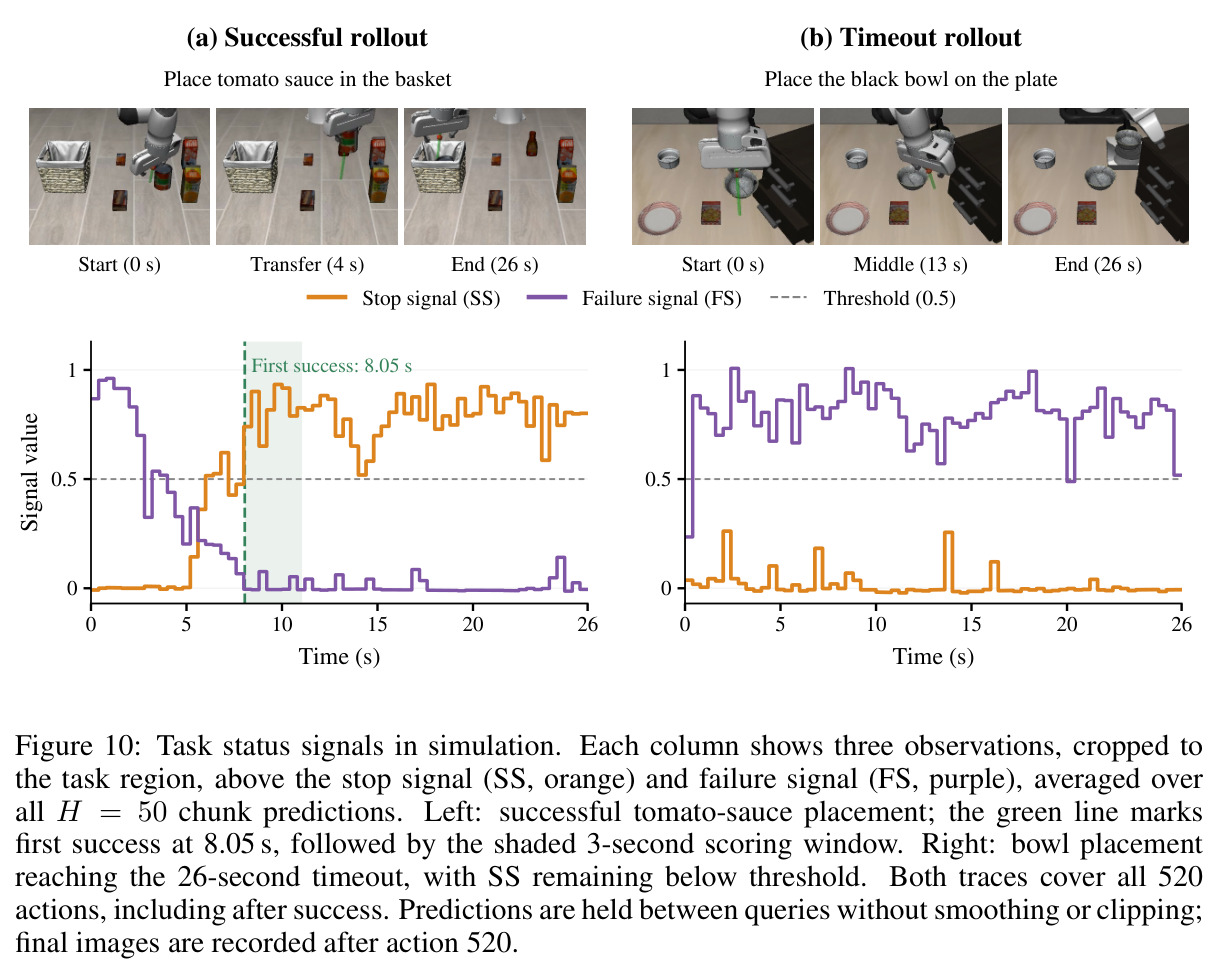
①主结果(Table 2,每任务 30 次):Echo 在全部五个真实任务上超过 action-only π0.5——Insert Flower 5.67→8.33、Capsule Toy 8.40→8.57、Insert Pen 6.87→8.60、Make Tanghulu 4.33→5.33、Open Drawer 5.40→7.90;两模型动作监督数据完全相同,收益只能来自状态信号。状态预测帧级 Macro-F1 为 88.01–92.18%,轨迹级 F1 为 90.00–100%;ongoing 帧级召回全部超过 99%,但 success/failure 帧级召回仅 66–79%。②方法对比(Table 3,Insert Flower):CycleVLA 仅得 3.00 分、帧级 F1 43.10(因其未用真实失败数据,对真实失败判别力弱);VLA-Corrector 5.67 分;外部奖励模型 Robometer 在二分类协议下帧级 F1 75.54、轨迹级 90.00;Echo 全面领先。③ID/OOD 分解(Table 4):增益集中在分布外——Insert Flower 的 OOD 位置上 π0.5 仅 2.00 分而 Echo 达 8.00,Open Drawer OOD 为 2.40 对 6.87;ID 下差距小甚至略负(Insert Flower 上 Echo 8.67 低于 π0.5 的 9.33),作者归因于状态信号把策略从"标称执行"偏向"调整纠正"行为。④组件消融(Table 5):阻断信号到动作的注意力(w/o S→A)分数跌至 5.00,接近 baseline,证明收益确实依赖信号引导动作;放开 SS–FS 互注意(Full Attention)帧级 F1 降至 86.14 并出现信号互抄;同步去噪得分 7.33 且轨迹级 F1 降至 86.67;跨组共享 MLP 最差(6.67 分、帧级 F1 78.68)。⑤信号干预(Figure 5):固定 SS=0、FS=1 诱发反复向上的恢复动作,FS=0 则恢复任务指向动作,因果地证明信号直接引导动作生成。⑥失败数据规模(Figure 6):终结失败轨迹从 50 增至 250 条,帧级 F1 从 81.94 升至 92.18,而任务分数稳定在 8.33 附近,说明失败数据改善状态监督而非提供纠正动作。⑦仿真(LIBERO-Recovery 固定 150 场景 ×3 种子共 4500 次):Echo 成功率 34.76% 对基线 32.67%(+2.09 个百分点),帧级信号准确率 89.97%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Insert Flower(真实机器人,30 次) | Task Completion Score (0–10) | 8.33 ± 0.69 | π0.5 (action-only) 5.67 ± 0.92 | +2.66 |
| Open Drawer(真实机器人) | Task Completion Score (0–10) | 7.90 ± 0.26 | π0.5 (action-only) 5.40 ± 0.77 | +2.50 |
| Insert Pen(真实机器人) | Task Completion Score (0–10) | 8.60 ± 0.46 | π0.5 (action-only) 6.87 ± 0.84 | +1.73 |
| Insert Flower OOD 位置(15 次) | Task Completion Score (0–10) | 8.00 ± 1.07 | π0.5 (action-only) 2.00 ± 1.07 | +6.00 |
| Insert Flower 状态预测(真实) | Frame-level Macro-F1 (%) | 92.18 ± 0.71 | CycleVLA 43.10 ± 1.80 | +49.08 |
| LIBERO-Recovery 仿真(4500 次) | 任务成功率 (%) | 34.76 | π0.5 (action-only) 32.67 | +2.09 个百分点 |
局限与改进
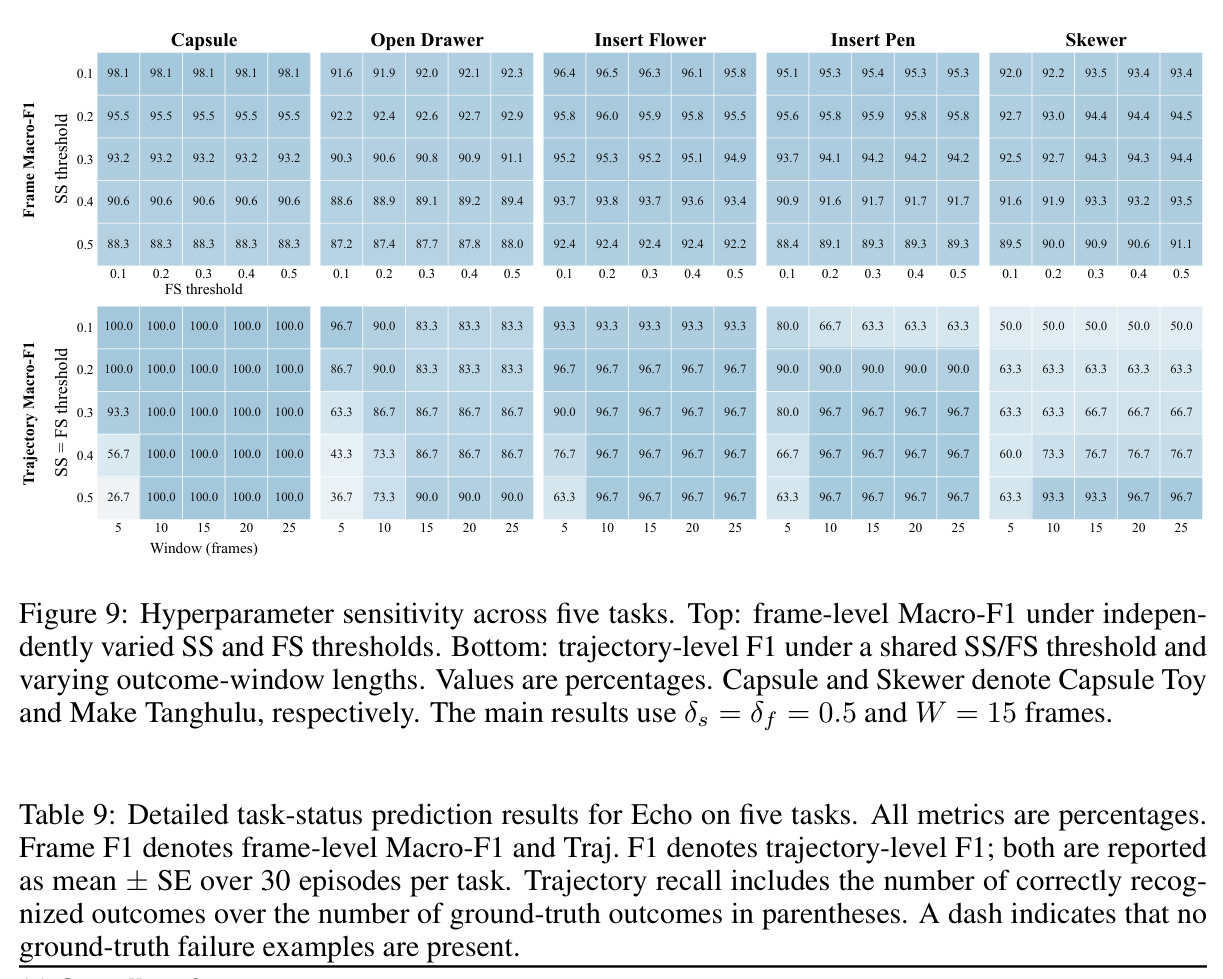
作者承认或可从数据中观察到的局限:插入类任务在分布内增益有限甚至略负(Insert Flower ID 下 Echo 8.67 对 π0.5 的 9.33);Make Tanghulu 提升最小(4.33→5.33);多子任务片段依赖人工标注子任务边界;评估阈值 $\delta_s{=}\delta_f{=}0.5$ 并非对每个任务最优——Figure 9 显示帧级 F1 对 SS 阈值相当敏感(Capsule Toy 从阈值 0.1 时的 98.1% 降到 0.5 时的 88.3%),且不存在对所有任务同时最优的阈值;轨迹级结果识别依赖 15 帧(3 秒)窗口,窗口过短会漏检(Capsule Toy 在 W=5 时仅 26.7%)。我自己的观察:其一,SS/FS 均为二值信号,丢掉了连续进度信息,难以表达长程任务的阶段推进;其二,恢复片段的 FS 目标假设恢复进度随时间近似线性($u_t$ 线性映射),而真实纠正过程常是非线性的,可能引入目标噪声;其三,终结失败数据必须在真实机器人上跑策略才能采到,成本高且有安全风险;其四,帧级 success/failure 召回仅 66–79%,远低于 ongoing 的 99% 以上,说明信号在成败边界附近的时间定位仍较粗糙;其五,仿真实验中 Echo 的 rollout 并不因信号预测而终止,信号的终止决策价值在仿真中未被检验,+2.09 个百分点的成功率提升也相对温和。
独立分析的弱点
独立分析四个弱点。①二值信号的表达瓶颈:SS/FS 只能区分三四种粗粒度状态,无法表达"离目标还有多远",对多阶段长程任务可能不够用——Make Tanghulu 这类多步任务提升最小(仅 +1.00 分)与此吻合;改进方向是增加连续进度维度或层次化状态信号(子任务级进度 + 步级成败)。②信号恒定影响动作可能损害标称执行:Insert Flower 的 ID 成绩从 π0.5 的 9.33 降到 8.67,提示状态条件化会轻微分散策略对动作本身的专注;改进方向是引入门控机制——仅在 FS 升高或信号接近边界时才让信号强烈影响动作。③阈值与窗口需按任务手调:Figure 9 显示不存在对所有任务同时最优的 $\delta_s,\delta_f,W$ 组合,部署时需要逐任务调参;改进方向是学习式决策头,或基于信号分布的自适应动态阈值。④失败数据获取昂贵:250 条终结失败轨迹背后是大量真实机器人试错,且采样比例固定为 20:1:2:20 需要精心维护;改进方向是在仿真中系统化生成失败、从网络视频中挖掘失败片段,或用世界模型"想象"失败以降低采集成本。
未来方向
作者提出的方向:Echo 的 SS/FS 语义可直接对接上层控制器或外部监控、恢复、规划模块,为它们提供策略内部的执行状态信息(附录 A.9 声明了架构兼容性,但组合系统的收益仍需单独评估);继续扩充失败数据的规模与多样性。基于本文成果可延伸的方向包括:把状态信号与在线强化学习结合——终止/失败信号天然构成奖励基元,可与 VLAC 式 critic 互补;在通用 VLA 基座上做跨任务、跨具身的通用状态信号预训练,打造"会自省"的基础策略;利用异步去噪思想做测试时计算扩展——并行生成多个候选动作块,用状态信号估计对候选进行重排序或提前终止较差候选;把恢复片段的 FS 目标从线性进度改为基于子目标检测或学习的非线性进度;扩展到双臂协调、移动操作、长程多阶段任务等更复杂形态;探索失败信号触发语言层面的重规划,即根据失败类型生成新的指令或子目标。
复现评估
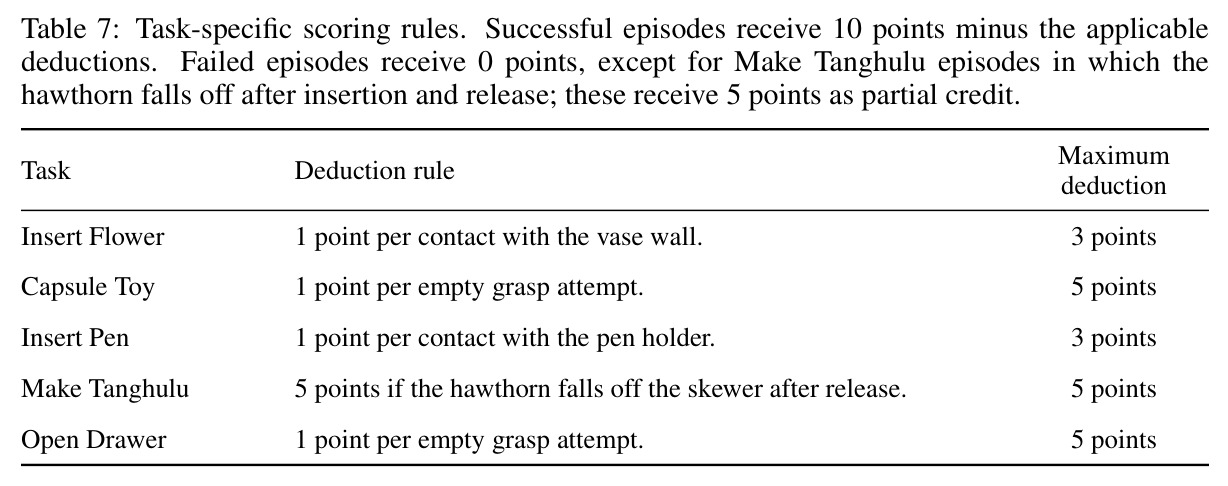
项目页为 https://lyfeng001.github.io/Echo/,论文正文与附录对方法细节披露相当充分:四类数据采样比 20:1:2:20、块长 $H=60$、损失权重 $\lambda_S{=}0.1,\lambda_F{=}1$、$\tau_{clean}{=}0.5$、阈值 $\delta{=}0.5$、5Hz 推理、骨干为公开的 π0.5;仿真部分完整给出了数据构成(6193 条 LIBERO 成功演示 + 3184 条 LIBERO-Recovery 专家恢复数据 + 9521 条 π0.5 失败 rollout)、训练配置(4 卡 GPU、batch 128、2500 步、AdamW 学习率 1e-5→1e-6)以及逐种子结果。但代码与真实机器人数据集未在论文中明确声明开源。复现真实机器人部分门槛很高:需要轮式人形机器人(双 7 自由度臂 + 6 自由度腰腿,共 20 自由度)、三相机遥操作采集管线,以及"执行中人工介入"的数据收集流程;评估还需每任务 30 次试验并按 Table 7 规则人工打分。建议路线:先在 LIBERO-Recovery 仿真中复现三数据类型版本(数据公开、门槛低),验证监督构造与异步去噪后再评估真实平台价值。总体难度:仿真中低,真实系统高。
论文图表
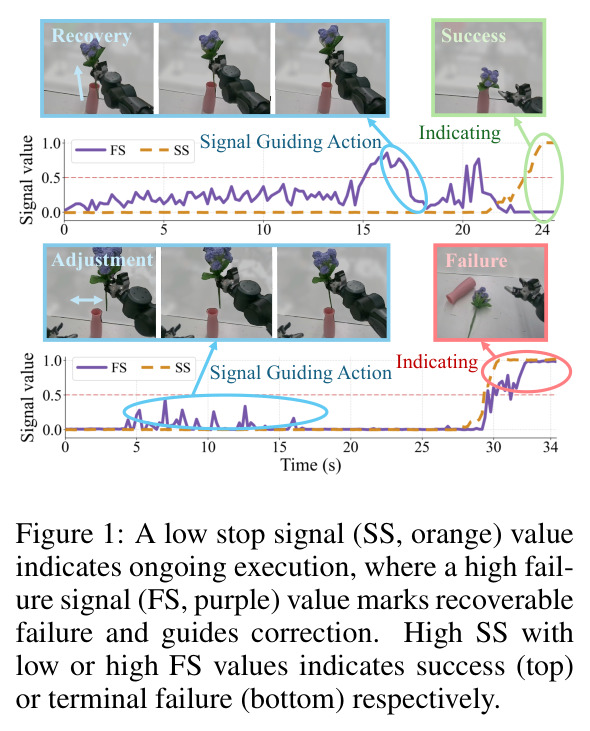
用两个二值信号 SS(橙)与 FS(紫)的组合示意四种执行状态:低 SS 表示进行中(此时高 FS 标记可恢复失败并引导纠正动作);高 SS 低 FS 表示成功;高 SS 高 FS 表示终结性失败。上半部分展示信号引导动作的场景,下半部分展示信号指示结果终止的场景。
这张图定义了全文最核心的概念——SS/FS 的语义与四状态判定规则,是理解方法表示设计、监督构造和评估协议的起点。
把终结失败轨迹从 50 条递增到 250 条(其他三类数据与训练设置不变):帧级 Macro-F1 从约 81.94% 一路升到 92.18%,而任务完成分数始终稳定在 8.33 附近。
揭示了各数据源的分工:失败数据只改善状态监督(其动作被排除在模仿之外),纠正能力主要来自恢复与介入前数据,对数据采集策略设计有直接指导意义。
外部奖励模型 Robometer 在执行视频上估计的成功概率与进度信号曲线,部分失败轨迹上的成功概率未能与成功轨迹区分开。
说明外置视频奖励模型这类"监控路线"的固有短板,与 Echo 的策略内信号形成对照,是 Table 3 对比的定性补充。
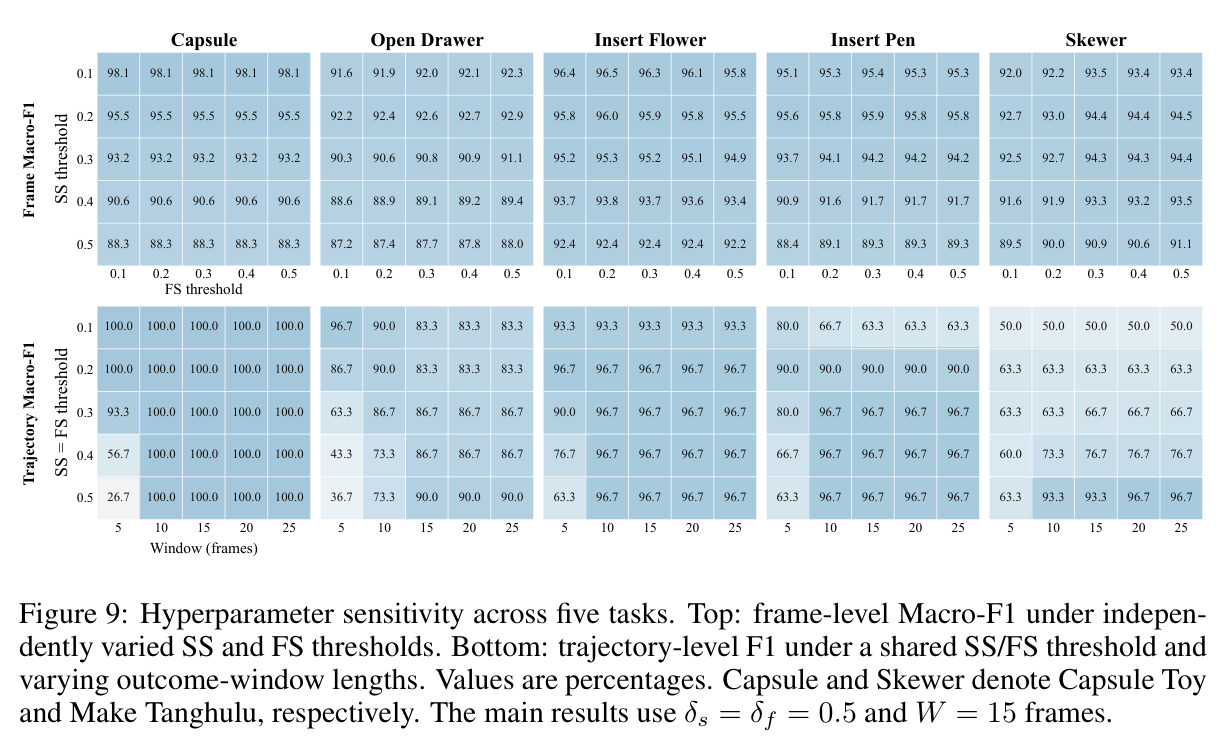
阈值敏感性热图:帧级 F1 随 SS/FS 阈值(0.1–0.5)变化,如 Capsule Toy 从 98.1% 降到 88.3%;轨迹级 F1 随共享阈值与结果窗口(5–25 帧)变化,如 Capsule Toy 在 W=5 时仅 26.7%、W=15 时达 100%。
展示了部署时阈值与窗口选择的实际影响,也暴露了方法在跨任务统一超参上的局限,是评估实用性与局限性的重要依据。
Insert Flower 上与 CycleVLA、VLA-Corrector、Robometer 的对比:Echo 8.33 分领先 CycleVLA 的 3.00 与 VLA-Corrector 的 5.67;帧级 F1 92.18% 远超 CycleVLA 的 43.10% 与 Robometer 二分类的 75.54%。
把 Echo 放到与现有状态信号方法同台比较,证明其同时赢了任务执行与状态预测两个维度,而非只赢自家 baseline。
四个组件变体与完整 Echo 的对比:去掉信号到动作的注意力掉到 5.00 分,放开 SS-FS 互注意帧级 F1 降到 86.14%,同步去噪 7.33 分且轨迹级 F1 降到 86.67%,共享 MLP 6.67 分且帧级 F1 仅 78.68%。
逐组件量化了受控交互、信号分离与异步去噪各自的贡献,证明性能不是单点技巧而是多项设计协同的结果。
LIBERO-Recovery 固定 150 场景、每种子每模型 1500 次共 4500 次:Echo 三个种子成功率 34.47–35.13% 均高于 π0.5 的 31.07–34.07%,平均 34.76% 对 32.67%,帧级信号准确率 89.97%。
提供真实机器人之外的补充证据,含逐种子数据,说明结论在仿真中方向一致但幅度温和(+2.09 个百分点)。