何时切换:面向视觉-语言-动作模型的可靠动作块扩展 When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
预测子技能切换时机并调制去噪生成,让VLA可靠执行4倍长动作块,减少机器人停顿
前置知识
VLA(视觉-语言-动作模型)
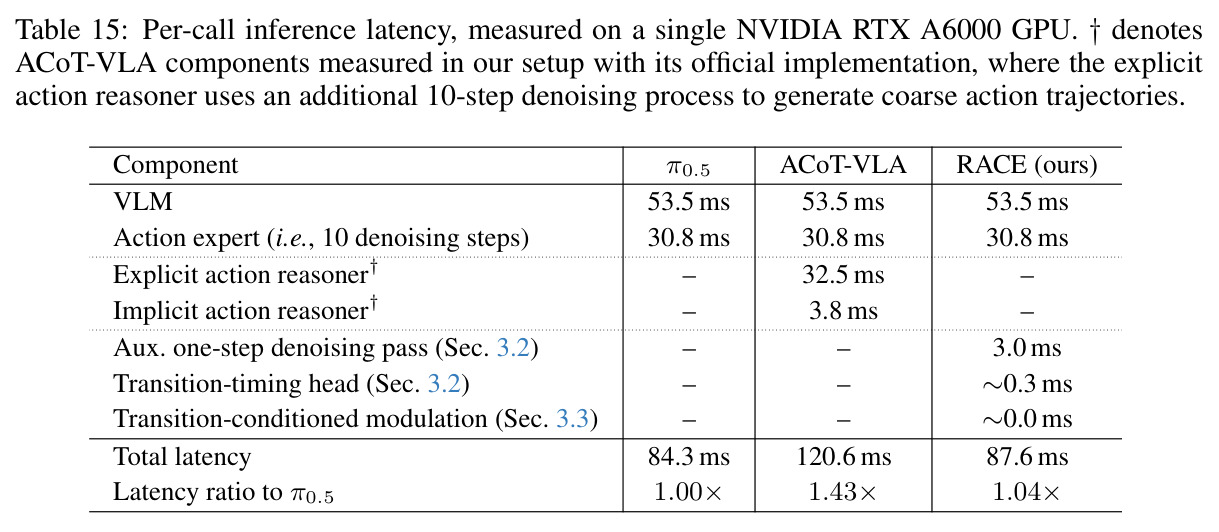
VLA 模型把预训练视觉-语言模型(VLM)适配到机器人控制:输入相机图像和语言指令,输出机器人动作。早期模型(RT-2、OpenVLA)自回归生成离散动作 token;新一代(π0.5、GR00T)由 VLM 提供语义特征,动作专家以流匹配并行生成连续动作块。其通用能力来自大规模预训练,但模型体量导致单次推理昂贵(π0.5 一次调用约 84.3 ms)。
本文方法与实验全部构建在 π0.5 之上,RACE 的辅助去噪通道、预测头和调制模块都挂在动作专家上,理解架构必须先知道 VLA 的 VLM+动作专家分工。
动作分块(Action Chunking)
策略每次推理不只预测一步动作,而是一次性预测未来 $H$ 步连续动作并依次执行,从而两次策略调用之间机器人能连续运动更久,缓解大模型推理延迟造成的停顿;适度加长块还会因时间一致性或隐式集成带来成功率提升,但块过长后开环预测误差累积、成功率反降。
本文研究的正是「块能加长到多少、为什么会失效」:$H_{exec}$(每次执行的动作数)是贯穿全文的核心变量,基线 π0.5 只执行 $H_{exec}=5$。
流匹配与迭代去噪
流匹配训练速度场 $v_\theta$,把高斯噪声沿 $A_t^k = A_t^{k-1} + \frac{1}{K}v_\theta(A_t^{k-1}, z_t)$ 迭代 $K$ 步变换为动作块。π0.5 的动作专家是一个 DiT 式 Transformer,用 $K=10$ 步去噪,每层的 adaptive RMSNorm 依据去噪时间对中间隐状态做缩放/平移/门控调制。
RACE 的核心是在每一个去噪步注入转移时机先验,辅助一步去噪通道也是从该过程派生的;不懂去噪循环就无法理解其条件化机制和逐去噪步门控的设计动机。
PELT 变点检测
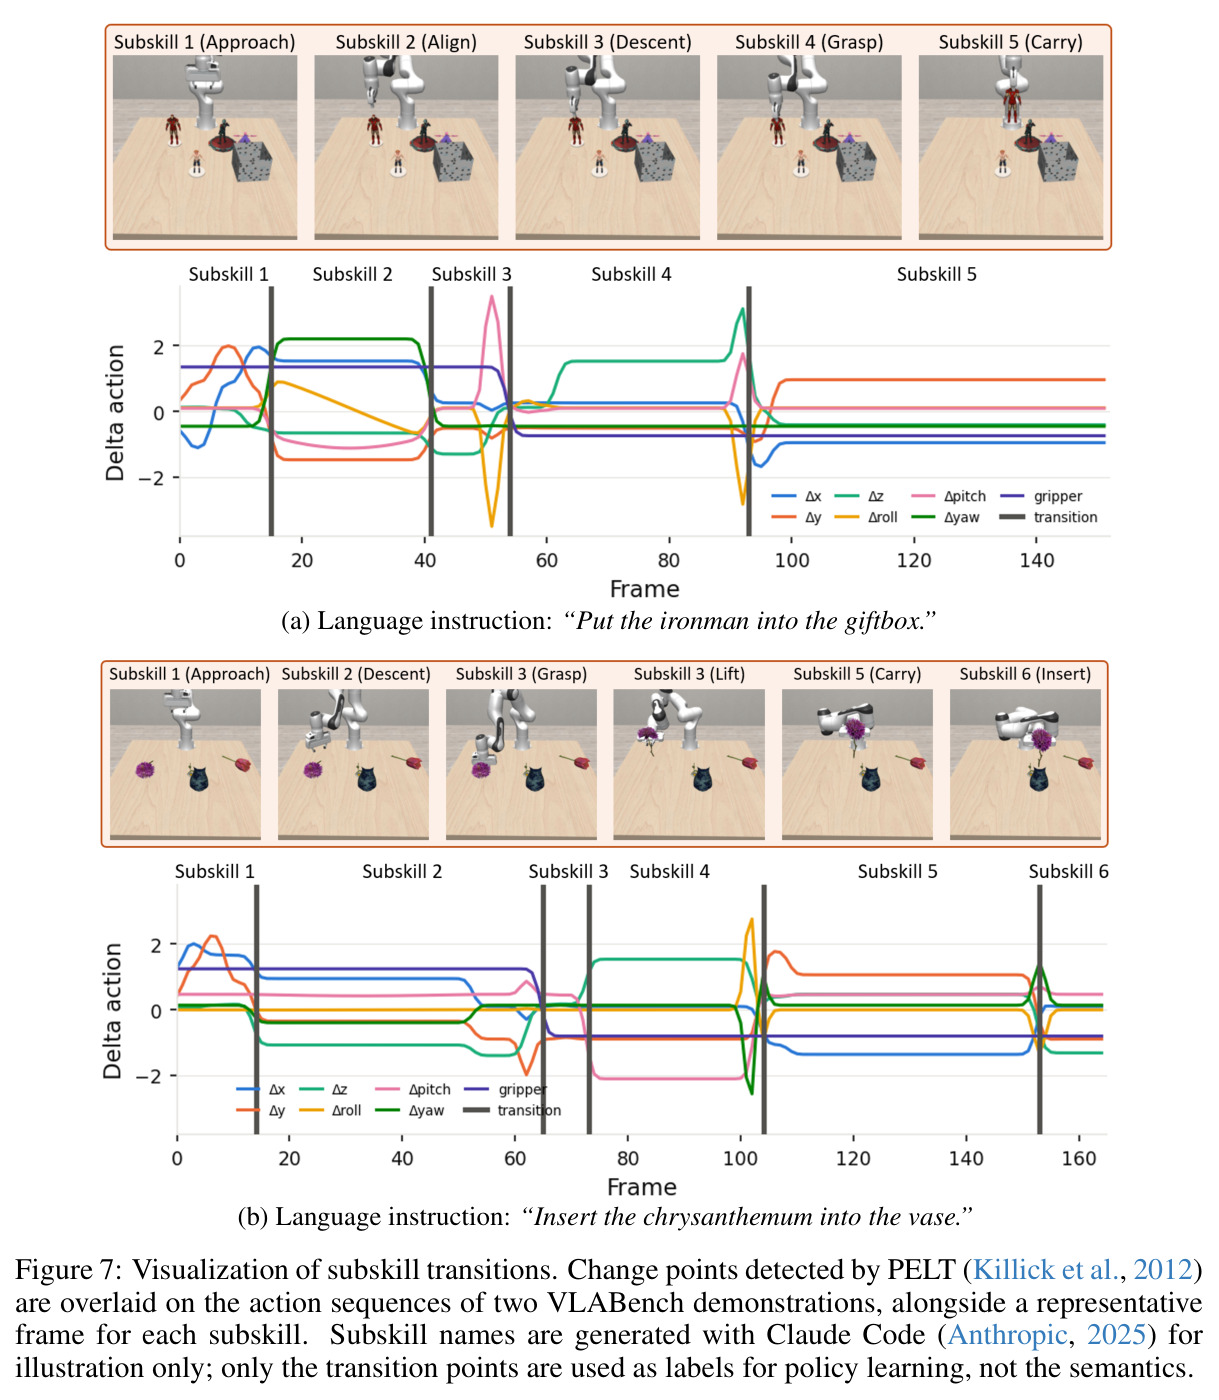
PELT(Pruned Exact Linear Time)在时间序列中寻找统计分布突变的点,通过最小化 $\sum_i \text{cost}(\tilde{a}_{c_i:c_{i+1}}) + \beta m$ 动态规划求解,$\beta$ 惩罚变点数量。本文对演示动作序列逐维标准化后,用高斯核分段代价无监督地把轨迹切成子技能段(接近、抓取、提起等),变点即子技能切换步,无需人工标注。
论文的动机分析(误差集中在切换处)与训练标签(转移时机软标签)全部由 PELT 产生,是理解 motivation 和复现训练的第一步。
自适应 RMSNorm(DiT 式调制)
DiT 用一组缩放/平移/门控参数 $(\gamma^\ell, \beta^\ell, g^\ell)$ 对每层归一化后的隐状态做仿射调制:$\tilde{X}^\ell = (1+\Gamma^\ell)\odot\text{RMSNorm}(X^\ell) + B^\ell$,再以 $X^{\ell+1} = X^\ell + G^\ell \odot \text{Module}^\ell(\tilde{X}^\ell)$ 更新,让时间步等全局条件调控每个 Transformer 层。π0.5 的动作专家沿用该机制。
RACE 正是把转移时机先验编码为对这些调制参数的逐 token 偏移(token-wise offset),这是它把「何时切换」信息注入动作生成的物理载体。
停走执行与异步执行
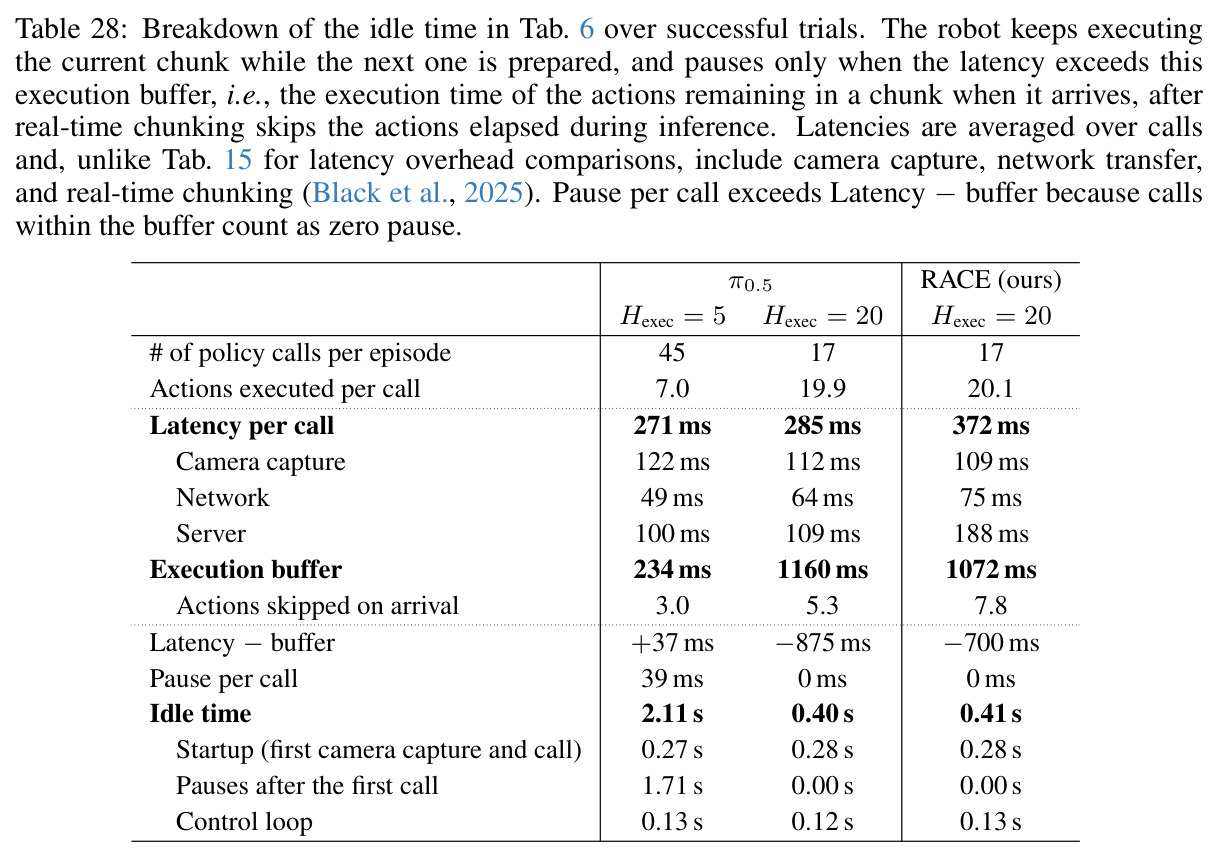
stop-and-go 指机器人执行完当前动作块后,因下一批动作尚未推理完成而停转等待,数百个控制步累积的空闲时间拉长任务完成时间。异步执行(如 real-time chunking)在执行当前块的同时生成下一块,用「块内剩余动作的执行时间」(execution buffer)掩盖推理延迟;只有当延迟超过缓冲时才真正停顿。
理解空闲时间从何而来、为什么「更长块即使有异步执行仍有价值」(Sec. 4.5 与 Tab. 28 的分解),需要这两个概念作为背景。
研究动机
VLA 模型单次策略推理代价高昂:π0.5 一次调用中 VLM 编码耗时约 53.5 ms、动作专家 10 步去噪约 30.8 ms,共 84.3 ms;而机器人以 30 Hz 控制频率执行动作,常常在下一批动作就绪前就把当前块执行完,被迫反复停顿等待,形成「走走停停」(stop-and-go)的执行模式。在论文的真实机器人实验中,基线 π0.5 每次只执行 5 个动作($H_{exec}=5$),一次抓放任务平均触发 45 次策略调用、每次停顿约 39 ms,累计空闲时间高达 2.11 秒,其中首次调用之后的停顿占 1.71 秒。动作分块虽能缓解,但先前工作一致观察到:块长超过一定限度后成功率不升反降,因为策略要在没有中间观测反馈的情况下预测更远的未来(开环执行),长块变得不可靠,这阻碍了 VLA 的真实部署。
本文的目标是论文的目标是先弄清长动作块执行为何不可靠,再让 VLA 在不牺牲成功率的前提下可靠执行更长的动作块——具体量化目标为:把每次执行的动作数从基线的 $H_{exec}=5$ 提升到 20(4 倍),将策略调用次数和停顿空闲时间压缩约 5 倍,同时保持或提高任务成功率。作者希望以轻量后训练(而非强化学习)实现:相同块长下稳定优于朴素微调;2 倍块长($H_{exec}=10$)下超过最新 SOTA VLA 与高效推理方法;4 倍块长下仍具竞争力;真实机器人上空闲时间减少约 5 倍且成功率更高。
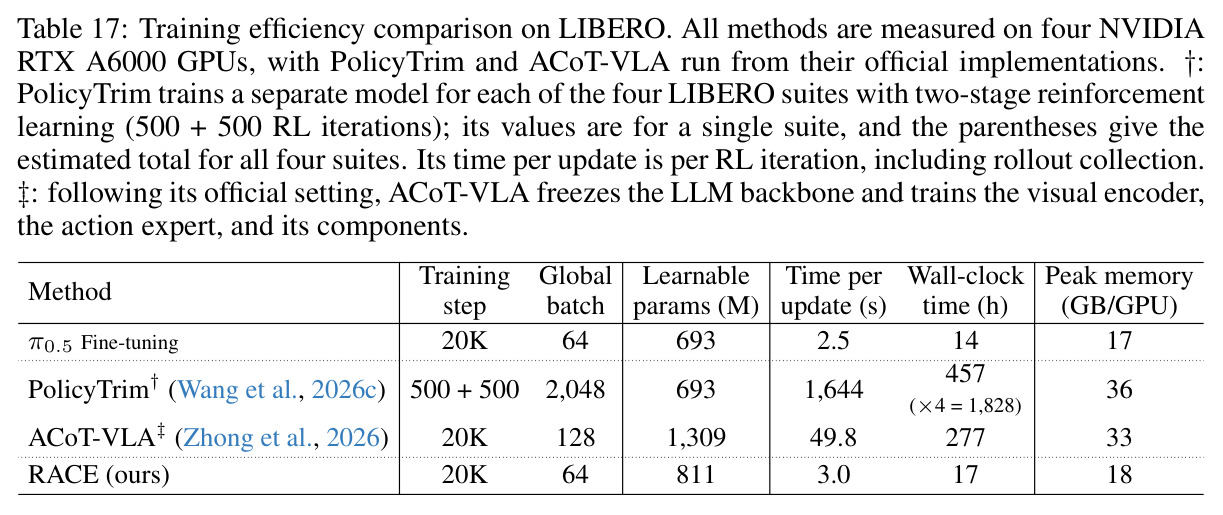
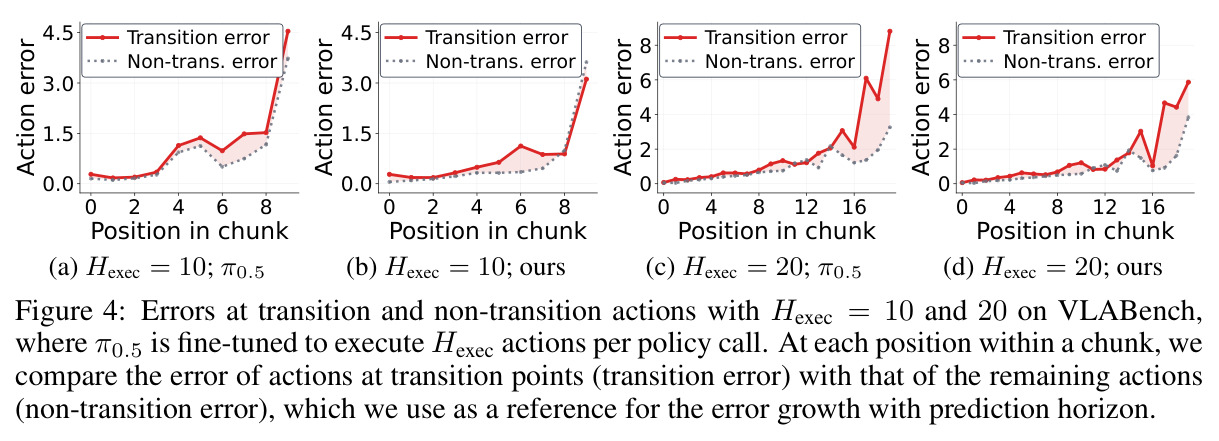
与已有工作不同的是,本文的独特切入是「先诊断、再治病」。已有方案都是事后补救:自适应分块方法(AutoHorizon、PACE)在推理时只执行每个块中「可靠的前缀」,PACE 靠低速谷检测回避转移处;PolicyTrim 用高成本强化学习延长块(每个 LIBERO 套件需 457 小时墙钟训练)。作者则用 PELT 变点检测在无标注演示中定位子技能切换点,发现动作误差并非均匀漂移,而是集中在切换点附近且随块长急剧增长(Fig. 2b),从而把问题重新表述为「块内何时切换子技能」(transition timing)。与其在推理时截断或回避不可靠动作,RACE 让策略显式学习并预测切换时机、再以之条件化动作生成,从源头降低切换处的误差,使整块动作都可靠——这使它与自适应分块、高效推理、异步执行三条线全部正交。
核心方法
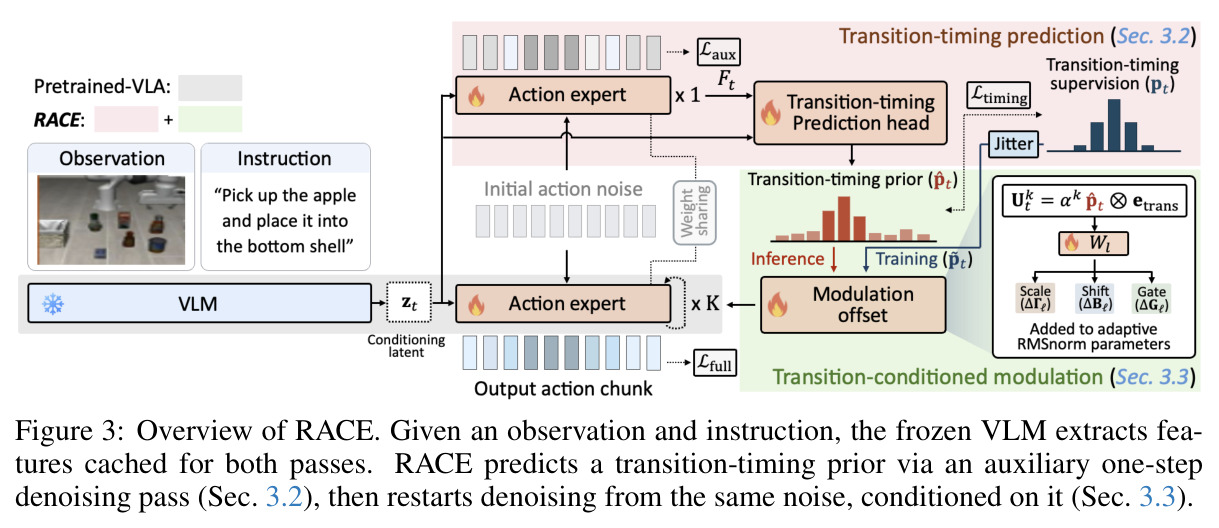
先说直觉:长块失败的根源不是均匀的「越远越不准」,而是在子技能切换点(接近→抓取→提起→搬运)处误差骤增;如果模型能提前知道「这个块里哪些位置将发生切换」,去噪生成就能在这些位置更谨慎地分配容量。技术上,RACE 构建在流匹配 VLA(π0.5)之上:冻结的 VLM 编码观测 $o_t$ 与指令 $\ell$ 得到缓存特征 $z_t$;动作专家从高斯噪声 $A_t^0 \sim \mathcal{N}(0,I)$ 出发,经 $K=10$ 步去噪生成动作块 $A_t=(a_t,\dots,a_{t+H-1})$。RACE 引入转移时机先验 $\hat{p}_t \in [0,1]^H$(每个位置是切换的分数),把去噪规则改为 $A_t^k = A_t^{k-1} + \frac{1}{K}v_\theta(A_t^{k-1}, z_t, \alpha_k \hat{p}_t)$,其中 $\alpha_k$ 是可学习的逐去噪步门控。整体流程三步:(1) 辅助一步去噪通道(不带先验)产出动作专家隐状态;(2) 预测头从隐状态与 VLM 特征估计 $\hat{p}_t$;(3) 从同一初始噪声重启完整去噪,每步以先验为条件。仅训练动作专家与新增模块(811M 参数),VLM 冻结。
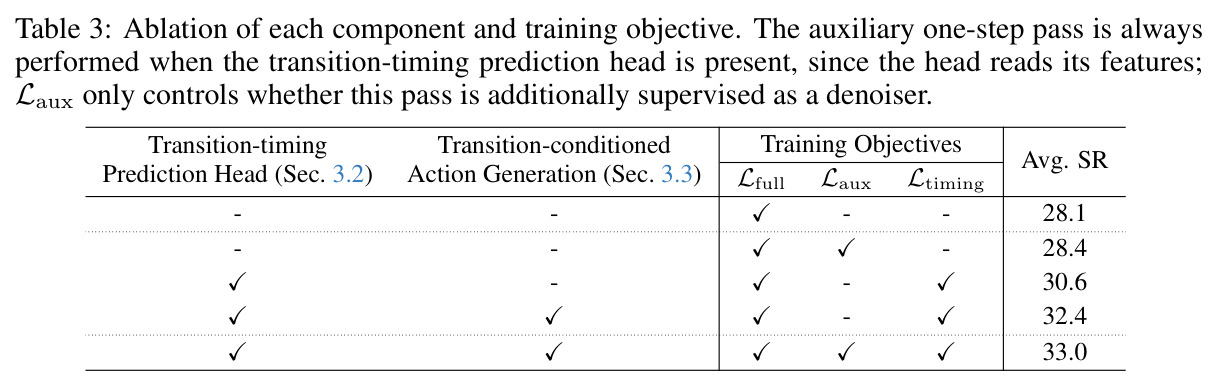
核心创新有三层。诊断层:首次把长块失效归因于子技能转移处的误差尖峰——用 PELT 在演示动作上无监督检测变点,显示尖峰随 $H$ 增长(Fig. 2b),指出被忽视的「切换时机」才是块扩展的瓶颈。学习层:通过辅助一步去噪通道读取动作专家末层隐状态 $F_t \in \mathbb{R}^{H \times d_a}$(与块内每个动作位置对齐的粗略运动估计),与 VLM 末层特征交叉注意力后预测逐位置转移分数;由于 $\mathcal{L}_{\text{timing}}$ 会反传进动作专家,其表征被迫变得「转移感知」——消融显示仅这一监督就使成功率从 28.1 升至 30.6,即使先验并未注入生成。条件化层:把预测先验经 $U_t^k = \alpha_k \hat{p}_t \otimes e_{\text{trans}}$ 映射为每层 adaptive RMSNorm 的 scale/shift/gate 逐 token 偏移,注入每个去噪步,$\alpha_k$ 控制每步强度。与 PACE 在推理时躲避转移不同,RACE 让动作本身变可靠;与 PolicyTrim 的 RL 相比只需轻量后训练(LIBERO 四套件 17 小时 vs 1828 小时)。
方法步骤详情
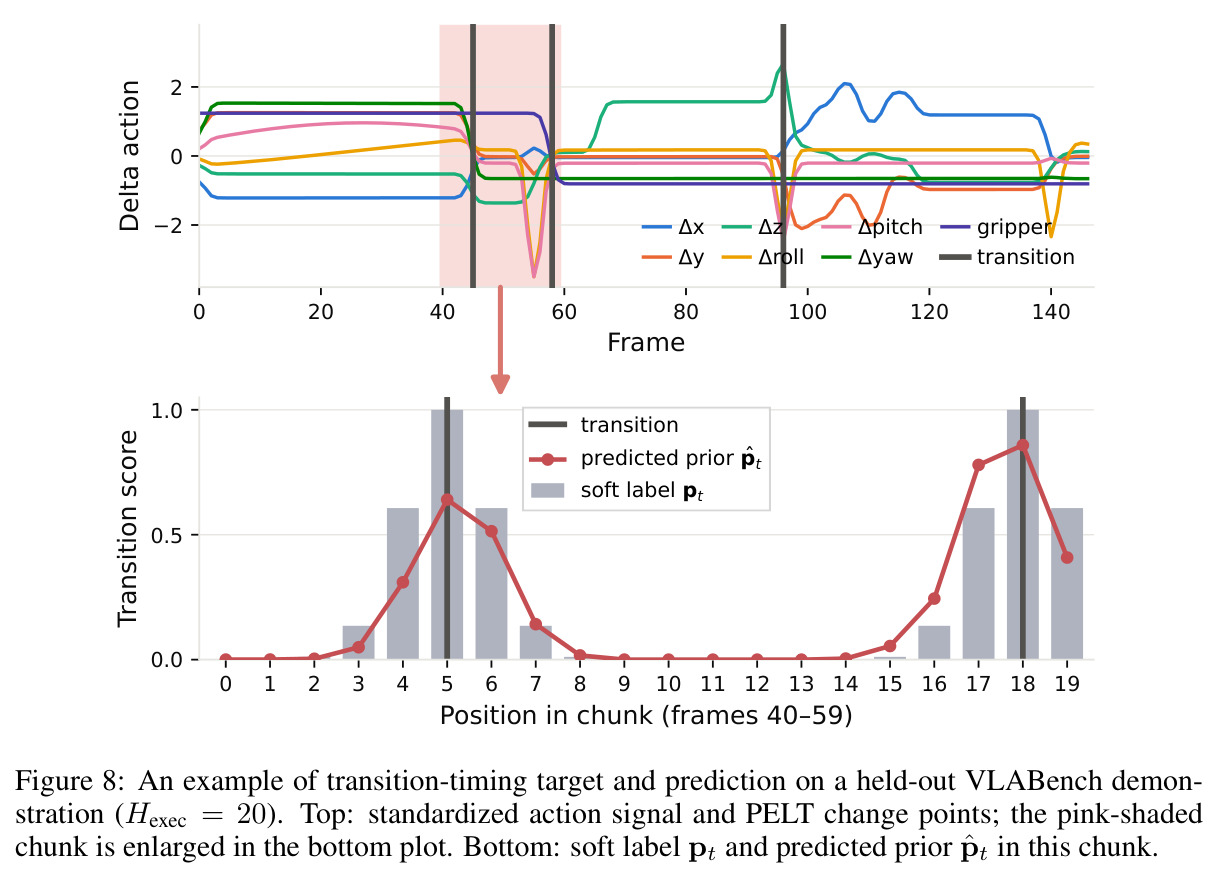
完整步骤如下。(1) 离线提取转移标签:对每条演示的动作序列逐维标准化 $\tilde{a}_t=(s_t-\mu)/\sigma$,用 PELT 以高斯核分段代价、惩罚 $\beta=4$ 检出变点集合 $C$(VLABench 上平均每集 3.57 个切换);再把每个变点转成软标签 $p_t = \exp(-d_t^2/2\sigma_p^2)$($\sigma_p=1$,3 步外截为零,每条转移影响约 7 步)。(2) 辅助一步去噪:从初始噪声 $A_t^0$ 不带先验地计算速度 $v_{\text{aux}} = v_\theta(A_t^0, z_t)$,取动作专家末层隐状态 $F_t \in \mathbb{R}^{H\times d_a}$($d_a=1024$);该通道同时用流匹配损失 $\mathcal{L}_{\text{aux}}$ 监督以保持其为有效去噪器。(3) 时机预测头:$\hat{p}_t = \sigma(\tilde{F}_t w_p)$,其中 $F_t$ 经投影后先与 VLM 末层特征 $\hat{z}_t$($d_z=256$)做交叉注意力、再自注意力;以 BCE 损失 $\mathcal{L}_{\text{timing}}$ 对软标签监督。(4) 转移条件化生成:构造 $U_t^k = \alpha_k \hat{p}_t \otimes e_{\text{trans}}$,经 $W^\ell$ 映射为偏移 $[\Delta\Gamma^\ell, \Delta B^\ell, \Delta G^\ell]$ 加到预训练调制参数上;$W^\ell$ 零初始化且无偏置,保证零先验时完全退化为原模型。(5) 训练目标 $\mathcal{L} = \mathcal{L}_{\text{full}} + 0.1\,\mathcal{L}_{\text{aux}} + 0.05\,\mathcal{L}_{\text{timing}}$;训练时用教师强制并以 0.5 概率把条件目标抖动 ±1 步(jittering),推理时改用预测的 $\hat{p}_t$。VLABench 训 40K 步、其余基准 20K 步,AdamW 学习率 $5\times10^{-5}$ 余弦衰减到 $5\times10^{-6}$,batch 64,4 块 RTX A6000。
技术新颖性
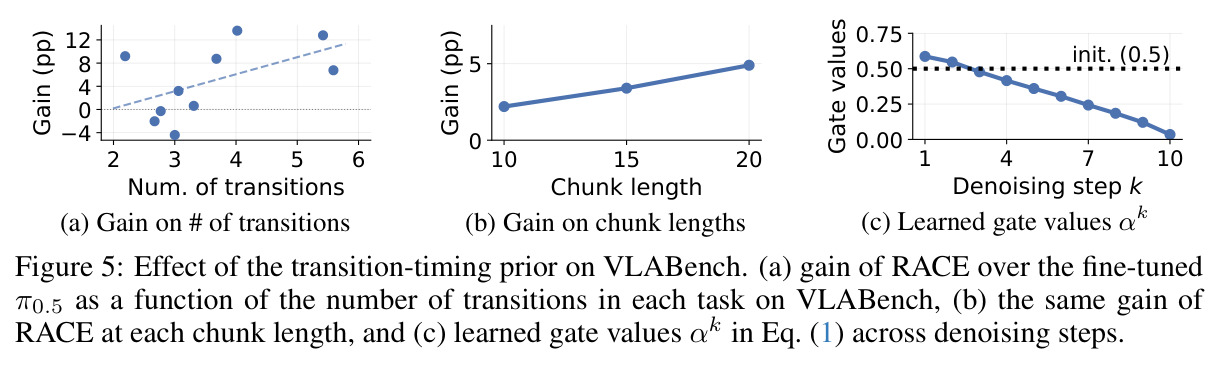
技术新颖性可从四个维度评估。第一,「何时切换」被提升为一等问题:以往子技能结构研究要么把阶段当预测目标(CoTPC 预测子技能目标状态)、要么当输入条件(SAGE 以阶段/进度条件化)、要么当辅助输出(PALM 联合生成进度序列),RACE 首次让动作专家在块内预测转移时机并以之调制去噪全过程,塑造转移感知的动作表征。第二,一步去噪通道充当「探测器」:它既提供与每个动作位置对齐的粗略运动信息供预测头使用,又经 $\mathcal{L}_{\text{aux}}$ 保持为有效去噪步(消融中把成功率从 32.4 提到 33.0),一个组件两种用途。第三,注入机制即插即用:先验以 $U_t^k=\alpha_k\hat{p}_t\otimes e_{\text{trans}}$ 的形式在每个去噪步、对每个动作 token 独立调制 RMSNorm 参数,$W^\ell$ 零初始化意味着训练从预训练模型出发、零先验即原模型;学到的 $\alpha_k$ 单调递减,先验主要作用于早期去噪步,与「转移边界在早期就应被分开」的表征分析(Fig. 6)互相印证。第四,作者坦诚保留开环误差的不可解部分:RACE 只消除转移处的额外误差、不补偿开环漂移,因此 $H_{exec}=40$ 时仍跌破基线——问题被精确界定而非夸大。
实验结果
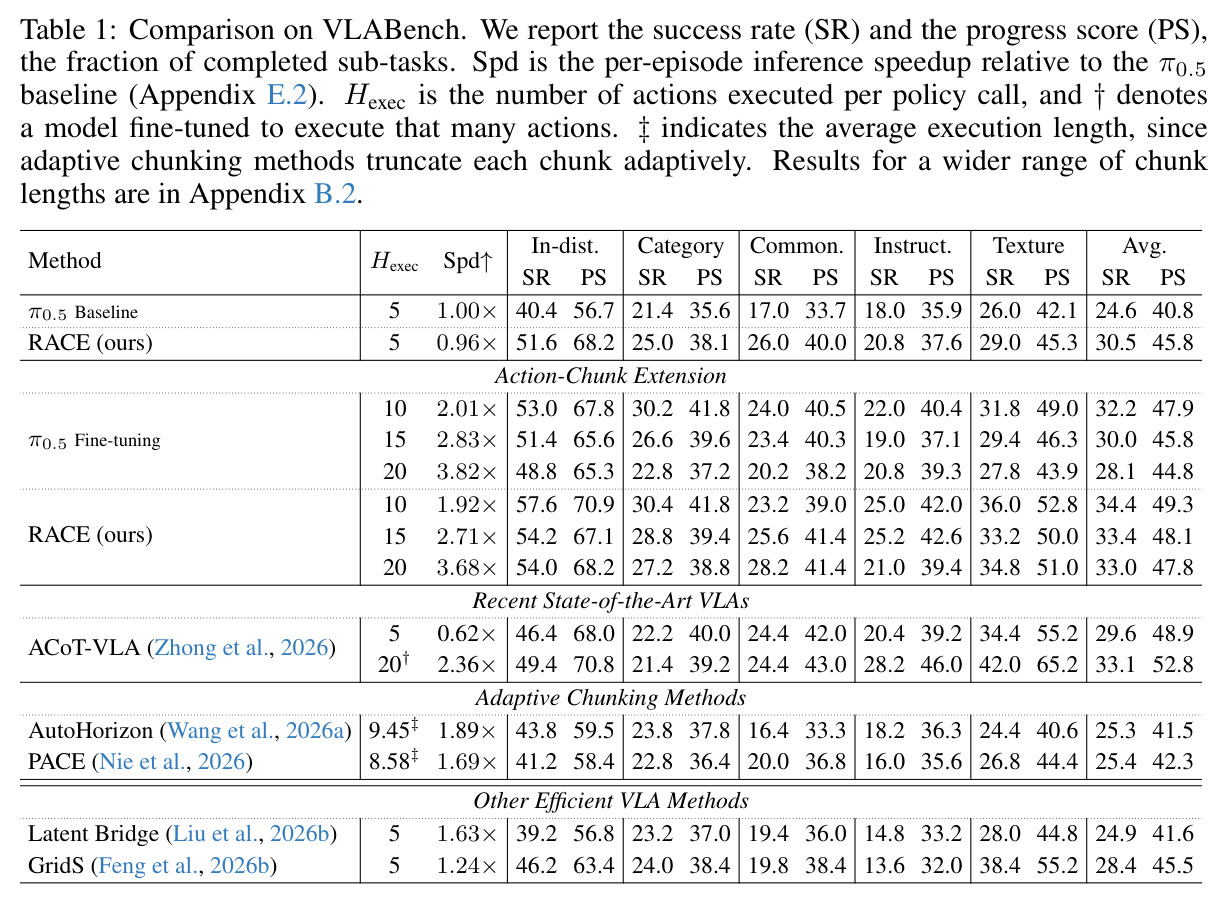
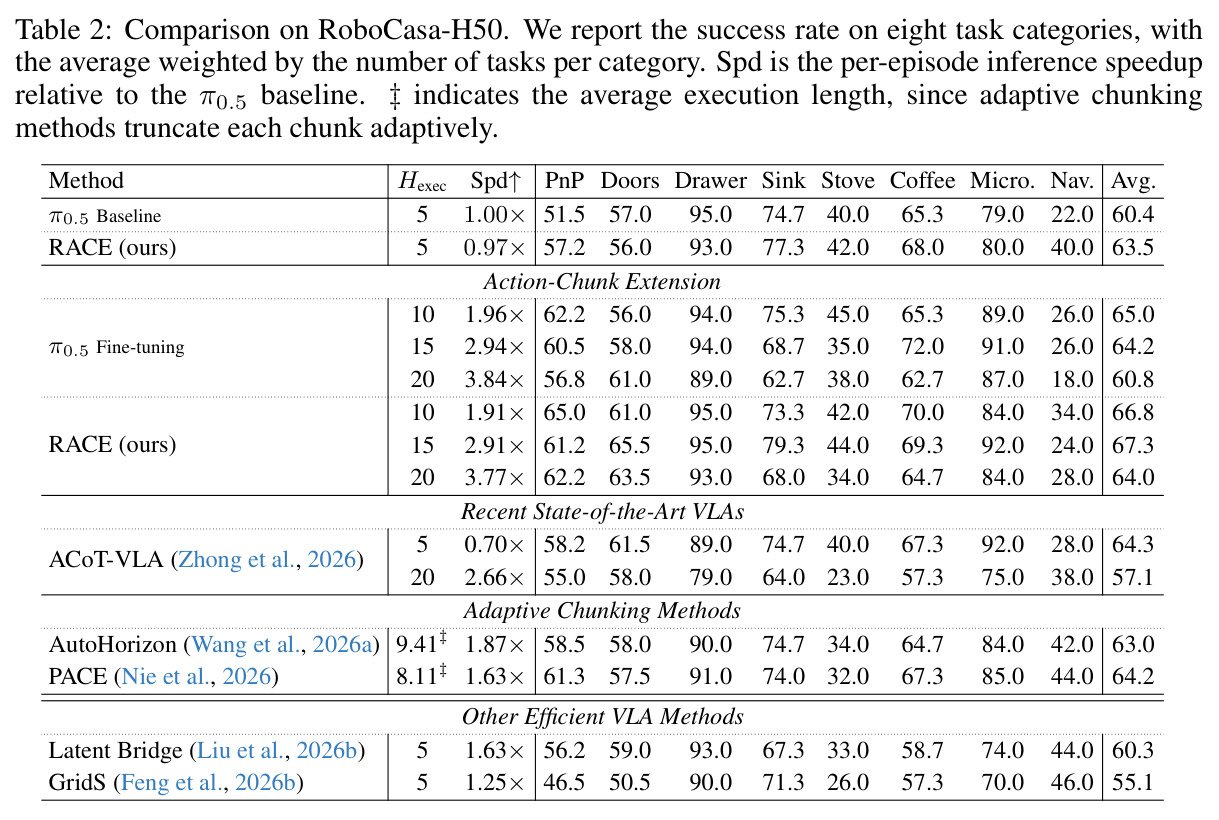
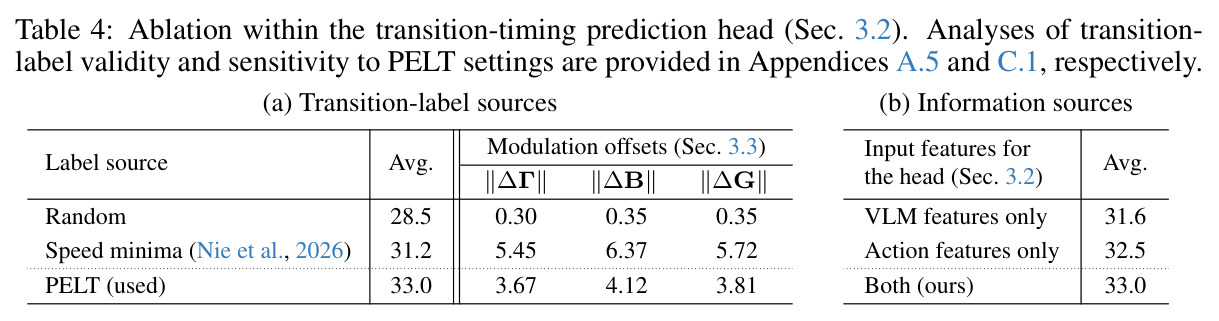
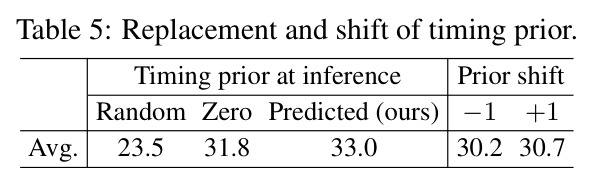
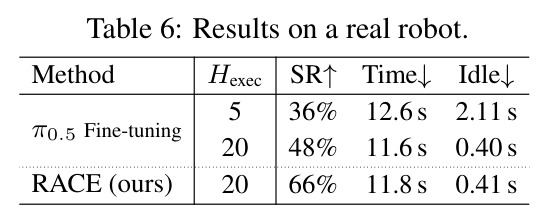
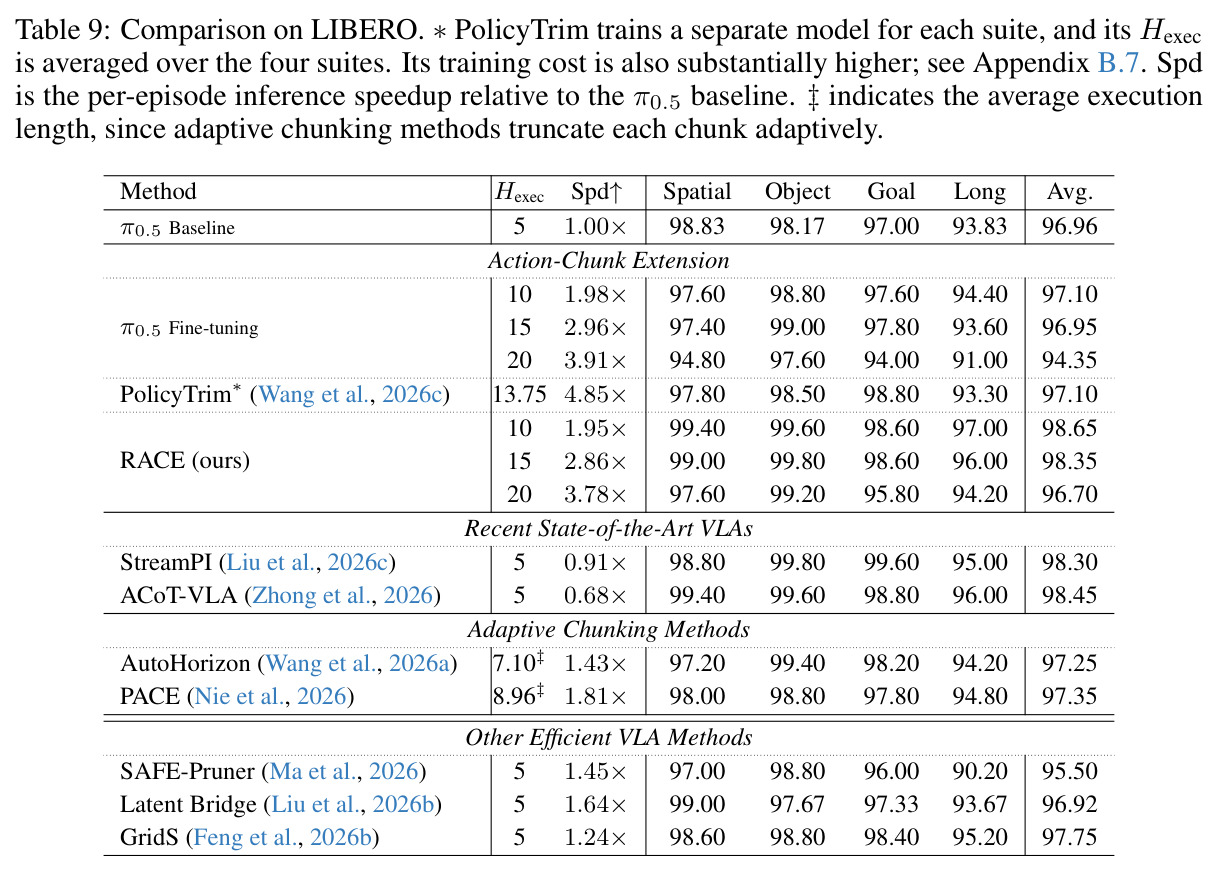
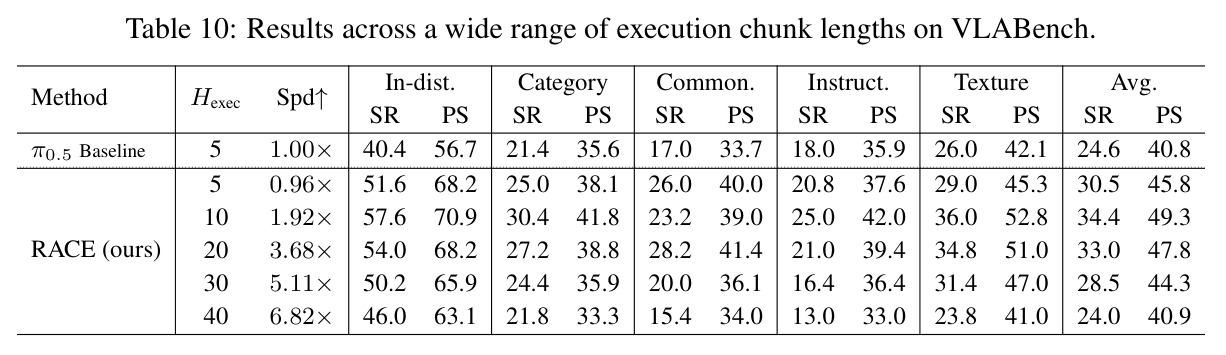
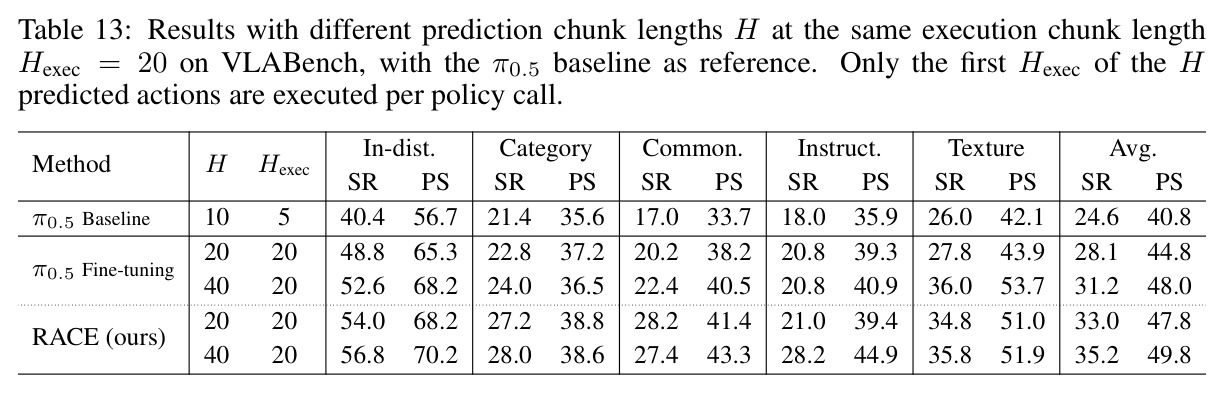
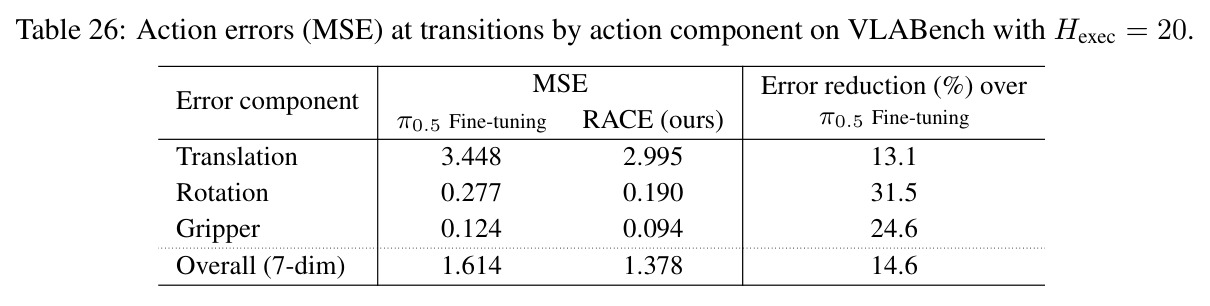
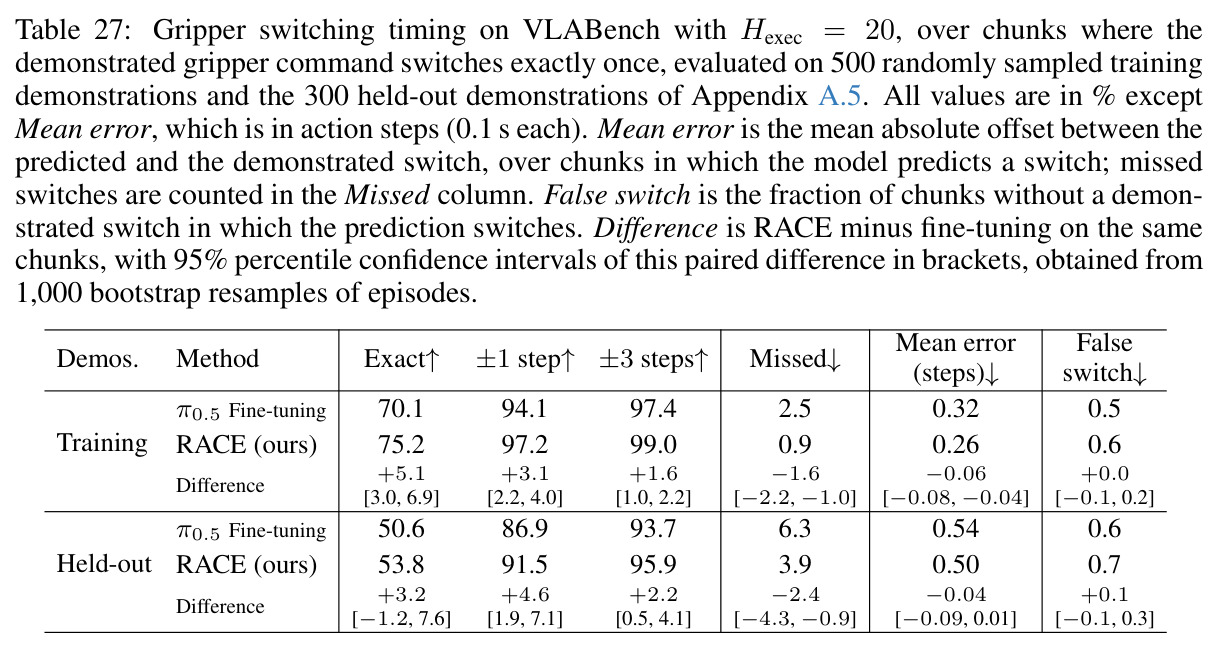
逐一分析主要实验。(1) VLABench(Tab. 1):π0.5 基线($H_{exec}=5$)平均成功率 SR 仅 24.6;RACE 同块长即达 30.5;微调版加长到 $H_{exec}=20$ 反而降至 28.1,而 RACE 在 10/15/20 分别为 34.4/33.4/33.0(加速 1.92×/2.71×/3.68×),即 4 倍块长仍全面高于基线。对比方法:SOTA 的 ACoT-VLA($H_{exec}=20$)SR 33.1 与 RACE 相当但加速仅 2.36×;自适应分块 AutoHorizon/PACE 仅 25.3/25.4;高效 VLA Latent Bridge/GridS 为 24.9/28.4。(2) RoboCasa-H50(Tab. 2):基线 60.4,RACE $H_{exec}=20$ 达 64.0(3.77×),微调同长度只有 60.8,ACoT-VLA 掉到 57.1。(3) LIBERO(Tab. 9):RACE $H_{exec}=10$ 平均 98.65,超过基线 96.96 与 PolicyTrim 的 97.10,而训练成本 17 小时 vs PolicyTrim 的 1828 小时(约 107 倍)。(4) 组件消融(Tab. 3,$H_{exec}=20$):仅 $\mathcal{L}_{\text{full}}$ 28.1 → 加 $\mathcal{L}_{\text{aux}}$ 28.4 → 加预测头与时机监督 30.6 → 加条件化 32.4 → 全部 33.0,证明监督与条件化互补。(5) 标签消融(Tab. 4a):随机标签使调制偏移范数缩小一个数量级(约 0.3)、模型学会忽略先验,SR 28.5;速度谷标签 31.2;PELT 33.0。信息源消融(Tab. 4b):仅 VLM 特征 31.6、仅动作特征 32.5、两者 33.0。(6) 误差分析:转移误差与同位置非转移误差之比为 1.34[1.15,1.56],$H_{exec}=20$ 时差距扩大;RACE 将总体转移误差降 14.6%(旋转 31.5%、夹爪 24.6%、平移 13.1%,Tab. 26),夹爪在精确步切换的比例 70.1%→75.2%、漏切率 2.5%→0.9%(Tab. 27)。(7) 先验扰动(Tab. 5):随机先验 23.5、零先验 31.8、预测先验 33.0,平移 ±1 步降至 30.2/30.7,且先验平移会带动生成的夹爪切换同向移动(每步约 0.23–0.28 步,Tab. 25),证明模型真正依赖先验的位置信息。(8) 真实机器人(Tab. 6,AgileX PiPER,30 条演示、50 次试验、异步执行):微调 $H_{exec}=5$ 成功率 36%、空闲 2.11 s;微调 $H_{exec}=20$ 48%、0.40 s;RACE $H_{exec}=20$ 达 66%、0.41 s——4 倍块长使空闲降约 5 倍,同块长成功率高出 18 个百分点;空闲分解(Tab. 28)显示 $H_{exec}=20$ 时首调用后停顿为 0,剩余空闲主要来自启动(0.28 s)与控制循环开销。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VLABench(5 轨道平均) | 成功率 SR (%) | RACE $H_{exec}=20$:33.0($H_{exec}=10$:34.4) | π0.5 基线 $H_{exec}=5$:24.6;π0.5 微调 $H_{exec}=20$:28.1 | +8.4 vs 基线;+4.9 vs 同块长微调,同时推理加速 3.68× |
| RoboCasa-H50(8 类任务加权平均) | 成功率 (%) | RACE $H_{exec}=20$:64.0($H_{exec}=15$:67.3) | π0.5 基线:60.4;微调 $H_{exec}=20$:60.8;ACoT-VLA $H_{exec}=20$:57.1 | +3.6 vs 基线;+3.2 vs 同块长微调;+6.9 vs ACoT-VLA |
| LIBERO(四套件平均) | 成功率 (%) | RACE $H_{exec}=10$:98.65 | π0.5 基线:96.96;PolicyTrim:97.10(4.85× 加速) | +1.69 vs 基线;+1.55 vs PolicyTrim,训练时间 17h vs 1828h |
| 真实机器人抓放(AgileX PiPER,50 次试验) | 成功率 / 空闲时间 | RACE $H_{exec}=20$:66% / 0.41 s | 微调 $H_{exec}=5$:36% / 2.11 s;微调 $H_{exec}=20$:48% / 0.40 s | 同块长 +18 pp;空闲时间约 5× 降低 |
| 单次策略调用延迟(RTX A6000) | 总延迟 (ms) | RACE:87.6 ms(1.04×) | π0.5:84.3 ms;ACoT-VLA:120.6 ms(1.43×) | 开销仅 +3.3 ms(辅助通道 3.0 ms + 预测头 0.3 ms) |
| LIBERO 全套件训练成本 | 墙钟时间 (h, 4×A6000) | RACE:17 h(18 GB/卡) | PolicyTrim:1828 h;ACoT-VLA:277 h;π0.5 微调:14 h | 约为 PolicyTrim 的 1/107、ACoT-VLA 的 1/16 |
局限与改进
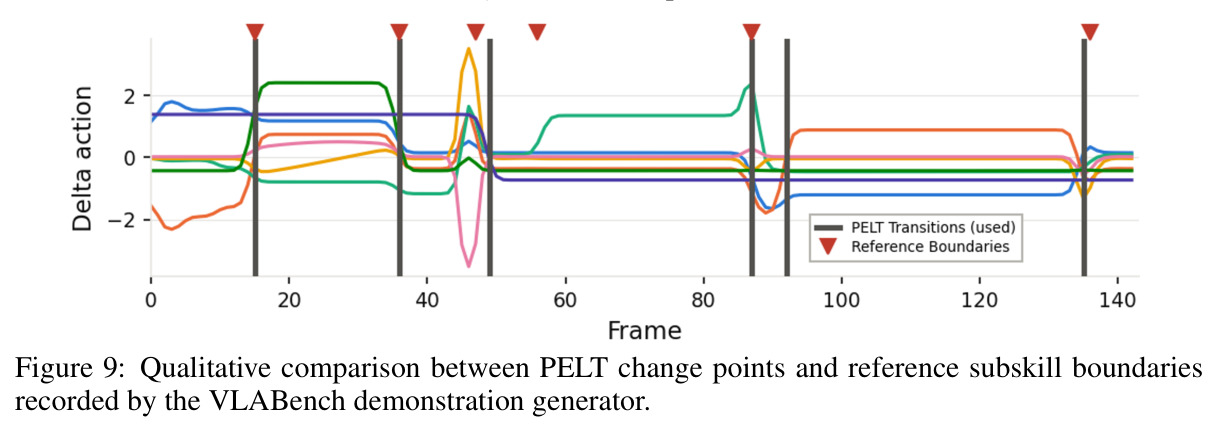
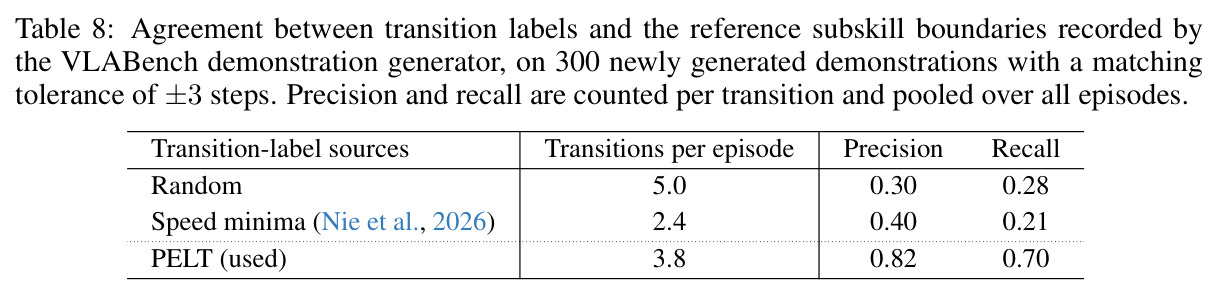
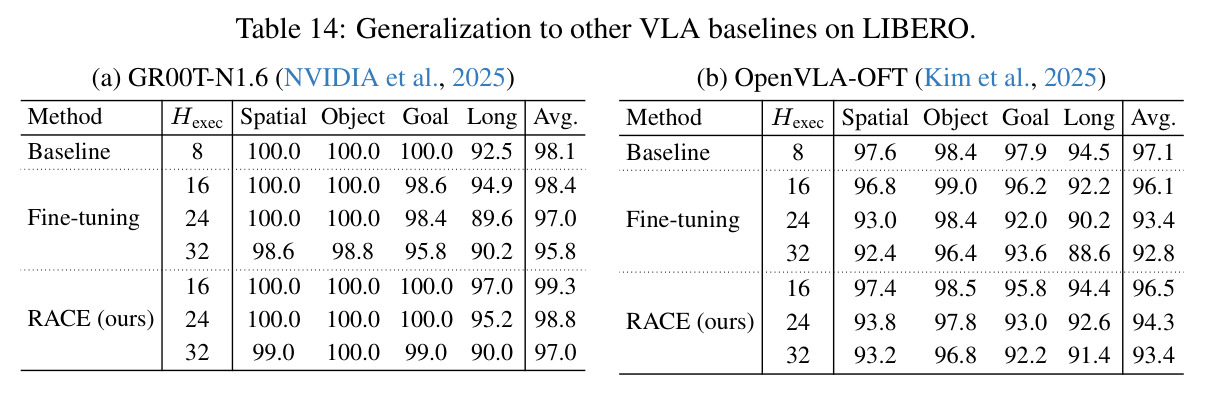
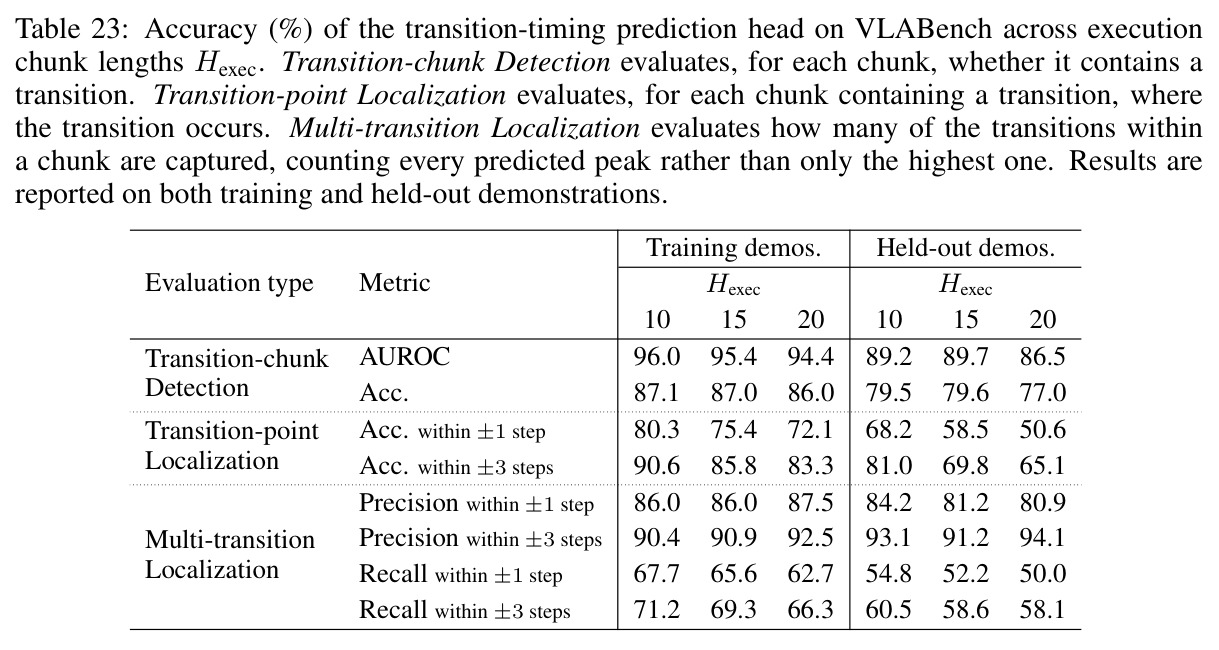
作者承认的局限有三。(1) 转移时机预测不完美:held-out 演示上 $H_{exec}=20$ 的 ±1 步定位精度仅 50.6%(训练演示 72.1%),多转移召回约 50–58%,平均每集约 3.8 条转移会漏掉近半;且标签是 PELT 伪标签而非人工标注,与生成器参考边界的 precision/recall 仅 0.82/0.70。(2) 超长块仍退化:$H_{exec}=30$ 时 SR 28.5 尚高于基线 24.6,$H_{exec}=40$ 时 24.0 跌破基线,因为 RACE 只缓解转移误差,开环漂移本身无法补偿。(3) 依赖迭代去噪架构:在无去噪过程的 OpenVLA-OFT 上收益缩水($H_{exec}=16$ 时 96.5 vs 基线 97.1,虽仍优于微调的 96.1)。我自己的观察:(4) 真实机器人验证薄弱——仅 1 个抓放任务、30 条演示、50 次试验,66% vs 48% 的差距在此样本量下置信区间较宽,也未测长程组合任务或双臂/工具使用等转移更密集的场景;(5) 预测精度在分布外明显下滑(AUROC 从 94.4 降至 86.5),暗示对视觉外观变化敏感,泛化到全新任务族存疑;(6) PELT 依赖动作动力学突变,对动作信号平滑的慢速精细操作(如插孔、擦拭)检测质量存疑——论文自己的数据显示速度谷替代标签 precision 只有 0.40;(7) 更长开环意味着对环境突变(人进入工作区、物体被移动)反应更慢,论文伦理部分也承认部署需额外安全防护,但未提供任何运行时安全机制。
独立分析的弱点
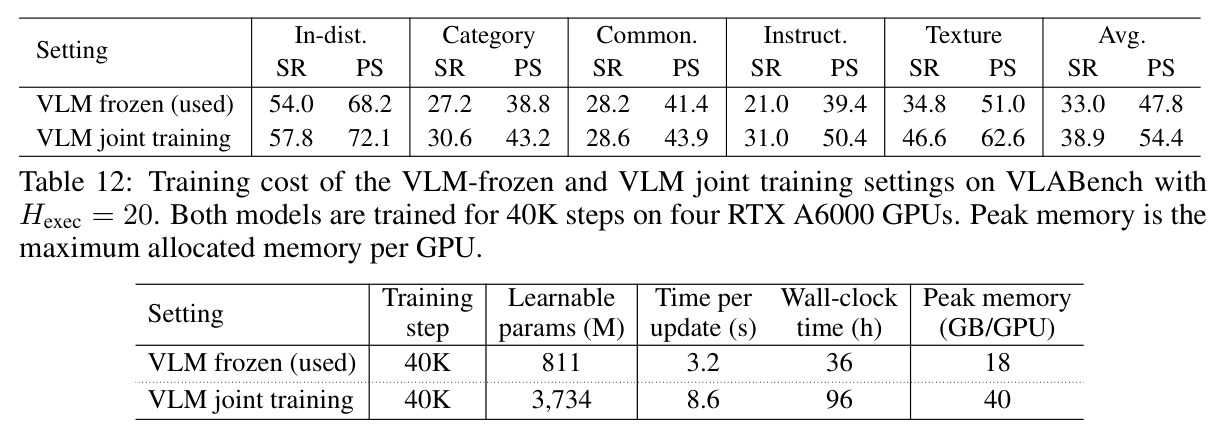
独立分析的弱点及改进方向。(1) 伪标签决定性能上限:整体方法受制于 PELT 检测质量(precision 0.82 / recall 0.70),而 PELT 只看动作统计特性、不理解任务语义。改进:用 VLM 视频理解模型做半监督转移标注,或对低置信度标签降权(不确定性加权 BCE),并把「标签质量—增益」关系做成在线估计。(2) 预测头召回不足:块内多个转移常漏检(多转移定位只取最高峰,召回 50–66%)。改进:改为集合式多峰预测(DETR 风格)或自回归逐转移预测,配合显式峰值抑制解码。(3) 只解决转移误差、不解决开环漂移:$H_{exec}=40$ 时跌破基线。改进:与自适应分块/异步执行显式组合(作者已指出正交性),或引入块内轻量重规划与不确定性感知执行长度。(4) 条件化机制绑定迭代去噪:OpenVLA-OFT 上增益减半。改进:为单遍回归模型设计更强的逐 token 调制(论文的两次前向方案仅部分有效),或引入伪去噪迭代。(5) 评估的统计功效有限:真实机器人单任务 50 次试验、仿真仅 3 次种子(SR 波动 ±0.5,单轨道波动更大)。改进:扩充真实任务谱系并报告置信区间。(6) VLM 冻结限制语义泛化:Tab. 11 显示联合训练可把 $H_{exec}=20$ SR 从 33.0 提到 38.9(Instruct 轨道 21.0→31.0),但成本从 36h/18GB 涨到 96h/40GB。改进:用 LoRA 等参数高效微调折中取益。
未来方向
作者提出的方向:释放完整代码、标签、脚本与训练权重;改进转移时机预测的召回(尤其 held-out 与长块场景);与异步执行正交结合以进一步压低空闲;近人部署前增加安全监控、碰撞检测与人在环路防护。基于其成果可延伸的研究:(1) 把先验从「何时切换」扩展到「切换成什么」——同时预测转移类型(接近/抓取/提起)并做语义条件化,走向子技能级的显式规划;(2) 在线自适应:部署中用触觉/力反馈与任务进度在线修正先验,缓解演示状态与 rollout 状态的分布偏移(论文的预测精度只在演示状态上评估);(3) 分层强化学习:以转移时机为时间抽象,按子技能分段设计奖励,可结合 PolicyTrim 式优化但不需其全量 rollout 成本;(4) 跨本体与跨任务迁移:检验 PELT 标签在双臂、移动操作、韧带接触密集任务上的稳健性;(5) 理论解释:为何早期去噪步对转移最敏感(学到的 $\alpha_k$ 单调递减、Fig. 6 中相似度凹陷从第一步就出现),可从流匹配速度场的结构给出分析,指导更优的注入调度;(6) 与高效推理(视觉 token 剪枝、缓存复用)叠加,叠加后每次调用更便宜、块更长,空闲时间可望进一步趋近于零。
复现评估
复现条件总体友好。开源:作者承诺在 GitHub 发布训练/推理代码、VLABench 微调基线、PELT 标签及计算脚本和训练好的模型权重;附录提供完整超参、数据与评测协议、以及训练/推理伪代码(Alg. 1/2),并有可复现性与 AI 使用声明。数据:全部基于公开基准(VLABench 5000 条、RoboCasa-H50 1250 条、LIBERO 2000 条演示),转移标签完全自动生成(PELT,$\beta=4$,且对 $\beta\in[2,8]$ 不敏感——SR 仅在 32.8–33.1 间波动),无需人工标注。算力:主要结果是在 π0.5 官方 checkpoint 上后训练,4×RTX A6000,VLABench 40K 步约 36 小时(峰值 18 GB/卡)、LIBERO 20K 步 17 小时,远低于对比方法(PolicyTrim 1828 h、ACoT-VLA 277–843 h);真实机器人需 AgileX PiPER 双相机平台与 30 条遥操作演示。难度评估:中等偏低——有 π0.5 微调经验的团队可较顺利复现仿真结果,主要门槛是 3D 仿真环境搭建与真实机器人实验;注意随机种子方差约 ±0.5 SR(Tab. 18),单轨道波动更大,严谨对比需多种子。
论文图表
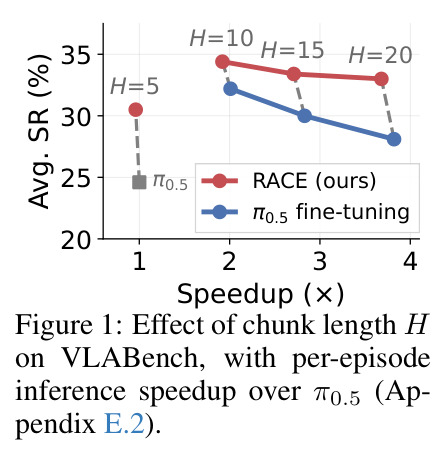
在 VLABench 上以成功率-加速比坐标画出击:微调版 π0.5 把块长从 5 加到 20 时 SR 从 24.6 先升后降,而 RACE 在每个块长都位于其右上方,4 倍块长(H=20)仍高于基线且加速约 3.7×。
这是论文核心论点的一图总览:块扩展的收益上限被 RACE 显著推远,读者第一眼即可看到「更长且更准」的可行性。
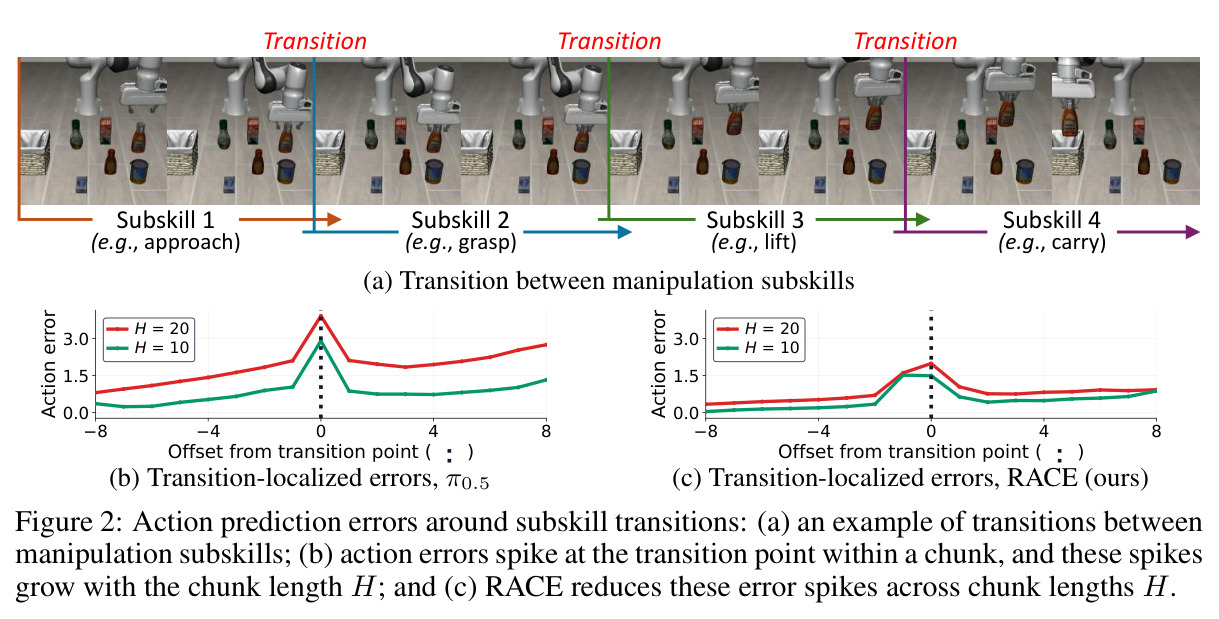
(a) 示意接近→抓取→提起→搬运四个子技能间的转移;(b) 将 π0.5 的动作误差按相对转移点的偏移对齐平均,可见误差在转移点处出现尖峰,且尖峰随块长 H=5/10/15/20 逐级增大;(c) RACE 在所有块长下都显著压低了这些尖峰。
整个论文的动机建立在此观察上:长块失效不是均匀漂移而是转移处误差骤增,这一诊断直接催生了「预测何时切换」的方法设计。
测量相邻动作 token 隐状态在转移点对齐后的余弦相似度:π0.5 的凹陷(表示模型区分相邻两种行为)在早期去噪步很弱、后期才明显;RACE 从第一步去噪起凹陷就清晰得多。
从表征层面解释了 RACE 为什么有效——时机监督让动作专家从一开始就去噪出子技能边界,也与学到的 α_k 早期大的模式一致。