VLA-Rolling:基于自适应动作尾部复用,用更少去噪步数实现更好的机器人控制 VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse
复用被丢弃的动作尾部,自适应分配去噪预算,让VLA更快更准
前置知识
流匹配 (Flow Matching)
一种生成式建模范式:训练速度场网络 $v_\\theta(x, \\tau)$,把高斯噪声(流时刻 $\\tau=0$)沿学到的向量场用欧拉法逐步积分到数据分布($\\tau=1$)。推理时通过 $N$ 步欧拉迭代完成去噪,步数越多越精确但越慢。π0、π0.5、SmolVLA 等机器人策略用流匹配生成连续动作,本文默认 $N_{full}=10$ 步。
本文的核心操作——把动作尾部分配到合适的流时刻 $\\tau$ 继续去噪、以及按置信度做'再噪化'插值——全部建立在流匹配的连续时间公式之上,不懂数值积分就无法理解方法。
VLA 与动作专家
视觉-语言-动作模型把视觉观测 $o_t$、本体状态 $q_t$ 和语言指令 $\\ell$ 输入 VLM 主干生成上下文(KV cache),再交给一个小得多的 Transformer '动作专家',用流匹配迭代去噪出连续动作。例如 π0.5 的 VLM 主干约 3B,而动作专家仅 30M 量级。动作专家的多步去噪占每次推理时延的主要部分。
VLA-Rolling 只加速动作专家的去噪阶段、完全冻结 VLA 主干,复用的正是动作专家已完成的部分去噪计算,必须理解主干与专家的分工才能明白节省从何而来。
动作分块与滚动时域执行
策略一次从单帧观测预测 $H$ 步动作块(本文 $H=50$),但只执行前 $K$ 步($K=10$)就重新观测再规划,以抑制开环执行累积的误差;未执行的后 $L=H-K$ 步称为'动作尾部',传统做法直接丢弃。这种以额外推理换取反馈闭环的范式是当前所有主流 VLA 的标准部署方式。
动作尾部正是本文要'抢救'的对象。理解滚动时域执行为什么丢弃尾部,才能明白论文发现的系统性计算浪费在哪里。
自适应去噪步数(逐样本预算)
不同样本所需去噪步数差异巨大:论文测得 π0.5 逐样本最优步数 $N^*=\\arg\\min_N E_N$ 从 1 到 10 全谱分布(均值 7.07、标准差 2.28)。固定步数要么浪费算力要么欠精化。本文用整块最小置信度线性映射预算:$N_{adapt}=\\mathrm{clip}(\\lceil(1-c_{min})N_{full}\\rceil, N_{min}, N_{full})$。
这是把'省算力'与'保精度'统一起来的关键机制,也是论文诊断实验(Figure 3)的直接推论:既然 $N^*$ 逐样本变化,预算就必须逐样本分配。
分位数归一化与 EMA 在线统计
动作尾与目标动作的误差 $E_t$ 跨多个数量级,直接回归难以学习。论文先取对数 $r_t=\\log E_t$ 压缩大误差、放大细微差异,再用 10%/90% 分位数做线性压缩到 $[0,1]$ 作为置信度标签 $c^*_t$;分位数用指数移动平均($\\eta=0.99$)在训练批间在线更新,避免对整个演示数据集重复统计。
置信度标签的构造决定了估计器学到什么;非对称 L1 损失(高估置信度罚 2 倍)与跨模型、跨环境的误差尺度统一都依赖这一标签设计。
研究动机
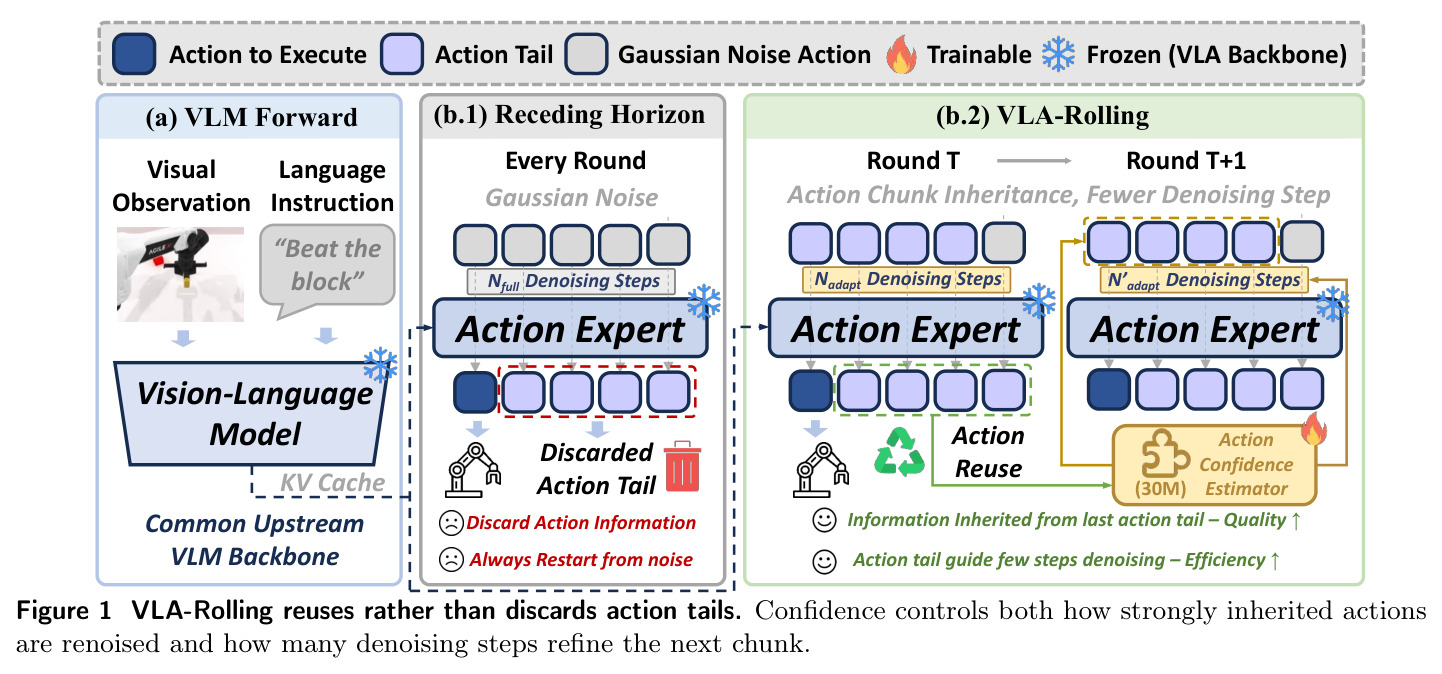
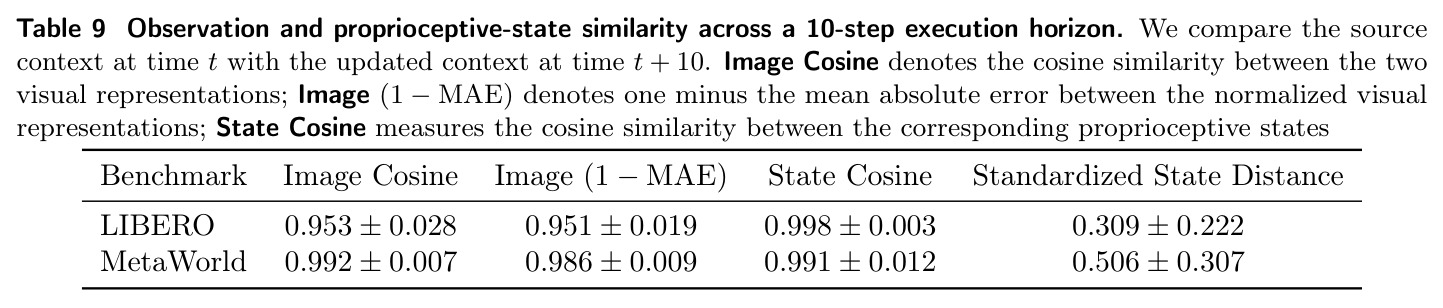
流匹配 VLA(π0.5、SmolVLA 等)一次从高斯噪声迭代去噪出 $H$ 步动作块,但在滚动时域执行下只运行前 $K$ 步(主流配置 $H=50, K=10$),剩余 $L=40$ 步的'动作尾部'连同其已完成的去噪计算被整体丢弃,下一轮规划从全新高斯噪声重新起步。以 π0.5 为例,每个动作块推理实测需 168-223 ms(LIBERO 168.09 ms、MetaWorld 222.69 ms),机器人每 10 个控制步就要为一次'从零去噪'买单,而其中大部分计算产物被扔掉。更关键的是,作者统计发现相邻环境步的变化极小:约 98% 的相邻步观测与本体状态高度相似(LIBERO 图像余弦相似度 0.953、本体状态余弦 0.998;MetaWorld 分别为 0.992 和 0.991,见 Table 9)。也就是说环境在两次规划之间几乎没有变,被丢弃的尾部仍然高度可用——这是一笔每 10 步发生一次、贯穿整个机器人运行过程的系统性浪费。
本文的目标是本文想回答的核心问题是:能否利用被丢弃的动作尾部,在不牺牲动作精度的前提下,用更少的去噪步数生成同等甚至更好的动作?具体拆成三问。其一,尾部是否保留了可迁移的去噪进度——诊断实验显示 π0.5 用尾部初始化只需 4 步去噪即可追平甚至超越 10 步高斯基线(误差比 1.039/1.007),SmolVLA 只需 6 步(1.018/1.006)。其二,每个新观测下应该'信任'尾部多少:逐样本最优步数 $N^*$ 在 1-10 间几乎全谱分布(π0.5 标准差 2.28,SmolVLA 2.88),且尾部去噪并非步数越多越好(π0.5 在 LIBERO 上误差比从 6 步的 1.073 降到 8 步的 1.037),说明固定预算行不通。其三,如何设计一个不改动、不重训冻结 VLA 的轻量推理框架,让单一置信度信号同时决定'保留多少尾部信息'(再噪化强度)与'花多少算力精化'(去噪步数预算),最终实现推理成本与任务成功率的帕累托改进。
与已有工作不同的是,已有两条相关路线各有盲区。动作块复用路线(时序一致性类工作)直接把上一块动作拿来用,但缺乏动作级的质量评估机制——低质量的块也会被无差别继承,导致错误在轨迹上传播;推理加速路线(蒸馏、少步采样、压缩动作解码器)通常要从头训练或牺牲动作精度,论文指出这类方法很少能在现有模型上通用并带来帕累托改进。本文的独特切入是把被丢弃的尾部视为流匹配轨迹上的'合法中间状态'而非废弃输出:既然 98% 的相邻环境步几乎不变,尾部就天然处于离目标不远的去噪中途,剩下的问题只是'逐样本决定还要走几步、退多少噪声'。为此引入一个仅 30M 参数、以演示轨迹内时间相邻动作对的误差为监督的置信度估计器,把质量评估下沉到动作级,并用置信度同时驱动再噪化与步数分配,完全冻结原 VLA——这在'复用但带评估'和'加速但不重训'两个维度上同时填补了空白。
核心方法
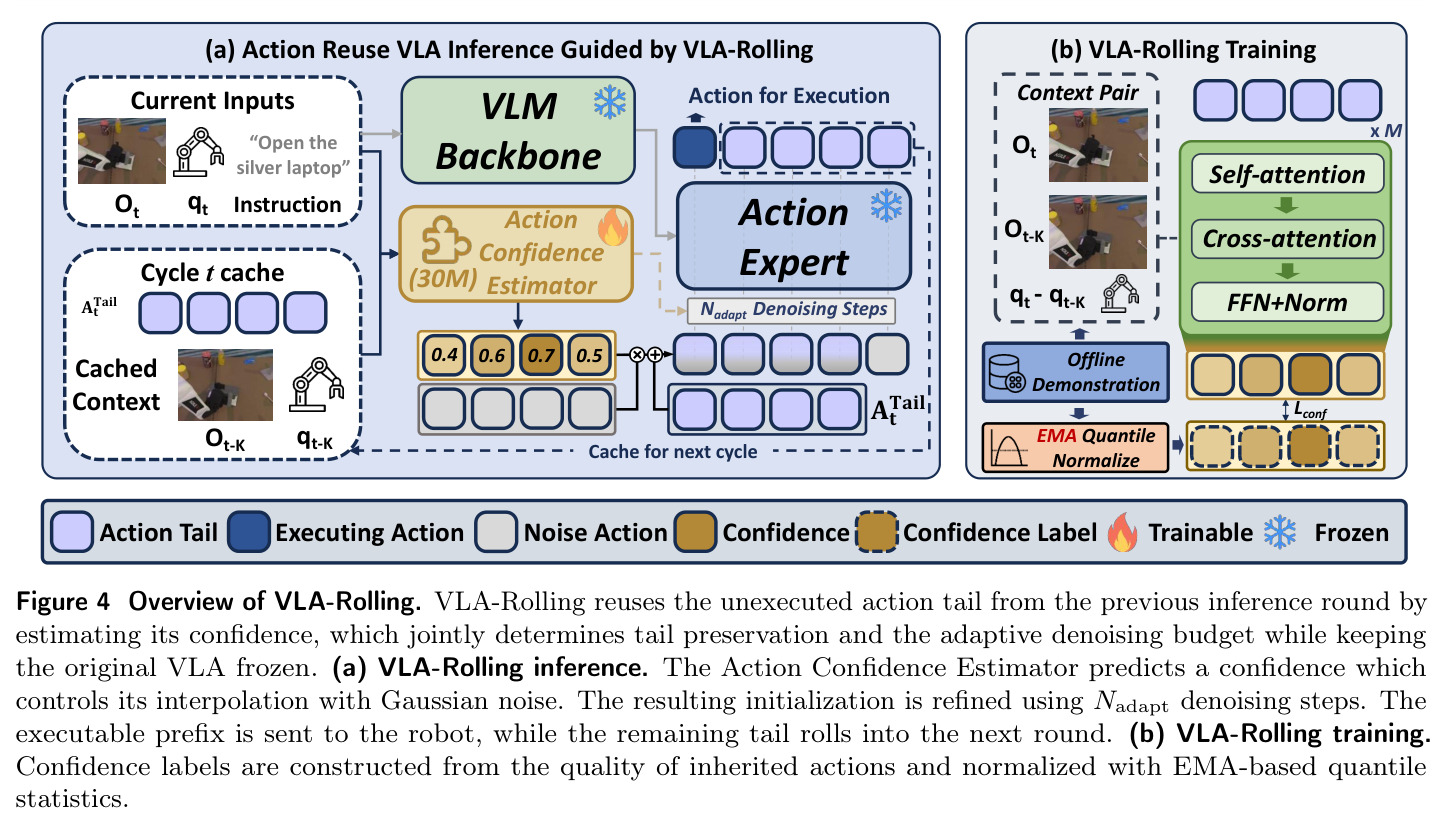
直觉上,上一轮没执行完的动作尾是对当前动作的'半成品草稿':环境变化不大时草稿比白纸(高斯噪声)更接近答案,但草稿也可能过时,需评估后再用。VLA-Rolling 分三阶段滚动进行。阶段一(动作尾继承):把上轮尾部 $A^{t-K}_{K:H}\in\mathbb{R}^{L\times d_a}$($L=H-K=40$)按时间对齐到当前规划窗口,并计算环境变化 $\Delta o_t=o_t-o_{t-K}$、$\Delta q_t=q_t-q_{t-K}$。阶段二(置信度估计):一个 30M 参数的 action-centric Transformer 读入尾部、当前观测/状态及其差分,为每个位置输出置信度 $c\in\mathbb{R}^{L\times 1}$,前向约 1.5 ms。阶段三(置信度引导精化):低置信位置注入更多高斯噪声(再噪化),整块按最小置信度分配自适应去噪步数 $N_{adapt}$,用与原 VLA 相同的欧拉更新沿剩余流轨迹继续积分,执行前 $K$ 步后新尾部滚入下一轮。全程冻结 VLA。
核心创新是'把被丢弃的动作尾当作流匹配去噪轨迹上的合法中间状态'。若尾部的最优剩余精化预算为 $N^*$,就把它的流时刻定在 $\tau_k=1-\frac{N^*-k}{N_{max}}$ 而非 $\tau=0$,再用原 VLA 的速度场 $v_\theta$ 与步长 $\delta=1/N_{max}$ 继续欧拉迭代——时间步嵌入与离散化完全兼容,无需改动模型。第二个创新是单一置信度同时控制两个自由度:再噪化按位置插值 $A_{init,i}=c_i A_{tail,i}+(1-c_i)\epsilon_i$,决定每个位置保留多少旧信息;预算 $N_{adapt}$ 决定整块花多少算力。置信度标签无需人工标注:取同一演示轨迹中相隔 $K$ 步的两时刻,用冻结 VLA 在旧状态生成的尾部与新时刻演示动作对齐,算 $E_t=\|A^{t-K}_{tail}-A^*_t\|_2^2$,经 $\log$ 与 EMA 分位归一化得标签,并以 $w^+{=}2>w^-{=}1$ 的非对称 L1 损失重罚高估。这与'整块无差别复用'或'固定少步采样'有本质区别。
方法步骤详情
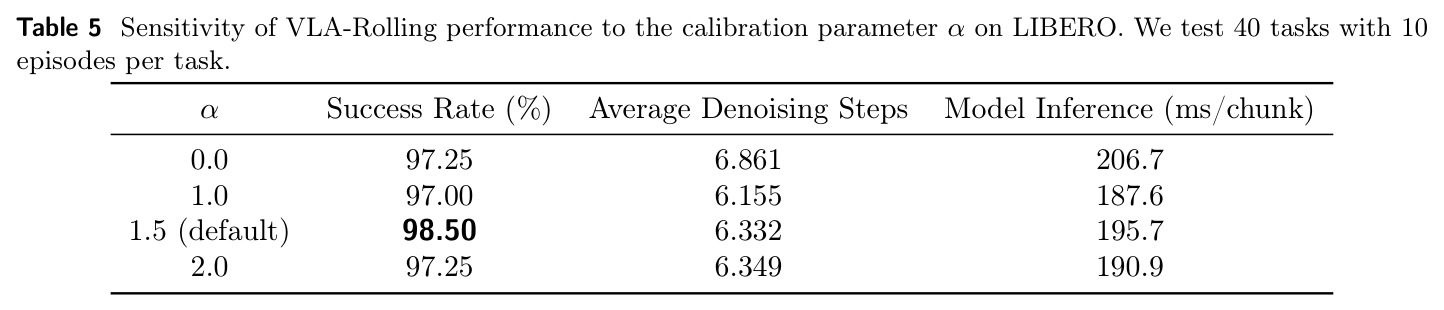
流程分离线训练与在线推理。训练:在同一演示轨迹上取相隔 $K$ 步的 $t-K$ 与 $t$,用冻结 VLA 在旧状态生成动作块并截出尾部,与新时刻演示动作 $A^*_t$ 对齐算误差 $E_t$,取 $r_t=\log E_t$,用 EMA($\eta=0.99$)维护的 $q_{0.1},q_{0.9}$ 分位归一化得标签 $c^*_t$,以 $w^+{=}2,w^-{=}1$ 的加权 L1 损失训练(AdamW,lr $10^{-4}$,batch 64,4000 步,单卡 96GB)。估计器输入长度与 VLA 的 $H$ 对齐(尾部前填充高斯噪声),注意力掩码屏蔽填充,输出截取前 $L$ 个置信度。在线推理每轮四步:(1) 继承尾部并计算环境变化 $\Delta o_t,\Delta q_t$,估计器前向输出逐位置置信度 $c$;(2) 按公式 (9) 逐位置再噪化,低置信位置接近纯噪声;(3) 取 $c_{min}=\min_i c_i$,按 $N_{adapt}=\mathrm{clip}(\lceil(1-c_{min})N_{full}\rceil,N_{min},N_{full})$ 分配预算,把初始化点放到对应流时刻执行 $N_{adapt}$ 步欧拉去噪(校准参数 $\alpha=1.5$);(4) 执行前 $K$ 步,新尾部滚入下一轮。
技术新颖性
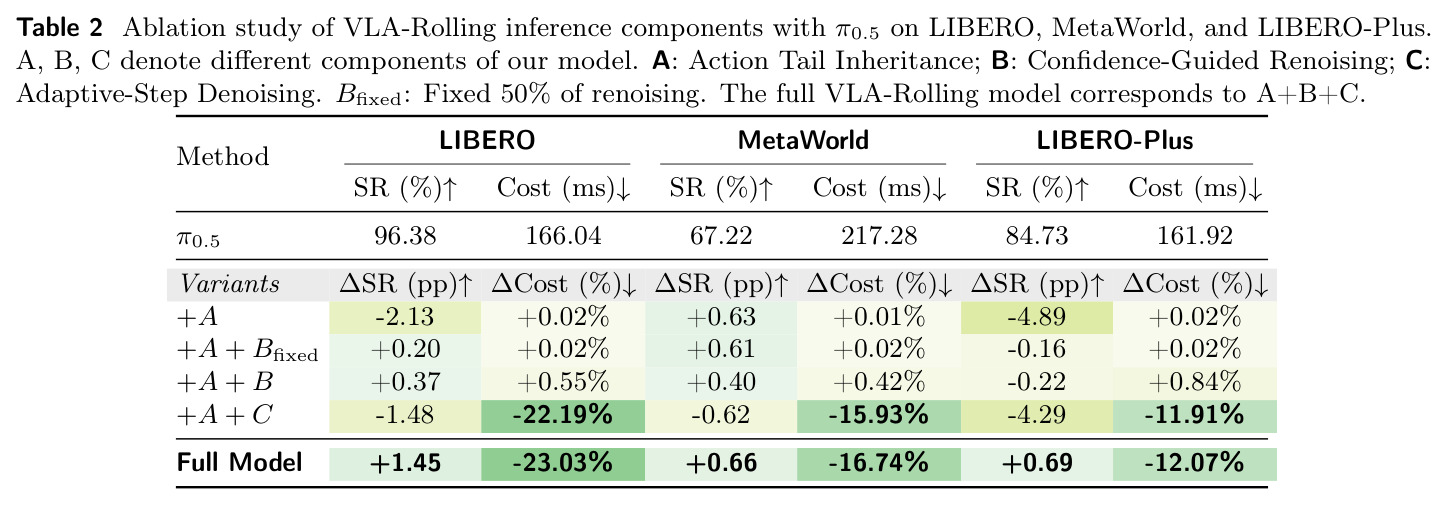
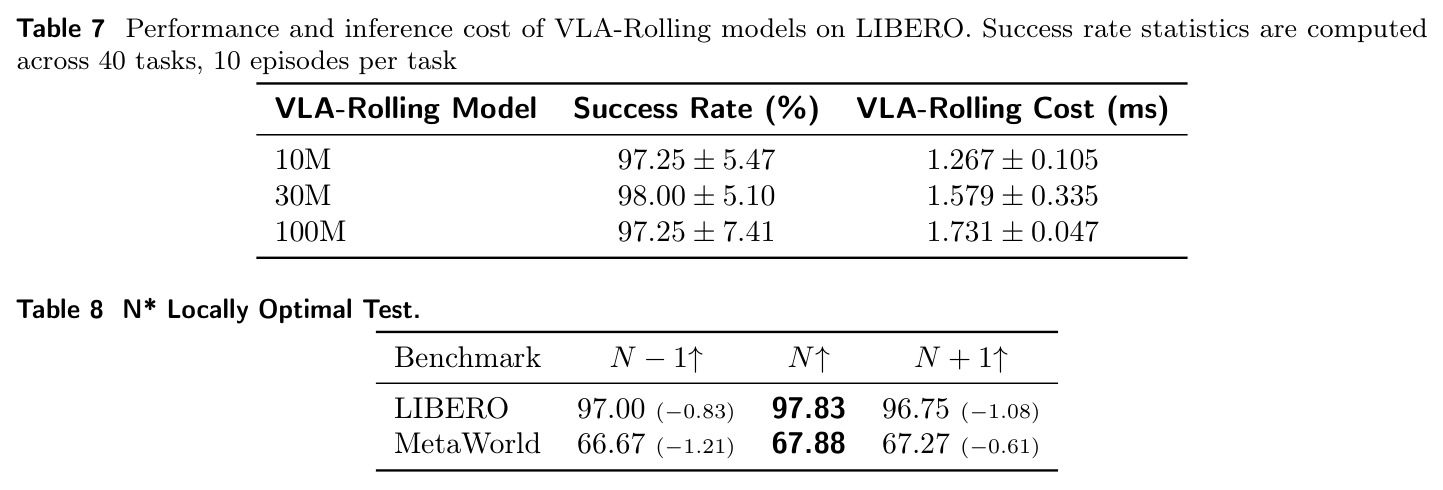
新颖性体现在四个层面。第一,问题定义新:以往工作把滚动时域丢弃的尾部当作计算废料,本文用诊断实验证明它是'已付成本的可回收中间态'(π0.5 用 4 步、SmolVLA 用 6 步追平 10 步高斯基线),属于对 VLA 推理范式的重新审视。第二,机制设计新:把尾部映射到流匹配中间时刻 $\tau$ 而非当作 $\tau=0$ 的起点,时间步嵌入与原模型一致——这是与 naive 复用的根本差异,消融显示只继承尾部会使 LIBERO-Plus 掉 4.89pp、LIBERO 掉 2.13pp。第三,监督构造新:不需要额外标注或在线试错,仅用演示轨迹内时间相邻动作对的对齐误差作监督,配合 EMA 分位归一化($\eta=0.99$)解决跨模型、跨环境的误差尺度漂移;非对称损失(高估罚 2 倍)防止'过度信任'造成不可恢复错误。第四,工程属性新:插件仅 30M(10M 不够好、100M 无增益,30M 成功率 98.00% 且开销仅 1.579 ms),框架与模型解耦,在 4 个 VLA、4 个基准上即插即用,理论上可与蒸馏、量化等其他加速手段叠加。
实验结果
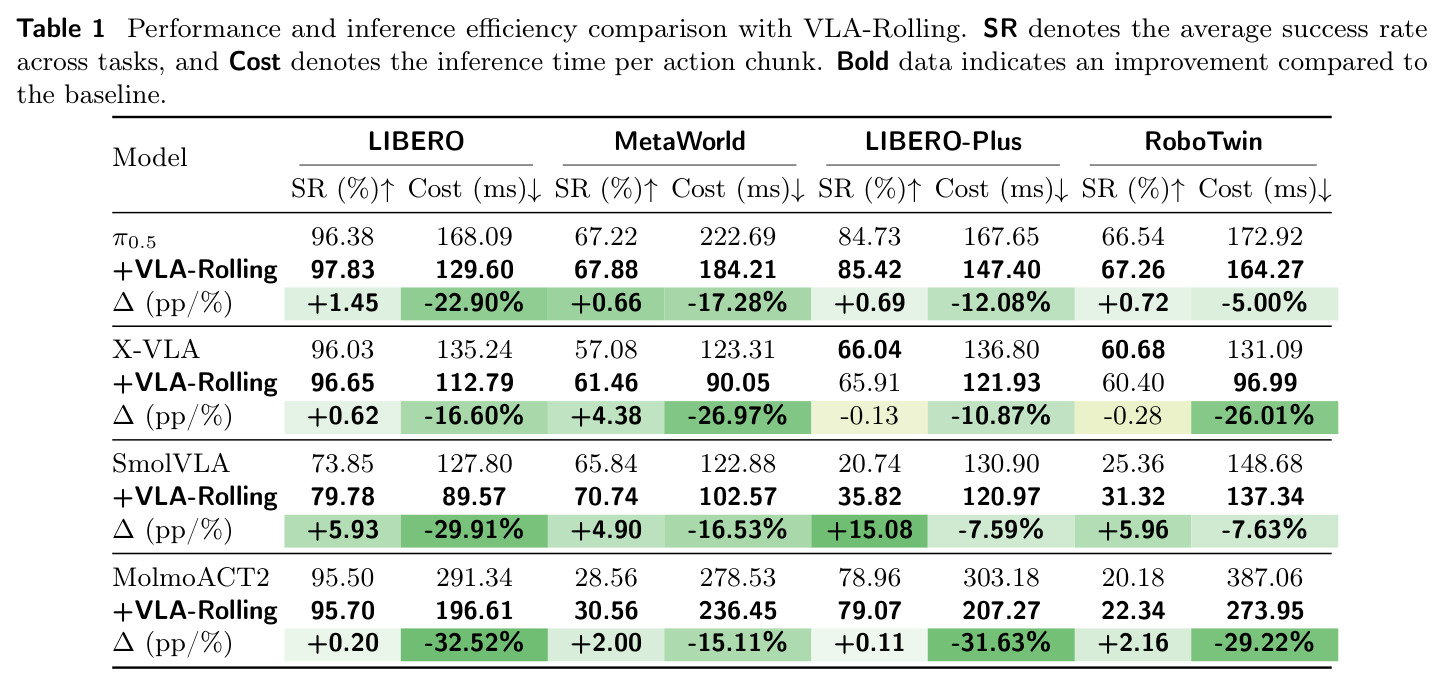
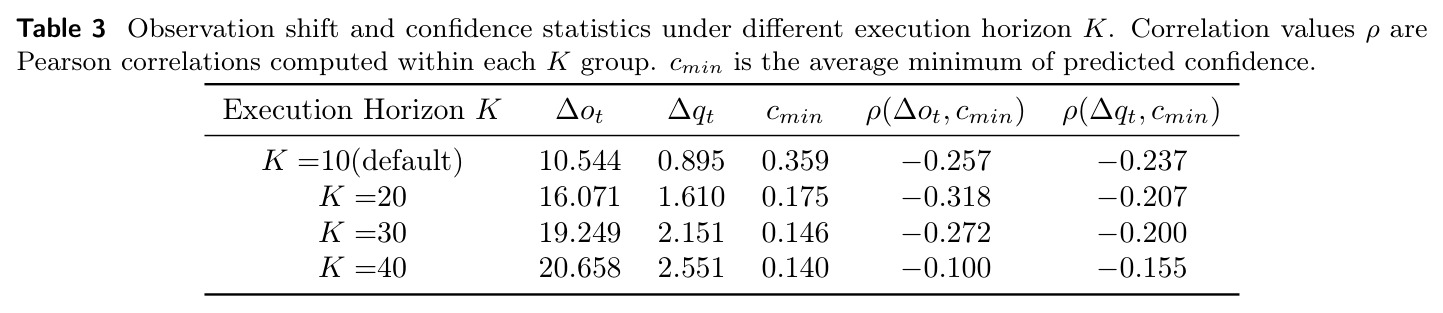
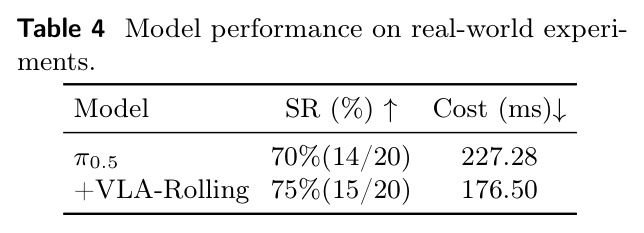
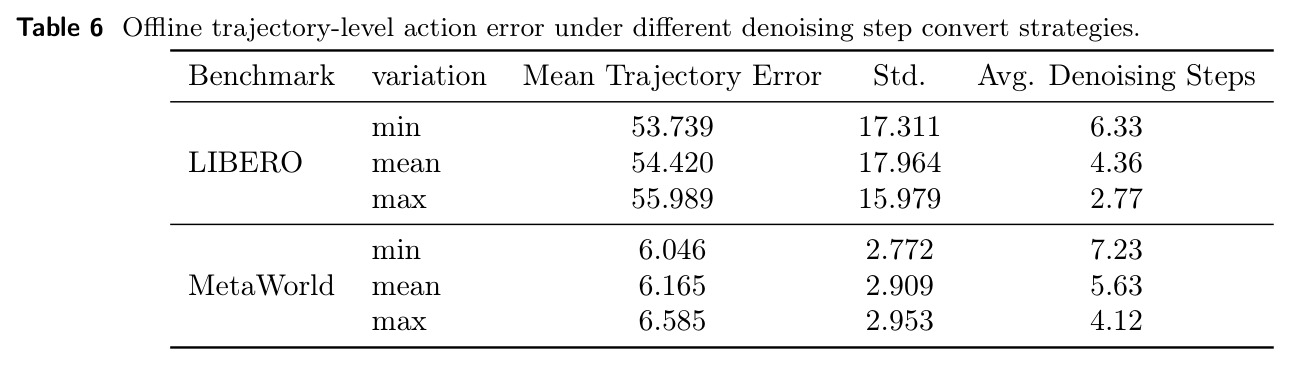
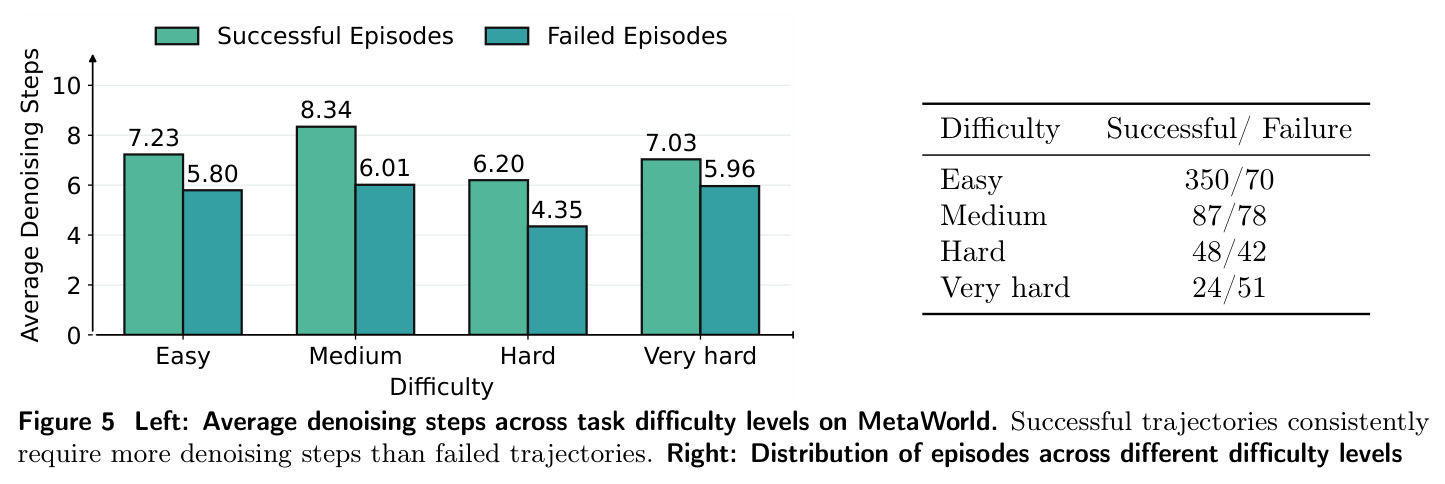
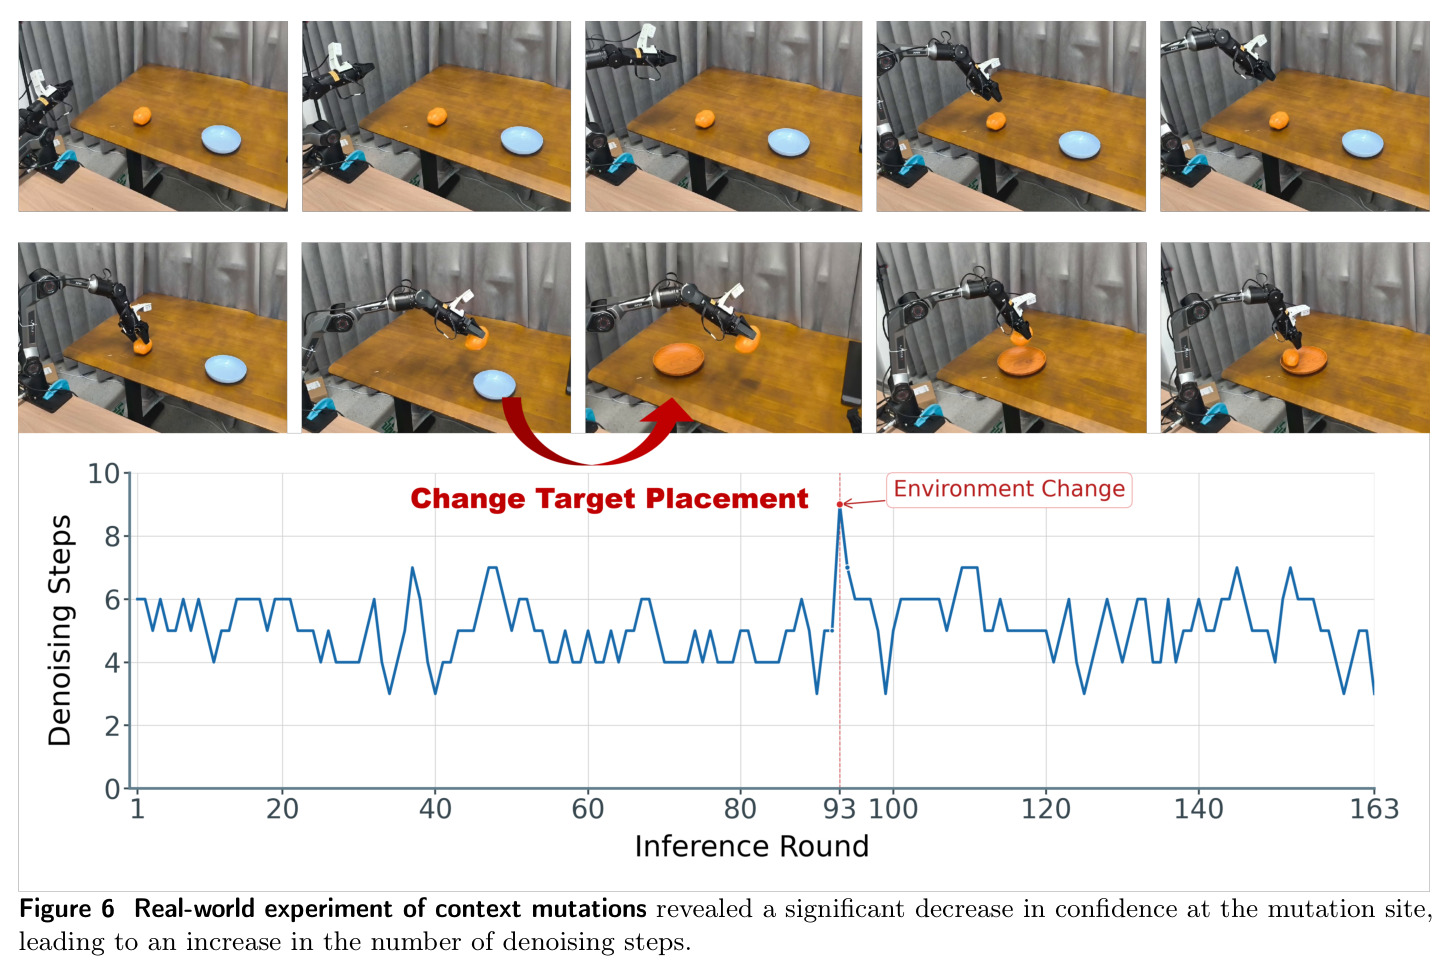
主实验(Table 1):4 个 VLA × 4 个基准共 16 组合上推理成本无一例外下降(-5.00% 到 -32.52%,最高 1.48 倍吞吐),14 组成功率同时提升,最大 +15.08pp(SmolVLA 在 LIBERO-Plus 从 20.74% 升至 35.82%);仅 X-VLA 两组微降 0.13/0.28pp。消融(Table 2):只继承尾部(+A)在 LIBERO 掉 2.13pp、LIBERO-Plus 掉 4.89pp,naive 复用有害;+A+C 省 22.19% 成本但掉 1.48pp;完整模型(A+B+C)才同时 +1.45pp 与 -23.03% 成本。分析实验:环境剧变与置信度负相关($\rho(\Delta o,c_{min})$ 从 K=10 的 -0.257 衰减到 K=40 的 -0.100);MetaWorld 上成功轨迹比失败轨迹多用至多 2.33 步去噪(Very hard 8.34 vs 6.01);$N^*\pm1$ 扰动使成功率降 0.61-1.21pp,说明预算预测局部最优。敏感性消融(Table 5-7):校准 $\alpha=1.5$ 最优(98.50%、6.332 步);最小置信度转换误差最低(LIBERO 53.739 vs mean 54.420);估计器 30M 是甜点(98.00%、1.579 ms)。真机(Table 4):π0.5 换盘突变任务成功率 70%→75%(15/20),延迟 227.28→176.50 ms;Figure 6 显示目标突变处置信度跳变并自动触发更多去噪步。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO(π0.5 主干,40 任务 × 100 回合) | 平均成功率 / 每块推理耗时 | 97.83% / 129.60 ms | 96.38% / 168.09 ms | +1.45 pp,成本 -22.90% |
| MetaWorld(SmolVLA,50 任务 × 100 回合) | 平均成功率 / 每块推理耗时 | 70.74% / 102.57 ms | 65.84% / 122.88 ms | +4.90 pp,成本 -16.53% |
| LIBERO-Plus(SmolVLA,扰动鲁棒性基准) | 平均成功率 / 每块推理耗时 | 35.82% / 120.97 ms | 20.74% / 130.90 ms | +15.08 pp(最大提升),成本 -7.59% |
| LIBERO(MolmoAct2) | 平均成功率 / 每块推理耗时 | 95.70% / 196.61 ms | 95.50% / 291.34 ms | +0.20 pp,成本 -32.52%(最大加速,1.48×) |
| MetaWorld(X-VLA) | 平均成功率 / 每块推理耗时 | 61.46% / 90.05 ms | 57.08% / 123.31 ms | +4.38 pp,成本 -26.97% |
| 真机换盘突变任务(π0.5 + AgileX PiPER 6-DoF) | 成功率(20 次试验)/ 每块推理耗时 | 75%(15/20)/ 176.50 ms | 70%(14/20)/ 227.28 ms | +5 pp,成本 -22.4% |
局限与改进
作者承认的局限:跨环境泛化探索有限,真机只有一个换盘突变任务、每种设置仅 20 次试验。我的观察:其一,置信度与环境变化的皮尔逊相关仅 -0.20 到 -0.32,K 增大到 40 时 $\rho(\Delta o,c_{min})$ 衰减到 -0.100,估计器对'该信任多少'的解释力有限且外推不足,更多是经验性校准;其二,LIBERO-Plus 每任务只跑 1 回合,SmolVLA +15.08pp 的亮眼数字可能受采样方差影响;其三,X-VLA 两组成功率微降(-0.13/-0.28pp),说明框架并非无条件帕累托——X-VLA 动作块更短($H=30,L=20$)时收益打折;其四,成本统计只含模型推理(KV cache + 去噪 + 估计器),不含感知与控制循环延迟,真机异步执行下执行时域 $K$ 随自适应步数波动(论文以上下界差不超过 100ms 论证可忽略),实际部署需要额外时序工程;其五,预算由整块最小置信度统一决定(Table 6 中 min 平均 6.33 步 vs mean 4.36 步),位置级差异只体现在再噪化上。
独立分析的弱点
弱点一:估计器条件信息较浅——视觉 token 只做均值池化,再与差分表示 LayerNorm 后拼接投影成 576 维上下文,丢失空间细节,这可能是其与真实环境变化相关性偏低($|\rho|\approx0.2\text{--}0.3$)的原因;改进方向是改用跨注意力或可学习空间池化,甚至接轻量世界模型预测'若执行尾部会到达什么状态'来直接构造复用价值信号。弱点二:估计器与具体 VLA 和 horizon 绑定,每个新模型都要重新采数据训练 4000 步、重建分位统计;可在多模型尾部分布上联合训练通用估计器或引入元学习适配。弱点三:$c_{min}$ 取整块最小值过于保守,Table 6 显示它误差最小但平均步数最多(LIBERO 6.33 步 vs mean 4.36 步),预算可下放到位置级或滑动窗口级。弱点四:训练目标是对齐演示动作的误差,而演示动作未必最优,置信度实际学的是'与演示一致'而非'与最优一致',在演示质量参差时可能系统性偏差。弱点五:每轮只复用上一轮尾部,多轮滚动后早期信息是否被反复再噪化稀释、长程任务是否存在'误差记忆',论文未分析,值得对照实验量化。
未来方向
作者提出的方向:把真机评估扩展到更复杂的任务设定与更多本体、交互场景,厘清除环境突变外还有哪些因素驱动置信度预测;将该推理范式与其他推理加速机制(蒸馏、量化、缓存复用等)结合,因为本方法不修改原模型、天然可组合,有望叠加出更大的加速比。基于成果可自然延伸的:一是把'尾部即流轨迹中间状态'的思想推广到流匹配/扩散策略的其他应用,如图像编辑的局部重绘、分子结构的局部修改——任何'滚动时域生成'场景都存在同样的被丢弃中间态;二是让执行时域 $K$ 本身自适应:既然置信度能感知环境变化幅度,$K$ 与去噪预算 $N_{adapt}$ 可以联合优化,环境稳定时多执行几步、突变时更频繁重规划;三是把置信度信号回传给数据采集端,构造面向困难状态的加权数据飞轮;四是在双臂协调(RoboTwin 已涉及)与多智能体场景验证逐位置再噪化对协调动作的价值;五是理论化工作:刻画尾部复用收益上界与环境漂移量、起始流时刻误差的解析关系,回答'何时该彻底弃用尾部'这一边界问题。
复现评估
复现条件中等偏友好。论文细节充分:估计器架构(30M action-centric Transformer、视觉 token 均值池化 + 差分表示拼接投影到 576 维、注意力掩码屏蔽高斯填充、sigmoid 输出)、全部训练超参($w^+{=}2,w^-{=}1$、EMA $\eta=0.99$、AdamW lr $10^{-4}$、batch 64、4000 步、校准 $\alpha=1.5$)、horizon 配置与真机协议(Lerobot pi05-base + AgileX PiPER,蓝/棕盘各采 20 条轨迹微调)都写在正文与附录。依赖的 4 个 VLA 与 4 个基准均为公开资源。算力门槛:训练估计器只需单张 96GB GPU,仿真评测用 4×RTX 4090。风险点:正文只给出项目主页未明确代码仓库链接,估计器实现与 EMA 分位统计需自行复刻;$N^*$ 诊断实验需大量 rollout 采样与动作对齐标注;真机需自备机械臂与遥操作数据。总体而言,仿真侧复现难度中等,真机侧门槛较高。
论文图表
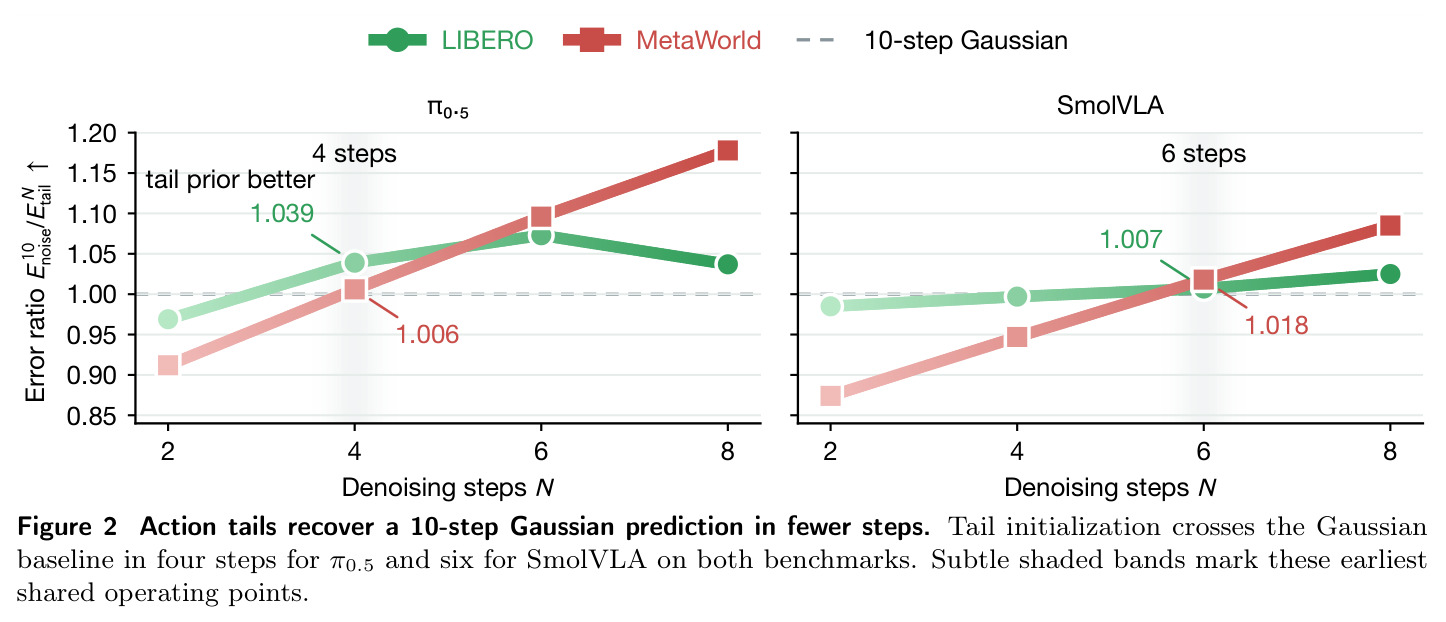
在 LIBERO 与 MetaWorld 上,用继承的尾部初始化分别做 2/4/6/8 步去噪,画出相对 10 步高斯基线的误差比曲线:π0.5 在 4 步时误差比为 1.039(LIBERO)/1.007(MetaWorld),SmolVLA 在 6 步时为 1.018/1.006,均追平或优于基线;同时显示 π0.5 在 LIBERO 上误差比从 6 步的 1.073 降至 8 步的 1.037,说明尾部并非步数越多越好。
这是全文可行性的核心证据,直接支撑'尾部保留了可迁移去噪进度'这一命题,也是后续所有设计的实验前提。
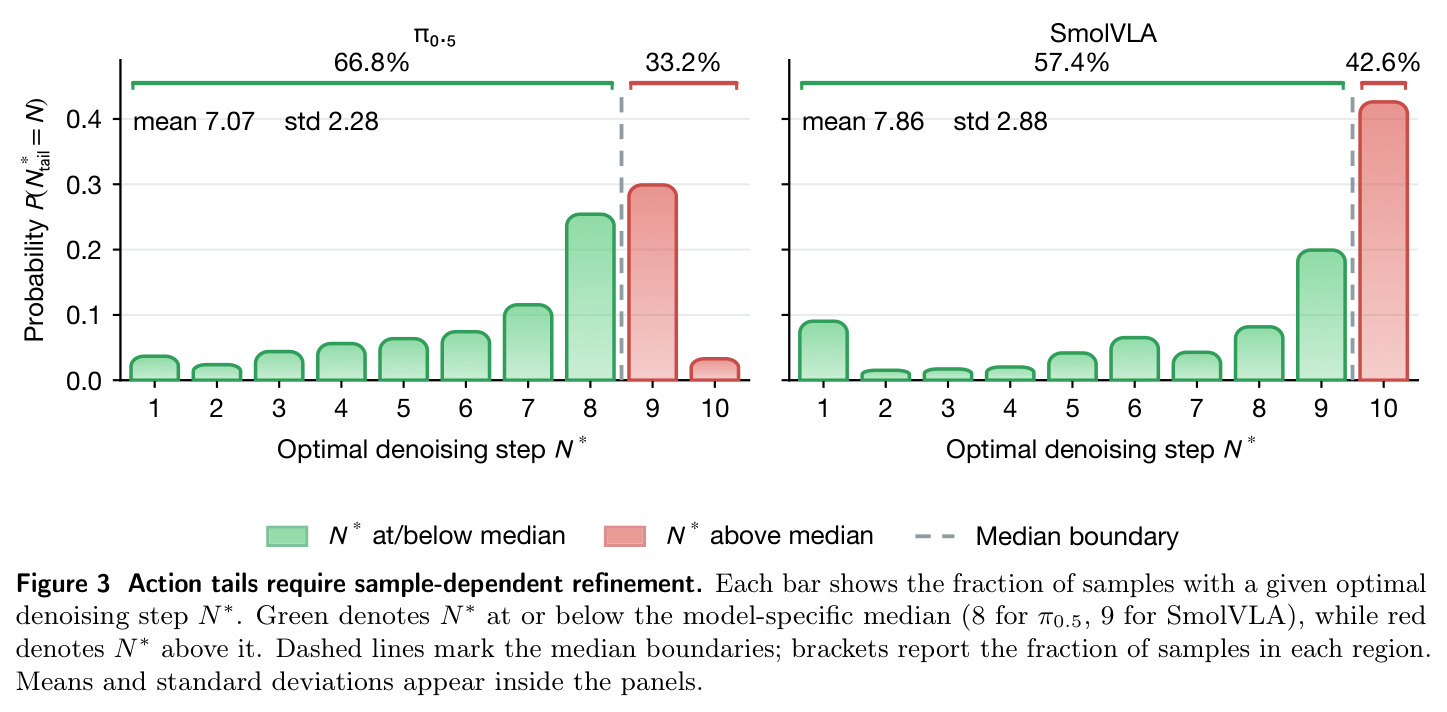
逐样本最优去噪步数 $N^*=\\arg\\min_N E_N$ 的分布直方图:π0.5 均值 7.07、标准差 2.28,中位数 8,仍有 33.2% 的样本最优步数大于中位数;SmolVLA 均值 7.86、标准差 2.88,中位数 9,42.6% 的样本超过中位数。$N^*$ 覆盖从 1 到 10 的全部取值。
证明固定去噪预算不可行、逐样本自适应是必需的,是从诊断发现(Figure 2)通向方法设计(置信度引导预算分配)的关键一环。
把预测去噪预算人为加/减 1 步:LIBERO 上 $N-1$ 与 $N+1$ 分别使成功率降 0.83 与 1.08 个百分点;MetaWorld 上分别降 1.21 与 0.61 个百分点。
双向扰动都变差说明预测的预算确实落在逐样本最优点附近,而非任意的步数削减,是对预算预测有效性的精细验证。