DISC:面向时间序列数据集的领域集成相似度代价 DISC: Domain-Integrated Similarity Cost for Time-Series Dataset
可学习的双混合门控框架,融合多种相似度指标以预测时序迁移误差
前置知识
Wasserstein距离与最优传输(OT)
最优传输衡量把一个经验分布搬运成另一个分布所需的最小代价,Wasserstein距离是其特例:把每个数据集近似为点云或高斯分布后,求解传输计划的成本作为两个数据集的分布差异。本文中OT是所有实验的参考基线(四任务相关性分别为-0.007、0.125、0.213、0.080),WSD则是候选指标之一。
Table II/III里所有括号中的增益都是相对OT计算的,不理解OT就无法解读实验表格的参照系。
最大均值差异(MMD)
MMD通过核函数把两个经验分布映射到再生核希尔伯特空间的均值嵌入,再取嵌入间距离,是两样本检验的常用统计量。它对分布形状敏感、对幅值量纲也敏感。本文中它恰好能把WSD、MAD、DBA+LCSS都误判为相近的covid_deaths、m1_quarterly、tourism_quarterly三对数据判为远。
Fig.1(d)的判别能力来自MMD,且TL-Lag-Llama学到的base权重中MMD占0.833,是理解实验细节的关键指标。
序列级距离与降维器(DTW/LCSS/ED + DBA/PCA)
DTW用动态规划对齐两条不等长序列的时间轴,LCSS容忍未匹配区域寻找最长公共子序列,ED直接比较对齐后的形状。数据集级比较需先用降维器把每个数据集压成一条代表序列:DBA求DTW重心序列,PCA取主成分投影,再套用序列距离,形成DBA-DTW、PCA-LCSS等6种组合配置。
DISC的10个候选指标里有6个是reducer加距离的组合,实验结论的粒度完全建立在这套命名体系上。
Match-and-Deform(MAD)
MAD是专为时间序列域适应设计的相似度方法,把样本匹配(哪个源样本对应哪个目标样本)与时间变形(序列内部对齐)统一到一个优化目标里。在Fig.1(b)中它比WSD更精细,能识别出electricity系列内部更紧的核心,也是OOD-Time-MoE任务上最强的单指标(相关性0.580)。
它是Table IV中多个任务的最佳单指标基线,也是学到的base权重里反复出现的组件。
Pearson相关与相关性对齐评估
Pearson相关衡量两组数值的线性单调关系,取值[-1,1]。本文的评估协议是:固定一个源数据集X,计算其到13个测试目标的相似度分数与对应下游误差的相关,再对14个测试源行取平均得到源级相关,另设全部有向对的全局相关。分数不需要预测误差绝对值,只需与误差同向单调。
它是全文唯一的评估指标:训练目标、验证选型、测试报告用的都是它,不懂这套协议就无法理解任何一张表。
OOD与迁移学习两种微调协议
OOD协议:模型先在源数据集上微调,然后直接在目标数据集上评估,不做任何目标侧适配;TL协议:先在源上微调,再在目标数据上继续适配后才评估。46个数据集下每个基础模型产生46×45=2070个有向源-目标对,Time-MoE与Lag-Llama两个基础模型乘两种协议共构成四个下游任务。
迁移是有方向的(X到Y的误差不等于Y到X),这决定了误差矩阵按有序对构造,也解释了DISC为何用有序对定义分数。
研究动机
随着时间序列数据集与基础模型爆发式增长,数据集比较成为时序工作流的核心环节:迁移评估、基准筛选、检索增强预测都依赖数据集相似度判断,而穷举源-目标评估代价高昂——46个数据集、单个基础模型就需要微调46个源模型并评估2070个有向对。现有指标众多(WSD、MMD、OT、MAD、DTW、LCSS等),但各自刻画数据集关系的不同侧面,且与下游效用对齐不稳定。Fig.1中:WSD和MAD识别电力类数据集相近,但只有DBA+LCSS发现m4_daily与m4_hourly形状相似;covid_deaths、m1_quarterly、tourism_quarterly这组语义错配数据被WSD、MAD、DBA+LCSS误判为近,只有MMD判为远。定量上,OT在四个任务的相关性为-0.007、0.125、0.213、0.080,平均仅0.103;最佳单指标随任务漂移:MAD 0.580(OOD-Time-MoE)、DBA-DTW 0.618(OOD-Lag-Llama)、PCA-ED 0.537(TL-Time-MoE)、MMD 0.435(TL-Lag-Llama),没有单一指标能跨任务占优。
本文的目标是本文的目标是构建一个可学习、可校准的相似度聚合框架DISC(Domain-Integrated Similarity Cost),把『选哪个指标、各占多少权重、如何组合』从人工决策变成从数据中学习的决策。具体而言:利用少量校准数据集上已观测到的迁移结果(真实下游误差)作为监督信号,为每个下游任务学习一组聚合参数,使产出的相似度分数与该任务下的下游预测误差单调正相关;校准完成后,对任意新的源-目标对只需计算现成的相似度指标值即可打分,无需再做任何微调评估。量化目标是在OOD与TL两种协议、Time-MoE与Lag-Llama两个基础模型构成的四个任务上,让DISC的平均测试相关性超过所有单一指标,甚至超过每个任务单独挑出的最佳单指标(oracle,平均0.543),并同时优于同一聚合家族内约790万配置的非学习人工网格搜索。
与已有工作不同的是,已有工作的切入方式要么是提出新的单一相似度度量(如用Wasserstein距离度量时序数据集相似度、用最优传输做Match-and-Deform),要么把某个现成指标直接用于源数据集选择或可迁移性估计,很少有工作把『多指标的选择与加权』本身形式化为一个任务依赖的可学习问题。本文的独特之处在于重新定义了问题:把时间序列数据集相似度视为『相似度分数与下游任务误差之间的相关性对齐问题』,从而相似度不再是一个固定的数学性质,而是随下游模型与协议变化的属性。技术路线上,作者刻意避开黑盒回归(不预测误差绝对值,只要求分数与误差单调一致),采用仅有约23个参数的可解释参数化:标准化幅值混合作为主分数、源内百分位秩混合作为先验、sigmoid门控做乘性调制,并用熵正则与重叠正则强制两条混合通路分工互补。这一设计使学到的权重可以直接被人类解读(Table V),同时保证了从校准集到测试集的泛化。
核心方法
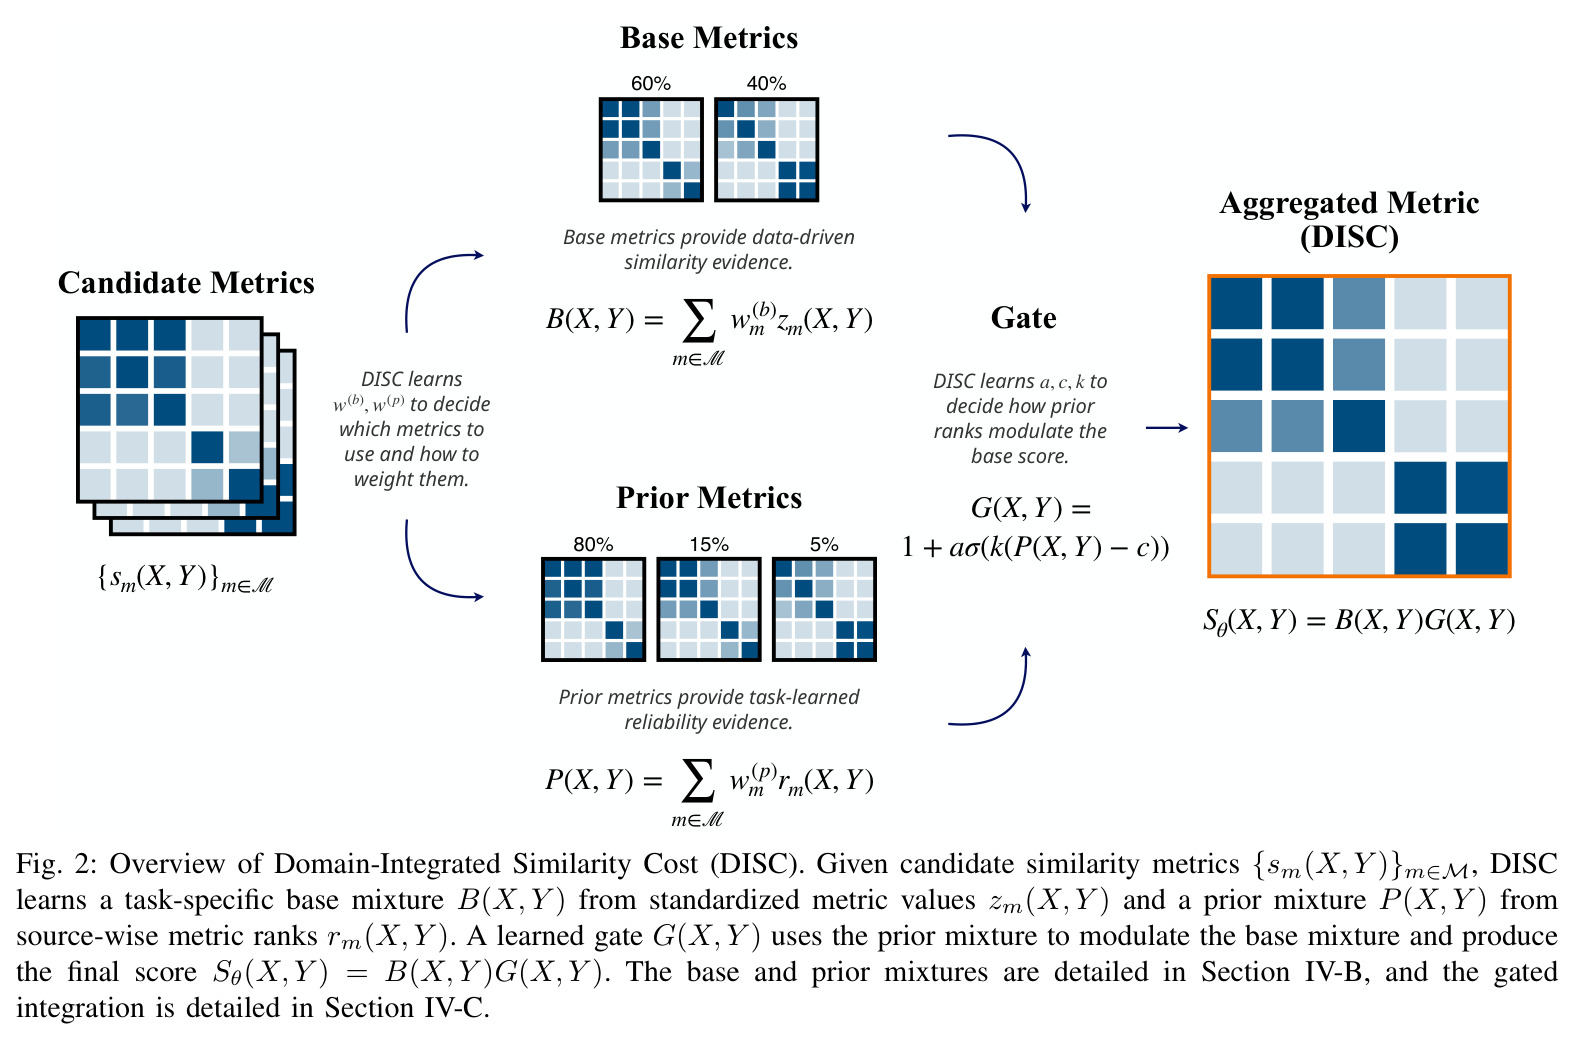
直觉上:没有单一指标在所有任务上都可靠,而每个指标又各捕捉数据集关系的一个侧面,因此不应挑『最好』的指标,而应让少量昂贵的迁移校准实验告诉我们,对当前任务该信哪些指标、信多少、何时用秩信息放大或抑制主分数。技术路线分三层。第一,特征层:对候选指标集合 $\mathcal{M}$ 中每个指标 $m$ 计算原始距离 $s_m(X,Y)$,并在每个源行内标准化得 $z_m(X,Y)$;同时计算源内百分位秩 $r_m(X,Y)\in[0,1]$,值越大目标相对越远。第二,混合层:base混合 $B(X,Y)=\sum_{m} w_m^{(b)} z_m(X,Y)$,其中 $w^{(b)}=\mathrm{softmax}(\alpha/\tau)$,$\tau=0.55$;prior混合 $P(X,Y)=\sum_{m} w_m^{(p)} r_m(X,Y)$,权重独立学习。第三,门控层:$G(X,Y)=1+a\,\sigma(k(P(X,Y)-c))$,$a$ 为调制强度(上限3.0)、$c\in[0,1]$ 为阈值、$k\in[1,55]$ 为锐度。最终分数 $S_\theta(X,Y)=B(X,Y)G(X,Y)$。
核心创新是把相似度指标集合当作候选信号池,端到端学习『指标选择+权重+门控行为』,与已有方法的本质区别有三点。第一,双特征分工:base通路使用标准化后的指标幅值 $z_m$ 保留归一化数值信息,prior通路使用源内百分位秩 $r_m$ 保留相对位置信息——秩对量纲和绝对尺度不敏感,在跨域异构仓库里尤其稳健,因为分布型指标如OT、MMD在高幅值数据集上会产生巨大绝对值,此时秩信号仍能正确排序。第二,乘性门控而非加性组合:先验不是往主分数上加一项,而是通过 $G=1+a\sigma(k(P-c))$ 调制base,三个门参数有明确语义——$a$ 控制调制强度、$c$ 控制秩在什么水平触发切换、$k$ 控制过渡陡峭程度,不同任务可以学到弱而宽的调制或强而锐的截断。第三,训练目标对齐而非回归:目标 $J(\theta)=(1-\lambda)\rho_{src}+\lambda\rho_{global}$($\lambda=0.10$)只需分数与误差同向单调,不需要预测误差值,这与评估协议完全一致,避免了直接回归误差这一困难得多的任务。
方法步骤详情
流程分六步。第一步,从GluonTS取46个数据集,每个采样N=100个长度L=16的窗口,采用24/8/14共享划分。第二步,计算10个候选配置的46×46距离矩阵:数据集级WSD、MMD、OT、MAD,及DBA/PCA配DTW、ED、LCSS的6个reducer组合。第三步,对每源行每指标行内标准化得 $z_m$、计算源内百分位秩 $r_m$。第四步,OOD协议下两个基础模型各在46个源上微调、2070个有向对上评估,TL协议额外做目标适配,得误差矩阵 $E(X,Y)$。第五步,每任务独立优化:Adam学习率0.03、500 epoch、patience 100、8次重启,logits近零初始化、gate初始平滑,最小化 $\mathcal{L}=-J(\theta)+\eta H(w^{(b)},w^{(p)})+\mu\langle w^{(b)},w^{(p)}\rangle$,熵正则 $\eta=0.006$ 鼓励稀疏、重叠正则 $\mu=0.02$ 防止base与prior重合,按验证源内相关选checkpoint。第六步:冻结 $\theta$ 后,对任意有序对只需 $z_m$ 与 $r_m$ 即可输出分数,无需下游误差。
技术新颖性
技术新颖性可从四个角度看。其一是问题形式化:将数据集相似度明确表述为『分数-误差相关性对齐』问题,论证相似度是任务依赖属性而非固定度量选择——Table II和III显示10个候选指标在4个任务上的强弱排名几乎完全洗牌。其二是轻量可解释的参数化:整个模型只有 $|\mathcal{M}|\times2+3\approx23$ 个参数,远小于任何神经网络聚合器,学到的softmax权重可直接读出任务依赖结构,例如TL-Lag-Llama的base是MMD(.833)+DBA-ED(.159)、prior是DBA-DTW(.362)+MAD(.324)+PCA-ED(.312),而MMD在OOD-Lag-Llama的base中完全不出现,说明学到的是任务特异而非指标特异的结构。其三是秩与幅值互补及双重稀疏正则(熵 $\eta=0.006$、重叠 $\mu=0.02$),迫使base与prior自动分工。其四是与非学习搜索的对照实验:同一聚合家族内约790万配置的穷举平均测试相关仅0.291,DISC达0.598,说明连续可微优化对离散网格搜索的优势不是调参技巧而是范式差异。
实验结果
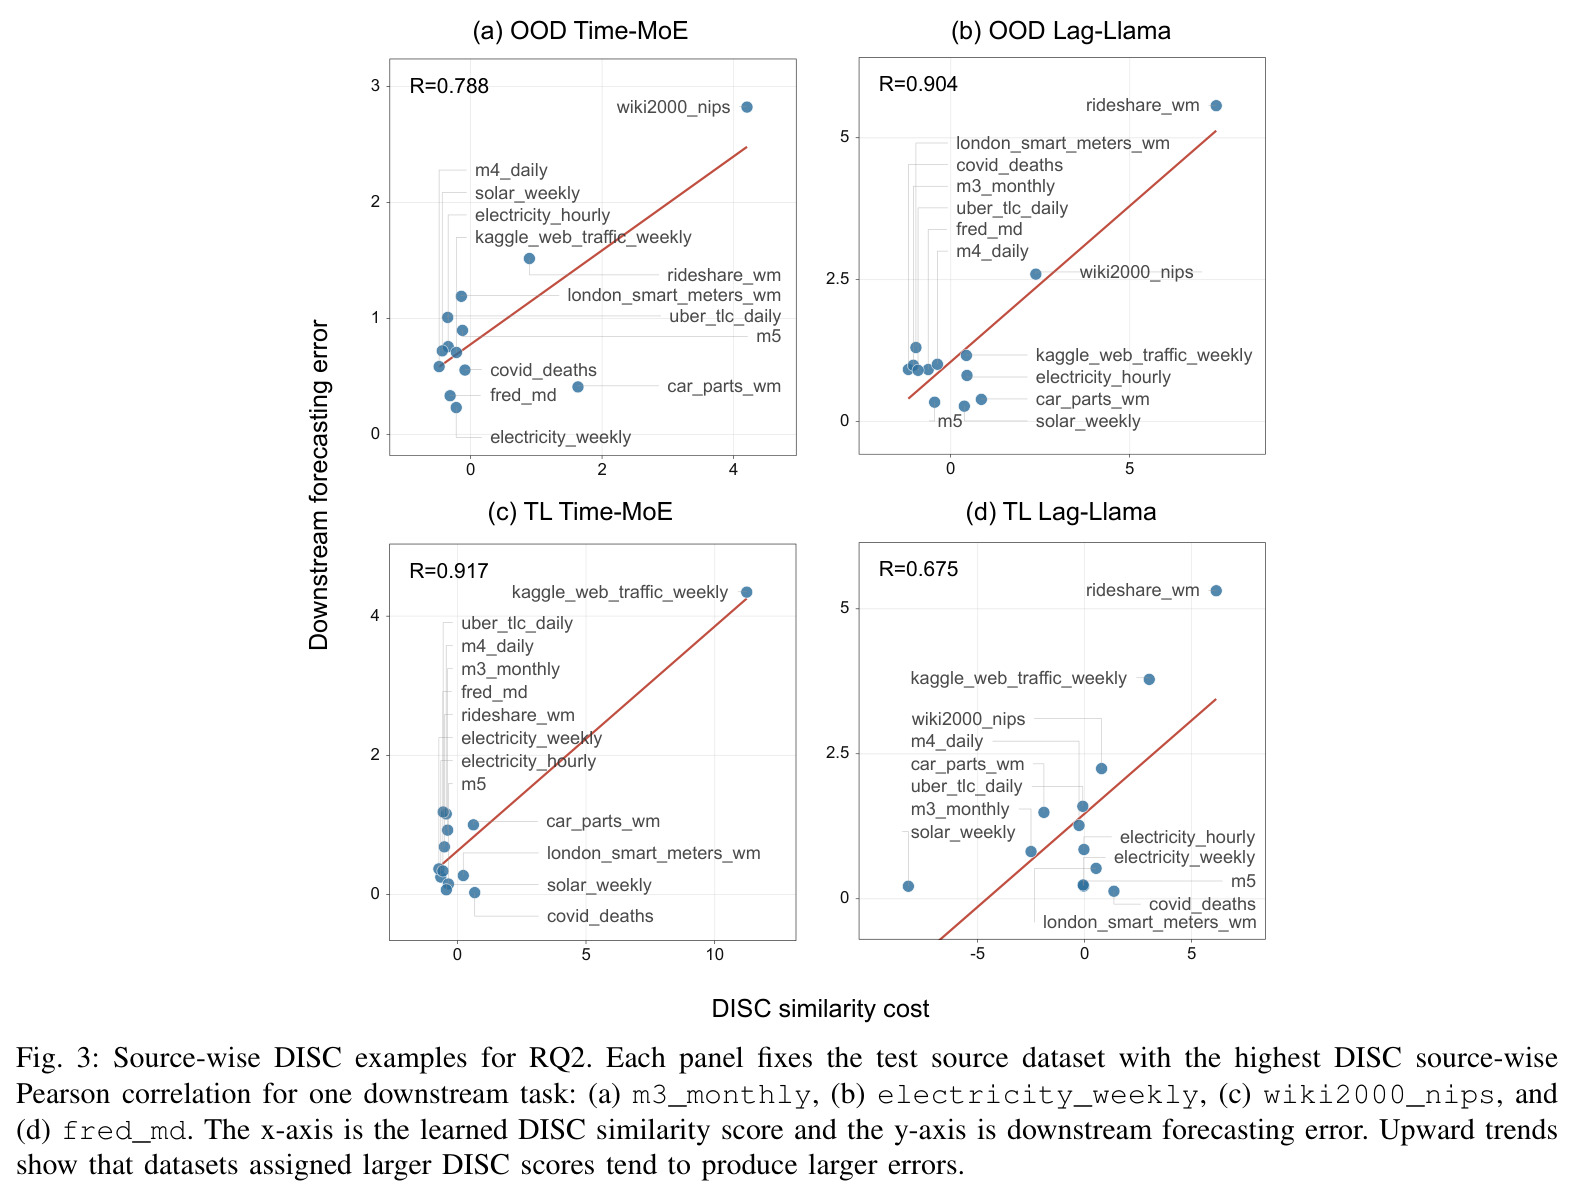
RQ1:以OT为参考(四任务相关-0.007/0.125/0.213/0.080,平均0.103),最佳单指标随任务漂移:MAD 0.580(OOD-TM)、DBA-DTW 0.618(OOD-LL)、PCA-ED 0.537(TL-TM)、MMD 0.435(TL-LL);固定单选平均最高仅PCA-ED的0.403,每任务oracle为0.543。RQ2:DISC四任务达0.601/0.697/0.617/0.479(平均0.598),超每任务最佳单指标平均10.29%:TL-TM +14.75%、OOD-LL +12.84%、TL-LL +10.15%、OOD-TM +3.55%。Fig.3源级散点强正相关:四任务最强源m3_monthly/electricity_weekly/wiki2000_nips/fred_md的R为0.788/0.904/0.917/0.675,DISC分大的目标误差更大。RQ3:同家族约790万配置的手动稀疏搜索平均测试相关仅0.291(OOD-TM为-0.066),DISC 0.598,平均相对提升105.38%,逐任务都胜出(+21.98%/+95.13%/+39.32%)。Table VII诊断:低相关组lag-1自相关0.841、零值比例0.191、多样性3.935,高相关组0.556/0.061/5.115——平滑平坦、低多样性的窗口削弱指标解释力。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OOD Time-MoE(源上微调,目标零适配评估) | 源级Pearson相关(14个测试源行平均) | DISC 0.601 | 最佳单指标 MAD 0.580(OT参考 -0.007) | +3.55% |
| OOD Lag-Llama | 源级Pearson相关 | DISC 0.697 | 最佳单指标 DBA-DTW 0.618(OT参考 0.125) | +12.84% |
| TL Time-MoE(源微调后目标适配再评估) | 源级Pearson相关 | DISC 0.617 | 最佳单指标 PCA-ED 0.537(OT参考 0.213) | +14.75% |
| TL Lag-Llama | 源级Pearson相关 | DISC 0.479 | 最佳单指标 MMD 0.435(OT参考 0.080) | +10.15% |
| 四任务平均(对比每任务最佳单指标oracle) | 源级Pearson相关 | 0.598 | oracle 0.543;固定单选最高 PCA-ED 0.403;OT参考 0.103 | +10.29% |
| 四任务平均(对比同家族非学习手动搜索,约790万配置/任务) | 测试集源级Pearson相关 | 0.598 | 手动搜索 0.291 | +105.38% |
局限与改进
作者承认的局限:第一,所有报告数字基于单一的24/8/14共享划分,14个测试源行、每个源行仅13个目标点,作者明确说明这是『共享划分下的源行迁移对齐分析』而非跨多种划分的不确定性分析,小样本Pearson相关方差大且无显著性检验;第二,下游误差 $E(X,Y)$ 包含目标数据集本身的内在预测难度,DISC的对齐分数衡量的是源条件下的分数-误差联动,并未把迁移兼容性与目标难度解耦;第三,这是相关性对齐分析而非源选择基准,top-k检索场景的性能未验证。我的补充观察:其一,校准成本高昂——学习权重需要完整误差矩阵,OOD协议每个基础模型要微调46个源模型,TL协议还要2070次目标适配,两个基础模型合计万次级微调/评估,实际部署时校准开销可能超过它想节省的评估开销;其二,候选指标池只有10个配置、数据集只有46个且全部来自GluonTS仓库,结论外推性存疑;其三,N=100、L=16的窗口采样对月度/季度等低频数据可能失真,Table VII已显示低多样性窗口会拉低相关,但论文只做诊断未做窗口消融;其四,OOD-TM增益仅+3.55%,当某单指标已很强时聚合收益边际递减。
独立分析的弱点
独立分析的弱点与改进方向:第一,校准依赖完整误差矩阵(46×45有向对×2模型×2协议),存在方法论上的鸡生蛋问题——用昂贵的迁移评估去学习避免昂贵迁移评估的打分器;改进方向是研究少样本校准,只用部分源行或目标子集学权重,并分析权重对校准集规模的敏感性。第二,统计功效不足:14个源行×13个点的相关性容易被个别异常源主导,虽然源级平均已部分缓解,但缺少bootstrap置信区间与多种划分的重复实验;改进方向是报告区间估计并做划分敏感性分析。第三,聚合结构手工设计:base+prior+sigmoid门控只是众多可行结构之一,论文未与更通用替代(小型MLP、Spearman秩相关目标、listwise学习排序)对比,无法排除表达能力更强的聚合器收益更高;改进方向是补结构消融。第四,指标池封闭:10个配置全是经典统计距离,未纳入基于基础模型嵌入或可学习表征的距离;改进方向是扩充候选池验证框架可扩展性。第五,仅在预测任务验证:分类、异常检测等下游任务的相似度-效用对齐是否同样成立未测。第六,正文未给出开源代码链接,误差矩阵与划分种子不可得将显著抬高复现门槛。
未来方向
作者提出的方向:DISC分数可用于源-目标评估的优先级排序(在昂贵评估前筛选高价值对)、基准数据集筛选与策展、以及跨域泛化分析;同时指出应研究窗口采样策略,因为Table VII显示平滑、平坦、低多样性的采样表征(lag-1自相关0.841、零值比例0.191、多样性3.935)会削弱相似度指标的解释力。基于成果可延伸的方向:其一,主动校准——用主动学习挑选信息量最大的源-目标对做微调评估,把校准成本从万次级降到百次级;其二,把DISC作为打分器嵌入检索增强预测(如TS-RAG类方法)或可迁移性感知的模型选择流水线,验证端到端收益;其三,跨任务层次化权重——学习任务间共享的先验混合再加任务级微调,减少每个新任务从零校准的开销;其四,扩展候选指标池至基础模型表征距离与可学习度量;其五,把训练目标从Pearson换成对源选择更直接的秩相关或top-k召回,对齐实际使用场景;其六,在GluonTS校准、GIFT-Eval等外部基准上测试权重迁移,检验聚合参数的跨仓库泛化能力。
复现评估
复现评估:论文未给出开源代码链接,难度中等偏上,但算法部分门槛很低。有利因素:46个数据集全部来自GluonTS公共仓库;10个候选指标(WSD、MMD、OT、MAD及DBA/PCA×DTW/ED/LCSS)均有成熟开源实现(tslearn、POT、sktime等);DISC模型本身极轻量——约 $10\times2+3=23$ 个可学习参数,训练配置在Table I完整给出:Adam、学习率0.03、500 epoch、patience 100、8次重启、$\tau=0.55$、gate调制上限3.0、阈值范围[0,1]、锐度范围[1,55]、熵权重0.006、重叠权重0.02、$\lambda=0.10$,CPU数十分钟可完成训练。主要瓶颈在下游误差矩阵:每个基础模型需微调46个源模型并做2070次有向对评估(OOD),TL协议再叠加2070次目标适配微调,Time-MoE与Lag-Llama共四套流程,估计需要多卡GPU运行数天;论文未披露算力配置与划分随机种子。结论:复现DISC训练与指标计算约一天;完整复现四任务实验需要可观的GPU预算,或依赖作者释出误差数据。
论文图表
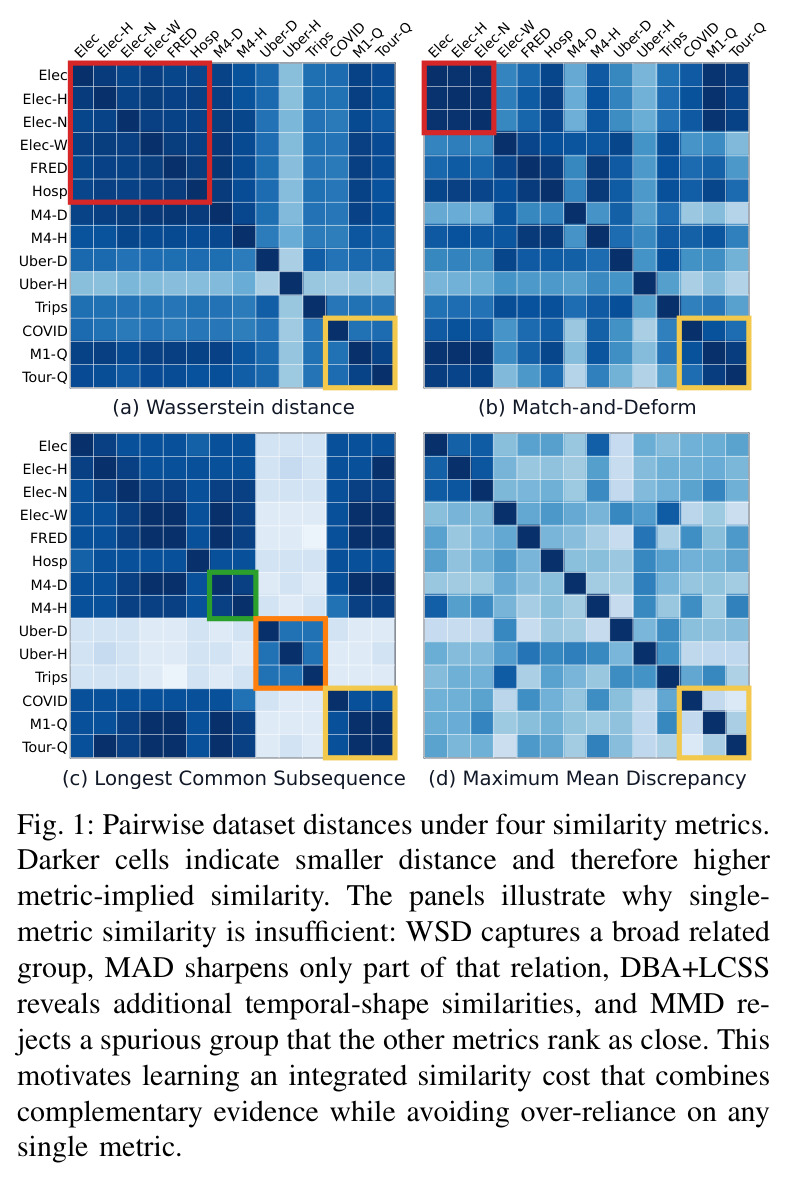
四个热图分别展示WSD、MAD、DBA+LCSS、MMD计算的全数据集两两距离,颜色越深距离越小、相似度越高。红框:WSD与MAD都能识别电力类数据集群,MAD进一步显示electricity、electricity_hourly、electricity_nips构成更紧的核心;绿框:只有DBA+LCSS清晰标记m4_daily与m4_hourly的低距离关系;橙框:DBA+LCSS对uber_tlc_daily、uber_tlc_hourly与vehicle_trips_wm给出最清晰的相似结果;黄框:covid_deaths、m1_quarterly、tourism_quarterly这组语义错配数据被WSD/MAD/DBA+LCSS都判为近,唯独MMD判为远。
这是全文动机的核心证据:直观展示单一指标各看到数据集关系的不同侧面,且低距离值可能是误导,直接引出『需要按下游效用学习集成相似度』的研究问题。
列出全部训练超参数:Adam优化器、学习率0.03、最大500 epoch、patience 100、8次随机重启、softmax温度 $\tau=0.55$、gate最大调制3.0、阈值范围[0,1]、锐度范围[1,55](围绕原始固定值40)、熵权重 $\eta=0.006$、重叠权重 $\mu=0.02$、全局相关权重 $\lambda=0.10$。
这是复现DISC训练过程的唯一完整超参来源,所有报告数字都在这套设置下产生。
五个配置(OT/WSD/MMD/MAD/DBA-DTW)与DISC在四个任务上的相关性及相对OT的增益。OT参考行为-0.007/0.125/0.213/0.080(平均0.103);WSD为0.445/0.361/0.516/0.011;MMD为-0.057/0.295/0.303/0.435;MAD为0.580/0.231/0.505/0.146;DBA-DTW为-0.016/0.618/0.134/0.302;DISC为0.601/0.697/0.617/0.479,平均0.598(较OT提升+0.496)。粗体标记每任务最佳,斜体标记最佳单指标。
RQ1与RQ2的主结果表:同时展示单指标强弱随任务洗牌的事实与DISC在每一列上的领先,是论文核心声明的主要出处。
续表,补充六种reducer组合与DISC的对比。DBA-ED为-0.016/0.618/0.134/0.302(平均0.259);DBA-LCSS平均仅0.019;PCA-DTW为0.381/0.577/0.482/0.113(平均0.388);PCA-ED为0.416/0.580/0.537/0.078(平均0.403,单指标中最高);PCA-LCSS平均0.148;DISC维持0.601/0.697/0.617/0.479。
补全10个候选指标的全景数据,是『最佳单指标随任务漂移』与『固定单选不够』论断的定量支撑。
每任务取最佳单指标作基线并给出DISC的相对提升:OOD-TM(MAD 0.580→0.601,+3.55%)、OOD-LL(DBA-DTW 0.618→0.697,+12.84%)、TL-TM(PCA-ED 0.537→0.617,+14.75%)、TL-LL(MMD 0.435→0.479,+10.15%),平均0.543→0.598(+10.29%)。
论文头条结论『DISC超过每任务oracle』的精确出处,数字以受控的对比方式呈现,避免了与弱基线比较的嫌疑。
每任务学到的base/prior指标及softmax权重(低于0.01省略)与prior调制因子均值和范围:OOD-TM base=DBA-LCSS(.549)+MAD(.402)+WSD(.022),prior=PCA-ED(.717)+Wasserstein(.173)等,调制2.26×[1.00,3.35];OOD-LL base=PCA-DTW(.612)+PCA-LCSS(.383),prior=PCA-LCSS(.935),调制1.21×[1.00,3.79];TL-TM base=MAD(.916)+Wasserstein(.067),prior=PCA-ED(.719)+DBA-ED(.180)等,调制1.17×[1.00,3.81];TL-LL base=MMD(.833)+DBA-ED(.159),prior=DBA-DTW(.362)+MAD(.324)+PCA-ED(.312),调制2.89×[1.00,3.95]。
可解释性的核心证据:不同任务选中的指标组合几乎不同,直接证明学到的是任务特异结构而非某个指标的普遍优势。
DISC与同聚合家族约790万配置的手动稀疏搜索对比(手动搜索用训练+验证集选配置再一次性应用到测试集):手动R为-0.066/0.571/0.316/0.344(平均0.291),DISC为0.601/0.697/0.617/0.479(平均0.598),增益为N/A(OOD-TM手动基线为负,百分比增益无意义)/+21.98%/+95.13%/+39.32%,平均+105.38%。
RQ3的关键消融:证明DISC的收益来自学习式聚合本身,而非在这个聚合家族里恰好挑到了好配置,手动搜索无法把校准集上的最优组合泛化到测试集。
对低相关组与高相关组数据集做采样窗口诊断(统一N=100、L=16):低相关组lag-1相邻步自相关0.841、零值样本比例0.191、多样性(z-normalized窗口的平均成对距离)3.935;高相关组分别为0.556、0.061、5.115。
揭示相似度失效的数据特性来源:过于平滑、平坦、低多样性的采样表征会削弱指标解释力——问题不只在指标设计,也在窗口采样策略,对实践有直接指导意义。