ToM2Vec:面向多智能体协同的连续心智理论令牌 ToM2Vec: Continuous Theory-of-Mind Tokens for Multi-Agent Coordination
用固定预算的连续思维令牌在隐空间建模伙伴心智,五个多智能体环境全面超越文本与提示基线
前置知识
心智理论(Theory of Mind, ToM)
指推断他人不可观测的心理状态(信念、欲望、意图)并据此预测其行为的能力,概念源自认知科学(Premack & Woodruff, 1978)。对智能体而言,意味着从有限的公开观测出发构建关于伙伴“接下来会做什么、为什么”的内部模型,从而减少显式沟通、实现默契配合。按贝叶斯 ToM 框架(Baker et al., 2011)可分解为信念、欲望、动作三个层次。
本文的方法设计与全部机理分析(贝叶斯 ToM 探针、Sally-Anne 假信念测试)都围绕“是否真正建模了伙伴心智”展开,理解 ToM 的分层结构才能读懂其动机、探针实验与分析结论。
潜在推理 / 连续思维令牌(Latent Reasoning)
让模型不解码出文字,而是把上一步最后层的隐藏状态直接作为下一步的输入嵌入,在隐空间中“思考”(代表工作如 Coconut,Hao et al., 2025)。连续向量可视为众多可能文本分布的叠加,一步即可并行表达多条候选推理链,突破了离散 token 每步只能走一条路的限制。
ToM2Vec 直接沿用该机制生成 ToM 令牌,其核心论点“隐空间能同时叠加关于伙伴的多个假设、而文本会把假设坍缩成单一陈述”正建立在连续推理的这一性质上。
自博弈(Self-Play)
让同一个模型(或其副本)同时扮演协作/对抗双方反复交互,自动产生无限训练数据而无需人工标注,AlphaGo 等系统靠它自我提升。在 LLM 语境下,双方各自的推理轨迹还可以互为监督信号。
ToM2Vec 的训练信号完全来自自博弈:伙伴生成的真实推理迹被压缩成目标向量供主智能体对齐,理解这一点才能明白它为何低成本、可扩展、且无需人工标注伙伴心理状态。
去中心化部分可观测马尔可夫决策过程(Dec-POMDP)
多智能体决策的形式化框架 $D=\langle I, S, \{A_i\}_{i\in I}, T, \{O_i\}_{i\in I}, O, R, \rho_0, H\rangle$:每个智能体只拿到自己的观测 $O_i$,看不到全局状态与他人私有信息,通过联合动作 $a_t$ 驱动状态转移 $T$。回合制交互可为不行动的智能体引入空动作(no-op)来表示。
论文 2.1 节以此定义问题设定;“部分可观测”正是智能体必须主动建模伙伴心智的根本原因,也是 ToM2Vec 区别于普通潜在推理工作的新挑战。
余弦相似度对齐(Cosine Similarity Alignment)
衡量两个向量方向一致程度的指标 $\cos(u,v)=\frac{u^\top v}{\|u\|\,\|v\|}\in[-1,1]$。以 $1-\cos$ 作为损失做表征对齐时只关心方向、不关心模长,广泛用于对比学习与知识蒸馏中的表征匹配。
ToM2Vec 用逐位置余弦损失 $\mathcal{L}_{\text{ToM}} = 1-\frac{1}{K}\sum_{k=1}^{K}\cos(\hat{z}_{t,k}, z_{t,k})$ 把学生智能体的预测向量拉向伙伴思维迹的隐状态,这是全文唯一的训练目标。
研究动机
现有 LLM 智能体在多智能体协同中的核心缺陷是对伙伴心智的建模薄弱,而且这个问题在“文本表征空间”里几乎无解。论文用 Overcooked 的真实对局(Figure 1)直观展示:未经训练的 Qwen3-8B 双智能体各自只推理自己的计划,竟然同时跑去餐盘架取盘,产生冗余甚至冲突的动作;用自然语言显式总结伙伴推理的“语言 ToM”智能体虽然更多考虑了伙伴,却常常锁定一条固定的伙伴轨迹(例如误以为绿帽伙伴要递盘子而原地干等),无法表达“伙伴可能拿盘、也可能去取洋葱”这类多重并列假设。推理时提示方法的收益也很有限:在 Overcooked 三个布局上 Prompted ToM 平均仅比未训练基线(94.7 分)高约 1.7~3 分,SimToM 平均 96.7、Adaptive ToM 平均 98.9,且提示法在 Cramped Room 上(Prompted ToM 92.0 除外)有时反而拖累表现。与之形成鲜明对照的是,给智能体“预言机”级别的伙伴私有想法可将平均分从 94.7 提到 117.7(+23.0 分)——伙伴信息价值巨大,但现有提示或文本化手段都无法有效利用它。
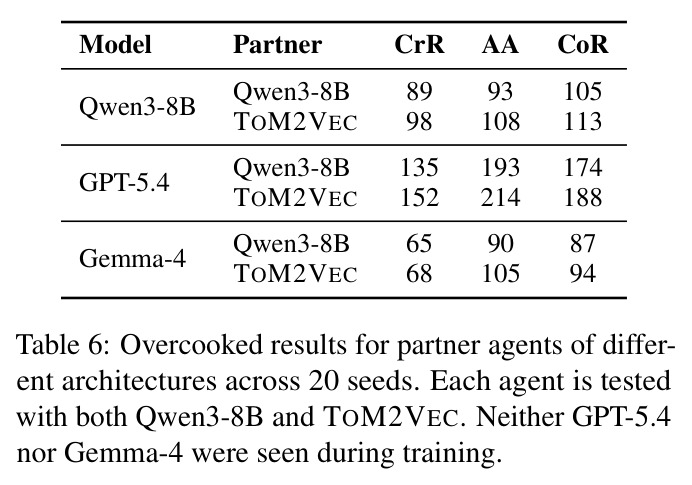
本文的目标是本文的目标是让 LLM 智能体在推理时完全无法访问伙伴私有上下文与推理的条件下,依然形成高质量的伙伴心智模型。具体拆成四个子目标:其一,训练智能体从自身局部观测预测一组固定预算($K=10$)的连续“心智理论令牌”,令其抽象并叠加伙伴的多条可能推理路径,而非锁定单一估计;其二,这些令牌在推理时作为后续思维与动作的条件,直接转化为协同收益,在覆盖合作(Overcooked-AI、Hanabi、Collab Escape/Capture)、混合动机(多方多议题谈判)与对抗(Decrypto)的五个环境中一致超越未训练基线、提示基线与训练基线;其三,验证学到的表征确实编码了伙伴的信念、欲望与下一步动作(而非只编码任务相关信息),并支持接触新证据后的信念更新;其四,验证只与单一开源模型(Qwen3-8B)自博弈训练得到的能力能泛化到训练时从未见过的异构伙伴家族,包括更强的闭源 GPT-5.4。
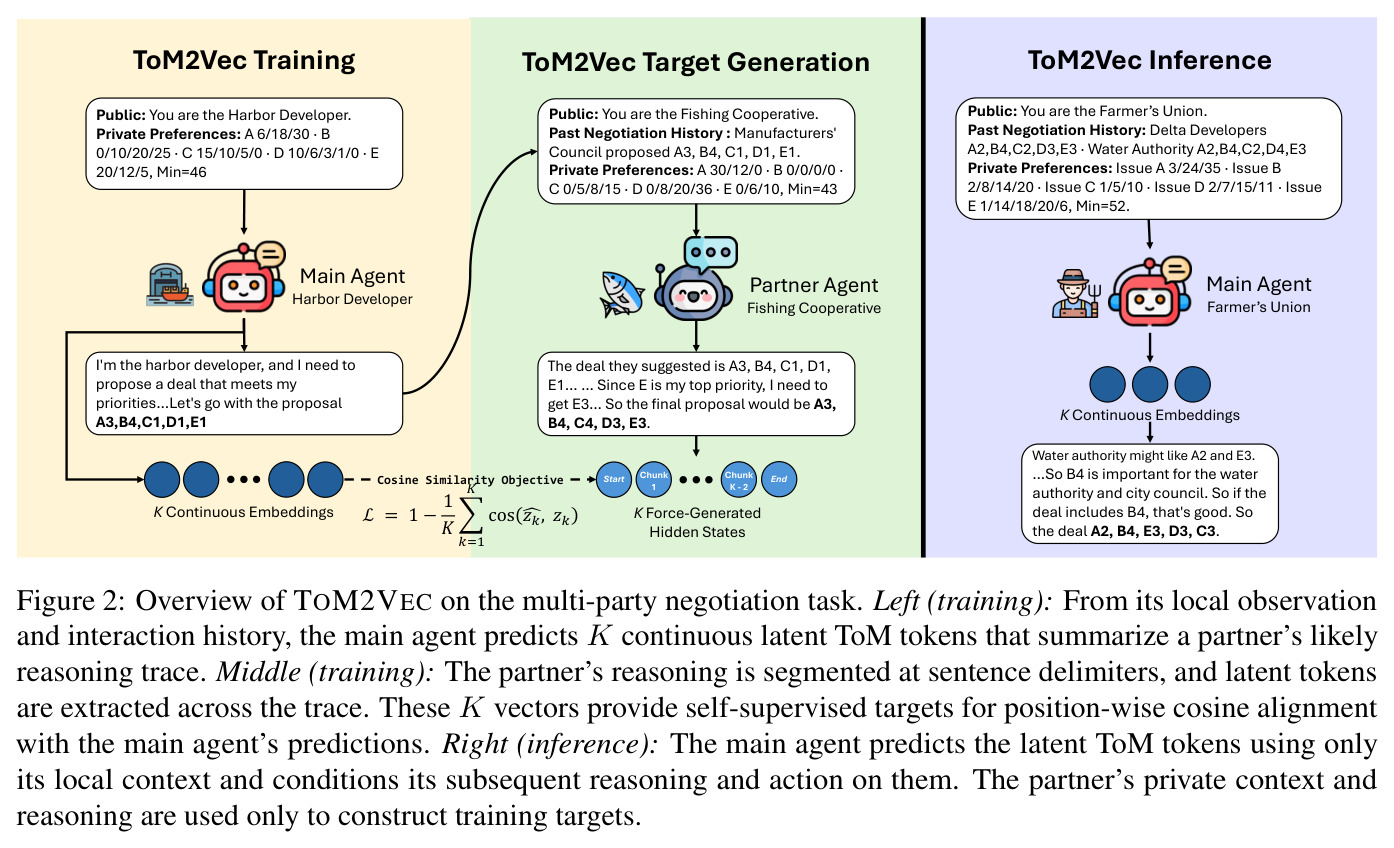
与已有工作不同的是,本文的独特切入是把对他者心智的建模从“输出空间的文本描述”搬到“隐空间的连续抽象”。作者论证自然语言是糟糕的 ToM 媒介:用文字陈述伙伴意图等于把多个并行假设坍缩成一个估计,而建模另一个智能体本质上更接近 LeCun 意义上的“隐空间世界模型”,潜在思维令牌(Coconut 一类连续推理)天然可以同时叠加多条候选思维链。基于这一视角,ToM2Vec 首次把潜在推理范式从“压缩自己的思考”转用于“读他人的心”:训练时直接抽取伙伴推理迹的隐藏状态作为自监督目标,让主智能体学习一个真正的读心任务。这填补了以往 LLM ToM 工作的两空档——推理时提示方法(SimToM、Adaptive ToM 等)不改参数、收益边际;训练方法让模型输出文本化的伙伴总结(Language ToM),仍受离散语言束缚。同时作者指出,把他者建模搬进隐空间还需面对部分可观测性这一单智能体潜在推理不曾遇到的新挑战。
核心方法
直觉层面:一个优秀的 ToM 智能体应当像隐空间世界模型一样,在头脑中同时保持关于伙伴的若干平行假设,待证据到来再收敛,而不是一开始就用一句话把伙伴“写死”。技术层面,作者把多智能体任务形式化为去中心化部分可观测 MDP $D=\langle I, S, \{A_i\}_{i\in I}, T, \{O_i\}_{i\in I}, O, R, \rho_0, H\rangle$(合作任务共享奖励 $R$,竞争任务不共享;回合制用空动作表示等待)。主智能体 $M$(可训练模型 $B_\theta$,与伙伴由同一基座 $B$ 初始化以保证表征空间共享)从自身上下文 $c_t^M$ 出发,以 Coconut 式潜在推理自回归地生成 $K$ 个连续潜在向量 $\hat{z}_t=(\hat{z}_{t,1},\ldots,\hat{z}_{t,K})$:每步把模型最后层的隐藏状态直接反馈为下一步的输入嵌入,不解码回词表。训练时用同基模伙伴在同一状态下的真实推理迹构造 $K$ 个目标向量 $z_t$,以逐位置余弦相似度损失对齐;推理时伙伴信息不可得,智能体生成自己的 $\hat{z}_t$ 并以其为条件产出后续推理与动作 $(r_t^M, a_t^M)\sim B_\theta(\cdot\mid c_t^M; \hat{z}_t)$。值得注意的是,$\mathcal{L}_{\text{ToM}}$ 是唯一训练信号,全程不直接优化任务奖励。
核心创新有三点。其一,监督信号是“伙伴的真实想法”:训练时从伙伴智能体推理迹中抽取隐藏状态作为目标,教主智能体执行真正意义上的读心任务,而不是预测行为或转述文本;其二,用连续潜在令牌而非文字承载 ToM,使表征能够“叠加”多条伙伴轨迹——这正是 Figure 1 中语言 ToM 智能体锁定单一轨迹、而 ToM2Vec 能同时考虑“伙伴可能递盘、也可能取洋葱”的本质区别;其三,ToM 目标是唯一训练目标且通过自博弈自动产生数据,无需人工标注伙伴心理状态。与最接近的对照(Language ToM 基线,同样用伙伴推理做监督但要求解码成离散文本)相比,增益确实来自“潜在”这一表征选择本身:Language ToM 在 Overcooked 平均只有 96.4 分(ToM2Vec 106.7),三个布局分别落后 11.3、9.0、12.3 分,在 Coordination Ring 上甚至比未训练基线还低 0.7 分,而 ToM2Vec 提升 11.6 分。此外,训练只需一个伙伴、部署时可换伙伴:同一套 ToM2Vec 权重配 GPT-5.4 伙伴仍平均涨 17.3 分,说明学到的是一般化的伙伴建模能力。
方法步骤详情
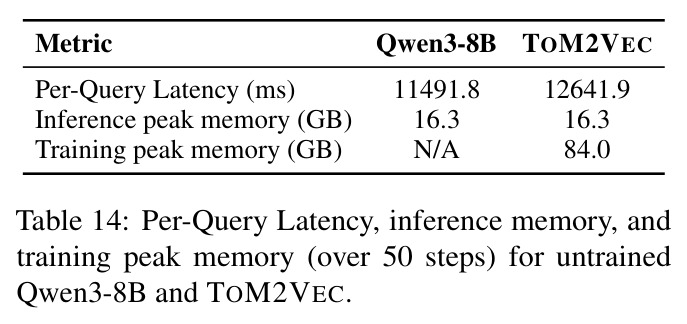
方法分四步执行。第一步(自博弈采样):主智能体与伙伴智能体由同一基座 $B$ 初始化;从环境采样交互状态,伙伴根据其含私有信息的上下文 $c_t^P$ 生成完整推理迹 $r_t^P\sim B_\theta(c_t^P)$。第二步(目标构造):将 $r_t^P$ 按句子分隔符切分,预留首尾两个位置,把句子均分为 $K-2$ 块,取每块中心 token 的隐状态,再加上推理迹首尾 token 的隐状态,得到 $K$ 个目标向量 $z_t=(z_{t,\text{start}}, z_{t,\text{chunk}_1},\ldots,z_{t,\text{chunk}_{K-2}}, z_{t,\text{end}})$,实验中固定 $K=10$。第三步(预测与对齐):主智能体仅凭自己的上下文 $c_t^M$ 自回归预测 $\hat{z}_t$(每步以上一步最后层隐状态为输入嵌入),用 $\mathcal{L}_{\text{ToM}} = 1-\frac{1}{K}\sum_{k=1}^{K}\cos(\hat{z}_{t,k}, z_{t,k})$ 训练;优化器 AdamW、学习率 $10^{-6}$、批大小 4、单步梯度累积;训练数据如 Overcooked 约 4000 个自博弈状态、谈判 500 个 GPT-5.4 生成的设置、Decrypto 1000 组关键词、Hanabi 4000 个局面、Collab Escape/Capture 各 4000 个状态,均按 80/20 划分训练/验证。第四步(推理部署):伙伴的上下文 $c_t^P$ 与推理 $r_t^P$ 完全不可见,智能体先发射 $K$ 个潜在 ToM 令牌拼入自身上下文,再条件生成后续推理与动作;代价仅是约 10 次额外前向传播(实测每查询多耗 1150.1 毫秒),推理峰值显存与基线完全相同(16.3 GB)。
技术新颖性
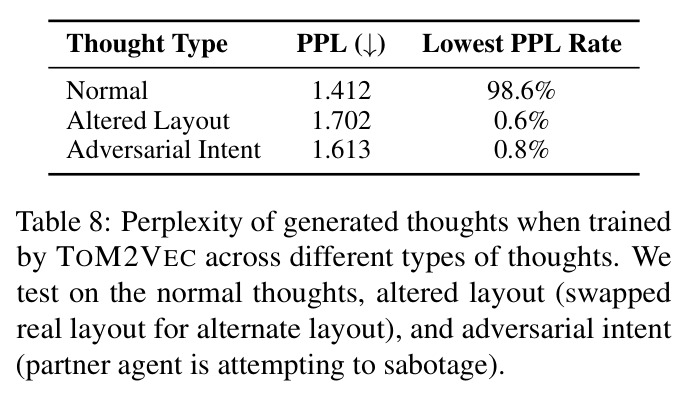
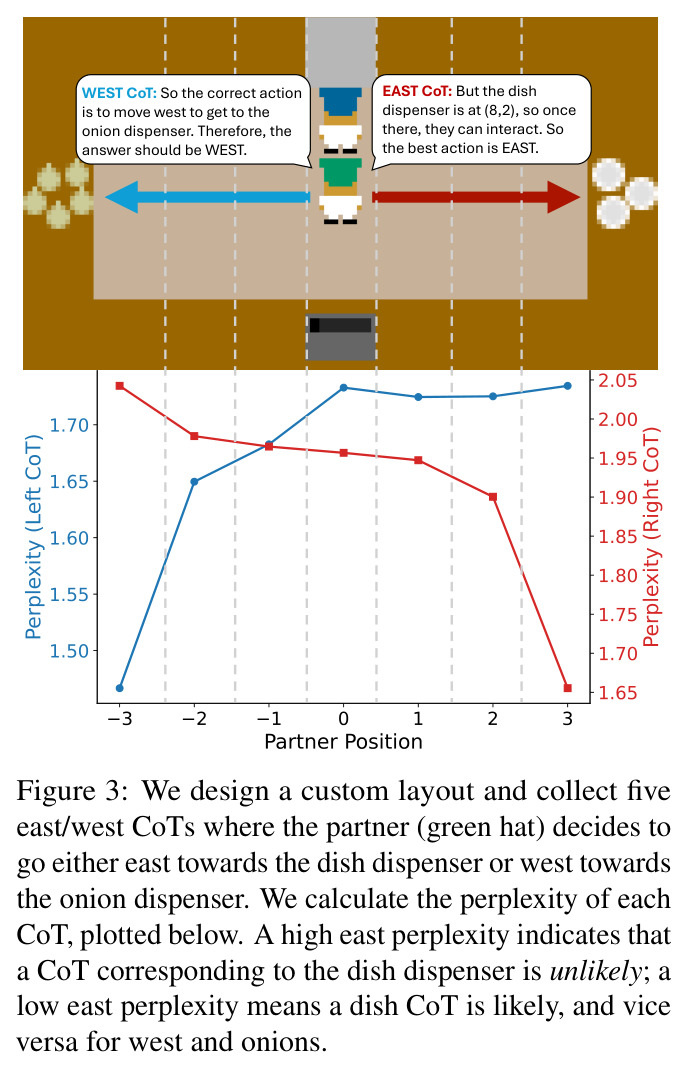
从技术谱系定位其新颖性。潜在推理工作(Coconut、CoDi、SoftCoT、Soft Thinking 等)都服务于压缩或增强模型自身的推理,本文首次将该范式转用于建模“他者”,并指出部分可观测性带来的独特挑战——主智能体永远看不到伙伴的完整历史与推理。与提示类 ToM(SimToM 的视角采择、Adaptive ToM 的推理顺序估计、Self-Consistency 的多链投票)相比,ToM2Vec 是训练时方法,把伙伴建模内化进参数,推理时无需额外的结构化流程;与训练类对照(Language ToM)相比,新颖性在于监督的模态与结构:目标向量直接取自伙伴推理迹的隐藏状态,并按句子块位置一一对应,保留了伙伴思考的时间组织,而文本化总结迫使模型提交到单一措辞。消融与分析进一步支撑:把潜在令牌换成文本总结只能收回一小部分增益;潜在令牌在真实伙伴上下文下对伙伴真实推理给出最低困惑度 1.412(篡改布局 1.702、对抗意图 1.613),98.6% 的情况下最低困惑度落在正确思维链上;跨家族迁移(GPT-5.4 +17.3 分、Gemma-4 仍全面占优)说明其编码的是与具体伙伴解耦的通用读心能力。
实验结果
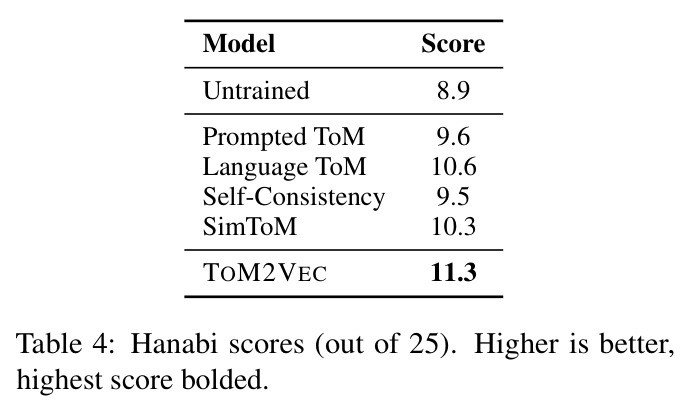
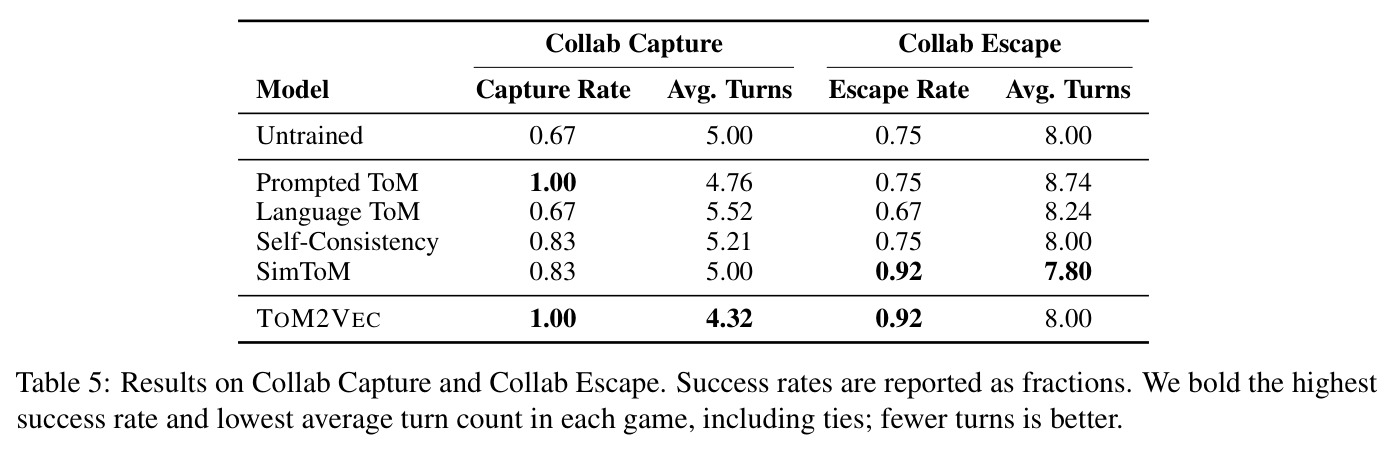
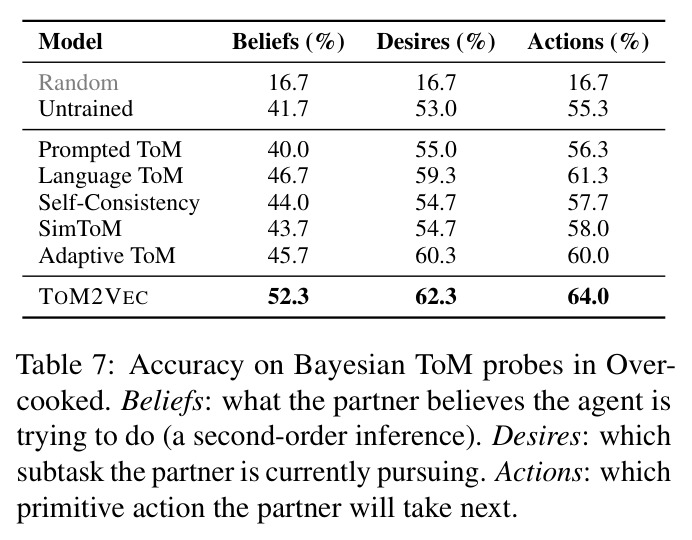
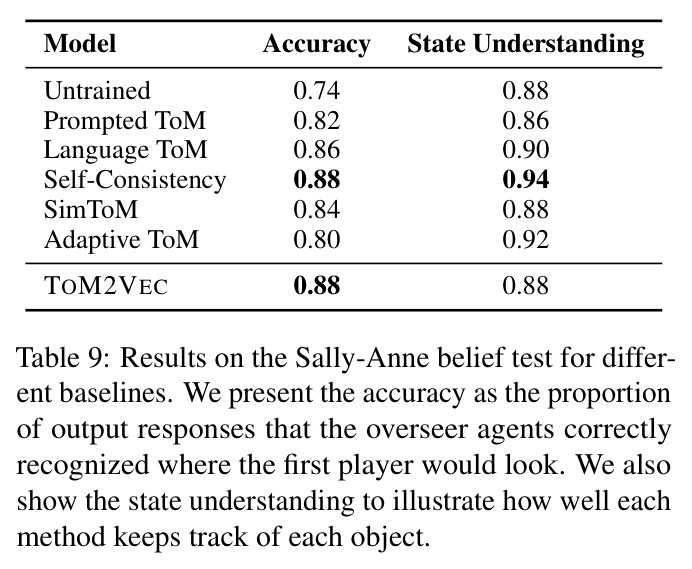
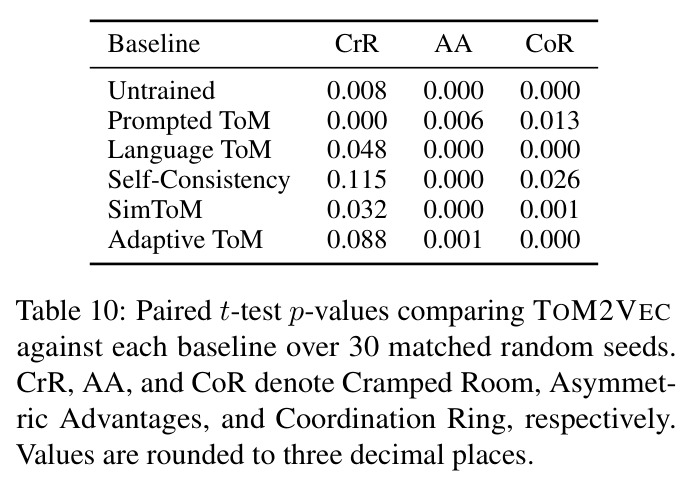
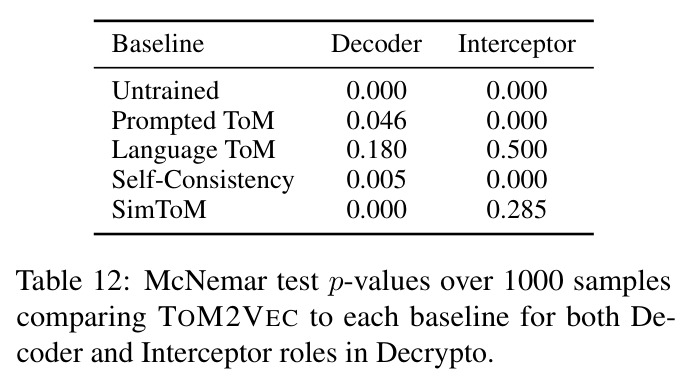
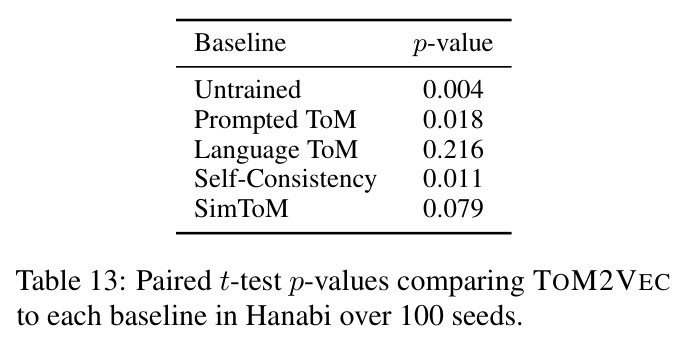
五个环境上一致超越全部基线。Overcooked(3 布局 × 30 种子):ToM2Vec 平均 106.7 分,比未训练基线 94.7 高 12.0 分,超过最强提示基线 Adaptive ToM(98.9)约 7.8 分,但仍低于拿到伙伴真实想法的预言机上界 117.7;逐布局为 Cramped Room 98.0、Asymmetric Advantages 107.7、Coordination Ring 114.3;配对 t 检验显示 18 组对比中 16 组在 $p<0.05$ 显著(Cramped Room 上对 Self-Consistency 与 Adaptive ToM 例外)。多方多议题谈判(100 局,6 方至少 5 方同意才算成交):成交率 62.0%→71.0%,自身得分 59.2→65.6,集体得分 54.7→59.2。Decrypto(1000 样本):解码器胜率 10.4%→14.8%(+4.4pp),拦截器胜率 87.4%→93.5%(+6.1pp),攻防两端都更强,McNemar 检验 10 组对比中 7 组显著。Hanabi(100 种子):得分 8.9→11.3(满分 25),比最强基线 Language ToM(10.6)还高 0.7。Collab Capture 抓捕率 0.67→1.00(+33pp)且平均回合数 5.00→4.32 为全场最低;Collab Escape 逃脱率 0.75→0.92(与 SimToM 并列最高)。跨模型泛化(Table 6,20 种子):只与 Qwen3-8B 自博弈训练的 ToM2Vec,配 GPT-5.4 伙伴时三布局 135/193/174→152/214/188(平均 +17.3 分),配 Gemma-4 时 65/90/87→68/105/94。机理分析:贝叶斯 ToM 探针(每类 300 题、6 选 1)上信念/欲望/动作准确率 52.3%/62.3%/64.0% 全面最佳,分别比次优基线高 5.6/2.0/2.7 个百分点,其中二阶信念最难;Sally-Anne 假信念测试得分 0.88(基线 0.74,+0.14),而各方法状态理解差异不超过 0.08,说明增益来自 ToM 而非更好的状态跟踪;Table 8 的困惑度实验(正常 1.412、篡改布局 1.702、对抗意图 1.613,最低困惑度命中率 98.6%)证明潜在令牌编码的是上下文敏感的伙伴特定信息。
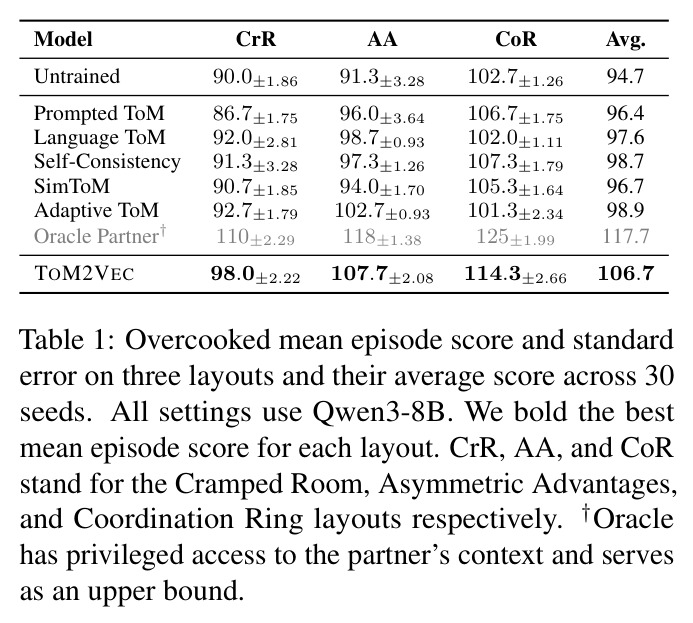
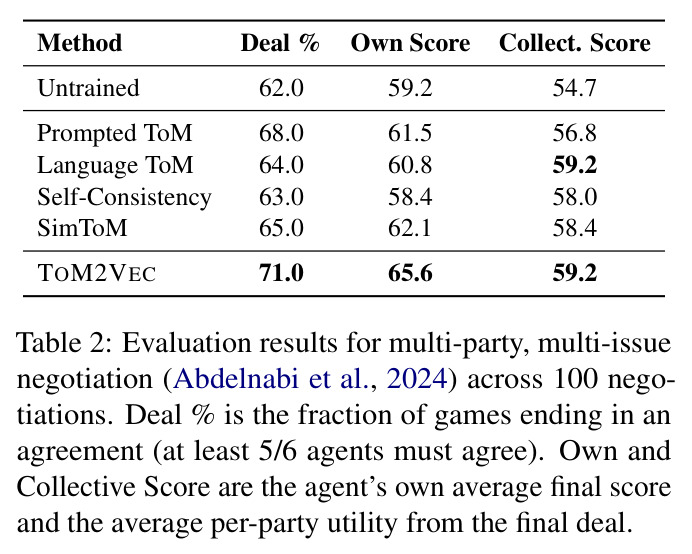
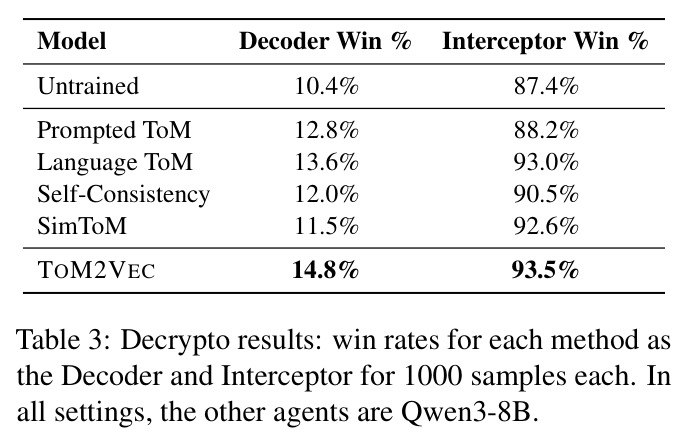
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Overcooked-AI(Cramped Room / Asymmetric Advantages / Coordination Ring,30 种子) | 平均回合得分 | 106.7(98.0 / 107.7 / 114.3) | 未训练 Qwen3-8B:94.7(90.0 / 91.3 / 102.7);最强基线 Adaptive ToM:98.9 | +12.0(对最强基线 +7.8;预言机上界 117.7) |
| 多方多议题谈判(Abdelnabi et al., 2024,100 局) | 成交率(≥5/6 方同意) | 71.0% | 未训练:62.0%;最强提示基线 SimToM:65.0% | +9.0 个百分点;自身得分 59.2→65.6,集体得分 54.7→59.2 |
| Decrypto——解码器方(1000 样本) | 队伍猜码胜率 | 14.8% | 未训练:10.4%;最强基线 Language ToM:13.6% | +4.4 个百分点(对最强基线 +1.2) |
| Decrypto——拦截器方(1000 样本) | 截获胜率 | 93.5% | 未训练:87.4%;次优 Language ToM:93.0% | +6.1 个百分点 |
| Hanabi(100 种子) | 游戏得分(满分 25) | 11.3 | 未训练:8.9;最强基线 Language ToM:10.6 | +2.4(对最强基线 +0.7) |
| Collab Capture(6 种子) | 抓捕成功率 / 平均回合数 | 1.00 / 4.32 回合 | 未训练:0.67 / 5.00;Prompted ToM:1.00 / 4.76 | +33 个百分点;回合数全场最低 |
| Collab Escape(12 种子) | 逃脱成功率 | 0.92 | 未训练:0.75;Language ToM 反而降到 0.67 | +17 个百分点,与 SimToM 并列最高 |
| Overcooked × GPT-5.4 伙伴(20 种子,训练仅见 Qwen3-8B) | 三布局平均得分 | 约 184.7(152 / 214 / 188) | 未训练 Qwen3-8B:约 167.3(135 / 193 / 174) | +17.3;Gemma-4 伙伴下 65/90/87→68/105/94 |
| 贝叶斯 ToM 探针(Overcooked,每类 300 题、6 选 1) | 二阶信念准确率 | 52.3% | 未训练:41.7%;最强基线:46.7%(Language ToM) | +5.6 个百分点;欲望 62.3%(+2.0)、动作 64.0%(+2.7)亦全面最佳 |
| Sally-Anne 式假信念测试(自定义橱柜布局,50 种子) | overseer 判断首玩家寻找位置的正确率 | 0.88 | 未训练:0.74;Self-Consistency:0.88(并列) | +0.14;各方法状态理解差异 ≤0.08,增益确属 ToM |
局限与改进
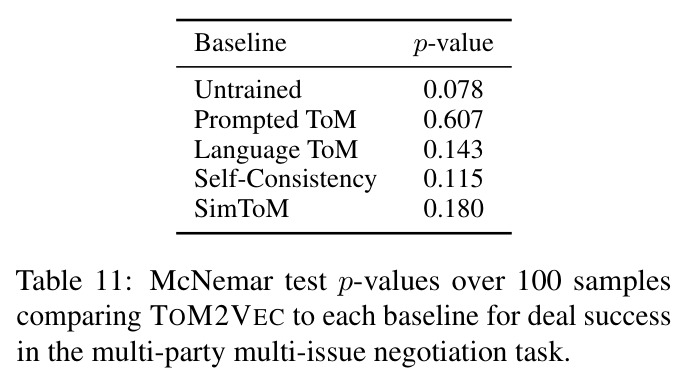
作者明确承认四点局限:训练需要伙伴的思维链(尽管实验证明训练伙伴不必是测试伙伴);监督依赖双方共享表征空间,故训练时必须使用同一基座模型,这意味着无法直接用闭源模型当训练伙伴;方法需要训练阶段,不像提示法即插即用(作者论证成本可被性能抵消:每查询仅多约 1.15 秒);实验仅覆盖英文任务。我的补充观察:其一,谈判任务的 5 组 McNemar 检验均不显著(Table 11,100 局样本量可能不足),成交率 +9pp 的结论应谨慎解读;其二,Hanabi 绝对分数仍很低(11.3/25),离人类专家水平遥远,潜在 ToM 在强规则、重公理博弈上的天花板不明;其三,Overcooked 上与预言机上界仍有约 11 分差距(106.7 对 117.7),说明有损抽象必然丢失部分伙伴信息;其四,Cramped Room 这一最简单布局上对 Self-Consistency 与 Adaptive ToM 的提升不显著,简单任务中额外容量可能冗余;其五,$K=10$ 的令牌预算在正文中未见敏感性消融,固定预算在更复杂多伙伴场景是否够用存疑;其六,训练峰值显存 84.0 GB,对普通实验室有一定门槛。
独立分析的弱点
独立分析出以下弱点。第一,训练依赖伙伴 CoT 且要求同基模:跨家族部署虽经实验验证(GPT-5.4、Gemma-4 伙伴),但训练伙伴必须与主智能体共享表征空间,闭源前沿模型被排除在训练伙伴之外;改进方向是学习跨模型投影层,或用一个公共锚定模型蒸馏异构伙伴的隐状态。第二,潜在令牌不可解释:出错时无法像文本 CoT 那样审计“智能体以为伙伴在想什么”,对安全关键的多智能体系统是隐患;可用稀疏自编码器等可解释性工具尝试反向解码这些向量。第三,推理延迟:每查询固定多出约 1150.1 毫秒(相当于 10 次额外前向),对高频实时交互环境不友好;可将潜在推理蒸馏为更少步数或跨回合缓存复用。第四,统计功效不足:Collab Capture 仅 6 种子、Escape 12 种子、谈判 100 局且全部对比不显著,多项结论证据薄弱;应扩大样本或改用方差更低的评估协议。第五,对抗鲁棒性只在困惑度层面检验(对抗意图下困惑度 1.613 仍高于正常的 1.412),未测试真正对抗性伙伴参与博弈时的协同表现,也未评估伙伴故意发出误导行为时的信念被带偏风险;建议加入刻意欺骗的伙伴做压力测试。第六,训练完全不使用任务奖励,学到的可能与任务弱相关的伙伴特征(例如无关偏好);可与 RL 微调级联,用稀疏任务奖励进一步筛选有用的 ToM 表征。
未来方向
作者提出的方向包括:把 ToM2Vec 部署进含前沿闭源模型的异构团队——已验证训练于开源 Qwen3-8B 即可配 GPT-5.4 协同并涨 17.3 分,这条“开源训练、前沿部署”路线值得延伸;扩展到非英文任务与更多环境。基于其成果还可延伸:递归 ToM——探针显示二阶信念(“伙伴认为我在做什么”)仍最难(52.3%),可设计分层潜在令牌显式编码不同阶心智;多伙伴团队 ToM——为 $n>2$ 团队的每个成员维护独立令牌组并建模成员间相互信念;信念修正机制化——Figure 3 已证明潜在令牌能随伙伴移动自然更新(向东移动时买盘方向思维链困惑度下降),可进一步构造显式贝叶斯式更新或结合元置信度;与任务奖励结合的混合目标训练;潜在思维链长度自适应(取代固定 $K=10$),按伙伴不确定性动态分配推理预算;以及迁移到具身多机器人协同与人机混合团队,其中对人类伙伴的建模可能比模型间建模更有价值。
复现评估
复现条件总体较好。代码承诺开源(GitHub: nsivaku/tom2vec);基座 Qwen3-8B 为 Apache-2.0 开源权重;五个环境中 Overcooked-AI、Hanabi、Collab Escape/Capture 为 MIT 许可、Decrypto 为 CCPL,均可公开获取;超参数完整给出(AdamW、学习率 $10^{-6}$、batch 4、$K=10$、80/20 数据划分),训练规模温和(每环境约 4000 个状态、谈判 500 个设置、Decrypto 1000 组关键词),vLLM 推理参数(温度 1.0、top_p 0.95、top_k 20、presence_penalty 1.5)也已列出。算力方面:训练峰值显存 84.0 GB,需 A100/H100 80GB 级单卡或多卡;推理峰值仅 16.3 GB,单张 A6000 即可,每查询延迟约 12.6 秒。主要门槛有两处:谈判训练数据(500 个设置)用 GPT-5.4 生成、跨家族评估也要调用 GPT-5.4(reasoning effort=high),需要 API 预算且闭源模型版本更迭可能影响严格复现;此外个别论文正文数字与表格存在细微出入(如 Collab Escape 基线 0.75/0.76),复现时以代码为准。总体属于中等难度:纯开源部分可直接复现,异构伙伴实验成本较高。
论文图表
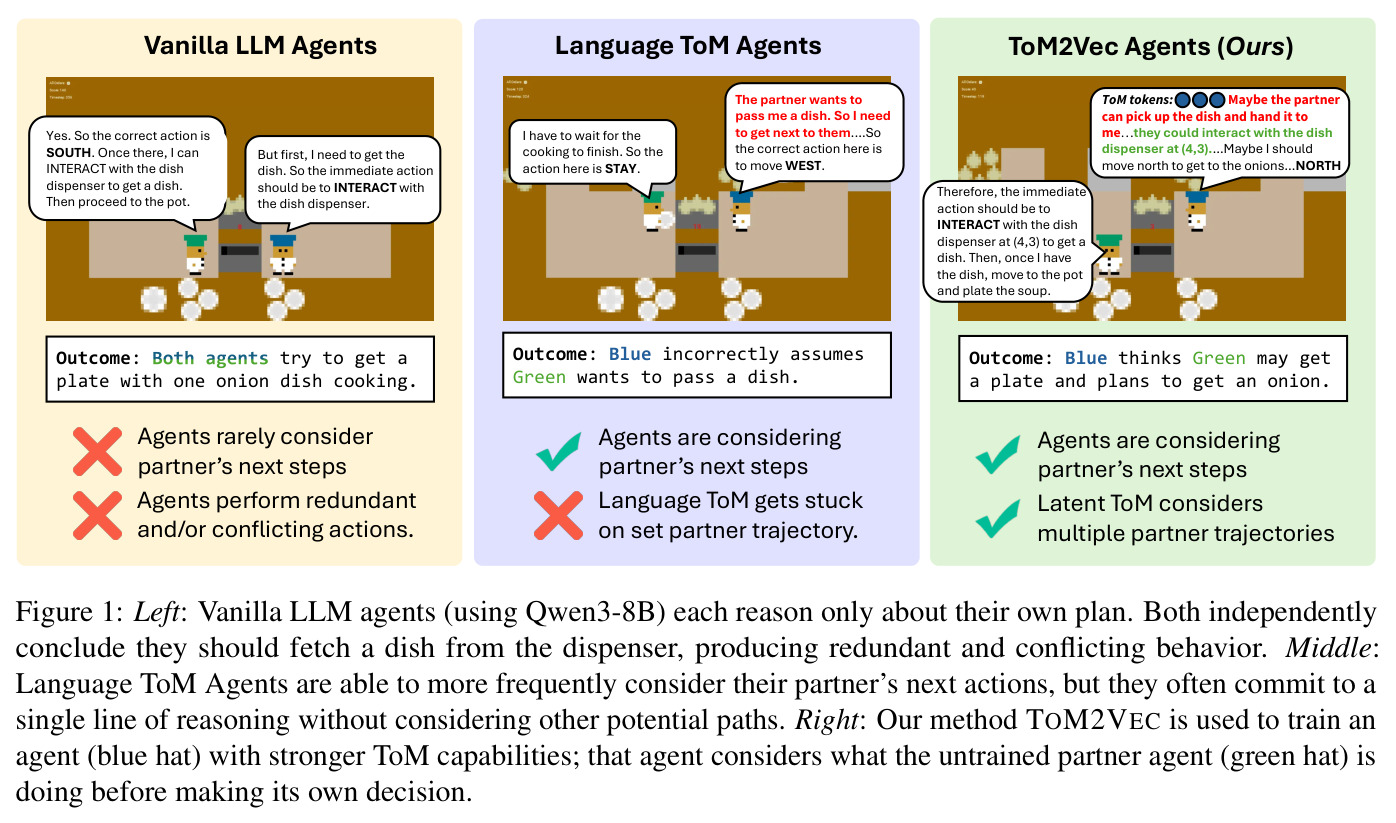
在 Overcooked 同一局面下对比三种范式的思维过程与结果:左,未经训练的两个智能体各自推理自己的计划,同时去拿盘子,产生冗余冲突;中,语言 ToM 智能体错误地认定“伙伴想递盘子给我”,于是干等烹饪完成;右,ToM2Vec 智能体用潜在令牌同时保留“伙伴可能拿盘递给我、也可能去取洋葱”等多个假设,最终决定去餐盘架取盘并规划后续上菜。
这是全文动机的直观缩影:文字化 ToM 会把多重假设坍缩成单一陈述并锁死行为,而隐空间 ToM 能叠加并行假设。理解这张图就理解了为什么“潜在”是本文的核心主张。