面向多智能体系统的心理模型框架 Mental-Models for Multi-Agent Systems
让智能体学习摊销式递归心理理论隐状态并耦合奖励模型,训练出可独立部署的伙伴建模策略
前置知识
心智理论(Theory of Mind, ToM)
推断他人不可观测心理状态(信念、意图、目标、知识)并据此预测其行为的能力。计算研究中常把 ToM 形式化为:从交互历史 $h_t$ 推断隐变量 $z_t$(伙伴的信念/意图/策略),再基于 $z_t$ 预测对方下一步行为或选择自己的动作。ToMnet、ToMi、BIGTOM 等工作分别在学习和度量这种能力。
本文的全部动机与方法(递归隐状态、BIT 子空间、心理标注数据增广、ToM 基准评估)都建立在 ToM 概念之上,不熟悉它就无法理解论文要解决什么问题。
一阶与二阶信念
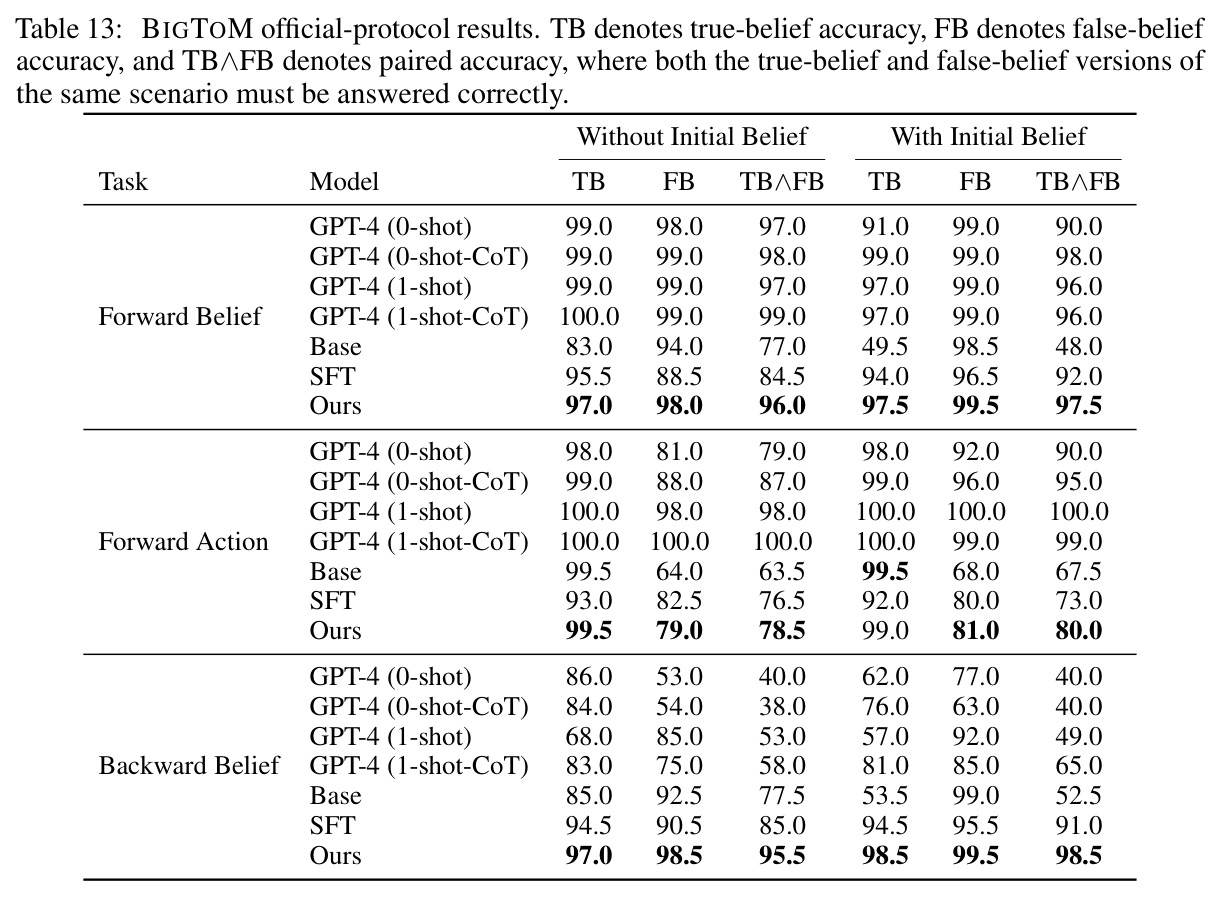
一阶信念是关于世界的信念,如“小红以为钥匙在抽屉里”;二阶信念是关于他人信念的信念,如“小红以为小明以为钥匙在抽屉里”。错误信念(false belief)任务要求在事实已改变、当事人未察觉时仍维持其旧信念,是 ToM 的经典试金石。BIGTOM 的 $\mathrm{TB}\wedge\mathrm{FB}$ 指标要求同一场景的真相/误念两个分支都答对才算对。
本文核心架构就是把隐状态递归分解为一阶 $z^{(1)}$ 和二阶 $z^{(2)}$ 两层,实验中二阶结构平均再带来 +6.7% 提升。
摊销推断(amortized inference)
不对每次观测跑昂贵的迭代推断(如 MCMC)去求后验 $p(z|h)$,而是训练一个前向网络 $q_\omega(z|h)$,输入历史直接输出后验参数。一次训练后每次推断只需一次前向传播,并能对新伙伴快速适应。ToMnet 率先在智能体建模中展示了这种做法的价值。
本文的心理模型就是把 $q_\omega(z_t|h_t)$ 作为摊销后验学习,这是“从交互历史快速读出伙伴心理状态”的技术基础。
变分推断与 VAE 参数化
把后验近似限制在参数族内(如对角高斯 $\mathcal{N}(\mu, \mathrm{diag}(\sigma^2))$),用 KL 散度拉向先验、用重建或监督项约束信息量。方差天然表达不确定性:观测证据少时 $\sigma$ 大,表示“对伙伴心理状态还不确定”,可表示连续分布而非单点估计。
本文用 VAE 风格的递归变分瓶颈建模 mental latent:$z^{(1)}$ 服从标准正态先验,$z^{(2)}$ 服从以 $z^{(1)}$ 为条件的先验;附录还消融了对角与全协方差后验的差异。
GRPO(组相对策略优化)
一种在线 RL 微调方法:对同一提示采样 $K$ 个候选动作,用组内奖励均值和方差归一化得到相对优势 $A_{i,k}=(r_{i,k}-\mu_i)/(\sigma_i+\epsilon)$,再做带裁剪和参考模型 KL 惩罚的策略梯度更新。无需价值网络,天然适合 LLM 的“采样候选再打分”式训练。
Phase 2 用冻结的 mental-reward 给采样候选打分、按组内相对优势做 GRPO,把信念感知信号蒸馏进策略,是三阶段方法的最后一环。
CKA 与线性探针
CKA(中心核对齐)度量两组表示的相似度,接近 1 表示高度相似;线性探针则是冻结表示、只训练线性分类/回归器,检验某个语义信息(如信念真假)能否从隐变量中线性读出。两者是分析隐空间结构的常用诊断工具。
论文第 5 节用 CKA 验证 belief/intent/thought 三个子空间互补、用探针与打乱干预验证递归 $z^{(1)}\to z^{(2)}$ 结构确实携带二阶信息,这些消融是理解方法为何有效的关键证据。
研究动机
LLM 智能体虽然对话能力强,但在需要推断他人心理状态的交互任务上明显落后于人类:GPT-4o-mini 在 TOMI 上 Average 仅 71.00、Joint 仅 24.42;GPT-4 在 BIGTOM backward belief 的配对准确率 $\mathrm{TB}\wedge\mathrm{FB}$ 最低只有 40.0;基座 7B 模型在 SOTOPIA-ALL 上 Overall 只有 3.29-3.51(10 分制)。现有 LLM 多智能体系统主要靠提示工程、记忆、自我反思、偏好微调或合成自博弈来塑造行为,伙伴的目标、信念、策略只隐式存在于 prompt 文本或轨迹摘要里,没有语义明确、带不确定性量化、可跨任务复用的显式信念状态。后果有三:不可解释、难以跨任务复用、无法系统地整合进不同策略学习器。面对有秘密、有隐藏目标的伙伴时,这类智能体容易误读意图、做出僵化计划,且在交互偏离预期时难以适应。
本文的目标是本文要回答的核心问题是:智能体能否从交互历史中学习一个摊销式隐信念状态,并把它作为多智能体策略学习的稳定训练信号?具体目标分三层:(1) 学习显式心理模型 $q_\omega(z_t|h_t)$,从可观测历史推断伙伴隐藏的信念、意图、知识、策略与高阶预期,隐状态按一阶/二阶递归因子化并细分 belief/intent/thought 子空间;(2) 学习以该信念状态为条件的奖励/效用模型,评估候选动作相对于推断出的伙伴状态的好坏,而非只看可观测上下文;(3) 用这个信念感知的奖励信号训练策略,部署时只保留独立运行的策略网络,兼顾显式伙伴建模的训练收益与部署效率,形成跨语言与多模态场景通用的 ToM 引导决策框架。
与已有工作不同的是,独特切入角度有三。第一,与 ToMnet 等只做行为预测的工作不同,本文把 ToM 隐状态接到效用预测上,让奖励目标的梯度反哺心理模型,使其朝 decision-relevant 方向演化——文中指出分开训练会产生两种互补失败:只学心理标注的模型可解释但与决策无关,只学奖励的模型会用表面特征解释打分而忽略伙伴状态,因此必须联合优化。第二,与 SymbolicToM 等解码时显式追踪信念的方法不同,本文的伙伴建模发生在训练期,推理时策略独立运行,无需额外搜索或重排。第三,伙伴状态不是自然语言假设(表达力受限且与 prompt 措辞强耦合),而是策略潜在动力学中的隐变量:可平滑插值、带方差不确定性、可被探针和干预分析,是从序列决策的信念维护原理到基础模型智能体的系统性迁移。
核心方法
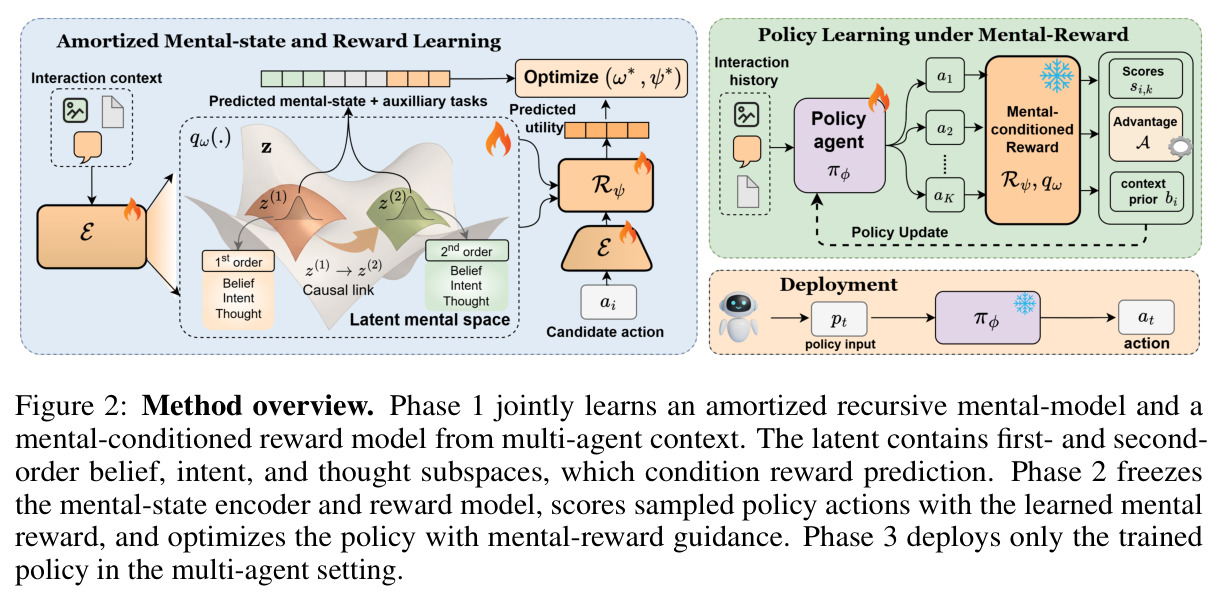
先讲直觉:让一个“读心模块”从对话历史压缩出对方“怎么想”的结构化猜测(含不确定性),再让一个“打分模块”回答“如果我这么做,在这种心理状态下结果会怎样”,最后让策略在训练中反复对照这两个模块学习,把“什么线索下该顾及对方什么心理”内化为参数,上线时甩掉两个模块轻装运行。技术上分三阶段(Fig. 2):Phase 1 在多智能体数据上联合训练摊销递归心理模型与信念条件奖励模型,损失涵盖效用回归、心理状态重建、理由条件预测、困难负样本排序和 KL 正则;Phase 2 冻结前两者,用学习到的奖励 $r_{\omega^\star,\psi^\star}(h_t,a_t)=w_e^\top\bar{u}_{\omega^\star,\psi^\star}(h_t,a_t)$ 给策略采样的候选动作打分,做 mental-reward 引导的 GRPO;Phase 3 只部署训练好的策略 $a_t\sim\pi_{\phi^\star}(\cdot|p_t)$。
核心创新是递归因子化的心理状态与耦合的心理-奖励学习目标。递归指 $q_\omega(z_t^{(1)},z_t^{(2)}|h_t)=q_{\omega_1}(z_t^{(1)}|h_t)\,q_{\omega_2}(z_t^{(2)}|h_t,z_t^{(1)})$:一阶隐状态直接从历史推断,二阶隐状态以一阶推断为条件,避免用一个平坦 latent 把两个不同的估计问题混为一谈——Fig. 4d 显示打乱 $z_2$ 会让二阶探针大幅退化,说明递归链接本身携带嵌套 ToM 信息。BIT 分解指每层 latent 再切成 belief/intent/thought 三个子块,为心理标注解码器提供稳定接口;消融显示 BIT 把偏好裕度中位数从 +12.76 提到 +25.06,而平坦监督与打乱标签对照几乎无差别。耦合指心理模型与奖励模型联合训练:奖励梯度逼 latent 装进决策相关信息,latent 又强制奖励头必须“绕道”伙伴状态才能解释打分,二者互相成就。
方法步骤详情
第一步,把每个数据集统一为元组 $(c_i, a_i^+, a_i^-, u_i, \gamma_i, m_i^{(1)}, m_i^{(2)}, \xi_i)$:上下文、正例动作、困难负例、效用向量、维度掩码、一/二阶心理标注与理由文本,缺失字段由掩码跳过。第二步,LoRA 微调的 7B 语言/VL 骨干分别编码上下文 $e(c_t)$ 与候选动作 $e(a)$,输出两个对角高斯后验:$q_{\omega_1}(z^{(1)}|c)=\mathcal{N}(\mu_1(e(c)),\mathrm{diag}(\sigma_1^2(e(c))))$,$q_{\omega_2}(z^{(2)}|c,z^{(1)})=\mathcal{N}(\mu_2([e(c);z^{(1)}]),\mathrm{diag}(\sigma_2^2))$,每层 $d_z=128$ 维并分 BIT 子空间。第三步,效用头 $\hat{u}^{joint}_t(a)=g_\psi^{joint}([z^{(1)};z^{(2)};e(a)])$ 预测 $D$ 维结果向量,按 $\mathcal{L}_{MR}=\mathcal{L}_{vec}+\lambda_p\mathcal{L}_{pref}+\lambda_m\mathcal{L}_{mental}+\lambda_e\mathcal{L}_{expl}+\mathcal{L}_{KL}$ 联合训练,困难负例只在被刻意破坏的维度 $\gamma_{t,d}$ 上施加排序惩罚。第四步,冻结后做 GRPO:每提示采样 $K=8$ 个候选,优势 $A_{i,k}=(r_{i,k}-\mu_i)/(\sigma_i+\epsilon)$ 组内归一化并裁剪,配参考模型 KL(系数 0.06-0.1)更新 LoRA 参数。训练采用三个稳定器:一阶 latent 预热、KL 退火加二阶延迟激活、$z^{(1)}\to z^{(2)}$ 初始 stop-gradient。
技术新颖性
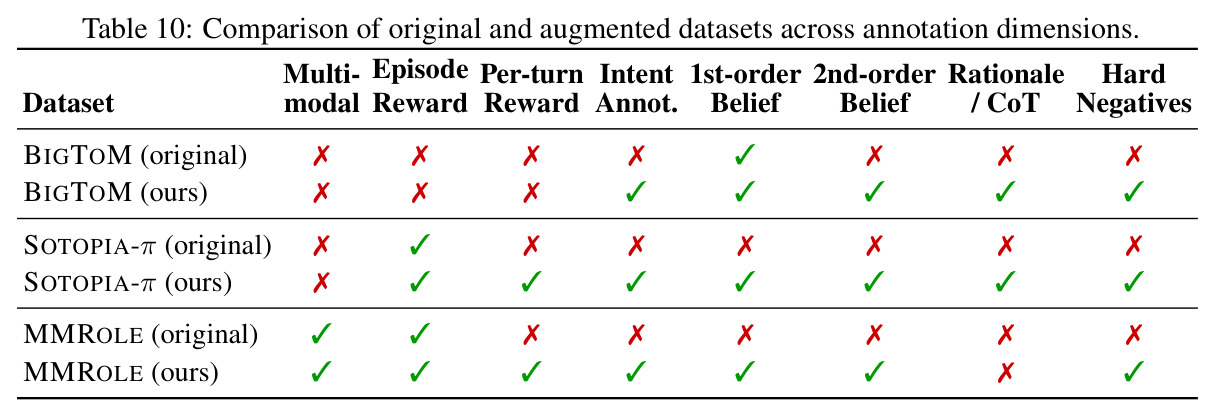
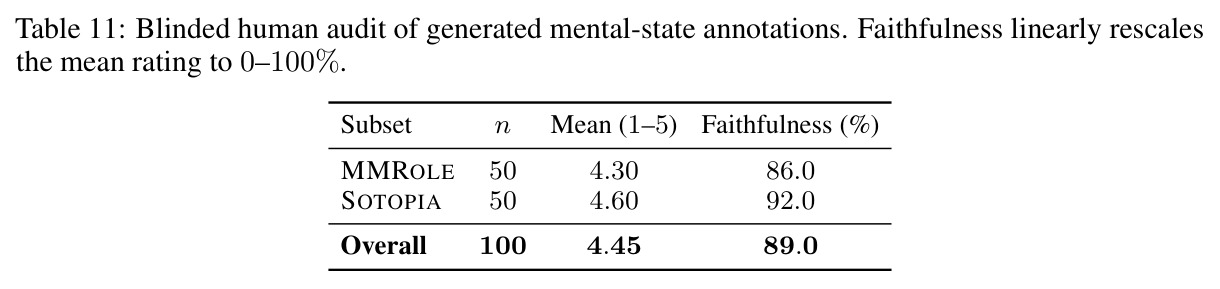
新颖性体现在四方面。(1) 架构上,一阶+二阶递归 latent、每层再分 BIT 子空间的双层结构是新的:ToMnet 用单一 latent 预测行为,SymbolicToM 靠符号规则,本文把“对对方的模型的模型”直接写进生成结构,并用条件先验 $p_\chi(z^{(2)}|z^{(1)})$ 的 KL 项维持递归性。(2) 目标上,心理-奖励耦合学习是关键贡献:matched-checkpoint 消融显示去掉心理重建或理由条件化使奖励回归相关性分别降 29% 和 26%,去掉困难负样本使偏好准确率从 100% 降到 81%,证明各目标真正互补而非拼盘。(3) 训练-部署解耦:显式伙伴建模只存在于训练期,部署时策略独立生成,推理零额外开销,与解码时依赖显式追踪的方法形成对照。(4) 数据上,用 GPT-4o/Qwen3-235B 把 SOTOPIA-π(1,647 集)、BIGTOM(9,964 行)、MMROLE(15,607 轮)统一增广为一/二阶心理标注+效用+理由+困难负例的格式,盲评人类审计平均 4.45/5,为社区提供了稀缺的 ToM 监督资源。
实验结果
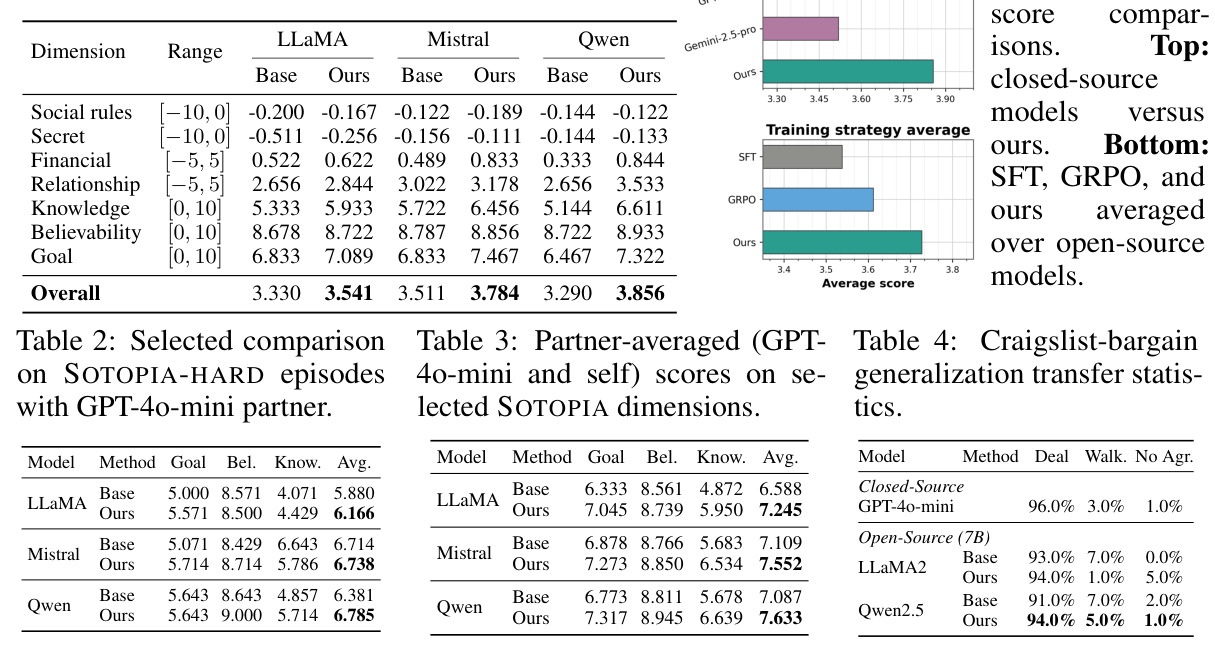
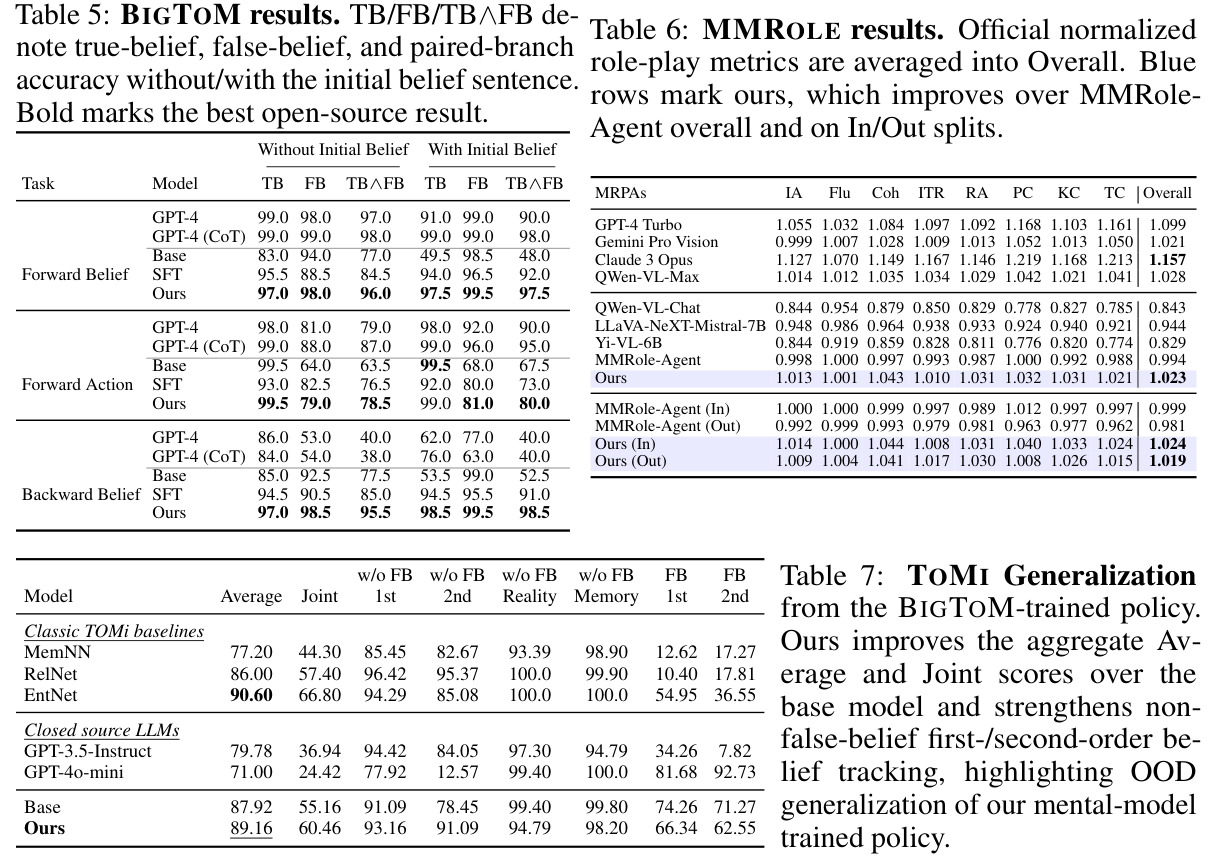
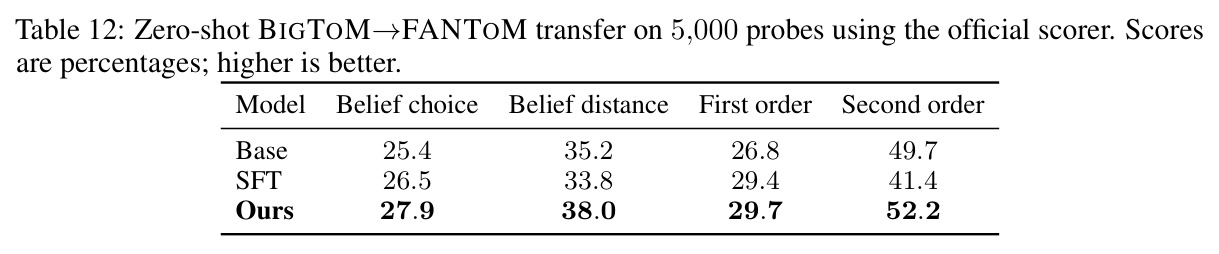
SOTOPIA:GPT-4o-mini 固定伙伴下 Overall 从 Qwen2.5 3.290→3.856(两伙伴设置平均相对提升 11.5%),LLaMA2 3.330→3.541、Mistral 3.511→3.784,提升集中在 Knowledge(5.144→6.611)与 Goal(6.467→7.322),Believability 保持 8.9 高位;SOTOPIA-HARD 与伙伴平均设置同样全面改善。谈判迁移:仅用 SOTOPIA 数据训练即把 CRAIGSLIST-BARGAIN 的 walkaway 从 7% 压到 1%、成交率升至 94%。BIGTOM:$\mathrm{TB}\wedge\mathrm{FB}$ 配对准确率六设置平均 +26.7pp,如 backward belief 77.5→95.5、forward belief 带初始句 48.0→97.5,表明模型能同时维持同一智能体的两个反事实心理状态。TOMI 零样本 OOD:Average 87.92→89.16、Joint 55.16→60.46;MMROLE:Overall 1.023 vs MMRole-Agent 0.994(Out 分片 1.019 vs 0.981);FANTOM 零样本多方迁移二阶分 52.2 vs Base 49.7。消融:25% 心理标注已达 3.650(基线 3.300)、全量 3.856;二阶 latent 较一阶再提升 6.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SOTOPIA-ALL(开放社交互动) | 七维 Overall 均分(10 分制) | Qwen2.5-7B 3.856 | Qwen2.5-7B 基座 3.290 | +0.566(约 17.2% 相对提升;两伙伴设置平均相对提升 11.5%) |
| SOTOPIA 伙伴平均(GPT-4o-mini + self) | Goal/Believability/Knowledge 平均 | Qwen 7.633 | Qwen 基座 7.087 | +0.546 |
| BIGTOM(受控信念推理 QA) | TB∧FB 配对准确率(%) | backward belief 无初始信念 95.5;forward belief 带初始信念 97.5 | 基座分别 77.5 / 48.0 | 六个设置平均 +26.7pp |
| TOMI(零样本 OOD 泛化) | Average / Joint 准确率(%) | 89.16 / 60.46 | Qwen2.5-7B 基座 87.92 / 55.16 | +1.24 / +5.30 |
| MMROLE(多模态角色扮演) | 官方 8 维归一化 Overall | 1.023(Out 分片 1.019) | MMRole-Agent 0.994(Out 0.981) | +0.029 / +0.038 |
| CRAIGSLIST-BARGAIN(跨域谈判迁移,100 例) | 成交率 / walkaway 率 | LLaMA2: 94% / 1%;Qwen: 94% / 1% | LLaMA2 基座 93% / 7%;Qwen 基座 91% / 7% | 成交率 +1~3pp,walkaway −6pp |
| FANTOM(零样本多方 ToM,5000 探针) | 二阶得分(%) | 52.2 | Base 49.7 / SFT 41.4 | +2.5 vs Base、+10.8 vs SFT |
局限与改进
作者承认的局限:训练环境基本是二元(dyadic)交互,多方场景只有 FANTOM 零样本迁移这一初步证据(52.2 vs 49.7,且 belief distance 上 SFT 反而更低,证据并不全面);心理标注由 GPT-4o/Qwen3-235B 生成,盲评人类审计 4.45/5(89.0%),意味着约一成标注存在过度推断或与对话/图像矛盾;NeurIPS 检查清单明确承认没有为所有主表报告 error bar 或置信区间,只靠跨基准一致性和重复评估支撑。我自己的观察:(1) 部署时丢弃心理模型意味着没有在线信念更新——伙伴中途改变策略或说谎时,策略只能靠参数化记忆泛化,而非更新 $q_\omega(z_t|h_t)$;(2) SOTOPIA Overall 绝对值仍低(3.856/10),Believability 逼近天花板说明改进集中在少数任务维度;(3) GPT-4o 既做标注又做 SOTOPIA 裁判,可能引入评估循环性偏差;(4) 隐状态语义继承标注偏见与刻板印象,作者在 Impact Statement 中也强调不能当作真实心理状态使用。
独立分析的弱点
第一,摊销推断是“一次读出”而非“持续追踪”:$q_\omega(z_t|h_t)$ 每次从完整历史重算,长对话中冗余且无法表达信念随回合的动态演化,改进方向是引入流式/增量信念更新,把 latent 作为逐回合传播的记忆状态。第二,心理标注由 LLM 生成,会系统性继承生成模型的偏见(审计发现低分样本多为过度自信、无支撑推断或与证据矛盾),改进方向是加入人类校准子集、不确定性加权损失或可学习的标注置信度。第三,效用向量依赖各 benchmark 官方评估器提供 $D$ 维分数和标量化权重 $w_e\in\Delta^{D-1}$,在无官方评估器的新环境里奖励来源不明,可探索从成对偏好数据自举效用维度。第四,7B+LoRA 的规模可能掩盖方法在大模型上的边际变化,Mistral 在 SOTOPIA 上的提升小于 Qwen 也提示方法对基座有选择性,应补充规模扩展曲线。第五,多方、联盟、递归深度大于 2 的推理(我猜你的心思、我以为你知道我知道)均未训练覆盖,FANTOM 迁移幅度有限即是征兆。
未来方向
作者提出的方向:把训练从二元扩展到多方场景并做参与者特定的 latent 更新;推广到具身与机器人 setting,其中伙伴信念、目标、视野与物理约束在更长时程上演化;扩展到更大策略、更多样化的伙伴模型、更丰富的在线信念更新与 human-in-the-loop 评估。基于本文成果可延伸的:(1) 在线信念追踪——部署时保留轻量版读心模块做流式推断,让策略能在对话中途检测“对方不相信我”并调整;(2) 递归深度推广到三阶以上,用合成任务系统研究“深度-收益”关系;(3) 把 BIT latent 用于可解释安全:检测智能体是否隐瞒(secret 维度)、操纵或对用户形成错误模型;(4) 与多智能体 RL 的对手建模(如 LOLA)结合,研究相互建模下的学习动力学;(5) 利用 latent traversal 做干预式数据增强与红队测试,主动生成心理边缘样本提升鲁棒性;(6) 把增广后的 ToM 监督数据(Table 10)作为公共资源,推动跨实验室的 ToM 能力对比研究。
复现评估
代码已在 GitHub 公开(github.com/hananshafi/Mental-Models),但 NeurIPS 检查清单第 5 题目前答 [No](承诺接收后发布代码、模型与数据),增广数据集尚未完全释放。有利条件:所有开放模型只用 LoRA(rank 8-32、$\alpha$ 16-64)微调 7B 级骨干(Qwen2.5-7B-Instruct、LLaMA2-7B-Chat、Mistral-7B-Instruct-v0.3、Qwen2.5-VL-Chat),硬件仅需 RTX A6000 48GB;附录完整给出超参(奖励模型 lr $2\times10^{-5}$、GRPO lr $1\times10^{-6}$-$3\times10^{-6}$、组大小 8、KL 系数 0.06-0.1、温度 0.6-0.8)、$d_z=128$ 与三个训练稳定器。成本痛点:标注管道需 GPT-4o(SOTOPIA 1,647 集、MMROLE 15,607 轮)与 Qwen3-235B(BIGTOM 25 倍扩增),评估依赖 GPT-4o-mini 伙伴与 GPT-4o 裁判。总体难度中等:方法论与超参文档充分,瓶颈在数据增广成本与闭源评估环节。
论文图表
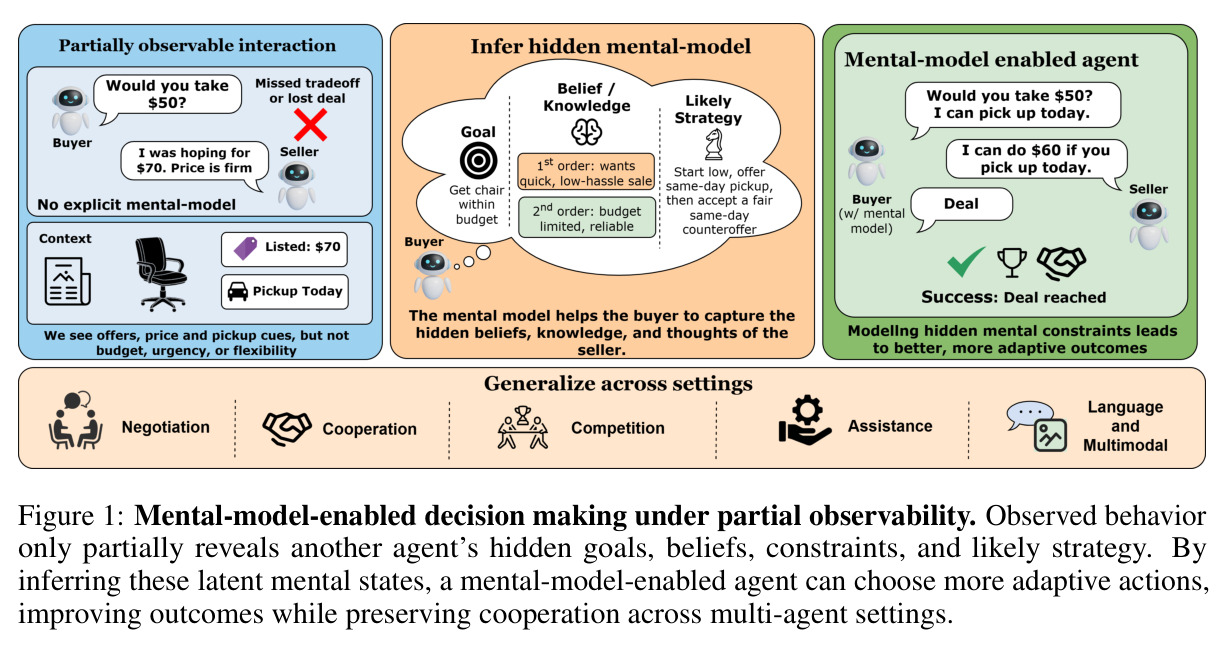
概念图:观测到的行为只部分揭示另一智能体隐藏的目标、信念、约束与可能策略;具备心理模型的智能体通过推断这些潜在心理状态,选择更具适应性的动作,在多智能体环境中改善结果同时保持合作。
开篇即点明论文要解决的问题设定——部分可观测下的伙伴心理状态推断如何指导动作选择,是理解全文动机的入口。
上图:闭源模型(GPT-4o-mini、Gemini)与本文 7B Qwen2.5 智能体的 SOTOPIA 均分对比,本文超过闭源基线;下图:SFT、GRPO 与本文方法在 LLaMA、Mistral、Qwen 三个开源模型上的平均分对比,本文一致最优。
直观展示两个关键论断:显式心理建模让 7B 开源模型战胜更强闭源基线,且收益超出标准 SFT/GRPO 训练。
四组诊断实验:(a) 打乱 latent 后平坦压缩 VAE 的奖励预测几乎不变而心理模型 latent 的 MSE 陡增,说明后者与决策结构强耦合;(b) BIT 变体的三个子空间 CKA 相似度低且互补,平坦/打乱变体则高度混同;(c) 线性探针从 BIT latent 恢复 MMROLE ToM 因子显著好于同维平坦 latent;(d) 保持边缘分布打乱 $z_2$ 破坏二阶探针,验证递归 $z^{(1)}\to z^{(2)}$ 结构本身携带嵌套信息。
这是支撑核心设计(BIT 分解与递归因子化不是装饰而是功能必需)的完整证据链,是分析部分最重要的一张图。
隐空间遍历分析:(a) 沿 belief 轴移动近边界锚点会单调改变分支分类器和仅用 $z_1$ 的冻结奖励头;(b) 沿 offer/proposal(提议)策略轴遍历时,探针分数随系数 $\alpha$ 上升、近邻标签从 questioning/other 转向 offer/proposal,且该方向的权重质量集中在二阶 ToM 块,说明提议类策略更依赖对“对方会如何回应”的建模。
证明恢复出的隐方向对应真实的心理与策略变量而非探针伪影,是隐空间语义可解释性的直接证据。
BIGTOM latent 的无监督 UMAP:左图按任务着色形成宏观任务/场景簇;右图按分支着色,aware 与 not-aware 样本在相近任务区域内保持局部分离(分支 F1=0.989),说明信念状态虽非最大变化轴但被几何连贯地表示。
从几何角度佐证 latent 确实编码了感知分支信息,与探针结果互相印证。
花瓣图:每个花瓣表示二阶 latent 相对一阶 latent 在各官方 SOTOPIA 维度上的百分比区间变化,中心徽章报告平均分相对提升 +6.7%;二阶在 knowledge、goal、financial、relationship 等任务维度外扩明显,believability 接近中性。
量化了递归二阶建模的边际价值,直接支持“高阶心理状态有用”的核心主张。
1,508 个 SOTOPIA 验证轮次上每样本偏好裕度 $r^+-r^-$ 的核密度:BIT 中位数 +25.06 且全部样本裕度 ≥ +1.40,平坦监督 +12.76 且与打乱标签对照(+12.53)重叠;偏好损失 BIT 9.6×10⁻⁵ vs 平坦 1.0×10⁻²,相差两个数量级。
用单一对照实验说明:仅有心理内容不够,把 belief/intent/thought 路由到专用 latent 子块才产生高置信的伙伴条件偏好分离。
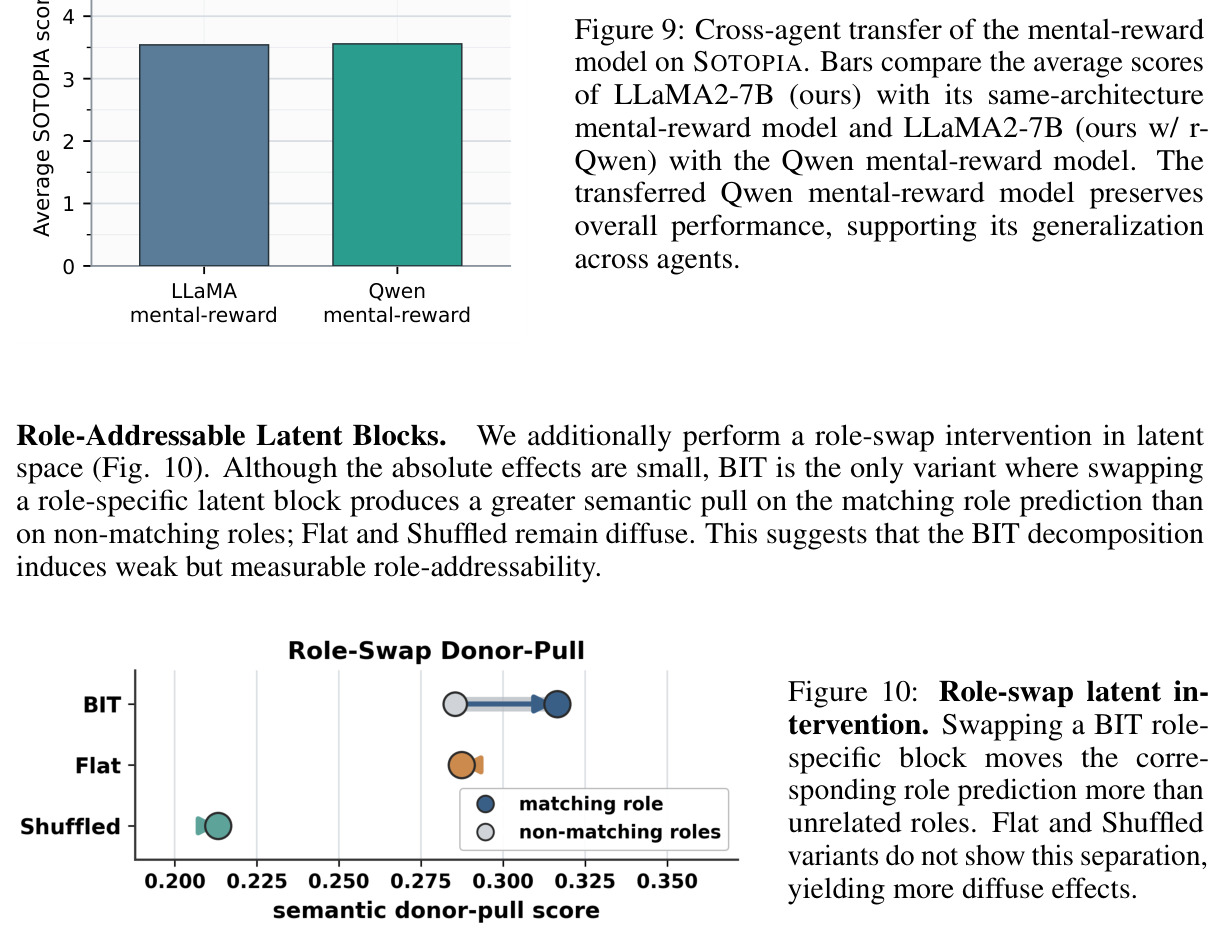
角色交换干预:在 latent 空间交换角色特定子块后,只有 BIT 变体对匹配角色的预测产生比非匹配角色更大的语义牵引,Flat 与 Shuffled 变体效应弥散,说明 BIT 诱导出弱但可测的角色可寻址性。
为“latent 子块确实对应具体角色/语义”提供了因果干预层面的证据,超越纯相关性探针。
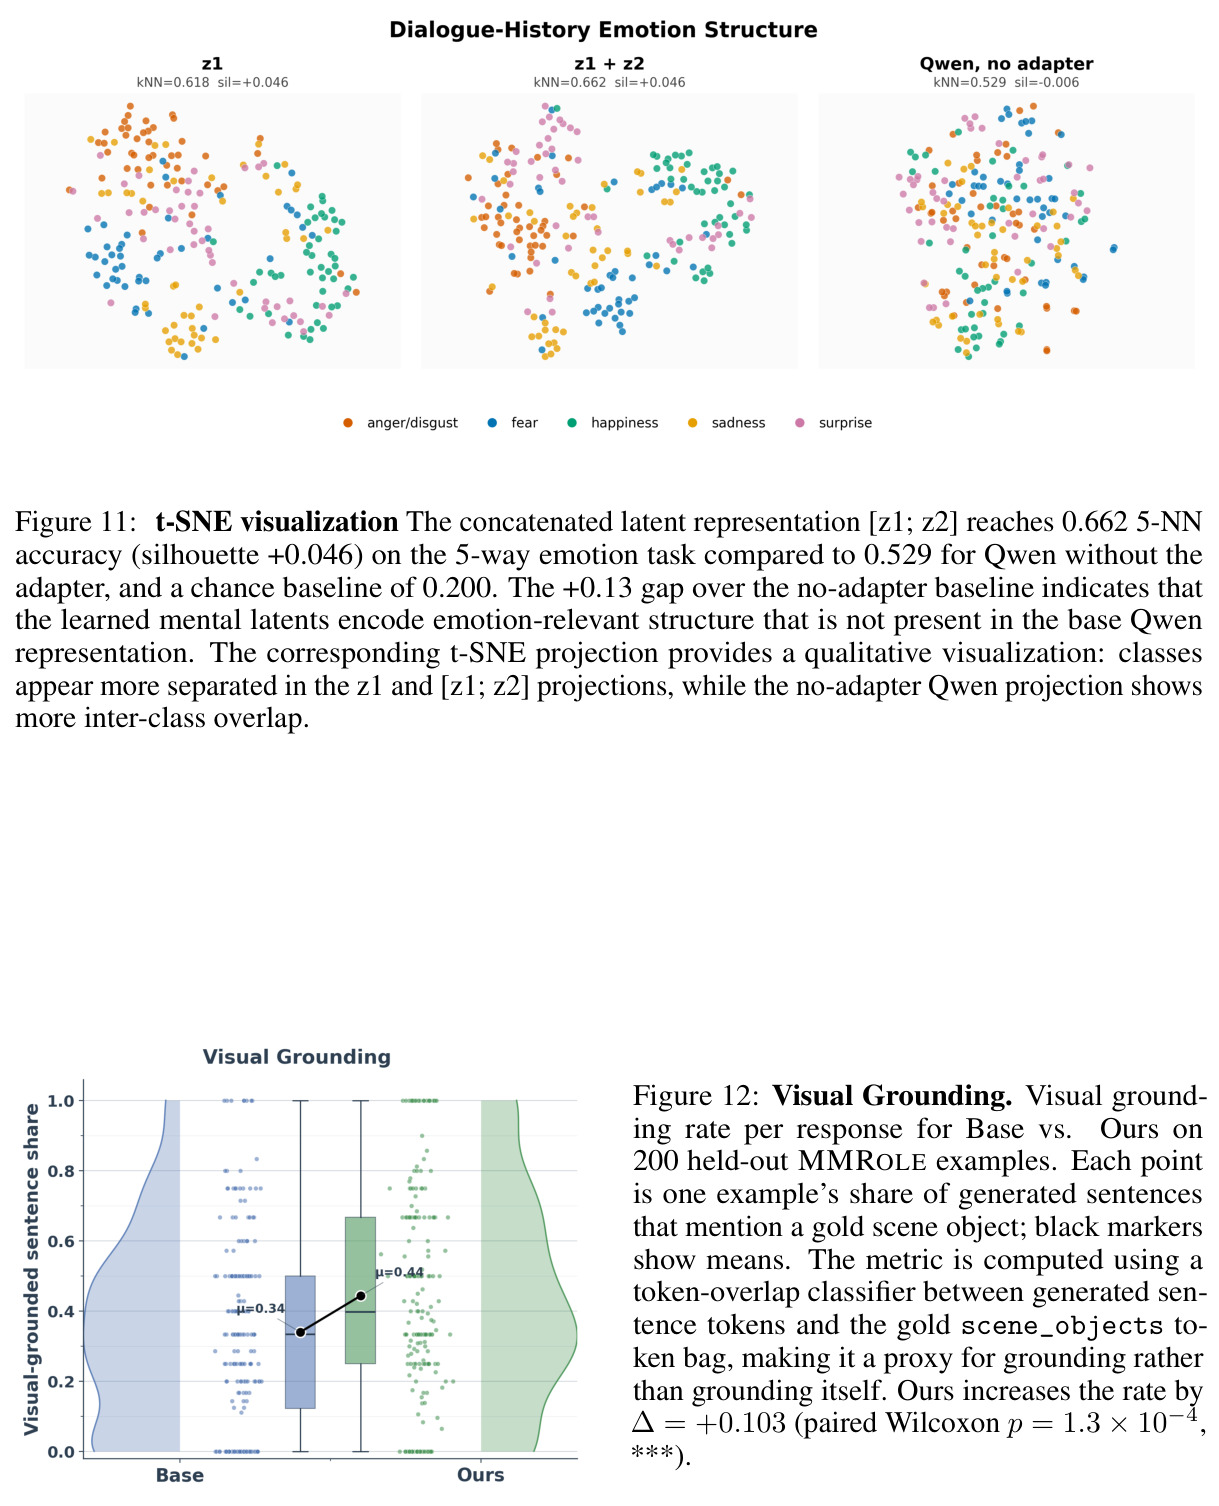
200 个留出 MMROLE 样本上的视觉落地率代理指标(生成句子提及黄金场景物体的比例):本文方法平均提升 Δ=+0.103(配对 Wilcoxon $p=1.3\times10^{-4}$),说明心理模型训练让角色回应更紧扣画面中的物体。
解释 MMROLE 提升的来源——不是表面模仿而是更充分利用视觉证据,是该基准结论可信度的关键检验。
与同维压缩 VAE 的探针可及性对比:冻结两编码器后训练轻量探针,心理 latent 在社会标签结构与奖励向量恢复上的 macro-F1/$R^2$ 均显著更高,说明递归心理目标不是单纯压缩上下文,而是围绕下游社会与奖励信号组织隐空间。
直接回应“心理模型是否只是压缩编码”的质疑,与 Figure 4a 形成互证。
三个 7B 开源模型(LLaMA2、Mistral、Qwen2.5)在 SOTOPIA-ALL 七个官方维度上的基座与本文对比:Overall 分别 3.330→3.541、3.511→3.784、3.290→3.856;Financial(Qwen 0.333→0.844)、Knowledge(5.144→6.611)、Goal(6.467→7.322)提升最大,Believability 稳定在 8.7-8.9。
主实验核心表,展示方法跨三个模型家族一致有效且不损害可信度。
对 GPT-4o-mini 伙伴与自我伙伴两个设置取平均:LLaMA 6.588→7.245、Mistral 7.109→7.552、Qwen 7.087→7.633,三个模型的 Goal/Knowledge 均提升且 Believability 略升。
证明收益不依赖特定伙伴模型,可跨闭源与开源对手迁移,回应“过拟合单一伙伴”的疑虑。
仅用 SOTOPIA 心理数据训练的模型零微调迁移到 CRAIGSLIST-BARGAIN 100 例谈判:GPT-4o-mini 成交 96%/放弃 3%;LLaMA2 基座 93%/7% 提升到 94%/1%;Qwen 基座 91%/7% 提升到 94%/1%,walkaway 大幅下降。
跨域迁移证据:学到的伙伴建模能力泛化到谈判任务,减少不必要谈判破裂。
BIGTOM 三类任务(forward belief/action、backward belief)在有无初始信念句两设置下的 TB/FB/TB∧FB:本文在配对指标上大幅领先开源对比(backward belief 无初始句 95.5 vs 基座 77.5、SFT 85.0;forward belief 带初始句 97.5 vs 基座 48.0),部分设置超过 GPT-4 zero-shot,接近 GPT-4 CoT 的 98。
TB∧FB 要求同时答对同一场景的真/假信念两分支,最能诊断反事实心理状态维持能力,是 ToM 主结果。
用 BIGTOM 风格数据训练的策略零样本迁移到结构不同的 TOMI:Average 87.92→89.16、Joint 55.16→60.46,非错误信念一/二阶问题(91.09/93.16)显著增强;经典专用基线(EntNet Joint 66.80)仍更高,因其绑定该合成格式。
OOD 泛化检查:学到的隐状态接口可跨基准复用,而非记住特定输出格式。
心理标注比例消融:0%(无心理监督的奖励基线)3.300、25% 3.650、50% 3.750、100% 3.856;仅 25% 标注即带来 +0.350 提升,收益随覆盖率单调增长。
回答实用性问题:方法不要求穷尽式标注,稀疏心理监督已有明显收益,降低落地门槛。
对角高斯与结构化全协方差后验 $\Sigma=\mathrm{diag}(\sigma^2)+UU^\top$ 对比:奖励准确率 96.6 vs 96.8、margin 均 1.05、信念探针 99.8 vs 99.9,0.2pp 差异在 ±0.65pp 采样不确定性内,更昂贵的协方差无可测收益。
为对角后验这一实现选择提供依据:跨坐标相关可由共享编码器和条件 $q(z^{(2)}|h,z^{(1)})$ 承担。