双层协调反思:多智能体LLM系统的博弈论方法 Bilevel Coordinated Reflection: A Game-Theoretic Approach to Multi-Agent LLM Systems
用双层博弈论刻画多智能体LLM反思,证明纯文本门控不可能并给出可证收敛的接地算法SRMA
前置知识
势博弈(Potential Game)
博弈论中的一类特殊博弈:存在全局势函数 $\Phi$,任意玩家单方面改变策略时,其自身效用变化与势函数变化始终同号(精确势博弈),或相差不超过一个小量 $\eta_c$(近似势博弈)。这一性质保证迭代\u201c更好响应\u201d更新使势函数单调上升,在有限动作集下有限步收敛到(近似)纳什均衡,是分析多智能体协调动态的标准工具(Monderer–Shapley 1996)。
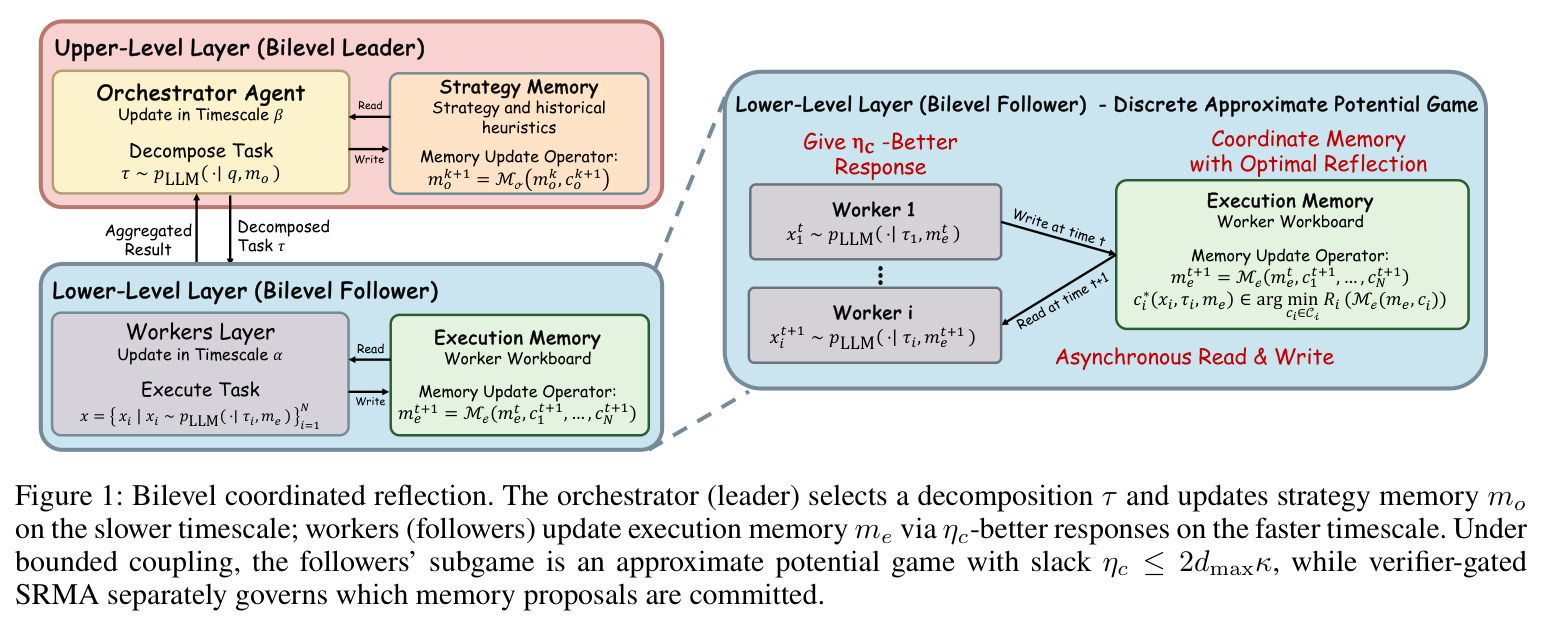
论文核心引理1证明:在弱耦合分解假设下,workers 子博弈是近似势博弈,slack 满足 $\eta_c \le 2d_{max}\kappa$,其中 $d_{max}$ 是交互图最大度、$\kappa$ 是跨工人耦合上界。这把\u201c编排者分解得好不好\u201d量化成一个可优化的均衡误差,是全文第一个理论支柱,不理解势博弈就读不懂定理1与推论1。
双层博弈与双时间尺度
双层优化中,领导者在上层选择影响下层问题的参数并预期跟随者的均衡反应,跟随者在下层求解自身最优;双时间尺度(Borkar 1997)指两层以不同速率更新,慢层近似看到快层的稳态。本文中 orchestrator 是 leader,慢时间尺度选任务分解 $\tau$ 并更新策略记忆 $m_o$;workers 是 follower,快时间尺度做 $\eta_c$-更好响应并更新共享执行记忆 $m_e$。
论文标题的 Bilevel 正指这一结构:leader 的目标含显式分解质量项 $C(\tau)=d_{max}(\tau)\kappa(\tau)$,推论1给出 $E[U]\ge J_{loc}-\frac{5}{2}NC(\tau)$;follower 收敛性由势博弈保证。两层各自由不同定理刻画,混淆时间尺度就无法理解为何可以分开分析。
随机漂移分析(Drift Analysis)
分析随机过程期望误差下降速度的工具箱:乘性漂移指 $E[V_{t+1}|\mathcal{F}_t]\le(1-\gamma)V_t+\nu$,推出有限时间界 $e_T\le(1-\gamma)^Te_0+\frac{\nu}{\gamma}(1-(1-\gamma)^T)$,渐近误差地板为 $\nu/\gamma$;可变漂移 $E[V_{t+1}|\mathcal{F}_t]\le V_t-cV_t^{1+\beta}$ 给出多项式速率 $T^{-1/\beta}$。源自随机逼近(Robbins–Monro)与随机搜索启发式(Doerr 等)。
论文把自由反思建模为语义记忆状态上的随机游走:定理2给出单边漂移下的上界(最坏情况紧),定理3在持久危害条件下给出匹配下界,定理5用乘性/可变漂移证明 SRMA 的几何或多项式收敛。所有核心定理都是漂移定理的实例化,且实测指数 $\hat\beta=0.52$ 可在线估计。
LLM-as-Judge 与自评估偏差
用 LLM 为自己或彼此生成的文本打分、挑错或决定是否采纳。大量实证(Zheng et al. 2023 的 MT-Bench 研究、Panickssery et al. 2024)表明模型存在相关性偏差:偏爱自己生成的文本,使自我评估系统性失真,纯文本裁判在实践中不可靠。Reflexion、Self-Refine 等自反思方法正依赖这种机制来改进输出。
论文把这一经验观察上升为定理4的信息论式不可能性:构造两个文本生成规律完全相同、但同一反思在 $\epsilon^+$ 中纠错、在 $\epsilon^-$ 中有害的环境对,证明任何只读 transcript 的随机化历史依赖门控(含理想文本裁判)在两环境中行为一致,故 $\max\{e_T^{\epsilon+},e_T^{\epsilon-}\}\ge e_0$;而接地门控可达 $e_T=e_0(1-\kappa\mu)^T\to 0$。
接地验证与 SWE-bench
接地(grounding)指门控信号依赖外部环境状态(测试执行、模拟器、形式检查器)而非仅由生成文本决定。SWE-bench 是500个真实 GitHub issue 修复基准,补丁必须通过官方仓库测试套件才算解决,测试执行天然提供了确定性接地验证器 $V$ 与评分 $\rho$,是论文端到端实验的主战场。
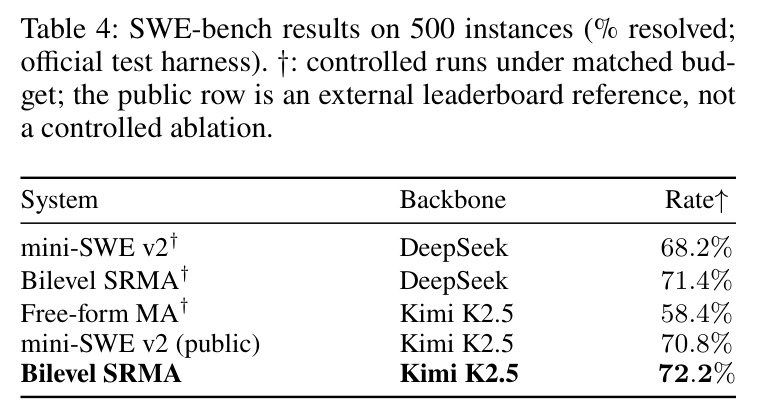
SRMA 每一步接受判断都依赖接地验证器风险的严格下降;SWE-bench 主结果为 Kimi K2.5 骨干下 Bilevel SRMA 解决 72.2%(361/500),超公开 mini-SWE-agent v2 的 70.8% 和同预算无门控多智能体的 58.4%。理解\u201c接地 vs 纯文本\u201d的分界才能解释这组数字为何支持理论。
研究动机
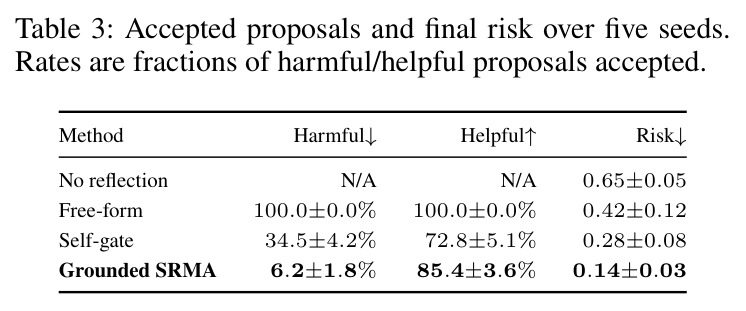
多智能体 LLM 系统已成为处理大型结构化任务的主流配方:orchestrator(如 AutoGen、MetaGPT、AFlow 等框架)把任务分解给一组 worker,团队通过\u201c反思\u201d——把批评、假设、经验写入共享文本记忆——来持续改进。由于模型权重测试期冻结,记忆编辑是唯一的主要适应通道。然而这些系统的主导描述是纯程序性的:现有框架只规定谁与谁通信、更新哪个缓冲区,却不说明智能体稳定化的战略对象是什么、反思改进的量是什么。这留下三个未解问题:分解质量如何控制工人协调?无条件反思何时会平台化(plateau)而不收敛?为何外部验证器能成功而更强的纯文本批评者可能失败?实践上,自由反思把纠错信息与幻觉信息混合在同一次记忆更新中(Table 3 显示自由反思对有害提案的接受率为 100.0±0.0%,最终风险 0.42±0.12),而 LLM-as-judge 的相关性自评偏差进一步削弱纯文本裁判的可靠性。
本文的目标是本文目标是在单一框架内回答上述三问,为多智能体 LLM 反思建立条件化、信息感知的理论:(1)把 orchestrator–worker 流水线建模为双层协调博弈,证明 follower 子博弈在弱耦合分解下是 slack 为 $\eta_c\le 2d_{max}\kappa$ 的近似势博弈,把分解质量与均衡误差直接挂钩(推论1:$E[U(x^*(\tau))]\ge J_{loc}(\tau)-\frac{5}{2}NC(\tau)$);(2)把文本记忆编辑建模为离散语义状态空间上的随机过程,对自由反思给出最坏情况紧的有限时间上界,并在可检验的\u201c持久危害承诺\u201d条件下给出普适下界,证明无条件承诺不足以保证收敛;(3)证明不可能性定理:文本不可区分的环境对上,仅观测 transcript 的门控无法一致改进,而接地门控可实现几何收敛;(4)据此设计 SRMA 算法,给出精确收敛速率、置信门控与再锚定扩展,并在 Resource Contest、Overcooked、SWE-bench 上验证。
与已有工作不同的是,独特切入有三。第一,把“分解质量”从模糊的工程直觉变成博弈论量:耦合上界 $\kappa$ 与交互图度 $d_{max}$ 的乘积直接进入均衡 slack $\eta_c=2d_{max}\kappa$ 和 leader 目标下界,使“怎么拆任务”第一次有了可推导、可优化的理论刻画——这是弱耦合团队问题(Srikant–Başar 1992)与势博弈理论在 LLM 多智能体上的首次系统嫁接。第二,把“要不要接地”从经验技巧上升为不可能性定理:构造文本层面完全不可区分、语义却相反的模糊环境对($C_0$ 类提案在 $\epsilon^+$ 中纠错、在 $\epsilon^-$ 中有害),证明即使无限文本处理能力的理想 LLM 裁判也无法一致超越自由反思,为 AutoGen 类系统引入外部测试/模拟器验证提供原则性辩护。第三,把漂移分析做成可证伪的闭环:速率指数 $\beta$ 可从接受频率在线回归估计(实测 $\hat\beta=0.52\pm0.04$,held-out Pearson $r=0.94$、RMSE=0.032),理论预测与实验可互相校验,这在多智能体 LLM 文献中罕见。
核心方法
直觉上,论文把“编排者分活儿、工人干活并写反思笔记”看成一个两层游戏加一条被门控的记忆通道。上层 leader(orchestrator)在慢时间尺度生成任务分解 $\tau\sim p_{LLM}(\cdot|q)$,把子任务 $\tau_i$ 分给 worker $i$ 并更新策略记忆 $m_o$;下层 followers 在快时间尺度基于共享执行记忆 $m_e$ 生成子解 $x_i\sim p_{LLM}(\cdot|\tau_i)$。全局效用 $U(x)=\sum_i u_i(x_i|\tau_i)+\sum_{(i,j)}\psi_{ij}(x_i,x_j)$,交互项有界 $|\psi_{ij}|\le\kappa$。引理1证明工人子博弈是以 $E[U(x)]$ 为势函数、slack $\eta_c\le 2d_{max}\kappa$ 的近似势博弈;定理1保证迭代 $\eta_c$-更好响应有限步收敛到近似纳什均衡。反思通道上,工人冻结权重、只编辑记忆:自由反思在单边漂移 $E[V_{t+1}|\mathcal{F}_t]\le(1-\gamma)V_t+\nu$ 下误差收敛到地板 $\nu/\gamma$,持久危害条件下还有匹配下界——所以必须换门控。SRMA 用固定接地评估协议计算验证器风险 $R_i(m_e)=\rho(V(g_i(\tau_i,m_e),\tau_i))$,只接受风险严格下降的候选记忆。
核心创新是与已有方法的三个本质区别。(1)势函数视角量化协调:AutoGen/MetaGPT 等只描述通信拓扑,本文证明工人子博弈是近似势博弈,slack 由 leader 可控的分解决定,leader 目标有显式下界 $E[U]\ge J_{loc}(\tau)-\frac{5}{2}NC(\tau)$——好分解同时抬高局部效用 $J_{loc}$ 并压缩耦合代价 $C(\tau)=d_{max}\kappa$,“分解质量”由此成为可推导的量。(2)不可能性定理改变辩论方式:以往“LLM 裁判靠不靠谱”是经验争论,本文用模糊对构造证明这是信息问题——两环境文本规律完全相同,只读文本的任何门控行为必然相同,最坏情况下 $\max\{e_T^{\epsilon+},e_T^{\epsilon-}\}\ge e_0$;接地门控接受纠错类后 $e_T=e_0(1-\kappa\mu)^T$ 几何归零,定理覆盖理想纯文本裁判。(3)SRMA 分离提议与评估:Reflexion/Self-Refine 无条件提交自评,本文要求候选记忆在固定评估协议下风险严格下降($\hat R_i<R_i$)才提交,并在校准($V_i\le LR_i$)与非退化纠错质量($p_t\ge c_1R_t^\beta$)下证明精确的几何($\beta=0$)或多项式($T^{-1/\beta}$)收敛,速率阶紧。
方法步骤详情
算法1(SRMA)针对单个 worker $i$,输入:子任务 $\tau_i$、接地验证器 $(V,\rho)$、确定性评估协议 $g_i$、记忆算子 $M_e$、初始记忆 $m_e^0$、预算 $T$。每轮 $t$:(1)用当前记忆生成执行输出 $x_i^t=g_i(\tau_i,m_e^t)$;(2)验证器诊断 $s_i^t=V(x_i^t,\tau_i)$,得风险 $R_t=\rho(s_i^t)$;(3)采样反思提案 $c_i^{t+1}\sim p_{LLM}(\cdot|x_i^t,s_i^t,\tau_i,m_e^t)$,诊断信号显式进入采样条件使反思有据可依;(4)形成候选记忆 $m_e^{t+1}=M_e(m_e^t,c_i^{t+1})$,在同一固定协议下重评得 $\hat R$;(5)仅当 $\hat R<R_t$ 严格下降才提交,否则回滚保留旧记忆。确定性风险不可得时,用 $K_t$ 个独立探针按 Hoeffding 不等式构造半宽 $\alpha_t$,接受条件收紧为 $\hat R(m^{t+1})+\alpha_t<\hat R(m^t)-\alpha_t$,以至少 $1-\sum_t\delta_t$ 概率保证每次接受严格降低真实风险(Proposition 4);分段平稳环境下,切换后重评当前与候选记忆实现再锚定(Proposition 5),最终分段内仍满足定理5的收敛率。
技术新颖性
新颖性有四。第一,理论工具的迁移是新的:弱耦合分解(假设1)+ 势博弈 slack(引理1)+ 乘性/可变漂移的证明链此前分属博弈论与随机搜索启发式文献,本文首次组合用于 LLM 冻结权重下的记忆编辑动力学,leader 外环只用有限 episode 仿射界而不做过强的渐近 regret 声明。第二,不可能性证明极简有力:用反射恒等式 $f_{1-a}(v)=1-f_a(1-v)$ 与共享随机源耦合,两环境接受相同类标签序列,立即得到 $e_T^{\epsilon+}+e_T^{\epsilon-}\ge 2e_0$,是 minimax 陈述而非经验归纳。第三,SRMA 收敛是精确的:几何情形 $r_T=(1-c)^Tr_0$($c=c_1c_2$)精确成立,多项式情形 $r_T\le r_0^{-\beta}+c^\beta T^{-1/\beta}$ 在构造下取等(Proposition 3),Prop 3 与 Prop 4 给出紧性与随机探针扩展,形成闭环。第四,理论可证伪:指数 $\beta$ 可由接受频率 $p_{acc}(R)\approx\min\{1,c_1R^\beta\}$ 与轨迹衰减两路独立估计,实测 $\hat\beta=0.52\pm0.04$、held-out 预测 $r=0.94$、RMSE=0.032。
实验结果
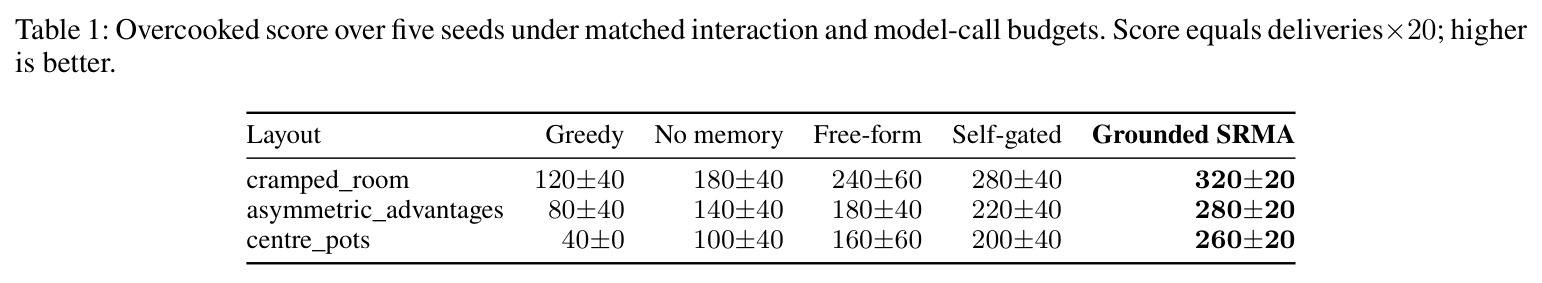
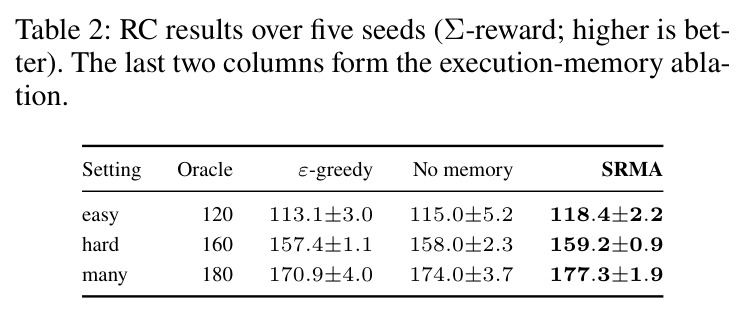
实验覆盖三个环境、五种子均值±标准差。(1)SWE-bench 全量500实例:Kimi K2.5 下完整双层系统(N=2 个 mini-SWE-agent v2 worker、至多3轮协调)解决 361/500(72.2%),对比同骨干无门控自由反思 58.4%(+13.8pt)与公开 mini-SWE-agent v2 榜单 70.8%;受控 DeepSeek 对照 71.4% vs 68.2%,说明增益来自接地门控而非算力。(2)Overcooked 三布局(BFS 验证器、预算匹配):接地 SRMA 得 320±20 / 280±20 / 260±20,较文本自门控提升 14.3% / 27.3% / 30.0%,首次送达步数 22±2 / 26±3 / 32±4;无记忆→自由反思→自门控→接地 SRMA 的单调排序分离分解、记忆、接地三效应。(3)Resource Contest:SRMA 达 oracle 的 98.5%–99.5%(118.4±2.2 / 159.2±0.9 / 177.3±1.9),执行记忆平均加 2.6 分、平均 regret 4.33→1.70(−60.8%)。(4)门级质量:有害提案接受率 6.2±1.8%(自门控 34.5%、自由反思 100%),有帮助接受 85.4±3.6%,最终风险 0.14±0.03 vs 0.28±0.08。(5)统计分辨率:一次性验证器误接受 28.4%,固定 K=5 降为 6.8%(225 次调用),自适应置信门以 82±14 次(−63.6%)达同级 7.1%。(6)漂移律:$\hat\beta=0.52\pm0.04$,held-out 预测 r=0.94、RMSE=0.032(约 $O(T^{-1.92})$)。(7)分段平稳:再锚定门 1.2±0.4 轮察觉切换、后切换 regret 12.6±2.8 vs 陈旧锚 38.2±5.5,纯文本门 20 轮内无察觉(85.4±4.2)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench(500 实例,官方测试 harness) | 解决率(% resolved) | 72.2%(361/500,Kimi K2.5 骨干) | 公开 mini-SWE-agent v2 70.8%;同骨干无门控自由反思多智能体 58.4%;DeepSeek 受控对照 68.2% | +1.4pt vs 公开榜;+13.8pt vs 同预算无门控;DeepSeek 受控 +3.2pt |
| Overcooked(三布局,交付×20 分) | 五种子平均得分(越高越好) | 320±20 / 280±20 / 260±20(接地 SRMA,全部布局最佳) | 文本自门控 280±40 / 220±40 / 200±40;自由反思 240±60 / 180±40 / 160±60;无记忆 180±40 / 140±40 / 100±40 | 较自门控 +14.3% / +27.3% / +30.0%,方差同步缩小 |
| Resource Contest(隐藏容量分配) | Σ-reward(oracle 分别为 120/160/180) | 118.4±2.2 / 159.2±0.9 / 177.3±1.9(oracle 的 98.5%–99.5%) | 无记忆 115.0±5.2 / 158.0±2.3 / 174.0±3.7;ε-greedy 113.1±3.0 / 157.4±1.1 / 170.9±4.0 | 执行记忆平均 +2.6 分;平均 regret 4.33 → 1.70(−60.8%) |
| 门控质量(RC + Overcooked,机制级) | 有害提案接受率 / 最终验证器风险 | 6.2±1.8% / 0.14±0.03(接地 SRMA) | 文本自门控 34.5±4.2% / 0.28±0.08;自由反思 100.0% / 0.42±0.12 | 有害接受率相对自门控降约 82%,最终风险减半 |
局限与改进
作者承认的限制:所有保证都是条件性的——有界耦合、有限动作集、验证器校准、非退化纠错质量在开放式 agent 任务中未必成立;漂移参数只在观测轨迹上验证(bootstrap 下界只是观测范围内的经验证书);不完整测试套件只保证验证器风险单调,不保证真实任务效用;再锚定只给分段收敛,无一般切换 regret 界;多智能体消耗大量 token;72.2% 对标的是公开 70.8% 榜单 run 而非严格同配置受控对比。我的观察:第一,校准假设 $V_i\le LR_i$ 的常数 $L$ 从未在 SWE-bench 上估计,测试通过率与真实代码质量差距可能很大,论文报告的 6.2% 残余有害率就是 verifier–oracle 失配的直接证据;第二,接地信号获取成本(每轮重评当前与候选记忆的测试执行、BFS 值表)在开放任务中可能高昂,论文未报告 token/调用开销与质量的 Pareto 曲线;第三,不可能性定理依赖模糊环境对的构造性存在,给出的是最坏情形保证,真实任务中文本与语义不可区分的程度未知;第四,N=2 worker、3 轮协调等超参未做敏感性分析。
独立分析的弱点
独立分析的弱点及改进方向:(1)条件假设难以在开放域检验——非退化纠错质量 $p_t\ge c_1R_t^\beta$ 在没有精确验证器的任务(写作、开放式研究)中无法验证;改进方向是发展只依赖可观测接受频率的诊断统计,在线检测假设是否近似成立。(2)随机评估的代价——Proposition 4 需要 $K_t$ 个独立探针,精确收敛要求 $K_t\to\infty$ 或 $\delta_t$ 可和;固定 K=5 用 225 次调用、自适应门 82 次,仍有压缩空间;改进方向是序贯概率比检验或 bandit 式自适应停止。(3)SWE-bench 主对比不严格——72.2% 对 70.8% 是受控系统 vs 公开榜单 run,配置差异可能贡献部分增益;改进方向是补同预算同配置的 mini-SWE v2 + 外部验证器对照行。(4)leader 外环理论薄弱——策略记忆 $m_o$ 只有有限 episode 仿射界,无分解选择的收敛或 regret 保证;改进方向是把 leader 建模为在线学习并给出分解空间上的次线性 regret。(5)成本未量化——门控每轮多一次完整评估且 N=2 worker 翻倍调用;改进方向是与预算感知终止联合优化,报告质量-成本 Pareto 前沿。
未来方向
作者提出的方向:联合优化记忆质量与预算感知终止,让系统在 token 预算约束下决定何时停止反思。基于本文成果可延伸的方向:(1)信息量-速率权衡:不可能性定理只区分\u201c纯文本 vs 接地\u201d二分,可量化部分接地信号(检索、工具返回、稀疏探针)的信息量如何转化为收敛速率,回答\u201c多少接地才够\u201d;(2)把再锚定从分段平稳推广到连续漂移环境,给出带切换惩罚的一般 regret 界,连接非平稳 bandit 文献;(3)异步多工人写入共享记忆的收敛性——当前引理1分析同步更好响应,而 Figure 1 已标注实际系统是异步读写;(4)把可估计的漂移指数 $\beta$ 用作运行时控制器:根据在线估计的 $\hat\beta=0.52$ 自动调节探针数 $K_t$、早停时机与记忆容量;(5)与参数化学习结合——记忆编辑作为非参数策略与 RL 微调互补,检验训练后校准常数 $L$ 是否自动改善;(6)扩展接地源形式(单元测试覆盖率、仿真置信区间、形式化规约),为不完美接地下校准假设建立实证估计管线。
复现评估
复现评估:代码已开源(https://github.com/YihangChen9/Bilevel-Coordinated-Reflection),论文声明完整 prompt、配置与逐种子轨迹在补充材料中。基准公开:SWE-bench 500 实例用官方测试 harness 判分,Overcooked 三布局配精确 BFS 验证器;Resource Contest 是自建隐藏容量分配环境,规则简单(容量 $M_i\in\{0,\dots,10\}$、oracle 奖励 120/160/180),易于重建。结果为五种子均值±标准差,关键对比均有受控消融(matched budget)。复现门槛中等偏高:需要商业 LLM API(Kimi K2.5、DeepSeek、MiniMax-M2.7),SWE-bench 全量运行需要大量模型调用与测试执行算力,SRMA 每轮还要额外重评当前与候选记忆的验证器调用;漂移参数估计(412 个门事件)需记录接受频率与风险轨迹日志。建议复现者从 Resource Contest 与 Overcooked 入手——环境轻、验证器精确、Table 1–3 数字最直接可对,SWE-bench 端到端可作为第二步。
论文图表
SRMA 伪代码,共14行:输入子任务 $\tau_i$、验证器 $(V,\rho)$、评估协议 $g_i$、记忆算子 $M_e$、初始记忆 $m_e^0$、预算 $T$。每轮 $t$ 依次执行:(1) 生成 $x_i^t\leftarrow g_i(\tau_i,m_e^t)$;(2) 验证器诊断并计算风险 $R_t\leftarrow\rho(V(x_i^t,\tau_i))$;(3) 采样反思 $c_i^{t+1}\sim p_{LLM}(\cdot|x_i^t,s_i^t,\tau_i,m_e^t)$;(4) 形成候选记忆 $m_e^{t+1}\leftarrow M_e(m_e^t,c_i^{t+1})$ 并在同一固定协议下重评 $\hat R$;(5) 仅当 $\hat R<R_t$ 时提交候选,否则回滚;最终返回 $m_e^T$。
算法是理论到实践的桥:十余行伪代码完整实现了“验证器门控下严格改进才提交”的核心机制,Proposition 4 的置信门即替换其中第8行的比较判断,是复现工作的直接依据。