CausGround:面向自适应具身规划的因果交互接地框架 CausGround: Causal Interaction Grounding for Adaptive Embodied Planning
免参数更新,把交互经验蒸馏为动作前置条件与效果,让MLLM长程规划成功率近乎翻倍
前置知识
动作前置条件与效果
前置条件指动作执行前世界必须满足的状态(如 $\mathsf{OPEN}(\text{fridge})$ 要求冰箱门可开、机器手为空),效果指动作成功执行后可靠发生的状态变化(如冰箱门状态变为 open)。经典符号规划(STRIPS/PDDL)用「前置条件→效果」刻画每个动作的因果语义,规划器据此判断动作可执行性并预测状态转移,是符号 AI 任务规划的基石。
CausGround 的全部核心就是把这种动作因果语义从符号系统搬进视觉 MLLM 规划器,库构建(提取 $\mathcal{C}(a(x))$ 与 $\mathcal{E}(a(x))$)和规划阶段的双向推理都建立在这对概念上。
因子化世界状态表示
将世界状态显式分解为对象集合 $O_t$ 与对象间关系集合 $R_t$:每个对象由语义类别加一组「属性-值」对描述(如 cup: graspable=true, color=blue),关系表示为带类型的二元边(如 $\mathsf{ON}(\text{cup},\text{table})$)。相比自由文本描述,因子化让每个状态因素可被单独寻址、匹配和比对,避免多个实体与动态属性纠缠在同一段文字里。
论文中观测、前置条件、效果三者共用同一因子化模式 $S_t=(O_t,R_t)$,才能把库中的因果知识逐因素「接地」到当前视觉观测上,这是全文方法成立的前提。
非参数化环境适应
指不更新模型权重、只在推理时借助外部信息(执行反馈、情景记忆、检索知识)让智能体适应新环境的方法。与之相对的是参数化适应(微调/强化学习),需要大量环境特定交互数据和反复优化,真实机器人场景成本极高。非参数化方法部署便宜、可跨环境共享,但经验若以非结构化轨迹存储则难以复用和接地。
CausGround 属于非参数化路线,理解它与微调/RL 路线的取舍、以及它相对已有记忆检索方法改进了什么,是把握论文动机与定位的关键。
受控干预与因果识别
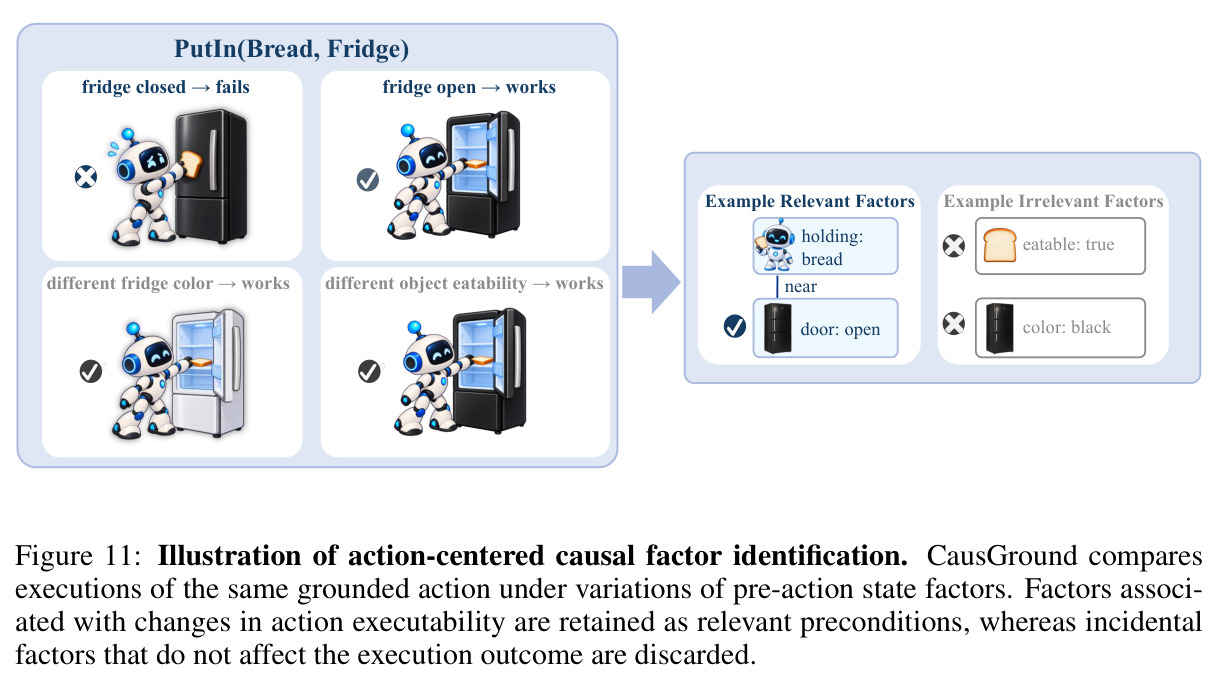
通过主动改变候选前置状态因素并观察动作成败是否随之变化,来判定哪些因素因果相关:违反某因素导致动作必然失败则保留为前置条件,改变某因素不影响结果则视为偶然因素丢弃。这正是「相关不等于因果」原则在交互经验中的应用,类似因果发现中的干预实验思想。
这是 CausGround 从轨迹中提炼因果知识(而非死记轨迹)的核心机制,Fig. 11 用 PUTIN(bread,fridge) 的对比实验直接展示了这一过程。
MLLM 高层规划与闭环执行
多模态大语言模型根据当前 RGB 观测和任务指令逐步输出语义级动作(如 GRAB(cup)、PUTIN(cup,fridge)),由环境或底层控制器执行,结果反馈给下一轮决策形成闭环。与一次性生成完整计划的 one-shot 模式相对,闭环重规划能根据真实状态纠错,但每步都依赖模型对动作可执行性的判断。
论文主实验就是视觉高层规划的 one-shot 与闭环重规划两种协议,且所有方法参数全程冻结,理解协议才能正确解读 Table 1 的数字。
研究动机
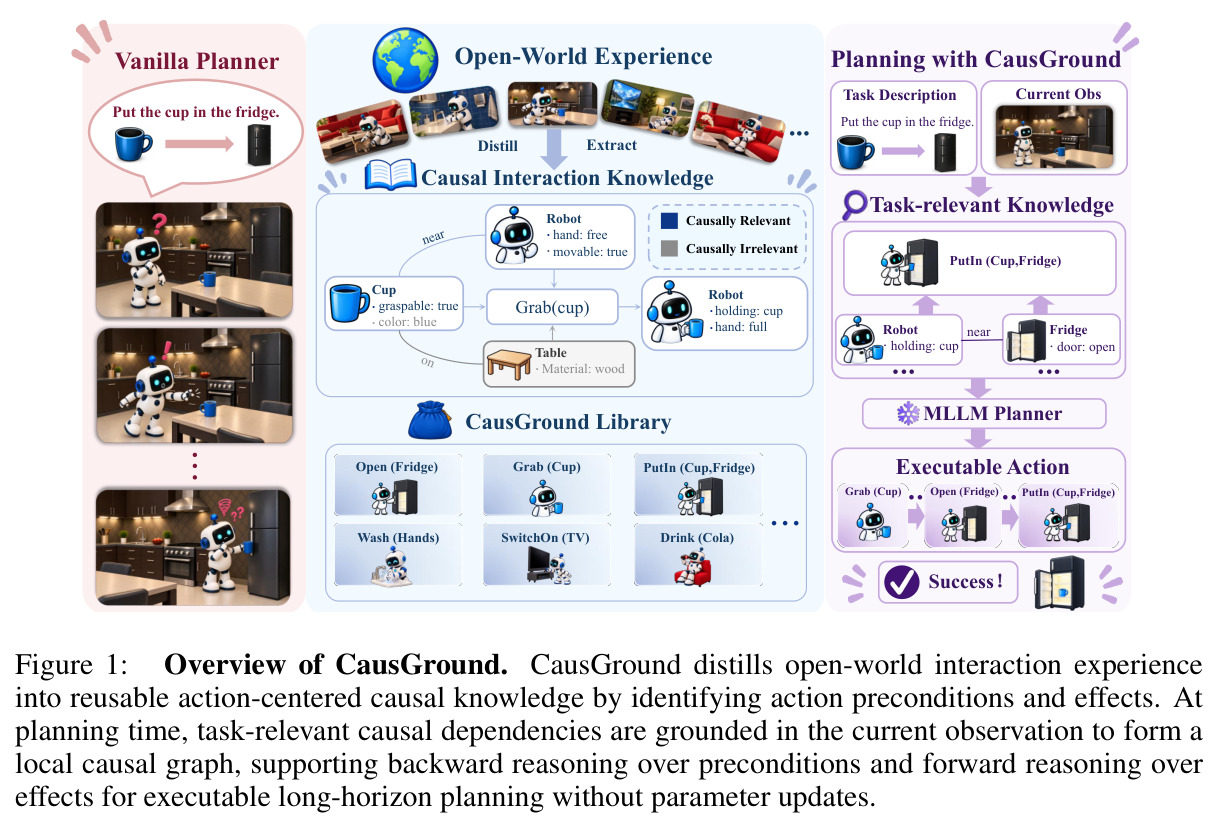
MLLM 具身智能体虽能生成看似合理的高层计划,却常在动作可执行性上犯错:例如任务是把杯子放进冰箱,模型可能直接输出 $\mathsf{PUTIN}(\text{cup},\text{fridge})$ 而没有先 $\mathsf{OPEN}(\text{fridge})$,违反了冰箱须打开这一前置条件。在长程任务(数十步动作序列)中,这类违背会不断累积,导致无效动作、反复重试和高昂试错成本——VirtualHome 实验中 Vanilla 规划器平均成功率仅 24.9%,长程任务甚至为 0%。更麻烦的是,动作前置条件和效果是环境相关的(不同环境中可执行动作、物体属性各不相同),MLLM 预训练知识无法完整覆盖。现有适应手段两条路都不理想:参数化路线(微调/RL)需要大量环境特定交互数据与反复优化,真实场景部署成本极高;非参数化路线把经验存成非结构化轨迹或任务级记忆,难以分辨哪些部分因果相关而非偶然,难以跨任务复用,也难以接地到当前视觉场景。此外,现有世界状态表示往往不能同时刻画判断前置条件所需的细粒度对象属性与对象间关系。
本文的目标是本文的目标是让冻结参数的 MLLM 规划器无需任何参数更新,就能适应新环境的交互动态。具体做法是把环境交互经验蒸馏成可复用的「以动作为中心」的因果知识:对每个接地动作明确回答两个问题——执行前什么必须为真(前置条件集 $\mathcal{C}(a(x))$)、执行后世界如何变化(效果集 $\mathcal{E}(a(x))$)。规划时将任务相关的因果依赖接地到当前观测,支持对前置条件的反向推理和对效果的正向推理。量化目标是在 VirtualHome、RoboCasa、SWITCH 与真实机器人等多样的长程具身设置上,相对 Vanilla 取得一致且显著的提升,并跨多个 MLLM 骨干(9B 到 38B、三个模型家族)成立,最终 VirtualHome 平均成功率从 24.9% 提升到 53.3%。
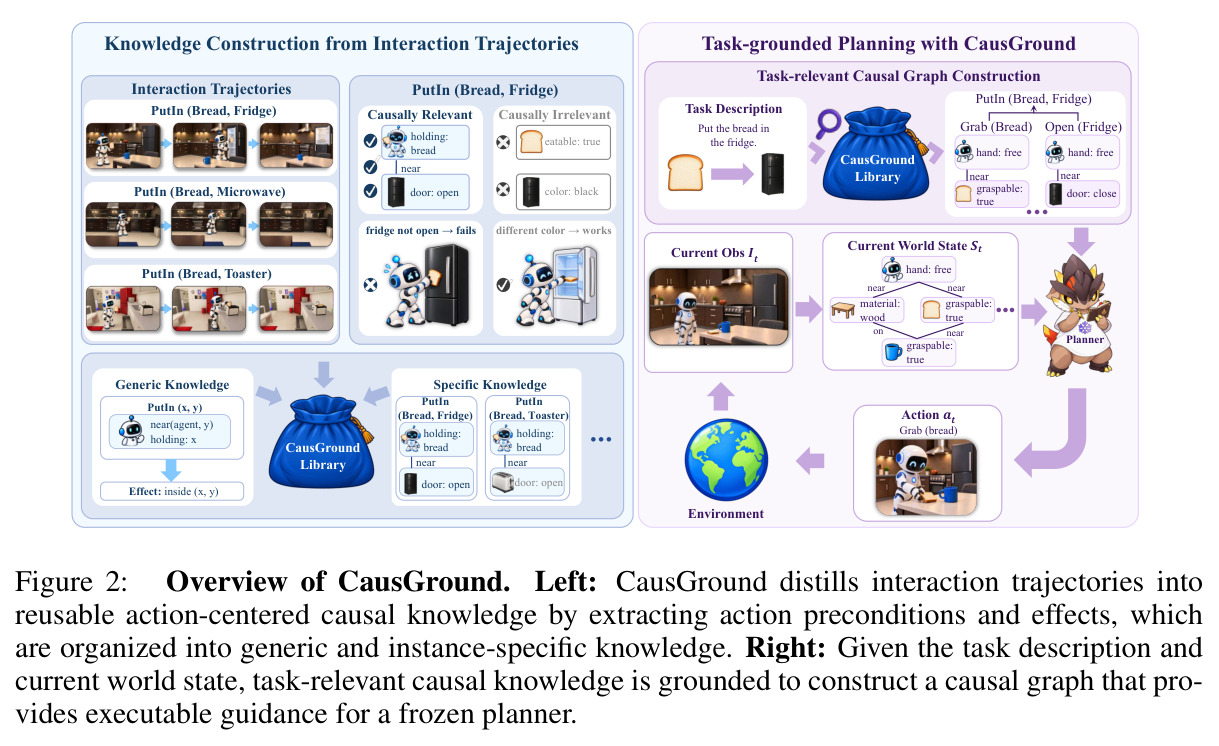
与已有工作不同的是,本文的独特切入点是「经验的因果化组织」。与 SelfReVision 等自由形式自我反思不同,它不增加不可靠的推理上下文;与 LookPlanGraph 等场景图记忆方法不同,它不只维护当前状态描述,而是提炼动作级的可复用因果规律;与世界模型规划器不同,它无需通过反复 rollout 来实例化跨动作依赖,而是把前置条件、效果和「一个动作的效果满足另一动作的前置条件」这类依赖关系作为显式知识直接供规划器复用。同时它坚持用同时包含对象属性与对象间关系的因子化世界状态作为观察与知识的共享接口,解决了自由文本表示纠缠实体、纯对象中心表示缺失关系的问题。库中知识还按通用/实例特定两级组织:如 $\mathsf{OPEN}(\text{fridge})$ 与 $\mathsf{OPEN}(\text{microwave})$ 共享「目标变为 open」的通用效果,但各自保留对象特定的前置条件。
核心方法
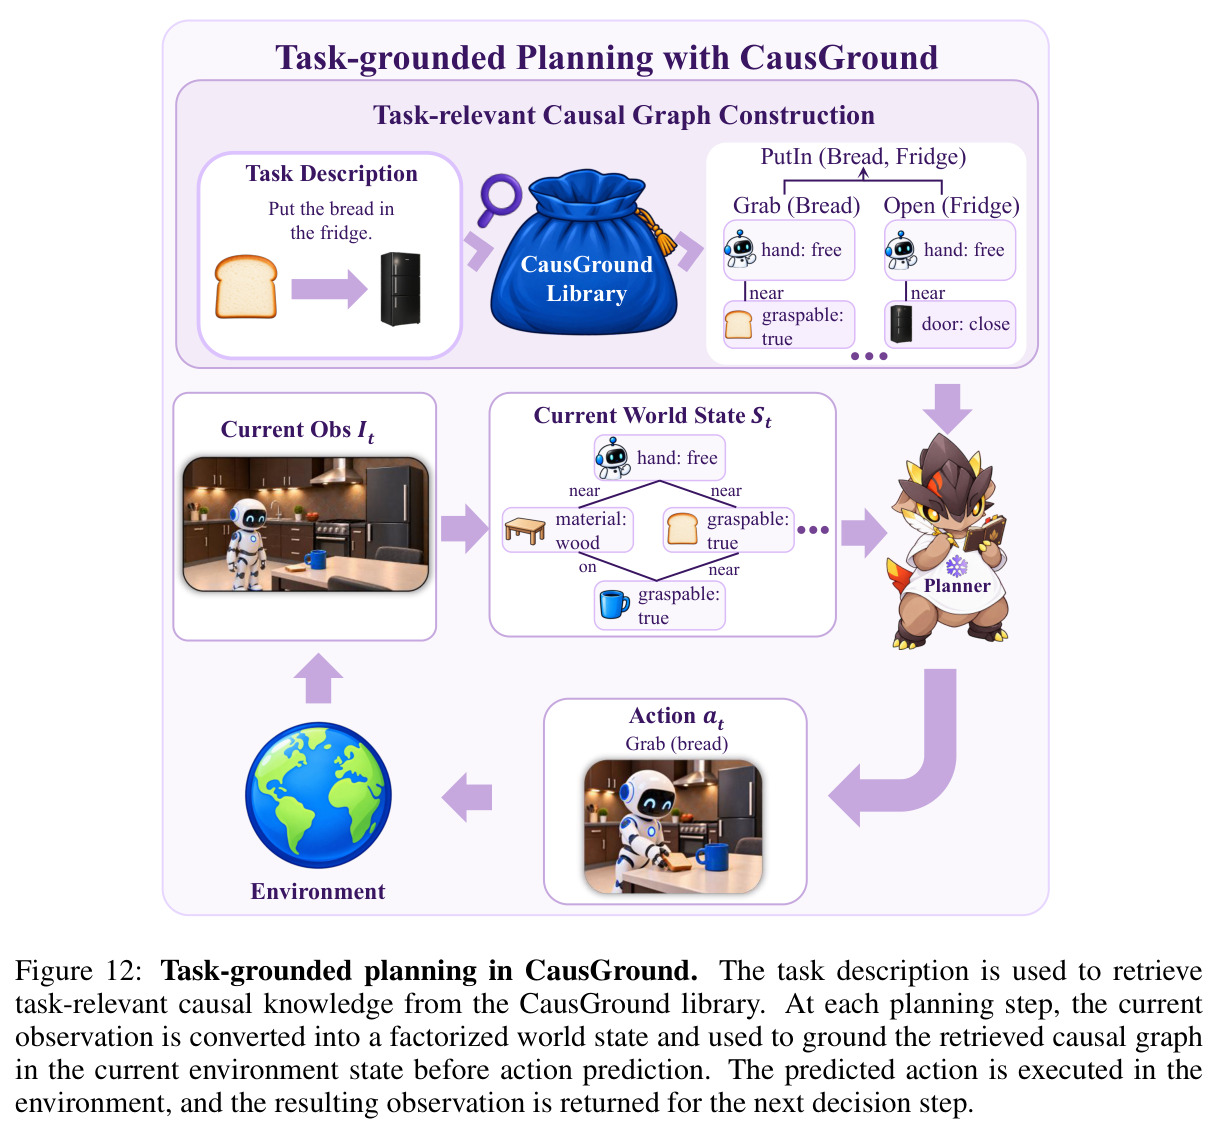
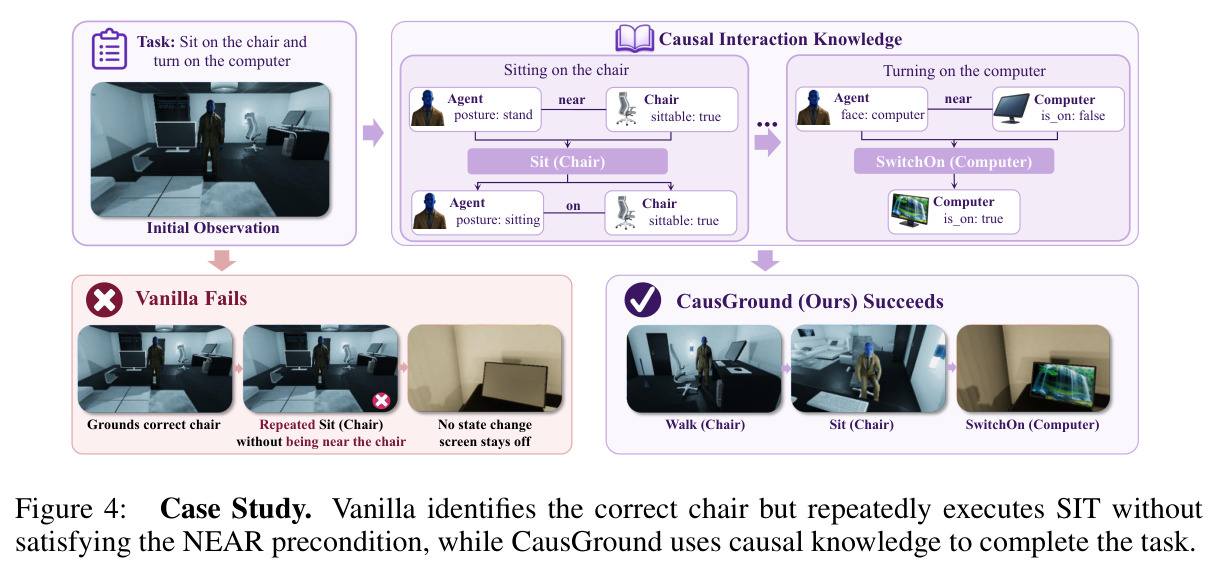
直觉上,CausGround 给规划器配了一本「动作说明书库」:每页记录一个动作「什么时候能做(前置条件)、做了会发生什么(效果)」。规划器接到任务后先挑出与任务相关的几页,再对照眼前的场景逐条核对条件,从而知道下一步该做什么、什么还不能做。技术上分两个阶段:第一阶段是因果交互知识构建——在因子化世界状态 $S_t=(O_t,R_t)$ 上,对每个动作族收集交互轨迹 $T_a=\{(S^i_{\text{pre}}, a(x_i), S^i_{\text{post}}, y_i)\}_{i=1}^{|T_a|}$,其中 $S_{\text{pre}}/S_{\text{post}}$ 是动作前后世界状态、$x_i$ 是动作参数、$y_i$ 是执行结果;通过对比成功与失败案例提炼前置条件集 $\mathcal{C}(a(x))$ 和效果集 $\mathcal{E}(a(x))$,并按通用性分层组织成知识库。第二阶段是任务接地规划——把任务描述解释为目标状态并反向推理得到 $K_{\text{causal}}$,再语义检索相关知识得到 $K_{\text{sem}}$,二者合并为 $K_{\text{task}}=K_{\text{causal}}\cup K_{\text{sem}}$;冻结规划器依据当前观测 $I_t$、世界状态 $S_t$、任务 $g$ 和 $K_{\text{task}}$ 逐步选择动作 $a_t=\pi_\theta(I_t, S_t, g, K_{\text{task}})$。
核心创新是把交互经验从「存储轨迹」改为「提炼因果」。已有非参数化方法把经验保留为完整轨迹或情节记忆,复用时只能整段检索,难以区分因果因素与偶然因素;CausGround 以动作为原子单元做因果识别:只有当违反某状态因素会导致动作必然失败时才保留为前置条件(如 $\mathsf{PUTIN}(\text{bread},\text{fridge})$ 在冰箱关闭时失败、打开时成功,故 door:open 是前置条件),而改变冰箱颜色不影响结果故被丢弃;效果同理只保留成功执行后一致出现的状态变化。与已有方法的本质区别有三:其一,知识是动作中心且因果纯净的,天然可跨任务复用;其二,知识与观测共用因子化模式,可与当前视觉场景逐因素匹配接地,而非悬空的文本提示;其三,效果与前置条件之间建立「生产者依赖」边(动作 A 的效果满足动作 B 的前置条件则连接二者),使多步规划成为因果图上的组合推理而非重新想象。整个过程规划器参数完全冻结,跨环境部署只需换知识库。
方法步骤详情
第一步,因子化状态提取:冻结 MLLM 把 RGB 观测 $I_t$ 解析为 $S_t=(O_t,R_t)$,每个对象 $o_i=(c_i,A_i)$,$A_i=\{(k_{ij},v_{ij})\}_{j=1}^{M_i}$ 为属性-值对,关系 $r_{ij}$ 是带类型边(如 $\mathsf{ON}(\text{cup},\text{table})$、$\mathsf{INSIDE}(\text{cup},\text{fridge})$)。第二步,知识库构建:在 VirtualHome 等可控环境中主动干预候选前置因素收集轨迹;每个属性-值对或关系作为原子候选前置条件,聚合同一接地动作 $a(x)$ 的轨迹,保留「满足与否一致区分成败」的因素进 $\mathcal{C}(a(x))$;对比成功执行的执行前后状态,保留一致变化进 $\mathcal{E}(a(x))$;跨实例比较抽象出通用知识 $K_{\text{gen}}(a)$ 与实例特定知识 $K_{\text{spec}}(a(x))$;效果满足其他动作前置条件时建立依赖边。VirtualHome 库最终含 58,458 条动作超边记录、归并为 5,614 条归一化规则(覆盖 40 个动作族、193 种语义节点、28 类属性、6 类关系);RoboCasa 库含 98 个接地动作机制(8 个动作族、225 种语义类型、254 条条件记录、416 条效果记录)。第三步,任务接地规划:每集开始时一次性构建 $K_{\text{task}}$;每步将当前观测转为因子化状态,判定哪些条件已满足、哪些候选动作可执行,规划器输出单个语义动作,执行后用新观测和成败历史更新局部状态,检索到的因果子图本身保持不变。
技术新颖性
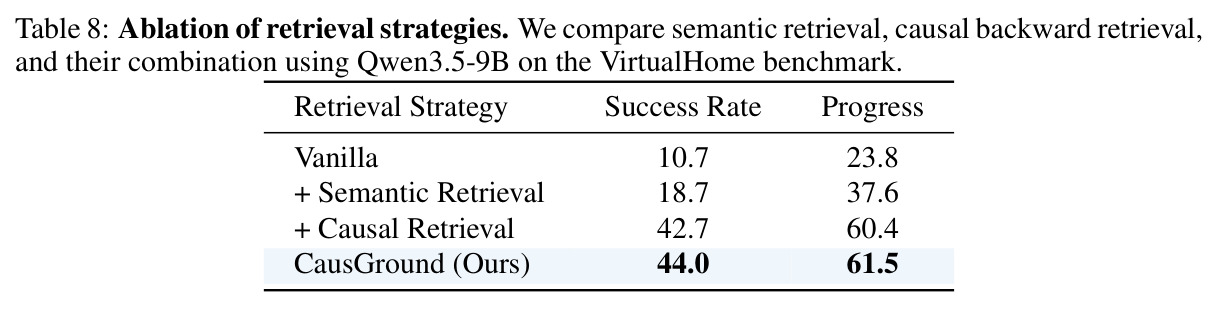
新颖性体现在四个层面。表示层面:同时保留对象属性与对象间关系的因子化世界状态,修正了自由文本表示纠缠实体、对象中心表示缺关系的缺陷。知识获取层面:用受控干预(VirtualHome)或严格一致性准则(RoboCasa/SWITCH,候选前置条件只要有一次缺席于成功执行即被排除)做因果识别,而非朴素轨迹存储或统计共现,保证知识「因果纯净」。组织层面:通用/实例特定两级抽象兼顾可复用性与环境特异性,类似以动作为中心的知识编译。规划层面:显式的效果→前置条件依赖边让跨动作约束无需 rollout 即可组合,规划成本是每任务一次检索加逐步接地,而世界模型方法需要反复模拟;与经验学习方法(如 EXPEL/Voyager)相比,提炼出的是结构化因果规则而非经验条目;与谓词学习方法(如 INTERPRET)相比,它同时建模前置条件与效果并支持双向推理。消融也佐证:纯语义检索只把 9B 成功率从 10.7% 提到 18.7%,因果反向检索则提到 42.7%,说明新检索机制是增益主源。
实验结果
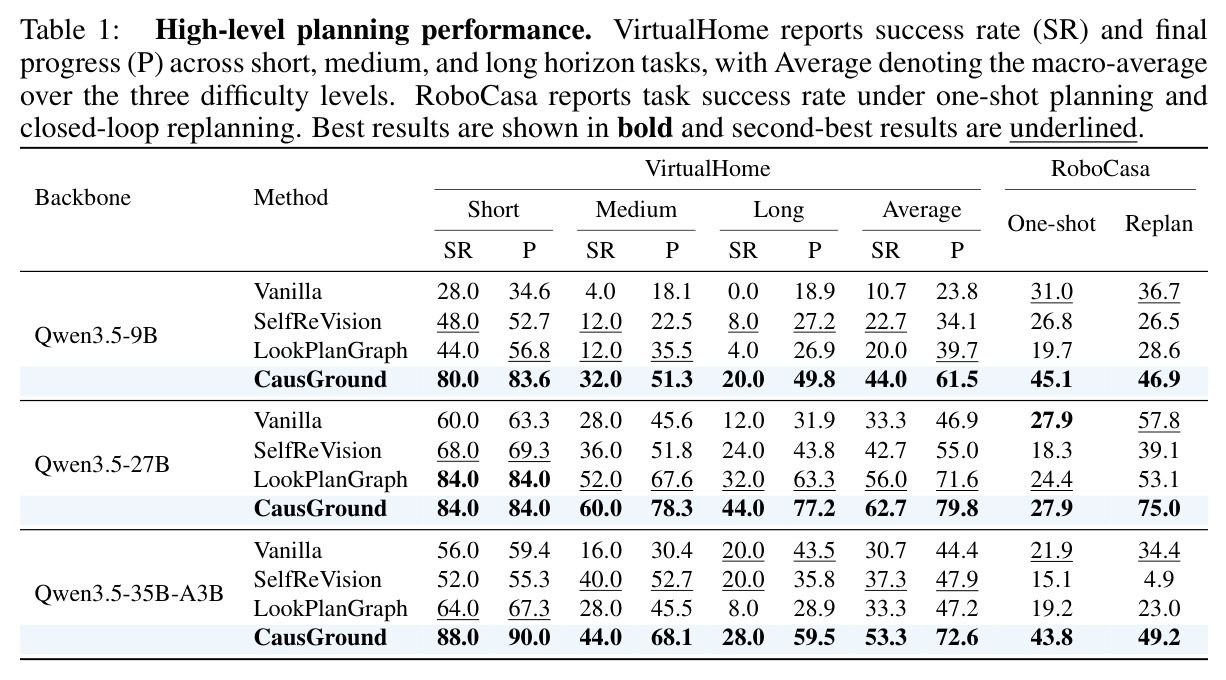
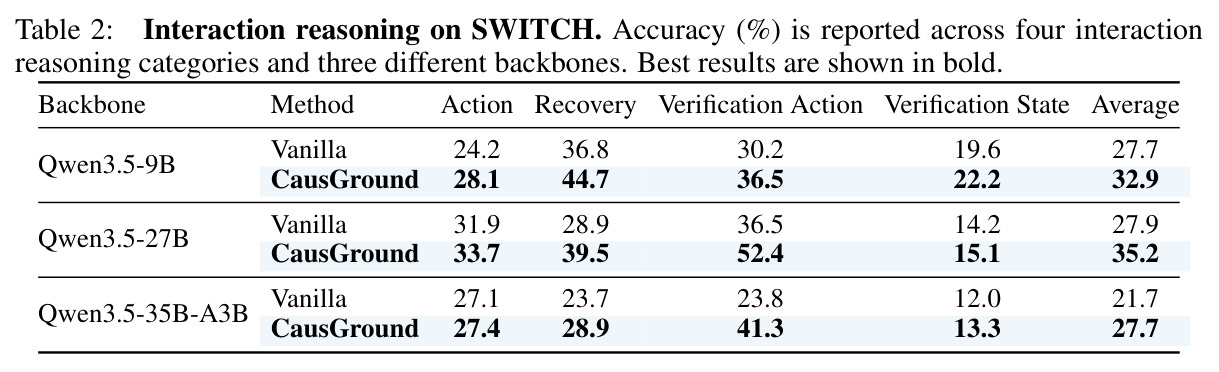
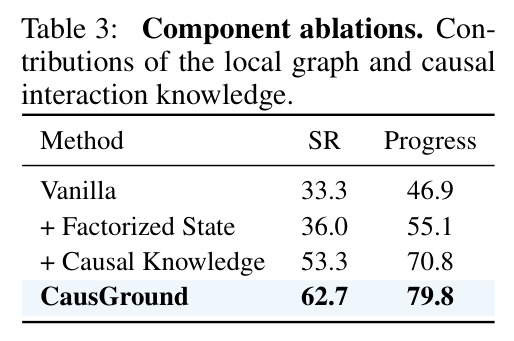
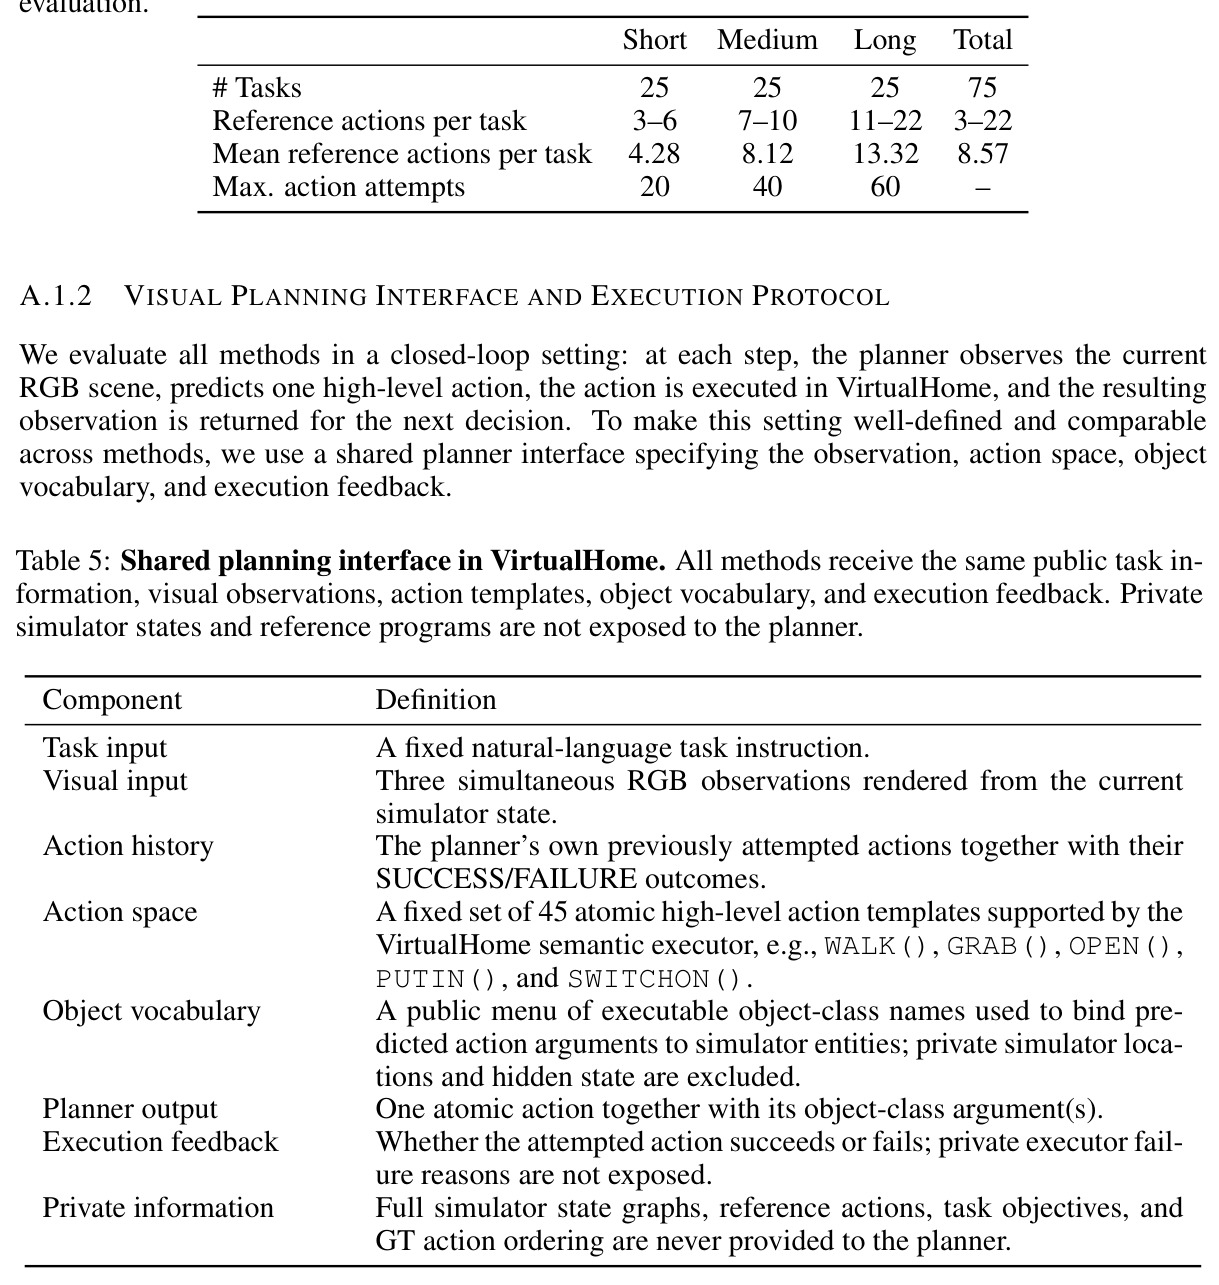
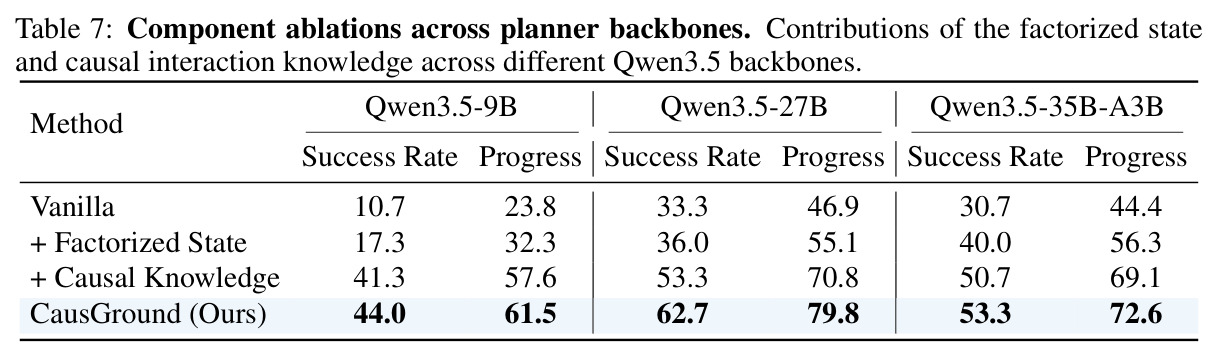
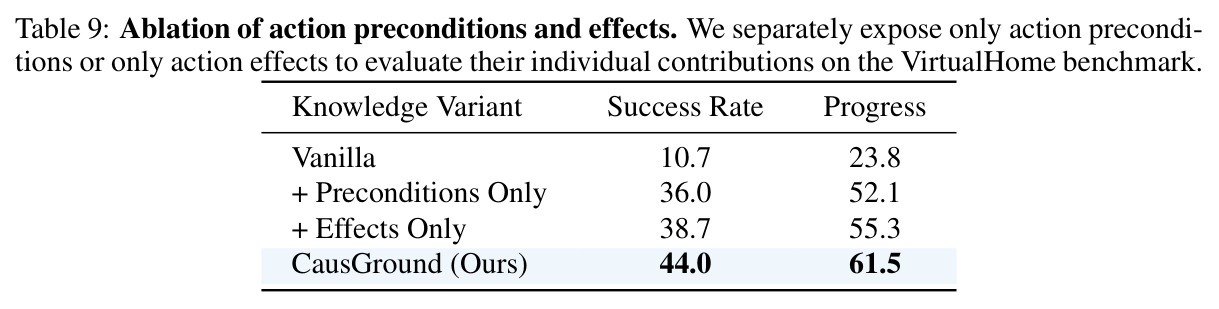
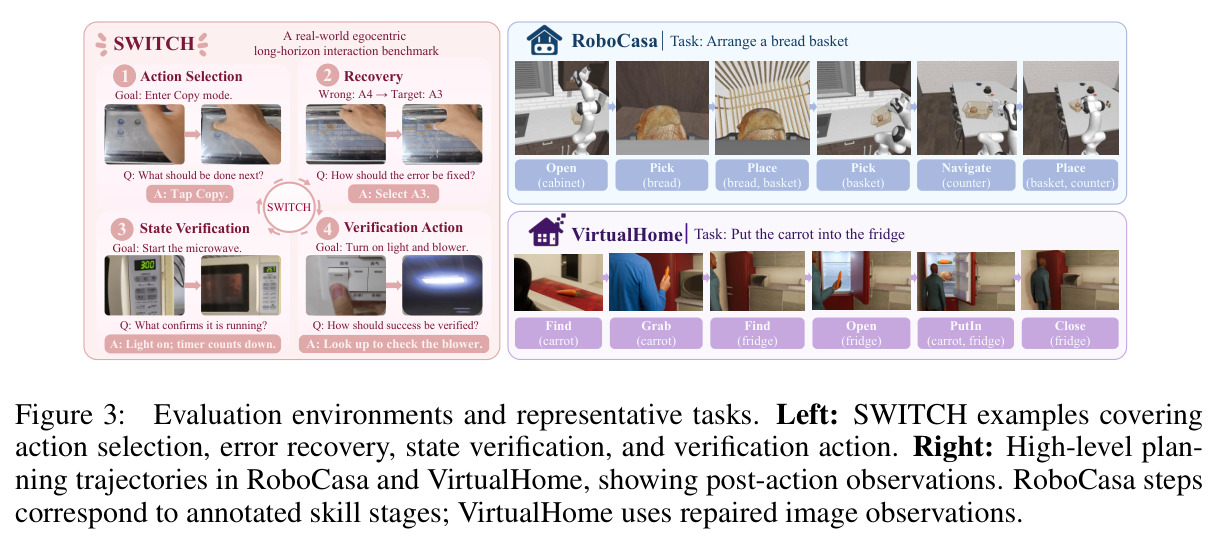
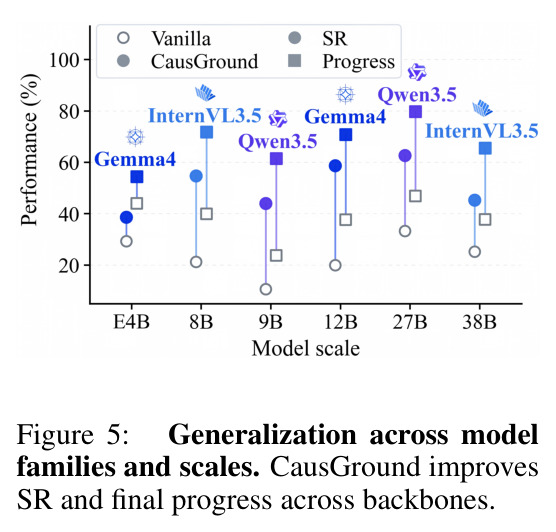
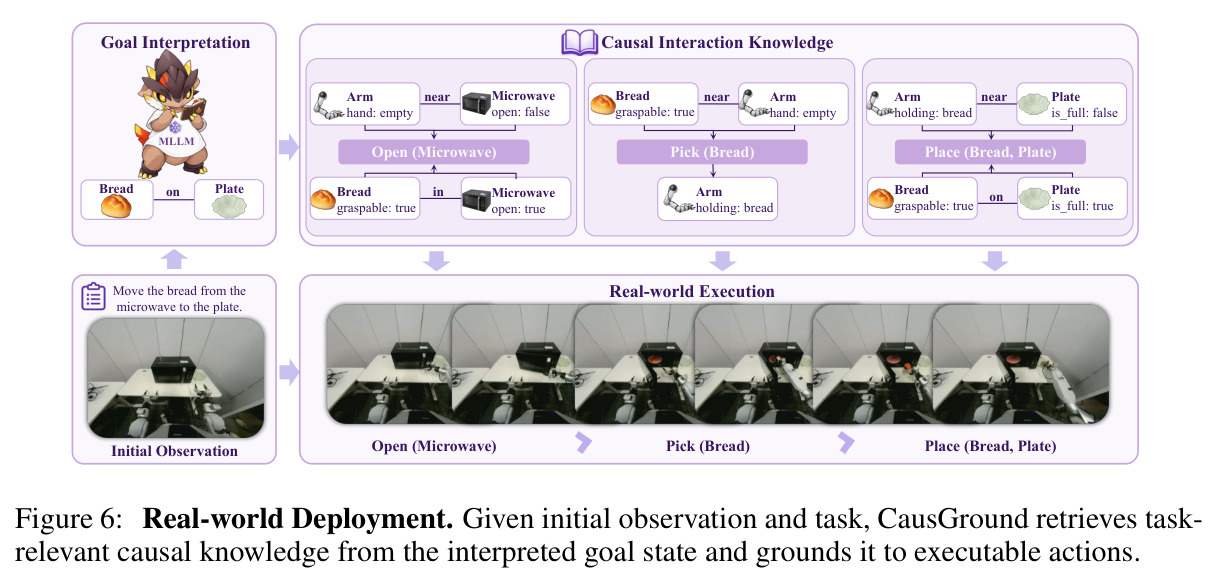
在适配后的 VirtualHome 视觉规划基准(75 个任务分 Short/Medium/Long 三档、每档 25 题,共 643 个参考动作,交互预算 20/40/60 步)上,CausGround 把平均成功率从 Vanilla 的 24.9% 提高到 53.3%,平均进度从 38.4% 提高到 71.3%,且在全部三个骨干、全部三个难度上均为最佳:9B 上 10.7%→44.0%(进度 23.8%→61.5%),27B 上 33.3%→62.7%(46.9%→79.8%),35B-A3B 上 30.7%→53.3%(44.4%→72.6%);长程任务提升尤为显著(27B:12%→44%)。RoboCasa 上,one-shot 规划平均成功率 26.9%→38.9%,闭环重规划 43.0%→57.0%(27B 重规划 57.8%→75.0%)。值得注意的是两个结构化基线反而可能差于 Vanilla:SelfReVision 在 35B-A3B 重规划仅 4.9%,LookPlanGraph 也常低于 Vanilla,说明自由反思会引入无依据的前提(如臆测物体在柜内而插入多余 OPEN)、离散场景图会传播感知错误(如把关闭的微波炉误判为开)。SWITCH 交互推理(768 题、4 类)上平均准确率 25.8%→31.9%,四类均有一致提升(如 27B 的 Verification Action 36.5%→52.4%)。跨家族实验覆盖 Qwen3.5、InternVL3.5、Gemma4 六个模型(E4B~38B),平均 SR 23.3%→50.7%、进度 38.4%→67.3%,证明增益不依赖特定家族或规模。消融显示因果知识贡献大于因子化状态(27B:+因果知识 53.3%、+状态 36.0%、完整 62.7%);因果反向检索是主要增益来源(9B:+语义 18.7%、+因果 42.7%、完整 44.0%);前置条件与效果单独均有效(9B:36.0% 与 38.7%),合并最佳 44.0%。真机实验中,CausGround 从 MLLM 解释的目标状态反向推理出 OPEN(Microwave)→PICK(Bread)→PLACE(Bread,Plate) 等可执行序列,双臂机器人成功完成「把面包从微波炉移到盘子」及多物体顺序操作。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VirtualHome 视觉高层规划(三骨干宏平均) | 成功率 SR | 53.3% | Vanilla 24.9% | +28.4 个百分点 |
| VirtualHome 平均任务进度(三骨干宏平均) | Progress | 71.3% | Vanilla 38.4% | +32.9 个百分点 |
| VirtualHome 长程任务(Qwen3.5-27B) | 成功率 SR | 44.0% | Vanilla 12.0% | +32.0 个百分点 |
| RoboCasa 闭环重规划(三骨干平均) | 成功率 | 57.0% | Vanilla 43.0% | +14.0 个百分点 |
| RoboCasa 闭环重规划(Qwen3.5-27B) | 成功率 | 75.0% | Vanilla 57.8%(SelfReVision 39.1%、LookPlanGraph 53.1%) | +17.2 个百分点 |
| RoboCasa one-shot 规划(三骨干平均) | 成功率 | 38.9% | Vanilla 26.9% | +12.0 个百分点 |
| SWITCH 交互推理(768 例,三骨干平均) | 准确率 | 31.9% | Vanilla 25.8% | +6.1 个百分点 |
| 跨家族泛化(6 模型平均,VirtualHome) | 成功率 SR | 50.7% | Vanilla 23.3% | +27.4 个百分点 |
| 组件消融(Qwen3.5-27B) | 成功率 SR | 62.7%(完整) | Vanilla 33.3%、+因子化状态 36.0%、+因果知识 53.3% | 完整版最高,两组件互补 |
| 检索策略消融(Qwen3.5-9B) | 成功率 SR | 42.7%(因果反向检索) | +纯语义检索 18.7% | +24.0 个百分点(因果 vs 语义) |
| 前置条件/效果消融(Qwen3.5-9B) | 成功率 SR | 44.0%(二者结合) | 仅前置条件 36.0%、仅效果 38.7% | 结合后最佳,二者互补 |
局限与改进
作者未设专门局限章节,但文中信息透露了边界。其一,VirtualHome 原生渲染偶尔产生与模拟器状态不一致的图像,本文用 Qwen-Image-Edit-2511 做观测修复,虽有受约束的编辑提示和确定性一致性校验加人工检查,但评测观测部分由生成式编辑产生,可能与真实渲染分布有偏差。其二,RoboCasa 评测通过重放官方轨迹实现,预测动作若无对应轨迹分支记为 UNKNOWN 并从对比中剔除,任务空间受官方轨迹覆盖限制。其三,知识库构建依赖环境内交互:VirtualHome 需要大规模受控干预(58,458 条记录),真实环境难以做到,真机实验只验证了推理阶段而非知识获取阶段。其四,SWITCH 上提升相对温和(+6.1 个百分点),Verification State 类提升有限(27B 仅 14.2%→15.1%)。我自己的观察:$K_{\text{task}}$ 在任务开始时一次性构建、执行期间固定,无法根据执行中的意外(动作失败揭示新因果)在线更新知识;MLLM 提取因子化状态若有错会直接误导接地;真机只演示了开环序列执行(低层由既有控制器完成),未展示闭环重规划与动态扰动;知识库是环境特定的,跨环境迁移能力未验证。
独立分析的弱点
第一,知识获取的可行性瓶颈:受控干预要求能主动重置和操纵环境状态,这在真实世界成本高且危险,论文真机部分回避了这一步。改进方向:从被动的人类操作视频或互联网视频挖掘因果规则,并为规则附加置信度、部署时在线验证。第二,知识静态性:$K_{\text{task}}$ 每集固定,若执行中动作意外失败(说明某前置条件缺失或效果不成立),框架没有机制把这次失败反哺进库或更新当次规划。改进方向:引入在线规则修订与置信度更新(类似 EXPEL 的经验学习循环),或失败驱动的局部因果图修复。第三,对 MLLM 状态提取的强依赖:因子化状态和接地全部由冻结 MLLM 完成,感知错误(如把关闭的微波炉看成开)会级联进因果匹配——这正是 LookPlanGraph 的失败模式,也可能困扰本方法。改进方向:为关键状态因素接入主动验证动作(论文 SWITCH 的 Verification 类别已提示此思路),或在接地时对不可观测因素显式标注「未知」并触发信息获取行为。第四,评测协议的 UNKNOWN 剔除机制虽取共享子集,仍可能引入选择偏差,不同方法的可评判分支分布不同。第五,高层规划与低层控制完全解耦,真机演示未报告低层执行成功率,端到端可用性有待验证;改进方向是与低层技能策略闭环集成并报告完整任务成功率。
未来方向
作者方向上,结论强调显式因果交互知识可作为跨环境的可复用接地基座,未来自然延伸包括:让知识库在部署中持续生长,从每次执行的成功/失败中在线提取新规则、修订旧规则;把因果图与世界模型结合,用效果做前瞻模拟、用前置条件剪枝候选动作以减少 rollout 次数;扩展到动态与多智能体环境(物体被他人移动时因果图如何重接地);从人类视频学习因果知识以摆脱对模拟器干预的依赖。基于成果可延伸的方向:真机闭环验证——把 SWITCH 式主动验证接入规划循环,让机器人在关键动作后主动确认状态变化再继续;跨环境知识迁移与组合,把通用层 $K_{\text{gen}}$ 作为先验、只需为新环境补实例特定层 $K_{\text{spec}}$;在知识库中引入不确定性建模,支持「探索性执行」主动补全未知前置条件;以及分析因果知识对上下文长度、推理延迟的影响,给出效率-性能权衡曲线。
复现评估
复现条件较好但工程量不小。论文提供了详尽附录:基准构建与评测协议(附录 A)、方法细节(附录 B)、全部 prompt 模板与基线适配(附录 C)、额外消融(附录 D)、真机部署(附录 E),并有项目主页 causground.github.io;文中未明确承诺代码开源,需关注项目页确认。所用基准均为公开资源(VirtualHome、RoboCasa、SWITCH),骨干为公开权重模型(Qwen3.5-9B/27B/35B-A3B、InternVL3.5-8B/38B、Gemma4 E4B/12B),另有 Qwen-Image-Edit-2511 做观测修复。算力需求:推理阶段全部参数冻结,主要是推理 9B~38B 模型的显存成本;知识库构建需大量模拟器交互(VirtualHome 58,458 条记录、归并为 5,614 条规则),模拟成本低但需自行实现干预协议;真机部分用双臂机器人,无硬件者可跳过。难度评估:仿真复现中等偏上——因子化状态提取、受控干预、检索接地的 prompt 工程量大且论文只给了模板骨架与规则统计,观测修复与一致性校验流程也需自建。整体而言方法无需训练、思想清晰,主要难点在知识库构建管道的工程细节。
论文图表
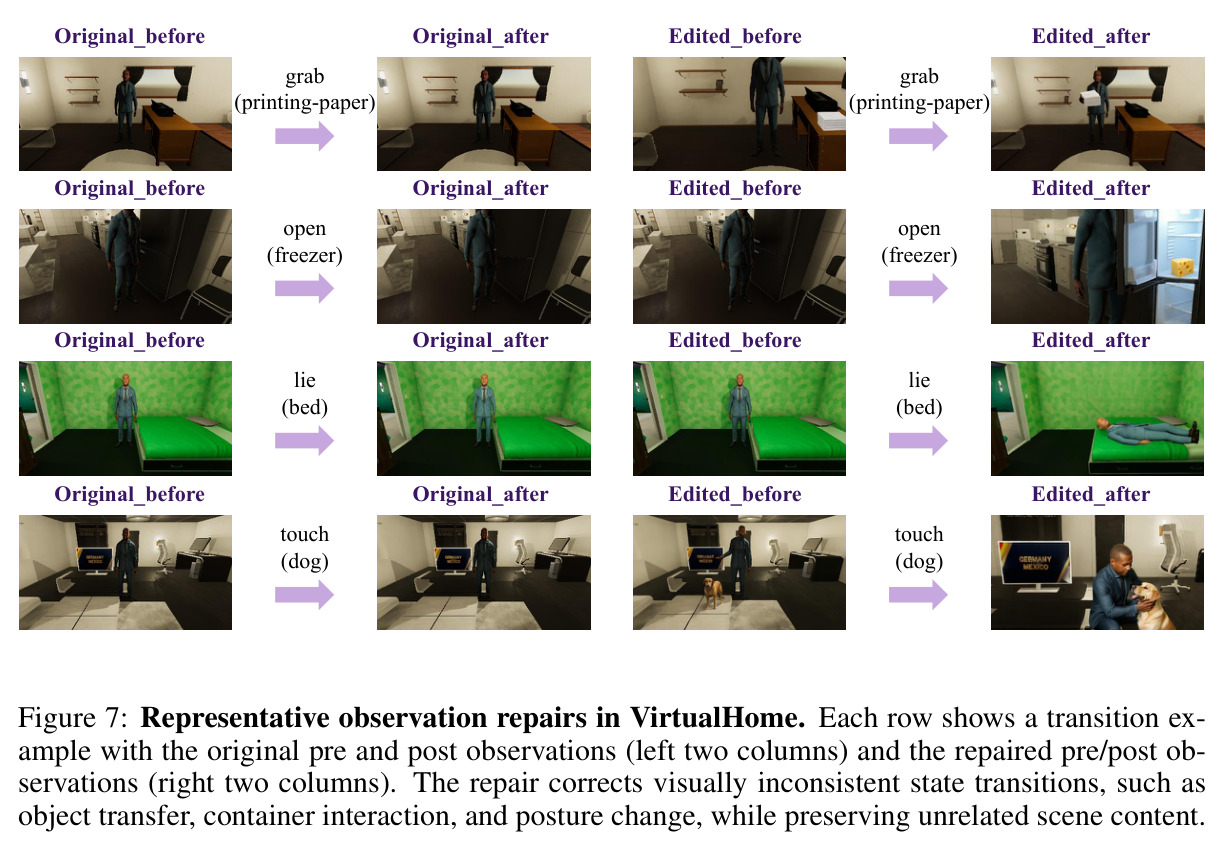
展示 VirtualHome 观测修复的四个前后对比示例(grab(printing-paper)、open(freezer)、lie(bed)、touch(dog)):原生渲染的动作前后帧存在与模拟器状态不一致的视觉问题(如物体未从手中消失、门未显示打开),经 Qwen-Image-Edit-2511 修复后图像正确反映状态变化,同时保持视角、布局和无关内容不变。
揭示该视觉基准构建中关键的工程细节与诚实披露:评测图像部分由生成式编辑产生,读者需知悉这一点才能正确评估结果的可靠性。