GAVEL:用图世界模型实现可验证且高效的长程 LLM 任务规划 GAVEL: Graph World Models for Verified and Efficient Long-Horizon LLM Task Planning
图世界模型预演修复LLM计划并在线重排任务,成功率41.2%→91.8%
前置知识
场景图(Scene Graph)
将环境表示为类型化图 $G=(V,E,\Phi)$:节点为房间集合 $R$、物体集合 $O$ 与机器人 $\rho$,边 $E$ 是 near、inside、on top、holding 等空间/接触关系,节点属性 $\Phi$ 记录 open、cooked、washed 等一元状态。它把非结构化的 3D 室内环境压缩成符号化、可查询、可在其上推演动作后果的紧凑结构。
GAVEL 的世界模型、计划验证与自动修复全部构建在这种类型化场景图上,它是全文所有推理(前向模拟、违规检测、图编辑修复、信念挂载)的基本数据结构,不懂场景图就无法理解方法本体。
动作前置条件与效果(STRIPS 式动作模型)
每个动作原语 $a$ 携带一对 $\langle pre_a, eff_a\rangle$:$pre_a$ 是执行前图上必须成立的条件(如 GRASP 前需邻近目标),$eff_a$ 是执行后对图的状态更新(如 GRASP 建立 holding 关系)。转移模型 $f(G,a)=eff_a(G)$ 当且仅当 $pre_a(G)$ 成立,否则转移非法(记为 $\bot$)。
GAVEL 正是用这套转移函数在执行前逐动作滚动 LLM 计划、判定可执行性、并根据"违反了哪个前置条件"直接推导修复动作——这是"图当世界模型"语义的技术核心。
信念状态与部分可观测
当机器人不知道某些物体在哪时,为每个不确定物体 $o$ 维护房间上的概率分布 $b_t^o(r)=P(\mathrm{room}(o)=r\mid H_t)$。每次观测要么定位该物体,要么把搜索后未找到的房间从支撑集中剪除,信念随动作和观测按贝叶斯方式更新:$B_{t+1}=\Upsilon(B_t,a_t,z_{t+1})$。
论文的关键卖点之一是"不坍缩信念":多数先前工作取最可能房间(argmax)后丢弃分布,而 GAVEL 把完整分布转成期望搜索代价用于任务排序,并随执行在线更新。理解信念表示才能读懂其多任务调度贡献。
LoRA 适配器
低秩适配(Low-Rank Adaptation)微调方法:冻结预训练模型全部权重,只在若干层旁注入可训练的低秩分解矩阵,参数量和显存开销远小于全量微调,小数据即可让模型学会特定映射任务。
本文的任务理解模块用两个共享的 Qwen3-1.7B LoRA 适配器分别抽取任务相关物体/显式关系与目标状态(8,000 条合成对训练),所有规划模型与基线共用它们;了解 LoRA 才能明白这一组件是小成本训练的轻量附件。
BEHAVIOR-1K 基准
大规模具身 AI 基准,含 1,000 项日常活动与高保真仿真器 OmniGibson,任务用目标谓词定义(物体到位、被洗、被煮、被打开等),动作空间为九类接地原语(导航、抓取、放置、开合、开关电器)。本文在其符号动作层评测,用保留原始楼层平面与谓词的轻量 2D 执行器大规模跑数。
论文全部结论(100 个单任务、500 条多任务指令、约 5,500 次评估)都建立在这套基准上;理解其任务定义方式与本文执行器抽象(结果与 OmniGibson 完全一致)是读懂实验的前提。
关系语义网络(RSN)
源自 SEEK 的物体位置语义先验:冻结文本编码器 bge-small-en-v1.5(384 维)接三层 MLP(256-128-64,dropout 0.2)预测物体属于各房间类型的分数 $\tilde f_o(\tau)$,再把类型分数在同类可达房间实例间均匀分配并归一化,得到初始信念 $b_0^o(r)$。本文用 11,218 个真实场景摆放样本训练(51 场景、197 类物体、37 类房间),AUC 0.904、Brier 0.057。
RSN 是 GAVEL 信念初始化的来源,而"真实房间仅 47% 概率排第一"这一 RSN 质量数据,直接支撑了本文"保留全分布而非坍缩成最可能房间"的核心设计论点。
研究动机
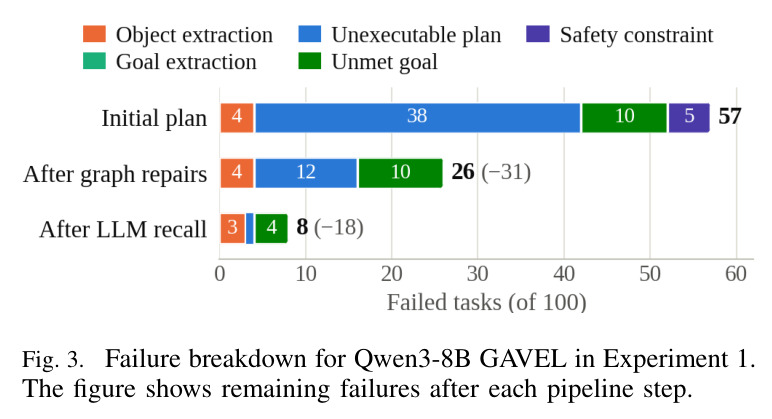
LLM 把自然语言指令翻译成机器人的长程动作序列很有吸引力,但生成的计划常不可执行:会遗漏前置动作(不导航就去抓取)、违反具身约束(伸手去拿关闭容器里的物体)、或结束时没达到目标状态。已有研究表明 LLM 作为独立规划器不可靠,失败率随规划视界增长,对要部署在边缘端的紧凑模型尤其严重——在本文的 100 个单长程任务上,Qwen3-4B 直接生成并执行计划的成功率仅 21.8%,Qwen3-8B 也只有 41.2%。现有补救各有缺陷:SayPlan 式"提出-检查"循环把每个验证失败都回传 LLM 重想,平均需 3.4 次 LLM 调用、27.6 秒,且反馈不保证小模型能正确修复错误;EPoG 直接从当前图与目标图的差分合成计划,虽快但只支持 pick/place 类重排,无法表达"把盘子洗净"这类必须推断"要运行洗碗机"的语义目标,在 500 条多任务指令上只拿到 60.2%,失败恰好集中在需要电器诱导语义状态(cooked/washed/dried)的任务上。此外,多数方法在部分可观测下把物体位置信念坍缩成单个最可能房间、并在初始时刻固定任务顺序,白白丢弃了执行中搜索所积累的信息。
本文的目标是本文要构建一个围绕显式图世界模型的长程 LLM 规划验证与修复框架,目标分三层。其一,执行前用图世界模型前向滚动 LLM 生成的计划,检验动作前置条件、目标完成与迹级安全约束(打开的容器要复原、安全电器要关闭),把违规在仿真层面暴露出来。其二,凡修复方式可直接从世界模型自身动作语义推导的失败(如抓取失败因缺少邻近关系),就在图上直接修复;只有真正需要语义推理的失败才回传 LLM 重新规划,且限制在预算 $T=5$ 次内。其三,在部分可观测的多任务指令下,为每个未观测物体保留完整的房间位置分布,把分布转成期望搜索与转移代价,并在每完成一个子任务、信念更新后在线重排剩余任务顺序。形式化为求 $\mu^\star=\arg\min_{\mu\in\mathcal{M}}\mathbb{E}_{G_0^\star\sim B_0,\mu}[C_{\mathrm{exec}}(\mu)]$,最小化期望物理行驶距离,同时满足目标达成 $\mathrm{unmet}(g,G_H^\star)=\emptyset$、安全性、前置条件与转移一致等约束。
与已有工作不同的是,已有工作对"图"的用法是片面的:SayPlan、VeriGraph 只在执行前用场景图做被动验证,每个失败都丢回 LLM;EPoG 走另一极端,完全用图编辑(pick/place 差分)直接合成计划,几乎绕开 LLM 但表达不了语义目标;SEEK 等语义先验方法用 RSN 预测物体可能在哪,但只在初始时刻用一次;belief-space 规划能随观测调整,却把信念坍缩成最可能结果、在初始化时定死任务顺序。GAVEL 的独特切入是重新划分职责并让图"活"在整个执行过程:LLM 只负责它擅长的语义流程生成,图作为显式世界模型承担滚动模拟、违规检测与可直接推导的修复;位置信念的完整分布在下游持续使用——先验借自 SEEK 的 RSN,但分布被保留用于期望代价估计与在线重排而非取 argmax 丢弃。"验证器升级为世界模型"加"修复优先、语义失败才问 LLM"的分工,是本文与最近邻 EPoG 的本质区别。
核心方法
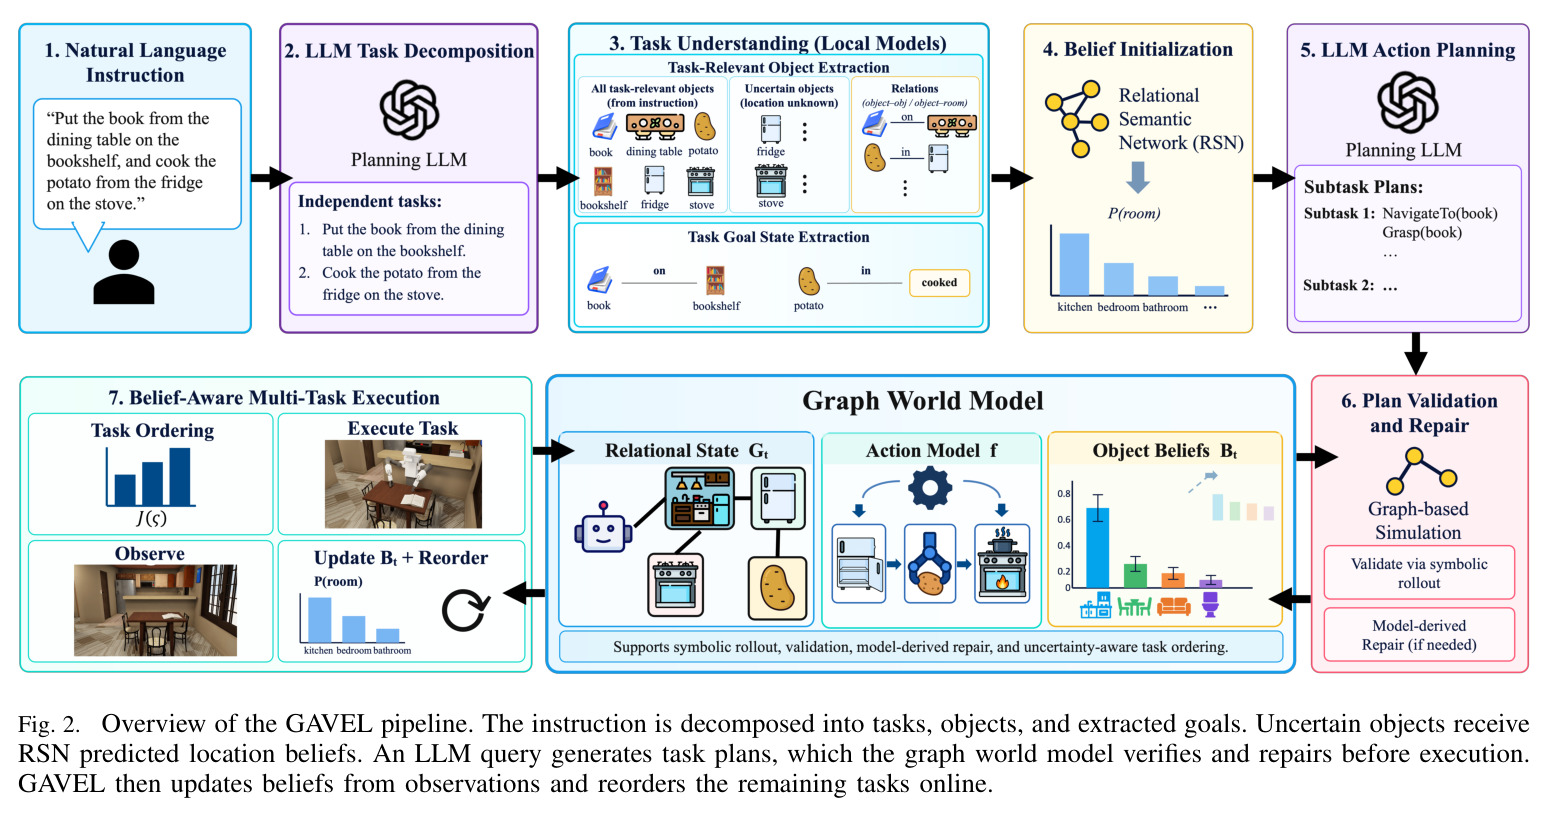
直觉上,GAVEL 给 LLM 规划器配了一个“沙盘”:LLM 写好的计划先在沙盘上推演,显而易见的错误由沙盘直接改,改不了才回去问 LLM。技术上,环境表示为类型化场景图 $G=(V,E,\Phi)$,$V=R\cup O\cup\{\rho\}$,边为空间/接触关系,节点标志记录 open/cooked/washed 等状态。流水线五步:(1)指令 $I$ 分解为 $N$ 个目标物体集互不相交的子任务;(2)两个 Qwen3-1.7B LoRA 适配器分别抽取任务相关物体与显式关系 $E_i$(如 inside(potato,fridge) 即完成定位),以及偏图目标 $g_i$;(3)RSN 为位置不确定的物体分配房间分布 $B_0$;(4)单次 LLM 调用生成各子任务计划 $\{\pi_i\}=\mathrm{LLM}(I,G_0,B_0,\{g_i\})$;(5)图世界模型逐动作前向模拟验证,REPAIR 修复模型可推导的失败,未解决的以结构化反馈回传 LLM(预算 $T=5$);验证通过后按期望代价排序执行,每完成一个子任务就用新观测更新信念并重排剩余任务。
核心洞察:许多计划失败的修复方式已蕴含在检测失败的图模型本身。抓取失败因缺邻近,补救是补 NAVIGATETO;物体在关闭容器里,补救是先导航再 OPEN;安全违规则插入恢复动作。图能检测失败就知道怎么修——此时调用 LLM 只会增加成本并引入新错误。与 SayPlan 的本质区别:后者只验证不修复,每个失败都要 LLM 重想;GAVEL 的 REPAIR 用模型可推导的图编辑递归修复,以已访问集合 $S$ 防循环,并按秩 $r_k(\omega,\pi)$(可执行、无未达目标、安全、代价取负)保留历史最佳;$T$ 只限 LLM 生成次数,两次调用间可发生多次图修复。第二个创新是信念不坍缩:未定位物体 $o$ 的期望搜索代价 $C_{\mathrm{srch}}=\frac{1}{Z_t}\sum_{k}b_t^o(r_k)\kappa_k$($\kappa_k$ 为扫到第 $k$ 个房间的路径与清扫代价),已定位物体用 $C_{\mathrm{loc}}=d_{\mathrm{nav}}(q_t,p_o)$。
方法步骤详情
① 分解:把指令拆成 $N$ 个目标集不相交的子任务。② 任务理解:grounding 适配器输出物体集 $O_i$ 与显式关系 $E_i$,goal 适配器输出目标 $g_i$;两者均为 Qwen3-1.7B 的 LoRA,用 8,000 条合成对训练。③ 信念初始化:RSN 为不确定物体赋房间分布 $b_0^o(r)$。④ LLM 规划:单次调用接收指令、信念图、目标与九原语定义(导航、抓取、释放、两类放置、开合、开关电器共九个接地原语),输出 $\{\pi_i\}$。⑤ 验证修复:VALIDATE 逐动作检查前置条件(邻近/可供性/夹爪/可达)与目标、安全;REPAIR 循环应用模型可推导编辑,无解时回传 LLM(预算 $T=5$)。⑥ 排序:$O(N^2)$ 次信念 rollout 得 $h[j]$ 与 $A[i,j]$,枚举排列最小化 $J=h[\varsigma_1]+\sum_{p}A[\varsigma_{p-1},\varsigma_p]$,按序取第一个无干扰的。⑦ 执行:只跑首任务,观测更新信念,重建 $(h,A)$ 重排剩余直至完成。
技术新颖性
其一,把场景图从被动验证器升级为带动作语义转移 $f(G,a)$ 的完整世界模型,使检测与修复共用同一套模型:仅图修复、从不重问 LLM 的 gavel-basic 在 Qwen3-4B 上达 67.7%,比纯反馈重试的 SayPlan(55.4%)高 12.3 个百分点且只需 1 次调用而非 3.4 次——量化了这一设计的独立价值。其二,与 EPoG 相反的职责划分:LLM 出语义流程、图管可执行性,既保留图差分规划无法表达的语义目标能力(如需推断“运行洗碗机”的洗盘子),又用符号验证兜底 LLM 的不可靠性。其三,信念不坍缩:RSN 显示真实房间仅 47% 概率排第一,取 argmax 会丢一半以上信息,GAVEL 保留全分布并推导期望搜索代价的闭式近似用于排序,在线重排还利用了“搜一个物体会更新其他物体信念”的耦合,比初始固定顺序再省 4.45m。其四,工程贡献:保留 BEHAVIOR-1K 楼层平面与谓词的轻量 2D 执行器,把单计划仿真从约 17 分钟压到约 1 秒,支撑 5,500 次评估,且 100 个单任务在 OmniGibson 中结果与执行器完全一致。
实验结果
实验一(100 个单任务):Qwen3-4B 上 llm-only 21.8%、sayplan 55.4%、gavel-basic 67.7%、gavel 88.8%;Qwen3-8B 依次 41.2%、76.4%、76.2%、91.8%。实验二(500 条多任务指令、Qwen3-8B):llm-only 19.9%、sayplan 75.6%、epog 60.2%(失败均为需电器语义态任务);gavel-map/static/gavel 均为 92.6%,距离 82.45→79.69→78.01m,共省 4.45m;oracle 100%/56.17m;38 个残余失败里 21 个是物体抽取。实验三(100 条子集):无 GAVEL 时 Qwen3-4B/8B、GPT-5.6 Sol、Claude Sonnet 5 为 2.4%/23.6%/24.6%/38.6%,加 GAVEL 后 75.2%/89.2%/99.2%/99.4%,托管模型耗时几乎不变。辅助:RSN 的 AUC 为 0.904、真实房间 top-1 仅 47%;代价模型 $R^2=0.93/0.89$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BEHAVIOR-1K 100 个单长程任务(Qwen3-4B) | 任务成功率 / LLM 调用次数 | 88.8%(GAVEL,1.7 次调用,15.0s) | llm-only 21.8%;SayPlan 反馈重试 55.4%(3.4 次调用,27.6s);gavel-basic(仅图修复)67.7% | 较 llm-only +67.0 个百分点,较 SayPlan +33.4 个百分点且 LLM 调用减半、时间省 12.6s |
| BEHAVIOR-1K 100 个单长程任务(Qwen3-8B) | 任务成功率 | 91.8%(1.5 次调用,15.5s) | llm-only 41.2%;SayPlan 76.4%;gavel-basic 76.2% | 较 llm-only +50.6 个百分点,仅图修复(76.2%)即追平 SayPlan(76.4%)且少 1.2 次调用 |
| 500 条多任务指令(Qwen3-8B,2–5 个子任务) | 指令成功率 | 92.6% | llm-only 19.9%;SayPlan 75.6%;EPoG 60.2% | 较 llm-only +72.7 个百分点,较 SayPlan +17.0 个百分点,较 EPoG +32.4 个百分点 |
| 500 条多任务指令(Qwen3-8B) | 平均行驶距离 | 78.01 m(gavel:全分布+在线重排) | gavel-map(信念坍缩)82.45 m;gavel-static(全分布但固定顺序)79.69 m | 较固定顺序省 4.45 m(约 5.4%),排序优化仅耗时 17 ms/指令 |
| 100 条多任务指令子集(Qwen3-4B + GAVEL) | 成功率 | 75.2%(35.0s) | Qwen3-4B 单独 2.4%;GPT-5.6 Sol 单独 24.6%;Claude Sonnet 5 单独 38.6% | 紧凑小模型加图世界模型后反超两个前沿托管模型单独使用的水平 |
| 100 条多任务指令子集(托管模型 + GAVEL) | 成功率 / 规划时间 | GPT-5.6 Sol 99.2%(16.5s);Claude Sonnet 5 99.4%(18.2s) | 同模型单独使用 24.6%(16.5s)/ 38.6%(18.0s) | +74.6 / +60.8 个百分点,且规划时间几乎不变,验证与修复开销可忽略 |
局限与改进
作者承认的局限:评估停留在符号动作层,图世界模型捕获逻辑后果但不捕获几何可行性(运动级可达性与碰撞),把运动级约束纳入同一验证-修复机制是未来工作;语义先验主要依赖房间类型,未利用环境特定规律;残余失败大多已从规划转移到指令理解(21/38 为物体抽取)。我的补充观察:其一,多任务基准的子任务按构造独立(目标物体集不相交),跨任务干扰只靠排序验证时负面检查兜底,真实家庭任务常有共享资源与顺序依赖,假设偏理想;其二,房间布局与连通性已知的假设较强,真实部署中 SLAM 不确定性会传入信念;其三,RSN 的 top-1 命中率仅 47%,信念质量上限直接限制距离优化收益——oracle 56.17m 与 gavel 78.01m 仍有约 22m 差距;其四,$N\le 5$ 时全排列枚举可行,任务数增大后 $O(N^2)$ rollout 加 $N!$ 排列搜索需要近似算法;其五,执行器与 OmniGibson 的一致性只在 100 个单任务上验证过,500 条多任务指令的大规模结果仍依赖 2D 抽象执行器,未做仿真器级复核。
独立分析的弱点
独立弱点分析:第一,指令理解已是最大失败源(21/38 的多任务失败来自物体抽取),而两个适配器只是 1.7B LoRA、用 8,000 条合成对训练,对措辞隐晦、指代省略的真实指令泛化存疑——改进方向是更强的抽取模型、VLM 常识消歧或抽取失败时主动澄清。第二,图修复依赖人工编写的九原语动作语义与修复规则库,换机器人形态或开放词汇动作需重新建模——可学习动作效果模型,或让 LLM 离线生成动作本体再经符号验证入库。第三,期望搜索代价模型假设按概率降序逐房扫描,未刻画搜索途中观测对后续信念的实时影响,且 $s(r)=A_{\mathrm{trav}}(r)/w_{\mathrm{cov}}$ 是粗覆盖近似——可用信念树搜索等 POMDP 近似替代闭式代价。第四,安全约束是硬编码恢复规则(开过的容器要关、开过的电器要关),覆盖不了未建模的危险交互——应扩展为可声明的时序逻辑(LTL)规范。第五,子任务独立假设排除了真实任务的目标耦合(先后依赖、共享资源),未来需支持耦合任务的联合排序,而这会破坏 $h/A$ 可加分解,需要更强的调度求解器。
未来方向
作者明确提出的方向:把运动级可达性与碰撞约束纳入同一验证-修复机制以扩展到物理执行;利用重复观测改进环境特定的语义先验(当前 RSN 只按房间类型泛化);攻克指令理解瓶颈(多数残余失败已转移到 grounding)。基于本文成果可自然延伸:其一,用学习的世界模型替换符号转移 $f(G,a)$,处理动作效果不确定的对象(半满杯子、软体物、可变形物);其二,多机器人扩展——同组 COMRES-VLM 处理多机探索,GAVEL 的信念与代价框架天然适合多机任务分配与调度;其三,任务数大时用 TSP 近似、束搜索或学习型排序替代 $N!$ 全排列枚举;其四,主动探索决策——当前只在任务需要物体时才搜索,可基于信念熵决定是否值得提前侦察以降低总代价;其五,把结构化失败反馈(complaint)接口迁移到 ALFRED、Habitat 等基准,检验世界模型修复范式的通用性;其六,既然托管前沿模型加 GAVEL 后接近满分(99.2%/99.4%)且开销可忽略,世界模型 harness 有潜力成为机器人基础模型的标准化外挂验证层。
复现评估
BEHAVIOR-1K/OmniGibson 是公开基准,但轻量 2D 执行器需自行实现——论文给出关键细节(保留原始楼层平面、erode 后 A* 导航、frontier 探索配楔形相机、九原语映射回 OmniGibson 接口),文中未明确说明代码是否开源,这是最大不确定项。模型全为公开权重:Qwen3-1.7B/4B/8B 本地推理,GPT-5.6 Sol 与 Claude Sonnet 5 走 API。训练成本很低:两个 LoRA 适配器仅需 8,000 条合成指令对,RSN 用 11,218 个摆放样本(bge-small 编码器 + 三层 MLP),单张消费级 GPU 可完成;评测协议清晰(5 个随机种子、均值±标准差、约 5,500 次执行、每计划约 1 秒)。整体难度中等:公式(1–11)与算法(Alg. 1–2)描述完整,主要工程量在忠实复刻九原语的 $\langle pre_a,eff_a\rangle$ 语义、REPAIR 图编辑规则库,以及 2D 执行器与 BEHAVIOR-1K 谓词体系的对接;若作者放出代码则接近开箱复现。
论文图表
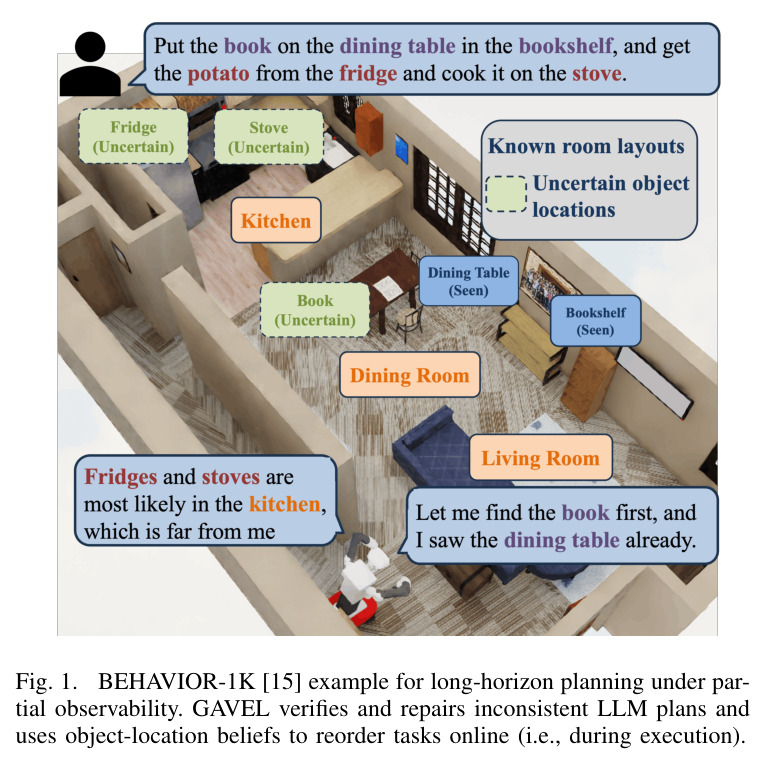
BEHAVIOR-1K 中部分可观测长程规划的实例图:机器人在看不到全部物体的环境中执行任务,GAVEL 验证并修复不一致的 LLM 计划,同时利用物体位置信念在执行过程中在线重排任务顺序。
这是全文的问题设定图:一眼看懂"长程+部分可观测"两大难点如何同时出现,以及 GAVEL 的两个核心机制(验证修复、信念驱动重排)分别对应哪一难点,适合放在引言/动机处建立直觉。
实验一主表:Qwen3-4B 与 Qwen3-8B 两种模型在 100 个单任务上对比 llm-only、sayplan、gavel-basic、gavel 四种方法的成功率、平均尝试次数与规划时间。gavel 使 Qwen3-4B 从 21.8% 升至 88.8%(1.7 次调用、15.0s),Qwen3-8B 从 41.2% 升至 91.8%(1.5 次调用、15.5s)。
核心结论表之一:量化"图修复"(gavel-basic)与"修复+语义回传"(gavel)各自的独立贡献,并证明 GAVEL 比反馈重试更准、调用更少、更快。
实验二主表:500 条多任务指令上 llm-only(19.9%)、sayplan(75.6%)、epog(60.2%)、gavel-map(92.6%/82.45m)、gavel-static(92.6%/79.69m)、gavel(92.6%/78.01m)、oracle(100%/56.17m)的成功率、行驶距离与时间。
同时展示两层贡献:验证修复把成功率推到 92.6%,而信念处理方式的消融(map/static/在线重排)用 82.45→79.69→78.01m 的距离差隔离出"保留全分布"与"在线重排"各值多少,是论文消融逻辑最完整的表。
实验三主表:同一 100 条指令子集上,Qwen3-4B/8B、GPT-5.6 Sol、Claude Sonnet 5 在"单独使用"与"加 GAVEL"两种条件下的成功率与时间对比:2.4→75.2%、23.6→89.2%、24.6→99.2%、38.6→99.4%,托管模型时间几乎不变。
回答"换更强模型能否替代 GAVEL"这一关键质疑:4B+GAVEL 超过 GPT-5.6 Sol 单打、前沿模型加 GAVEL 近乎满分且开销可忽略,证明世界模型推理与模型规模互补,这是论文立场成立的决定性证据。