TernScope:面向高效三值肠镜分割的模型-硬件协同设计 TernScope: Model-Hardware Co-Design for Efficient Ternary Endoscopic Segmentation
分支融合加渐进式三值量化,0.25M参数实现肠镜分割并使加速器面积降低88%
前置知识
三值权重量化(W2)
把卷积权重约束到集合 $\{-1, 0, +1\}$,并配合每通道缩放因子 $s_c$:$W_c = s_c\cdot\mathrm{clip}(\mathrm{round}(W_c/s_c), -1, 1)$。推理时权重仅需 2 bit 打包存储,乘法 $w\cdot x$ 退化为按符号选择 $-x$、$0$ 或 $+x$ 后累加,无需通用乘法器,存储与计算成本同时大幅下降。
TernScope 把全部 25 个卷积都做成三值权重(W2A8),这是其计算阵列面积降低 88.46%、逻辑能耗降低 95.69% 的直接来源;不理解三值化的算术就无法看懂硬件收益。
量化感知训练(QAT)与 PTQ
PTQ(训练后量化)直接把训练好的 FP32 权重按规则取整量化,不重新训练;QAT(量化感知训练)则在训练中插入 fake quantization,前向模拟低精度计算、反向用直通估计器(straight-through estimator)让梯度绕过不可导的取整操作,使网络在低比特约束下重新学习。
论文消融显示三值 PTQ 让 Dice 从 0.8102 崩溃到 0.0002,只有 QAT 能保住精度;TPQ 本质是一种渐进调度的高级 QAT,不懂 QAT 机制就无法理解为何渐进有效。
结构重参数化与分支融合
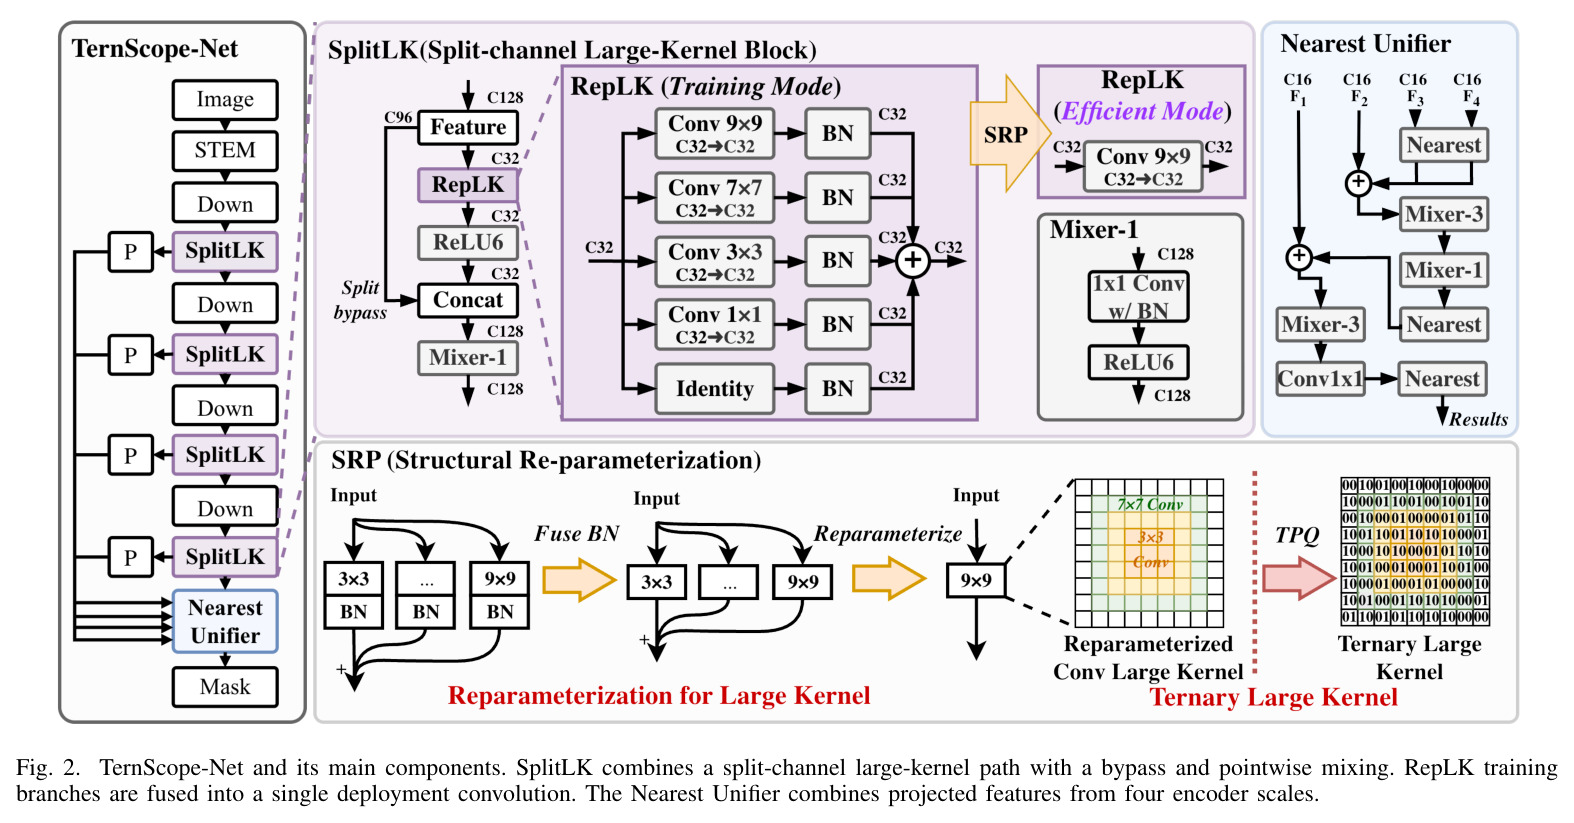
训练时用多分支结构(如 $3\times3$ 卷积 + 恒等映射 + $1\times1$ 卷积并行)增强表达能力;训练结束后把各分支的 BN 折叠进权重并线性合并为单个等效卷积:$W_{rep}=\sum_j P_j(\bar W_j)$,其中 $P_j$ 表示中心填充对齐、恒等分支用中心恒等核表示。推理图从多分支塌缩成单卷积,精度不变、执行路径更省。
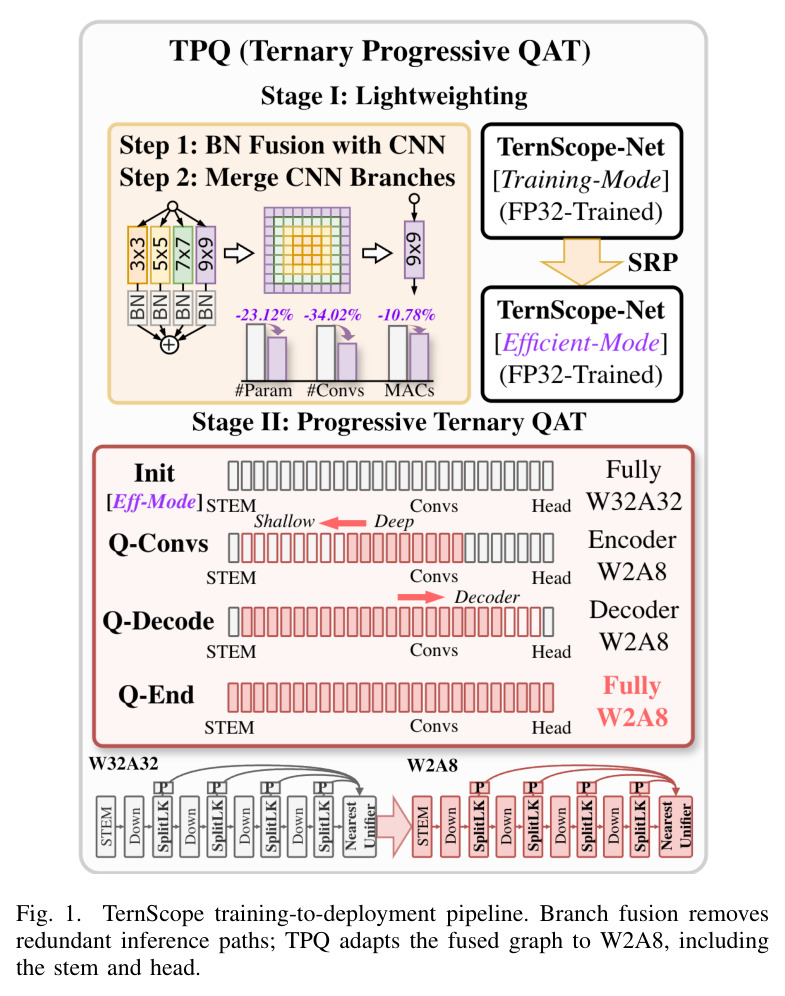
TernScope 遵循先融合、后量化的次序:分支融合把 0.3233M 参数压到 0.2483M 而 FP32 分数逐位不变,随后才对融合图做 TPQ。不理解融合就无法理解量化对象是谁。
大核卷积与通道拆分(SplitLK)
$5\times5$、$7\times7$、$9\times9$ 等大核能扩大感受野、捕获空间上下文,但计算量随 $k^2$ 增长。SplitLK 把空间大核卷积限制在部分通道上:对输入宽度 $C$ 只处理 $C_s$ 个通道,密集空间项从 $HWC^2k^2$ 降到 $HWC_s^2k^2$(例如 128 通道中处理 32 个即降到 1/16),其余通道旁路,再用 pointwise 卷积在通道间交换信息。
SplitLK 是 TernScope-Net 做到 0.0949 GMACs 的关键组件,解释了大感受野与低计算量如何兼得,是理解网络设计的第一块拼图。
脉动阵列与 Gemmini 加速器
脉动阵列是把 PE(处理单元)排成网格、数据逐拍流动并在相邻单元间传递的矩阵计算架构,天然适合卷积与矩阵乘。Gemmini 是 UC Berkeley 开源的可配置 DNN 加速器生成器,典型配置为带 INT8 乘法器的 systolic array,可在 Chipyard 生态中做 RTL 综合与功耗评估。
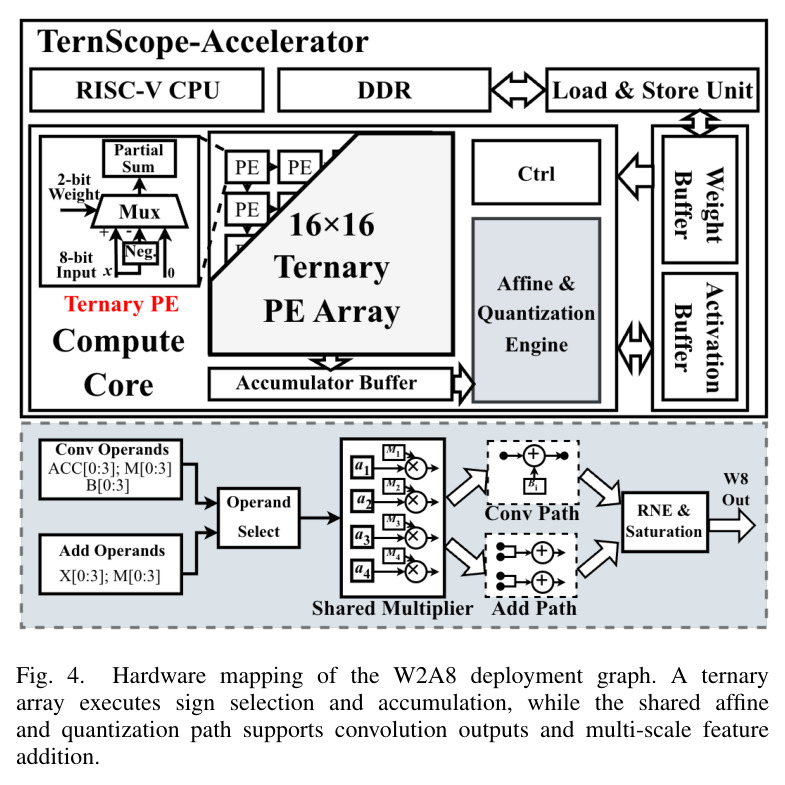
论文的硬件贡献是以相同 16×16 阵列、相同 45nm 工艺、相同 25 卷积负载与 INT8 版 Gemmini 正面对比,Table III 的面积/能耗/FPS 全部以 Gemmini 为基准,了解它才能判断对比是否公平。
Dice 与 IoU 分割指标
Dice 系数衡量预测掩码与真实掩码的重叠度:$\mathrm{Dice}=\frac{2|X\cap Y|}{|X|+|Y|}$;IoU(交并比)为 $\frac{|X\cap Y|}{|X\cup Y|}$。两者取值 0 到 1、越高越好,是医学分割的标准指标。本文报告的是阈值 0.5 下按图平均的分数,模型成本则用参数量与 GMACs 衡量。
论文所有精度结论(域内 Dice 0.8158、跨域 0.7291/0.5945 等)都用这两个指标表达,同时对比表中的 Params 与 GMACs 是衡量轻量化的通用货币。
研究动机
边缘端肠镜息肉分割必须同时满足模型小、分割准、推理快,但现有方法无法兼顾。以 Kvasir-SEG 基准为例,经典 U-Net 有 31.03M 参数、48.17 GMACs,域内 Dice 0.8208,但根本无法部署到边缘设备;轻量化路线如 Mobile-PolypNet(0.2239M 参数)与 EGE-UNet(0.0534M 参数)虽然模型极小,域内 Dice 却只有 0.5974 和 0.5882,跨数据集到 ClinicDB 时更跌到 0.4390 和 0.4464。更麻烦的是,模型小并不自动等于推理快和硬件便宜:实际执行还取决于访存、算子组织与目标架构。许多轻量网络(如 UNeXt、TinyU-Net)训练时保留多分支结构,推理路径冗余;若量化时把 stem 或分割头留在高精度,硬件就必须同时支持多种位宽的卷积;而如果分别量化训练分支再融合,由于量化是非线性的,结果并不等于量化融合后的算子。
本文的目标是本文的目标是在肠镜分割场景下把三难困境同时压下来:构建一个极小且准的分割网络,并通过模型-硬件协同设计让低比特表示直接转化为电路级收益。具体而言,网络侧所有 25 个卷积统一为三值权重加 8-bit 激活(W2A8),支持打包存储与无乘法器计算;模型规模控制在 0.2483M 参数、0.0949 GMACs,同时域内 Dice 与 U-Net 的差距不超过 0.51 个百分点、跨数据集迁移显著更强;硬件侧在相同 45nm 工艺、相同 16×16 PE 阵列、相同 25 卷积负载下与 INT8 Gemmini 对比,大幅降低计算阵列面积、标准单元综合面积与逻辑能耗,并把吞吐提升到 100 FPS 以上。最终目标是给出一条从准确轻量医学分割到紧凑低比特硬件的完整通路。
与已有工作不同的是,本文的独特切入点是模型主导的模型-硬件协同设计,以及先融合、后量化的次序。已有工作要么只压缩模型(轻量架构设计),要么只做量化(PTQ/QAT),要么单独优化硬件算子,三者彼此割裂。本文主张三个层面互相成全:SplitLK 把空间大核计算限制在部分通道上,让大感受野不再昂贵;分支融合把 RepLK 多分支训练图折叠成单一部署卷积,消除冗余执行路径;然后对融合后的部署图整体做渐进式三值化 TPQ,而不是分别量化训练分支——因为量化是非线性的,对分支量化再求和不同于对和量化,只有先融合才能保证被量化的算子就是部署时执行的算子。同时坚持 stem 与分割头也三值化,避免异构位宽卷积,硬件才能用统一的纯三值阵列、以无乘法器方式执行。
核心方法
整体思路可以概括为:先设计省算力的网络,再折叠成最简部署图,然后渐进学会三值执行,最后让硬件直接受益。直觉上,大核卷积贵是因为对所有通道做空间卷积,那就只对一小部分通道做大核、其余旁路再用 1×1 交换信息;多分支训练结构在推理时是冗余的,训练完可以线性合并成一个卷积;低比特若一步硬切会崩溃,就从深到浅逐层渐进适配。技术路线对应三步:第一步用 SplitLK 构建四级编码器(32/64/96/128 通道,空间卷积仅占 16/16/16/32 通道,大核 5/7/9 只在 32×32 分辨率及以下使用)加 Nearest Unifier 窄解码器;第二步把 RepLK 分支融合为单卷积部署图,参数从 0.3233M 降到 0.2483M、MACs 从 0.1064 降到 0.0949,而 FP32 分数完全不变;第三步 TPQ 在 200 epochs 内先用 5% 进度做 W8A8 适配,再用 35% 进度从深层到浅层逐级把权重转为三值,最终全部 25 个卷积均为 W2A8。部署模型配合 16×16 三值 PE 阵列,在 100MHz 下达到 102.701 FPS。
核心创新是 Ternary Progressive QAT(TPQ):对分支融合后的部署图做由深到浅的渐进式三值化,让网络先学会融合后的算子、再逐步降低位宽。它与已有方法的本质区别有三点:其一,量化对象是融合后的部署算子而非训练分支,保证量化结果与部署拓扑一致,避免了分别量化分支再求和的失配;其二,全网络三值化覆盖 stem 与分割头,消灭异构位宽卷积,硬件阵列才能做到无乘法器、控制逻辑统一;其三,渐进调度(5% 进度 W8A8、35% 进度逐级转三值、剩余 60% 全 W2A8 训练,配合 scale 重校准与短暂低学习率适配)避免了直接三值化的崩溃——消融显示三值 PTQ 的 Dice 从 0.8102 崩到 0.0002,直接三值 QAT 只有 0.8075/0.7029/0.5636,而 TPQ 达到 0.8158/0.7291/0.5945,甚至全面超过 FP32 参考。模型侧配套的 SplitLK 与加法式 Nearest Unifier 则保证进入量化的拓扑本身已经足够紧凑。
方法步骤详情
流程分三步。第一步网络构建:输入 256×256 RGB,四级编码器通道 32/64/96/128,SplitLK 只让 16/16/16/32 通道走 5/7/9 大核空间卷积,其余通道旁路后经 pointwise 混合;Nearest Unifier 把四个编码器尺度最近邻对齐、投影到 16 通道后相加,解码器以加法保持 16 通道宽度,最后接分割头。第二步分支融合:每个 RepLK 分支先把 BN 折叠为 $(\bar W_j, \bar b_j)$,再按 $W_{rep}=\sum_j P_j(\bar W_j)$、$b_{rep}=\sum_j \bar b_j$ 合并成单卷积($P_j$ 为中心填充,恒等分支用中心恒等核表示),得到 25 个普通卷积的部署拓扑。第三步 TPQ:FP32 初始化,AdamW、batch 2、学习率 $2\times10^{-4}$、200 epochs、无蒸馏;量化器为 $W_c = s_c\cdot\mathrm{clip}(\mathrm{round}(W_c/s_c), -1, 1)$,fake quantization 加直通梯度,激活恒为 8-bit;前 5% 进度做 W8A8 适配,随后 35% 从深层到浅层逐级转三值,再覆盖跳连投影、解码器与分割头,40% 进度时全部卷积三值化;每次转换做 scale 重校准并短暂降学习率,激活 scale 最后冻结,验证 Dice 只从全 W2A8 阶段选 checkpoint;训练仅用 Kvasir-SEG 的 720/80/200 划分。
技术新颖性
技术新颖性体现在四个层面。第一,次序上的新颖:文献中量化通常作用于训练图或独立于结构改造,本文明确论证并实验验证了必须对融合后的部署图做量化,才不浪费结构简化的收益。第二,覆盖范围上的新颖:绝大多数三值化工作保留首尾层高精度,本文把 stem 与分割头一并 W2 化,换来硬件上完全同构的 25 个三值卷积,这是阵列面积降 88.457% 的前提。第三,训练调度上的新颖:TPQ 的深到浅渐进次序、5%/35%/60% 的进度划分、scale 重校准与冻结策略,都是在无蒸馏条件下的系统设计,使三值模型反超 FP32 参考(三个数据集分别 0.8158/0.7291/0.5945 对 0.8102/0.7142/0.5532)。第四,评估范式上的新颖:把同一 25 卷积负载映射到自研 16×16 三值阵列与 Gemmini,用统一的 Yosys/ABC + Nangate45 45nm 流程对比面积、SRAM、FPS 与能耗,把算法贡献与电路收益闭环对应,这在轻量分割文献中少见。
实验结果
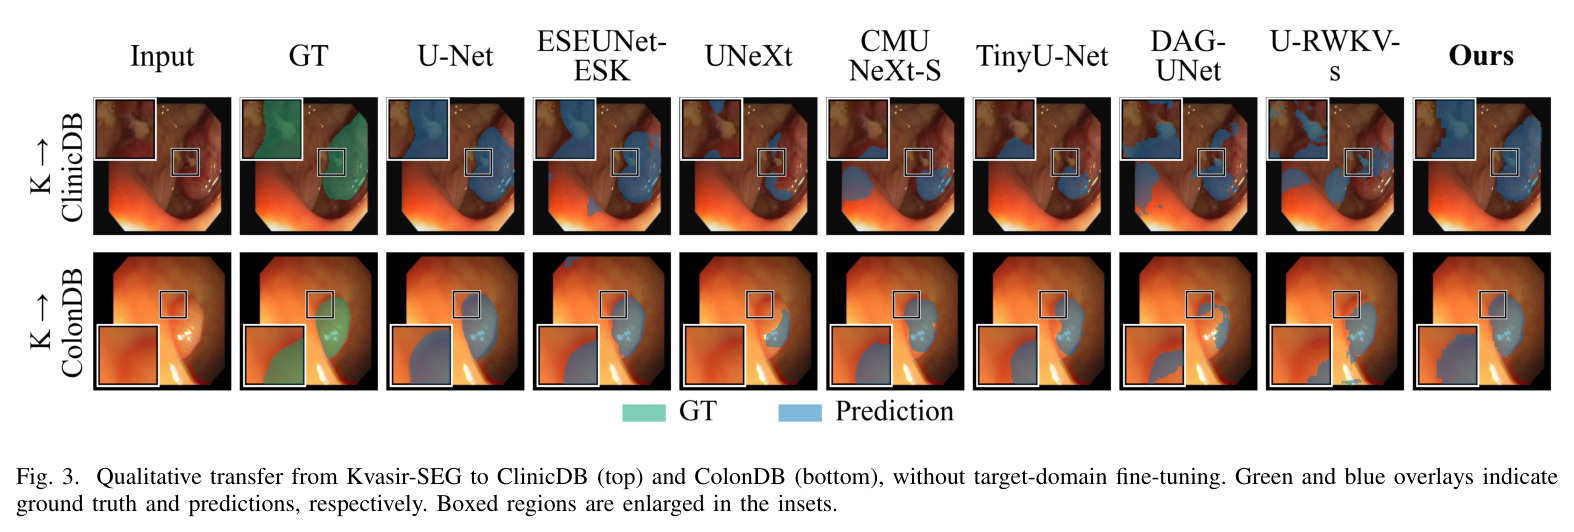
论文给出三组互相印证的实验。第一,分割质量与跨域迁移(Table I,256×256、阈值 0.5 逐图均值):TernScope 仅 0.2483M 参数、0.0949 GMACs、W2/A8,在 Kvasir-SEG 上 Dice 0.8158、IoU 0.7247,与 U-Net(0.8208/0.7303)只差 0.51pp;无微调迁移到 ClinicDB 的 Dice 0.7291(比 U-Net 高 5.00pp)、ColonDB 的 Dice 0.5945(高 5.85pp),六个指标全部领先;参数约为 U-Net 的 1/125、MACs 约为 1/508,而参数更少的 EGE-UNet 与 Mobile-PolypNet 分数反而低得多,说明收益来自保留空间上下文而非单纯砍参数。第二,消融(Table II):分支融合砍掉 23.21% 参数(0.3233M→0.2483M)与 10.78% MACs(0.1064→0.0949)而 FP32 分数逐位不变;三值 PTQ 完全崩溃(Dice 0.0002);直接三值 QAT 恢复到 0.8075/0.7029/0.5636;TPQ 达到 0.8158/0.7291/0.5945,外部 Dice 比直接 QAT 高 2.62 和 3.09pp,且全面超过 FP32 参考的 0.8102/0.7142/0.5532。第三,硬件实现(Table III):同一 25 卷积负载、16×16 阵列、Nangate45 45nm、TT 1.1V 25°C 下,相比 INT8 Gemmini:计算阵列面积降 88.457%(0.685→0.079 mm²)、综合面积降 70.275%(1.816→0.540 mm²)、100MHz 下 FPS 11.902→102.701(8.629 倍)、逻辑能耗降 95.690%(14.019→0.604 mJ/图),SRAM 由 320 增至 344 KiB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 域内息肉分割(Kvasir-SEG 测试集 200 张) | Dice / IoU | 0.8158 / 0.7247(0.2483M 参数、0.0949 GMACs、W2A8) | U-Net:0.8208 / 0.7303(31.03M 参数、48.17 GMACs、FP32) | Dice 低 0.51pp,但参数约为 1/125、MACs 约为 1/508;领先所有其他轻量基线(次优 ESEUNet-ESK 为 0.7693) |
| 跨域迁移 K→CVC-ClinicDB(612 张,无微调) | Dice / IoU | 0.7291 / 0.6290 | U-Net:0.6791 / 0.5849;最佳轻量基线 ESEUNet-ESK:0.5776 / 0.4759 | Dice 较 U-Net 高 5.00pp,较最佳轻量基线高 15.15pp |
| 跨域迁移 K→CVC-ColonDB(380 张,无微调) | Dice / IoU | 0.5945 / 0.5015 | U-Net:0.5360 / 0.4471;最佳轻量基线 ESEUNet-ESK:0.4113 / 0.3333 | Dice 较 U-Net 高 5.85pp,较最佳轻量基线高 18.32pp |
| 结构消融:分支融合 vs 多分支训练图 | Params / GMACs / 三个数据集 FP32 Dice | 融合后 0.2483M / 0.0949,Dice 0.8102 / 0.7142 / 0.5532 | 多分支 0.3233M / 0.1064,Dice 0.8102 / 0.7142 / 0.5532 | 参数省 23.21%、MACs 省 10.78%,精度逐位不变 |
| 量化消融:TPQ vs 直接三值 QAT vs 三值 PTQ | 三个数据集 Dice | TPQ:0.8158 / 0.7291 / 0.5945 | 直接 QAT:0.8075 / 0.7029 / 0.5636;PTQ:0.0002 / 0.0004 / 0.0007 | 外部 Dice 高 2.62 与 3.09pp,并全面反超 FP32 参考 0.8102 / 0.7142 / 0.5532 |
| 硬件实现:同一 25 卷积负载的加速器成本 | 面积 / FPS / 能耗 | 计算阵列 0.079 mm²、综合面积 0.540 mm²、102.701 FPS、0.604 mJ/图 | INT8 Gemmini:0.685 mm²、1.816 mm²、11.902 FPS、14.019 mJ/图 | 计算阵列面积降 88.457%、综合面积降 70.275%、吞吐提升 8.629 倍、能耗降 95.690%(SRAM 320→344 KiB 略增) |
局限与改进
作者明确承认的局限:三值权重中的零值稀疏性尚未被利用,当前阵列仍做稠密计算与传输,论文把稀疏感知执行与压缩存储列为下一步工作。我自己还观察到几点:其一,硬件结果停留在综合与估计层面(Yosys/ABC 标准单元综合、OpenSTA vectorless 功耗分析),没有流片或 FPGA 实测,102.701 FPS 是特定负载下的吞吐而非含前后处理的端到端延迟;其二,SRAM 从 320 增至 344 KiB,说明缓存并未随逻辑同步缩小,存储侧收益主要来自 W2 打包而非片上缓冲;其三,对比对象是原始 INT8 Gemmini 映射,其 14.019 mJ 能耗中含有较高 CPU 后处理开销,对比的公平性可以商榷;其四,任务仅限二分类息肉分割、256×256 输入,多类别、多器官与高分辨率场景未验证;其五,训练只用 Kvasir-SEG 的 720 张图,跨域强但域内 Dice 仍差 U-Net 0.51 个百分点,容量上限值得注意;其六,TPQ 需要 200 epochs、batch 2 的额外训练成本,且低比特为何能反超 FP32(可能存在正则化效应)缺少机理解释。
独立分析的弱点
独立分析出的弱点与改进方向:第一,域内精度上限——Kvasir-SEG Dice 0.8158 仍低于 U-Net 的 0.8208,若场景要求极致域内精度,可尝试 W2/W4 混合精度或引入自蒸馏恢复损失;第二,稠密执行浪费——三值权重天然含大量零,当前阵列不区分零权重,结合 SCNN 式稀疏加速与压缩索引存储可同时降计算与数据搬运,这是最直接的增量空间;第三,基线映射不占优——Gemmini 侧沿用原始 INT8 配置且 CPU 后处理未卸载干净,14.019 mJ 的能耗基线可能偏高,应给 Gemmini 也加融合的 affine 引擎后再公平对比;第四,插值方式粗糙——Nearest Unifier 用最近邻对齐多尺度特征,可能损失亚像素细节,可尝试硬件友好的 bilinear 或 area 插值并量化其对 Dice 的影响;第五,训练数据单薄——仅 720 张 Kvasir-SEG,跨域好但域内上限受数据量限制,可做多中心联合训练;第六,缺少真实系统评估——未报告实际边缘 SoC 上含前后处理的端到端延迟与功耗,建议补充 FPGA/ASIC 实测。
未来方向
作者明确提出的下一步是利用零值三值权重的稀疏性做稀疏感知执行与压缩存储,进一步降低计算量与数据搬运成本。在此基础上的延伸方向:把 TPQ 的渐进量化范式推广到其他边缘分割任务(皮肤镜、腹腔镜、超声)与其他骨干(Transformer、RWKV),检验其对架构的普适性;探索 W2A4 或逻辑二值的精度-硬件极限,并与阵列设计联动权衡;将 Affine & Quantization Engine 与稀疏 PE 阵列协同调度,让零权重跳过累加与访存;解释并利用低比特训练的正则化效应——TPQ 在三个数据集上全面反超 FP32 参考的现象值得理论分析,可能反过来指导 FP32 训练;在 Chipyard/Gemmini 生态中做 post-layout 时序收敛、FPGA 原型或 ASIC 流片,补齐实测延迟、功耗与温度数据;研究部署后持续自适应场景下 QAT 模型的在线更新与联邦训练,使模型能在新中心的数据分布上继续进化而不破坏三值约束。
复现评估
复现条件总体友好。代码与实验开源在 https://github.com/ReaganWu/TernScope;数据全部公开且无需申请:Kvasir-SEG(1000 张,720/80/200 划分)、CVC-ClinicDB(612 张)、CVC-ColonDB(380 张)。算法侧超参记录细致:256×256 输入、归一化到 [-1,1]、增广列表明确、TPQ 用 AdamW/batch 2/学习率 2e-4/200 epochs/无蒸馏,阶段进度比例(5%/35%/60%)、scale 重校准与 checkpoint 选择规则都有交代;模型仅 0.25M 参数,单张消费级 GPU 即可训练,算法部分复现难度低,预计一两天可跑通。硬件侧门槛较高:需要 Gemmini(Chipyard 生态)、Yosys/ABC 综合、Nangate45 45nm 标准单元库与 OpenSTA 功耗分析,工具链全开源但要自己搭流程,并严格控制 TT 1.1V、25°C 与综合脚本一致才能复现 88.457% 等数字,属于中等偏难,预计数天到数周;好在论文给出全部关键数字(面积、SRAM、频率、FPS、能耗),可直接对照校验。
论文图表
对比 U-Net、UNeXt、Mobile-PolypNet、EGE-UNet、CMUNeXt-S、TinyU-Net、U-RWKV-s、DAG-UNet、ESEUNet-ESK 与 TernScope 的参数量、GMACs、权重/激活位宽,以及 Kvasir-SEG 域内与 K→ClinicDB、K→ColonDB 跨域的 Dice/IoU。TernScope 以 0.2483M/0.0949 GMACs/W2A8 取得域内 0.8158/0.7247、跨域 0.7291/0.6290 与 0.5945/0.5015,整体领先。
这是核心结果表,量化了模型小但分割强的中心主张,也是确定本文相对九个轻量基线位置的一手数据。
五种配置对照:多分支 FP32(0.3233M/0.1064,Dice 0.8102/0.7142/0.5532)、重参数化 FP32(0.2483M/0.0949,分数逐位不变)、三值 PTQ(崩溃至约 0.0002)、直接三值 QAT(0.8075/0.7029/0.5636)、TPQ(0.8158/0.7291/0.5945,A/B/C 三个数据集)。
该表把结构简化的收益与低位宽适配的必要性干净地分离:融合免费省 23.21% 参数、PTQ 证明一步到位不可行、TPQ 是精度的真正来源,是方法各组件贡献的证据链。
TernScope 与原始 Gemmini 在相同负载、16×16 阵列、Nangate45 45nm、Yosys/ABC、TT 1.1V 25°C 下的对比:位宽 8/8 对 2/8;标准单元面积 1.816 对 0.540 mm²;计算阵列面积 0.685 对 0.079 mm²;SRAM 320 对 344 KiB;100MHz 下 FPS 11.902 对 102.701;逻辑能耗 14.019 对 0.604 mJ/图。
硬件协同设计的核心证据表,88.457%、70.275%、8.629 倍、95.690% 等结论数字全部来自此表,也如实暴露了 SRAM 略增的代价。