LightMIS:无逐级解码器的超轻量医学图像分割 LightMIS: Ultra-Lightweight Medical Image Segmentation Without a Stage-Wise Decoder
0.131M参数的无解码器分割网络,五级编码器一次聚合,精度逼近大型模型
前置知识
U-Net 与对称编码器-解码器结构
2015 年提出的医学分割基础架构:编码器逐级下采样提取从细节到语义的多尺度特征,解码器逐级上采样恢复分辨率,并以跳跃连接逐级融合浅层细节与深层语义,“逐级解码”是其标志性设计,nnU-Net 等大量变体都保留这一骨架。
本文标题即'无逐级解码器',只有理解传统 U 形网络如何通过解码路径融合层次特征,才能明白 LightMIS 砍掉了什么、用什么机制替代了它的功能。
深度可分离卷积(depthwise + pointwise)
将标准卷积拆为逐通道空间卷积(depthwise)与跨通道 1×1 卷积(pointwise/PWConv),参数与计算量约降为标准卷积的 $1/C$ 量级($C$ 为通道数),是 MobileNet 以来轻量化网络的基石,本文所有构件均由其搭成。
LightMIS 的 SAP、PRF、AKF 全部由 depthwise/pointwise 卷积构成,不理解其数量级优势就无法理解 0.131M 参数、0.575 GFLOPs 是如何做到的。
膨胀卷积(dilated convolution)
Dice $=2|P\cap G|/(|P|+|G|)$ 与 IoU $=|P\cap G|/|P\cup G|$ 衡量预测区域与标注的重叠度,越高越好;HD95(边界距离 95 分位数)与 ASSD(平均对称表面距离)以像素为单位衡量边界定位精度,越低越好。
AKF 的门控组合对象就是 depthwise 3×3 与膨胀 3×3($d=2$)两路响应,PRF 的三分支感受野互补设计也依赖膨胀卷积,是读懂公式 (2)(10) 的前提。
Dice、IoU 与边界距离指标
Dice $=2|P\cap G|/(|P|+|G|)$ 与 IoU $=|P\cap G|/|P\cup G|$ 衡量预测与标注重叠度,越高越好;HD95 与 ASSD 以像素为单位衡量边界定位精度,越低越好。
论文所有精度结论都用这四个指标表达,作者特别强调重叠指标(Dice/IoU)与边界指标(HD95/ASSD)要分开解读,某些数据集上边界指标才是区分模型的关键。
nnU-Net 与统一评测协议
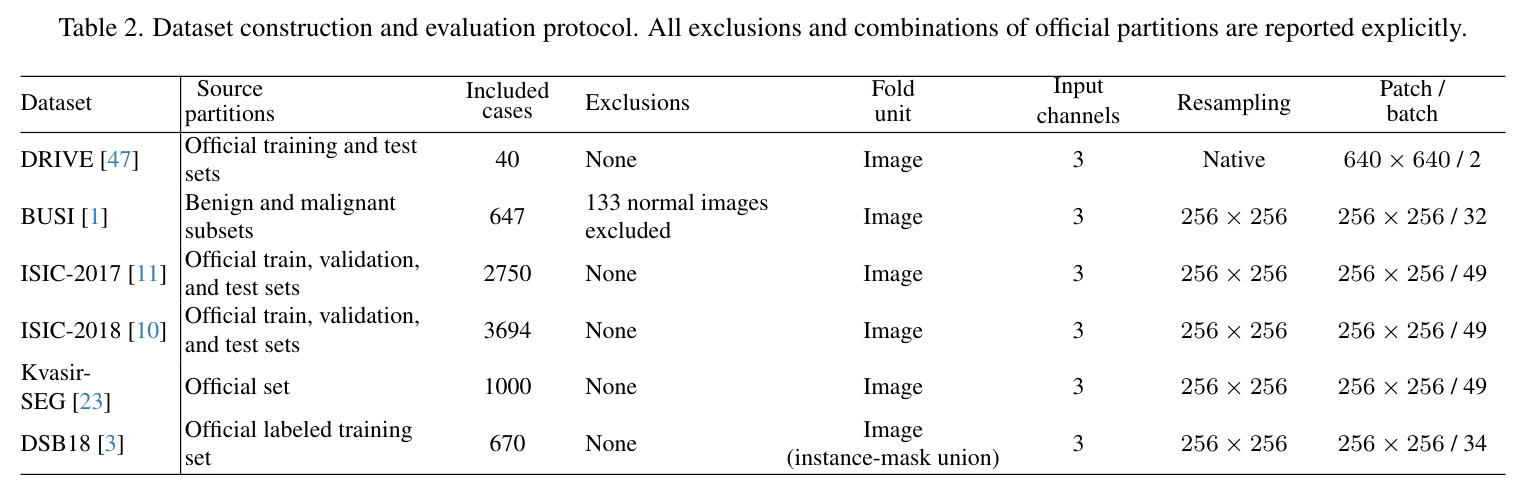
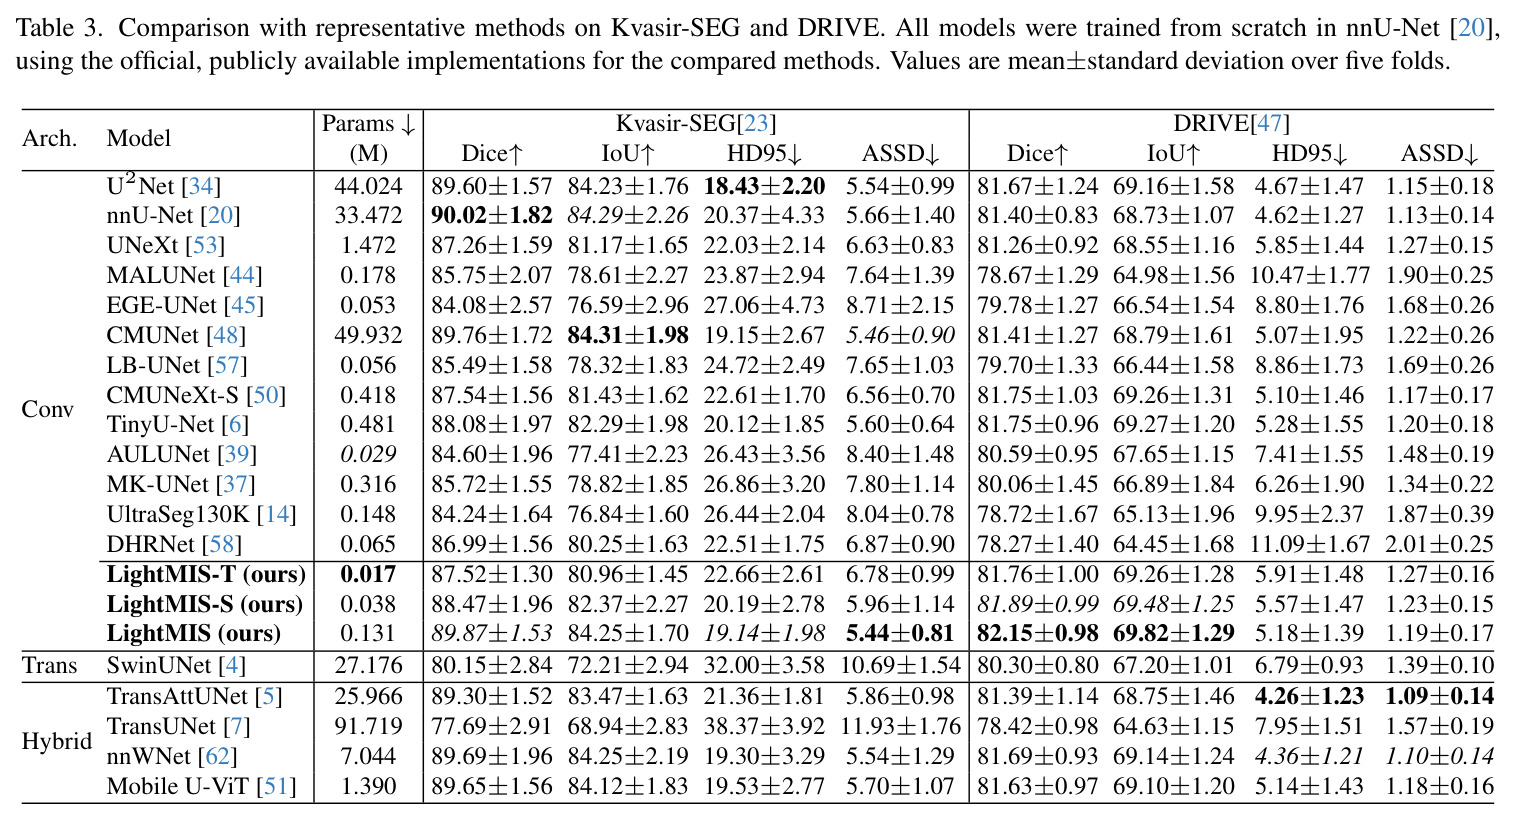
自动配置预处理、patch 尺寸、批大小与训练计划的医学分割框架,本身即最强基线之一。本文将 20 个对比模型统一嵌入 nnU-Net v2.3.1:从头训练 200 epoch、五折交叉验证、CE+软 Dice 损失,使结构成为唯一变量。
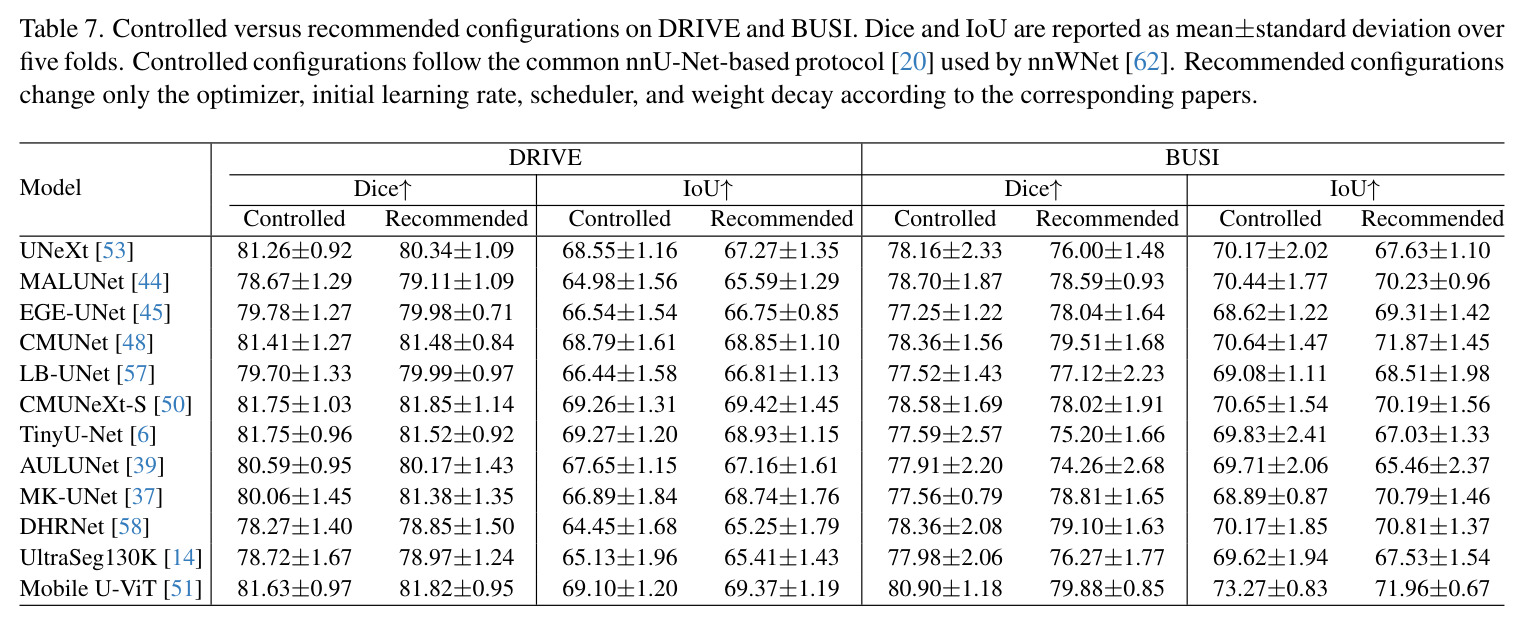
论文的核心卖点是'公平比较',所有表格数值均出自这一协议;同时作者在 Table 7 中检验了协议本身对各基线是否公平,理解协议才能正确判断结论的适用范围。
GFLOPs 与真实端侧延迟的差异
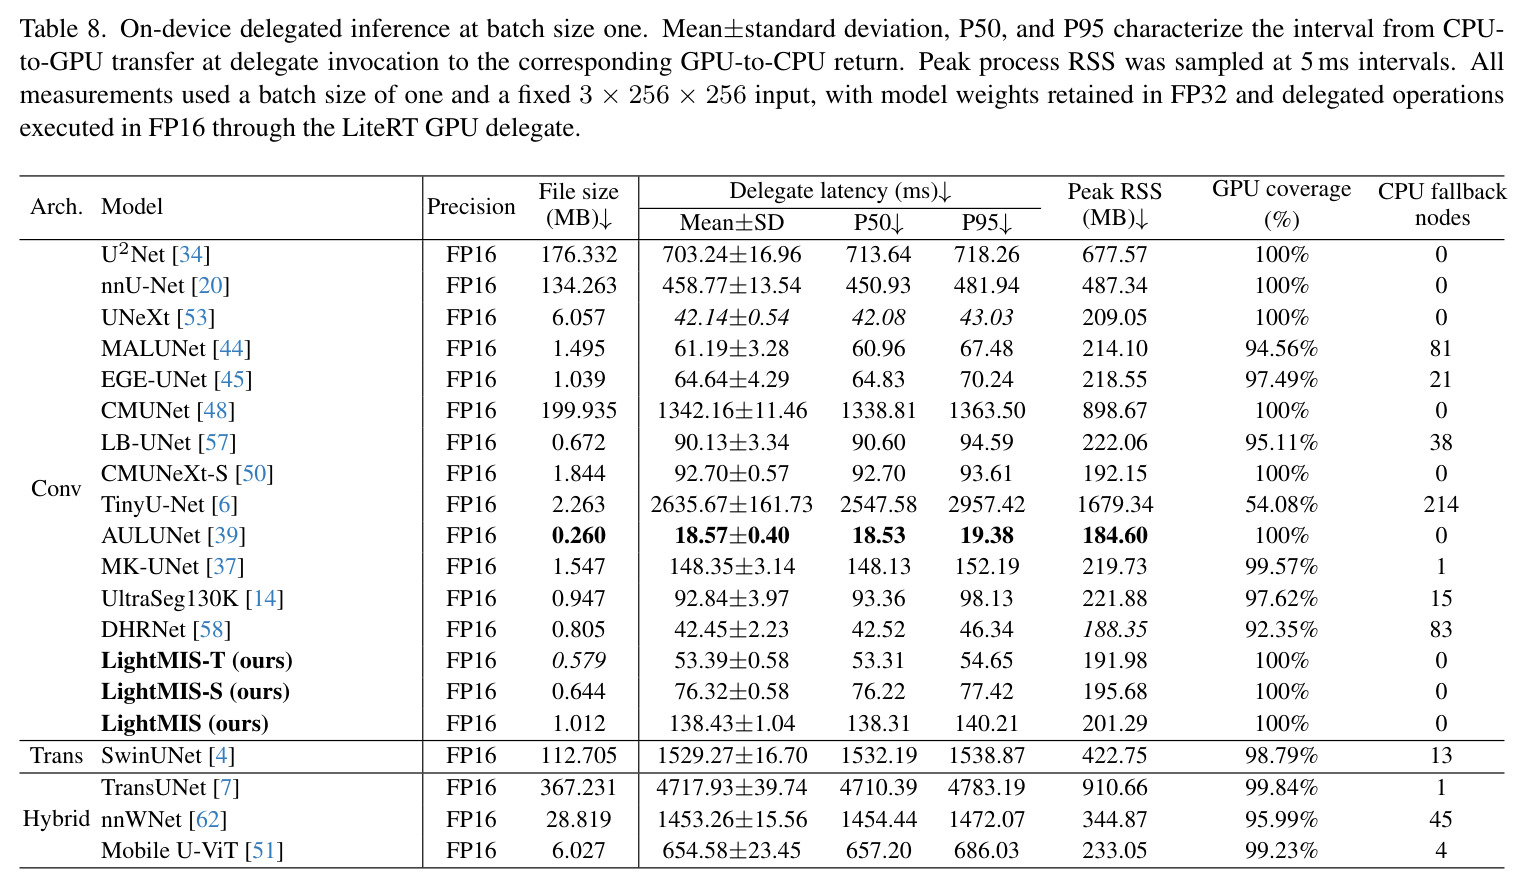
GFLOPs 是理论浮点运算数;真机延迟还取决于内存搬运、kernel 启动次数与算子支持度。文中 UNeXt 与 LightMIS 的 GFLOPs 几乎相同(0.577 对 0.575),手机延迟却相差 3 倍多,TinyU-Net 因 CPU 回退更高达 2.5 秒。
'GFLOPs 不能预测真机效率'是本文方法学层面的重要发现之一(Table 6 与 Table 8 的核心结论),理解这一点才能读懂作者为何同时报告理论复杂度与双端实测延迟。
LiteRT 与 GPU 委托(delegate)
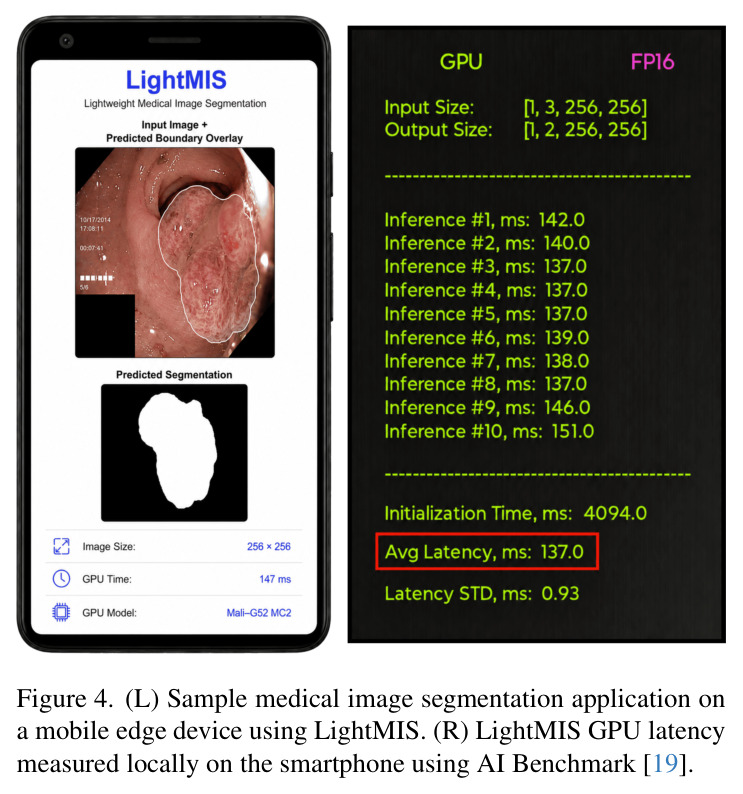
LiteRT(原 TensorFlow Lite)是 Android 推理引擎;GPU delegate 把算子交手机 GPU 执行,覆盖率指成功委托的算子比例,未覆盖节点回退 CPU 代价巨大。论文设置权重 FP32、委托算子 FP16,在 Mali-G52 上测 P50/P95 延迟。
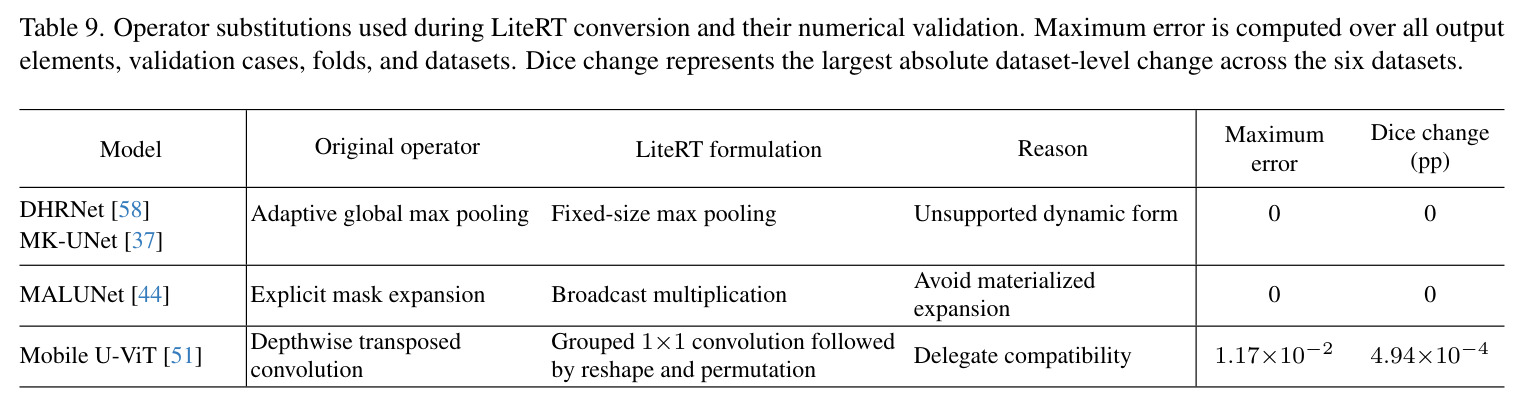
Table 8 中三个 LightMIS 变体均达到 100% 覆盖、0 个回退节点,是该模型端侧可行性的直接证据;而部分对比模型(如 TransAttUNet 因 BROADCAST_TO 算子不受支持)甚至无法完全上 GPU。
研究动机
医学图像分割对床旁监护、移动平台和资源受限临床环境的部署需求日益增长,但高精度模型普遍计算昂贵:在统一口径重算后,U2Net 有 44.024M 参数、nnU-Net 33.472M、TransUNet 高达 91.719M(30.286 GFLOPs)、混合架构 nnWNet 7.044M/10.618 GFLOPs、Mobile U-ViT 1.390M/3.294 GFLOPs。现有轻量化路线(UNeXt、MALUNet、EGE-UNet、TinyU-Net 等)虽压缩了模型,却仍保留 U 形编码器-解码器结构,靠逐级上采样与跳跃融合重建稠密预测;而已有的 decoder-free 工作(FSE-Net、CBL-Net、FAN-Net)评测几乎只聚焦视网膜血管分割单一任务。此外各论文训练配置五花八门,参数量与 FLOPs 统计口径不一,轻量模型之间的对比长期缺乏统一协议,真实端侧(尤其手机 GPU 上的算子覆盖与延迟)证据更是稀缺。
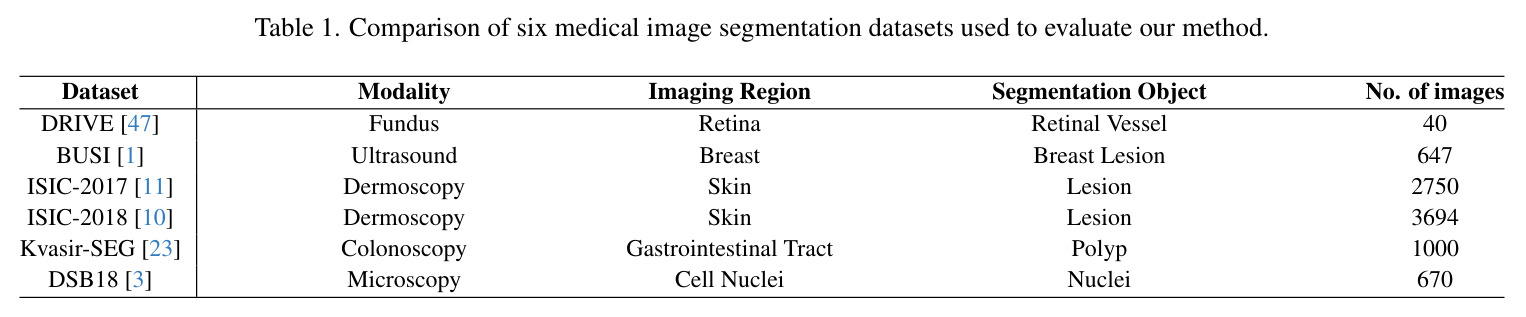
本文的目标是本文目标是构建一个可扩展的超轻量 2D 二值医学图像分割网络家族,彻底去掉可学习的逐级解码器:将五级编码器的完整层次输出直接对齐到共同空间分辨率、一次性聚合,再用紧凑头部细化并预测。具体验收标准为:在统一的 nnU-Net v2.3.1 训练评测协议下、跨 DRIVE(视网膜血管)、Kvasir-SEG(内镜息肉)、DSB18(显微细胞核)、BUSI(乳腺超声)、ISIC-2017/2018(皮肤镜)六个公开数据集,以 0.017M–0.131M 参数、0.099–0.575 GFLOPs 的代价逼近 Mobile U-ViT、nnWNet、nnU-Net 等大型模型的 Dice/IoU 与边界指标;同时在桌面 CPU/GPU 与智能手机 Arm Mali-G52 MC2 GPU 上给出延迟、峰值显存、模型体积与 GPU 委托覆盖率的完整效率画像,验证真实端侧执行可行性。
与已有工作不同的是,本文的独特切入角度是'架构哲学+评测方法学'的双重贡献。架构上,作者直接质疑自 U-Net 以来'必须对称逐级解码'的默认假设:完整编码器层次可以经 Scale-Aligned Projection 一次性对齐聚合,无需逐级上采样和编码器-解码器跳跃融合,多尺度信息主要由编码器内部的 AFC 模块增强、再由最终头部统一细化。与 FSE-Net/CBL-Net/FAN-Net 等 decoder-free 先驱相比,本文不局限于血管分割,而是同一家构不做任务特调地横跨五种成像模态。方法学上,作者把 20 个对比模型全部从头训练在同一 nnU-Net 协议下,按 NTIRE 超分挑战的约定统一重算参数量与 GFLOPs,补充配对 bootstrap 置信区间与 Benjamini-Hochberg 多重校正的统计检验、桌面与手机双端延迟、峰值显存,以及 LiteRT 算子替换的数值验证,填补了轻量分割领域'公平比较+真实端侧证据'的双重空白。
核心方法
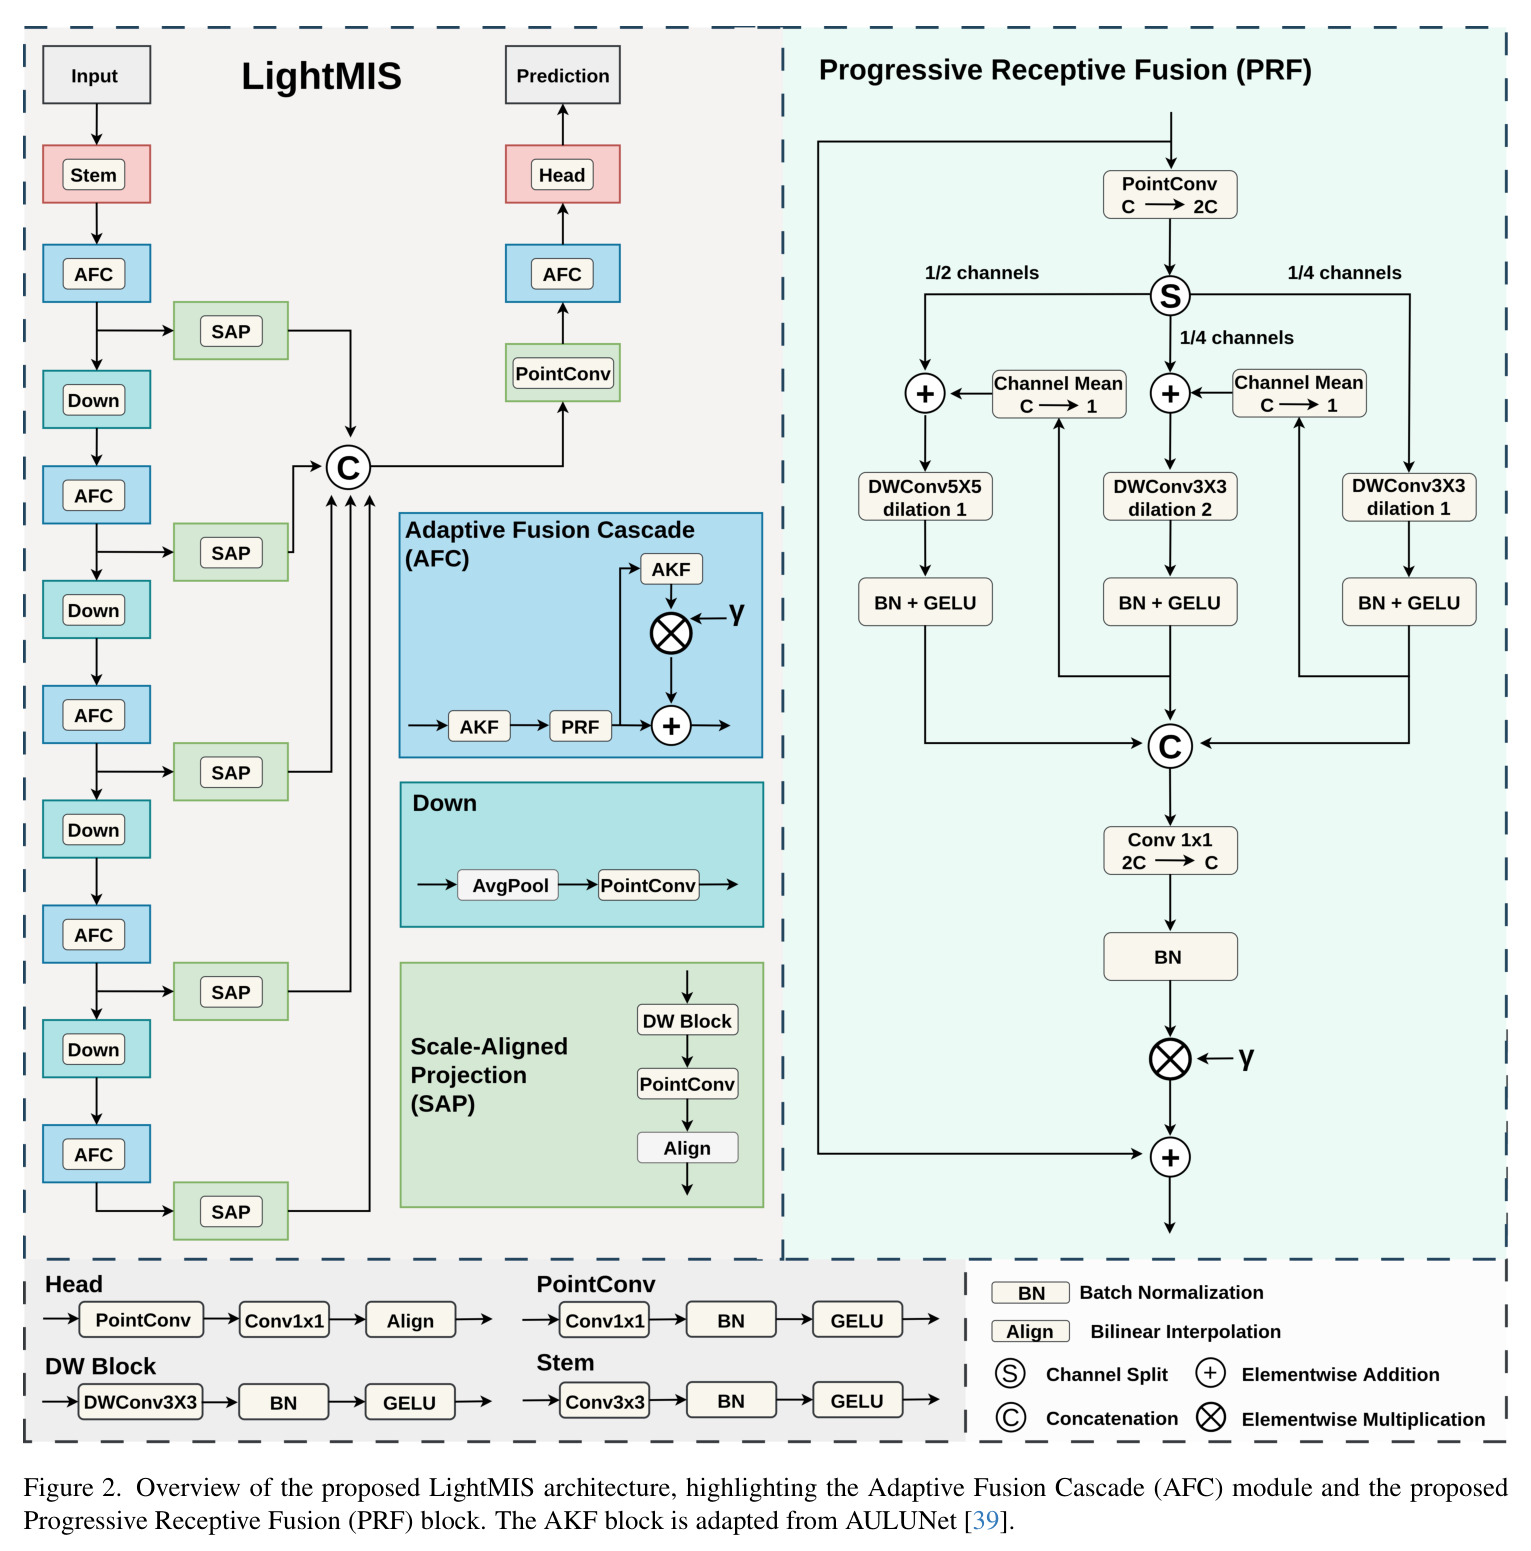
直觉上,编码器五级已天然包含从细粒度纹理到大范围语义的多尺度信息,U 形解码器只是把它们逐步搬回原分辨率的昂贵方式;若能把五个输出投影到同一空间尺寸、拼接后做一次紧凑细化,就能省掉整条解码路径。技术路线:输入先经 3×3 卷积+BN+GELU 得 $Z_0$;五级编码器中每级执行 $E_i=\text{AFC}(Z_i)$,其中 $\text{AFC}(U)=\text{ResAKF}(\text{PRF}(\text{AKF}(U)))$;级间用 $2\times2$ 平均池化加逐点卷积降采样。五个输出 $E_i$ 各经 Scale-Aligned Projection 块(DWBlock3×3 → PWConv → 双线性对齐到 $E_1$ 尺寸)得 $\bar{E}_i$,拼接成 $5F$ 通道后投影回 $F$,再做一次最终 AFC 细化得 $Q$,经 PWConv+1×1 卷积输出 logits,双线性放大回输入分辨率。三个规格只改变通道数与聚合宽度 $F$。
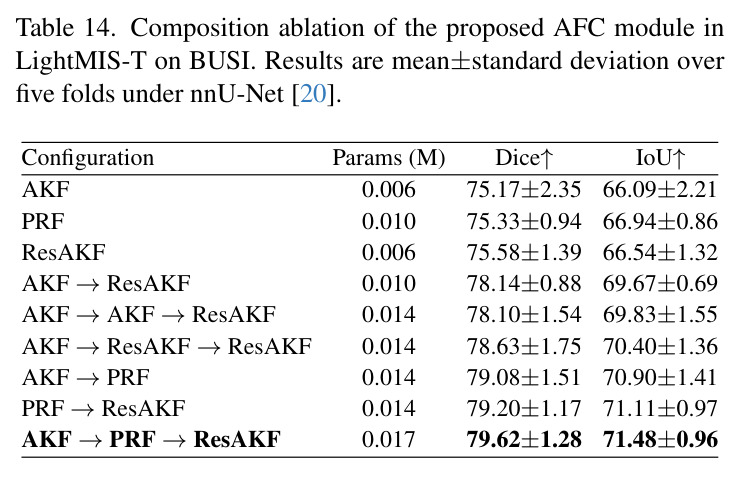
核心创新是 PRF 模块与 AFC 级联,以及“直接聚合替代对称解码”的整体设计。PRF 先用 PWConv 将特征临时扩展到 $2C$ 通道并三等分为 $A_0,B_0,C_0$,分别经 depthwise 3×3、膨胀率 2 的 depthwise 3×3、depthwise 5×5 形成互补感受野;与 TinyU-Net 的 CMRF 级联的本质区别在于:PRF 在每支卷积前把上一支的空间响应按通道平均 $\text{Mean}_c(\cdot)$ 注入下一支($\text{Mean}_c(A)$ 加入 $B_0$、$\text{Mean}_c(B)$ 加入 $C_0$)——通道平均使空间图与通道数解耦,异构分支无需通道匹配即可传递信息。三支输出拼接、投影回原宽度后以可学习标量 $\gamma_P$(初始 0.05)残差回连。AFC 把 AULUNet 的 AKF(sigmoid 门控自适应组合局部与膨胀响应)、PRF、残差 AKF 串联为统一细化单元。本质区别:多尺度融合从“解码器逐级搬运”变为“编码器内增强 + 头部一次聚合”。
方法步骤详情
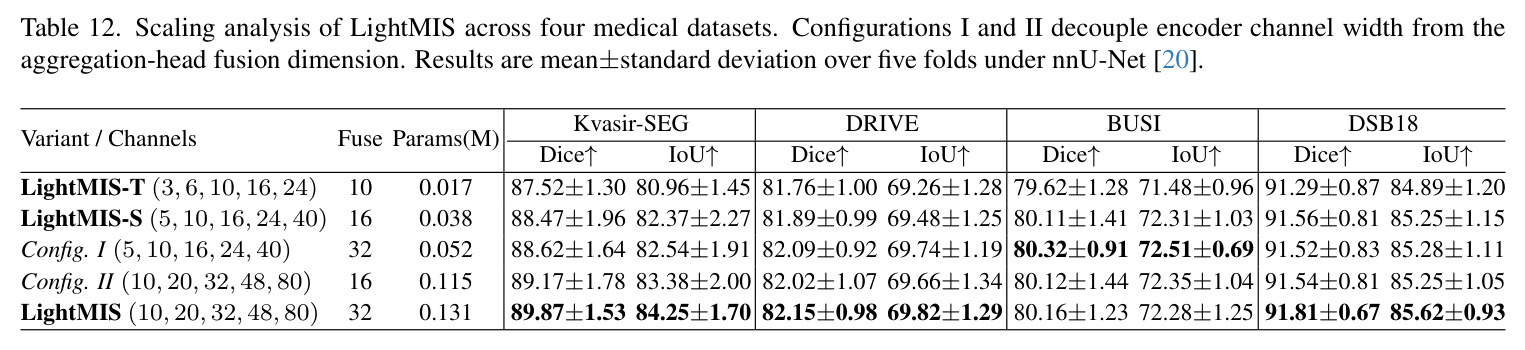
(1) 输入经 3×3 卷积、BN、GELU 得初始特征。(2) 每级编码器执行 $E_i=\text{AFC}(Z_i)$:AKF 用 sigmoid 门控 $\alpha$ 自适应组合局部 3×3 与膨胀 3×3($d=2$)深度卷积响应并经逐点卷积输出;PRF 做通道扩展、三分支异构卷积、通道平均渐进传递与拼接投影;ResAKF 以可学习标量 $\gamma_A$ 残差精修。(3) 级间用 2×2 平均池化加逐点卷积降采样。(4) SAP:每级输出经 DWBlock3×3 加逐点卷积,双线性对齐到 $E_1$ 尺寸。(5) 拼接五个对齐特征($5F$ 通道)投影回 $F$。(6) 最终 AFC 细化。(7) 逐点卷积加 1×1 卷积输出 logits,双线性放大后 softmax 取 argmax。三档规格:T 通道 (3,6,10,16,24)、宽 10,0.017M;S (5,10,16,24,40)、宽 16,0.038M;full (10,20,32,48,80)、宽 32,0.131M,GFLOPs 0.099/0.195/0.575。
技术新颖性
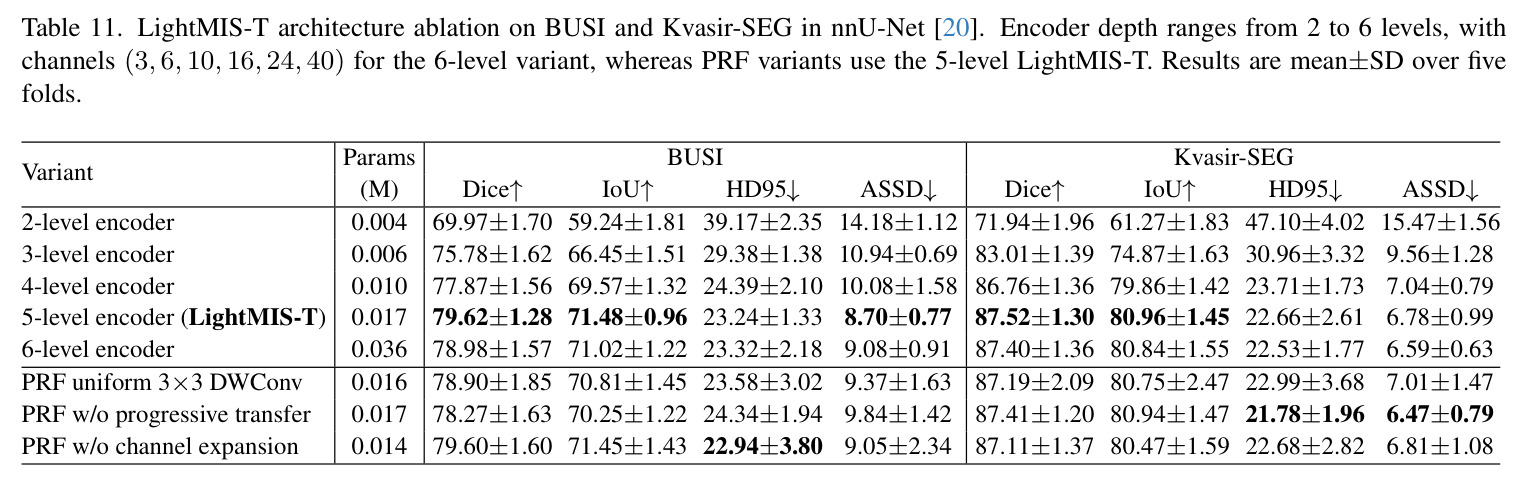
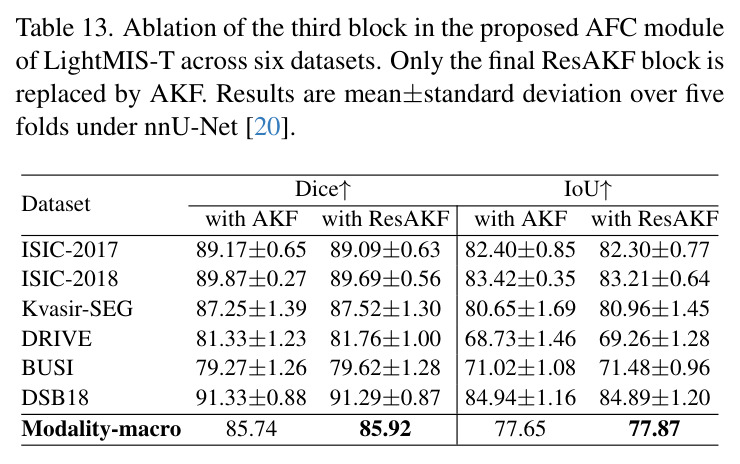
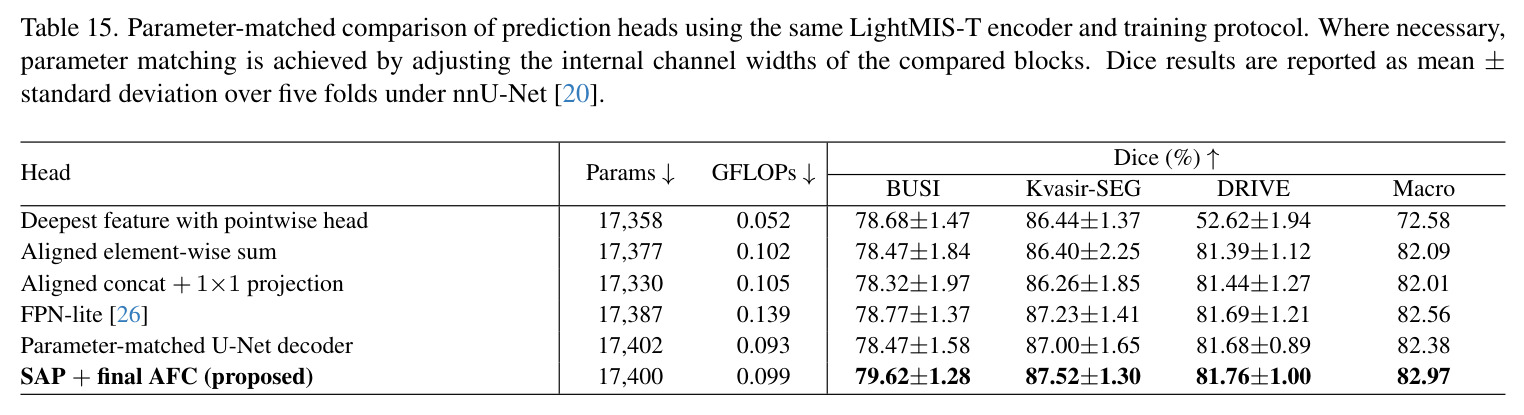
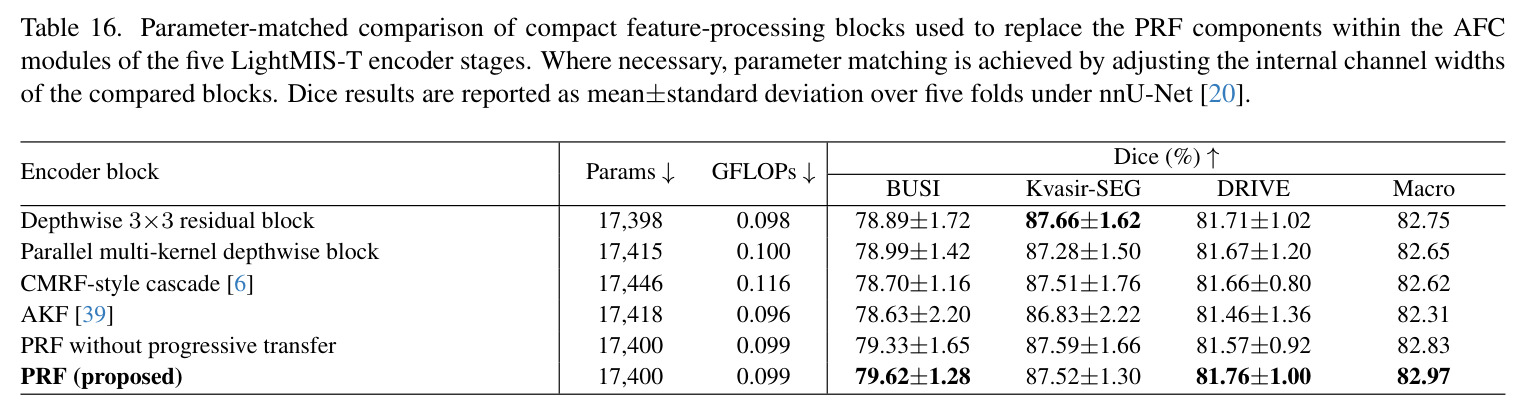
(1) 架构层面:LightMIS 是少数在五模态基准上系统验证“无逐级解码器”可行性的工作,区别于只在血管分割评测的 FSE-Net/CBL-Net/FAN-Net,也区别于仍在 U 形骨架内做减法的 MALUNet/TinyU-Net。(2) PRF 的渐进通道平均传递是新设计:通道平均使空间响应与通道维度解耦,异构分支无需通道匹配即可通信;消融显示去掉传递后 BUSI Dice 从 79.62 降至 78.27,参数匹配下 PRF 宏 Dice 82.97 优于 CMRF 级联 82.62 与并联多核块 82.65。(3) AFC 三段组合(AKF→PRF→ResAKF)优于任何单段或两段配置(BUSI Dice 79.62 对单独 AKF 75.17),且参数匹配下 SAP+AFC 头优于 FPN-lite(82.97 对 82.56)与紧凑 U-Net 解码器(82.38)。(4) 评测方法学:统一协议重训 20 个模型、NTIRE 口径重算 FLOPs、配对 bootstrap+置换检验+BH 校正、LiteRT 算子替换数值验证,这套公平性方案在轻量分割文献中罕见。
实验结果
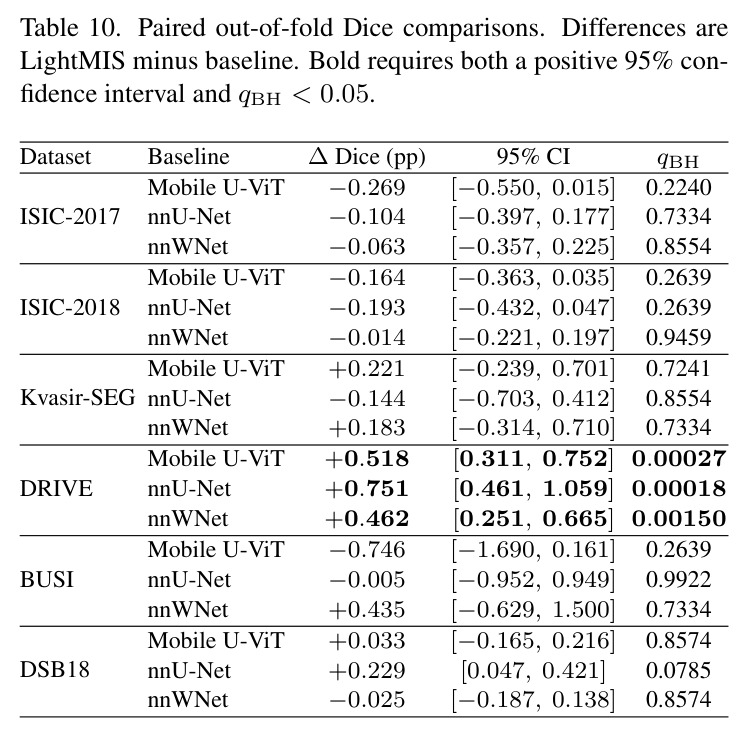
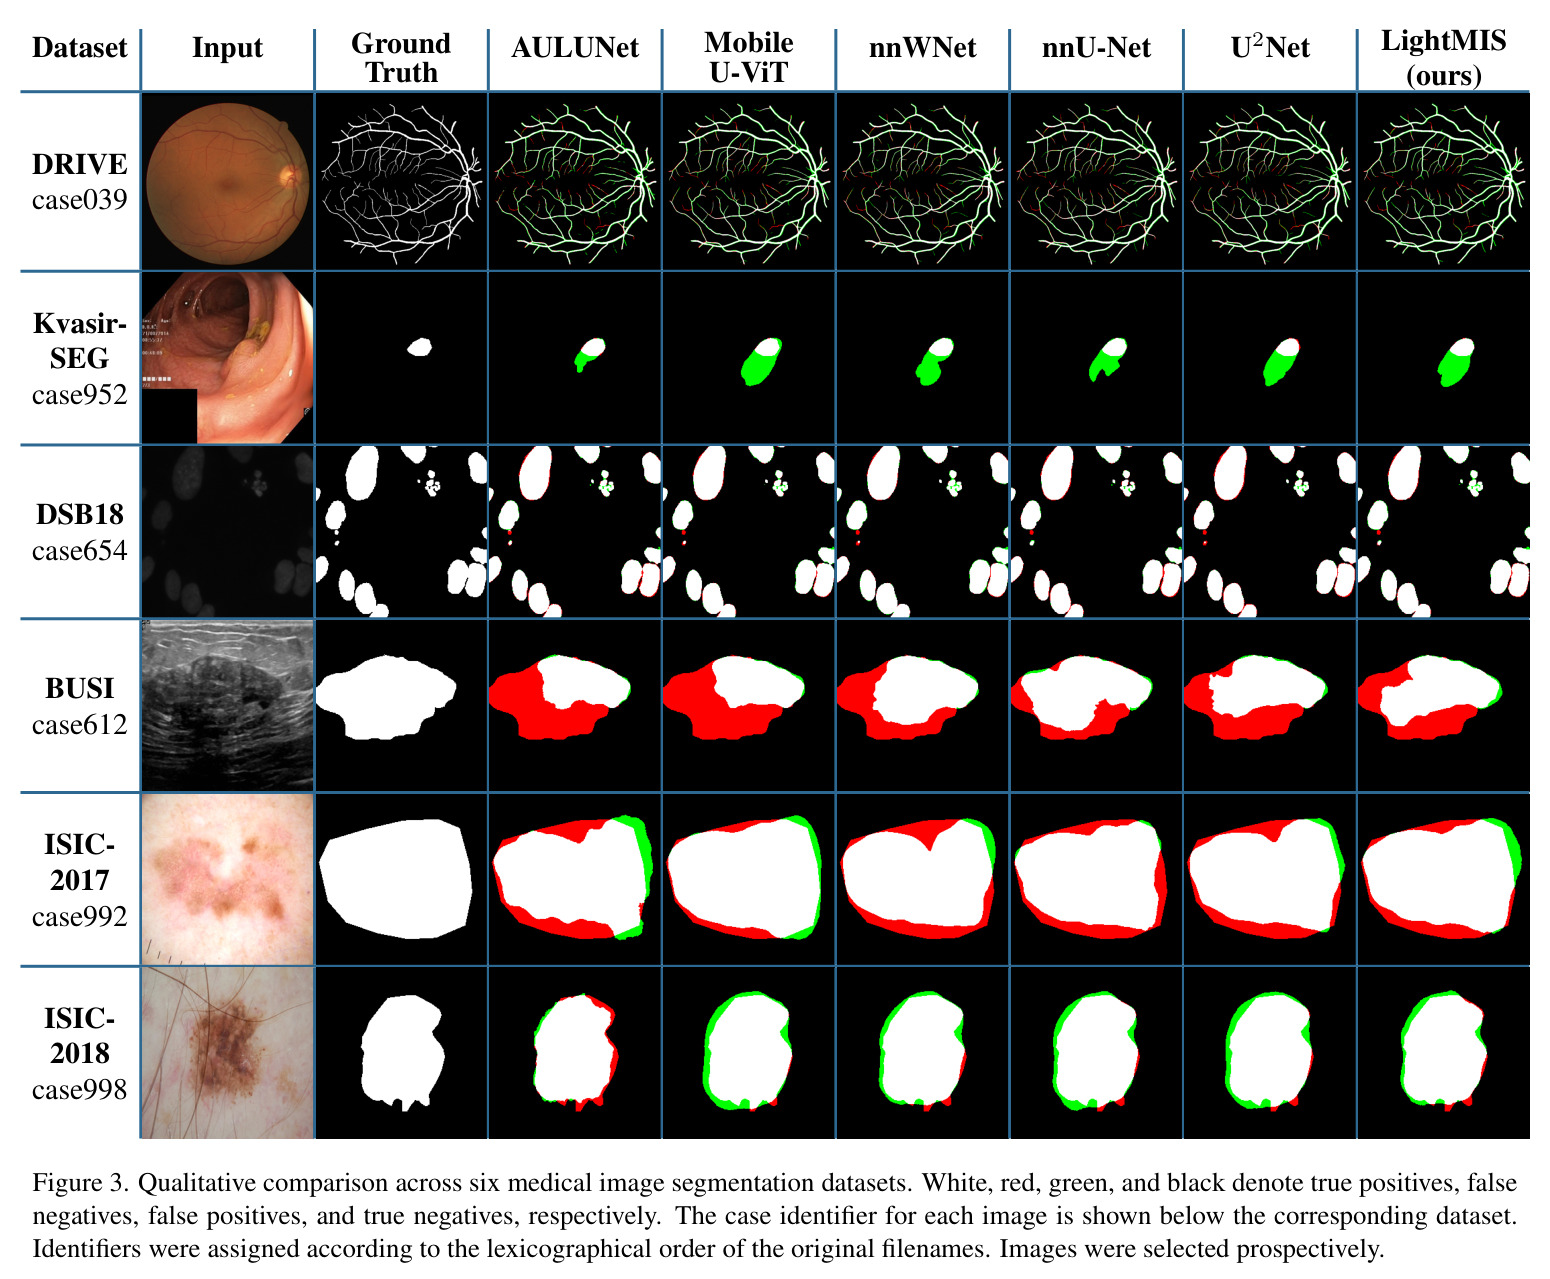
(1) DRIVE:Dice 82.15%、IoU 69.82% 全场最高,对三大基线(+0.46~+0.75pp)均显著(qBH<0.05)。(2) BUSI:80.16%,超 nnWNet 0.44pp。(3) DSB18:91.81% Dice,HD95 4.59 与 ASSD 1.53 全场最低。(4) Kvasir-SEG:89.87% Dice 差 nnU-Net 0.15pp,ASSD 5.44 最低。(5) ISIC 两集 89.32%/89.83% 居第二。模态宏平均 Dice/IoU 86.71%/78.99%,仅次于 Mobile U-ViT(86.75%/79.07%),但六数据集平均名次 3.42 最佳;参数少 90.58–99.61%、GFLOPs 少 82.54–96.14%。端侧 Mali-G52 P50 延迟 53.31–138.31 ms,GPU 覆盖 100%。消融:五级编码器最优;ResAKF 使宏 Dice 85.74→85.92;SAP+AFC 头 82.97 优于 FPN-lite 82.56,仅用最深层特征 DRIVE 崩至 52.62。
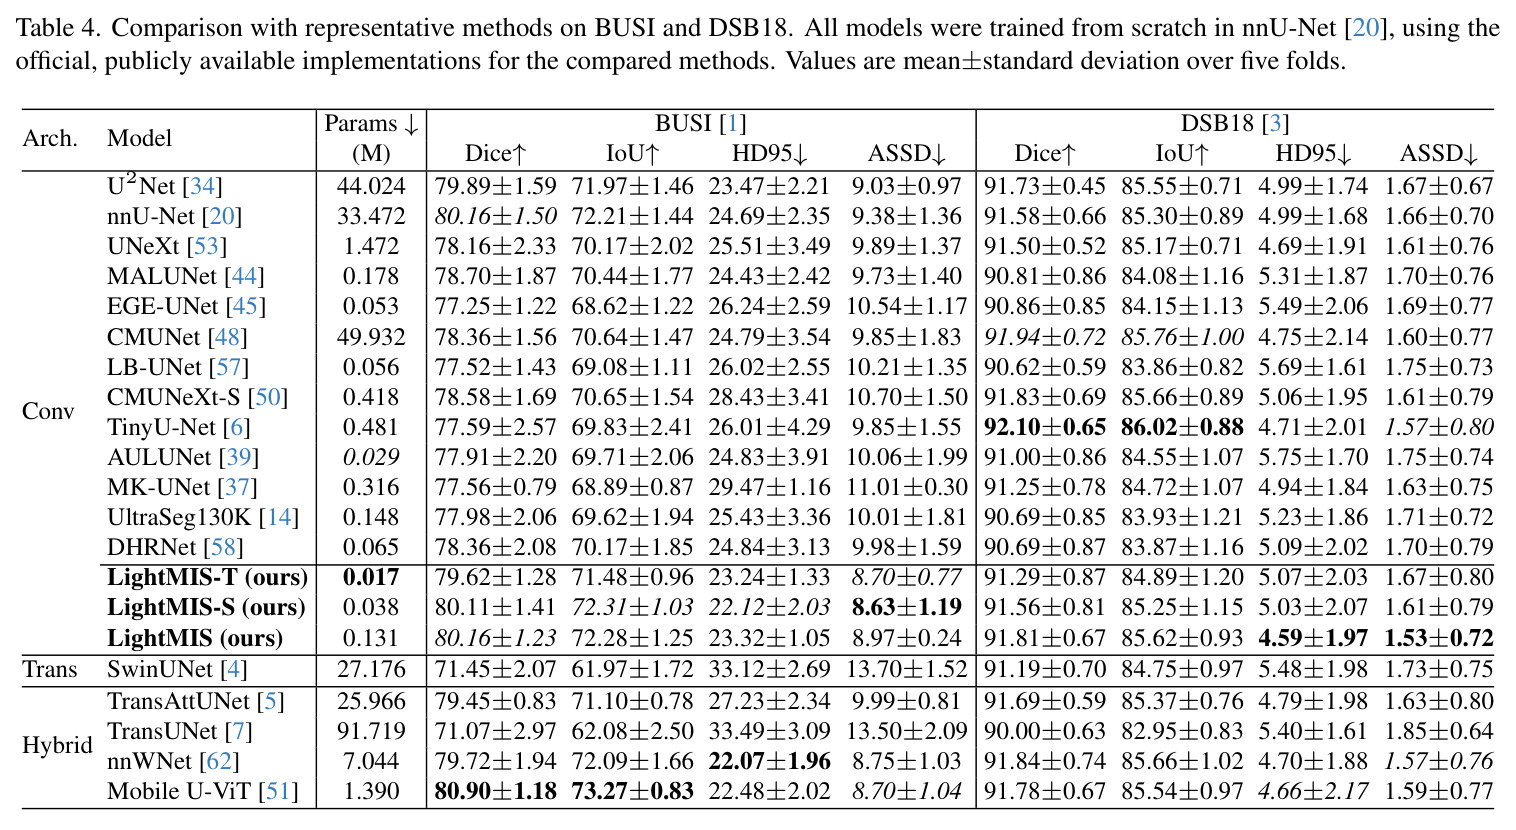
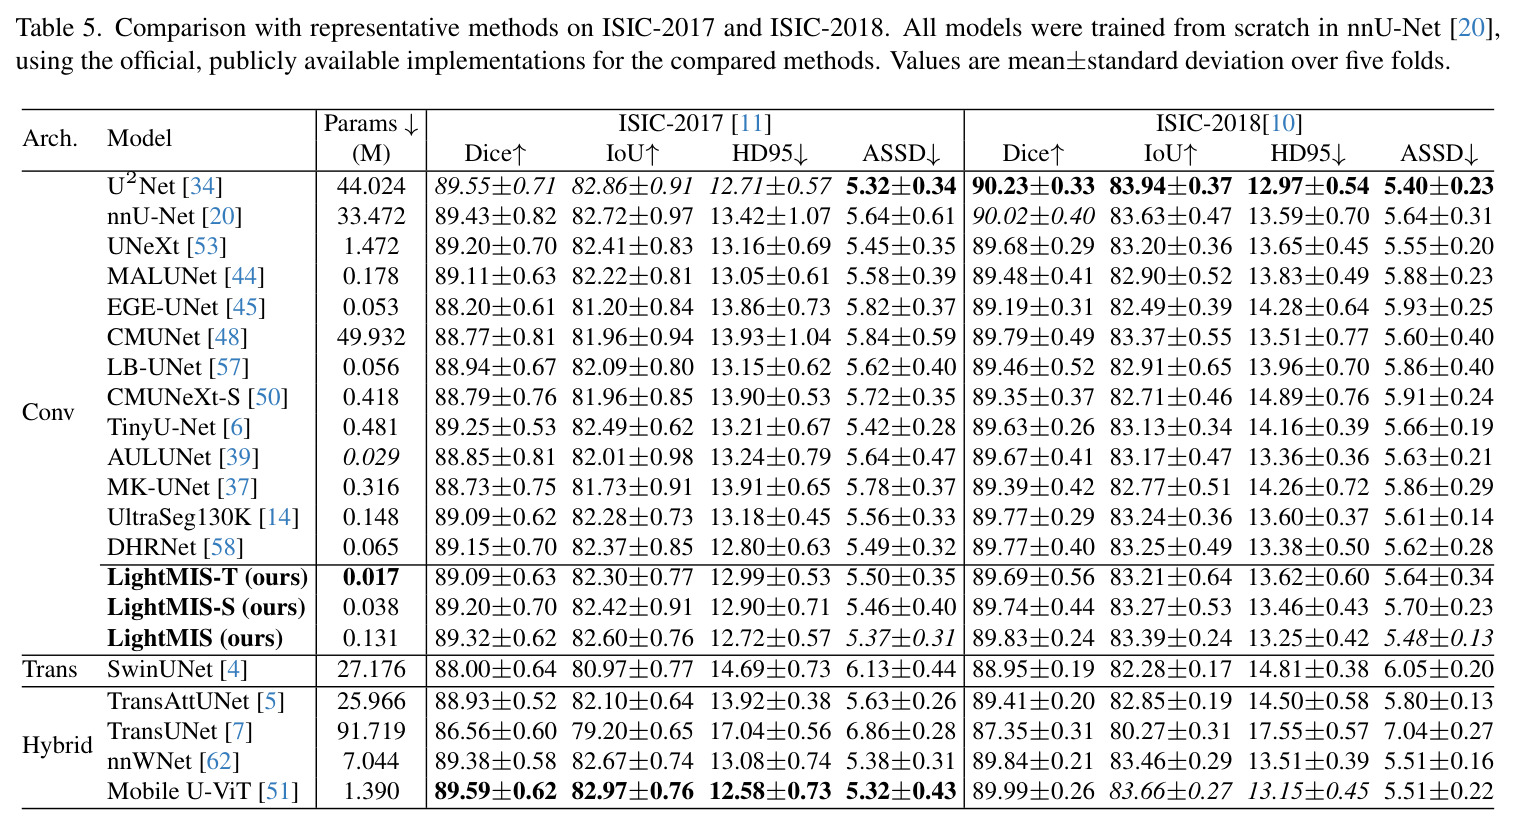
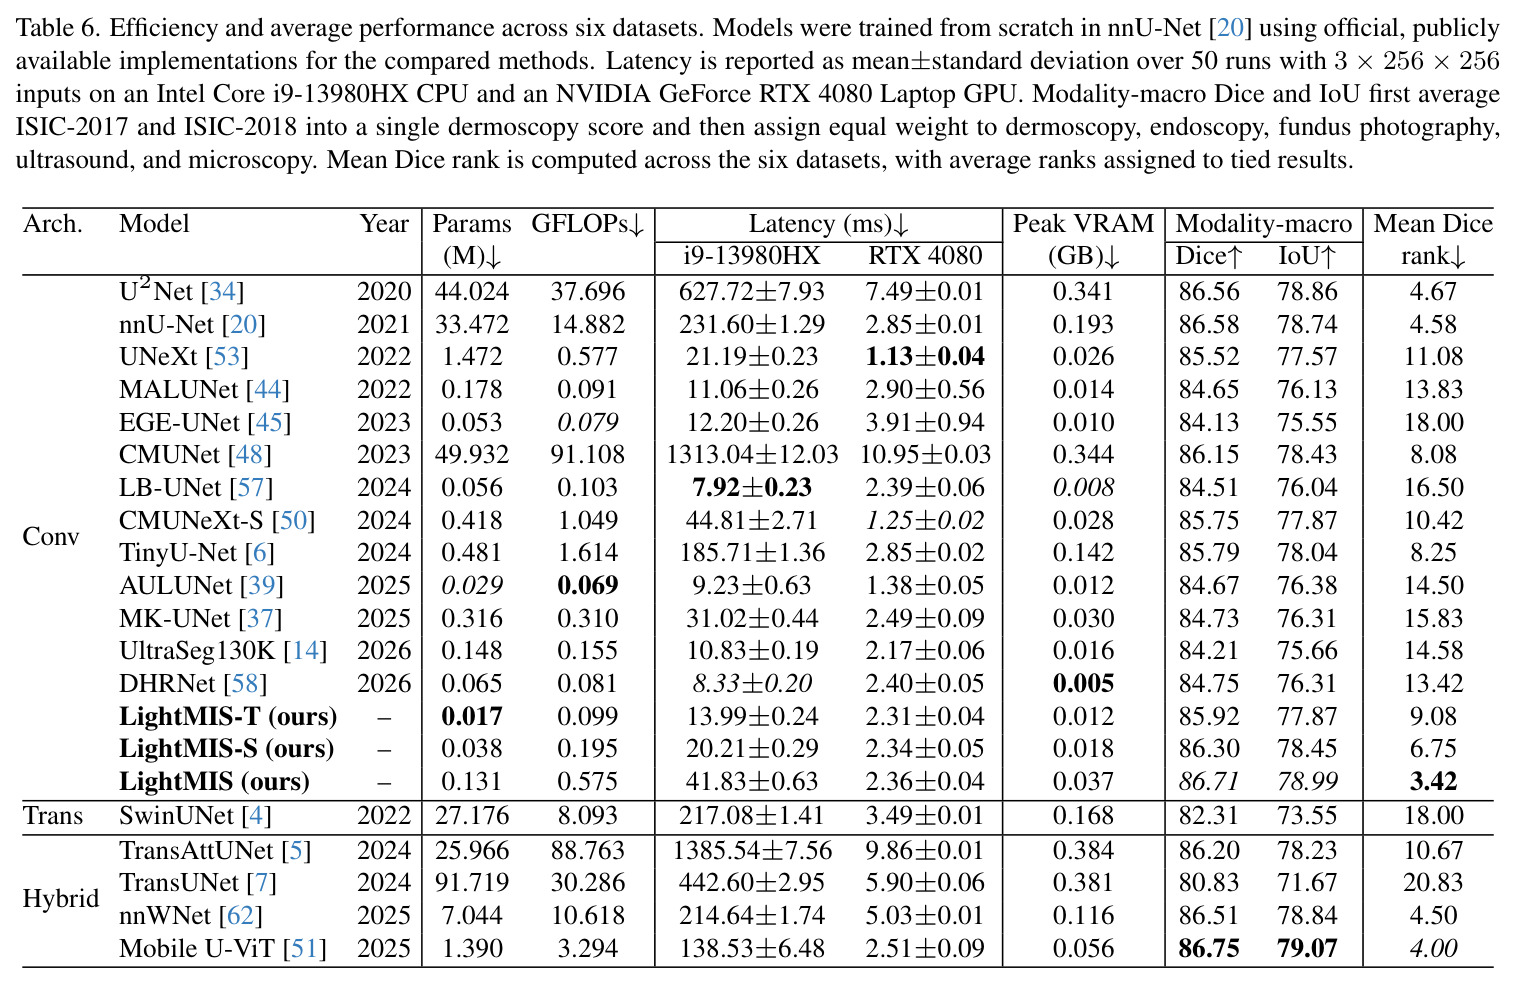
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 模态宏平均(6 数据集 / 5 成像模态) | Dice | 86.71% | Mobile U-ViT 86.75% | -0.04pp,但参数少 90.58%、GFLOPs 少 82.54%;六数据集平均 Dice 名次 3.42 全场最佳(Mobile U-ViT 为 4.00) |
| DRIVE 视网膜血管分割 | Dice | 82.15% | nnU-Net 81.40% / Mobile U-ViT 81.63% / nnWNet 81.69% | +0.75 / +0.52 / +0.46pp,均为统计显著(qBH<0.05) |
| BUSI 乳腺超声病灶 | Dice | 80.16% | nnWNet 79.72% / nnU-Net 80.16% | +0.44pp 优于 nnWNet;与 nnU-Net 持平但参数少 99.61%、GFLOPs 少 96.14% |
| DSB18 细胞核分割 | HD95 | 4.59 px(Dice 91.81%) | nnU-Net 4.99 px(Dice 91.58%) | 边界距离降低 8.0%,HD95 与 ASSD(1.53)均为全场最低 |
| Kvasir-SEG 息肉分割 | Dice | 89.87% | nnU-Net 90.02% | -0.15pp,但 ASSD 5.44 全场最低,且参数少 99.61%;大幅领先同类轻量模型(AULUNet 84.60%、EGE-UNet 84.08%) |
| 端侧推理(Mali-G52 MC2,FP16 委托) | P50 委托延迟 | 53.31 / 76.22 / 138.31 ms(T/S/full),100% GPU 覆盖 | Mobile U-ViT 657.20 ms / nnWNet 1454.44 ms | 约 4.8–10.5 倍于 Mobile U-ViT、10.5–27.4 倍于 nnWNet,且无 CPU 回退节点 |
| 参数匹配预测头对比(同 LightMIS-T 编码器) | 三数据集宏 Dice | 82.97%(SAP+最终 AFC,17,400 参数) | FPN-lite 82.56% / 参数匹配 U-Net 解码器 82.38% / 仅最深层特征 72.58% | +0.41pp 于 FPN-lite、+0.59pp 于紧凑 U-Net 解码器 |
| ISIC-2017 / ISIC-2018 皮肤镜 | Dice | 89.32% / 89.83% | Mobile U-ViT 89.59% / 89.99% | 均为第二(-0.27 / -0.16pp),仍领先 nnU-Net、U2Net 与绝大多数轻量模型 |
局限与改进
作者承认的局限:仅覆盖公开 2D 二值分割,未涉及多分类与三维数据;统一 nnU-Net 协议(200 epoch、无深度监督、无预训练)可能不利于依赖预训练或专属训练策略的基线——Table 7 显示按推荐配置 MK-UNet 在 DRIVE 上 +1.32pp,却让 AULUNet 在 BUSI 上 -3.65pp、TinyU-Net -2.39pp;DRIVE 与 ISIC 用池化标签交叉验证而非官方测试集,且无受试者级分组;除 DRIVE 外直接缩放到 256×256 破坏长宽比;移动评测仅一台手机一套软件栈,未覆盖能耗与热状态;无前瞻性临床验证。我的观察:统计显著性仅在 DRIVE 达成,宏平均与 Mobile U-ViT 差距虽小但方向为负,作者诚实只称“数值接近”;GFLOPs 与真机延迟严重脱节——同约 0.575 GFLOPs,LightMIS 比 UNeXt 慢 3 倍多(138.43 对 42.14 ms),AULUNet 以相近体积做到 18.53 ms P50,暗示多分支小算子堆叠对移动 GPU 不友好。
独立分析的弱点
(1) 一次性聚合放弃逐级精修:SAP 把 $E_0$–$E_4$ 全部双线性插值到 $E_1$ 的 1/4 分辨率,最深层语义需上采样 8 倍,对极小病灶或超长细结构可能损失细节,可探索两级聚合头(先粗聚合再在更高分辨率二次融合浅层)。(2) 通道平均 $\text{Mean}_c$ 传递是有损压缩:整支特征压成单张空间图广播,通道特异性信息全丢,可改用分组平均或轻量 1×1 投影。(3) PRF 各组件收益高度依赖数据集——Table 11 显示去渐进传递在 Kvasir-SEG 上 HD95 反而更优(21.78 对 22.66)、通道扩展对 BUSI 几乎无贡献,可引入按层可学习门控自动调节传递强度。(4) 真机效率非最优:同约 0.575 GFLOPs,延迟是 UNeXt 的 3.3 倍,分支多、单算子小导致 kernel 启动开销,可做训练多分支、推理重参数化融合或延迟感知剪枝。(5) 全局禁用深度监督可能低估自身与基线上限,DRIVE Dice 82.15% 距临床要求的血管级精度仍有空间,可探索边界感知辅助损失。各弱点共同指向:架构压缩与端侧友好的联合优化尚未系统化。
未来方向
作者明确列出的方向包括:受试者分组与外部机构验证、多分类与三维体分割、更多边缘处理器上的量化执行,以及将 PRF 与 AFC 推广到其他密集预测任务。基于本文成果可自然延伸的路线:其一,把 SAP+直接聚合范式移植到 3D nnU-Net 配置,检验无解码器设计在体数据(如 BraTS、AMOS)上的可扩展性;其二,针对移动端 kernel 启动开销做结构重参数化(训练期保留 PRF 多分支、推理期融合为等效单分支),有望在保持精度的同时把 138.31 ms 的 P50 压向 UNeXt 的 42 ms 量级;其三,把 PRF 的通道平均传递替换为可学习稀疏路由并与 NAS/剪枝结合,自动搜索每级最优分支组合;其四,在 MedSAM 等自监督预训练初始化下重新评估该家族——统一从头训练协议排除了预训练红利,而 Table 7 已暗示 Transformer 系模型可能更依赖预训练;其五,为轻量模型添加不确定性估计与校准,使点状部署的输出可纳入临床决策流程;其六,把 Table 8 的委托覆盖率与算子替换分析提炼成'边缘友好算子设计准则',反哺新一代轻量架构设计。
复现评估
复现条件属同类论文顶级:实现、环境说明、五折划分、nnU-Net plan 文件、数据集转换脚本、全部基线 commit hash、训练命令、checkpoint、FLOP 计数脚本、LiteRT 转换与双端基准脚本全部开源于 github.com/AndreiiArhire/LightMIS。数据为六个公开数据集(最大 ISIC-2018 共 3694 张)。训练基于 nnU-Net v2.3.1 + PyTorch v2.11.0,从头训练 200 epoch × 5 折,单卡 RTX 4080 Laptop 即可,最大模型仅 0.131M 参数,个人可承受。风险点:20 模型 × 6 数据集 × 5 折的全量基线复现耗时;移动基准绑定 Android 14 / Moto G24 Power / LiteRT v1.4.1,不同 delegate 版本算子支持可能变化(论文已验证算子替换数值误差可忽略);nnWNet 未公开其数据集转换脚本,数值直接对齐存在不确定性。总体难度:低到中,成本主要在全量基线重训。
论文图表
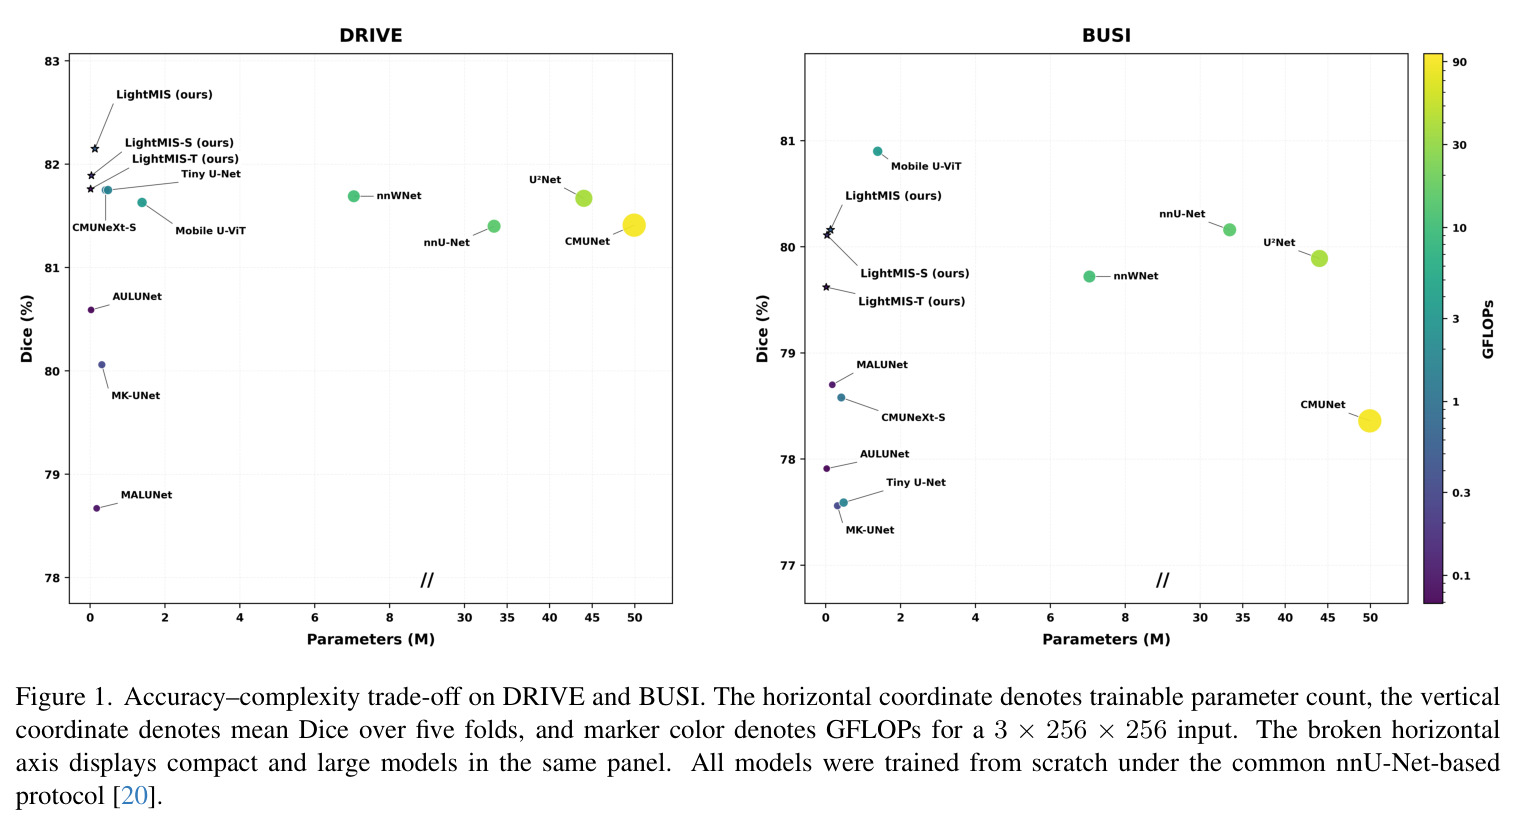
以横轴为可训练参数量、纵轴为五折平均 Dice、标记颜色为 3×256×256 输入下的 GFLOPs,在断轴坐标中同时展示轻量与大型模型的精度-复杂度权衡。所有模型均在统一 nnU-Net 协议下从头训练。
一图概括全文卖点:LightMIS 位于左上角高精度-低参数区域,直观展示其以两个数量级更少的参数逼近大型模型的权衡优势,是引言部分的核心论据。