从VLM规划器到机器人智能体:面向历史依赖操控的自进化Harness From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
用可编辑harness组织VLM智能体并从执行经验自进化,历史依赖操控提升7个百分点
前置知识
VLA模型
Vision-Language-Action模型把相机图像、本体状态与语言指令直接映射为机器人动作序列(通常一次输出一段action chunk),代表工作有RT-2、π0、π0.5、OpenVLA。它们在短时程操控上表现很强,但默认只以当前观测为条件,不显式保留历史信息。
SERA的底层执行器就是一个参数完全冻结的VLA,高层VLM通过语言命令驱动它;理解VLA的输入输出接口(图像+子任务语言→动作块)是读懂整个规划-执行回路的前提。
非马尔可夫任务(历史依赖操控)
马尔可夫设定下当前状态足以决定最优动作;非马尔可夫任务的决策还依赖未观测的历史,例如'按压按钮三次'需要知道已成功按压几次,'放到演示中第二个访问的目标处'需要记住演示顺序,相似观测可能要求不同动作。
这是论文的问题定义和全部实验的出发点:RoboMME专为评测这类能力设计,SERA的任务上下文维护机制就是为了让历史信息在决策时持续可用。
层级规划架构
把控制分成两层:高层模型(VLM/LLM)周期性输出子目标或语言命令,低层策略(VLA或技能库)把子目标转成连续动作,代表工作有SayCan、RT-H、Inner Monologue、MemER,可以在层间引入环境反馈。
SERA是典型的VLM高层+VLA低层层级系统,论文与SimpleSG、GroundSG、MemER等层级基线的对比,以及对'高层规划器'的改造都建立在这套架构之上。
Harness(可编辑编排外壳)
围绕模型的一段外部代码与提示结构,负责组装输入、维护运行时状态、校验模型输出、控制重试与恢复流程;模型参数不动,只改外壳就能改变系统整体行为,例如改prompt指导、结果判定标准、恢复规则。
harness是本文的核心概念与自进化对象:episode内它是任务上下文的组织者,跨episode它是被诊断和修订的显式目标,理解它才能区分本文与改模型参数的方法。
SFT(监督微调)
用人工标注或专家演示构成的(输入,输出)数据对对模型做监督微调,是训练高层规划器的传统做法;需要大量昂贵的演示数据,且改的是模型参数本身。
SERA刻意强调不构建SFT数据集也能改进规划:所有改进都落在harness的结构化文本与规则修订上,这是它与MemER等训练式层级方法的关键分界线。
RoboMME基准
Dai et al. (2026)提出的机器人记忆基准,包含Counting、Permanence、Reference、Imitation四个套件共16个历史依赖操控任务,官方leaderboard提供各基线的任务平均成功率,是本文唯一的定量评测平台。
论文的全部数字(51.38%整体成功率、+7.00个百分点等)都在该基准的800个episode(16任务×50 episodes)上测得,理解其任务构成才能解读各套件的强弱差异。
研究动机
VLA模型(如π0.5)在视觉观测加语言指令到动作的映射上表现出色,但长时程任务的决策往往是非马尔可夫的:当前观测不足以决定动作。论文开篇给了一个直观例子——'按下按钮三次'任务中,机器人看到的两张图像几乎相同,但根据已成功按压的次数(1/3还是3/3),正确决策分别是'再按一次'和'停止';更隐蔽的情况是关键线索只出现在早期观测里,随后从画面中消失。RoboMME基准(Dai et al., 2026)的系统评测显示了问题的普遍性:π0.5整体成功率仅17.93%,加入动作历史也只到19.40%,记忆增强的SAM2Act为21.37%,说明单纯强化感知-动作映射难以保留和使用历史信息。层级方法(如MemER,42.38%)虽有改善,但高层VLM往往被当作一次性子目标生成器,既缺乏episode内持续维护任务上下文的机制,也没有从执行失败中系统性改进规划流程本身的通道。
本文的目标是本文的目标是把高层VLM从'规划器'升级为'智能体',具体包含两个相互衔接的能力。其一是episode内的任务上下文管理:在部分可观测且执行会出错的长时程任务中,从观测和执行反馈中提取、保留并更新任务进度、决策相关事实和未解决的不确定性,使早期事件在图像离开观测窗口后仍能影响后续规划,例如记住'已成功按压2次'或'演示中第二个访问的目标'。其二是跨episode的执行驱动自进化:利用环境rollout自动诊断初始harness的局限,修订其规划指导、评估标准与控制规则,且不构建SFT演示数据集、不微调VLM规划器与VLA执行器。最终在RoboMME的16个任务×50 episodes共800个episode上验证:自进化应带来可量化的成功率提升(论文报告为7.00个百分点),并且所选harness配置在held-out测试前固定,以保证评测的严格性。
与已有工作不同的是,已有工作各有切入角度:记忆增强策略(HAMLET、MemoryVLA、ContextVLA、WeaveLA等)把历史压缩进动作模型的表征;层级方法(SayCan、RT-H、MemER、Goal2Skill)训练或prompt一个高层规划器输出子目标;agentic系统(ReAct、Reflexion、Voyager)证明了推理-行动-反馈循环的价值,但很少用于真实操控。近期具身harness工作(Harness VLA、HELM、Cortex)给冻结VLA加装固定外壳,ETA、SHAPER、Zetta开始探索经验驱动的harness自适应,但尚未聚焦历史依赖操控这一具体问题。SERA的独特之处是把可编辑harness作为统一修改对象:episode内它是上下文的组织者,跨episode它成为自进化的显式载体;修订被约束为规划指导、评估标准、控制规则三类结构化组件,保留执行器命令接口不变,并用配对rollout验证与pre-test固定协议保证经验复用的可审计性。
核心方法
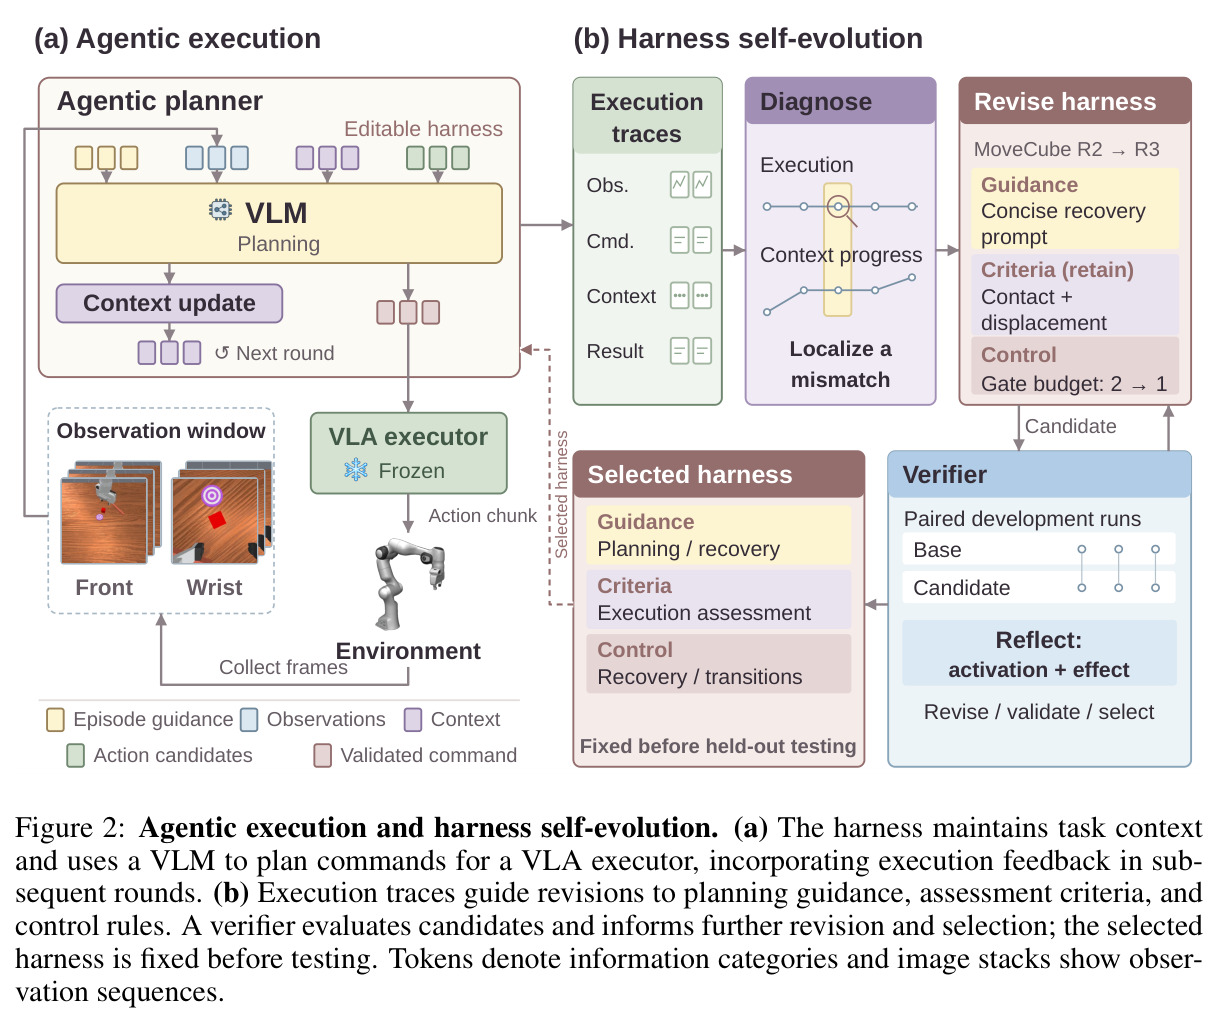
直觉上,高层VLM的规划质量取决于三件事:喂给它什么信息、如何解读执行反馈、如何控制重试与推进的流程。SERA把这三件事从模型内部搬到显式的可编辑harness $H$ 中,让系统自己从失败中改进这套逻辑。技术路线上,SERA由可编辑harness、VLM规划器(gpt-5.6-sol via Codex,reasoning effort为high)和参数冻结的VLA执行器组成。episode初始化时从指令 $i$ 与初始上下文 $c_0$(如一段演示)导出固定的episode指导 $g$;此后每轮规划,harness向VLM提供 $g$、近期观测窗口 $V_n$、运行时上下文 $c_n$、上一条命令 $u_{n-1}$ 和候选命令集 $A_{cand,n}$,VLM在同一次调用中评估上一命令效果并输出更新后的上下文与高层命令:$(c_{n+1}, u_n) = P_H(g, V_n, c_n, u_{n-1}; A_{cand,n})$,其中 $P_H$ 同时包含VLM调用与harness的校验、控制逻辑。命令经格式校验后交给冻结VLA预测action chunk并执行其有界前缀,采集观测后进入下一轮规划。
核心创新是把harness本身作为自进化的显式修改对象,这与改模型参数的两类主流做法有本质区别:记忆增强方法要训练VLA的记忆模块,层级SFT方法要为高层VLM构建演示数据集。SERA只修改harness的三类外部组件——planning guidance(引导VLM规划与恢复的程序性指导)、assessment criteria(判断执行效果所需的证据标准)、control rules(恢复与任务切换规则);候选修订用结构化manifest表达,含任务范围、激活条件、组件与修订谱系,且执行循环可以应用和检查这些修改、保留执行器命令接口,论文明确拒绝未注册的Python干预插件以保证可审计。自进化闭环为:分析agent从执行轨迹定位首次偏离点并给出修复假设→修订agent生成候选bundle→verifier在同一评估episodes上与缓存的baseline结果配对比较(统计修复的失败数与退化的成功数)→反馈驱动再修订或换修复目标,预算内自主选择 $H^\star$ 并在held-out测试前固定。
方法步骤详情
方法分执行与进化两个阶段。(1) 初始化:从指令与初始上下文导出episode指导 $g$,episode内固定。(2) 上下文维护:每轮生成上限1600字符的进度摘要,记录当前阶段、已完成步骤、任务/物理/执行状态与不确定性,另有held-object、gripper状态等结构化字段,以及跟踪停滞的计数器,episode间重置。(3) 上下文感知规划:VLM评估上一命令效果后,从命令catalog选模板并填grounding点(0-999归一化坐标+物体描述+帧),harness校验模板、点数、坐标界与帧有效性后才下发。(4) 执行与反馈:冻结VLA结合front/wrist图像与本体状态预测action chunk并执行有界前缀;下一轮依据执行证据决定继续、推进或恢复缺失前置条件,执行状态分为progressing/completed/uncertain/stagnant/regressed等。(5) 自进化:失败诊断→候选修订(触及指导/标准/规则三类组件)→verifier在如PatternLock的6-episode开发panel上与baseline配对评估→通过者再在未参与诊断的episodes上做fresh validation→自主选择(含预算耗尽时仅+1成功且无回归的fallback),$H^\star$ 固定后进入测试。
技术新颖性
新颖性有三点。第一,经验复用的对象从模型参数转移到harness:不需要为高层VLM构建SFT数据集,修订是可审计的结构化文本与规则更新,并被约束为执行循环可应用、可检查的组件。第二,明确区分两种时间尺度的记忆:episode内不断更新的任务上下文 $c_n$(测试时仍持续运行)与跨episode固定的harness配置 $H^\star$(pre-test固定),避免把'上下文维护'与'流程改进'混为一谈。第三,验证协议严格:候选与缓存baseline在同一episodes上配对比较,选择协议包含fresh validation通过的候选与少量明确声明的fallback,被选中者即使测试分数下降也保留在聚合中,不做per-task事后挑选;附录Table 2还同时给出本地复现的MemER作对照。相比MemER(训练VLM提名历史关键帧)与Harness VLA、HELM、Cortex(外壳固定不可改),'harness本身可进化'是SERA的关键差异。
实验结果
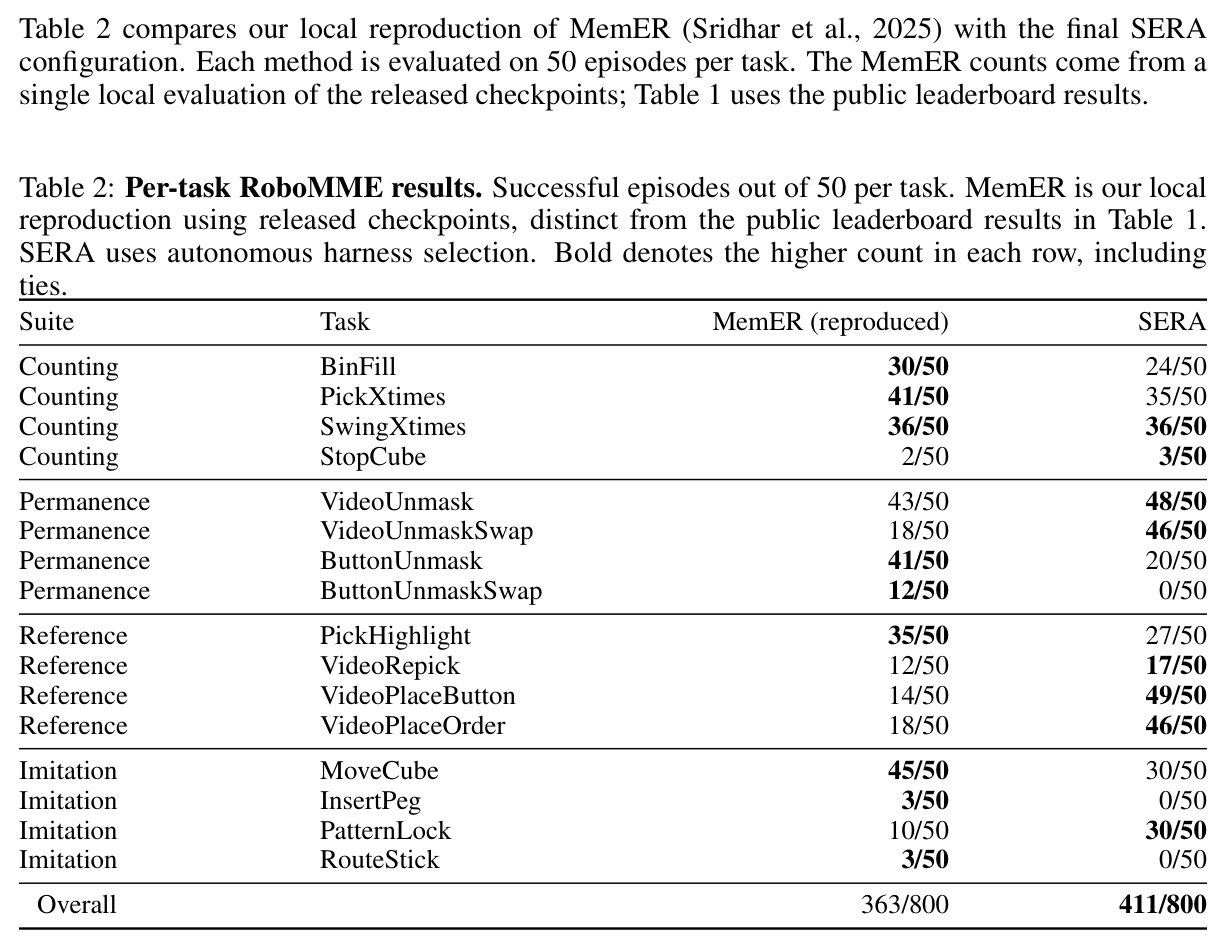
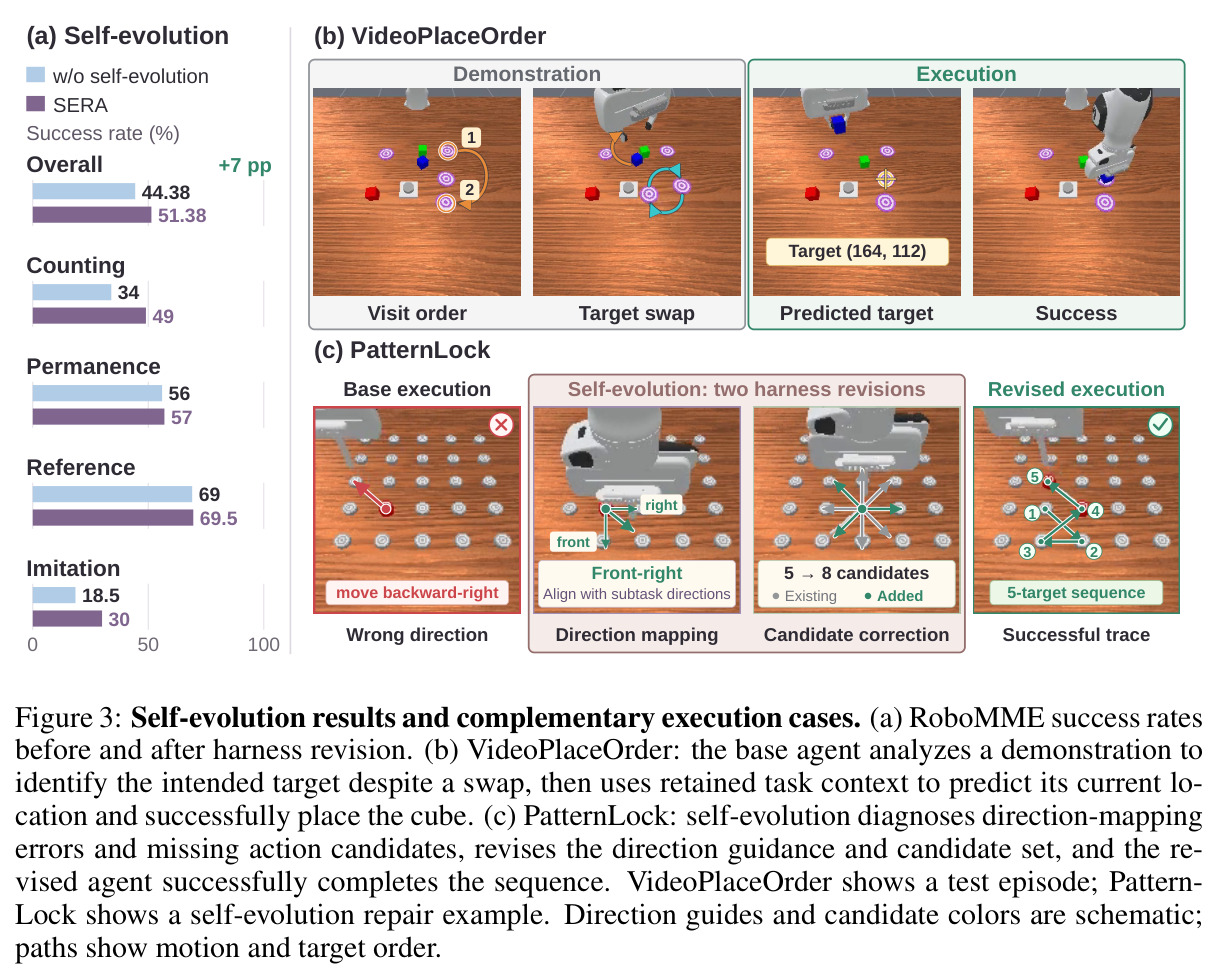
主实验在RoboMME上进行:16个历史依赖任务、四个套件、每任务50 episodes共800个。SERA(自主选择)整体成功率51.38%,比无自进化的44.38%高7.00个百分点;分套件为Counting 49.00、Permanence 57.00、Reference 69.50、Imitation 30.00。基线对比:π0.5仅17.93%、加动作历史19.40%、SAM2Act 21.37%、FrameSamp+Modul 44.51%、MemER 42.38%;SERA在Reference(69.5对38.0)和Permanence(57.0对53.17)领先所有列出方法。逐任务看(Table 2,本地复现MemER对SERA):SERA在VideoPlaceButton 49/50对14/50、VideoPlaceOrder 46/50对18/50、VideoUnmaskSwap 46/50对18/50大幅领先,总成功数411/800对363/800;但ButtonUnmaskSwap 0/50对12/50、InsertPeg与RouteStick均0/50、MoveCube 30/50对45/50明显落后。案例层面:PatternLock的自进化诊断出方向映射错误与候选集缺动作,两次修订后6个开发episodes成功数从2升到5;VideoPlaceOrder显示base agent也能靠演示理解与上下文维持完成任务;探索性gripper干预效果mixed,说明执行级恢复仍是开放问题。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboMME 整体(16任务×50 episodes,自进化前后对比) | 任务平均成功率 SR (%) | 51.38(自主选择) | 44.38(无自进化的 base harness) | +7.00 个百分点 |
| RoboMME 整体 vs 最强层级基线 | 任务平均成功率 SR (%) | 51.38 | 42.38(MemER,公开排行榜) | +9.00 个百分点 |
| Reference 套件(4任务) | 套件平均成功率 SR (%) | 69.50 | 38.00(MemER) | +31.50 个百分点 |
| Permanence 套件(4任务) | 套件平均成功率 SR (%) | 57.00 | 53.17(MemER) | +3.83 个百分点 |
| RoboMME 整体 vs 最强记忆增强/调制基线 | 任务平均成功率 SR (%) | 51.38 | 44.51(FrameSamp+Modul) | +6.87 个百分点 |
| 逐任务总成功数(vs 本地复现 MemER) | 成功 episode 数 / 800 | 411/800 | 363/800(MemER 本地复现) | +48 episodes |
局限与改进
作者明确承认的局限是规划延迟:VLM以高推理档位参与每一轮规划,长时程执行中反复推理会累积可观开销,在动态任务中可能无法及时响应,推理质量与响应速度的权衡尚未系统评估。结合数据还能观察到更多问题:其一,SERA并非全面占优,Imitation套件仅30.00,InsertPeg与RouteStick均为0/50,ButtonUnmaskSwap从复现基线的12/50降到0/50,说明harness级修复对精细接触类任务帮助有限——瓶颈在执行器能力而非规划。其二,修订可能过拟合开发失败模式并产生任务级负迁移。其三,自进化选择基于少量开发episodes与配对比较(如6-episode修订panel),统计功效有限,7个百分点的提升规模需要更大规模验证。其四,fallback机制(预算耗尽后仅+1成功且无回归即可保留)引入了轻微的选择自由度。其五,有效的执行级干预位于planner harness范围之外,目前只能探索性使用,可靠恢复尚未解决。
独立分析的弱点
独立分析有五个弱点。第一,规划延迟与成本:每轮规划都调用gpt-5.6-sol(reasoning effort high),既拖慢执行也推高API成本,实时或动态场景基本不可用,改进方向是上下文增量摘要、轻量模型预筛选或异步规划。第二,任务粒度的修订隔离:候选bundle按任务激活,ButtonUnmaskSwap退化到0/50提示修订可能在部分任务上过拟合开发失败模式,应引入跨任务共享修订与负迁移检测,在更多episodes上做回归测试。第三,评估规模小:每任务50 episodes、修订验证只用小型panel(如6个episode),建议扩大panel并报告置信区间。第四,对专有VLM的依赖使结果对模型版本敏感且难以复现,应补充开源VLM的消融实验。第五,执行器完全冻结的假设让精细任务(InsertPeg 0/50、RouteStick 0/50)触到能力硬上限,planner侧harness无法弥补,应把受控的执行级干预(如gripper重试原语)纳入agent可选择与评估的动作空间,这也与作者自述的方向一致。
未来方向
作者提出的方向有两个:一是把能直接干预执行的机制纳入harness,让agentic planner选择并评估执行级干预(探索性gripper干预已出现部分开发运行成功、部分失败的mixed证据),从而把任务理解与有效恢复连接起来;二是研究更高效的上下文处理与推理策略,在保持决策质量的同时降低规划延迟。基于本文成果还可以延伸出多个方向:将harness自进化扩展到持续部署场景,研究在线修订与灾难性遗忘防护;用学习到的世界模型替代部分真实rollout,降低verifier的环境成本;构建多任务共享的harness组件库并自动组合复用;把assessment criteria与独立的状态估计信号对齐,减少LLM自评偏差;以及在RoboMemArena等记忆基准上系统评估上下文维护质量,横向对比不同harness设计的贡献。
复现评估
复现难度中等偏上。论文未声明开源代码或harness manifest,复现需要自建多个昂贵组件:RoboMME基准与基线分数来自Dai et al. (2026)的公开排行榜,MemER可用released checkpoints本地复现(论文Table 2给出363/800的复现结果作对照);高层规划器是gpt-5.6-sol via Codex,API成本高且行为随版本漂移;VLA执行器为冻结模型;自进化需要大量环境rollout(多候选×多任务×配对评估),仿真算力需求大。附录B.1-B.3对命令catalog构建、上下文字段(1600字符摘要、held-object等)、选择协议与fallback规则描述较细,但prompt全文、catalog条目与修订谱系未公布。拥有RoboMME环境与较强工程能力的团队可以尝试复现,但精确复现51.38%这一数字对VLM版本敏感,建议关注作者是否放出harness配置与自进化轨迹。
论文图表
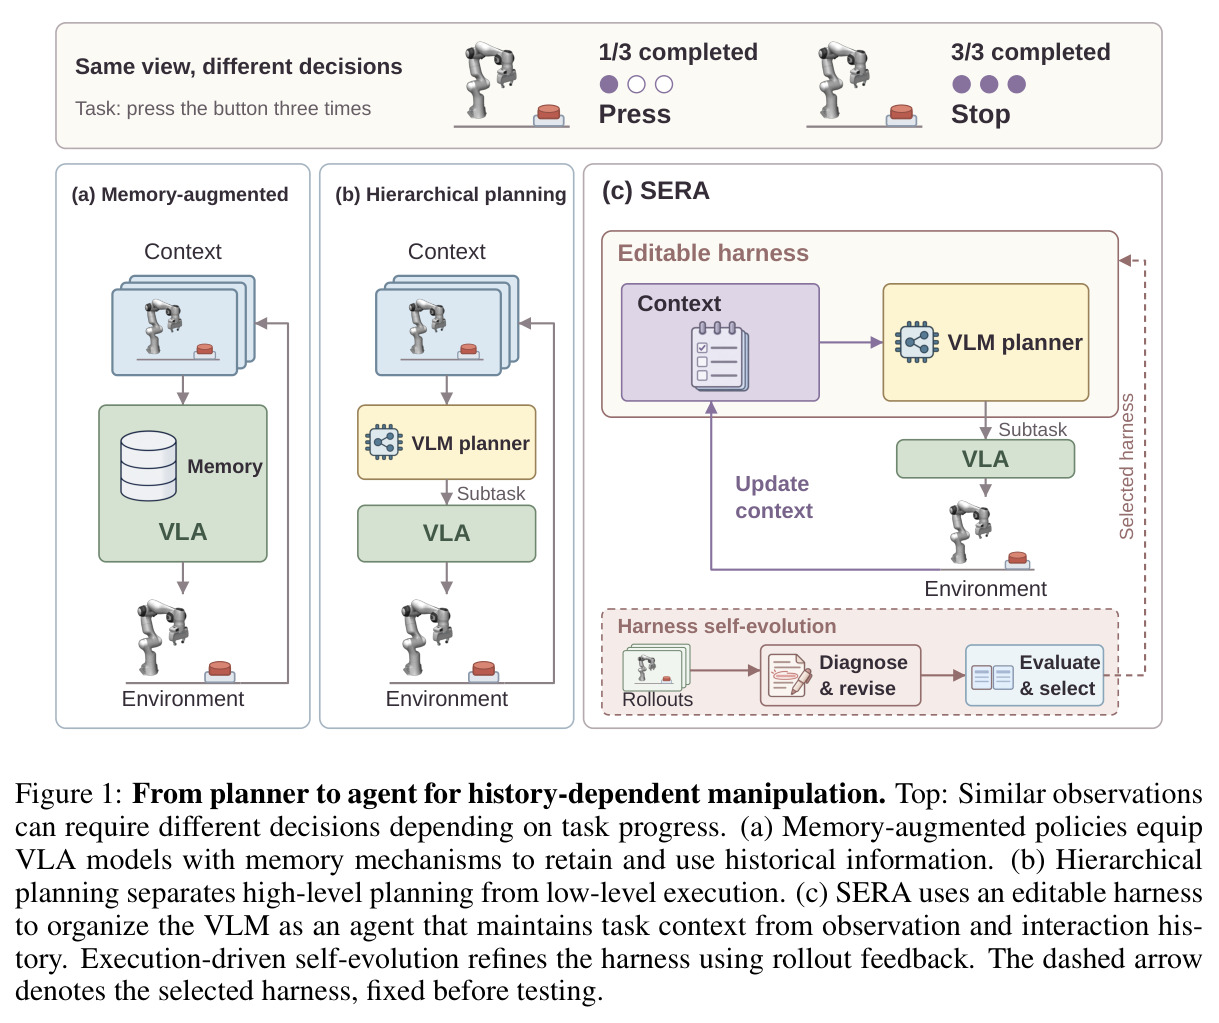
概念对比图。上半部分以'按压按钮三次'任务展示相同观测需要不同决策(1/3完成时按Press,3/3完成时Stop);下半部分并排三种范式:(a)记忆增强策略给VLA挂记忆模块;(b)层级规划用VLM输出子任务、VLA执行;(c)SERA用可编辑harness组织VLM为智能体,维护上下文并驱动VLA,底部展示harness自进化流程(rollout→诊断与修订→评估与选择,虚线箭头表示测试前固定的选中harness)。
这张图定义了论文的定位:把SERA放在记忆增强与层级规划两条已有路线的对立面,直观说明'planner到agent'的升级与harness自进化的位置,是理解全文动机与框架差异的入口。
主结果表,按VLA基线、记忆增强、层级三类列出9个方法在四个套件与整体的成功率:π0.5 17.93、π0.5+动作历史19.40、SAM2Act 21.37、FrameSamp+Modul 44.51、SimpleSG+QwenVL 29.00、GroundSG+Gemini 11.56、GroundSG+QwenVL 32.70、MemER 42.38、SERA 51.38(Counting 49.00/Permanence 57.00/Reference 69.50/Imitation 30.00),SERA整体与Reference、Permanence均为最优。
这是论文的核心定量证据:51.38%的整体成绩、对MemER的+9pp、以及SERA强弱套件的分布(Reference最强、Imitation最弱)都来自这张表,是评估论文贡献大小的主要依据。