Git 未记录之事:AI 辅助科研仓库中的溯源可读性 What Git Does Not Record: Provenance Legibility in Two AI-Assisted Research Repositories
同一作者的两个 AI 辅助科研仓库证明:Git 无法为 AI 使用披露提供可靠证据
前置知识
Git 提交与对象数据库
Git 把每次提交记录为文件树的完整快照,元数据只有提交者姓名、邮箱、两个时间戳和一条自由文本消息,全部由提交者自填、无一经过验证。被删除或覆写的内容并未消失,而是留在对象数据库中,只有显式查看文件历史(如 git log -p、git blame)才能取回;工作目录和普通读取永远只显示最新状态。
论文的核心度量"历史独有占比"正建立在"存储可见"与"历史可达"的区分上:Git 保留了 Project B 中 78.2% 的消失行,却不把它们展示给读内容的人,这一区分是全文论证的支点。
Co-Authored-By 拖车
Git trailer 是提交信息末尾的键值对行,键集不受 Git 约束。Co-Authored-By 原本用于标注共同作者,因主流 agent 编码工具默认写入 AI 身份而事实上成为"AI 参与披露"字段,也是自动化审计扫描提交日志时最常读取的键,_corpus 研究直接拿它估计 LLM 参与率。
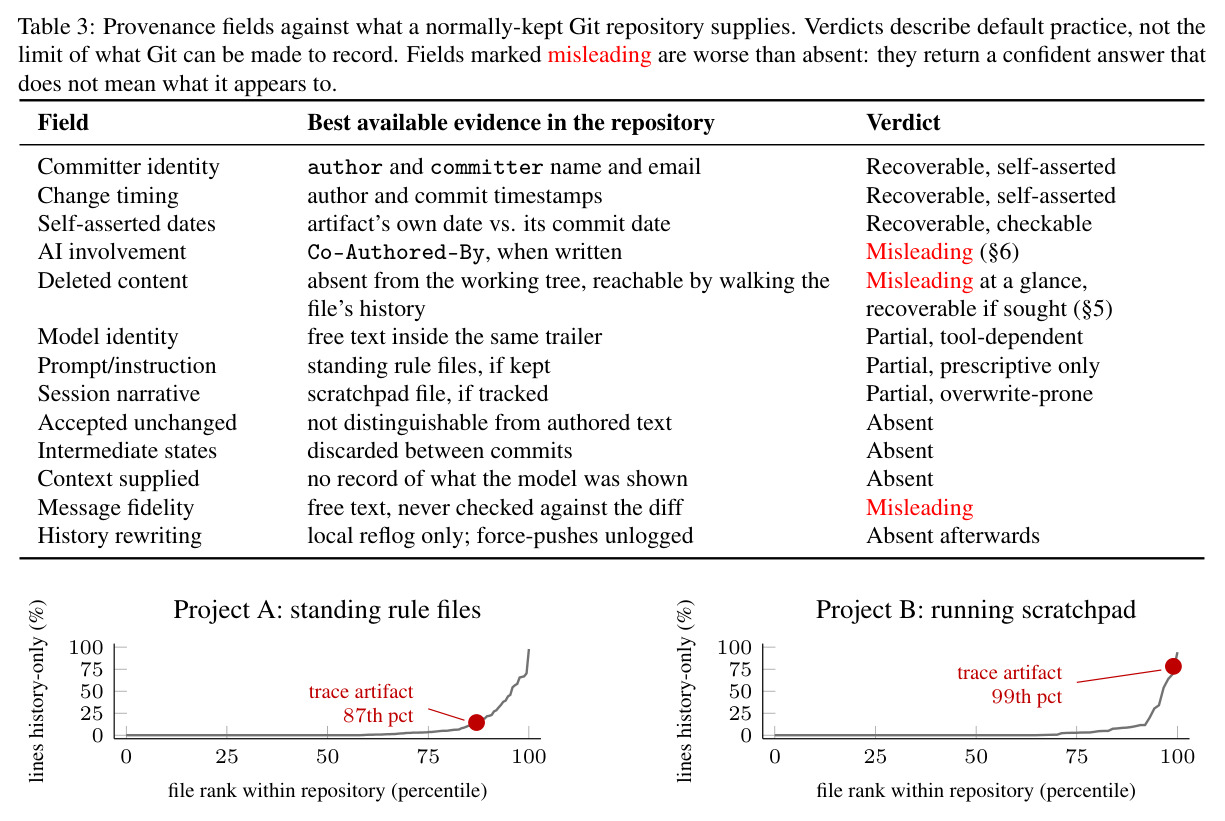
第 6 节整个论证围绕这个键展开:本文证明它漏掉 Project A 45.5% 的披露、对仓库内部代理信号的敏感性低至 2.6%,且比率在同一项目内可相差 6.6 倍,因此不能当参与率读。
git blame 与重命名追踪
git blame 逐行回答"这一行最后由哪个提交写入",并能跟随文件重命名追溯历史;路径限定的 git log -- 则只报告该路径上的提交,重命名前的旧路径会被过滤掉。blame 会简化历史,但能看到路径查询看不到的修订。
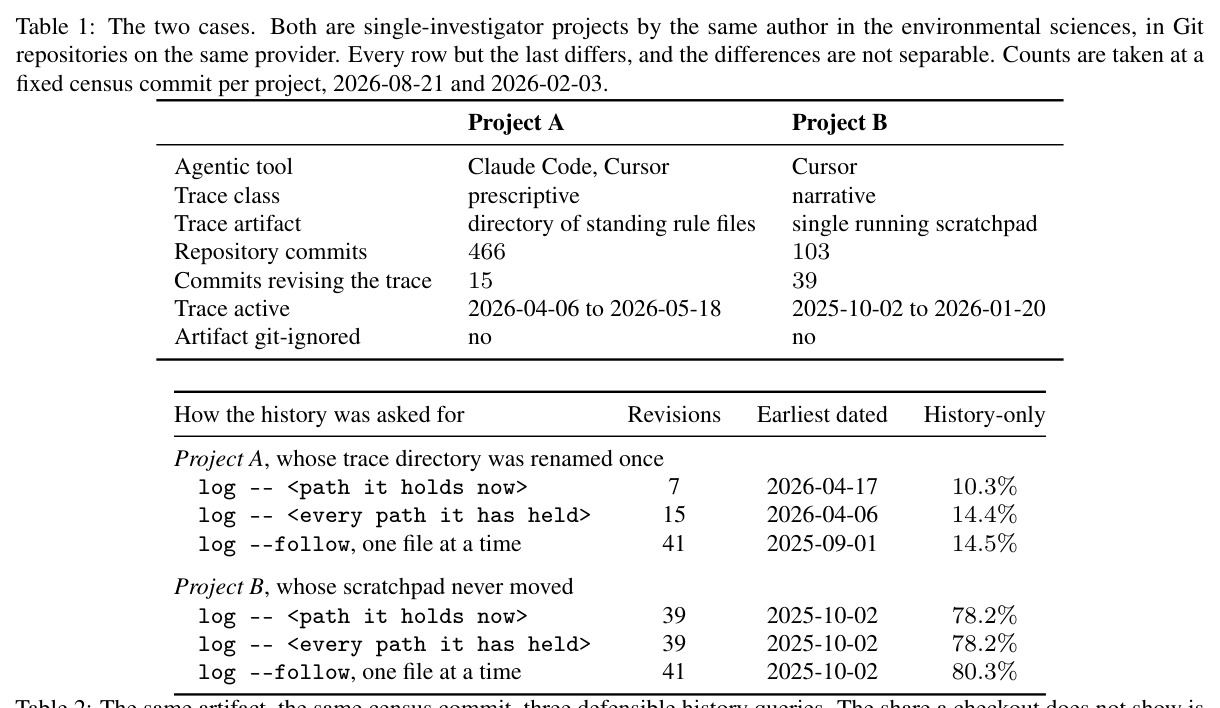
Project A 的规则目录被重命名过一次,两种查询给出的修订数在 7、15、41 之间相差 5.9 倍、表观起始日期相差 228 天,论文用它证明"查询方式本身就是结果的一部分"。
研究溯源
形式化溯源模型要求可问责的计算结果记录三类要素:实体、产生实体的活动、以及负责任的 agent。可复现性文献的共识是这种记录不会从日常实践中自动产生,必须被刻意制造;软件供应链工作在此之上再加密码学证明与透明日志,但都预设"值得证明的事件"已被识别。
本文测量的正是溯源链条中被忽略的前置步骤:在值得证明的事件被识别之前,一个按默认习惯维护的 Git 仓库里到底有哪些溯源字段幸存、哪些会给出自信却错误的答案。
git 忽略与追踪决策
.gitignore 让指定路径不进入版本控制。本地 agent 工作目录(常驻规则文件、scratchpad)是否被追踪是一次性的、不可见的选择,两种主流工具都不提示也不警告;一旦选择忽略,agent 的全部痕迹在仓库层面即不存在。
论文所有可读性数字都以"工件被追踪"为前提:作者核实两个工件都未被 git 忽略,并指出若作者当初加了一行 ignore,本文的每个数字都会是零,这是一切测量的隐含条件。
研究动机
期刊和会议越来越要求作者披露 AI 在研究中的贡献:Nature 自 2023 年起要求声明生成式工具的角色,会议要求说明 LLM 扮演了什么,审稿人起疑时还会索要证据。这些政策只规定了声明写在哪里,却没有说明声明的内容从哪里来——作者要在提交后数月描述当时发生了什么。在计算研究中唯一现成的候选就是版本控制仓库:它带时间戳、可共享,被视为工作如何完成的权威记录,是作者复盘或审计员核查的第一个去处。但仓库挖掘文献早已警告:提交是精心策划的,会被 rebase、squash、改日期,仓库元数据会系统性地错报署名与工作量。近年的实证研究直接统计提交信息与 Co-Authored-By 拖车里的 AI 自声明来估计 LLM 参与率,却把声明本身当成了测量结果,从未追问这些渠道究竟能证明什么。
本文的目标是本文的经验性目标是回答:一个按默认习惯维护的 Git 仓库,对于"AI 如何参与了这项研究"这类溯源问题,究竟能够提供、无法提供、以及看似提供实则误导什么。作者把目标拆成四件可交付的事:其一,按字段逐一判定的分类法,区分"不可恢复"与"可恢复但误导";其二,对两个 AI 痕迹工件做可读性测量,量化历史提交过的行在当前版本还剩多少可见,并与仓库内全部其他文本文件对比定位;其三,测量提交日志这一披露通道的敏感性——用仓库内部的代理信号交叉验证 Co-Authored-By 拖车——以及比率在时间上的不稳定性;其四,从测得的缺口逐字段推导任何"在研究进行时原位记录溯源"的系统必须满足的需求。每个数字背后都有可审计的账本,一行对应一个工件修订。
与已有工作不同的是,最接近的工作是在真实语料中统计提交信息与拖车里的 AI 自声明,它们把声明当作测量对象;本文恰恰反过来,问的是"这个声明能确立什么"。独特切入有三点:第一,两个仓库出自同一位作者、同一学科(环境科学)、同一版本控制平台,剔除了人与人之间记录习惯差异这一最明显的 rival 解释——尽管工具、工件类型、主题、时长与年份仍然混杂,作者明确声明不做任何因果归因,只主张"存在性"结论;第二,引入"可读性"这一新度量:不是问 AI 用了多少,而是问历史记录在当前页面上还剩多少可见,并把工件放回本仓库全部文本文件的分布中定位,使判断不依赖两个项目彼此相似;第三,提出比"缺失"更危险的"误导"类别——字段存在且返回自信的数字,却不能换算成读者想要的量。
核心方法
直觉上,审计员想知道"这项研究里 AI 干了什么",而仓库只会展示一份文件的当前状态和一串自我声明的提交信息。本文把分析单元定为 AI 痕迹工件——agent 工具在仓库里维护、用于跨会话携带状态的文件或目录,因为这是审计员实际会读的东西。Project A(466 个提交)用 Claude Code 与 Cursor,工件是一组规定型"常驻规则文件"目录;Project B(103 个提交)用 Cursor,工件是单个叙事型 scratchpad(.cursor/scratchpad.md),随工作推进不断重写。核心量是"历史独有占比" $s = 1 - V/I$,其中 $I$ 是所有触及该工件任何历史路径的提交累计插入行数,$V$ 是普查提交时仍可见的行数。四个脚本完成测量,第五个生成论文全部坐标,第六个逐个核对论文印出的每个数字;两个案例分别固定在普查提交(2026-08-21 与 2026-02-03),防止论文写作期间的提交污染它们要报告的比率。
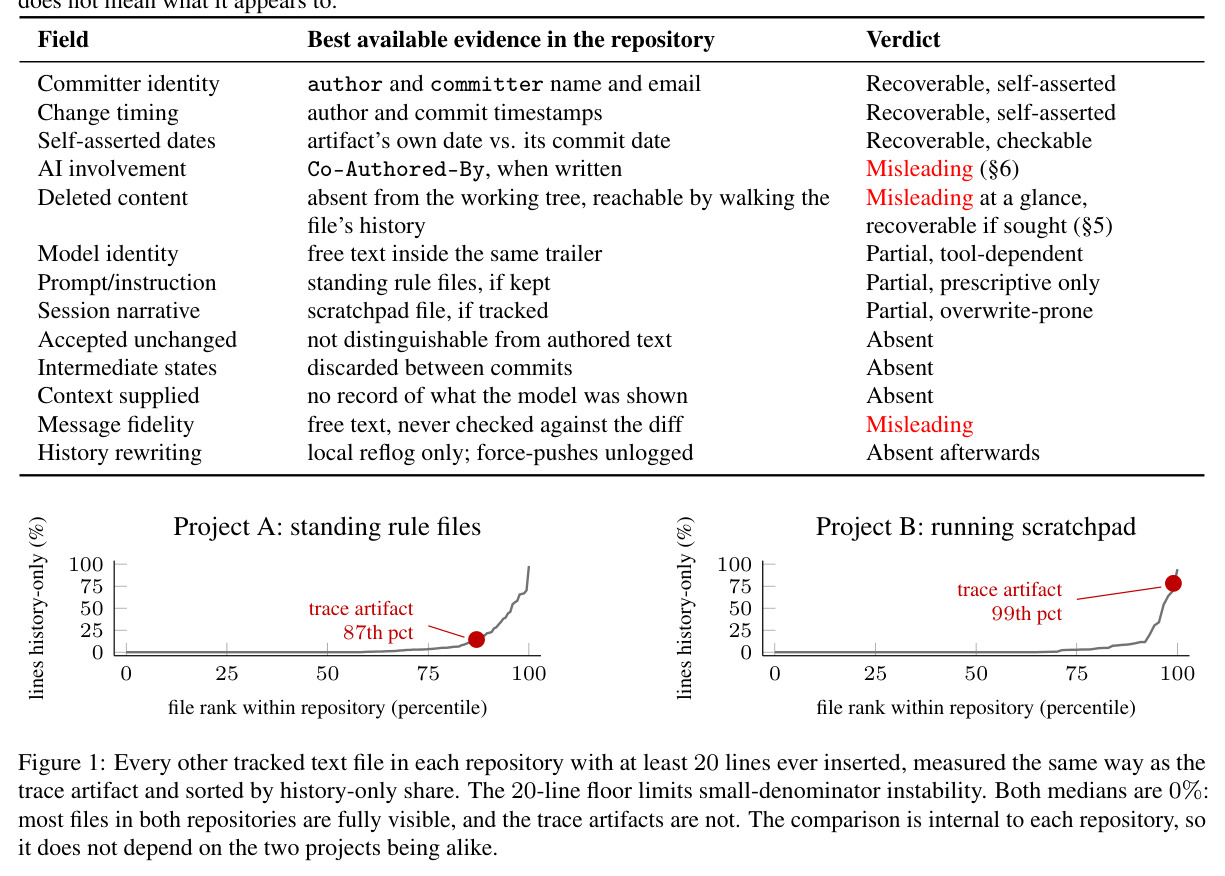
核心创新是把问题从"AI 参与率是多少"换成"仓库能为此作证什么",并给出三个互相支撑的测量设计。其一,把工件的可读性放回仓库自身的参照系:单独说 78.2% 无从判断是否异常,但若仓库中位文件的历史独有占比为 0%,而 scratchpad 排在第 99 百分位,异常性立刻成立,且这个比较完全在仓库内部进行,不依赖两个项目相似。其二,给拖车找一个仓库内部的真实代理:39 个修订 scratchpad 的提交就是同时段 agent 活动的下界证据,拖车只覆盖其中 1 个(2.6%),敏感性就此可测,而无需仓库之外的任何数据。其三,字段级裁决引入"误导"类——比缺失更有害,因为它给出自信却错位的答案,如 Co-Authored-By,又如"接受未修改"这种仓库在原理上就无法记录的字段。这与以往把提交日志当忠实记录、把自声明当测量的做法有本质区别。
方法步骤详情
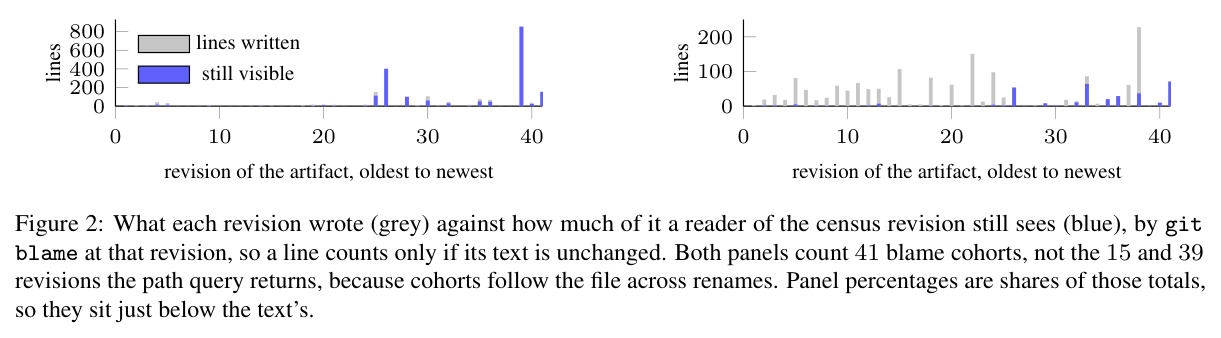
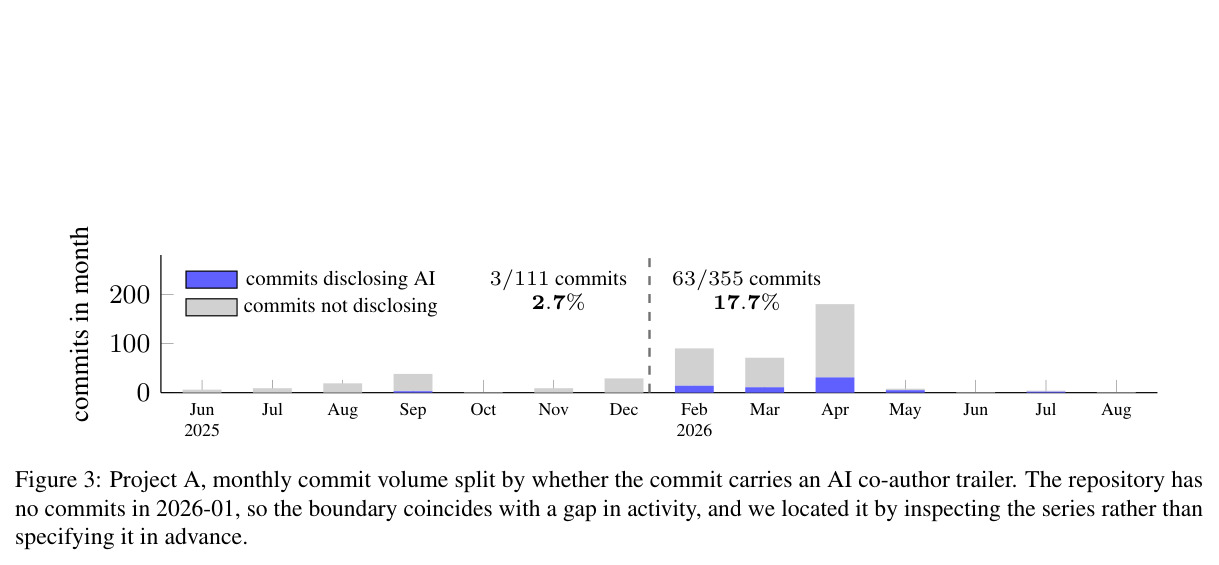
测量流程八步。第一步,界定工件并沿其占据过的所有路径的并集遍历每个触及提交,记录每次修订的插入与删除行数——路径限定 log 看不到重命名,Project A 的工件目录被重命名过一次,三种查询给出 7、15、41 个修订(相差 5.9 倍),本文统一采用路径并集形式。第二步,在普查提交处统计工件当前可见行数,用 git blame 把每行归属到修订,得到各 41 个 blame 群组,量化哪些修订还有幸存行。第三步,核实两个工件均未被 git 忽略。第四步,不预设键名地扫描全部拖车块(发现 Co-Authored-By、Made-with、Claude-Session 三个 AI 键),再以 Co-Authored-By 为主键统计披露率。第五步,把拖车与"修订工件的提交"交叉列表测敏感性:Project A 为 5/15(33.3%),Project B 为 1/39(2.6%)。第六步,按月拆分提交量定位时间断点:2025-12 前 2.7%(3/111),之后 17.7%(63/355)。第七步,把工件自述日期与引入该行的提交日期对照,只发现一处不一致(2026-01-20 写入的行写着未填占位符 2025-01-XX)。第八步,尝试仅凭规定型轨迹重建规则背后的 episode,按起源证据、人工审阅状态、证据强度三维度编码。
技术新颖性
新颖性体现在四个"第一次"。第一,首次量化 AI 痕迹工件的"可读性"并与仓库内文件分布对比:Project A 规则目录居 174 个文件第 87 百分位(22 个文件在其上)、Project B scratchpad 居 88 个第 99 百分位(仅 1 个文件在其上),证明它们是各自仓库中最被反复覆写的文本之一而非普通文件。第二,首次对 Co-Authored-By 做"敏感性评估"而非直接采信:同一仓库内换一个键比率就从 14.2% 跳到 26.0%,单键审计漏掉 55 个披露(45.5%);对代理信号的敏感性在两个案例分别是 33.3% 与 2.6%,既不恒定也不接近仓库级比率。第三,首次展示同一项目内部披露率可相差 6.6 倍(计全部三键则 12.3 倍),且断点是事后从月度序列里挑出的最大对比。第四,方法论上的"第六个脚本"逐数核对论文,配上盐化哈希的可审计账本,把实证声明做成了可复算的形式。
实验结果
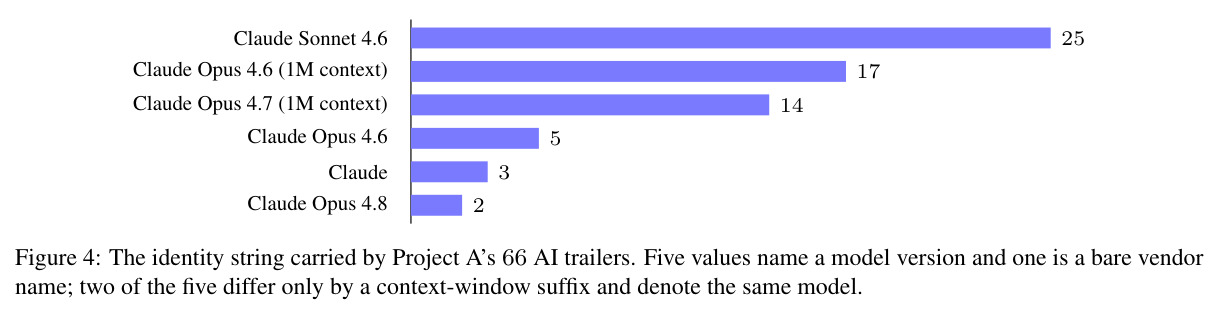
这是两案例审计而非受控实验,核心数字如下。可读性:Project A 规定型轨迹累计提交 2,236 行,后来删除 321 行,当前剩 1,915 行,85.6% 仍可见、14.4% 只存在于历史;Project B 叙事型轨迹提交 1,537 行、删除 1,202 行、仅剩 335 行,78.2% 只在历史里——39 次修订净增 335 行却吸收了 2,739 行改动,是"原地重写"的典型特征。但按修订计数差距骤减:A 的 41 个 blame 群组中 15 个、B 的 41 个中 18 个不留任何可见行;A 的可见行高度头部化,最新 3 次修订(7.3%)贡献一半可见行,其中一次修订独占 853/1,915 行。工件年龄被低估:blame 把 686/1,915 行(35.8%)归给路径查询列不出的 26 个提交,最早到 2025-09-01,路径查询让工件显得年轻 7 个月。披露通道:A 的 Co-Authored-By 覆盖 66/466(14.2%),但仓库实际携带 3 个 AI 键共 121/466(26.0%),单键审计漏掉 55 个(45.5%);B 仅 1/103(1.0%),而 39 个修订 scratchpad 的提交里只有 1 个(2.6%)带拖车,且该提交署名的是项目其余部分未用的另一个工具。时间不稳定:A 在 2025-12 前披露率 2.7%(3/111),之后 17.7%(63/355),相差 6.6 倍。66 条 AI 拖车使用 6 种身份字符串却至多对应 4 个模型,其中 3 条什么都没说。规则重建:所有规则的起源证据均为"未知",证据强度至多到工具元数据;自述日期核对只发现 1 处不一致(未填占位符)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 叙事型轨迹可读性(Project B scratchpad) | 当前版本可见行占比(相对历史累计插入) | 21.8%(335/1,537),78.2% 只存在于历史 | 仓库内 88 个普通文本文件的历史独有占比中位数为 0% | 工件居第 99 百分位,是仓库中第二被覆写的文件——异常性由仓库内部分布确立 |
| 规定型轨迹可读性(Project A 规则目录) | 当前版本可见行占比 | 85.6%(1,915/2,236),14.4% 只存在于历史 | 仓库内 174 个普通文本文件中位数为 0% | 仍居第 87 百分位(22 个文件在其上);且 35.8% 可见行(686/1,915)来自路径查询漏掉的 26 个提交,最早 2025-09-01 |
| 提交日志披露通道(Project B) | AI 拖车对代理信号(修订 scratchpad 的提交)的敏感性 | 2.6%(1/39) | 仓库级披露率 1.0%(1/103) | 38/39 个代理提交未披露——拖车严重低估 agent 活动 |
| 提交日志披露通道(Project A) | Co-Authored-By 覆盖率 | 14.2%(66/466) | 扫描全部拖车键后为 26.0%(121/466,三个 AI 键) | 单键审计漏掉 55 个披露(45.5%);对代理信号敏感性 33.3%(5/15) |
| 时间稳定性(Project A) | 月度披露率跨边界变化 | 2.7%(3/111)→ 17.7%(63/355),6.6 倍 | 同一作者、同一仓库、计全部 AI 键时为 12.3 倍 | 披露率在单一项目内不稳定,不能作为参与率或跨项目比较的依据 |
局限与改进
作者坦承的局限:只有两个仓库、一位作者,工具、工件类型、主题、时长、年份全部混杂且与结果同向,不能把任何对比归因于工件类型;第 7 节编码由创建两个仓库且知道结果的作者单独完成,无评分者间一致性;时间断点是看过月度序列后选的,6.6 倍是可获得的最大对比而非先验假设检验;最大的 rival 解释——作者在断点后确实更多使用 agent、也更常让工具写提交——无法排除,因为两个仓库都不记录工具设置历史或每个提交由哪个进程产生(文中点名 VS Code 曾在某个版本默认开启 AI 拖车、两个版本后又回退)。我自己的观察:以"行"为单位让重写一段与删掉一个标题权重相同;blame 会简化历史且只覆盖被追踪文件;普查点选在论文之前虽巧妙,但两个仓库都是单人环境科学项目,结论对团队协作、其他学科与托管平台的适用性未知;第 8 节的六条需求只有推导、没有实现或验证。
独立分析的弱点
第一,代理信号双向不完美:人类可以直接改 scratchpad,agent 会话的产出也可能延后、单独或混在无关改动里提交,39 个修订只是活动的下界而非精确计数。第二,"误导"类字段的量化依赖键名扫描的启发式(把 cursor、ai、domain、chains 等词与结构化拖车区分开),换一种解析规则数字就会移动——论文报告了文本匹配 40.8% 对拖车 14.2% 的差距,但校验规则无法形式化到让所有审计者得到同一答案。第三,两案例在所有维度上都不同,"规定型 vs 叙事型"的互补失败叙事虽优雅,却无法支持任何反事实推断;一个对照设计(同一作者、同一工具、强制两种工件格式)会干净得多。第四,论文未测量可读性对下游的实际影响:审计员是否真会被 78.2% 的不可见误导是行为问题,而非可读性问题。改进方向:把"接受事件"记录做成编辑器/agent 插件原型,在真实开发任务上测其开销与采纳率,让第 8 节的需求从推导变成可部署的系统。
未来方向
作者在第 8 节给出六条原位捕获需求,可直接作为后续工程路线:在编辑器或 agent 内记录"接受事件"而非只留结果,以区分辅助与署名;把"参与度"与"工具身份"分成两个标准化键并提供"未记录"值,避免 3 个竞争键各记一半;叙事记录应只追加或以序列而非头部呈现,因为 Git 已证明存储不是瓶颈、呈现才是;工件创建时显式提示追踪决策;溯源查询必须跟随重命名并按写入时间定日期;自动核对自述日期与提交日期(本文已证明该检查可机械实现却无人运行)。可延伸方向:在能拿到地面真值的受控开发任务上系统校准拖车敏感度,建立跨项目可比的修正模型;为过程溯源设计 datasheets 式披露 schema;把可读性度量推广成自动仓库审计工具(blame 群组报告);以及跨多名作者、多种工具、多个托管平台的纵向研究,检验 2.7%→17.7% 的阶跃在群体层面是否普遍。
复现评估
复现性双面。有利面:全部定量结果是机械可再生的——六个脚本分工明确(测量四、绘图一、核对一),git 命令全部写明(路径并集 log、blame、拖车提取、gitignore 检查),论文承诺每个数字背后有账本(每行一个工件修订/披露提交/被追踪文本文件/blame 群组,提交 id 以盐化哈希为键),在任何自己的仓库上重跑这套管道只需 git 与常规脚本能力,无算力门槛,这是实证审计论文里少见的自检设计。不利面:两个仓库本身与账本未公开;伦理节说明识别性字符串、地址、路径全部剔除,但作者承认"了解该领域的读者可以从计数、日期与工具名定位这些仓库",说明数据不可共享的根本约束是隐私而非体积;因此精确复现论文数字不可能,只能复现方法论;第 7 节的定性编码由单一、知情的编码者完成,原则上不可独立复算,作者也如实承认这是"论证而非对照"。
论文图表
同一工件、同一普查点、三种同样站得住的历史查询的对比。Project A(目录被重命名过一次):路径限定 log 只给 7 个修订、最早 2026-04-17;路径并集给 15 个、2026-04-06;log --follow 给 41 个、最早 2025-09-01——而 history-only 占比在三者间只移动 10.3%/14.4%/14.5%。Project B(文件从未移动)三行几乎一致:39/39/41 个修订,78.2%/78.2%/80.3%。
证明"查询决定部分答案"这一方法学核心:标题数字对查询形式稳健(Project A 内最多 4.2 个百分点、Project B 内 2.1 个百分点),但修订数相差 5.9 倍、表观起始日期相差 228 天——审计员跑的窄查询会无声地漏掉超过一半的修订。