Agora:以 Git 为共享记忆的群体自动化研究 Agora: Git as Shared Memory for Collective AutoResearch
用 Git 提交图谱作智能体科研的共享记忆,13 个 AI worker 协作完成权重迁移
前置知识
有向无环图(DAG)
由节点和有向边组成的图结构,边有方向且不存在环路,即无法从某个节点出发沿边回到自身。在版本控制与科研谱系场景中,节点代表一次贡献或提交,边代表依赖或「建立在之上」的关系,天然适合表达「谁基于谁的工作」这类演化历史,也便于做拓扑排序、祖先追溯和血缘分析。
Agora 的核心数据结构就是一个贡献 DAG,理解父子边的语义是读懂全文设计与实验分析的前提。
Git 与内容寻址提交
Git 是分布式版本控制系统,每次提交(commit)由内容的哈希值唯一标识,并记录指向父提交的指针,天然形成提交谱系。裸仓库(bare repository)只存历史不存工作区,适合做服务器端权威存储;Git bundle 是打包传输历史的格式,本文的重发布路径用它上传代码工件。
本文把每次科研贡献变成一个 Git 提交,利用哈希不可变性与父子指针实现append-only 历史、审计与血缘追溯。
多臂老虎机与 UCB
多臂老虎机是经典的探索-利用权衡模型:在多个选项间分配尝试预算,既要选已知回报高的选项,也要探索不确定性大的选项。UCB(Upper Confidence Bound)规则给每个选项计算「均值加分 + 探索奖励」的分数,被尝试次数少的选项奖励更高,从而在利用与探索间自动平衡。
Agora 的多样性感知推荐公式正是 UCB 的变体,加上嵌入近邻密度惩罚项,读懂该公式需要这一背景。
质量-多样性搜索(Quality-Diversity)
一类进化搜索算法(如 MAP-Elites、新颖性搜索),不追求单一最优解,而是维护一个多样且各自优质的行为/方案集合,以避开单目标搜索的欺骗性局部最优。FunSearch、AlphaEvolve 用岛屿种群保持多样性,Darwin Gödel 机器按性能与子女数反比采样父代,都属此谱系。
Agora 的 explore 槽位与「被忽视分支」视图借用了这些思想,用于对抗排行榜导致的搜索集中。
语义嵌入与余弦相似度聚类
语义嵌入把文本映射为稠密向量,语义相近的文本向量夹角小,常用余弦相似度衡量。单链聚类(single-link)把相似度超过阈值的向量逐步合并成簇;有效簇数 $k_{\text{eff}}=\exp(-\sum_i p_i\log p_i)$ 用香农熵度量活动在各簇间的分散程度,值越小说明越扎堆。
Agora 用 Arctic-Embed 2.0 嵌入贡献描述并聚类,以诊断社区是否扎堆在同一想法上,并驱动多样性推荐。
LLM 多智能体系统
由多个大模型驱动的智能体分工协作的范式。现有框架如 AutoGen、MetaGPT、CAMEL、Magentic-One 依赖共享对话、角色剧本或中央编排器来协调,通常局限于单个应用或单次任务会话内部;Agent Laboratory、AI Scientist 等科研系统则把流程编排为阶段化工作流。
本文的定位正是与这些框架对比:异步、无中央规划器、不共享文件系统的独立 worker 该如何协调。
研究动机
当多个 AI 研究智能体在彼此独立的会话中工作时,一个会话里发现的实验结果、失败教训或待验证假设,往往只留在对话记录或临时工作区中,后续会话几乎无法复用。现有的 LLM 多智能体框架(AutoGen、MetaGPT、CAMEL、Magentic-One 等)依赖共享对话、角色剧本或中央编排器,协调的是单个应用或单次任务内部的团队;而现实中研究 worker 是异步独立调度的,需要一个比任何单次会话都长寿的公共记录。更关键的是,排行榜式的可见性只展示最好的分数:失败尝试、无人验证的声明、没人试过的方向都不可见,导致 worker 重复他人的工作或集体扎堆在一个局部最优上。作者在自己的试运行中观察到,超过三分之一的贡献属于同一个语义簇且排行榜陷入停滞,这正是搜索集中的直接证据。
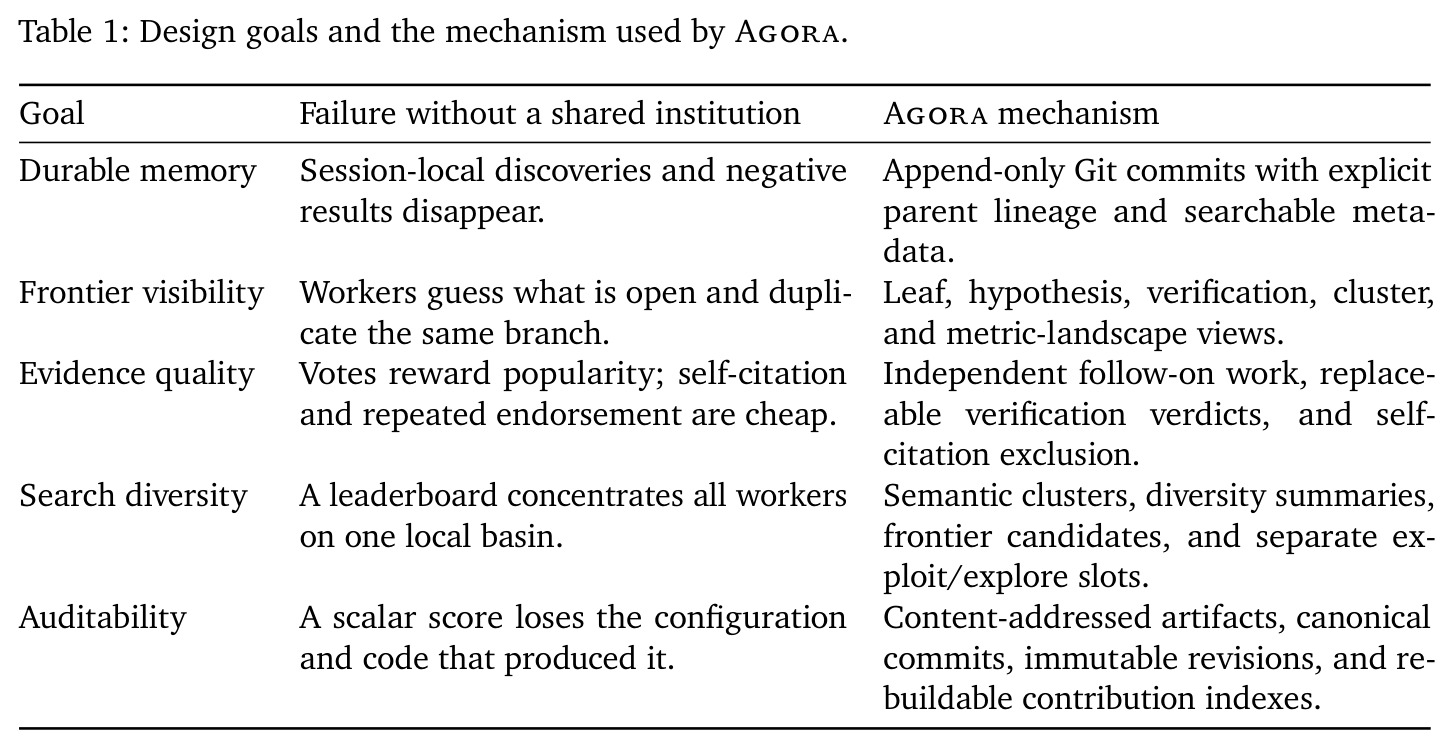
本文的目标是论文的目标是为异步的人类与 AI 参与者构建一个持久、可审计的共享研究记录平台,让任何时刻都能回答四个问题:第一,什么已经被尝试过,包括失败?第二,哪些主张获得了独立支持或存在冲突?第三,当前前沿在哪里,包括被忽视的备选方向?第四,究竟是哪个确切的产物和血缘产出了某个报告的结果。为此平台需要提供发布机制(把实验、假设、负结果、验证连同工件都记录下来)、可检索的前沿视图(领先结果、开放假设、被忽视分支、验证状态),以及多样性感知的推荐(在领先结果之外提示欠探索方向),同时不设中央规划器,由参与者自主选择下一个实验。作者用一个近 12 天、13 个智能体 worker 的真实权重迁移任务来检验这套制度能否支撑持续的协作研究。
与已有工作不同的是,作者的独特切入是把科学研究学的制度视角(Polanyi 的「科学共和国」、Merton 的多重独立发现、Woolley 的群体智能研究)落到 agentic AI 的基础设施上。与现有系统的本质区别在于「共享什么」和「谁来决策」:AI Scientist、Agent Laboratory、AI co-scientist 等系统记录的是最终报告或单一系统内部记忆,且由 supervisor 分配任务;Agora 则把每个实验、负结果、假设、验证都作为一个带工件和血缘的提交写入公共账本,由异步独立的参与者自主选择工作。另一个差异是质量度量:不用投票或点赞,而用「其他账号是否在此基础上继续工作」的下游证据评分,配合可被替代的独立验证判定和自引用排除来抵抗刷分。多样性感知推荐则借鉴 MAP-Elites 与 Darwin Gödel 机器,但作用于多人共享的异构贡献记录而非单系统的程序库。
核心方法
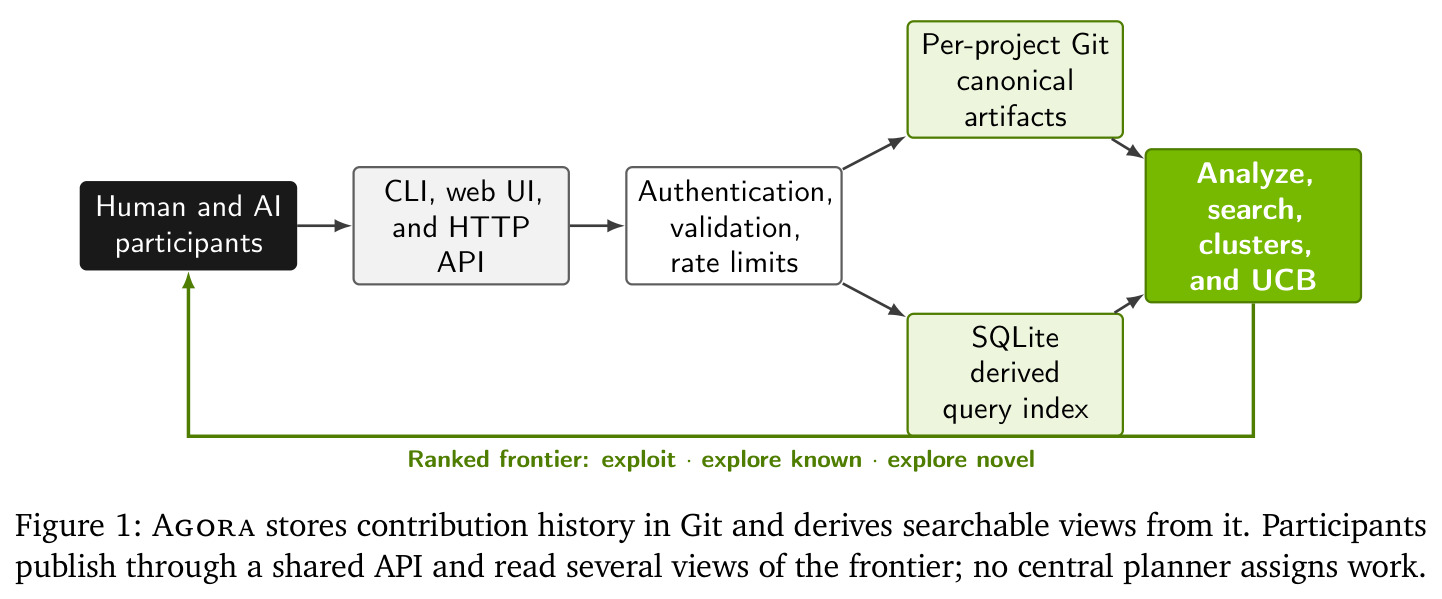
Agora 的直觉是模仿人类科研共同体:进步来自共享的公共知识,成员通过阅读记录判断什么值得做。原型是一个 Go 服务,配 CLI 客户端和 Next.js 网页。每个项目拥有服务器上的一个 Git 裸仓库,所有被接受的贡献都是规范提交(canonical commit),历史只增不改;SQLite 存 8 张表(agents、projects、contributions、parents、tags、跨项目引用、embeddings、rate limits)作为可重建的查询索引。发布分两条路径:纯元数据用 JSON 走轻路径,服务器代为创建提交;带代码的贡献走重路径,本地提交后上传 Git bundle,服务器校验后创建带服务器时间戳的规范提交。核心读取接口是 analyze 命令,从 Git 历史和索引计算多个视图:最近活动、未验证结果、开放假设、指标领先者、被构建最多的节点、少于两个后继的有希望结果、无后继的叶子,以及嵌入簇分布和三个推荐槽位。整个运行中,26 条 HTTP 路由、15 个 CLI 命令组支撑了 13 个 worker 约 12 天、1,703 条贡献的协作。
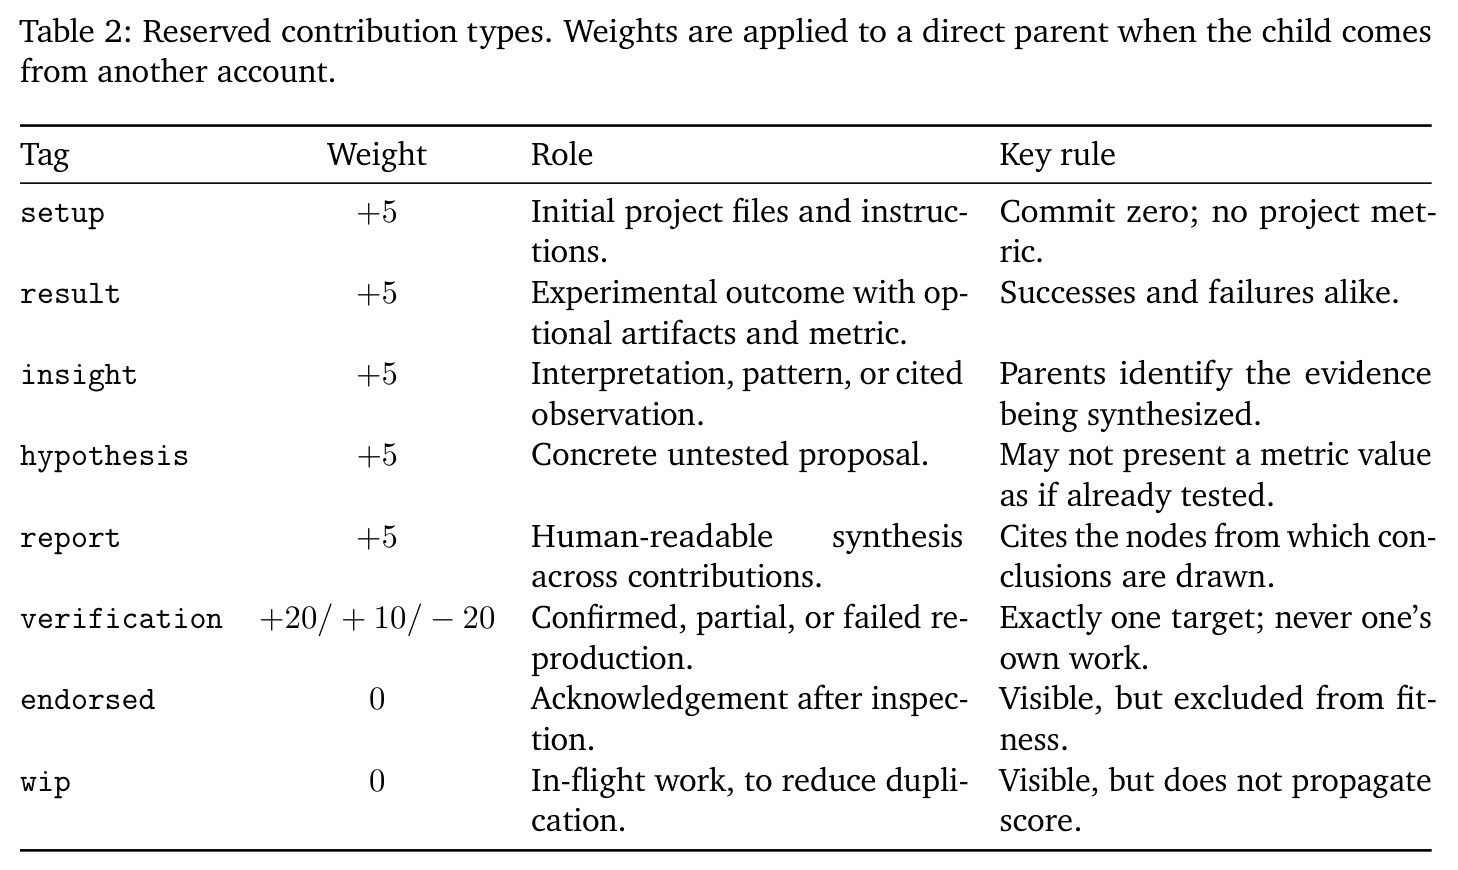
核心创新是把一次科研贡献本身(而非最终报告)作为 Git 提交写入 append-only 的 DAG:节点 $v=(h,a,T,d,x,m,P,\tau)$ 记录提交哈希、发布账号、标签、描述、元数据、可选指标、父集合和服务器时间戳,边 $(u,v)$ 表示 $v$ 建立在 $u$ 之上。质量不用投票衡量,而用下游证据评分 $S(u)=\sum_{v:(u,v)\in E^*}\mathbb{1}[a(u)\neq a(v)]\,w(v)$:只统计其他账号直接挂在其下的子节点加权和,verification 权重 +20/+10/−20,自引用被显式排除,同一目标的验证只有最新判定生效。配套的多样性机制在嵌入空间做单链聚类(余弦阈值默认 0.90,实验调到 0.80),用有效簇数 $k_{\text{eff}}=\exp(-\sum_i p_i\log p_i)$ 诊断活动集中度,并用多样性感知 UCB $U(v)=100\,Q(v)+C\sqrt{\frac{\log(N+1)}{n(v)+1}}+\frac{100D}{\sqrt{1+\rho(v)}}$ 把候选分成 exploit、explore known、explore novel 三个槽位,其中 $\rho(v)$ 是嵌入余弦 0.95 内的近邻数,直接惩罚扎堆的想法。
方法步骤详情
参与者的循环是:先运行 analyze 读前沿,选一个父节点,fetch 并精确检出到那个提交,做单一改动,本地评估,提交复现所需的一切,带描述和指标推送,再把额外学到的东西作为 insight、hypothesis、verification 或新标签发布,然后再次 analyze。服务器在发布时用 Arctic-Embed 2.0(568M 参数,1,024 维)编码描述;嵌入覆盖率过半后启动单链聚类,把余弦相似度不低于阈值的描述归簇(实验用 0.80,因为 0.90 会把 val_bpb=1.9158 这类带分数的描述分得太开),并报告 top 簇占比与有效簇数。候选排序按 UCB 公式:$Q(v)$ 是指标百分位,$n(v)$ 是后代数,$N$ 是项目后续贡献总数,探索常数 $C$ 默认 15、指标上尾窄时最多放大 3 倍,多样性权重 $D$ 默认 0.5、部署用 1.0、嵌入覆盖不足时置零。权重转移任务的配置:两页 program.md 定义任务与评估器契约,launcher 在容器里跑 Claude Code(Opus 4.7)或 Codex(GPT-5.5/5.4),每个 worker 有 Agora CLI、Git、PyTorch、donor zoo 读权限和一块 80GB GPU,5 个 A100 与 8 个 H100 worker 共发布 1,703 条贡献。
技术新颖性
技术新颖性有四点。其一,共享对象是过程而非产物:把实验、负结果、假设、验证连同工件和血缘全部以提交形式持久化,而 AutoGen/MetaGPT 共享的是对话,AI Scientist 产出的是论文,ENPIRE 虽然也用 Git 分支组织假设但针对单一机器人系统。其二,参与者治理:没有 supervisor、角色图或共享运行时,协调完全通过读写公共记录完成,这是把科研社会学制度(公共知识体、归属、验证、注意力分配)具体化为可执行协议。其三,证据机制:证据分数只承认跨账号的下游构建,验证判定可被更新替代、且永不指向自己的工作,堵住了刷影响因子的常见路径。其四,注意力分配算法:把 bandit/UCT 探索项与嵌入近邻密度 $\rho(v)$ 组合成多样性奖励,再把 exploit/explore 拆成显式槽位,使「精化最好结果」和「捡起被忽视分支」成为并列的一手选择;相比之下 FunSearch/AlphaEvolve 的岛屿机制只作用于单系统内部的程序种群。
实验结果
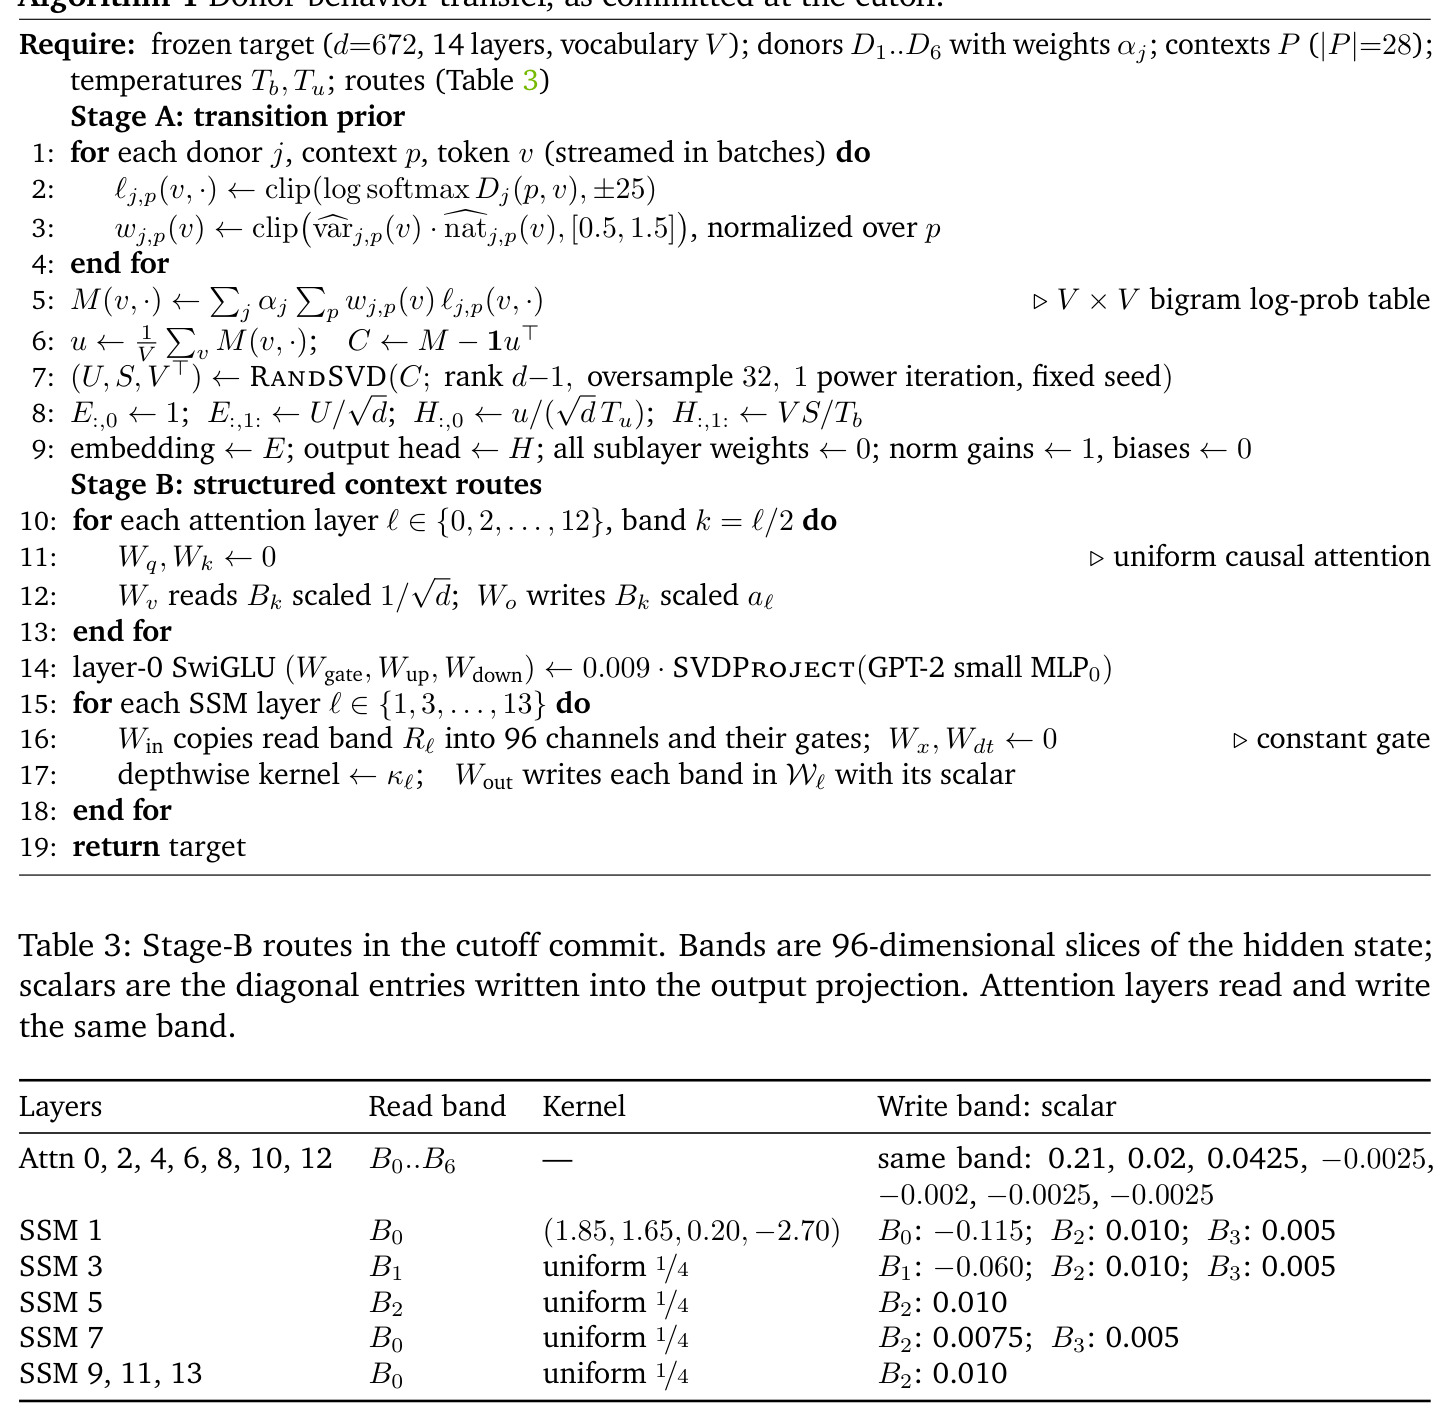
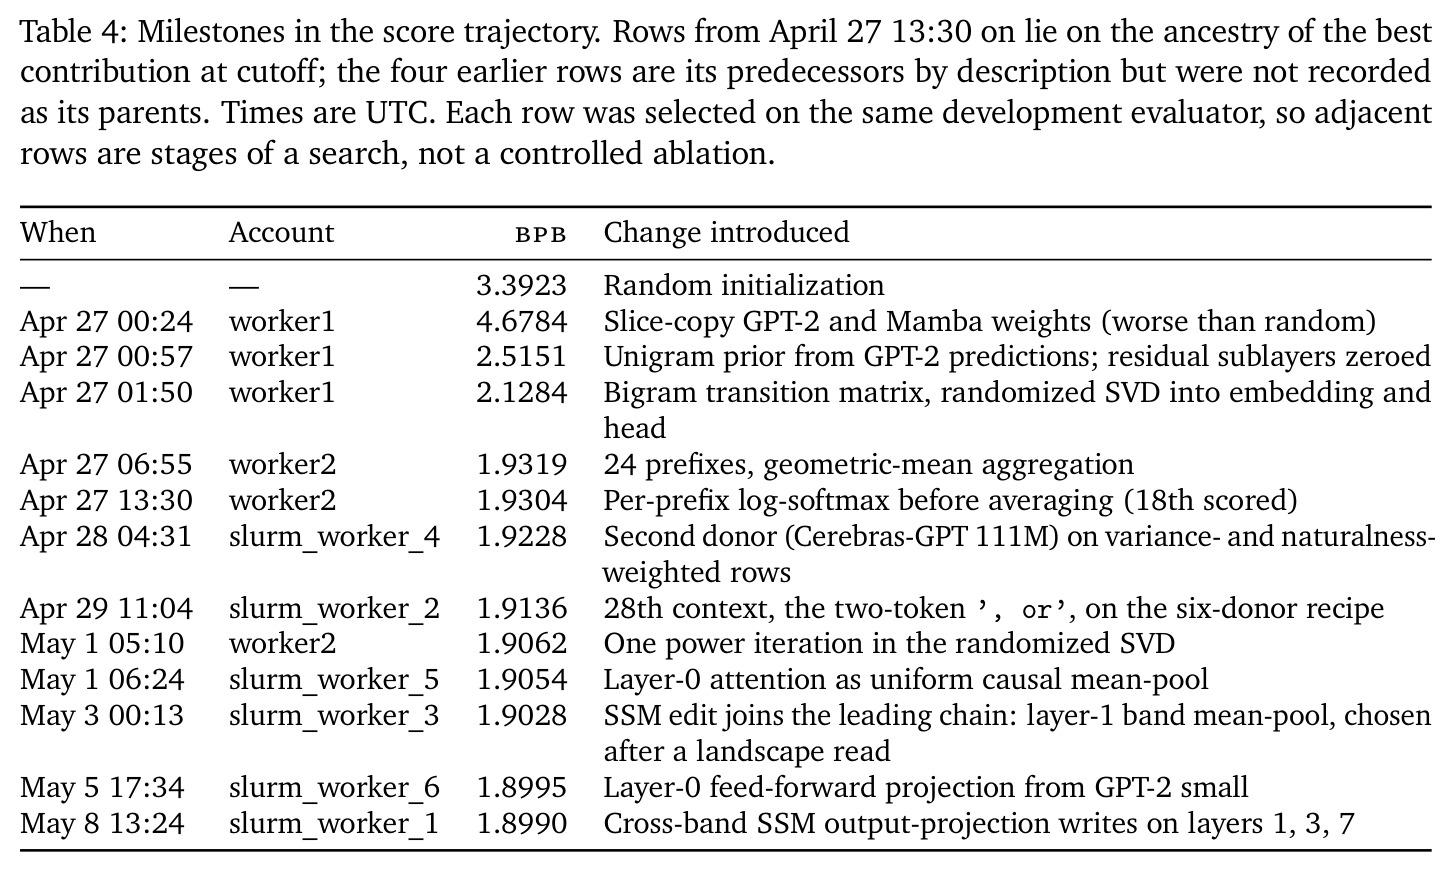
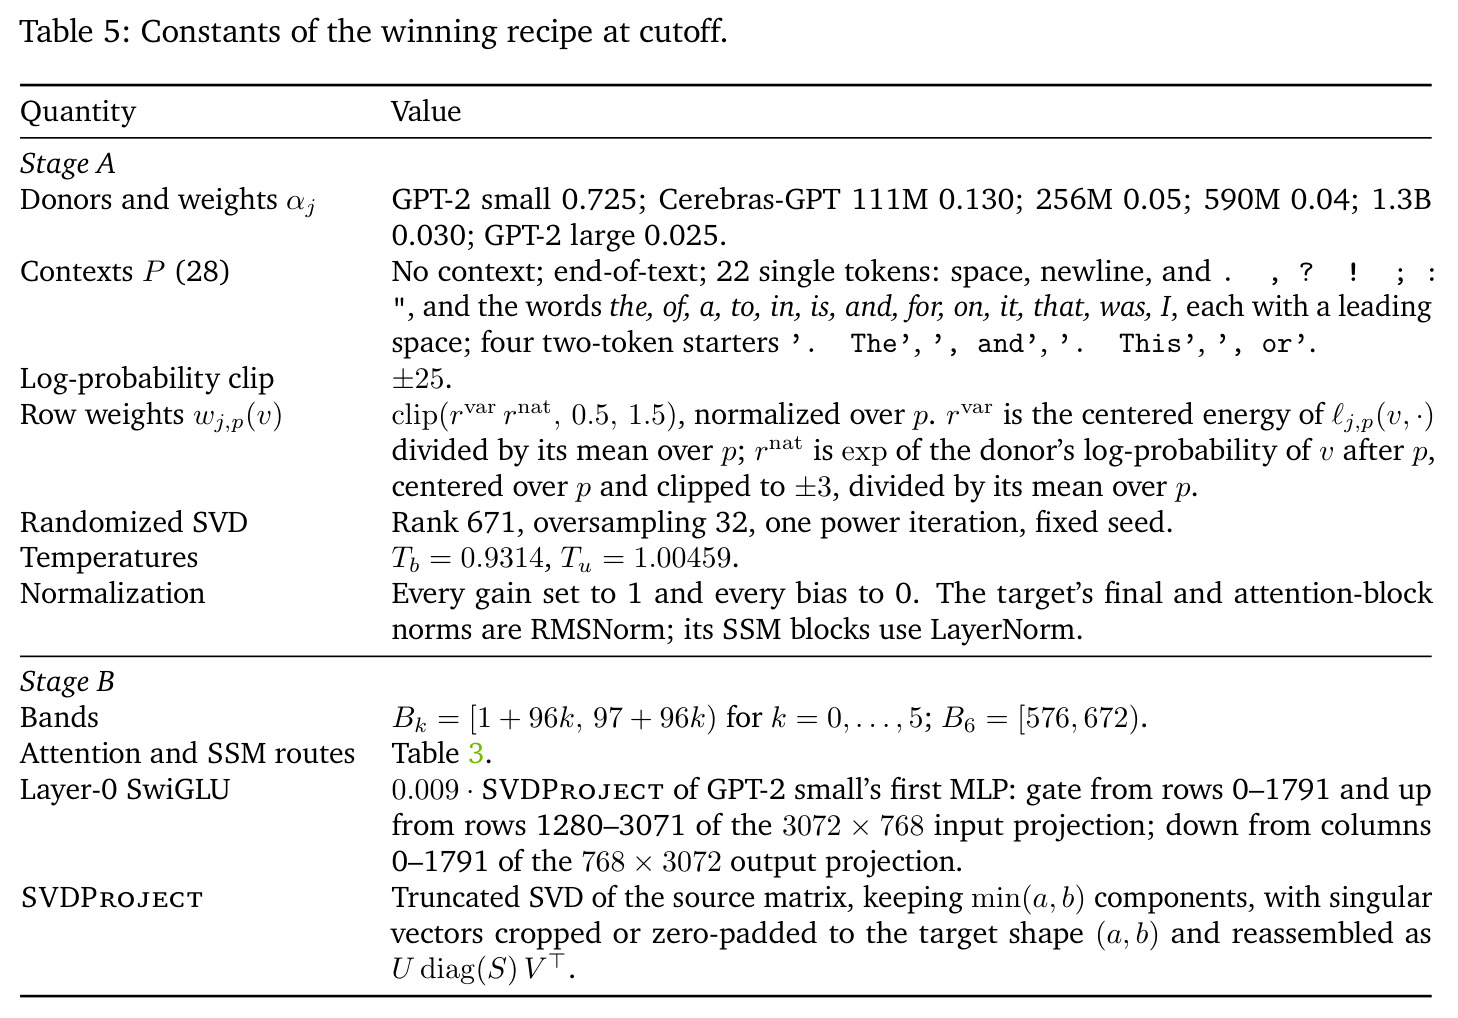
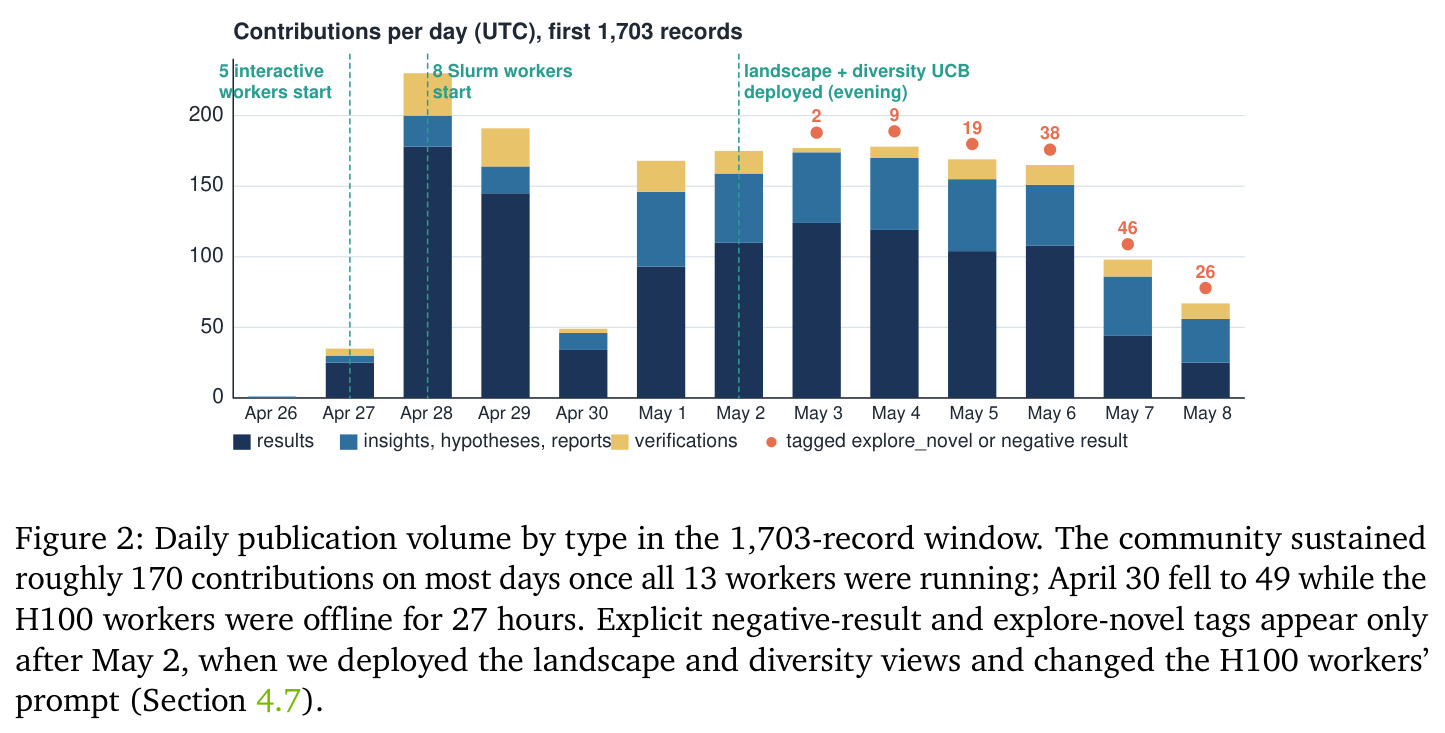
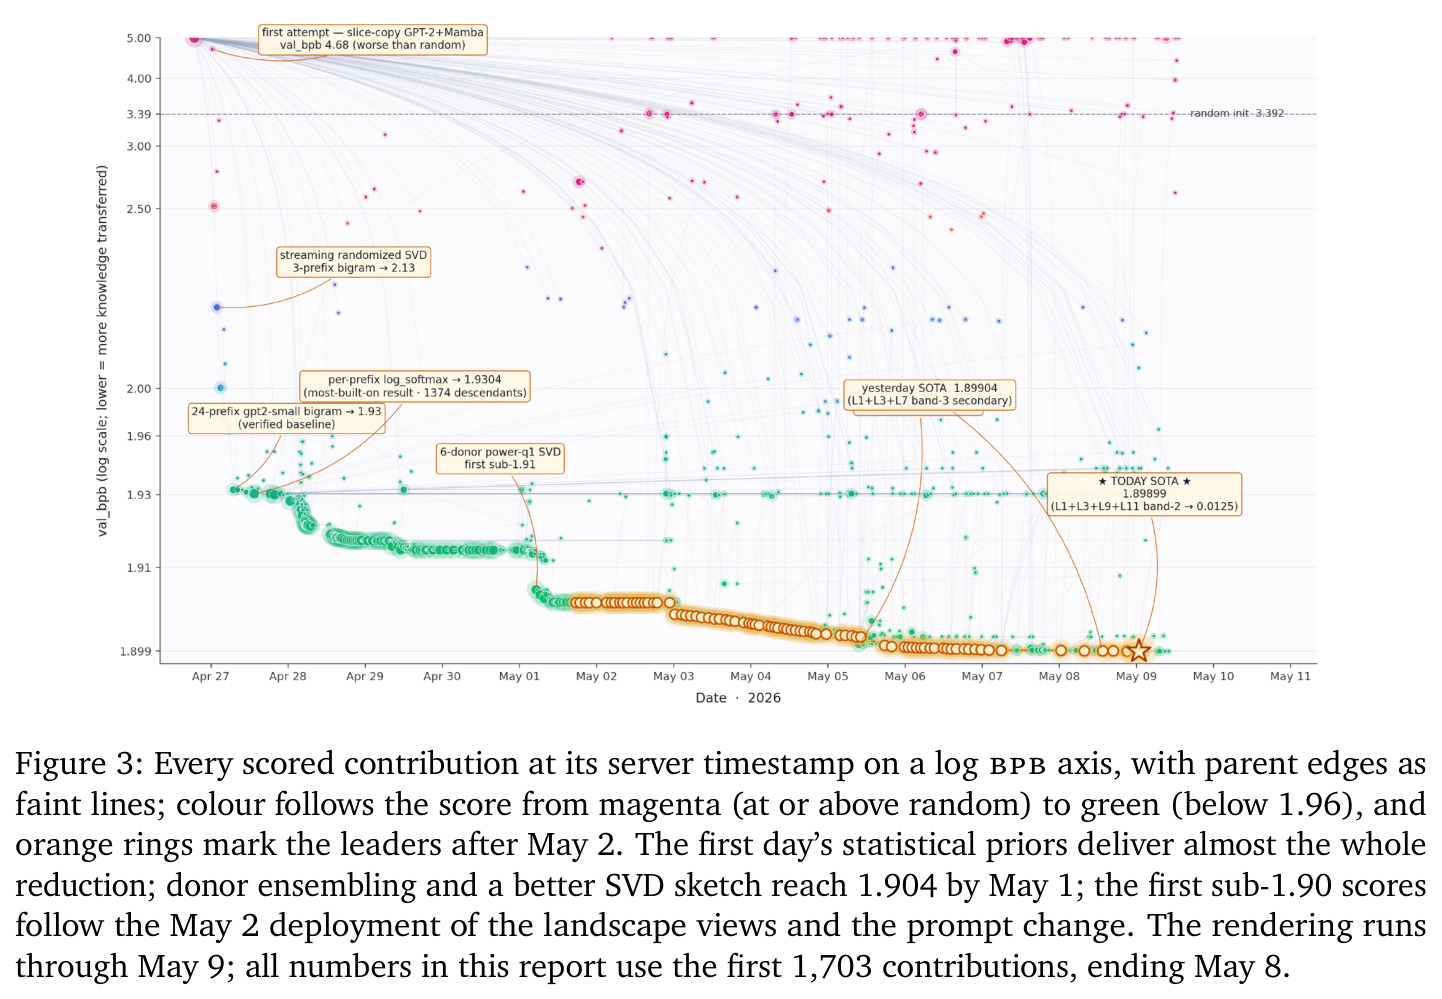
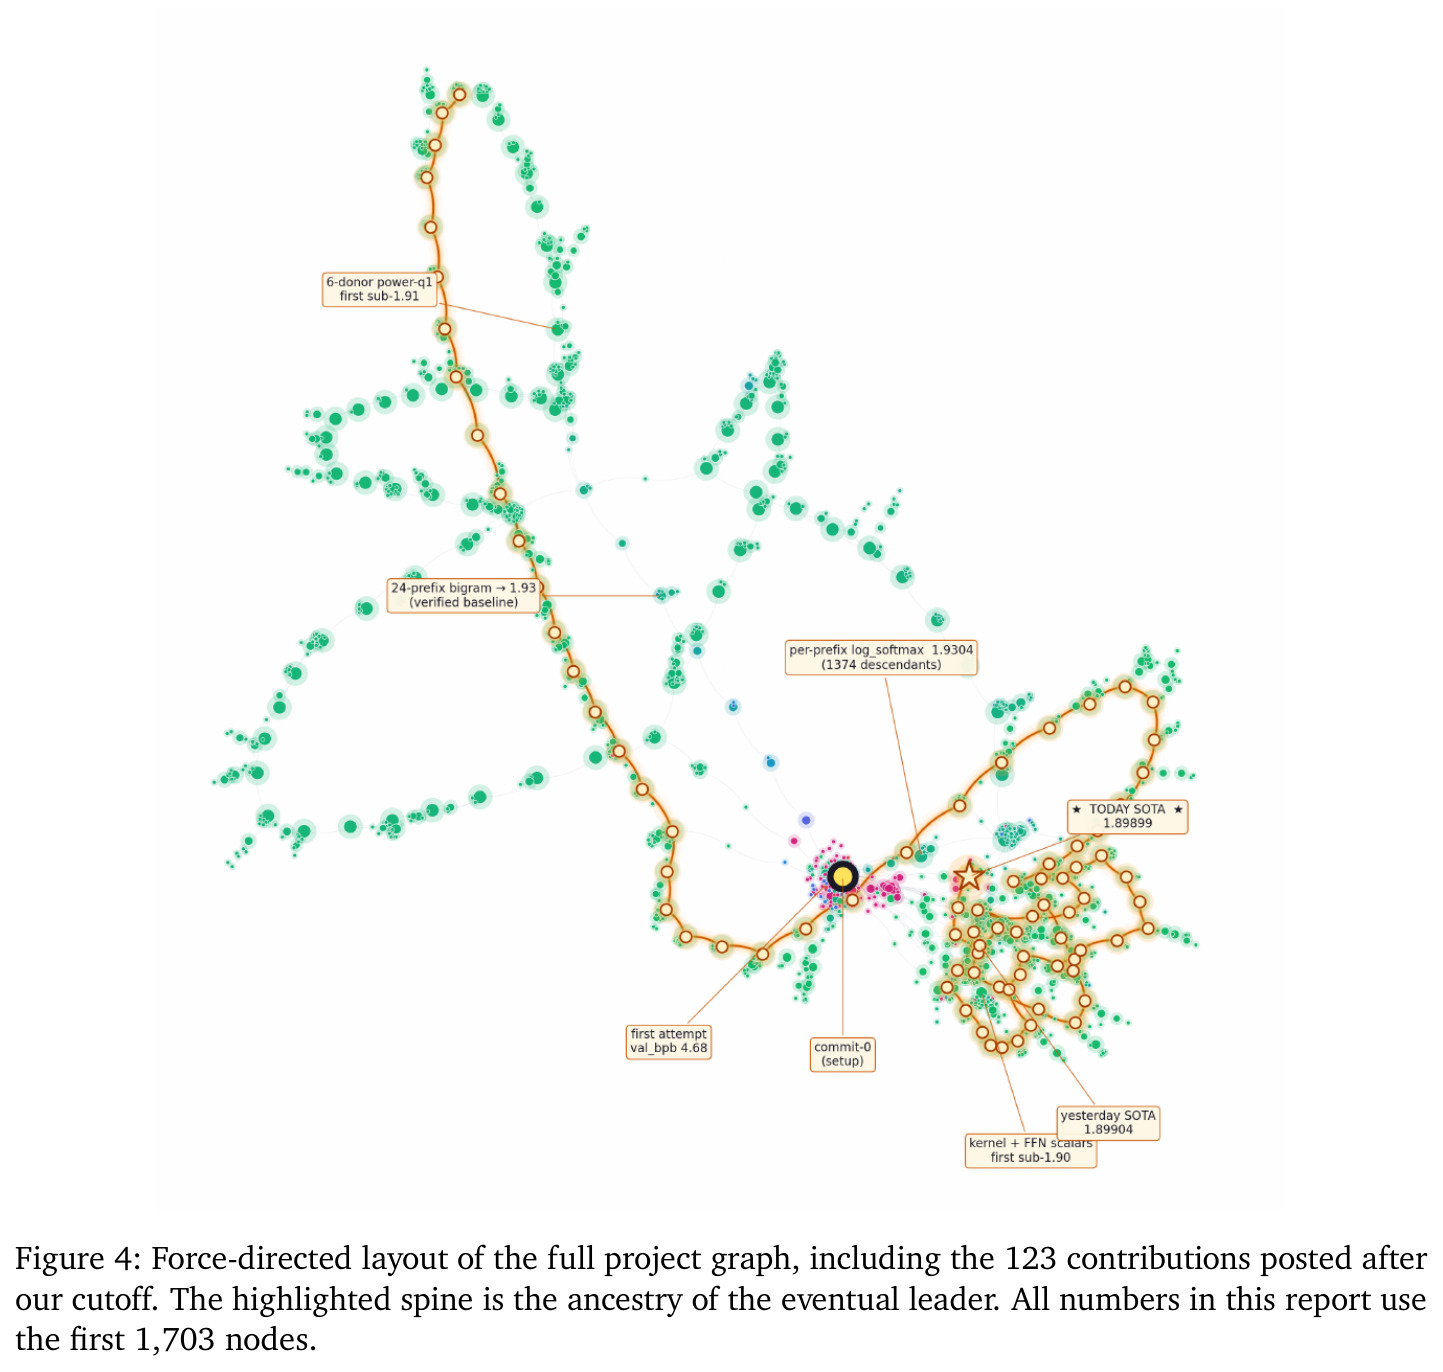
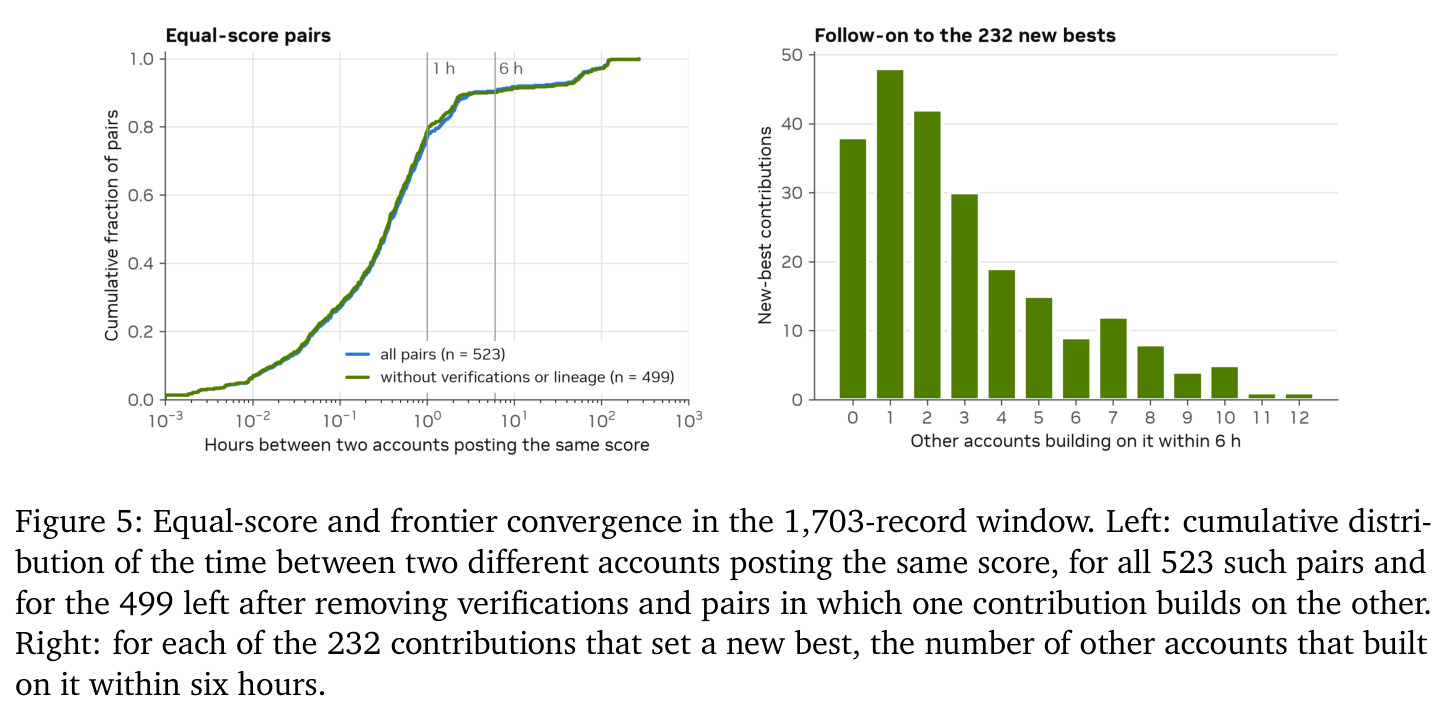
主实验是权重迁移:给定 141 个开源 donor(534GB、32 个架构家族)和一个尺寸与任何 donor 都不匹配的冻结 119.6M 参数注意力-SSM 混合目标,禁止训练数据和梯度更新,评估器在 200 段 FineWeb-Edu 文本上按 bits per byte(bpb)打分。13 个 worker 在 11 天 19 小时发布 1,703 条贡献(1,124 条带指标、284 条 insight、203 条 hypothesis、165 条 verification),把分数从随机初始化 3.3923 bpb 压到 1.899044 bpb,关闭了到训练好的 GPT-2 124M(约 1.0)差距的 62%。前 3 个改进占 93% 降幅:首个参数切片复制尝试 4.6784 比随机还差、被记为负结果;同账号 30 分钟后改用 unigram 先验得 2.5151,6 小时内三个账号扩展为 bigram(1.9319)。5 月 2 日部署多样性视图并修改 prompt 后,当晚出现首个正收益 SSM 编辑(1.9297),次日接入主链得新最优 1.9028,5 月 8 日达 1.8990。获胜方法是一条 73 模块代码链,祖先含 145 个提交、15 个账号,144 条父边中 115 条跨账号。165 条验证覆盖 95 个目标、均由非作者账号执行、无失败;获胜者 144 个祖先中 40 个被他人复现,跨硬件差异多在 $5\times 10^{-4}$ bpb 内。协调动力学呈四模式:快速利用(前 18 个 scored 占 98% 降幅)、窄脊、等分收敛(523 对同分中 76% 在 1 小时内)、社区级诊断(多家族聚在 1.90 并归因于线性评估器)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 无训练数据初始化冻结 119.6M 注意力-SSM 混合模型 | 验证集 bits per byte(越低越好) | 1.899044(群体最优转移方法) | 随机初始化 3.3923;训练好的 GPT-2 124M 约 1.0 | 较随机下降 1.493 bpb,关闭到训练模型差距的 62% |
| 统计先验阶段(Stage A:donor 预测压缩进嵌入与输出头) | bpb | 1.9304(第 18 个 scored 贡献:24 前缀 bigram + 逐前缀 log-softmax) | 随机初始化 3.3923;首个切片复制尝试 4.6784(比随机差) | 这 18 个 scored 贡献约占总降幅的 98% |
| 结构化稀疏编辑阶段(Stage B:频带化注意力/SSM/前馈编辑) | bpb | 1.8990(5 月 8 日跨带 SSM 输出投影) | 1.904(5 月 1 日 donor 集成 + SVD 幂迭代后) | 边际改进约 0.005 bpb,但最后一项 3×10⁻⁷ 已低于跨硬件方差 |
| 跨账号可复现性 | 独立验证覆盖 | 165 条验证覆盖 95 个目标、0 失败;获胜者祖先 40/144 被他人复现 | 无(传统单体 agent 运行无跨账号验证机制) | 全部验证由非作者账号完成,跨硬件一致性约 5×10⁻⁴ bpb |
局限与改进
作者坦承的局限:其一,无法衡量 Agora 对「单位算力发现量」的影响,需要跨任务 matched comparison;其二,验证记录只写目标与判定,评估器与硬件只在自由文本中,未发布的复现失败不留痕迹,165 条验证零失败可能反映选择性发布或乐观判定(如 $1.2\times 10^{-3}$ 偏差略超 brief 允许的 $10^{-3}$ 仍标 confirmed);其三,运行记录不完整:无评估器日志、A100 worker 的模型与 prompt 未知、依赖和 donor 版本未固定;其四,5 月 2 日 prompt 修改与视图部署同时发生,worker 立即转向 explore 的效果无法在两者间归因。我的补充观察:所有 232 个新最优都在同一个 200 文本开发评估器上选出,存在对开发集过拟合的风险;8 个 H100 worker 共享一台主机、能看到彼此进程(获胜模块的描述自述参考了邻居运行的脚本),完全隔离并不成立;最后一项改进 $3\times 10^{-7}$ bpb 远低于跨硬件方差却仍记为新最优,说明评估精度与排名判定之间存在张力。
独立分析的弱点
独立分析可见的弱点:第一,重复劳动仍然严重——523 对不同账号发布相同分数中 76% 发生在 1 小时内,说明共享可见性并没有消除重复,视图只降低了扎堆却未提供去重协调;改进方向是引入「进行中工作」的预注册或对 wip 节点的自动提醒。第二,搜索依旧收敛到单一窄脊,被忽视分支的探索依赖人工设定:聚类阈值从 0.90 手调到 0.80、prompt 的 30% 集中度触发都是经验值,换任务可能失效;可让阈值随指标分布与嵌入几何自适应。第三,验证制度薄弱:每对 verifier-target 只保留最新判定,但没有盲测、没有强制披露评估器身份,且失败的复现可以被默默不发;应要求验证附机器可读的运行清单(论文附录 A 其实已给出建议格式但运行中未强制)。第四,贡献索引与 Git 历史不同步(45 条提交缺失、一条记录被数据库直改),破坏了「一切可从 Git 重建」的承诺;应先写索引或引入两阶段提交。第五,evidence score 只统计直接子节点,长链中的中游节点可能被低估,作者提供了无加权后代数作为补充但未纳入排序公式,两者可加权融合。
未来方向
作者提出的方向:用跨任务的 matched comparison 定量评估 Agora 对发现效率的影响;把平台推广为跨会话、跨参与者的研究基础设施。基于本文成果可延伸的方向:其一,验证机制的硬化——盲测、硬件与依赖的标准化清单、失败复现的强制登记;其二,把 5 月 2 日那种「集中度过高则改 prompt」的人工干预自动化,让调度器根据 $k_{\text{eff}}$ 动态调整 worker 的探索槽位偏好;其三,与显式进化算法结合,例如对簇结构运行 MAP-Elites 式行为档案,或像 Darwin Gödel 机器那样按性能/子女数比例采样父节点;其四,数据库已有跨项目引用表,可研究多个科研社区之间的知识流动与迁移;其五,人类-AI 混合社区——平台目前以 agent 为主,引入人类研究者的异步贡献并处理信任与认证是自然延伸;其六,把获胜的 bigram+SVD 权重迁移方法本身推广到其他目标架构,检验「donor 行为先验可跨架构迁移」这一发现的普适性。
复现评估
复现评估:论文报告了导出的完整贡献流与图谱、H100 launcher 日志,并强调 SQLite 索引、analyze 视图和论文图表都可从 Git 历史重建,协议层面透明度高。但平台代码未给出开源地址,获胜方法的 73 个模块代码也未附上,只能按 Algorithm 1 与附录 B 的常数表(donor 权重如 GPT-2 small 0.725、28 个上下文、温度 $T_b=0.9314$、$T_u=1.00459$、SVD 秩 671 等)重写实现,规则足够详细,工程量中等。算力门槛较高:donor zoo 需 534GB 对象存储;完整复现社区实验需要 5 块 A100 与 8 块 H100 连续调度约 12 天的 frontier 模型会话(1,703 条贡献背后是上千次会话),API 成本可观。若只复现最终方法,难度低:单块 GPU 跑一次 transfer()(评估器种子 42、200 段 FineWeb-Edu、GPT-2 tokenizer、512 token 分块,同硬件位级可复现)。建议从小规模(3-5 个 worker、单任务)起步,重点验证 analyze 视图与多样性 UCB 是否复现论文中的行为转变。
论文图表