Repo-To-Skill:把GitHub仓库蒸馏为AI研究智能体的可验证技能库 Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills
提出DisCo智能体,把ML仓库蒸馏为可验证技能库,使研究性能最高提升134.3%
前置知识
自主研究智能体
能够自主执行ML研究流程(设计方法、写代码、跑实验、比较结果)的智能体系统。通常由两部分构成:模型骨干 $M_\theta$ 提供理解、推理、规划与执行能力;harness $H$ 提供编排、记忆、验证与迭代精炼,两者共同构成“推理—行动—观察”循环,直到满足目标 $g$ 或预算耗尽。
本文的出发点就是指出现有“骨干+harness”二组件视角的盲区,所有讨论都建立在这个架构之上,并将其扩展为三元组 $A_{\text{res}} = (M_\theta, H, K)$。
操作知识
区别于声明性知识(论文陈述“某方法有效”、文档说明“某API接受什么参数”),操作知识是把事实转化为任务级行动方案的know-how:什么方法能解决当前问题、何时适用、怎么正确使用,涵盖选方法、配参数、避实现与评估陷阱。论文将其形式化为智能体显式携带的操作上下文 $K$。
它是全文的核心概念。理解本文就是理解如何从仓库与论文中自动生产、验证这种知识,并让它跨任务复用。
Agent Skills 规范与 SKILL.md
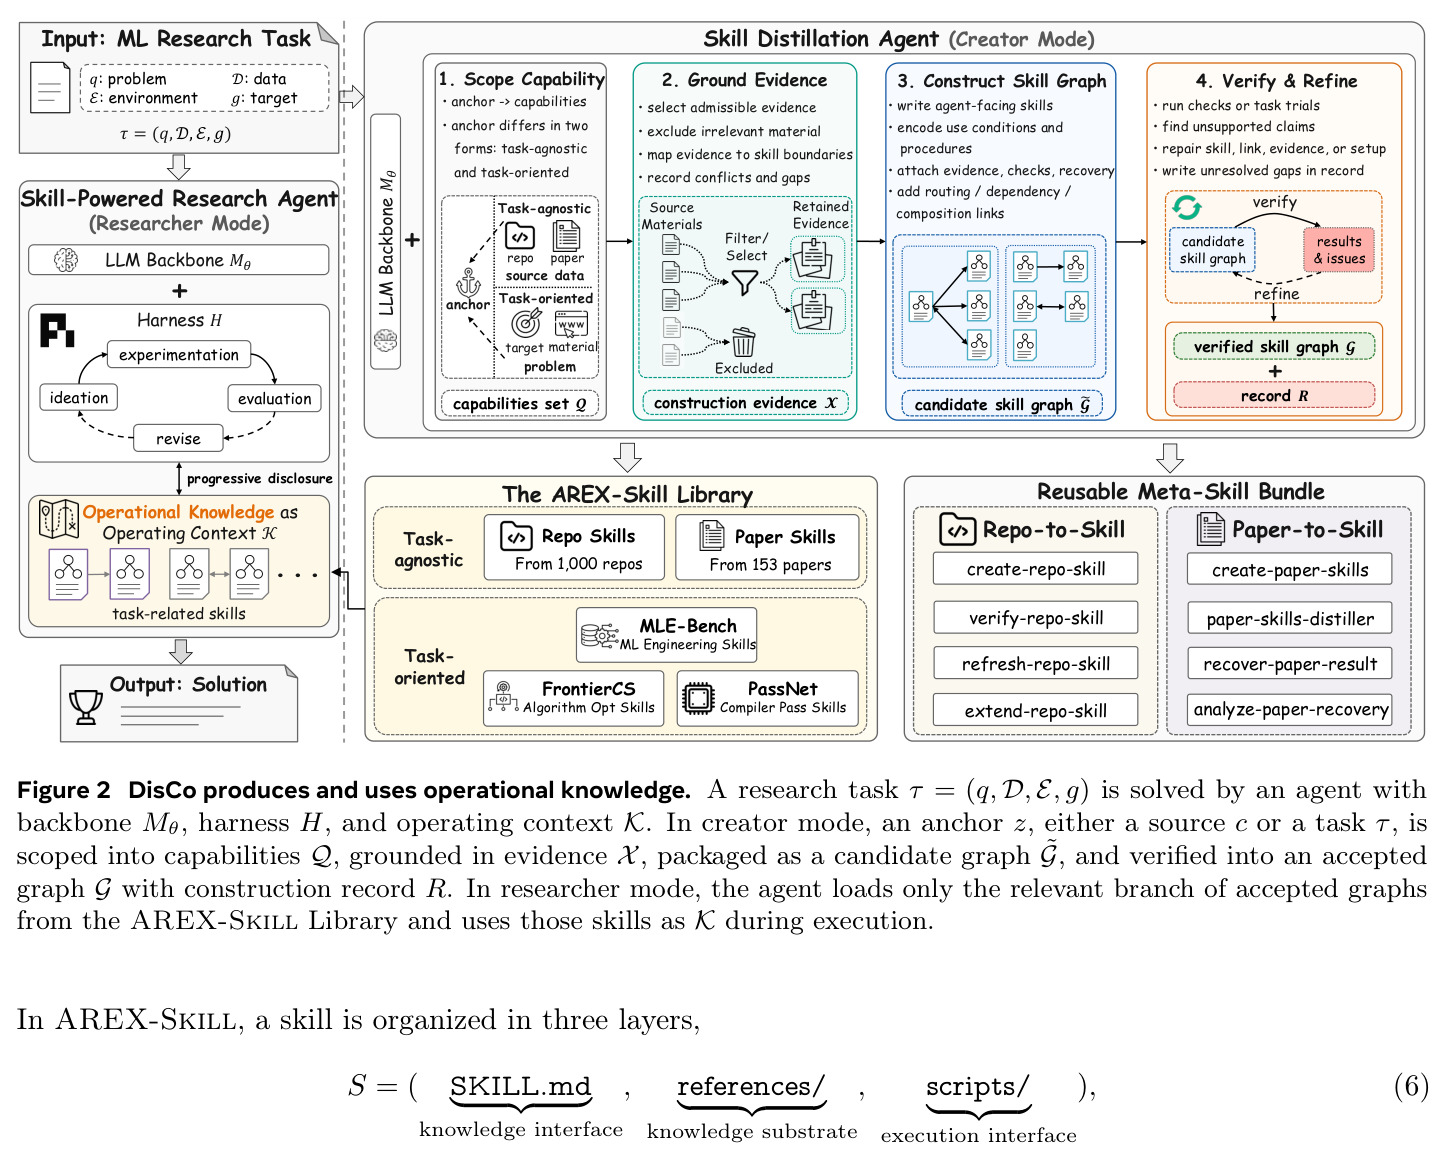
Anthropic提出的智能体技能标准:每个技能是一个以SKILL.md为核心的可检视工件,说明用途、激活条件、操作步骤与工具使用策略,可附带references/参考文档和scripts/可执行脚本。Claude Code、Codex等主流智能体系统原生支持,技能即插即用、无需改动模型参数。
本文选择技能作为操作知识的载体,三层结构(SKILL.md知识接口 / references知识基底 / scripts执行接口)正是整个方法设计的骨架。
渐进式披露
一种上下文管理原则:技能入口只放摘要级信息,智能体先读入口判断相关性,再按需打开更深层的参考文档或脚本。这样智能体可以持有成千上万个技能,而任一时刻只加载当前任务需要的少数几个,避免知识库撑爆上下文窗口。
AREX-Skill库的路由器与技能图链接都靠这一原则工作,是理解5000+技能如何被高效消费而不挤占上下文的关键。
研究动机
当前自主ML研究智能体由模型骨干(提供理解、推理、规划与执行)和harness(提供编排、记忆、验证与迭代精炼)两部分构成,但这个双组件架构存在盲区:领域专有的“操作知识”缺失。设想让智能体在不熟悉的数据集上改进模型,它必须决定用什么方法、选哪个包、数据该怎么布局、哪些配置合理、哪些陷阱会毁掉一次运行——这些只能靠试错推断,而一次配置错误的训练可能在烧掉大量算力预算后才暴露无效,且这些试错结论无法跨任务保留,每个任务都要重新摸索。这类知识其实大量存在于GitHub仓库和论文中,但它们是为人类读者写的、体量太大无法在任务运行时直接加载。实测数据印证了缺失的代价:GPT-5.5驱动的Codex在MLE-bench全部75个竞赛上仅取得31.11%的Any-Medal得分,High难度赛题只有13.33%,大量预算浪费在试错而非真正的研究上。
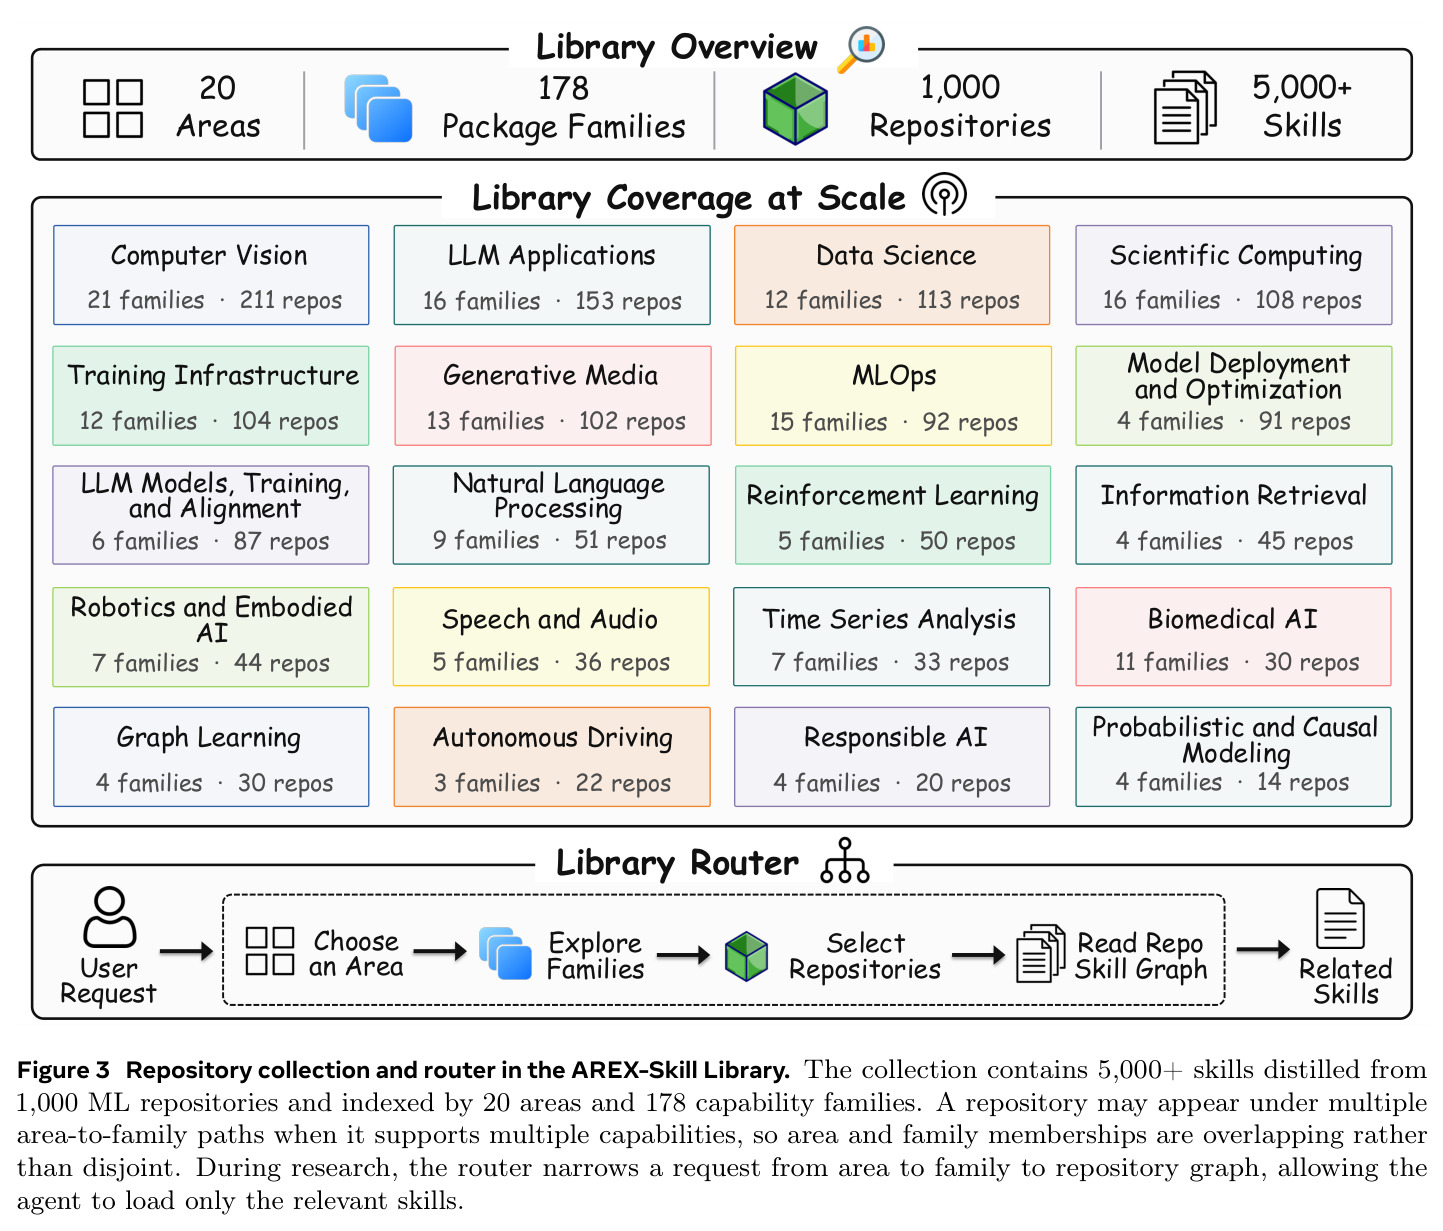
本文的目标是本文的目标是自动、大规模地把声明性知识来源(代码仓库、论文、教程)转化为紧凑、可操作、经过验证的技能,构建智能体可直接加载的“操作知识层” $K$。具体包括四件事:一是把智能体形式化扩展为 $A_{\text{res}} = (M_\theta, H, K)$;二是提出DisCo智能体,在同一骨干与harness上以creator/researcher两种模式分别生产技能和使用技能;三是把该流程规模化到开放生态,从1000个广泛使用的ML仓库蒸馏出5000+经核验的技能,按20个领域、178个能力族组织成可路由的AREX-Skill库;四是在骨干模型、harness与下游执行预算全部固定的对照设置下,量化技能层对MLE-bench、PaperBench、FrontierCS、PassNet四个基准的净增益,使技能成为唯一变量。
与已有工作不同的是,已有工作的思路几乎都是造更强的控制回路:更聪明的多智能体编排、更精细的搜索策略、更复杂的记忆机制。本文的独特切入是承认智能体架构本身已经够用,缺的是知识内容——harness决定智能体“怎么研究”,操作知识决定它“开工时知道什么”。因此作者完全不改模型与harness,把知识外置为符合Agent Skills规范的可移植工件,同一技能可被任何兼容harness消费。与Voyager、Agent Workflow Memory、ExpeL等从交互轨迹中总结经验的方法不同,本文从静态工件(仓库/论文)蒸馏,每条技能带证据溯源与验证记录,且“无验证不入库”——验证正是蒸馏与普通摘要的本质分界。creator一次性付费、researcher按需读取的成本不对称设计,也让这个知识层可以规模化摊薄。
核心方法
直觉上,这相当于给自主研究智能体配一套“岗前操作手册”:不是教它更会思考,而是让它开工前就知道该用哪些工具、怎么用、何时用。技术上,论文先把研究任务形式化为 $\tau = (q, D, E, g)$(问题、数据、环境、目标),把研究智能体写成 $A_{\text{res}} = (M_\theta, H, K)$,其中 $K$ 是技能集合。每个技能是三层结构:SKILL.md是知识接口(入口加标准操作流程),references/是知识基底(按需加载的API文档与算法细节),scripts/是执行接口(定义好输入输出的封装脚本)。单个来源的知识组织成技能图 $G = (S, L)$,入口技能经路由、依赖、组合三类链接连接组件技能。蒸馏遵循四阶段流水线 scope→ground→construct→verify,分任务无关(锚定来源)与任务导向(锚定任务)两种互补形式。AREX-Skill库再用两层分类法(20个领域、178个能力族)与库级路由器实现渐进式披露,从请求出发逐级收窄到具体技能。
核心创新是识别并形式化了“操作知识”这一缺失层,并给出可自动生产、可验证的载体。$K$ 有两个互补组成:把知识变成能力(方法、代码、模型、API封装成智能体可调用的单元),把能力变成使用策略(每个单元附带适用条件、理由与流程)——只有能力没有策略则不会选择,只有策略没有能力则不可执行。与已有方法的本质区别有三点:其一,知识来源是静态工件而非交互经验,解决了轨迹蒸馏出的代码与洞察难以验证、失败难以归因的问题;其二,验证门控机制——候选技能必须通过断言式检查或任务试验才能入库,残余缺口如实写入构建记录 $R$ 而非隐瞒;其三,双模式的成本不对称——creator模式为每个来源付一次构建费(平均每仓库约40美元),researcher模式只支付实际打开的内容,使5000+技能可被摊薄持有而不挤占上下文。
方法步骤详情
蒸馏流水线写作 $z \xrightarrow{\text{scope}} Q \xrightarrow{\text{ground}} X \xrightarrow{\text{construct}} \tilde{G} \xrightarrow{\text{verify}} (G, R)$。第一步scope:锚点 $z$ 是来源(仓库/论文)时做源理解与能力识别,是任务 $\tau$ 时做任务分解与能力缺口分析,输出待覆盖能力集 $Q$。第二步ground:任务无关形式从来源内部提取证据 $X \subseteq C$;任务导向形式则主动搜索外部材料填补缺口。第三步construct:可执行部分封装成稳定接口的脚本,按三层结构组装候选技能图 $\tilde{G}$,链接编码路由、依赖与组合关系。第四步verify:用断言式用例、仓库原生示例、测试、CLI检查或冒烟脚本核验内容与可用性,归因于图的失败触发局部修复并重跑,通过的图 $G$ 连同构建记录 $R$ 入库。使用时researcher模式从库级路由器出发,按领域→能力族→仓库图逐级收窄,只加载当前需要的内容。构建用GPT-5.5与GPT-5.6-sol(xhigh档),平均每仓库约40美元。
技术新颖性
技术新颖性体现在四方面。第一,规模化的自动技能生产:此前对现有SKILL.md的大规模分析显示人工编写质量参差,本文首次把1000个仓库自动蒸馏为5353个经验证技能,并构建两层分类法——先冻结每仓库摘要,再让LLM提议完整领域树,用100个稳定批次(每批10仓库)的定位器与评审调用迭代修正,最终做精确路径归类,拒绝仅关键词、仅依赖、仅可选集成、仅示例的匹配。第二,验证协议:每个图的核验绑定可执行证据(原生测试、CLI、夹具),PaperBench场景还引入有界恢复实验并排除目标论文自身实现以防泄漏,153篇来源论文产出636个论文衍生技能。第三,渐进式披露的工程化:入口技能加链接图让智能体持有5000+技能却只读少数几个,700个仓库出现在多个能力族下体现能力重叠。第四,严格的对照实验设计:骨干、harness、下游预算全部固定,技能是唯一变量,并用配对bootstrap给出置信区间。
实验结果
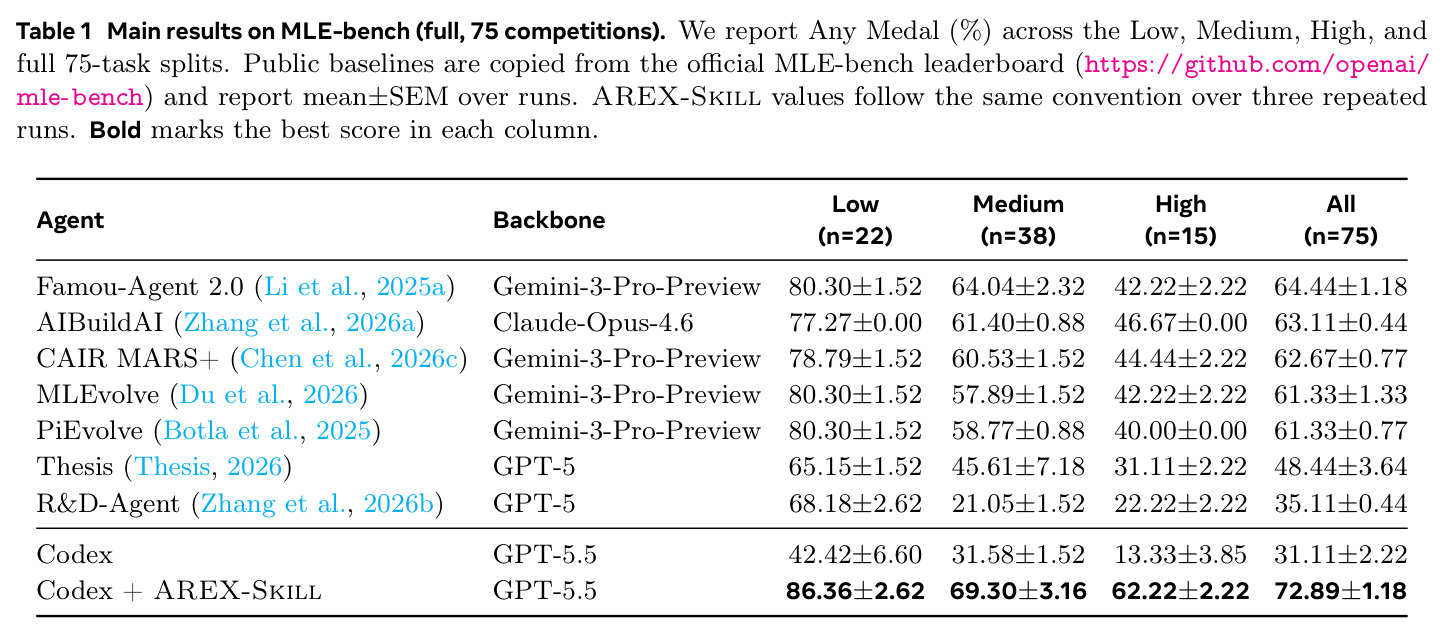
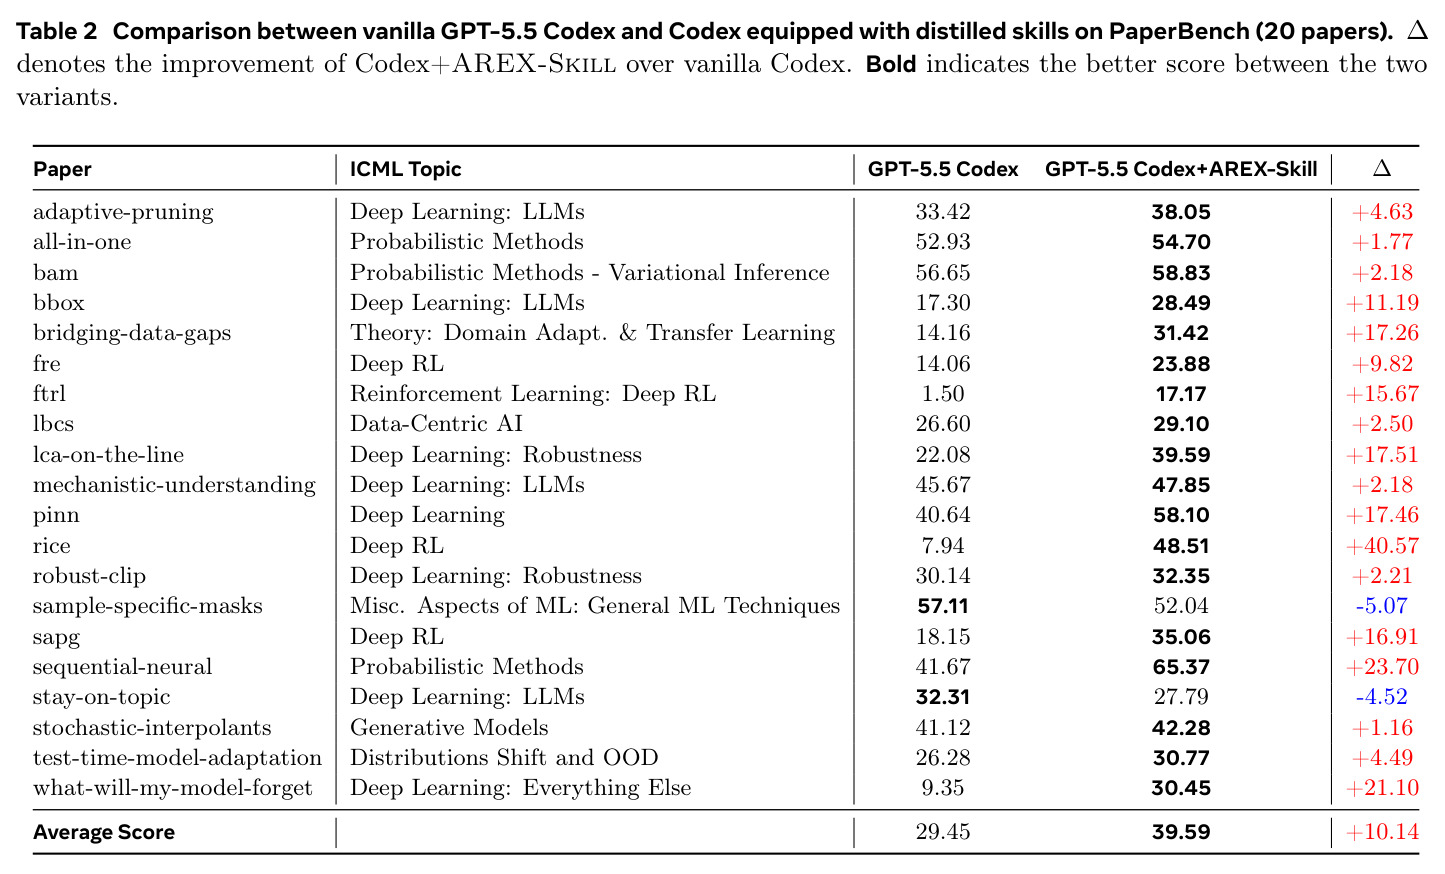
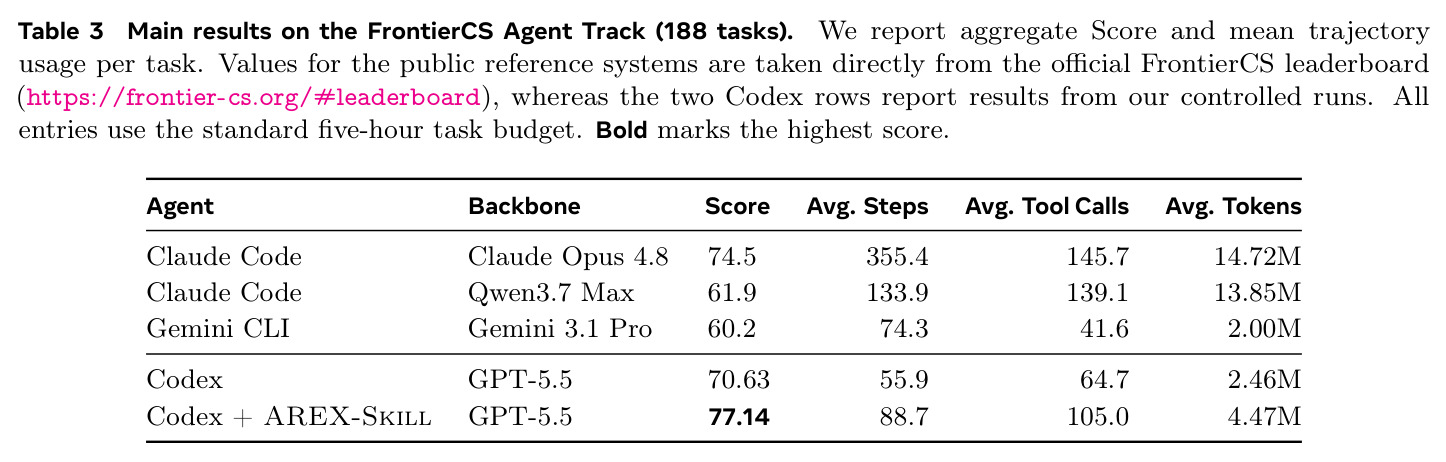
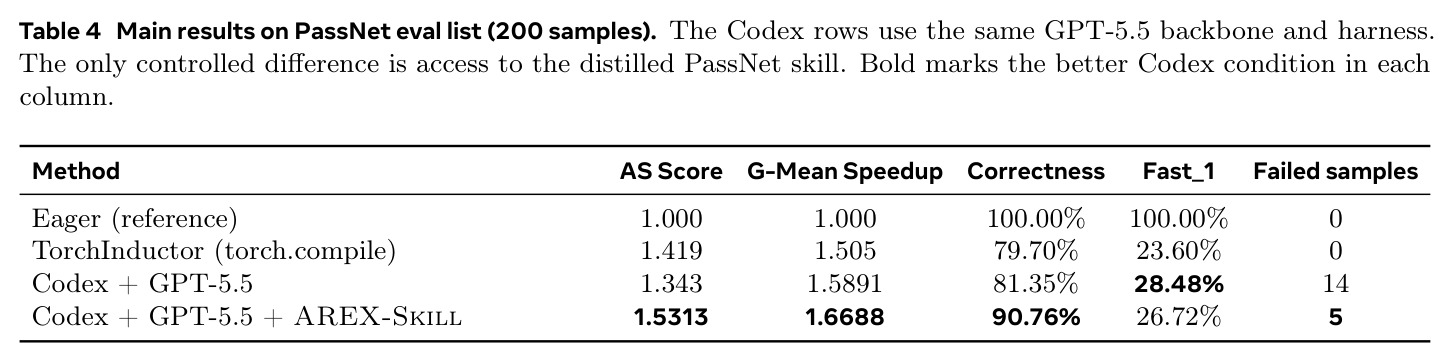
四个基准在固定GPT-5.5骨干与Codex harness下对照结果一致为正。MLE-bench(75赛题):Any-Medal从31.11%升至72.89%(+41.78pp,相对+134.3%),Low/Medium/High分别为42.42→86.36、31.58→69.30、13.33→62.22(High相对+366.8%),并超过最强公开基线Famou-Agent 2.0的64.44%。PaperBench(20篇):平均分29.45→39.59(+10.14pp,+34.4%),18篇提升仅2篇回退,最大增益rice +40.57、sequential-neural +23.70,ftrl从1.50升至17.17(11.4倍),呈基线越低相对增益越大。FrontierCS(188题):70.63→77.14(+9.22%),95% CI [3.41, 9.83];47个低于50分的任务均值19.43→45.99,30题跨过50分线;token用量4.47M仅为Claude Code(14.72M)的约三成而得分更高,四维度Pareto支配。PassNet(200样本):AS Score 1.343→1.5313(+14.0%),正确率81.35%→90.76%,失败样本14→5(降64.3%),超过TorchInductor的1.419。且增益与额外token/步数/工具调用的Spearman相关近乎为零(ρ≈0.006–0.015),说明提升来自知识而非资源堆砌。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MLE-bench 全量(75个Kaggle竞赛) | Any-Medal 得分 (%) | 72.89 | 无技能 Codex (GPT-5.5) 31.11;最强公开基线 Famou-Agent 2.0 (Gemini-3-Pro-Preview) 64.44 | +41.78pp(相对+134.3%),超过最强公开基线 8.45pp |
| MLE-bench High 难度(15题) | Any-Medal 得分 (%) | 62.22 | 13.33(无技能 Codex) | +48.89pp,相对提升 366.8%(4.67倍) |
| PaperBench(20篇 ICML 论文复现) | 平均复现得分 (%) | 39.59 | 29.45(无技能 Codex) | +10.14pp(相对+34.4%),18/20 任务提升,最大单项 rice +40.57 |
| FrontierCS Agent Track(188题) | 平均 Score(5小时预算) | 77.14(token 4.47M) | 70.63(无技能);Claude Code + Claude Opus 4.8 为 74.5(token 14.72M) | +6.51(相对+9.22%),95% CI [3.41, 9.83],token 仅为竞品约 1/3 且 Pareto 支配 |
| PassNet(200个图编译器 pass 生成样本) | AS Score / 正确率 / 失败样本数 | 1.5313 / 90.76% / 5 | 1.343 / 81.35% / 14(无技能 Codex);TorchInductor 为 1.419 | AS Score +14.0%,失败样本减少 64.3%,正确率 +9.41pp,并超过 TorchInductor |
局限与改进
作者承认的局限:PaperBench上2篇任务回退(sample-specific-masks −5.07、stay-on-topic −4.52),且二者无技能基线均高于20篇均值29.45,提示技能检索存在精度-召回权衡——当任务依赖未被技能图覆盖的特异实现选择时,检索内容反而会把智能体从本来能自行收敛的方案上拉偏,作者提出改进路由或在检索失配时显式回退到无引导推理。我的补充观察:其一,四个基准全部是ML/CS编程类任务,操作知识层对湿实验、理论推导类研究的可迁移性未知;其二,仓库随版本发布不断漂移,技能时效性维护(refresh-repo-skill)流程存在但未量化评估衰减速度;其三,验证依赖可执行检查,对无法运行的声明性内容覆盖有限;其四,构建成本约每仓库40美元,1000仓库即约4万美元一次性投入,且依赖GPT-5.5/GPT-5.6-sol等闭源前沿模型;其五,PassNet上Fast_1指标略降(28.48%→26.72%),说明技能并非在所有子指标上严格占优。
独立分析的弱点
独立分析的弱点:第一,检索精度问题是结构性的——路由器按领域/族/仓库三级收窄,但技能相关性最终仍靠入口描述匹配,两个回退案例显示检索内容可能干扰本可自主发现的策略,改进方向是引入检索置信度门控与无技能回退路径,甚至并行有/无技能两条推理线择优。第二,潜在数据污染灰区:MLE-bench的技能图按赛题逐题构建,虽排除了竞赛官网与竞赛专属内容,但web搜索收集的知识源可能间接包含该竞赛的高票公开方案,与排除泄漏的意图存在张力,改进方向是加入来源时间戳过滤与泄漏审计。第三,验证的局部性:检查通过只保证被测路径可用,技能之间组合使用时的端到端正确性缺乏验证。第四,任务导向技能与基准耦合较深(FrontierCS共享图、PassNet基准级图),其“可复用于同类问题”的论断缺少跨任务实验支撑。第五,结论建立在闭源前沿模型上,技能层对中小型开源模型的补偿效应未知,影响“知识换参数”这一潜在价值的说服力。
未来方向
作者方向:把paper-derived工作流扩展到更多论文(当前仅153篇、636个技能,受验证预算限制);改进路由精度与失配回退机制以消除回退案例;持续扩展AREX-Skill库覆盖面(当前快照1000仓库、5353技能、20领域/178族)。可延伸方向:其一,技能时效维护——监听上游release自动触发refresh-repo-skill,并量化技能过期对性能的衰减曲线;其二,用强化学习优化路由器与技能选择,把“哪个技能在什么任务状态下被打开”变成可学习决策,而非纯描述匹配;其三,静态工件蒸馏与交互轨迹蒸馏互补,形成持续学习的技能生命周期,让researcher模式的运行经验反哺creator模式;其四,扩展到ML之外的科学领域(生物信息、计算化学),检验操作知识形式化的普适性;其五,系统测试技能层对开源小模型的增益幅度,量化“知识换参数”的性价比;其六,建立技能质量的标准化评测协议,缓解当前验证依赖可执行工件、理论型技能难以核验的不对称。
复现评估
复现要点:代码仓库为 https://github.com/VectorSpaceLab/AREX-Skill,AREX-Skill库(1000仓库、5353技能)是否随代码发布需查阅该仓库。构建侧需要GPT-5.5与GPT-5.6-sol的API权限(xhigh推理档),预算约每仓库40美元、1000仓库约4万美元,这是复现库层面的主要门槛;单任务技能图(75个竞赛图、153篇论文的636技能、FrontierCS与PassNet各1个共享图)可小规模单独复现。评测侧:MLE-bench与PaperBench使用官方grader,结果为3次重复的均值±SEM,需要多轮完整运行;FrontierCS经Harbor运行,每题5小时、容器限2 CPU/4 GiB,188题×2条件耗时可观;PassNet需要A100-SXM4-40GB。总体难度偏高:完整复现需要前沿闭源模型权限、数百小时级容器/GPU时长与数千美元API开销。建议从PassNet(200样本、单卡A100)或PaperBench(20篇)入手做子集复现,再决定是否扩展到全量。
论文图表
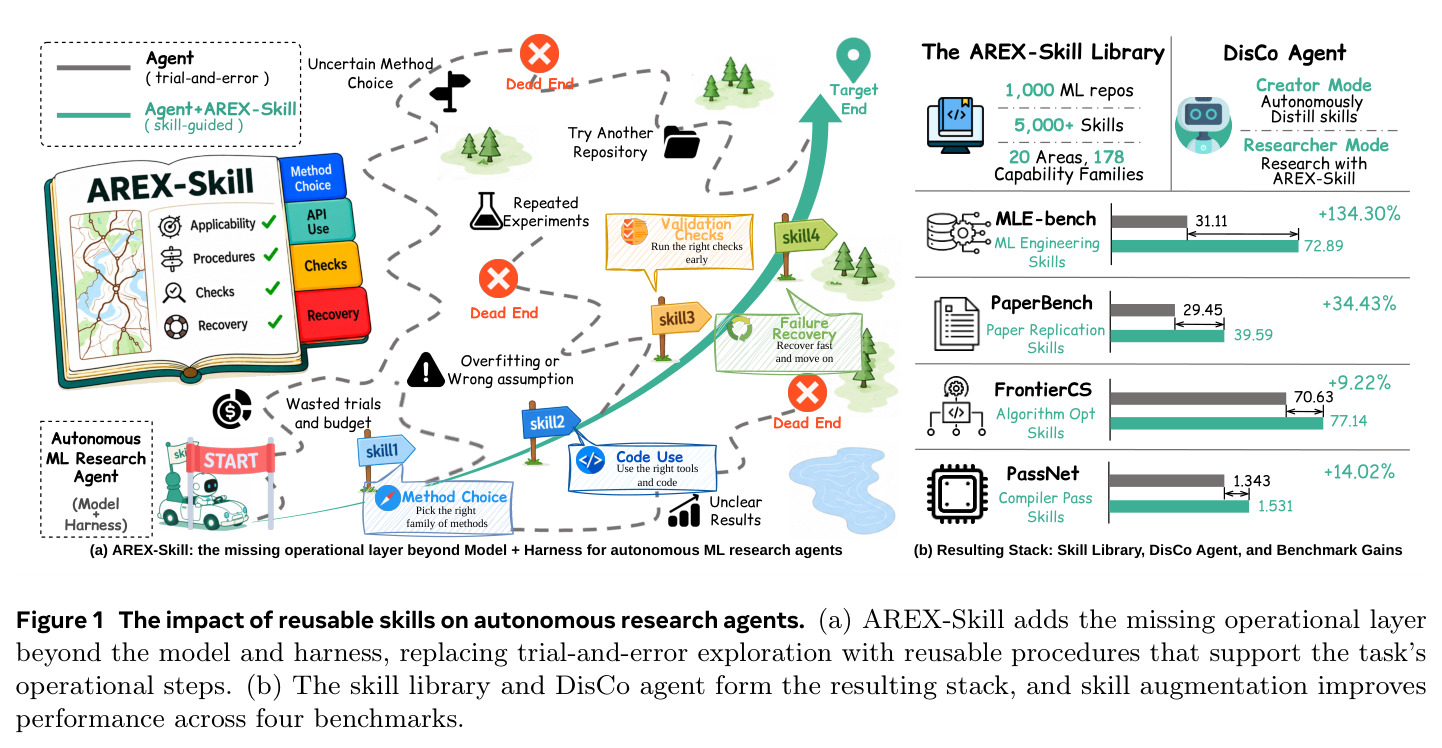
全景图分两半。(a)对比有/无技能的智能体行为:无技能时智能体靠试错选方法、反复实验、误判假设、在死胡同里耗尽预算;有AREX-Skill时按技能指引走正确流程,早跑检查、快速失败并恢复、及时跳过无效路线。(b)展示最终技术栈:1000个ML仓库经蒸馏得到5000+技能(20领域、178能力族)构成AREX-Skill库,DisCo智能体以creator模式产技能、researcher模式用技能,右侧列出四个基准的提升幅度:MLE-bench 31.11→72.89(+134.30%)、PaperBench 29.45→39.59(+34.43%)、FrontierCS 70.63→77.14(+9.22%)、PassNet 1.343→1.531(+14.02%)。
这是论文的电梯演讲:一张图同时交代了问题(试错浪费预算)、方案(技能作为缺失的操作层)和全部核心结果,读完全文后回头看此图可以校验自己是否抓住了主线。