通过点轨迹预测学习4D世界 Learning the 4D World through Point Trajectory Forecasting
VPM多视角世界模型联合预测未来视频与持久3D点轨迹,点监督同时提升视频保真度与机器人操作成功率
前置知识
世界模型(World Model)
学习从过去观测预测场景未来演变的生成模型,通常以视频扩散或流模型实现。理想的世界模型不仅要画面逼真,还要符合物理与三维一致性,是机器人「在脑中推演」、策略评估与数据引擎的基础设施。本文的世界模型以多视角视频历史和语言指令为条件,同时预测未来视频与三维点运动。
整篇论文的载体就是世界模型:读懂动机(视觉逼真不等于3D一致)和方法(在生成器上加轨迹监督)都需要先理解视频世界模型的训练与推理范式。
持久3D点轨迹(Persistent 3D Point Trajectories)
从场景表面选取若干查询点后,其在整段时间序列中的3D位置构成的轨迹,且同一条轨迹在所有相机视角中追踪的是同一个物理点,在固定参考系下表达。它与逐帧几何监督(深度图、pointmap)的本质区别在于携带跨帧、跨视角的点身份,能显式约束每个表面点的运动路径。
这是本文的核心监督信号和卖点:作者声称增益正来自「时间身份」而非单纯几何信息,理解这一点才能看懂方法设计与关键消融(Table 22)。
校正流匹配(Rectified Flow Matching)
一种生成建模训练目标:把干净数据 $x_0$ 与高斯噪声 $\epsilon$ 沿直线路径插值 $x_\sigma=(1-\sigma)x_0+\sigma\epsilon$,网络 $v_\theta$ 在噪声水平 $\sigma$ 下回归 $\epsilon-x_0$,推理时从纯噪声沿常微分方程去噪到数据。相比扩散模型路径更直、采样更稳定。
VPM 的视频生成损失 $\mathcal{L}_{\mathrm{FM}}$ 和动作损失 $\mathcal{L}_{\mathrm{act}}$ 都建立在流匹配上,动作 token 也是以独立噪声水平插入同一去噪骨干联合训练的,不懂流匹配就看不懂公式 (1) 和 (8)。
Plücker 射线与相机条件化
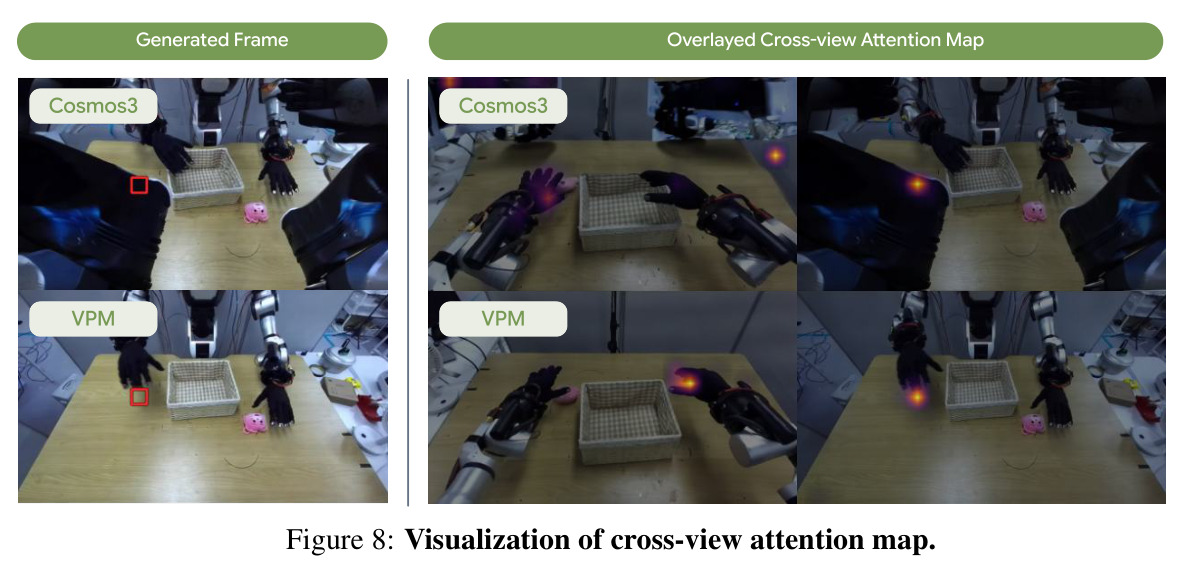
Plücker 坐标用六维量 $r_i=(d_i,\, o_i\times d_i)$ 参数化一条射线(单位方向 $d_i$ 与原点叉积矩)。给定相机内外参即可为图像每个区域计算射线,从而把相机几何注入网络。本文为每个视频 token 计算射线并编码为 $e_i=\phi(r_i)$,一方面加性注入特征 $h_i\leftarrow h_i+W e_i$,另一方面对注意力的 query/key 做相机相关的旋转 $R(\psi(e_i))$。
这是 VPM 实现任意视角生成与跨相机信息融合的关键机制之一,消融显示去掉后仿真通用场景 FVD 从 81.92 恶化到 140.06。
旋转位置编码与4D RoPE
RoPE 用与位置相关的旋转相位作用于注意力 query/key,使注意力天然感知相对位置。视频模型常用 3D RoPE(时间、高、宽),但不同相机的 token 可能共享相同的时空坐标。本文加入第四个轴:视角 $p_{view,i}=v$,相位变为 $\theta_{i,k}=p_{t,i}\omega^t_k+p_{h,i}\omega^h_k+p_{w,i}\omega^w_k+p_{view,i}\omega^{view}_k$,其中视角频率可学习且初始化为零(等价于原3D RoPE)。
多视角 token 打包进同一序列是本文架构前提,视角轴是区分相机流的最小改动方案,是读懂 3.3 节和相机条件消融(Table 28)的基础。
评测指标:FVD / cross-view MEt3R / δ3Davg
FVD 用 I3D 特征度量生成视频与真实视频的分布距离(越低越好);PSNR 是像素级保真度。MEt3R 原本衡量两张图像的3D一致性,本文提出 cross-view 版本:对每个生成视角对计算 MEt3R 后减去真值视频的对应值,度量生成视频相对真值的一致性偏差(越低越好)。δ3Davg 用 MVTracker 配合 MoGe-2 深度从生成视频提取3D点轨迹,与真值轨迹比较,统计落入深度自适应阈值集合 $D=\{1,2,4,8,16\}$ 像素换算的3D距离内的比例(越高越好)。
论文所有实验表都围绕这四个指标展开,且这些指标都不是完美指标(作者明确给出了上限/下限的估计方式),理解它们才能正确解读表格。
研究动机
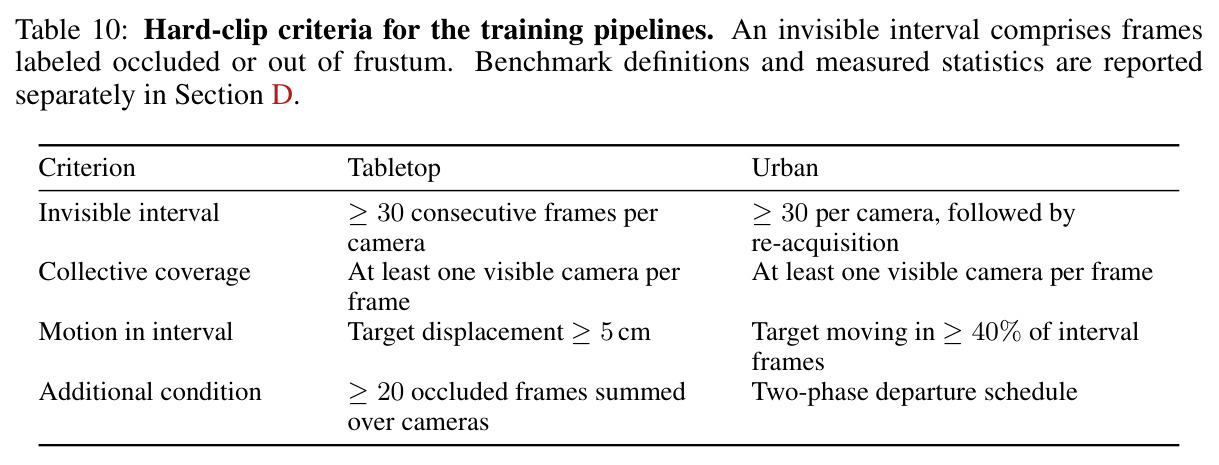
现有视频世界模型以「预测未来像素、画面看起来可信」为目标,但视觉上的合理性并不能保证预测描述了一致的三维运动:物体在不同视角下的位置和运动可能互相矛盾,遮挡区域的动态更容易被凭空幻觉。在机器人场景里这直接致命——策略依据的预测与真实3D世界脱节。已有的几何感知方案各有缺陷:用2D点跟踪或光流做辅助监督(如 VideoJAM)不携带度量3D信息;预测 RGB-D 或 pointmap(如 X-WAM、Geometry-aware 4D)是逐帧目标,同一像素在相邻帧之间没有身份关联;SV4D 类方法只合成已观测视频的新视角而非预测未来;最接近的 MVTrack4Gen 用多视角2D跟踪监督新视角生成,但既不能预测观测帧之外的对应关系,也未把监督提升到度量3D。评测侧同样空白:缺乏同时考察未来外观质量与3D运动准确度、且覆盖模拟与真实的多视角预测基准,硬遮挡场景(相机轮流丢失目标)更无从考察。
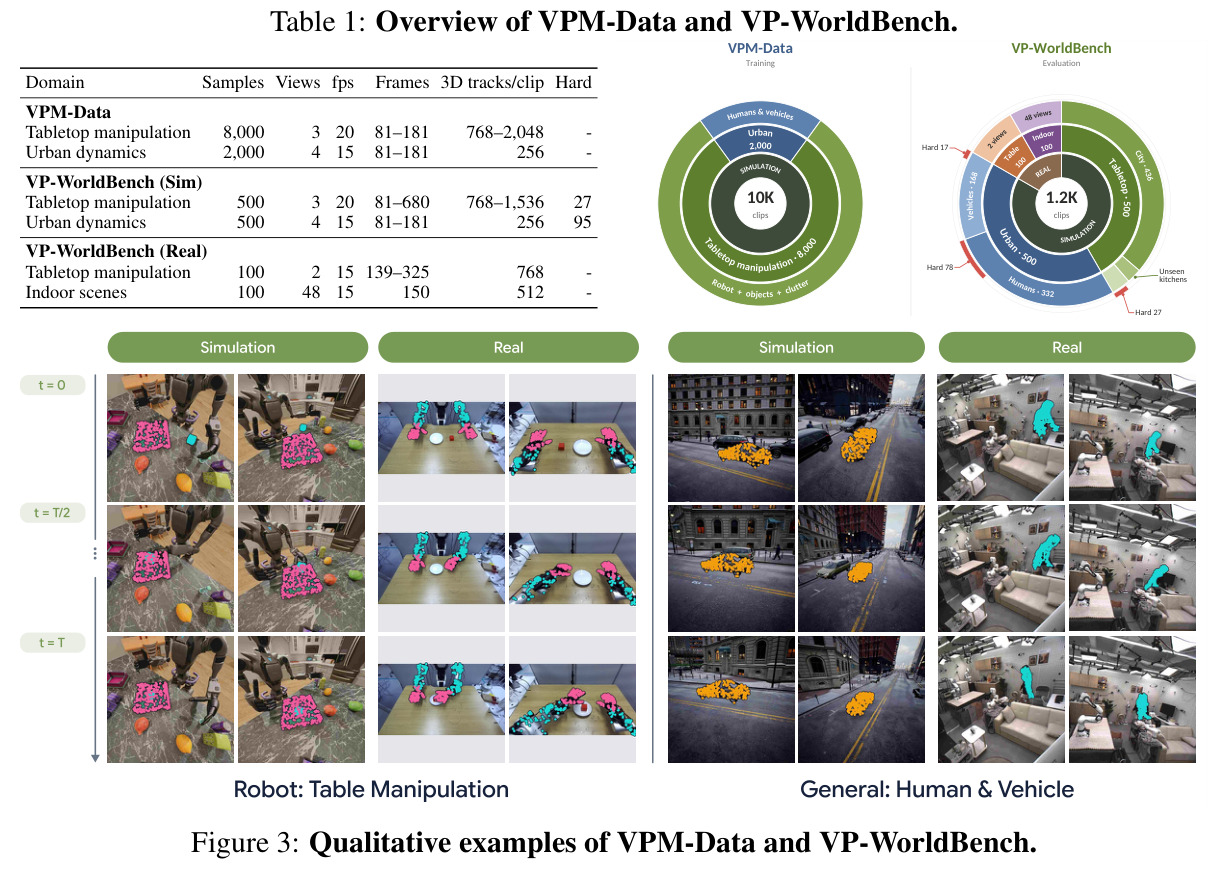
本文的目标是本文要构建一个多视角视频-点世界模型 VPM:给定带位姿的多视角视频历史、目标视角的相机参数与语言指令,从任意视角预测未来视频,同时预测从观测帧中选出的若干查询点在未来的持久3D轨迹(在固定参考系下、跨所有视角共享同一点身份)。核心科学问题是验证一个假设:让模型学习「场景点将来会移动到哪里」,能否反过来提升视频预测的保真度与3D一致性。文章还要补齐两块基础设施——配对的视觉+几何训练语料 VPM-Data,以及跨模拟与真实环境的评测套件 VP-WorldBench;并把同样的表征延伸到机器人控制,检验点监督对动作学习的迁移收益。
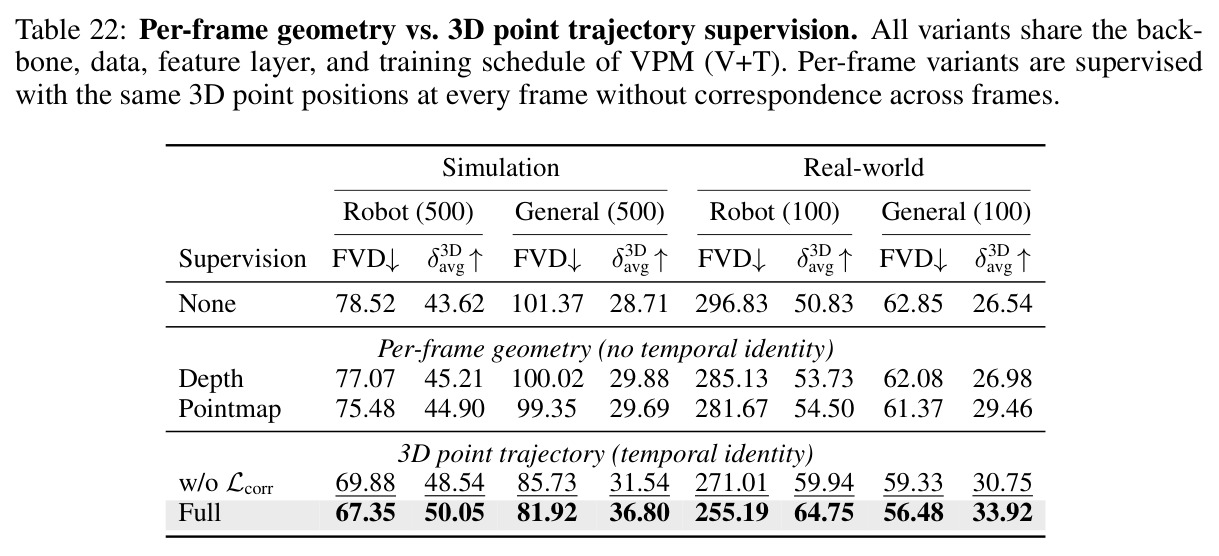
与已有工作不同的是,本文的独特切入是把「跟踪」改写成「预测」,并让几何监督直接落在视频生成器的内部表征上。传统点跟踪在已观测帧内建立对应,本文要求模型在没有未来帧的条件下预测未来对应关系,这迫使模型形成对场景动力学的前瞻理解。监督形式上,每条轨迹在所有相机中追踪同一物理点,把每个视角的表观变化锚定到一份共享的3D运动描述上,这与逐帧几何目标(深度/pointmap)有本质区别——Table 22 证明逐帧深度/pointmap只能恢复轨迹监督19%/28%的FVD增益,说明增益来自时间身份而非几何本身。此外,轨迹头读取的是生成器第18层自注意力的 Q/K 特征,配合直接监督注意力图的对应分类损失 $\mathcal{L}_{corr}$,让几何学习信号真正塑造「用来生成视频的那些特征」,而不是挂在外面的独立模块。
核心方法
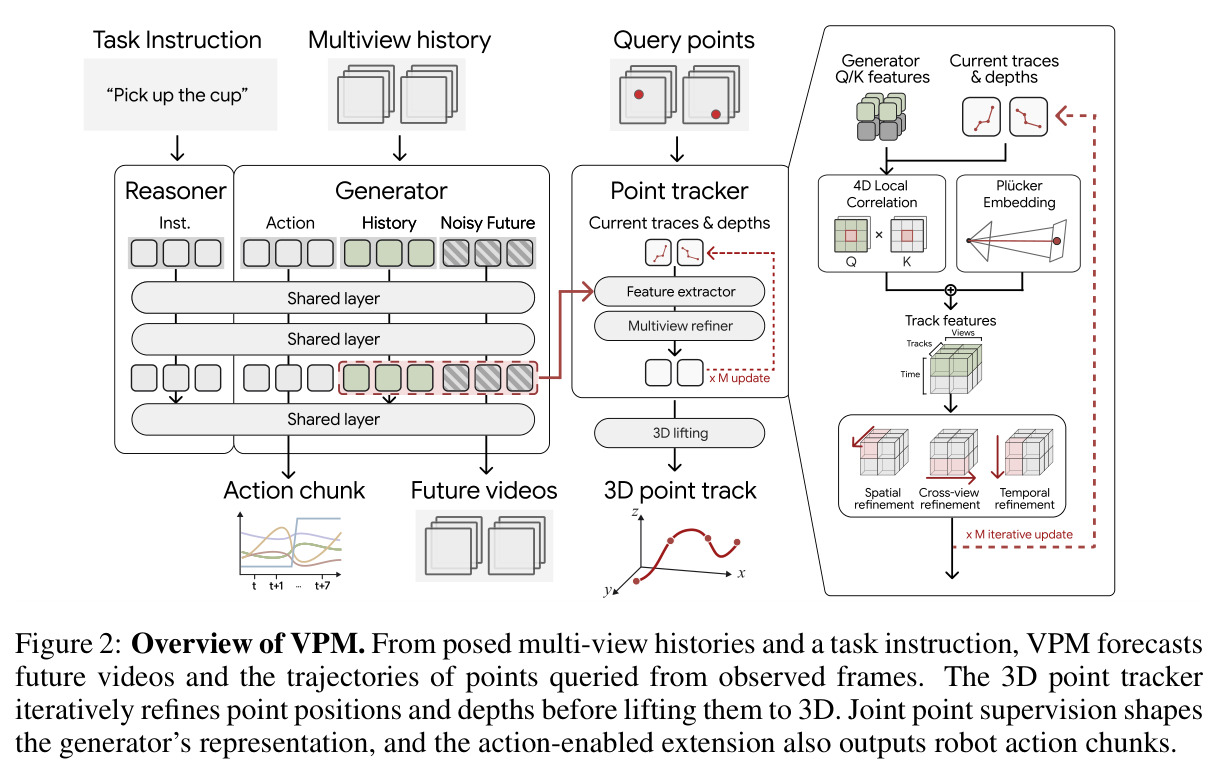
直觉上,如果视频生成器的内部表征已经「知道」每个表面点未来会移向哪里,它生成的未来帧在时间与视角之间自然保持3D一致,因为画面必须服从一份共同的点运动剧本。技术上,VPM 以 Cosmos3-Nano 为骨干(Mixture-of-Transformers:reasoner 处理指令,generator 用校正流匹配生成,二者联合注意力交互)。为融合多相机,VPM 把所有相机的 latent token 打包进一个共享序列:用 Plücker 射线嵌入编码相机几何(加性注入 $h_i\leftarrow h_i+We_i$,并对注意力 query/key 做相机相关旋转 $q_i\leftarrow R(\psi(e_i))q_i$),在 RoPE 中加入可学习的第四视角轴区分相机流。轨迹头从生成器中间层的注意力特征出发,以相关度匹配加 $M=4$ 次迭代精化,预测每视角每帧的2D位置、深度与置信度,再经 $\hat{P}_v^{\tau,n}=R_v^\tau\,\hat{d}_v^{\tau,n}(K_v)^{-1}\hat{u}_v^{\tau,n}+b_v^\tau$ 反投影到固定参考系。训练分三阶段,最终联合优化 $\mathcal{L}_{forecast}=\mathcal{L}_{FM}+\lambda_{track}\mathcal{L}_{track}+\lambda_{corr}\mathcal{L}_{corr}$。
核心创新点是把「持久点身份」当作跨视角、跨时间的共同运动语言,并把它的监督直接焊进视频生成器的表征。与已有工作的本质区别有四层:其一,监督目标不是逐帧几何而是带身份的轨迹——Table 22 显示,同样的3D位置信息若不给跨帧对应(逐帧深度/pointmap),只能恢复完整轨迹监督一小部分增益(逐帧深度恢复约19%、pointmap约28%的FVD改进),说明跨帧身份约束才是关键;其二,轨迹头读取生成器第18层自注意力的 Q/K 特征,几何监督因此直接塑造后续用于生成视频的表征,而非对齐某个外挂特征空间;其三,$\mathcal{L}_{corr}$ 把跨视角-跨时间对应建模为对目标帧空间 cell 的分类问题,直接最大化注意力图上正确对应的权重,从特征源头鼓励「同一物理点在不同视角/时刻被关联起来」;其四,训练时轨迹是从部分去噪的中间特征预测的,头学会的是「从模型的预测性特征中推断运动」,推理时无需未来帧。动作扩展则让动作 token 共享这个被点监督塑造过的骨干,表征红利直接迁移到控制。
方法步骤详情
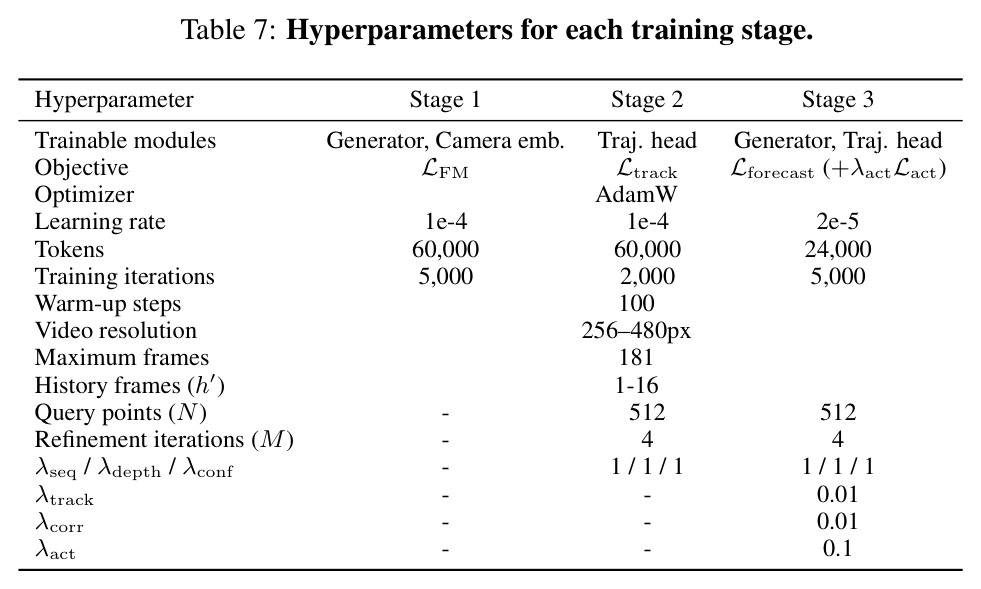
输入为带位姿的观测历史 $\{O_v^{t-h'+1:t}\}$、各相机内外参、语言指令 $\ell$ 与从历史帧选出的 $N$ 个查询点 $(t_n,v_n,u_n)$;输出未来 $h$ 帧任意视角视频与各点的3D轨迹(固定参考系取首个观测时刻)。步骤一,多视角打包:各相机 latent token 按共享时间网格进入同一序列,每 token 计算射线嵌入 $e_i=\phi(r_i),\, r_i=(d_i,\,o_i\times d_i)$,做加性注入与 Q/K 旋转,4D RoPE 相位为 $\theta_{i,k}=p_t\omega^t_k+p_h\omega^h_k+p_w\omega^w_k+p_{view}\omega^{view}_k$。步骤二,轨迹头:在第18层自注意力取 Q/K 特征按视角排成网格,对查询点在每视角每时刻与当前估计邻域做相关匹配,经空间-时间-视角三路分解注意力的 transformer 迭代精化 $M=4$ 次,输出 $\hat{u},\hat{d},\hat{c}$ 并按公式 (4) 反投影成3D。步骤三,三阶段训练(共12K迭代、32块GH200、512查询点/clip):Stage 1 只用 $\mathcal{L}_{FM}$ 训 generator 与相机嵌入(lr $10^{-4}$,5K迭代);Stage 2 冻结其余,只训轨迹头与视角频率(2K迭代),用 $\mathcal{L}_{track}=\lambda_{seq}\mathcal{L}_{seq}+\lambda_{depth}\mathcal{L}_{depth}+\lambda_{conf}\mathcal{L}_{conf}$(截断 Huber 用于2D位置与帧间位移、log 深度,BCE 用于置信度);Stage 3 联合优化 $\mathcal{L}_{forecast}$(lr $2\times10^{-5}$),动作版加 $\lambda_{act}\mathcal{L}_{act}$。步骤四,动作扩展与推理:9维统一动作块作为额外 token 模态,按 $a^{\sigma_a}=(1-\sigma_a)a^0+\sigma_a\epsilon_a$ 加噪并与视频联合去噪;推理从 $\sigma=1$ 到 0,历史 token 保持干净,轨迹从头部的骨干特征解码后变换到参考系。
技术新颖性
与几何/运动感知视频预测的已有路线逐一对比:VideoJAM 类方法用光流辅助监督,是2D逐帧量;VideoREPA 类做表征对齐,对齐目标来自基础模型而非显式3D点运动;Geometry-aware 4D 预测 RGB+pointmap,逐帧且无身份;X-WAM 在多视角 RGB-D 上加动作,但监督仍是逐帧深度;GEM-4D、MECo-WAM、4D-WAM 把几何场或轨迹场蒸馏进表征,属于间接的场级监督。最接近的 MVTrack4Gen 用多视角2D跟踪监督新视角合成,但受限于已观测帧内的2D对应。本文的差异化组合是:预测超出观测帧的未来对应(forecasting 而非 tracking)、把监督从2D提升为固定参考系下的度量3D、同一点身份跨所有视角共享、监督直接作用于生成器注意力特征、并以同一骨干服务动作学习。配套上,VPM-Data 提供可见性控制与硬遮挡子集的配对数据,VP-WorldBench 首次把外观与几何预测放在同一协议下联合评测(并提出 cross-view MEt3R 这一多视角一致性度量修正),这套「模型+数据+基准+动作扩展」的完整闭环在4D世界模型文献中是新的。
实验结果
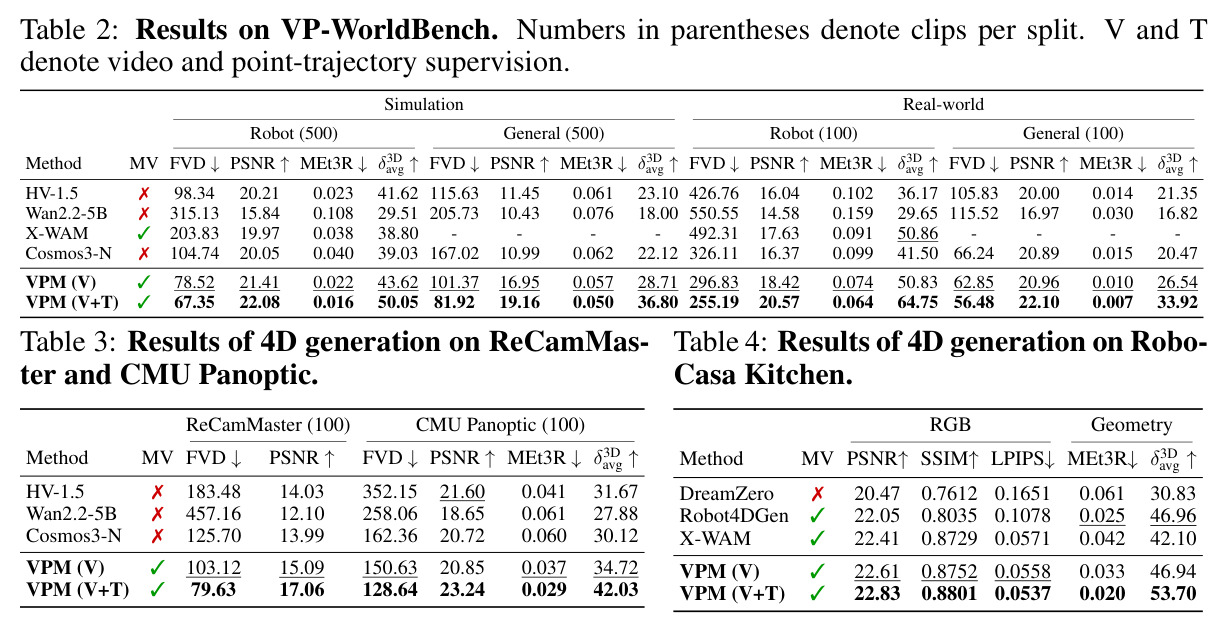
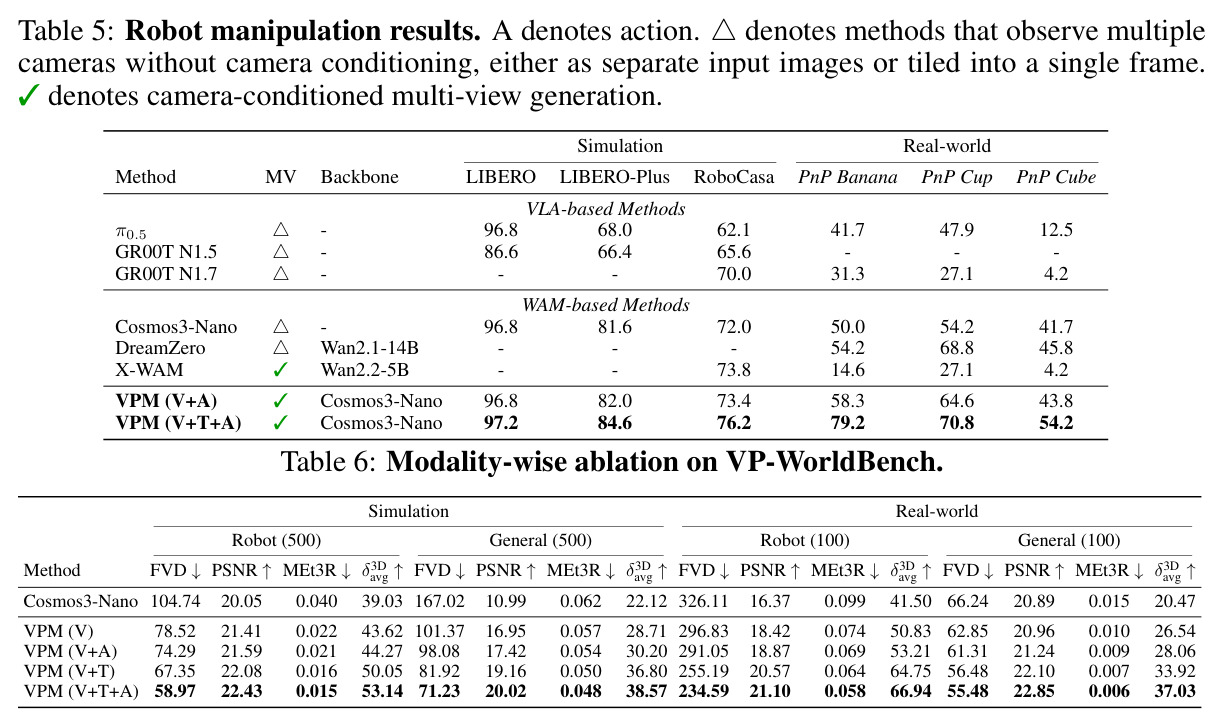
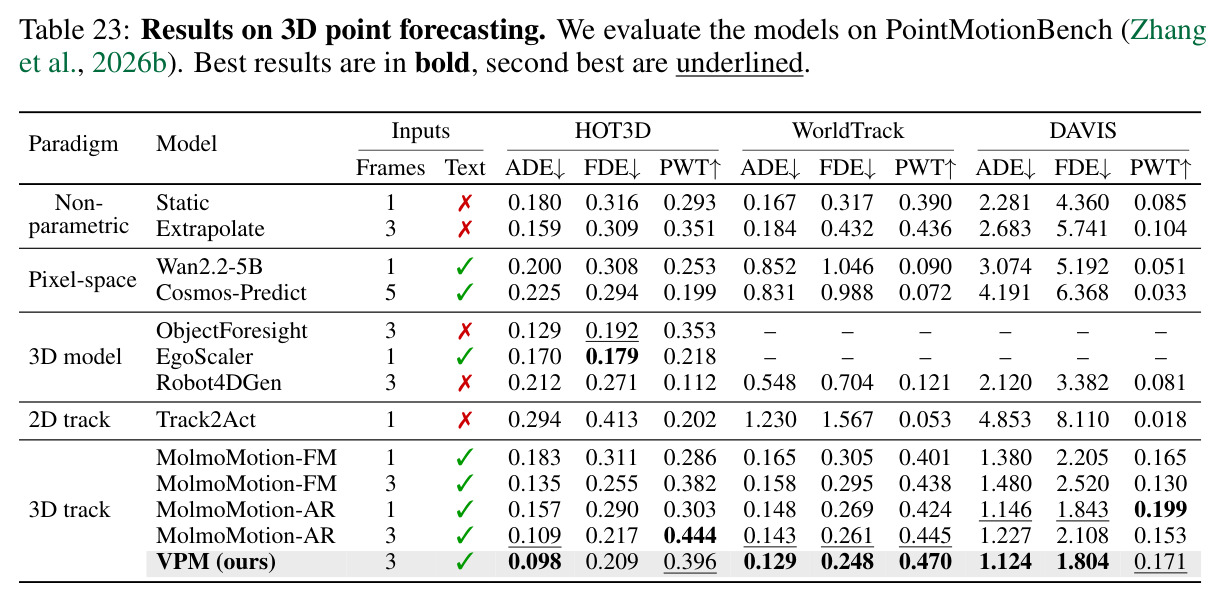
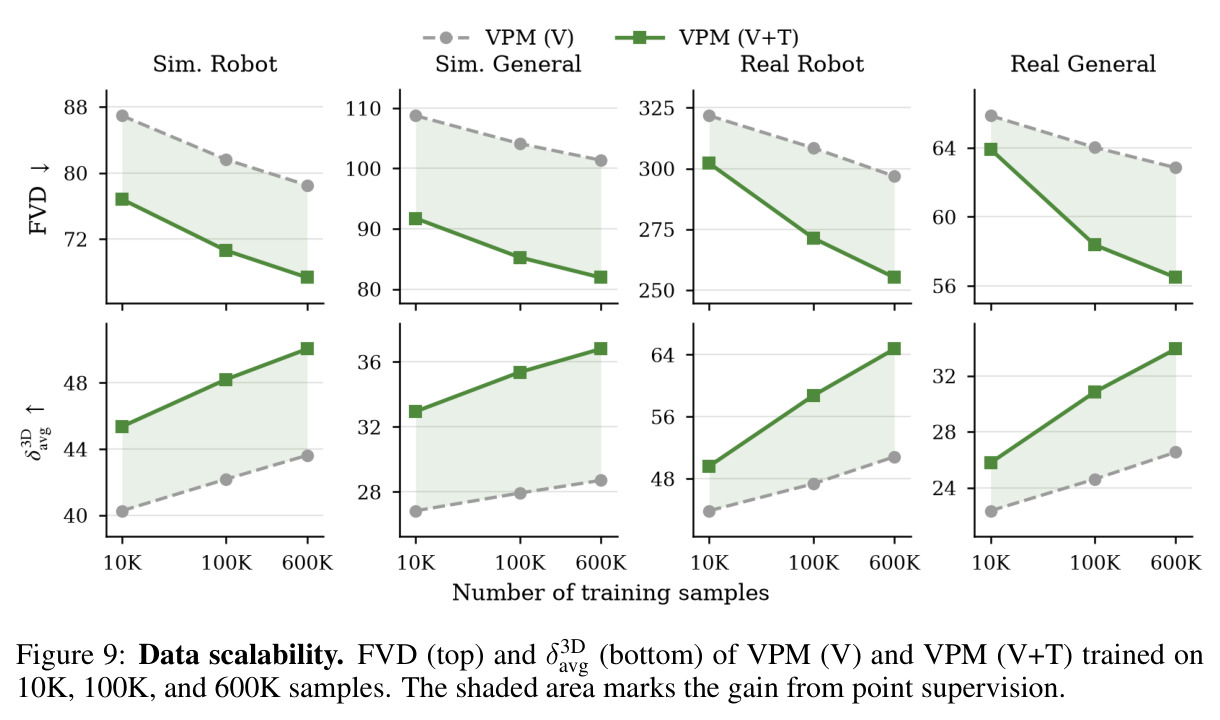
(1)VP-WorldBench 主结果(Table 2,I2V 全视角、不给未来相机参数):VPM(V+T) 在全部 4 个 split 全指标最优,仿真机器人 FVD 67.35 / PSNR 22.08 / MEt3R 0.016 / δ3Davg 50.05,远超 Cosmos3-Nano(104.74 / 20.05 / 0.040 / 39.03);真实机器人 δ3Davg 64.75(管线上限 80.40)。同预算对照 VPM(V)(78.52 / 43.62)干净地证明增益来自轨迹监督本身。(2)零样本4D生成:ReCamMaster FVD 103.12→79.63(PSNR 15.09→17.06),CMU Panoptic δ3Davg 34.72→42.03;RoboCasa Kitchen 上 VPM(V) 的 MEt3R 0.033 落后 Robot4DGen(0.025),加轨迹后反超至 0.020、δ3Davg 53.70 对 46.96,说明点监督是3D一致性的来源。(3)机器人操作(Table 5):VPM(V+T+A) 在 LIBERO 97.2 / LIBERO-Plus 84.6 / RoboCasa 76.2 全部最佳,超过 π0.5 与 Cosmos3-Nano;仅用 89K DROID 轨迹训练,真实三个抓放任务成功率 79.2 / 70.8 / 54.2,对无轨迹版 VPM(V+A)(58.3 / 64.6 / 43.8)banana 提升 20.9 个百分点。(4)模态消融(Table 6):轨迹贡献最大增益(仿真机器人 FVD 78.52→67.35、δ3Davg 43.62→50.05),动作次之,V+T+A 最优(58.97 / 53.14)。(5)PointMotionBench(Table 23):HOT3D ADE 0.098 最低、WorldTrack 三项全最佳。(6)数据扩展(Figure 9):VPM(V+T) 用 100K 样本即超过 VPM(V) 全量 600K(FVD 70.61 对 78.52);单视角评测 PAIBench-G Overall 83.0 亦为最佳。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VP-WorldBench 仿真机器人多视角预测(500 clips,I2V 全视角) | FVD ↓ | 67.35(VPM V+T) | Cosmos3-Nano 104.74;同预算视频版 VPM(V) 78.52 | 较骨干降 35.7%;同预算轨迹监督再降 14.2% |
| VP-WorldBench 仿真机器人,几何一致性 | δ3Davg ↑ | 50.05 | Cosmos3-Nano 39.03;VPM(V) 43.62 | +10.99 / +6.43 |
| VP-WorldBench 真实机器人多视角预测(100 clips) | δ3Davg ↑ | 64.75(上限 80.40) | Cosmos3-Nano 41.50;VPM(V) 50.83 | +23.25 / +13.92 |
| 零样本4D生成 ReCamMaster(100 clips) | FVD ↓ | 79.63(PSNR 17.06) | VPM(V) 103.12;HunyuanVideo-1.5 183.48 | -23.49(相对 VPM(V)) |
| 零样本4D生成 CMU Panoptic(100 clips) | δ3Davg ↑ | 42.03(MEt3R 0.029) | VPM(V) 34.72;Cosmos3-Nano 30.12 | +7.31 |
| RoboCasa Kitchen 4D生成 | δ3Davg ↑ / MEt3R ↓ | 53.70 / 0.020 | Robot4DGen 46.96 / 0.025;X-WAM 42.10 / 0.042 | 反超原领先的 Robot4DGen |
| 仿真机器人操作(LIBERO / LIBERO-Plus / RoboCasa) | 成功率 % | 97.2 / 84.6 / 76.2(VPM V+T+A) | Cosmos3-Nano 96.8 / 81.6 / 72.0;π0.5 96.8 / 68.0 / 62.1 | LIBERO-Plus +3.0,RoboCasa +4.2 |
| 真实机器人抓放(banana / cup / cube,各24次,仅89K DROID训练) | 成功率 % | 79.2 / 70.8 / 54.2(VPM V+T+A) | VPM(V+A) 58.3 / 64.6 / 43.8;Cosmos3-Nano 50.0 / 54.2 / 41.7;π0.5 41.7 / 47.9 / 12.5 | banana +20.9(对无轨迹版) |
| 3D点运动预测 PointMotionBench(HOT3D / WorldTrack / DAVIS) | ADE ↓ | 0.098 / 0.129 / 1.124(WorldTrack 三项全最佳) | MolmoMotion-AR(3帧) 0.109 / 0.143 / 1.227 | 三个数据集 ADE 全部最低 |
局限与改进
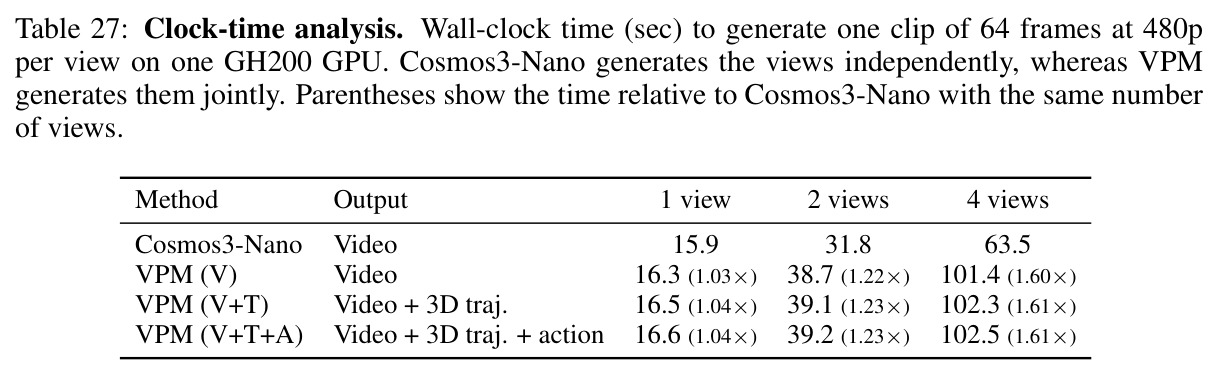
作者承认:点监督只覆盖机器人与已标注物体而非全场景;骨架式标注不含布料、头发等独立非刚性运动;推理需已知相机内外参;所有相机流共享一个 token 序列,代价随视角数增长(4 视角生成一 clip 102.5s,为逐视角 Cosmos3-Nano 的 1.61 倍)。我的补充观察:其一,600K 训练数据中真正配对的多视角模拟数据只有 10K,机器人轨迹来自 CAD+正运动学管线(CAD-图像召回≥0.9 过滤),通用场景轨迹来自 MolmoMotion/Ego-Exo4D 伪标签,监督质量在不同域不一致;其二,FVD/PSNR 在仿真域是对重渲染真值计算的,可能偏乐观,真实通用基准仅 100 段 10 秒序列,统计功效有限;其三,动作扩展只在桌面抓放与标准仿真套件验证,9 维统一动作空间对灵巧手等高自由度末端是否成立未验证;其四,δ3Davg 依赖 MVTracker+MoGe-2 估计管线,估计器偏差同时作用于所有方法,跨方法比较公平但绝对数值需谨慎;其五,轨迹头每次只预测单一 clip 的查询点,长时程滚动预测的误差累积未被量化。
独立分析的弱点
独立分析的弱点与改进方向。(1)对标定相机的强依赖:推理需已知内参位姿,Plücker 嵌入以固定参考系表达,无法直接用于互联网视频或手持拍摄——可引入可微位姿估计或改用相对/自监督相机表示。(2)监督稀疏且偏刚性:每物体 256 点、每 clip 仅采 512 查询点,布料、绳索、流体等稠密非刚性内容完全缺失——可用场景流场、4D 高斯或稠密跟踪基础模型的伪标签做分层加权监督。(3)架构扩展性:所有视角共享一个 token 序列,48 相机级采集不可行,且 4 视角耗时已是 1.61 倍——可探索跨视角注意力稀疏化(按视角分组+层次融合)或视角间只交换轨迹级摘要。(4)评测指标不完美:FVD 基于 I3D 特征,与3D一致性的相关性存疑,两个真实 split 各仅 100 段,建议补充面向任务的下游指标(策略成功率、可行动性)作金标准。(5)组件贡献未完全解耦:轨迹头、$\mathcal{L}_{corr}$ 与动作头三者在真实机器人上的单独消融缺失,工业复现时难以判断哪个组件值得优先投入——应公开各组件在真实任务上的分项结果。
未来方向
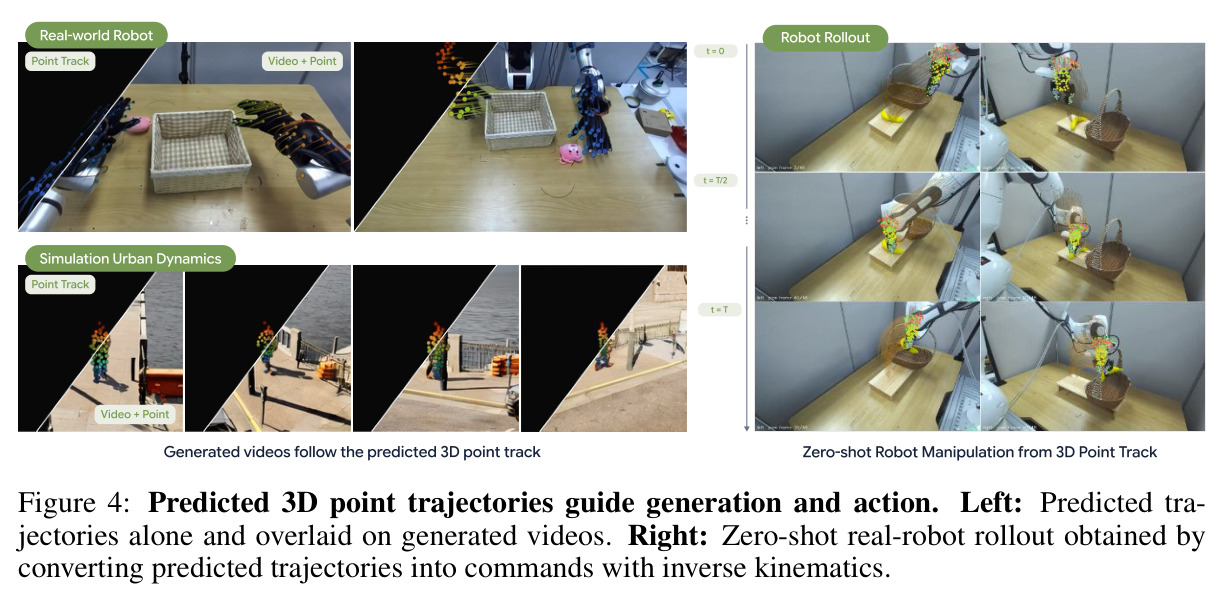
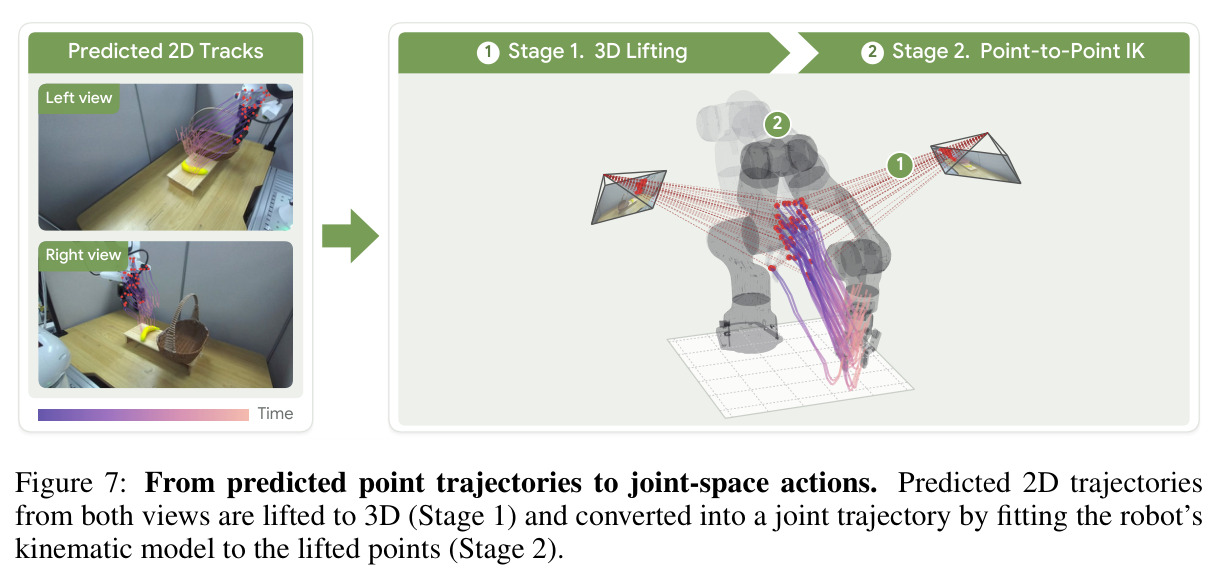
作者明确提出:从真实多视角视频大规模导出轨迹监督(替代昂贵的模拟渲染)、扩展到更稠密更非刚性的内容、放松对标定相机的依赖。基于其成果可以延伸的方向:其一,「轨迹即策略」——论文已演示把预测轨迹经逆运动学零样本转成机器人命令(Figure 7 的两阶段流程:3D 提升后做 point-to-point IK),可发展为以3D轨迹为中间规划表示的机器人框架,把语言指令先落地为点轨迹再优化执行,并与 VLA 的语义规划互补;其二,数据引擎闭环——用 VPM 生成带几何标注的多视角想象数据反哺策略训练,尤其是硬遮挡场景,可量化生成数据对真实成功率的影响;其三,把 $\mathcal{L}_{corr}$ 的对应监督推广为与跟踪/深度基础模型的表征对齐(REPA 风格),降低对真值轨迹的依赖;其四,将预测轨迹作为动态3D表征(4D 高斯、网格形变场)的初始化,打通视频预测与可编辑3D重建;其五,在线世界模型与测试时扩展——滚动预测时用轨迹一致性做候选重排序或拒绝采样,把点轨迹当作廉价的可验证信号。
复现评估
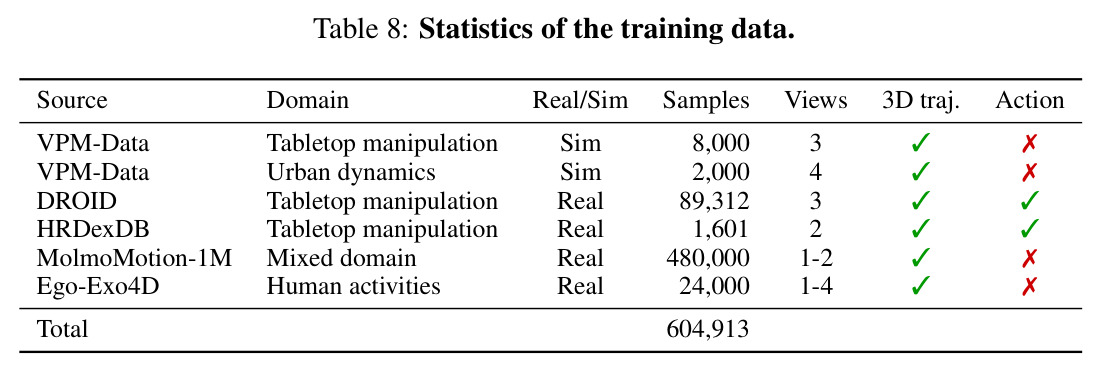
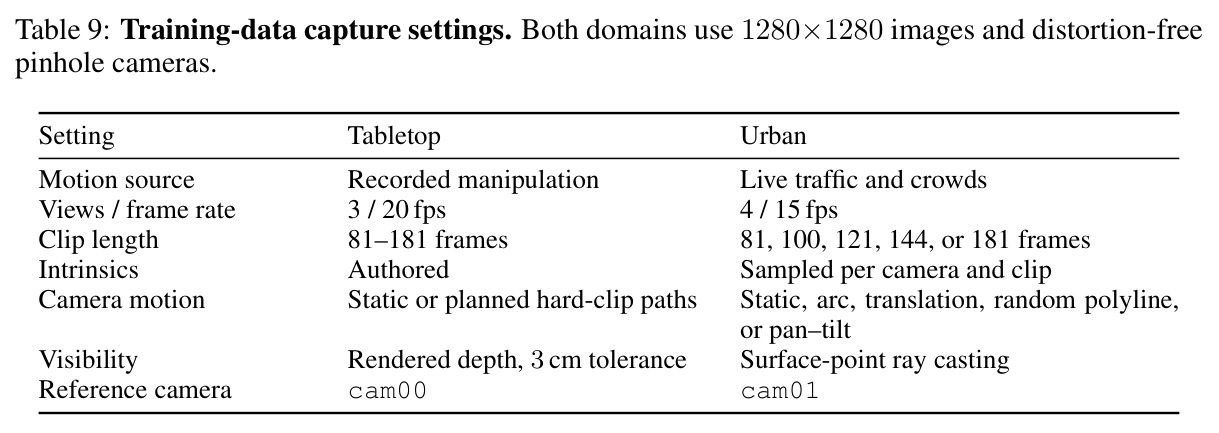
评测复现中等偏易:项目页承诺开源 VPM-Data 与 VP-WorldBench,评测协议写得细(I2V/V2V、480p、35 步去噪、classifier-free guidance、cross-view MEt3R 与 δ3Davg 的计算公式及上下限估计),依赖的 MVTracker、MoGe-2、MEt3R 均为公开工作,固定版本即可。训练复现门槛高:骨干 Cosmos3-Nano 需可获得;全量数据 604,913 条(VPM-Data 10K + DROID 89,312 + HRDexDB 1,601 + MolmoMotion-1M 480K + Ego-Exo4D 24K),机器人3D轨迹需 CAD 模型、标定与正运动学管线(含召回≥0.9 过滤),模拟数据需 UE5 加物理仿真与人工审核,完整重建成本大;算力上为 32 块 GH200、12K 迭代、最长 181 帧 480p,属集群级别。低成本路径是只复现轨迹头(读第18层 Q/K、$M=4$ 迭代,本身轻量)或在冻结骨干上做 Stage 2/3 小规模验证,再借官方权重做下游评测。若官方只放模型与基准而数据生成管线不开源,训练级复现的最大瓶颈将在数据而非算力。
论文图表
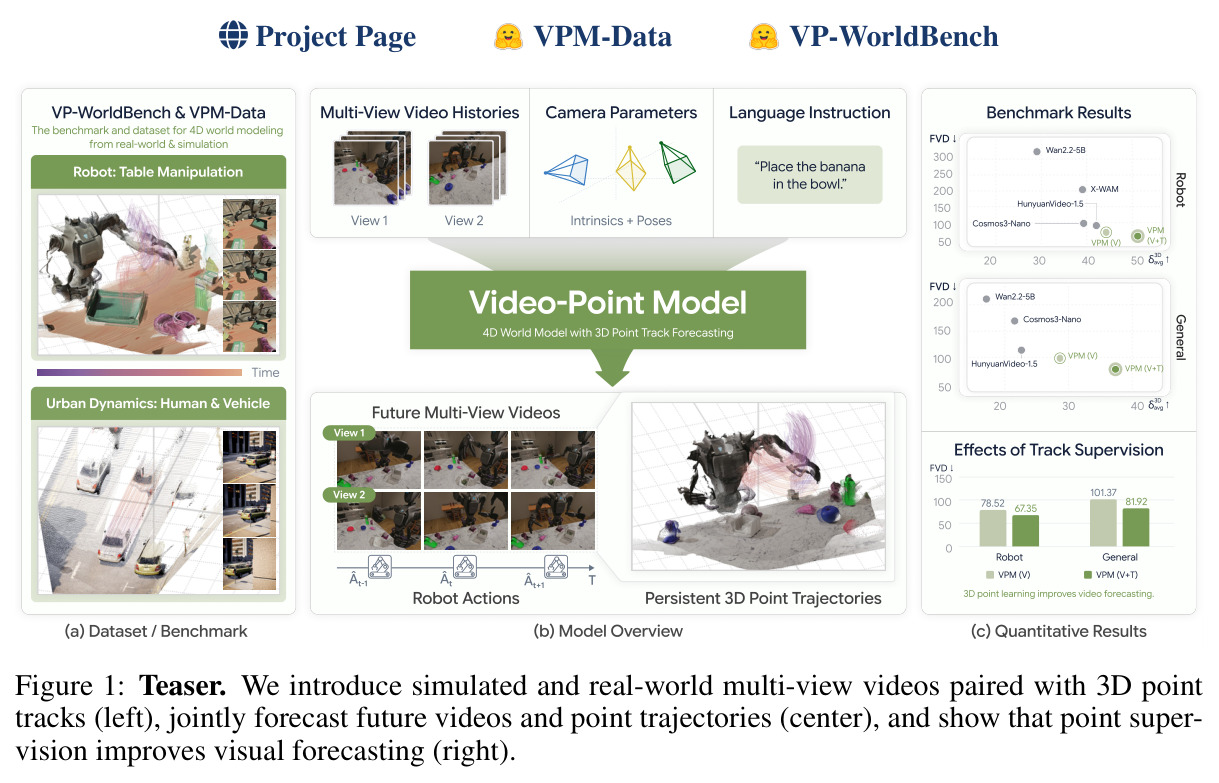
导览图分三部分:(a) 数据与基准——展示配对的模拟与真实多视角视频及3D点轨迹(桌面机械臂操作、城市人流车流),并标注 FVD-δ3Davg 权衡曲线;(b) 模型概览——多视角视频历史+相机参数+语言指令输入,输出未来多视角视频与3D点轨迹;(c) 定量结果——点监督使 FVD 与 δ3Davg 同时改善,且动作版在真实机器人任务上提升成功率。
一张图讲清论文的三件套:数据/基准、模型、结论。右侧散点图直观呈现「点监督同时改善画质与几何」这一核心主张,适合作为读者的第一印象。