WorldFlow:基于大规模预训练的视频与三维运动联合预测 WorldFlow: Joint Video and 3D Motion Prediction via Large-Scale Pretraining
统一世界模型联合生成未来视频与查询点三维流,视觉监督显著提升运动预测精度
前置知识
整流扩散Rectified Flow
一种生成建模范式:学习一个速度场,把高斯噪声沿近似直线路径输运到数据分布,训练目标是向量场回归,采样时从纯噪声出发迭代求解常微分方程。相比传统扩散模型路径更直、采样步数更少,且多个模态可以共享同一噪声水平和同一去噪骨干进行联合去噪。
WorldFlow 的视频与 3D 流正是在统一 rectified-flow 目标下联合去噪的:两种模态共享每样本噪声水平,推理用 40 步采样、guidance scale 2。理解该机制才能读懂其训练损失(式 9-10)与生成流程。
Mixture-of-Transformers (MoT)
一种多模态 Transformer 架构:不同模态(视频、流、文本等)各持有一套独立的注意力投影、MLP 与归一化权重,但在注意力层共享同一序列做全注意力交互,实现权重分离、通信共享,兼顾模态特异性的表达力与跨模态信息融合。
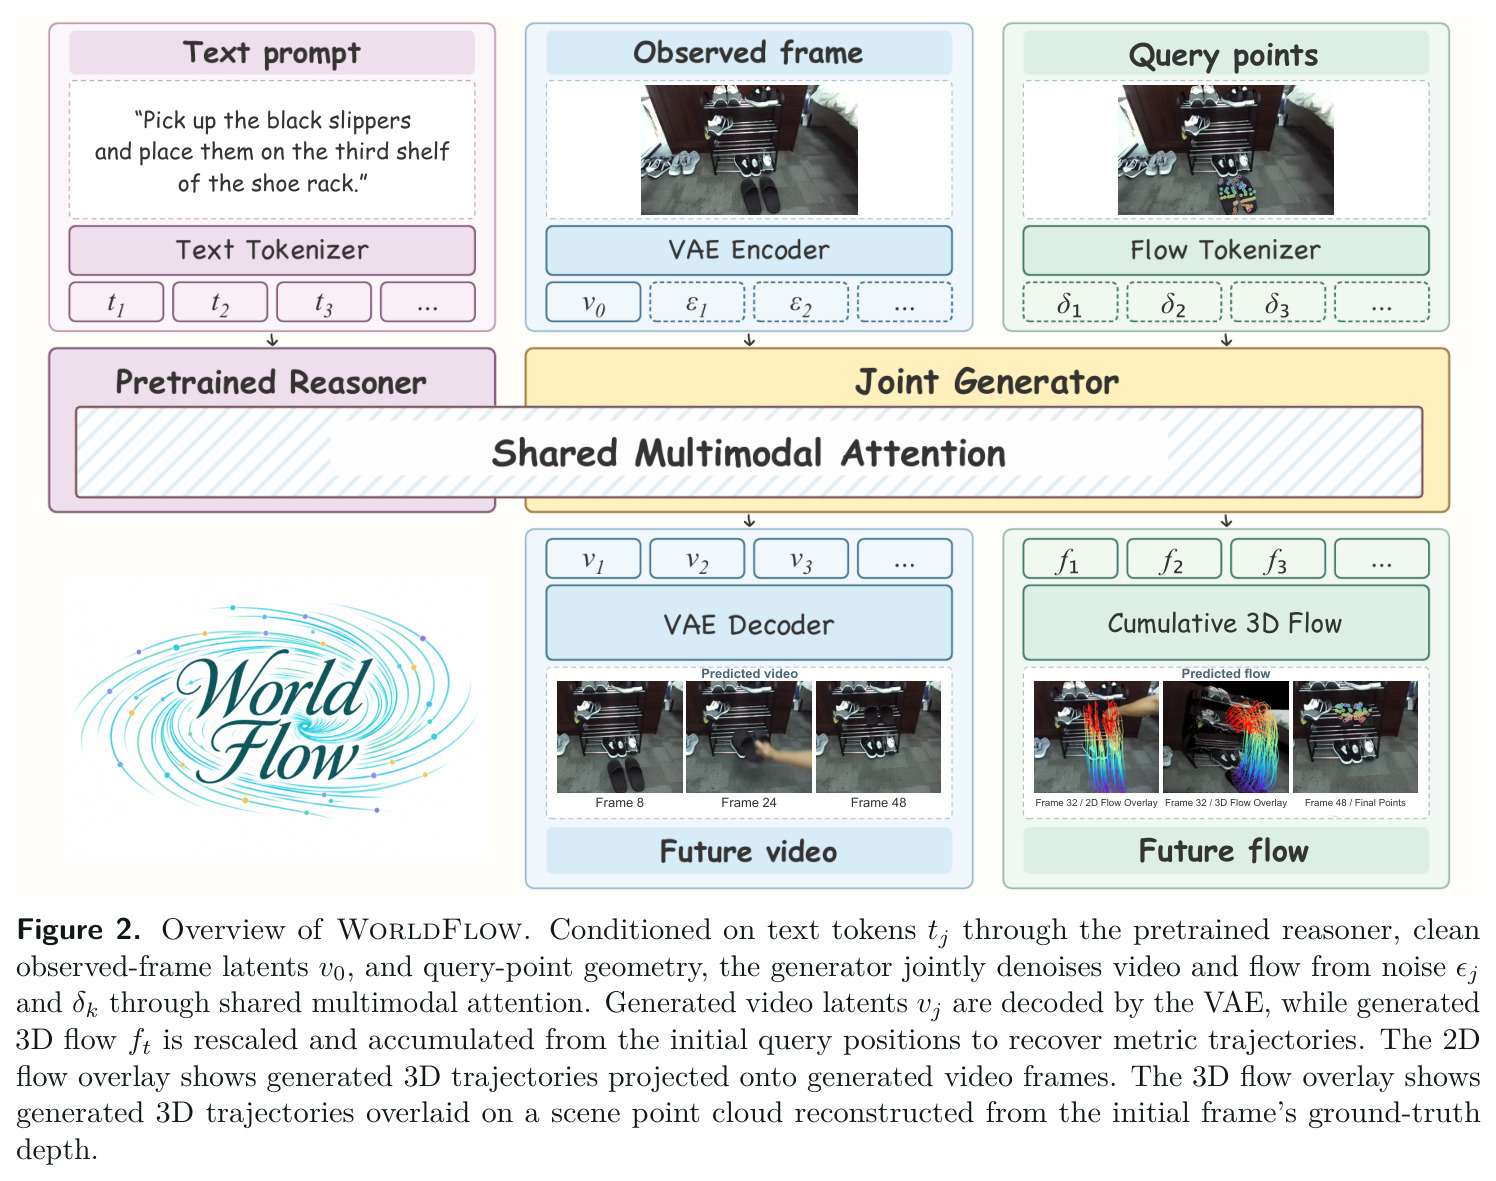
WorldFlow 的生成器采用 MoT 骨干,视频 token 与流 token 各自拥有专属权重、通过全注意力交互并共享时空位置网格,这是本文联合生成得以成立的架构基础。
3D场景流与查询条件流
场景流指三维空间中点的逐帧位移向量场。稠密场景流对每个点建模,生成式预测计算昂贵;查询条件流只对用户指定的少量 3D 查询点预测位移,把建模能力集中在任务关键区域,其余场景仅作为上下文。轨迹可由逐帧位移累加恢复:$p_{t,i}=p_{0,i}+\sum_{\tau} f_{\tau,i}$。
本文的预测对象正是查询点的逐帧位移 $f_{t,i}=p_{t,i}-p_{t-1,i}$,理解流与轨迹的换算关系是读懂问题定义(式 1-2)、评测指标与机器人实验的前提。
视频潜空间与VAE压缩
视频生成模型通常先用 VAE 把像素压缩到低维潜空间再建模。WorldFlow 的视频 VAE 时间压缩 4 倍、空间压缩 16 倍,再做 2×2 patch 化,于是 49 帧 288×480 的输入被压缩成 13×9×15 的视频 token 网格,大幅降低序列长度与算力开销。
流 token 的旋转位置编码必须与视频 token 网格对齐(式 7 中的 $q_t,q_s,p_s$),不理解 VAE 压缩系数与 patch 大小就无法理解跨模态对齐这一核心设计。
ADE/FDE/PWT轨迹指标
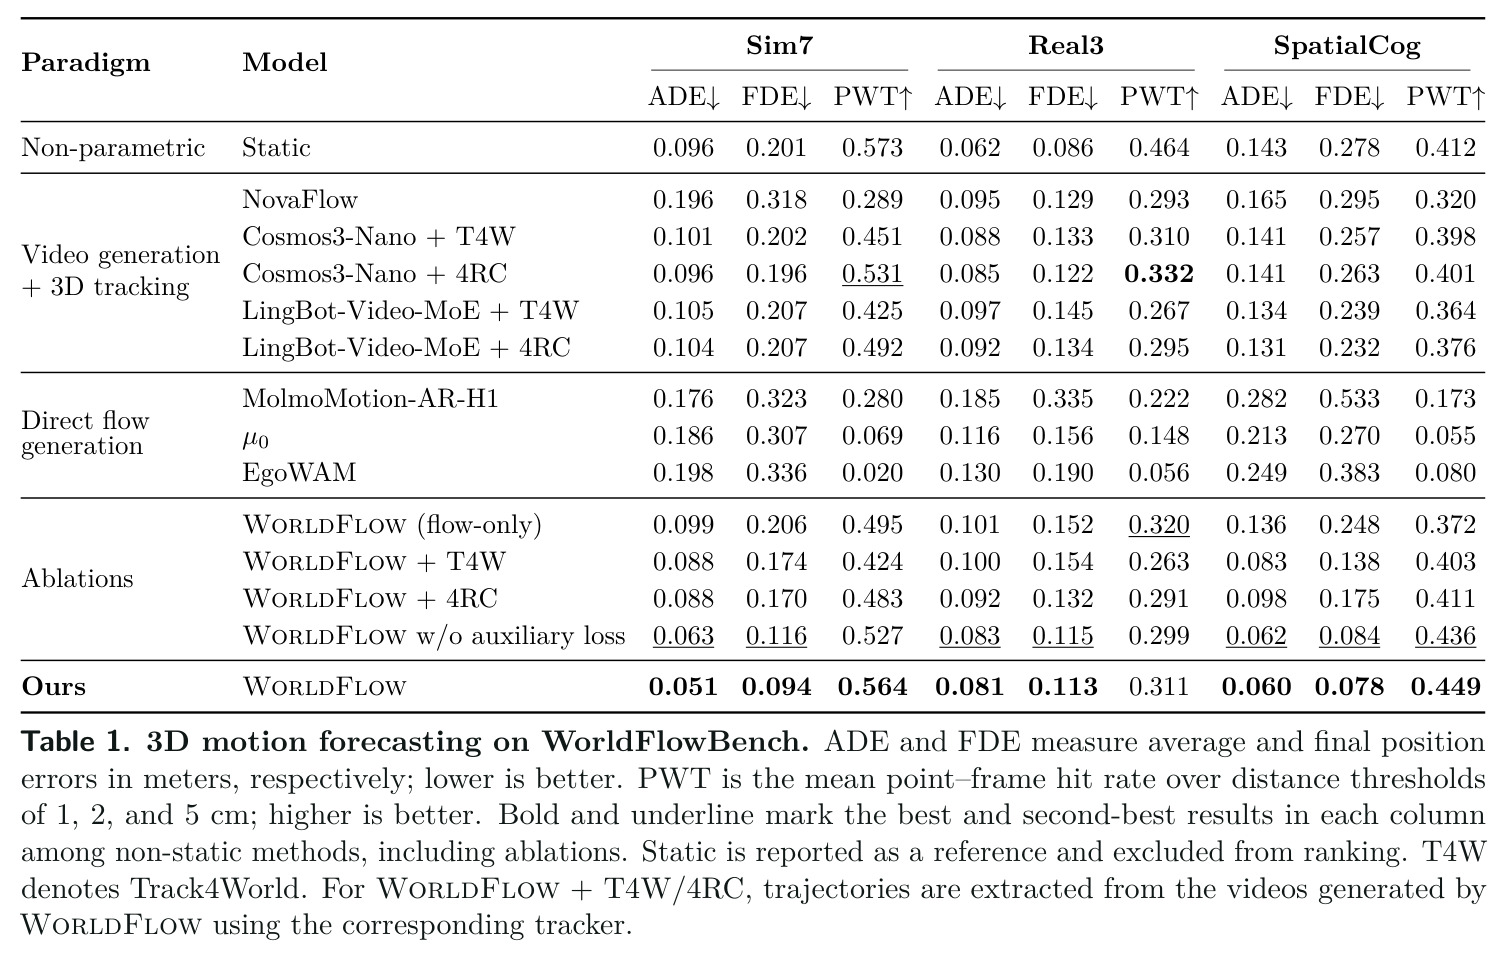
轨迹预测常用指标:ADE 是所有查询点在所有未来帧上的平均欧氏位置误差;FDE 是最后一帧的平均位置误差,两者均以米为单位、越低越好;PWT 是位置误差落在给定阈值内的点-帧比例,本文报告 1、2、5cm 三个阈值的均值,衡量细粒度轨迹精度、越高越好。
论文所有核心结论——三个评测集最低 ADE/FDE、三组消融对比、机器人实验——都建立在这三个指标上,必须先掌握才能读懂 Table 1 与 Table 2。
Classifier-Free Guidance
一种提升条件生成质量的技术:训练时以一定概率丢弃条件输入(本文文本以 0.1 概率丢弃,视觉与几何条件保留),推理时把条件预测与无条件预测做外推组合,引导输出更贴合文本指令;外推强度由 guidance scale 控制,本文取 2。
它是 WorldFlow 推理配置的关键超参,直接影响指令遵循能力与生成质量;复现实验和理解消融中的采样设置时都需要它。
研究动机
具身智能需要预知未来物理状态,但现有三类方法各有硬伤。视频世界模型(如 Wan、Seedance 等大规模视频生成器)能生成视觉上连贯的未来画面,却把三维动力学隐含在像素里,缺少可供规划与控制使用的度量几何信息。世界动作模型(WAM)把机器人动作直接纳入建模,但动作数据采集成本高昂,且动作表示绑定特定本体构型,难以跨平台迁移。另一路 3D 运动预测模型只用流监督:稠密场景流生成计算昂贵,场景级方法只能在粗空间网格上预测(如 TraceGen 的紧凑 3D 轨迹、PointWorld 的全场景流),稀疏网格把 token 浪费在任务无关区域,低分辨率还限制了精细运动边界的保真度。更关键的是,高质量 3D 轨迹标注稀缺,仅靠流这一个监督信号学习物理动力学过于单薄,跨场景、跨交互的泛化能力受限。
本文的目标是本文目标是构建一个生成式世界模型 WorldFlow:给定单帧 RGB 观测、语言指令和少量稀疏 3D 查询点,同时预测未来视频帧 $I_{1:T}$ 和这些查询点的度量 3D 轨迹,把视觉演化与显式几何运动耦合进同一个模型,让动作无关、可跨本体迁移的运动表示服务下游规划与控制。具体分三步:其一,设计能把 3D 流作为额外生成模态、与视频 token 在时空上对齐的统一架构,并用预训练视频模型权重初始化;其二,组装约 144 万(1.44M)物体级样本的异构语料(相当于 16 FPS 下 49 帧序列的 1224 小时),覆盖 Sim7 仿真、Real3 真实、自采 SpatialCog 与 MolmoMotion-1M 四大来源,统一运动表示、分域归一化并做质控;其三,提出 WorldFlowBench 基准,含 1678 个留出评测样本(Sim7 396、Real3 882、SpatialCog 400),用 ADE/FDE/PWT 与已有方法公平比较。
与已有工作不同的是,本文的独特切入是把 3D 流当作世界模型的一种原生生成模态,而不是生成视频之后的后处理。现有范式要么先生成视频再用跟踪器事后恢复运动(NovaFlow、Cosmos3+T4W、LingBot-Video-MoE+4RC 等管线),误差经生成与跟踪两级放大;要么只预测流(µ0、EgoWAM、MolmoMotion),监督信号单薄。WorldFlow 让视频与流在同一个 Mixture-of-Transformers 里联合去噪:密集的视频监督提供同一未来的另一视角,为稀疏的流监督补充物理常识;同时采用查询条件化,把流 token 只分配到任务关键位置,兼顾稠密方法的表达力与稀疏方法的效率。作者把这概括为解锁预训练视频模型中蕴含的物理常识——从 Cosmos-Nano 预训练权重起步,让几何运动成为共享生成过程的一部分。
核心方法
直觉上,物体的未来既是外观变化(视频)也是空间位置变化(几何轨迹),两者应在同一模型里同时生成、互相印证。WorldFlow 基于预训练 Cosmos-Nano 框架:保留其语言推理器处理指令,用视频 VAE 把观测帧编码为干净潜码;关键扩展是给生成器新增流 token 这一生成模态——每个查询点每帧的归一化位移 $\bar{f}_{t,i}=f_{t,i}/a_d$($a_d$ 为按域统计后固定的标量)经线性投影,叠加查询点几何嵌入与噪声级条件嵌入得到 token $h^{(\sigma)}_{t,i}$;流 token 用与视频 token 相同的旋转位置编码约定锚定到未来帧与查询点初始图像块,从而在 Mixture-of-Transformers 的全注意力里跨模态对齐。训练时两种模态共享噪声水平、在加权 rectified-flow 目标 $\mathcal{L}_{FM}=\lambda_{video}\mathcal{L}_{video}+\lambda_{flow}\mathcal{L}_{flow}$ 下联合去噪;推理时从噪声联合去噪 40 步,VAE 解码出 RGB 帧,流重缩放累加恢复度量轨迹,全程无需独立跟踪器。
核心创新是把连续位移 token 与视频网格做时空对齐,并在统一生成过程中联合去噪,与已有方法的本质区别有三点。第一,与视频生成加事后跟踪的管线不同,流是显式生成输出而非从像素恢复:消融显示直接生成在 SpatialCog 上 ADE 0.060m,优于同一模型生成视频后用 Track4World(0.083m)或 4RC(0.098m)提取的轨迹。第二,与纯流模型不同,密集视频监督为流学习提供互补信号:同一未来的视觉演化约束几何运动必须物理自洽,flow-only 变体在相同骨干、数据与优化配方下 ADE 比 WorldFlow 高 48.5%(Sim7)和 55.9%(SpatialCog)。第三,几何编码器同时编码查询点的绝对位置 $E_{abs}(p_{0,i})$ 与相对质心位置 $E_{rel}(p_{0,i}-\mu)$,再叠加方向、位移、终点三项辅助损失,把向量场监督转化为对干净流的显式约束,强化局部精度与轨迹级一致性。
方法步骤详情
流程如下。(1) 输入:指令 $c$、首帧 $I_0$、$N=64$ 个 3D 查询点及图像坐标 $S_0$;流定义为 $f_{t,i}=p_{t,i}-p_{t-1,i}$,学习 $p_{\theta}(I_{1:T},f_{1:T}\mid I_0,Q,S_0,c)$。(2) 数据:Sim7/Real3 用 Gemini-2.5 Pro 写字幕、SAM 2 取掩码、Track4World 提轨迹;MolmoMotion-1M 复用已发布标注并做几何/尺度/有效性检查;统一为 49 帧片段并按域固定归一化标量 $a_d$。(3) Token 化:噪声位移经 Linear 投影,叠加几何嵌入与模态/噪声级嵌入;旋转位置编码 $(t/q_t,\, v_{0,i}/(q_s p_s),\, u_{0,i}/(q_s p_s))$ 与视频网格对齐,49 帧 288×480 输入得到 13×9×15 视频 token 与 48×64 流 token。(4) 训练:$\mathcal{L}=\mathcal{L}_{FM}+\lambda_{dir}\mathcal{L}_{dir}+\lambda_{vmag}\mathcal{L}_{vmag}+\lambda_{end}\mathcal{L}_{end}$,文本 0.1 概率丢弃;先在 SpatialCog 训 32,000 步(峰值学习率 $10^{-4}$),再以 EMA 权重起步在混合语料训 51,100 步,经仿真聚焦、真实域适应、SpatialCog 精修三段课程并保留跨域回放;64 张 H800、全局 batch 128。(5) 推理:40 步采样、guidance scale 2,流重缩放累加得 $p_{t,i}=p_{0,i}+\sum_{\tau} f_{\tau,i}$。
技术新颖性
技术新颖性体现在四个层面。架构上,流 token 作为原生生成模态被引入世界模型,并用与视频 token 完全相同的时空位置约定(经 VAE 压缩系数 $q_t=4$、$q_s=16$ 与 patch 大小 $p_s=2$ 换算)锚定,使跨模态注意力能建立某个流点对应某块画面的细粒度对应——此前没有工作把度量 3D 流与视频潜码放进同一去噪过程。监督上,除向量场回归外,对由预测速度场重构的干净流施加方向、位移、终点三项辅助损失,方向误差按真值位移量级加权、小净位移点排除在终点监督外,并随噪声级衰减加权;消融显示仅此一项就把 Sim7 ADE 从 0.063 降到 0.051m(19.0%)。数据上,统一 11 个来源的运动表示、分域归一化、结构化提示扩展(数据来源/相机运动/主体类型/环境)支撑了 1.44M 规模训练。实验上,WorldFlowBench 把直接生成流与生成后跟踪两条路线放到同一单帧协议下对比,结论干净利落。
实验结果
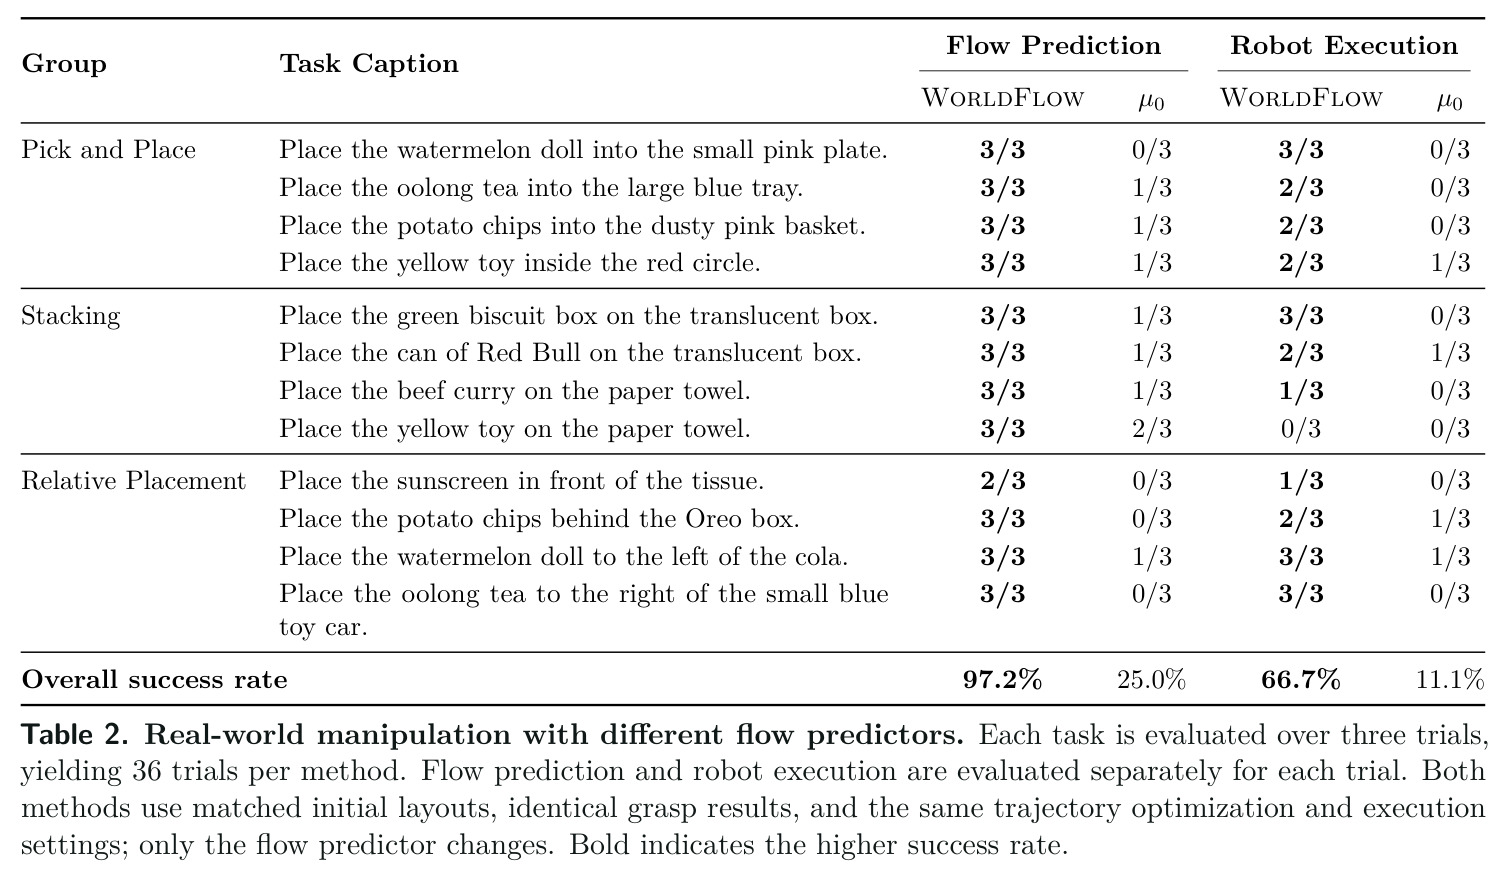
WorldFlowBench(1678 样本)上,WorldFlow 在三个子集的学习类方法中 ADE/FDE 均最低:Sim7 ADE 0.051m、FDE 0.094m、PWT 0.564;Real3 ADE 0.081m、FDE 0.113m、PWT 0.311;SpatialCog ADE 0.060m、FDE 0.078m、PWT 0.449。相对各子集最强外部基线(Sim7 的 Cosmos3-Nano+4RC 0.096m、Real3 的 0.085m、SpatialCog 的 LingBot-Video-MoE+4RC 0.131m),ADE 分别降 46.9%、4.7%、54.2%;PWT 在 Sim7 与 SpatialCog 最高,Real3 上 0.311 略低于最佳值 0.332。消融一(联合 vs 纯流):ADE 降 48.5%(Sim7)、19.8%(Real3)、55.9%(SpatialCog),SpatialCog FDE 从 0.248 降至 0.078m(68.5%)。消融二(直接生成 vs 事后跟踪):SpatialCog 上直接生成 0.060m 优于 T4W 的 0.083m 与 4RC 的 0.098m。消融三(辅助损失):Sim7 ADE 从 0.063 降至 0.051m(19.0%),三子集 PWT 全升。真实机器人 36 次实验:流预测成功率 97.2%(35/36)对 µ0 的 25.0%,整机执行 66.7%(24/36)对 11.1%(4/36)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SpatialCog 空间关系推理下的 3D 运动预测 | ADE (m) | 0.060 | 0.131(LingBot-Video-MoE + 4RC,最强外部基线) | 降低 54.2% |
| Sim7 仿真交互 3D 运动预测 | ADE (m) | 0.051 | 0.096(Cosmos3-Nano + 4RC) | 降低 46.9% |
| Real3 真实场景 3D 运动预测 | ADE (m) | 0.081 | 0.085(Cosmos3-Nano + 4RC) | 降低 4.7% |
| SpatialCog 终点位置误差 | FDE (m) | 0.078 | 0.232(LingBot-Video-MoE + 4RC) | 降低约 66.4% |
| 联合生成 vs 纯流消融(SpatialCog) | ADE / FDE (m) | 0.060 / 0.078 | 0.136 / 0.248(flow-only 变体,同骨干同数据同配方) | ADE 降 55.9%,FDE 降 68.5% |
| 真实机器人操作(12 任务 × 3 次,共 36 次) | 成功率 | 流预测 97.2%,整机执行 66.7% | µ0:流预测 25.0%,整机执行 11.1% | 流预测 +72.2 个百分点,执行 +55.6 个百分点 |
局限与改进
作者明确承认两点局限:一是需要预先给定的查询点,实际部署要靠外部模块选点(机器人实验中用 Qwen3.8-27B 做目标定位、SAM 2 取掩码、深度图提取点云提供查询点),端到端程度受限;二是自动生成的轨迹监督本身带噪,Track4World 提取误差会进入训练标签。我的补充观察:Real3 上细粒度精度 PWT 0.311 仍低于最佳基线的 0.332,说明真实场景的细尺度轨迹还有差距;评测采用单帧协议、不提供运动历史,49 帧(16 FPS 下约 3 秒)的预测地平线对长时程任务偏短;所有 3D 位置固定表达在初始相机坐标系,相机大幅运动的场景只靠提示词声明相机运动而未显式建模;真实执行成功率 66.7% 明显低于流预测的 97.2%,暴露抓取失败、轨迹优化失败与堆叠放置不稳等管线短板;训练需要 64 张 H800,算力门槛极高。
独立分析的弱点
独立分析几点弱点。其一,查询点依赖:需要深度/分割先验才能选点,对无深度相机的纯 RGB 场景或场景级大范围预测不友好,改进方向是让模型自主提出查询,例如可学习的查询提议头或与分割模型联合训练。其二,监督噪声:1.44M 样本中大量轨迹来自 Track4World 自动提取与 MolmoMotion 复用标注,系统性误差会被模型记忆,可引入不确定性加权或多教师交叉验证过滤低质量片段。其三,生成随机性:rectified flow 采样结果随初始噪声变化,机器人执行需要稳定可复现的轨迹,论文未报告多次采样的方差,可研究轨迹级最佳样本选择或模式聚合。其四,规模扩展:固定 $N=64$ 个查询点、49 帧窗口下流 token 为 48×64,点数与帧数增多时 token 线性上涨,注意力开销与显存需要评估。其五,域归一化标量 $a_d$ 依赖训练前统计并全程固定,遇到尺度差异大的新域需重新估计,可探索自适应归一化或在线尺度估计。
未来方向
作者提出的方向包括:自动查询选择(免除人工与外部模块选点)、多模态未来(同一条件下生成多个可能的未来)、以及 3D 流与动作的联合生成,以研究显式运动表示对策略学习的增益。在此基础上可以自然延伸:把 WorldFlow 预测的流直接接入模型预测控制或抓取优化闭环,定量验证流作为中间表示相比端到端动作模型的跨本体迁移优势;利用视频与流的几何一致性做自监督降噪或测试时优化——生成的视频经重投影应与预测流对齐,不一致即是误差信号;扩展到更长时程与动态相机,把相机位姿作为显式条件引入;把流 token 与点云、深度等 3D 观测模态联合,支持场景级稠密预测;以及模型蒸馏与采样步数压缩,把当前 40 步的推理降到机器人实时可控的水平。
复现评估
复现难度:高。算力上需 64 张 H800(8 节点)、全局 batch 128、两阶段共约 83,100 步,属机构级配置;模型从 NVIDIA 开源的 Cosmos-Nano 权重初始化,这部分可获得。数据上,底层数据集多为公开资源(ManiSkill、MIKASA、MetaWorld、MetaFold、RLBench、RoboCasa、RoboTwin、AgiBot World、EPIC-KITCHENS、SSv2、EgoDex、DROID、Stereo4D 等),但标注管线依赖 Gemini-2.5 Pro 字幕、SAM 2 分割与 Track4World 跟踪,逐域归一化标量与课程采样细节需查补充材料;自采的 SpatialCog(400 个评测样本加训练划分)是否完全开放未知。项目主页为 https://worldflow-rbs.github.io/ ,代码与权重开放情况以主页为准。机器人复现还需 xArm、XHand 灵巧手、ZED Mini RGB-D,以及 Qwen3.8-27B、T(R,O)Grasp、Dream2Flow 式局部刚体拟合优化器等组件。有多卡资源与较强工程能力时可复现核心基准结果,机器人端门槛更高。
论文图表
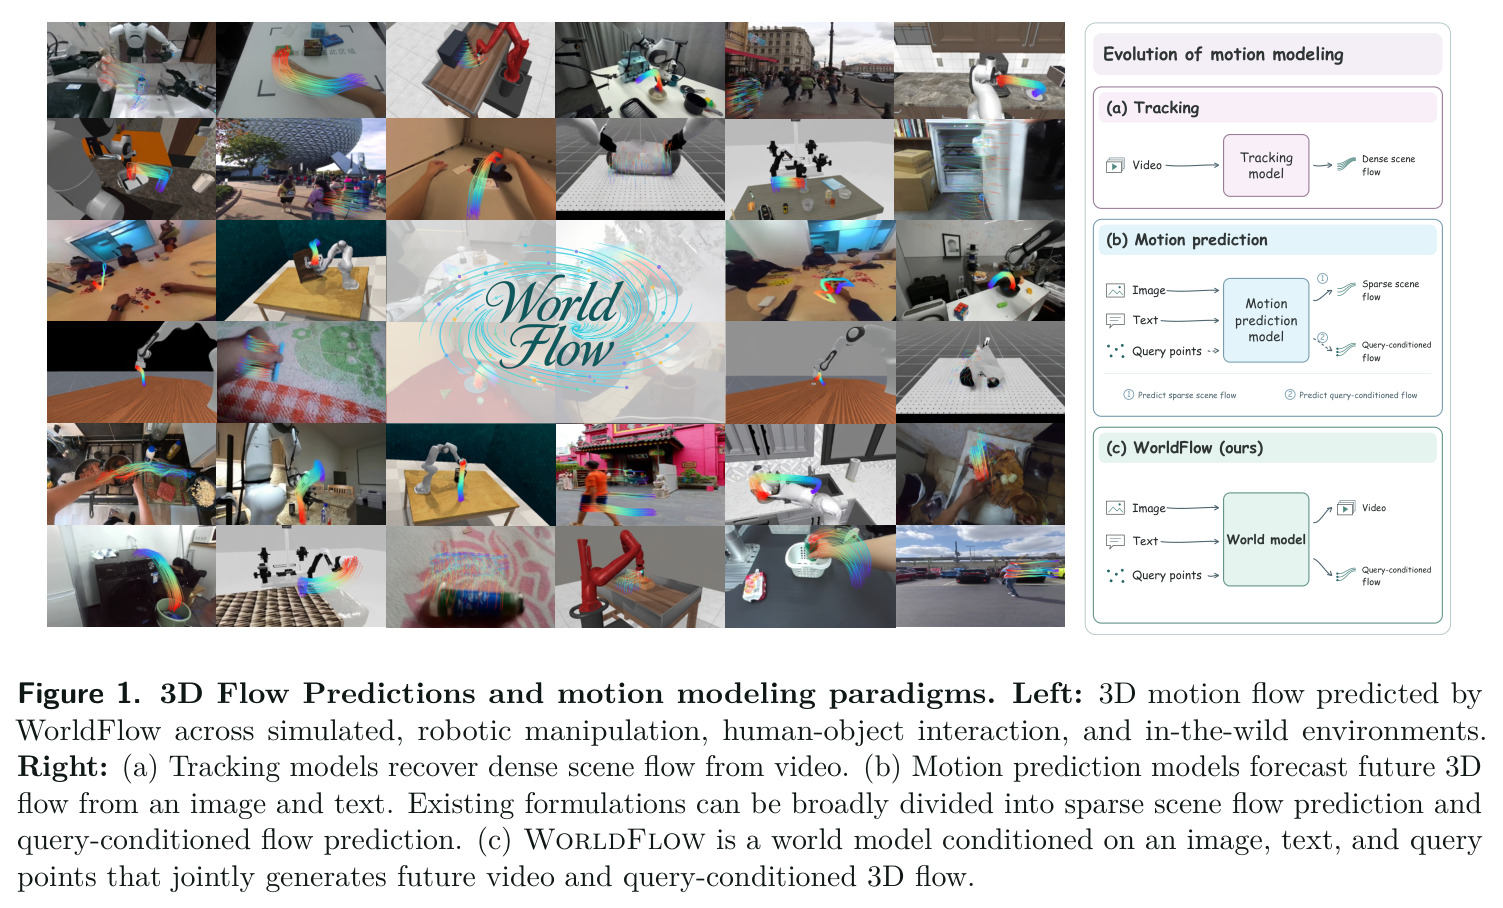
左侧展示 WorldFlow 在仿真、机器人操作、人-物交互和真实野外环境中预测的 3D 运动流;右侧对比三种运动建模范式:(a) 跟踪模型从视频中恢复稠密场景流;(b) 运动预测模型从图像加文本预测未来 3D 流,又分为稀疏场景流预测与查询条件流预测两类;(c) WorldFlow 以图像、文本和查询点为条件,联合生成未来视频与查询条件 3D 流。
这张图一图道尽论文定位:把 WorldFlow 放在跟踪、运动预测到世界模型的演进谱系末端,直观展示它与两类已有范式在输入输出上的差异,是理解动机与贡献的最快入口。