Sage-A1.5:从长程执行到科学探索的能力组合 Sage-A1.5: From Long-Horizon Execution to Scientific Exploration with Capability Composition
35B MoE 智能体学会任务编排与自主验证,科学基准超越更大闭源模型
前置知识
Mixture-of-Experts (MoE)
MoE 是一种稀疏激活架构:模型由多组专家前馈网络构成,路由器为每个 token 只选择少数专家计算,因此总参数量远大于单次前向的实际计算量。Sage-A1.5 基于 Qwen3.5-35B-A3B,即总参数 35B、每 token 仅激活约 3B,这使其在保持大容量知识的同时推理成本接近小模型,还便于 FP8/4-bit 量化后在消费级硬件与本地设备部署。
论文反复强调 35B-A3B 规模与万亿参数模型的对比,以及本地部署能力(Ascend/NVIDIA/AMD/Apple Silicon、LM Studio、llama.cpp),不理解 MoE 的总参-激活参区分就无法理解这些卖点的含义。
SFT 与 RL 后训练
监督微调(SFT)在教师模型的演示轨迹上做 token 级负对数似然学习,教模型行为的形态;强化学习(RL)则用环境给出的结果奖励(如测试通过、竞赛奖牌)直接优化策略。现代智能体训练通常两者结合:先 SFT 建立基本交互能力,再用 RL 提升结果质量。本文还引入按样本混合两种信号的统一后训练。
Sage-A1.5 的训练管线本质上是'各域教师模型先分别 SFT/RL,再统一 outcome-process 后训练',文中 Stage I/II 公式、MLE 的 WIRL 都建立在这套框架之上。
子代理编排与上下文隔离
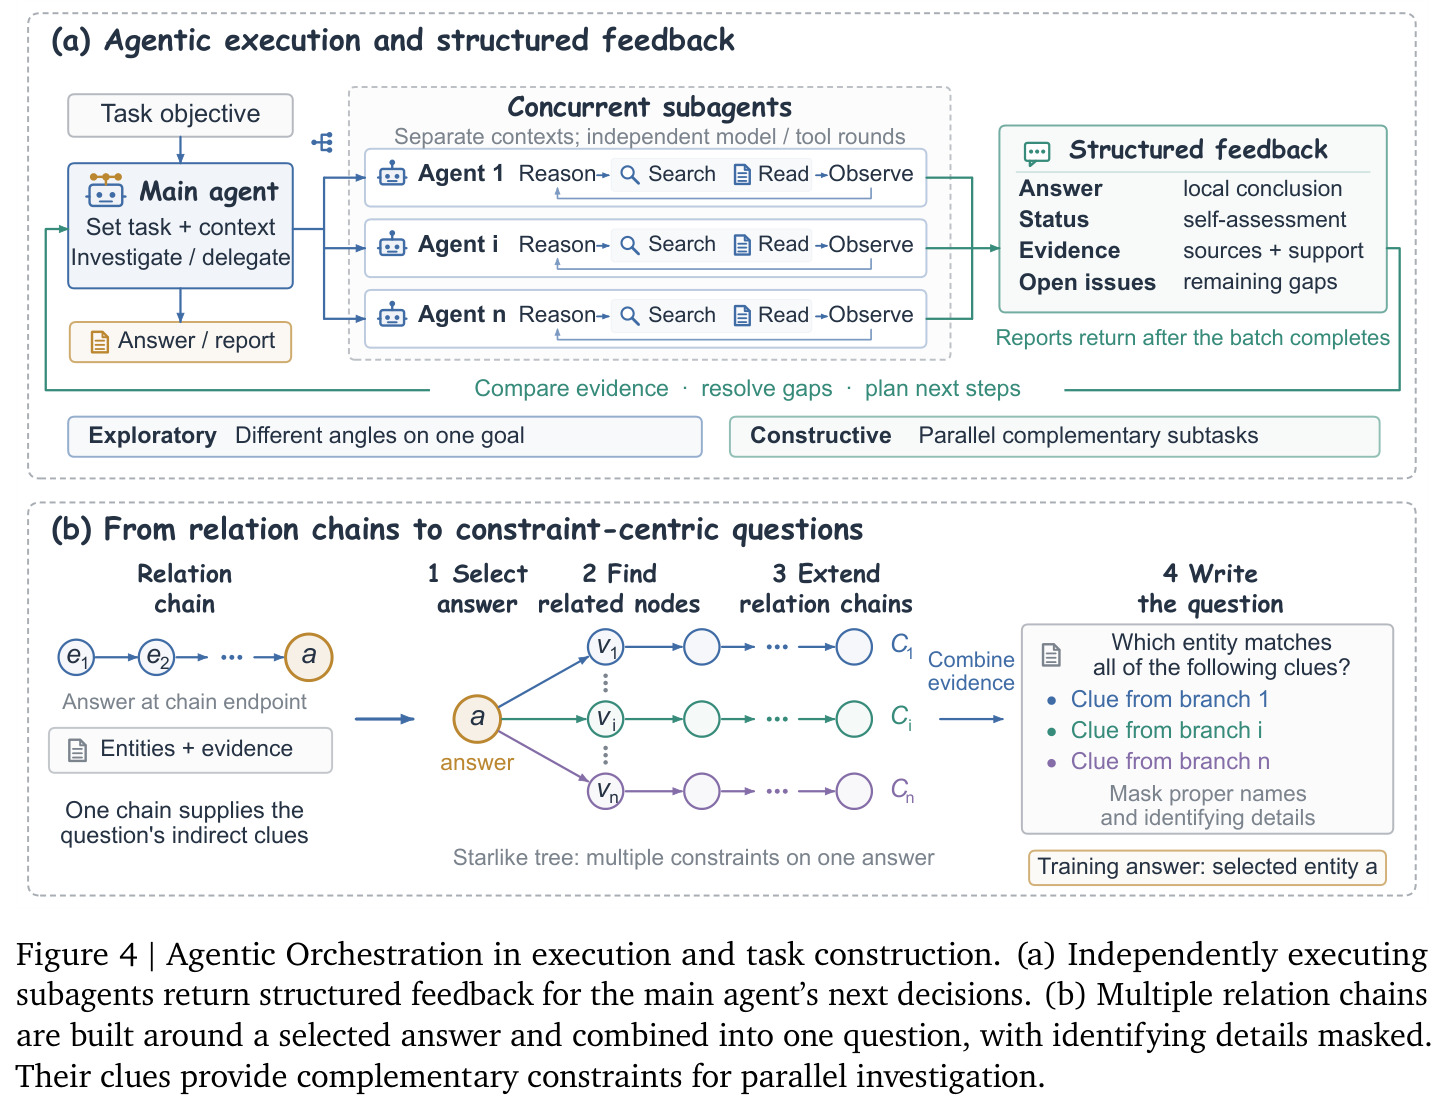
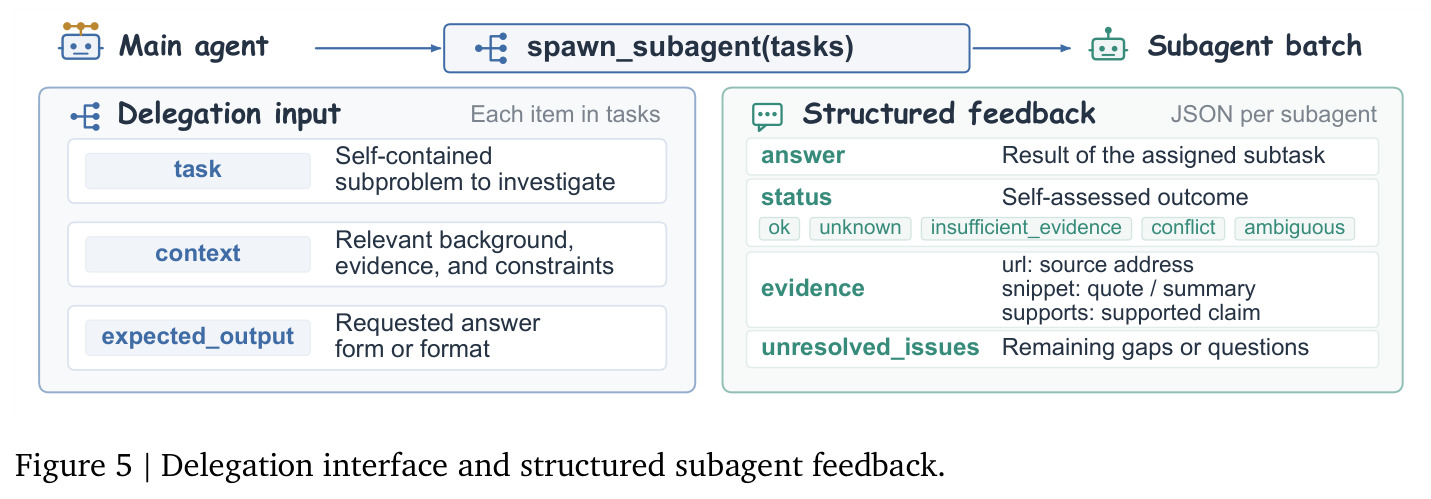
主代理把大任务拆成子任务,通过 spawn_subagent 生成一批并行子代理,每个子代理拥有完全独立的上下文窗口,独立执行推理-搜索-工具循环,完成后把结论连同结构化元信息返回。上下文隔离可防止并发调查互相污染,也绕开单一上下文窗口的长度限制。
Agentic Orchestration 是本文第一核心能力:主代理与子代理的委派接口、结构化反馈(状态/证据/未解决问题)是理解其训练数据构造与案例演示的基础。
PPO 与 KL 正则
PPO(近端策略优化)用裁剪的重要性采样比率限制每次策略更新幅度,是结果奖励 RL 的标准算法;KL 散度正则项约束策略偏离参考(如 SFT 初始)策略的距离,防止训练崩溃或能力遗忘;熵项 $H$ 鼓励探索。本文 WIRL 损失 $\ell_t + \lambda_{\mathrm{KL}}K_t - \lambda_H H_t$ 就是这套组件的组合。
读懂 MLE 训练的公式 (1) 和统一后训练的 $L_{\mathrm{RL}}$ 项都需要 PPO 术语:clipped loss、优势、mask $m_t$、stop-gradient 权重 $w_t$。
在线蒸馏与反向 KL
在线策略蒸馏(OPD)让学生模型在自己生成的轨迹上,逐 token 向教师的下一 token 分布对齐,目标是反向 KL 散度 $D_{\mathrm{KL}}(p_t \| p_t^{\mathrm{T}})$。与在教师数据上做 SFT 不同,OPD 在学生实际访问的状态上施加过程监督,能纠正学生在自己分布内的错误,适合结果验证昂贵的领域。
Stage II 统一后训练的一半信号来自多教师 OPD(公式 6),理解'result RL + process distillation 按样本加权'这一设计是把握全文方法的关键。
研究动机
前作 Agents-A1 已经证明小模型也能胜任长程任务:它是 35B 参数的 MoE 智能体模型,通过'知识-行动'基础设施连接外部知识、工具调用、观察与验证反馈,训练轨迹平均长达 45K token,在多步搜索、科学推理、指令遵循和工具使用上匹配甚至超过万亿参数模型。但真实复杂任务暴露了单代理串行执行的结构性短板:软件工程、机器学习优化和科学研究往往需要同时管理多个相关子任务、比较不同技术方案、并随新证据出现修正之前的决策。单个智能体一步步推进时,上下文不断膨胀、探索速度变慢,早期错误还会污染后续所有决策。更麻烦的是,执行得更久并不等于结果更好——智能体可能在同一个假设周围反复无效搜索,把未经证实的假设当作前提继续推理,或者在证据检查完成之前就匆忙接受结论。这说明单纯扩张'能力覆盖'(会做更多领域的任务)已经触及瓶颈,必须让模型学会组织工作和检查进度。
本文的目标是本文的目标是让 35B 规模的模型在长程任务上具备'组织工作'与'检查进度'两种元能力,并把它们做成模型内生的、可训练的策略,而不是外部脚手架里的固定规则。具体拆成三条线:第一,Agentic Orchestration——模型要能自主决定如何分解任务、把子任务委派给上下文隔离的并行子代理、再整合它们的发现;第二,Agentic Verification——模型要在进展停滞或关键结论出现时主动复查证据与假设、识别无效搜索路径并调整方向,且推理时不依赖在线监督模型或独立验证工具;第三,开放科学发现——把智能体能力从'回答预设问题'扩展到'进行探索性研究',产出可检查的研究工件。最终交付一个在这些能力上达到或超过更大闭源模型的开源 35B 模型,为社区提供一条从长程执行通往可协作、可验证、可检查的科学探索的可行路径。
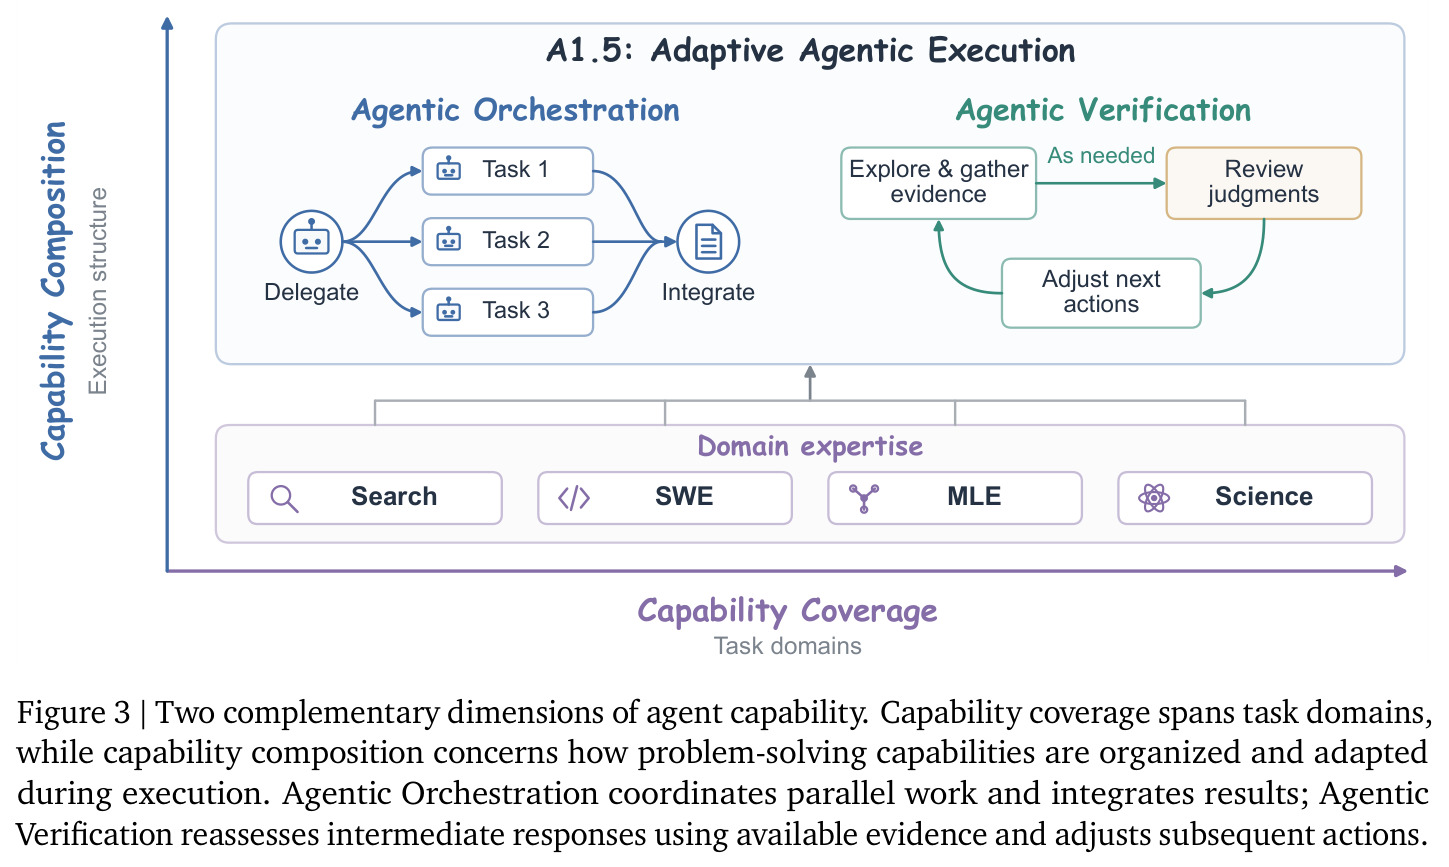
与已有工作不同的是,与已有工作的本质差异在于把'执行的形状'本身当作训练目标。过去的多智能体系统把任务分解、子代理调度、验证检查都写在外部框架的固定规则里,模型只负责执行单步动作;这类设计无法让模型学会什么时候该委派、给子代理什么上下文、如何用返回的证据修正计划。Sage-A1.5 提出与'能力覆盖'(capability coverage,模型能处理哪些领域)正交的第二个维度——'能力组合'(capability composition,能力在执行中如何被组织、协调与调整),并为其分别构造了可验证的训练任务族:约束引导长程搜索(从关系链升级为围绕共享答案的星形树约束图,天然逼出并行调查行为)和多源研究综合。编排进一步区分了两种可学习的并行模式:探索式组合与构造式组合,类比逻辑或与逻辑与。验证能力则采用'监督模型只在造数据时介入、训练完成后外部提示全部移除'的方式内生到模型推理文本中,推理时仅需在系统提示中加一行条件标记即可按需激活,全程无需外部验证器。
核心方法
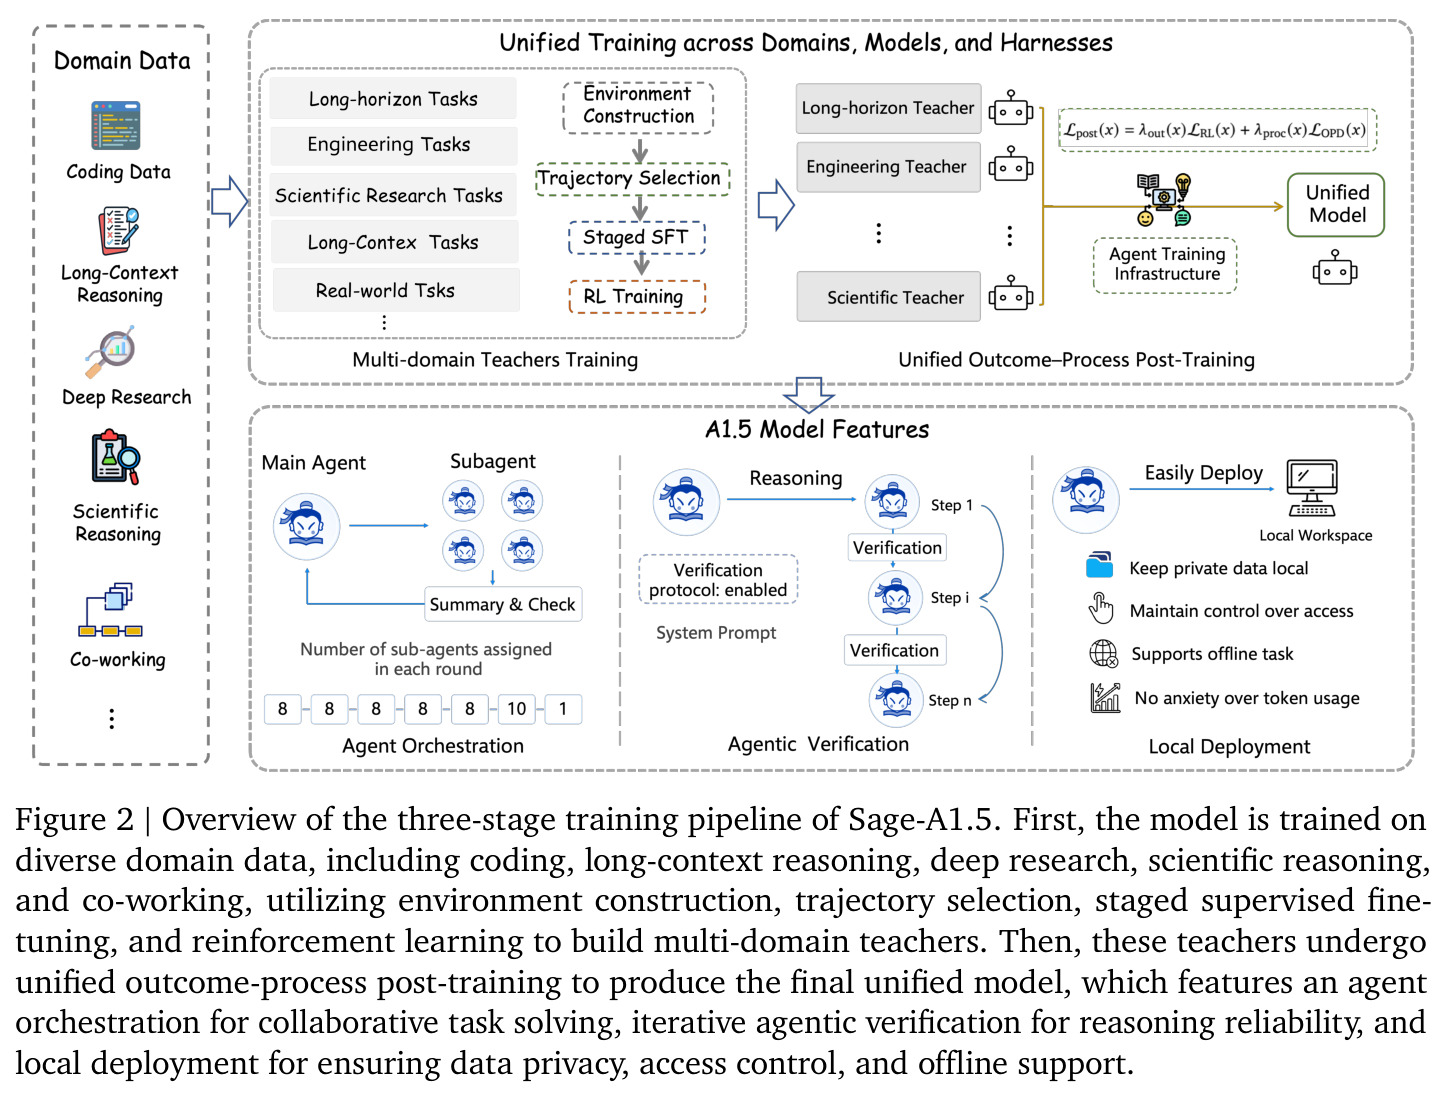
整体思路分两层。直觉层:复杂任务需要'分而治之'与'自我纠错',那就先把这两种行为连同各领域专长分别训练成专门的教师模型,再融合进一个统一模型。技术层:以 Qwen3.5-35B-A3B(在 A1 基础上迭代)为底座,先针对七个方向分别造数据训练教师——MLE 工程(Kaggle-MLE Factory + 窗口交互 RL)、SWE 修复(双 harness 轨迹 + 三重防泄漏)、科学研究(三阶段蒸馏 science-enhanced teacher)、搜索代理(证据标准过滤轨迹)、长上下文(递归任务演化产出 3512 道难题)、编排(结构化反馈协议)与验证(监督模型定点插入反思)。随后统一两阶段后训练:Stage I 多域 SFT 混合任务导向与协议冷启动数据;Stage II 在学生自产轨迹上联合优化结果奖励 RL 与多教师在线蒸馏,$L_{\mathrm{post}}(x) = \lambda_{\mathrm{out}}(x)L_{\mathrm{RL}}(x) + \lambda_{\mathrm{proc}}(x)L_{\mathrm{OPD}}(x)$,按样本在结果/过程/混合监督间选择。底层由 pVisor 沙箱支撑,支持环境按需加载与等待期内存卸载(静态测试显示驻留内存降低约 80%)。
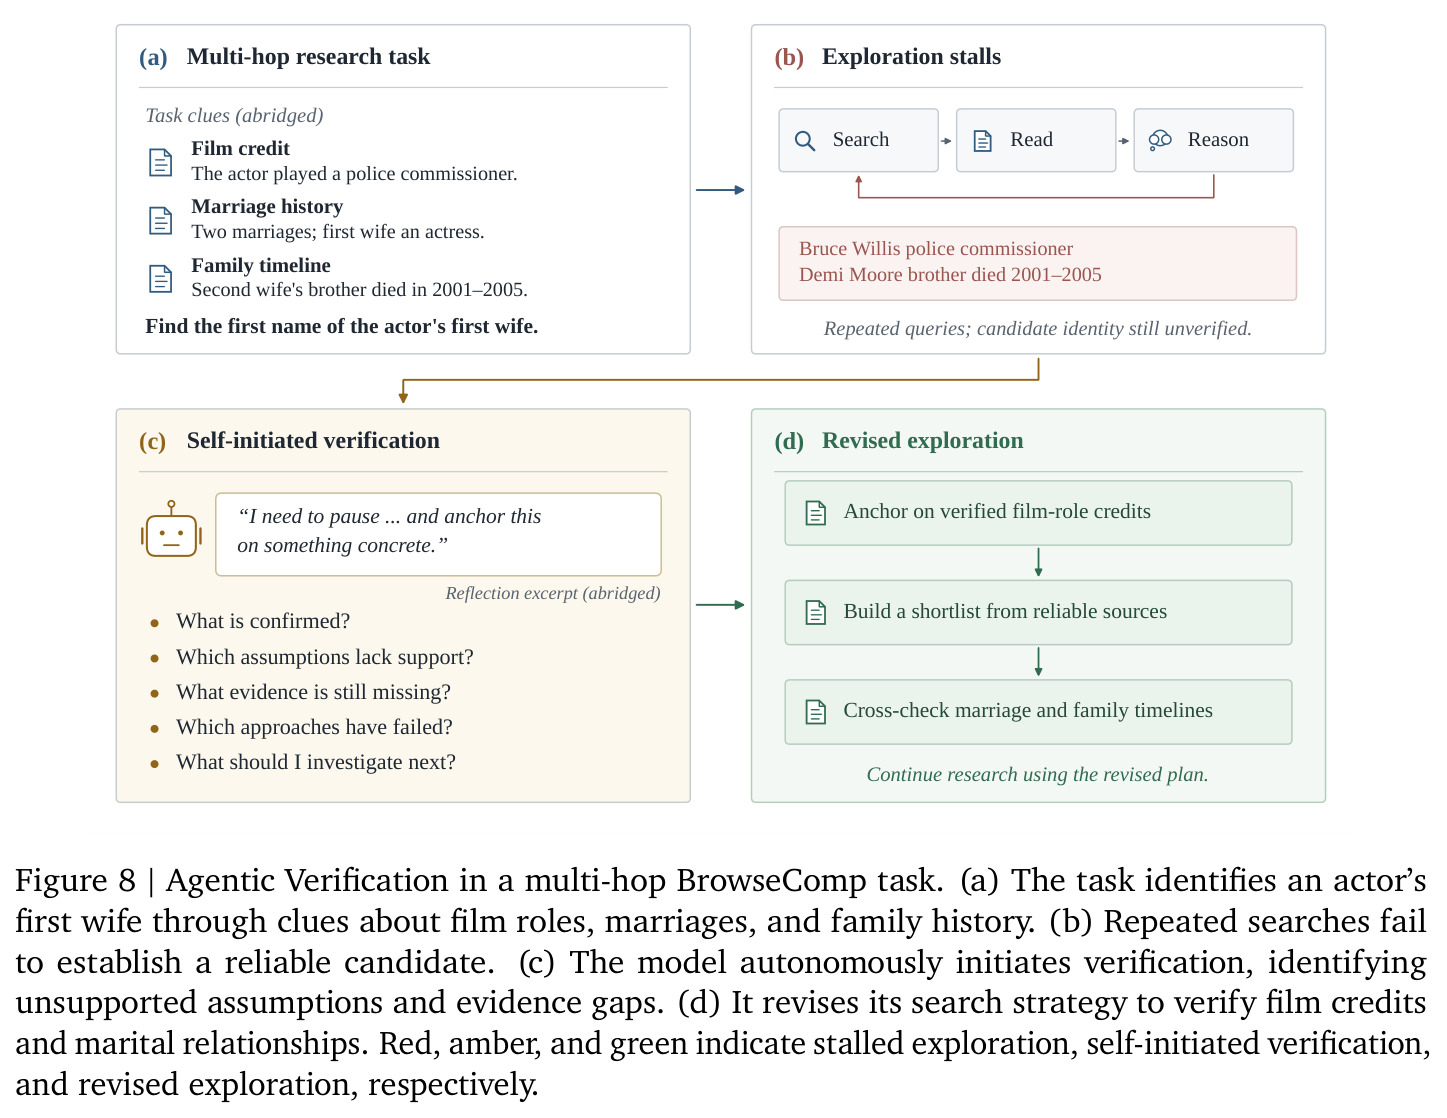
核心创新有两点。其一是'把编排当成可学习策略':主代理调用 spawn_subagent 生成一批上下文完全隔离的子代理,每个子代理独立完成推理-搜索-阅读循环后,除答案外必须返回结构化反馈 JSON——自评状态(ok/unknown/insufficient_evidence/conflict/ambiguous 五档)、支撑证据(url、片段、所支持的论断)与未解决问题清单;主代理据此识别缺口与冲突,决定直接调查还是再次委派。训练数据按角色切分:主代理轨迹教任务分解、委派与综合,子代理轨迹教独立调查与结构化汇报,两路监督注入同一模型,使其既能当指挥又能当执行者。其二是'把验证内生化':造数据时由执行模型真实搜索读网页,监督模型仅在重复搜索、持续无进展、关键结论需确认三类时机插入验证反思;每条验证只用当时已获得的证据,必须区分已证实事实与未验证假设,并给出具体下一步方向;清洗后删除所有外部监督痕迹,把反思织入模型推理文本。推理时只需系统提示加 'Verification protocol: enabled' 即可激活,无需验证工具、在线监督器或 harness 规则。
方法步骤详情
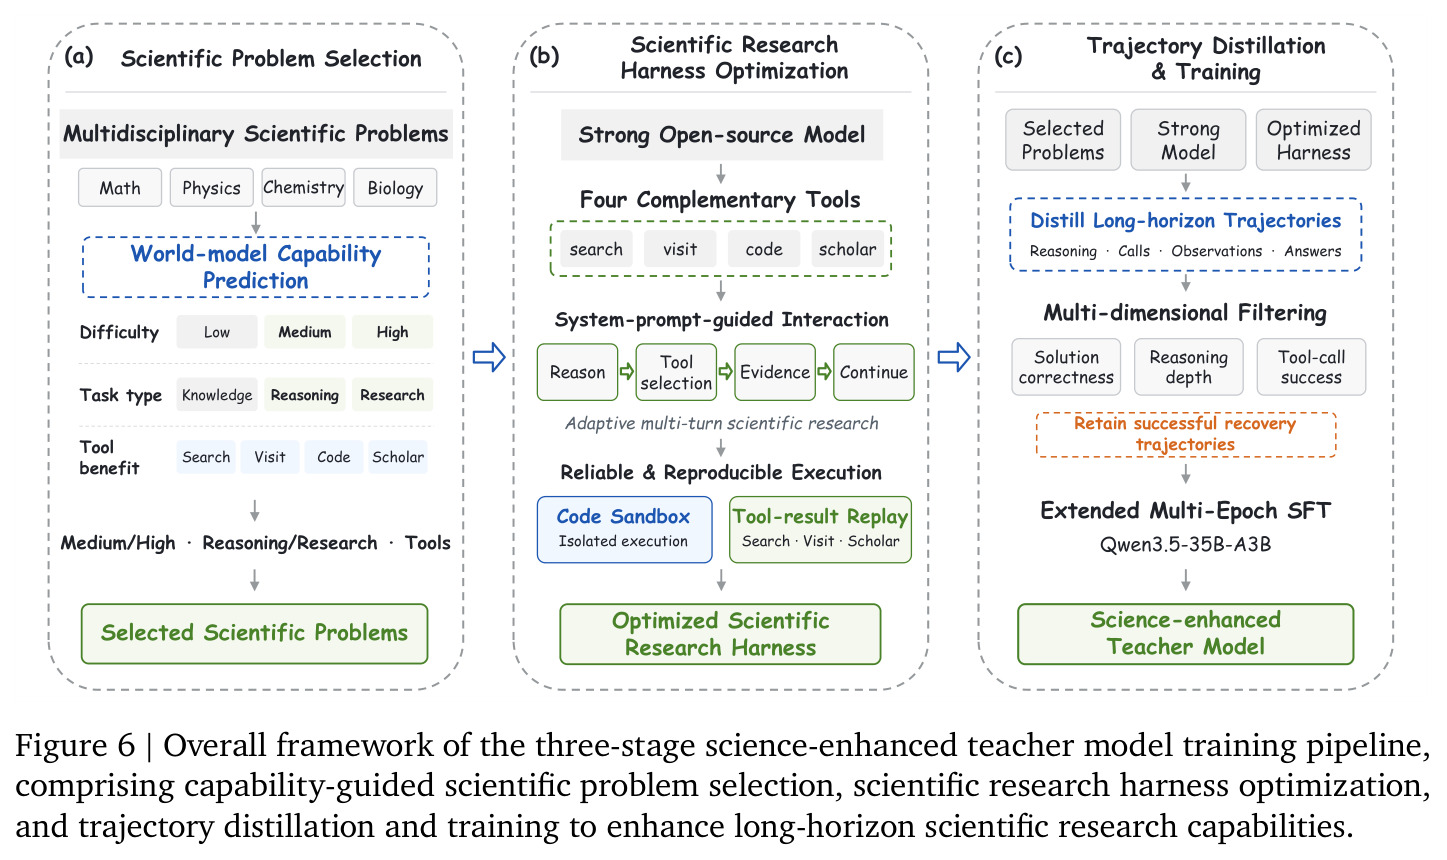
训练分六条领域支线加一个统一阶段。第一步,MLE 工程:Kaggle-MLE Factory 把历史 Kaggle 竞赛转成带隐藏测试集的可执行任务,交互框架用'实验树'支持分支比较与回退;先两阶段 SFT,再用 WIRL——把两次实验结果间的交互划为共享结果奖励的窗口,优化 $L(\phi)=\frac{1}{|\mathcal{B}|}\sum_{u\in\mathcal{B}}\frac{1}{\max(N_u,1)}\sum_t m_t[w_t\ell_t(\phi;R_u)+\lambda_{\mathrm{KL}}K_t-\lambda_H H_t]$,并异步修正新旧策略概率比。第二步,SWE:统一 SWE-rebench-V2 与自建任务为修复格式,参考补丁/no-op 双验证,配合删除暴露答案的 Git 对象、封锁出站网络、轨迹审计三重防泄漏。第三步,科学教师:按难度、题型、工具收益三维筛选问题,优化含 search/visit/code/scholar 四工具的 harness(隔离沙箱+工具结果重放),蒸馏后按正确性、推理深度、工具成功率过滤,对 Qwen3.5-35B-A3B 做扩展多 epoch SFT。第四步,长上下文:在 LongBlocks 16K–128K 文档的 24 类任务上沿 10 个难度轴递归演化出 3512 道难题(基座成功率 31.57%),从 DeepSeek-V4-Pro 采轨迹、正倒序双评审后留 1949 条。第五步,搜索与真实工作流:搜索问题由带工具的提案代理沿可发现的证据生成并附评价标准;ALE 环境经 builder/reviewer/judger 三角色演化扩到 1000+ 专业工作流环境,训练集达数亿监督 token。第六步,统一后训练:Stage I 多域 SFT,$L_{\mathrm{SFT}}=(1-\rho)\mathbb{E}_{q_{\mathrm{task}}}[\ell_\theta]+\rho\mathbb{E}_{q_{\mathrm{proto}}}[\ell_\theta]$;Stage II 联合结果 RL($R_{\mathrm{out}}=V_d-P_{\mathrm{fmt}}-P_{\mathrm{proto}}$)与多教师 OPD(反向 KL $L_{\mathrm{OPD}}=\frac{1}{N_\tau}\sum_t m_t D_{\mathrm{KL}}(p_t\|p_t^{\mathrm{T}})$),异步生成适应异构回滚时长。
技术新颖性
技术新颖性体现在五处。第一,把'能力组合'确立为与'能力覆盖'正交的训练维度,并把并行执行抽象为探索式($A\lor B\lor C$,多假设竞争同一问题)与构造式($A\land B\land C$,互补子问题并行)两种可组合模式,完成多智能体协作从'框架固定规则'到'模型内生策略'的范式转变。第二,任务构造上把 A1 的关系链升级为围绕共享答案的星形树图:每条分支是独立证据链,掩去专名后形成多约束线索题,天然要求并行调查再合并恢复答案。第三,结构化反馈协议用五档自评状态(含 conflict、ambiguous)显式暴露证据冲突,既帮主代理识别缺口,也为轨迹选择提供质量信号。第四,WIRL 的窗口奖励承认'一次实验结果背后是多轮分析',窗口完成即可更新策略而无需等任务结束,配合 stop-gradient 比率修正处理异策略偏差,规避超长回合稀疏奖励的低效。第五,样本级混合监督 $\lambda_{\mathrm{out}},\lambda_{\mathrm{proc}}$ 让一个训练循环同时容纳结果可廉价验证域的 RL 与昂贵域的教师蒸馏;教师按域标签路由、作为独立 prefill 服务按需查询;编排任务中学生同时担任主代理与子代理,同一份报告在发送方轨迹算监督、在接收方算观察——这些设计共同把异质域、异构 harness 统一进单一模型。
实验结果
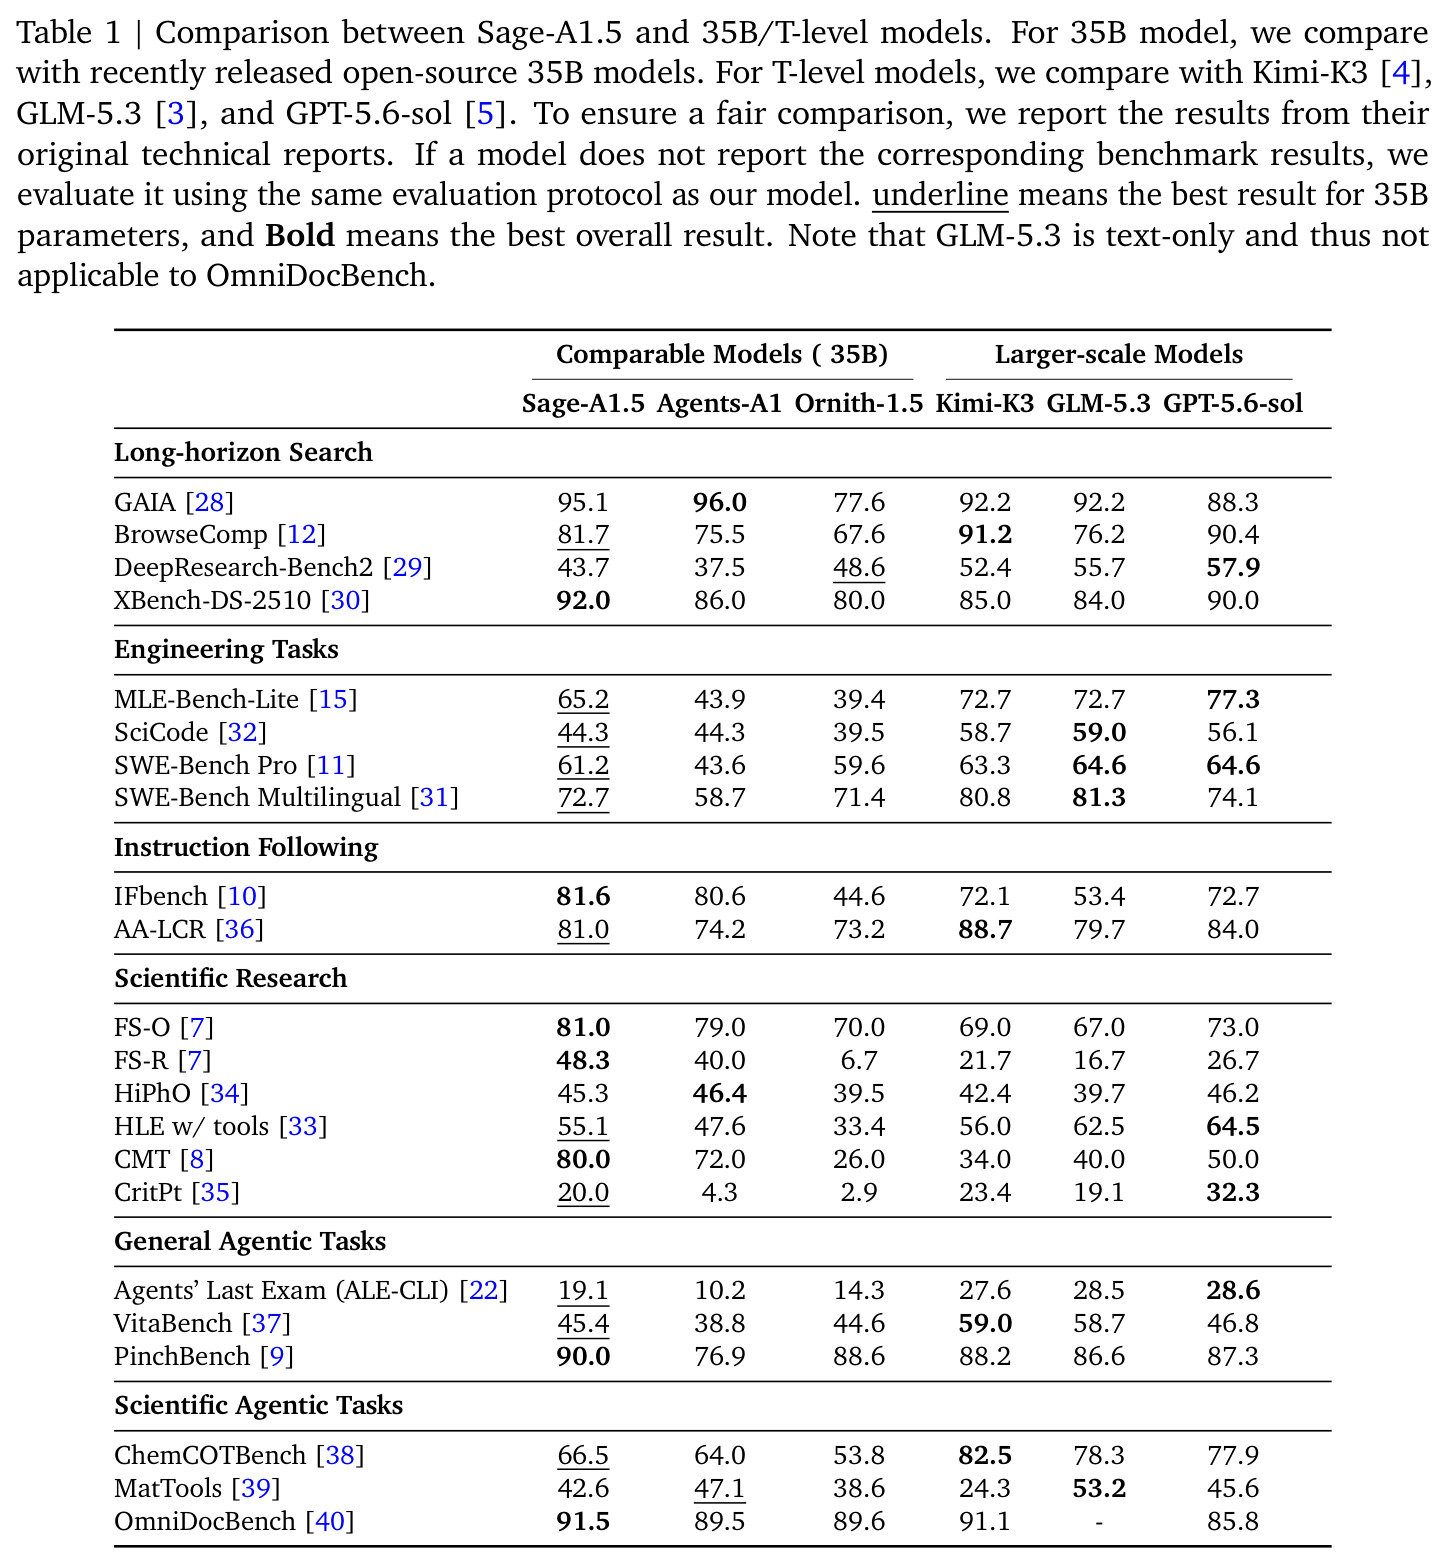
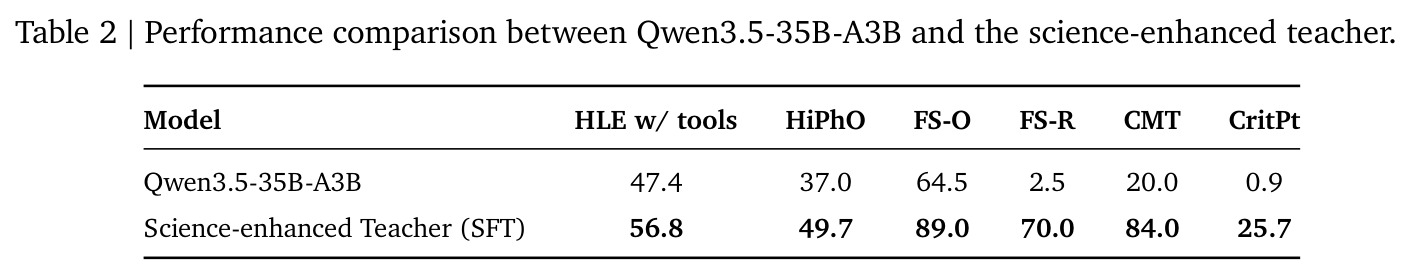
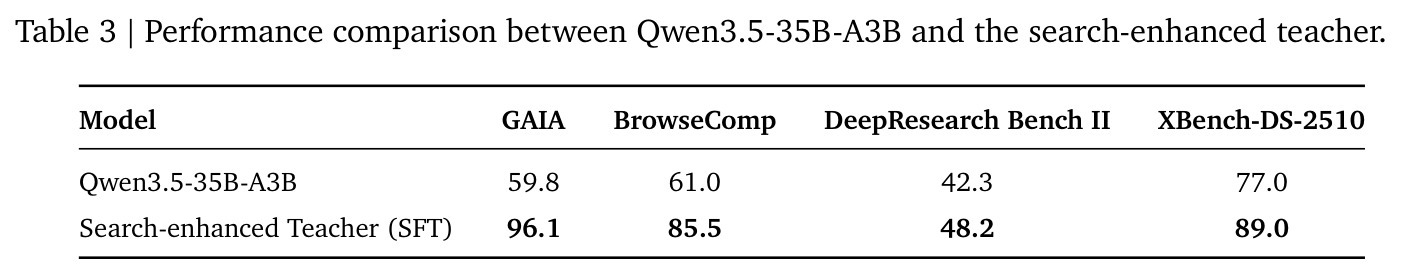
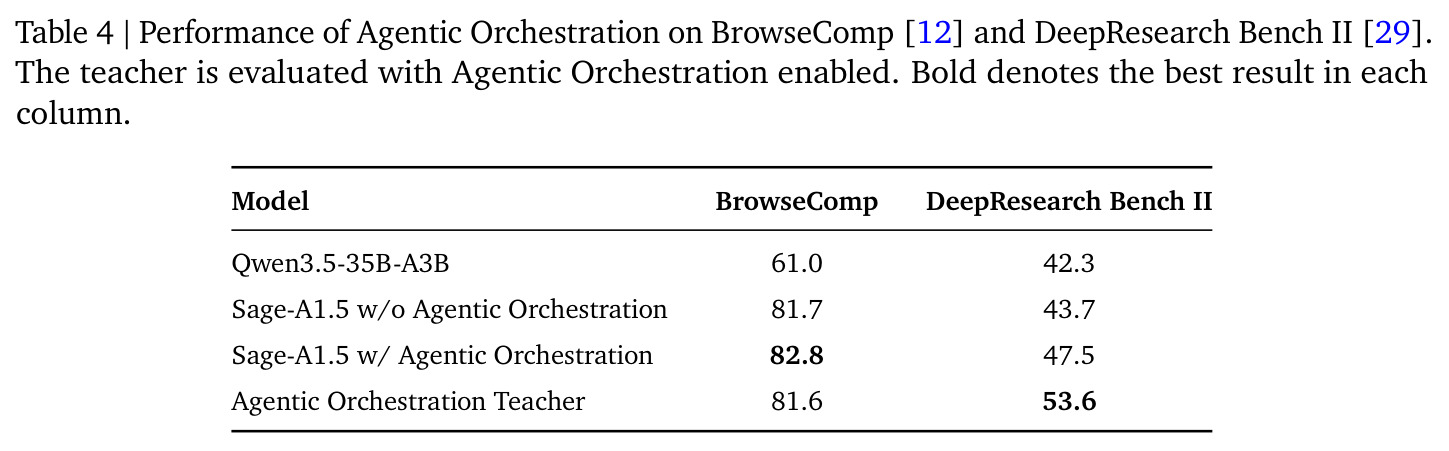
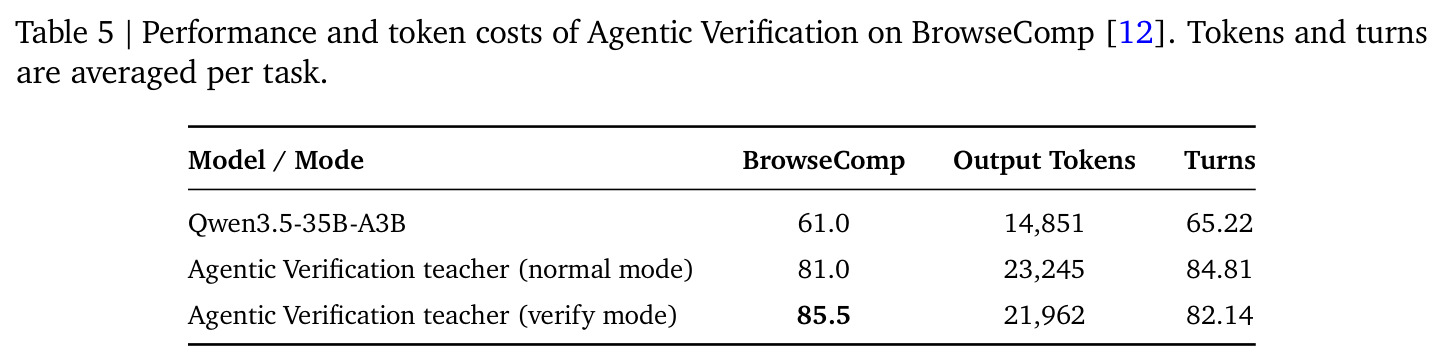
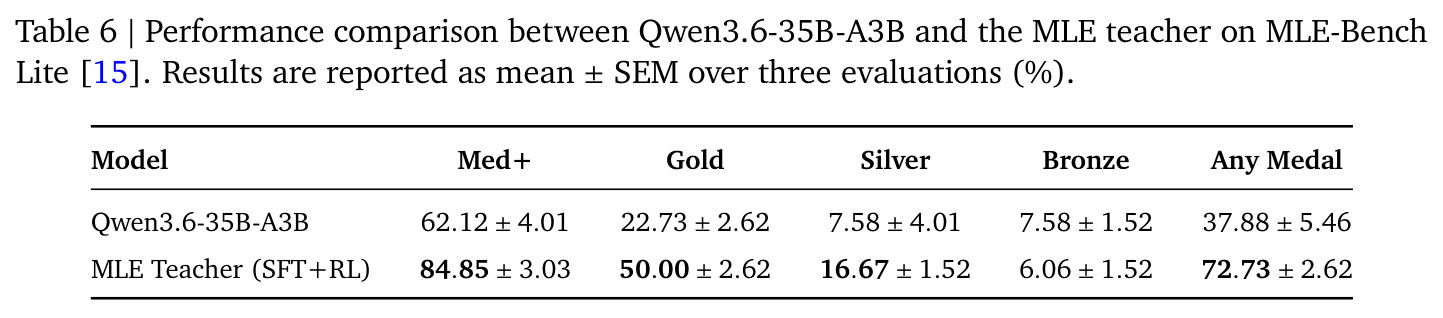
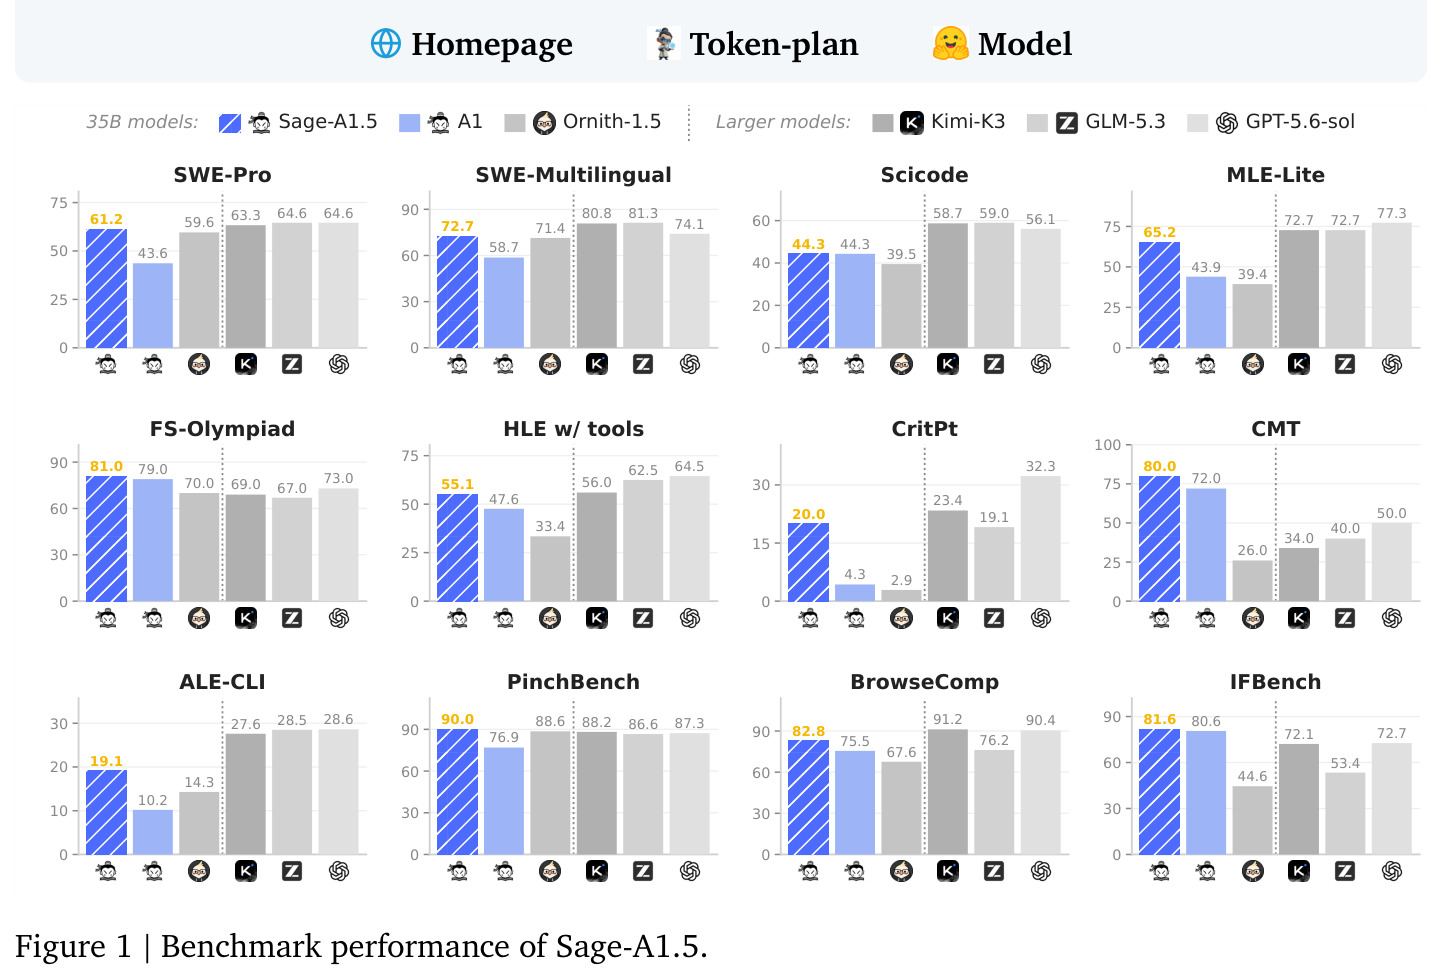
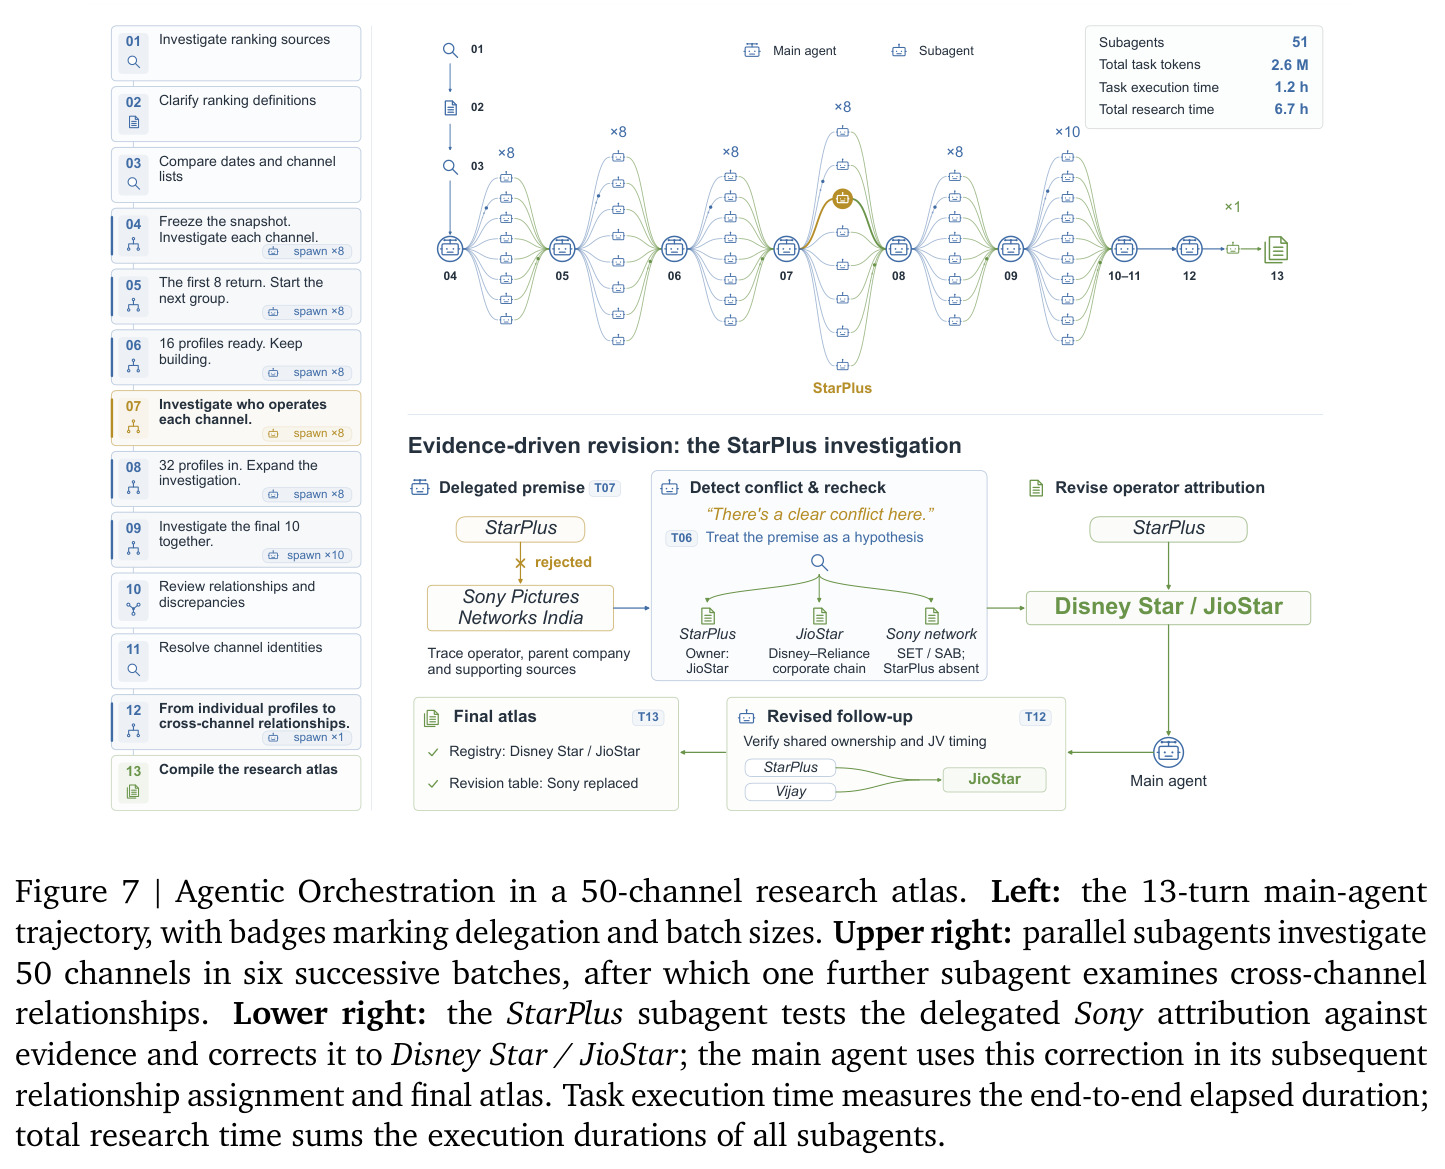
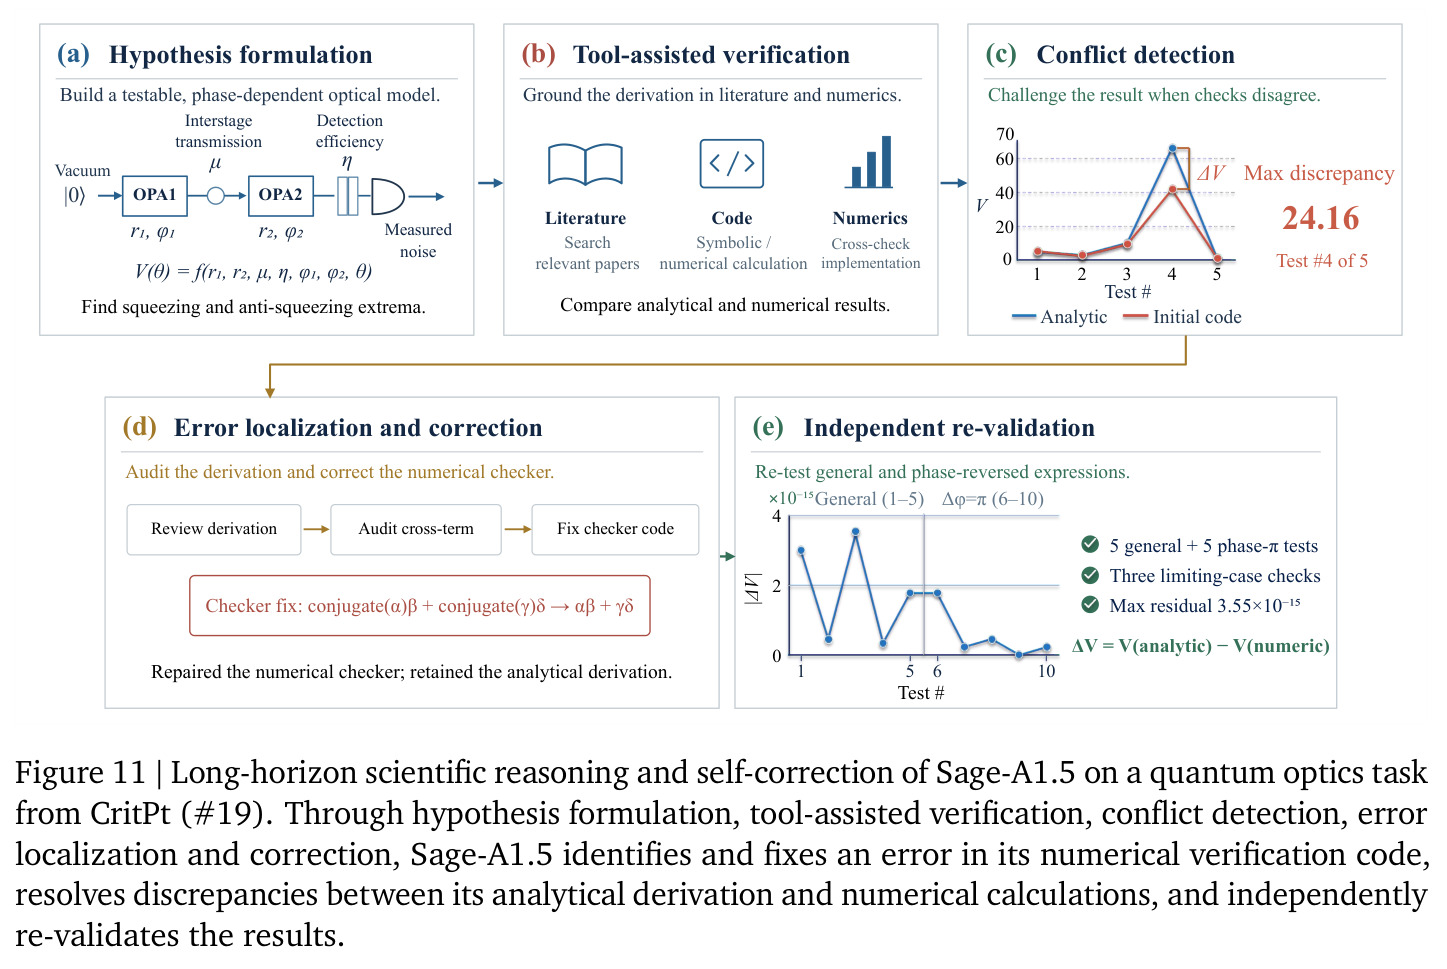
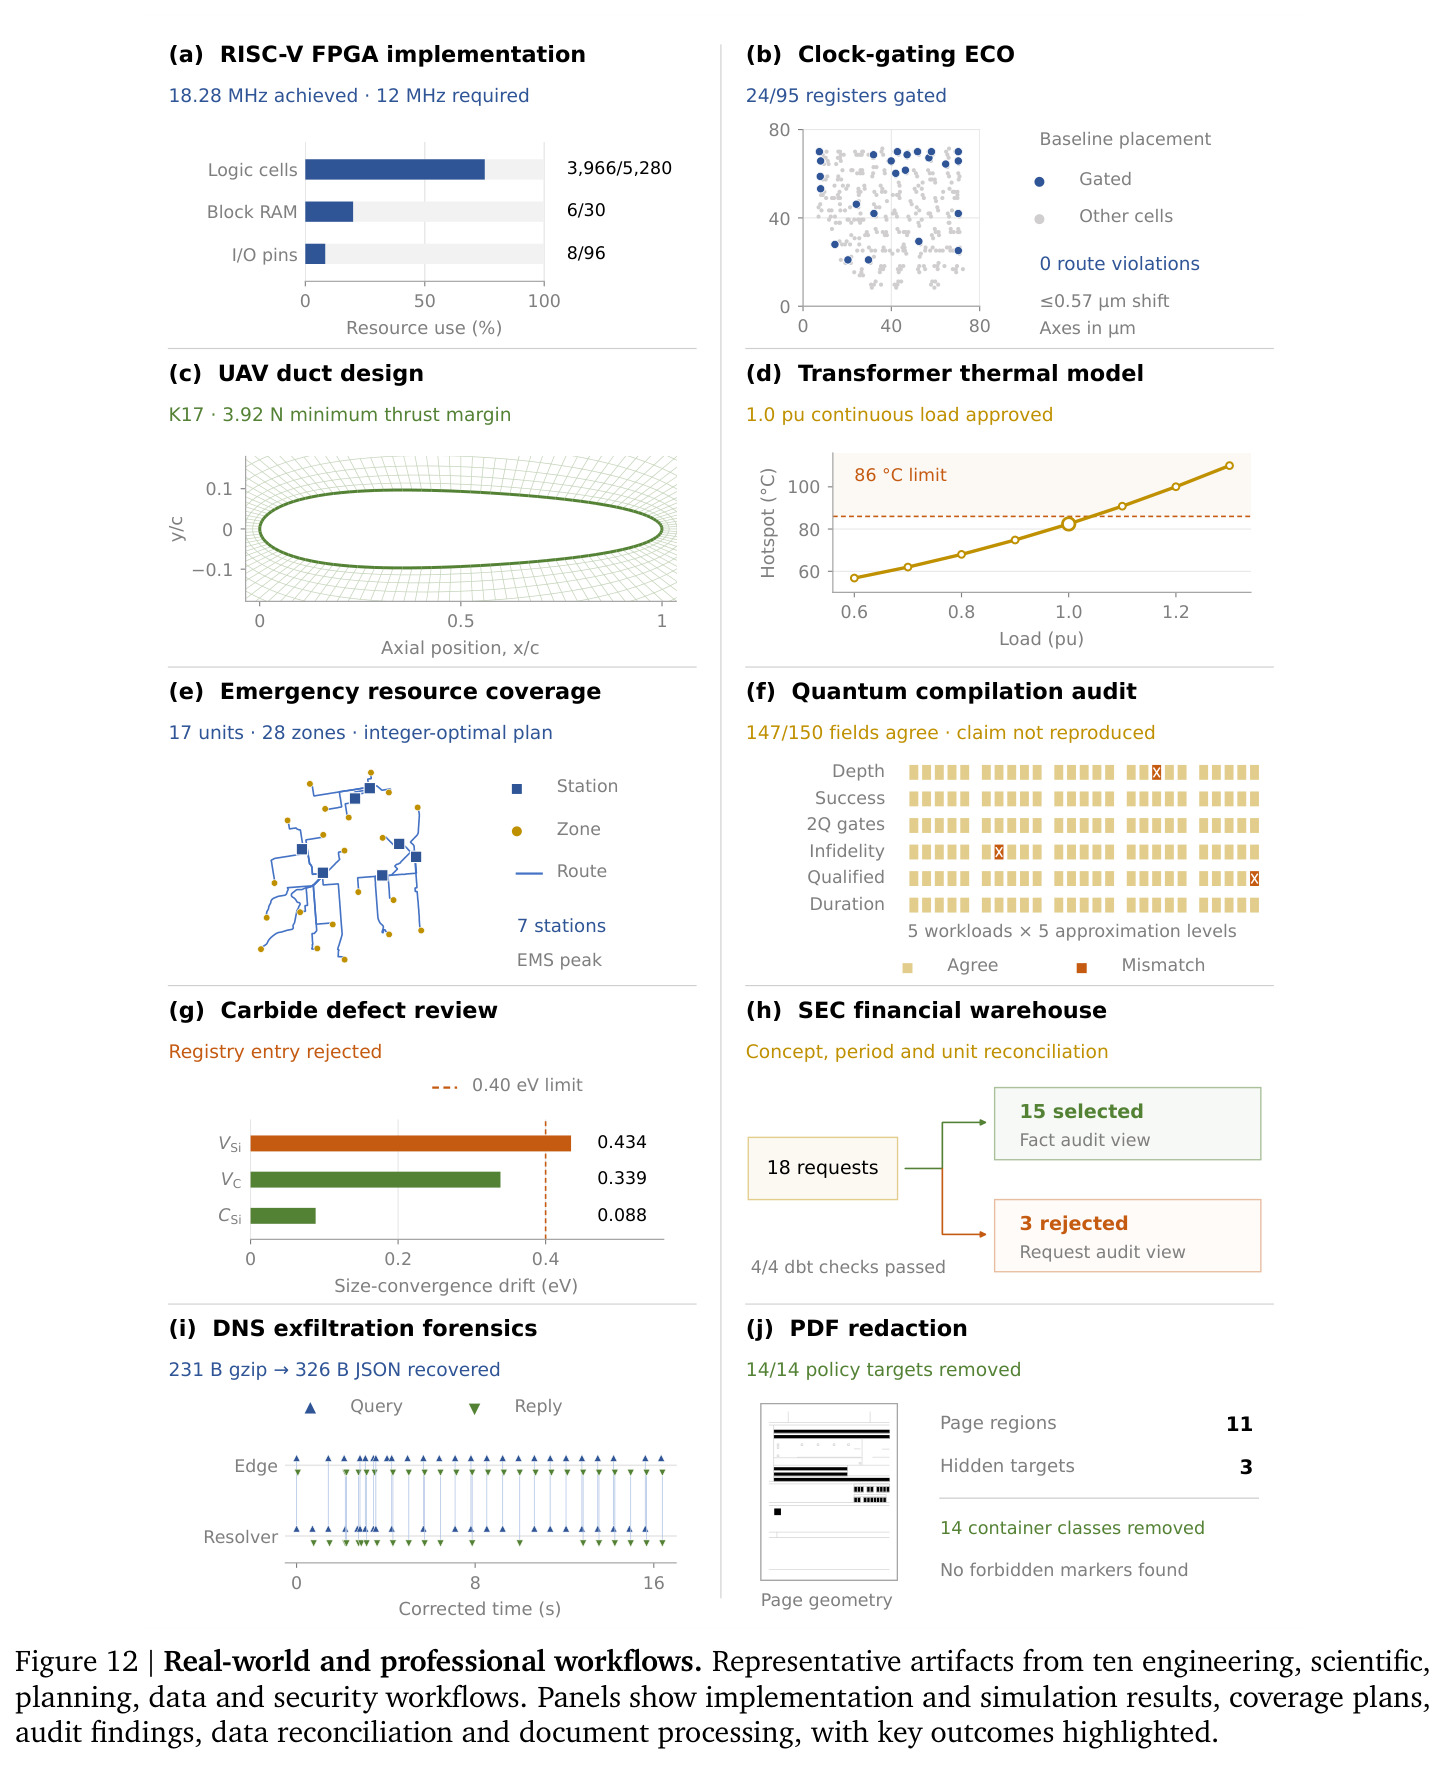
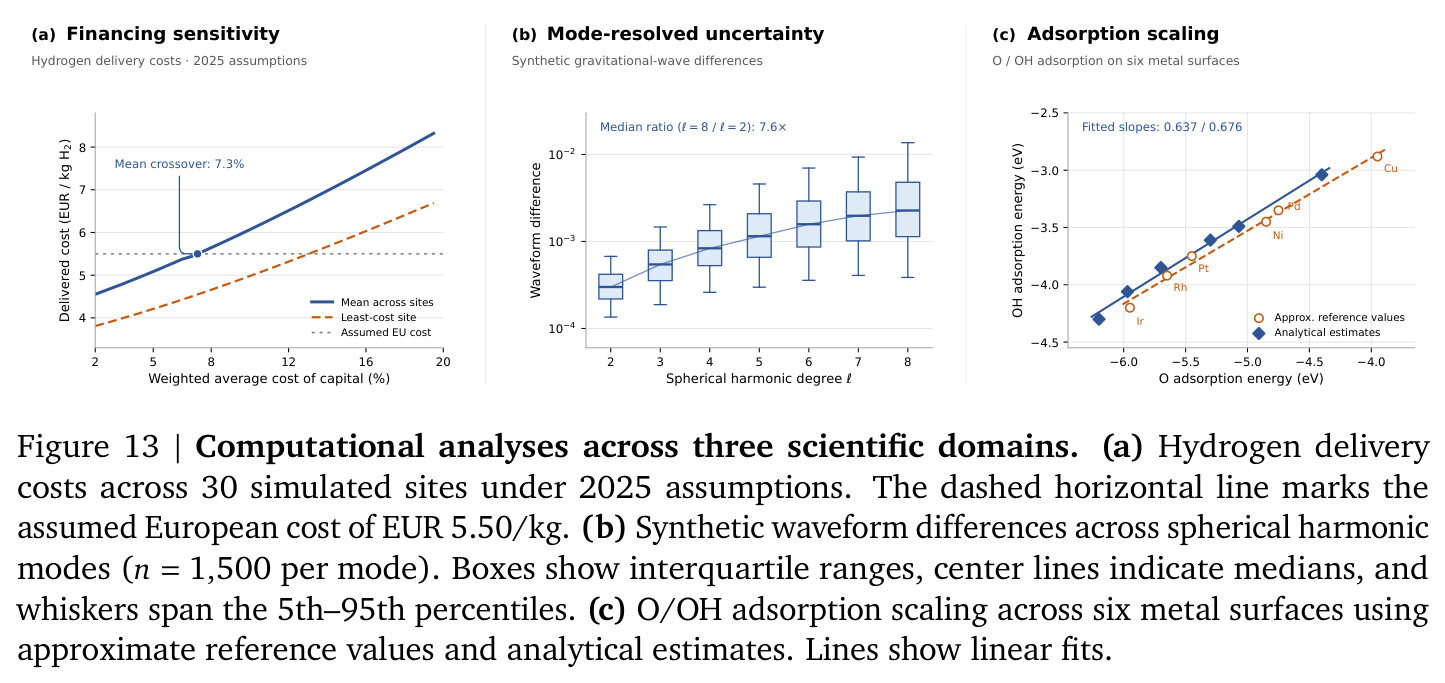
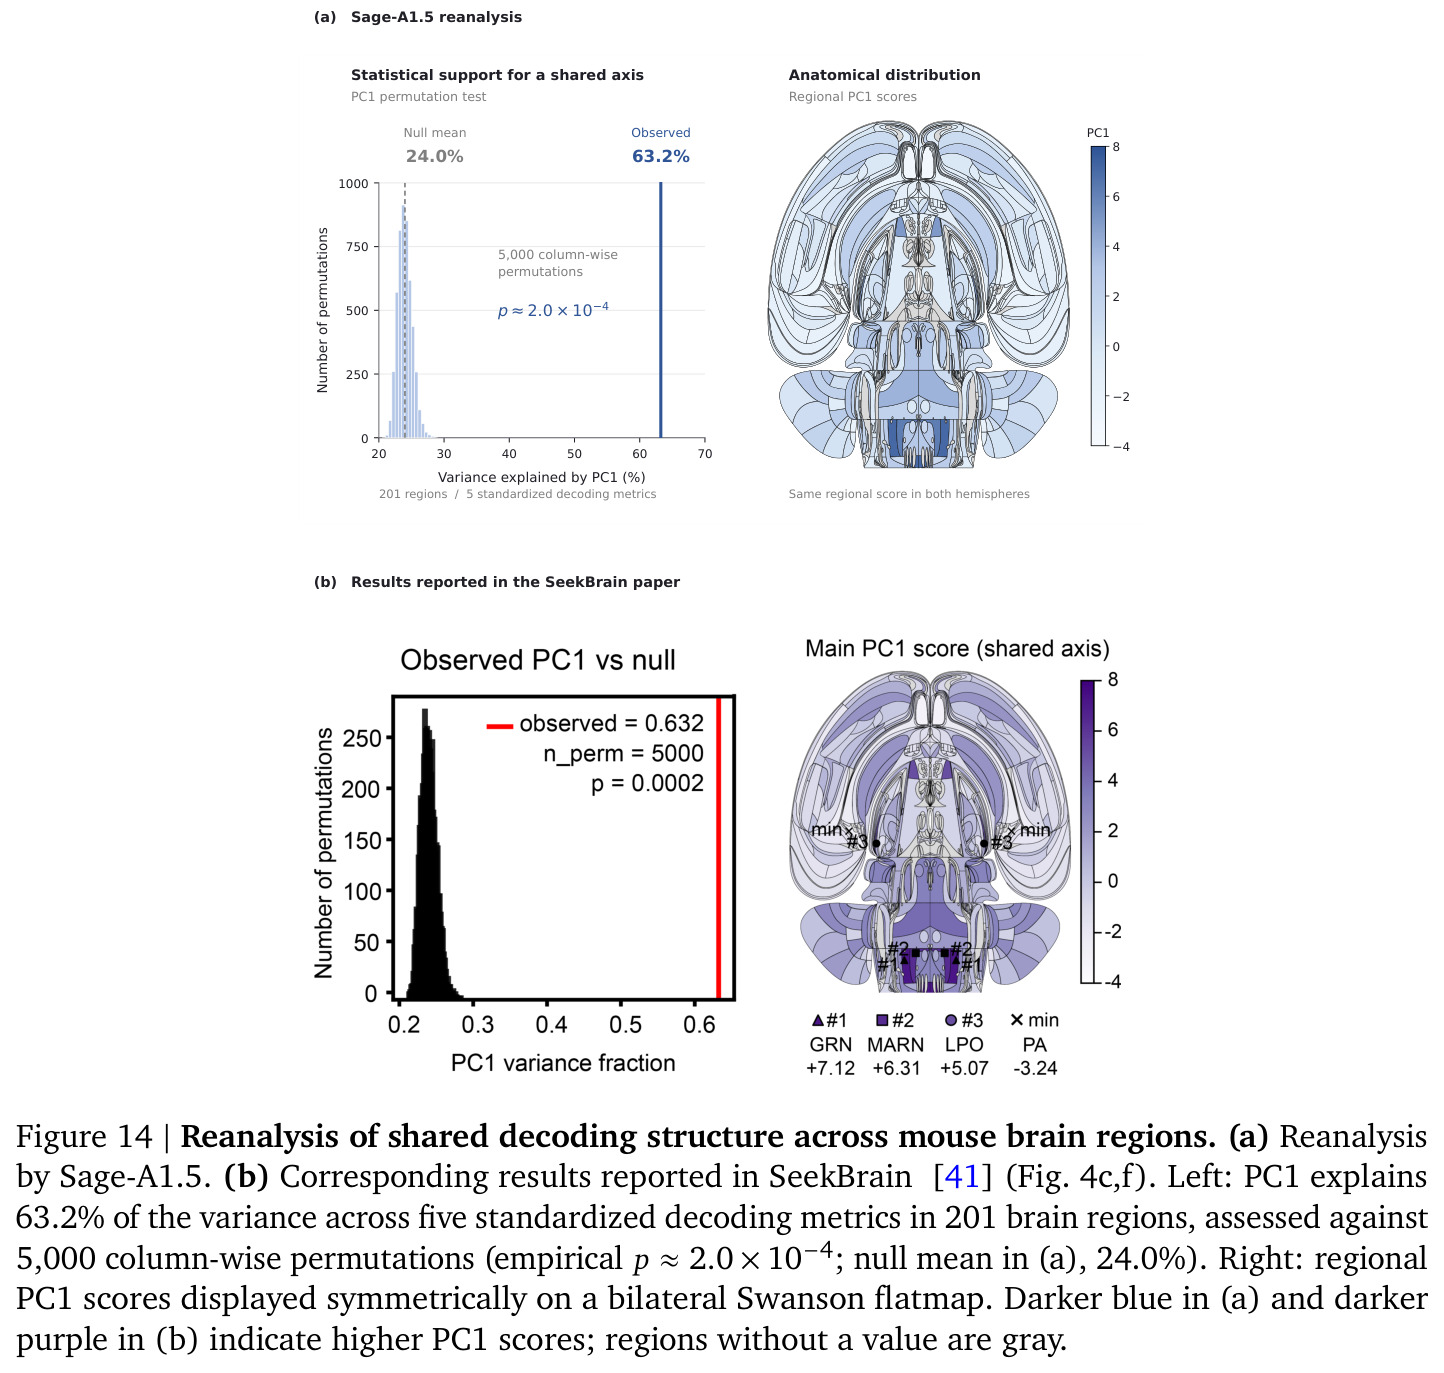
核心结果分四层。第一层,总榜(Table 1,22 个基准):Sage-A1.5 在全部 12 个基准上匹配或超过同规模的 Agents-A1(如 MLE-Bench-Lite 65.2 对 43.9、SWE-Bench Pro 61.2 对 43.6)和 Ornith-1.5,并在 FS-Olympiad 81.0、CMT 80.0、FS-R 48.3、PinchBench 90.0、IFBench 81.6 上超过更大的 Kimi-K3、GLM-5.3 与 GPT-5.6-sol——FS-R 比最强基线高 21.6 个百分点,CMT 高 30 个百分点。第二层,教师消融:科学教师把 Qwen3.5-35B-A3B 的 FS-R 从 2.5 提到 70.0、CMT 从 20.0 到 84.0、CritPt 从 0.9 到 25.7;搜索教师把 GAIA 从 59.8 提到 96.1;MLE 教师奖牌率从 37.9% 到 72.7%、金牌率翻倍至 50.0%。第三层,能力消融:开编排后 BrowseComp +1.1pp、DeepResearch Bench II +3.8pp;开验证后 BrowseComp 达 85.5(+4.5pp),且输出 token 从 23245 降到 21962(−5.52%)、轮次从 84.81 降到 82.14(−3.15%),验证反而降低成本。第四层,案例:50 频道研究以 6 批并行子代理耗 2.6M token(执行 1.2h、累计研究 6.7h)完成并纠正 StarPlus 归属错误;BrowseComp 多跳题第 20 轮自主验证、第 30 轮答出 Madhumati,基线 48 轮后答错;量子光学题修复数值代码复共轭错误,残差降至 $3.55\times10^{-15}$;神经科学重分析复现 SeekBrain(PC1 63.2%,$p\approx2.0\times10^{-4}$);化学工作流约 12 小时完成估计需人类一周的任务。
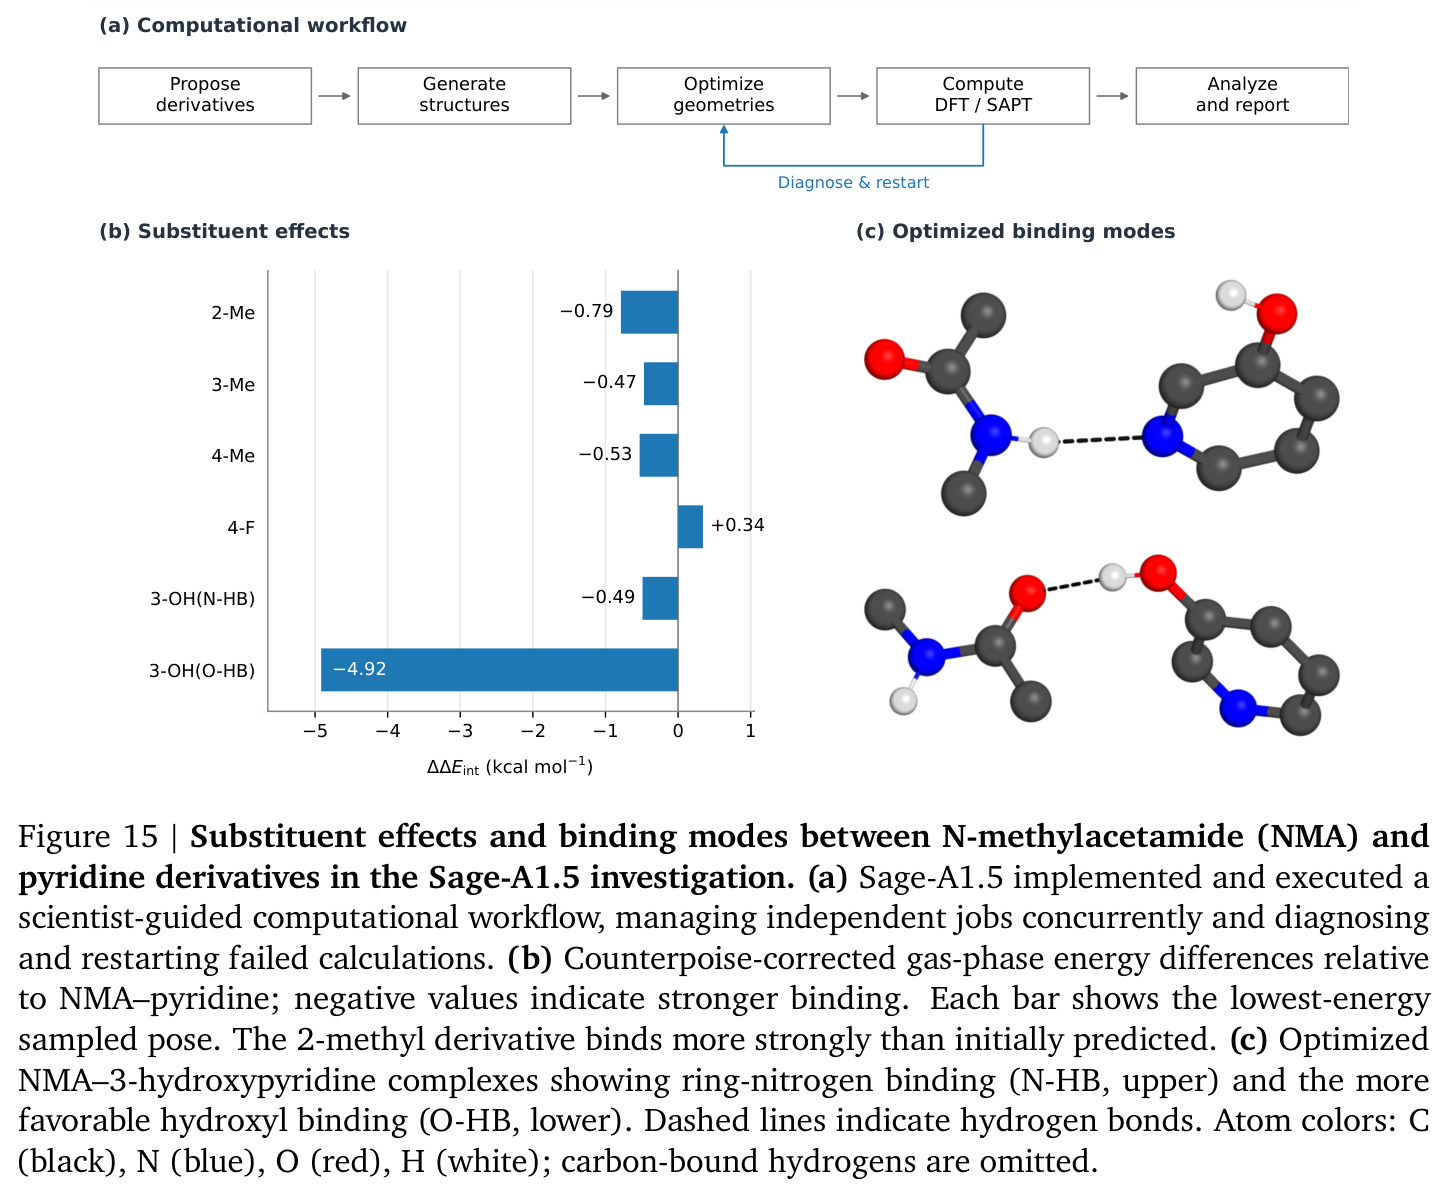
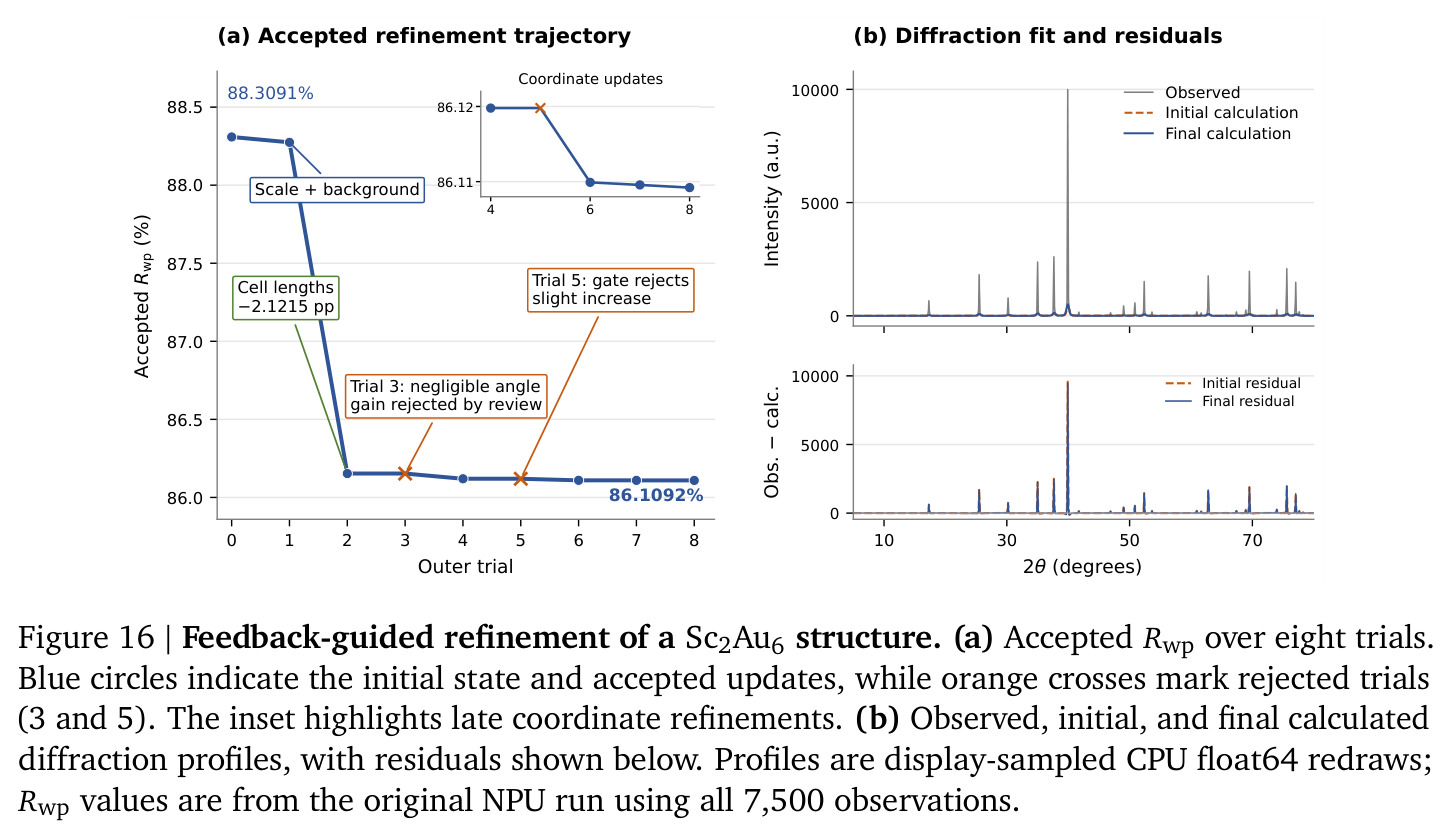
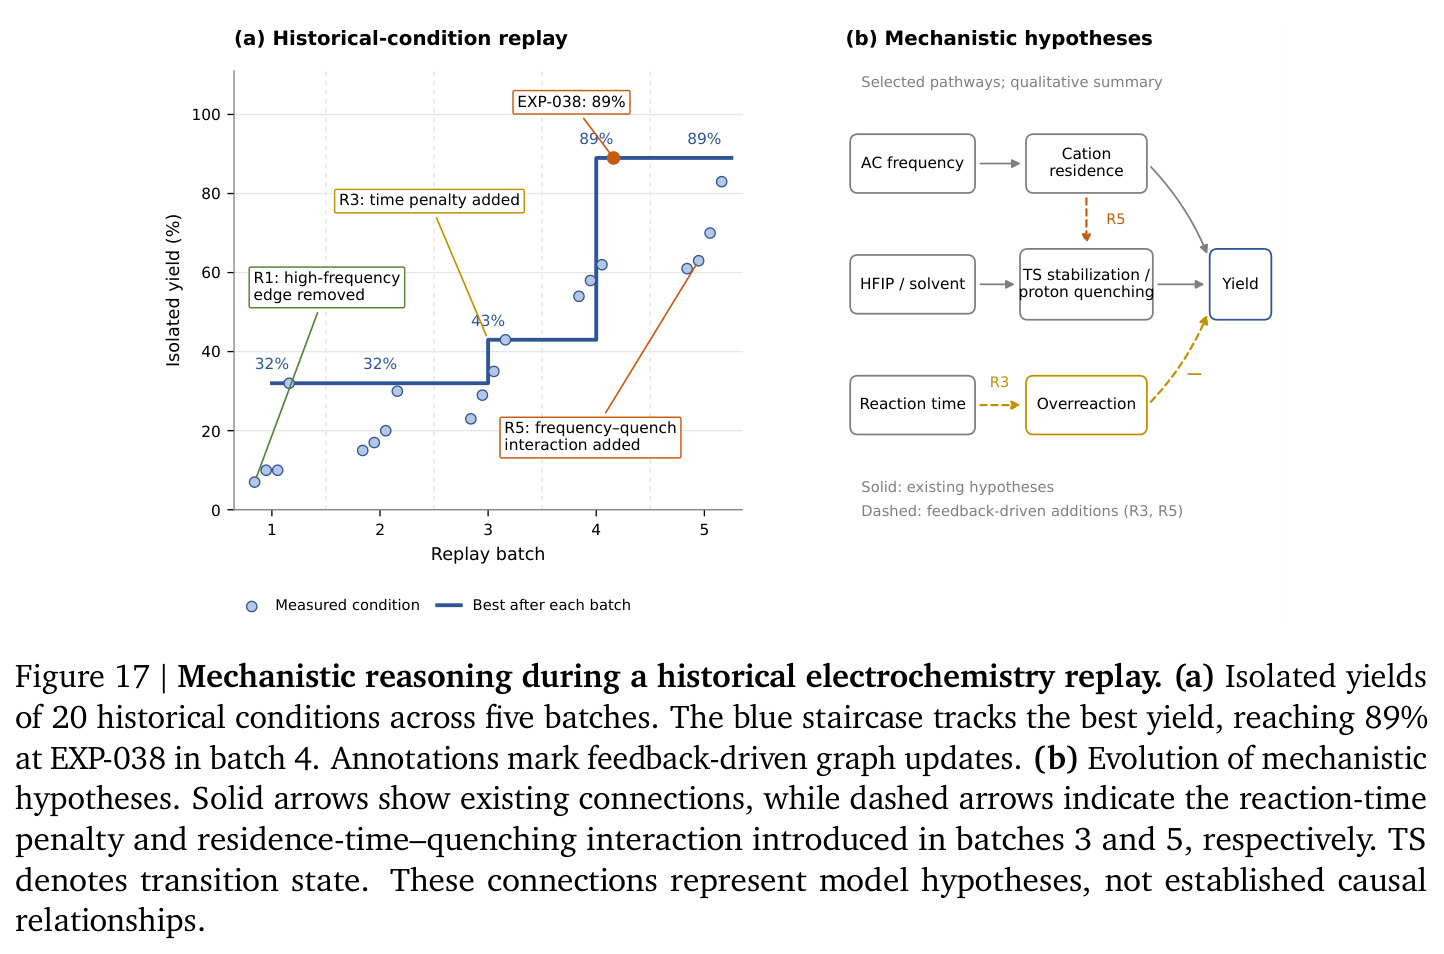
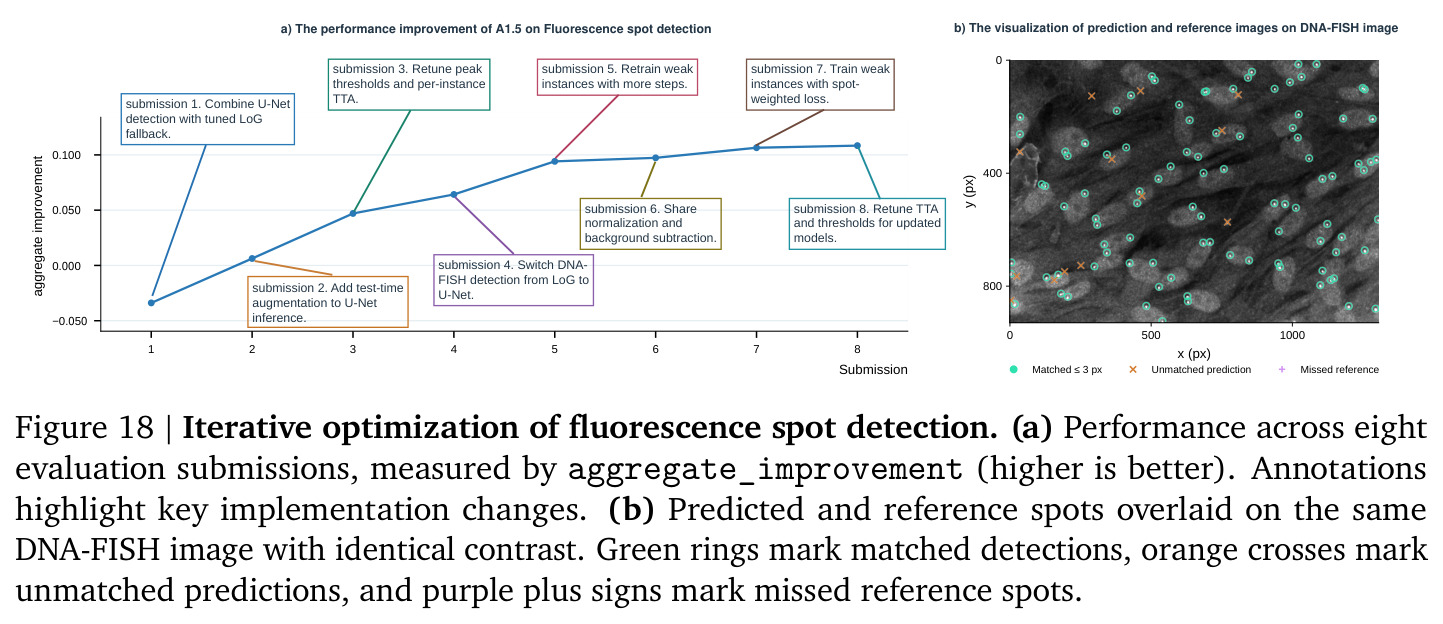
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FrontierScience-Research (FS-R) | 准确率 (%) | 48.3 | GPT-5.6-sol: 26.7;Agents-A1: 40.0 | 较最强基线 +21.6 pp |
| CMT 凝聚态理论基准 | 准确率 (%) | 80.0 | GPT-5.6-sol: 50.0;Agents-A1: 72.0 | 较最强基线 +30.0 pp |
| FS-Olympiad 多学科奥赛 | 准确率 (%) | 81.0 | Agents-A1: 79.0;GPT-5.6-sol: 73.0 | +2.0 / +8.0 pp,全场最高 |
| IFBench 指令遵循 | 严格提示级准确率 (%) | 81.6 | GPT-5.6-sol: 72.7;Agents-A1: 80.6 | 较最强基线 +8.9 pp,全场最高 |
| MLE-Bench-Lite | 铜牌及以上比例 (%),3 seeds | 65.2 | Agents-A1: 43.9;GPT-5.6-sol: 77.3 | 较同规模 +21.3 pp |
| SWE-Bench Pro | 解决率 (%) | 61.2 | Agents-A1: 43.6;GPT-5.6-sol: 64.6 | 较同规模 +17.6 pp,与闭源大模型接近 |
| BrowseComp | 准确率 (%) | 81.7(开编排 82.8,开验证 85.5) | Agents-A1: 75.5;Qwen3.5-35B-A3B: 61.0 | 较基座 +24.7 pp;验证模式再 +4.5 pp 且省 5.52% token |
| PinchBench | 得分 (%),5 次重复评测 | 90.0 | GPT-5.6-sol: 87.3;Agents-A1: 76.9 | 较最强基线 +2.7 pp,全场最高 |
局限与改进
作者明确承认三点:编排与验证的训练目前集中在搜索与研究综合任务上,超长轨迹仍会积累沉重的上下文开销;统一模型经联合后训练后未能完整保留各领域教师的峰值性能(如科学教师 CMT 84.0 对最终 80.0,编排教师 DeepResearch Bench II 53.6 对最终 47.5);科学展示仍停留在计算模拟与历史数据回放,未接入真实物理实验。我的补充观察:一是与顶级闭源模型的差距集中在通用专业工作流——ALE-CLI 仅 19.1% 对 GPT-5.6-sol 28.6%,SciCode 44.3% 对 GLM-5.3 59.0%,CritPt 20.0% 对 32.3%,说明蒸馏融合后在深度专业域折损明显;二是 HiPhO 45.3 与 GAIA 95.1 反而略低于 A1 的 46.4 与 96.0,提示统一训练存在轻微跨域干扰;三是验证消融只在 BrowseComp 一个基准上报告,编排收益也仅 1.1–3.8 个百分点,泛化性需要更强证据;四是 PXRD 案例的 $R_{wp}$ 仅从 88.31% 降到 86.11%,作者自己承认残余失配限制了结构性结论;五是与闭源模型的对比混用了原报告数字和自测数字,协议差异可能引入偏差。
独立分析的弱点
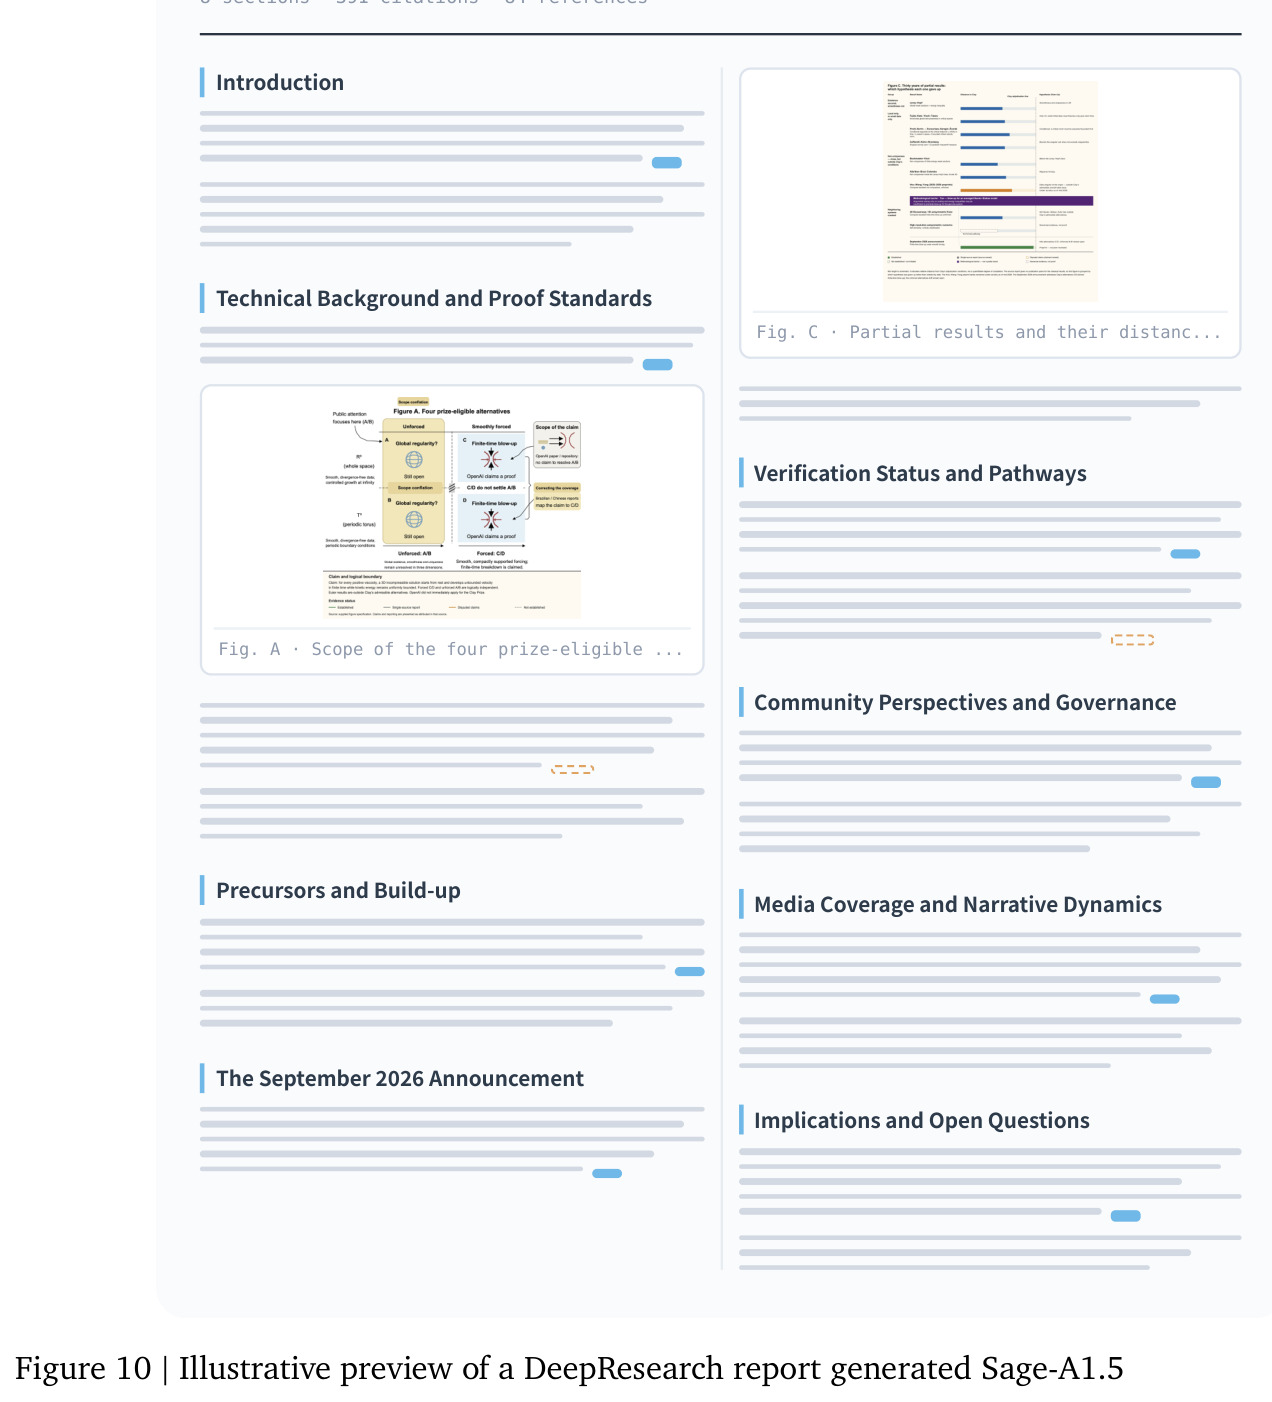
独立分析四个弱点。第一,编排的开销-收益比存疑:50 频道案例耗 2.6M token、累计 6.7 小时研究时间,而 BrowseComp 上编排只带来 1.1 个百分点提升;对小团队部署而言并行子代理成本可能超过收益,改进方向是训练'何时值得委派'的门控策略,只在预期收益高的子问题上触发并行。第二,验证触发时机分布可能偏窄:训练数据由监督模型固定在重复搜索、持续无进展、关键结论三类时刻插入反思,遇到训练分布外的停滞模式(如工具反复返回相同结果)未必触发验证,改进方向是把'验证时机选择'本身纳入 RL 奖励,让模型从任务结果反推何时该反思。第三,科学案例缺少可信度评估闭环:Navier-Stokes 报告有 391 条引用但无领域专家盲评,电化学回放是对历史数据的事后拟合(作者也声明 89% 条件的关联非因果),这些案例展示了流程能力而非科研上限,改进方向是引入前瞻性实验设计评测——让模型先预测实验结果再与实测对照。第四,教师融合存在不可逆损失:科学教师 CMT 84.0 统一后掉到 80.0,SciCode、ChemCoTBench、ALE-CLI 等基准落后闭源对手 10 个百分点以上,改进方向是按域路由的专家保留机制,或在统一训练中对教师性能落差加显式惩罚。
未来方向
作者在第五节提出三个方向:一是把中间验证点用作上下文压缩的自然边界——每次反思后由模型自主判断前段探索史能否折叠成简短的阶段记录,且只压缩最近两个验证点之间的片段以避免重复压缩,在保留关键证据、被否决假设与任务状态的同时控制上下文开销,支撑更长程的研究任务;二是把学到的编排能力从搜索与研究综合扩展到更广的工程工作流,同时降低跨域蒸馏损失;三是与科学家合作把 Sage-A1.5 连接到真实世界的实验验证,让自动科研从计算模拟与历史回放走向主动实验闭环。基于本文成果还可延伸四个方向:其一,把结构化子代理反馈协议(五档状态加证据溯源)标准化为智能体间通用接口,推动可组合的多智能体生态;其二,WIRL 的窗口奖励机制可推广到一切'多轮交互后才有稀疏结果'的领域,如实验设计优化、临床方案搜索;其三,本地部署路线(FP8/4-bit 量化加异构硬件支持)与数据不出域的智能体工作流结合,可发展医疗、金融、企业研发等隐私敏感场景的科研助手;其四,验证点驱动的上下文管理与编排相结合,有望把有效任务 horizon 从当前数十万 token 量级再推一个数量级。
复现评估
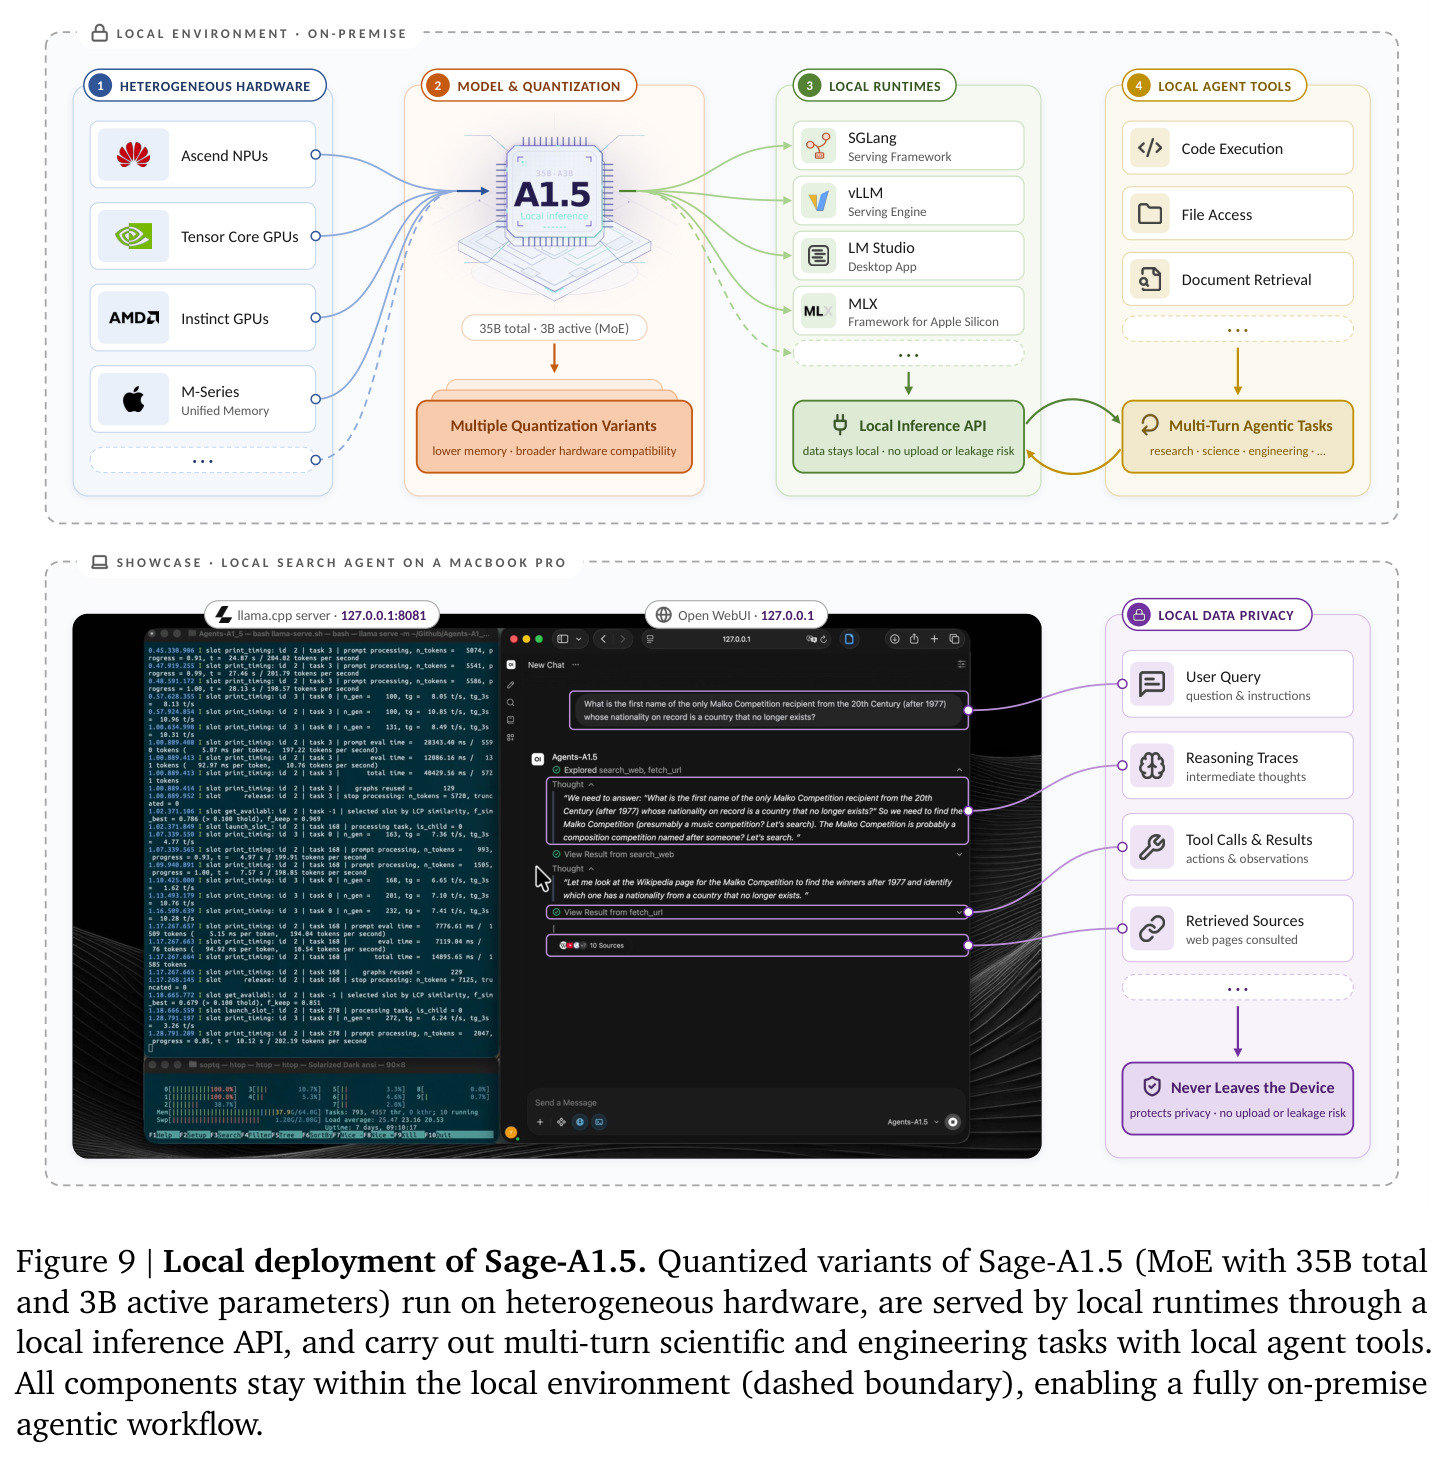
复现条件总体友好但训练侧门槛高。开源情况:报告首页给出 Homepage、Token-plan(权重发布计划)与 Model 三个链接;模型以 35B-A3B MoE 发布并提供 FP8 与 4-bit 量化变体,可在华为 Ascend 910B/910C、NVIDIA A100/H100/H200/B200 与 RTX 系列、AMD MI300X 及 Apple M 系列上运行,LM Studio、llama.cpp、MLX 等本地运行时即可起服务,论文还展示了 MacBook Pro 上的全本地搜索代理。数据与协议:评测设置写得相当细(各基准的工具配置、BrowseComp 超 300 次工具调用或触顶后重跑至多 5 轮的上下文管理、token 预算与评分方式);案例涉及的公开数据(IBL 小鼠决策数据集、SEC Companyfacts、历史 Kaggle 竞赛、Psi4 量子化学)大多可获取;但训练数据——数亿监督 token、1000+ 演化环境、3512 道长上下文难题——未逐一开源,重建数据管线需要大量工程投入与教师模型调用费用。算力:推理复现单张 24GB 级消费卡(4-bit)即可起步;MLE-Bench-Lite 评测需每任务一张 H200 跑 12 小时;完整训练需大规模集群,论文未披露 GPU 时数。综合判断:推理与案例复现难度中等,训练与数据管线复现难度高。
论文图表