Sage-Taiyi:面向科学发现的元认知架构 Sage-Taiyi: A Metacognitive Architecture for Scientific Discovery
用元认知的监控-控制回路积累科学理解,指导科研搜索该查什么、怎么查。
前置知识
元认知与监控-控制模型(Nelson & Narens)
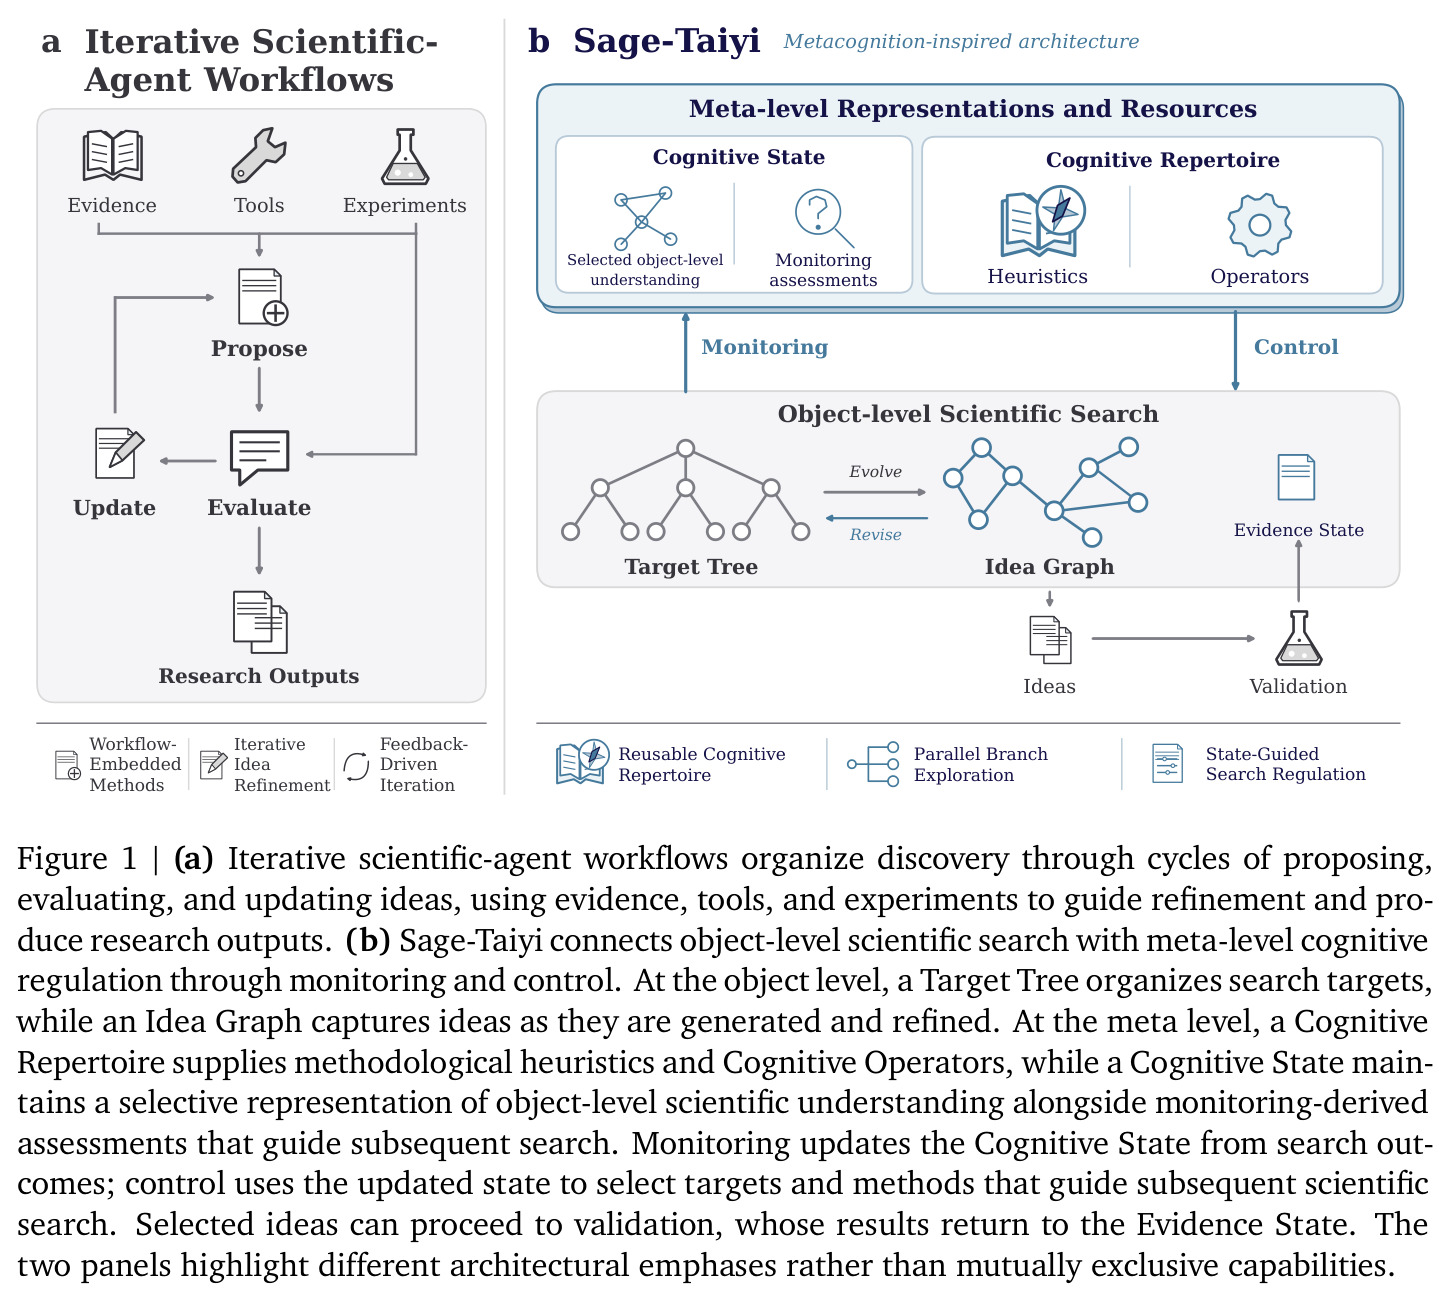
元认知即“对思维的思维”:对自己认知过程的监控与调节。Nelson 和 Narens 把认知系统分为对象层(执行任务本身)与元层(维护对象层认知的动态模型)。监控负责解读搜索进展并更新评估,控制则依据评估决定下一步做什么、是否转向以及用什么方法。
Sage-Taiyi 整个架构直接以此模型为蓝本:Cognitive State 就是元层的动态模型,Monitoring/Control 是其工程化实现,不理解元认知就看不懂方法部分的动机与术语。
问题空间理论(表示、算子、启发式)
Newell 和 Simon 将问题求解建模为在问题空间中的搜索:知识状态、把一个状态局部变换为另一状态的算子,以及引导搜索方向的启发式。科学发现被视为在假设空间与实验空间之间往返移动、逐步变换知识状态的过程。
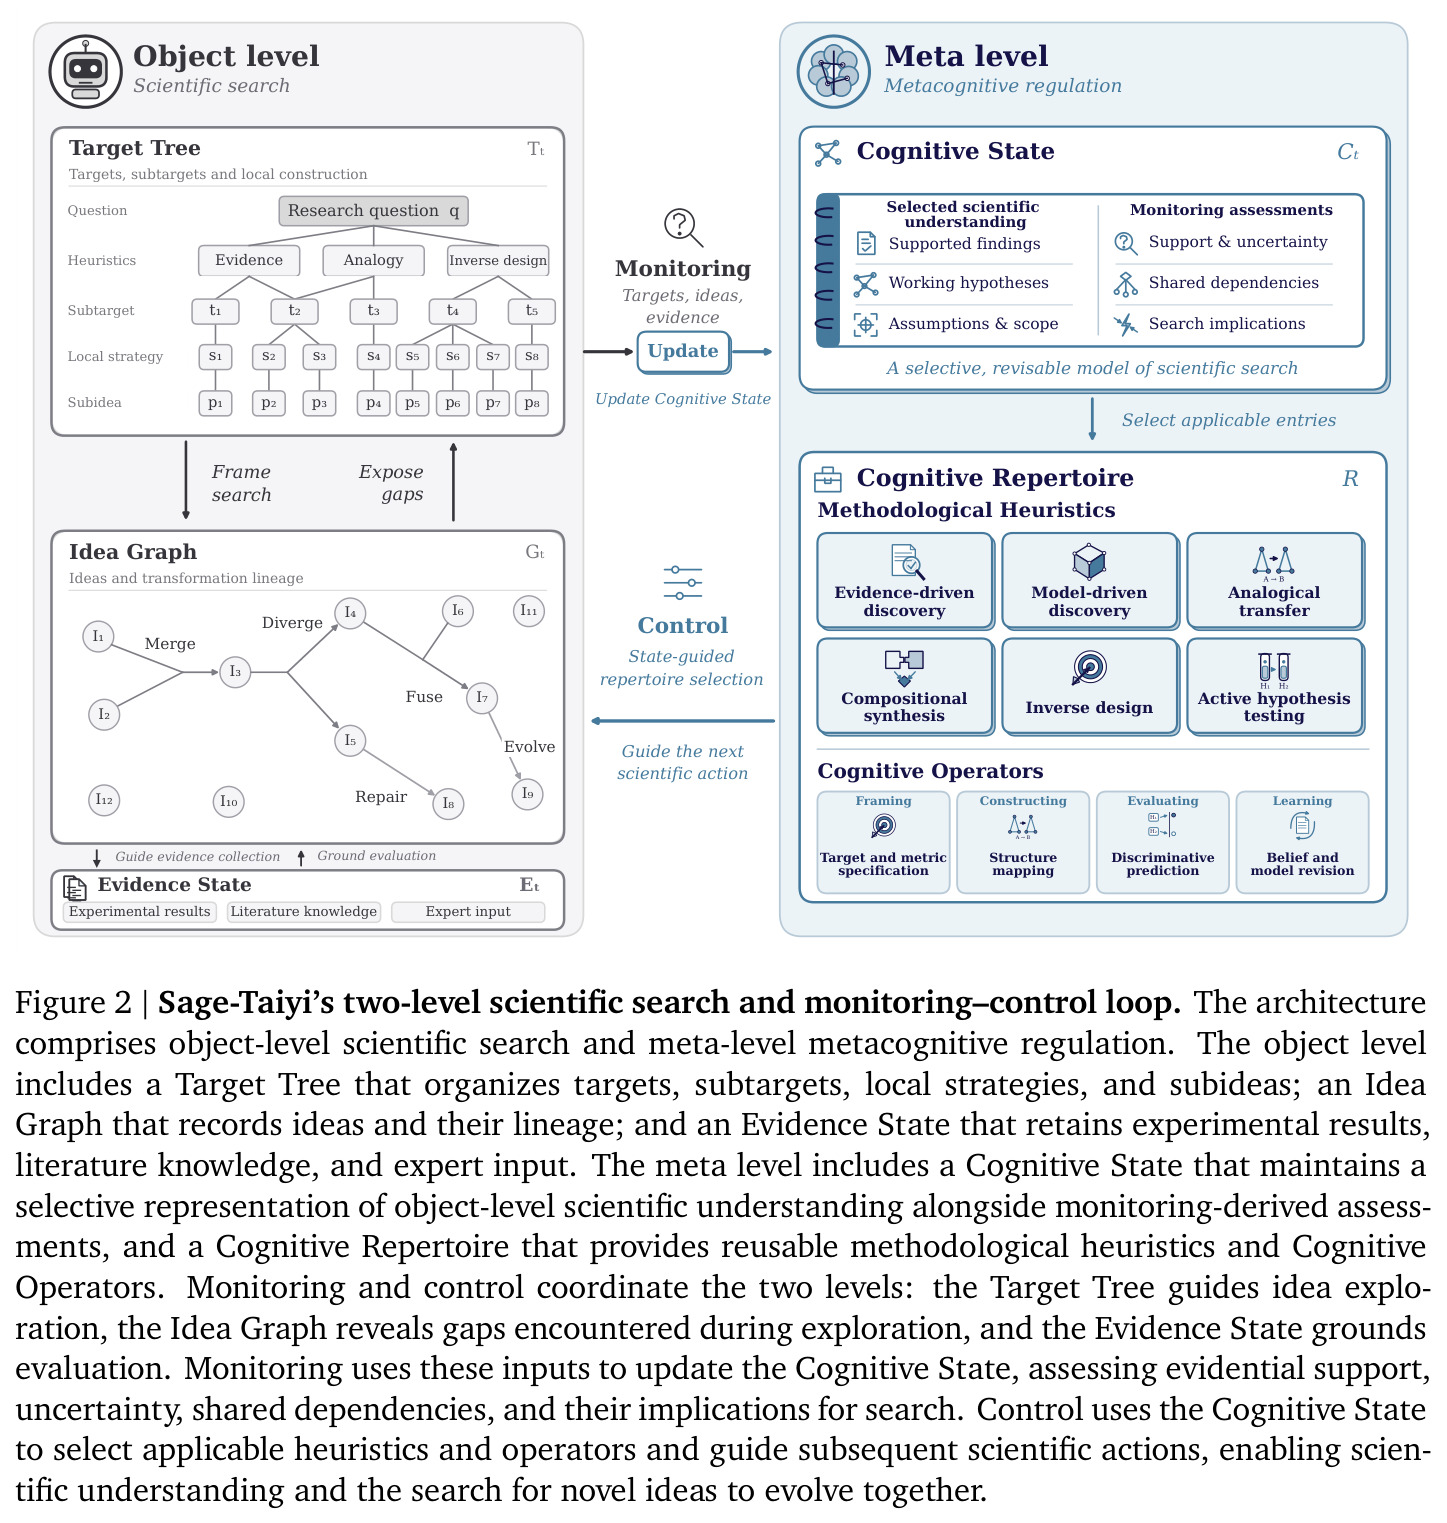
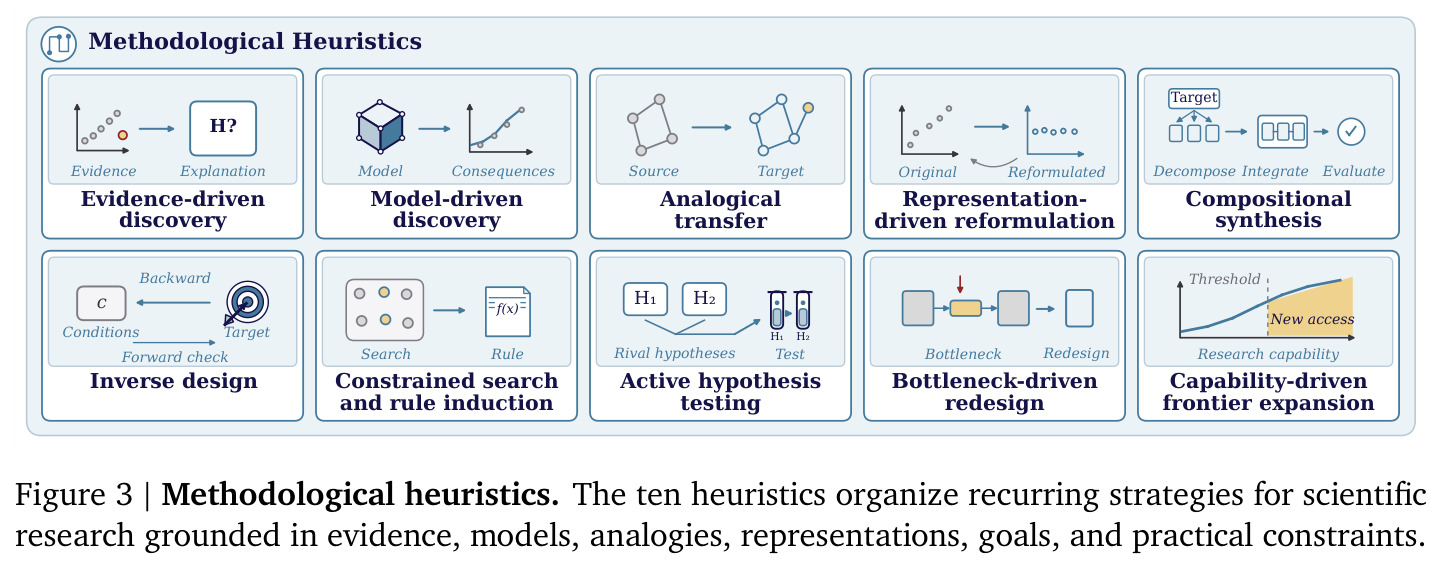
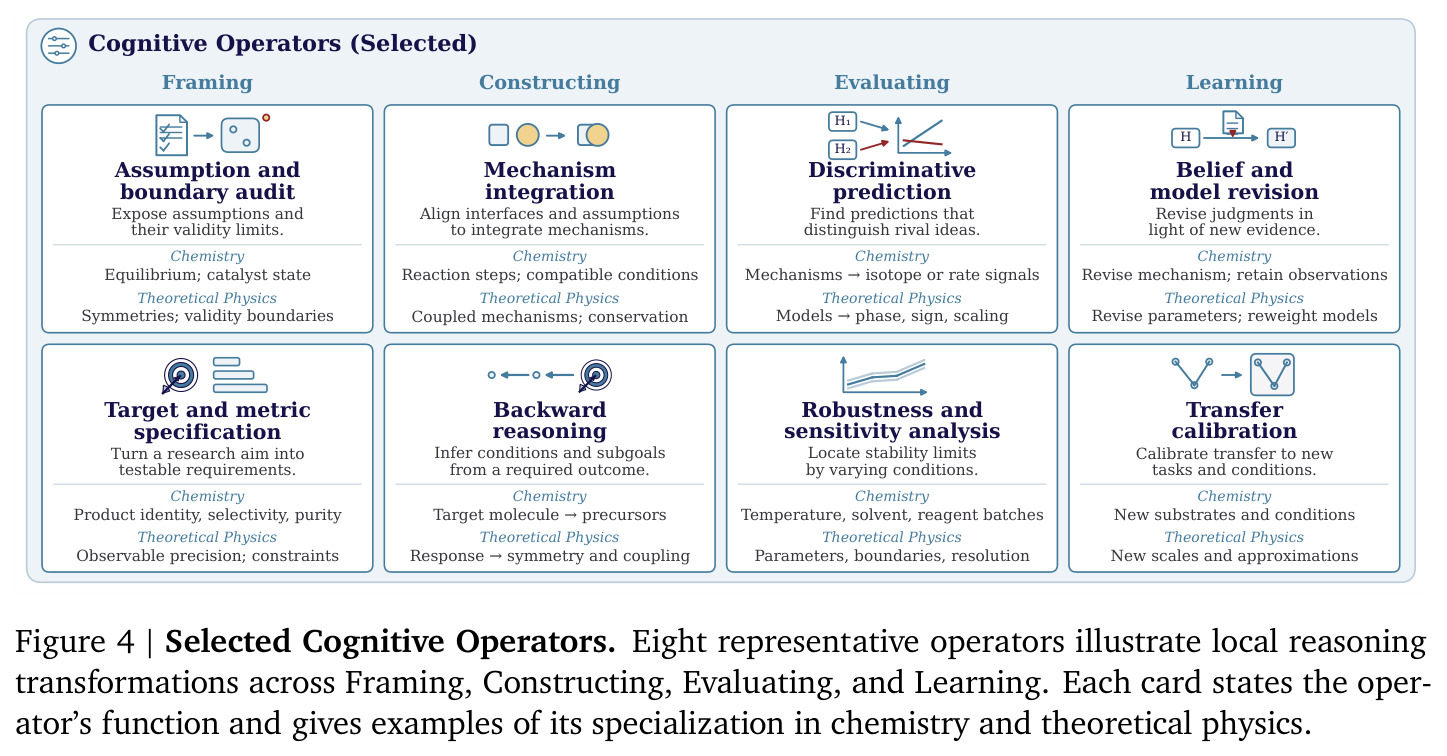
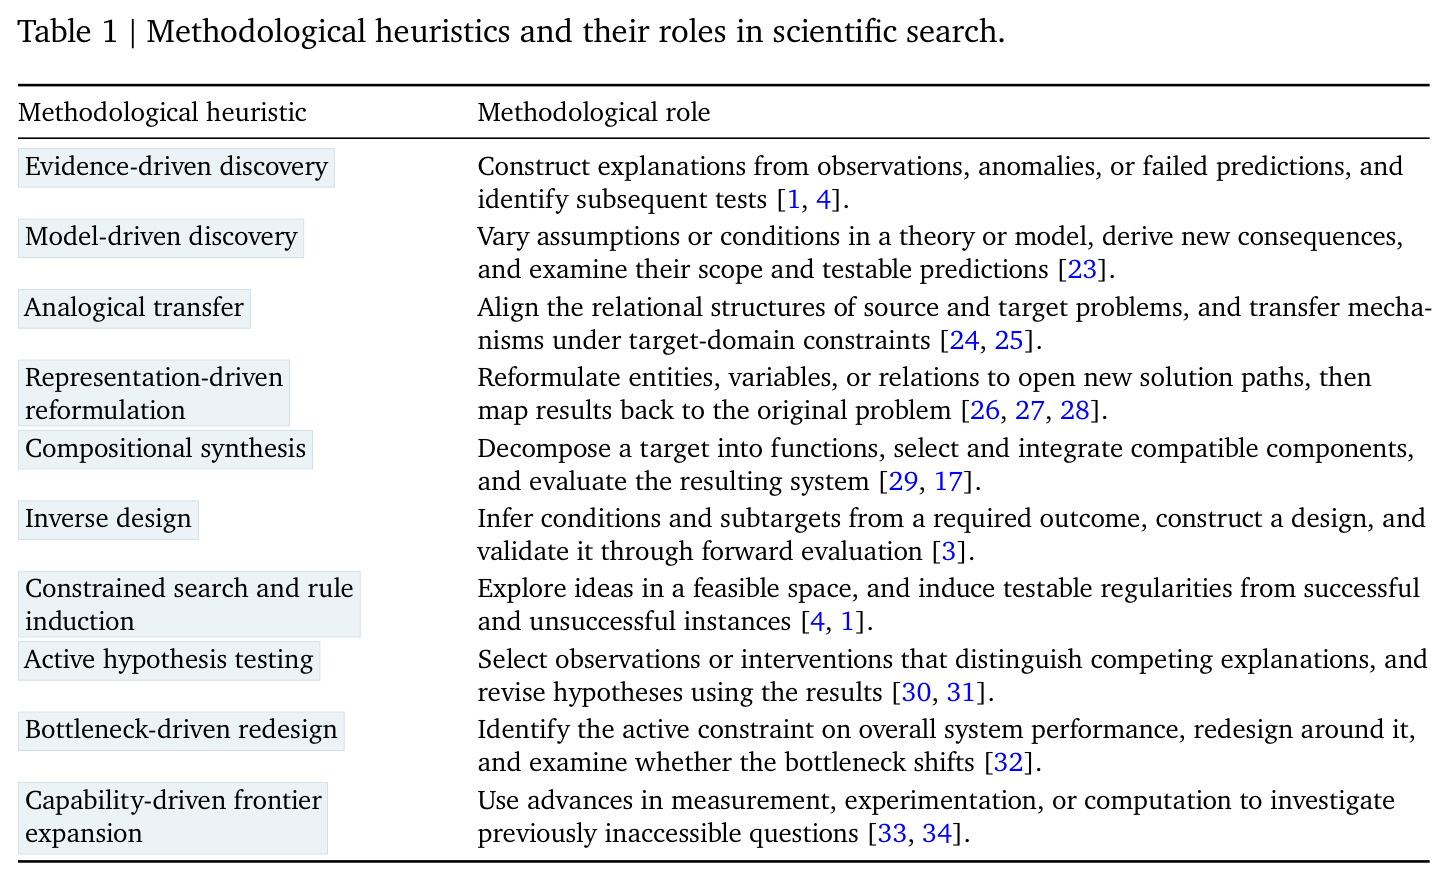
论文中的 Target Tree、Idea Graph、Cognitive Operators(Framing/Constructing/Evaluating/Learning 四类)与十条方法启发式,都是这套术语的工程化落地。
AI co-scientist 与科学构思(ideation)
指能自主完成文献调研、假设生成、实验设计乃至验证的 AI 科研系统。“构思”特指提出完整、可检验研究方案的阶段(机制、支撑文献、约束、可检验推论),区别于执行实验与撰写论文。AI Scientist、Co-Scientist、Robin 都是这一方向的代表。
Taiyi-Bench、AgentIdeaBench、IG-Arena 三个基准评测的都是构思能力,理解评测对象才能读懂实验设计为何逐层披露决策、为何要求每任务给出 K=10 个想法。
贝叶斯优化
一种样本高效的全局优化方法:用高斯过程等代理模型拟合已观测的(参数,目标值)数据,通过采集函数决定下一个评估点,逐步逼近最优。特别适合每次评估昂贵的场景,如湿法化学实验、电磁仿真与 CFD 计算。
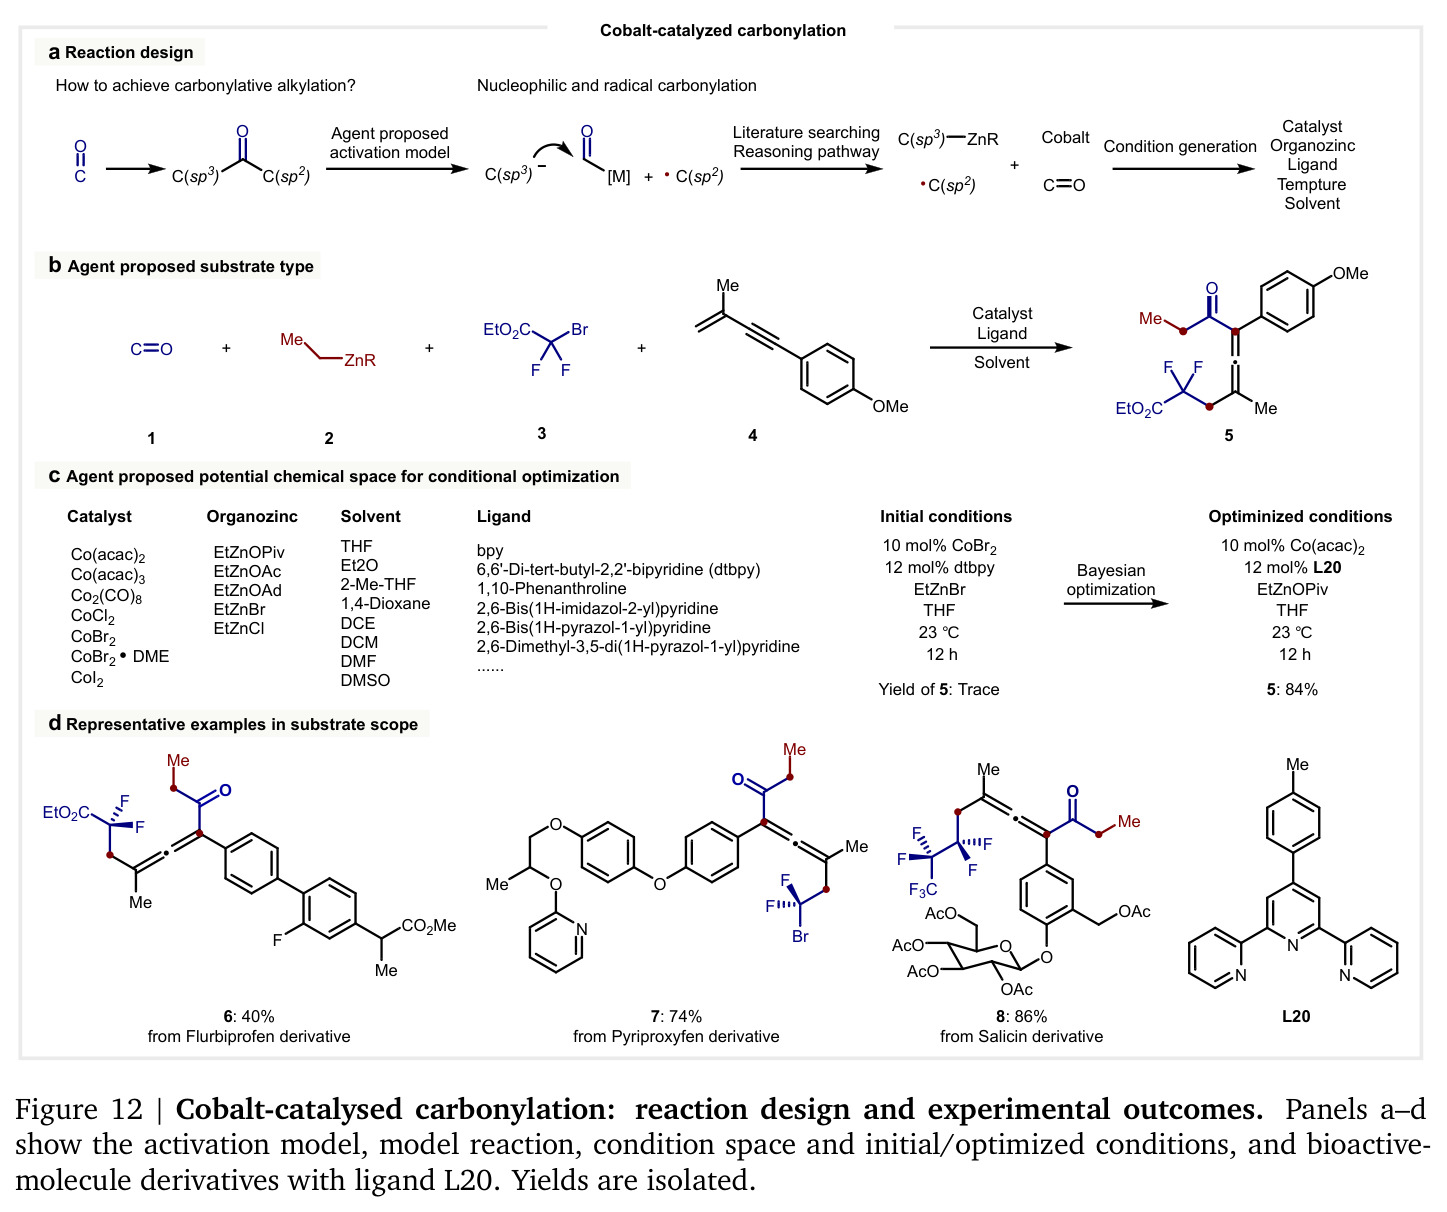
五个真实案例中 Taiyi-Optimizer 都以贝叶斯优化在条件/设计空间迭代搜索,钴催化羰基化产率从 trace 到 84% 的提升正来自该优化回路与合理的条件空间定义。
ELO 等级分与 Bradley–Terry 模型
源自国际象棋的等级分体系:用 Bradley–Terry 概率模型把成对胜负记录拟合为每个系统的标量评分,分差越大预期胜率越高,可将海量两两比较汇总为统一排名。
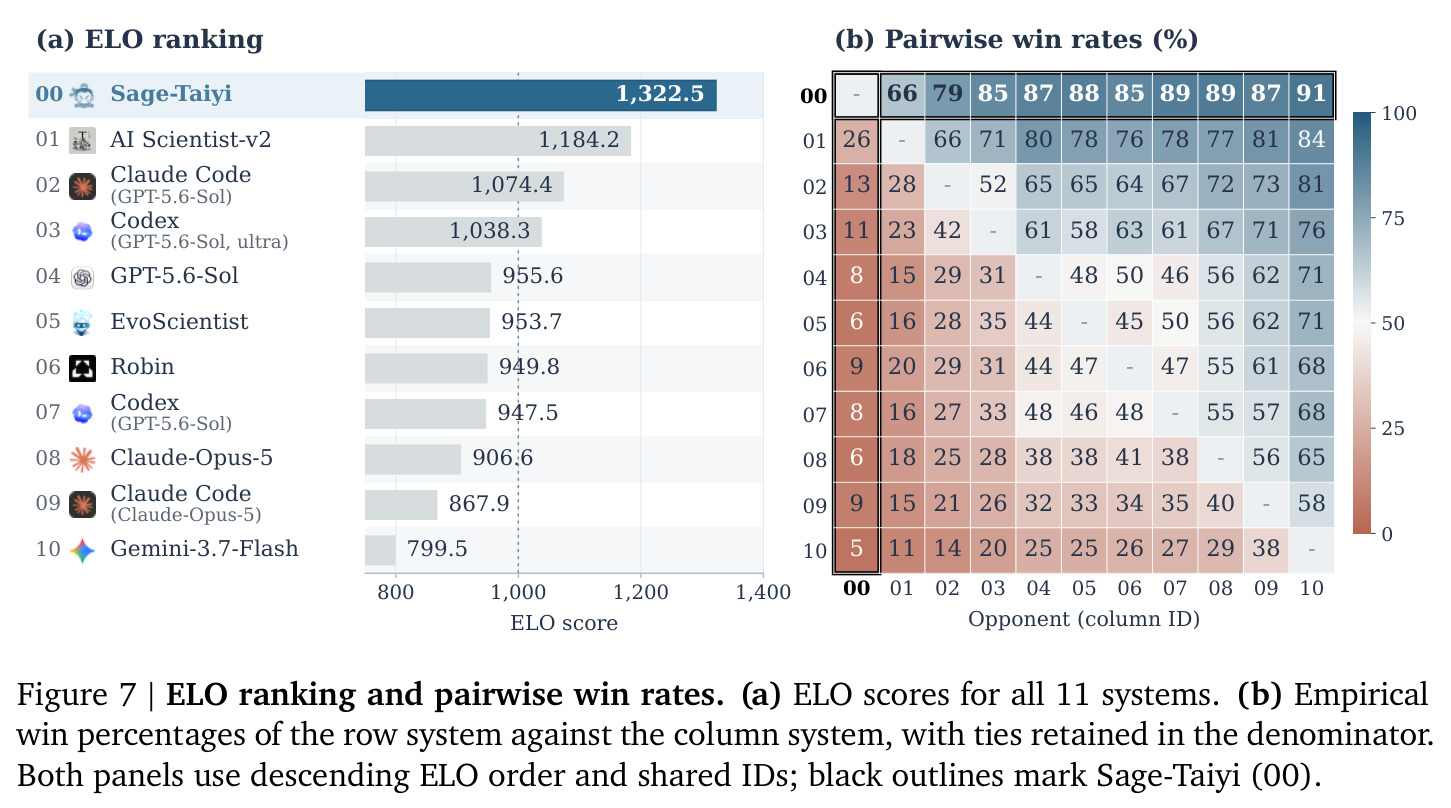
Taiyi-Bench 用任务级成对比较的 ELO 排名(Sage-Taiyi 1322.5 分)佐证总分领先,Figure 7 的胜率矩阵需要这一背景才能正确解读。
有向无环图(DAG)
一种不含环路的有向图,节点依赖关系呈单向层级。Taiyi-Bench 把一篇论文的关键科学决策及其前置条件重建为 DAG,再按信息层级 $L_0$–$L_8$ 逐层披露已确立的决策来构造任务。
Rediscovery 的三项指标(Exact/Coverage/Lookahead)都围绕“恢复 DAG 中的节点”定义,且要求必要前置条件在同一提案内被披露或建立,不懂 DAG 就无法理解指标含义。
研究动机
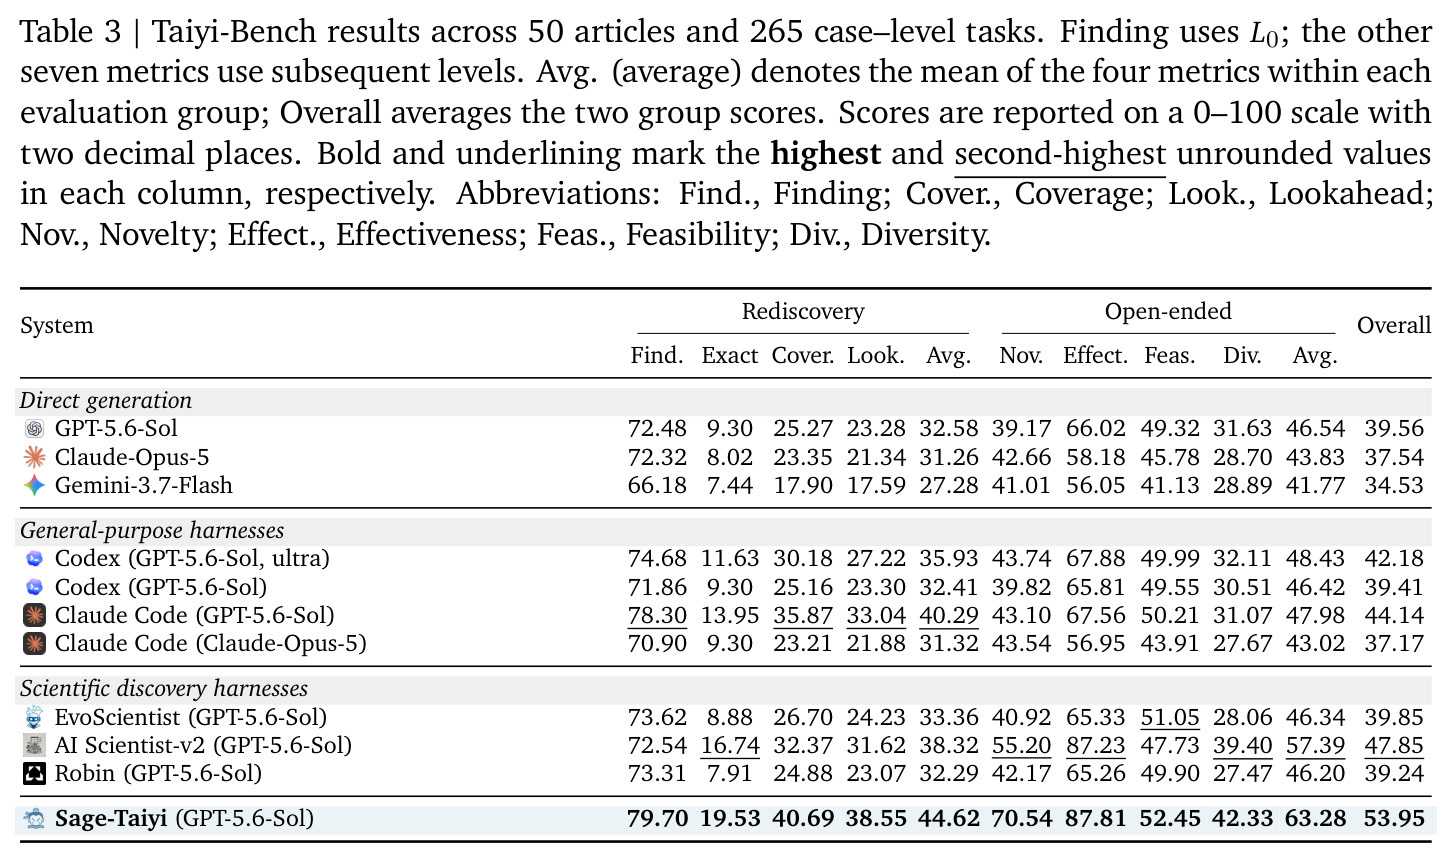
现有 AI 科学家系统(AI Scientist、Co-Scientist、Robin 等)已把一次性想法生成扩展为迭代式科研工作流,但论文指出迭代本身并不保证学习被保留:其一,不同搜索分支得到的发现往往不连同其证据和适用条件一起被保留,早期失败、未解决的矛盾和跨分支的共享依赖被遗忘,导致重复犯错或沿无效路径继续搜索;其二,搜索过度响应最近一轮的反馈,难以及时识别关键不确定性或“该换目标、换表征、换方法”的信号。实测数据印证了缺口:在 Taiyi-Bench 上,直接生成的 GPT-5.6-Sol 的 Exact 分仅 9.30、Coverage 25.27、Novelty 39.17;即便最强的迭代系统 AI Scientist-v2,Overall 也只有 47.85(0–100 分制),Exact 仅 16.74,说明“把任务约束、机制与后续设计决策连成有支撑的完整研究路线”以及“提出超越文献的新颖机制”仍有明显不足。
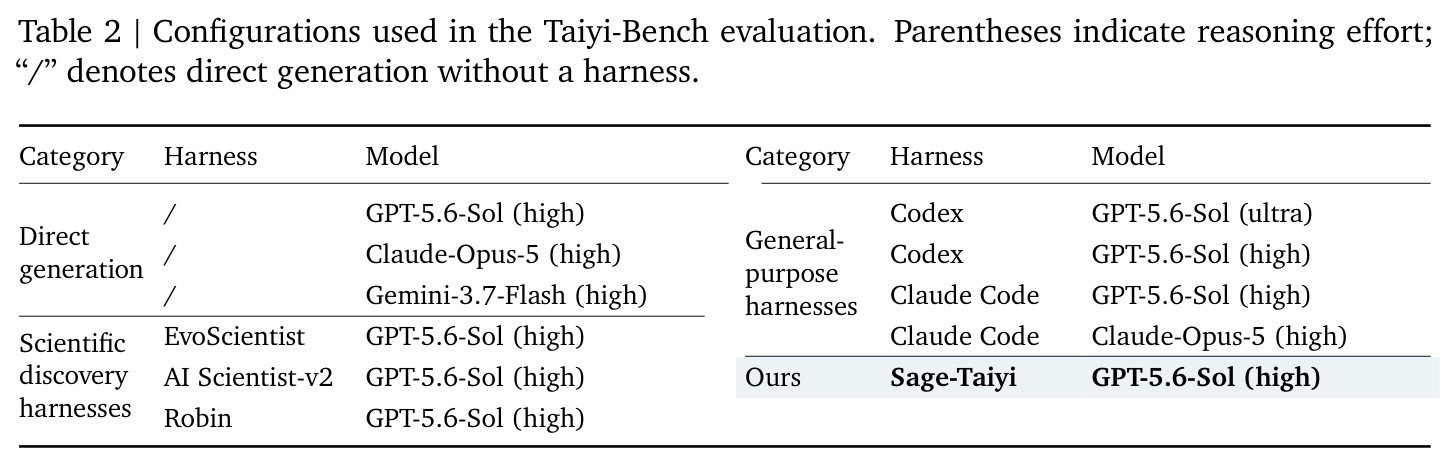
本文的目标是本文要构建一个以“积累的科学理解”为指导的科研智能体架构:显式监控系统对证据、假设与未决问题的理解,并利用这些评估去调整研究目标、选择可复用的推理方法,即决定“接下来研究什么”和“怎么研究”。在构思质量之外,还要把提出的想法接入真实的实验与仿真验证,形成从想法到产率、强度、效率等可测量指标提升的闭环。可量化的目标是在 Taiyi-Bench(50 篇论文、10 学科、265 个任务、8 项指标)上全面超越十种基线配置(含直接生成、通用编码 harness 和三类科学发现框架),并在 AgentIdeaBench、IG-Arena 两个外部基准以及五个专家合作的真实课题(金属催化、光化学、超材料、镁合金、压缩机)上验证有效性。
与已有工作不同的是,独特切入角度是把认知科学中的元认知理论(Nelson & Narens 的对象层/元层、监控与控制)作为架构设计的功能蓝本,而不是继续堆叠“提出-评审-修改”的迭代循环。与 Reflexion 等把反馈存为文字反思的做法不同,Sage-Taiyi 显式区分对象层搜索状态 $X_t=(T_t,G_t,E_t)$ 与元层资源 $(C_t,\mathcal{R})$:元层的 Cognitive State $C_t$ 选择性地保留关键发现、竞争解释、必要假设、适用条件与未决问题,并特别记录“多个想法共享同一未检验前提”这类跨分支依赖——这正是现有系统忽略的部分;同时用可复用的 Cognitive Repertoire $\mathcal{R}$(十条方法启发式加按功能组织的认知算子)把“选择什么推理方法”变成显式的元层决策,而非隐式交给 LLM 即兴发挥。
核心方法
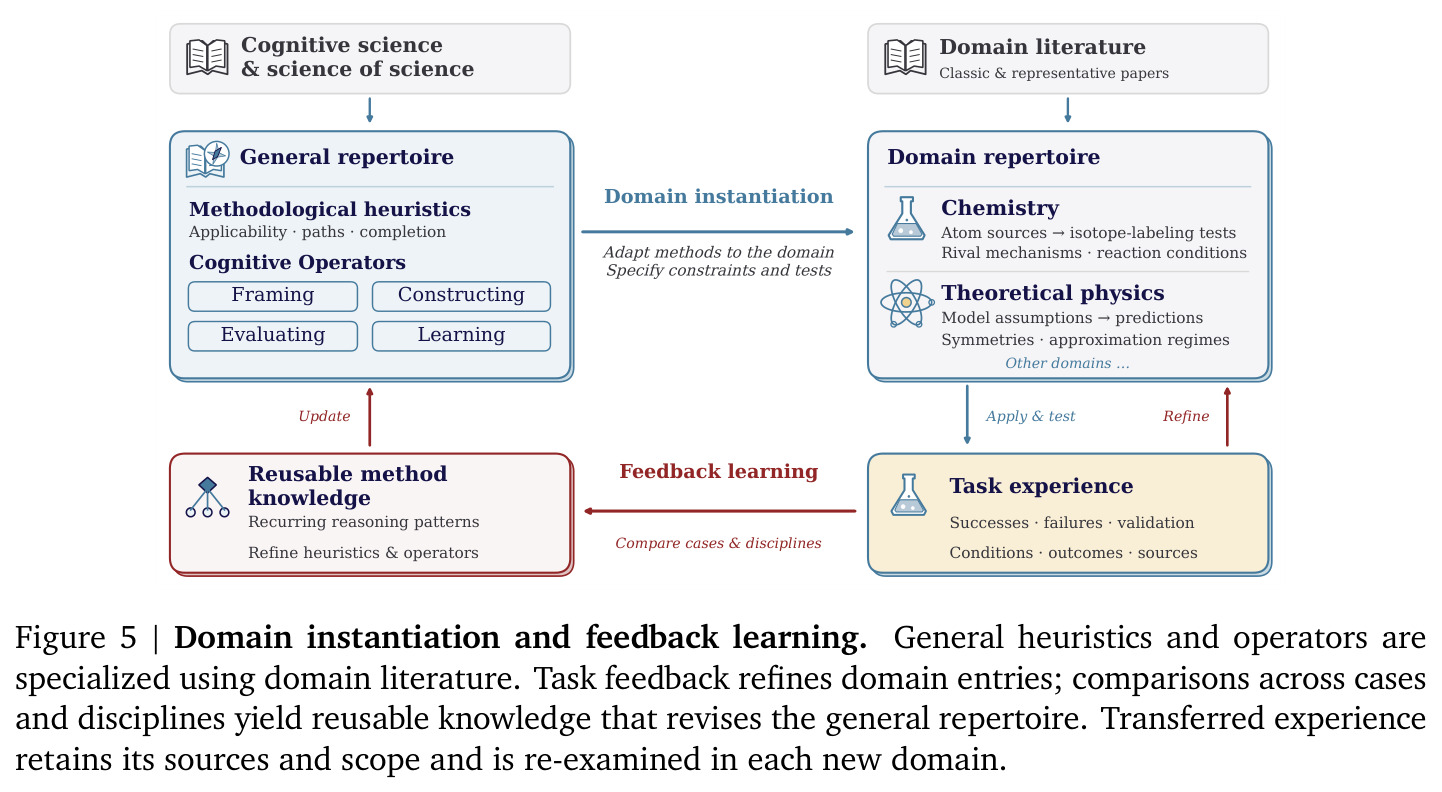
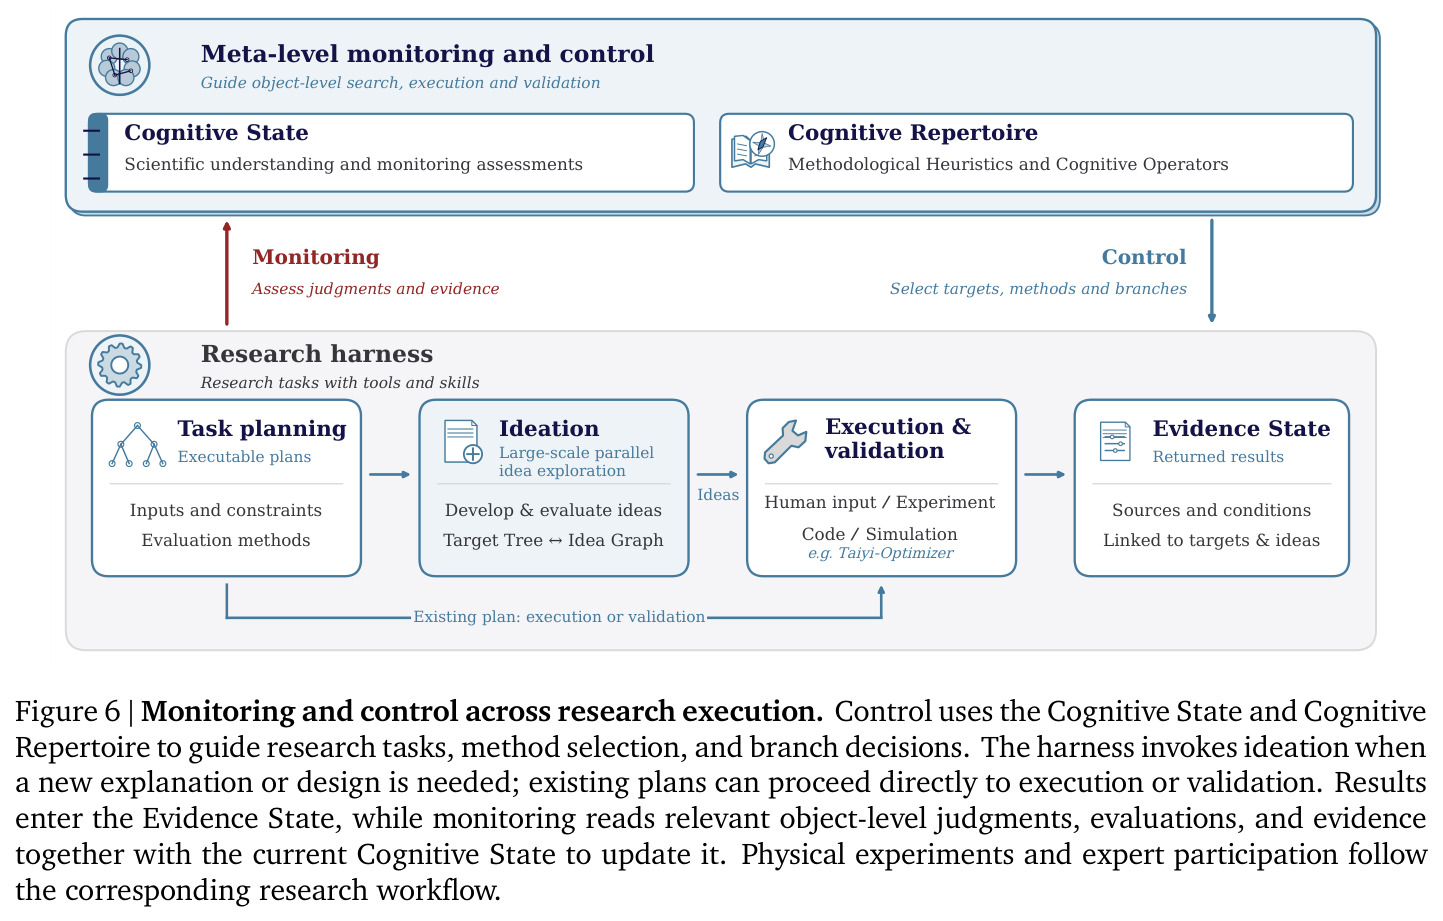
直觉上,科学家做研究时脑中有一本“账”:哪些判断有证据支撑、哪些假设未验证、哪些问题悬而未决,这本账决定下一步查什么、做什么实验。Sage-Taiyi 把这本账显式建模为元层的 Cognitive State,用监控与控制把它和对象层科研搜索连成闭环。技术路线上,对象层维护三个结构:Target Tree $T_t$ 把研究问题 $q$ 分解为子目标、局部策略与子想法;Idea Graph $G_t$ 以节点存想法、以边存 Merge/Fuse/Diverge/Repair/Evolve 五种变换谱系;Evidence State $E_t$ 记录实验结果、文献知识与专家输入及来源。元层维护 Cognitive State $C_t$ 与 Cognitive Repertoire $\mathcal{R}$(启发式+算子,经领域实例化与反馈学习精化)。每轮循环执行 $C_{t+1}=\mathrm{Monitor}(q,X_t,C_t;\mathcal{R})$、$R_t=\mathrm{Select}(q,X_t,C_{t+1};\mathcal{R})$、$X_{t+1}=\mathrm{Search}(q,X_t,C_{t+1};R_t)$,并经 research harness 接入工具、并行探索与实验/仿真验证。
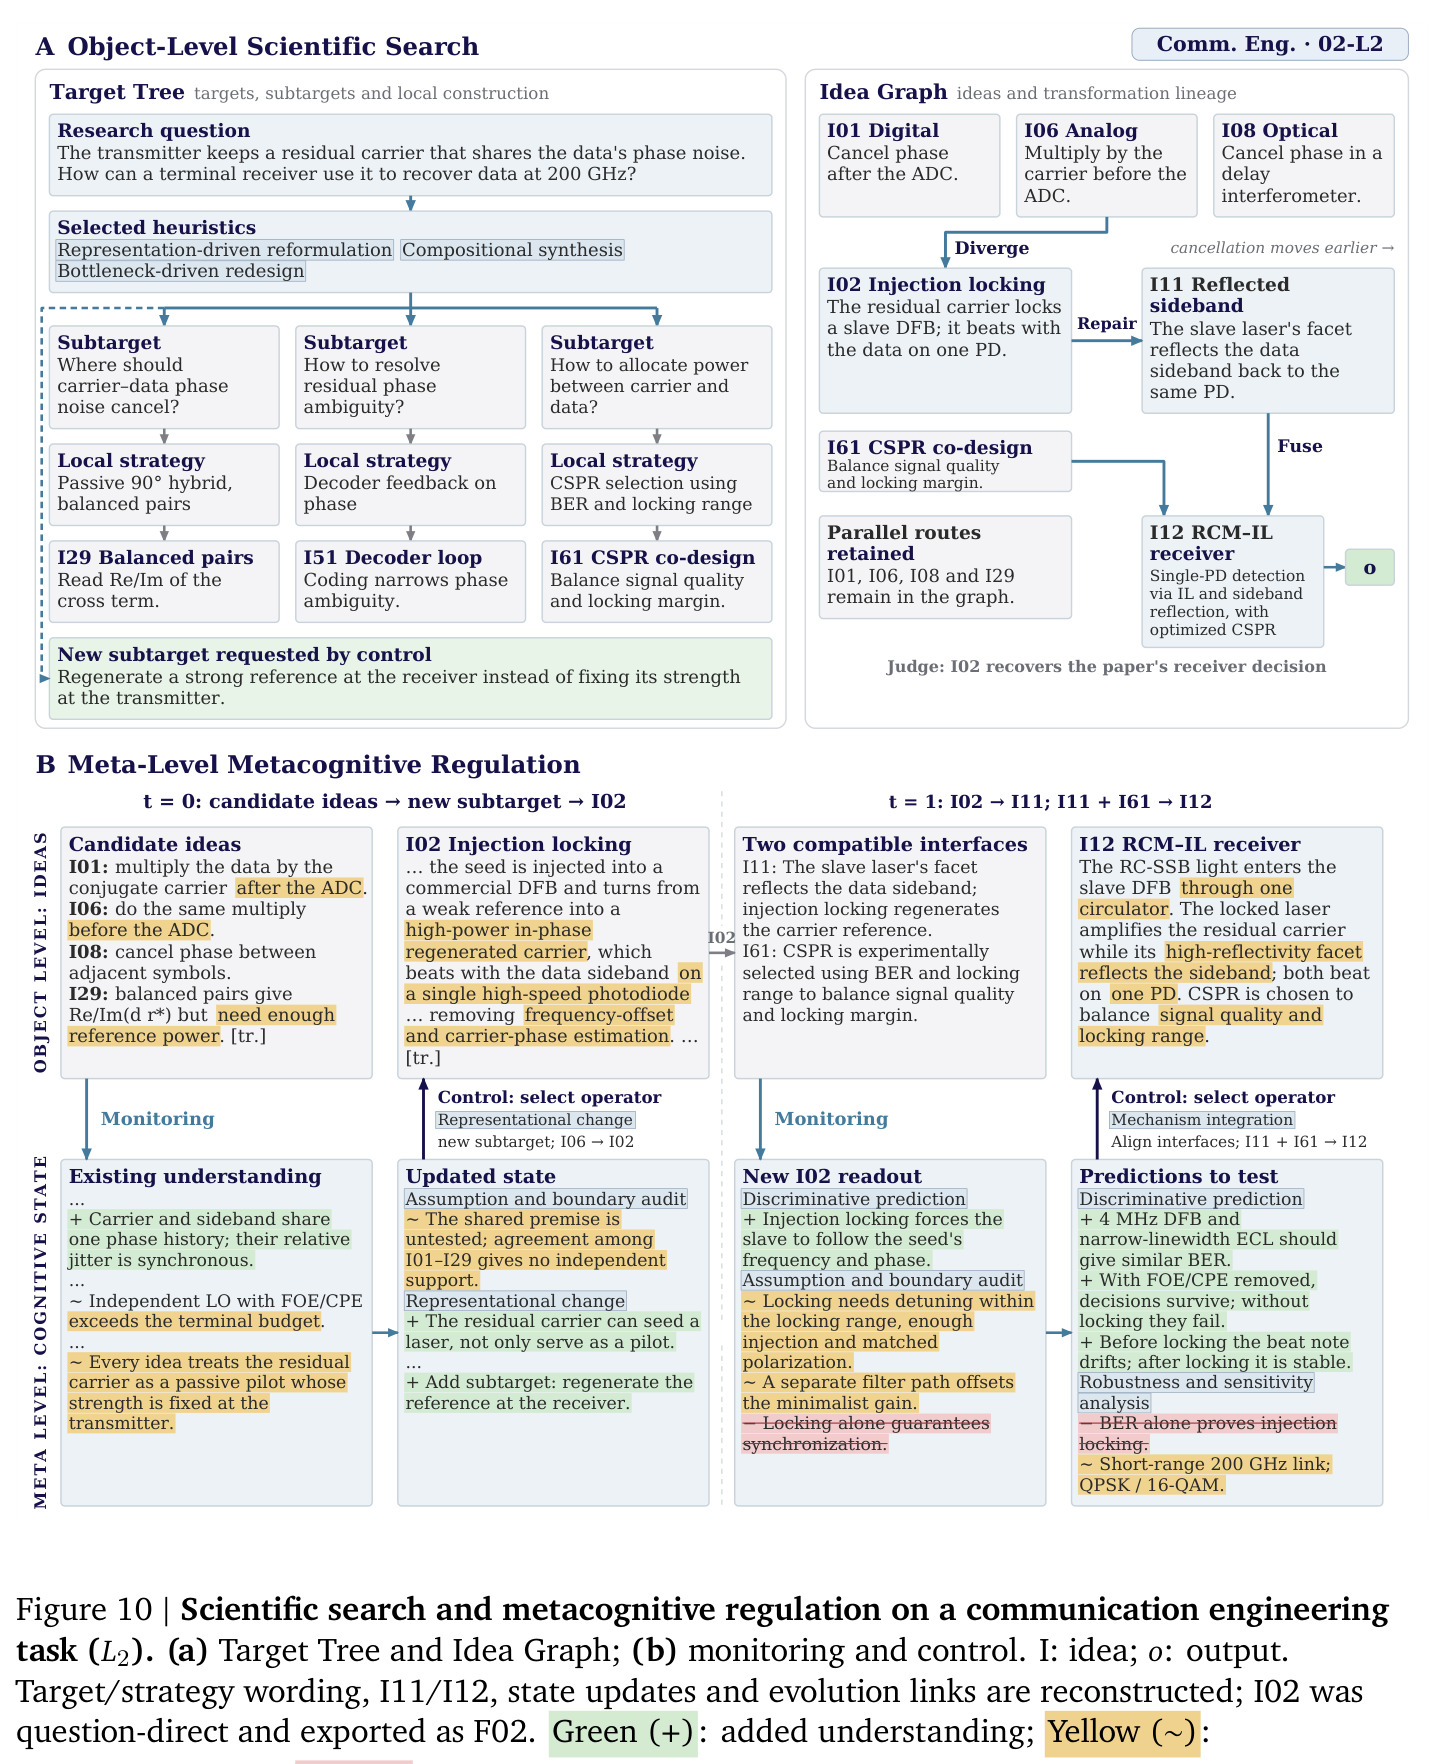
核心创新是“用积累的科学理解来调节搜索”,与已有方法有三点本质区别。一、状态与资源分离:对象层搜索状态 $X_t$(目标、想法、证据)与元层认知状态 $C_t$ 各司其职,$C_t$ 是对 $X_t$ 的选择性、带来源链接的表示,加上监控得出的评估(证据支持度与不确定性、未决冲突、跨想法共享依赖),保持工作假设与外部证据的区分。二、显式建模共享依赖:当多个想法依赖同一未检验前提时,监控记录“它们的一致不构成独立支持”,控制因此调用 Assumption and boundary audit 与 Discriminative prediction 算子设计能区分前提真假的检验,避免把资源浪费在保留共同失败条件的分支上。三、方法选择成为一等公民:十条方法启发式各自带适用条件与完成标准,由控制过程依据 $C_t$ 显式选出 $R_t\subseteq\mathcal{R}$ 来组织目标分解与研究路径,而现有系统的方法使用是隐式的。
方法步骤详情
完整流程见 Algorithm 1,输入研究问题 $q$、初始证据 $E_0$、Repertoire $\mathcal{R}$、停止规则与预算。(1) 初始化:以 $q$ 为根建 $T_0$,$G_0$ 为空,由 $q,E_0$ 初始化 $C_0$,置 $X_0=(T_0,G_0,E_0)$。(2) 监控:目标、想法、评估或证据变化时执行 $C_{t+1}\leftarrow\mathrm{Monitor}(q,X_t,C_t;\mathcal{R})$,更新选择性理解与搜索含义评估,无更新则 $C_{t+1}=C_t$。(3) 控制:结合 $C_{t+1}$ 与各条目适用条件,决定处理哪个目标/想法、继续、修正、转向或停止哪个分支,选出方法集 $R_t$。(4) 构思任务:$R_t\leftarrow\mathrm{Select}(\cdot)$ 后 $X_{t+1}\leftarrow\mathrm{Search}(\cdot)$,在 Target Tree 分解目标、在 Idea Graph 以 Merge/Fuse/Diverge/Repair/Evolve 发展想法并保留谱系与评估,各分支并行。(5) 执行/验证任务:harness 把任务细化为带输入、约束与评估方法的可执行计划并选择工具(如 Taiyi-Optimizer 做贝叶斯优化),结果连同来源与条件写入 Evidence State。(6) 对照请求输出评估进展,直至停止规则满足,返回带证据与未决问题的成果。
技术新颖性
新颖性分析:(1) 把元认知从隐喻变成可执行的形式化——式 (1)–(3) 把 Monitor/Control 写成对状态与资源的显式函数,索引 $t$ 标记逻辑状态变化而非固定时长的轮次;(2) Idea Graph 跨目标分支连接想法谱系,使为不同目标发展的想法可比较、可重组(如通信案例中 I11 与 I61 经 Fuse 合成 I12),优于只沿单链细化的树状搜索;(3) Repertoire 的三层学习回路——通用启发式/算子经领域实例化落地(如 active hypothesis testing 在化学中变为同位素标记实验),任务成功失败与验证结果经案例比较提炼复现模式反哺通用库,借鉴图式归纳与案例推理(Figure 5);(4) 与 CoALA、Generative Agents、Reflexion 等认知架构工作相比,Sage-Taiyi 的独特处在于“状态依赖的方法选择”与“跨分支科学判断迁移”的结合,Related Work 明确其焦点是“一个分支形成的判断如何影响搜索其他位置的决策”。
实验结果
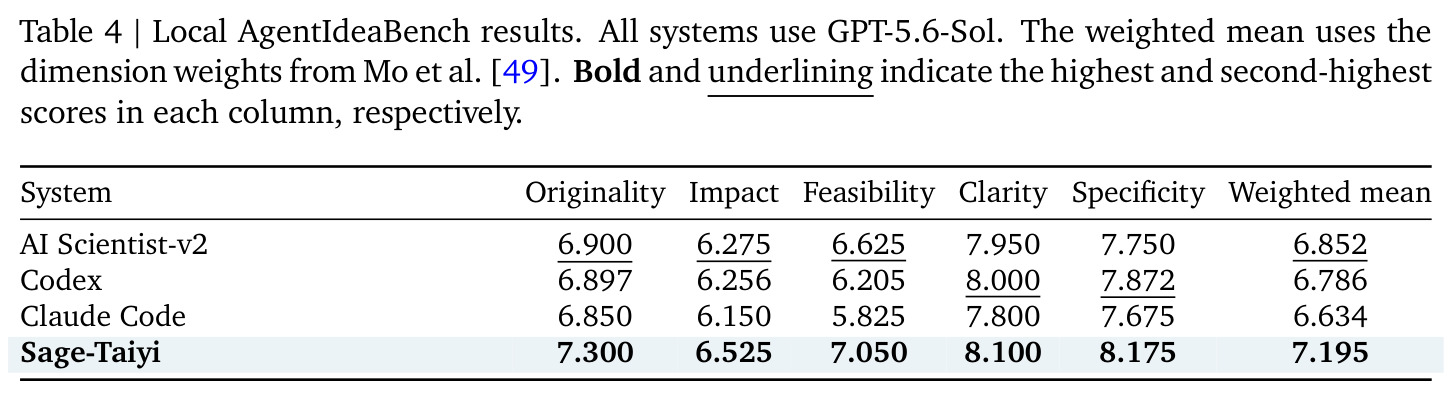
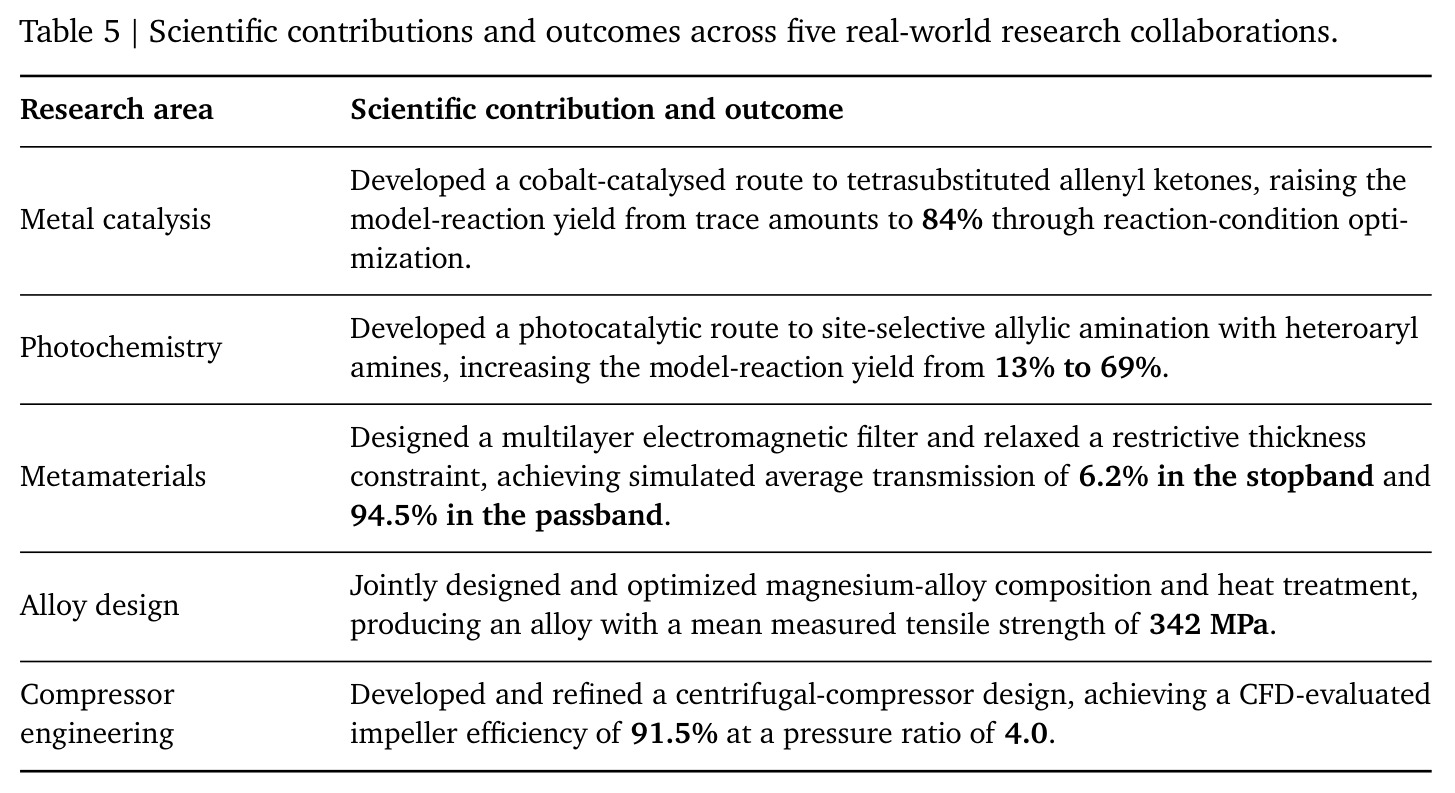
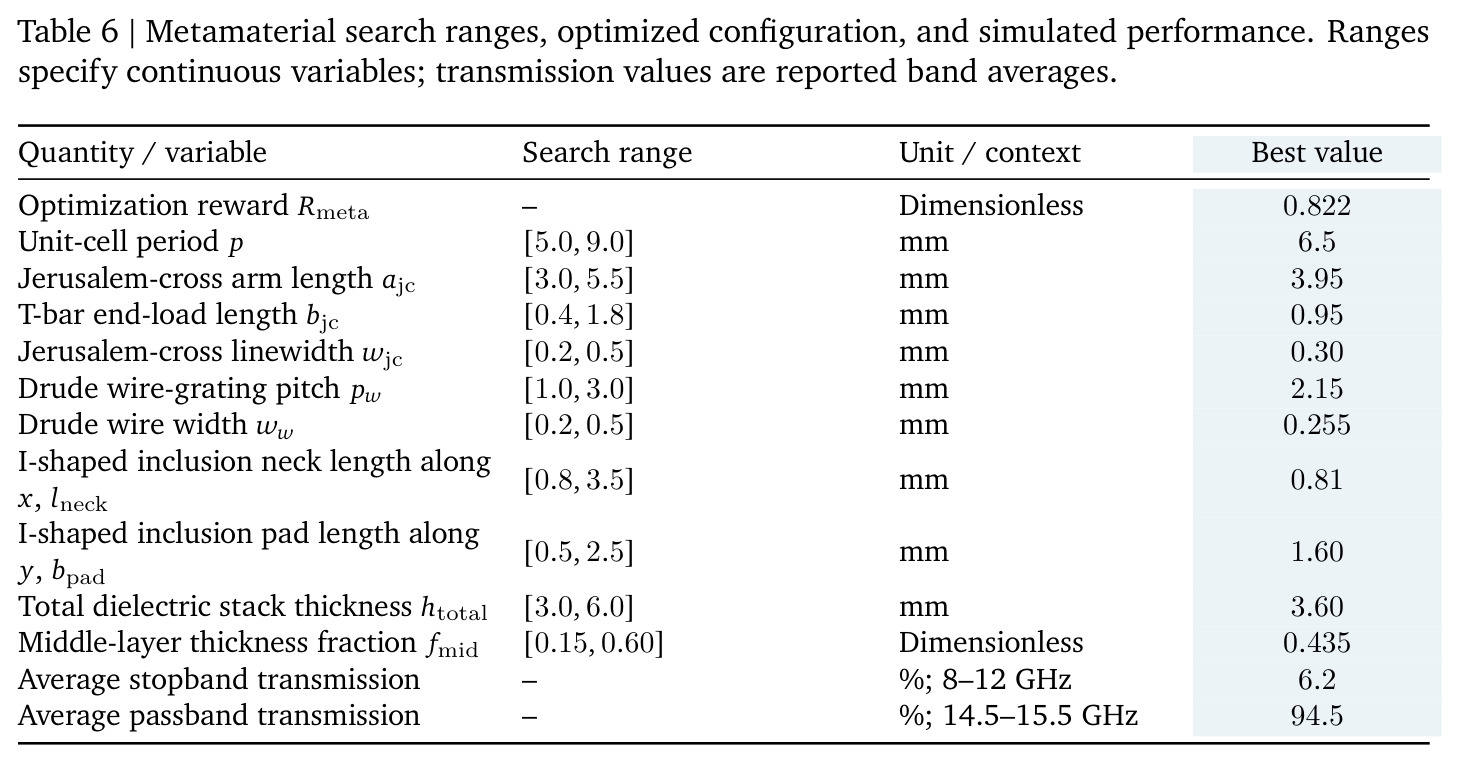
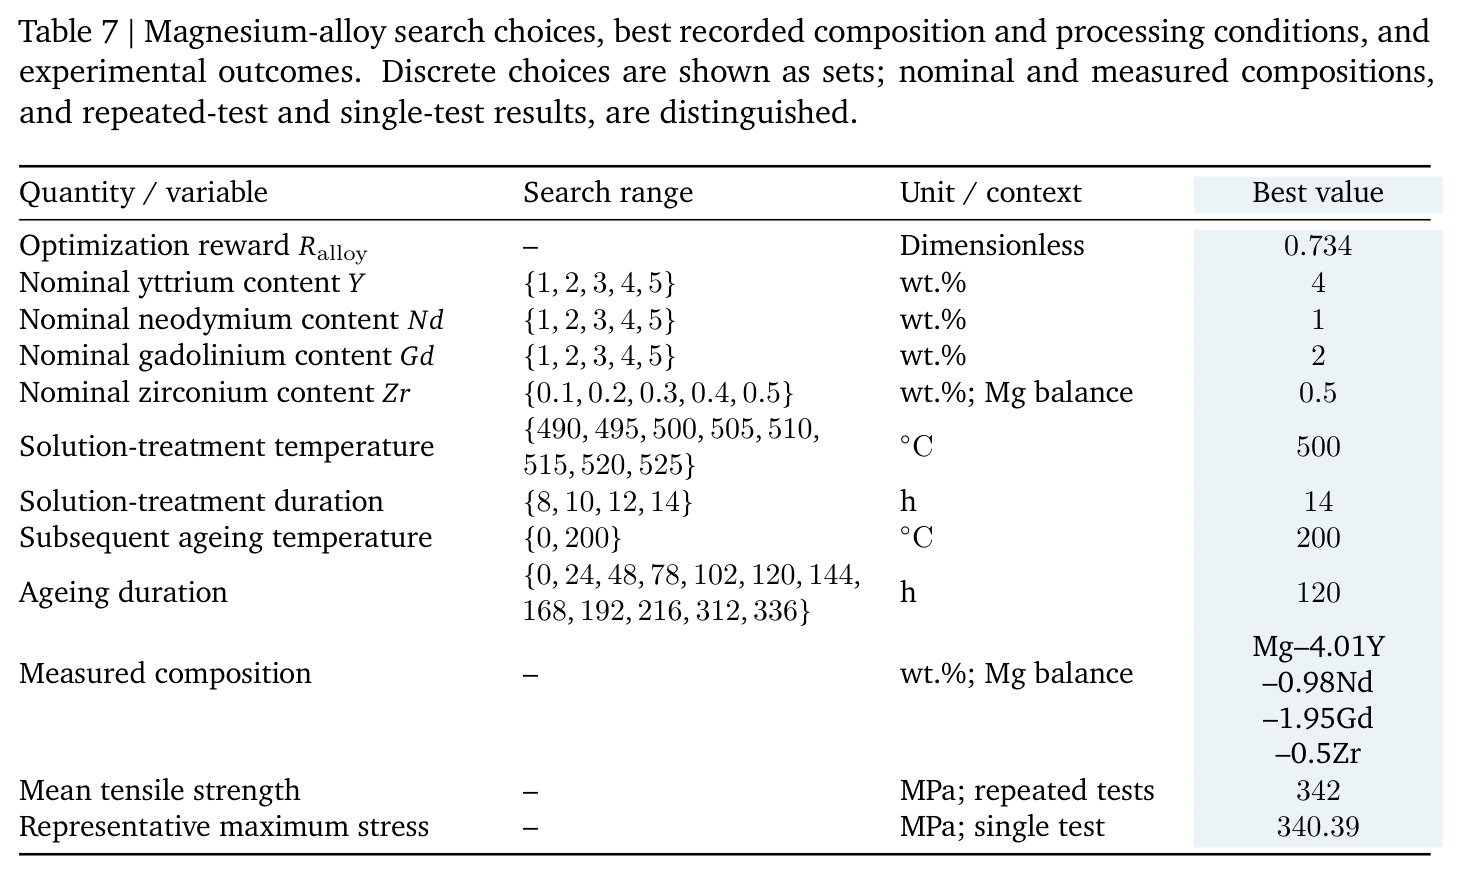
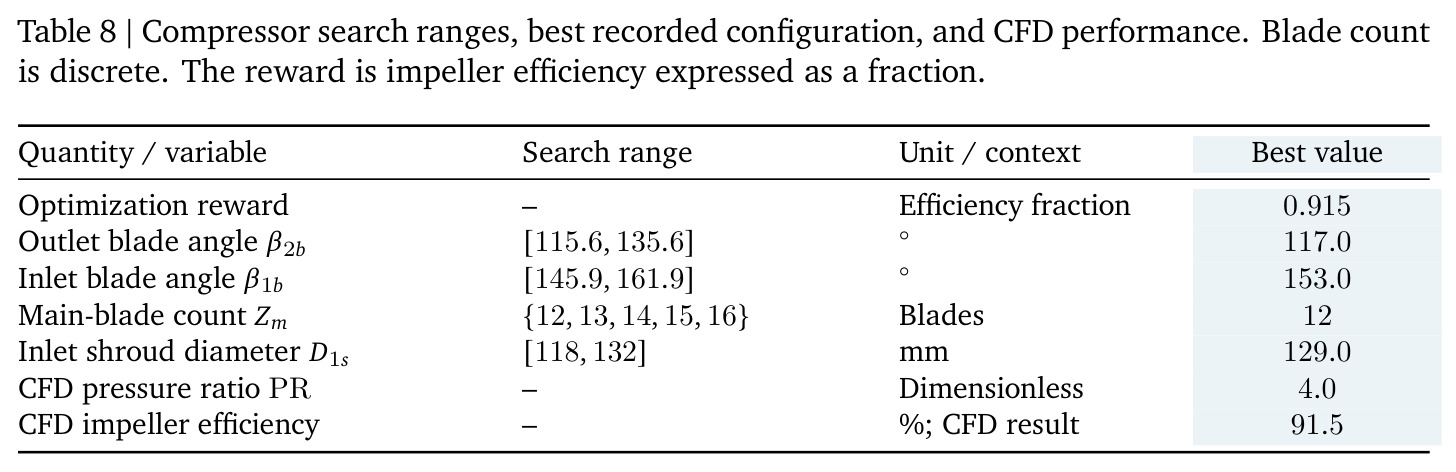
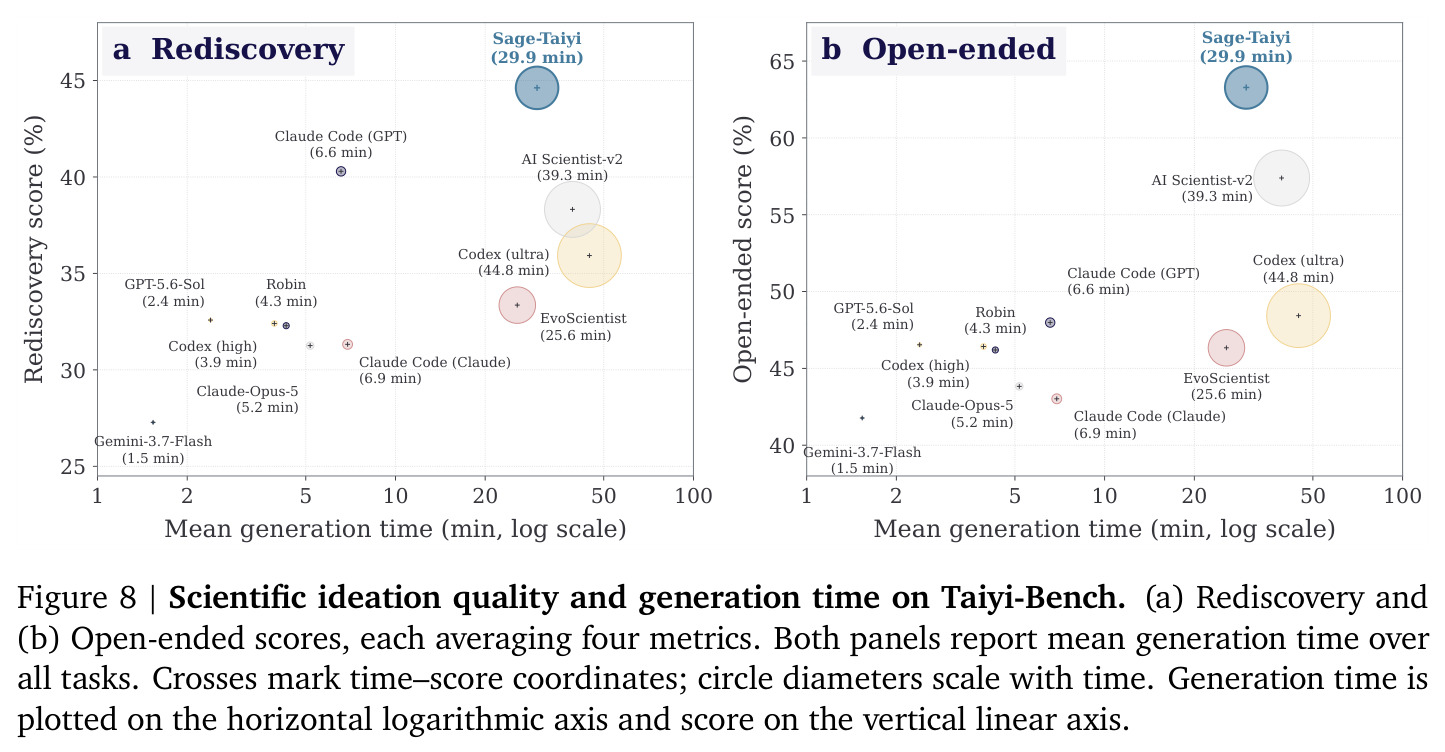
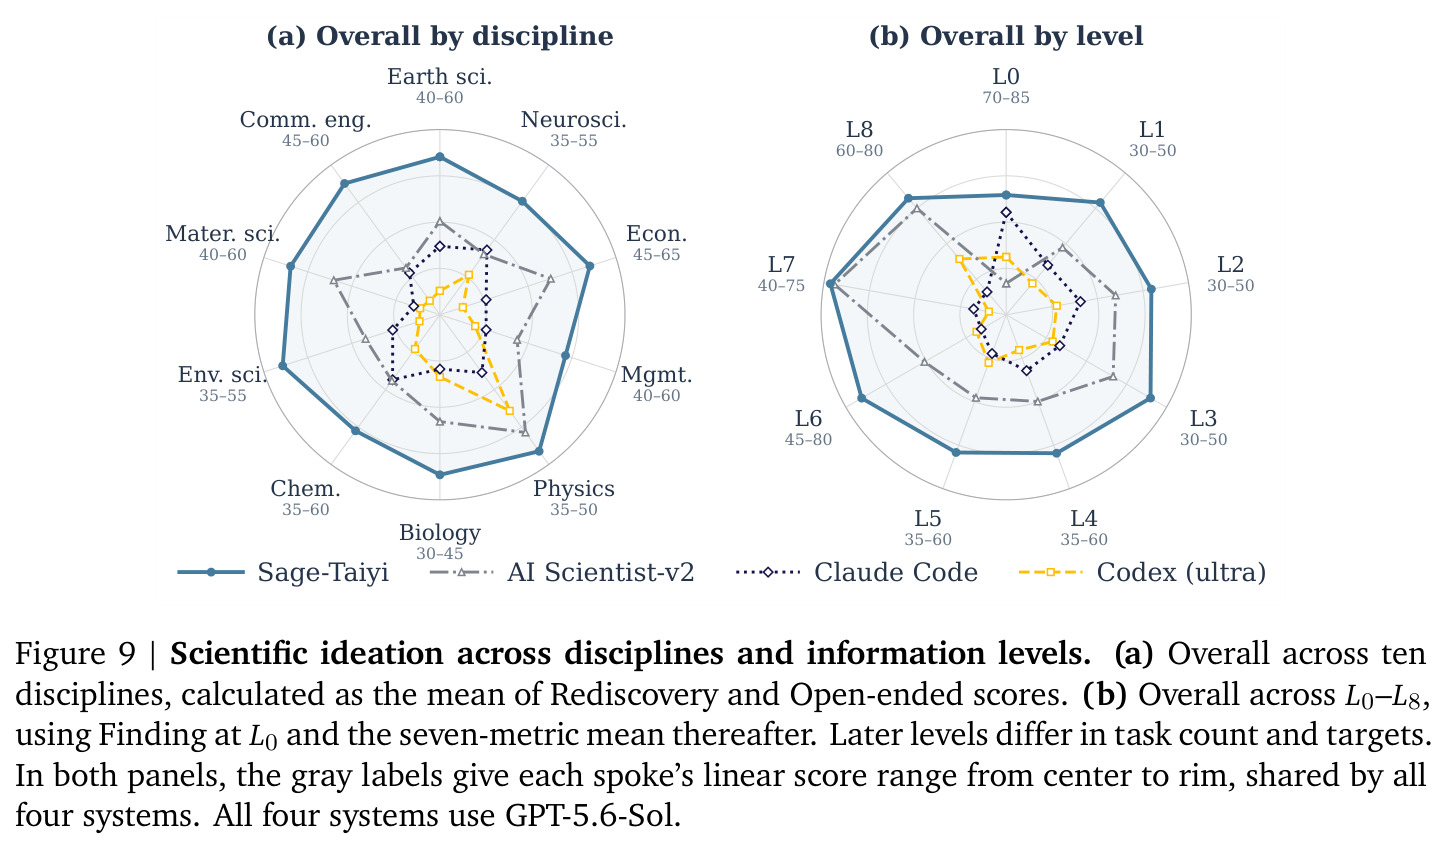
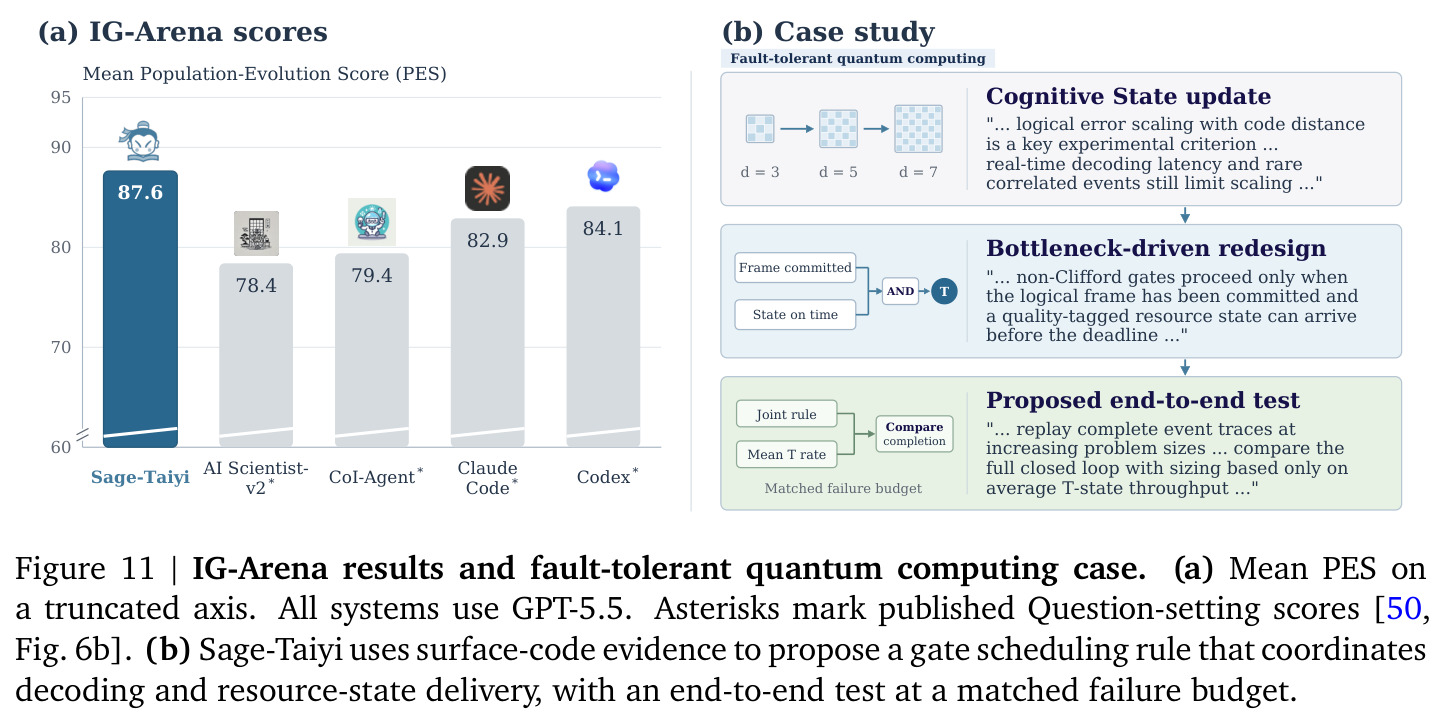
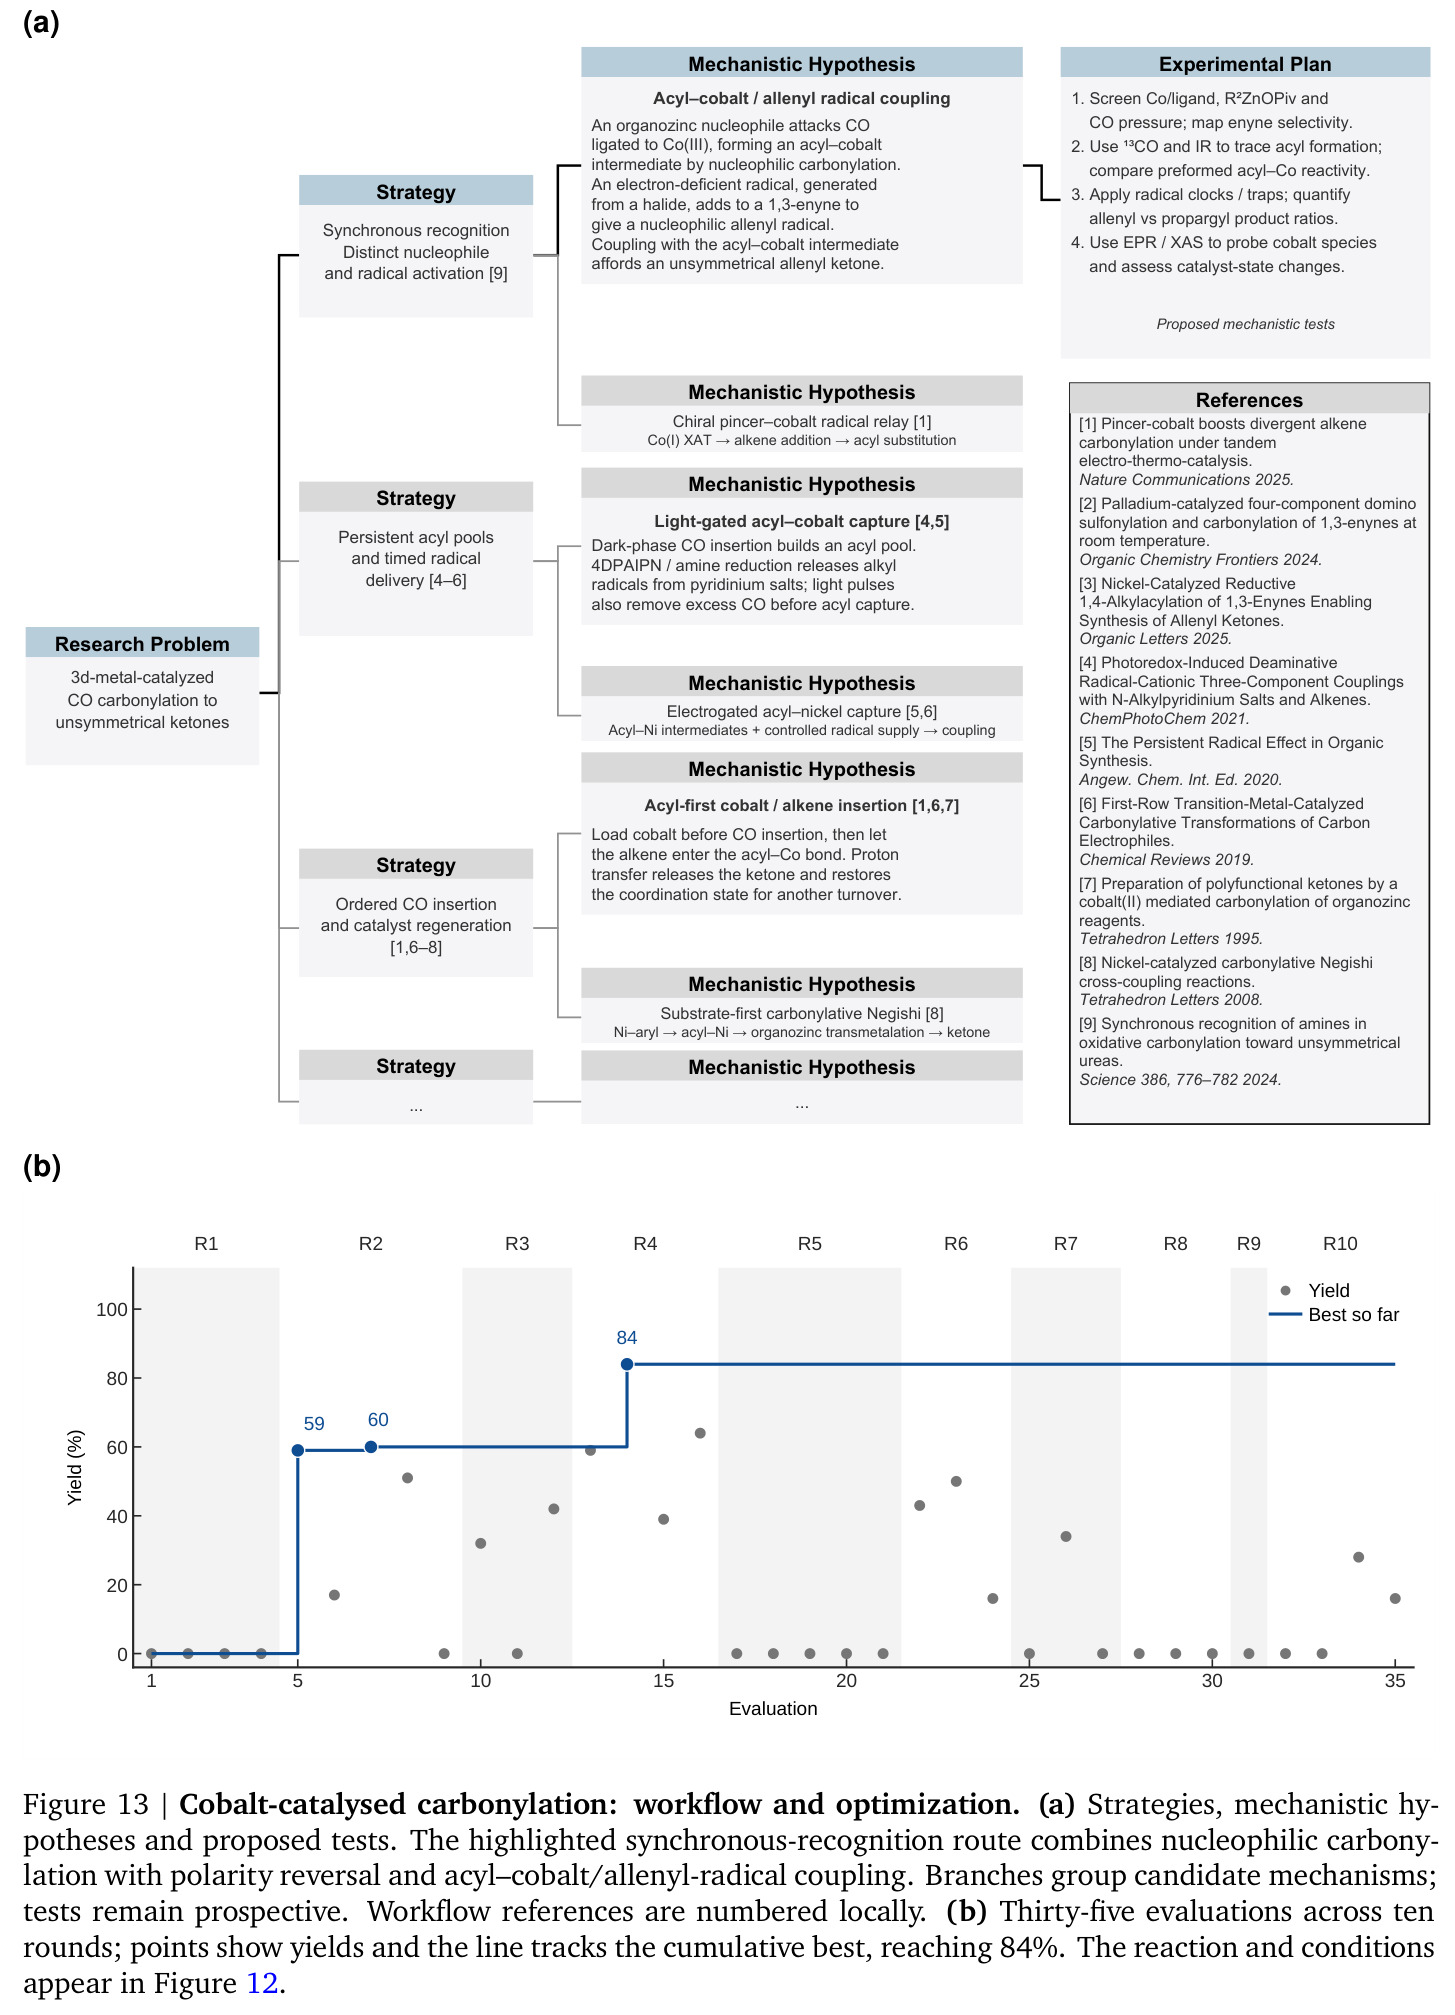
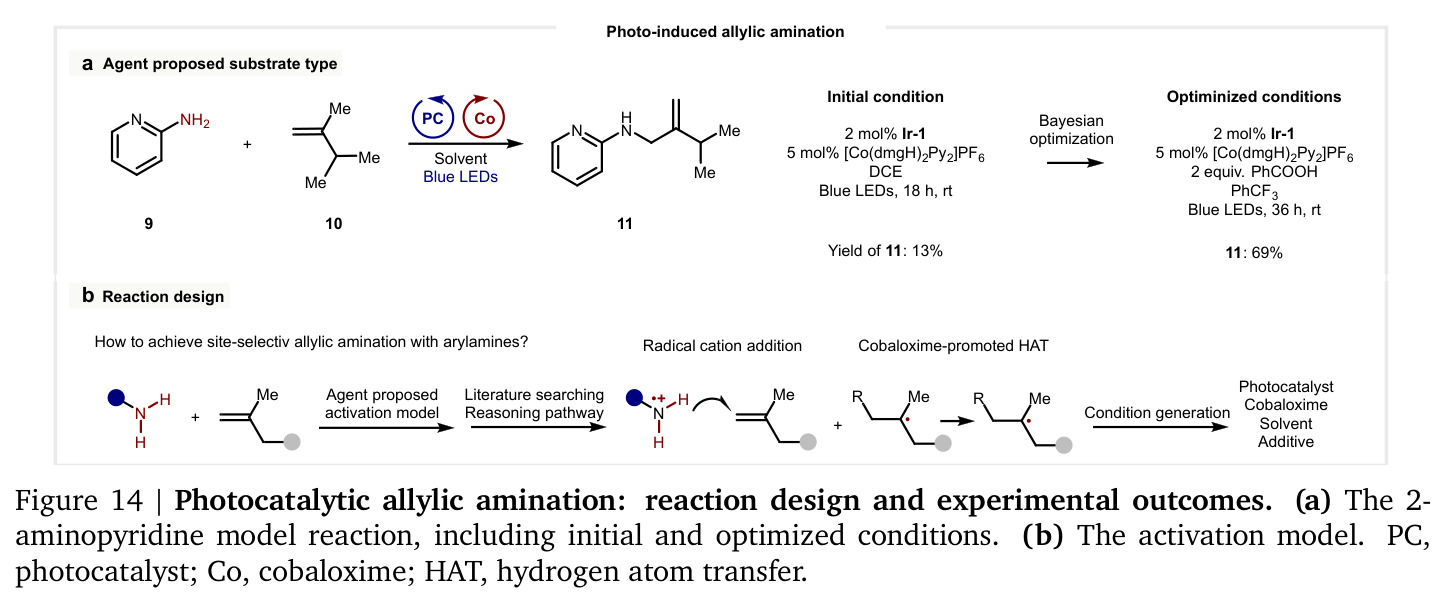
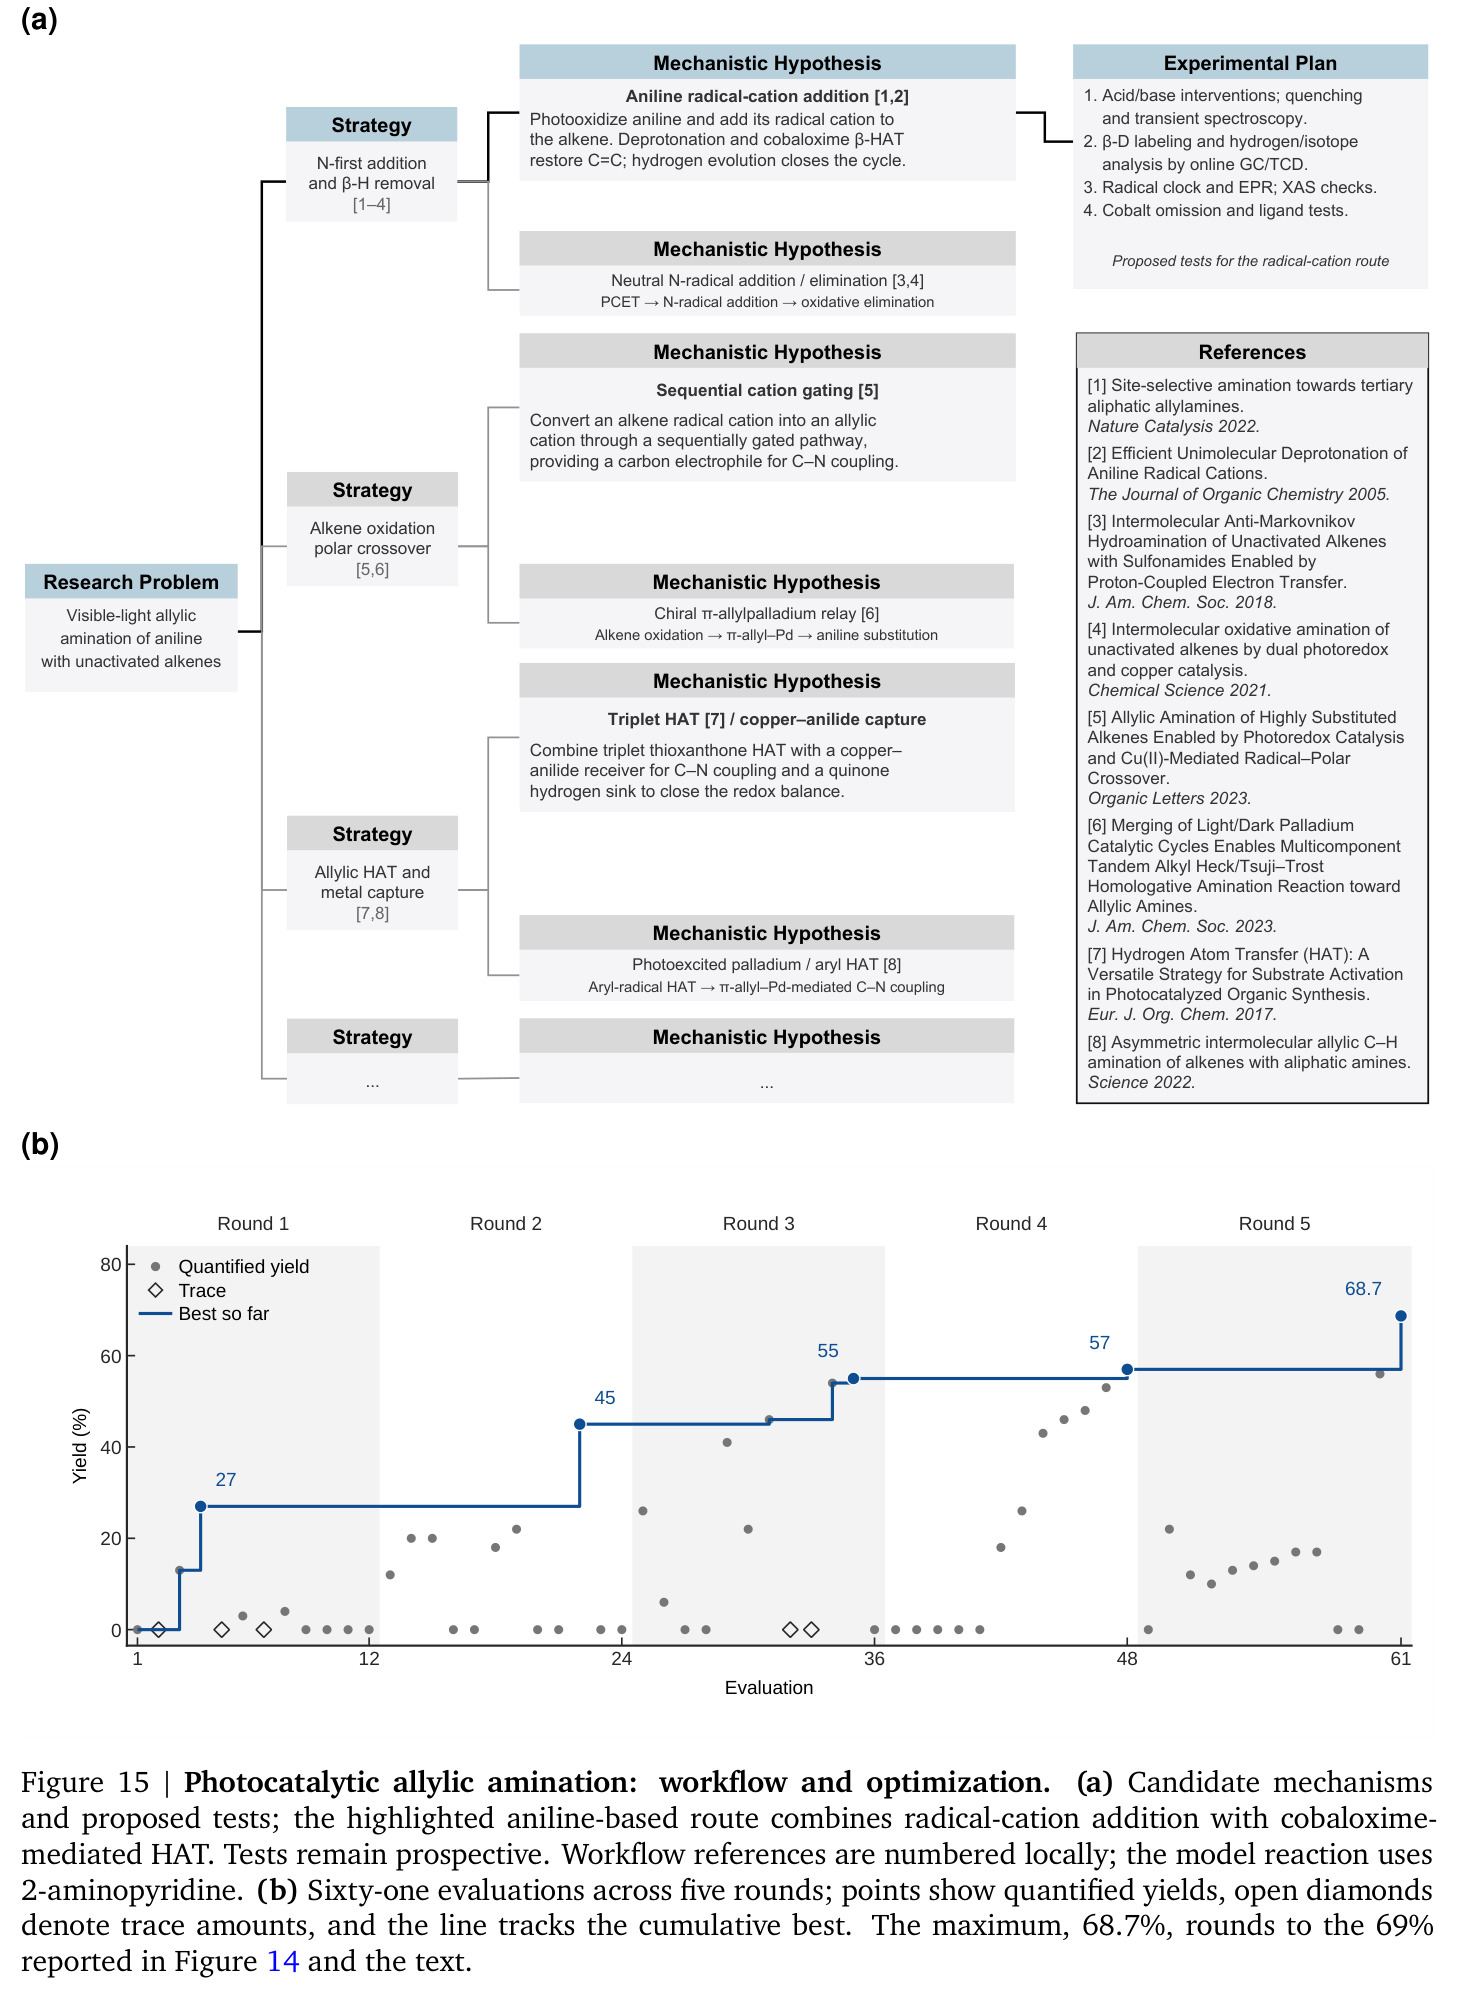
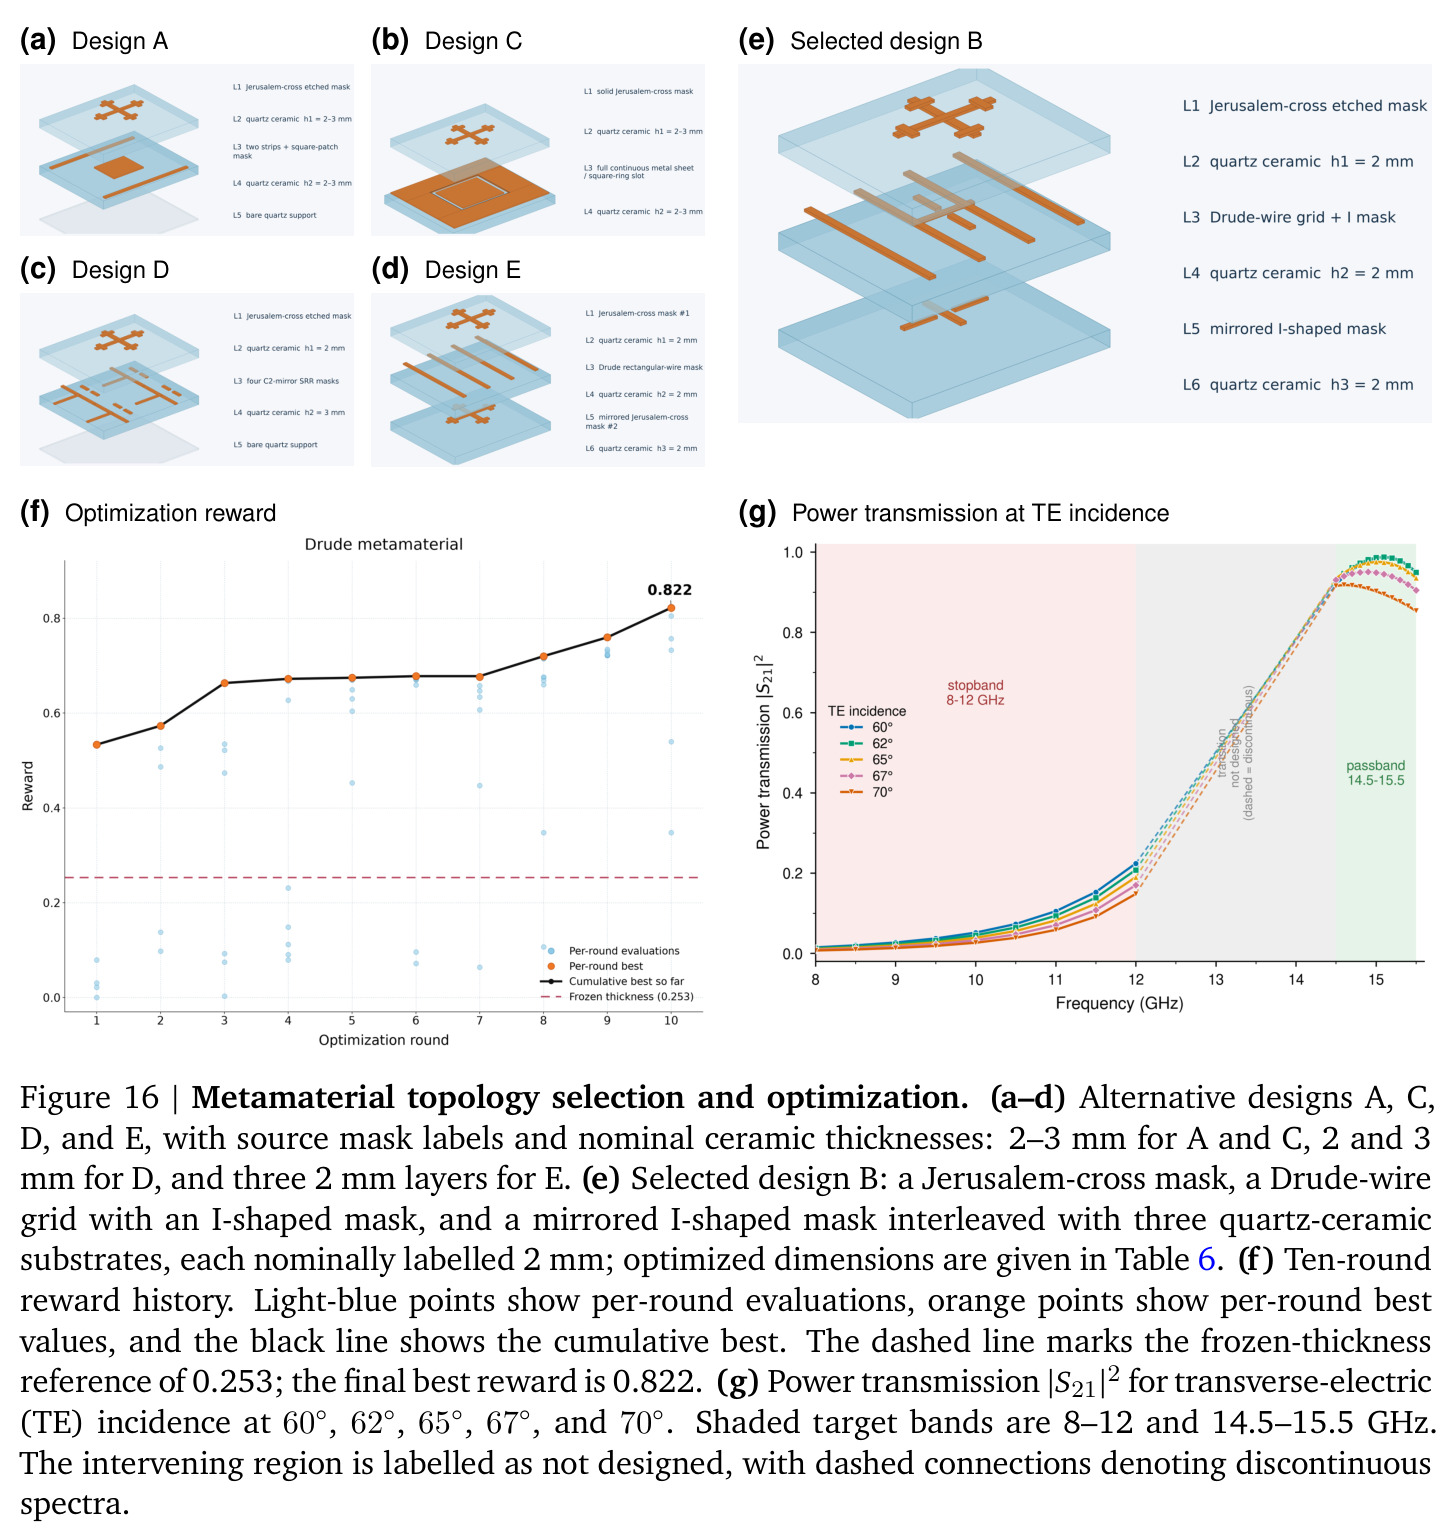
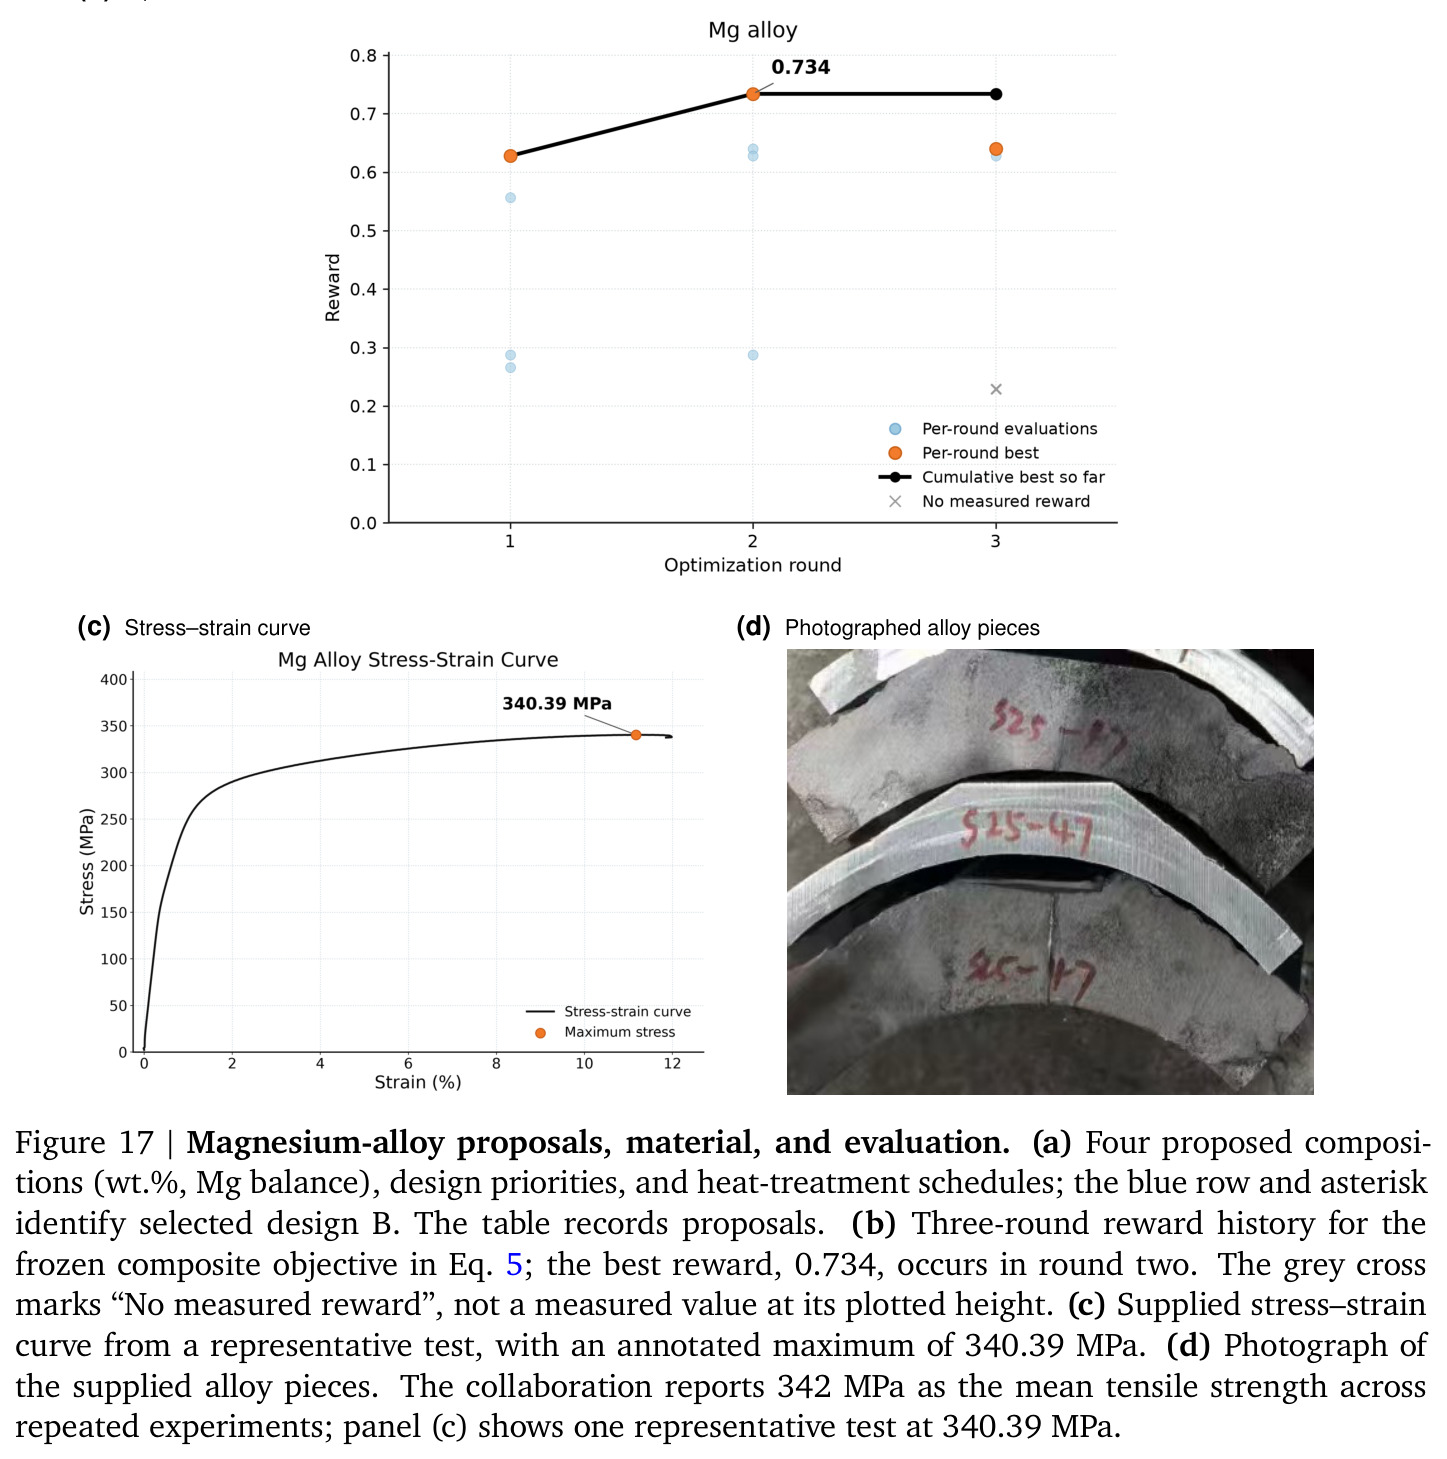
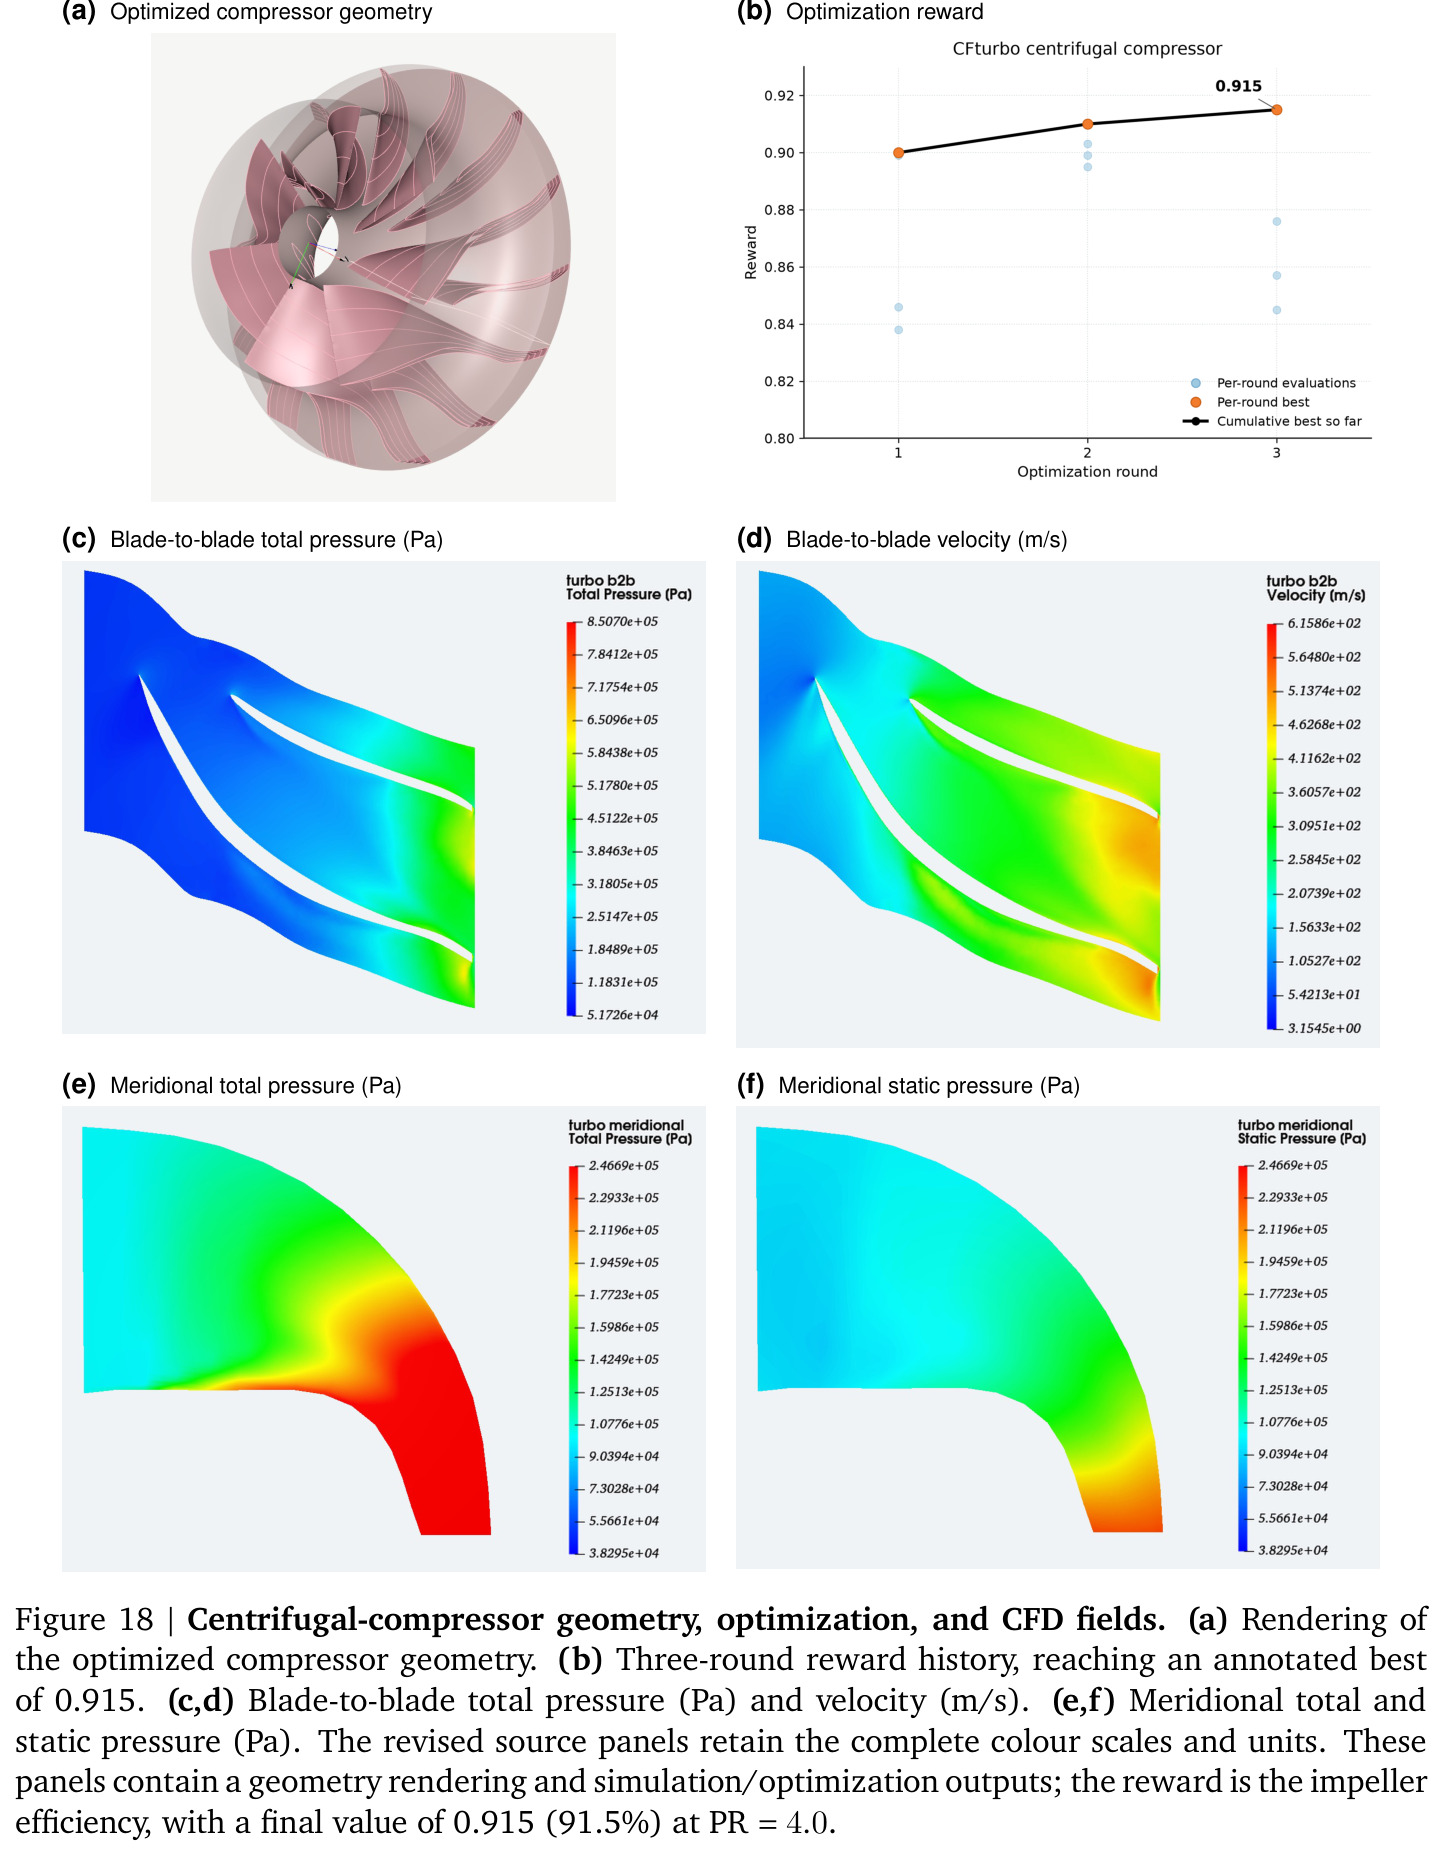
逐一分析核心实验。(1) Taiyi-Bench(50 篇论文、265 任务、10 学科、每任务 10 想法):八项指标全部第一,Overall 53.95 比最强基线 AI Scientist-v2 的 47.85 高 6.1 分;Novelty 70.54 vs 55.20(+27.8%)、Coverage 40.69 vs 32.37、Lookahead 38.55 vs 31.62、Exact 19.53 vs 16.74、Effectiveness 87.81、Feasibility 52.45、Diversity 42.33;ELO 1322.5 vs 1184.2,对 AI Scientist-v2 胜率 66.3%;平均耗时 29.9 分钟,短于两个强基线的 39.3 与 44.8 分钟;十个学科全部领先 1.9–9.4 分,$L_0$–$L_8$ 每层级第一。(2) AgentIdeaBench:加权均值 7.195 vs 6.852,五维全部最高,Originality +0.400、Feasibility +0.425。(3) IG-Arena:平均 PES 87.634,超已发表最佳 ClaudeCode 的 84.1(Codex 79.4、AI Scientist-v2 78.4)。(4) 真实课题:钴催化羰基化产率 trace→84%(35 次评估/10 轮,改用 Co(acac)2+三齿配体 L20+EtZnOPiv);光催化烯丙胺化 13%→68.7%(61 次/5 轮,换 PhCF3、加 2 当量 PhCOOH、延至 36 h);超材料滤波器解除基板厚度瓶颈,reward 0.253→0.822,阻带/通带透射 6.2%/94.5%(专家 fishbone 9.5%/87.4%);镁合金 Mg–4Y–1Nd–2Gd–0.5Zr 实测平均抗拉强度 342 MPa(reward 0.734);压缩机叶轮效率 90.0%→91.0%→91.5%(PR=4.0)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Taiyi-Bench 综合构思(265 任务) | Overall(0–100) | 53.95(约 54.0) | AI Scientist-v2 47.85 | +6.1 分,八项指标全部第一 |
| Taiyi-Bench 开放式新颖性 | Novelty(0–100) | 70.54 | AI Scientist-v2 55.20 | +27.8% |
| Taiyi-Bench 历史再发现 | Coverage(0–100) | 40.69 | AI Scientist-v2 32.37 | +8.32 分(Exact 19.53 vs 16.74,Lookahead 38.55 vs 31.62 同列第一) |
| Taiyi-Bench 成对比较 | ELO / 胜率 | 1322.5 / 对 AI Scientist-v2 胜率 66.3% | AI Scientist-v2 1184.2 | ELO +138.3,11 个系统排名第一 |
| Taiyi-Bench 生成效率 | 平均生成时间(分钟) | 29.9 | AI Scientist-v2 39.3;Codex(ultra) 44.8 | 更高质量的同时耗时更短 |
| AgentIdeaBench(40 子领域) | 加权均值(1–10) | 7.195 | AI Scientist-v2 6.852 | +0.343,五个维度全部最高 |
| IG-Arena(30 个前沿问题) | 平均 PES | 87.634 | 已发表最佳 ClaudeCode 84.1 | +3.5(AI Scientist-v2 78.4、Codex 79.4) |
| 钴催化羰基化合成四取代联烯酮 | 模型反应分离产率 | 84% | 初始条件仅 trace(CoBr2/dtbpy/EtZnBr/THF) | 从痕量到 84%(35 次评估、10 轮贝叶斯优化) |
| 光催化区域选择性烯丙胺化 | 模型反应产率 | 69%(68.7%) | 初始条件 13% | +56 个百分点(61 次评估、5 轮) |
| 多层电磁带阻滤波器设计 | 阻带/通带平均透射;reward $R_{meta}$ | 6.2% / 94.5%;reward 0.822 | 专家 fishbone 设计 9.5% / 87.4%;冻结厚度参考 0.253 | 阻带抑制更深的且通带更透;reward 提升 0.569 |
| 砂型铸造镁合金成分+热处理联合设计 | 平均抗拉强度(MPa) | 342(代表性单次 340.39) | 专家可选的实验支撑基线方案 D(未作为对照报告具体强度) | reward 0.734,成分与工艺协同优化后物理实现 |
| 离心压缩机叶轮优化 | CFD 叶轮效率(PR=4.0) | 91.5% | 初始约 90.0% | 三轮提升约 1.5 个百分点 |
局限与改进
作者承认的局限:(1) 五个真实案例均为“专家引导的合作”,专家参与了想法筛选与验证——化学案例的方案、超材料的设计 B、合金方案 B、压缩机路线一都是专家选定,系统与人类专家的贡献无法严格剥离;(2) Taiyi-Optimizer 的贝叶斯优化是在预先限定的条件空间内搜索,化学案例的初始条件产率极低(trace、13%),说明“提出初始条件”环节仍依赖文献映射而非第一性预测;(3) 基准评测只保留各科学发现框架的构思阶段,未比较其执行实验与写报告的能力。我的补充观察:(1) 成本未披露——Sage-Taiyi 墙钟时间 29.9 分钟虽短于两个强基线,但并行分支探索加元层监控意味着更高的 token 消耗,论文未报告调用次数与费用;(2) 缺少消融实验,无法分辨收益来自 Cognitive State、Repertoire、Idea Graph 还是仅仅来自更结构化的提示;(3) 评分依赖“文献接地验证器”,虽称与人类专家一致性良好,但评分模型与生成模型可能共享偏差;(4) 化学优化是单目标模型反应,未涉及复杂底物选择性、克级放大与重复性统计。
独立分析的弱点
独立分析的弱点:(1) 消融缺失是最大硬伤——Cognitive State、十条启发式、五种图变换、领域实例化各自的贡献完全未知,改进方向是逐组件消融,并用更小的底座模型测试架构收益是否随模型能力缩放;(2) “再发现”评测范式偏向收敛到论文原决策,可能低估发散性构思的价值,改进方向是引入前瞻性“想法-实验结果”对齐评测(如 Robin 式闭环后统计预测命中率);(3) Cognitive Repertoire 的十条启发式与算子由人工整理,覆盖面受整理者领域知识限制,改进方向是让反馈学习回路自动从任务轨迹归纳新启发式并做一致性校验;(4) 化学案例中 Sage-Taiyi 与 Taiyi-Optimizer 的贡献边界模糊——产率提升究竟归于架构定义的条件空间还是贝叶斯优化本身,改进方向是在同一空间对比随机搜索、网格搜索与无架构 LLM 提议的基线;(5) 元层评估本身由 LLM 完成,可能继承幻觉并把错误评估写入 $C_t$,改进方向是给监控做可证伪的单元测试,例如故意注入错误证据检验监控能否发现并修正。每个弱点都指向同一主题:论文证明了“系统整体有效”,但尚未解释“为什么有效、何时会失效”。
未来方向
作者明确提出的方向:(1) 通过积累的研究经验精化 Cognitive Repertoire,并检验方法条目跨领域复用的效果;(2) 扩展多智能体协作,在有限时间与迭代预算内探索更广的高价值方案空间。基于本文成果可延伸的方向:(1) 把监控评估与因果推断结合,让“判别性预测”算子自动设计能区分竞争机制的实验(active hypothesis testing 的全自动版本);(2) 将 Repertoire 开放为社区可贡献的“科学方法库”,众包标注各启发式的适用条件与失败案例;(3) 在更多实验平台(生物、能源、气候科学)复制五案例的“构思-优化-验证”闭环,并建立产率/性能提升的统计显著性报告规范(本文化学结果多为单点最优值);(4) 为 $C_t$ 开发可解释的可视化界面,让人类科学家审查并纠正元层评估,形成真正的人机共创而非专家只做终审;(5) 反过来把该架构用作“科学学”研究工具——统计十学科中各类启发式的选用频率与胜率,用数据驱动启发式库自身的演化。论文的目标场景(10 学科、265 任务、5 个真实课题)已经为这类元研究提供了难得的数据基础。
复现评估
复现评估:论文来自上海人工智能实验室 Sage-Taiyi 团队(90 余位作者),首页有 Homepage 链接,但正文与附录未见明确代码开源声明,附 A 仅为贡献列表。可复用资产方面,Taiyi-Bench 构建方法描述完整(50 篇 2026 年 3 月后公开论文重建为 DAG、265 任务、$L_0$–$L_8$ 分级披露、决策级 rubric 与机制等价判据),但未说明数据与评分验证器是否发布;另两个为第三方基准。算力成本上,底座为 GPT-5.6-Sol(high reasoning),复现需相应 API 预算:每任务 10 个想法、平均 29.9 分钟/任务、265 个任务,单次完整评测成本不低,消融多轮重复更贵。真实案例复现需湿法化学实验室(钴催化、光催化)、电磁仿真、镁合金熔铸与 CFD 设施,普通团队难以全部复现;化学两案例条件披露最完整(如 Co(acac)2/L20/EtZnOPiv、换 PhCF3 加 PhCOOH),是最可行的切入点。总体:基准评测中等偏难(有 API 即可,卡点在基准数据是否放出),真实实验复现难(依赖平台与专家)。
论文图表