以用户的语言变体作答:用于后训练的校准顺应配对 Answering in the User's Variety: Calibrated Accommodation Pairs for Post-Training
后训练使回复一律标准化,但训练更新仍偏好迎合声望变体;CAP配对可校准迎合而不强加方言
前置知识
语言顺应理论(CAT)
Communication Accommodation Theory 是社会语言学经典理论:说话人会出于寻求认同、标记身份等社会动机调整自己的言语风格。趋同(convergence)指缩小与对话者的语言差异,趋异(divergence)指刻意拉大差异,维持(maintenance)指保持自己的变体。CAT 的关键预言是趋同是「向上的」——流向社会地位更高的变体而非被污名化的变体;且过度顺应(over-accommodation,如模仿得夸张做作)会被听者感知为居高临下或漫画化。
本文把 CAT 的三条可检验预言(向上趋同、过度顺应有害、心理顺应不等于语言顺应)直接转译成对语言模型的度量协议,全文的假设、指标与 CAP 的「校准」目标都建立在这套概念之上。
SFT / DPO / RLVR 后训练流水线
预训练之后的三段式流程:监督微调(SFT)用标准答案教模型对话格式与风格;直接偏好优化(DPO)用「chosen/rejected 回复对」按 Bradley-Terry 式目标调整策略,其训练目标使策略与参考策略的对数比 $\log\frac{\pi_\theta(y|x)}{\pi_{ref}(y|x)}$ 成为隐式奖励;RLVR 则是用可验证奖励的强化学习。OLMo-2/3、Tülu-2/3、Zephyr 等开放谱系公开了每一个阶段的 checkpoint,使相邻两阶段可以单独比较。
论文的核心问题是「对用户变体的标准化默认是哪一阶段安装的」,只有逐阶段比较相邻 checkpoint 才能归因, closed 模型或 base/instruct 两点比较都做不到。
内容匹配孪生请求与 novel-span 评分
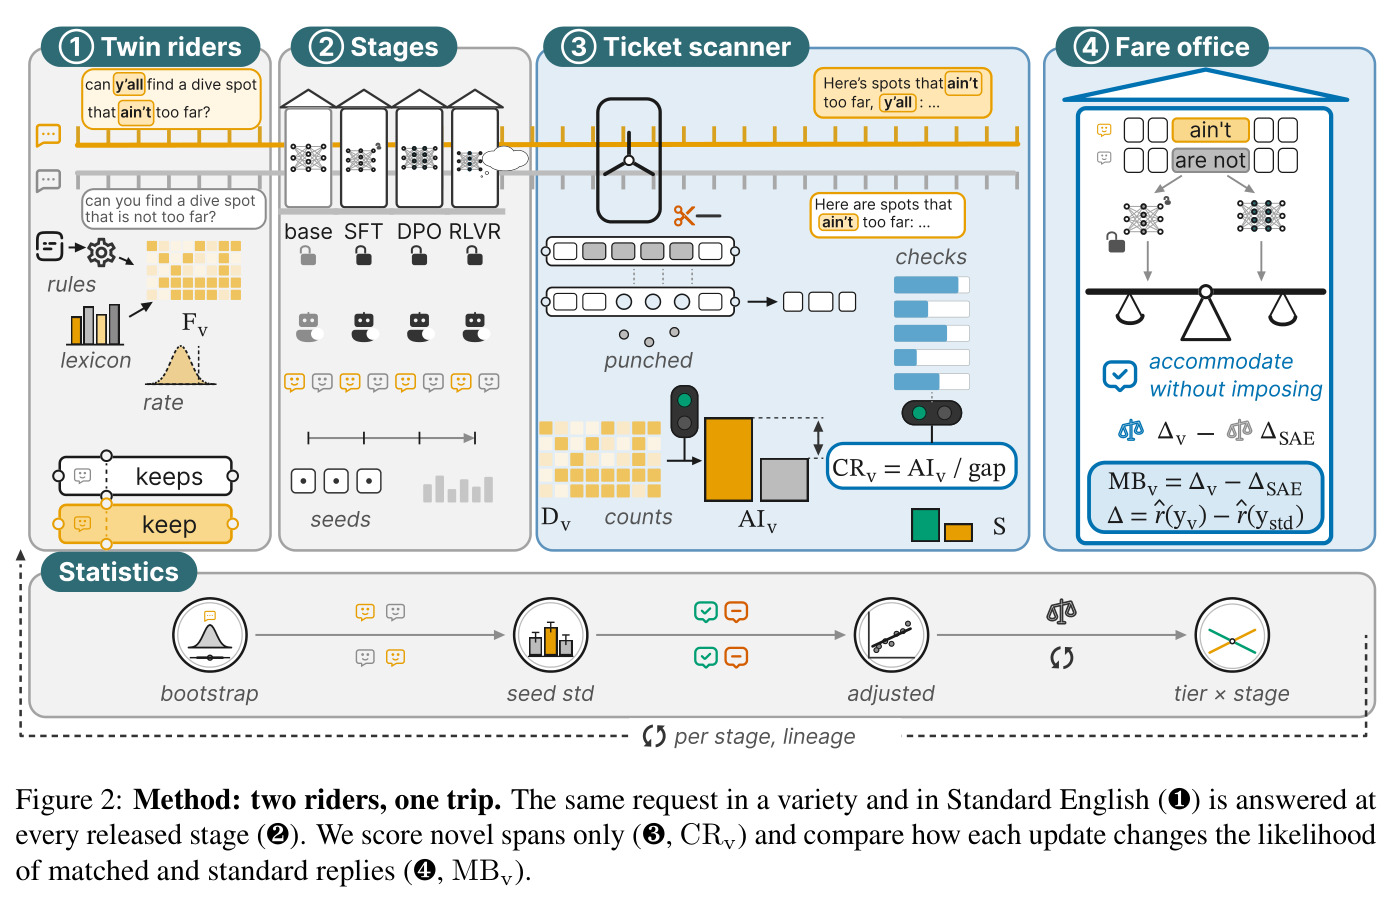
同一条请求写成两份:一份用某语言变体(如 AAE 的 who keep dragging、y'all),一份用标准美式英语(who keeps dragging),内容完全相同、只差变体特征。模型分别作答后,只对 novel spans(与请求不共享 4-gram 的 token,且不在引号内)打分,排除「复读用户原话」造成的虚假趋同;再在特征可能出现但用了标准变体的位置(opportunities)上统计实现率。
孪生设计把「变体」从内容中剥离出来,使趋同率 $CR_v$ 与更新诊断 $MB_v$ 都能在同一条请求内做配对比较,是论文两条测量通道的共同基石。
声望变体 vs 污名化变体与标准语言意识形态
社会语言学的态度研究(匹配伪装实验等)把英语变体排成声望层级:英式拼写、澳式英语等「声望线索」被普遍正面评价;非裔美式英语(AAE)、新加坡口语英语(Singlish)、尼日利亚皮钦语、阿巴拉契亚英语等则被污名化。标准语言意识形态认为只有一种「正确」变体、其余都是「错误」,机构通过奖励标准变体来再生产这一观念。
作者预注册了这一层级并据此预测:如果训练更新对声望变体的迎合多于污名化变体,就说明后训练复现了「向上趋同」的标准意识形态;这个层级是全部选择性分析的坐标系。
DPO 对数比更新诊断与匹配奖励
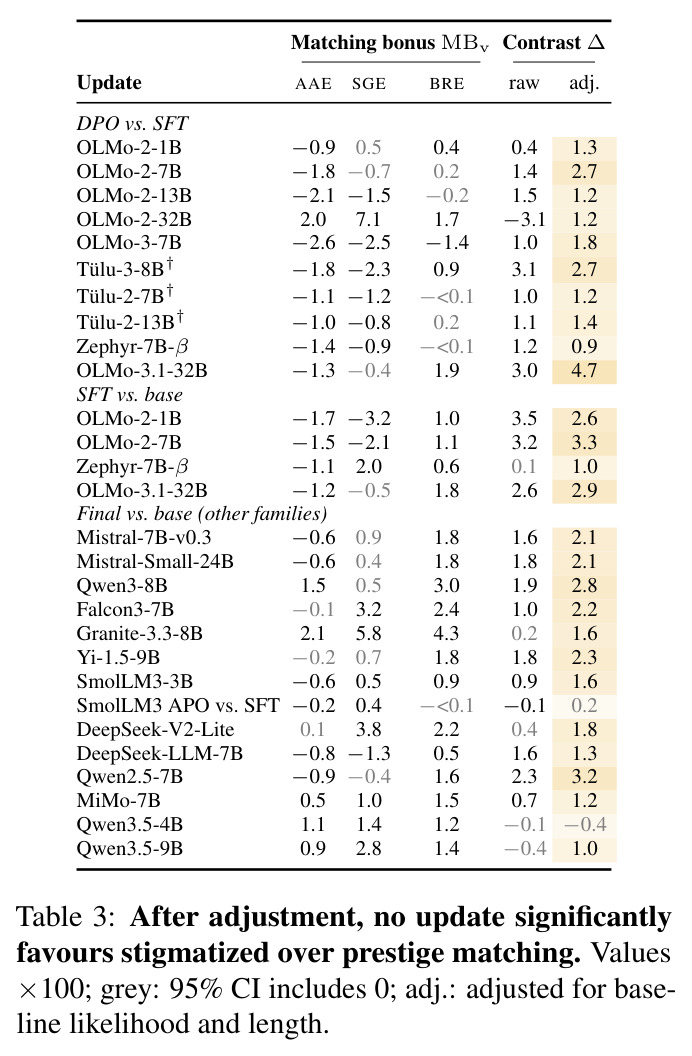
记 $\hat{r}_m(x,y)=\frac{1}{|y|}\left[\log\pi_m(y|x)-\log\pi_{m-1}(y|x)\right]$ 为阶段 $m$ 相对前一阶段对回复 $y$ 的长度归一化对数比(DPO 中它正是隐式奖励)。对同一条方言请求的两条内容匹配回复(一个匹配用户变体 $y_v$、一个标准回复 $y_{std}$)作差并用标准英语孪生归一,得到匹配奖励 $MB_v$,表示该训练步在多大程度上更抬举「匹配用户」的回复。作者强调这只是描述性诊断,不是已识别的奖励。
这是全文的「更新通道」度量:输出审计看不到的训练选择性偏好,全部是用它在公开 checkpoint 上读出来的,无需重训。
研究动机
用户用 AAE 向聊天机器人求助:「my sister, who keep dragging me to the movies… Do y'all have any tips?」,得到的却是清一色的标准英语回答。已有研究记录了这个问题:Fleisig et al. (2024) 发现 ChatGPT 强化方言歧视,Hofmann et al. (2024) 证明 AI 基于 AAE 语音做出隐性种族化决策,Mire et al. (2025) 发现奖励模型系统性地不喜欢 AAE,Ryan et al. (2024) 发现偏好调优制造方言差距。但这些证据要么来自闭源模型、要么只是 base 与 instruct 的两点比较,无法回答两个关键问题:第一,标准化默认到底是 SFT 学标准回复安装的,还是偏好优化阶段安装的?第二,只审计输出无法判断训练是否「一视同仁」——两个对所有人都说标准英语的模型,可能学到了完全不同的偏好,输出层面完全看不出差别。更麻烦的是方言特征在真实流量与训练数据中极其稀少:WildChat 的 162,842 条英文首问中约只有 0.12% 含经人工核实的 AAE 特征,OLMo-2-7B 偏好混合中仅 0.81% 的 prompt 能触发方言识别器。
本文的目标是本文要做两件事。诊断上:沿 10 条所有训练阶段公开的开放谱系(OLMo-2 1B/7B/13B/32B、OLMo-3-7B、OLMo-3.1-32B、Tülu-3-8B、Tülu-2-7B/13B、Zephyr-7B-β)逐阶段测量两个通道——回复是否趋同到用户的变体(输出通道,$CR_v$),以及每个训练步本身是否偏好趋同(更新通道,$MB_v$),从而定位标准化进入训练的位置,并判断它对不同声望等级的变体是否一视同仁。干预上:基于诊断结果设计一种偏好数据配方(CAP,校准顺应配对),让模型在方言用户面前适度趋同,又不把方言强加给标准英语用户,同时不损失指令遵循与推理能力。
与已有工作不同的是,本文的独特之处在于「双通道阅读」:把模型做什么(输出)与训练偏好什么(更新)严格分开。更新通道借助相邻公开 checkpoint 之间的对数比,在内容完全相同、只差变体特征的回复对上读取,无需重新训练——这在此前的方言公平研究(用奖励模型给固定文本打分)和顺应研究(只测功能词风格匹配)中都没有出现过。第二,它在 10 条谱系上做逐阶段归因,而不是常见的 base/instruct 两点比较。第三,假设、声望层级、证伪条件都在主实验前预注册(2026-10-01 冻结),连「没有成立的预测」也全部报告。第四,把诊断直接转化为数据干预:用 U/O/A 三类配对同时惩罚不顺应、过度顺应与强加三种失败模式,而不是单方向地「越像用户越好」。
核心方法
先说直觉:把每个阶段的模型当成一个同时接待双胞胎的客服——同一条请求的方言版和标准英语版各答一次,看它对哪一边说话更像对方(输出通道);再翻训练账本,看训练本身给「像对方」的那个答案涨了多少分(更新通道)。技术上分四步:第一,287 条第一人称请求、6 种任务类型,由博士级母语者渲染成 6 种变体(AAE、Singlish、尼日利亚皮钦语、阿巴拉契亚英语、英式、澳式)加标准美式英语和非正式/正式两个语域控制,方言语法特征按 Multi-VALUE 的 eWAVE 规则以 0.8 倍涌现率施加。第二,回复只对 novel spans 打分,特征密度 $D_v(x)=\frac{\sum_{f\in F_v} real_f(x)}{\sum_{f\in F_v}\left[real_f(x)+opp_f(x)\right]}$,趋同率 $CR_v$ 用双胞胎请求之间的密度差归一化。第三,更新通道用相邻阶段的长度归一化对数比 $\hat{r}_m$ 在孪生回复对上作差得到 $MB_v$。第四,把诊断结论转化为 CAP 偏好数据配方,在 OLMo-2-1B 与 Qwen3-8B 上重训验证。
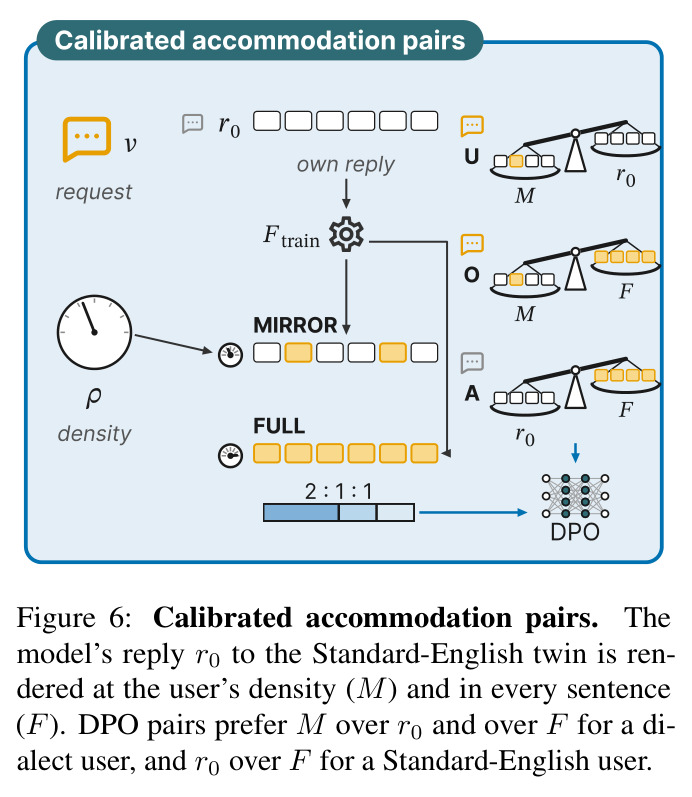
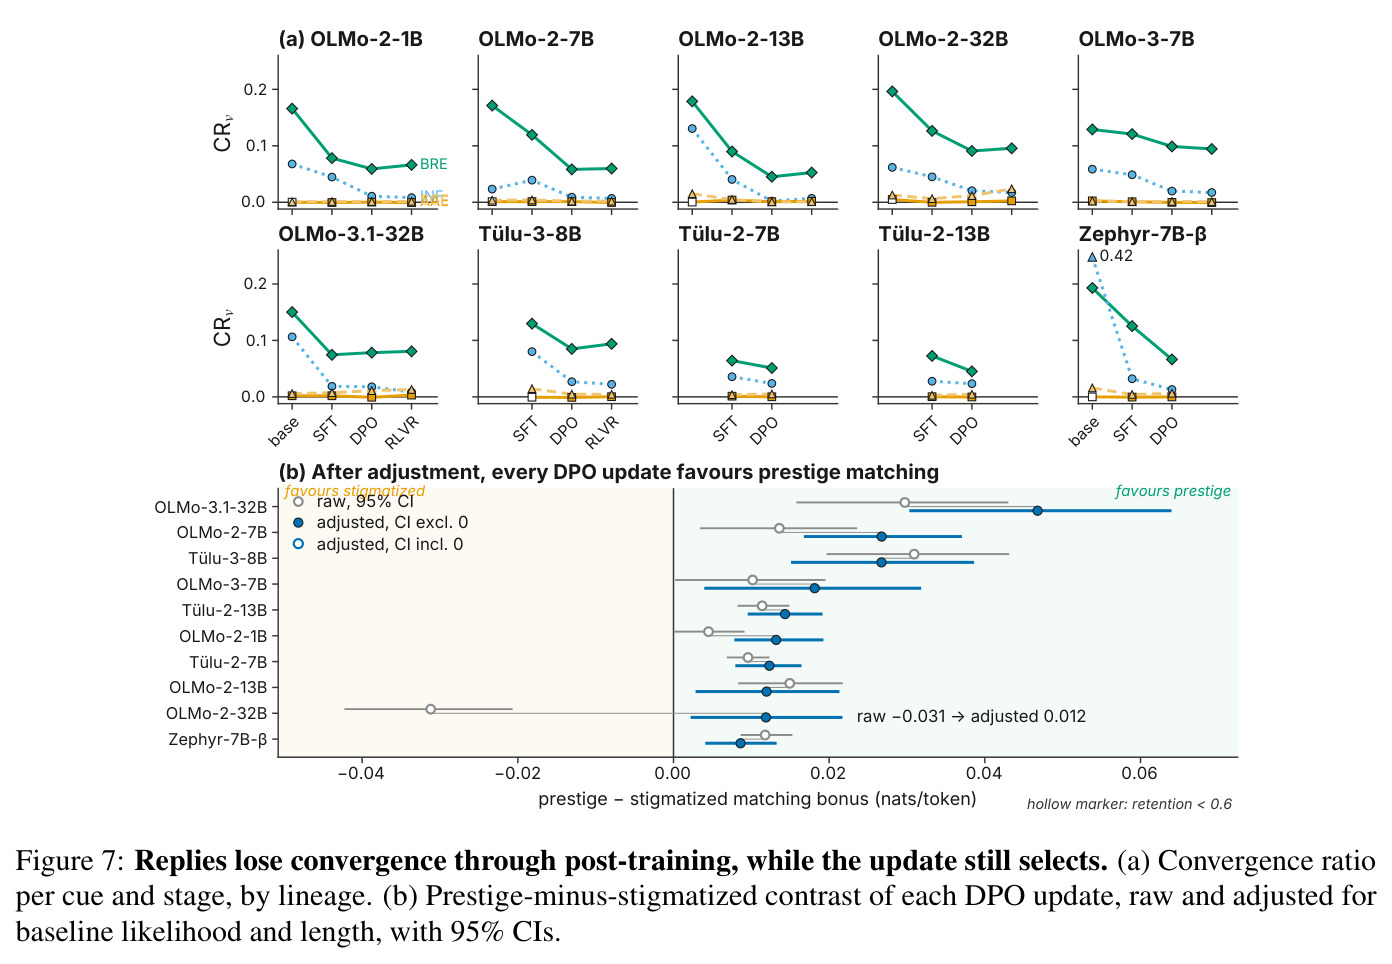
核心创新有三点。其一,内容匹配回复对 + 更新诊断:DPO 的隐式奖励本来就是策略与参考策略的对数比,作者直接用公开的相邻 checkpoint 把它读出来,在同一条请求、仅差变体特征的两条回复上比较,并用 OLS 调整「基线可能性高低」和「回复长度」两个混杂因素(报告 raw 与 adjusted 两个对比)——OLMo-2-32B 的 raw 对比是 -0.031、调整后是 +0.012,恰好说明两种读法回答的是不同问题。其二,CAP 的三类配对各自惩罚一种失败模式:U 对(选密度匹配的 M、拒绝原始回复 $r_0$,惩罚不顺应)、O 对(选 M、拒绝每句都带特征的 F,惩罚过度顺应)、A 对(标准英语用户的请求:选 $r_0$、拒绝 F,惩罚强加方言),并用密度匹配(M 的密度最接近用户且不超过 1.25 倍)取代单边「越像越好」。其三,逐阶段 + 预注册的审计协议本身:把 CAT 理论的每个构念映射到一个可测量量。
方法步骤详情
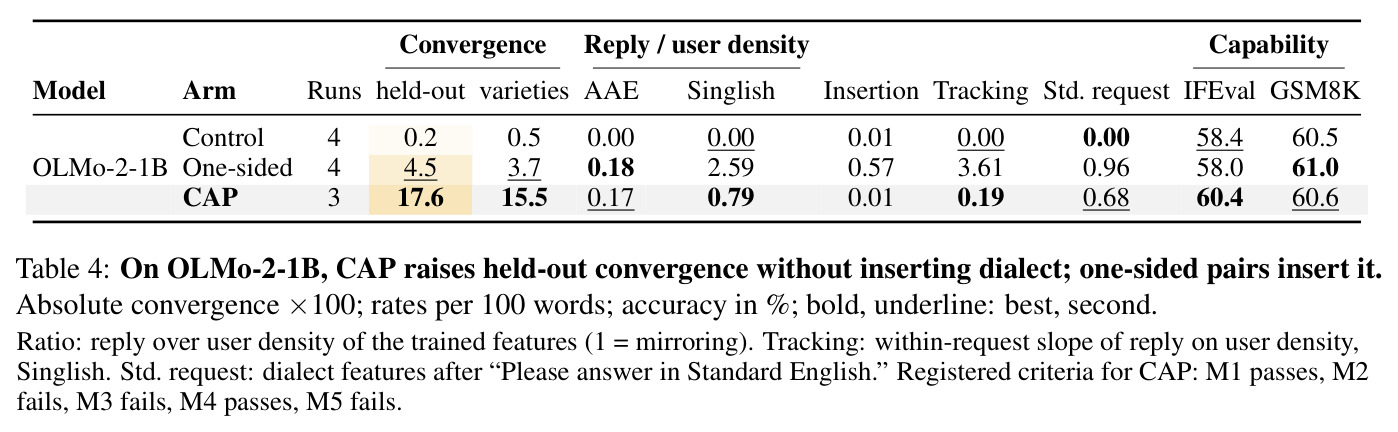
第一步,构造孪生请求:287 条请求 × 6 种变体 + SAE + 非正式/正式语域;检测器先在 8,000 条 Dolly-15k 金标句上验证,入选的 13 个特征 recall 0.81–1.00、precision ≥0.99、假阳性 ≤0.9%,并设门槛:每个保留特征在标准英语请求的回复上假阳性 ≤2%。第二步,逐阶段生成回复:10 条谱系的 base/SFT/DPO/RLVR checkpoint 用 vLLM 推理(温度 0.7、top-p 0.95、3 个采样种子 × 2 条样本),另测 14 个流行家族和 5 个部署聊天机器人。第三步,输出通道打分:novel-span 过滤后计算 $CR_v(m)=\frac{AI_v(m)}{\mathbb{E}_i D_v(p_{v,i})-\mathbb{E}_i D_v(p_{SAE,i})}$,分裂指数 $S$ = 声望线索均值 − 污名化变体均值,能力 $COMP_v$ 用显式请求回复与真实文本(AAE 推文、NUS 短信语料)的特征率之比衡量。第四步,更新通道:计算 $MB_v(m)=\hat{r}_m(x_v,y_v)-\hat{r}_m(x_v,y_{std})-\hat{r}_m(x_{SAE},y_v)+\hat{r}_m(x_{SAE},y_{std})$,再配对求「声望 − 污名化」对比并做似然/长度调整。第五步,剂量实验:从 OLMo-2-1B 的 SFT checkpoint 用官方发布配方重跑 DPO($\beta=5$、学习率 $2.5\times10^{-6}$、1 个 epoch、每步 128 对),在固定的 120k 对子集上加 0/1k/5k/20k/60k 个 accommodation-consistent 对(chosen 是标准回复的方言渲染、rejected 是原标准回复),对照臂加等量标准对。第六步,构建 CAP:取模型对标准英语孪生的回复 $r_0$,用训练特征重渲染成 M(密度最接近用户、≤1.25 倍)和 F(每句都带特征),按 U:O:A = 2:1:1 组成 DPO 数据的三分之一。第七步,在 300 条全新请求上按预注册判据 M1–M5 评测(held-out 趋同增量 ≥0.02 且 CI>0;校准更接近 1;追踪斜率为正;IFEval ±2 点内;标准英语请求合规)。
技术新颖性
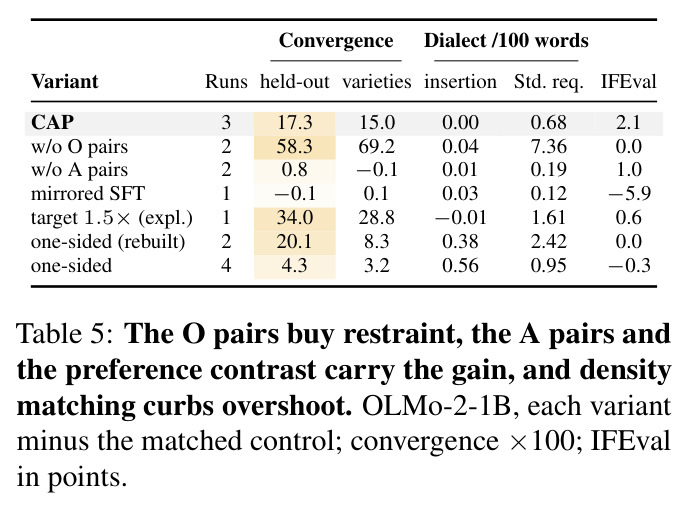
与已有工作的本质区别:Blevins et al. (2026) 等测的是功能词层面的风格匹配(LSM),作者在本文数据上实测这些指标在变体与阶段之间的变化小于 0.04,根本无法区分变体;Mire et al. (2025) 用奖励模型给固定文本打分,而本文读的是策略自身的更新,能看到「训练在学什么」而非「一个外部评分器喜欢什么」;同质化(homogenization)研究只测输出方差下降,本文测的是有方向的标准化——所有非标准线索都滑向同一个标准。数据侧,CAP 与单边配对的差别是把「匹配用户」从一个方向的偏好变成三种约束的组合,并用密度匹配锚定幅度:消融显示去掉 O 对趋同升到 0.583 但对标准英语用户强加 0.039 特征/100 词,去掉 A 对增益几乎消失(0.008),而直接在镜像回复上做 SFT 完全无效(-0.001),证明增益来自偏好对比而非模仿。这种「先诊断、后配方、配方反哺诊断」的闭环设计在方言公平文献中是新的。
实验结果
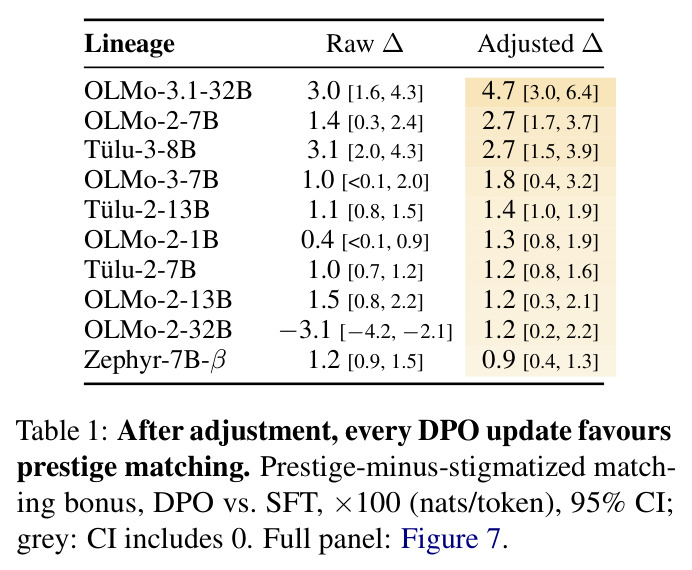
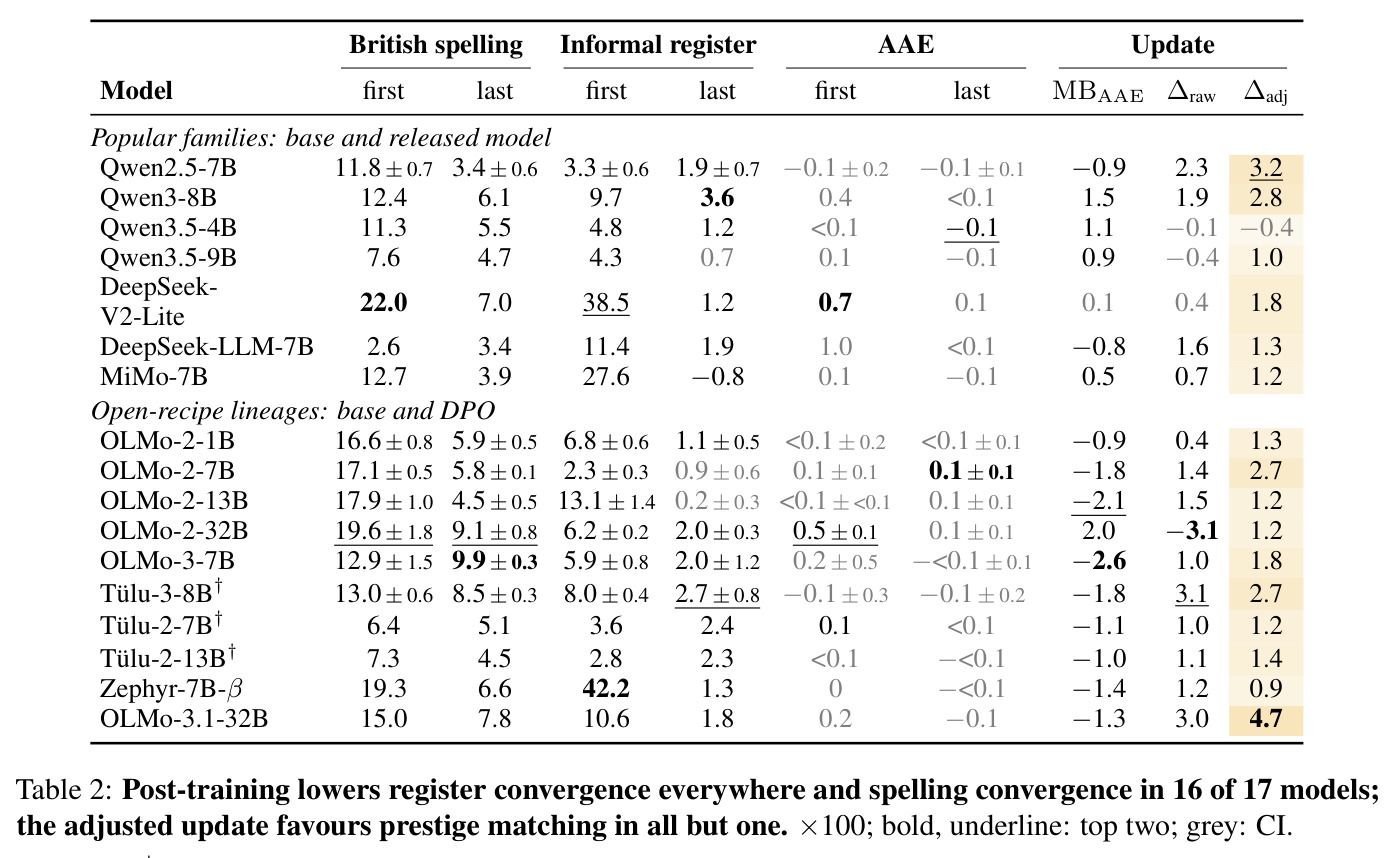
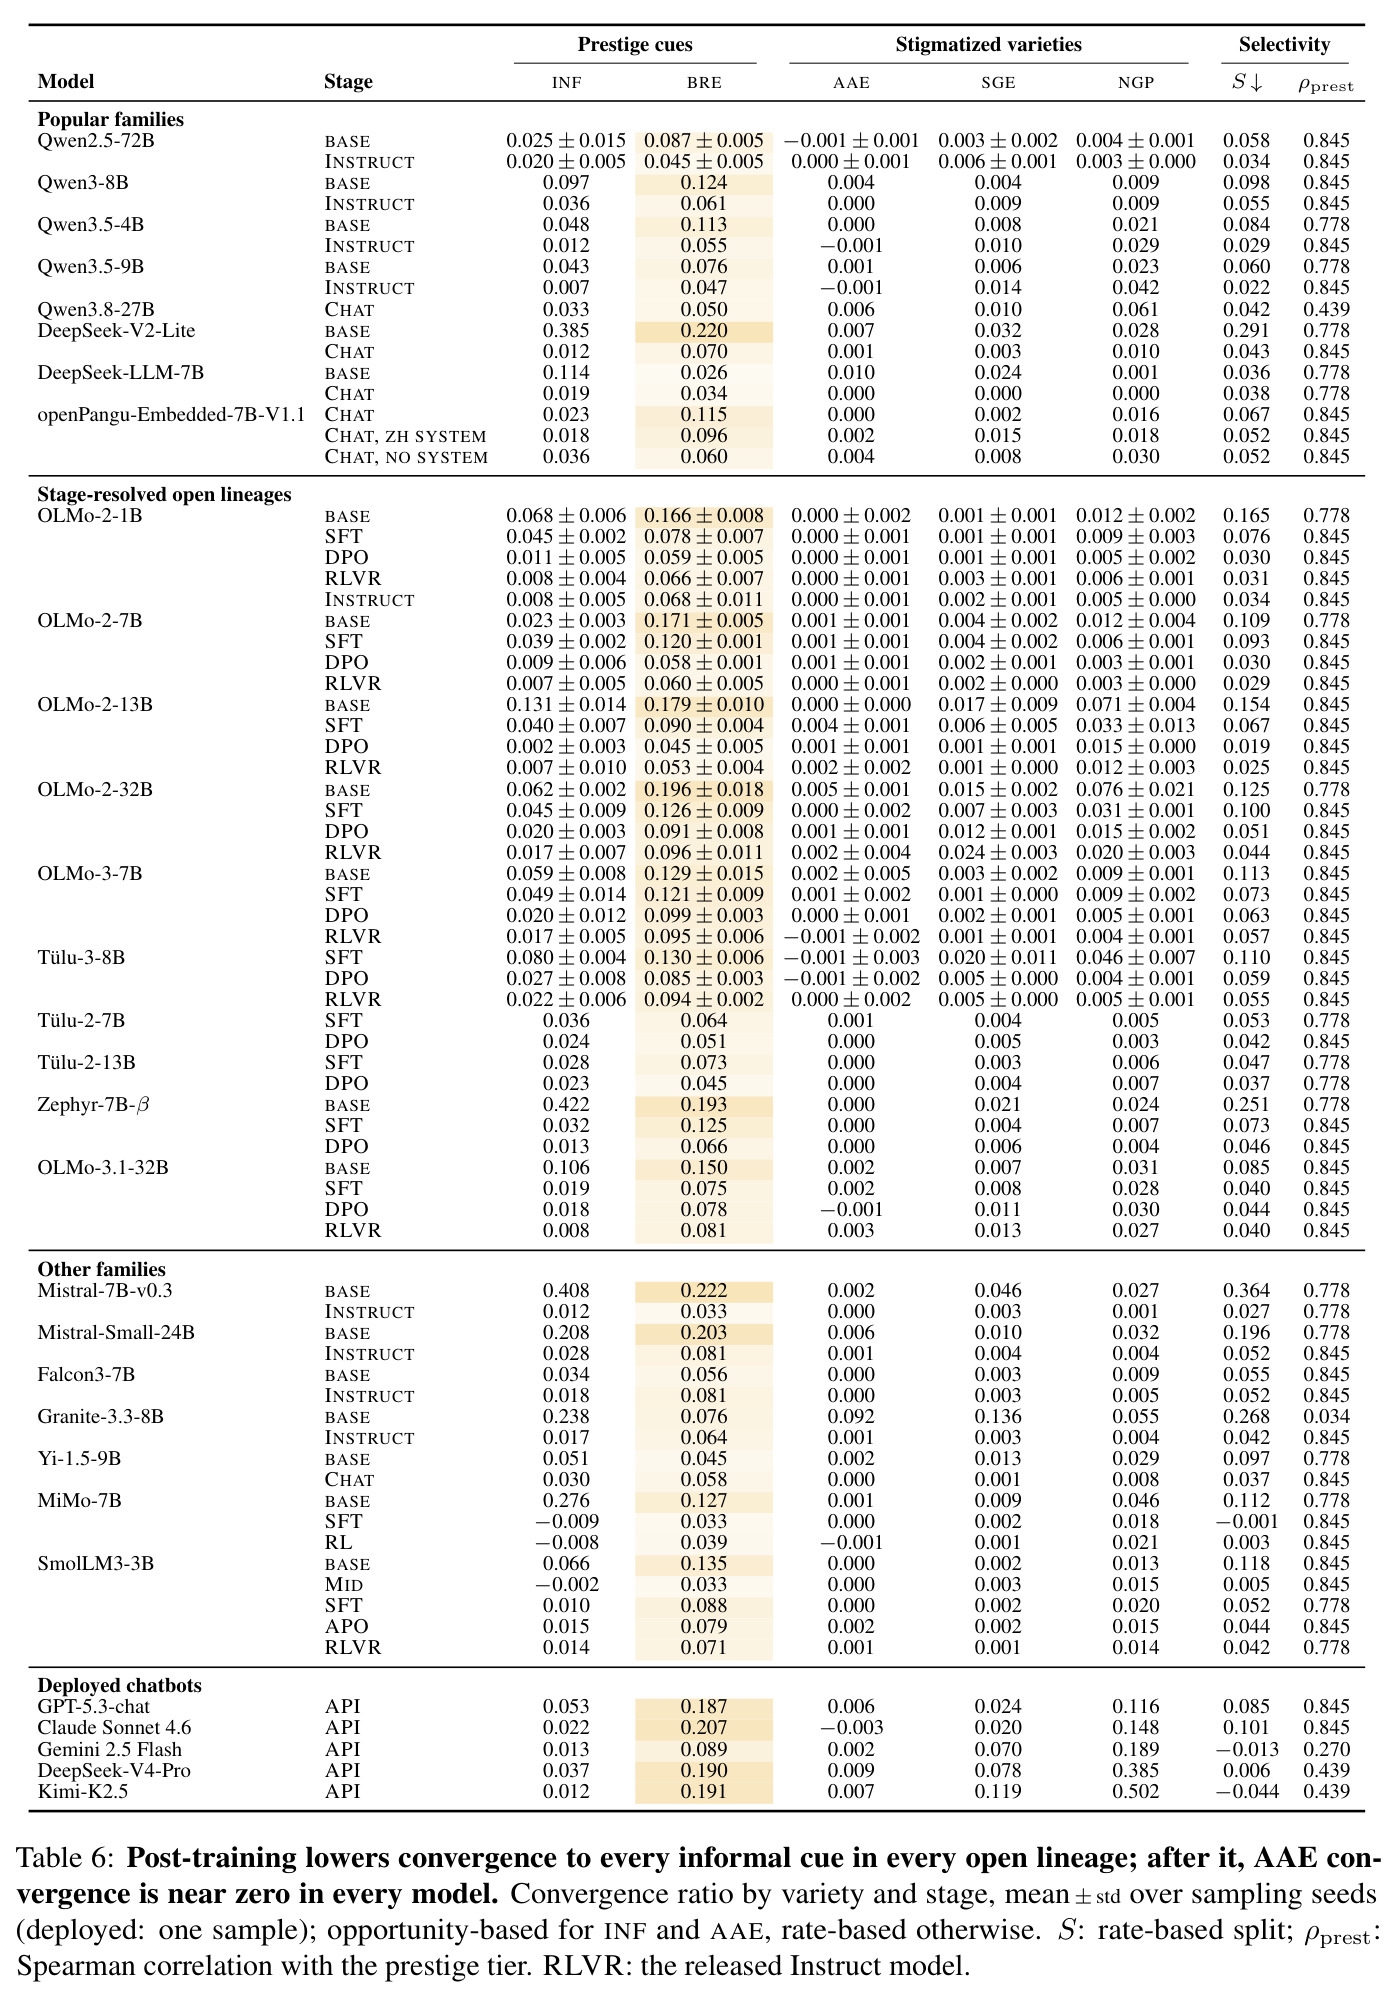
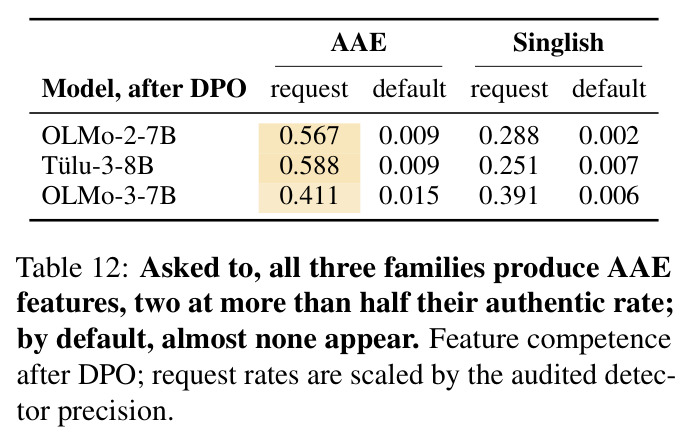
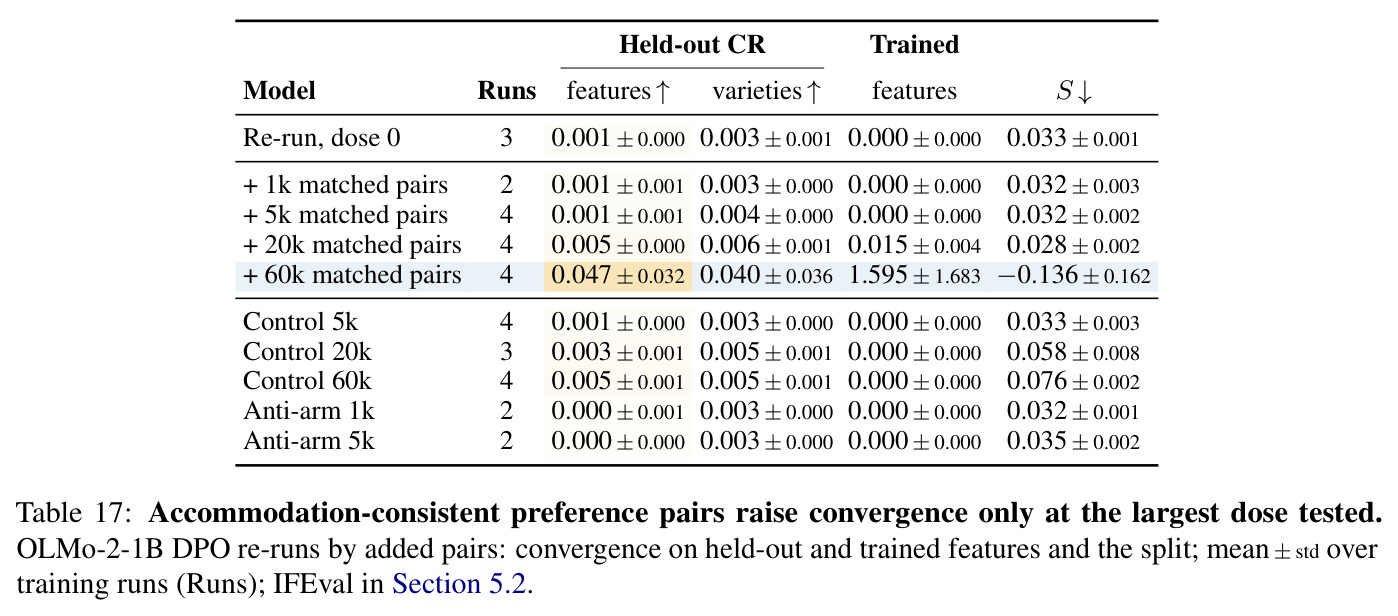
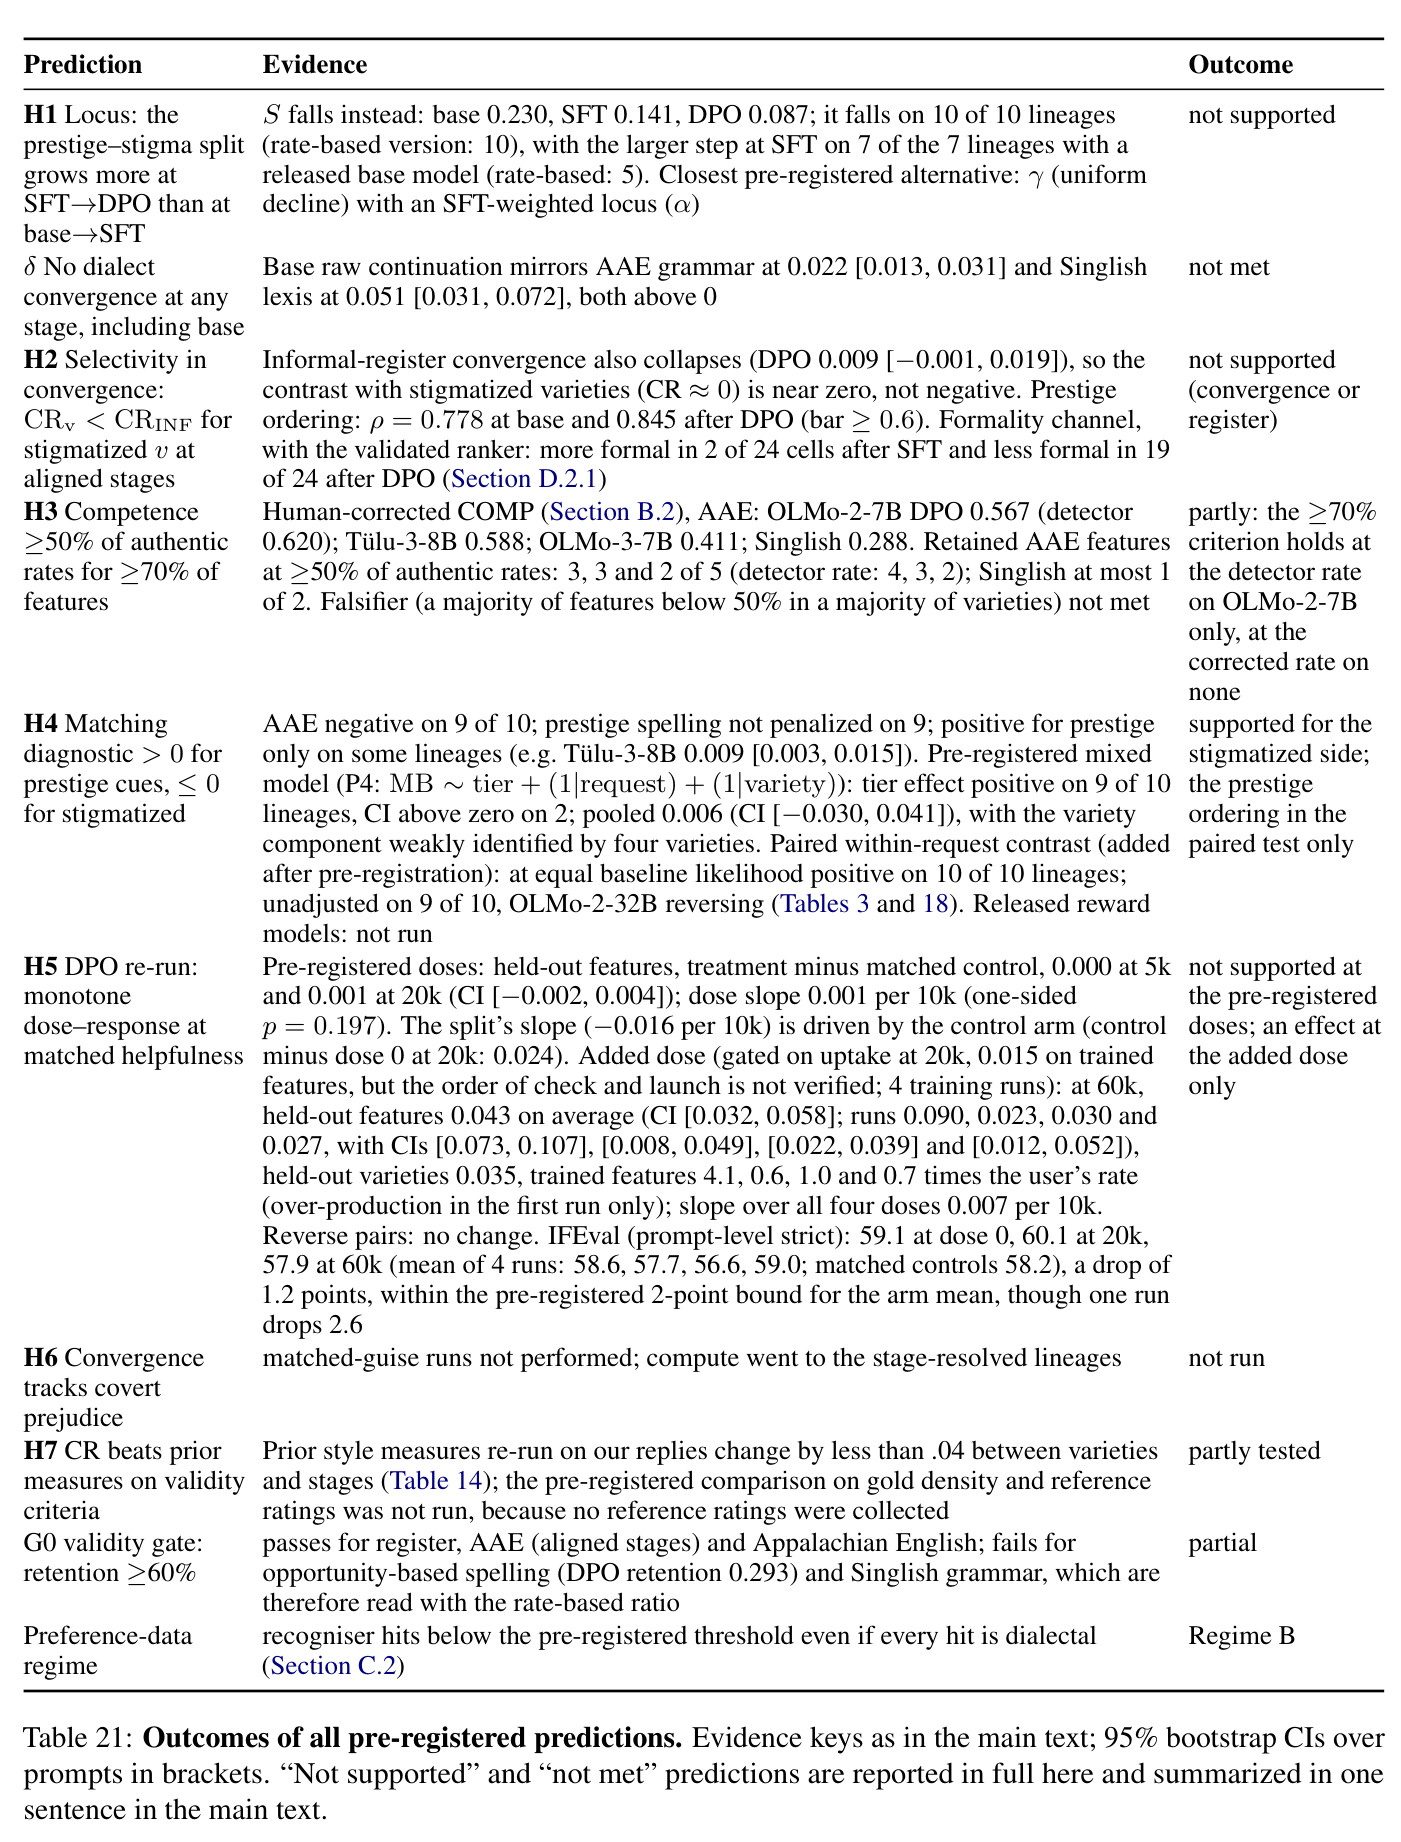
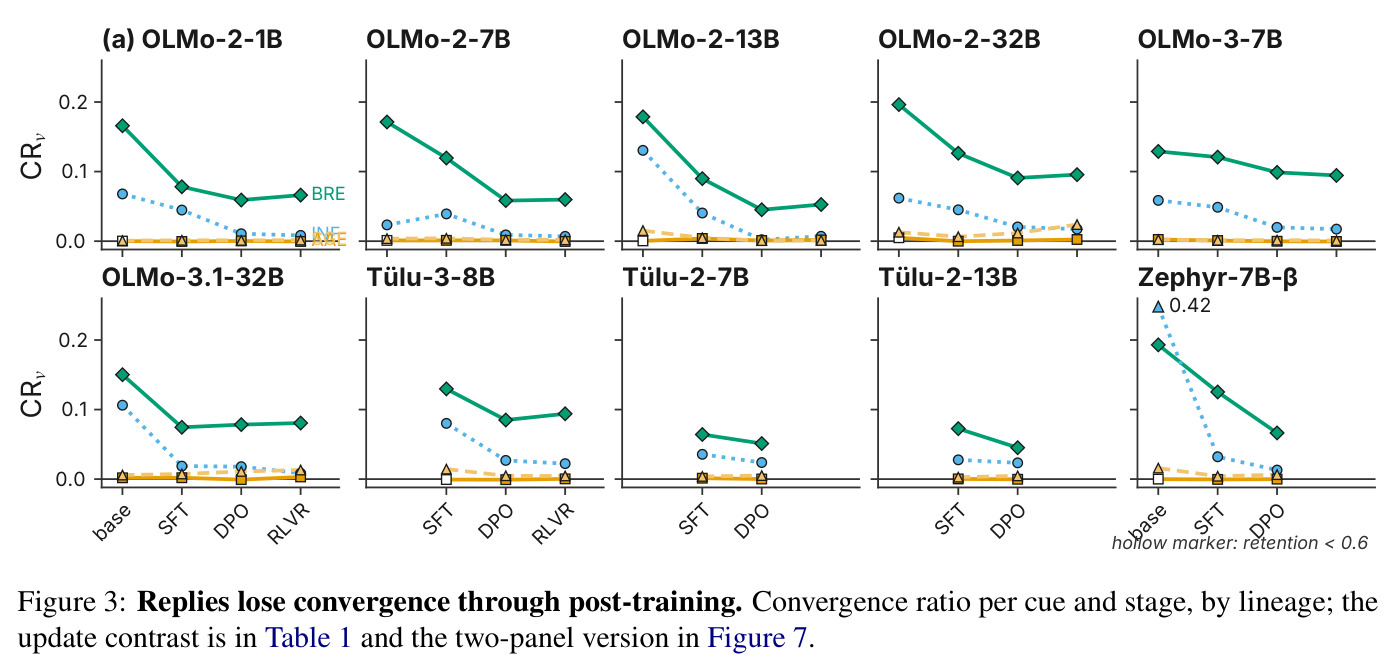
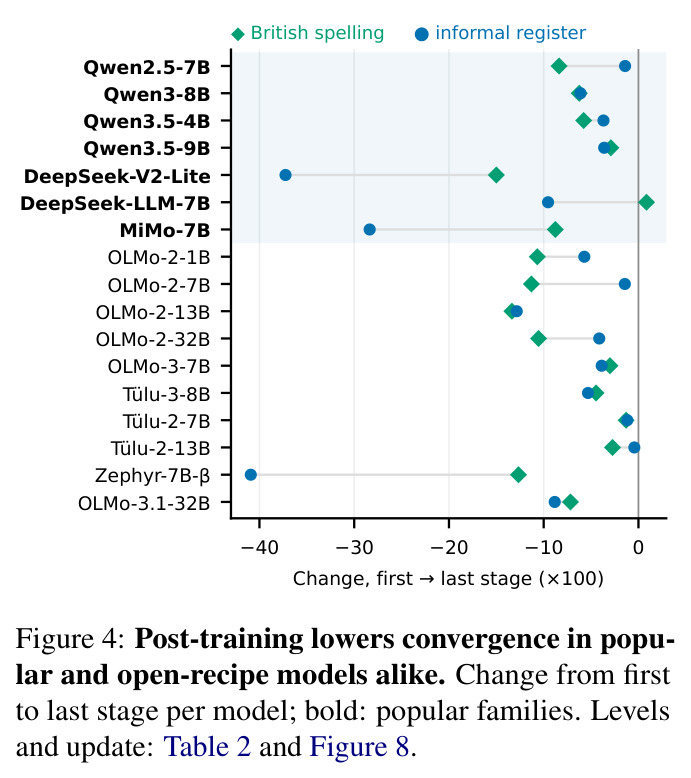
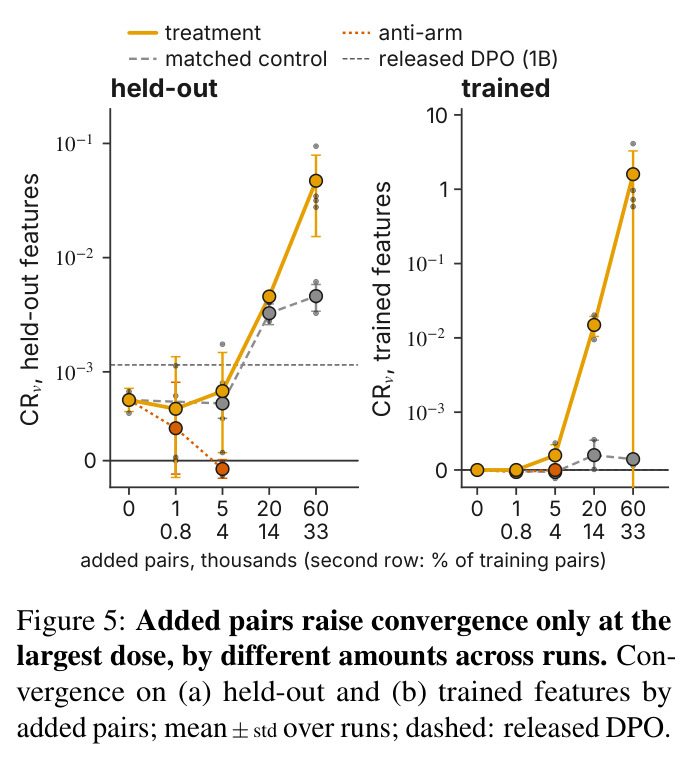
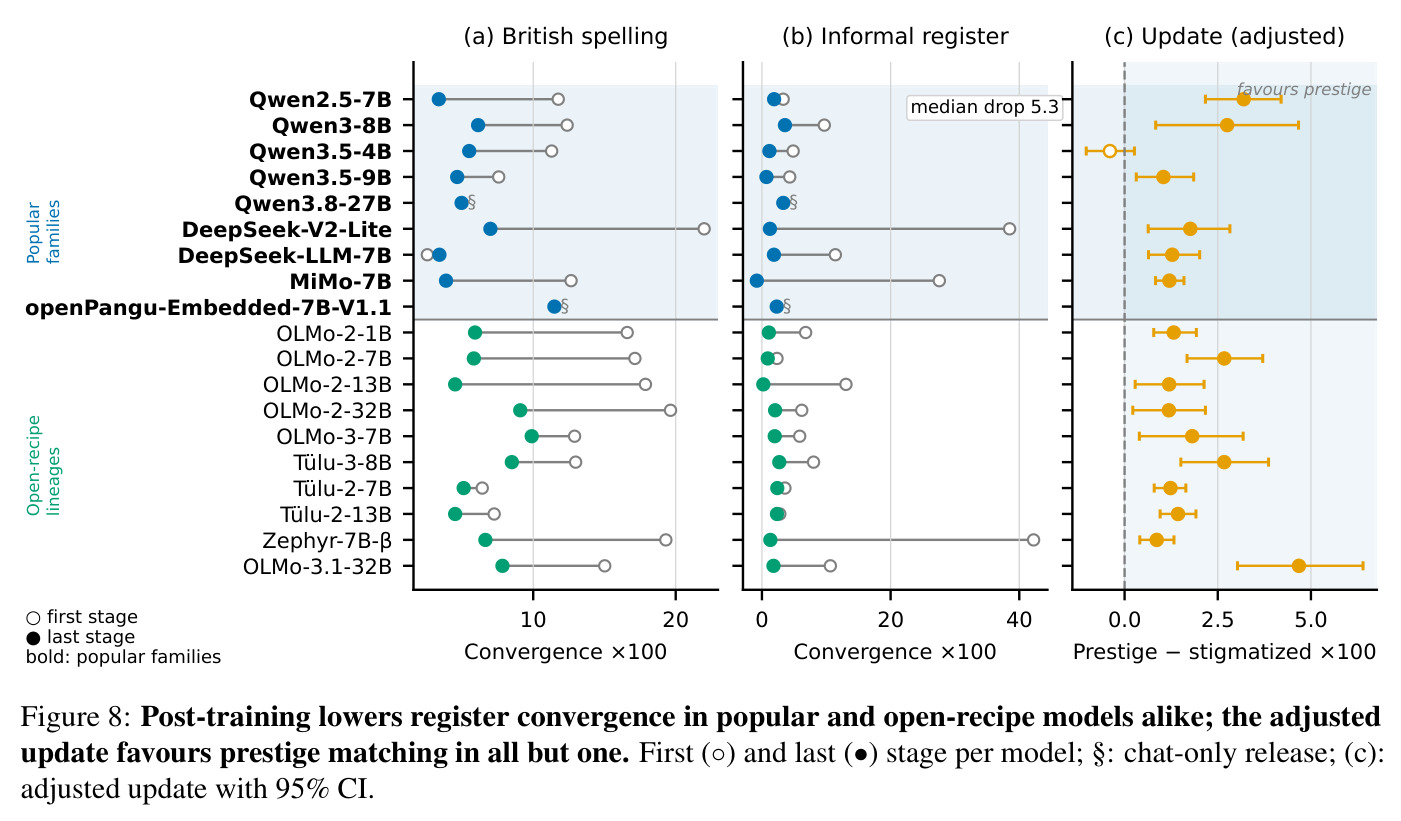
第一,输出全面标准化:后训练把所有变体的回复都拉向标准英语。OLMo-2-7B 对英式拼写的趋同率从 base 0.171 → SFT 0.120 → DPO 0.058 → RLVR 0.060;非正式语域从 base(chat 模板下)0.413 跌到 DPO 后 0.009;从首个发布阶段到 DPO,声望-污名化分裂指数 $S$ 在 10/10 谱系全部下降。17 个流行/开放模型中 16 个拼写趋同下降(例外是起点本就极低的 Falcon3-7B、Yi-1.5-9B、DeepSeek-LLM-7B);所有模型后训练后 AAE 趋同 ≤0.001。声望排序在 base 阶段就已存在(OLMo-2-7B 上 $\rho=0.778$,DPO 后 0.845)——后训练降低了趋同的整体水平但没有安装这个排序。部署聊天机器人同样标准化 AAE(≤0.009),但部分会用尼日利亚皮钦语回应(0.116–0.502),说明标准化并非不可避免。第二,更新是有选择性的:调整基线可能性与长度后,DPO 更新在 10/10 谱系上都偏好迎合英式/澳式拼写胜过 AAE/Singlish,合并对比 +0.020 nats/token(CI [0.014, 0.027]);$MB_{AAE}$ 在 9/10 谱系为负(OLMo-2-7B:-0.018,CI [-0.024, -0.012]);raw 对比在 9/10 为正,唯一反转的 OLMo-2-32B 是因为它整体抬举低可能性回复(斜率 -0.034/SD)。第三,能力仍在:显式请求时 OLMo-2-7B(DPO) 以 0.567 的真实文本率产出 AAE 特征(默认回复仅 0.009),Tülu-3-8B 达 0.588,OLMo-3-7B 0.411。第四,剂量实验:加 1k(0.8%,接近自然占比)、5k、20k(14%)个 accommodation-consistent 对都无效(20k:+0.001,CI [-0.002, 0.004]),60k(33%)才在 4/4 次运行中超过对照(0.090/0.023/0.030/0.027,均值 0.043,CI [0.032, 0.058]),并迁移到 held-out 变体(+0.035);IFEval 57.9 对对照 58.2;但完全没有校准——标准英语回复被插入 0.10–1.06 个方言特征/100 词(对照 0.00),Singlish 回复达用户密度的 1.07–9.47 倍、AAE 只有 0.17–0.47 倍。第五,CAP 主结果(Table 4):OLMo-2-1B 上 held-out 趋同比匹配对照 +0.173(CI [0.138, 0.207]),是单边配对 0.043 的 4 倍;held-out 变体 +0.150(单边 0.032);对标准英语用户的方言插入仅 0.001 特征/100 词(CI [-0.008, 0.013],单边是 0.560);IFEval +2.1 点;Singlish 校准比率 0.79(单边 2.59)。但 M2/M3/M5 未通过:对「请用标准英语」的显式请求仍带 0.68 特征/100 词,追踪斜率仅 0.191。Qwen3-8B(LoRA-DPO)上 CAP 只有 +0.017,低于单边配方的 0.154,未达 M1。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 方言用户回复标准化(英式拼写,OLMo-2-7B) | 趋同率 CR | DPO 后 0.058(RLVR 0.060) | base 模型 0.171 | 趋同下降约 66%;非正式语域 0.413 → 0.009;AAE 趋同所有模型后训练后 ≤0.001 |
| DPO 更新对声望变体的偏好(10 条开放谱系) | prestige−stigmatized 匹配奖励差(nats/token,×100,调整后) | 10/10 为正,合并 +2.0(CI [1.4, 2.7]) | raw 合并 +1.1(9/10 为正;OLMo-2-32B raw 为 -3.1) | 调整基线可能性与长度后全部为正;14 个流行家族更新中 12 个为正、0 个反转 |
| 显式请求下的方言产出能力(AAE) | 相对真实文本的特征率(人工审计校正后) | OLMo-2-7B(DPO) 0.567;Tülu-3-8B 0.588;OLMo-3-7B 0.411 | 默认回复仅 0.009(OLMo-2-7B) | 「会而不做」:产变体能力保留过半,默认输出却几乎为零,证明标准化是偏好而非能力损失 |
| DPO 重跑剂量实验(加入 accommodation-consistent 对) | held-out 特征趋同增量(对匹配对照) | 60k 对(33%)时 4/4 次运行为正,均值 +0.043(CI [0.032, 0.058]),迁移 +0.035 | 20k 对(14%)时 +0.001(CI [-0.002, 0.004]),与对照无差别 | 仅最大剂量有效且无校准:标准英语回复被插入 0.10–1.06 特征/100 词,Singlish 超冲至用户密度 1.07–9.47 倍 |
| CAP 在 OLMo-2-1B 上的主实验 | held-out CR 增量 / 方言插入 / IFEval | +0.173(CI [0.138, 0.207]);插入 0.001/100 词;IFEval 60.4;Singlish 比率 0.79 | 匹配对照 +0.002;单边配对 +0.043、插入 0.560/100 词、IFEval 58.0、Singlish 比率 2.59 | 增益达单边配方 4.0 倍且几乎零强加;代价是 M3(追踪)、M5(标准英语请求合规,仍带 0.68/100 词)未达标 |
| CAP 迁移到 Qwen3-8B(LoRA-DPO) | held-out CR 增量 | +0.017(CI [0.009, 0.026]) | 单边配方 +0.154 | 未达预注册 M1 门槛(0.02),说明跨模型/训练方式迁移有限 |
局限与改进
作者明确承认的局限:研究仅覆盖英语、6 个变体和 32B 以下全阶段公开的开放谱系,闭源模型只能通过行为间接观察;所有请求是规则化渲染,未按真实文本的特征密度校准,对真实用户书写的趋同可能不同(仅用 225 条人工翻译 AAE 推文做了有限核查,且 OLMo-2-7B DPO 对 22% 的推文对拒答);检测器只覆盖有限的特征清单,人工验证仅 84 项共识标注且无独立双标注、未报告标注者间一致性。CAP 本身:在 1B 上通过 M1/M4 但未通过 M2/M3/M5(校准、追踪、标准英语合规),在 Qwen3-8B 上连 M1 都未通过;因果重跑只在 1B 上做,效应只在最大剂量出现且 run 间波动大(0.023–0.090),其中一次运行过度产出 4.1 倍用户率,存在漫画化风险。我自己的补充观察:其一,识别器排除了 AAE 核心语法特征(copula absence 假阳性 0.513、零第三人称 -s 假阳性 0.592),审计很可能低估了真实趋同;其二,CAP 只实现「不强加」而非真正跟随用户密度,AAE 回复只有用户密度的 0.17–0.47 倍,属于欠顺应;其三,只测单轮首问,多轮对话和 code-switching 场景未涉及;其四,关键的配对对比检验晚于预注册(虽做了敏感度分析),严格来说有事后构造的成分。
独立分析的弱点
第一,渲染保真度:规则化渲染的方言密度与真实文本不符,模型对真实 AAE/Singlish 的反应可能不同——人工核查显示识别器在真实 WildChat 请求上的精度只有 3/18,说明此类工具在原生方言文本上很不可靠。改进方向:在大规模真实方言语料(社交媒体、方言树库)上校准渲染器和判据,或直接用社区志愿者写的真实请求。第二,校准不完整:CAP 的回复/用户密度追踪斜率仅 0.191,对显式「请用标准英语」的请求仍带 0.68 特征/100 词,AAE 回复只有用户密度的 0.17–0.47 倍——它解决了「强加」但没解决「跟随」。改进方向:把密度窗口做成更细的分档、或改用带密度约束的在线 RL 而非静态 DPO 对。第三,规模与配方局限:全量重训只在 1B 模型上完成,Qwen3-8B 只做了 LoRA-DPO 且未过 M1,未尝试 GRPO、APO 或在线 RLHF。改进方向:在不同规模、不同偏好算法上系统扫描剂量与 U:O:A 配比,给出可迁移的配方。第四,特征覆盖:识别器只保留 13 个特征,排除了 copula absence、零第三人称 -s 等 AAE 标志性语法,趋同率可能是低估。改进方向:用经人工验证的更强检测器(如约束解码的 LLM judge)补齐特征清单。第五,评价维度单一:只测了特征实现率,没有测说话人偏好与感知(预注册的 H6 匹配伪装实验因算力未执行),一次运行过度产出 4.1 倍说明缺乏上限控制时有漫画化风险。改进方向:与方言社区共创评价协议,把「何时该用变体」的决定权交还用户。第六,更新诊断只有描述性解释力:它说明更新偏好什么,但不回答为什么(作者未训练这些模型,偏好数据审计只是相关性)。
未来方向
作者提出的方向:模型发布时应把更新诊断与输出审计并列报告,让公众能看到训练偏好而不仅是行为;CAP 需要改进校准与追踪(M3 失败意味着模型还不会「跟着用户的密度走」);是否以及何时应该用某个变体,应由该变体的说话者群体决定(Sandoval et al. 2025),需要补上态度↔行为的匹配伪装研究(H6);部署聊天机器人已经能用尼日利亚皮钦语回应(0.116–0.502),说明标准化不是不可避免的,值得研究这些系统用了什么数据或流程。基于本文成果可以延伸的方向:把更新诊断推广到其他受保护属性(性别语体、其他语言的变体如印度英语、西语英语)和更多后训练算法(APO、GRPO、在线 RLHF),形成「逐阶段公平审计」的标准流程;在真实偏好数据管道中系统注入 CAP 式配对,绘制从 0.8% 到 33% 的完整剂量-收益-风险曲线;把隐式奖励诊断与显式奖励模型评测(RewardBench 式)对齐,定位偏好是在数据里还是在算法里形成的;研究多轮对话与 code-switching 中的顺应动态;以及方言与拒绝率/安全行为的交互——本文发现 OLMo-2-7B 对标准英语推文的拒答反而更多(17% vs 12%),这条线索值得追下去。
复现评估
开源情况很好。代码与数据在 github.com/kouzhizhuo/cap-accommodation(以及匿名评审版 anonymous.4open.science/r/cap-accommodation),包括 287 条请求及其全部变体渲染与有效性门控、13 个特征检测器、完整分析与重跑代码、人工标注(84 项盲审共识标注、20 条 WildChat 请求与 40 条回复的自然度检查)、以及预注册文件(SHA-256 固定,附偏差日志——连「预测不成立」都逐条报告)。所有 checkpoint 都钉在 Hugging Face snapshot 哈希上(Table 7),诊断部分只需下载公开模型推理即可复现。算力需求:总计 ≥298 GPU 小时(NVIDIA H800),其中 185 小时用于 DPO 重跑,GRPO 用 4 卡 verl 0.9.1——诊断实验用单机数卡即可完成,CAP 训练需要约 60+ GPU 时和 DPO 工程经验。数据限制:AAE 推文与 EnDive 因许可不再分发(提供从原始来源重建孪生的脚本),重训后的 checkpoint 不发布(需自行重跑),部署聊天机器人的回复待提供方条款允许后发布。总体复现难度中等:核心诊断结果(Tables 1–3、Table 6)复现门槛低,CAP 主结果(Table 4)需要完整重训且 run 间有方差(4 次运行增益 0.023–0.090),建议按作者发布的三次运行均值评估。
论文图表
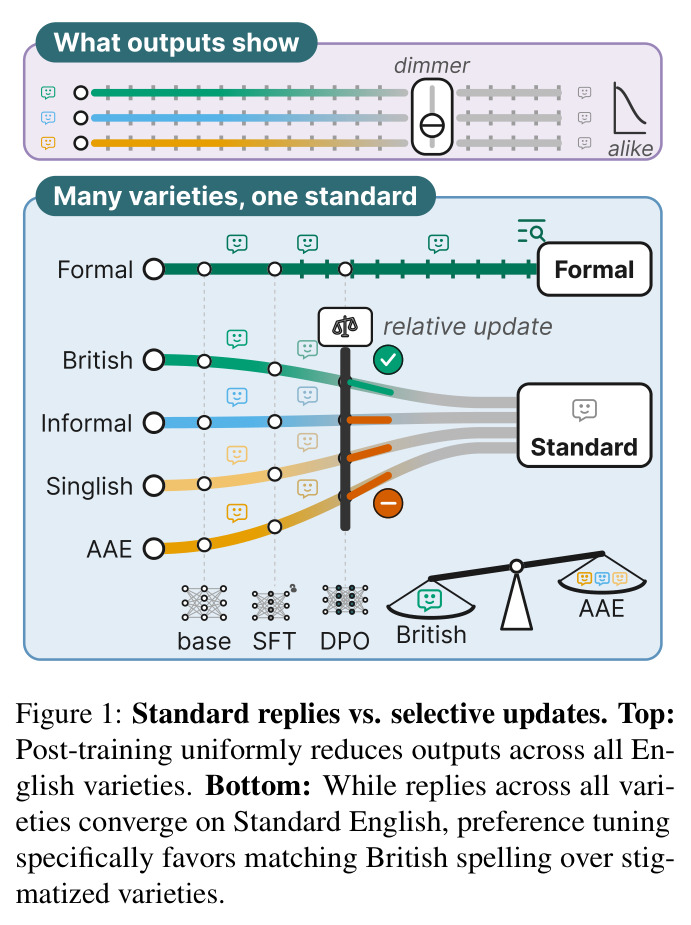
上:不同变体(formal、informal、British、Singlish、AAE 等)的回复在 base→SFT→DPO 各阶段都收敛到同一个标准英语(「many varieties, one standard」);下:以 relative update 视角显示,偏好调优的选择性更新在回复都已统一的情况下,仍然更偏袒「匹配英式拼写」而冷落被污名化变体(AAE)。
全文论点的浓缩:输出 homogeneous(看起来一视同仁)但 update selective(训练偏好有歧视),这是「审计必须读更新而不只是输出」这一核心主张的可视化摘要。