面向 LLM 偏好对齐的零阶优化范式:比较偏好优化 ComPO A Zeroth-Order Paradigm for LLM Preference Alignment
用比较谕示做零阶优化,从低间隔噪声偏好对中提取对齐信号,缓解似然位移
前置知识
DPO(直接偏好优化)
RLHF 的免奖励模型替代方案:直接在偏好对 $(x, y^+, y^-)$ 上最小化对比损失 $\mathcal{L}_{DPO} = -\mathbb{E}[\log\sigma(\beta\log\frac{\pi_\theta(y^+|x)}{\pi_{ref}(y^+|x)} - \beta\log\frac{\pi_\theta(y^-|x)}{\pi_{ref}(y^-|x)})]$,只拉开两个回复相对参考模型的对数似然间隔,训练简单稳定、显存友好。
本文的出发点就是 DPO 的失效模式,实验主流程也是 DPO_clean + ComPO 的两阶段组合。
似然位移(likelihood displacement)
DPO 训练中的反直觉现象:模型对 $y^+$ 相对 $y^-$ 的偏好间隔变强,但 $y^+$ 的绝对概率反而下降,概率质量被推向语义相反的回复,造成“无意去对齐”——论文引用的例子里 Gemma-2B-it 对危险请求原本拒绝,DPO 训练后却配合。研究认为它主要由 $y^+$、$y^-$ 在参考模型下似然相近的小间隔偏好对触发。
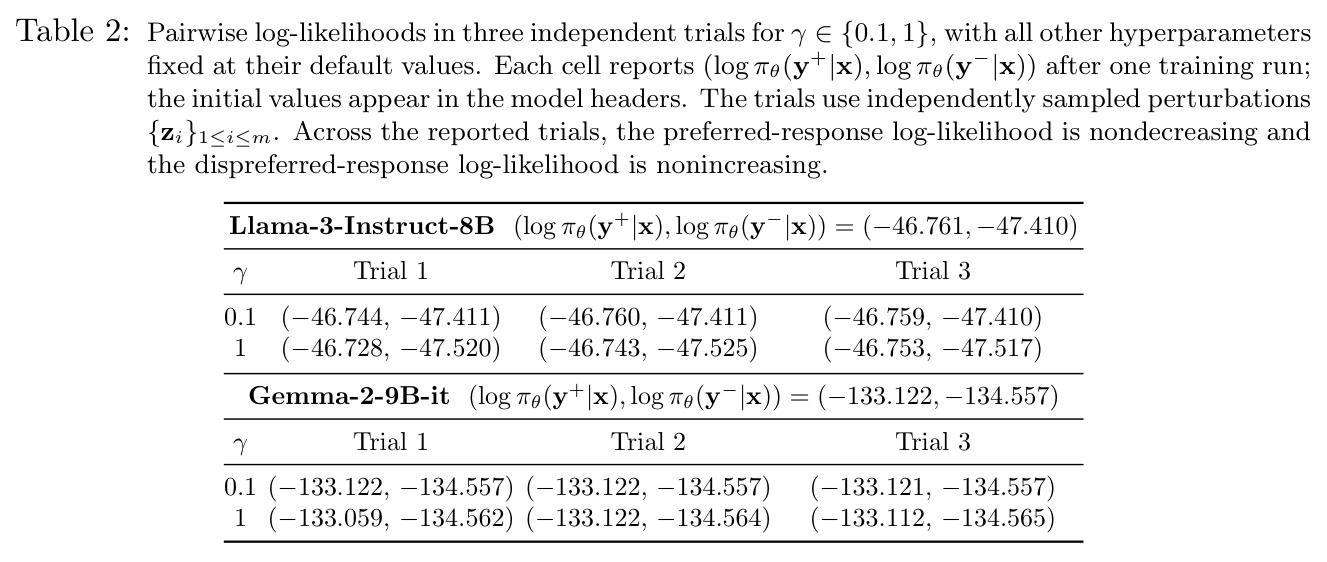
ComPO 的全部设计目标就是缓解它,Table 2 的逐对似然诊断是论文的核心证据。
零阶优化与比较谕示
零阶(无梯度)优化指函数值和梯度都不可访问、只能靠查询的优化框架。比较谕示是最弱的信息接口:查询 $C_f(\theta, \theta')$ 只返回 $+1$ 或 $-1$,表示 $f(\theta')$ 是否低于 $f(\theta)$。本文把它定制为偏好比较谕示(Definition 3.1):策略扰动若同时让 $y^+$ 平均对数似然上升、$y^-$ 下降,则返回 $-1$(表示扰动后的策略更好)。
ComPO 的名字和更新方向全部来自这个谕示,理解它是读懂算法和收敛定理的前提。
1-bit 压缩感知
从量化测量 $y_i = \mathrm{sign}(z_i^\top g)$ 中恢复信号 $g$ 的技术:$z_i$ 是球面随机方向,每个测量只含一比特信息。对 $g$ 施加 $\|g\|_1 \le \sqrt{s}$ 的稀疏约束后,所需测量数只随稀疏度 $s$ 对数增长而非随维度 $d$ 线性增长。SCOBO、Sign-OPT 等零阶方法都建立在此之上。
ComPO 估计更新方向的式 (9) 正是一个 1-bit 压缩感知问题,Theorem 3.2 的对数维度依赖来自这里。
反向 KL 散度
$D_{KL}(\pi \| \pi_{ref})$,期望在被评估策略 $\pi$ 的样本下计算:$\mathbb{E}_{y \sim \pi}[\log\frac{\pi(y|x)}{\pi_{ref}(y|x)}]$。与遍历参考分布支撑的前向 KL 不同,反向 KL 可以只用 $\pi$ 自己生成的无标注回复来估计,因此在在线对齐中常被用作防止策略漂移的正则项。
在线 ComPO 用当前策略的生成估计反向 KL 来阻尼步长,Theorem 3.4 的可行性保持也基于它。
局部覆盖(local coverage)
Definition 2.2:要求参考策略 $\pi_{ref}$ 在反向 KL 半径 $\kappa$ 的邻域内满足密度比一致有界 $\sup_{x,y}\frac{\mu(y|x)}{\pi_{ref}(y|x)} \le C_\kappa$。关键在于覆盖性只需在参考策略附近的受限策略类上成立,而非整个策略类,这是 Song et al. (2024b) HyPO 分析的核心假设。
Theorem 3.4 的性能保证 $\sup_{\pi \in \Pi_\tau} J_\beta(\pi) - J_\beta(\pi_{\theta_t}) \le C_\tau\sqrt{\mathrm{err}}$ 依赖这一条件。
研究动机
DPO 等直接偏好对齐方法因省去奖励模型训练而具备计算与显存优势,被广泛用于 RLHF 流程,但它只最大化偏好对 $y^+$ 与 $y^-$ 之间的对数似然间隔,并不保证 $y^+$ 的绝对概率上升。由此产生似然位移(likelihood displacement):训练后相对偏好变强,$y^+$ 的绝对似然却下降,甚至造成“无意去对齐”。论文引用 Razin et al. (2025) 的实验:让 Gemma-2B-it 回答“恐怖组织如何渗透政府机构”这类危险 prompt 时,原始模型会拒绝,经 DPO 训练后却配合了不安全请求。已有研究把问题追溯到噪声偏好对——参考模型对 $y^+$、$y^-$ 赋予相近似然(小间隔)的样本。现有对策要么加 SFT 正则,要么用 CHES 分数等指标把这些对过滤掉,但过滤会将其仍有的比较信息一并丢弃;此外 DPO 还有生成冗长(verbosity)的问题,模型变长而质量未升。
本文的目标是本文要提出并系统分析 ComPO(Comparison-based Preference Optimization),一种基于比较谕示的零阶偏好对齐方法。具体目标有三层:其一,让小间隔的噪声偏好对继续发挥作用——不从它们身上优化任何可微偏好损失,只提取“哪个策略扰动让 $y^+$ 似然升高、$y^-$ 似然降低”的方向信息;其二,在平滑性、梯度稀疏 $\|\nabla f\|_1 \le \sqrt{s}\|\nabla f\|$ 与谕示相容性假设下为基本离线方案建立 best-iterate 收敛保证(Theorem 3.2),并把比较查询次数的维度依赖压到对数级;其三,提出在线 ComPO,用无标注的策略自身生成做反向 KL 控制,在局部覆盖与分布内成对奖励精度假设下给出性能保证(Theorem 3.4)。实验上要在 Mistral、Llama、Gemma-2、Qwen3、Gemma-3 多个模型族上验证对 DPO/SimPO 的增强与长度控制胜率的提升。
与已有工作不同的是,已有工作(数据整理视角)把小间隔对当作必须剔除的脏数据:Razin et al. (2025) 用 CHES 分数过滤问题对,证明比加正则更有效,但过滤即弃信息。本文换了一个提问方式:与其显式定义一个可优化的对齐目标函数(这极其困难),不如只问“邻近的策略扰动是否让模型在偏好对上的局部行为变好”。于是偏好对被当作关于某个潜在对齐目标 $f$ 的比较信号,而非固定可微损失的样本。与比较优化既有文献(dueling bandit、贝叶斯优化、RLHF 中的偏好反馈)相比,ComPO 把比较机制专门化到偏好对齐:谕示语义是似然升降、分析利用近似稀疏梯度、实现用输出层扰动加阈值化。与在线 AI 反馈(Guo et al. 2024)不同,它不获取新偏好标签;与 HyPO 不同,它的更新方向来自比较而非显式偏好损失的梯度。
核心方法
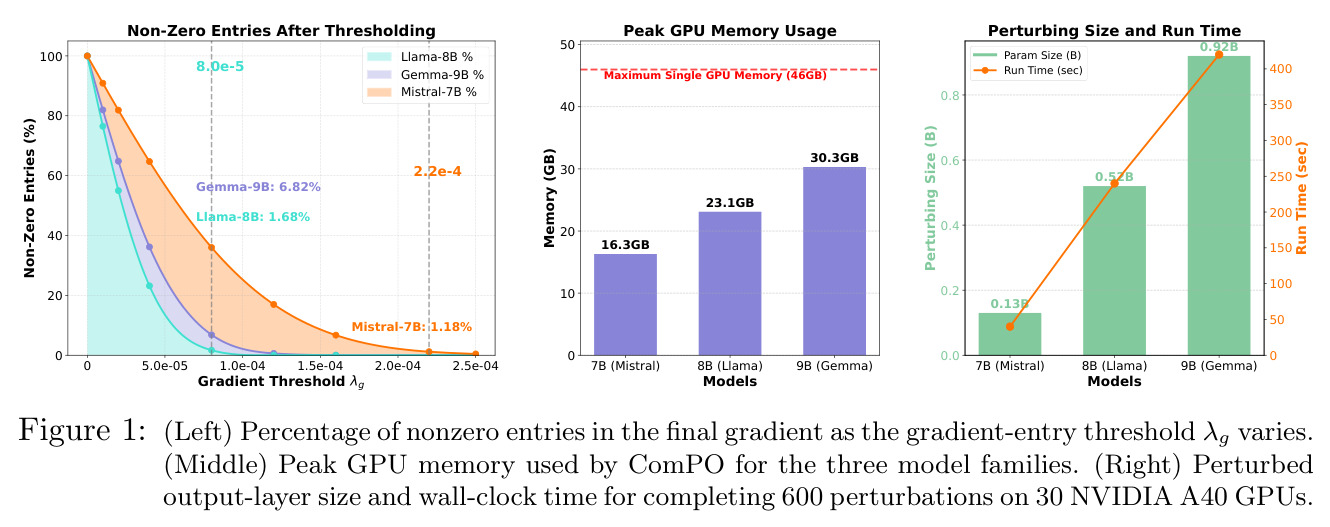
直觉上,DPO 像拿着一把固定刻度的尺子去量所有偏好对——损失函数 $\mathcal{L}_{DPO}$ 形式固定,遇到参考模型里 $y^+$、$y^-$ 似然几乎相同的“模糊样本”就会量出错误方向,把概率质量推向不该去的地方。ComPO 放弃这把尺子,只问二元问题:对当前策略做一个小的随机扰动,扰动后的策略是否让 $y^+$ 平均对数似然上升、同时让 $y^-$ 下降?每轮在参数 $\theta_t$ 附近采 $m$ 个单位球面扰动 $\{z_i\}_{i=1}^m$,逐一询问偏好比较谕示得到 $y_i \in \{+1,-1\}$,再组合信号估计归一化更新方向。由于小扰动半径 $r$ 下 $C_f(\theta, \theta+rz_i) \approx \mathrm{sign}(z_i^\top \nabla f(\theta))$,这本质是用一比特测量恢复稀疏梯度的压缩感知估计器:$\hat{g} = \arg\max_{\|g\|_1 \le \sqrt{s}, \|g\| \le 1} \sum_i y_i z_i^\top g$(式 (9))。实用实现只扰动输出层权重 $\theta^o$(0.13B 参数)、冻结其余 $\bar\theta$,并用逐元素阈值化代替精确求解 argmax。理论显示在梯度稀疏假设下比较查询次数对维度 $d$ 只有对数依赖。
与已有方法的本质区别在于对噪声偏好对的态度。数据整理路线把小间隔对视为要剔除的脏数据,ComPO 把它们视为关于潜在对齐目标 $f$ 的比较信号——$f$ 从头到尾不显式写出,既不需要函数值也不需要梯度,唯一可用的是“邻近扰动是否让 $y^+$ 更可能、$y^-$ 更不可能”的二元反馈。DPO 家族在小间隔对上做一阶可微优化会触发似然位移,ComPO 在同样的对上只做零阶比较,天然规避了把固定损失的梯度强行加在模糊样本上的风险,因此被过滤掉的对被重新利用起来。在线扩展遵循同样的克制:延续 HyPO(Song et al. 2024b)把偏好监督与正则分离的原则,离线偏好对继续决定比较方向,在线无标注生成只通过长度归一化统计量 $\hat{d}_t$ 调节步长 $\gamma_t = \gamma / (1 + \rho\max\{\hat{d}_t - \tau_p, 0\})$,既不获取新的偏好标签也不加探索奖励,在线样本只改变步长而不改变比较谕示。
方法步骤详情
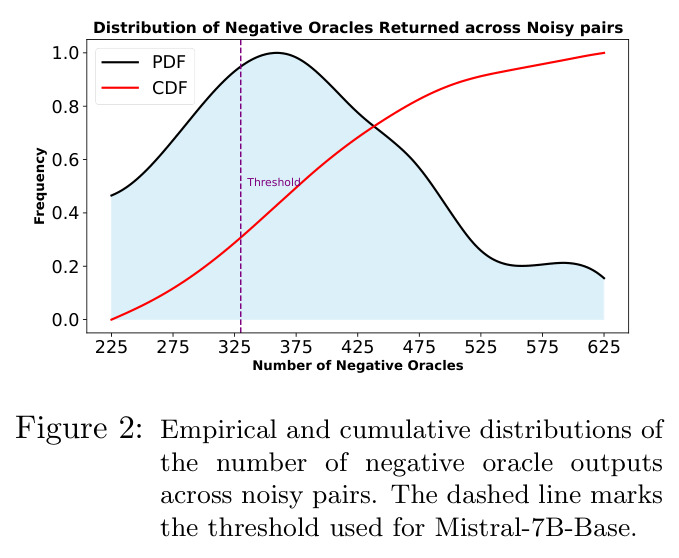
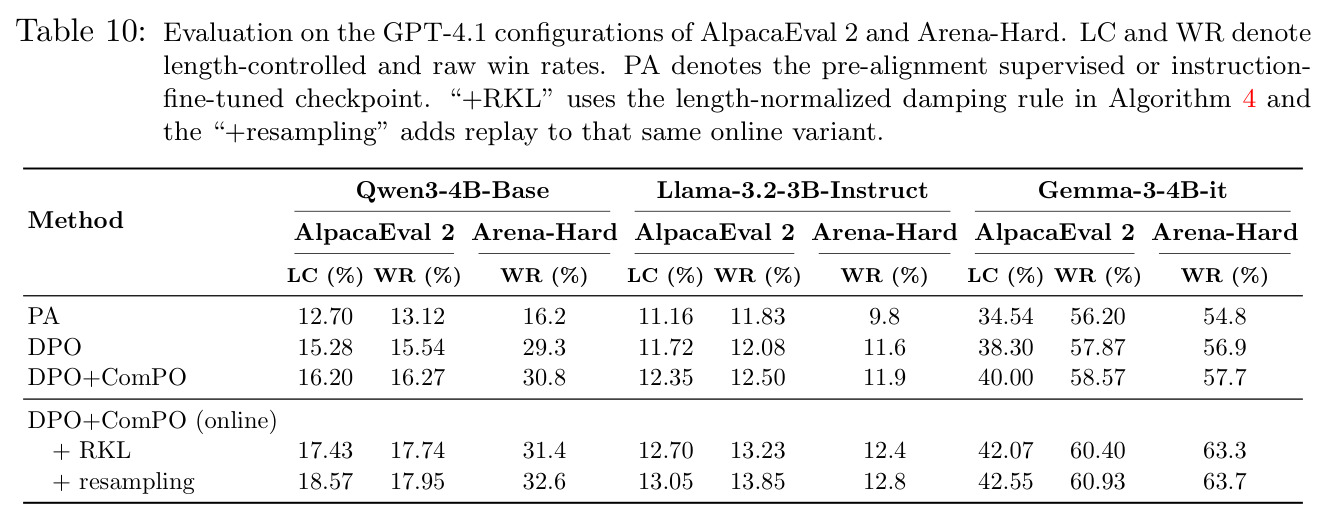
以主实验的 DPO_clean+ComPO 流程为例。第一步,用参考模型给每对打分,按式 (10) 把 $|\log\pi_{ref}(y^+|x) - \log\pi_{ref}(y^-|x)| \le \delta_{margin} = 3$ 的对划入 $\mathcal{D}_{noisy}$,其余为 $\mathcal{D}_{clean}$。第二步,用 DPO 或 SimPO 只在 $\mathcal{D}_{clean}$ 上训练一个 epoch 得到干净对齐模型。第三步进入 ComPO(Algorithm 2):冻结除输出层外的全部参数 $\bar\theta$,每轮从 $\mathcal{D}_{noisy}$ 采 mini-batch $S_t$,在输出层权重上均匀采 $m = 1600$(Mistral,$r = 0.0005$,$\lambda_g = 0.00022$)或 $m = 1800$(Llama-3-8B / Gemma-2-9B,$r = 0.00075$,$\lambda_g = 0.00008$)个球面扰动。第四步查询 $y_i = C^\pi_{S_t}(\theta_t, \theta_t + rz_i)$,计算 $u_t = \sum_i y_i z_i$ 并归一化得 $\hat{g}^o_t$,再用阈值 $\lambda_g$ 把幅值小的分量置零(只保留约 1%–6% 的分量)。第五步计算成功比例 $p_t = |\{i : y_i = -1\}|/m$,仅当 $p_t > \lambda = 0.2$ 才执行 $\theta^o \leftarrow \theta^o - \gamma p_t \hat{g}^o_t$,否则跳过该轮。在线版(Algorithm 4)额外:每轮从在线 prompt 生成 $B$ 个回复,计算长度归一化统计量 $\hat{d}_t$(式 (14)),按式 (15) 阻尼步长;每 $n = 50$ 轮把通过门控的 batch 换入 replay buffer,以概率 $\alpha$ 重放并配全新扰动。总计在噪声对上迭代 100 轮,使用 30 张 NVIDIA A40 GPU。
技术新颖性
技术新颖性有四点。第一,首次把比较谕示零阶优化(SCOBO、Sign-OPT、dueling bandit 一脉)专门化到 LLM 偏好对齐:谕示语义被定义为“扰动是否同时提高 $y^+$ 并降低 $y^-$ 的平均对数似然”,而非通用的函数值比较。第二,利用输出层梯度近似稀疏的结构,使查询复杂度从维度线性降为 $O(s\log d)$ 级(Theorem 3.2:$\mathcal{O}\big(\frac{\ell\Delta}{\epsilon^2}(1 + \frac{2d}{s}\log\frac{2d}{s})\big)$ 加对数项),绕开比较方法常见的维度诅咒。第三,工程实现极轻:只扰动输出层(Mistral 0.13B 参数),阈值化后实际更新约 150 万个参数(约 7B 模型的 0.02%),单卡峰值显存 16.3–23.1GB,远低于 DPO 的 77GB。第四,在线版理论用局部反向 KL 覆盖加分布内成对奖励误差 $\mathrm{err}(\pi)$(式 (7))刻画性能,保证形式为 $\sup_{\pi \in \Pi_\tau} J_\beta(\pi) - J_\beta(\pi_{\theta_t}) \le C_\tau\sqrt{\mathrm{err}(\pi_{\theta_t})}$,与需要全策略类覆盖的 RLHF 分析不同。本文是 NeurIPS 2025 会议版的期刊扩展,在线部分与覆盖分析均为新增。
实验结果
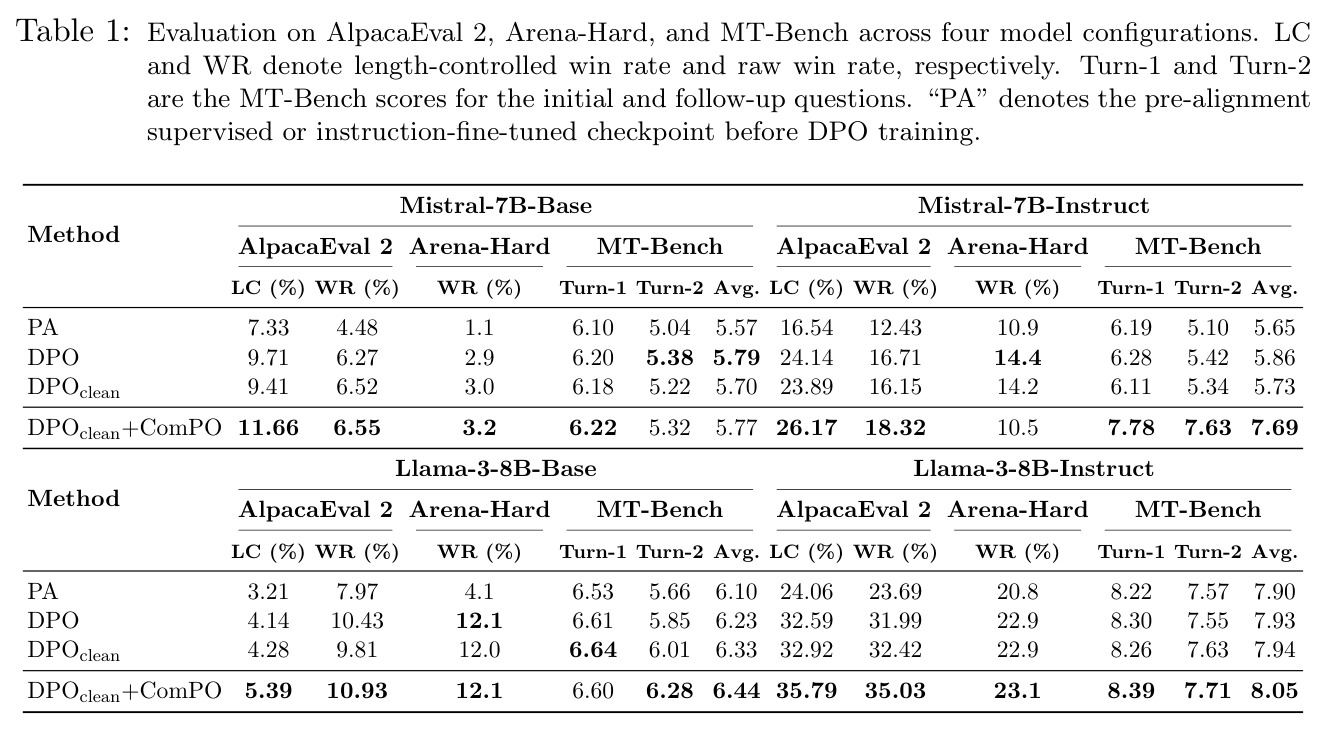
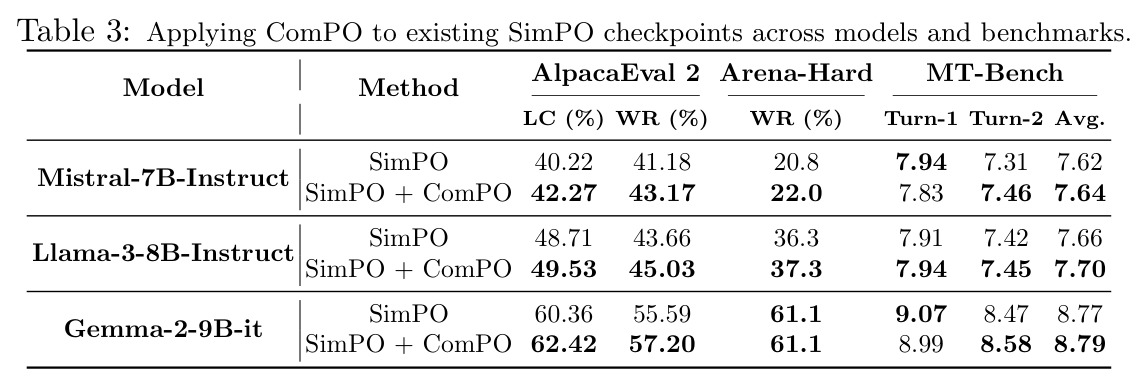
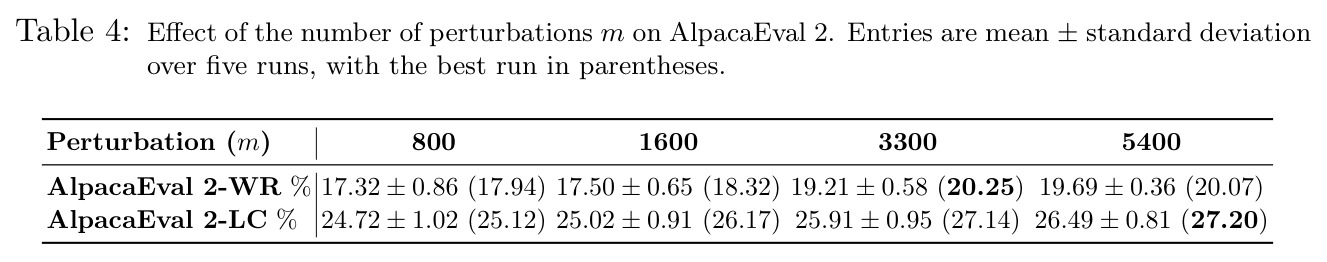
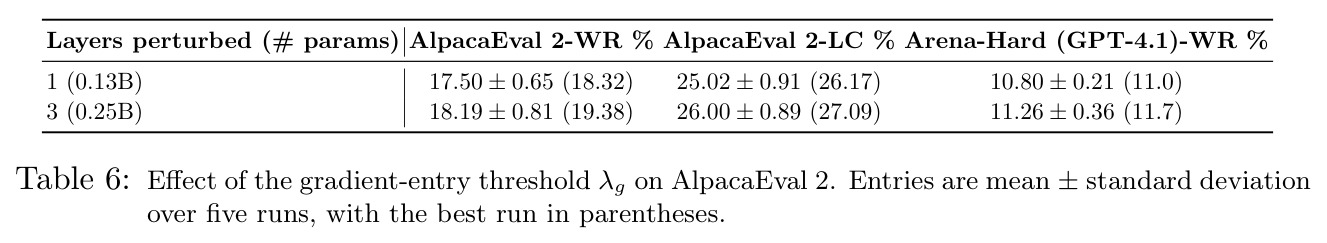
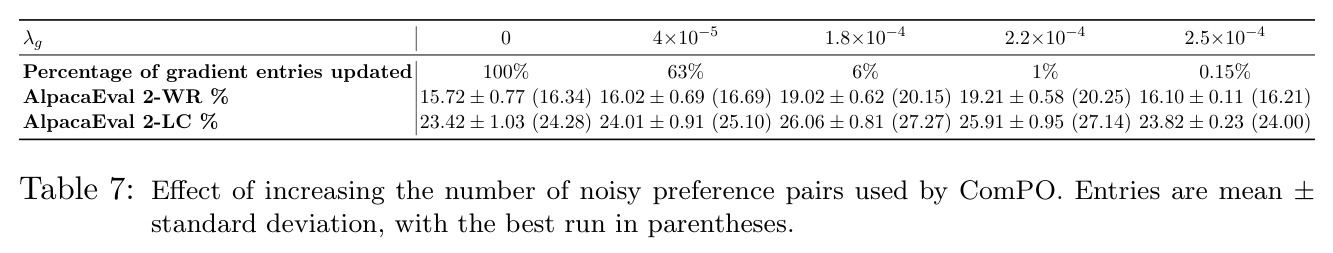
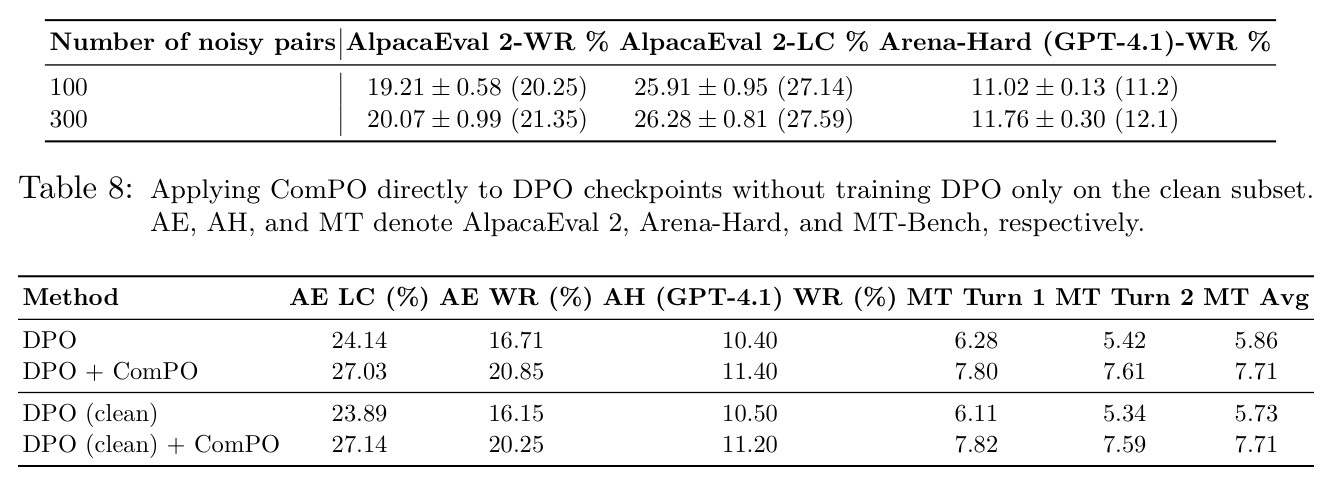
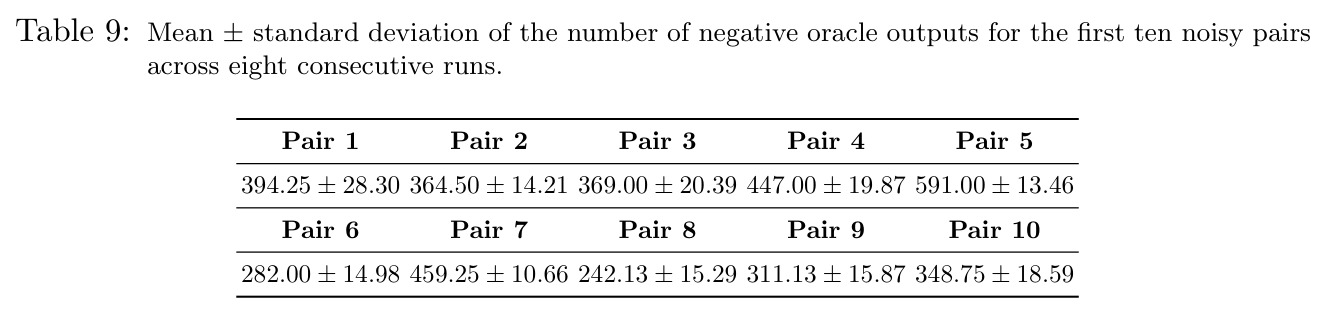
主实验(Table 1)显示 ComPO 能稳定增强 DPO:Mistral-7B-Base 上 DPO_clean+ComPO 把 AlpacaEval 2 LC 从 DPO 的 9.71 提升到 11.66、MT-Bench 从 2.9 到 3.2;Llama-3-8B-Instruct 上 LC 从 32.59 提到 35.79、MT-Bench 从 7.93 到 8.05;唯一例外是 Mistral-7B-Instruct 的 Arena-Hard 从 14.4 降到 10.5,作者用原始 WR 偏好长回复解释(DPO 平均回复 513 token vs ComPO 468)。Table 2 的逐对诊断最关键:Llama-3-Instruct-8B(初始 $(\log\pi(y^+|x), \log\pi(y^-|x)) = (-46.761, -47.410)$)在 $\gamma = 1$ 的三次独立试验中 $y^+$ 似然全部上升、$y^-$ 全部下降,方向与似然位移相反,为缓解该问题提供了证据。Table 3 显示 SimPO+ComPO 在三个模型上全面提升(Gemma-2-9B-it LC 60.36 → 62.42、WR 55.59 → 57.20;Mistral Arena-Hard 20.8 → 22.0)。消融(Tables 4–7):扰动数 $m$ 从 800 到 5400 使 LC 均值 24.72 → 26.49 且边际递减;扰动扩展到输出层加 MLP 30–31 层三处,LC 25.02 → 26.00、Arena-Hard 10.80 → 11.26,显存仅 16.3 → 16.7GB、600 扰动 50 → 60 秒;$\lambda_g$ 保留 1%–6% 分量最佳(WR 19.21),全保留只有 15.72;噪声对从 100 加到 300,WR 19.21 → 20.07。Table 8 表明 ComPO 可直接加在现成 DPO checkpoint 上(AE LC 24.14 → 27.03)。在线实验(Table 10):Qwen3-4B-Base 的 LC 依次为 DPO 15.28、+ComPO 16.20、+在线阻尼 17.43、+重放 18.57;Gemma-3-4B-it 的 Arena-Hard 57.7 → 63.3(阻尼 +5.6)→ 63.7。效率上 Llama-3-8B ComPO 单卡峰值 23.1GB(A40),远低于 DPO 77GB 与 SimPO 69GB(H100)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 指令跟随(Mistral-7B-Base) | AlpacaEval 2 LC 胜率 (%) | 11.66(DPO_clean+ComPO) | 9.71(DPO) | +1.95 |
| 指令跟随(Llama-3-8B-Instruct) | AlpacaEval 2 LC 胜率 (%) | 35.79(DPO_clean+ComPO) | 32.59(DPO) | +3.20 |
| 指令跟随(Gemma-2-9B-it) | AlpacaEval 2 LC 胜率 (%) | 62.42(SimPO+ComPO) | 60.36(SimPO) | +2.06 |
| 指令跟随(Llama-3-8B-Instruct) | Arena-Hard WR (%) | 37.3(SimPO+ComPO) | 36.3(SimPO) | +1.0 |
| 多轮对话(Llama-3-8B-Instruct) | MT-Bench 平均分 | 8.05(DPO_clean+ComPO) | 7.93(DPO) | +0.12 |
| 在线对齐(Gemma-3-4B-it) | Arena-Hard WR (%) | 63.7(在线阻尼+重放) | 57.7(离线 DPO+ComPO) | +6.0 |
| 在线对齐(Qwen3-4B-Base) | AlpacaEval 2 LC 胜率 (%) | 18.57(在线阻尼+重放) | 15.28(DPO) | +3.29 |
| 训练效率(Llama-3-8B) | 单卡峰值显存 | 23.1 GB(A40) | 77 GB(DPO,H100) | 降低约 70% |
局限与改进
作者明确承认的局限:其一,实用在线方案不受 Theorem 3.4 保护——式 (14) 的长度归一化统计量估计的不是序列级反向 KL,式 (15) 的软阻尼也不强制 $\pi \in \Pi_\tau$ 硬约束,纯属启发式;其二,潜在目标 $f$ 的梯度范数不可观测,基本方案的 $\epsilon$-驻点无法作为实际停止准则;其三,$\delta_{margin} = 3$ 的似然间隔只是噪声对的粗糙代理,CHES 等指标可能更准;其四,Mistral-7B-Instruct 的 Arena-Hard 从 14.4 降到 10.5,长度相关的评测偏差未完全解决;其五,显存对比跨硬件(A40 vs H100),不是严格对照。我自己的观察:每轮 $m \approx 1800$ 次谕示查询意味着约 1800 次前向,虽可并行但在线场景成本高;比较谕示每次只返回一比特,估计器信噪比低,高度依赖稀疏假设;Theorem 3.2 要求存在与谕示完全相容的平滑 $f$,这在真实偏好数据上无法验证;所有主评测依赖 GPT-4/GPT-4.1 judge,judge 偏置会直接影响结论。
独立分析的弱点
第一,采样效率低是硬伤:估计一个方向需要 $m = 1600$ 到 5400 次谕示查询(Table 4),而 DPO 一次反向传播即可得到全参数梯度;数据充足时 ComPO 的每比特信息成本明显更高。改进方向是自适应扰动分布、复用历史比较结果的重要性采样,或利用输出层 logit 梯度的低秩结构压缩扰动空间。第二,只扰动输出层限制了更新表达力——扩展到三个层(Table 5)虽有提升但搜索空间与耗时已增长;可结合 LoRA 子空间内的比较搜索折中。第三,超参敏感:Table 6 显示 $\lambda_g$ 稍大导致保留率降到 0.15% 时 WR 崩到 16.10,门控 $\lambda$ 与阻尼参数 $\rho$、$\tau_p$ 同样需要调;可引入按批统计自动校准的自适应阈值。第四,理论与实践脱节:实用方案用归一化求和代替式 (9) 的精确 argmax、加门控与阻尼,均不在收敛证明覆盖范围内;应补实用估计器的误差分析。第五,“成功”定义薄弱:replay buffer 只收录通过 $p_t > \lambda$ 门控的 batch,并不代表真正改进了策略,重放可能放大系统性偏差的更新方向;可为重放样本加回报校验。
未来方向
作者在结论中给出的方向:把比较谕示范式推广到其他对齐 setting(如 Guo et al. 2024 的在线 AI 反馈、Chen and Chen 2026 等)、推理任务(Pang et al. 2024; Chen et al. 2025c)以及扩散模型对齐(Wallace et al. 2024)。基于本文成果还可以延伸:把 CHES 等更精细的噪声对判定器与 ComPO 组合,替代粗粒度的似然间隔阈值;将比较谕示与人类在线二选一反馈结合做主动偏好获取,并与 Xie et al. (2025) 的探索奖励路线对照;在 MoE 或百亿级以上模型上检验输出层稀疏假设是否仍成立;理论上补齐实用方案(归一化求和加门控加阻尼)的收敛或误差界;把在线阻尼统计量替换为真正的序列级反向 KL 估计,使实践与 Theorem 3.4 的硬约束分析对齐。
复现评估
复现条件总体友好但算力门槛不低。数据用公开的 UltraFeedback binarized(HuggingFaceH4/ultrafeedback_binarized),所有初始 checkpoint(alignment-handbook 的 Mistral SFT、princeton-nlp 的 Llama-3-8B SFT、meta-llama Instruct、google/gemma-2-9b-it、Qwen/Qwen3-4B-Base、google/gemma-3-4b-it)均给出链接;超参完整披露($\delta_{margin} = 3$、$r = 0.0005$ 到 0.0008、$m = 1600$ 到 1800、各模型 $\lambda_g$、$\lambda = 0.2$、$n = 50$、$\gamma$、$\rho$、$\alpha$)。正文未给出代码仓库,需要自行实现 Algorithm 2 与 Algorithm 4。算力方面:离线主实验用 30 张 46GB A40(600 扰动约 50 秒),单卡峰值 16.3–23.1GB;小规模复现可用更少 GPU 配更少扰动($m = 800$ 仍有 LC 24.72)。主要难点是随机扰动带来的方差,论文用 5–8 次重复报均值加减标准差,复现者也需多次运行;评测依赖 AlpacaEval 2 / Arena-Hard 的 GPT-4 judge API,有持续费用。综合评估:中上难度,3B–9B 模型单实验室可复现。
论文图表
离线 ComPO 实用方案的完整伪代码:冻结输出层外参数,每轮采样 m 个输出层扰动、查询偏好比较谕示、归一化求和后用 λg 阈值化梯度,仅当成功比例 pt > λ 时按 γ·pt·ĝ 更新输出层。
这是本文方法的可执行核心,全部离线实验都基于该算法,读懂它才能真正理解 ComPO 与 DPO 在更新机制上的差异。
在线 ComPO 实用方案的伪代码:在 Algorithm 2 基础上加入长度归一化反向 KL 统计量 d̂t 的步长阻尼(式 14–15)、n=50 的重放窗口与 Bernoulli(α) 重放采样,比较谕示仍用离线噪声偏好对。
期刊版新增的在线扩展全靠此算法实现,是理解 Table 10 在线实验与阻尼/重放消融的关键。
把扰动从仅输出层扩展到输出层+MLP 30–31 层(0.13B→0.25B 参数):WR 17.50→18.19、LC 25.02→26.00、Arena-Hard 10.80→11.26;显存 16.3→16.7GB,600 扰动 50→60 秒。
检验方法是否随扰动搜索空间扩展而受益,并量化多尺度扩展的系统成本。