PLC-DPO:噪声与模糊偏好优化中的后验标签纠正 PLC-DPO: Posterior Label Correction in Noisy and Ambiguous Preference Optimization
把每条偏好标签建模为清洁/翻转/平局潜状态,用校准边际在线纠正 DPO 的监督方向
前置知识
DPO(直接偏好优化)
DPO 是目前最主流的离线对齐目标:跳过单独训练奖励模型和 PPO 强化学习,直接用策略模型与冻结参考模型的序列级对数几率比构造边际 $m_{seq}=\beta\left[\log\frac{\pi_\theta(y_w|x)}{\pi_{ref}(y_w|x)}-\log\frac{\pi_\theta(y_l|x)}{\pi_{ref}(y_l|x)}\right]$,再最小化 $L_{DPO}=-\log\sigma(m_{seq})$。它把 RLHF 转化为偏好对上的二元分类,实现简单、可扩展,是本文改造的基座。
PLC-DPO 完全建立在 DPO 的边际与损失之上:路由证据取自同一个 $m_{seq}$,三种纠正动作也都是 DPO 损失的变体(正向、反向、压平),不懂 DPO 就无法理解本文到底在纠正什么。
Bradley-Terry 偏好模型
Bradley-Terry 模型假设人类在两个候选间的选择概率为 $P(y_w\succ y_l)=\sigma(r(y_w)-r(y_l))$,即由两者隐含奖励之差过 sigmoid 给出。DPO 通过重参数化把奖励差表示为策略-参考对数几率比,从而无需显式奖励模型即可直接拟合偏好数据。
本文的校准信号 $z$ 本质上是对 BT 边际的在线 z-score 标准化;理解 BT 模型才能明白'边际的正负与大小'为什么能充当偏好方向可靠性的证据。
标签噪声与歧义偏好
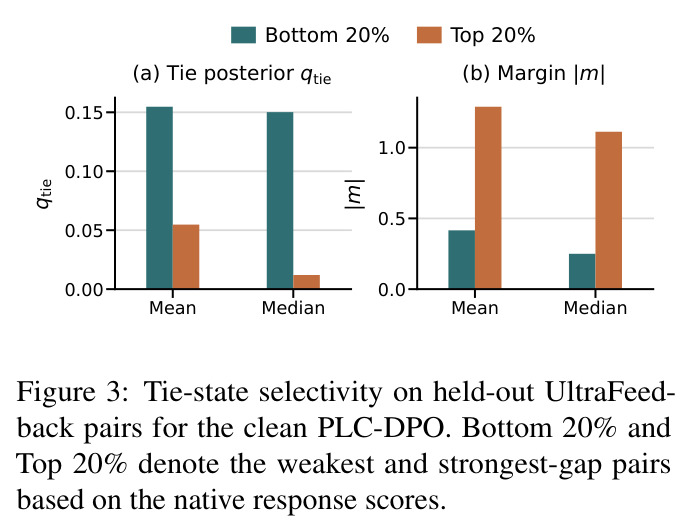
真实偏好数据有三类典型病灶:翻转(flipped,标注者或判分模型把更差一侧标为 chosen,方向反了)、弱方向(两个回答同样好或同样差,差距太小,二元选择不稳定)、歧义(标注者之间意见不一致甚至倾向平局)。论文分析显示独立奖励模型与 UltraFeedback 标签在 22.9% 的样本上不一致。
这三类病灶正是本文的动机所在,clean/flip/tie 三状态与之一一对应,实验也分别用翻转注入和平局注入来检验对应通路的响应。
EMA 与 z-score 标准化
指数滑动平均按 $\mu_t=\alpha\mu_{t-1}+(1-\alpha)\bar{m}_t$ 缓慢跟踪统计量,对单批噪声鲁棒;z-score 标准化把原始值减均值、除以标准差,得到无量纲的相对位置。两者结合把训练中尺度不断漂移的 DPO 边际转换成'流内相对信号',使 $z=0$、$|z|$ 大小等阈值在不同训练阶段含义一致。
策略-参考边际的均值和方差随训练剧烈变化,若不做在线校准,固定的路由阈值会失效——EMA 校准是本文稳定性设计的关键一环。
停止梯度(stop-gradient)
stop-gradient 是自动微分操作:张量的值仍在前向中被使用,但反向传播时被当作常数,不回传梯度。本文用了两处:对边际 $\tilde{m}=\mathrm{stopgrad}(m_{seq})$ 和对路由权重 $\bar{q}_s=\mathrm{stopgrad}(q_s)$,防止策略通过改变自己的边际或标签分配来'作弊'式地降低损失。
若没有 stop-gradient,模型可以在同一步里既改标签分配又改目标函数,路由会退化为自证循环;这是理解本文防自确认设计的必要概念。
LLM-as-a-judge 胜率评估
对齐效果常用胜率衡量:让一个强判分模型(本文主实验用 Skywork-Reward-V2-Llama-3.1-8B)对候选回答两两比较,统计被评模型击败基线的比例。AlpacaEval、AlpacaEval 2、MT-Bench、Vicuna 等基准都采用这类协议;本文所有胜率均相对于同数据训练的单轮 DPO 基线。
本文几乎所有表格都是'对 DPO 基线的胜率',先理解这一协议才能正确解读 60.5、66.88 这些数字:高于 50 即优于基线,50 是平局线。
研究动机
DPO 把每一条观测偏好 $y_w\succ y_l$ 当作完全可靠的监督信号,但真实数据远非如此:标注者之间经常意见不一致,模型判分器带有自身偏好,长度、自信措辞等表面线索会污染标签;两个回答可能同样好、同样差或差距太小,无法支撑稳定的二元选择。本文自己的分析显示,独立奖励模型(Skywork-Reward-V2)与 UltraFeedback 数据集标签在 22.9% 的样本上不一致,且分歧强度与翻转概率的 Spearman 相关系数达 0.561。更糟的是,DPO 会把这些错误直接转化为策略梯度:方向翻转的标签产生反向更新,弱方向/平局对产生任意方向的强更新,等于在主动强化错误的优化方向。
本文的目标是本文目标是构造一个在线的鲁棒偏好优化目标:不丢弃数据、也不只做降权,而是直接判断并纠正 DPO 实际消费的那条'对标签'——该加强的加强(clean)、标反了的反转(flip)、没有可靠方向的中性化(tie)。同时满足三个工程约束:不引入额外监督或外部奖励模型;不增加额外前向/反向传播,开销与标准 DPO 相当;通过校准、预热与置信度门控保证早期训练稳定,并能用同一套超参配方跨模型、跨数据集工作。
与已有工作不同的是,既有方案各有盲区:cDPO/rDPO 等鲁棒损失假设全局噪声率、对所有样本施加一致的平滑修正;ROPO 等过滤方法直接丢弃可疑数据,浪费了本可通过翻转而利用的信号;Dr.DPO 用分布式鲁棒框架控制可靠性但仍是全局视角;γ-PO 引入成对动态边际却不改变方向本身;RE-PO 用 EM 式后验在正反方向间重加权,最接近本文,但缺少'非方向性'的 tie 状态。PLC-DPO 的独特切入点是:把潜在变量从'响应质量'换成'对方向状态'(clean/flip/tie),并用 DPO 自己的边际经 EMA 校准后作为在线证据,以最小的潜结构直接修正标签,而非间接估计质量或筛选数据。
核心方法
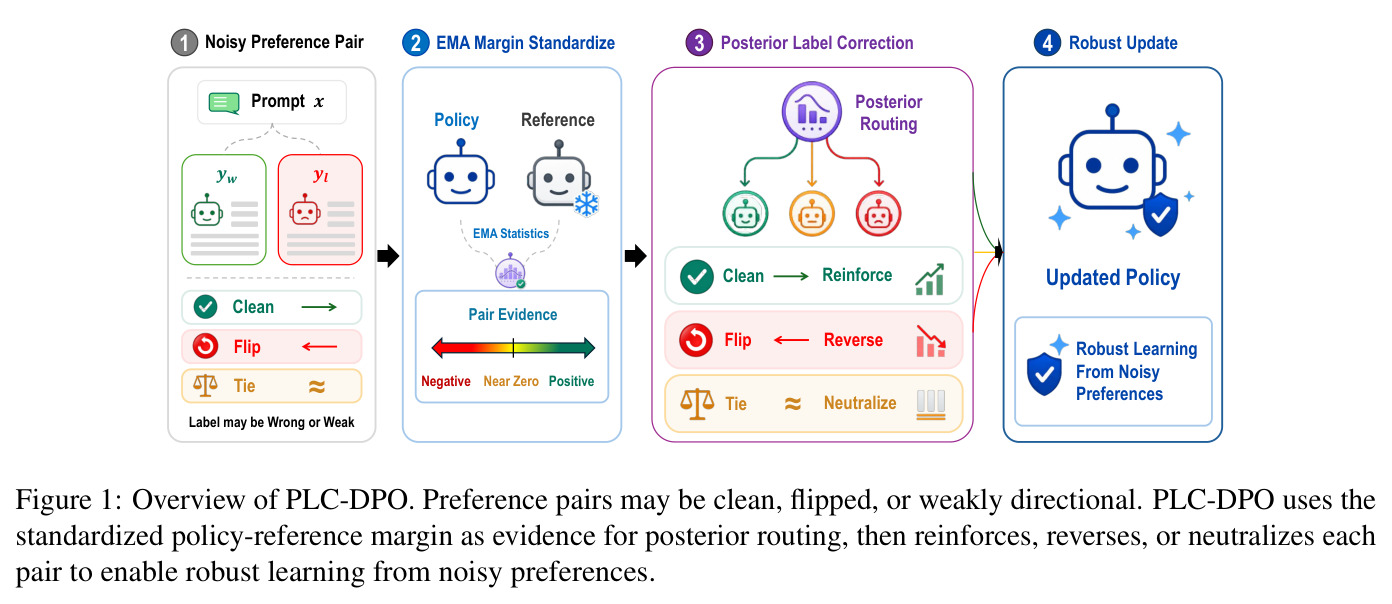
直觉上,一条偏好对可不可信可以问当前模型:策略相对冻结参考模型的偏好边际 $m_{seq}$ 是否与标注方向一致、强烈相反、还是接近零。PLC-DPO 把这个信号映射为三种训练动作:边际强且同向则按标准 DPO 强化;强且反向则用反向 DPO 纠正(学习相反方向);接近零则用 $\mathrm{softplus}(|m|)$ 压平方向梯度。技术路线分四步:(1) 计算序列级边际 $m_{seq}=\beta\left[\log\frac{\pi_\theta(y_w|x)}{\pi_{ref}(y_w|x)}-\log\frac{\pi_\theta(y_l|x)}{\pi_{ref}(y_l|x)}\right]$;(2) 对其做 stop-gradient 后,用批统计量的 EMA 做 z-score 得 $z_i$;(3) 由能量分数经 softmax 得路由分布 $(q_{clean},q_{flip},q_{tie})$;(4) 用路由权重混合三个状态损失,再经归一化置信门控与预热调度,与标准 DPO 做凸组合得到最终损失。
核心创新是把噪声偏好学习重构为'对标签的在线后验纠正'。每个观测对的标签被建模为潜状态 $s\in\{clean,flip,tie\}$:clean 表示应强化观测方向,flip 表示应学习相反方向,tie 表示该对不提供可靠方向信息、不应诱导强方向梯度。与响应级潜质量方法(先估计每个响应的好坏再推断对动作)不同,PLC-DPO 直接询问'这条对的方向该不该信',而证据恰恰是 DPO 用于优化的同一个边际——detach 并经 EMA 校准后成为方向性证据。这是'纠正'而非'筛选'的哲学:一条被翻转的偏好对仍然包含有用信息,只要识别出反转就可以反着学;模糊对则被中性化,避免任意方向的强更新污染策略。
方法步骤详情
单步训练(Algorithm 1)流程如下。(1) 前向计算 $\pi_\theta,\pi_{ref}$ 对 $(y_w,y_l)$ 的对数概率,得边际 $m^i_{seq}$ 与 $L_{DPO,i}=-\log\sigma(m^i_{seq})$。(2) 取 $\tilde{m}_i=\mathrm{stopgrad}(m^i_{seq})$,计算批均值 $\bar{m}$ 与方差 $s_m^2$,按 $\mu\leftarrow\alpha\mu+(1-\alpha)\bar{m}$、$v\leftarrow\alpha v+(1-\alpha)s_m^2$ 更新 EMA。(3) 标准化 $z_i=\frac{\tilde{m}_i-\mu}{\max(\sqrt{v},\sigma_{min})}$。(4) 构造能量分数 $\ell_{clean}=\log\pi^0_{clean}+z/\tau_{dir}$、$\ell_{flip}=\log\pi^0_{flip}-z/\tau_{dir}$、$\ell_{tie}=\log\pi^0_{tie}-|z|/\tau_{tie}$,softmax 得路由权重 $(q_{clean},q_{flip},q_{tie})$。(5) 定义状态损失 $L_{clean}=-\log\sigma(m)$、$L_{flip}=-\log\sigma(-m)$、$L_{tie}=\mathrm{softplus}(|m|)$。(6) 混合得 $L_{PLC}=\bar{q}_{clean}L_{clean}+\bar{q}_{flip}L_{flip}+\bar{q}_{tie}L_{tie}$,其中 $\bar{q}$ 已 detach。(7) 计算置信度 $C(\bar{q})=\frac{\max_s\bar{q}_s-1/3}{2/3}$。(8) 预热期(占比 $\rho_{warm}$)内 $\gamma_t=0$,之后按调度升至 $\gamma_{max}$。(9) 最终损失 $L(\theta)=(1-\gamma_t C)L_{DPO}+\gamma_t C L_{PLC}$,反向传播更新参数。
技术新颖性
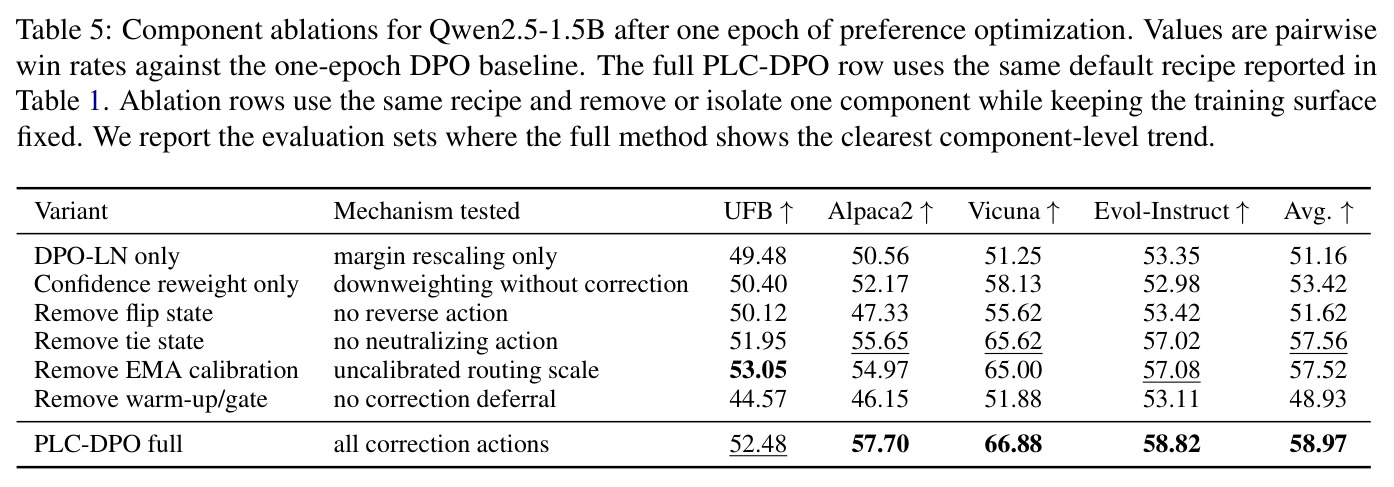
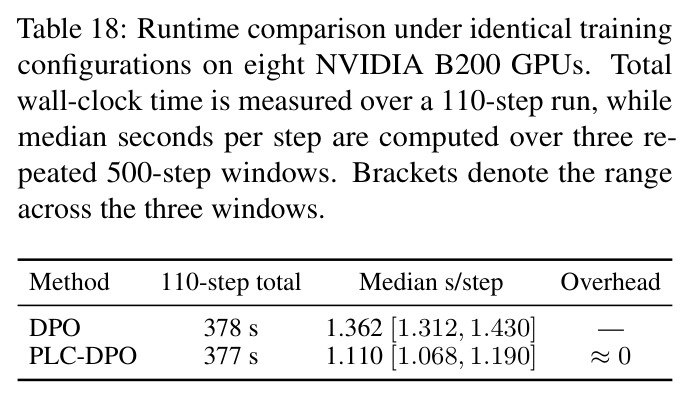
与既有工作的本质区别有四点。其一,三状态潜标签:RE-PO 等 EM 式方法只能在正反两个方向间分配质量,本文新增 tie 状态,使'同样好/同样差'的模糊对被中性化而非强行二选一;消融中去掉 tie 使平均胜率从 58.97 降到 57.56。其二,证据来源:路由不依赖外部奖励模型或响应级绝对打分,而是复用 DPO 自身边际并以 EMA z-score 在线校准,解决了边际尺度随训练漂移这一根本问题。其三,稳定性三件套:stop-gradient 阻断'通过改变标签分配来降损失'的自证路径;归一化最大权重置信门控 $C=\frac{\max_s\bar{q}_s-1/3}{2/3}$ 比熵门控更敢于在路由确定时行动;warm-up 把早期不可靠路由完全关闭(前 20% 训练仅承担 1.9% 的总纠正量,平均纠正权重 0.026 对全程 0.286)。其四,零开销:复用 DPO 已算好的对数概率,无额外模型副本,8×B200 实测每步 1.110s 对 DPO 的 1.362s。
实验结果
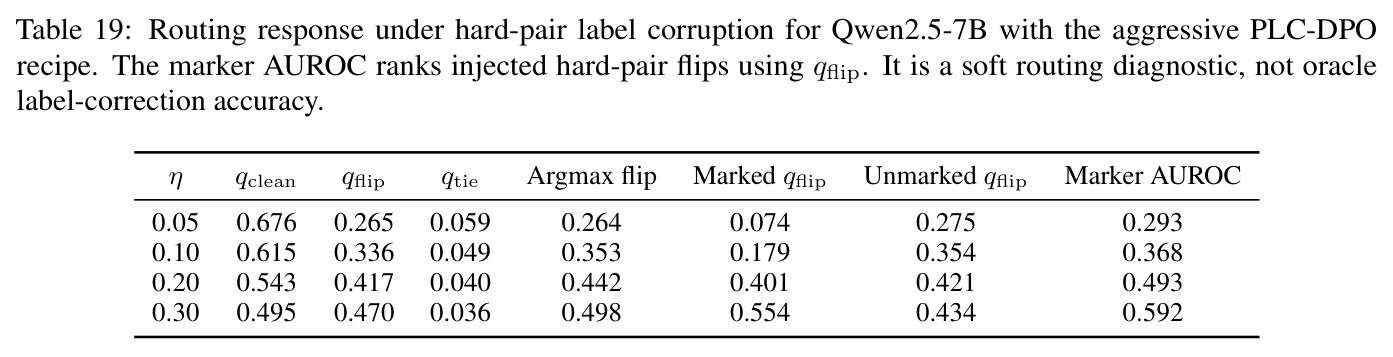
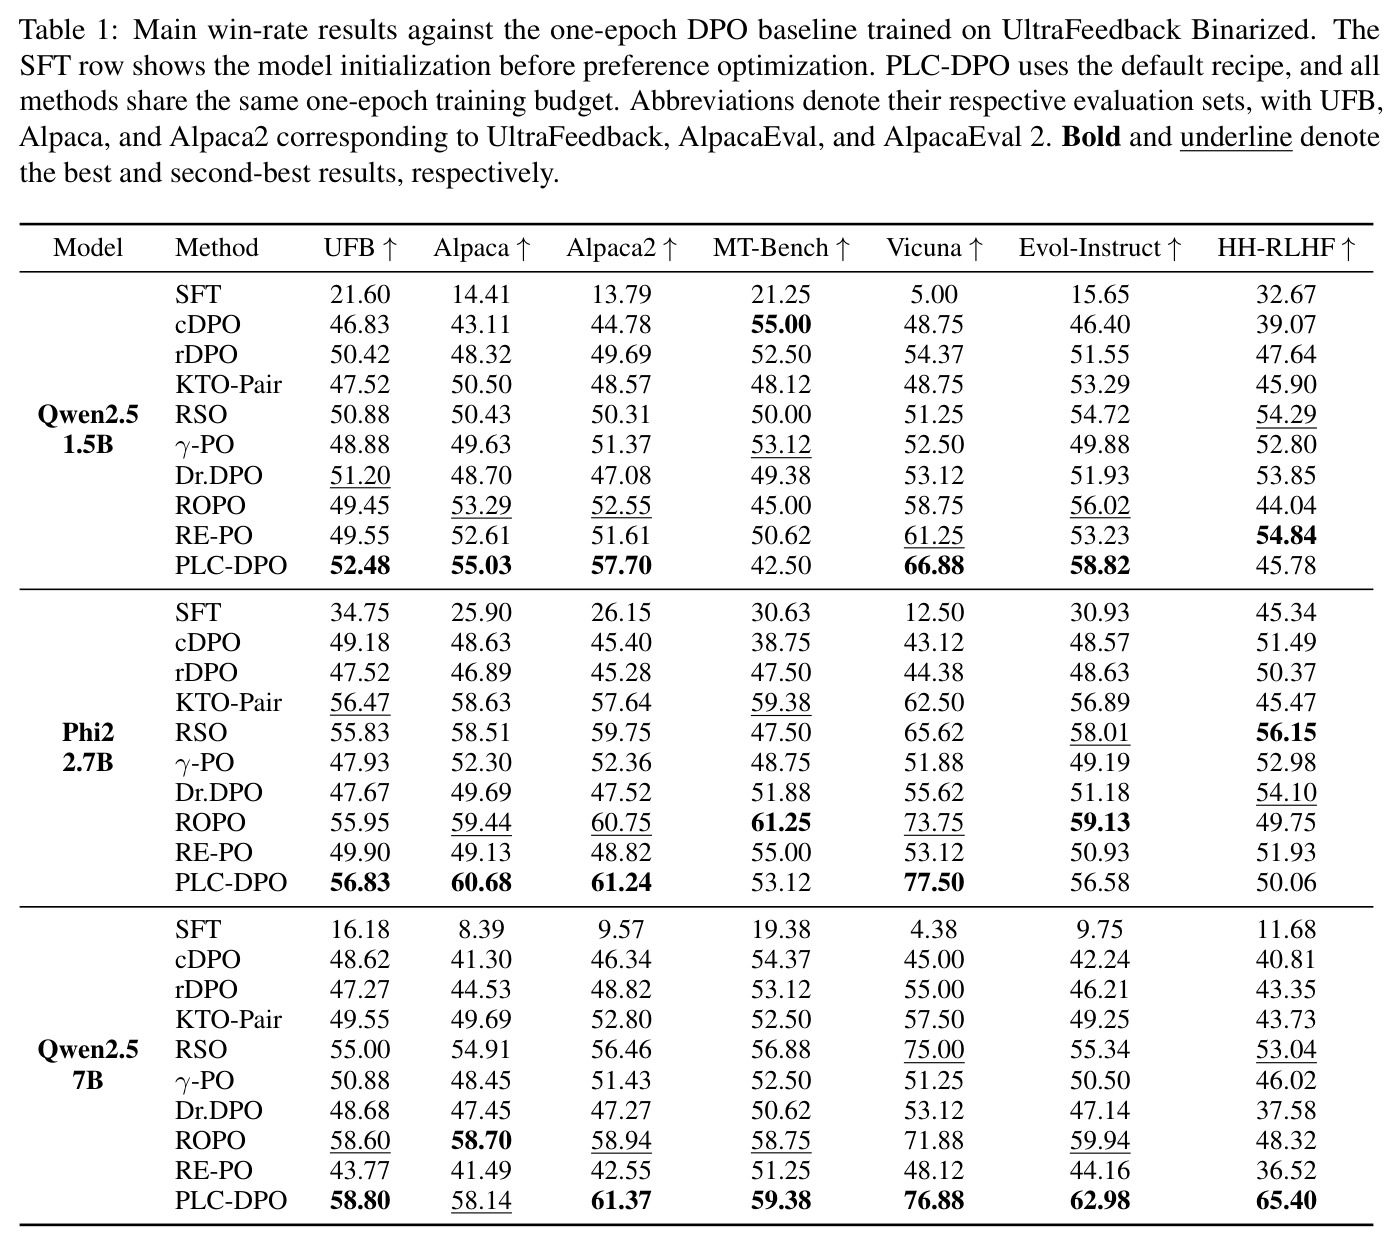
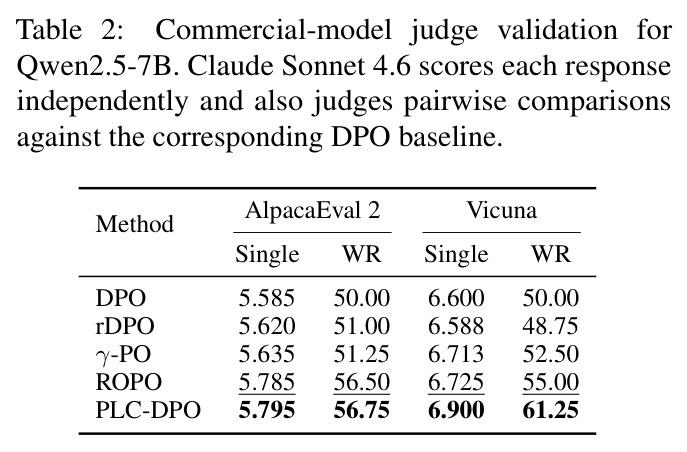
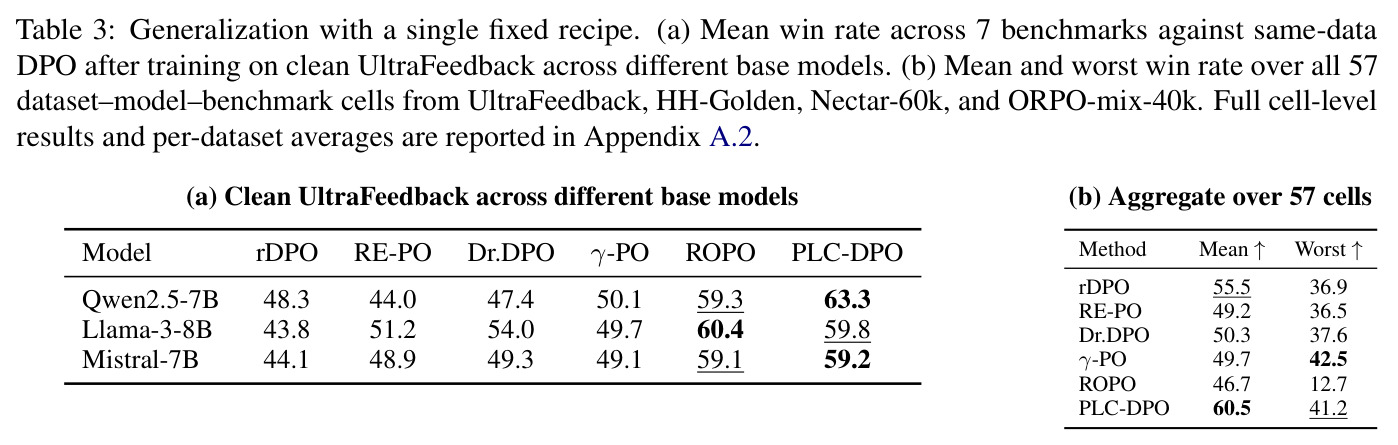
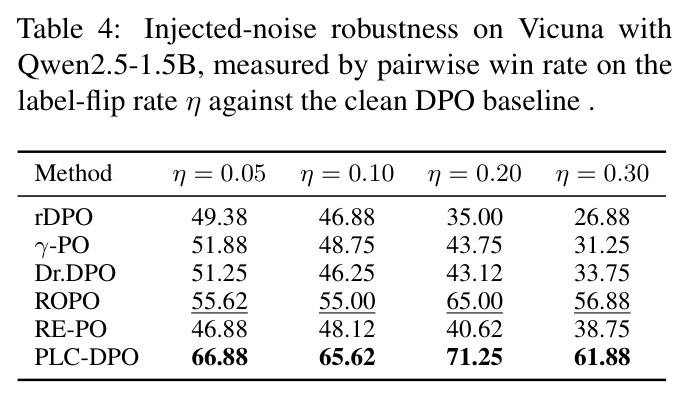
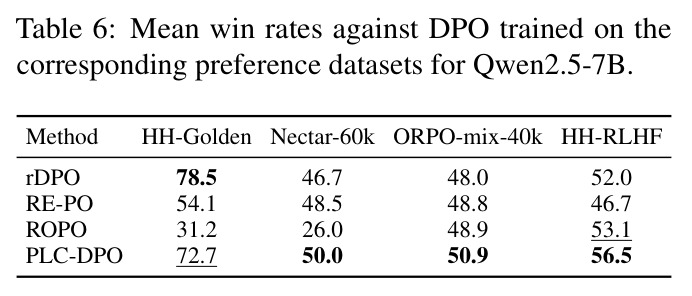
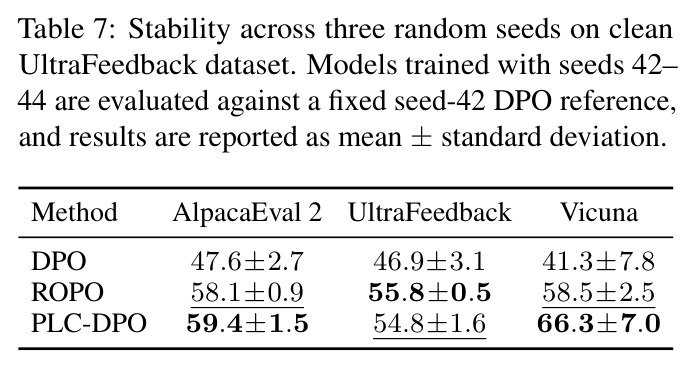
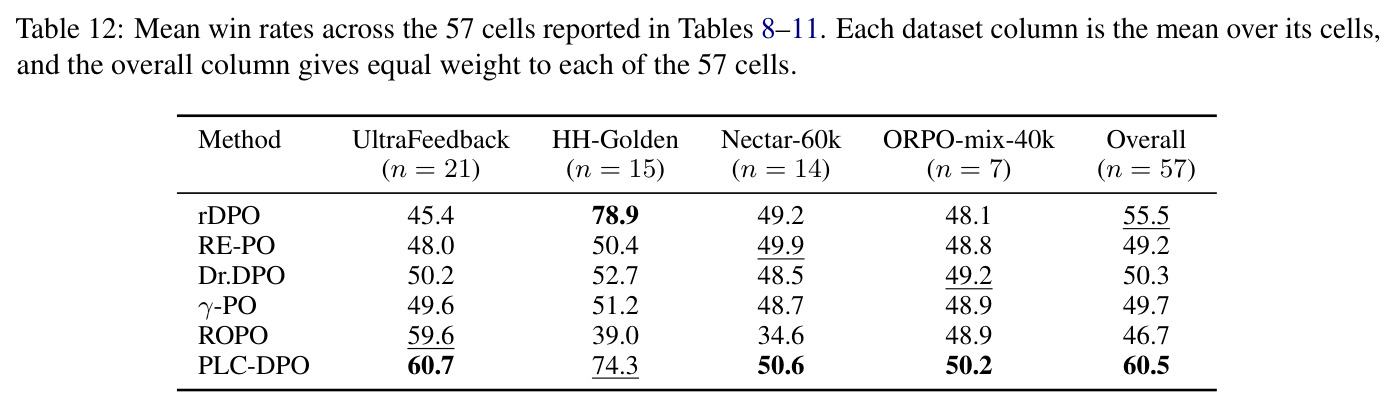
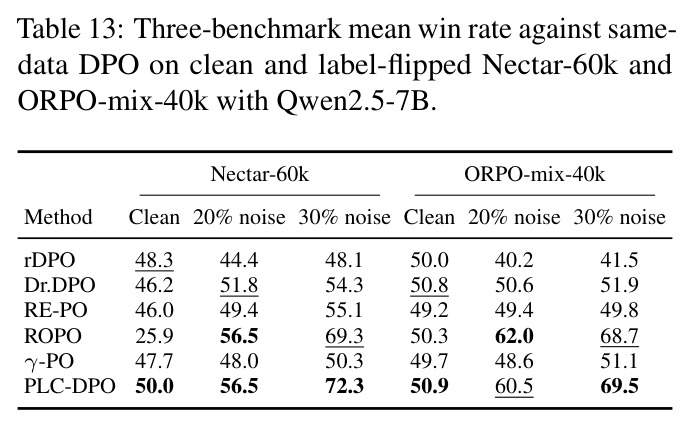
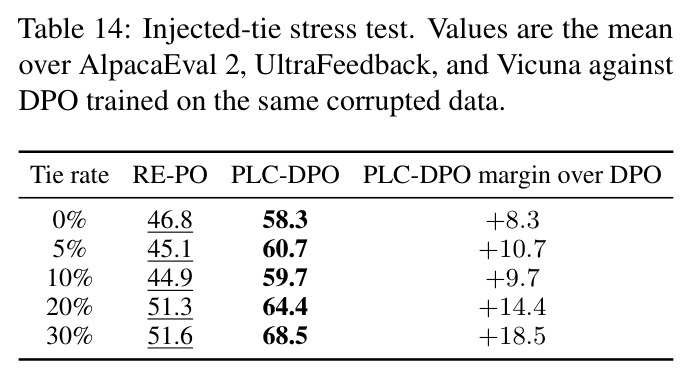
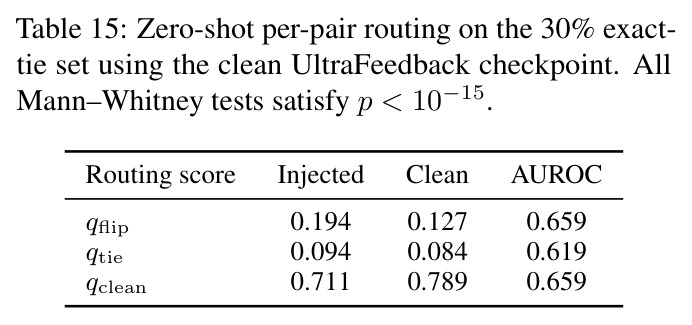
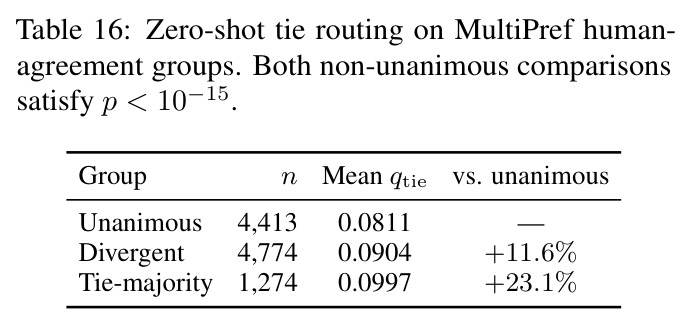
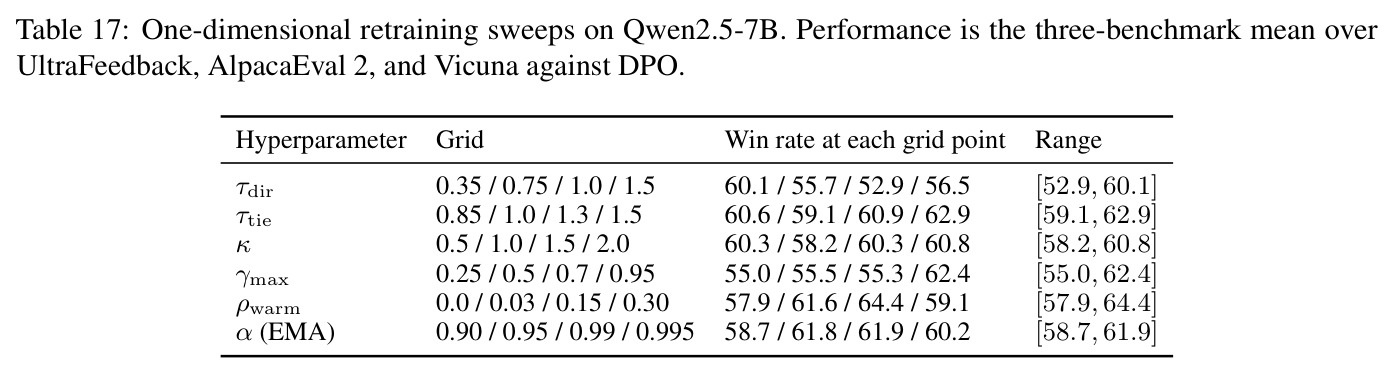
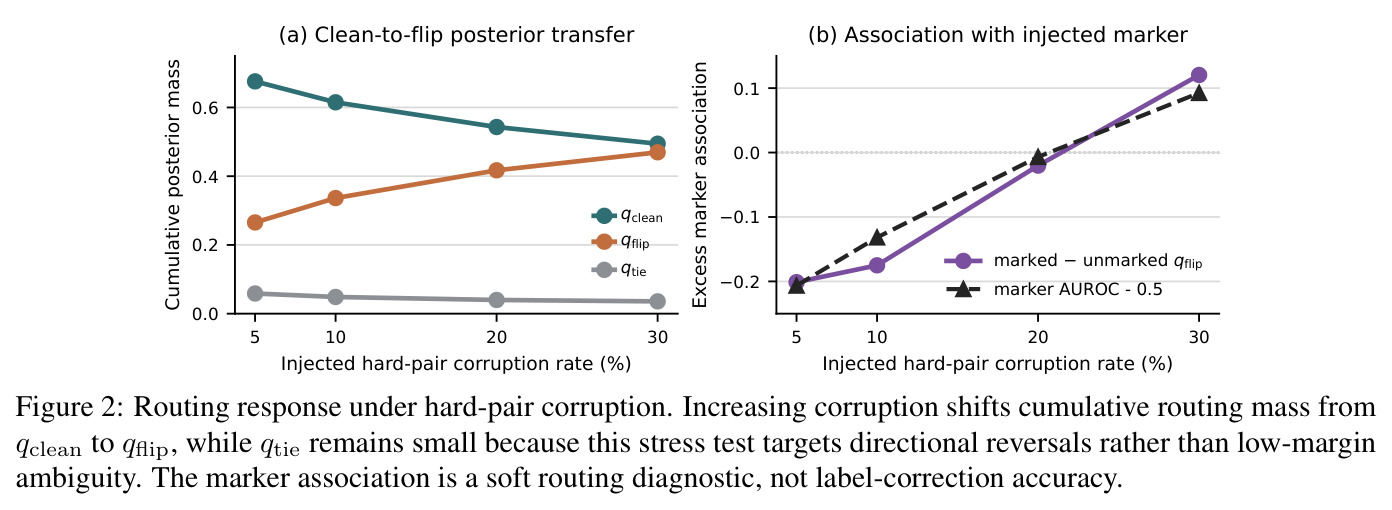
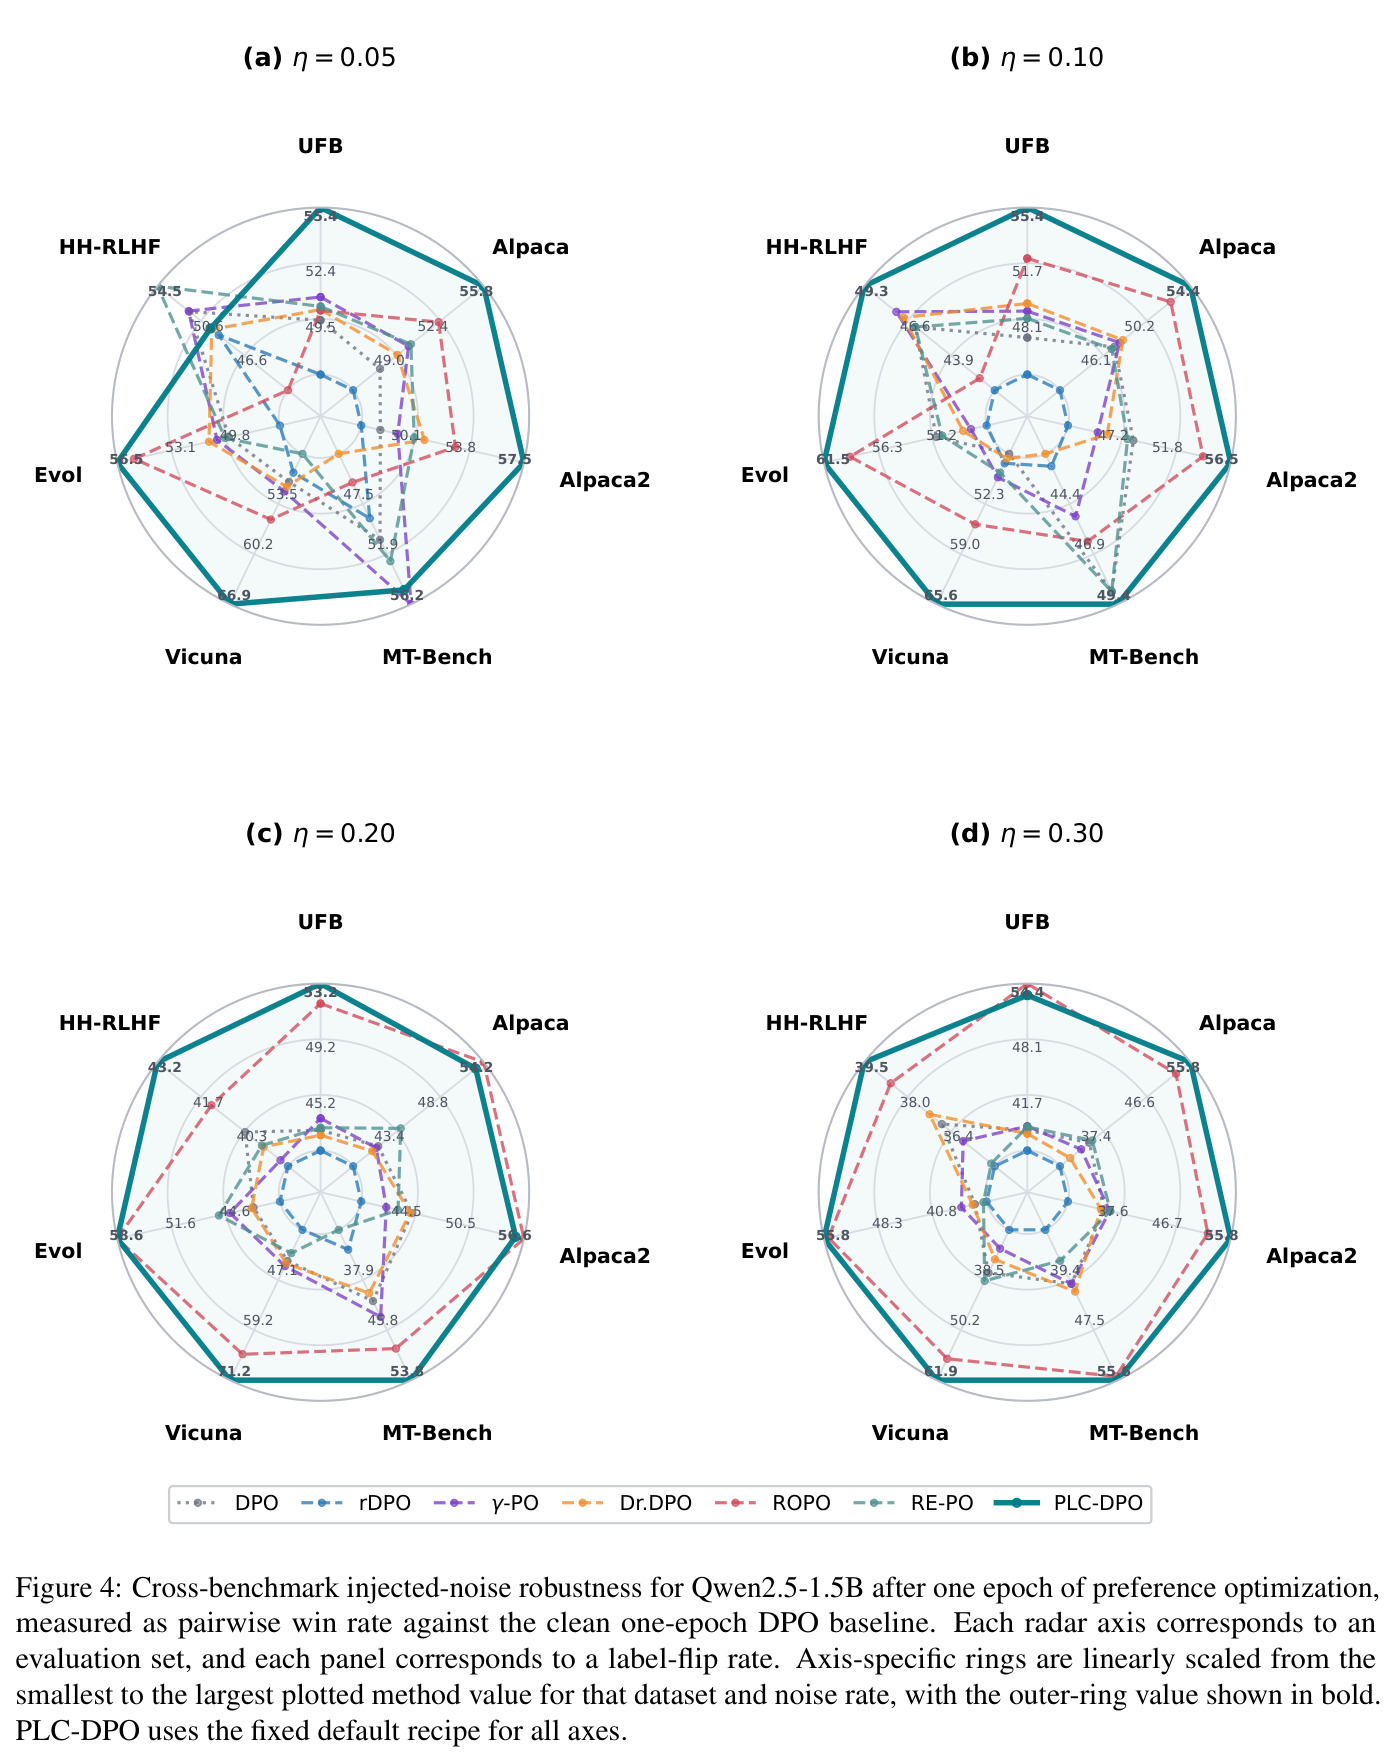
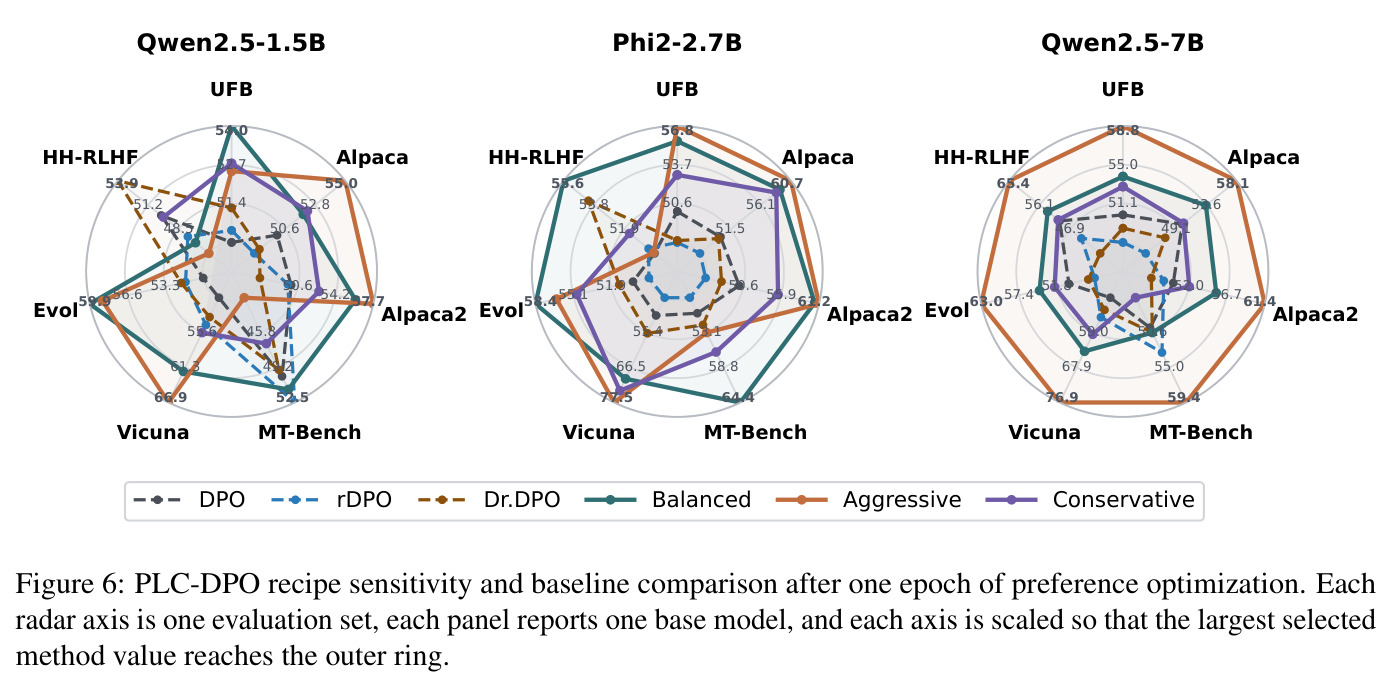
主实验(Table 1):在 UltraFeedback Binarized 上训练一轮、以同数据 DPO 为基线、Skywork-Reward-V2-Llama-3.1-8B 判分。Qwen2.5-7B 上 PLC-DPO 达 UFB 58.80、Alpaca 58.14、AlpacaEval2 61.37、Vicuna 76.88、Evol-Instruct 62.98、HH-RLHF 65.40;1.5B 与 Phi-2 上在 AlpacaEval2(57.70/61.24)和 Vicuna(66.88/77.50)领先,且模型越大增益越明显。泛化(Table 3):57 个数据集-模型-基准单元平均胜率 60.5,领先第二名 rDPO(55.5)5.0 分;最差单元 41.2 仅次于 γ-PO 的 42.5,而 ROPO 干净 UFB 均值虽达 59.6、最差单元却崩到 12.7,说明本文'高均值+有竞争力的下界'。注入翻转噪声(Table 4):Qwen2.5-1.5B/Vicuna 上 $\eta=0.05\to0.30$ 时 PLC-DPO 为 66.88/65.62/71.25/61.88,全程领先最近的 ROPO。注入平局(Table 14):以 0→30% 等分对替换训练对,PLC-DPO 对 DPO 的优势从 +8.3 扩大到 +18.5 分,30% 时 68.5 对 RE-PO 的 51.6。人类分歧(Table 16):MultiPref 上 $q_{tie}$ 随分歧程度单调上升(unanimous 0.0811 → divergent 0.0904 → tie-majority 0.0997,$p<10^{-15}$)。路由诊断(Table 19):$\eta$ 从 0.05 到 0.30,累计 $q_{clean}$ 从 0.676 降至 0.495、$q_{flip}$ 从 0.265 升至 0.470,marker AUROC 升至 0.592;20% 翻转下最终 flip-marker AUROC 为 0.731,$q_{flip}$ 预测独立奖励模型与数据标签分歧的 AUROC 达 0.779。消融(Table 5):去掉 warm-up/门控跌至 48.93,去掉 flip 状态 51.62,完整方法 58.97。敏感性(Table 17):24 种配置全部优于 DPO(50.0),均值 59.3、范围 52.9–64.4。开销(Table 18):每步中位 1.110s vs DPO 1.362s。种子稳定性(Table 7):Vicuna 上 66.3±7.0。此外在 HH-RLHF 长训退化实验中,约 45% 训练进度时 PLC-DPO 域内胜率仍保持 87.8(基线 62.0–73.8),且是唯一在最佳检查点仍高于 SFT 起点的方法。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 主对齐矩阵(3 模型 × 7 基准,胜率对同数据单轮 DPO) | 57 个数据集-模型-基准单元的平均/最差胜率 | PLC-DPO 平均 60.5、最差 41.2 | rDPO 平均 55.5;γ-PO 最差 42.5(最高下界) | 平均 +5.0 分;最差单元仅次于 γ-PO 1.3 分 |
| 干净 UltraFeedback 泛化(21 单元) | 平均胜率 | PLC-DPO 60.7 | ROPO 59.6,其余方法 ≤50.2 | +1.1 分 vs ROPO,+10.5 分 vs 其他方法 |
| 注入标签翻转鲁棒性(Qwen2.5-1.5B,Vicuna,η=0.30) | 对干净 DPO 的胜率 | PLC-DPO 61.88(66.88/65.62/71.25 @ η=0.05/0.10/0.20) | ROPO 56.88(最接近的基线) | 全程领先,η=0.30 时 +5.0 分 |
| 注入平局压力测试(0–30% 等分对替换) | 对同数据 DPO 的三基准平均胜率 | PLC-DPO 68.5(30% 注入率),对 DPO 优势 +18.5 分 | RE-PO 51.6 | +16.9 分;优势随注入率从 +8.3 单调扩大到 +18.5 |
| 路由诊断(20% 翻转污染,Qwen2.5-7B) | flip-marker AUROC / qflip 对奖励模型分歧的 AUROC | 0.731 / 0.779(qflip 在注入对上均值 0.473 vs 干净对 0.197) | 无(机制验证性实验) | 证明路由分布对受控病灶有剂量响应且与外部证据一致 |
| 计算开销(8×NVIDIA B200,110 步) | 每步中位耗时 | PLC-DPO 1.110 s | DPO 1.362 s | ≈0 额外开销(复用 DPO 前向结果) |
局限与改进
作者承认的局限:路由证据完全依赖当前策略-参考边际,当策略与冻结参考共享系统性错误(同源于 SFT 初始点)时证据可能失真,尽管 EMA 校准与自确认控制可缓解;分布偏移下可能需要更长预热或更自适应的校准;理论性质(路由错误率、EMA 适配、策略与路由联合动态下的门控行为)尚未建立。我自己的观察:主实验为单轮、单种子、贪心解码(仅 Table 7 做三种子),结论对多轮 RLHF 或更长训练的适用性未知;主矩阵依赖开源奖励模型判分,虽有 Claude Sonnet 4.6 的小规模验证(200 条 AlpacaEval2 + 80 条 Vicuna),仍有判分器偏差风险;小模型上 MT-Bench 明显偏弱(1.5B 仅 42.50,低于 cDPO 的 55.00),暗示多轮对话能力可能受损;HH-Golden 上 rDPO 的单元均值(78.9)仍强于本文(74.3),Llama-3-8B 干净 UFB 上 ROPO(60.4)也略高于本文(59.8);tie 损失把模糊对往边际零点推,可能浪费其中仍含微弱信号的部分;三状态是硬离散假设,缺少'部分翻转/按强度修正'的中间态。
独立分析的弱点
第一,自证循环风险:路由证据来自被训练的策略本身,若 SFT 初始点对某些话题存在系统性偏好错误,策略与参考会共享这一先验,EMA 校准只能消除尺度漂移、无法消除方向性偏见;改进方向是引入第二个独立参考(不同初始化或不同数据训练)交叉验证边际。第二,证据单一:只用标量边际 z-score,丢弃了长度差、风格差等可解释特征,可将 $z$ 与辅助特征(长度差、困惑度差、外部判分一致性)拼接后路由。第三,tie 损失 $\mathrm{softplus}(|m|)$ 会把模糊对硬性压向边际零点,对本来就接近但确有细微差异的对可能过度抑制;可改为按 $q_{tie}$ 缩放的弱方向损失。第四,批级 EMA 对小批量/梯度累积设置敏感(论文固定有效 batch=64),batch 很小时方差估计噪声大,可改用跨步滑动分位数或 Welford 在线方差。第五,置信门控是启发式,且敏感性扫描显示 $\tau_{dir}$ 影响最大(52.9–60.1)、$\gamma_{max}$ 次之(55.0–62.4),说明路由锐度与纠正强度需要更原则化的自适应机制,例如按 EMA 置信度统计量在线调节温度。
未来方向
作者提出的方向:刻画路由错误率、EMA 适配与门控在策略和路由联合演化下的理论保证。基于本文成果可延伸的方向:其一,把三状态路由搬进在线/迭代 RLHF——策略提升后边际证据更可靠,纠正会更准,形成正反馈;其二,推广到其他偏好目标(KTO、SimPO、IPO)乃至 token 级路由,实现细粒度纠正;其三,与数据选择和课程学习结合,用路由分布给课程排序,$q_{flip}$ 高的对先纠正再训练;其四,在多标注者数据(MultiPref 风格)上把人类分歧本身作为监督信号,训练显式的分歧/平局预测头,把 $q_{tie}$ 从诊断量升级为一等公民;其五,理论层面分析三状态混合损失的收敛性,以及 flip 状态误纠(把干净对翻过来)的代价上界;其六,把路由分布作为数据集审计工具输出给标注流程,形成'训练中发现坏标签—回馈修复数据'的闭环。
复现评估
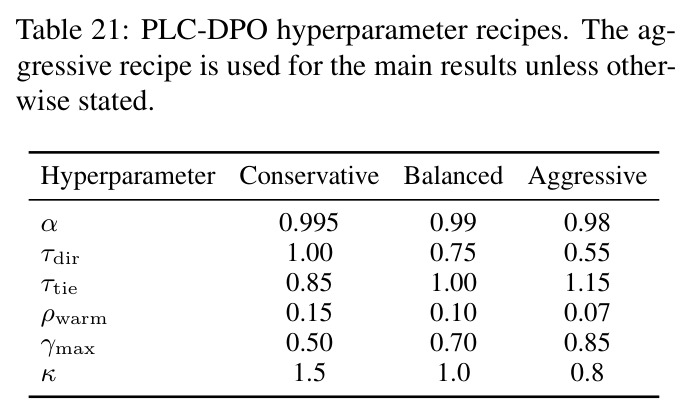
复现条件相当友好。代码已在 GitHub 开源(VennTum99/PLC-DPO)。所有模型与数据公开:SFT 起点(Qwen2.5-1.5B/7B、Phi-2-2.7B、Llama-3-8B、Mistral-7B 的 UltraChat SFT 权重)、训练数据(UltraFeedback Binarized、HH-Golden、Nectar-60k、ORPO-mix-40k、HH-RLHF)。训练配置普通:LoRA r=16/α=16、学习率 $1\times10^{-5}$、AdamW、cosine 调度、有效 batch 64、单轮偏好训练,主实验只需两张 RTX A6000(7B 模型约 8 小时),开销测量用 8×B200。论文给出三套完整配方(Table 21:conservative/balanced/aggressive 的 $\alpha$、$\tau_{dir}$、$\tau_{tie}$、$\rho_{warm}$、$\gamma_{max}$、$\kappa$),主实验默认 aggressive。方法本身只是在 DPO 之上加几十行标量运算与 EMA 状态,无需额外模型副本。主要门槛在评测侧:需要 Skywork-Reward-V2-Llama-3.1-8B 之类的判分模型与 AlpacaEval/MT-Bench 等评测流水线;且主结果为单轮单种子,复现者应对 ±2–3 分的方差有预期(Table 7 显示 Vicuna 上标准差可达 ±7.0)。总体难度:中低。
论文图表
单步训练伪代码:输入 mini-batch、策略 $\pi_\theta$、参考 $\pi_{ref}$ 与 EMA 状态 $(\mu,v)$;依次执行前向算边际与 $L_{DPO}$、detach 并做批统计 EMA 校准得 $z_i$、能量分数 softmax 得路由权重、构造三个状态损失并混合为 $L_{PLC}$、计算置信度 $C_i$、按预热调度得 $\gamma_t$,最终以 $L_i=(1-w_i)L_{DPO,i}+w_iL_{PLC,i}$ 更新参数,其中 $w_i=\gamma_t C_i$。
全部实现细节浓缩在 20 行伪代码内,是复现本文方法最直接的依据;stop-gradient、EMA 更新、预热与门控的位置一目了然。