Matrix-Game 4.0:用视频模型驱动的实时可玩游戏世界 Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
引擎管规则、代理写玩法、视频模型实时渲染,单卡 RTX 5090 实现 112ms 低延迟可玩游戏
前置知识
交互式世界模型
指能根据用户动作逐帧生成环境观测的生成模型,代表工作有 Genie 系列、GameNGen、Oasis、Magpie 等。它们把「下一帧画面」当作动作的函数来预测:玩家按键后,模型以自回归方式生成对应视角变化与场景演化的视频,从而构成一个可以「玩」的虚拟世界。这类模型通常用游戏录像或互联网视频训练,动作被压缩为隐变量或键鼠映射。
本文正是在这条技术路线上工作,理解它才能看清 Matrix-Game 4.0 把世界状态从模型搬进引擎这一根本转变。
流匹配与少步蒸馏
流匹配是一种扩散式生成范式:模型预测速度场 $v$,按 $z \leftarrow z - \sigma v$ 迭代去噪,通常需要多步。少步蒸馏(如 DMD 分布匹配蒸馏、一致性蒸馏)把多步教师压缩成 1-2 步学生:学生从较高噪声水平一步预测干净样本,被训练去逼近教师在下一噪声水平的输出或真实数据分布,从而大幅降低推理开销。
本文渲染器的实时性(每个 4 帧块仅 1-2 步去噪)完全建立在 Causal Forcing++ 式三阶段蒸馏之上。
低多边形代理
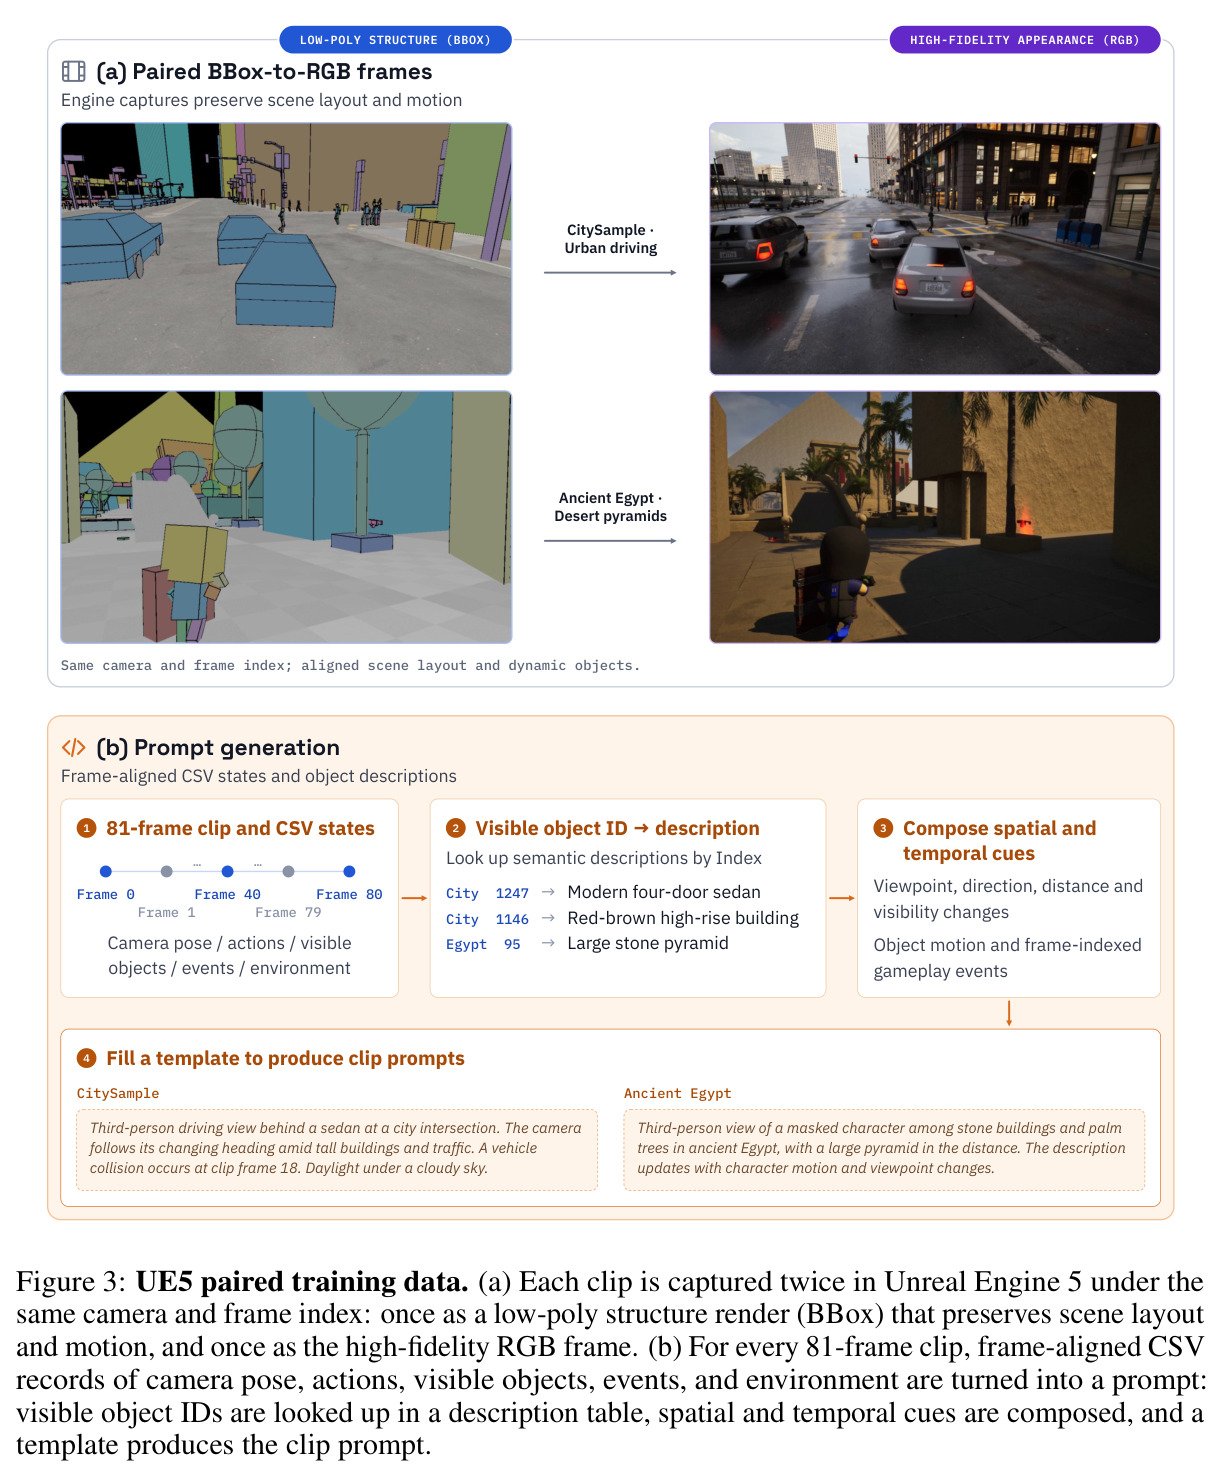
用极简几何体(方块、圆柱加球体)加黑色描边表示建筑、树木、角色的结构渲染:天空纯黑、地面灰格棋盘,没有材质、纹理、反射和阴影,只保留空间布局、刚体位姿与运动轨迹。UE5 捕获时它与高保真渲染共享同一相机轨迹和帧索引,做到逐像素对齐,形成「结构→外观」的确定性条件映射训练对。
代理是引擎与视频模型之间的核心接口,读懂它才能理解「引擎出结构、模型出画面」的分工。
因果自回归与 KV 缓存
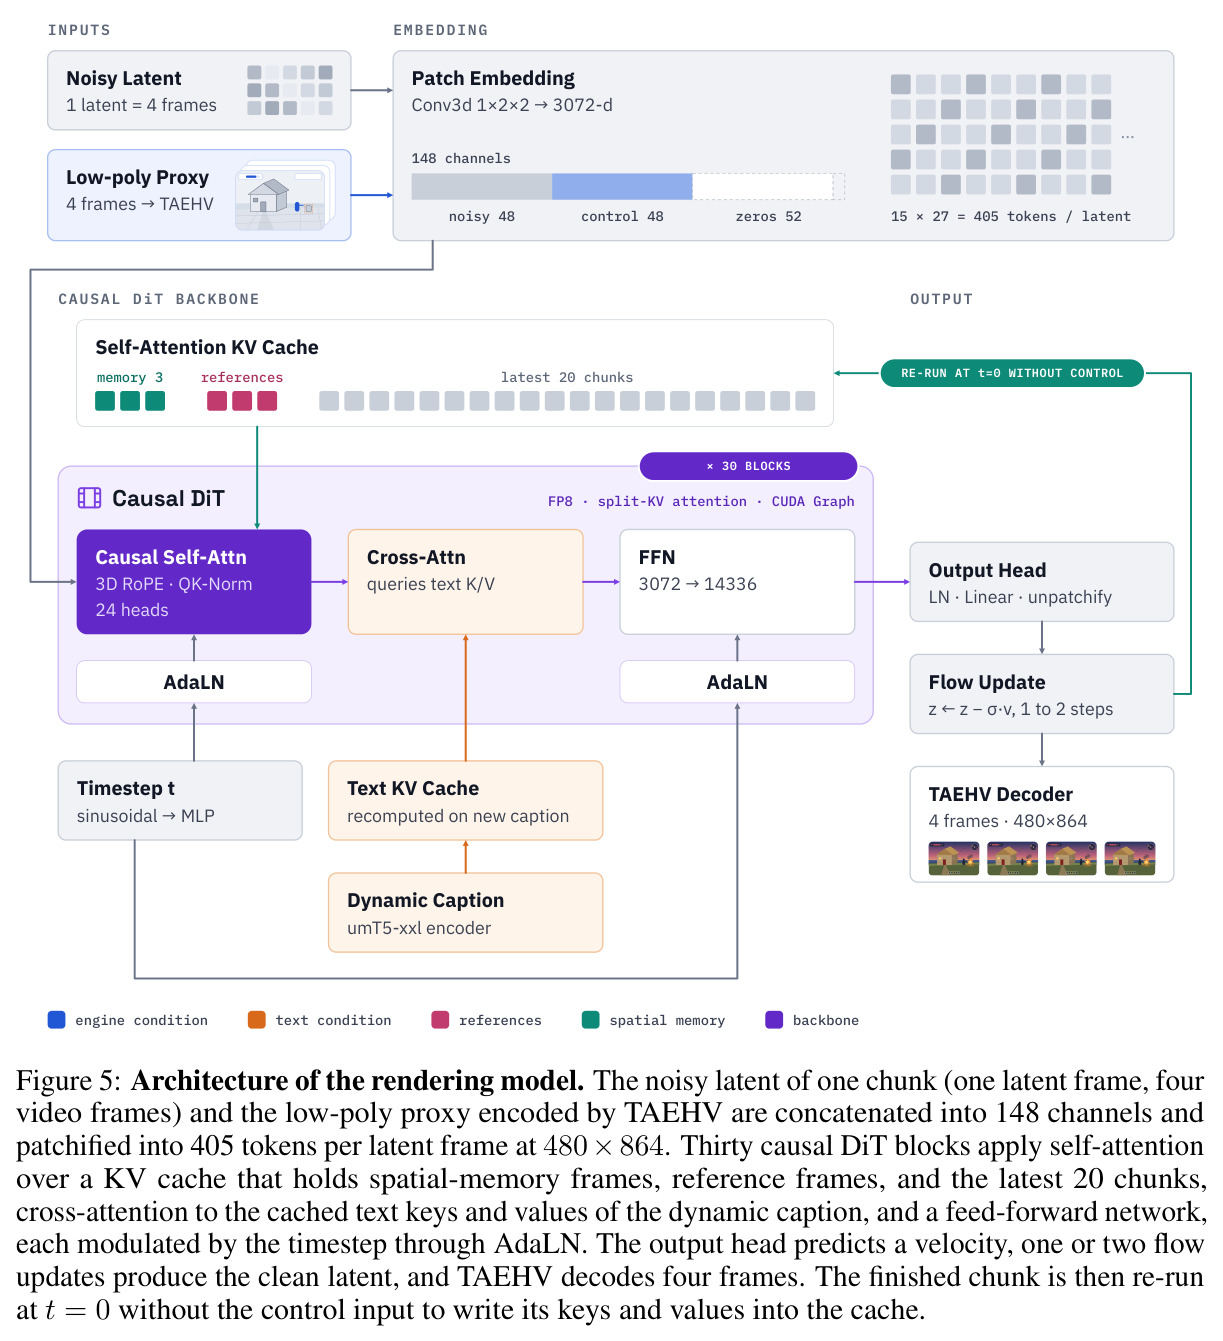
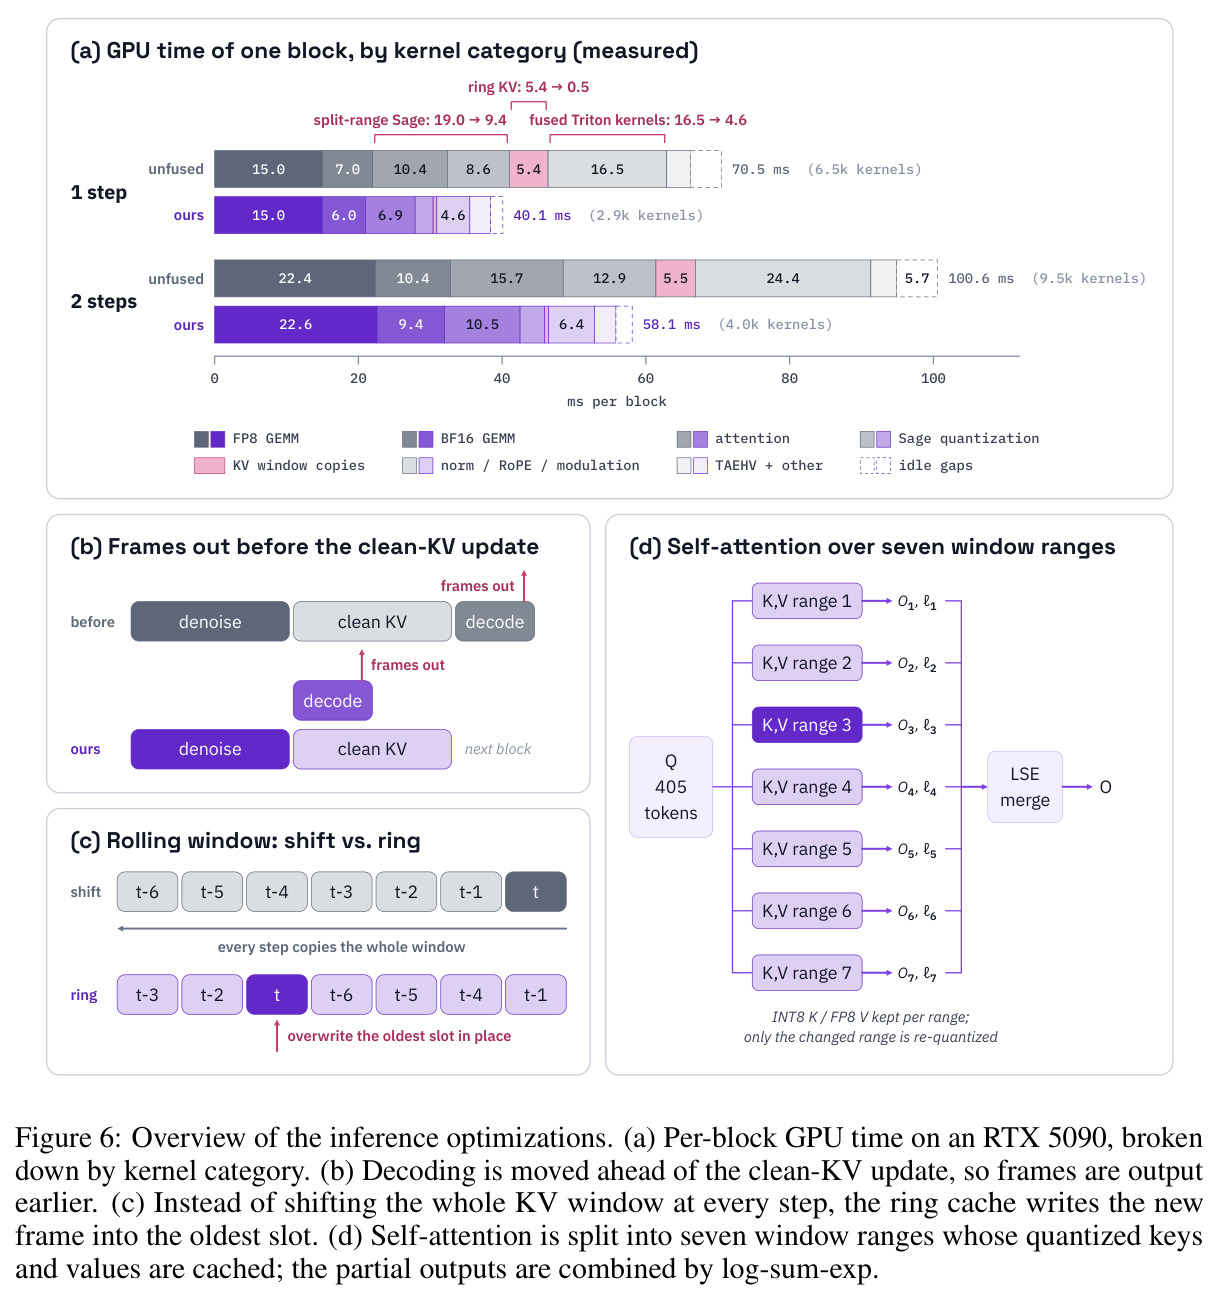
因果模型生成当前块时只能看到过去的帧。Transformer/DiT 的自注意力会把历史 token 的键值缓存下来避免重算;长视频生成通常只保留最近窗口(如本文最近 20 块)加参考帧。环形缓冲区让新帧原地覆盖最旧槽位、避免整窗搬移;分窗注意力把窗口切成多个区间并行计算,再用 log-sum-exp 合并部分输出。
本文 83 FPS 的推理优化大多围绕 KV 缓存与注意力展开,是读懂 Figure 5/6 与 Table 2 的前提。
FP8 量化与 CUDA Graph
FP8 是 8 位浮点格式,把线性层权重和部分注意力键值压缩到 8 位以节省显存和带宽;CUDA Graph 把整段 GPU 计算录制成一张图,运行时单次发射回放,消除每个块上千个 kernel 的 CPU 启动空转。两者是现代推理引擎的标准手段,尤其适合本文明这种「每块计算量很小、调用极频繁」的实时场景。
论文从 4.5 FPS 提到 83 FPS 的系统优化清单里,这两项支撑了从 15.4 到 24.2 FPS 的关键一段加速。
研究动机
以 Genie 系列、GameNGen、Oasis、Magpie 和 Matrix-Game 2.0/3.0 为代表的交互式世界模型把世界状态完全交给视频生成网络:状态隐含在生成的像素和模型上下文里,视野之外的区域没有任何显式记录。由此带来四个具体问题。第一,没有持续的外部纠错,模型滚动基本处于孤立状态,自回归生成中微小误差不断复利累积,即便引入外部 3D 工具,相机位姿估计误差也会积累到场景坍塌;第二,历史帧未经空间压缩,显存随滚动时长线性增长,难以支撑长时程游戏;第三,玩法机制贫乏,交互基本停留在导航和基础环境反馈,缺少可执行规则、持久的行为后果和玩家可主动追求的明确目标;第四,扩散模型学到的主要是统计相关性——视觉逼真不等于因果或物理理解。论文借用 Jakobson 的符号学三分法指出,文生视频更像「符际翻译」,语义智能主要来自上游 MLLM 和文本编码器,扩散本身更像一个渲染器,因此这类系统做不出真正可玩、规则可改的长时游戏。
本文的目标是目标是把「可控视频」升级为「可执行世界」:让游戏规则由代码定义、世界状态由轻量引擎持续维护、视频模型只负责把引擎输出的低多边形代理实时渲染成逼真画面,并用多模态编码代理支持自然语言创建和修改场景与玩法。性能指标非常具体:在单张 NVIDIA RTX 5090(32 GB 消费级显卡)上实现 480p、60 FPS 可玩游戏,按键到首帧显示延迟 112 ms;单步去噪稳态吞吐 83 FPS、峰值显存约 18.2 GiB;并进一步下探到 16 GiB 级消费卡(RTX 5080 约 67 FPS、RTX 5070 Ti 约 58 FPS);同时在发布当天开源代码、模型权重与低多边形游戏资产。
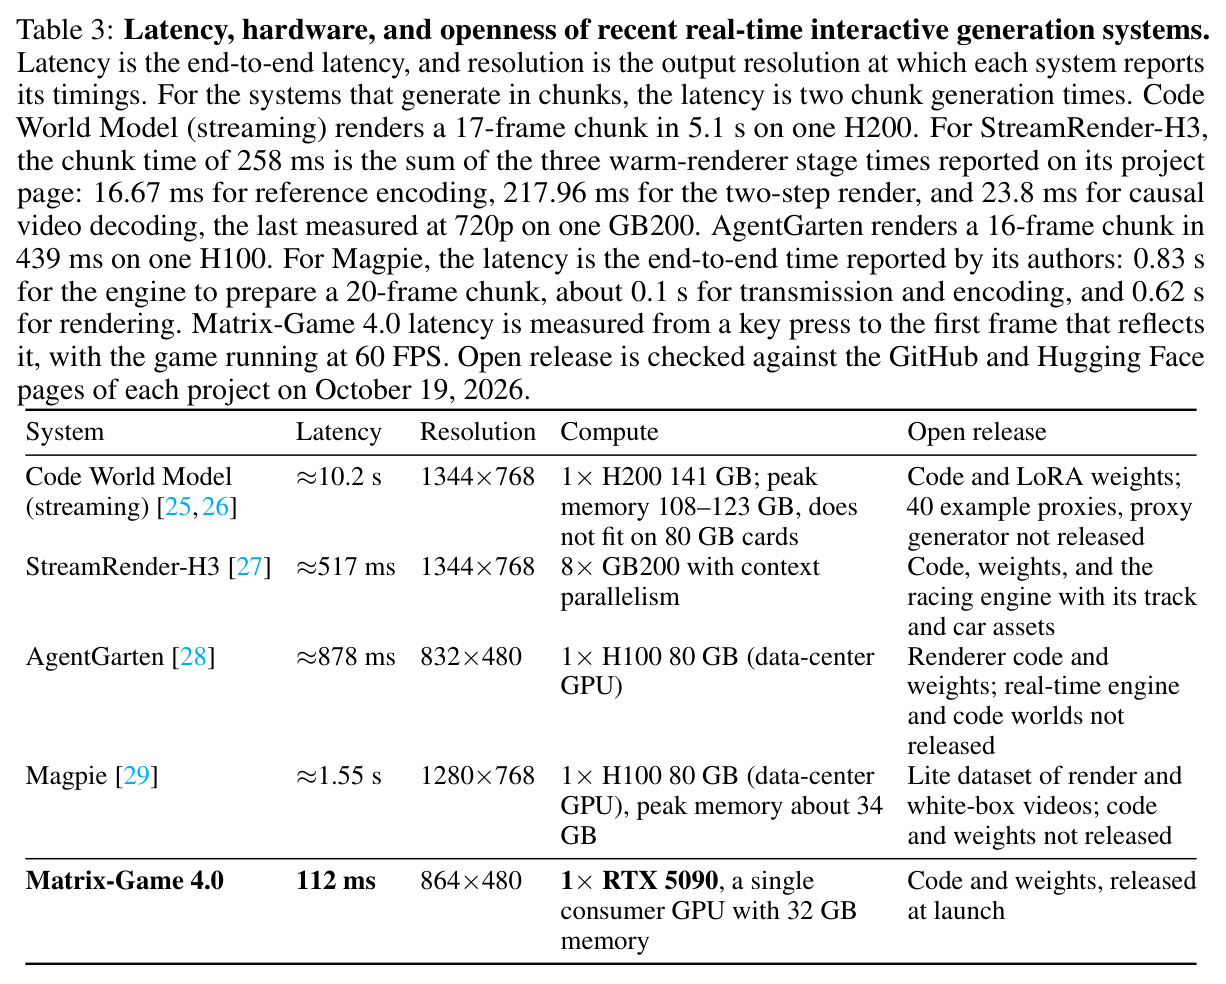
与已有工作不同的是,被忽视的切入点是:不必让视频模型同时承担「世界如何运行」和「世界看起来如何」两件事。同期工作 Code World Model、Magpie、StreamRender-H3、AgentGarten 也提出了「代码定义世界 + 视频模型渲染」的分工,但代价过高:Code World Model 在单张 H200 上生成一个 17 帧块需 5.1 秒(端到端约 10.2 s)且峰值显存 108–123 GB;StreamRender-H3 依赖 8×GB200(约 517 ms);AgentGarten 和 Magpie 都要 H100(878 ms / 1.55 s),没有一台能跑在消费级 GPU 上实时可玩,运行时可改规则的编码代理也大多缺席。Matrix-Game 4.0 的独特之处在于把这个范式推到极限:配 UE5 逐像素对齐的成对数据、纯规则模板(不用 VLM)的逐帧动态字幕、把每块 4 帧压到 1-2 步去噪的因果蒸馏,再叠加 9 项推理优化,最终 112 ms 延迟且发布即全量开源。
核心方法
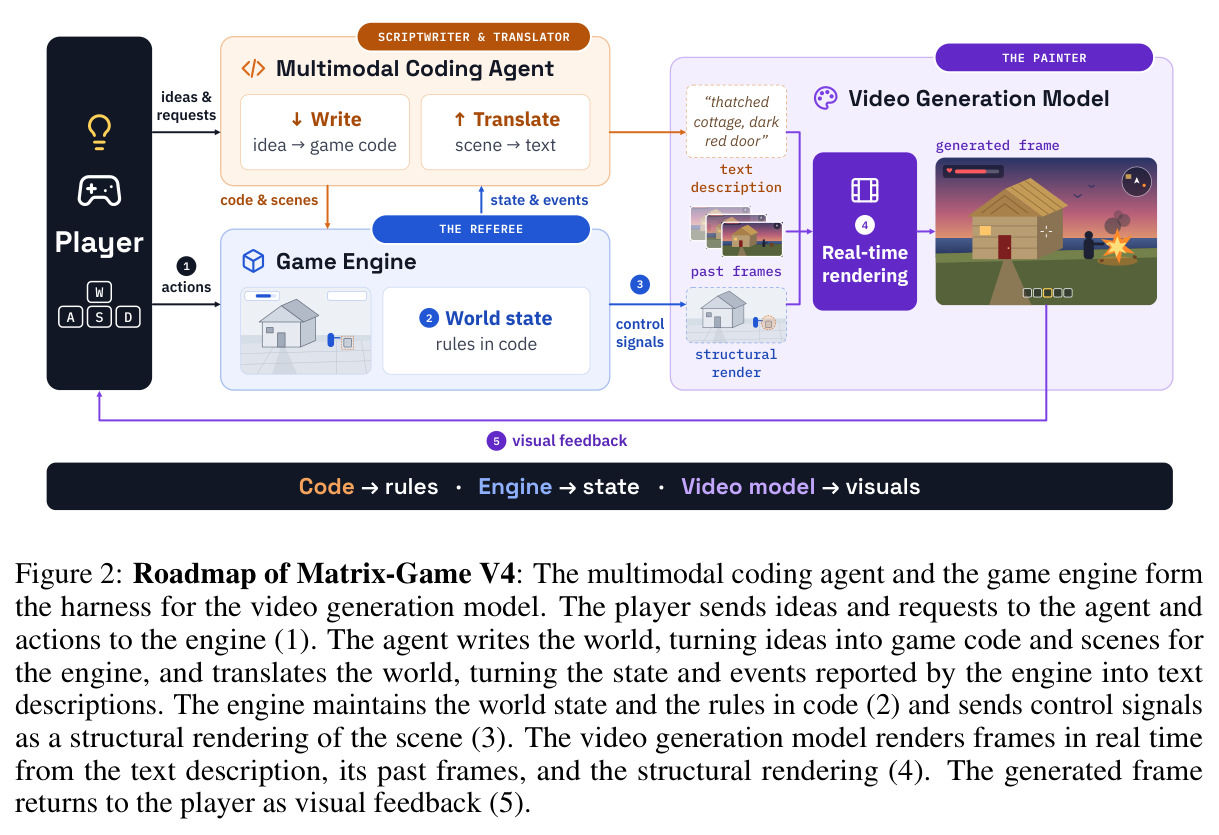
可以把整个系统想象成一个剧组:多模态编码代理是编剧兼翻译,游戏引擎是裁判,视频生成模型是画师。玩家把想法和请求发给代理、把按键动作发给引擎;代理把想法写成可运行的游戏代码和场景描述,同时把引擎上报的状态与事件翻译成文字;引擎在代码里执行血量、碰撞、重力、任务进度等规则并维护视野外对象,输出低多边形结构渲染;视频模型以动态字幕、过去帧和空间记忆为条件,把代理画面实时「画」成逼真帧反馈给玩家。技术上,渲染器从 Wan2.2-Fun-5B Control 改造成视频到视频模型:噪声潜变量与 TAEHV 编码的代理潜变量沿通道拼接成 148 维输入,每个潜变量块(=4 帧)产生 405 个 token,30 个因果 DiT 块做自注意力、文本交叉注意和 FFN;每块按 $z \leftarrow z - \sigma v$ 做 1-2 步流更新后由 TAEHV 解码。再经三阶段因果少步蒸馏和 CUDA Graph、FP8、融合 Triton 核、环形 KV 缓存、分窗注意力等 9 项优化,在 RTX 5090 上达到 83.4 FPS 稳态与 112 ms 端到端延迟。
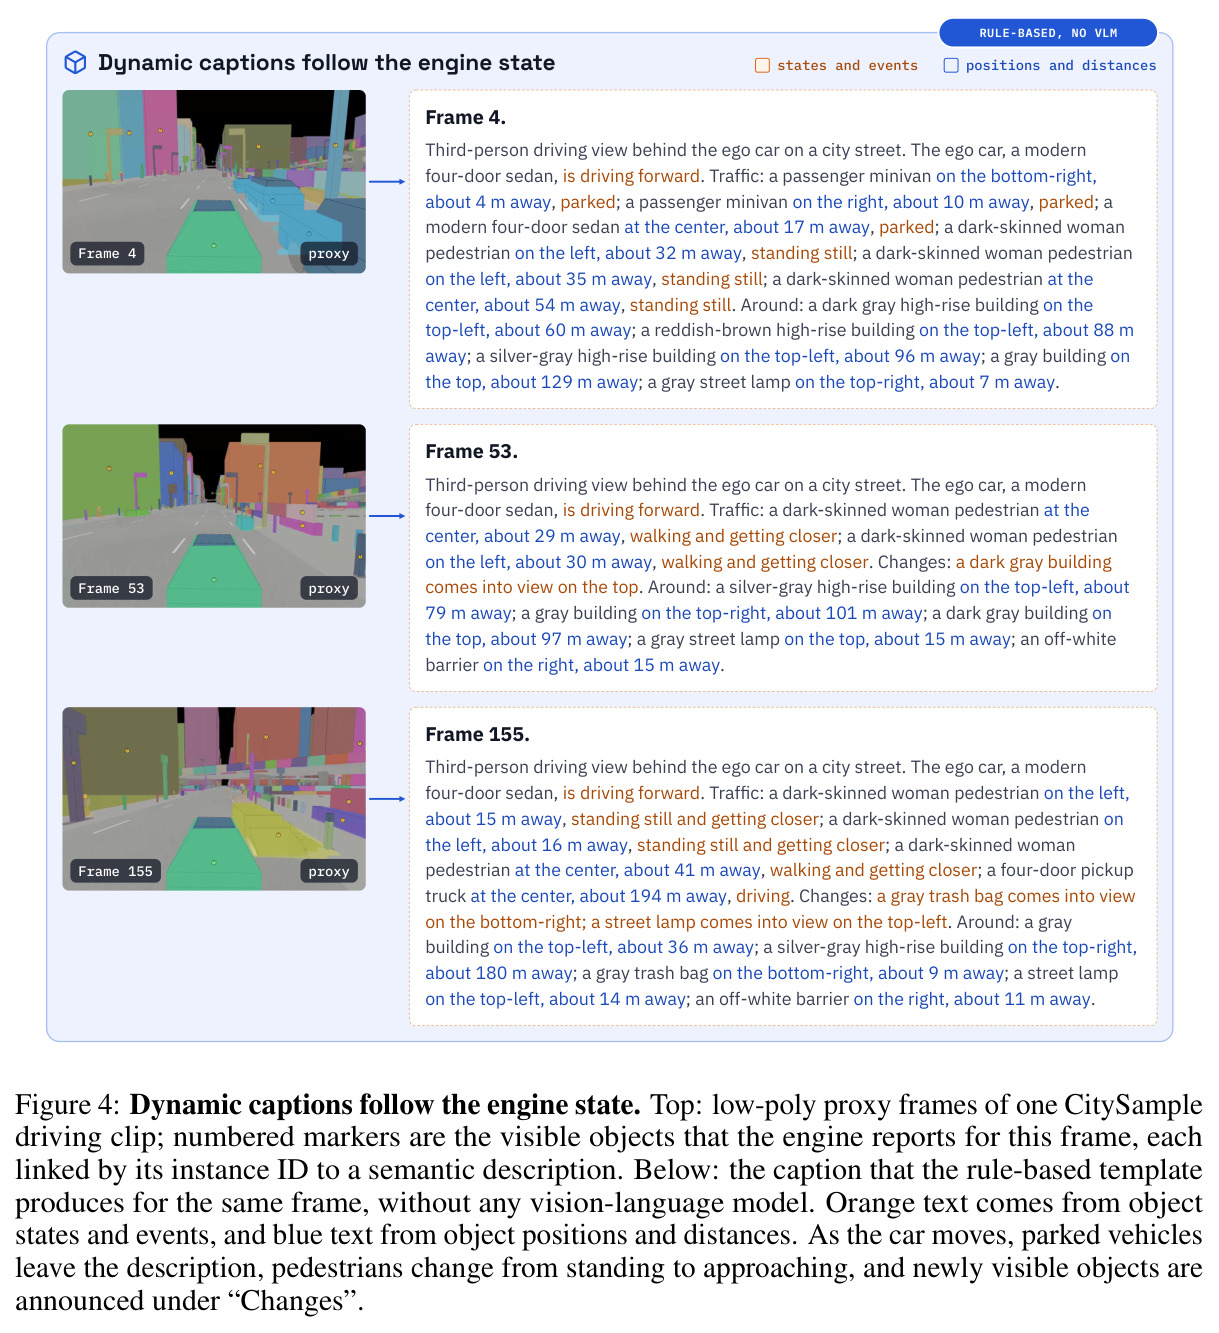
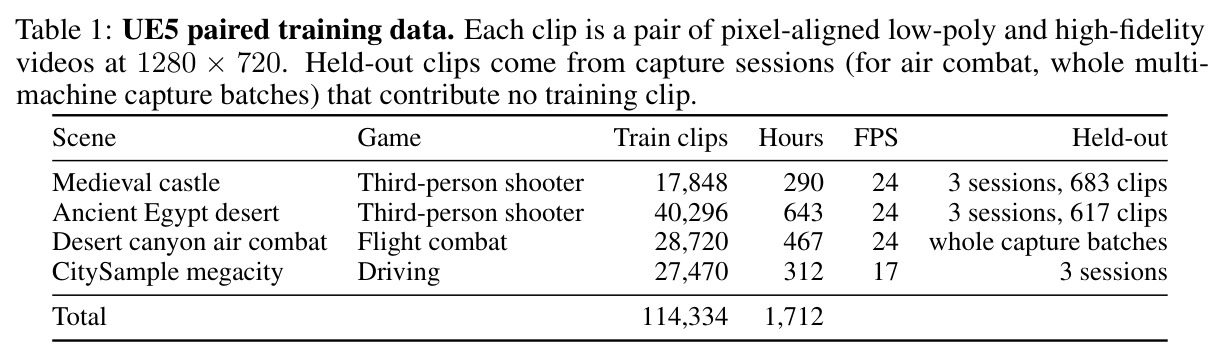
核心思想一句话:代码保规则,视频模型画每一帧。与 Genie、GameNGen 等让网络同时承载世界动力学和视觉的路线本质不同,Matrix-Game 4.0 把「游戏如何运行」完全移出神经网络——规则写在引擎代码里,状态由引擎显式维护,即使对象离开视野也按规则继续更新,游戏因此不再依赖视频模型的「记忆」来维持世界或执行判定。两个配套设计让这个分工真正成立:其一,UE5 成对捕获数据用同一相机、同一帧索引同时渲染低多边形代理与高保真 RGB,四个场景共 114,334 段、1,712 小时的逐像素对齐样本,把「结构→外观」变成有确定性监督的条件映射,长滚动一致性不再靠模型自觉;其二,动态字幕不用 VLM,而是基于对象 ID 查语义描述表、按模板逐帧组装方位、距离与事件(例如「第 18 帧发生碰撞」),与代理形成「结构 + 语义」的双重连续约束。视觉逼真交给统计生成的画师,因果性和可玩性交还给确定性代码,这正面绕开了扩散模型不真正理解物理的根本短板。
方法步骤详情
第一步,数据捕获与字幕:在 UE5 中用同一相机与帧索引录制低多边形结构渲染、高保真 RGB 与深度三路对齐视频加逐帧元数据(1280×720),覆盖城堡射击、沙漠射击、峡谷空战、城市驾驶四场景,共 114,334 段、1,712 小时,每场景留 3 个完整会话(空战为整批)作 held-out;同时由帧对齐 CSV 中的可见对象 ID 查语义描述表、按规则模板逐帧组装方位、距离与事件生成动态字幕,全程不调 VLM。第二步,监督微调:从 Wan2.2-Fun-5B Control 出发,在 704×1280 的 81 帧窗口上以流匹配目标训练双向 V2V 模型,条件为代理、字幕、首帧和至多 3 个空间记忆帧(取自窗口前 40 帧以上、按相机位姿最近选取);首帧/提示词/代理按 0.3/0.2/0.2 概率丢弃以支持 CFG,64 卡、batch 64、学习率 $10^{-5}$ 训 4,000 步,每个游戏单独一个模型。第三步,因果少步蒸馏(Causal Forcing++ 三阶段):教师强制自回归扩散 20,000 步(lr $2\times10^{-6}$)得因果教师;一致性蒸馏(48 个噪声水平、EMA 衰减 0.99、5,000 步)得 4 步生成器;非对称 DMD 以冻结双向模型的 $v_c + 3(v_c - v_u)$ 为真实分数、假分数在线训练,学生在 21-121 块的自回归滚动上学习并混喂 TAEHV 控制编码,最终每块 2 步、首块 4 步去噪。第四步,实时推理:每块 1 个潜变量(4 帧),1-2 步去噪并 TAEHV 解码输出;随后在 $t=0$ 不带控制重跑一次,把干净 KV 写入缓存供后续块 attend 到干净历史。
技术新颖性
与 Code World Model(H200 上 17 帧块 5.1 s、端到端约 10.2 s)、StreamRender-H3(8×GB200、约 517 ms)、AgentGarten(H100、878 ms)、Magpie(H100、1.55 s、代码权重未开源)相比,本文是唯一在消费级 GPU 上实时运行、且发布即开源全部代码与权重的系统。技术细节上的新意包括:把 TAEHV 解码提前到干净 KV 更新之前,让帧更早输出给玩家;环形 KV 缓存把窗口滑动的整窗拷贝(5.4 ms)降为原地覆盖最旧槽位(0.5 ms);自注意力切成 7 个 KV 窗口区间并行计算,每区间缓存 INT8 键/FP8 值、只重量化变化区间,部分输出经 log-sum-exp 合并;以及用纯规则模板替代 VLM 生成逐帧动态字幕。蒸馏侧完整复用 Causal Forcing++ 的三阶段配方,但针对部署做了适配:学生在自回归滚动上训练、双分数只评估最后 21 块、并混喂 TAEHV 与 Wan-VAE 两种控制编码以弥合训练-部署差异。
实验结果
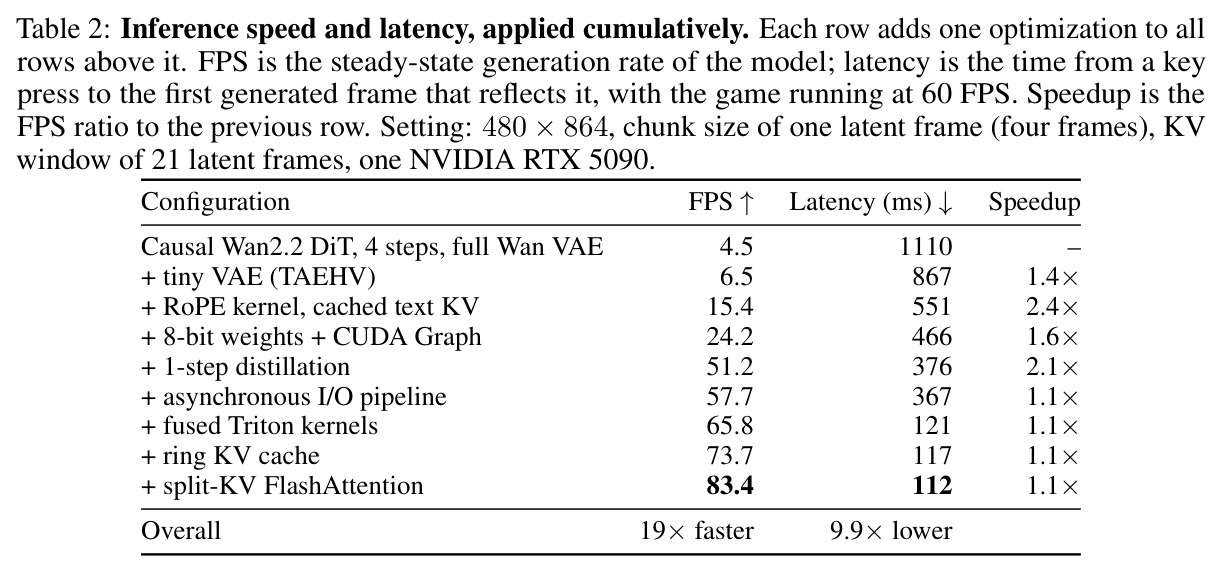
推理优化是最扎实的贡献。在 RTX 5090、480×864、KV 窗口 21 块设定下,从「因果 Wan2.2 DiT、4 步、完整 Wan VAE」的 4.5 FPS / 1110 ms 基线逐项叠加:TAEHV 解码器(6.5 FPS / 867 ms,1.4×)、RoPE 融合核与文本 KV 缓存(15.4 / 551,2.4×)、FP8+CUDA Graph(24.2 / 466,1.6×)、1 步蒸馏(51.2 / 376,2.1×)、异步 I/O(57.7 / 367)、融合 Triton 核(65.8 / 121,砍掉 246 ms)、环形 KV(73.7 / 117)与分窗 FlashAttention(83.4 / 112),累计 19 倍吞吐、9.9 倍延迟改善;单步去噪每块仅 48 ms、峰值显存 18.2 GiB,固定提示词下 RTX 5080 约 67 FPS、5070 Ti 约 58 FPS(12.8/10.9 GiB),部署门槛压进 16 GiB 级消费卡。系统对比(Table 3)中,112 ms 约为次优 StreamRender-H3(517 ms、8×GB200)的五分之一,较 Code World Model(10.2 s、H200)低近两个数量级,且是唯一发布即开源代码与权重的方案。质量上,三游戏在 961 帧(40 秒)held-out 滚动中始终跟随代理布局与相机,材质、烟雾由模型补全且角色外观不漂移;编码代理实录的护盾耐久碎裂、高射速霰弹枪、归零判负、检查点计时赛与贴身五秒拦截的追捕模式,规则全部由引擎执行,验证「代码管玩法、模型管画面」。
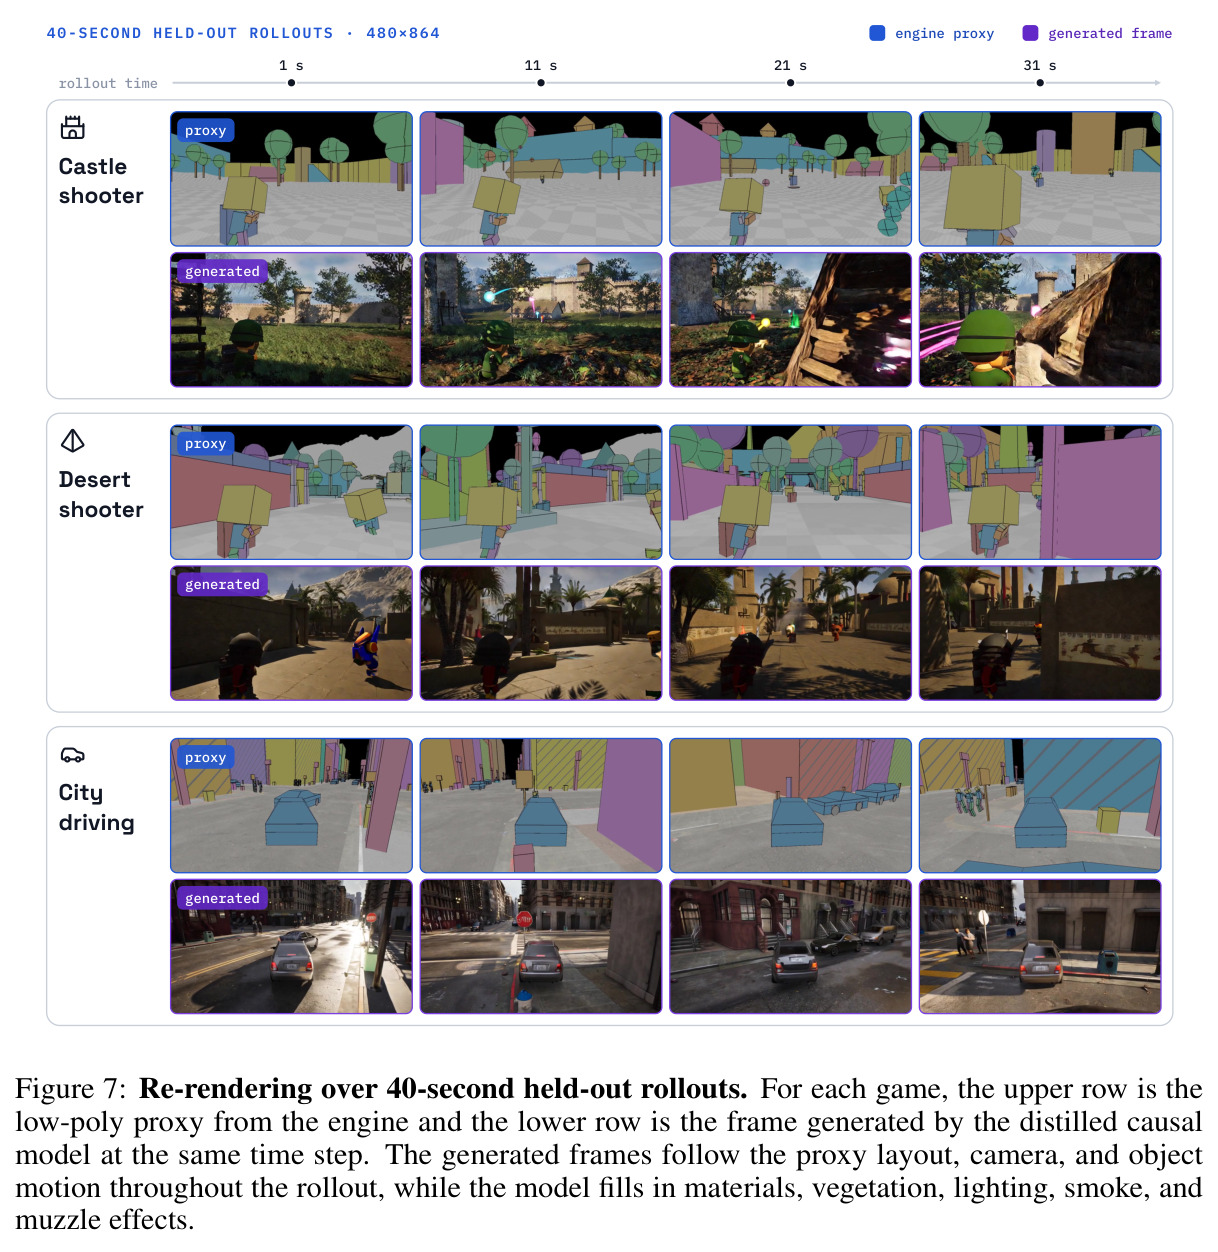
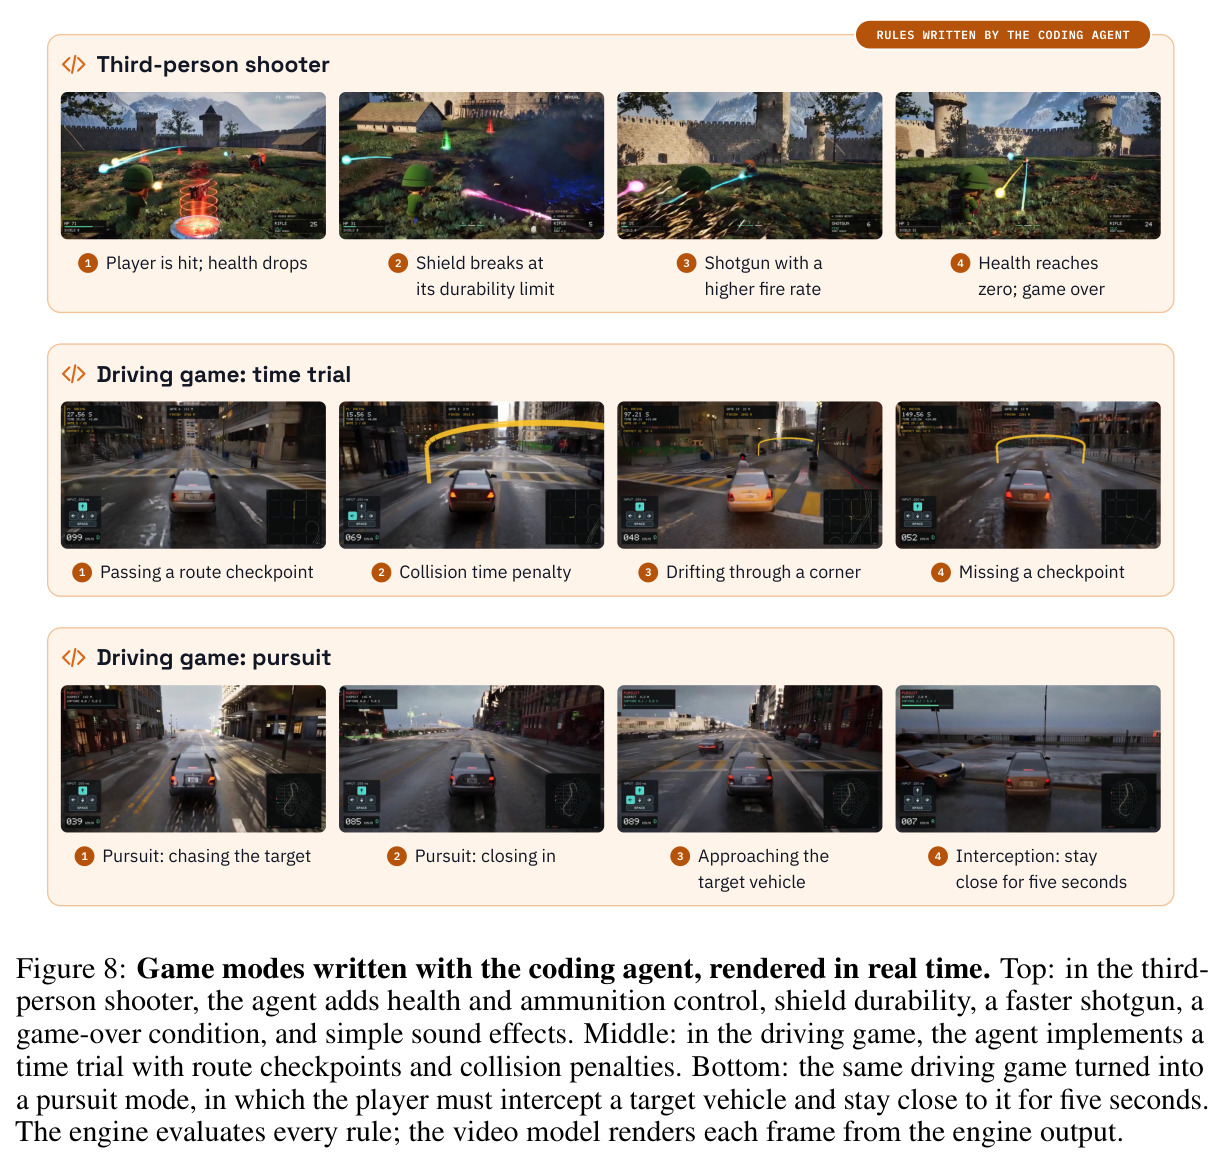
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端交互延迟(按键到首帧反映,游戏以 60 FPS 运行) | 延迟(ms) | 112 ms @ 1×RTX 5090,864×480 | StreamRender-H3 ≈517 ms(8×GB200);AgentGarten ≈878 ms(H100);Code World Model ≈10.2 s(H200) | 约为次优的 1/5(4.6×),较 Code World Model 约 91× |
| 稳态视频生成吞吐(模型推理,480×864) | FPS | 83.4 FPS(1 步去噪,RTX 5090) | 因果 Wan2.2 DiT、4 步、完整 Wan VAE:4.5 FPS | 19× |
| 消费级 GPU 可部署性 | 峰值显存 / FPS | RTX 5080 约 67 FPS @ 12.8 GiB;RTX 5070 Ti 约 58 FPS @ 10.9 GiB | Code World Model 峰值 108–123 GB(需 H200,不兼容 80 GB 卡);Magpie 约 34 GB(H100) | 首次把可玩游戏世界压进 16 GiB 级消费卡 |
| 单块(4 帧)生成时间 | ms | 48 ms(1 步去噪) | 基线配置下约 555 ms/块(由 1110 ms 延迟 ≈ 2 个块生成时间推算) | 约 11.6× |
局限与改进
作者承认的局限:每个游戏需要单独训练一个渲染模型(SFT 4,000 步加三阶段蒸馏约 26,000 步、均需 64 卡),尚未形成跨游戏通用的世界模型;输出分辨率限于 480×864,更高分辨率要靠未来的精修阶段;多人一致视角渲染仍只是展望;16 GiB 卡上的 67/58 FPS 是在固定提示词(即动态字幕不更新)条件下测得的,实际游玩字幕逐帧变化会带来额外开销。我的独立观察:训练数据全部来自 UE5 内四个可控场景(含 CitySample 等成熟资产),对开放世界、风格化画面或引擎外场景的泛化完全未知;动态字幕依赖对象 ID 语义表与手工模板,遇到表外新对象或复杂复合事件(多物体连锁反应)就无法描述;烟雾、火花等视觉特效仍是统计相关的产物,与引擎规则不保证因果一致;视觉质量评估完全定性(挑好的时刻截图),没有任何 FVD/LPIPS 式量化指标;编码代理依赖外部 MLLM,其调用成本、延迟和失败率未披露,实时改玩法时的卡顿风险不明。
独立分析的弱点
第一,「一个游戏一个模型」的成本结构最脆弱:新增游戏要重新做 UE5 成对捕获(单场景数百小时)加 64 卡上的 SFT 与三阶段蒸馏(合计约 3 万步),改进方向是训练跨场景共享底座、每个新游戏只微调 LoRA,甚至让代理直接生成合成代理式训练对来弱化 UE5 捕获依赖。第二,规则字幕的表达力天花板低:模板只能表达「某方位某距离某对象某状态」式的描述,像「爆炸波及邻近油桶引发连环火」这类因果链很难转译,遇到语义表外对象直接失语;改进方向是保留模板主干、为复杂事件加小型 VLM 兜底,或用学习式状态编码器取代文本通道。第三,480p 与固定 4 帧块在高动态场景(空战、快速甩镜)下容易出现细节丢失与运动模糊,且首个潜变量块要 4 步去噪会抬高开局延迟;可引入自适应块大小或按场景运动强度切换步数。第四,评估缺乏量化:held-out 质量只靠挑好的可视化帧,没有 FVD、结构一致性(如代理-生成帧边缘 IoU)、事件触发时刻的画面正确率等指标,建议公开失败案例与统计性评测。第五,玩法依赖引擎预设的几何与规则原语,真正开放式的「代理从零写一个全新游戏」尚未演示,成功率与迭代时长未知。
未来方向
作者给出的近期计划是继续降低推理成本与硬件门槛,目标在 Steam 发布技术预览版;中期方向包括加入精修阶段提升分辨率、实现多人共享世界状态且各视角一致、对生成画面做更精细的可控、扩展到更多游戏类型与场景。顺着本文成果还可以延伸几个方向:把「引擎状态 + 视频渲染」组合当作智能体训练环境(与 AgentGarten 的思路接轨),用编码代理批量产出异构玩法做课程式强化学习;把空间记忆帧机制推广成可检索的场景记忆库,支持任意「回访旧地」且外观不漂移;研究生成帧偏离引擎代理时的自动检测与回退策略,让「画师」不服从「裁判」判决时系统能自我纠正;以及把单游戏渲染器统一为多游戏条件化模型,用游戏描述嵌入切换风格,摊薄每游戏训练成本。
复现评估
开源情况是本文的强项:发布当天放出代码、模型权重(HuggingFace checkpoints)与低多边形游戏资产,每个游戏的蒸馏因果模型都可下载直接跑;但 114,334 段 UE5 训练数据本身未随论文发布,只描述了可复用的捕获管线。推理复现门槛低:单张 RTX 5090(32 GB)即可跑到 83 FPS / 18.2 GiB,16 GiB 的 RTX 5080/5070 Ti 也能到约 67/58 FPS(固定提示词),个人开发者装一块消费卡就能体验和二次开发。训练复现门槛高:每个游戏需要 64 卡做 SFT(4,000 步)加三阶段蒸馏(20,000+5,000+1,000 步),还要搭建 UE5 双渲染同步捕获、CSV 元数据与动态字幕模板管线,接近中小实验室级别的工程量;编码代理依赖未指明的外部 MLLM,接口协议需自行对接。综合判断:跑推理、改引擎规则、换资产非常友好;完整复训每个游戏则需充足算力与 UE5 工程能力。
论文图表
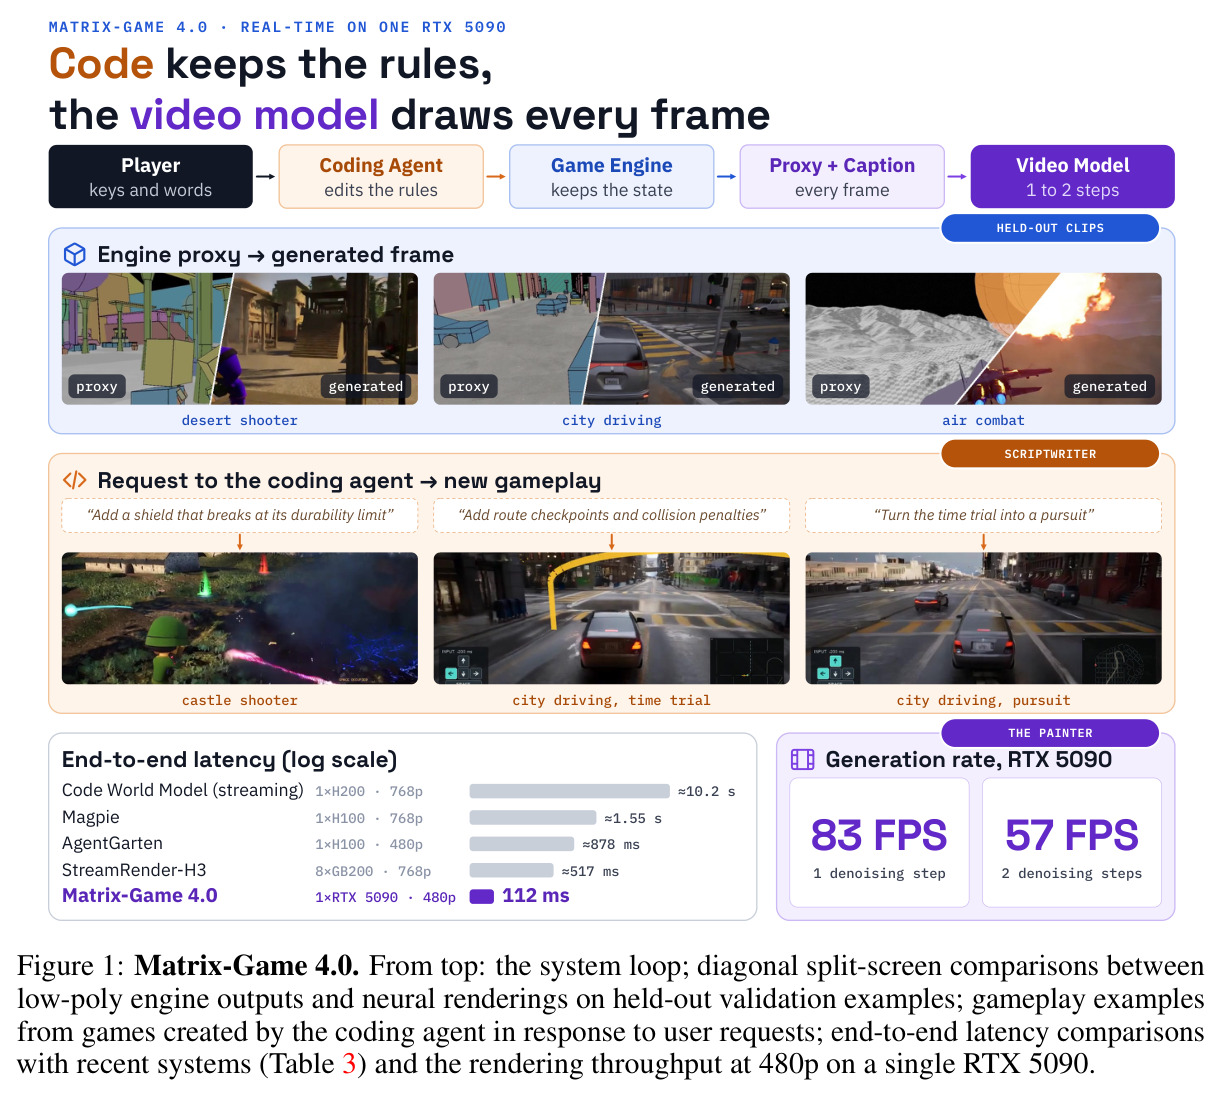
论文首页大图,自上而下四部分:系统实时循环(玩家按键与请求 → 编码代理改规则 → 游戏引擎保状态 → 代理画面加字幕 → 视频模型 1-2 步生成);三组斜切分屏对比(沙漠射击、城市驾驶、空战),左侧为低多边形引擎输出、右侧为神经渲染结果;编码代理按用户请求(加护盾、加检查点、改追捕模式)生成的新玩法截图;以及与近期系统的端到端延迟对数轴对比和 RTX 5090 上 1/2 步去噪的 83/57 FPS 吞吐图。
一图总览全文:既给出「代码定规则、模型画帧」的核心循环,又用分屏对比直观展示渲染质量,还亮出 112 ms 延迟与 83 FPS 这些最关键数字,是快速判断论文价值的入口。