Zing-0.5:迈向具备实时联合动作与文本控制的可玩游戏世界 Zing-0.5: Toward Playable Worlds with Real-Time Joint Action and Text Control
5B自回归世界模型,键盘导航与文本指令联合实时控制,480p 24FPS,每分钟约0.009美元
前置知识
自回归世界模型(Autoregressive World Model)
根据用户动作逐块预测画面演化的生成模型:不一次性生成整段视频,而是以已有视觉历史为条件,按时间块(本文每块 4 个潜帧)不断向外延展画面,用户输入(按键、指令)在每个块边界生效。用户可以「探索—干预—观察反馈—再行动」,代表作有 GameNGen、Matrix-Game、LingBot-World 等。
Zing-0.5 就是此类模型,理解逐块生成机制才能看懂其教师/学生的时间划分设计与 KV 缓存策略。
流匹配(Flow Matching)
扩散类生成模型的训练目标:构造带噪样本 $x_\sigma=(1-\sigma)x_0+\sigma\epsilon$,训练网络 $v_\theta$ 预测速度场,据此恢复干净潜变量 $\hat{x}_0=x_\sigma-\sigma v_\theta$,再从噪声积分回数据。相比 DDPM 的弯曲路径,流匹配路径更直,便于做少步采样与蒸馏。底座 Wan2.2-TI2V-5B 即用此目标。
论文公式 (1) 与全部四个训练/蒸馏阶段都建立在这个目标上,是读懂方法部分数学描述的基础。
分布匹配蒸馏(DMD)
把多步扩散模型压缩到少步(本文 4 步/块)的技术:用冻结的真实教师估计目标分布得分,用可学习的「伪评分器」估计学生输出分布得分,两者之差构成代理梯度方向 $g_{\text{DM}}$,推动学生生成分布逼近教师分布。配合 Self Forcing 式的自身 rollout 训练,学生能在自己生成的历史上继续学习,弥合训练与推理的分布漂移。
这是 Zing 第四阶段训练的核心,也是实现 24 FPS 实时推理的关键;读懂它才能理解教师如何跨生成块监督学生。
因果注意力与 KV 缓存
因果注意力指每个时间块只能看到过去、不能看到未来,是流式生成的正确性保证;KV 缓存把已计算的 Key/Value 存下来避免重复计算,是增量式生成的效率来源。缓存若无界会随交互时长线性膨胀,常见做法是「固定前缀 sink + 滑动窗口」把内存压到常数上界。
论文在提示词切换时只更新文本 K/V、保留视觉 K/V,并设计 sink+滑动窗口+pin 的缓存管理,这些细节全部依赖此概念。
研究动机
现有交互式世界模型分裂为两类互不相通的控制范式:一类做键盘/相机导航(GameNGen、Matrix-Game、LingBot-World、ABot-World-0),用户只能移动和转视角,无法表达「让角色欢呼」「让树放出火花」这类事件意图;另一类做语言条件生成(GameGen-X、GameCraft-2),能改场景却难以和连续导航叠在同一条会话里。更深层的结构性矛盾有两个:其一,依赖相机位姿做条件的方案要靠位姿重建模型,误差会在长时程 rollout 中复利放大,而且文本提示切换可能引起视角变化,由键盘换算出的位姿轨迹无法覆盖这种变化,长会话下视觉连贯性可能崩坏;其二,「事件学习」与「增量生成」的时间尺度不匹配——一个文本事件常横跨多个生成块,而实时交互要求模型以短块滚动生成并及时接收新输入,块级模型去噪事件前段时看不到后段,监督天然残缺。此外实时交互必须便宜,多数系统难以在消费级 GPU 上以 24 FPS 供电 480p 视频流。
本文的目标是本文要构建 5B 参数的自回归世界模型 Zing-0.5,让用户在同一条持续生成流里既能用带连续力度的键盘(W/A/S/D 移动、I/J/K/L 视角)导航、又能用在线文本指令干预事件与角色行为,并在观察世界反馈后继续行动。量化目标包括:在 WBench Navigation 的 158 个图像条件用例上取得有竞争力的总分与一致性(最终总分 81.0、一致性 88.5);文本事件切换无需重启生成、完整保留已有视觉上下文;在单张 RTX 5090 上支撑 832×480、客户端可见 24 FPS 的实时交互,服务器租金成本约 0.009 美元/流分钟。同时发布模型权重、推理代码与 Zing-SGLang 服务实现,支撑社区后续研究。
与已有工作不同的是,本文的独特切入角度有三点。第一,把「力度感知的键盘输入」与「时间对齐的多段文本」统一进同一条序列做联合条件:动作特征按潜帧对齐直接加到视觉 token 上,文本提示按区间经交叉注意力生效,两者可在生成过程中独立变化——不同于以往「导航配一个固定全局提示」或把导航与文本生成做成两种独立模式的做法。第二,显式指出并解决教师-学生时间划分不一致问题:用段级教师(对整个提示区间双向注意力联合去噪、区间之间因果衔接)去蒸馏块级因果学生(每次 4 个潜帧),让事件尺度的监督跨越学生的多个生成块。第三,绕开相机位姿这一中间表示,直接以 8 通道带连续力度的键盘输入做条件,既避免位姿重建误差在长时程复利,也避免提示切换引起的视角变化与位姿轨迹脱节,同时让训练与推理的控制表征完全一致。
核心方法
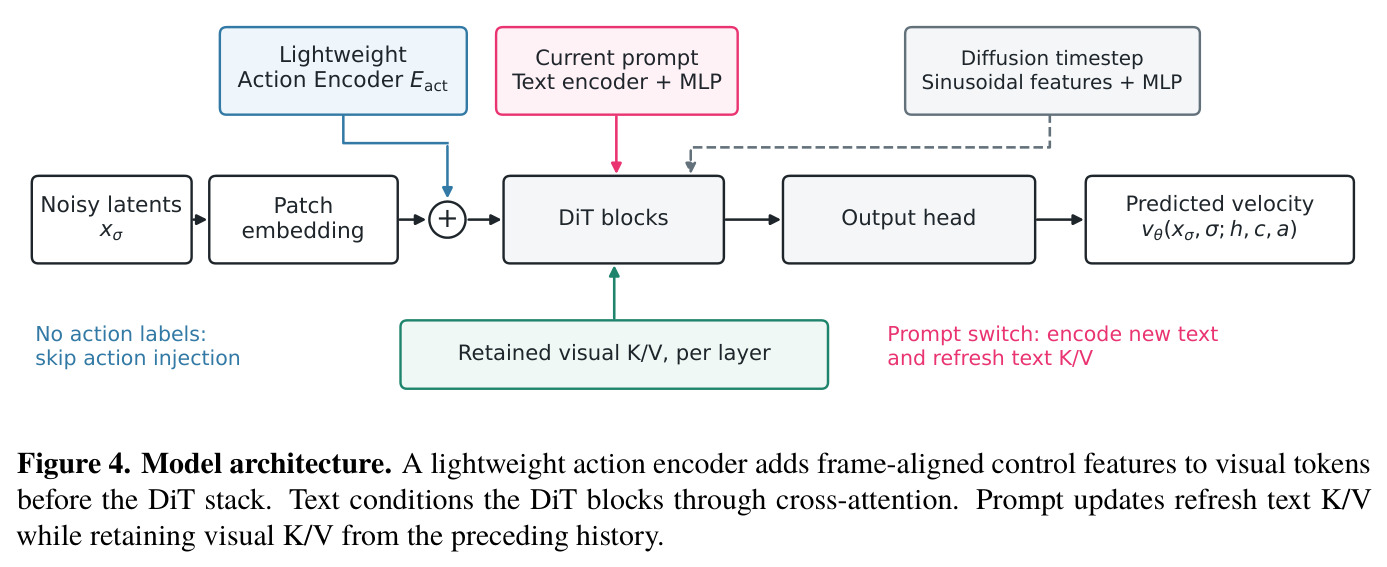
直觉上,Zing-0.5 像一个「边开车边听导航」的司机:方向盘和油门(带力度的键盘)实时控制行进,副驾的语音指令(文本)在任意时刻插入并改变目的地,二者互不干扰地作用于同一段旅程。技术上,它以 Wan2.2-TI2V-5B 为底座(保留其视频自编码器与扩散 Transformer),在流匹配目标 $x_\sigma=(1-\sigma)x_0+\sigma\epsilon$ 下训练。架构上新增一个仅 3.68M 参数(约为主干 5B 的 0.074%)的轻量动作编码器 $E_{\text{act}}$:把窗口平均后的动作向量 $\bar{a}_j=\frac{1}{|\mathcal{W}_j|}\sum_{t\in\mathcal{W}_j}a_t$ 经正弦力度嵌入、残差 MLP 与因果时间卷积编码为 $e_j$,加到对应潜帧的视觉 token 上;文本条件改为分段交叉注意力。训练分四阶段递进:双向适配引入动作条件、自回归适配分别训练段级教师与块级生成器、ODE 初始化加局部一致性蒸馏、最后用 DMD 在学生自身 rollout 上蒸馏,最终学生每块只需 4 步去噪。
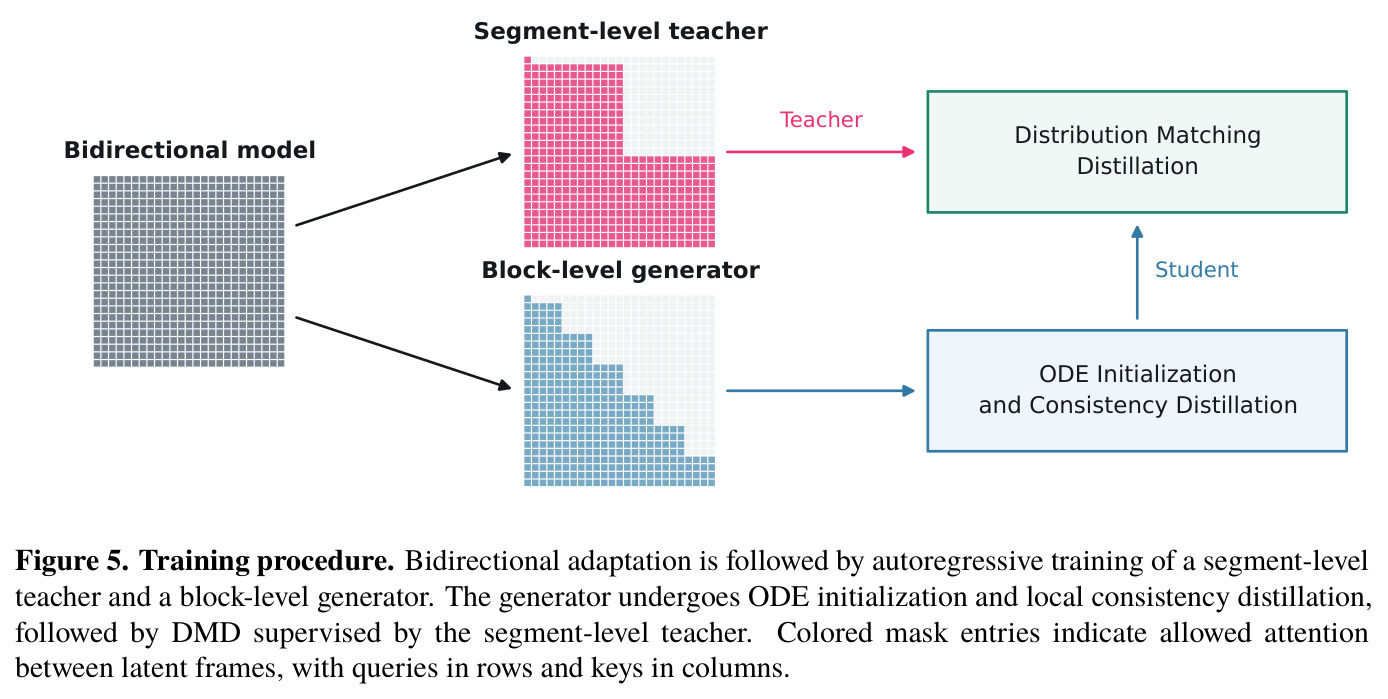
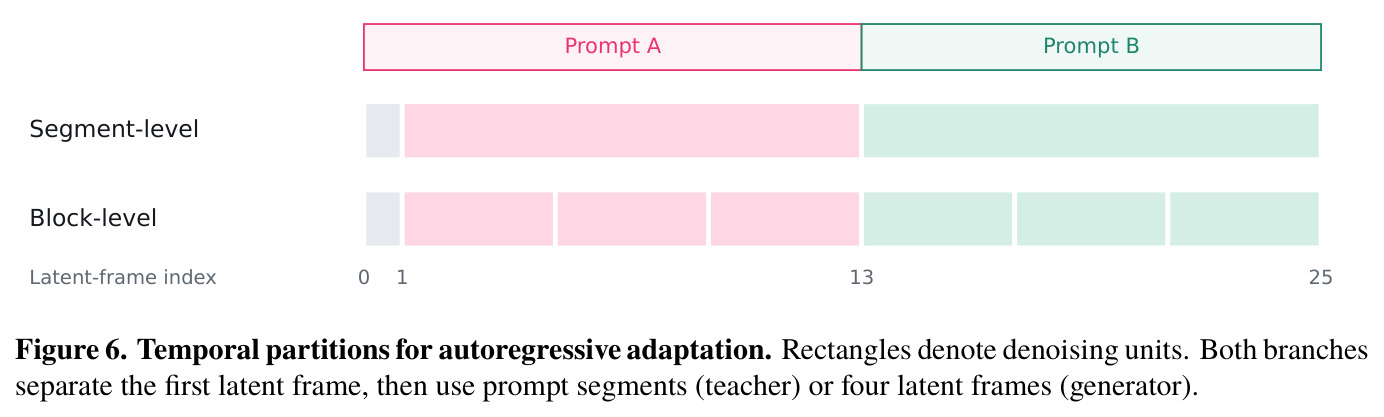
核心创新是「事件尺度监督」与「增量生成」的桥接。文本事件往往持续多个生成块,但块级模型去噪第 i 块时看不到后续块,同一事件的前后块缺乏联合监督。Zing 的解法是训练两个时间划分不同的分支:段级教师对整个提示区间做双向联合去噪、区间之间因果衔接,从而学会「跨提示变化的续写」;块级学生每次只生成 4 个潜帧、严格因果,满足在线交互的低延迟。随后用分布匹配蒸馏把教师的事件级分布知识迁移给学生,且学生在自己生成的历史上训练(rollout-and-replay 两遍法:先无梯度 rollout 并缓存去噪出口状态,再打包回放计算梯度),弥合「干净训练历史→自身生成历史」的分布漂移。另一个关键设计是提示切换时只刷新文本 K/V 缓存、完整保留视觉 K/V 缓存,并用固定前缀 sink、滑动窗口、切换后首帧 pin 三者共享固定容量的策略保证缓存有界——这让事件切换「不打断世界」,与 LongLive 按新提示重算历史视觉特征的 KV-recache 形成鲜明对比。
方法步骤详情
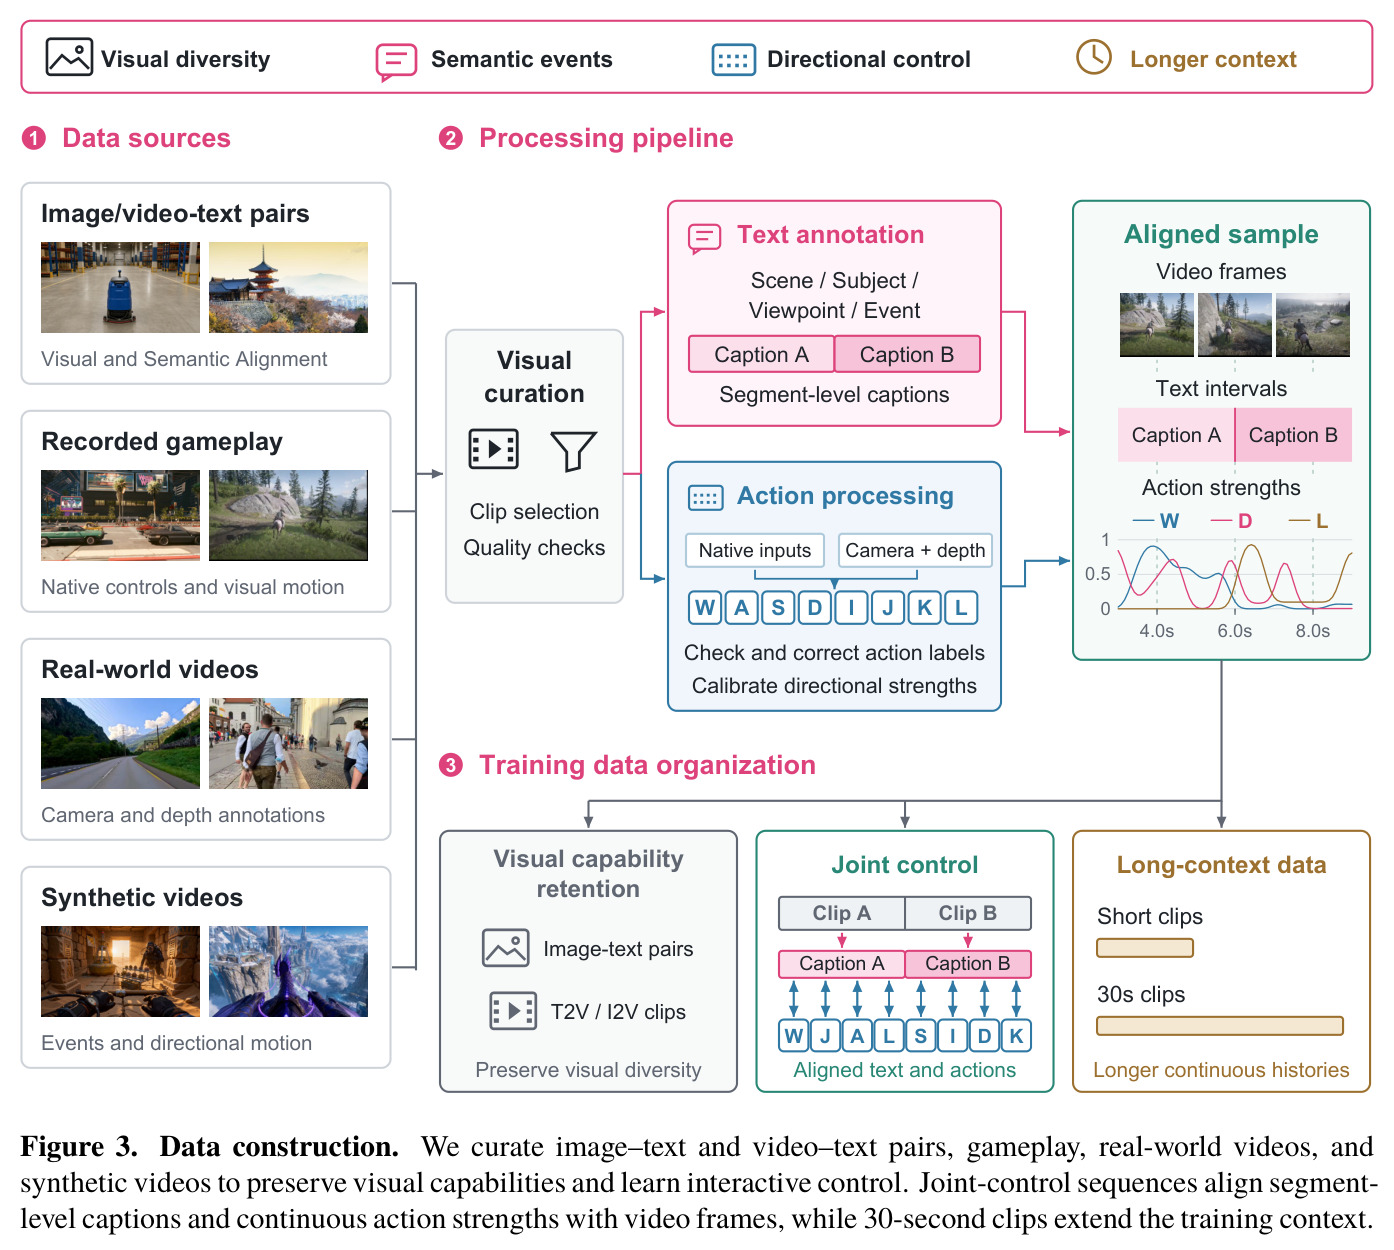
第一步(双向适配):在 Wan2.2-TI2V-5B 上加入动作分支,混合带动作标注视频与无动作 T2I/T2V/I2V 样本防遗忘,先用短序列再用 30 秒长视频扩上下文。第二步(自回归适配):从同一双向模型分出两支——段级教师以「区间内双向、区间间因果」在多提示视频上训练;块级生成器按 1+4n 潜帧布局训练,首帧单独建模(T2V 拆成 T2I+I2V),并做历史增强(混合干净/带噪/模糊历史及均值重缩放扰动),两支都用 30 秒视频扩长。第三步(ODE 初始化与一致性蒸馏):用冻结教师 ODE 轨迹端点监督学生端点预测 $\mathcal{L}_{\text{ODE}}=\mathbb{E}\|F_\theta(x^T_{\sigma_i},\sigma_i;h,c,a)-x_0^T\|^2_{\mathcal{M}}$(教师带 CFG);再用 EMA 学生做局部一致性目标并线性加权。第四步(DMD):学生先无梯度 rollout 并缓存状态,打包经冻结真实评分器与伪评分器得 $g_{\text{DM}}$ 与 $g_{\text{CA}}$,打包回放施加代理梯度,按批次概率混入 DFD 样本。推理每块 4 步生成 4 潜帧(解码 16 帧)。
技术新颖性
与已有工作的具体区别:相对 GameCraft/WorldPlay 等把键盘换算成相机位姿增量的方案,Zing 直接以力度感知键盘为条件,训练与推理表征一致,规避了位姿重建误差复利与提示切换导致的视角脱节;相对 LongLive 的 KV-recache(按新提示重算历史视觉特征),Zing 只更新文本 K/V、保留视觉 K/V 并 pin 切换后首帧,成本更低、上下文更稳;相对 CausVid 的双向教师 ODE 初始化,Zing 的初始化教师是因果的,规避了 Causal Forcing 研究过的「教师看了学生看不到的未来」的失配;相对 Decoupled DMD/DFD 的原始用法(DFD 作为 DMD 稳定后的后训练阶段),Zing 在 DMD 全程按概率混入 DFD 样本,作者报告这抑制了运动幅度波动与严重视觉退化;Self Gradient Forcing 的两遍 rollout-replay 被改造成支持变长样本数据打包以降低峰值显存。教师(段级)与学生(块级)时间划分不同这一点,也是 ABot-World-0 的 LongForcing 之外少见的显式设计。
实验结果
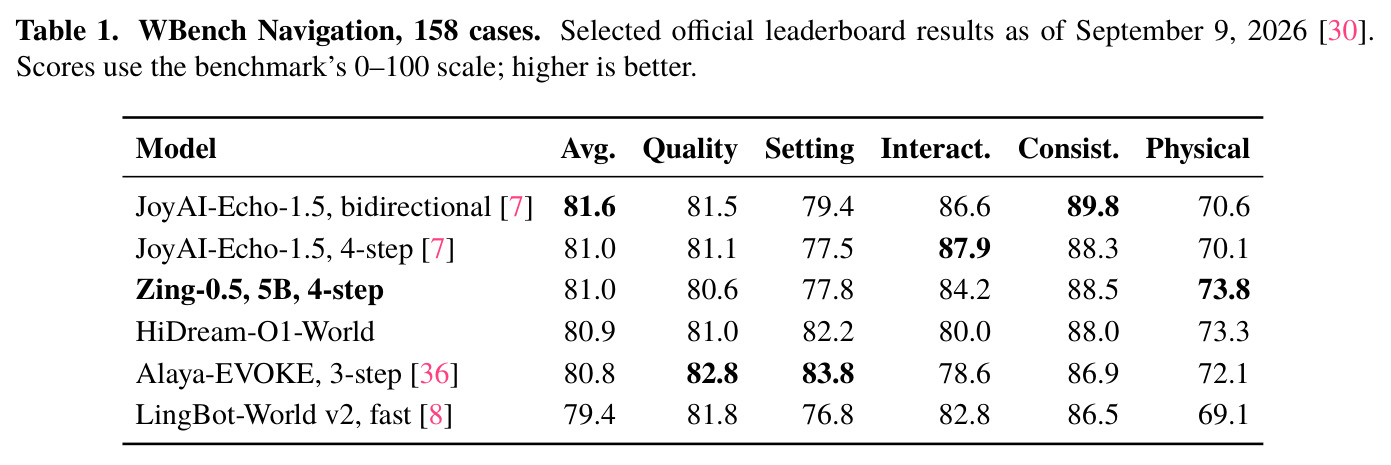
定量上,Zing-0.5 在 WBench Navigation 的 158 个图像条件用例上(1248×704 分辨率生成、每块 4 步去噪、24 FPS 保存)取得总分 81.0、质量 80.6、场景 77.8、交互 84.2、一致性 88.5、物理合理性 73.8。对照官方榜单:总分追平 JoyAI-Echo-1.5 的 4 步版(81.0),仅低于其双向版(81.6),高于 HiDream-O1-World(80.9)、Alaya-EVOKE 3 步版(80.8)与 LingBot-World v2 fast(79.4);一致性 88.5 位列第二;物理合理性 73.8 是表中最高,说明蒸馏未牺牲运动可信度。系统层面:8 卡 RTX 5090 服务器每卡独立承载一条 832×480 流,客户端可见 24 FPS(不限速稳态 24.63 FPS),估算成本约 0.009 美元/流分钟。定性结果覆盖单会话内雪橇联合控制(「欢呼」「开伞」)、火树金光、融化糖果屋、穿镜入园、城市彩虹、战场火雨、月光升空、坐骑喷火等演示,证明文本事件可在持续导航中实时生效。
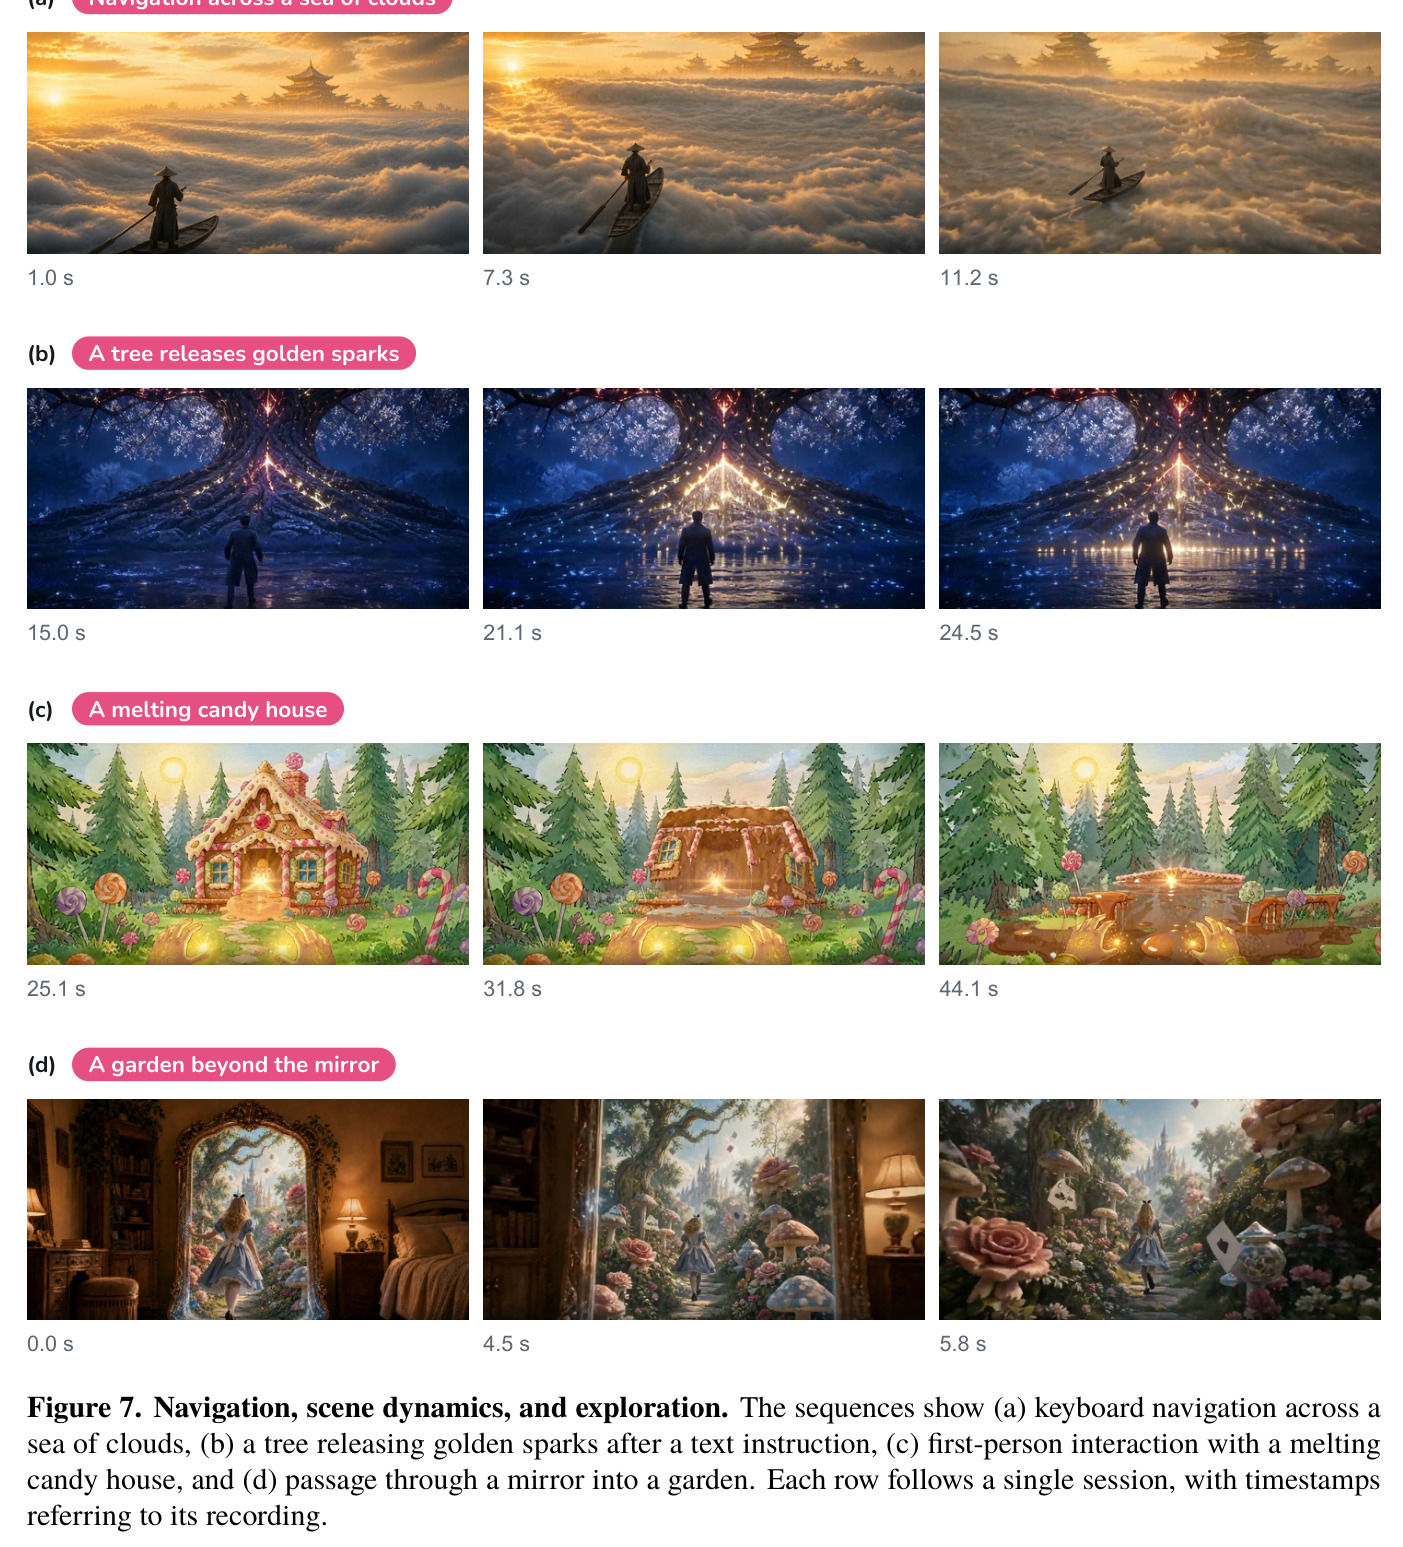
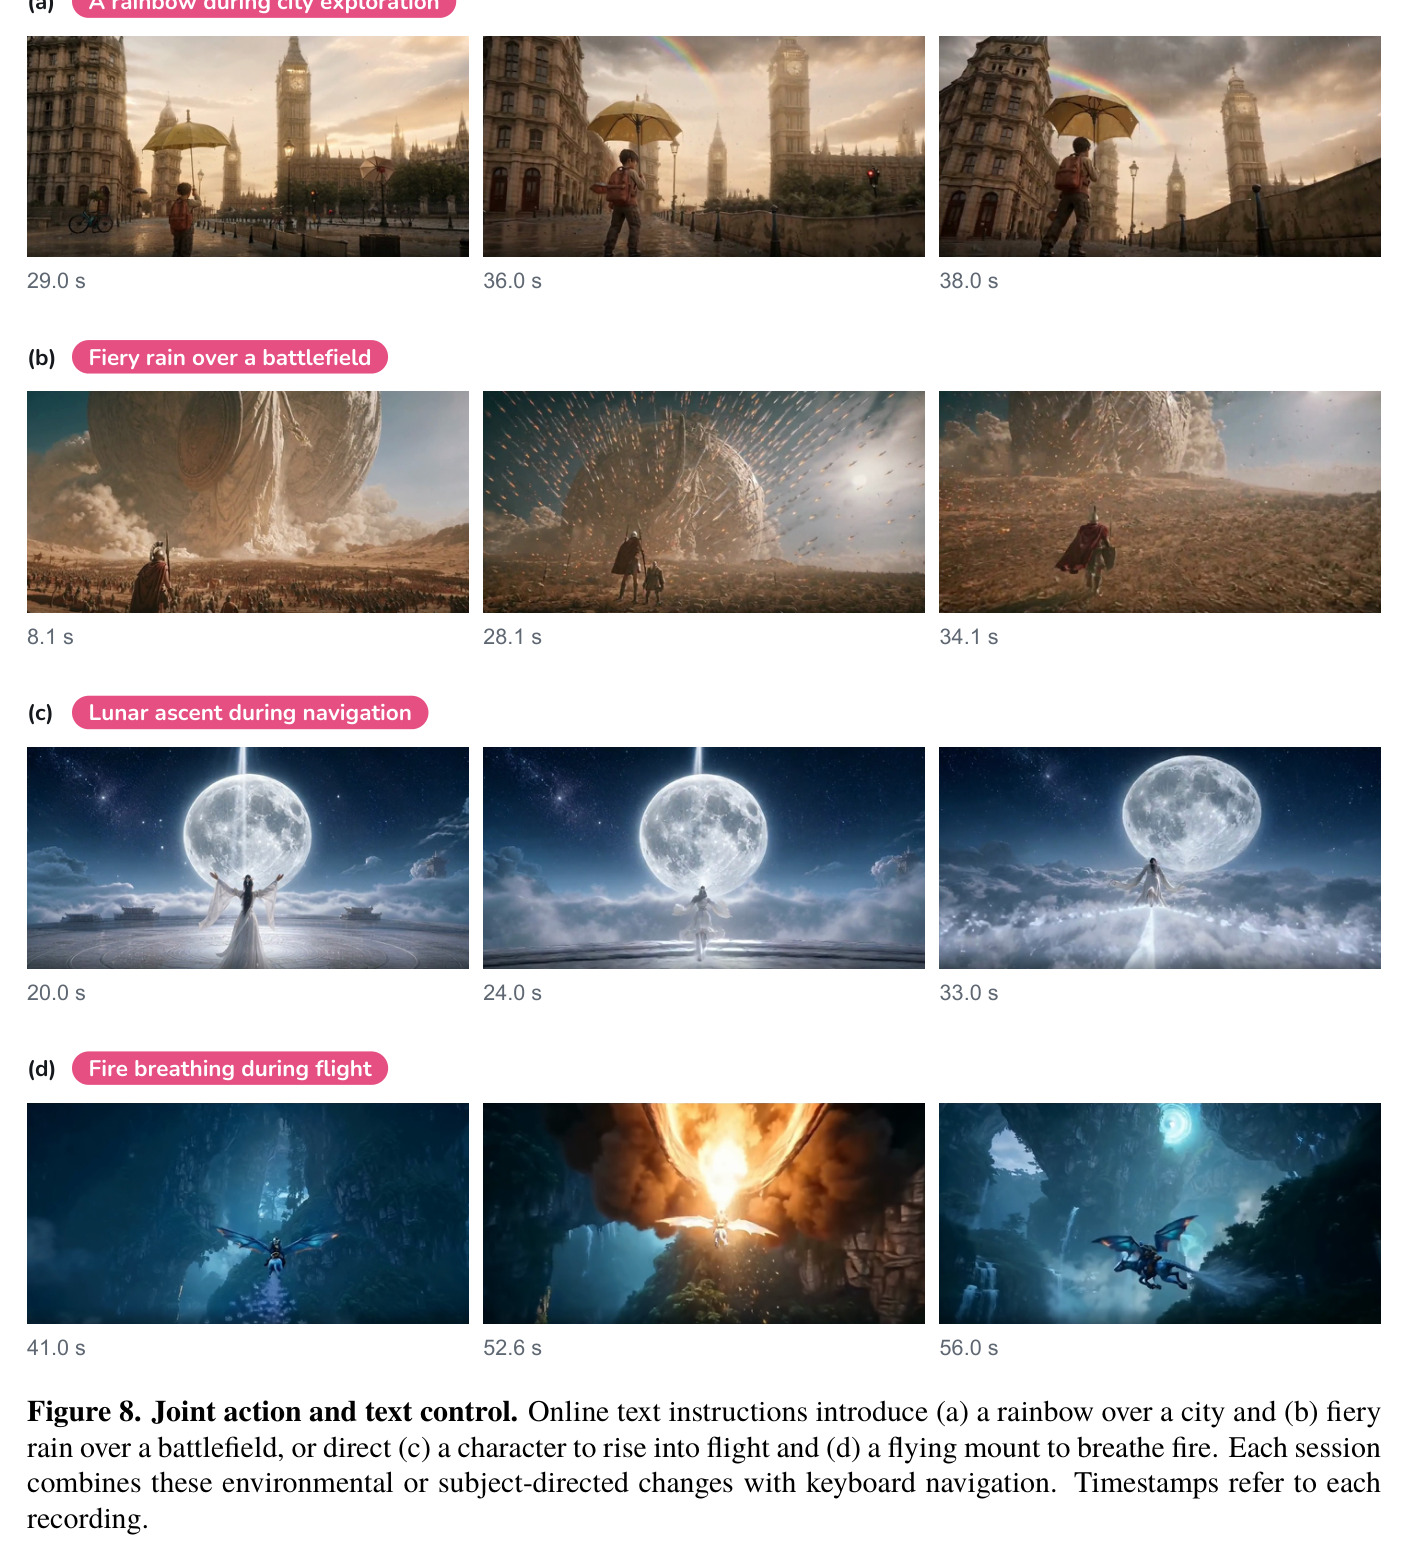
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WBench Navigation(158 例)综合评价 | Avg(0-100,越高越好) | 81.0 | JoyAI-Echo-1.5 双向版 81.6;JoyAI-Echo-1.5 4步版 81.0 | 追平 4 步版,距榜单第一仅差 0.6 |
| 一致性 Consistency | 0-100 | 88.5 | JoyAI-Echo-1.5 双向版 89.8 | 榜单第二,少步模型中最高档 |
| 物理合理性 Physical | 0-100 | 73.8 | 次优 HiDream-O1-World 73.3、JoyAI-Echo-1.5 双向版 70.6 | 表中第一(+0.5) |
| 实时交互成本 | 美元/流分钟 | 约 0.009(832×480@24FPS,单张 RTX 5090 一条流) | 论文未提供可比系统的直接成本数据 | 以低成本实时为卖点,8 卡服务器同时服务 8 条独立流 |
局限与改进
作者坦承的最大局限是「视觉历史不完全等于世界状态」:模型不显式跟踪实体状态、不强制状态转移规则,物体移出画面后其存在与位置只能隐式残留在有界 KV 缓存里,交互的后果(如被挪开的物体、已生效的规则)未必在用户回头时仍然成立;长序列训练与历史扰动只是缓解续写不稳定,并未提供持久性机制。其次,联合控制的证据主要是定性演示:WBench 只评导航条件生成,文本事件控制的成功率、响应延迟、切换后一致性均无量化指标。训练层面,作者观察到 DFD 与 DMD 联合训练在长训后出现高频噪声伪影与色彩饱和度下降。我自己的观察:480p/24FPS 的保真度对精细纹理有限;动作力度是跨源校准的「相对强度」而非物理位移,跨域泛化存疑;sink+滑动窗口在超长会话中可能丢失早期远距离依赖;评测分辨率 1248×704 与部署分辨率 832×480 不一致,榜单分数不能直接代表实盘体验。
独立分析的弱点
弱点一:缺乏持久世界状态——玩家把物体推开后走出画面再回来,其位置可能已被丢弃的 KV 条目「遗忘」,交互后果不可靠。改进方向:在潜变量旁挂显式场景图或实体状态表,用检索/写回机制在生成时注入。弱点二:文本控制完全未量化——没有事件成功率、指令响应延迟、切换后画面漂移等指标,实用价值难以横向比较。改进:构建含在线指令轴的交互基准。弱点三:4 步蒸馏的画质代价——作者自述出现高频噪声与饱和度下降,且部署分辨率 832×480 偏低。改进:加入对抗微调或轻量超分后处理。弱点四:动作力度语义是相对强度,「力度 0.5」在不同来源(原生键盘、相机+深度换算、合成数据)含义不同,标定误差直接变成控制误差。改进:用光流或深度回归出的物理量做统一锚定。弱点五:每流独占一张 GPU 的架构在多用户并发与弹性伸缩上的成本模型未讨论,闲时利用率可能很低。改进:批处理多流共享 DiT 或引入抢占式调度。
未来方向
作者明确提出的方向是「持久性架构」:未来模型应把状态与规则的跨视角、跨指令保持作为设计目标,评估标准应是「用户能否改变某物、离开、再回来时后果仍然成立」,而非只看画面质量;更大容量与更长上下文只有服务于交互可靠性才有价值。基于本文成果可延伸的方向包括:把段级教师/块级学生的划分思想推广到更长的事件层级乃至多事件叙事;在 DMD rollout 中引入用户在环反馈做在线强化学习;用 3D 一致性或深度先验进一步提升物理合理性(虽已 73.8 居首,仍有天花板);研究文本事件与动作指令冲突时的优先级学习(如「前进」与「停下让糖果屋熔化」同时下达);以及把 TAEHV 解码与 fMP4 有界环形队列的流式管线推广到更高分辨率和帧率,服务更广的实时场景。
复现评估
开源情况较好:模型权重(HuggingFace seedleap/zing-0.5)、推理代码与 Zing-SGLang 服务实现均已发布,推理侧复现门槛低——一条流只需一张 RTX 5090 常驻 DiT、有界 KV 缓存与 TAEHV 解码器,按论文配置可跑 832×480@24FPS,初始图像编码才需要原生 VAE。训练侧难度高:数据包含内部采集玩法录像与合成视频(未完整开源,公开玩法数据引自 ABot-World-0,真实视频带相机+深度标注),四阶段训练涉及变长样本打包、FlashAttention/FlexAttention 块掩码、Ulysses 序列并行、FSDP 分片与激活检查点,还需在线生成并缓存教师 ODE 轨迹,属于机构级工程量。对个人开发者的务实路径是:直接用官方权重做推理与轻量二次微调——动作分支仅 3.68M 参数、投影零初始化,微调成本远低于复训 5B 主干。
论文图表
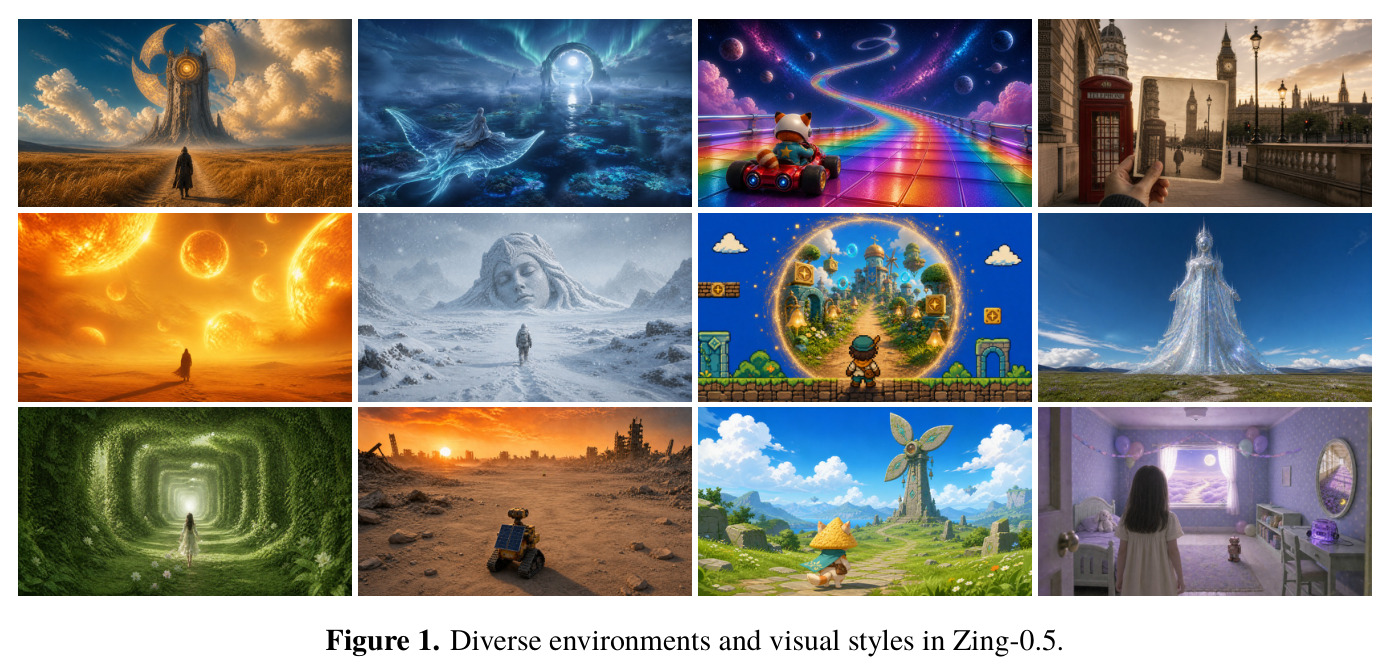
网格化展示 Zing-0.5 能生成的多样环境与视觉风格,覆盖不同题材、光照与美术风格的场景画面。
直观建立对模型生成覆盖面的第一印象,说明这个世界模型「能玩出多少种世界」。
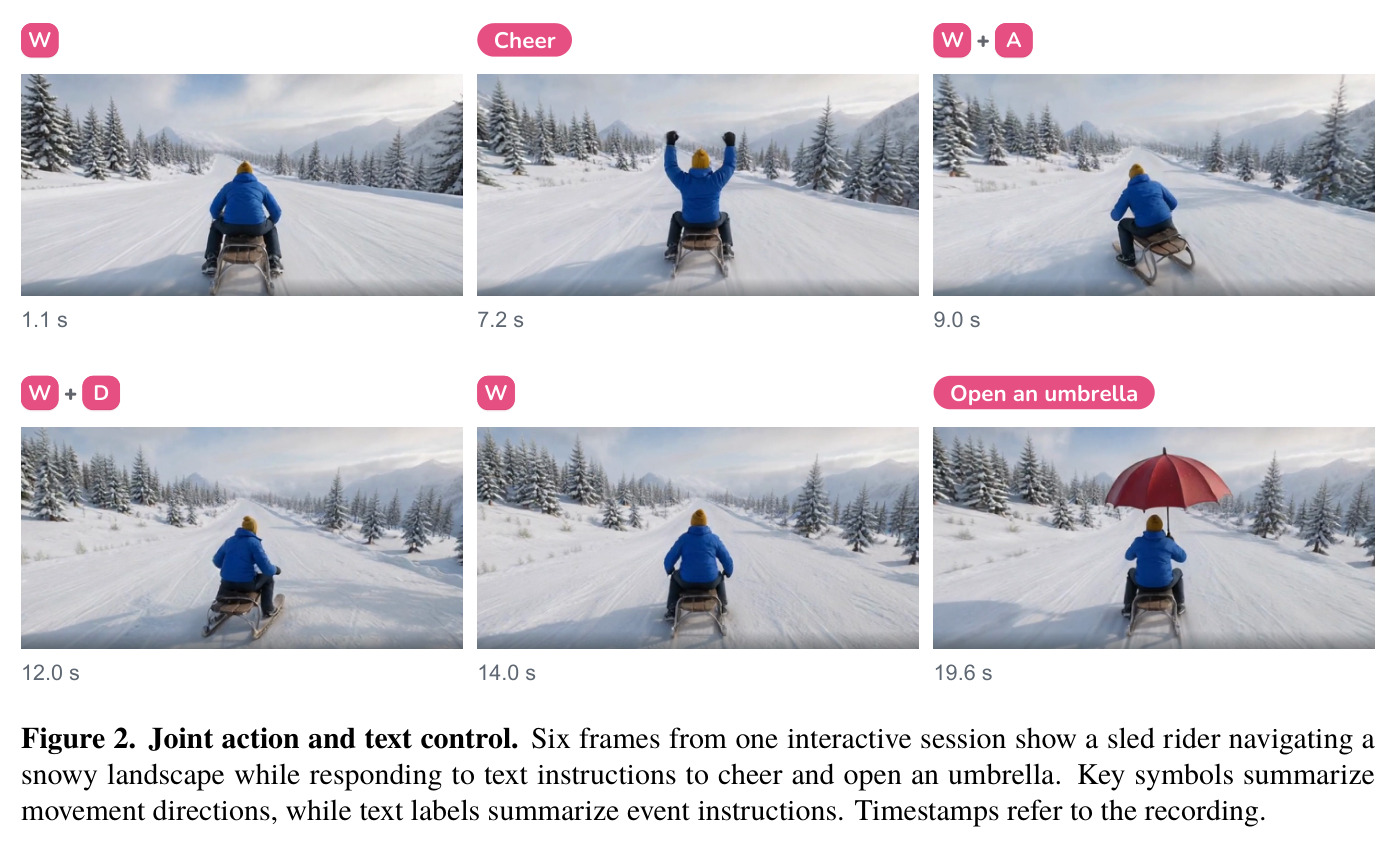
单次交互会话的六帧:用户以 W/A/D 等键驾驶雪橇穿越雪原,期间文本指令让骑手「欢呼」「打开雨伞」,时间戳从 1.1s 到 19.6s,全程不重启生成。
这是论文核心卖点「联合控制」的标志性证据,正文与结论反复引用该会话。