迷失于恢复:经由目标导向动作重放揭示计算机使用智能体的恢复行为 Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
提出RETRACE框架首次系统量化CUA模型级恢复能力:恢复是解锁任务潜力的关键杠杆
前置知识
计算机使用智能体(Computer-Use Agent, CUA)
通过键盘鼠标级细粒度操作(如 pyautogui 的 click、type、scroll、hotkey)在真实操作系统或 GUI 环境中完成用户任务的(大)视觉语言模型智能体。它以截图等视觉观测为输入,结合观测-动作历史逐步输出动作直至任务完成,代表系统包括 Claude Sonnet、GPT 的计算机使用变体以及 UI-TARS、EvoCUA 等开源模型。
本文的研究对象就是 CUA 在出错后能否自主恢复环境,理解其动作空间与长程执行的脆弱性是读懂全文的前提。
部分可观测马尔可夫决策过程(POMDP)
序贯决策的标准形式化框架,记作 $\mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{O},\mathcal{E},T,\Omega)$:智能体只能通过观测函数 $o_t=\Omega(s_t)$ 看到真实状态 $s_t$ 的可见部分 $o_t$,而隐藏分量 $h_t$(如后台配置文件内容)不可见,策略 $π_\theta$ 只能基于观测-动作历史 $\pi_\theta(a_t|o_0,a_0,\ldots,o_t)$ 决策。
恢复判定之所以困难,正是因为环境隐藏状态无法从截图推断,这一不可观测性直接催生了本文的转移一致性准则。
预测状态表示(Predictive State Representations, PSR)
强化学习理论中用「未来」表示状态的思想:两个状态等价,当且仅当从它们出发执行相同动作序列会得到相同的未来观测结果,而不要求内部表征或像素完全一致。它把状态等价性从「长得像」转化为「行为上等价」。
本文的核心形式化——转移一致恢复(Transition-Consistent Recovery)正是借用 PSR 的行为等价思想来定义「恢复成功」。
动作重放(Action Replay)与环境重置
在可重置环境中,把记录下来的动作序列从某个已知状态重新执行一遍以复现历史状态,称为动作重放;环境重置则是把整个环境恢复到初始状态。重放的开销随轨迹长度线性增长,且生产环境的专有网站、操作系统往往根本不提供重置能力。
RETRACE 用受控动作重放来构造确定性转移并评测恢复质量,而本文动机正是论证纯重放/重置方案在真实场景中不可行。
SSIM(结构相似性)
衡量两幅图像在亮度、对比度与结构上相似程度的经典指标,取值 0 到 1,越接近 1 越相似,常用于检测截图级别的视觉差异。本文以 SSIM≥0.99 作为观测级恢复判据 $R_O$ 的阈值,并实验验证了阈值取松(0.95、0.91)会显著增加与人类判断的分歧。
RETRACE 的恢复 oracle 由 $R=R_{TC}\wedge R_O$ 组成,理解 SSIM 阈值的作用才能理解其评测的严格性与争议点。
研究动机
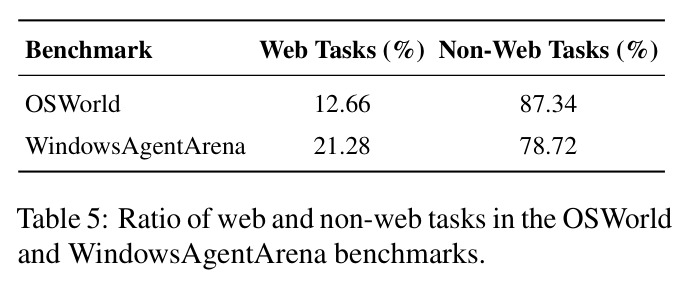
计算机使用智能体在长程复杂任务中非常脆弱:早期错误会沿轨迹累积并向下传播,且已执行的动作会留下不该发生的副作用——例如智能体整理目录时虽然完成了任务,却静默覆盖了用户想保留的文件。出错后把环境回退到先前完好状态的能力因此变得关键,但现有三种补救手段都不堪用:(1)Reflection 类方法从错误状态继续往前走,副作用持续累积;(2)完整环境重置加全量动作重放在专有环境(生产网站、商业操作系统)中不可行,且代价随轨迹长度增长;(3)API 级回滚(如 Playwright 的 go-back、浏览器后退)只在 web 环境有效。而实测数据表明 OSWorld 中 87.34%、WindowsAgentArena 中 78.72% 的任务是非 web 任务(Table 5),这些 API 完全无用武之地。于是「模型级自主恢复」——由智能体自己恢复到先前状态而不依赖任何环境特设机制——成为必需能力,但此前从未被系统研究过。
本文的目标是本文要构建一个可扩展的评测框架 RETRACE,把「成功恢复」形式化为可检验的准则,并在 OSWorld 与 WindowsAgentArena 两个桌面基准、五个主流模型上首次系统回答三个研究问题:RQ1——理想恢复能否解锁模型尚未发挥的潜在任务完成能力(对比完全重置);RQ2——现有智能体是否真的具备自主恢复能力,这种能力是「潜在的」还是「彻底缺失的」;RQ3——准确的模型级恢复能否转化为可测量的端到端任务成功提升。最终目标是把「恢复」确立为构建可靠计算机使用智能体的一项基础能力。
与已有工作不同的是,已有工作把回滚当作推理流水线里的启发式组件:树搜索用动作重放做回溯、WebRollback 依赖 Playwright 的 go-back API,没人把这些机制本身作为研究对象系统分析其行为与影响。更关键的是,已有判断「恢复成功」的方式几乎都是截图视觉相似度匹配,这会漏掉隐藏状态差异——比如截图完全不变但一个配置文件已被偷偷修改,视觉判据会错误宣布恢复成功。本文的独特切入是借用预测状态表示理论,用「执行相同后续动作得到相同结果」的行为等价性定义恢复质量,再配合受控错误注入构造每个模型自己的 on-policy 评测集,第一次让「恢复」成为可量化、可跨模型比较的科学对象。
核心方法
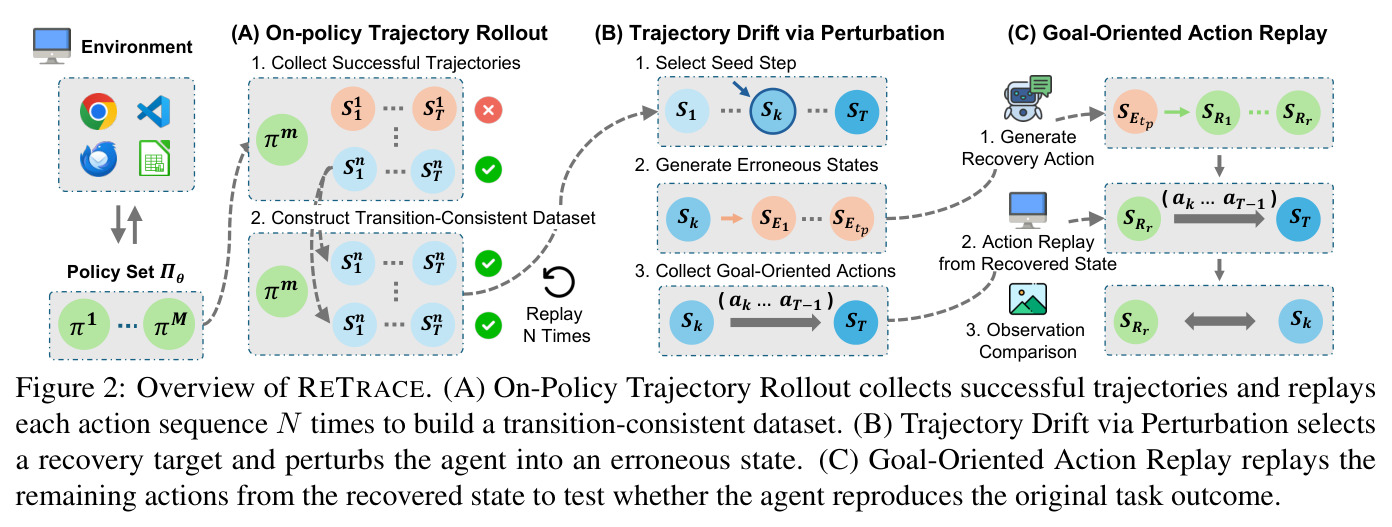
先给直觉:这像验证游戏存档是否完好——不看存档截图像不像,而是读档后把后续关卡照样打一遍,若能复现同样结局就说明存档有效。技术上是三阶段流水线(Figure 2)。第一阶段 On-Policy Trajectory Rollout:让每个被测策略 $\pi_\theta$ 在每个任务上滚动执行,用任务 oracle $\Phi_q$ 筛出成功轨迹,并把每条动作序列原样重放 $N=3$ 次、只保留三次全部成功的轨迹,从而构造出「转移一致」的摊销式确定性转移函数 $\hat{T}$,克服 GUI 环境的随机性。第二阶段 Trajectory Drift via Perturbation:选定轨迹上的种子状态作为恢复目标 $s_{target}$,用同 backbone 的扰动策略故意把轨迹「带偏」至多 $t_p$ 步,得到经 oracle 确认的错误状态 $s_{error}$。第三阶段 Goal-Oriented Action Replay:让恢复策略 $\pi^R_\theta$ 从 $s_{error}$ 出发尝试恢复到 $s_{target}$,然后把原轨迹的剩余动作 $(a_k,\ldots,a_{T-1})$ 从恢复后的状态重放到底,看任务 oracle 是否复现原始成功结果,同时用 SSIM≥0.99 检查观测一致性。
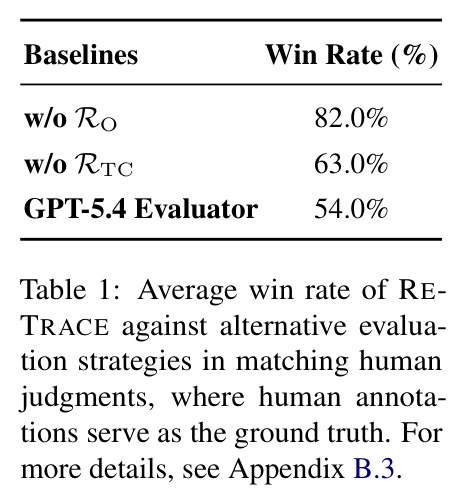
核心创新是转移一致恢复(Transition-Consistent Recovery)准则。形式化地,恢复是把任意状态映射回过去目标状态的函数 $f(s_t)=s_{target}=s_{t-d}$,$d$ 为恢复距离;单步判据为 $R_{TC}=\mathbb{I}[\,T_E(f(s_t),a_{t-d})=s_{t-d+1}\,]$,即从恢复态执行与原轨迹相同的动作能否复现原轨迹的下一状态,多步形式最终用任务 oracle 判定重放整条剩余动作后任务是否成功;同时用观测级判据 $R_O=\mathbb{I}[o=\hat{o}]$(SSIM≥0.99)防止「功能等价但界面走样」,最终取 $R=R_{TC}\wedge R_O$。与已有工作的本质区别在于:已有回滚是依赖环境 API 的工程组件、恢复判定靠像素相似,而本文给出行为学定义加可控评测协议,并证明该判据与人类判断的一致率(82.0%)显著高于纯视觉判据(61.2%)或 GPT-5.4 直接评估(54.0%)。
方法步骤详情
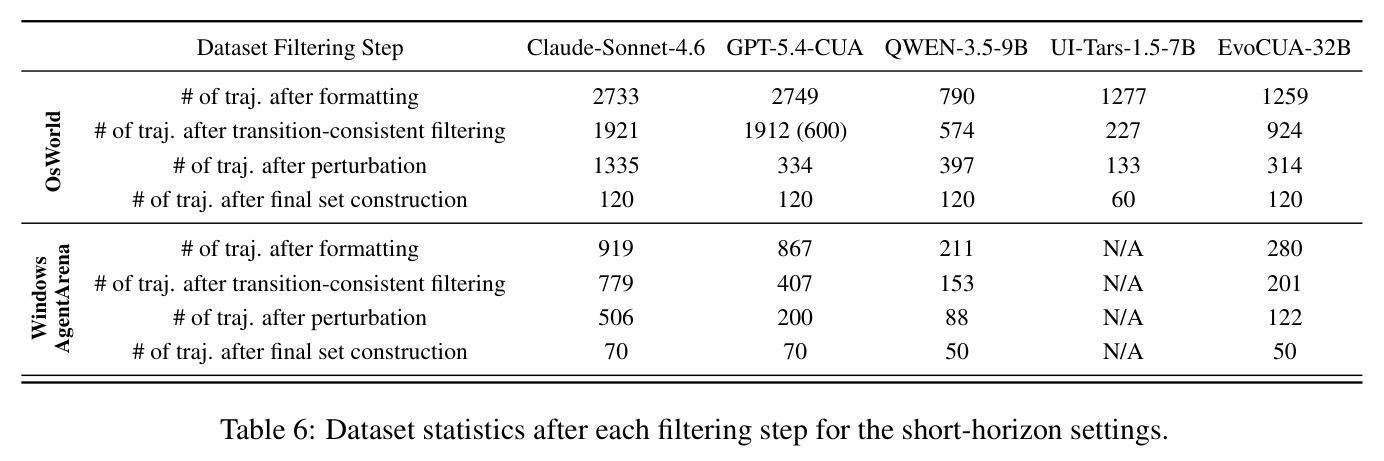
第一步(构造转移一致数据集):每个模型在 OSWorld/WindowsAgentArena 上 rollout,oracle 筛出成功轨迹并采样种子步 $t_{seed}$,随后把动作序列连续重放 $N=3$ 次、只保留三次全部成功的轨迹(保留率 64.4%),得到每模型的 $\mathcal{D}_{TC}$——例如 Claude-Sonnet-4.6 在 OSWorld 从 2733 条格式化轨迹过滤到 1921 条。第二步(受控错误注入):从 $s_{target}=s_{t_{seed}}$ 重放前缀并以 LLM verifier 确认复现保真,再用共享 backbone 的扰动策略走至多 $t_p$ 步(短程 $d=1$,GPT-5.4-CUA 用 2 因其倾向先截图),oracle $\Phi_q$ 把错误末态记为 $s_{error}$,并用 SSIM 剔除与目标过于相似的样本对,最终每模型采样 60–120 条评测样本构成 $\mathcal{D}_R$。第三步(恢复与重放判定):恢复策略从 $s_{error}$ 出发、步数预算 $r\in\{1,3,10\}$ 尝试恢复;随后把剩余动作从恢复态重放,若基准 oracle 判定任务成功且截图 SSIM≥0.99 则记恢复成功。恢复策略分两类:隐式恢复($\pi^R_\theta=\pi_\theta$,不给任何恢复指令,考察自发倾向)与显式恢复(提供上下文 $C$ 的四种变体:w/o History、0~E、0~R、w/ Contextualization,即用 Claude-Sonnet-4.6 把目标状态前的转移史压缩成摘要)。长程设定取 $d=5$。
技术新颖性
技术新颖性有三层。定义层面:首次为「模型级恢复」给出形式化 oracle,把行为转移一致性($R_{TC}$,源自 PSR 理论)与观测匹配($R_O$)结合,优于任一单独判据——在人类标注分歧样本上,联合 oracle 与人类一致率 81.2%,而单独 $R_{TC}$ 只有 38.8%、单独 $R_O$ 为 61.2%。评测层面:用「$N=3$ 次重放全成功才保留」的摊销式确定性转移函数 $\hat{T}$ 解决 GUI 环境随机性,使错误注入可控、可复现、且对每个模型保持 on-policy;配合三阶段流水线可扩展到任意 CUA。实证层面:首次系统回答恢复能力相关问题,并发现反直觉现象——在单向任务完成后训练的专项模型(EvoCUA-32B 恢复率低于 1%)反而比泛化模型更不会恢复,说明大规模离线轨迹后训练可能抑制了固有的恢复能力。与 WebRollback(依赖 Playwright)、树搜索动作重放(Koh et al.)的本质区别是:那些方法依赖环境提供回滚 API 或把重放当搜索算子,本文完全由模型自身完成恢复并给出严格判据。
实验结果
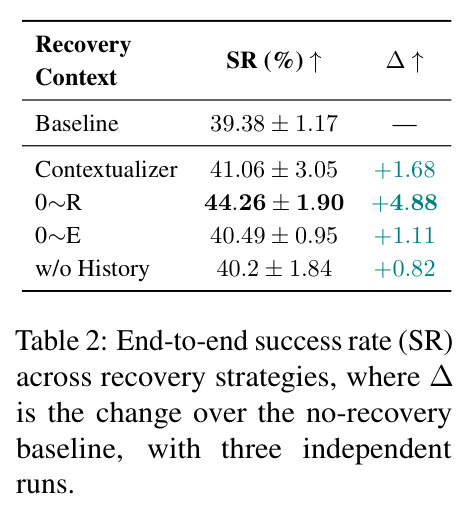
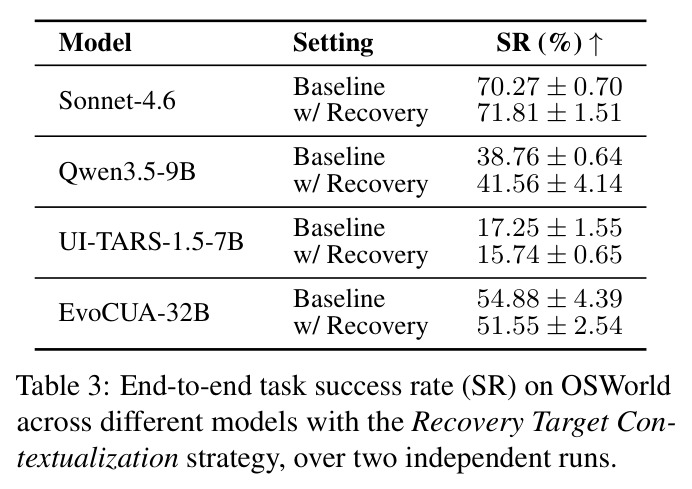
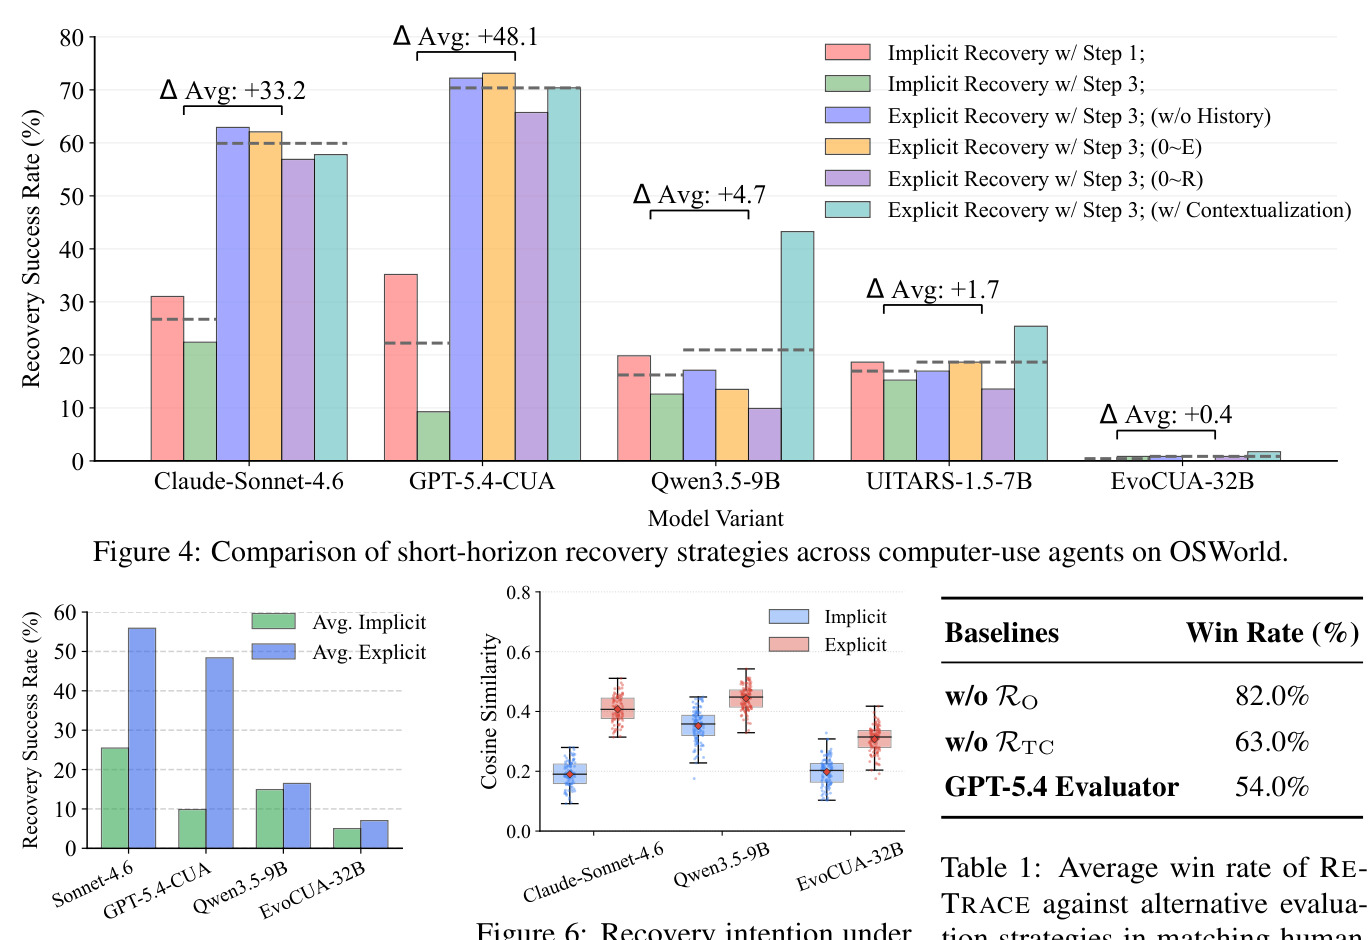
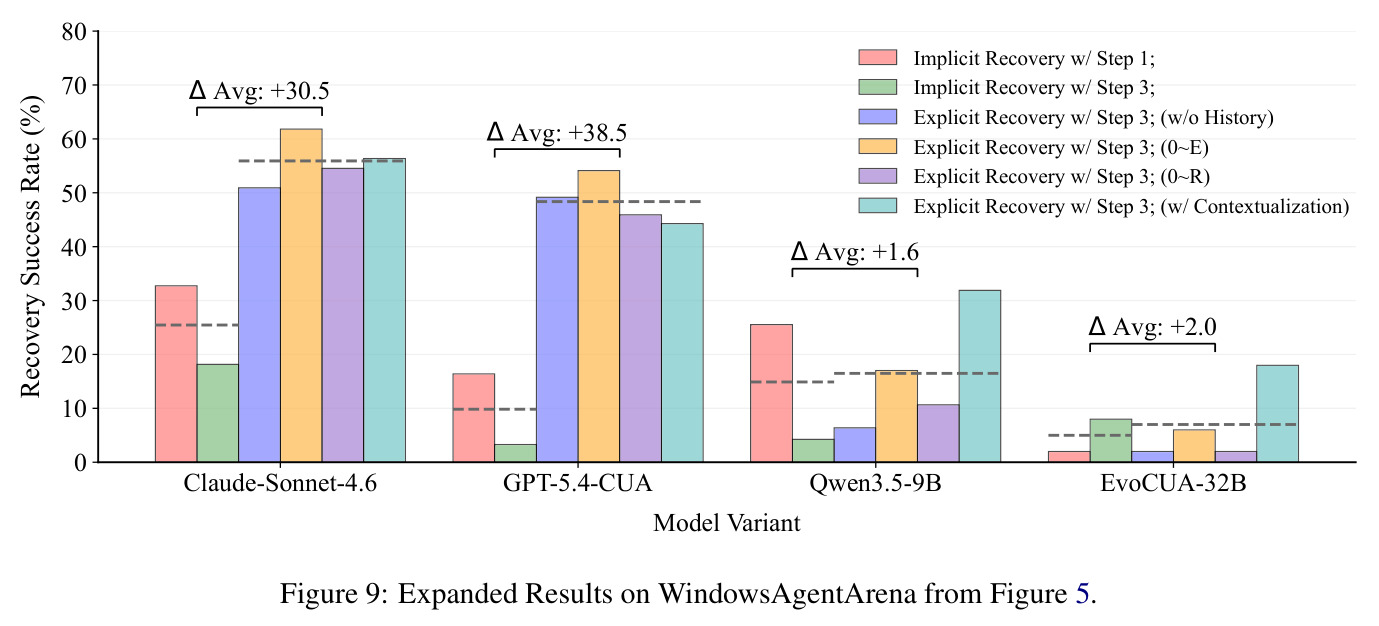
论文以六个 Finding 组织实验。Finding 1(理想恢复解锁潜力,Figure 3):以 EvoCUA-32B 为前向策略、在 OSWorld 83 条失败轨迹上测 Success@K($K=1,\ldots,5$),所有非零恢复步($R=E-1$、$R=E\text{-random}$、$R=R_{LLM}$)都优于完全重置 $R=0$,且低 $K$ 时优势最大。Finding 2/3(不会自发恢复但能力潜在):隐式恢复成功率极低,EvoCUA-32B 平均低于 1%;Table 8 显示 Claude-Sonnet-4.6 的隐式恢复成功率随预算增大反而从 26.98%(Max2)跌到 6.37%(Max10)。而显式模型恢复使成功率平均提升 17.86 个百分点(跨 OSWorld 与 WAA);OSWorld 上显式 w/ Contextualization 相对隐式平均 +48.1 个百分点(Figure 4),泛化型模型受益最大、专项后训练的 EvoCUA-32B 几乎无感——能力是潜在的而非缺失的。Figure 6 显示隐式模式下智能体的 rationale 与恢复 prompt 相似度低,说明很少自发尝试恢复。Finding 5/6(恢复质量决定端到端收益):Table 2 中 Qwen3.5-9B 在 0~R 策略下 39.38%→44.26%(+4.88),各设置平均 +2.12;Table 3 中 Sonnet-4.6 70.27%→71.81%,但 UI-TARS-1.5-7B 17.25%→15.74%、EvoCUA-32B 54.88%→51.55%——弱恢复反而拖累任务;Figure 8 显示更多恢复迭代对 Qwen3.5-9B 持续增益、对 EvoCUA-32B 不断脱轨。评测可靠性(Table 1):RETRACE 与人类判断的平均一致胜率 82.0%,高于去掉 $R_O$ 的 63.0% 与 GPT-5.4 评估器的 54.0%;12 名标注者间一致率 82%、Cohen's κ=0.45;86.0% 的判定不受弹窗、时间戳等随机环境动态影响(Table 11)。
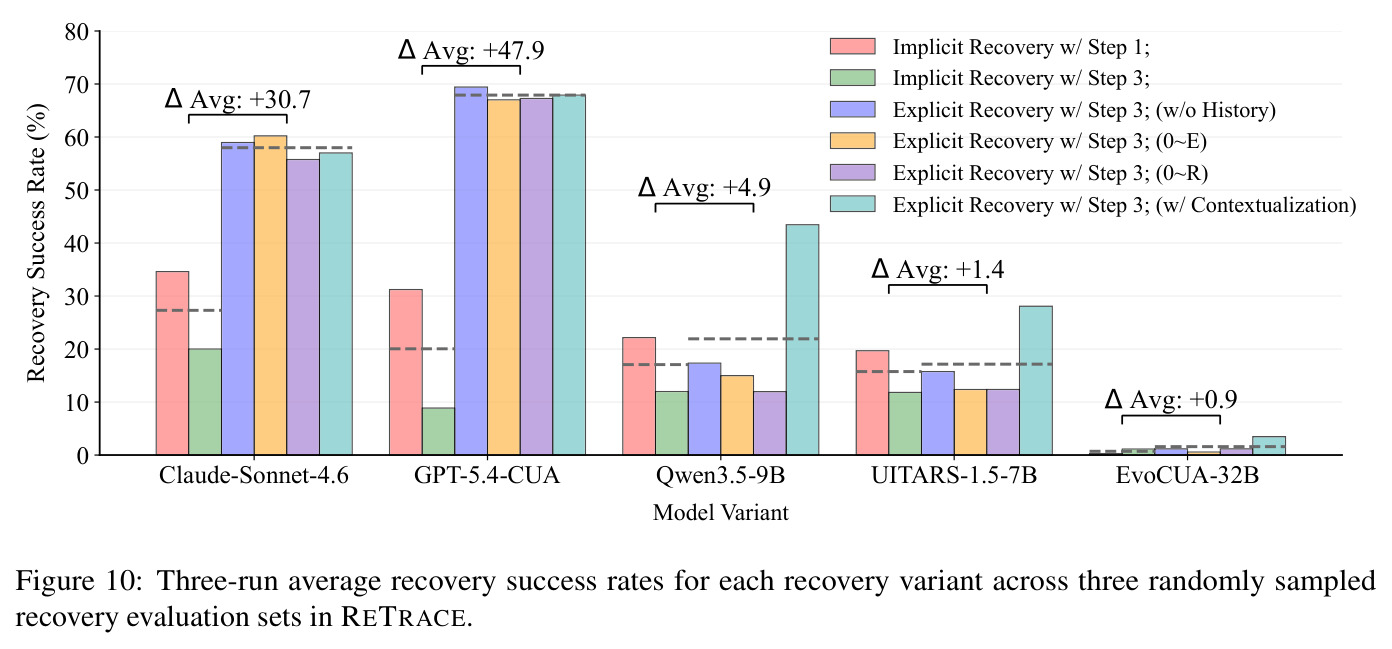
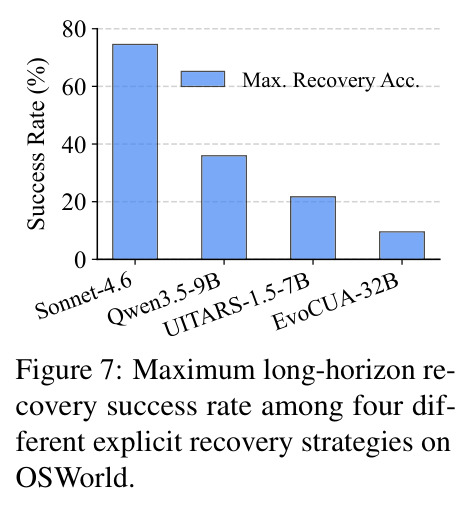
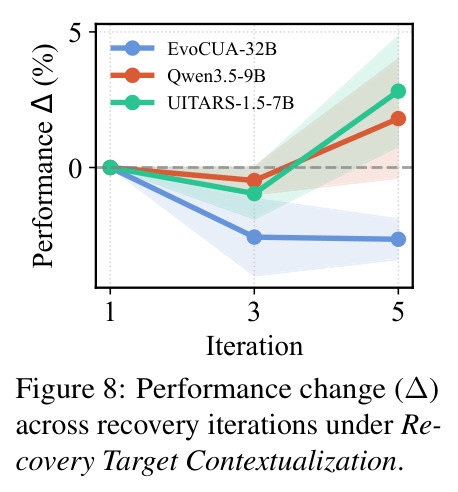
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 短程恢复(d=1) | 显式恢复相对隐式恢复的平均成功率提升 | +48.1 个百分点(w/ Contextualization) | 隐式恢复自身仅 +0.4~+1.7 个百分点 | 约 +46~48 个百分点 |
| OSWorld + WindowsAgentArena 短程恢复 | 显式 vs 隐式恢复平均差距 | 17.86 个百分点 | 隐式恢复(同一模型无恢复指令) | 平均 17.86 pp |
| OSWorld 端到端任务(Qwen3.5-9B) | 任务成功率 SR | 44.26%±1.90(0~R 恢复策略) | 39.38%±1.17(无恢复) | +4.88 个百分点 |
| OSWorld 端到端任务(Claude-Sonnet-4.6) | 任务成功率 SR | 71.81%±1.51(含恢复) | 70.27%±0.70(无恢复) | +1.54 个百分点 |
| OSWorld 端到端任务(EvoCUA-32B,弱恢复案例) | 任务成功率 SR | 51.55%±2.54(含恢复) | 54.88%±4.39(无恢复) | -3.33 个百分点(弱恢复导致退化) |
| 恢复判定质量(vs 人类标注) | 与人类判断的平均一致胜率 | RETRACE oracle 82.0% | GPT-5.4 评估器 54.0%、仅 RO 63.0% | +28.0 个百分点 |
局限与改进
作者承认的局限:RETRACE 旨在测量与分析恢复行为而非直接改进它;显式恢复只能激发模型已有的能力,无法弥补 GUI 理解、状态跟踪或动作规划上的先天缺陷;因此恢复能力弱的专项模型(如 EvoCUA-32B)在接受显式恢复后反而可能引入额外轨迹漂移、降低任务成功率。我的独立观察:其一,错误步 $E$ 与恢复步均由 Qwen3.6-Plus 做 LLM 标注,检测错误会系统性传导进评测集;其二,goal-oriented replay 以「重放原轨迹剩余动作」为判据,会惩罚那些恢复到等价状态后选择了不同但同样有效路径的智能体;其三,转移一致过滤刻意丢弃了环境随机的任务(保留率仅 64.4%),结论对动态真实环境的适用性存疑;其四,每个模型的评测集只有 60–120 条样本,且 SSIM 0.99 的严格阈值可能把时间戳、弹窗等无害差异判为失败(作者用人类评估部分缓解,Table 13 显示放宽阈值反而更糟);其五,覆盖面限于 pyautogui 动作空间和两个桌面基准,移动端与浏览器场景未验证。
独立分析的弱点
第一,判据绑定原轨迹:恢复成功与否完全取决于重放原轨迹剩余动作能否成功,若智能体恢复到行为等价但像素不同的状态、并合理选择替代路径,会被误判为失败。改进方向:允许一组候选延续动作序列,任一成功即记恢复成功。第二,错误是人工注入的:扰动策略生成的错误与真实失败模式(误点、打开错误应用)分布不同,结论可能失真。改进方向:从大规模真实失败轨迹中挖掘错误模式构建更自然的错误分布。第三,评测成本高:每评一个模型都要 on-policy 采集、$N=3$ 次重放过滤、扰动再过滤,实验动用 1×H200 加两块 RTX A6000 并为闭源模型支付 API 费(GPT-5.4-CUA 被迫只采样 600 条)。改进方向:跨模型复用环境快照与动作前缀缓存,或用轻量世界模型替代物理重放。第四,恢复与续行耦合:Table 4 显示恢复后失败常源于「虚假感知」与「状态跟踪失败」,无法区分「恢复得不好」和「续行能力差」。改进方向:把状态等价性指标与续行成功率拆开报告。第五,隐式恢复成功率随步数预算增大反而下降(Sonnet-4.6 从 26.98% 到 6.37%),说明模型缺乏内生的状态态势跟踪,更多自由度只会让它越走越偏。
未来方向
作者在 Limitations 中明确提出两个方向:一是恢复感知的后训练(recovery-aware post-training),在「错误状态—目标状态—纠正动作轨迹」三元组上训练模型;二是设计辅助目标让模型显式跟踪潜在环境状态、预测动作诱导的状态转移,RETRACE 正好能提供所需的评测协议与受控恢复场景。在此基础上可延伸:把恢复机制集成进树搜索与测试时扩展框架,让回退成为搜索算子而非事后补救;用学习到的世界模型预测动作后果,自动选择最优恢复步 $R$ 而非依赖 LLM 检测器;把恢复成功率作为强化学习的奖励信号或过程奖励模型的监督来源;扩展到移动端、浏览器与云办公套件等多平台恢复基准;以及把转移一致性从单步推广到多步链式验证,评测「恢复后又执行 $k$ 步」的稳定性。
复现评估
复现条件较好。代码与数据集开源:https://github.com/BangProx/ReTRACE;两个基准均公开——OSWorld(Apache 2.0)与 WindowsAgentArena(MIT,作者用 OS-Symphony 的预处理环境加速评测),全部环境部署在隔离 Docker 容器中。五个被测模型中三个开源(Qwen3.5-9B-Thinking、UI-TARS-1.5-7B、EvoCUA-32B,vLLM 以 bfloat16 本地部署),两个闭源需付费 API(Claude-Sonnet-4.6 开 thinking、GPT-5.4-CUA 开 xhigh 推理);错误步与恢复步检测器使用 OpenRouter 上的 Qwen3.6-Plus。算力为 1 块 H200(141GB)加 2 块 RTX A6000;GUI 环境工程细节多(10 秒动作后沉降窗口、1920×1080/1280×800 分辨率、重放失步最多重试 3 次),附录给出全部 prompt(Figure 12–38)。总体复现难度中等偏高:协议与超参记录完整,但 GUI 时序不稳定、大量重复重放和 API 开销意味着完整复现耗时花钱,建议先从开源模型的短程设定切入。
论文图表
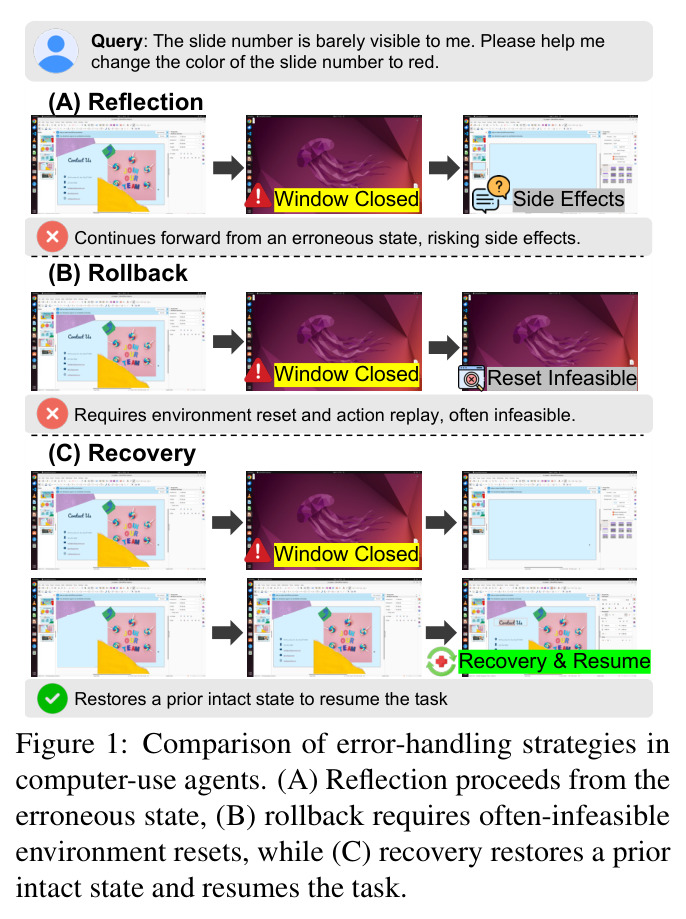
以「把幻灯片页码改成红色」为例对比三种错误处理策略:(A) Reflection 从错误状态继续前进,副作用不断累积;(B) Rollback 需要环境重置加动作重放,在专有环境中往往不可行;(C) Recovery 由模型自身恢复到先前完好状态并继续任务。
一图定义了全文的问题空间与术语(reflection/rollback/recovery),说明为什么模型级恢复是唯一通用可行的路线。
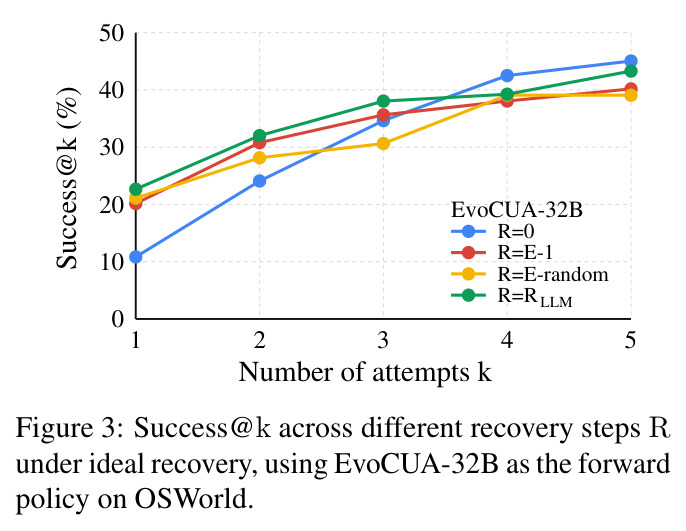
在 83 条失败轨迹上比较四种恢复起点:完全重置 R=0、错误前一步 R=E-1、随机过去步 R=E-random、LLM 检测的恢复步 R=R_LLM,横轴为重试次数 K。所有非零恢复步都优于完全重置,且低 K 区域优势最大。
直接回答 RQ1:理想恢复比重启更能利用模型的潜在能力,是「恢复值得研究」的关键证据。