UndoBench:解耦工具使用型 AI 智能体的任务能力与故障恢复能力 UndoBench: Separating Task Competence from Recovery Capability in Tool-Using AI Agents
配对反事实基准把智能体任务能力与故障恢复分离,揭示名义成功率掩盖的阶段性恢复缺陷
前置知识
工具调用智能体 (Tool-Using Agent)
以 LLM 为核心决策器、通过调用外部工具或 API 完成多步任务的系统:模型输出结构化的工具调用(如 JSON 函数调用),运行时框架负责真正执行请求并把结果拼回上下文,循环往复直到任务完成。每次工具调用会产生两类后果——返回给模型的文本载荷 $r_t$,以及对远程资源的真实状态变更 $\tau: \mathcal{S} \times \mathcal{A} \to \mathcal{S}$(写数据库、打款、部署等)。
本文的全部评测对象就是这类智能体;理解「工具调用不只是返回文本,还会改动外部世界」是理解 UndoBench 为什么必须做线级副作用监控的前提。
丢失确认 (Lost Acknowledgment / Lost ACK)
分布式系统的经典故障模式:客户端发出的变更请求已在服务端成功提交,但携带确认的响应包在网络中丢失,客户端只收到超时或异常。此时客户端无法区分「操作失败」还是「操作成功但确认丢了」,形成提交不确定性(commit uncertainty),盲目重试就可能重复执行。
这是 UndoBench 冻结主研究注入的核心故障 POST_MUTATION_PRE_ACK(变更已提交但确认未达)。论文中的重复扣款、DER、不安全重试等全部核心概念都围绕这一故障展开。
幂等性 (Idempotency)
同一操作执行一次与执行多次效果相同的性质。工程上常通过幂等键实现:客户端为每个逻辑操作生成确定性唯一键(本文用 task_id、tool_name、参数的截断 SHA-256),服务端缓存已见键并在重放时直接返回上次结果而非重复执行。Stripe 等支付 API 均原生支持。
它是论文恢复基线 B2 与全局干预 B2-K 的核心机制,也是理解「为什么 B2 只在支持幂等键的 3 个端点上把 CRSR 提到 100%,而对无保护端点几乎无效」的关键。
补偿事务与 Saga 模式
数据库领域的经典容错方案(Garcia-Molina & Salem, 1987):把长事务拆成一串子事务,每个子事务配一个逆向补偿操作,失败时按相反顺序执行补偿把系统拉回一致状态;ARIES 写前日志(Mohan et al., 1992)则是基于持久日志重放的另一条恢复路线。
它们是人类工程师处理故障的既有方案,也是论文恢复基线的灵感来源:B5(EvoUndo 本地变更日志 + 对账)对应日志路线,而真正的 Saga 补偿(B3)因零权限约束不可行被排除,这一设计直接塑造了实验结论。
反事实配对评估与 CRSR
对每个试验跑两次:同一任务、同一随机种子,一次不注入故障(对照组,成功记 $C_i$),一次注入故障(实验组,成功记 $F_i$)。条件恢复成功率定义为 $\mathrm{CRSR} = \mathbb{P}(\text{Success} \mid \text{Fault}, \text{Comp}) = \frac{1}{D}\sum_{i=1}^{D} C_i F_i$,其中 $D=\sum_i C_i$ 为对照组成功的试验数,只在「有能力」的试验上衡量恢复。
这是全文最核心的度量设计:没有配对条件化,无条件 RSR 会把「本来就不会做」混入「做不好恢复」——由 $\mathrm{RSR} = \mathbb{P}(S|F,\mathrm{Comp})\mathbb{P}(\mathrm{Comp}) + \mathbb{P}(S|F,\lnot\mathrm{Comp})\mathbb{P}(\lnot\mathrm{Comp})$ 可见混淆来源,这正是作者指出现有基准混淆两种能力的数学根源。
恰好一次语义 (Exactly-Once Semantics)
分布式副作用的目标语义:每个逻辑操作对外部世界恰好生效一次——既不遗漏(missing)也不重复(duplicate)。与之相对的是至多一次(可能丢失)和至少一次(可能重复)。本文用 $\mathrm{dup}_i = \sum_k \max(0, \mathrm{commits}(k)-1)$ 与缺失指示 $\mathrm{miss}_i$ 把它程序化。
UndoBench 的安全指标族——恰好一次率 EOR、重复效应率 DER、不安全重试率 URR、缺失效应率 MER——都是对恰好一次语义的程序化检验,是判断恢复是「安全」还是「碰巧成功」的标尺。
研究动机
工具使用型智能体正被部署到企业软件系统中——检查代码仓库、执行数据库迁移、操作 CRM、 provision 云基础设施、发起跨境电汇——但主流评测基准(SWE-bench、ToolBench、API-Bank、AgentBench、WebArena)几乎只在标称、无扰动条件下测「任务能不能完成」。真实分布式系统并非静态沙箱:网络有瞬时延迟与丢包,上游微服务返回限流与 5xx,数据库写会撞唯一键冲突,而最常见且最危险的是丢失确认——远端变更已提交但确认包丢失。论文给出具体场景:金融智能体执行 $\texttt{process\_renewal}(\texttt{sub\_id}=\texttt{\"sub\_99\"}, \texttt{amount}=1200)$,支付网关已扣款但响应包丢失,智能体捕获到连接超时后,由于不知道变更是否已提交,标准重试循环立即重发调用,账户被扣款两次。传统基准根本探测不到这种失败:它们不注入确认丢失,也不检查外部线级副作用。更根本的问题是,单一端到端成功率把任务能力(标称条件下协调工具完成目标)与恢复能力(故障发生时诊断、对账并安全修复)混为一谈,而前者成功并不蕴含后者成功。
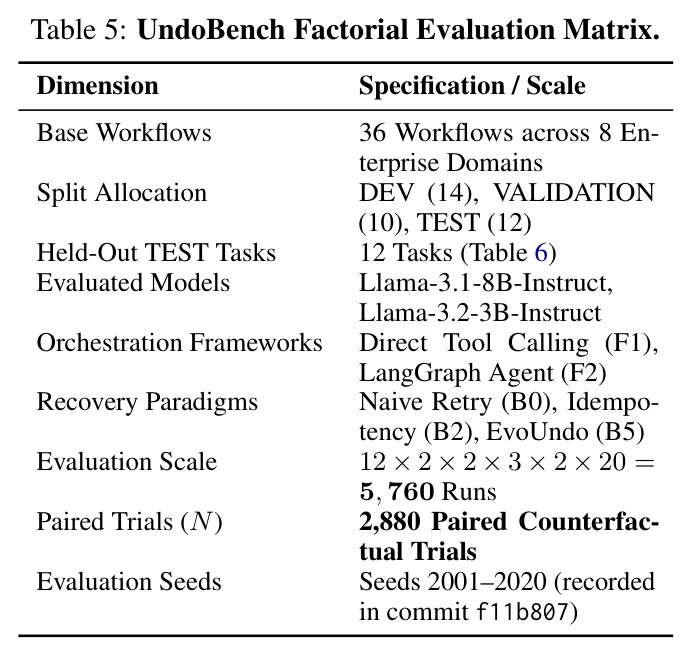
本文的目标是本文的目标是构建 UndoBench,把多轮任务能力与故障恢复能力在形式上分离,并系统回答研究问题:当故障沿外部变更生命周期移动时,智能体的恢复行为如何变化?具体包含四个子目标。其一,构建覆盖 8 个企业域的 36 个基础工作流与 36 个故障场景,沿外部状态变更的不同执行边界注入故障;其二,提出反事实配对评估范式,把每次故障运行与同种子对照运行配对,定义条件恢复成功率 $\mathrm{CRSR} = \mathbb{P}(\text{Success} \mid \text{Fault}, \text{Comp})$,把恢复严格条件化在能力之上;其三,提供程序化状态 oracle 与线级效应历史 oracle 的双重校验,量化重复(DER)、缺失(MER)与恰好一次(EOR)执行安全性;其四,通过冻结的确证性研究(12 个 held-out TEST 工作流、5,760 次执行、2,880 配对试验)加上前瞻性注册的二次扩展(商业模型、互补边界、全局幂等干预),实证刻画恢复到底是单一标量能力还是相位依赖的系统属性。
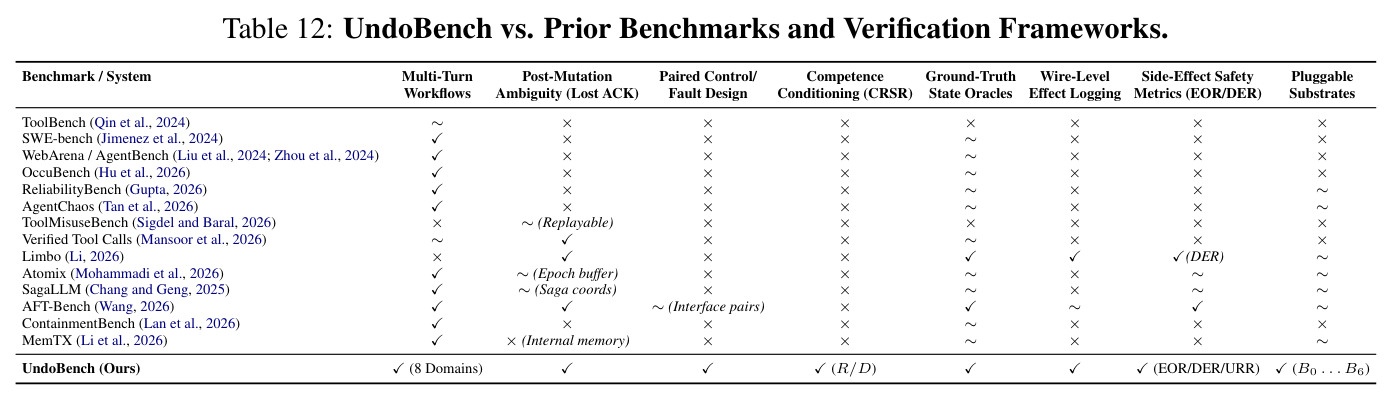
与已有工作不同的是,本文的独特切入有三点。第一,评测视角从「端到端任务结果」下移到「线级执行效应」:不同于只检查最终字符串答案的基准,UndoBench 在代理层拦截每次工具调用,显式区分物理调用、已提交变更、语义效应三个层次,能发现「终态断言全过但外部世界被重复修改」的隐性灾难。第二,统计设计采用反事实配对:每次故障运行都有同种子对照孪生,从而把能力条件化的 CRSR 与无条件 RSR 分开——能力低时无条件指标被任务失败稀释,这正是现有故障注入型基准(AgentChaos、ReliabilityBench 等)无法回答「会做的任务失败了能否安全救回」的原因。第三,把故障按执行边界形式化为五类(PRE_MUTATION、DURING_MUTATION、POST_MUTATION_PRE_ACK、POST_ACK_PRE_CHECKPOINT、DURING_COMPENSATION),首次把「恢复」当作随故障时机变化的相位依赖系统属性而非标量分数来研究。同期工作各有侧重:LIMBO 研究 exactly-once 责任归属,AFT-Bench 做接口语义干预,Verified Tool Calls 结合后置条件验证与幂等中间件,但附录 Table 12 的 8 维对比显示,只有 UndoBench 同时具备配对对照、能力条件化、双 oracle 与副作用安全指标。
核心方法
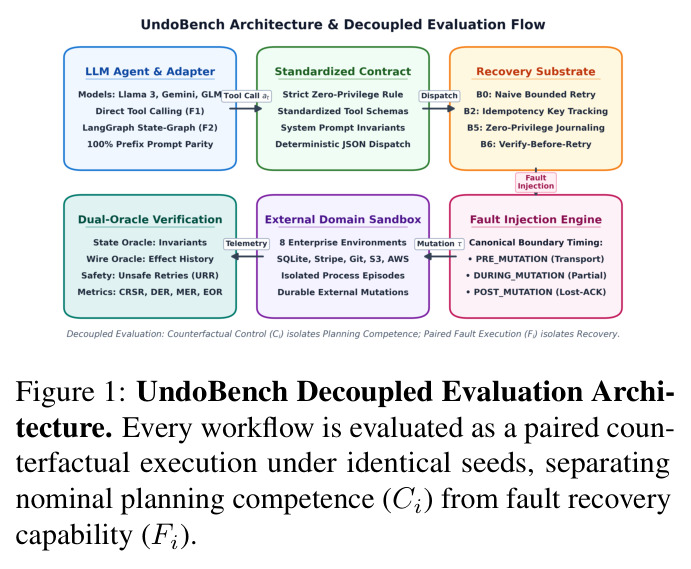
核心直觉是「双胞胎实验」:让同一个智能体在完全相同的初始状态和随机种子下把同一工作流跑两遍,一遍一切正常(对照),一遍在特定时机注入故障(实验),然后问——在对照成功的前提下,实验组是否也安全成功。技术路线分四层。任务层:36 个基础工作流覆盖 Cloud、CRM、Database、Git、Messaging、Payments、Storage、Ticketing 8 个企业域,按 14 DEV / 10 VALIDATION / 12 held-out TEST 划分并冻结,主研究聚焦 POST_MUTATION_PRE_ACK(提交后确认丢失)边界。执行层:代理层拦截所有工具调用,注入故障令牌,同时生成不可变的 WireEffectEvent 线级日志。恢复层:同一故障下对比三种范式——B0 天真重试(至多 3 次指数退避)、B2 幂等键(对 task_id、tool_name、参数做截断 SHA-256 生成确定性键)、B5 EvoUndo-RB1(客户端变更日志 + 零权限崩溃对账)。评估层:终态 oracle 验证数据库 schema、git 提交图、对象存储中的目标不变量;线级效应 oracle 审计完整事务日志计算重复与缺失。模型侧使用 Llama-3.1-8B 与 Llama-3.2-3B(Q4_K_M 量化,温度 0.2),框架覆盖 F1 直接工具调用与 F2 LangGraph,20 个种子共 $12\times2\times2\times3\times2\times20=5{,}760$ 次执行、2,880 配对试验。
创新之一是把「能力」与「恢复」在统计上解耦:已有基准只测 $\mathbb{P}(\text{Success}\mid\text{Nominal})$,即使注入故障也只报告无条件的 $\mathbb{P}(\text{Success}\mid\text{Fault})$,能力不足时该指标被任务失败稀释。UndoBench 用同种子配对试验构造反事实,定义 $\mathrm{CRSR}=\frac{1}{D}\sum_{i=1}^{D}C_iF_i$,把恢复严格条件化在能力之上。其二,双 oracle 设计:终态 oracle 只能判断「最终状态对不对」,线级效应历史 oracle 则审计完整提交序列,计算 $\mathrm{dup}_i$ 与 $\mathrm{miss}_i$,把 EOR(恰好一次率)、DER(重复效应率)、URR(不安全重试率)、MER(缺失效应率)作为独立安全维度报告——一个只会重试的智能体可能在终态断言下「通过」,却留下重复扣款;在 POST_MUTATION_PRE_ACK 域内 $\mathrm{URR}\Leftrightarrow\mathrm{dup}_i>0$、$\mathrm{EOR}_{\mathrm{cond}}\equiv\mathrm{CRSR}$ 数值重合但概念独立。其三,执行边界分类法:恢复不是标量能力,故障发生在变更前、变更中、提交后确认丢失三种时机需要完全不同的机制(重试 / 幂等去重 / 观测验证 + 服务端去重),这一「机制–故障匹配」框架是与所有已有工作的本质区别。
方法步骤详情
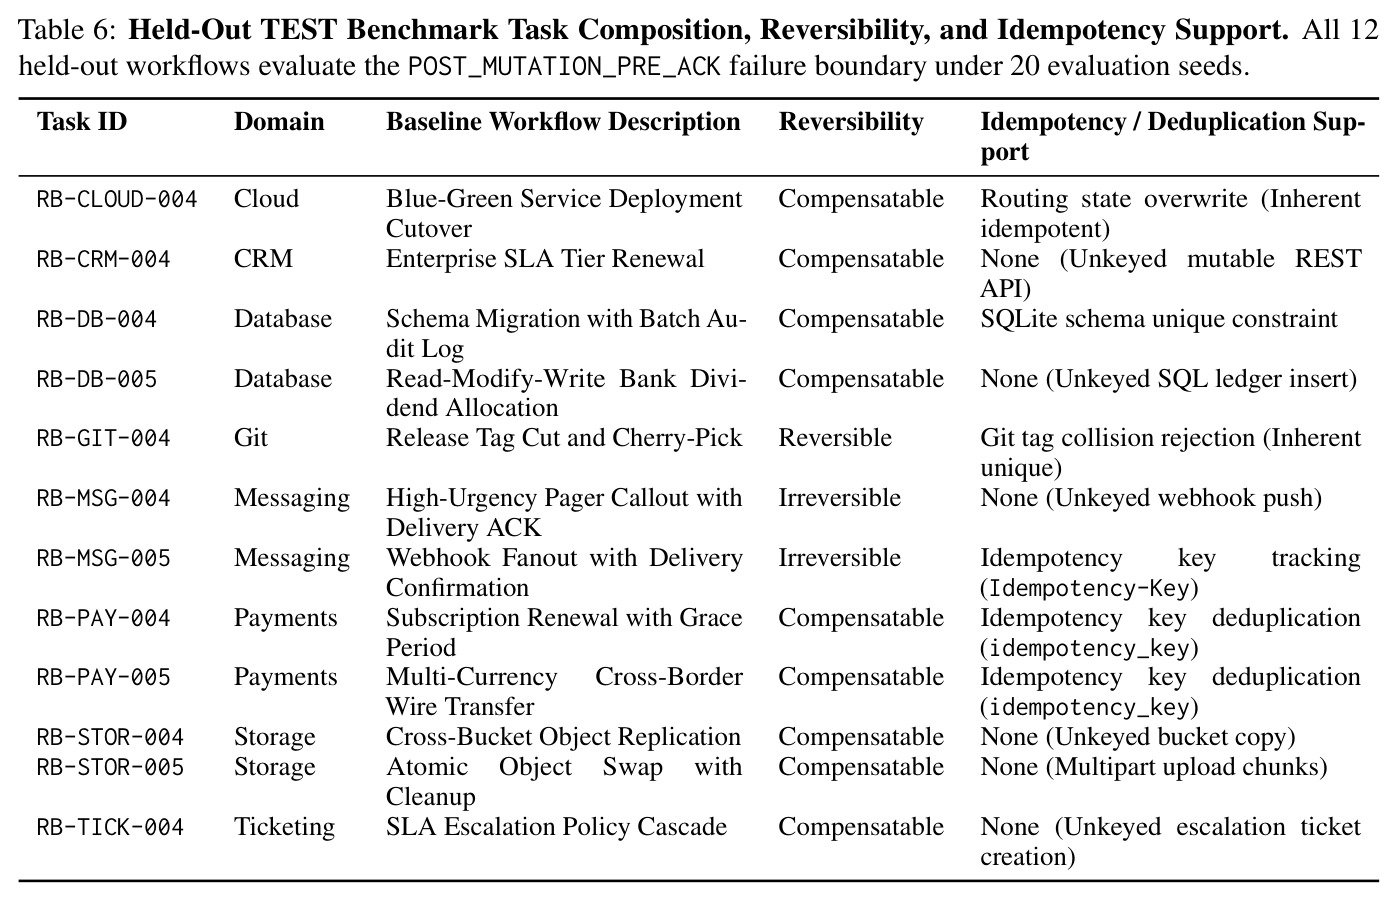
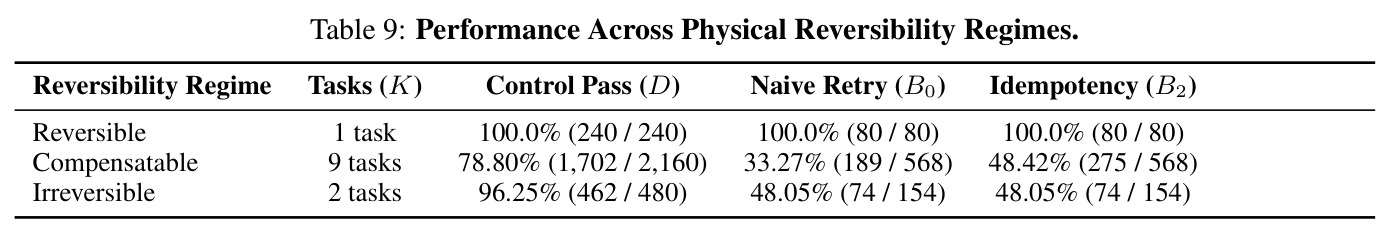
第一步,任务构建与冻结:36 个工作流按物理可逆性标注为 REVERSIBLE / COMPENSATABLE / IRREVERSIBLE,并标注幂等支持(如 RB-PAY-004/005 有 idempotency_key、RB-DB-004 有 SQLite 唯一约束,多数端点无保护),划分为 14 DEV、10 VALIDATION、12 held-out TEST,TEST 数据以 SHA-256 摘要锁定。第二步,配对执行:12 个 TEST 工作流 × 2 模型(M1 Llama-3.1-8B、M2 Llama-3.2-3B)× 2 框架(F1 直接工具调用、F2 LangGraph)× 3 恢复基线(B0/B2/B5)× 20 种子(2001–2020),共 5,760 次执行、2,880 配对试验;对照组记录 $C_i$,实验组在 POST_MUTATION_PRE_ACK 时机注入故障记录 $F_i$。第三步,故障注入与日志:代理层让远端变更提交但吞掉确认,写入含 call_index、tool_name、target、op_type、arguments、committed_externally、acknowledged_to_agent 等字段的不可变事件流。第四步,双 oracle 评估:终态 oracle 验证任务目标不变量;线级 oracle 计算 $\mathrm{dup}_i$、$\mathrm{miss}_i$,导出 EOR/DER/URR/MER。第五步,统计推断:任务聚类非参数 bootstrap($B=10{,}000$)估置信区间,Holm-Bonferroni 校正,TOST 等价检验($\delta=\pm10$ pp)验证框架等价。第六步,前瞻注册的二次扩展:商业模型(Gemini 3.8 Flash、GLM-5.2 MaaS)、互补边界(PRE_MUTATION、DURING_MUTATION)与全基准服务端幂等干预 B2-K(960 配对试验)。
技术新颖性
技术新颖性体现在四个层面。其一,度量层面:CRSR 的配对条件化设计在智能体评测中是新的——现有可靠性工作(ReliabilityBench、AgentChaos、ToolMisuseBench 等)注入故障但不构造同种子对照,无法分离「不会做」与「救不回」;附录 Table 12 的 8 维对比显示 UndoBench 是唯一同时具备配对对照设计、能力条件化、线级效应日志与副作用安全指标的框架。其二,观测层面:WireEffectEvent 的三层次效应模型(物理调用 / 已提交变更 / 语义效应)把分布式系统久已区分的概念引入智能体评测,使「重复扣款」这类终态断言不可见的失败成为一等公民指标,并辅以 72/72 对抗 oracle 一致性测试与 100% 配对前缀等价审计。其三,本体层面:五边界故障分类法把「恢复」从单点性质展开为相位依赖谱系,并通过 PRE/DURING/POST 三边界实验给出机制–故障匹配矩阵:重试在变更前安全、幂等治提交不确定性、观测+可许可修复治中间态。其四,科研流程层面:冻结主研究 + 前瞻性注册的二次扩展(模型、边界、干预均预先指定)+ 取证式指标重建(EOR 因初版日志缺陷未直接记录时,用不可变线级日志经 scripts/reproduce_eor.py 确定性重放),为基准论文提供了少见的可审计性标准。
实验结果
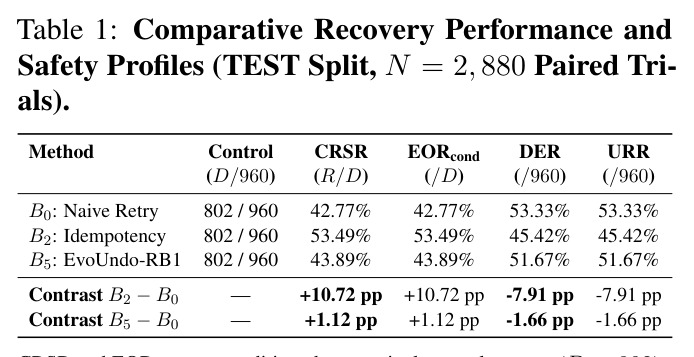
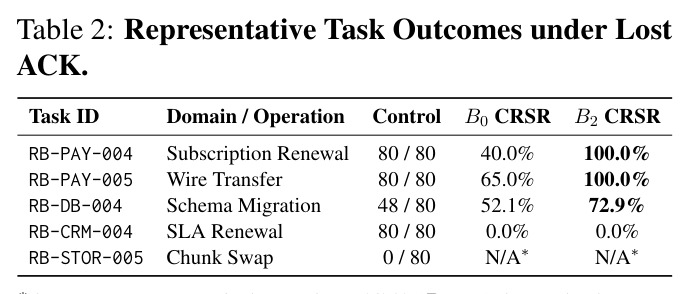
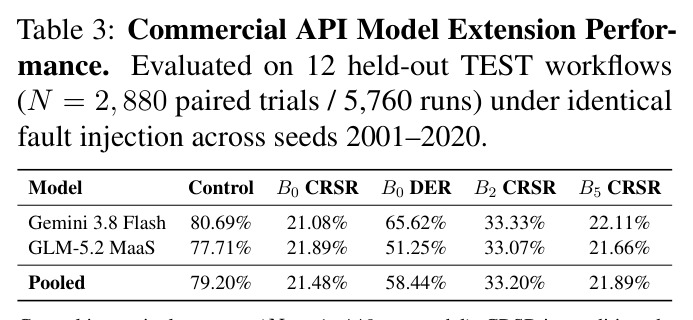
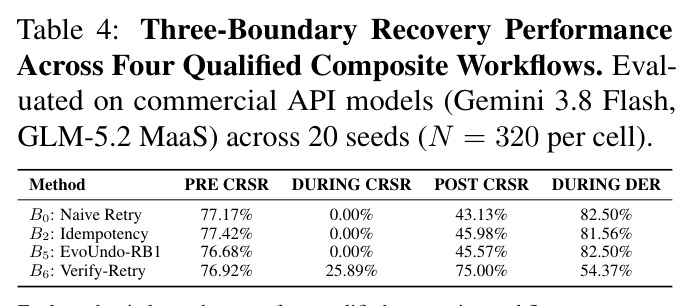
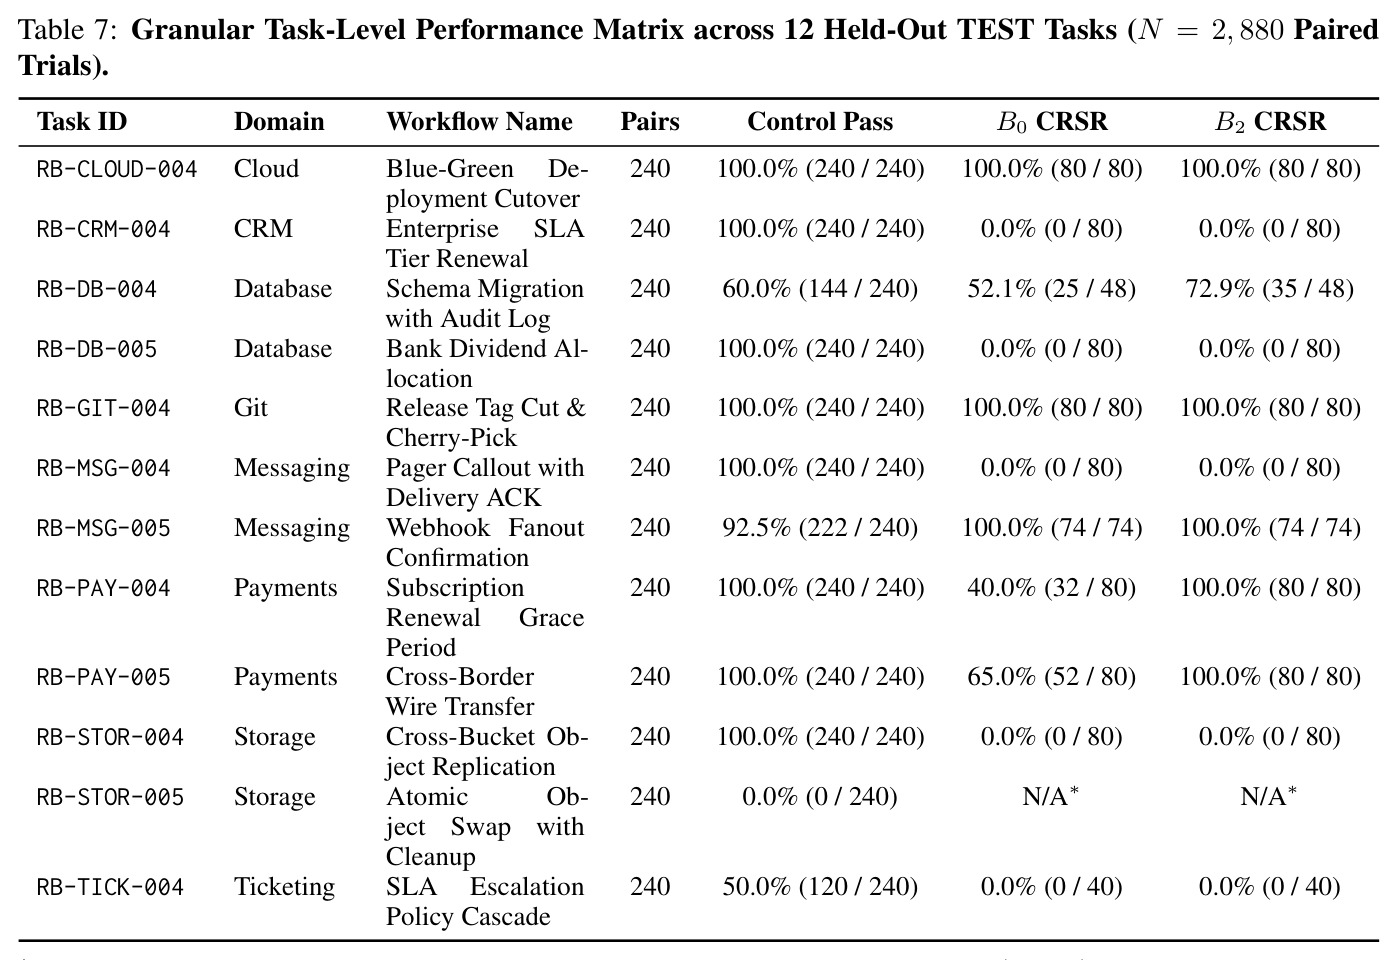
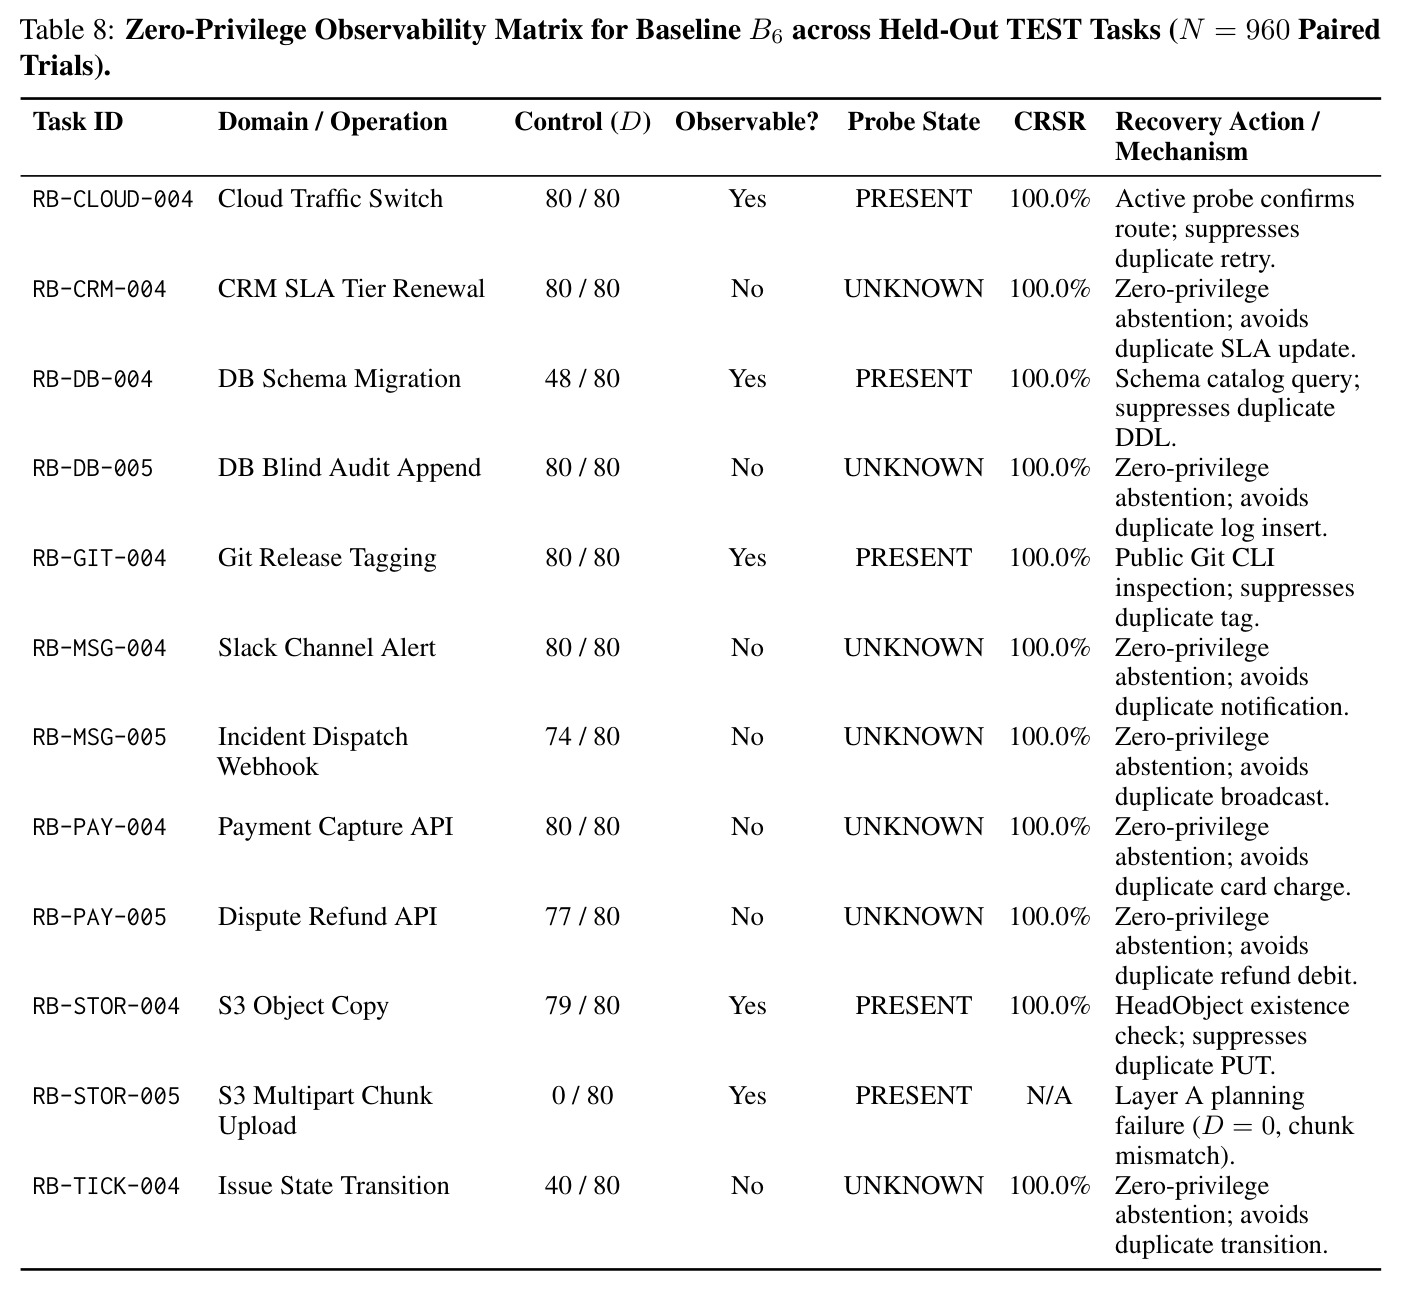
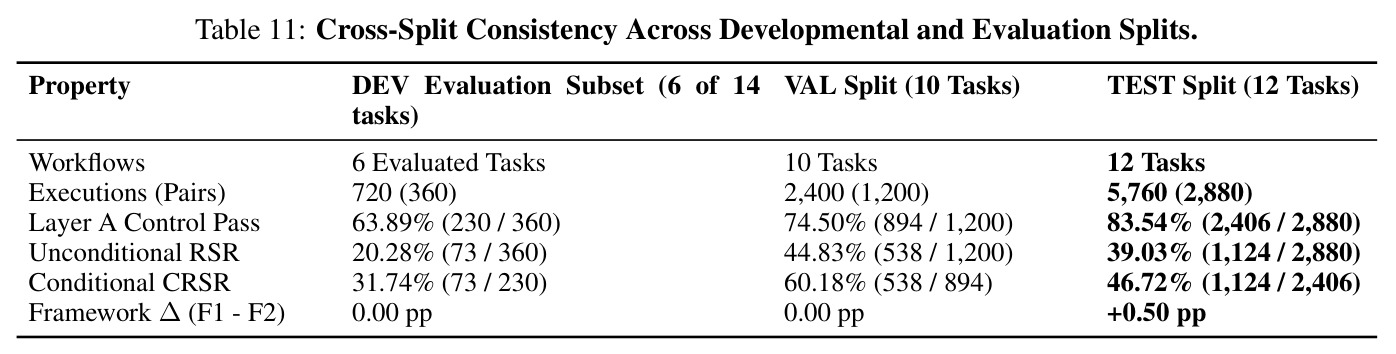
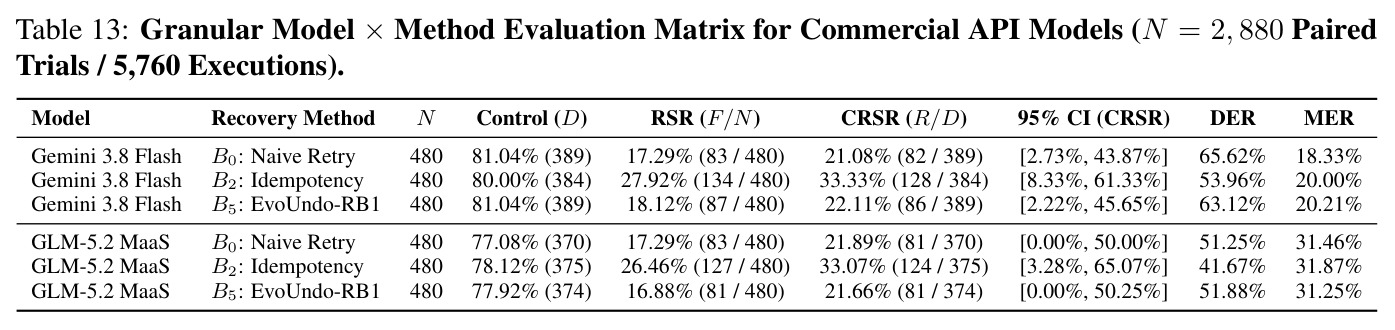
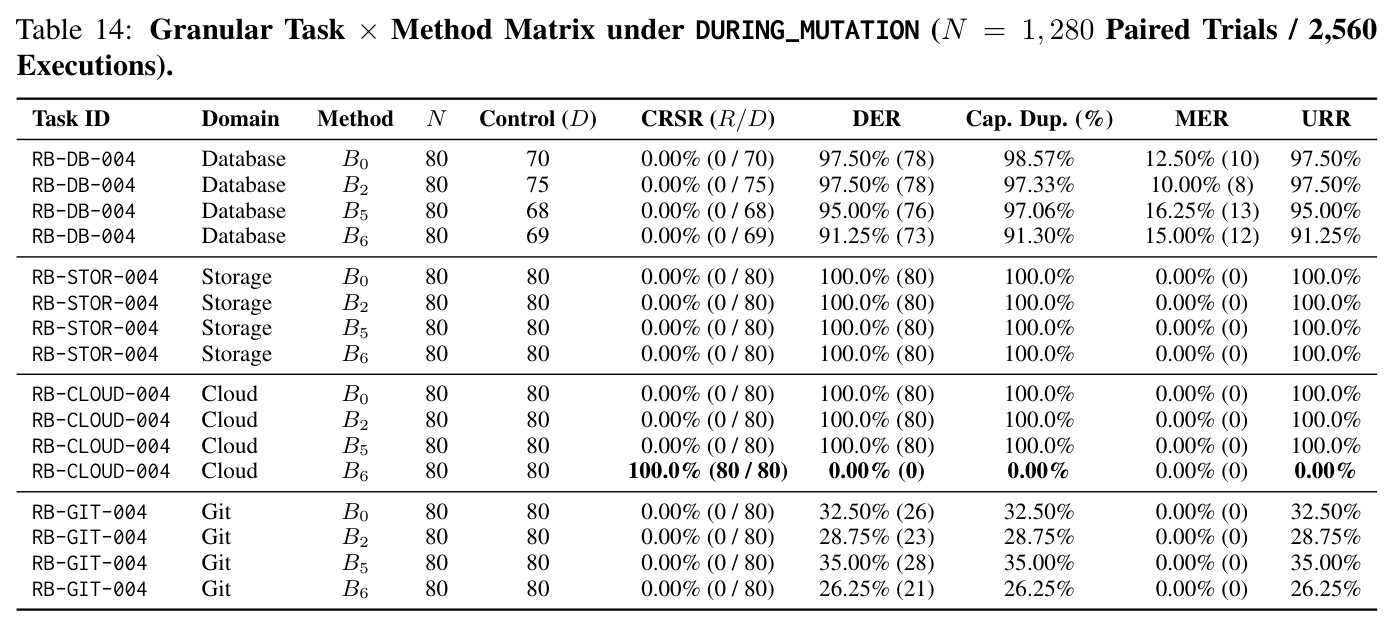
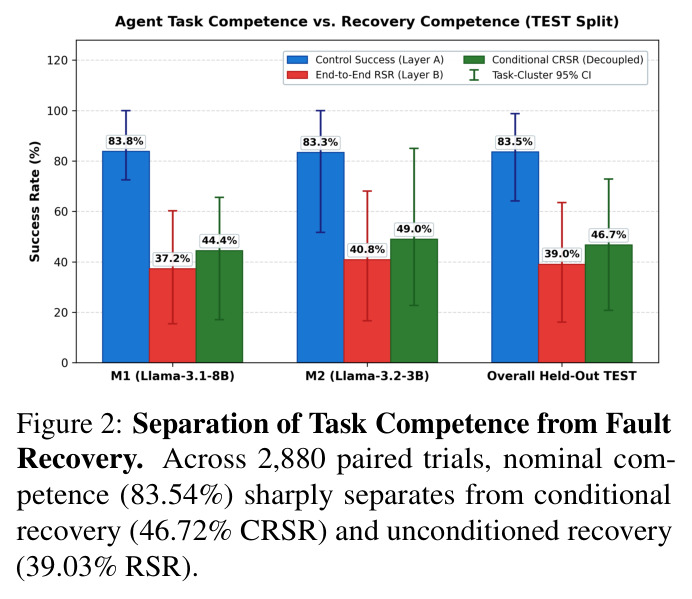
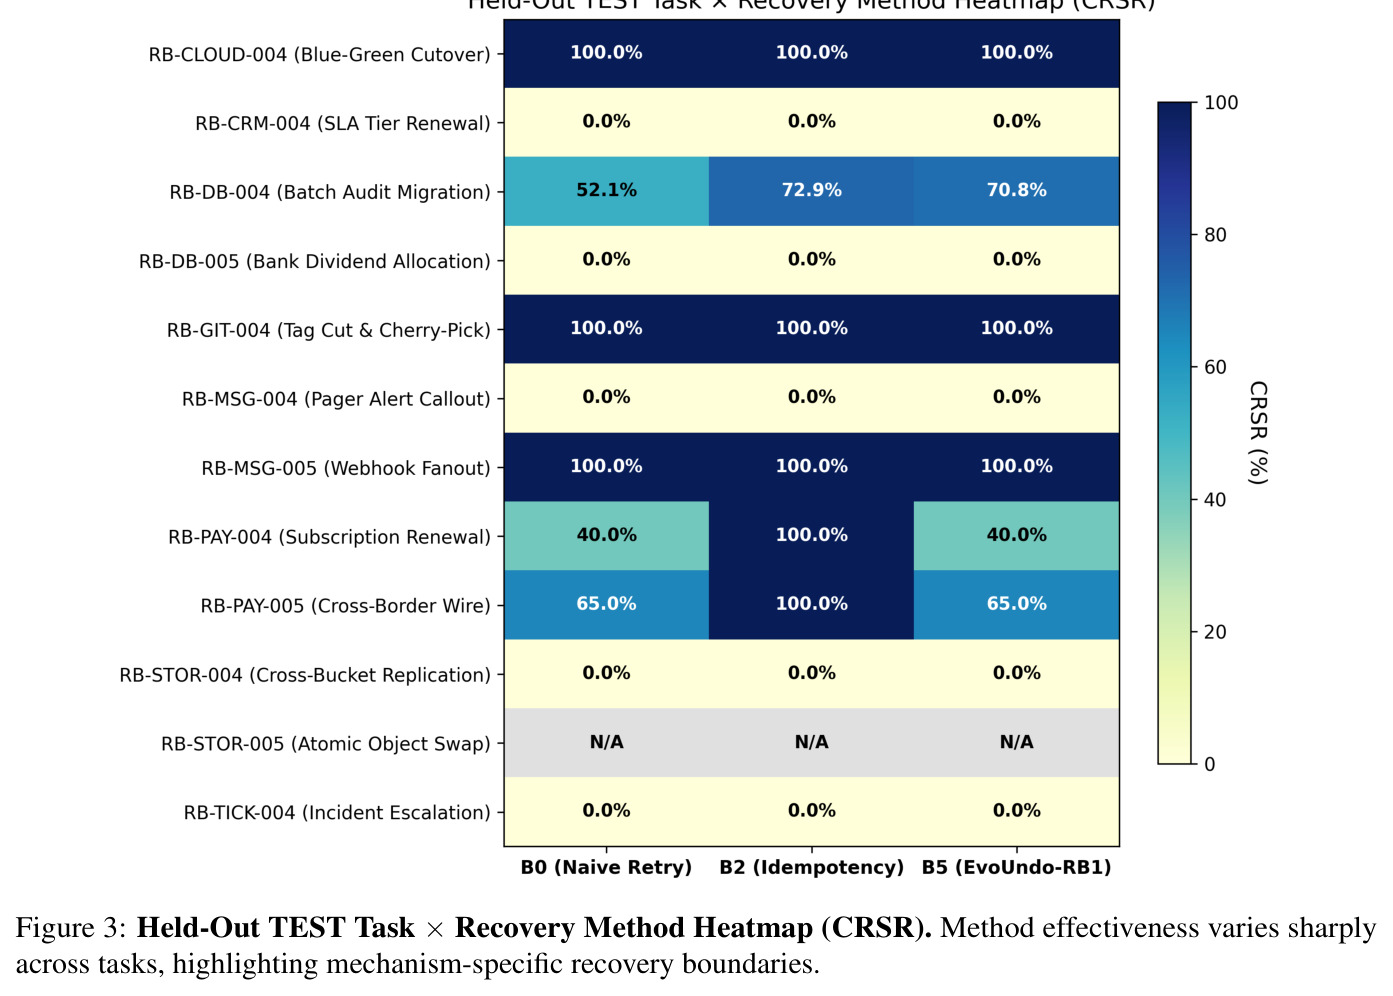
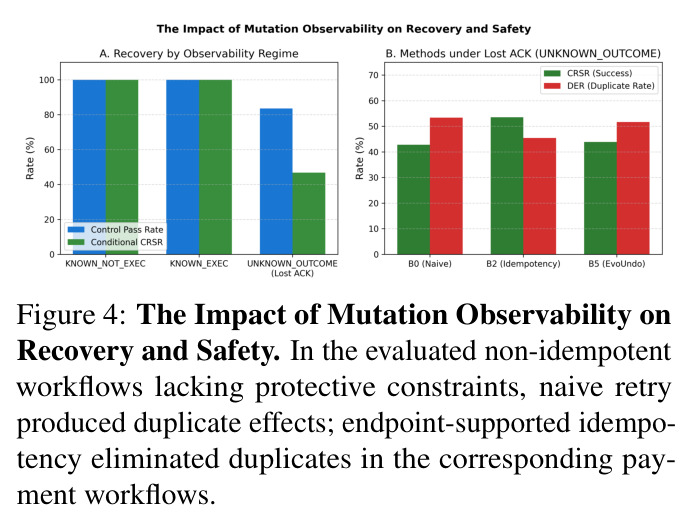
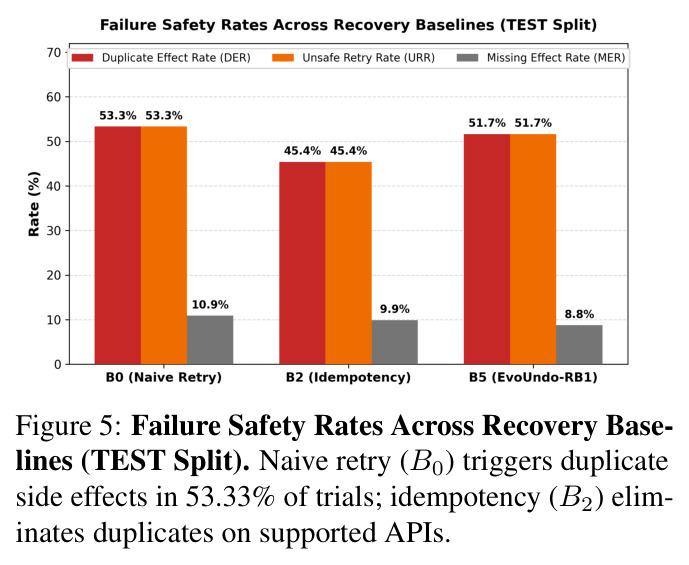
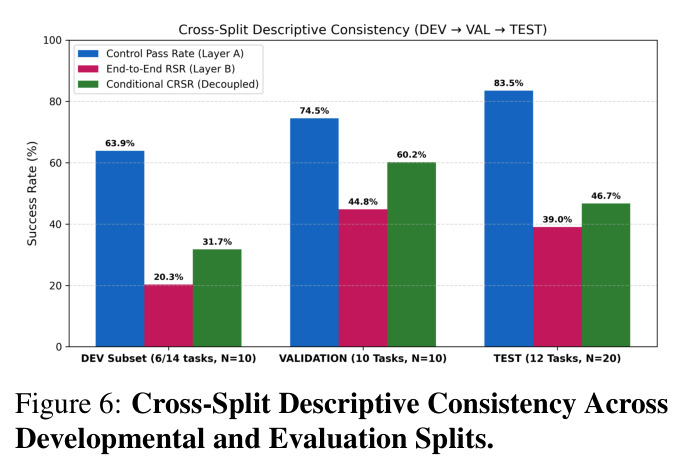
发现一(能力–恢复分离):冻结主研究(2,880 配对试验)中标称成功率 83.54%(2,406/2,880),无条件恢复 RSR 仅 39.03%,条件恢复 CRSR 46.72%(1,124/2,406)——名义成功高估故障可靠性约 37 个百分点;天真重试(B0)的重复效应率 DER 达 53.33%(512/960)。发现二(幂等收益集中于有支持的端点):B2 相对 B0 的 CRSR 优势 +10.72 pp(53.49% vs 42.77%,95% CI [0.00, +24.23],校正后 $p_{adj}=1.00$ 不显著);收益几乎全部来自 3 个支持幂等键的端点(RB-PAY-004/005、RB-MSG-005:CRSR 100%、DER 0%),而 5 个无保护工作流上重试 100%(400/400)产生重复、RB-STOR-005 为 45%,合计 436/960(45.42%);RB-DB-004 的 0% 重复来自 SQLite 唯一约束而非幂等键。发现三(零权限日志几乎无用):B5 仅 +1.12 pp(DER 51.67%),因无法确认未确认变更是否提交。模型与框架:Llama-3.1-8B CRSR 44.50% vs Llama-3.2-3B 54.17%($\Delta=-9.67$ pp 不显著);F1/F2 两框架 TOST 等价($p<0.001$)。商业模型扩展:Gemini 3.8 Flash 标称 80.69% 但 B0 CRSR 仅 21.08%、DER 65.62%(鸿沟 59.96 pp);GLM-5.2 为 77.71% → 21.89%(鸿沟 55.19 pp),说明先进推理不消除操作风险。全基准服务端幂等 B2-K 把 CRSR 提到 97.24%(741/762)、DER 降至 0.00%,闭合 95.87%–97.97% 差距,残余 21/762 失败均为非恢复性生成错误。多边界动力学:PRE_MUTATION 下四方法 CRSR 76.68%–77.42% 且 3,028 个能力试验零重复;DURING_MUTATION 下 B0/B2/B5 全部 0% CRSR、DER ~82%,仅 B6 达 25.89%;POST 边界 B6 达 75.00%。B0 的 PRE vs POST 边界差 +56.96 pp(95% CI [+27.97, +84.67]),共同能力支撑下 +57.34 pp,证明差距源于故障时机而非条件漂移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 标称能力 vs 故障恢复(12 个 held-out TEST 工作流,POST_MUTATION_PRE_ACK) | Control / RSR / CRSR | Control 83.54%(2,406/2,880),CRSR 46.72%(1,124/2,406) | 无条件 RSR 39.03%(1,124/2,880) | 揭示约 36.8 pp 能力–恢复鸿沟,证明单一成功率掩盖恢复缺陷 |
| 重复外部副作用(DER,每方法 960 试验) | DER | B2 幂等键降至 45.42%(支持的 3 个端点 0% DER) | B0 天真重试 53.33%(512/960) | 全基准服务端幂等 B2-K 达 0.00% DER |
| 全基准服务端幂等干预(B2-K,商业模型,960 配对试验) | CRSR | 97.24%(741/762) | 标准客户端幂等 B2 33.20% | +64.04 pp,差距闭合 95.87%(共同支撑下 97.97%) |
| 前沿商业模型恢复(Gemini 3.8 Flash,B0) | CRSR / DER | CRSR 21.08%(82/389),DER 65.62%(315/480) | 同模型标称控制 81.04%(389/480) | 量化 59.96 pp 鸿沟:更强模型并不自动更安全 |
| 故障时机对比(PRE_MUTATION vs POST_MUTATION_PRE_ACK,B0) | CRSR | PRE 78.44%(593/756) | POST 21.48% | +56.96 pp(95% CI [+27.97, +84.67]),证明恢复是相位依赖属性 |
| 变更中断恢复(DURING_MUTATION,4 个合格复合工作流) | CRSR / DER | B6 验证后重试 25.89% CRSR、54.37% DER | B0/B2/B5 全部 0.00% CRSR、DER 81.56%–82.50% | 唯一非零恢复,表明可观测性 + 可许可修复是必要条件 |
局限与改进
作者明确承认十条边界:评测模型仅两个小参数开源模型加两个商业 API;任务聚类数只有 $K=12$,20 个种子不增加独立聚类数,导致置信区间宽;冻结研究只覆盖 POST_MUTATION_PRE_ACK,二次扩展只覆盖 PRE 与 4 个 DURING 工作流,POST_ACK_PRE_CHECKPOINT(同步 harness 下无法忠实实现)与 DURING_COMPENSATION 未研究;每条轨迹只注入单一故障,级联、并发、拜占庭故障留待未来;环境是模拟沙箱(SQLite、本地 Git、mock Stripe/AWS),缺少生产级并发与延迟分布;B5 是零权限实例而非完整 EvoUndo;B6 是事后补测、不在确证性比较内;EOR 因初版日志缺陷由线级日志事后取证重建;CRSR 在 $D=0$ 时(RB-STOR-005,控制 0/240)数学上未定义;B0 使用固定 3 次重试预算,退避调度敏感性未扫描。我的补充观察:其一,12 个 TEST 任务上任务级结论波动极大(CRSR 从 0% 到 100% 跨任务),对「哪个方法更好」的统计功效实际很低;其二,商业 hosted API 无法位级复现,扩展结论可重复性弱于冻结主研究;其三,oracle 正确性是全部安全结论的单点依赖,而 RB-STOR-005 连控制成功率都是 0%,说明部分任务对被评智能体过难,指标退化为 N/A。
独立分析的弱点
独立分析可见四类弱点。第一,恢复机制本身偏弱:B6 只是「公开探针验证 + 抑制重试/弃权」,真正的 Saga 补偿(B3)和检查点回滚(B1)因沙箱限制被排除在主比较之外,因此论文实际上没有测到「主动修复」类机制的上限——例如对 RB-STOR-004 的多段上传中断态,带权限的补偿执行器(列出已上传分块、删除后重传)应能大幅超过 25.89%。第二,任务规模与统计功效:$K=12$ 的聚类数使关键对比(B2 vs B0 的 CI [0.00, +24.23]、$p_{adj}=1.00$)无法显著,而任务级 CRSR 在 0%–100% 间剧烈跳变,结论对任务抽样高度敏感,扩展到 50+ 工作流才能支撑机制排序。第三,单故障、同步注入:真实生产事故常是级联(限流引发超时引发重复提交)或并发竞争(两个智能体同时重试同一操作),单故障、agent turn 边界注入的设定测不出这些交互效应。第四,可观测性假设:B6 的成功依赖任务存在「可公开查询的提交状态」(catalog、Git CLI、HeadObject),而 8 个 UNKNOWN 探测任务实际靠「盲目弃权」得分——这更像「不作为也安全」而非「修复」,对必须推进业务的任务(如 RB-MSG-004 呼机呼叫必须发出)弃权策略会导致任务失败,论文未讨论这种安全–完成权衡的自动化裁决机制。
未来方向
作者指出的方向包括:补齐 POST_ACK_PRE_CHECKPOINT 与 DURING_COMPENSATION 两个未覆盖边界(需异步 harness 与可中断补偿执行);引入级联、并发故障与更大工作流套件;扫描重试预算与退避调度敏感性;处理商业 hosted API 的生成确定性问题。基于本文成果可自然延伸的方向:其一,把 B2-K 式服务端幂等推广为工具调用协议标准——类似在 MCP 等智能体工具协议层强制 idempotency-key 契约,论文已证明它能把 CRSR 从 33% 拉到 97%,这是工程上收益最大的一步;其二,把 B6 的「探测状态 → 修复动作」矩阵自动化:用零权限探针结果自动检索或合成注册的 inverse handler,形成「观测 + 补偿」闭环,弥补 DURING_MUTATION 边界 0% CRSR 的崩溃;其三,训练侧干预:以 UndoBench 的配对轨迹为偏好数据(安全恢复 vs 重复扣款)做 DPO/RL 微调,检验恢复能力是否可训练而非仅靠运行时机制兜底;其四,与混沌工程结合,从单故障扩展到故障图(故障间依赖与放大),评估多智能体并发场景下的 exactly-once 维持;其五,把 EOR/DER 指标接入生产 agent 网关做持续审计,让线级效应日志成为部署门槛。
复现评估
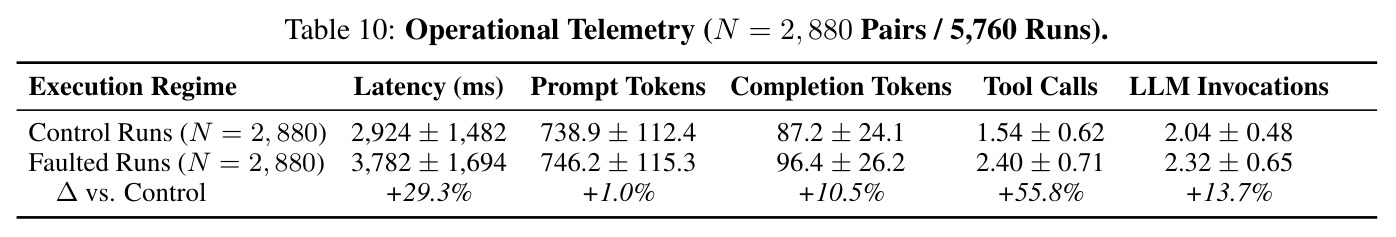
可复现性设计是这篇论文的突出优点。冻结主研究的数据集以 SHA-256 摘要锁定(tag f11b807),商业扩展的 matrix.csv 与 trajectories.jsonl 亦附独立摘要;评估参数(种子 2001–2020、温度 0.2、top-p 1.0、512 token 上限)与故障注入调度全程确定性;配套 scripts/reproduce_eor.py 取证脚本与单元测试支持从不可变线级日志确定性重建 EOR;72/72 oracle 对抗一致性用例与 100% 配对前缀等价审计(PRE 3,028 对、B2-K 762 对、DURING 1,242 对)公开了全部验证方法。算力门槛低:主研究在单张 A100-40GB(AMD EPYC 7713、115 GiB RAM、vLLM 0.30.0)上运行 Q4_K_M 量化的 Llama-3.1-8B / 3.2-3B,遥测显示单次执行平均约 3 秒、约 750 prompt token,全套 5,760 次执行在学术实验室预算内可完成;另有覆盖 Qwen3-14B、Mistral-NeMo-12B、Granite-3.3-8B 的单 GPU 兼容性验证。注意事项:正文提及 Code 链接但摘要未给出正式开源仓库 URL,需确认发布状态;商业模型部分依赖 Vertex AI,无位级复现保证。总体难度中等:复现主研究需搭建代理层故障注入 + 双 oracle + 两个框架适配,工程量集中在 harness 而非模型训练。
论文图表