MMEnterprise-Bench:基于演化多模态记录的企业智能体评测基准 MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
首个同时评测跨源冲突、时序冲突与不可回答性的多模态企业QA基准,最强模型仅68.0%
前置知识
RAG(检索增强生成)
先检索后生成的范式:给定问题,系统先从外部语料库检索最相关的 top-$k$ 条记录(本文用稠密检索器 Qwen3-VL-Embedding-2B),再把记录连同问题拼进模型上下文,让模型基于证据作答。检索质量用 $\mathrm{Recall}@k$(金标证据落入前 $k$ 条的比例)衡量,检索记录按时间戳排序后交给模型。
本文所有实验都在 RAG 设置下进行,检索预算 $k$ 与检索器大小是核心实验变量,理解 RAG 才能读懂评测协议与主要结论。
LLM-as-a-judge(模型评模型)
用强 LLM 充当自动裁判:把问题、参考答案、被评模型的回答一起交给裁判模型(本文用 GPT-5.6 Luna),让它判定回答是否正确,语义等价即得分,不可回答的题以等价拒答为正确。它替代昂贵的人工评分,使大规模评测成为可能,但会引入裁判自身偏好等系统性偏差。
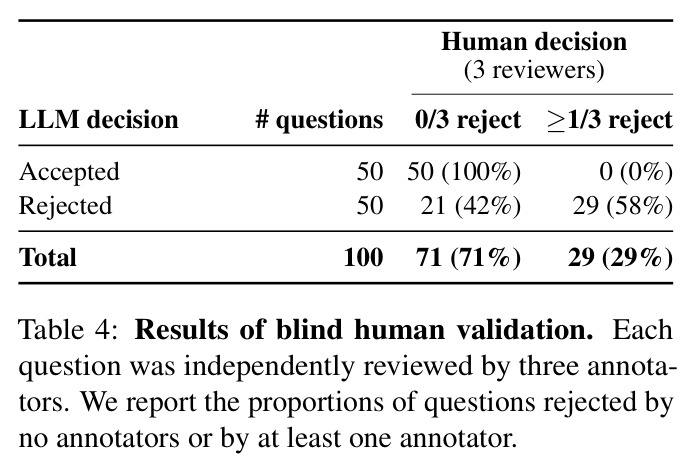
本文 1,613 题的准确率全部由 LLM judge 判定,其与人类判断的一致性(Table 4 的盲测对比)直接决定基准分数的可信度。
跨源冲突与时序冲突
跨源冲突指同一事实在不同来源(PDF 报告、Slack 消息、Notion 页面等)中出现不一致版本,例如图里是 27.3 而修正后的 Slack 消息说 27.8、旧 Notion 记录仍未更新。时序冲突指问题要求某个历史时刻的状态而非最新值,例如「截止日期在 14:00 时是多少」。两者都源于工作区记录只增不删、多版本长期共存的特性。
这是本文定义的两类核心难题(CR 类别),也是该基准区别于既有工作区基准的关键,全文实验与失败分析都围绕它们展开。
不可回答性(Unanswerability)
指可用证据不足以建立答案的问题:目标信息在工作区中根本不存在,或问题预设的前提不被记录支持。可靠的智能体应明确拒答(「记录中没有」),而不是拿最相近的错误事实硬答。构造上通常从可回答问题出发,改动其中一个实体或条件使其无解。
UNS 是本文三大评测维度之一,实验显示总体最强的模型在这类题上反而大幅落后于小模型,是全文最有意思的发现之一。
多模态文档理解
对文本富集的图像(扫描页、图表、幻灯片、表格截图)直接进行理解和问答的能力。多模态 LLM 将图像作为视觉输入,需要从像素中读出数字、图例、曲线高低等 image-only facts。相关工作从 DocVQA 的单页问答发展到 MMLongBench-Doc 等多页长文档场景。
本文语料中 54.6% 的可回答问题金标证据包含视觉记录,多图像证据上的性能崩塌(83.3% 降至 27.5%)是核心实验结论。
研究动机
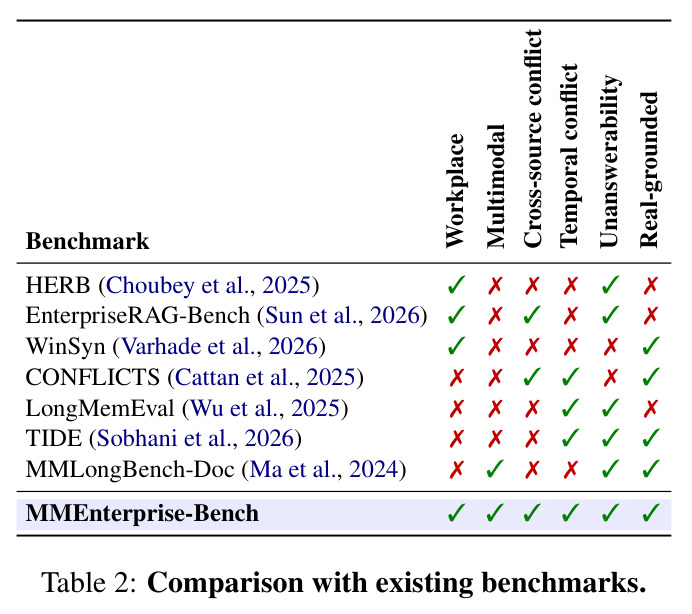
企业智能体的真实工作环境是 Slack、邮件、Notion、PDF 报告、幻灯片等异构记录构成的工作区,而团队协作的本质是信息不断被分享、质疑和修正:一个基金规模先在 PDF 里写成 £27.8bn,经 Slack 确认后修订为 £28.7bn,但 Notion 里的旧页面不会同步删除。于是同一事实的多个版本在工作区中长期共存,产生两类现实难题:不同来源给出不一致数值的跨源冲突,以及需要回答某个历史时刻状态的时序冲突。现有基准没有覆盖这一组合:HERB 是纯文本工作区模拟;EnterpriseRAG-Bench 虽引入 fact-altered 近重复文档,但只把最新值当正确答案,旧版本全是干扰项;WinSyn 加入修正链干扰却不修改金标答案;LongMemEval、TIDE 等时序知识基准面向公共知识或个人对话;MMLongBench-Doc 是多模态长文档 QA 但不含演化冲突;WorkArena、TheAgentCompany 等工作区智能体基准测的是工具操作任务而非证据支撑的问答。换言之,「旧记录本身就是合法答案」这一真实企业场景在既有评测中是缺失的。
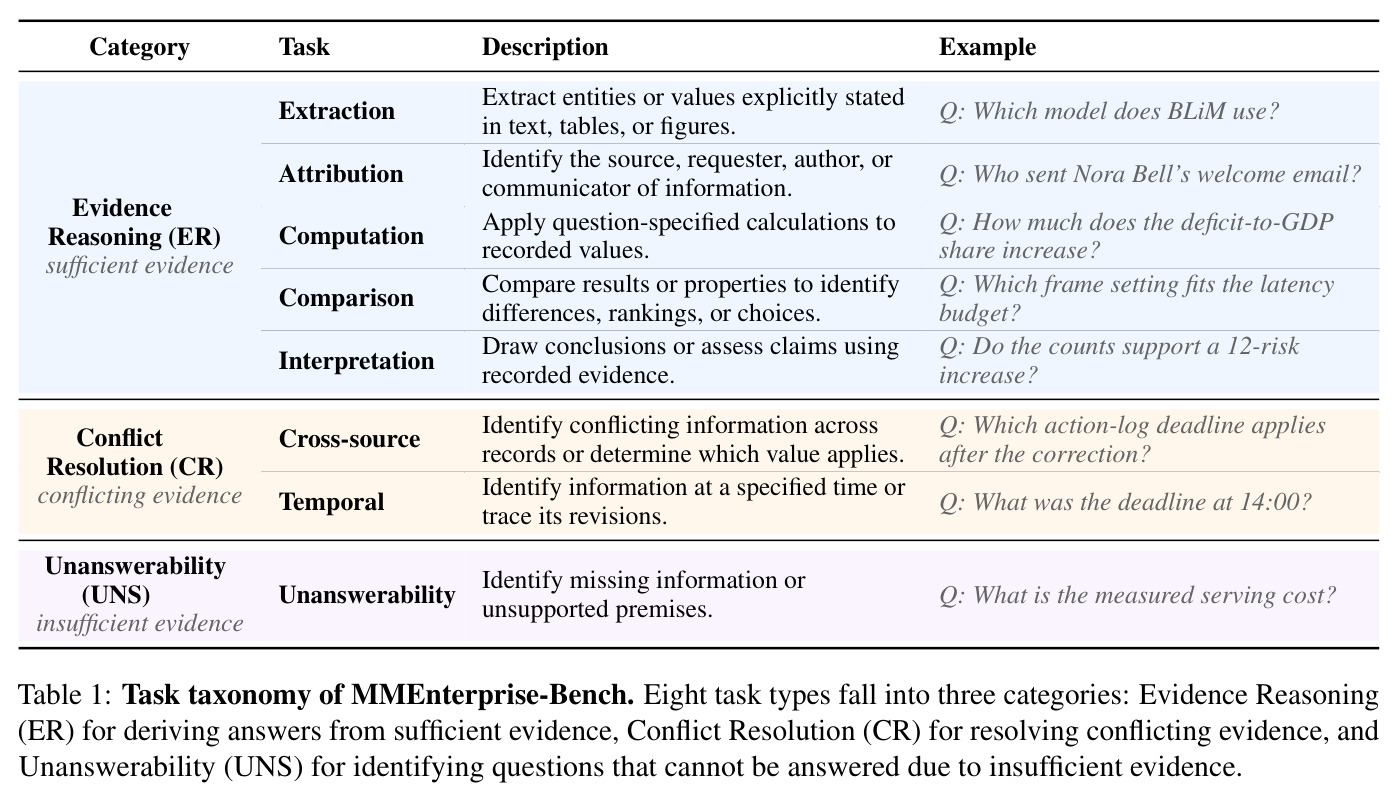
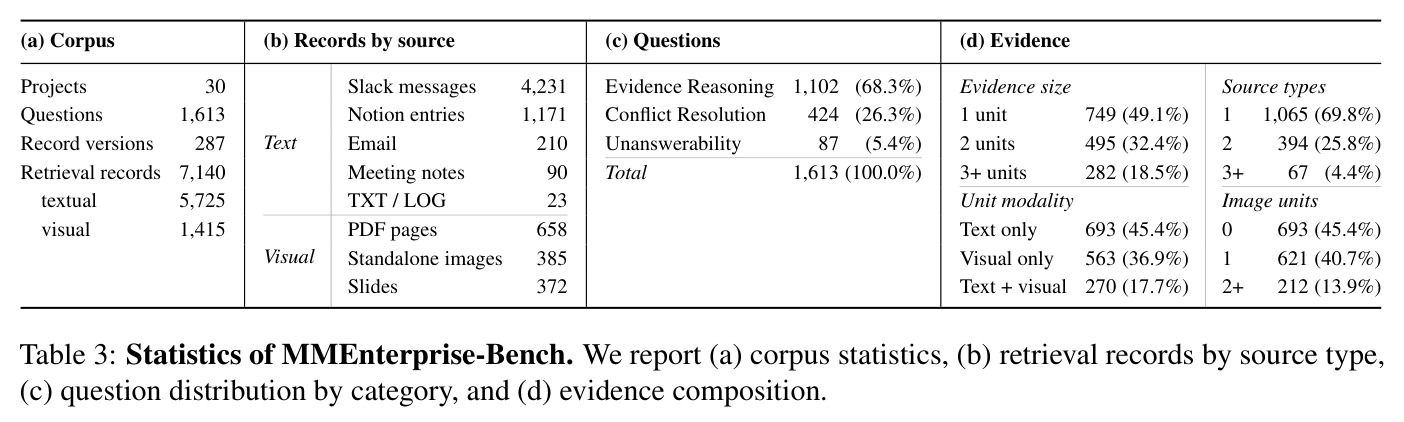
本文的目标是本文要构建一个系统评测企业智能体在演化多模态记录上推理能力的基准,目标分三层。其一,用模拟协作项目构造一个共享工作区:30 个项目、7,140 条文本与视觉检索记录、287 个记录版本,其中刻意保留被替代的旧值,让跨源冲突与时序冲突真实存在且可检索。其二,定义三大能力维度共八个子任务:证据推理 ER(含抽取、归属、计算、比较、解释五类,1,102 题)、冲突解决 CR(跨源与时序两类,424 题)、不可回答性 UNS(87 题),共 1,613 个 QA 对,并给每题标注金标证据的数量、来源类型与模态构成。其三,在统一 RAG 协议(Qwen3-VL-Embedding-2B 检索、$k \in \{10, 50\}$、时间戳排序、LLM judge 评分)下评测 10 个专有与开源多模态 LLM,量化「检索变好是否等于回答变好」这一此前未被回答的问题。
与已有工作不同的是,本文的独特切入点是把「演化」作为一等公民:与其只测最新值是多少,不如把修订历史本身作为考点。设计上有一个关键决定——旧记录在被修正后依然保留在检索语料中,因此「修正前一刻的截止日期是几点」是合法问题,其正确答案恰恰是被其他来源否定的旧值。这与 EnterpriseRAG-Bench 形成鲜明对比:后者把旧值一律当干扰项,等于暗示模型「永远选最新值」,而真实工作区要求的是区分哪个值在哪一刻、哪个来源中适用。第二个被忽视的点是跨模态的证据传播:数值先出现在图表里,修正却通过文本消息传达,模型必须跨模态对齐同一事实的不同版本。第三个是证据充足性判断:把「证据不足应拒答」作为独立维度而非附带测试,因为实验显示它与总体能力并不同步——总体最强的 GPT-5.6 Sol 在 UNS 上反而被 Gemini 3.8 Flash 超过 21.9 个点。
核心方法
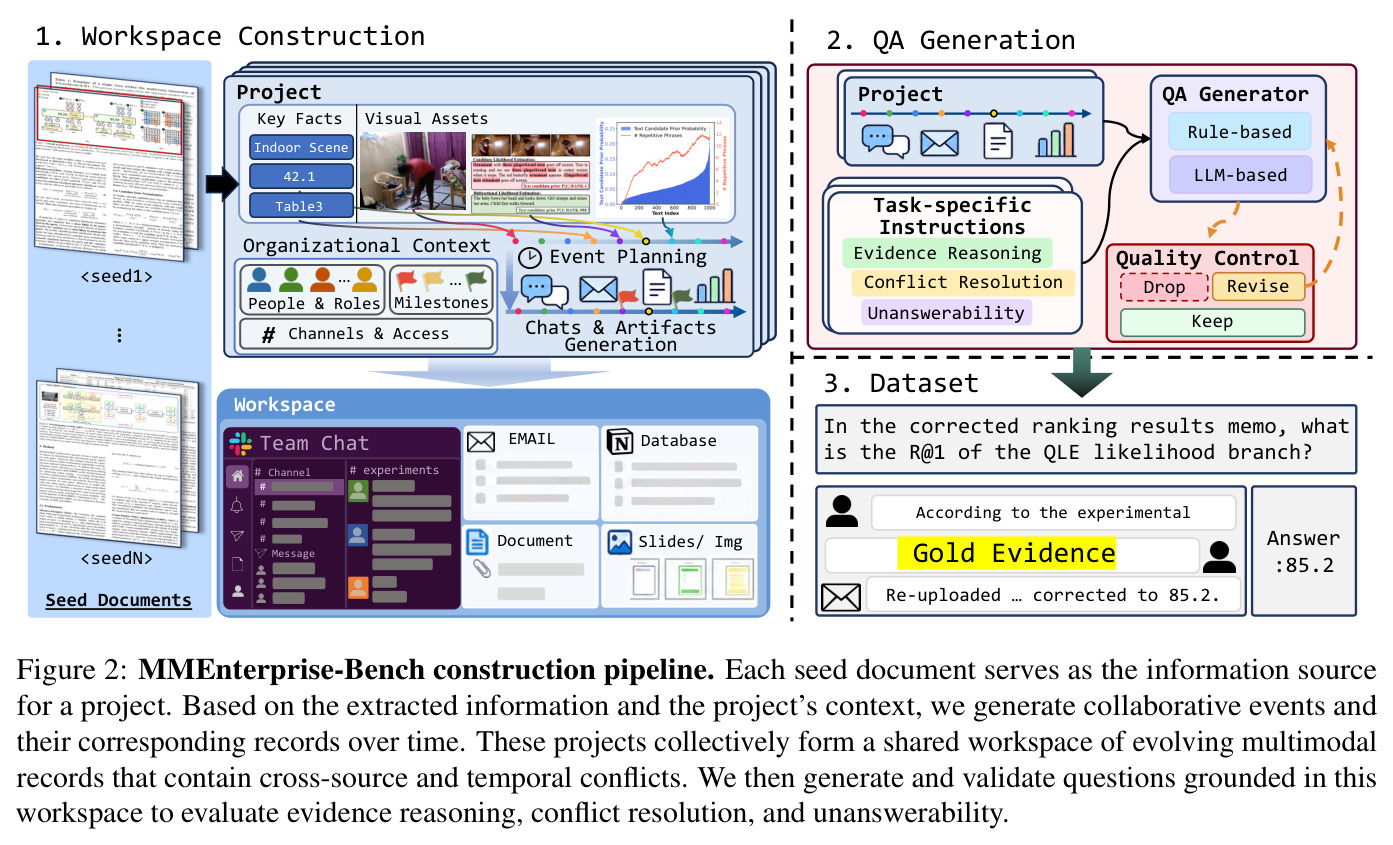
直觉上,这篇论文做的事相当于把一篇公开报告变成一个虚构公司的一周协作史:论文里的每个数字、表格和图,都变成这家公司 Slack 里的消息、邮件附件、Notion 条目和 PDF 报告,而且信息按剧情演化——先有人写错值,再有人发现并纠正,最后决策敲定;所有旧版本都不删除,于是工作区天然充满多版本冲突。技术上分两大阶段。第一阶段是工作区构建:从 30 份种子文档(12 篇研究论文加 18 份政府报告,如 CBO 预算展望、GAO 审计、NIST 框架)提取关键值、配置、定量声明与图像独有事实;选定组织原型(研究实验室或分析咨询公司)并配置团队角色、频道与访问权限;用 LLM 规划一周协作事件序列(结果发布、错误引入—发现—纠正、决策记录、状态变更);再按事件生成多模态记录(PDF 报告版本、slides、Slack 消息、渲染的表格与图表)。第二阶段是 QA 构建与质检:规则式与 LLM 式结合出题,UNS 题通过扰动可答案题构造;每题标注参考答案、解题步骤与金标证据集;经程序化检查、三阶段 LLM 验证与 100 题盲测人工验证。最终 30 个项目的记录合并成一个 7,140 条、约 266 万 tokens 的共享检索库,评测时智能体从中检索 top-$k$ 条作答。
核心创新是事件驱动加版本保留的工作区模拟,它让冲突成为数据结构的自然产物而非人工拼接的对抗样本。每个项目围绕种子文档设定一条剧情线:LLM 先规划错误脚本(谁在何时把什么值写错、谁在哪里发现、何时用正确值修正)与演化事实(预算、截止日期、负责人等随时间多次变更),每条事实的每个版本都带明确的时间戳、频道和发言人。关键是所有历史版本都保留在语料中且各自可检索,于是一个「Notion 记录 32、修正后 PDF 写 34、Slack 又新增一行 23」的跨源冲突现场不需要任何特殊标注就自然存在。在此之上,出题规则明确要求:问当前状态时用最新一次修正而非最后一次提及,问历史状态时在题目中显式给出时间或版本边界——这把时序冲突变成了可判定的 QA 题而非常规模糊题。与既有工作的本质区别就在这里:EnterpriseRAG-Bench 的旧值只是干扰项(金标永远是最新值),WinSyn 的修正链不改变金标答案,LongMemEval 评的是个人对话记忆,而本文中被修正的旧值本身就是某道题的正确答案,模型必须理解哪个值在哪个时刻、哪个来源中适用。
方法步骤详情
完整流程分八步。第一步源信息提取:输入种子文档全文与图表,输出结构化 JSON——方法名、任务摘要、带精确数字的配置事实、定量声明、流水线步骤,以及图表的 image-only facts(只能从像素读出的事实),规则禁止改写任何数字。第二步组织构建:选定公司原型(research_lab 或 analysis_firm)、虚构公司与客户、团队成员人设(每人有 owns 职责和 voice 语气)、频道与访问限制、里程碑。第三步事件调度:输出按时间排序的一周事件表,包括结果行(baseline/progression/release/analysis)、刻意脚本化的错误(错误值—发现者—修正时刻)、决策日志与状态漂移事实,每个演化事实有多个带时间戳的版本。第四步记录生成:按事件生成 PDF 报告版本(v1 中未定结果标 pending)、slides、Slack 消息(纠正必须写成错值到对值)、渲染表格与图表图像,每条记录带 ID、时间戳与来源元数据。第五步记录质检:程序化检查 JSON 格式、数值与源文档一致、事件顺序正确;对每个频道用 LLM 评审 Slack 自然度(5 分制,2 分以下触发重写)。第六步 QA 生成:规则式与 LLM 式结合出题,输出问题、参考答案、2-5 步解题方案与代表性充分证据集;UNS 题由可答案题改动一个实体或条件生成并验证全库不可答。第七步三阶段 LLM 验证:独立求解器仅看引用证据作答并判断 knowable;比对候选与金标(容许等价措辞与合理舍入);全项目校验竞争答案、数字核验与答案泄漏,裁决为 pass/fix/drop。第八步人工盲验证:3 名标注者盲评 100 题(50 条 LLM 接受加 50 条 LLM 拒绝),LLM 接受题 100% 通过人工,29 条人工拒绝题全部被 LLM 拒绝,说明 LLM 验证与人类一致且更保守。
技术新颖性
技术新颖性体现在三点。第一,基准设计层面:Table 2 的六维对比(工作区、多模态、跨源冲突、时序冲突、不可回答性、真实文档奠基)显示本文是唯一全占的基准——EnterpriseRAG-Bench 缺多模态与真正的时序金标,CONFLICTS 有冲突但无工作区与多模态,MMLongBench-Doc 有多模态却无演化,LongMemEval 有时序但面向个人对话。第二,数据构造层面:把冲突内生于「错误—发现—纠正」事件脚本与「只增不删」的版本保留策略,而非事后插入对抗样本,保证了冲突场景在时间戳、访问权限、消息语气上的全局一致性;统计上 CR 题的平均证据数(跨源 2.23、时序 2.93 条)显著高于 ER 题(1.32-1.95),证明这种构造天然产生多证据难题。第三,评测分析层面:首次系统解耦证据召回与答案准确率——用同一语料在 $k \in \{10, 50, 100\}$ 与 2B/8B 两个检索器上做对照实验,证明 $\mathrm{Recall}@k$ 提升不必然带来准确率提升,指出瓶颈在证据整合推理而非检索本身。
实验结果
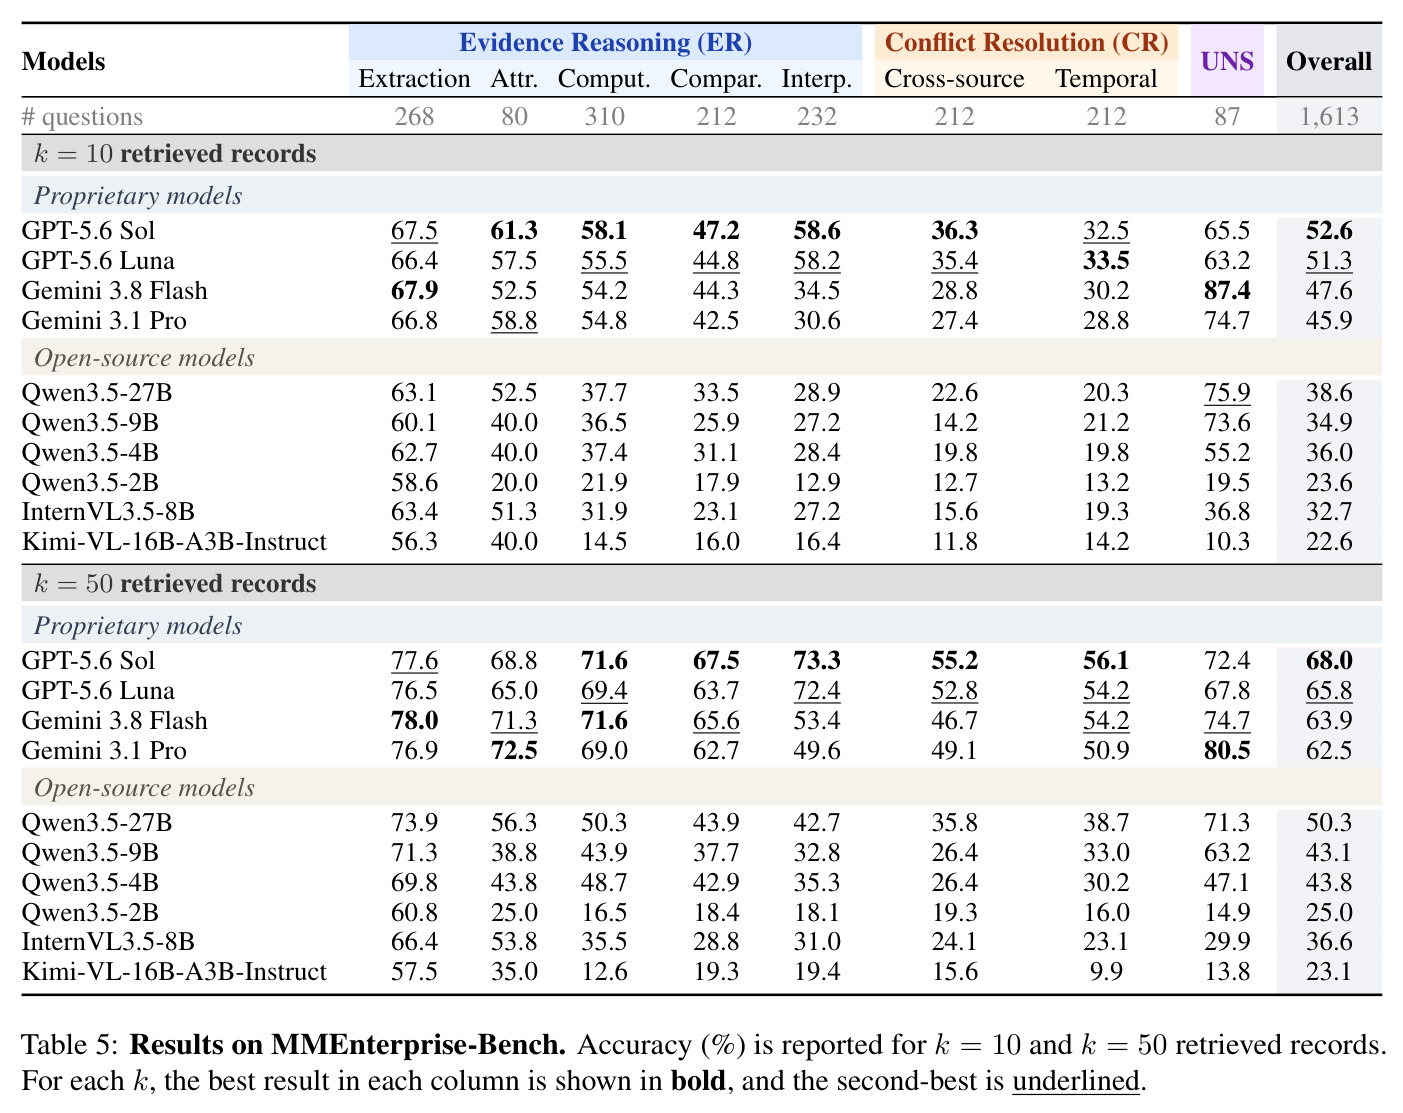
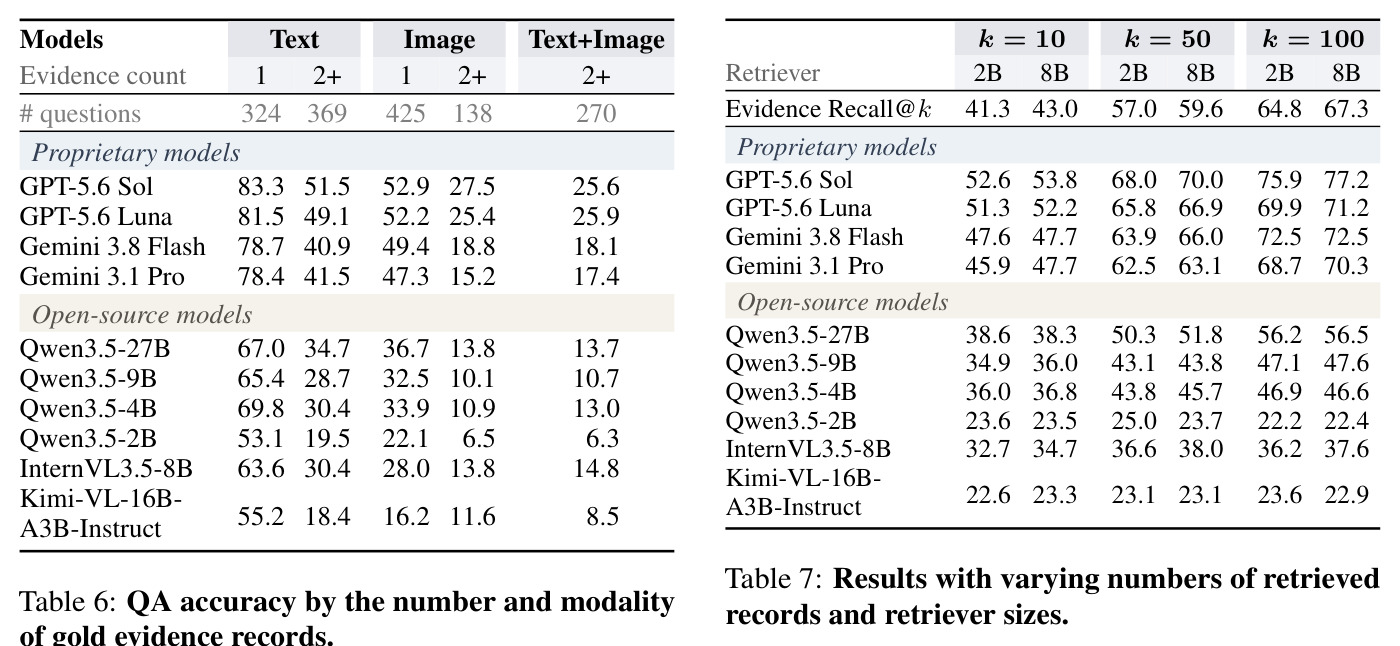
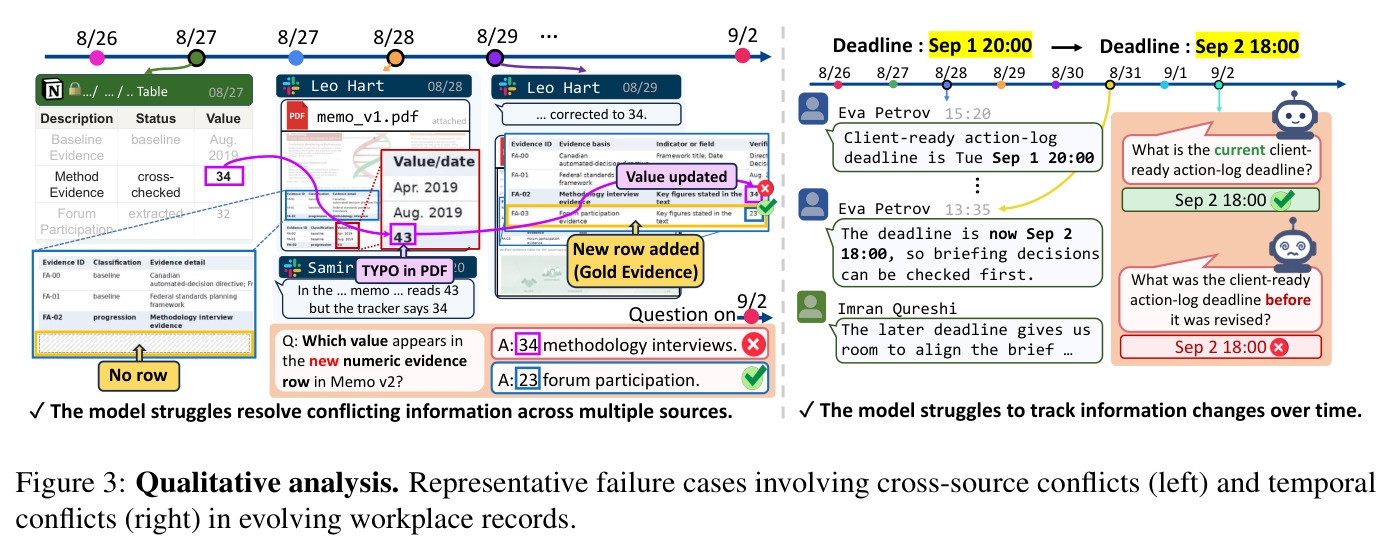
逐项看实验结果。第一,总体水平偏低:在 $k=50$ 下,最强的专有模型 GPT-5.6 Sol 仅 68.0%,GPT-5.6 Luna 65.8%、Gemini 3.8 Flash 63.9%、Gemini 3.1 Pro 62.5%;最强开源的 Qwen3.5-27B 只有 50.3%,与专有最优差 17.7 个点;$k=10$ 时全体更差(GPT-5.6 Sol 52.6%)。第二,冲突解决是重灾区:$k=10$ 下跨源冲突各模型仅 11.8%(Kimi-VL-16B)到 36.3%(GPT-5.6 Sol),时序冲突 13.2% 到 33.5%——即便最好的模型也远低于其在抽取题上的 67.5%。第三,不可回答性与总体能力脱钩:GPT-5.6 Sol 的 UNS 准确率只有 65.5%,不仅低于 Gemini 3.8 Flash 的 87.4%,甚至低于 9B 的 Qwen3.5-9B(73.6%),说明知道何时该拒答不是随规模自然增长的能力。第四,多模态多证据崩塌(Table 6):GPT-5.6 Sol 单条文本证据 83.3%,多条文本 51.5%;单图 52.9%,多图 27.5%,图文混合 25.6%——多图像题比单文本题低 55.8 个点。第五,检索提升不转化为准确率(Table 7):2B 检索器 $k$ 从 50 增到 100,$\mathrm{Recall}@k$ 从 57.0% 升至 64.8%,但 Qwen3.5-2B 准确率从 25.0% 跌到 22.2%;8B 检索器召回高 1.7-2.6 个点,GPT-5.6 Sol 在 $k=100$ 从 75.9% 升到 77.2%,Qwen3.5-4B 却从 46.9% 微降到 46.6%。第六,金标证据结构解释了难度来源:平均每题 1.94 条证据,时序冲突题平均 2.93 条、75.9% 需多条证据,证据时间跨度中位数 24.0 小时(35.8% 超 48 小时),54.6% 的可回答题证据含视觉记录,30.2% 跨多个来源类型。第七,定性失败模式(Figure 3):面对「43 修正为 34 且 memo 新增 23 行」的题,GPT-5.6 Sol 答了语境相近的 34 而非目标行的 23;面对截止日期从 Sep 1 20:00 改为 Sep 2 18:00,它能答当前值却在问历史值时答成修正后的值。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整体问答(k=50 检索) | 准确率 (%) | GPT-5.6 Sol 68.0 | Gemini 3.8 Flash 63.9;最强开源 Qwen3.5-27B 50.3 | 较次优专有模型 +4.1,较最强开源 +17.7 |
| 整体问答(k=10 检索) | 准确率 (%) | GPT-5.6 Sol 52.6 | Gemini 3.8 Flash 47.6;Qwen3.5-27B 38.6 | 较次优 +5.0 |
| 跨源冲突(k=10) | 准确率 (%) | GPT-5.6 Sol 36.3(最高) | 最低 Kimi-VL-16B 11.8;Gemini 3.1 Pro 27.4 | 全类别最弱,最佳模型也不到四成 |
| 时序冲突(k=10) | 准确率 (%) | GPT-5.6 Luna 33.5(最高) | 最低 Kimi-VL-16B 13.2;Gemini 3.1 Pro 28.8 | 最佳模型也不足 34% |
| 不可回答性 UNS(k=10) | 准确率 (%) | Gemini 3.8 Flash 87.4(最高) | 总体最强的 GPT-5.6 Sol 仅 65.5;Kimi-VL 10.3 | 总体冠军反而落后 21.9 个点 |
| 多图像证据问答(k=10) | 准确率 (%) | GPT-5.6 Sol 27.5 | 同一模型单条文本证据 83.3 | 下降 55.8 个点(负向) |
| 证据召回(k=100) | Evidence Recall@k (%) | 8B 检索器 67.3 | 2B 检索器 64.8 | +2.5,但 Qwen3.5-4B 准确率反而 46.9 降至 46.6 |
| 构建质量(人工盲验证) | 拒绝率 (%) | LLM 接受的 50 题 0/3 人拒绝(100% 通过) | LLM 拒绝的 50 题中 29 题(58%)被人工拒绝 | LLM 验证与人类判断一致且更保守 |
局限与改进
作者在 Limitations 中承认三点:语料来自 30 份公开文档的模拟,未必覆盖真实企业环境的全部特征;生成与验证依赖 LLM,可能残留错误(人工盲验只覆盖 100 题子集且由作者本人完成);基准高分不代表真实部署可靠,隐私、访问控制与人工监督仍不可少。我的独立观察还有几点:UNS 只有 87 题(占 5.4%)且全部由改动可答案题的单个实体或条件生成,模式单一,模型可能学到「换了个查询对象就拒答」的浅层捷径而非真正的证据充足性判断;评测 judge 是 GPT-5.6 Luna,与被评的 GPT-5.6 Sol/Luna 同家族,存在自家族偏好风险,论文未报告更换 judge 的敏感性实验;检索只用单一稠密检索器(Qwen3-VL-Embedding),未测 reranker、混合检索或 agentic 检索,「检索变好无用」的结论可能依赖于这一特定检索器;访问权限约束只用于生成阶段(决定谁在哪个频道发言),评测时模型能看到全部记录,权限感知问答未被测试;此外 30 个种子中至少 7 篇来自作者所在实验室自己的论文,领域分布偏向计算机视觉论文与美英政府报告。
独立分析的弱点
独立分析五个弱点。第一,UNS 维度太薄:仅 87 题且构造方式单一(替换实体),真实部署中证据不足的形态远比换个查询对象丰富——证据部分过期、来源可信度未知、单位不一致等;改进方向是引入对抗性多类型 UNS(部分支持、时效过期、前提矛盾各占一定比例)并扩到数百题规模。第二,judge 单点依赖:全程用 GPT-5.6 Luna 评分,对同家族专有模型可能存在风格偏好;改进方向是双 judge 交叉验证(如并用 Gemini 系 judge)并报告 judge 间一致率,或对随机子集做人工全量复核。第三,检索设置过于理想化:记录按时间戳排序后整包喂给模型,低估了上下文长度压力——单项目平均 8.88 万 tokens,$k=50$ 时弱模型未必能有效利用全部检索记录,其准确率随 $k$ 下降正暗示这一点;改进方向是报告不同排序策略(最新在前或相关度在前)、上下文压缩与长上下文消融。第四,冲突类型以数值被修正为主:剧情模板集中在错误—纠正与截止日期变更,缺少两个来源各自部分正确需合并、精度不同的等价表述等更细粒度的冲突语义;改进方向是为 CR 增加冲突类型标签并分类报告成绩,帮助诊断模型究竟败在哪一类冲突。第五,语料规模偏小(7,140 条记录、约 266 万 tokens),检索难度可能低于真实企业级语料库;改进方向是用同一 pipeline 扩展到数百个项目并测试规模效应。
未来方向
作者的结论指出:提升检索并不必然提升回答,需要能对多模态证据与演化记录状态进行推理的模型,MMEnterprise-Bench 将作为开发可靠企业助手的测试床。基于此可延伸的方向包括:冲突感知检索与重排序——把同一事实的多个版本作为检索单元分组,让模型显式看到版本链而非离散记录;时间感知索引——为每条记录引入 valid time(事实有效时刻)与 transaction time(记录写入时刻)双时间轴,精确支持 as-of 查询;拒答校准——把 UNS 扩展为带置信度的弃权目标,研究为何总体能力强的模型(GPT-5.6 Sol 65.5%)反而不如 Gemini 3.8 Flash(87.4%)会拒答;多智能体检索—核对流水线——让检索器、视觉读取器、冲突仲裁器分工协作,直接针对跨多图像崩塌(27.5%)的问题;以及把基准扩展到权限感知评测(谁能看哪条记录)与会话中途的在线演化更新,进一步逼近真实部署形态。
复现评估
复现难度总体中低,资源友好。基准本体:代码与数据已在项目页开源(https://mlvlab.github.io/MMEnterprise-Bench/),语料基于 CC BY 4.0、Public Domain、OGL 3.0 等明确许可的公开文档构建,附录 A 列出全部 30 个种子的来源与权利信息。评测复现:协议简单——Qwen3-VL-Embedding-2B 检索 top-$k$($k \in \{10, 50\}$),记录按时间戳排序,temperature 0;开源模型用 vLLM 0.24.0(bfloat16)即可运行,2B-9B 模型单张工作站 GPU 可承受,27B 约需多卡或 A100/H100 级别;专有模型走 API;judge 依赖 GPT-5.6 Luna API。数据构建复现:附录 B 公开了从源提取、组织构建、事件调度到 Slack 与报告生成的全部 prompt 模板,附录 C 公开验证 prompt,工程上可照搬;但完整重建语料需要大量 LLM API 调用(每个项目 203-274 条记录)与人工盲验环节(作者由作者本人完成、未招募外部标注者),第三方从零复现到题级一致较难;直接使用发布数据做评测则门槛很低,适合作为即取即用的测试床。
论文图表
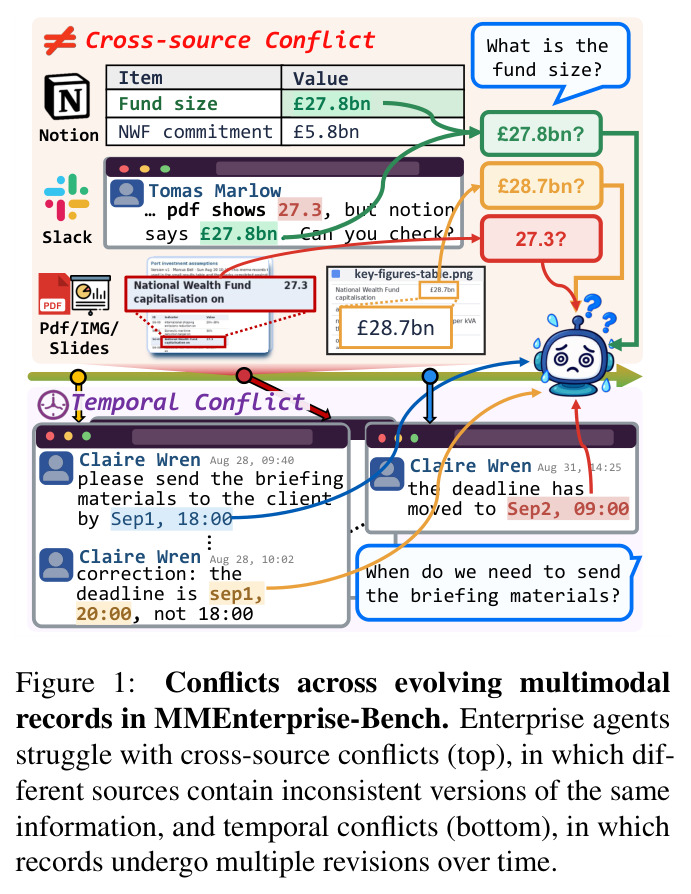
展示两类冲突的真实样例:上方跨源冲突中,PDF 显示基金规模 £27.3bn,Slack 消息确认修正为 £27.8bn,而 Notion 记录仍保留旧值,三个来源同框对比;下方时序冲突中,Claire Wren 先在 8/28 09:40 要求 9/1 18:00 前发送材料,随后在 10:02 更正截止时间为 9/1 20:00,两条消息都保留在记录中。
一图讲清本文问题设定的核心——同一信息的多版本共存于多模态来源,是理解跨源冲突与时序冲突两大类别定义的最快入口。
按(单条或多条)乘(纯文本、纯图像、图文混合)证据类型的准确率矩阵($k=10$):GPT-5.6 Sol 单文本 83.3、多文本 51.5、单图 52.9、多图 27.5、图文混合 25.6;Gemini 3.1 Pro 多图 15.2;各开源模型同样一致退化,Kimi-VL 多图仅 6.5。
定位失败根源在多记录整合与视觉证据处理,「证据结构决定难度」的直接证据,解释了 CR 类低分的机制。