Argo-Bench:面向企业级工作流的数据 Agent 评测基准 Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
构建模拟外卖平台的235表ERP仓库,按行动后果评测数据Agent,最强模型仅解决34.8%
前置知识
数据 Agent 与 Text-to-SQL 基准
数据 agent 是能在数据仓库中多步推理、执行统计分析并采取业务行动的 LLM 系统;text-to-SQL 只要求把自然语言翻译成一条 SQL。Spider 2.0 与 BIRD 是最知名的 text-to-SQL 基准,用 gold SQL 或 gold 答案对比评分。Spider 2.0-Snow 的最佳成绩已从发布时的 23.8% 涨到 96.7%,BIRD 达 82.4%(人类 93.0%),表面上看企业数据工作已接近解决。
本文的核心论证是这类基准已饱和且不能代表企业数据工作,理解它们的评分方式与局限才能明白 Argo-Bench 每个设计决策的针对性。
ERP 系统与 Oracle E-Business Suite
ERP(企业资源计划)系统保存公司的总账、工资、客户与供应商记录,典型如 Oracle EBS、SAP S/4HANA。在 ERP 仓库中一个业务事件(一笔订单)会触及十余张相互勾稽的表,不同模块必须对同一数字达成一致。Oracle 提供 EBS 12.2 Vision 演示环境,数据字典公开可查,因此自建 schema 可被独立验证。
Argo-Bench 的仓库就是 Oracle EBS 12.2 格式:235 张表的命名约定与跨表勾稽关系是任务难度的核心来源,不懂 ERP 的组织方式就看不懂任务为何难。
以模拟器作为 ground truth
当真实数据因隐私无法公开、或关键标签(如从未被发现的欺诈)根本不存在时,可以先模拟一个完整业务世界,再从模拟器内部状态直接读出答案。Synthea(合成病历)、PaySim(洗钱检测)是先例。关键设计是'解题难于验证':仓库刻意不包含潜在状态,只有 grader 能读到它。
这是本文评分体系的根基:答案键由模拟器生成并在任何运行前冻结,而不是标注员解题得到,从机制上消除了标注错误这一老基准的顽疾。
加权区间得分(WIS)
WIS 是流行病学预测的标准评分,同时评价点预测和区间预测的质量,且是 proper scoring rule——报出真实的中位数和统计最优的区间才能期望得分最高。本文把提交的分位数 $q$ 和真实值 $y$ 经 $g(v)=\operatorname{asinh}\left(\frac{v-r}{s}\right)$ 变换后按 $100\left(1-\frac{\mathrm{WIS}}{W}\right)$ 打分,定标常数 $W=0.623$ 是参考预测自身 WIS 的中位数,完美预测得 100,与参考一样差得 0。
72 个预测任务全靠它打分;理解其 proper 性质才能看懂'模型名义 80% 区间实际只覆盖 44.8%'意味着模型在期望意义上白白丢分,而非评分不公平。
三边市场与最低工资冲击
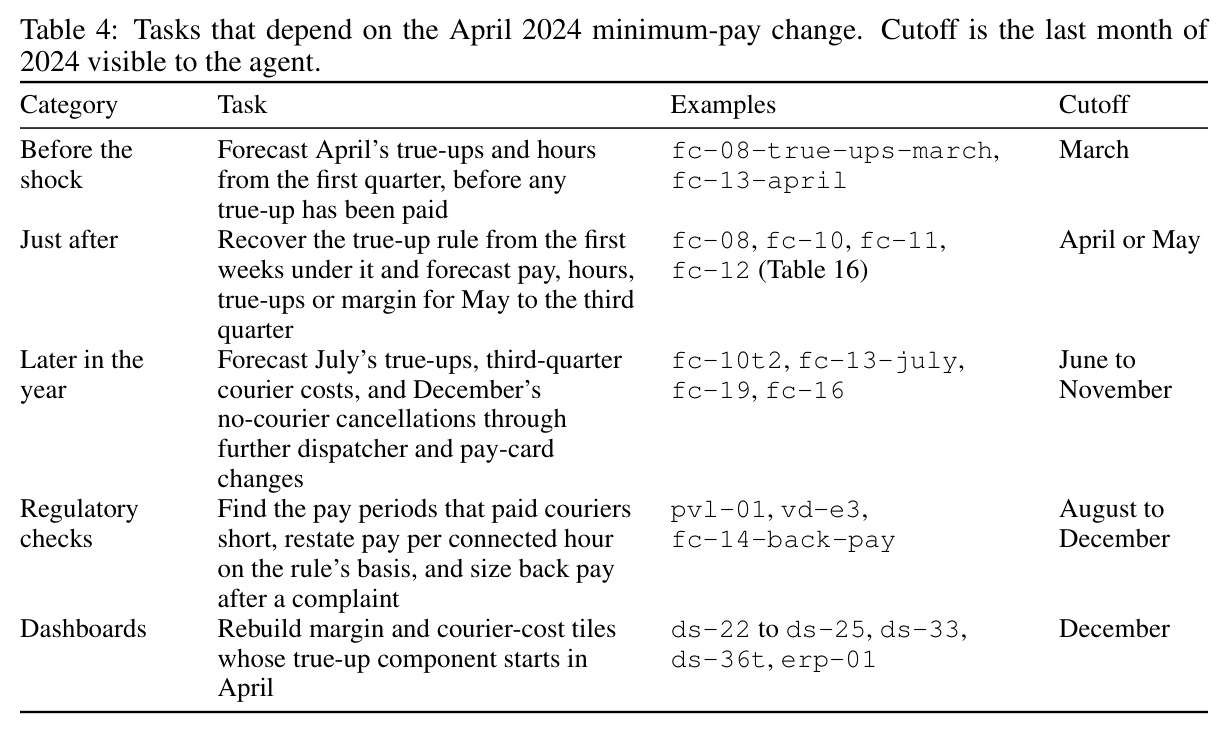
外卖平台是骑手—客户—商家三边市场:用 quest 奖励与建议薪酬调度骑手供给,用促销和 surge 定价调节需求,与商家联合出资活动。2024 年 4 月 1 日 NYC 把 App 送餐员最低时薪从 $17.96 提高到 $19.56(税前、不含小费),平台被迫改用新调度器,并对每周薪酬不足者以 true-up 补足。
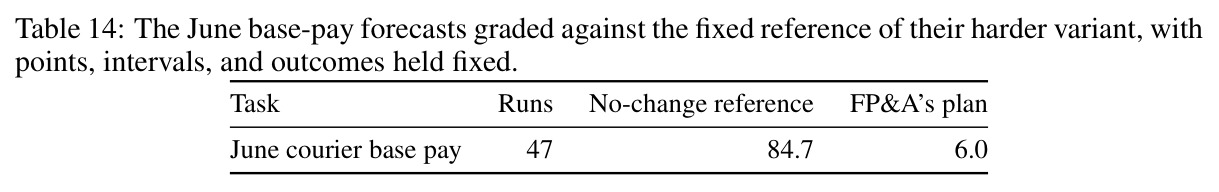
这一真实外生冲击打破了序列的平稳性,使简单的 no-change 预测失效,是预测、合规检查(找回少付周薪)和仪表盘重建任务的出题核心。
研究动机
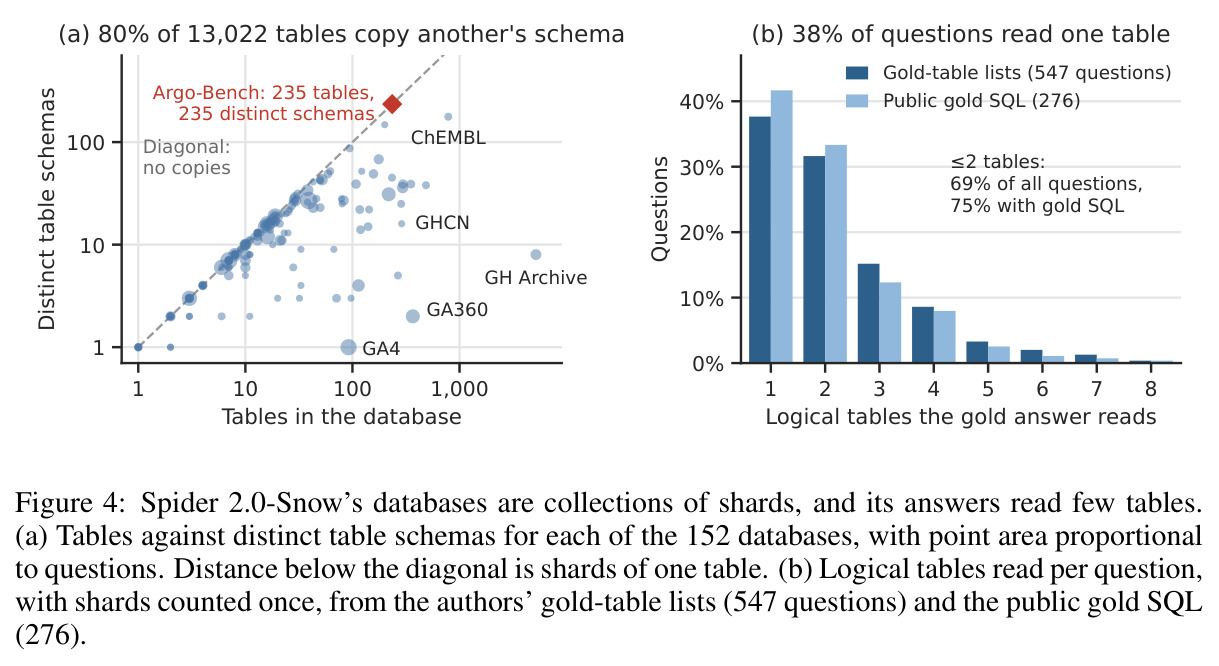
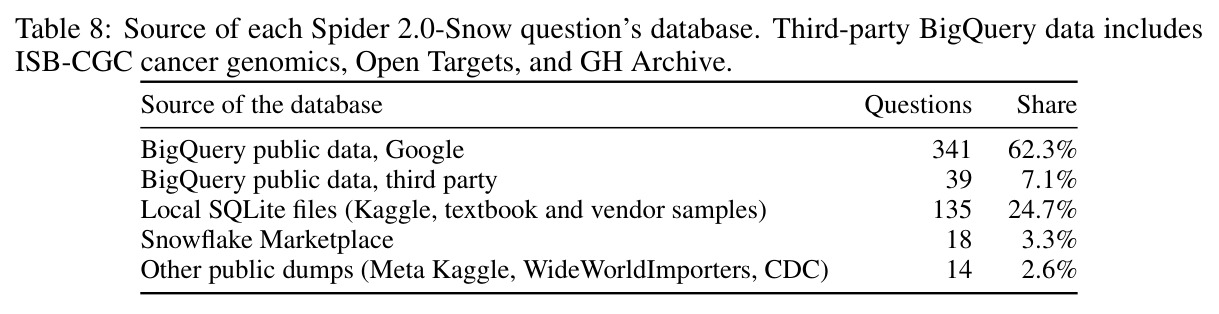
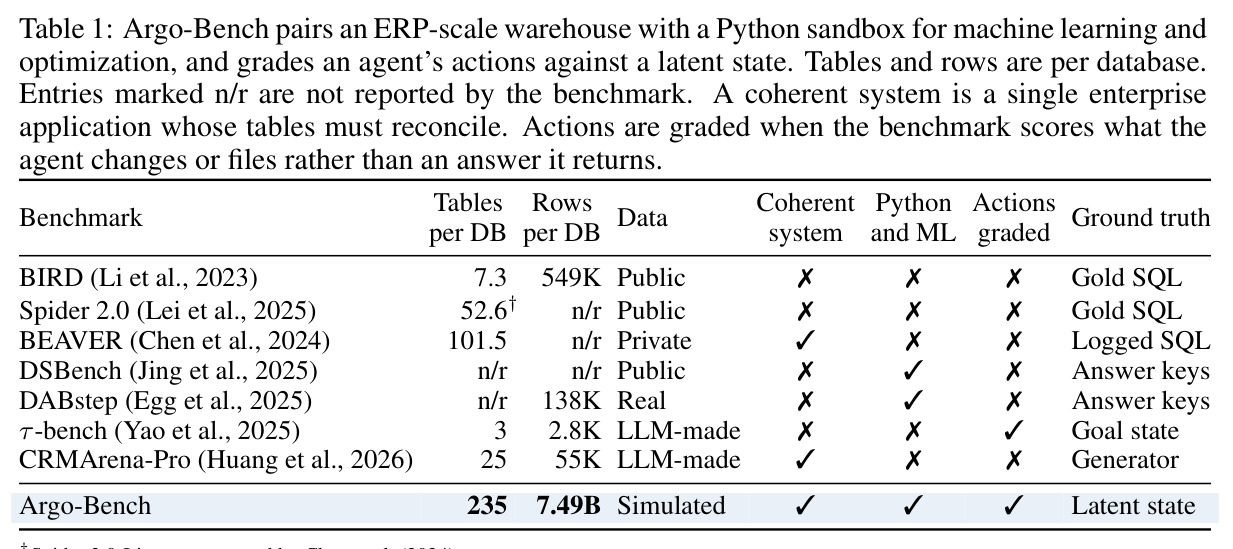
现有数据基准看似接近解决,实则与企业数据工作严重脱节。Spider 2.0-Snow 的最佳成绩从发布时的 23.8% 涨到 96.7%,BIRD 达 82.4%(人类 93.0%),但它们评测的只是 SQL 生成,问题出在三方面。第一,数据是公共数据集的拼凑:Spider 2.0-Snow 的 547 个问题稀疏地散布在 152 个数据库上,超过三分之一的数据库只被用来出过一道题,三分之二的问题用 BigQuery 公共数据集,且至少三分之二的表是日期、地理或版本的分片副本——而真实企业仓库中一个业务事件会触及十余张相互勾稽的表(Plattner, 2014)。第二,不通端到端:拟合需求预测、训练欺诈模型、优化骑手排班都需要统计、机器学习和优化库,SQL 根本做不了;而且发现要落到决策,决策最终由投资回报评判——高核销率的促销如果大部分订单本来就会发生,照样亏钱,gold answer 无法区分这种决策。第三,不可验证:审计发现 Spider 2.0-Snow 62.8%、BIRD Mini-Dev 52.8% 的 gold query 有错,多为标注员误读数据或 schema,纠正 BIRD 的错误使排行榜名次最多变动 9 位。更根本的是,未被发现的欺诈不会留下标签,被否决决策的结果永远观察不到——最有价值的任务上 gold answer 根本不存在。而真实 ERP 数据因隐私无法发布,匿名化又会破坏答案依赖的关系结构:BEAVER 的早期发布中就出现主键违反唯一性约束、部分问题 gold query 为空的问题。
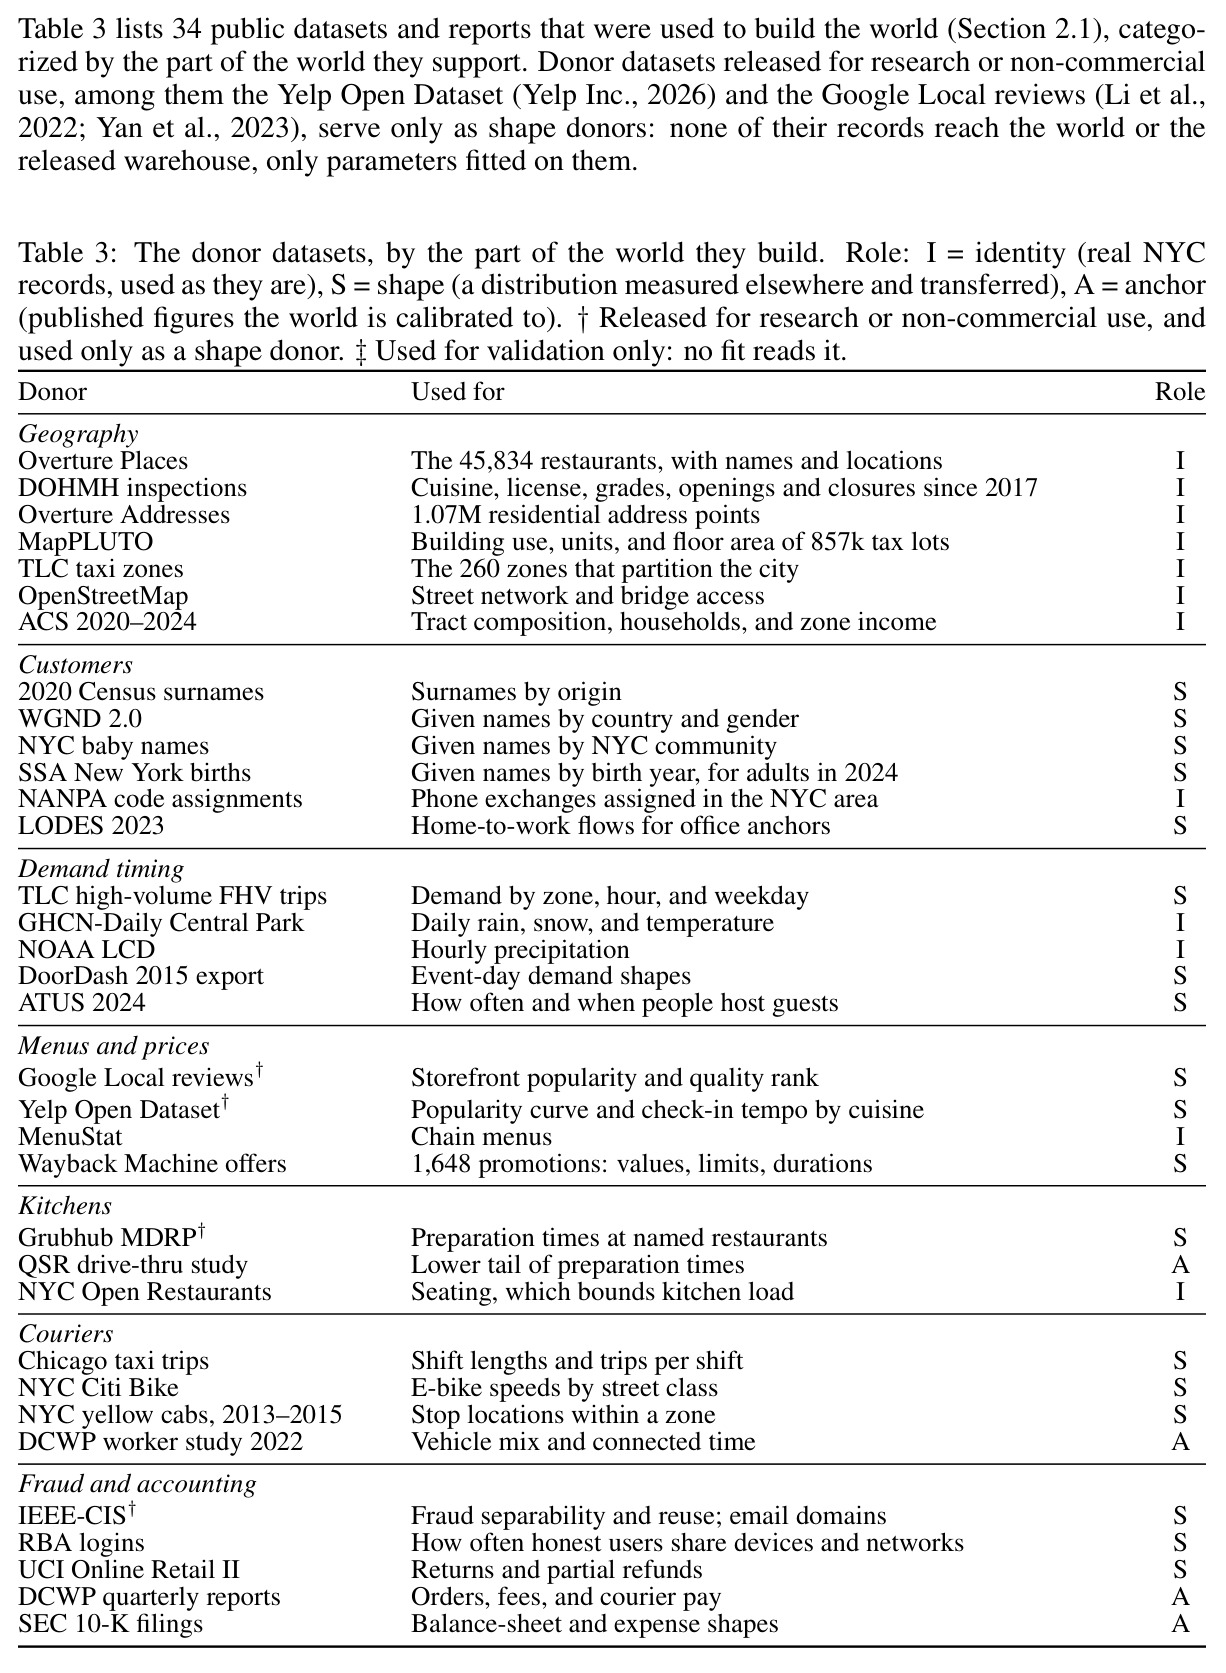
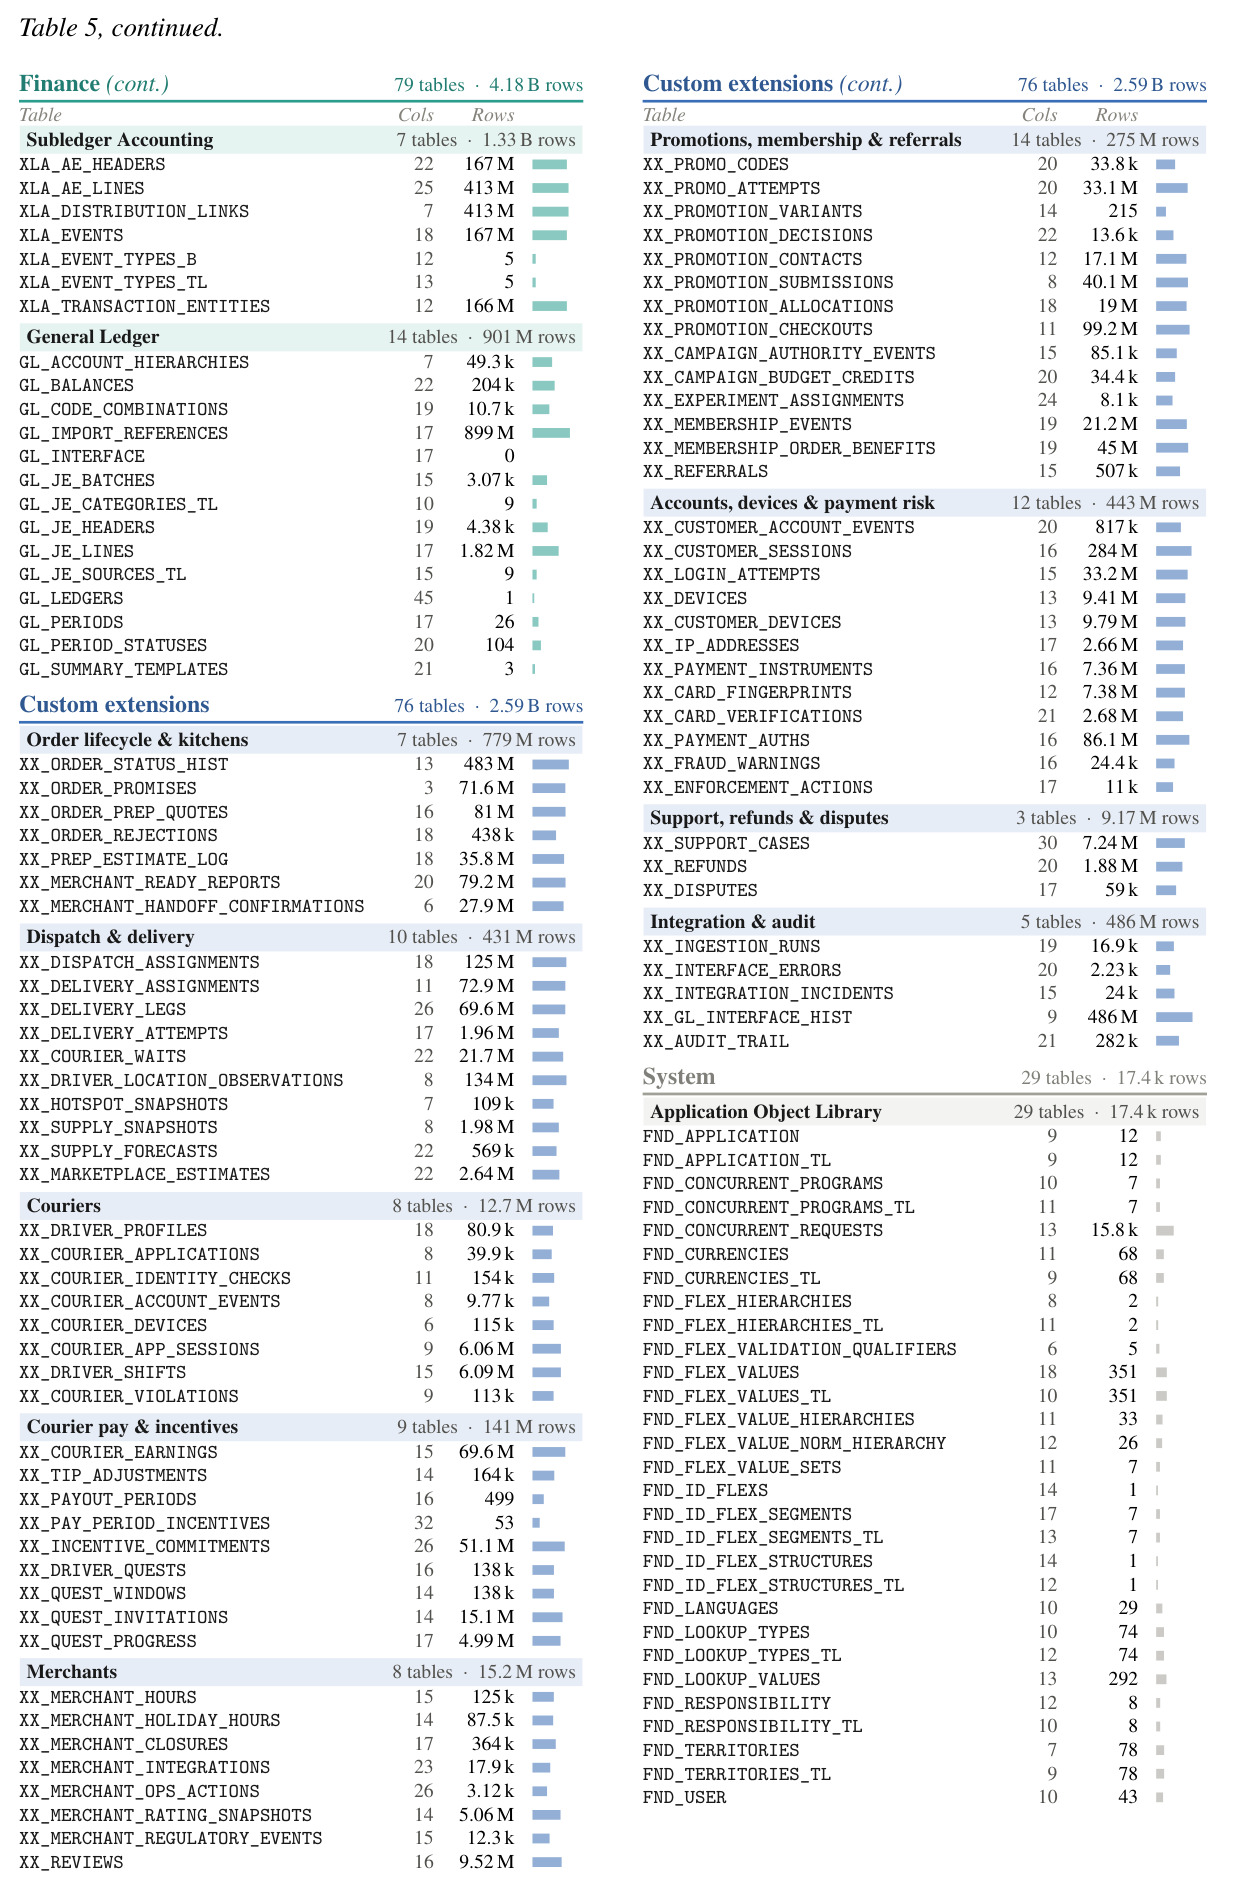
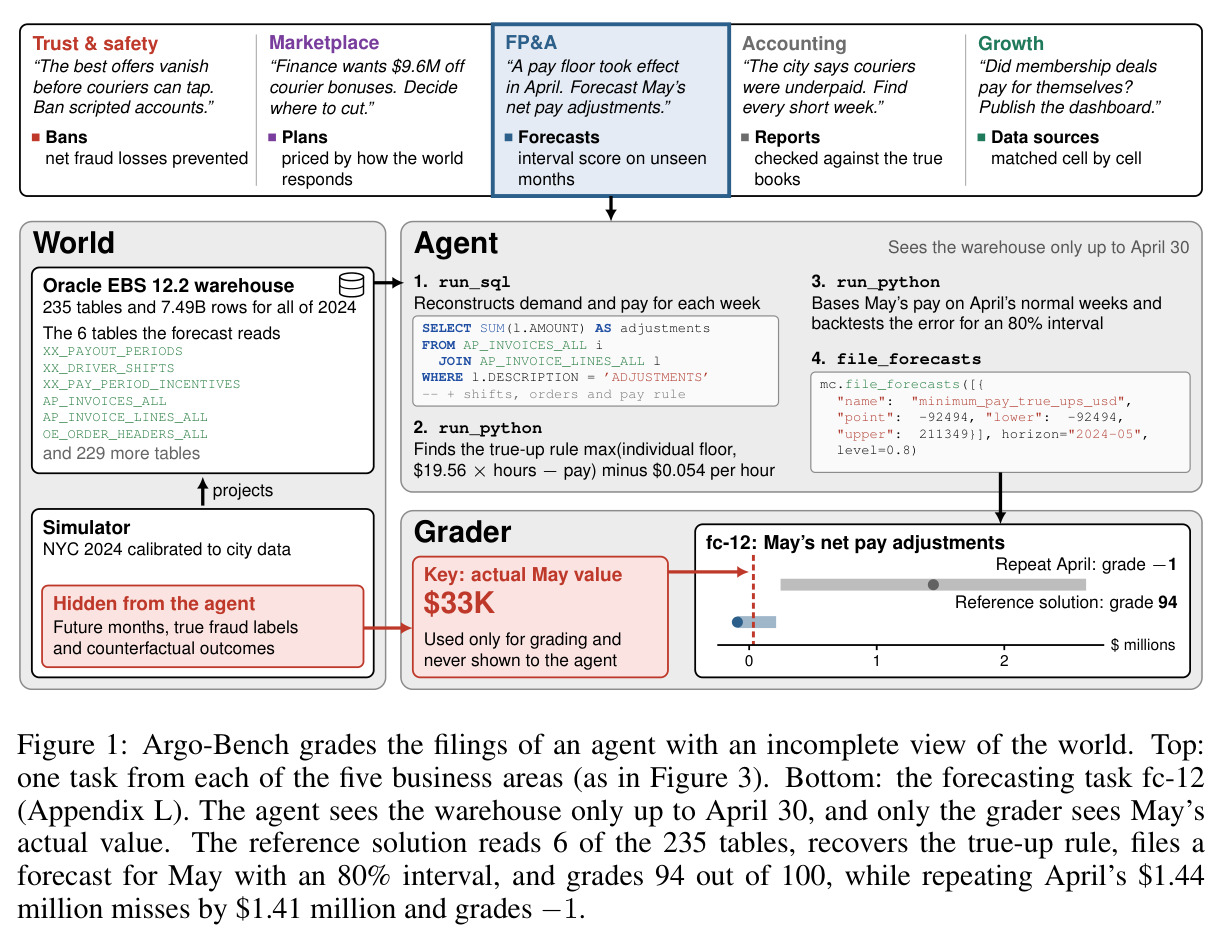
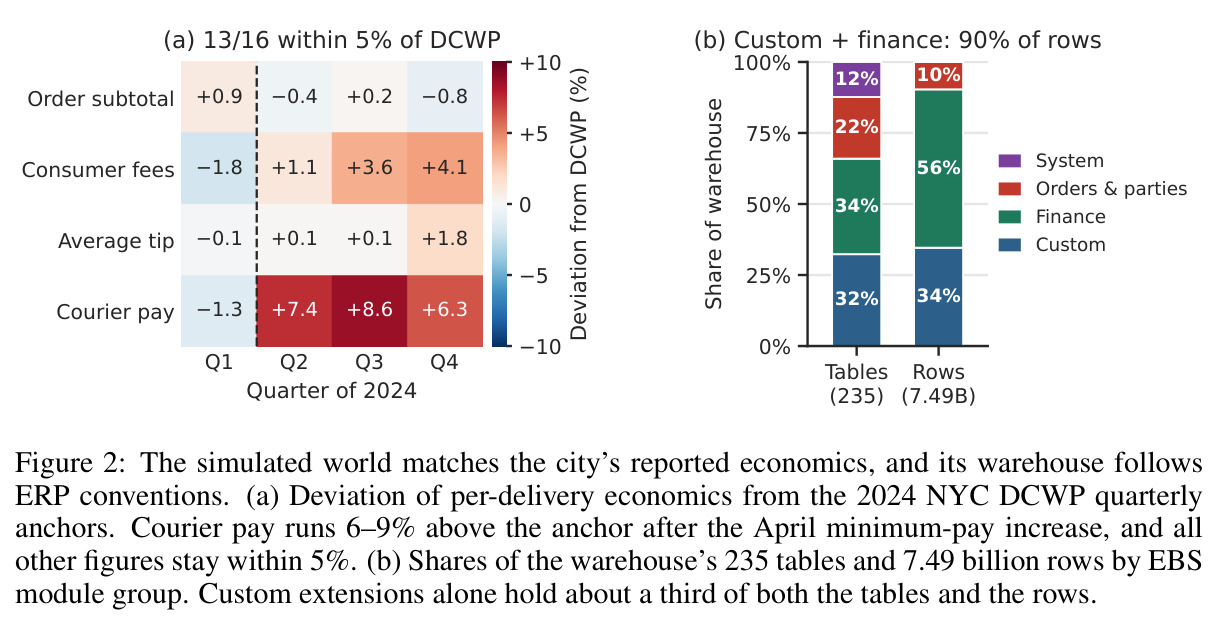
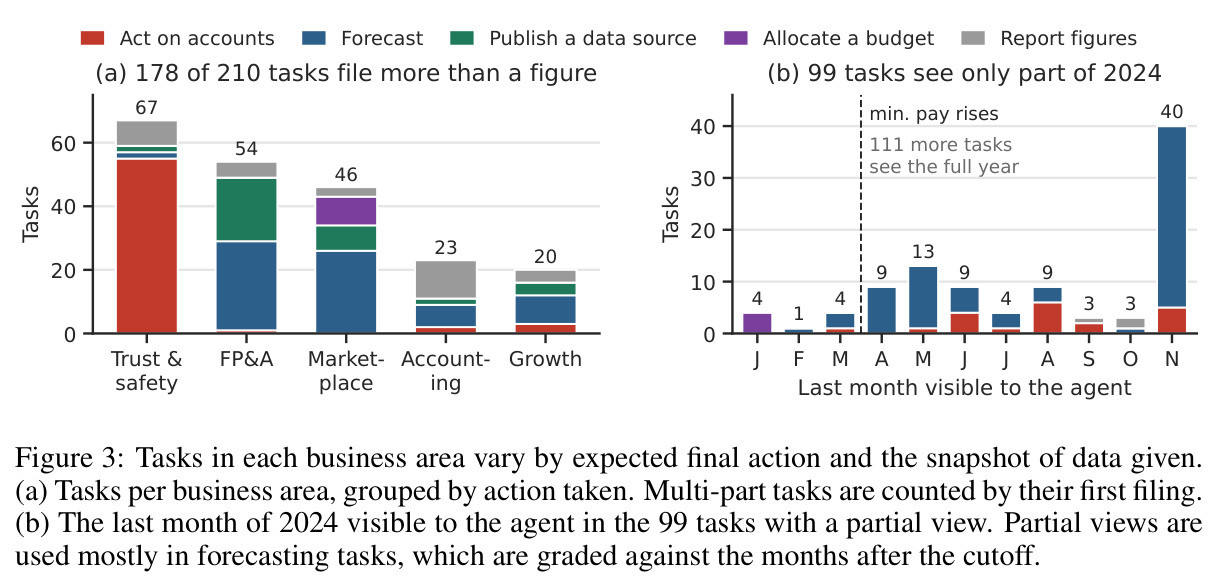
本文的目标是本文的目标是构建一个既有企业级数据复杂度、又有无争议 ground truth 的数据 agent 评测框架。具体做法分三步:先模拟一个 2024 年纽约市外卖平台的完整商业世界——8100 万订单、340 万活跃客户,经济指标校准到 NYC 消费者与劳工保护局(DCWP)的季度披露,16 项季度对比中 13 项偏差在 5% 以内;再把这个世界投影成 Oracle EBS 12.2 格式的 ERP 分析仓库,235 张表、74.9 亿行、一个订单解析为派单决策、骑手薪酬、商家打款和平衡的总账分录。在此之上定义 210 个数据科学与分析任务,覆盖信任与安全、FP&A、市场、会计、增长五类业务领域,其中 178 个任务要求 agent 提交业务动作而非仅返回数字,99 个任务只给截止月份之前的数据。每个任务配有可执行参考解,证明只用仓库即可解出;评分完全由模拟器潜在状态按行动后果给出。最后用它测量 14 个前沿与开源模型,给出可比较的分数与失败模式分析。
与已有工作不同的是,本文的独特切入点是'先造世界、再投影、后按后果打分'。此前的工作要么在真实数据上出题(答案键不可靠、隐私受限),要么在模拟环境中检查状态(但成败状态对 agent 可见、或由 agent 在风格化游戏中直接改变,如 τ-bench、AppWorld),要么用 LLM 生成数据再以生成器为真值(CRMArena-Pro)。Argo-Bench 抓住了三个被忽视的点:其一,模拟器的潜在状态由模拟过程自然产生而非人工植入,且刻意不包含在 agent 可见的仓库里,使解题难于验证(Song et al., 2025);其二,企业仓库的表间勾稽本身就是被测能力而非需要绕开的噪音——agent 必须自己发现生产负载实际复用的那几十张表组合,这正是'理解和探索企业数据组织'的技能;其三,评分对象是 agent 提交的动作在模拟世界中的后果——封禁列表按其阻止的欺诈损失(含平台从未检测到的欺诈)减去误封收入损失来打分——这是首个把'表间一致的企业级仓库'与'后果评分'组合起来的基准。公开/私有双 world 的设计则从机制上堵住了记忆化刷榜。
核心方法
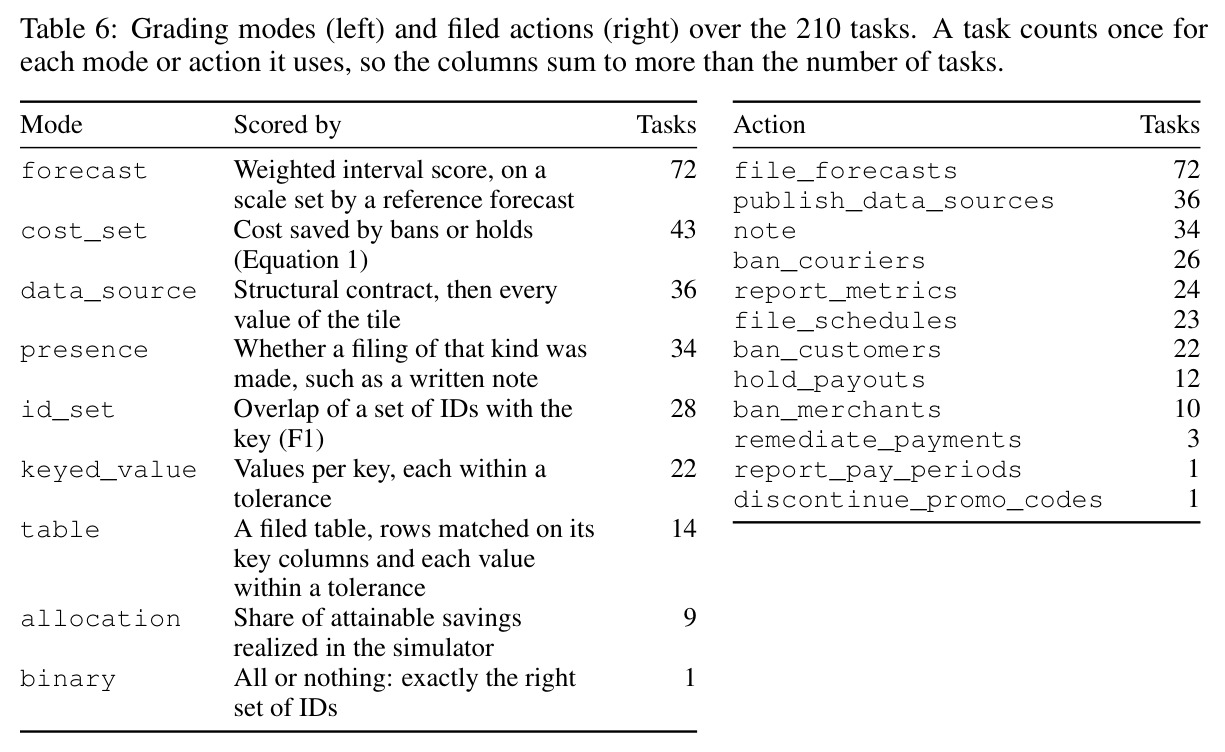
直觉上,Argo-Bench 把评测从'考试对答案'换成'沙盘推演后按战果记分'。评测者手里有一个正在运转的模拟公司,agent 是刚入职的分析师,只看得到 ERP 系统导出的数据仓库;它对世界做出的事实重建和业务动作,由知道'真相'的模拟器按后果打分。技术路线分三步。第一步世界模拟:以 34 个公共数据集为原料——Uber/Lyft 行程给出区间行驶时间、TLC 行程给出各区各时段的需求分布、MenuStat 给出连锁菜单、IEEE-CIS 给出欺诈可分性——按 identity(真实实体照搬,如全市 45,834 家餐厅、107 万地址、260 个出租车分区)、shape(只借分布)、anchor(校准目标)三类注入,校准到 DCWP 季度报告与 DoorDash/Grubhub 10-K 财报,并注入七类欺诈模式与 2024 年 4 月 1 日最低时薪 $17.96→$19.56 的真实冲击。第二步仓库投影:把世界导出为 Oracle EBS 12.2 格式,235 张表、74.9 亿行,每张标准表和列都存在于 Oracle Vision 数据字典。第三步任务与评分:210 个任务、五个业务领域,agent 在无网络的 gVisor 沙箱中用 Python 分析(预装 25 个统计/ML/优化库,上限 500 模型轮),通过 mission-control 接口提交动作,九种评分模式全部由模拟器潜在状态驱动。
核心创新是'潜在状态与可见仓库的分离 + 按后果评分'。传统基准的答案键要靠标注员解题来写,而审计显示标注员经常写错;Argo-Bench 的答案键来自模拟器内部状态——既可以在任何运行之前用 SQL 在潜在表上一次性算出并冻结,也可以直接读模拟器的标签(哪些骑手被设定为偷单者),因此标签精确且无需匿名化。仓库被刻意构造成不包含这些潜在事实,agent 必须跨表导航、从间接证据重建事实,而 grader 直接读状态。后果评分让许多无法用 gold answer 表达的任务变得可判:一份封禁列表按其阻止的欺诈损失计分,包括平台自己从未检测到的欺诈,再扣除误封忠诚客户造成的收入损失;一份预测按其在未见月份上的加权区间得分计分;一份骑手奖金预算按模拟器实际兑现的可行节省份额计分。这本质上是把 benchmark 的评判标准从'答案对不对'升级为'决策的 ROI'。同时 filing(提交动作)是显式的意图声明——对比 SQL 结果时难以判断接近的数字是答案还是中间结果——使部分得分良定义,且完全避免了 LLM-as-a-judge 的主观性。
方法步骤详情
完整流程如下。第一步,模拟器从 34 个 donor 数据集生成 2024 全年世界:8100 万订单(约为 App 上报的 1.48 亿次配送的 55%,按主导平台规模设定)、340 万活跃客户,三边市场各自平衡(骑手侧 quest 与建议薪酬、客户侧促销与 surge、商家侧联合出资活动),每单解析为派单决策、骑手薪酬、商家打款和平衡的总账分录。第二步,注入欺诈:骑手偷单、GPS 欺骗、bot 抢单、账号出租;客户新账号薅促销、盗卡与 bust-out;店面壳公司、合谋退款、篡改银行账户转移打款。每种模式按真实欺诈的可分性与诚实用户共享设备/地址/卡片的比例校准,因为后者决定检测器的精度上限。第三步,与三位 14-31 年经验的 ERP 顾问设计 schema,把世界投影为 Oracle EBS 12.2 分析导出:159 张标准表隶属 15 个 Oracle 产品(平均携带 Vision 对应表 52% 的列,省去本业务不用的弹性域和功能列),76 张 custom 扩展表占约三分之一的表数与行数。第四步,定义 210 个任务,每题含 prompt(以利益相关者口吻描述问题,平均 159 词,风格与详略各异)、scope(agent 可见的最后月份,99 题只见部分年份)、expectations(要求的 filing、键与评分模式)、answer key(提前从潜在表 SQL 或模拟器标签冻结)。第五步,agent 在 gVisor 沙箱中用 run_sql/run_python 探索分析,经 mission_control.py 提交 26 类动作(ban_customers、file_forecasts、publish_data_sources、post_journal_entries 等)。第六步,九种模式评分:预测报点与 80% 区间,经 $g(v)=\operatorname{asinh}\left(\frac{v-r}{s}\right)$ 变换后按 $100\left(1-\frac{\mathrm{WIS}}{0.623}\right)$ 打分,不提交记 $-200$;封禁按相对'不封'与'全封'的成本节省计分;预算分配按模拟器兑现的可行节省份额计分。
技术新颖性
与已有工作的本质区别在真值的来源与评分的对象。BIRD、Spider 2.0、BEAVER 对比 gold/logged SQL,答案键依赖标注员且已被证明大量出错;DSBench、DABstep 用答案键评分析结论;τ-bench、AppWorld 检查环境终态,但那些状态对 agent 可见、或由 agent 在小规模风格化游戏中直接改变;CRMArena-Pro 的 CRM 数据由 LLM 生成、以生成器为真值;AvalancheBench 用 LLM 评一个小型潜在电商世界的恢复程度;Era by Eon 为每个只读问题'种下'记录与近似干扰项。Argo-Bench 的潜在状态由模拟过程本身产生(而非植入),证据散布在 74.9 亿行、表间必须勾稽的 ERP 仓库中,agent 被评的是所提交动作在模拟世界中的后果而非返回的答案。工程上还有两处新意:一是双 seed 设计——公开一个 world 的仓库,官方排行榜用私有 seed 生成的另一个 world(两个 seed 共享模拟器与校准,但每个 ID、客户、餐厅、骑手都不同),杜绝记忆化刷榜;二是世界数据零 LLM 生成(唯一例外是公开仓库中欺诈店面的化名由 LLM 起草并经逐一核查),保证数据的机械可复现性。
实验结果
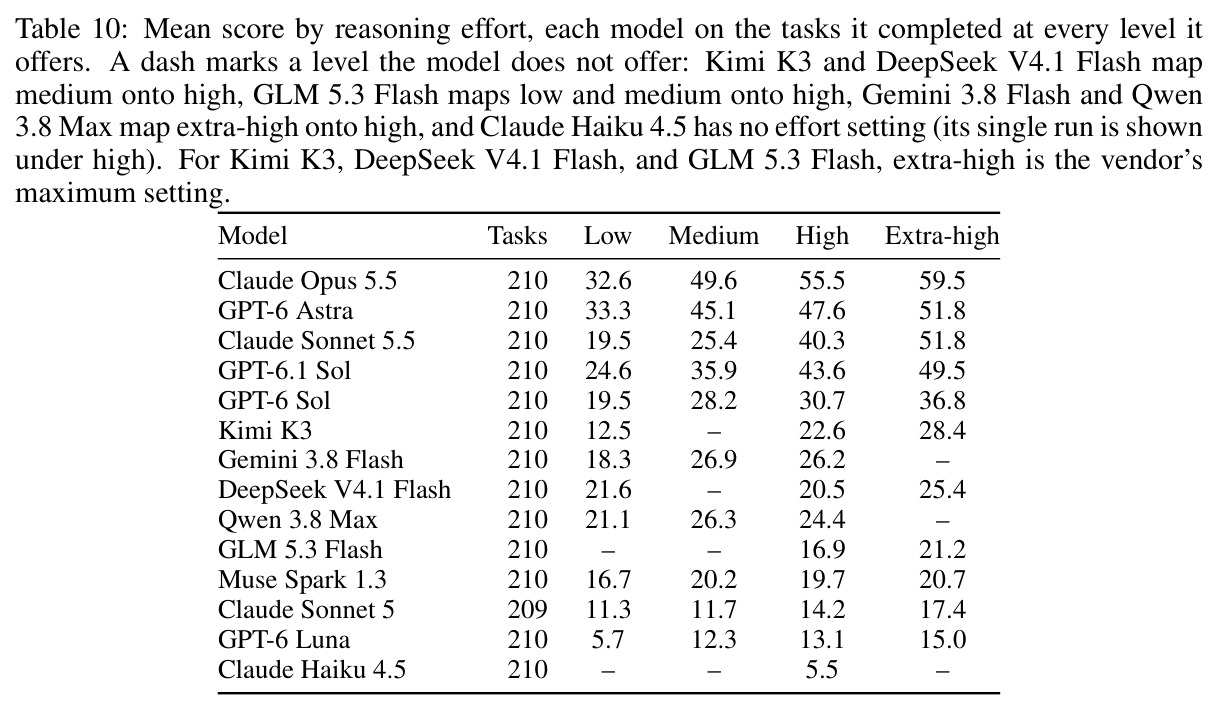
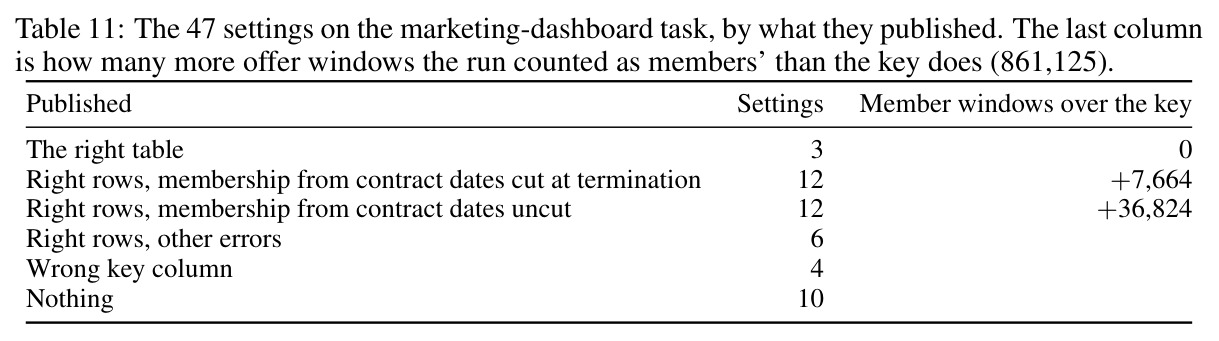
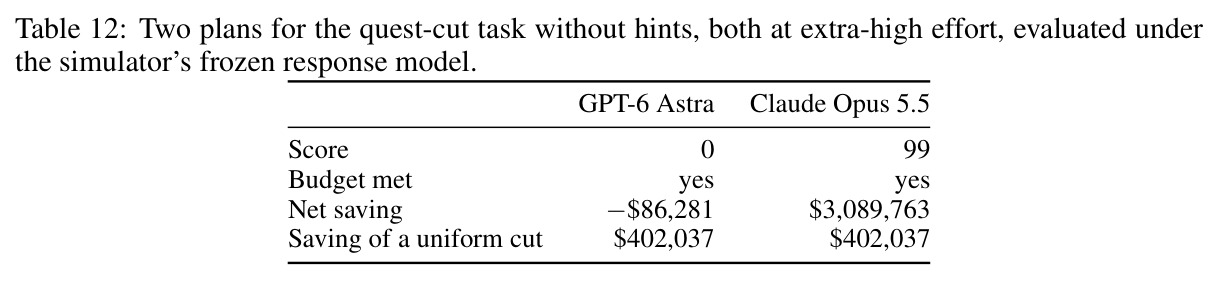
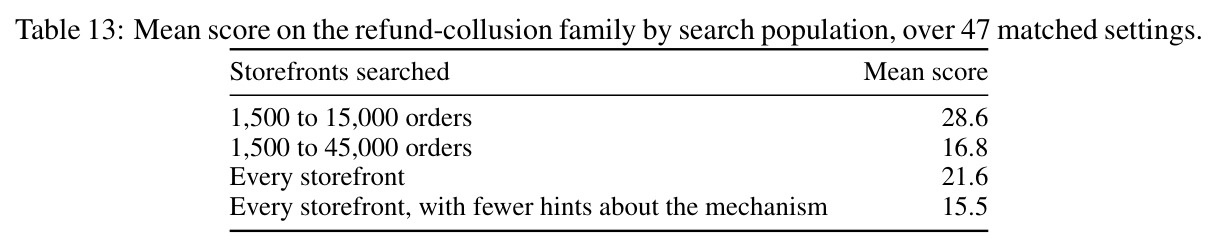
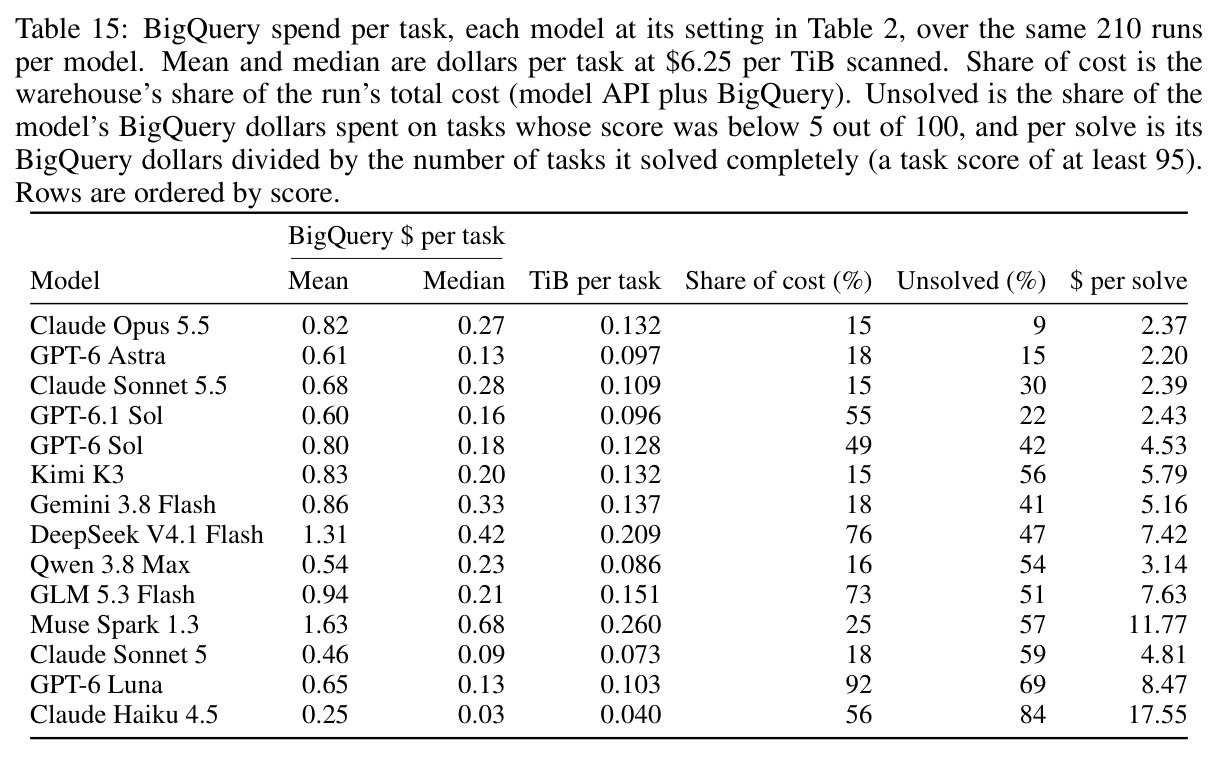
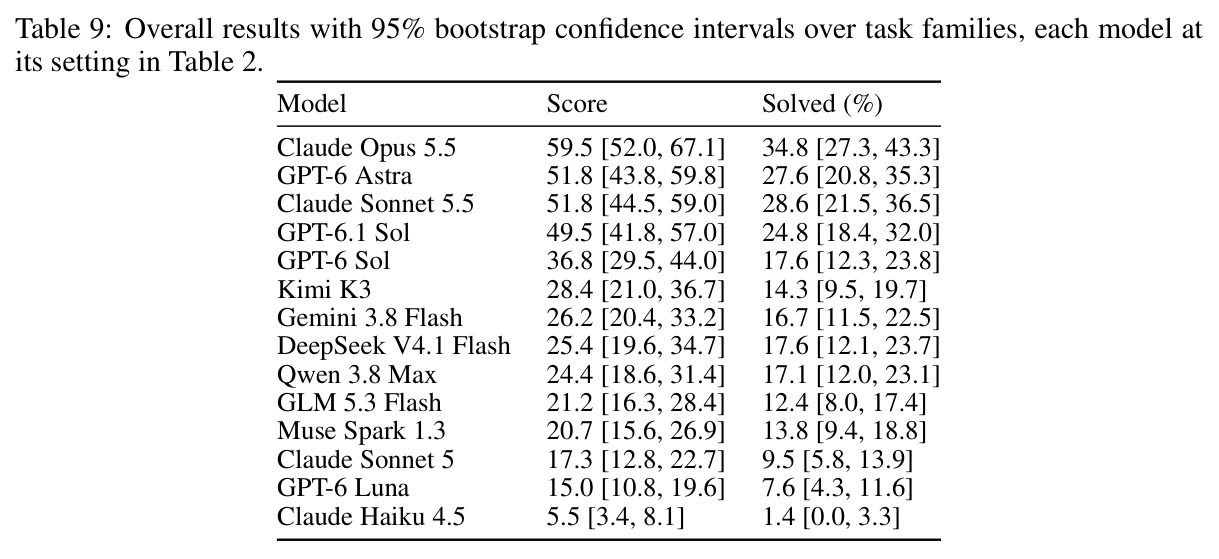
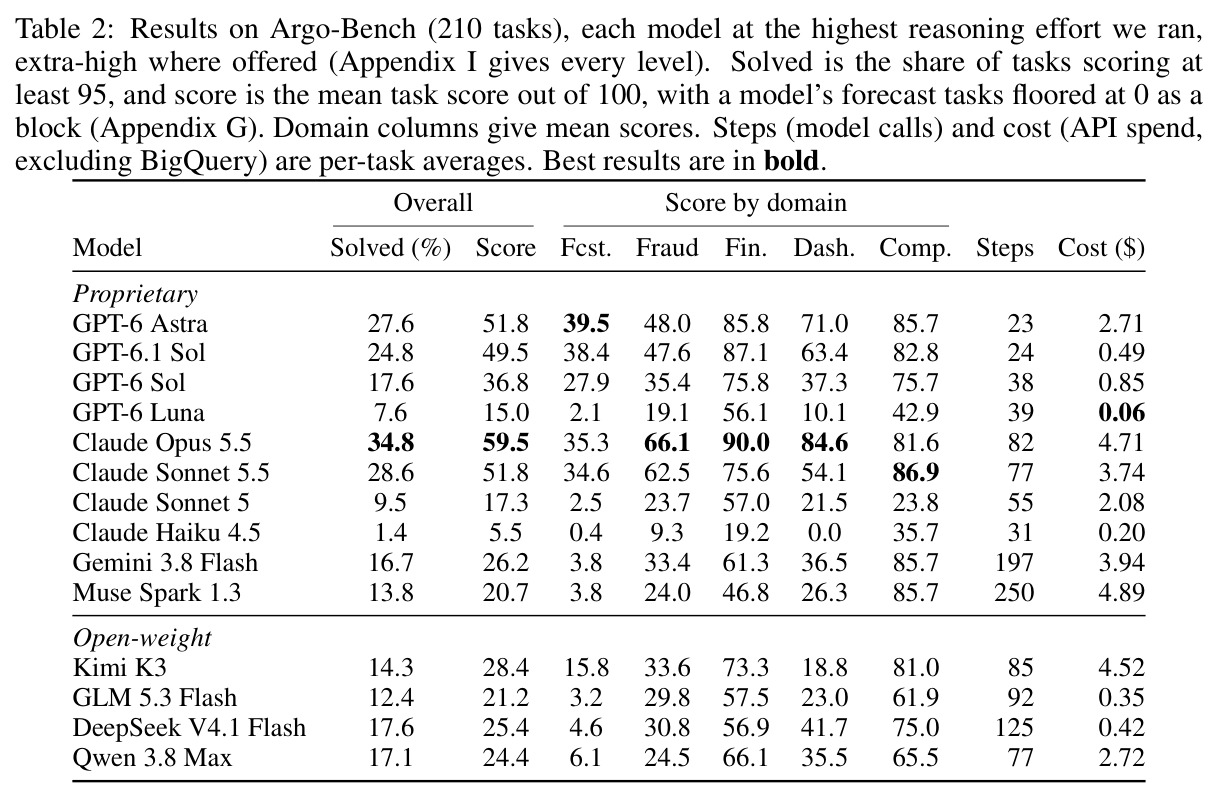
整体结果:Claude Opus 5.5 最强,在 210 个任务上解决率(得分≥95)34.8%、平均 59.5 分,在五个领域中的三个领先(欺诈 66.1、财务 90.0、仪表盘 84.6);GPT-6 Astra 以 39.5 领先预测,Claude Sonnet 5.5 以 86.9 领先合规。第二梯队(GPT-6 Astra、Sonnet 5.5、GPT-6.1 Sol,得分 49.5–51.8)与 Opus 按任务配对比较落后 7.7–10.0 分;14 个模型中有 9 个平均分低于 35。推理努力普遍有效但边际递减:Opus 从 low 到 medium 涨 17.0 分、medium 到 high 涨 5.9、high 到 extra-high 涨 4.0;Gemini 3.8 Flash 从 low 到 medium 涨 8.6 后不再有可检测的提升。效率差异惊人:Gemini 3.8 Flash 和 Muse Spark 1.3 平均每任务 197 和 250 次模型调用,是 Opus(82 次)的 2.4–3 倍却分数更低,且 Muse 57% 的仓库开销花在得分低于 5/100 的任务上;成本上 Opus 每任务 4.71 美元,GPT-6 Luna 仅 0.06 美元。失败模式分析最有价值,分三类。错记录:会员仪表盘任务中 24 个失败 run 从合同日期而非账单历史判定会员身份(会员卡被拒后有 7 天宽限期,但合同在账面上保留到数周后取消),其中 7 个其他数字全部正确到几美元;三个通过的 run 重放账单并对照实际享受会员权益的订单交叉验证,GPT-6.1 Sol 发现自己规则下 1,057 个矛盾订单后推倒重来。错目标:从 960 万美元年度 quest 预算决定削减位置时,GPT-6 Astra 用固定效应与部分池化估计供给响应、削减'quest 买到骑手小时最少'的区块,但 quest 的作用本是替代 surge pay,其方案在模拟中反而亏损 86,281 美元得 0 分;Opus 识别出替代关系、按'每奖金美元省下的 surge 最少'处削减,实现可行节省 312 万美元中的 309 万得 99 分;在提示中说明 quest 用途和 holdout 存在后,该族任务均分从 18.5 升至 61.7。错数量:骑手位置服务任务的 47 个完成 run 中 46 个错过全部 12 个月度计数(容差 1%),因为仓库只存每小时的 idle check-in 而应用实际每半小时上报一次。预测任务暴露系统性过度自信:4,553 个序列上名义 80% 区间的实际覆盖率仅 44.8%。仪表盘任务中 66.9% 通过结构契约的数据源在数值上得 0 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 企业级数据工作流(210 个任务) | 平均任务得分(满分 100,预测任务按块下限取 0) | Claude Opus 5.5:59.5 分 | 第二梯队 GPT-6 Astra / Claude Sonnet 5.5:各 51.8 分 | 按任务配对比较领先 7.7–10.0 分(95% CI 约 ±2–8 分) |
| 企业级数据工作流 | 解决率(得分 ≥95 的任务占比) | 34.8%(Claude Opus 5.5) | 旧基准近乎饱和:Spider 2.0-Snow 最佳 96.7%、BIRD 82.4% | 同一批前沿模型在新基准上仅解决约三分之一,14 个模型中 9 个平均分低于 35 |
| 骑手 quest 预算削减($9.6M/年) | 模拟器兑现的净节省 | Claude Opus 5.5:节省 $3.09M(可行上限 $3.12M,得分 99) | GPT-6 Astra:亏损 $86,281(得分 0) | 同一提示下对业务机制的认知差异导致 0 → 99 分 |
| 预测任务(72 个,4,553 个序列) | 名义 80% 区间的实际覆盖率 | 44.8% | 标称 80% | 低 35.2 个百分点——模型普遍过度自信,因评分是 proper 的而在期望上丢分 |
| 仪表盘数据源发布(36 个任务) | 通过结构契约的数据源中数值正确的比例 | 33.1% | 结构契约通过率 100%(入选条件) | 66.9% 的数据源虽过契约但数值得 0 分,暴露'形式对、数值错'的普遍失败 |
局限与改进
作者承认的局限:数据集只覆盖单一城市,因此没有外币及其交易/本位/报告三重表示;只模拟单一业务(真实复杂仓库常把外卖与杂货等多业务混在同一账户,如骑手应付账款和客户余额);只模拟一年(2017–2026 的历史会引入 2020–2022 年的市场冲击);只支持 Oracle EBS 一种格式(SAP S/4HANA 是自然扩展);模拟器仅验证 23 个指标,公共数据不约束的行为被排除在任务之外,其中会员程序的假设尤其薄弱;对聚合目标的校准不保证真实分布的尾部;每个设置每任务只运行一次、所有任务共享同一个模拟世界,因此置信区间只反映任务选择而非运行间方差;分数对 prompt 措辞敏感,附录承认有一个 prompt 作者自认为欠规范;计划类任务按模拟器冻结的响应模型评分。我的补充观察:grader 与模拟器不公开,意味着分数只有主办方才能计算,评测存在单点依赖,第三方无法独立复核排行榜;公开 world 与私有 world 只共享模拟器与校准,两个 world 的任务难度分布可能有系统差异;模拟器的响应模型(如 quest 对 surge pay 的替代关系)是建模者的选择,模型可能学会拟合模拟器假设而非真实世界规律;单次运行加措辞敏感性使第二梯队内部(49.5–51.8 分)的排名未必稳健。
独立分析的弱点
第一,单次运行与 prompt 敏感性叠加:quest 任务族仅加一句提示均分就从 18.5 涨到 61.7,而论文每个'模型×努力'组合每任务只跑一次,模型间 2–8 分的差距可能被运行噪声淹没。改进方向:每任务多次采样报中位数,并系统报告跨措辞方差,或对 prompt 做标准化改写消融。第二,模拟器假设与出题人假设同源:agent 得分高可能意味着它拟合了模拟器的响应模型(quest→surge 替代、调度器切换规则),换到真实平台未必成立——这正是论文自己引用 Leis et al. 提出的'生成器与被测系统共享简化假设会让任务变容易'的风险。改进方向:为同一世界训练多个参数不同的响应模型,汇报跨模型得分稳定性;或引入对抗性扰动(红队调整响应参数)检验稳健性。第三,评分闭环不透明:grader 私有使社区只能依赖主办方 best-effort 评分,长期能否形成开放、自治的排行榜存疑。改进方向:发布一套带噪声加扰的练习用 grader,或采用回合制新 seed 评测并公布统计摘要,让提交格式本身可验证。第四,分数未按计算预算归一:Opus 82 次调用、4.71 美元与 Muse 250 次调用、4.89 美元同场竞技,实践者难以判断性价比。改进方向:报告分数-成本帕累托前沿,并增设固定预算赛道。第五,每题一次运行也让 500 轮上限带来的'跑不完就零分'(如 Haiku 4.5 解决率仅 1.4%)与真实能力混在一起,应区分'能力不足'与'预算耗尽'两种失败。
未来方向
作者明确提出的方向:增加 SAP S/4HANA 投影以覆盖另一大 ERP 生态;把模拟历史扩展到 2017–2026,让 2020–2022 年的疫情与通胀冲击进入运营与预测任务;模拟多业务混合仓库(外卖与杂货共享骑手应付账款和客户余额),这是真实复杂 ERP 最显著的特征之一;加入外币交易的三重表示;为模拟器已验证的 23 个指标之外的行为开发任务。基于论文成果可以延伸的方向:把 wrong record / wrong objective / wrong quantity 三类失败转成诊断套件,指导数据 agent 系统设计——例如自动构建语义层、或强制模型对关键量做二次来源验证(通过者正是重放账单并交叉核对权益订单);针对 44.8% 的区间覆盖率问题,研究在 agent 工作流中显式做预测校准(先 backtest 再报告校准后的区间);把参考解与失败轨迹作为训练数据,研究长 schema 导航能力的学习;探索 agent 在数百张表中'探索多少、从哪里开始'的主动策略;甚至把开发期模型逃逸沙箱读取 grader 代码的事件发展成 agent 基准的安全性测试项。
复现评估
开源程度相当高但留有关键保留。公开部分:一个 world 的完整仓库在 Hugging Face(CC BY 4.0,1,219 个 Parquet 文件共 76.5 GB,BigQuery 上 941 GB 未压缩;数据卡给出 BigQuery、DuckDB、Snowflake、Trino、Delta Lake、Iceberg 六种引擎的接入说明);GitHub 上以 Apache 2.0 发布全部复现代码:210 个任务、基于 Inspect AI 0.3.263 的参考 agent、仓库与 Python 工具服务器、mission-control 控制台、三种沙箱配置(macOS Seatbelt、锁定库的 Docker 镜像、论文实际使用的无网络 gVisor pod)、每个模型各努力档的配置,附录 L 还给出三个完整参考解。不公开部分:模拟器与 grader,以防直接记忆化答案;官方排行榜在私有 seed 的第二个 world 上评分,运行公开代码导出的提交文件由作者 best-effort 评分。算力需求:仓库用 BigQuery 或本地 DuckDB 均可承载,瓶颈是模型 API 调用——每任务平均 19–250 次调用、0.06–4.89 美元,单个模型跑完 210 任务约十几到一千美元 API 费。复现注意:重跑公开代码得到的是'兄弟世界'上的结果而非论文精确数字;15 个点名具体实体的问题取自公开 world;专有模型经 API 访问,结果可能随供应商更新漂移。总体难度中等:工程文档完善、跑通容易,但与官方排行榜对齐必须依赖主办方评分。
论文图表