数据湖分析中编码代理的无监督工具演化 Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
TEAL无需标签即可为编码代理演化可复用工具与技能,紧步数预算下大幅提升数据湖问答准确率
前置知识
数据湖(Data Lake)
存储大量异构数据的仓库:成千上万张表格、文档和原始文件混放在一起,没有统一 catalog 或索引。要在其上回答分析问题,必须先做数据发现(找到相关文件)、数据清洗(把混乱记录转成结构化表示)、跨源整合(对齐键后 join),最后才能分析推理。
本文的全部问题设定都在数据湖上:论文的核心观察是数据准备工作的重复性,以及没有 catalog 时代理会踩的坑(选错表粒度、清洗耗尽预算),理解数据湖的结构特点才能理解工具为什么有价值。
编码代理(Coding Agent)与轨迹
配备 bash shell 和文件编辑器的 LLM 代理,可以读写文件并执行代码,自主完成多步任务。它每解一题会留下一条轨迹:按顺序记录每一步动作、工具调用和中间输出。步数预算限制每个问题最多执行多少步,是控制成本和延迟的实际手段。
Worker 的轨迹既是 Critic 诊断问题的证据,也是验证阶段的比较对象;步数预算则是本文的关键实验变量——论文发现预算压力本身就是替代标签的训练信号。
工具演化(Tool Evolution)
跨任务自动构建和精炼可复用工具的过程:工具是加入代理动作空间的命名可调用程序,实现并调试好后一次调用即可替代多步流程,还可以由预计算的数据工件(catalog、索引、清洗后的表)支撑。技能文件则用自然语言告诉代理何时、如何调用每个工具。
这是本文的对象:TEAL 演化的不是模型权重,而是工具集与技能文件组成的库,测试时冻结后交给 Worker 使用。理解工具与工件的区别是理解 Explorer 通道价值的前提。
重跑验证(Rerun Verification)
无标签环境下判断工具变更是否有效的机制:用触发该变更的问题让 Worker 带着更新后的库重跑,把重跑轨迹与原轨迹对比,检查工具是否被调用、任务是否仍完成、答案变化是否有执行证据支撑,据此保留或回滚变更。
这是全文最核心的创新:它把「工具是否有用」的判断从外部真值标签转移到 Worker 自身的行为证据上,是理解本文与 ISE 等仅看执行是否成功的方法的本质区别的关键。
研究动机
编码代理(配备 bash shell 和文件编辑器)虽然能自主回答数据湖上的分析问题,但它们把每个问题当作孤立任务:回答完就把解析器、schema 检查、join 脚本全部丢弃,下一个问题从零开始重复发现、清洗、整合数据。论文的例子非常具体:要回答「哪个都会区占其州欺诈报告的比例最大」,答案散落在 52 个表头不规则的分州 CSV 文件里,埋在数千个文件中,且文件名无法反映表粒度——代理很可能误选缺少州级分解的全国汇总表;即便找对了文件,逐一打开清洗也会耗尽 30 步预算,15 步预算下失败更快。现有自动化方案两头堵死:catalog 与 ontology 格式只存描述性元数据,不含可执行的清洗查询工具;监督式工具生成器依赖真值标签,而数据湖问答验证一个答案本身就要求专家先走完发现-清洗-join 全流程;仅凭「执行无错」保留工具也不可靠——工具可能在错误粒度读表、解析丢行、join 键不对齐的情况下依然干净跑通。
本文的目标是本文目标是构建完全无监督的工具演化框架 TEAL:给定固定的 Worker 编码代理和一个数据湖,仅凭无标签的训练问题,自动演化出可复用库 $\mathcal{L} = (\mathcal{T}, S)$,其中 $\mathcal{T}$ 是可执行工具集(部分由预计算工件如 SQLite catalog、值索引支撑),$S$ 是自然语言技能文件,告诉 Worker 何时、如何调用每个工具;训练结束后库被冻结,在互斥的测试问题上评估。可量化的目标包括:在 10/15 步紧预算下提升全部四个 Worker(Gemini-3.8-Flash、Gemini-3.1-Pro、Sonnet-5、Opus-4.8)在 KramaBench 与 LakeQA 上的准确率;无监督的重跑验证效果要接近有真值的 oracle 验证;真实问题缺失时,用 TEAL-Q 合成问题演化出的库要与真实问题演化出的库相当。
与已有工作不同的是,已有工具演化方法隐含两个假设,在数据湖分析中都不成立:一是工具填补阻塞性缺口——没有它任务无法推进,于是接受标准退化为「能否执行成功」(如 ISE);二是可以用标签验证工具对答案的贡献。TEAL 抓住三个被忽视的点:第一,证据来源应当互补——仅靠轨迹分析(Critic 通道)只能修眼前的小错误,无法构建覆盖全湖的工件型工具,因此引入不看任何问题和轨迹、像领域专家一样通读数据湖的 Explorer 通道;第二,反馈信号可以来自 Worker 自身行为——重跑验证用三查代替真值;第三,紧步数预算本身就是训练信号:预算紧张时 Worker 以空答案、截断流水线等可见方式失败,给 Critic 明确靶子,也让「省一步就改变结局」的验证更灵敏,这是本文最有洞察力的发现。
核心方法
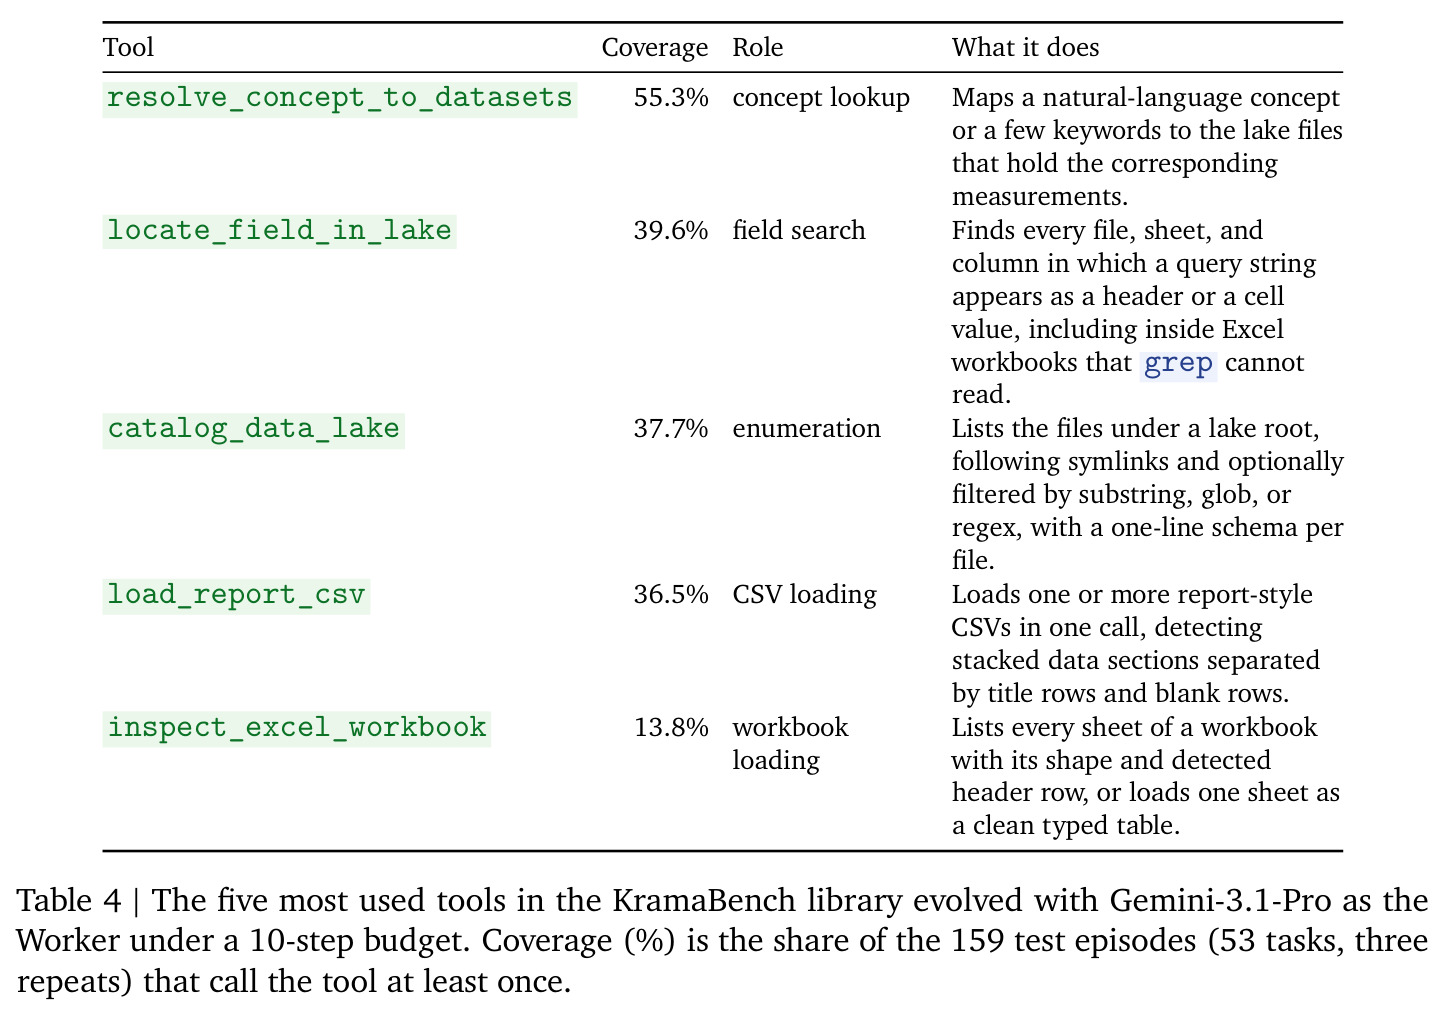
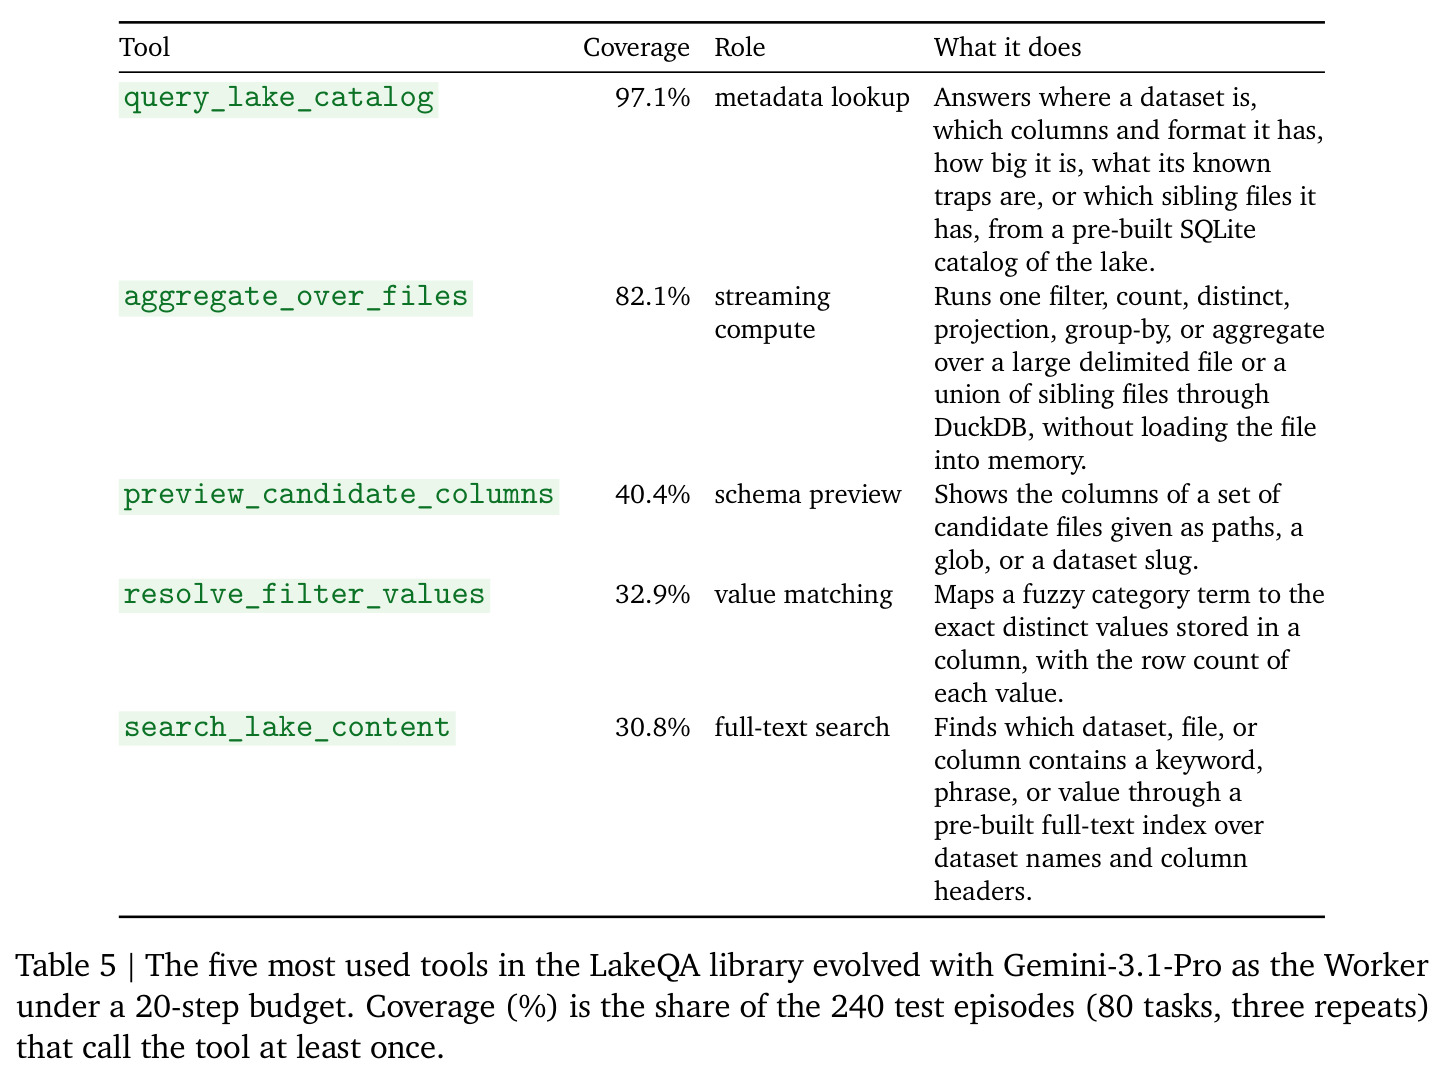
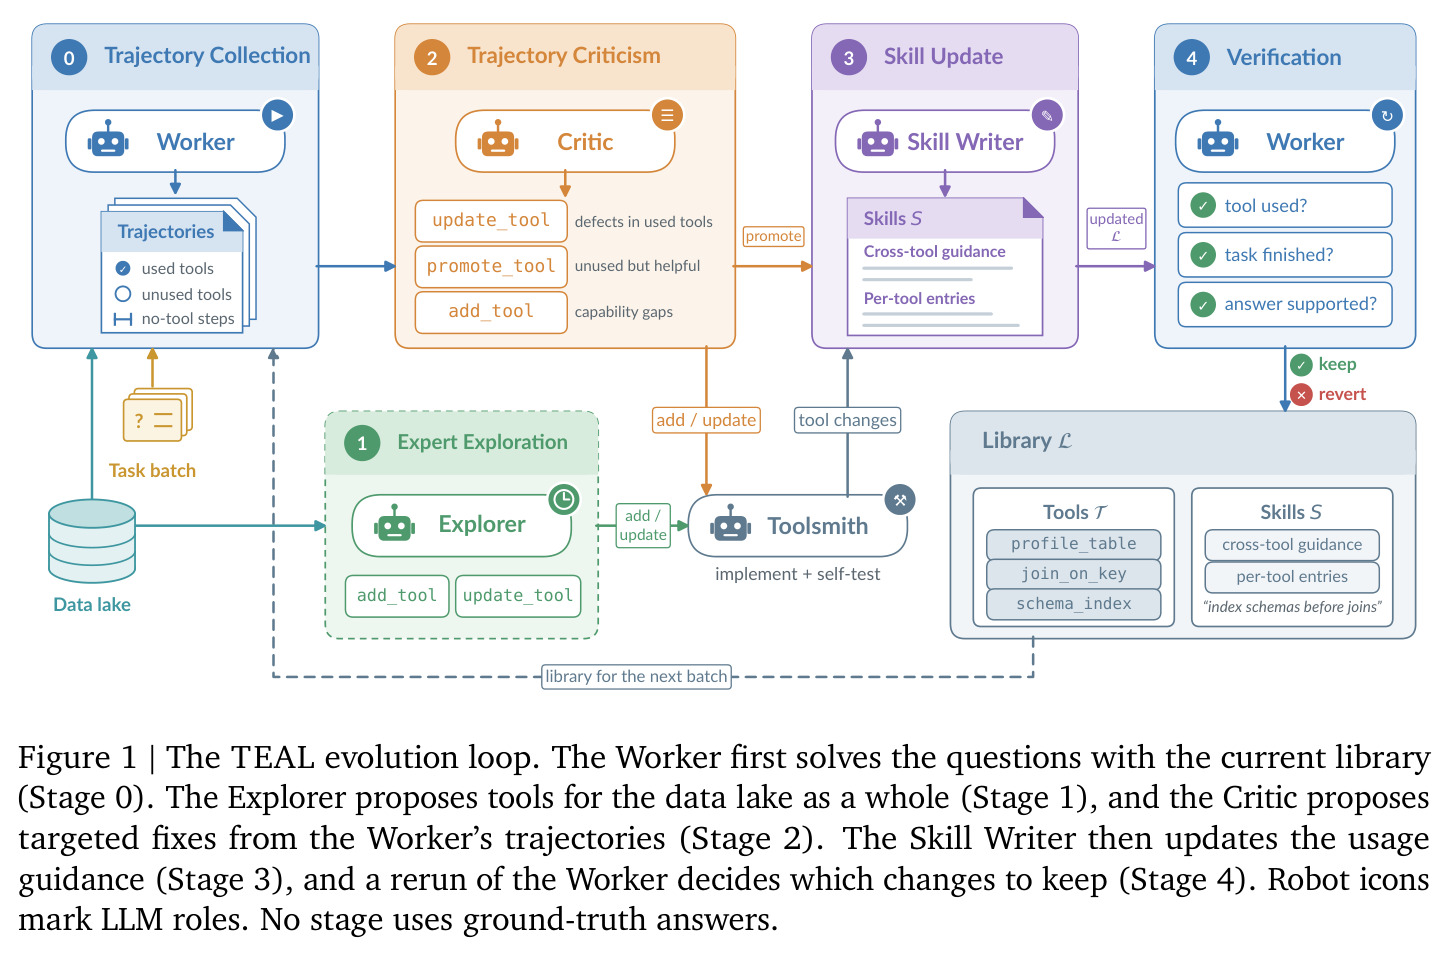
直觉上,数据库系统靠 catalog、索引、物化视图避免对原始数据的重复扫描,TEAL 就是让代理自己把这些「基础设施」建起来:一次工具调用替代 locate-load-join 的多步流程。技术路线上,TEAL 离线运行(作者称之为训练,但不更新任何模型权重),以 5 个问题为一批迭代更新库,协调五个 LLM 角色:Explorer 只看数据湖本身(每 $E = 4$ 批运行一次),像领域专家那样提出数据级工具与预计算工件,例如扫描数千个 CSV/Excel 文件后提出基于预计算 SQLite catalog(文件格式、列头、样例行)的数据集搜索工具;Critic 审查 Worker 轨迹摘要,找出浪费步骤和错误,提出针对性的 add/update/promote 操作;Toolsmith 把提案实现为可执行代码并用单元测试自检;Skill Writer 维护技能文件 $S$(跨工具工作流规则加每工具条目);Analyst 在验证阶段比较原轨迹与重跑轨迹。演化全程用 Opus-4.8 扮演所有角色,Worker 则可以是四个不同模型。
核心创新是无真值下的重跑验证。新工具可能通过单元测试却含逻辑错误(错粒度读表、丢行、键不对齐),也可能被 Worker 直接无视,因此「能执行」远不等于「有帮助」。TEAL 用触发该变更的问题重跑 Worker,与原轨迹对比做三查:(1) 变更的工具在重跑中被真实调用——没被调用通常说明技能指引不清而非工具损坏,此时先让 Skill Writer 修改用法说明再重跑一次;(2) 任务仍能完成——重跑不能从有答案变成无答案,步数超出原轨迹 $n$ 的部分不得超过 $m = \max(2, 0.2n)$;(3) 仅当答案变化时,Analyst 对比两条轨迹的执行证据(最终值是出现在工具输出里,还是仅由 Worker 口头断言),只有证据明确偏向原答案才判失败,偏向新答案或无法判定都通过。任一次重跑通过全部三查则保留变更,否则至多一轮修复后回滚。这套机制把「工具是否真的帮到了 Worker」的判断从外部标签转移到 Worker 自身的行为证据上,且实验证明其效果与用真值答案验证相当。
方法步骤详情
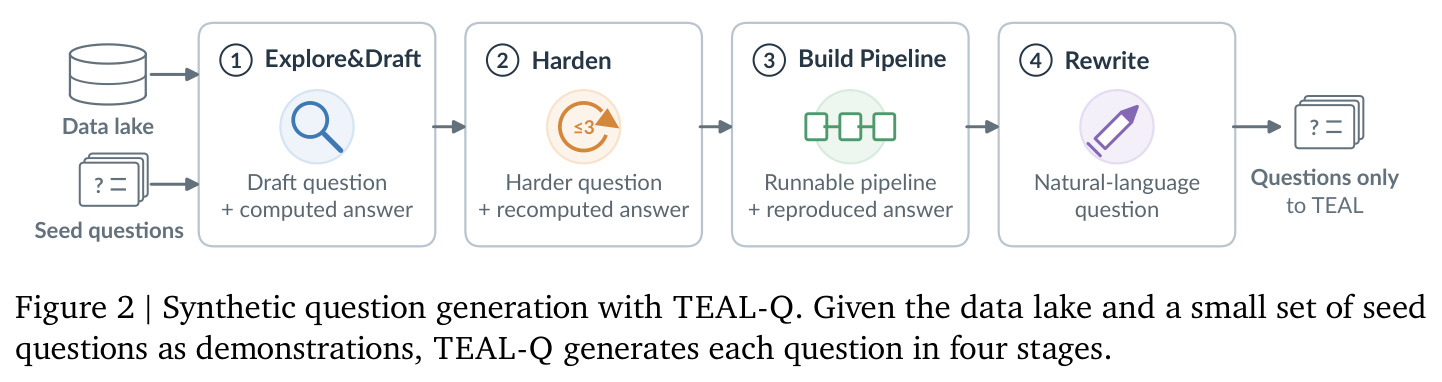
每个批次依次执行五个阶段。Stage 0 轨迹收集:Worker 用当前库 $\mathcal{L}$ 解答一批 5 个问题,记录每条轨迹及工具使用摘要(用了哪些工具、哪些没用、哪里连续多步无工具调用,例如在大目录上连跑七个 bash 搜索步骤耗尽预算)。Stage 1 专家探索(每 $E = 4$ 批一次):Explorer 在看不到问题和轨迹的条件下勘察数据湖的目录结构、文件格式与 schema,提出 add_tool/update_tool,可创建由持久工件支撑的工具,Toolsmith 实现并用单元测试验证。Stage 2 轨迹批评:Critic 结合 Stage 0 证据审查工具集,对已用工具的缺陷提 update_tool(如 catalog 漏掉某表的年度版本),对本可用却没用的工具提 promote_tool,对能力空白提 add_tool(如 Excel 表头不在首行时新增表头感知加载器)。Stage 3 技能更新:Skill Writer 把已实现变更与 promote 提案整合进 $S$,包括跨工具规则(先查 catalog 再跑 shell 搜索)与每工具条目。Stage 4 验证:Worker 用更新后的库重跑触发问题,按三查决定保留或回滚;训练结束后库冻结用于评估。TEAL-Q 在真实问题缺失时介入:从相关文件簇起草问题并用代码算出答案,至多三轮 Harden(加 join、加难解析文件)并每轮重算答案,再把解法变成可执行流水线验证可答性,最后改写成自然语言——只把问题交给 TEAL,答案与流水线仅用于保证问题良定义、无需人工验证正误。
技术新颖性
与最近工作的本质区别:EvoOntology 演化本体层但需保留有标签的 held-out 集来决定接受;DataCOPE 无标签发现技能,但其技能是程序性指导而非由持久工件支撑的可调用工具;Cai et al. 等监督式工具生成依赖标注样例;ISE 只按「执行无错」保留工具,会留下逻辑错误或低效工具——论文复现时其 search_file_content 工具逐行扫描全湖,126 次调用中 121 次超时,反而拖垮 Worker。长时程任务中的工具创建则是「任务无法推进才造工具、造完立刻被行使」,与数据湖场景「Worker 没有工具也不阻塞、工具价值只在多问题间摊销」的结构完全不同。TEAL 首次把验证信号定义为 Worker 在重跑中的行为变化,并把步数预算压力当作替代标签的训练信号——紧预算下演化、松预算下部署这一配方,是可以迁移到其他无监督智能体演化场景的方法论贡献。
实验结果
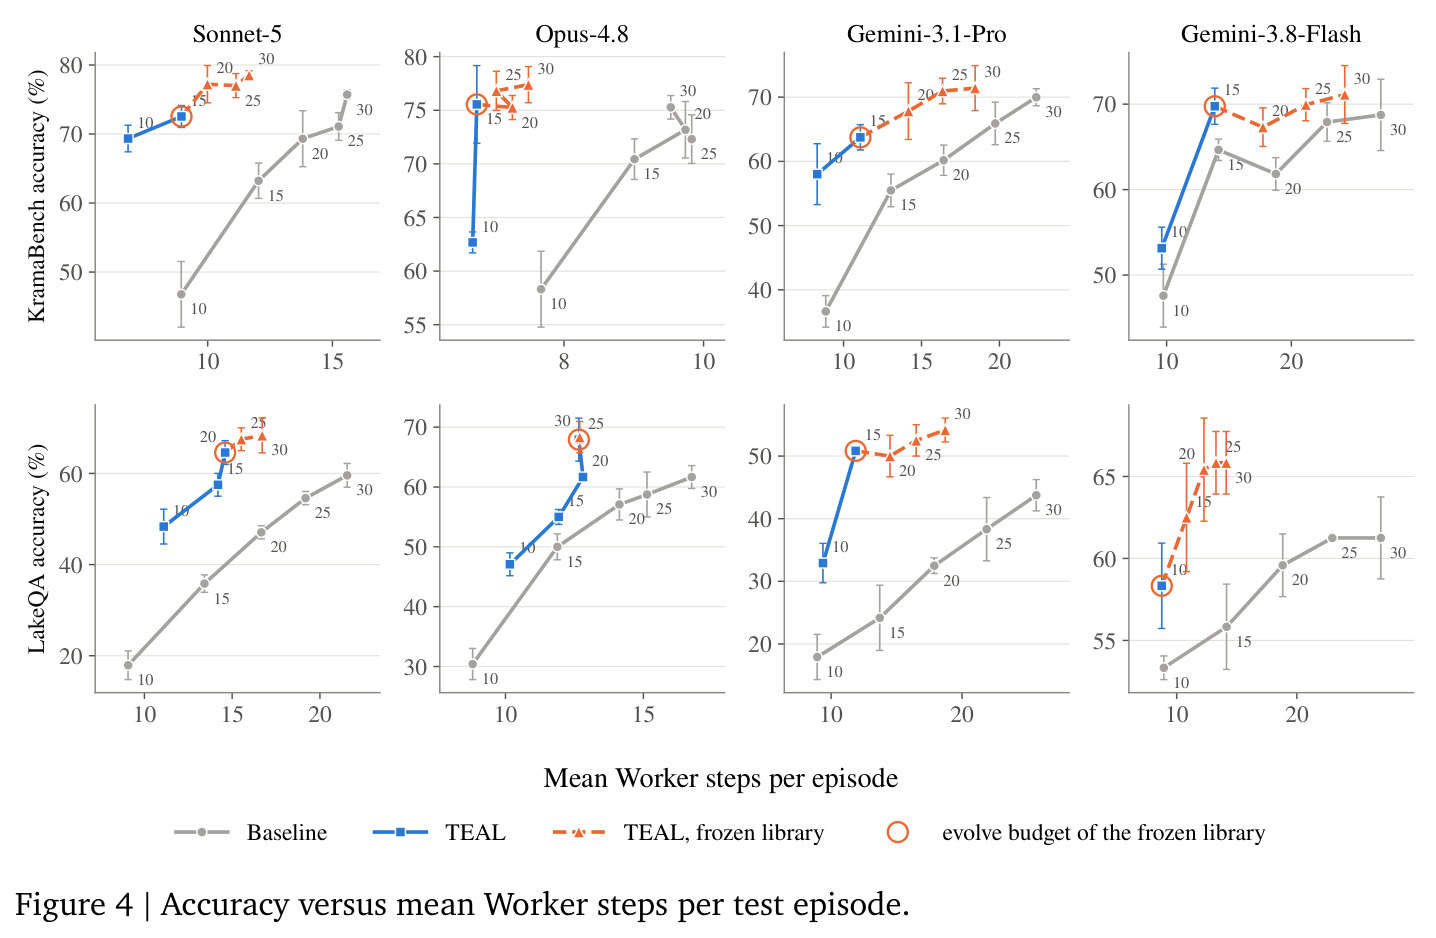
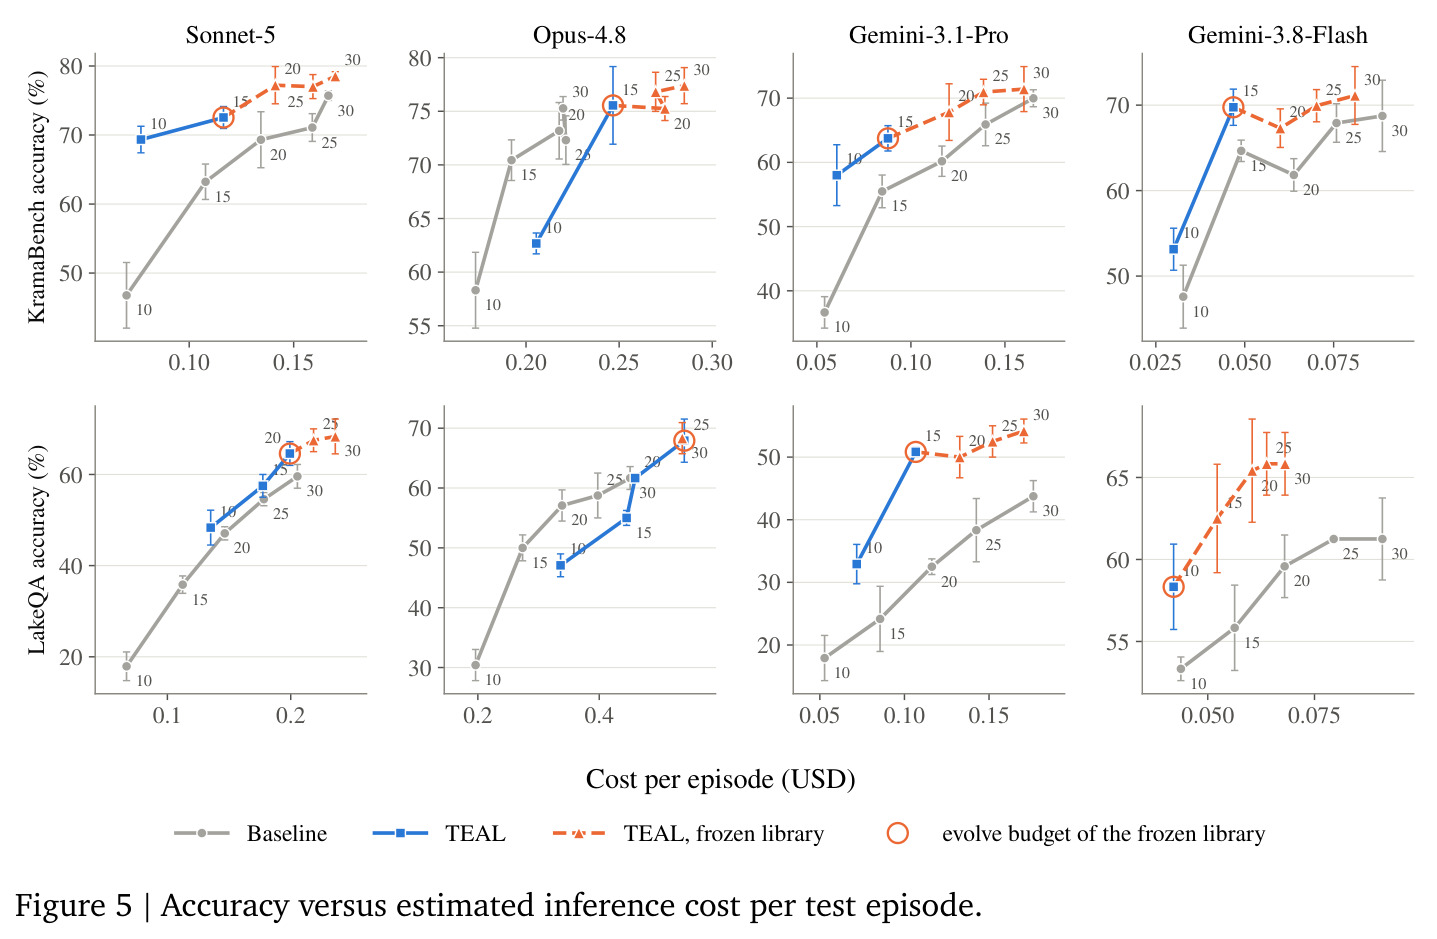
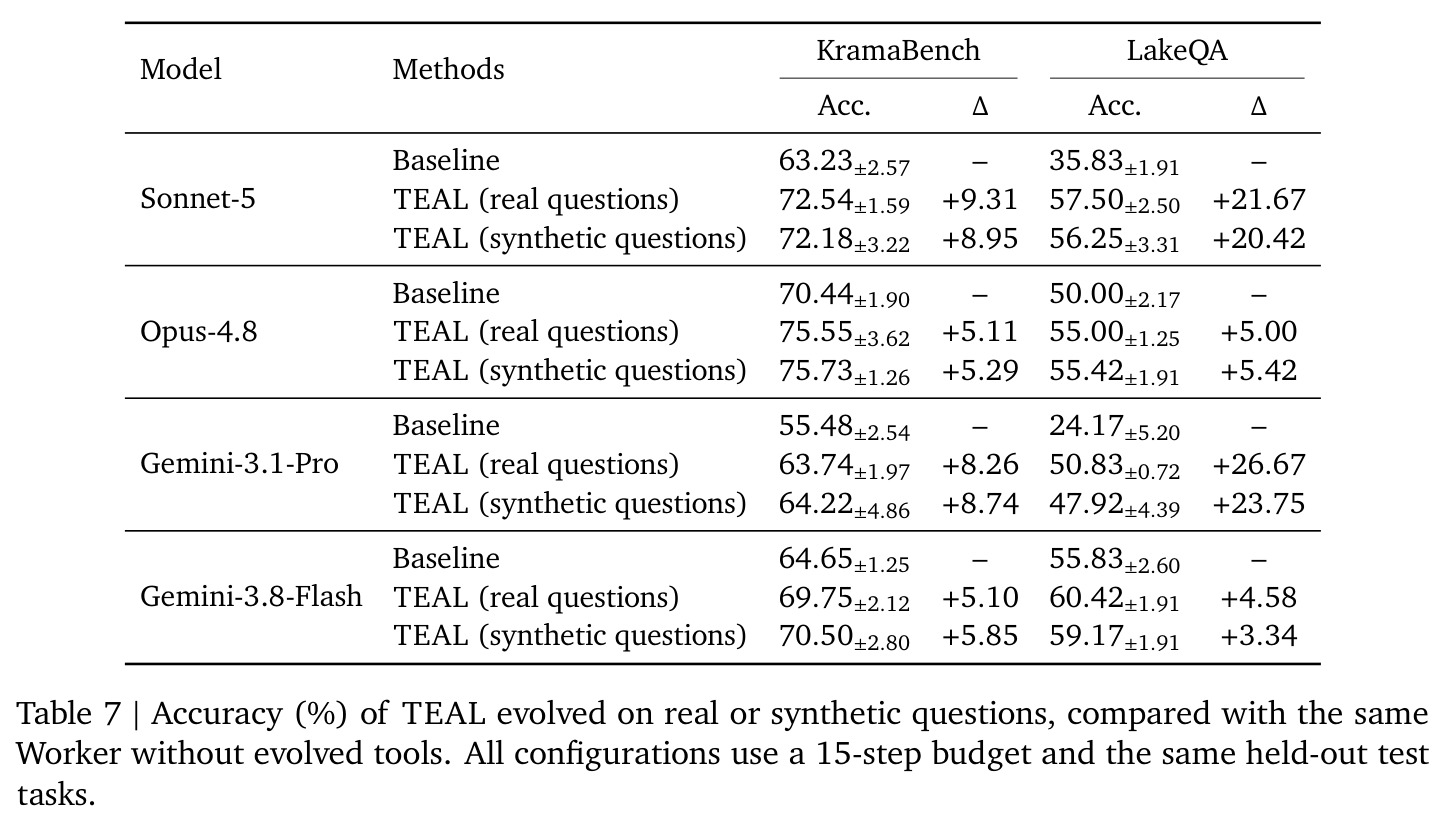
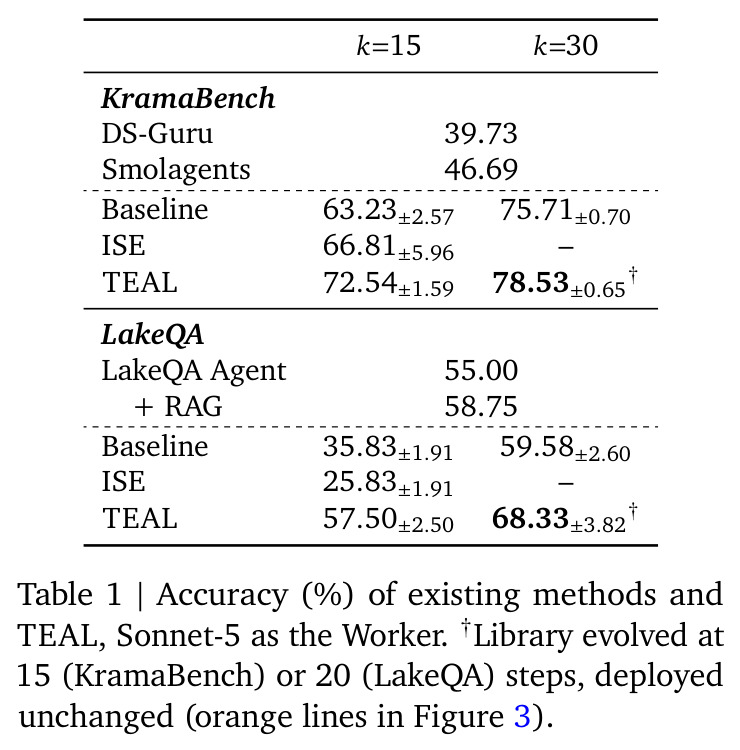
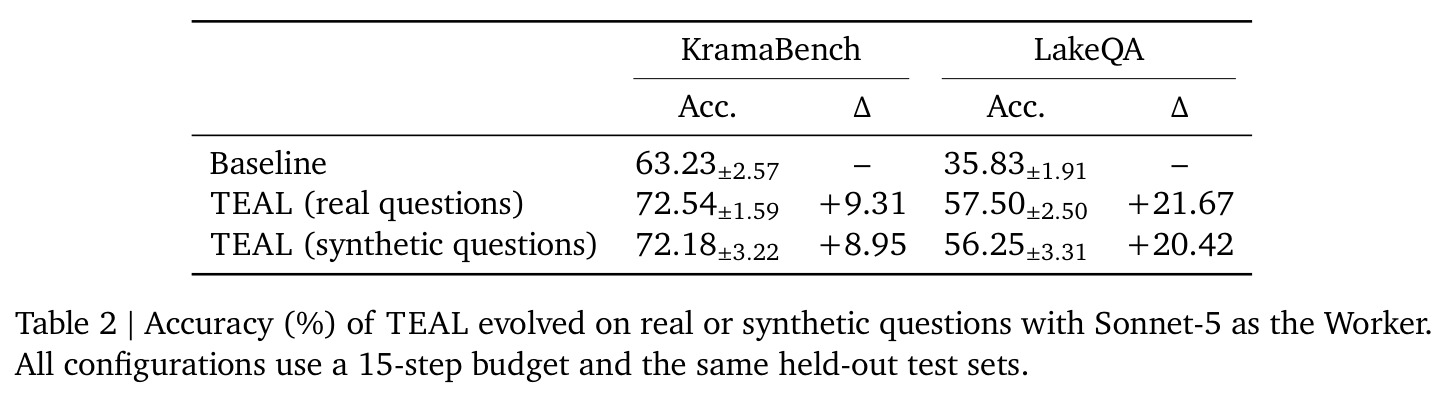
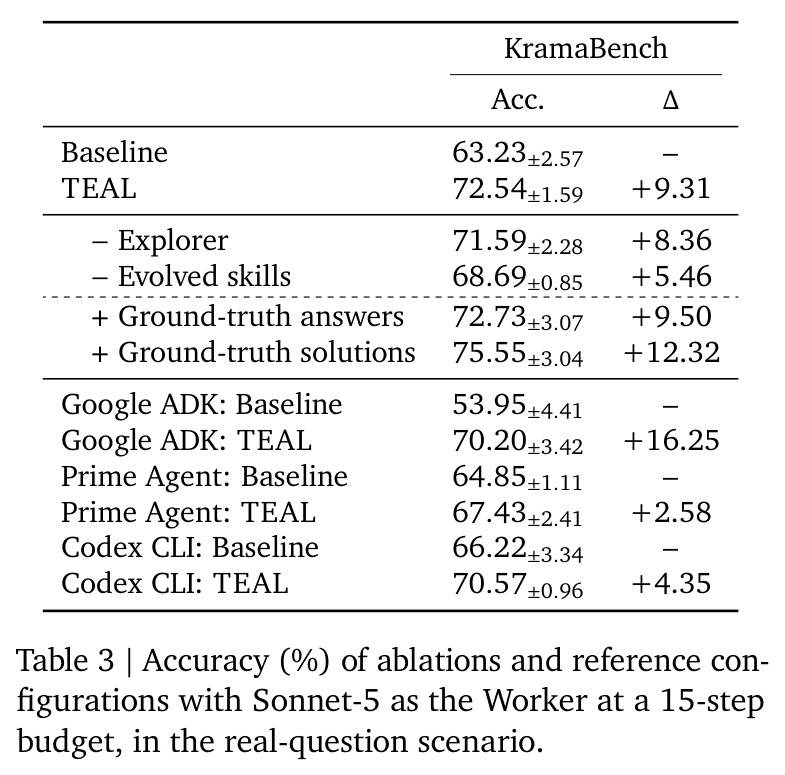
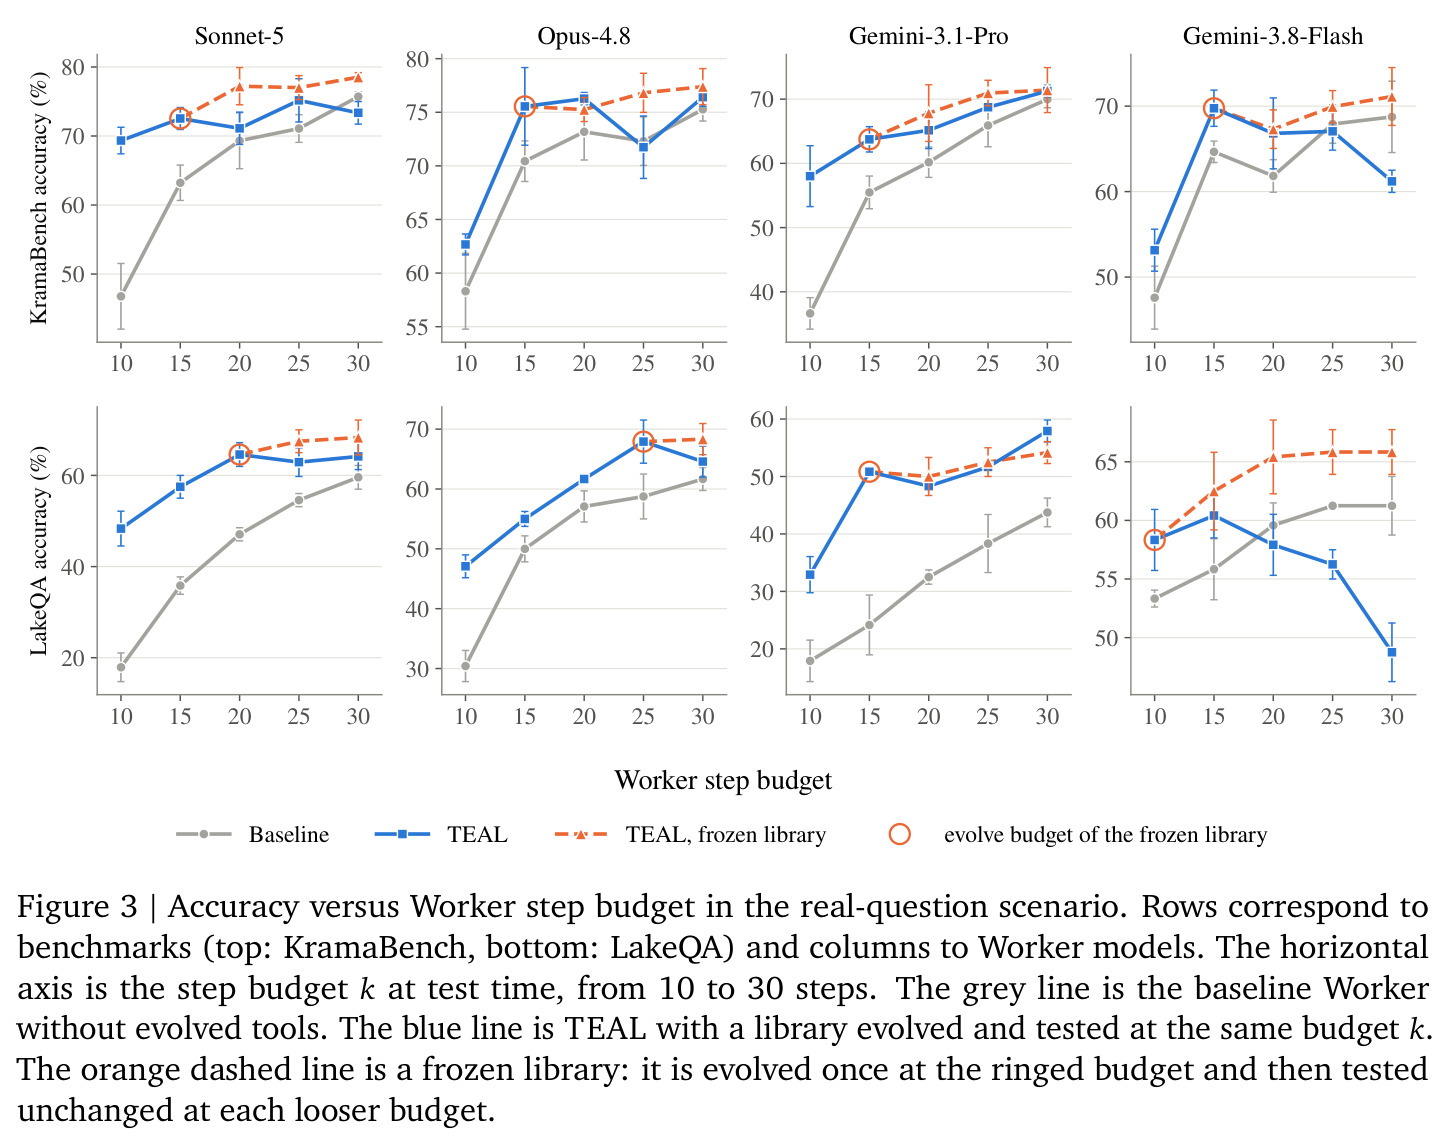
核心发现有四点。(1) 紧预算下全面提升:Sonnet-5 在 10 步预算下 KramaBench 提升 22.6 分、LakeQA 提升 30.4 分;15 步下分别提升 9.3 和 21.7 分;四个 Worker 在两个基准的 10/15 步全部提升,且八个面板中有五个 TEAL@15 步不低于基线@30 步。原因是单次工具调用替代了 locate-load-join 多步流程,让 Worker 能在基线耗尽于文件发现的预算内完成任务。(2) 与已有方法对比(Table 1):KramaBench 上基线 63.23(15 步)已远超 DS-Guru 39.73 和 Smolagents 46.69,TEAL 达 72.54±1.59、30 步 78.53;ISE 仅 66.81±5.96,比 TEAL 低 5.7 分。LakeQA 上 TEAL 57.50±2.50,超过带人工工具与预建索引的 LakeQA Agent(55.00)与 +RAG(58.75,25 步下),ISE 25.83±1.91 反而比基线低 10 分——其逐行扫描工具 126 次调用 121 次超时,说明执行无错不等于有用。(3) 紧预算演化可迁移(Figure 3 橙线):Sonnet-5 在 20 步演化的 LakeQA 库原样部署到 30 步得 68.3,高于基线 59.6 和直接在 30 步演化的 64.2,说明紧预算下的失败更可见、反馈更干净。(4) 合成问题足够:TEAL-Q 用 50 个合成问题演化,KramaBench 72.18±3.22、LakeQA 56.25±3.31,与真实问题的 72.54/57.50 相当。消融(Table 3):去掉 Explorer 降至 71.59(不再产出工件型工具),去掉演化技能大幅降至 68.69;给真值答案验证为 72.73(与无标签版相当,证明重跑验证已榨取答案能提供的反馈),给完整真值解法为 75.55。跨 harness 迁移:OpenHands 演化的库不改一字用于 Google ADK(53.95→70.20,+16.25)、Prime Agent(64.85→67.43)、Codex CLI(66.22→70.57)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| KramaBench 数据湖问答(Sonnet-5,15 步预算) | 官方评分准确率(%,含精确匹配/F1/相对误差/LLM 评审) | TEAL 72.54±1.59 | 基线 Worker 63.23±2.57;无监督工具演化 ISE 66.81±5.96 | 较基线 +9.31 分,较 ISE +5.73 分 |
| LakeQA 表格问答(Sonnet-5,15 步预算,80 测试题) | 确定性评分准确率(%) | TEAL 57.50±2.50 | 基线 Worker 35.83±1.91;LakeQA Agent+RAG 58.75(25 步);ISE 25.83±1.91 | 较基线 +21.67 分,较 ISE +31.67 分 |
| 两基准紧预算(Sonnet-5,10 步预算) | 准确率提升(分) | KramaBench +22.6 分,LakeQA +30.4 分 | 无工具库的基线 Worker | 10 步预算下四个 Worker 在两个基准全部提升 |
| LakeQA 紧预算演化的库迁移到松预算(Sonnet-5,20 步演化→30 步部署) | 准确率(%) | 68.3 | 基线 59.6;同预算(30 步)演化的库 64.2 | 比同预算演化高 4.1 分,比基线高 8.7 分 |
| KramaBench/LakeQA 合成问题演化(TEAL-Q,50 题,15 步部署) | 准确率(%) | KramaBench 72.18±3.22;LakeQA 56.25±3.31 | 真实问题演化 72.54±1.59 / 57.50±2.50 | 与真实问题演化相当(差距 0.36 / 1.25 分),远超基线 |
| 跨 harness 迁移(OpenHands 演化的库原样部署) | 准确率提升(分) | Google ADK +16.25(70.20 vs 53.95);Prime Agent +2.58;Codex CLI +4.35 | 各 harness 下无库基线 | 三个 harness 全部正收益,最大 +16.25 分 |
局限与改进
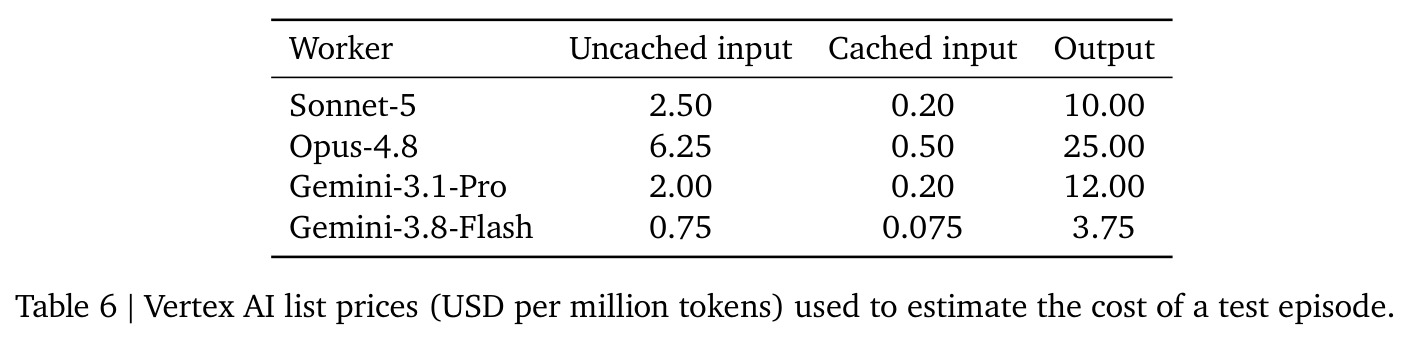
作者承认的局限:演化出的库以两种方式增加开销——技能文件和工具描述拉长 Worker 每步读取的 prompt,增加输入 token;Worker 每步倾向更多推理(作者推测是在权衡调用哪个工具)。此外所有演化角色由 Opus-4.8 扮演,演化成本未量化;实验仅覆盖两个数据湖基准。我的补充观察:验证第三查在证据无法判定时放行,长期可能保留微妙劣化答案的变更;库随批次只增不减,缺乏淘汰机制,ISE 的教训(坏工具占步数)说明这可能成为隐患;TEAL-Q 的问题难度依赖种子问题示范,覆盖面可能偏窄;松预算下同预算演化有时低于基线(蓝线),说明验证机制对预算敏感,部署前需要先用紧预算试演化。
独立分析的弱点
独立分析三点弱点。第一,验证的非对称性:第三查只要求「证据不偏向原答案」即通过,Analyst 判「无法判定」时变更被保留的概率高于被拒绝,在答案本身模糊的数据湖任务上可能累积静默回归;改进方向是让 Analyst 输出置信度、只对高置信通过放行,或周期性用少量人工抽检校准。第二,演化-部署的模型不对称:演化全部用 Opus-4.8,而部署 Worker 可以是便宜的 Flash,论文未报告演化总成本与每分准确率收益的性价比,也没有实验「用与 Worker 同档模型演化」的效果衰减,工程落地时这笔账必须算;改进方向是给出演化预算-收益曲线,并测试更便宜的演化角色组合。第三,技能文件是单一全局文档,随工具增多变长且可能互相冲突(作者已承认 prompt 变长、每步推理增多),工具库又只增不减,缺少类似数据库视图物化淘汰的机制;改进方向是引入按问题类型检索的分层技能组织、工具使用统计触动的自动剪枝。
未来方向
作者明确提出两个方向:通过改进重复 prompt 内容的缓存复用来压缩输入开销;把技能内化到 Worker 权重中(例如微调)以消除每步的工具选择推理开销。论文结语还希望启发无监督智能体演化中「演化什么、如何获取反馈」的研究。基于本文成果可延伸的:把「紧预算作为训练信号」推广到数据湖之外的长时程任务(网页操作、科学工作流、代码库维护);探索工具库的自动剪枝与版本管理,使演化可以长期在线运行;让 TEAL-Q 的合成问题难度分布自适应于 Critic 发现的失败模式,形成「生成-失败-修复」的闭环课程;研究多数据湖之间共享的通用工具层与湖特定工具的解耦,避免每个新湖从零演化。
复现评估
复现基础较好:基座 harness 是 OpenHands 开源 software-agent-sdk(论文给出链接),对比方法 ISE、DS-Guru 有公开代码(ISE 从发布代码忠实复现,仅替换 Worker),KramaBench 与 LakeQA 是公开基准——LakeQA 取 tables-only 变体 130 题(50 训练/80 测试),KramaBench 合并六域共 1,742 个文件(51 训练/53 测试),划分方式论文已说明。但算力与费用不低:演化阶段所有角色用 Opus-4.8,Worker 评估覆盖四个前沿模型,每个配置跑 3 次重复,步数预算扫描 10-30 步,API 开销可观;论文未明确声明自身代码开源,五个角色与验证三查的提示词细节需自行实现,属于中等偏高难度复现。若只想验证核心思想,可在单基准、单 Worker、固定 15 步预算、少量批次下做最小化复现。
论文图表